Przykład: sklep internetowy z materacami i pościelą
Fikcyjny sklep internetowy sprzedaje materace, pościel, kołdry i poduszki. Tydzień po dostawie każdy klient dostaje mail z jednym pytaniem: „Jak oceniasz zakup?” (1–5). Z 20 000 zamówień z pół roku ankietę wypełniło 2445 osób, czyli 12.2%. Dział marketingu pyta: czy średnia z ankiety mówi, jak zadowoleni są nasi klienci?
Sklep ma przewagę, której nie ma zwykły sondaż: CRM zna wszystkich klientów, także tych, którzy nie odpowiedzieli. Dla każdego zamówienia wiemy, co kupiono, za ile, ile dni trwała dostawa i czy towar wrócił. Satysfakcję znamy tylko u respondentów – to klasyczna sytuacja, w której może powstać błąd braku odpowiedzi.
Dane są fikcyjne, więc znamy prawdę: w symulacji każdy z 20 000 klientów ma ocenę, także ten, który nie odpowiedział. Średnia wszystkich wynosi 3.644, a odsetek zadowolonych (ocena 4–5) 57.85%. Parametry ustaliliśmy ręcznie (pełna lista przy kodzie): zwrot i długa dostawa obniżają ocenę, materac ją podnosi; odpowiadają częściej kupujący materace i droższe rzeczy, rzadziej ci po zwrocie. Po pierwszym uruchomieniu wzmocniliśmy wpływ kategorii i wartości na odpowiedź i ocenę oraz zwrotu na odpowiedź, bo obciążenie było małe (0.06 punktu); ziarna 682 nie zmienialiśmy. Dane pobierzesz jako ankieta-po-zakupie-sklep-z-materacami.csv (wiersz = zamówienie; ocena tylko u respondentów, tak jak w prawdziwym CRM).
Rysunek 1: od wszystkich klientów do odpowiadających
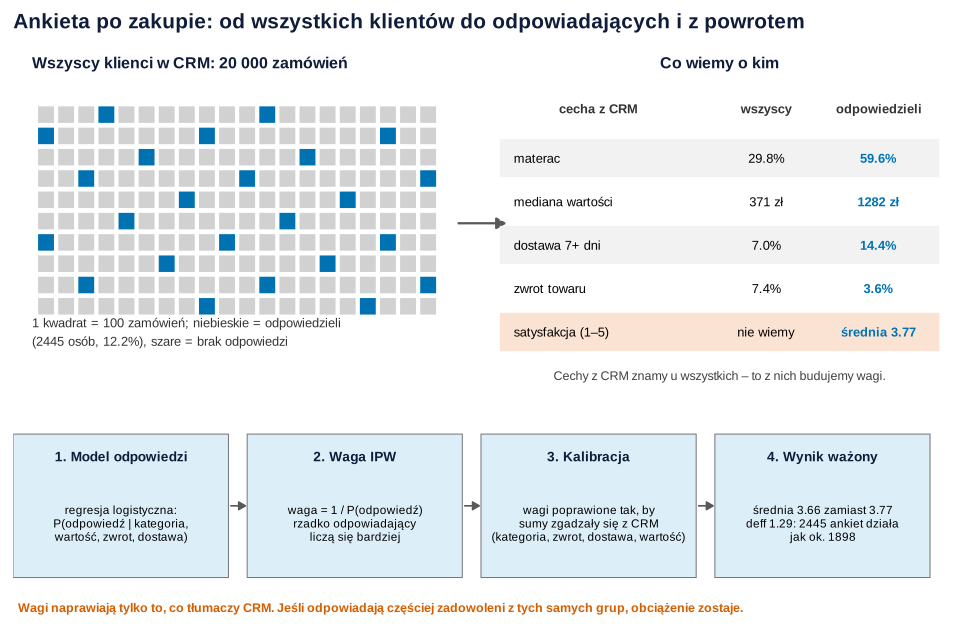
Co widać. Odpowiadający to nie miniatura klientów. Kupujących materace jest wśród nich dwa razy więcej (59.59% zamiast 29.82%), mediana wartości zamówienia to 1282 zł zamiast 371 zł, a zwrotów jest o połowę mniej (3.56% zamiast 7.41%). Problemem nie jest sam niski wskaźnik odpowiedzi, lecz to, że odpowiadający różnią się w cechach wpływających na satysfakcję. Groves (2006) zwraca uwagę, że brak odpowiedzi może, ale nie musi wywoływać obciążenia, a korekta po badaniu wymaga dobrych zmiennych pomocniczych. Tu są nimi dane z CRM.
Jak może zmylić. Tabela porównuje tylko cechy z CRM. Nie pokazuje, czy w obrębie tej samej kategorii, wartości i czasu dostawy odpowiadają częściej zadowoleni – tego z danych nie widać (wrócimy do tego na rysunku 5).
Rysunek 2: kto odpowiada na ankietę
Najpierw porównujemy odsetki odpowiedzi w grupach, potem wszystkie cechy naraz w regresji logistycznej, w której zmienną zależną jest „odpowiedział (1) / nie (0)”. Taki model to model skłonności do odpowiedzi – ten sam pomysł, co propensity score, tylko „leczeniem” jest udział w ankiecie.
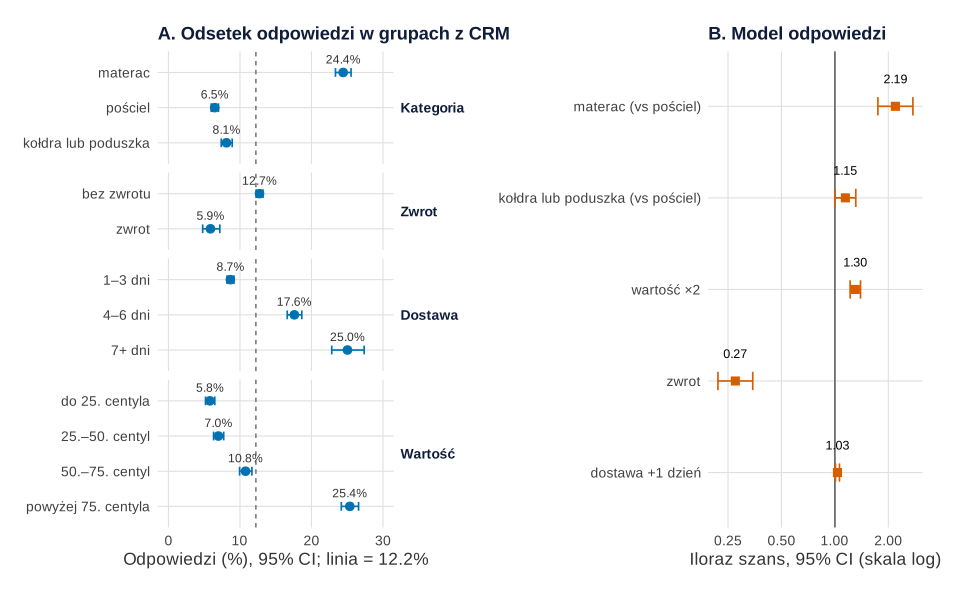
set.seed(682)).Co widać. Na ankietę odpowiedziało 24.4% kupujących materace (95% CI [23.4, 25.5]) i tylko 6.5% kupujących pościel. Klienci, którzy zwrócili towar, odpowiadali dwa razy rzadziej (5.9% wobec 12.7%). W modelu z wszystkimi cechami szansa odpowiedzi jest przy materacu 2.19 raza wyższa niż przy pościeli (95% CI [1.75, 2.75], p < .001), rośnie 1.30 raza przy podwojeniu wartości zamówienia i spada przy zwrocie (OR = 0.27, 95% CI [0.22, 0.34]).
Jak może zmylić. Panel A sugeruje, że długa dostawa mocno zachęca do odpowiedzi (25.0% przy 7+ dniach). W modelu każdy dodatkowy dzień to tylko OR = 1.03 (95% CI [1.01, 1.06], p = .012): długo jadą głównie materace, a to ich kupujący odpowiadają chętniej. Pole pod krzywą ROC modelu wynosi .707 – CRM dobrze, ale nie idealnie przewiduje, kto odpowie. Przewidywane skłonności wahają się od .010 do .420.
Ile myli się ankieta bez wag
Średnia 2445 odpowiedzi wynosi 3.769, a prawda – 3.644. Ankieta zawyża satysfakcję o 0.124 punktu, a odsetek zadowolonych o 5.46 punktu procentowego (63.31% wobec 57.85%). 95% przedział ufności średniej bez wag, [3.732, 3.805], w ogóle nie obejmuje prawdy: większa liczba ankiet zwęziłaby go wokół złej wartości. Mechanizm jest prosty: odpowiadają głównie kupujący drogie materace, którzy są bardziej zadowoleni, a milczą klienci po zwrocie, którzy są mniej zadowoleni. To błąd z części „reprezentacji” w całkowitym błędzie badania sondażowego (TSE).
Obciążenie średniej respondentów można zapisać jednym wzorem:
Słowami: liczy się to, czy skłonność do odpowiedzi jest skorelowana z satysfakcją, a nie sam odsetek odpowiedzi. Groves i Peytcheva (2008) w metaanalizie 59 badań, w których obciążenie dało się oszacować dzięki danym administracyjnym i bogatym operatom – czyli w sytuacji podobnej do CRM – sprawdzali, kiedy odsetek braku odpowiedzi wiąże się z obciążeniem, a kiedy nie.
Rysunek 3: wagi z CRM
Wagi IPW. Każdy respondent dostaje wagę równą odwrotności swojej przewidywanej skłonności do odpowiedzi: waga IPW = 1 / P(odpowiedź | CRM). Klient, który miał 4% szans na odpowiedź, „liczy się za” 25 klientów; kupujący materac z 40% szans – za 2.5. Seaman i White (2013) opisują IPW jako częstą metodę usuwania obciążenia z analizy samych pełnych przypadków i omawiają przycinanie i stabilizację wag.
Kalibracja. Drugi sposób nie wymaga modelu odpowiedzi: wagi poprawia się tak, by ważone sumy zgadzały się ze znanymi sumami z CRM (liczba klientów w kategoriach, zwrotów, grup czasu dostawy i łączna wartość zamówień). Deville i Särndal (1992) pokazali, że wagi kalibracyjne są możliwie bliskie wagom wyjściowym i dokładnie odtwarzają sumy populacyjne, a raking jest szczególnym przypadkiem tego podejścia. Haziza i Beaumont (2017) opisują ten sam porządek pracy: korekta braku odpowiedzi, potem kalibracja, w razie potrzeby przycięcie wag. Liczymy trzy wersje: IPW, kalibrację z wag jednakowych i IPW z kalibracją. Ogólny proces krok po kroku opisuje wpis ważenie danych sondażowych; tu pokazujemy wariant z pełnymi danymi o wszystkich klientach.
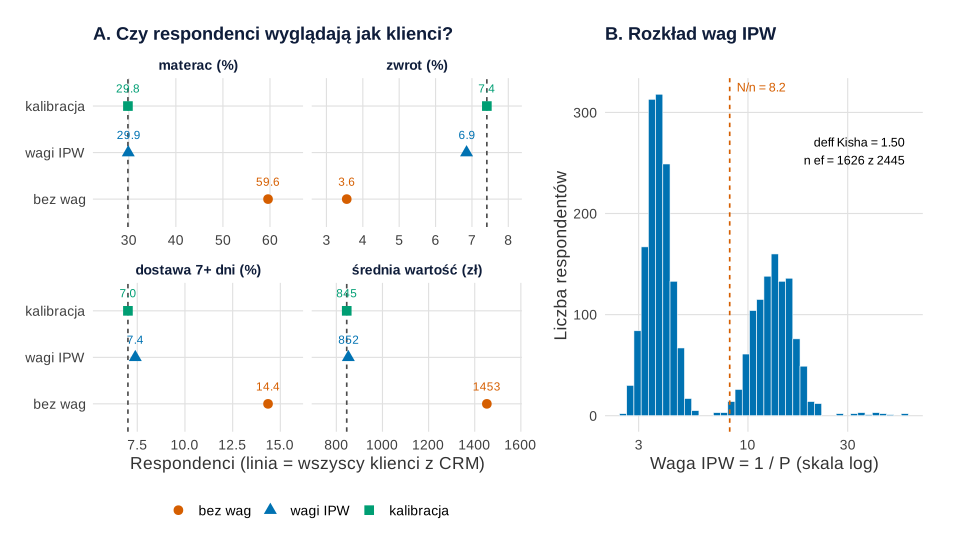
Co widać. Wagi IPW prawie wyrównują strukturę: materace 29.88% wobec 29.82% w CRM, zwroty 6.85% wobec 7.41%, średnia wartość 852 zł wobec 845 zł. Kalibracja z definicji trafia w sumy z CRM co do grosza. Wagi IPW wynoszą od 2.53 do 56.24 (stosunek największej do najmniejszej 22.25); dwa garby na panelu B to kupujący materace (niskie wagi) i pozostali.
Jak może zmylić. Zgodna struktura nie dowodzi, że wynik jest trafny – dowodzi tylko, że wagi zrobiły to, do czego je zbudowano. Ważenie kosztuje też precyzję. Efekt schematu wynikający z samych nierównych wag (deff Kisha = 1 + kwadrat współczynnika zmienności wag) wynosi 1.50, więc 2445 ankiet działa jak 1626 ankiet bez wag.
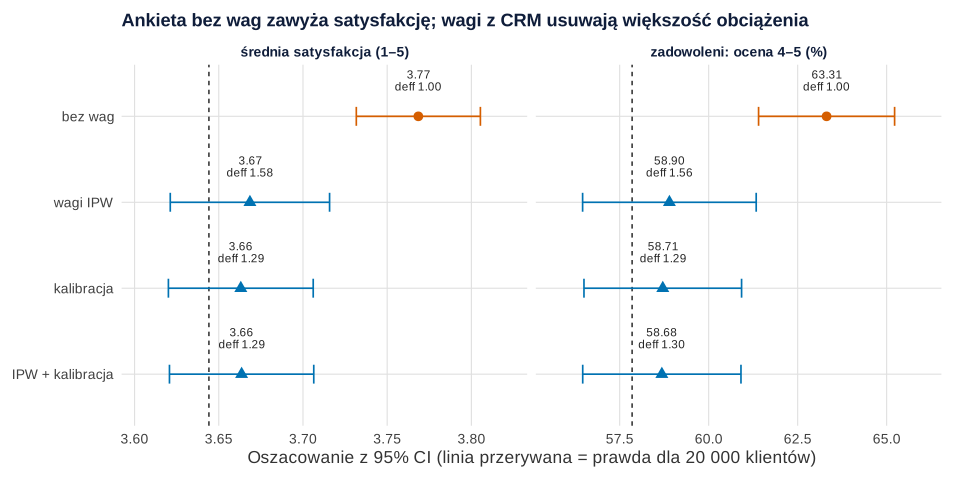
Rysunek 4: satysfakcja bez wag i z wagami
Średnie z wagami i ich błędy standardowe liczymy pakietem survey, który uwzględnia wagi i kalibrację (Lumley, 2004). Zwykły weighted.mean() daje tę samą średnią, ale nie poprawny przedział.
| Wersja | Średnia (95% CI) | Obciążenie | deff | n efektywne |
|---|---|---|---|---|
| Bez wag | 3.769 [3.732, 3.805] | +0.124 | 1.00 | 2445 |
| Wagi IPW | 3.669 [3.621, 3.716] | +0.024 | 1.58 | 1545 |
| Kalibracja (raking) | 3.663 [3.620, 3.706] | +0.019 | 1.29 | 1889 |
| IPW + kalibracja | 3.664 [3.621, 3.706] | +0.019 | 1.29 | 1898 |
Co widać. Wagi usuwają 80–85% obciążenia średniej (z 0.124 do 0.019–0.024) i odsetka zadowolonych (z 5.46 do 0.84–1.05 punktu procentowego). Każdy przedział z wagami obejmuje prawdę. Kalibracja ma mniejszy deff niż IPW (1.29 wobec 1.58), choć jej wagi są równie nierówne (deff Kisha 1.50–1.54): zmienne kalibracyjne, zwłaszcza zwrot, same wyjaśniają część satysfakcji, a kalibracja to wykorzystuje.
Jak może zmylić. W podgrupach wagi nie zawsze pomagają. W kategorii „kołdra lub poduszka” ankieta bez wag dała 3.597 (prawda 3.601), a po ważeniu 3.555 – mała grupa respondentów i wagi do 62.66 zwiększają losowy rozrzut. Porównania grup z przedziałami ufności pokazuje wpis NPS – przedział ufności i porównania.
Rysunek 5: kiedy ważenie nie pomoże
Wagi z CRM działają przy założeniu, że wśród klientów o tych samych cechach z CRM odpowiadający nie różnią się satysfakcją od milczących. To założenie MAR z hasła braki danych MCAR, MAR i MNAR. Groves, Presser i Dipko (2004) sprawdzali eksperymentalnie, czy osoby zainteresowane tematem chętniej biorą udział w badaniu i co to oznacza dla błędu braku odpowiedzi. W ankiecie po zakupie „tematem” jest sam zakup: zadowolony klient może chętniej kliknąć w gwiazdki.
Powtarzamy ankietę 1000 razy na tych samych 20 000 klientach w dwóch scenariuszach. MAR: odpowiedź zależy tylko od cech z CRM (jak w przykładzie). MNAR: dodatkowo każdy punkt satysfakcji powyżej średniej zwiększa logit odpowiedzi o 0.4; wyraz wolny przesunęliśmy tak, by wskaźnik odpowiedzi pozostał 11.9%. Siłę tej zależności ustaliliśmy ręcznie; w pierwszej wersji było to 0.6, co dawało obciążenie aż 0.52 punktu, więc przyjęliśmy łagodniejszy wariant. Symulacja ma własne ziarno (2682): użycie 682 powtórzyłoby liczby losowe, którymi losowano kategorie zamówień, i sztucznie związało odpowiedź z kategorią.
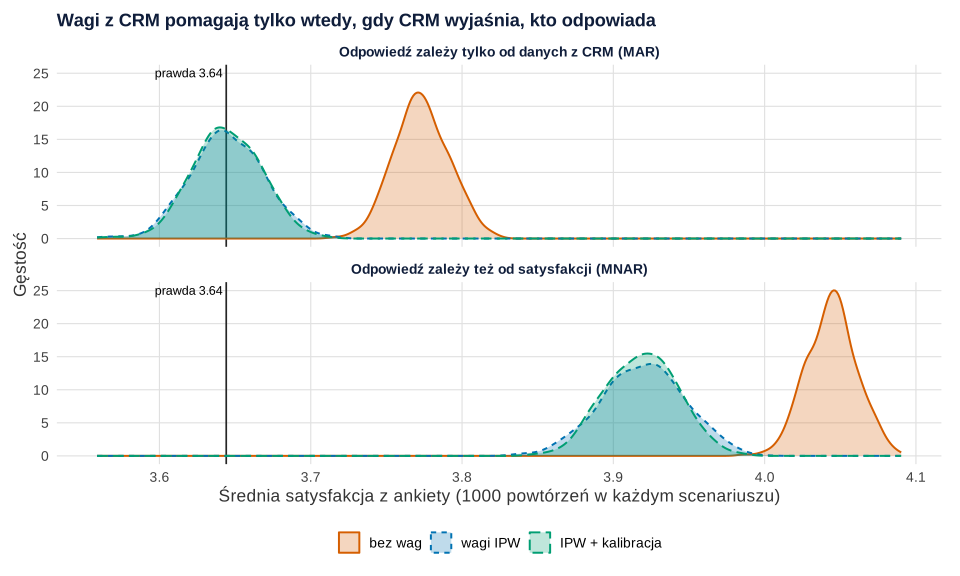
set.seed(2682)).Co widać. Przy MAR średnia bez wag jest obciążona o 0.129 punktu, a z wagami IPW o 0.001 (błąd Monte Carlo 0.0008); pierwiastek błędu średniokwadratowego spada z 0.130 do 0.024. Przy MNAR ankieta bez wag zawyża wynik o 0.400, a wagi zmniejszają obciążenie tylko do 0.275 (IPW) i 0.274 (IPW z kalibracją). Ważenie usunęło część błędu, która szła przez CRM, ale nie usunie części, która zależy od samej satysfakcji.
Jak może zmylić. W danych z jednej ankiety oba scenariusze wyglądają tak samo: wagi wyrównują strukturę równie dobrze, a deff Kisha jest podobny (średnio 1.58 i 1.80). Założenia MAR nie da się sprawdzić na samych respondentach. Zostaje analiza wrażliwości typu „punkt krytyczny”: o ile musieliby różnić się milczący, żeby zmienić wniosek. Model wyboru, jak model selekcji Heckmana, opiera się na mocnych założeniach i nie zastąpi danych od części milczących.
Co z tym zrobić w marketingu
- Raportuj satysfakcję ważoną, a surową jako drugą liczbę. Tu różnica to 0.105 punktu średniej i 4.6 punktu procentowego zadowolonych – tyle, ile często dzieli „cel osiągnięty” od „nieosiągnięty”.
- Co kwartał sprawdzaj, kto odpowiada. Zmiana kampanii mailowej albo kanału sprzedaży może zmienić skład respondentów bez zmiany satysfakcji.
- Zbieraj odpowiedzi od tych, którzy milczą. Krótkie przypomnienie lub telefon do losowej próbki klientów po zwrocie da choć trochę danych o grupie, której wagi muszą „dopowiadać” najwięcej. To jedyny sposób, żeby sprawdzić MNAR.
- Nie porównuj kategorii surowymi średnimi. Pościel i materace mają różnych respondentów; porównuj średnie ważone z przedziałami. Jak zwroty rozkładają się na produkty, opisuje wpis zwroty produktów w sklepie internetowym.
- Pamiętaj o tym przy innych ankietach. Ten sam błąd grozi deklaracjom zakupu i szacunkom wielkości rynku z ankiety.
Jak opisać w pracy
W Metodzie podaj liczbę zaproszonych i respondentów, cechy z CRM użyte do ważenia, model odpowiedzi, sposób kalibracji, ewentualne przycięcie wag i metodę błędów standardowych. W Wynikach – oszacowanie ważone z 95% CI, wynik bez wag i efekt schematu; w Ograniczeniach – założenie MAR. Więcej o pracach na danych firmowych: statystyka w pracy z marketingu; różnicę między strukturą próby a trafnym wynikiem pokazuje próba reprezentatywna w obrazkach.
Kod R: dane z CRM, model odpowiedzi, wagi, kalibracja i symulacja
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają następne. Model odpowiedzi to glm(), wagi i kalibracja (raking) – pakiet survey (svydesign(), calibrate(), svymean()). Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(682)) i 5 (set.seed(2682)); ziarna ustalono raz. Ręcznie ustalono: 20 000 zamówień, udziały kategorii (30/45/25%), mediany wartości i średni czas dostawy w kategoriach, model zwrotu, model satysfakcji (zwrot −1.4, każdy dzień dostawy ponad 3 dni −0.13, materac +0.35, logarytm wartości +0.15, szum SD = 0.95) i model odpowiedzi (materac +0.70, logarytm wartości +0.40, zwrot −1.40, dzień dostawy +0.04 na skali logitu), a w symulacji siłę zależności MNAR (0.4 na punkt satysfakcji). Po pierwszym uruchomieniu wzmocniono wpływ kategorii i wartości na odpowiedź i satysfakcję oraz zwrotu na odpowiedź (obciążenie wynosiło 0.06 punktu), a zależność MNAR osłabiono z 0.6 do 0.4. Powtórzenia: 1000 ankiet w każdym scenariuszu.
1. Paleta, dane z CRM i ankieta: liczby z przykładu
R
# Dane. Fikcyjny sklep internetowy z materacami i pościelą: 20 000 zamówień z CRM i ankieta satysfakcji po zakupie
# (dane symulowane). Kod tworzy paletę, motyw i dane, z których korzystają kolejne przepisy.
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", blekit = "#56B4E9", szary = "grey55", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie --------------------------------------------------------------------
N <- 20000                                                     # zamówienia z 6 miesięcy (jeden klient = jedno zamówienie)
kategorie <- c("materac", "pościel", "kołdra lub poduszka")
udzial_kat <- c(0.30, 0.45, 0.25)
mediana_wartosci <- c(materac = 1900, "pościel" = 260, "kołdra lub poduszka" = 340)   # zł
srednia_dni <- c(materac = 5.0, "pościel" = 2.3, "kołdra lub poduszka" = 2.6)         # dni dostawy

# Satysfakcja 1–5 („Jak oceniasz zakup?”): zwrot i długa dostawa obniżają ocenę, materac ją podnosi
satysfakcja_z <- function(kat, wartosc, zwrot, dni) {
  eta <- 3.70 + 0.35 * (kat == "materac") + 0.15 * log(wartosc / 500) - 1.40 * zwrot - 0.13 * (dni - 3) +
    rnorm(length(kat), 0, 0.95)
  pmin(5, pmax(1, round(eta)))
}
# Skłonność do odpowiedzi (logit): odpowiadają częściej kupujący materace i droższe rzeczy,
# rzadziej ci, którzy zwrócili towar; dłuższa dostawa lekko zwiększa chęć odpowiedzi („żeby się poskarżyć”)
logit_odp <- function(kat, wartosc, zwrot, dni) {
  -2.35 + 0.70 * (kat == "materac") + 0.40 * log(wartosc / 500) - 1.40 * zwrot + 0.04 * (dni - 3)
}

set.seed(682)
kat <- sample(kategorie, N, replace = TRUE, prob = udzial_kat)
wartosc <- round(rlnorm(N, log(mediana_wartosci[kat]), 0.45))
dni <- pmin(14, 1 + rpois(N, srednia_dni[kat] - 1))
zwrot <- rbinom(N, 1, plogis(-2.9 + 0.7 * (kat == "materac") + 0.12 * (dni - 3)))
satysfakcja <- satysfakcja_z(kat, wartosc, zwrot, dni)          # znamy ją u WSZYSTKICH – tylko w symulacji
odpowiedz <- rbinom(N, 1, plogis(logit_odp(kat, wartosc, zwrot, dni)))
crm <- data.frame(zamowienie = seq_len(N), kategoria = factor(kat, levels = kategorie), wartosc = wartosc,
                  dni_dostawy = dni, zwrot = zwrot, odpowiedz = odpowiedz,
                  satysfakcja = ifelse(odpowiedz == 1, satysfakcja, NA))   # w CSV satysfakcja tylko respondentów
crm$dostawa <- cut(crm$dni_dostawy, c(0, 3, 6, 14), labels = c("1–3 dni", "4–6 dni", "7+ dni"))
write.csv(crm[, c("zamowienie", "kategoria", "wartosc", "dni_dostawy", "zwrot", "odpowiedz", "satysfakcja")],
          "ankieta-po-zakupie-sklep-z-materacami.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Co wiemy o wszystkich klientach (CRM), a co tylko o respondentach
c(zamowien = N, odpowiedzi = sum(odpowiedz), wskaznik_odp_proc = round(100 * mean(odpowiedz), 2))
opis <- function(d) c(materac_proc = 100 * mean(d$kategoria == "materac"), mediana_wartosci = median(d$wartosc),
                      sr_dni = mean(d$dni_dostawy), dostawa_7plus_proc = 100 * mean(d$dni_dostawy >= 7),
                      zwrot_proc = 100 * mean(d$zwrot))
round(rbind(wszyscy = opis(crm), respondenci = opis(crm[crm$odpowiedz == 1, ])), 2)
# Prawda (znana tylko dzięki symulacji) i wynik ankiety bez wag
prawda <- mean(satysfakcja)
c(prawda_srednia = prawda, ankieta_srednia = mean(crm$satysfakcja, na.rm = TRUE),
  prawda_zadowoleni_proc = 100 * mean(satysfakcja >= 4),
  ankieta_zadowoleni_proc = 100 * mean(crm$satysfakcja >= 4, na.rm = TRUE)) |> round(3)
Wynik w R
         zamowien        odpowiedzi wskaznik_odp_proc
         20000.00           2445.00             12.22
            materac_proc mediana_wartosci sr_dni dostawa_7plus_proc zwrot_proc
wszyscy            29.82              371   3.17               7.01       7.41
respondenci        59.59             1282   4.01              14.36       3.56
         prawda_srednia         ankieta_srednia  prawda_zadowoleni_proc
                  3.644                   3.769                  57.850
ankieta_zadowoleni_proc
                 63.313
2. Kto odpowiada: odsetki i regresja logistyczna (Rysunek 2)
R
# Rysunek 2. Kto odpowiada na ankietę po zakupie: odsetek odpowiedzi w grupach z CRM i regresja logistyczna odpowiedzi
# Korzysta z obiektów przepisu 1: crm, kol, motyw. Nie losuje.
library(ggplot2)
library(patchwork)

# Odsetek odpowiedzi w grupach z 95% przedziałem Wilsona
crm$wartosc_grupa <- cut(crm$wartosc, quantile(crm$wartosc, 0:4 / 4), include.lowest = TRUE,
                         labels = c("do 25. centyla", "25.–50. centyl", "50.–75. centyl", "powyżej 75. centyla"))
crm$zwrot_t <- factor(crm$zwrot, 0:1, c("bez zwrotu", "zwrot"))
grupy <- list("Kategoria" = "kategoria", "Zwrot" = "zwrot_t", "Dostawa" = "dostawa", "Wartość" = "wartosc_grupa")
odsetki <- do.call(rbind, lapply(names(grupy), function(g) {
  do.call(rbind, lapply(levels(crm[[grupy[[g]]]]), function(poz) {
    x <- crm$odpowiedz[crm[[grupy[[g]]]] == poz]
    ci <- prop.test(sum(x), length(x), correct = FALSE)$conf.int
    data.frame(zmienna = g, grupa = poz, n = length(x), odp = sum(x), proc = 100 * mean(x),
               dolna = 100 * ci[1], gorna = 100 * ci[2])
  }))
}))
transform(odsetki, proc = round(proc, 1), dolna = round(dolna, 1), gorna = round(gorna, 1))

# Model odpowiedzi: regresja logistyczna na zmiennych z CRM (znanych dla wszystkich 20 000 klientów)
crm$kategoria_m <- relevel(crm$kategoria, ref = "pościel")             # punkt odniesienia: pościel
model_odp <- glm(odpowiedz ~ kategoria_m + log(wartosc) + zwrot + dni_dostawy, family = binomial, data = crm)
ilorazy <- data.frame(zmienna = c("materac (vs pościel)", "kołdra lub poduszka (vs pościel)",
                                  "wartość ×2", "zwrot", "dostawa +1 dzień"),
                      wsp = coef(model_odp)[-1], se = sqrt(diag(vcov(model_odp)))[-1],
                      p = summary(model_odp)$coefficients[-1, 4], row.names = NULL)
ilorazy$mnoznik <- ifelse(ilorazy$zmienna == "wartość ×2", log(2), 1)    # OR dla podwojenia wartości
ilorazy <- transform(ilorazy, OR = exp(wsp * mnoznik), dolna = exp((wsp - 1.96 * se) * mnoznik),
                     gorna = exp((wsp + 1.96 * se) * mnoznik))
transform(ilorazy[, c("zmienna", "OR", "dolna", "gorna", "p")], OR = round(OR, 2), dolna = round(dolna, 2),
          gorna = round(gorna, 2), p = signif(p, 3))
# Jak dobrze CRM przewiduje odpowiedź: pole pod krzywą ROC (AUC) i zakres przewidywanych skłonności
crm$p_odp <- fitted(model_odp)
r <- rank(crm$p_odp); n1 <- sum(crm$odpowiedz); n0 <- sum(1 - crm$odpowiedz)
c(AUC = (sum(r[crm$odpowiedz == 1]) - n1 * (n1 + 1) / 2) / (n1 * n0),
  p_min = min(crm$p_odp), p_mediana = median(crm$p_odp), p_max = max(crm$p_odp)) |> round(3)

# Rysunek 2A: odsetek odpowiedzi w grupach
odsetki$zmienna <- factor(odsetki$zmienna, levels = names(grupy))
odsetki$grupa <- factor(odsetki$grupa, levels = rev(unique(odsetki$grupa)))
sredni <- 100 * mean(crm$odpowiedz)
pA <- ggplot(odsetki, aes(proc, grupa)) +
  geom_vline(xintercept = sredni, colour = "grey50", linetype = "22") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(size = 2.6, colour = kol[["niebieski"]]) +
  geom_text(aes(label = sprintf("%.1f%%", proc)), nudge_y = 0.38, size = 3.2, colour = "grey20") +
  facet_grid(zmienna ~ ., scales = "free_y", space = "free_y") +
  scale_x_continuous(limits = c(0, 30)) +
  labs(x = sprintf("Odpowiedzi (%%), 95%% CI; linia = %.1f%%", sredni), y = NULL,
       title = "A. Odsetek odpowiedzi w grupach z CRM") +
  motyw + theme(strip.text.y = element_text(angle = 0, hjust = 0))
# Rysunek 2B: ilorazy szans z modelu odpowiedzi (skala logarytmiczna)
ilorazy$zmienna <- factor(ilorazy$zmienna, levels = rev(ilorazy$zmienna))
pB <- ggplot(ilorazy, aes(OR, zmienna)) +
  geom_vline(xintercept = 1, colour = "grey40") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", colour = kol[["cynober"]]) +
  geom_point(size = 2.8, shape = 15, colour = kol[["cynober"]]) +
  geom_text(aes(label = sprintf("%.2f", OR)), nudge_y = 0.3, size = 3.3) +
  scale_x_log10(breaks = c(0.25, 0.5, 1, 2, 4)) +
  labs(x = "Iloraz szans, 95% CI (skala log)", y = NULL, title = "B. Model odpowiedzi") + motyw
p2 <- pA + pB + plot_layout(widths = c(1.1, 1))
p2   # zapis: ggsave("ankieta-po-zakupie-kto-odpowiada.svg", p2, width = 10, height = 6.2)
Wynik w R
              zmienna               grupa     n  odp proc dolna gorna
1           Kategoria             materac  5963 1457 24.4  23.4  25.5
2           Kategoria             pościel  9168  593  6.5   6.0   7.0
3           Kategoria kołdra lub poduszka  4869  395  8.1   7.4   8.9
4               Zwrot          bez zwrotu 18518 2358 12.7  12.3  13.2
5               Zwrot               zwrot  1482   87  5.9   4.8   7.2
6        Czas dostawy             1–3 dni 13191 1142  8.7   8.2   9.1
7        Czas dostawy             4–6 dni  5407  952 17.6  16.6  18.6
8        Czas dostawy              7+ dni  1402  351 25.0  22.8  27.4
9  Wartość zamówienia      do 25. centyla  5022  291  5.8   5.2   6.5
10 Wartość zamówienia      25.–50. centyl  4997  349  7.0   6.3   7.7
11 Wartość zamówienia      50.–75. centyl  4982  537 10.8   9.9  11.7
12 Wartość zamówienia powyżej 75. centyla  4999 1268 25.4  24.2  26.6
                           zmienna   OR dolna gorna        p
1             materac (vs pościel) 2.19  1.75  2.75 1.24e-11
2 kołdra lub poduszka (vs pościel) 1.15  1.00  1.31 4.89e-02
3                       wartość ×2 1.30  1.22  1.39 1.38e-14
4                            zwrot 0.27  0.22  0.34 3.50e-29
5                 dostawa +1 dzień 1.03  1.01  1.06 1.16e-02
      AUC     p_min p_mediana     p_max
    0.707     0.010     0.079     0.420
3. Wagi IPW, kalibracja i ich koszt (Rysunek 3)
R
# Rysunek 3. Wagi: odwrotność skłonności do odpowiedzi (IPW) i kalibracja do sum z CRM; zbalansowanie i rozkład wag
# Korzysta z obiektów przepisów 1–2: crm (z kolumną p_odp), N, kol, motyw. Nie losuje.
library(ggplot2)
library(patchwork)
library(survey)

resp <- crm[crm$odpowiedz == 1, ]
n <- nrow(resp)
resp$w_brak <- N / n                                   # bez korekty: każdy respondent „za” N/n klientów
resp$w_ipw <- 1 / resp$p_odp                           # IPW: odwrotność przewidywanej skłonności do odpowiedzi

# Kalibracja (raking) do sum z CRM (liczba klientów w kategoriach, zwroty, grupy dostawy, łączna wartość)
X_pop <- model.matrix(~ kategoria + zwrot + dostawa + wartosc, data = crm)
sumy <- colSums(X_pop)
projekt_brak <- svydesign(ids = ~1, weights = ~w_brak, data = resp)
projekt_ipw  <- svydesign(ids = ~1, weights = ~w_ipw, data = resp)
projekt_kal  <- calibrate(projekt_brak, ~ kategoria + zwrot + dostawa + wartosc, population = sumy, calfun = "raking")
projekt_ipwk <- calibrate(projekt_ipw,  ~ kategoria + zwrot + dostawa + wartosc, population = sumy, calfun = "raking")
resp$w_kal <- weights(projekt_kal); resp$w_ipwk <- weights(projekt_ipwk)

# Diagnostyka wag: suma, zakres, efekt ważenia Kisha (1 + CV²) i efektywna liczebność
diag_wag <- function(w) c(suma = sum(w), min = min(w), mediana = median(w), max = max(w),
                          max_do_min = max(w) / min(w), deff_kish = length(w) * sum(w^2) / sum(w)^2,
                          n_ef = sum(w)^2 / sum(w^2))
round(sapply(resp[, c("w_ipw", "w_kal", "w_ipwk")], diag_wag), 2)

# Zbalansowanie: struktura respondentów bez wag i z wagami wobec wszystkich klientów z CRM
cechy <- function(d, w = rep(1, nrow(d))) c(
  "materac (%)" = 100 * weighted.mean(d$kategoria == "materac", w),
  "zwrot (%)" = 100 * weighted.mean(d$zwrot, w),
  "dostawa 7+ dni (%)" = 100 * weighted.mean(d$dni_dostawy >= 7, w),
  "średnia wartość (zł)" = weighted.mean(d$wartosc, w))
bal <- rbind("wszyscy klienci (CRM)" = cechy(crm), "respondenci bez wag" = cechy(resp),
             "respondenci, wagi IPW" = cechy(resp, resp$w_ipw), "respondenci, kalibracja" = cechy(resp, resp$w_kal),
             "respondenci, IPW + kalibracja" = cechy(resp, resp$w_ipwk))
round(bal, 2)

# Rysunek 3A: struktura w czterech cechach (CRM = linia odniesienia)
dl <- data.frame(wersja = rep(rownames(bal)[2:4], times = 4), cecha = rep(colnames(bal), each = 3),
                 wartosc = c(bal[2:4, ]), crm = rep(bal[1, ], each = 3))
dl$cecha <- factor(dl$cecha, levels = colnames(bal))
dl$wersja <- factor(dl$wersja, levels = rownames(bal)[2:4], labels = c("bez wag", "wagi IPW", "kalibracja"))
pA <- ggplot(dl, aes(wartosc, wersja, colour = wersja, shape = wersja)) +
  geom_vline(aes(xintercept = crm), colour = "grey30", linetype = "22") +
  geom_point(size = 3) +
  geom_text(aes(label = ifelse(cecha == "średnia wartość (zł)", sprintf("%.0f", wartosc), sprintf("%.1f", wartosc))),
            nudge_y = 0.38, size = 3.1, show.legend = FALSE) +
  facet_wrap(~ cecha, scales = "free_x", ncol = 2) +
  scale_colour_manual(values = c("bez wag" = kol[["cynober"]], "wagi IPW" = kol[["niebieski"]], "kalibracja" = kol[["zielony"]]), name = NULL) +
  scale_shape_manual(values = c("bez wag" = 16, "wagi IPW" = 17, "kalibracja" = 15), name = NULL) +
  scale_x_continuous(expand = expansion(mult = 0.25)) +
  labs(x = "Respondenci (linia = wszyscy klienci z CRM)", y = NULL,
       title = "A. Czy respondenci wyglądają jak klienci?") + motyw + theme(axis.text.y = element_blank())
# Rysunek 3B: rozkład wag IPW (skala log) z efektem ważenia
dk <- diag_wag(resp$w_ipw)
pB <- ggplot(resp, aes(w_ipw)) +
  geom_histogram(bins = 40, fill = kol[["niebieski"]], colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = N / n, colour = kol[["cynober"]], linetype = "22") +
  annotate("text", x = N / n * 1.08, y = Inf, vjust = 1.5, hjust = 0, size = 3.3, colour = kol[["cynober"]],
           label = sprintf("N/n = %.1f", N / n)) +
  annotate("text", x = max(resp$w_ipw), y = Inf, vjust = 3.2, hjust = 1, size = 3.3,
           label = sprintf("deff Kisha = %.2f\nn ef = %.0f z %d", dk[["deff_kish"]], dk[["n_ef"]], n)) +
  scale_x_log10() +
  labs(x = "Waga IPW = 1 / P (skala log)", y = "Liczba respondentów", title = "B. Rozkład wag IPW") + motyw
p3 <- pA + pB + plot_layout(widths = c(1.35, 1)) & theme(legend.position = "bottom")
p3   # zapis: ggsave("ankieta-po-zakupie-wagi-zbalansowanie.svg", p3, width = 10, height = 5.8)
Wynik w R
              w_ipw    w_kal   w_ipwk
suma       19911.31 20000.00 20000.00
min            2.53     0.76     2.16
mediana        4.35     4.55     4.45
max           56.24    51.63    62.66
max_do_min    22.25    68.18    29.02
deff_kish      1.50     1.50     1.54
n_ef        1626.22  1632.43  1592.74
                              materac (%) zwrot (%) dostawa 7+ dni (%)
wszyscy klienci (CRM)               29.82      7.41               7.01
respondenci bez wag                 59.59      3.56              14.36
respondenci, wagi IPW               29.88      6.85               7.40
respondenci, kalibracja             29.82      7.41               7.01
respondenci, IPW + kalibracja       29.82      7.41               7.01
                              średnia wartość (zł)
wszyscy klienci (CRM)                       845.07
respondenci bez wag                        1452.60
respondenci, wagi IPW                       851.99
respondenci, kalibracja                     845.07
respondenci, IPW + kalibracja               845.07
4. Średnia satysfakcja i odsetek zadowolonych z przedziałami (Rysunek 4)
R
# Rysunek 4. Średnia satysfakcja i odsetek zadowolonych: bez wag, z wagami IPW, po kalibracji – wobec prawdy z symulacji
# Korzysta z obiektów przepisów 1–3: satysfakcja (prawda dla wszystkich), resp, projekty survey, kol, motyw. Nie losuje.
library(ggplot2)
library(patchwork)
library(survey)

resp$zadowolony <- as.numeric(resp$satysfakcja >= 4)
projekty <- list("bez wag" = svydesign(ids = ~1, weights = ~w_brak, data = resp),
                 "wagi IPW" = update(projekt_ipw, zadowolony = as.numeric(satysfakcja >= 4)),
                 "kalibracja" = update(projekt_kal, zadowolony = as.numeric(satysfakcja >= 4)),
                 "IPW + kalibracja" = update(projekt_ipwk, zadowolony = as.numeric(satysfakcja >= 4)))
prawda_m <- mean(satysfakcja); prawda_z <- 100 * mean(satysfakcja >= 4)
oszacuj <- function(nazwa, d) {
  m <- svymean(~ satysfakcja + zadowolony, d, deff = "replace")   # deff względem prostej próby losowej ze zwracaniem
  ci <- confint(m)
  data.frame(wersja = nazwa, miara = c("średnia satysfakcja (1–5)", "zadowoleni: ocena 4–5 (%)"),
             wynik = coef(m) * c(1, 100), se = SE(m) * c(1, 100), dolna = ci[, 1] * c(1, 100), gorna = ci[, 2] * c(1, 100),
             deff = deff(m), prawda = c(prawda_m, prawda_z), row.names = NULL)
}
wyniki <- do.call(rbind, Map(oszacuj, names(projekty), projekty))
wyniki$obciazenie <- wyniki$wynik - wyniki$prawda
wyniki$n_ef <- nrow(resp) / wyniki$deff
transform(wyniki, wynik = round(wynik, 3), se = round(se, 3), dolna = round(dolna, 3), gorna = round(gorna, 3),
          deff = round(deff, 2), prawda = round(prawda, 3), obciazenie = round(obciazenie, 3), n_ef = round(n_ef))

# Satysfakcja w kategoriach (domeny): bez wag i po IPW + kalibracji
round(cbind(prawda = tapply(satysfakcja, crm$kategoria, mean),
            bez_wag = svyby(~satysfakcja, ~kategoria, projekty[["bez wag"]], svymean)[, 2],
            ipw_kalibracja = svyby(~satysfakcja, ~kategoria, projekty[["IPW + kalibracja"]], svymean)[, 2]), 3)

# Rysunek 4: oszacowania z 95% CI wobec prawdy (linia przerywana)
wyniki$wersja <- factor(wyniki$wersja, levels = rev(names(projekty)))
p4 <- ggplot(wyniki, aes(wynik, wersja, colour = wersja == "bez wag", shape = wersja == "bez wag")) +
  geom_vline(aes(xintercept = prawda), colour = "grey25", linetype = "22") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.22, orientation = "y") +
  geom_point(size = 3) +
  geom_text(aes(label = sprintf("%.2f\ndeff %.2f", wynik, deff)), nudge_y = 0.42, size = 3.1, lineheight = 0.85,
            colour = "grey15") +
  facet_wrap(~ miara, scales = "free_x") +
  scale_colour_manual(values = c("TRUE" = kol[["cynober"]], "FALSE" = kol[["niebieski"]]), guide = "none") +
  scale_shape_manual(values = c("TRUE" = 16, "FALSE" = 17), guide = "none") +
  scale_x_continuous(expand = expansion(mult = 0.15)) +
  labs(x = "Oszacowanie z 95% CI (linia przerywana = prawda dla 20 000 klientów)", y = NULL,
       title = "Ankieta bez wag zawyża satysfakcję; wagi z CRM usuwają większość obciążenia") + motyw
p4   # zapis: ggsave("ankieta-po-zakupie-oszacowania.svg", p4, width = 10, height = 5)
Wynik w R
                             wersja                     miara  wynik    se
bez wag.1                   bez wag średnia satysfakcja (1–5)  3.769 0.019
bez wag.2                   bez wag zadowoleni: ocena 4–5 (%) 63.313 0.975
wagi IPW.1                 wagi IPW średnia satysfakcja (1–5)  3.669 0.024
wagi IPW.2                 wagi IPW zadowoleni: ocena 4–5 (%) 58.897 1.244
kalibracja.1             kalibracja średnia satysfakcja (1–5)  3.663 0.022
kalibracja.2             kalibracja zadowoleni: ocena 4–5 (%) 58.711 1.129
IPW + kalibracja.1 IPW + kalibracja średnia satysfakcja (1–5)  3.664 0.022
IPW + kalibracja.2 IPW + kalibracja zadowoleni: ocena 4–5 (%) 58.685 1.134
                    dolna  gorna deff prawda obciazenie n_ef
bez wag.1           3.732  3.805 1.00  3.644      0.124 2445
bez wag.2          61.402 65.224 1.00 57.850      5.463 2445
wagi IPW.1          3.621  3.716 1.58  3.644      0.024 1545
wagi IPW.2         56.459 61.335 1.56 57.850      1.047 1565
kalibracja.1        3.620  3.706 1.29  3.644      0.019 1889
kalibracja.2       56.497 60.925 1.29 57.850      0.861 1901
IPW + kalibracja.1  3.621  3.706 1.29  3.644      0.019 1898
IPW + kalibracja.2 56.462 60.908 1.30 57.850      0.835 1886
                    prawda bez_wag ipw_kalibracja
materac              3.741   3.838          3.717
pościel              3.604   3.712          3.687
kołdra lub poduszka  3.601   3.597          3.555
5. Symulacja: 1000 ankiet przy MAR i MNAR (Rysunek 5)
R
# Rysunek 5. 1000 powtórzeń ankiety: odpowiedź zależy od CRM (MAR) albo także od samej satysfakcji (MNAR)
# Korzysta z obiektów przepisów 1–3: crm, satysfakcja, logit_odp, X_pop, resp, projekt_kal, kol, motyw.
# Klienci i ich satysfakcja są stali; losujemy tylko, kto odpowie. Losuje – własne ziarno. Liczy się ok. 30 s.
library(ggplot2)
library(survey)

X <- model.matrix(~ kategoria + log(wartosc) + zwrot + dni_dostawy, data = crm)   # model odpowiedzi
eta_mar <- logit_odp(as.character(crm$kategoria), crm$wartosc, crm$zwrot, crm$dni_dostawy)
# Scenariusz MNAR (ustalony ręcznie): każdy punkt satysfakcji powyżej średniej zwiększa logit odpowiedzi o 0.4;
# wyraz wolny przesunięto tak, by średni wskaźnik odpowiedzi był ten sam co w scenariuszu MAR
gamma <- 0.4
przes <- uniroot(function(a) mean(plogis(eta_mar + a + gamma * (satysfakcja - mean(satysfakcja)))) - mean(plogis(eta_mar)),
                 c(-3, 3))$root
eta_mnar <- eta_mar + przes + gamma * (satysfakcja - mean(satysfakcja))
round(c(odp_MAR_proc = 100 * mean(plogis(eta_mar)), odp_MNAR_proc = 100 * mean(plogis(eta_mnar)), przesuniecie = przes), 3)

# Szybki raking (kalibracja wykładnicza metodą Newtona) – to samo co survey::calibrate(calfun = "raking")
raking <- function(d, Xs, sumy, iter = 50) {
  lam <- rep(0, ncol(Xs))
  for (i in seq_len(iter)) {
    w <- d * exp(drop(Xs %*% lam))
    g <- sumy - colSums(w * Xs)
    if (max(abs(g / sumy)) < 1e-10) break
    lam <- lam + solve(crossprod(Xs * w, Xs), g)
  }
  w
}
Xk <- X_pop; Xk[, "wartosc"] <- Xk[, "wartosc"] / 1000          # wartość w tys. zł: te same wagi, stabilniejszy Newton
sumy_k <- colSums(Xk)
c(max_roznica_wag = max(abs(raking(resp$w_brak, Xk[crm$odpowiedz == 1, ], sumy_k) - weights(projekt_kal))))   # sprawdzenie: ≈ 0

# Szybka regresja logistyczna (metoda Newtona) – te same współczynniki co glm()
logit_fit <- function(X, y, iter = 25) {
  b <- c(qlogis(mean(y)), rep(0, ncol(X) - 1))
  for (i in seq_len(iter)) {
    p <- plogis(drop(X %*% b))
    krok <- solve(crossprod(X * (p * (1 - p)), X), crossprod(X, y - p))
    b <- b + drop(krok)
    if (max(abs(krok)) < 1e-8) break
  }
  plogis(drop(X %*% b))
}
c(max_roznica_p = max(abs(logit_fit(X, crm$odpowiedz) - fitted(glm(crm$odpowiedz ~ X - 1, family = binomial)))))   # ≈ 0

jedna_ankieta <- function(eta) {
  r <- rbinom(nrow(crm), 1, plogis(eta)) == 1
  p <- logit_fit(X, as.numeric(r))                                # model odpowiedzi na danych z CRM
  w_ipw <- 1 / p[r]; y <- satysfakcja[r]
  w_kal <- raking(w_ipw, Xk[r, ], sumy_k)                        # IPW + kalibracja do sum z CRM
  c("bez wag" = mean(y), "wagi IPW" = weighted.mean(y, w_ipw), "IPW + kalibracja" = weighted.mean(y, w_kal),
    deff_kish = sum(r) * sum(w_kal^2) / sum(w_kal)^2, n = sum(r))
}
# Inne ziarno niż w przepisie 1: ziarno 682 powtórzyłoby te same liczby losowe, którymi losowano kategorie
# zamówień, i odpowiedź byłaby sztucznie związana z kategorią
set.seed(2682)
sym <- list(MAR = t(replicate(1000, jedna_ankieta(eta_mar))), MNAR = t(replicate(1000, jedna_ankieta(eta_mnar))))
prawda <- mean(satysfakcja)
podsum <- do.call(rbind, lapply(names(sym), function(s) {
  m <- sym[[s]]
  do.call(rbind, lapply(c("bez wag", "wagi IPW", "IPW + kalibracja"), function(k) data.frame(
    scenariusz = s, metoda = k, srednia = mean(m[, k]), obciazenie = mean(m[, k]) - prawda,
    blad_mc = sd(m[, k]) / sqrt(nrow(m)), sd = sd(m[, k]), rmse = sqrt(mean((m[, k] - prawda)^2)))))
}))
transform(podsum, srednia = round(srednia, 3), obciazenie = round(obciazenie, 3), blad_mc = round(blad_mc, 4),
          sd = round(sd, 3), rmse = round(rmse, 3))
round(sapply(sym, function(m) c(sr_n = mean(m[, "n"]), sr_deff_kish = mean(m[, "deff_kish"]))), 2)

# Rysunek 5: rozkład oszacowań średniej satysfakcji w 1000 ankietach
dl <- do.call(rbind, lapply(names(sym), function(s) data.frame(
  scenariusz = s, metoda = rep(c("bez wag", "wagi IPW", "IPW + kalibracja"), each = 1000),
  wynik = c(sym[[s]][, "bez wag"], sym[[s]][, "wagi IPW"], sym[[s]][, "IPW + kalibracja"]))))
dl$scenariusz <- factor(dl$scenariusz, levels = c("MAR", "MNAR"),
                        labels = c("Odpowiedź zależy tylko od danych z CRM (MAR)", "Odpowiedź zależy też od satysfakcji (MNAR)"))
dl$metoda <- factor(dl$metoda, levels = c("bez wag", "wagi IPW", "IPW + kalibracja"))
p5 <- ggplot(dl, aes(wynik, fill = metoda, colour = metoda, linetype = metoda)) +
  geom_vline(xintercept = prawda, colour = "grey15", linewidth = 0.6) +
  geom_density(alpha = 0.25, linewidth = 0.7, adjust = 1.2) +
  annotate("text", x = prawda, y = Inf, vjust = 1.4, hjust = 1.05, size = 3.3, label = sprintf("prawda %.2f", prawda)) +
  facet_wrap(~ scenariusz, ncol = 1) +
  scale_fill_manual(values = c("bez wag" = kol[["cynober"]], "wagi IPW" = kol[["niebieski"]], "IPW + kalibracja" = kol[["zielony"]]), name = NULL) +
  scale_colour_manual(values = c("bez wag" = kol[["cynober"]], "wagi IPW" = kol[["niebieski"]], "IPW + kalibracja" = kol[["zielony"]]), name = NULL) +
  scale_linetype_manual(values = c("bez wag" = "solid", "wagi IPW" = "22", "IPW + kalibracja" = "42"), name = NULL) +
  labs(x = "Średnia satysfakcja z ankiety (1000 powtórzeń w każdym scenariuszu)", y = "Gęstość",
       title = "Wagi z CRM pomagają tylko wtedy, gdy CRM wyjaśnia, kto odpowiada") + motyw
p5   # zapis: ggsave("ankieta-po-zakupie-symulacja-mar-mnar.svg", p5, width = 10, height = 6)
Wynik w R
 odp_MAR_proc odp_MNAR_proc  przesuniecie
       11.880        11.880        -0.091
max_roznica_wag
   1.004109e-08
max_roznica_p
 1.185393e-09
  scenariusz           metoda srednia obciazenie blad_mc    sd  rmse
1        MAR          bez wag   3.773      0.129   6e-04 0.018 0.130
2        MAR         wagi IPW   3.645      0.001   8e-04 0.024 0.024
3        MAR IPW + kalibracja   3.645      0.000   7e-04 0.023 0.023
4       MNAR          bez wag   4.044      0.400   5e-04 0.017 0.400
5       MNAR         wagi IPW   3.920      0.275   9e-04 0.027 0.277
6       MNAR IPW + kalibracja   3.919      0.274   8e-04 0.024 0.276
                 MAR    MNAR
sr_n         2375.69 2375.23
sr_deff_kish    1.58    1.80
6. Grafika: od wszystkich klientów do odpowiadających (Rysunek 1)
R
# Rysunek 1. Grafika: wszyscy klienci z CRM → odpowiadający → wagi. Liczby z obiektów przepisów 1–4: crm, resp, wyniki.
# Nie losuje (pozycje „kwadratów respondentów” są ustalone wzorem, nie losowaniem).
library(ggplot2)

n_kw <- 200                                                        # 1 kwadrat = 100 zamówień
kw <- data.frame(id = 1:n_kw, x = 0.45 + ((1:n_kw - 1) %% 20) * 0.215, y = 6.05 - ((1:n_kw - 1) %/% 20) * 0.245)
ile_odp <- round(n_kw * mean(crm$odpowiedz))
kw$odp <- kw$id %in% round(seq(4, n_kw - 3, length.out = ile_odp))
proc <- function(x) sprintf("%.1f%%", 100 * mean(x))
tab <- data.frame(y = c(5.55, 5.05, 4.55, 4.05, 3.55),
                  cecha = c("materac", "mediana wartości", "dostawa 7+ dni", "zwrot towaru", "satysfakcja (1–5)"),
                  wszyscy = c(proc(crm$kategoria == "materac"), sprintf("%.0f zł", median(crm$wartosc)),
                              proc(crm$dni_dostawy >= 7), proc(crm$zwrot), "nie wiemy"),
                  odp = c(proc(resp$kategoria == "materac"), sprintf("%.0f zł", median(resp$wartosc)),
                          proc(resp$dni_dostawy >= 7), proc(resp$zwrot), sprintf("średnia %.2f", mean(resp$satysfakcja))))
kroki <- data.frame(x = c(1.25, 3.75, 6.25, 8.75),
                    tytul = c("1. Model odpowiedzi", "2. Waga IPW", "3. Kalibracja", "4. Wynik ważony"),
                    tekst = c("regresja logistyczna:\nP(odpowiedź | kategoria,\nwartość, zwrot, dostawa)",
                              "waga = 1 / P(odpowiedź)\nrzadko odpowiadający\nliczą się bardziej",
                              "wagi poprawione tak, by\nsumy zgadzały się z CRM\n(kategoria, zwrot, dostawa, wartość)",
                              sprintf("średnia %.2f zamiast %.2f\ndeff %.2f: %d ankiet działa\njak ok. %d",
                                      wyniki$wynik[wyniki$wersja == "IPW + kalibracja"][1], wyniki$wynik[wyniki$wersja == "bez wag"][1],
                                      wyniki$deff[wyniki$wersja == "IPW + kalibracja"][1], nrow(resp),
                                      round(wyniki$n_ef[wyniki$wersja == "IPW + kalibracja"][1]))))
p1 <- ggplot() +
  annotate("text", x = 0.3, y = 6.65, hjust = 0, fontface = "bold", size = 4.2, colour = "#0f1d3a",
           label = sprintf("Wszyscy klienci w CRM: %s zamówień", format(nrow(crm), big.mark = " "))) +
  geom_tile(data = kw, aes(x, y, fill = odp), width = 0.17, height = 0.19, colour = NA) +
  scale_fill_manual(values = c("TRUE" = "#0072B2", "FALSE" = "grey82"), guide = "none") +
  annotate("text", x = 0.3, y = 3.55, hjust = 0, size = 3.4, colour = "grey20",
           label = sprintf("1 kwadrat = 100 zamówień; niebieskie = odpowiedzieli\n(%d osób, %.1f%%), szare = brak odpowiedzi",
                           nrow(resp), 100 * mean(crm$odpowiedz))) +
  annotate("segment", x = 4.85, xend = 5.35, y = 4.8, yend = 4.8, arrow = arrow(length = unit(0.25, "cm"), type = "closed"),
           colour = "grey35", linewidth = 0.8) +
  annotate("text", x = 7.65, y = 6.65, fontface = "bold", size = 4.2, colour = "#0f1d3a", label = "Co wiemy o kim") +
  annotate("text", x = c(6.35, 8.15, 9.35), y = 6.12, label = c("cecha z CRM", "wszyscy", "odpowiedzieli"),
           fontface = "bold", size = 3.4, colour = "grey20") +
  geom_tile(data = tab, aes(x = 7.65, y = y), width = 4.7, height = 0.44, fill = c("#F2F2F2", "white", "#F2F2F2", "white", "#FBE3D3")) +
  geom_text(data = tab, aes(x = 5.45, y = y, label = cecha), hjust = 0, size = 3.4) +
  geom_text(data = tab, aes(x = 8.15, y = y, label = wszyscy), size = 3.4) +
  geom_text(data = tab, aes(x = 9.35, y = y, label = odp), size = 3.4, fontface = "bold", colour = "#0072B2") +
  annotate("text", x = 7.65, y = 3.05, size = 3.3, colour = "grey25",
           label = "Cechy z CRM znamy u wszystkich – to z nich budujemy wagi.") +
  geom_tile(data = kroki, aes(x = x, y = 1.55), width = 2.3, height = 1.65, fill = "#DCEEF8", colour = "grey45", linewidth = 0.35) +
  geom_text(data = kroki, aes(x = x, y = 2.12, label = tytul), fontface = "bold", size = 3.6, colour = "#0f1d3a") +
  geom_text(data = kroki, aes(x = x, y = 1.35, label = tekst), size = 3.1, lineheight = 0.95) +
  annotate("segment", x = c(2.42, 4.92, 7.42), xend = c(2.58, 5.08, 7.58), y = 1.55, yend = 1.55,
           arrow = arrow(length = unit(0.2, "cm"), type = "closed"), colour = "grey35") +
  annotate("text", x = 0.15, y = 0.38, hjust = 0, size = 3.3, colour = "#D55E00", fontface = "bold",
           label = "Wagi naprawiają tylko to, co tłumaczy CRM. Jeśli odpowiadają częściej zadowoleni z tych samych grup, obciążenie zostaje.") +
  coord_cartesian(xlim = c(0.1, 10.05), ylim = c(0.2, 6.9), expand = FALSE) +
  labs(title = "Ankieta po zakupie: od wszystkich klientów do odpowiadających i z powrotem") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 6)),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 12, 8, 10))
p1   # zapis: ggsave("ankieta-po-zakupie-schemat.svg", p1, width = 10, height = 6.6)
7. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – niebieski (bez wag / z wagami)" = c("#D55E00", "#0072B2"),
             "niebieski – zielony (IPW / kalibracja)" = c("#0072B2", "#009E73"),
             "cynober – zielony (bez wag / kalibracja)" = c("#D55E00", "#009E73"),
             "niebieski – jasnoszary (odpowiedzieli / nie)" = c("#0072B2", "#D1D1D1"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                             widzenie_typowe deuteranopia
cynober – niebieski (bez wag / z wagami)               114.6        108.3
niebieski – zielony (IPW / kalibracja)                  70.1         55.4
cynober – zielony (bez wag / kalibracja)               102.4         53.5
niebieski – jasnoszary (odpowiedzieli / nie)            56.2         60.1
czerwony – zielony (do unikania)                       121.7         21.1
                                             protanopia
cynober – niebieski (bez wag / z wagami)           91.9
niebieski – zielony (IPW / kalibracja)             58.0
cynober – zielony (bez wag / kalibracja)           37.3
niebieski – jasnoszary (odpowiedzieli / nie)       51.4
czerwony – zielony (do unikania)                   31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, regresja logistyczna, przedziały Wilsona – pakiety base i stats; wagi, kalibracja, średnie ważone i ich błędy standardowe – pakiet survey). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survey (wersja 4.5): Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8), 1–19. https://doi.org/10.18637/jss.v009.i08
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- „Mamy 2445 ankiet, więc wynik jest pewny”. Duża próba zwęża przedział wokół wartości obciążonej; bez wag przedział [3.732, 3.805] nie objął prawdy 3.644.
- Odsetki odpowiedzi w grupach czytane jak efekty. Długa dostawa „zwiększała” odpowiedź do 25.0%, a w modelu wpływ był minimalny (OR = 1.03 na dzień).
- Ważenie zmiennymi niezwiązanymi z satysfakcją. Tylko podnosi deff i nic nie poprawia; wybieraj cechy, które tłumaczą i odpowiedź, i ocenę.
- Zbyt duże wagi bez kontroli. Sprawdź największą wagę i efektywną liczebność; przycięcie wag zmniejsza wariancję kosztem niewielkiego obciążenia.
Najczęstsze pytania
Jaki wskaźnik odpowiedzi w ankiecie satysfakcji klientów jest wystarczający?
Nie ma progu, który gwarantuje brak obciążenia. Groves (2006) pokazuje, że brak odpowiedzi może, ale nie musi wywoływać obciążenia – decyduje to, czy odpowiadający różnią się od milczących. W przykładzie 12.2% odpowiedzi dało zawyżenie średniej o 0.124 punktu, bo odpowiadali głównie kupujący materace, bardziej zadowoleni.
Jak sprawdzić, czy respondenci ankiety po zakupie różnią się od klientów?
Porównaj strukturę respondentów i wszystkich klientów w danych z CRM (kategoria, wartość, zwroty, dostawa) i dopasuj regresję logistyczną odpowiedzi. W przykładzie materace stanowiły 59.6% respondentów i 29.8% klientów, a zwrot obniżał szansę odpowiedzi (OR = 0.27).
Czym różni się ważenie IPW od kalibracji (rakingu)?
Wagi IPW to odwrotność przewidywanego prawdopodobieństwa odpowiedzi z modelu. Kalibracja poprawia wagi tak, by ważone sumy zgadzały się ze znanymi sumami populacyjnymi (Deville i Särndal, 1992), bez modelu odpowiedzi. Można je łączyć: najpierw IPW, potem kalibracja – w przykładzie dało to średnią 3.664 przy prawdzie 3.644.
Ile precyzji kosztuje ważenie ankiety?
Koszt opisuje efekt schematu (deff): wariancja rośnie deff razy, a efektywna liczebność to n/deff. Sama nierówność wag dała tu deff Kisha 1.50, czyli 2445 ankiet działało jak 1626. Kalibracja do zmiennych związanych z satysfakcją obniżyła deff średniej do 1.29.
Czy ważenie usuwa błąd, gdy na ankietę odpowiadają głównie zadowoleni klienci?
Tylko w części, która idzie przez zmienne użyte do ważenia. W symulacji, w której odpowiedź zależała też od samej satysfakcji, wagi z CRM zmniejszyły obciążenie z 0.400 do 0.274 punktu. Tego założenia nie sprawdzisz na respondentach – potrzebne są dane od części milczących albo analiza wrażliwości.
Powiązane hasła
Przeczytaj też
Ważenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →PoradnikDeklaracja zakupu a faktyczny zakup
Catering dietetyczny: top-2-box, wykres kalibracji, konwersje deklaracji w segmentach i prognoza sprzedaży z bootstrapem – pięć rysunków z kodem R.
Czytaj →PoradnikStatystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →Analizujesz ankietę klientów w pracy z marketingu?
Pomożemy sprawdzić, kto odpowiedział, zbudować wagi z danych o klientach, policzyć wyniki z przedziałami i opisać ograniczenia tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Deville, J.-C., & Särndal, C.-E. (1992). Calibration estimators in survey sampling. Journal of the American Statistical Association, 87(418), 376–382. https://doi.org/10.1080/01621459.1992.10475217
- Groves, R. M. (2006). Nonresponse rates and nonresponse bias in household surveys. Public Opinion Quarterly, 70(5), 646–675. https://doi.org/10.1093/poq/nfl033
- Groves, R. M., & Peytcheva, E. (2008). The impact of nonresponse rates on nonresponse bias: A meta-analysis. Public Opinion Quarterly, 72(2), 167–189. https://doi.org/10.1093/poq/nfn011 ● Otwarty dostęp: pełny tekst
- Groves, R. M., Presser, S., & Dipko, S. (2004). The role of topic interest in survey participation decisions. Public Opinion Quarterly, 68(1), 2–31. https://doi.org/10.1093/poq/nfh002
- Haziza, D., & Beaumont, J.-F. (2017). Construction of weights in surveys: A review. Statistical Science, 32(2), 206–226. https://doi.org/10.1214/16-sts608
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08 ● Otwarty dostęp
- Seaman, S. R., & White, I. R. (2013). Review of inverse probability weighting for dealing with missing data. Statistical Methods in Medical Research, 22(3), 278–295. https://doi.org/10.1177/0962280210395740
Cytowania BibTeX
@article{deville1992calibration, author={Deville, Jean-Claude and Särndal, Carl-Erik}, title={{Calibration estimators in survey sampling}}, journal={Journal of the American Statistical Association}, year={1992}, volume={87}, number={418}, pages={376--382}, doi={10.1080/01621459.1992.10475217}}@article{groves2006nonresponse, author={Groves, Robert M.}, title={{Nonresponse rates and nonresponse bias in household surveys}}, journal={Public Opinion Quarterly}, year={2006}, volume={70}, number={5}, pages={646--675}, doi={10.1093/poq/nfl033}}@article{groves2008impact, author={Groves, R. M. and Peytcheva, E.}, title={{The impact of nonresponse rates on nonresponse bias: A meta-analysis}}, journal={Public Opinion Quarterly}, year={2008}, volume={72}, number={2}, pages={167--189}, doi={10.1093/poq/nfn011}}@article{groves2004role, author={Groves, R. M. and Presser, S. and Dipko, S.}, title={{The role of topic interest in survey participation decisions}}, journal={Public Opinion Quarterly}, year={2004}, volume={68}, number={1}, pages={2--31}, doi={10.1093/poq/nfh002}}@article{haziza2017construction, author={Haziza, David and Beaumont, Jean-François}, title={{Construction of weights in surveys: A review}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={206--226}, doi={10.1214/16-sts608}}@article{lumley2004analysis, author={Lumley, Thomas}, title={{Analysis of complex survey samples}}, journal={Journal of Statistical Software}, year={2004}, volume={9}, number={8}, doi={10.18637/jss.v009.i08}}@article{seaman2013review, author={Seaman, Shaun R. and White, Ian R.}, title={{Review of inverse probability weighting for dealing with missing data}}, journal={Statistical Methods in Medical Research}, year={2013}, volume={22}, number={3}, pages={278--295}, doi={10.1177/0962280210395740}}