Co właściwie znaczy „próba reprezentatywna”
Słowo „reprezentatywna” ma w pracach dwa różne znaczenia, które łatwo pomylić. Pierwsze dotyczy sposobu doboru: każda osoba z populacji miała znaną, niezerową szansę trafienia do badania, jak w próbie losowej. Drugie dotyczy wyniku doboru: rozkład płci, wieku czy kierunku w próbie zgadza się z rozkładem w populacji. Szerzej oba sensy omawia hasło reprezentatywność próby. Tu pokazujemy na rysunkach, co dzieje się między nimi, gdy część wylosowanych osób odmawia udziału, i co z tym robi ważenie.
Przykład jest fikcyjny, więc znamy prawdę. Uczelnia ma 2000 studentów na czterech wydziałach. Każdy ma wynik na skali stresu akademickiego (0–40 punktów); średnia w populacji wynosi 21.55 (SD = 7.59). Z listy studentów (operatu losowania) losujemy 400 osób i zapraszamy je do ankiety. Porównujemy dwa scenariusze odmów:
- Scenariusz A – chęć udziału zależy tylko od płci i roku studiów: kobiety i starsze roczniki odpowiadają chętniej (od 25% wśród mężczyzn z lat I–II do 75% wśród kobiet z lat III–V).
- Scenariusz B – chęć udziału zależy tylko od poziomu stresu: im wyższy stres, tym rzadziej ktoś odpowiada.
Parametry populacji i odmów ustaliliśmy ręcznie tak, by oba mechanizmy były wyraźne: 60% kobiet, 55% studentów lat III–V, stres wyższy o 4 punkty u kobiet, o 3 na latach III–V i o 3 na wydziale medycznym. Ziarno 586 ustalono raz i nie zmieniano go. Dane pobierzesz jako proba-reprezentatywna-populacja.csv (2000 osób z informacją, kto został zaproszony i kto odpowiedział). Przy każdym rysunku: co widać, czego wykres nie pokazuje, podpis i zdanie do pracy.
Rysunek 1: mapa uczelni – kto odmówił
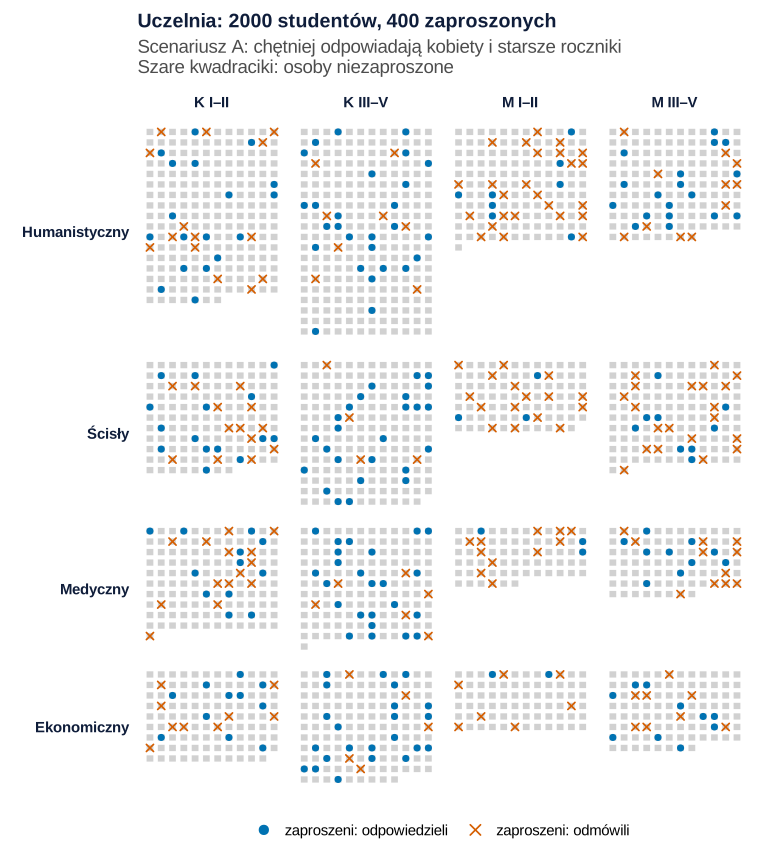
set.seed(586)).Co widać. Losowanie rozrzuciło zaproszenia równomiernie po całej mapie – to jest próba losowa z pełnego operatu. Odmowy już równomierne nie są. Wśród kobiet z lat III–V odpowiedziało 81.1% zaproszonych, wśród mężczyzn z lat I–II – tylko 21.3%. Łącznie odpowiedziało 218 z 400 osób (54.5%), co opisuje wskaźnik odpowiedzi. Wszyscy zaproszeni mieli średni stres 21.65, czyli prawie tyle, co populacja. Ci, którzy odpowiedzieli, mieli 22.56. W scenariuszu B odpowiedziało 187 osób, a ich średnia wyniosła 18.31.
Czego ten wykres nie pokazuje. Mapa scenariusza B wyglądałaby prawie tak samo jak przypadkowa: odsetki odpowiedzi w czterech kolumnach wynoszą od 36.1% do 53.3%. Odmowy zależą tam od cechy, której na mapie nie ma, bo nie znamy jej u osób, które odmówiły. Dobry operat i losowanie nie chronią przed obciążeniem, które wnoszą odmowy. Ten mechanizm opisuje hasło błąd braku odpowiedzi, a schematy samego losowania – wpis schematy losowania w obrazkach.
Podpis do pracy (np. w aneksie albo na obronę):
Zdanie do Metody:
Rysunek 2: zgodna struktura to nie trafny wynik
Zwykle pierwsze, co student robi z próbą, to tabela „próba a populacja”. Zestawmy ją ze średnim stresem.
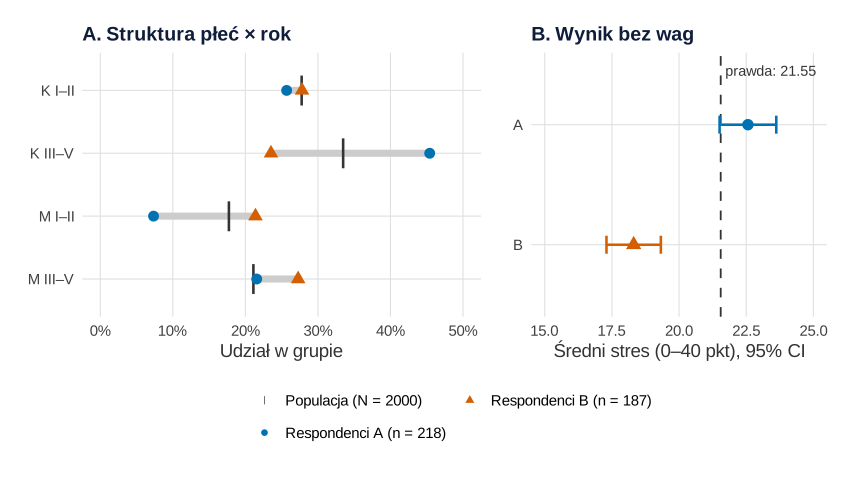
Co widać. Respondenci A mają strukturę wyraźnie skrzywioną: kobiety z lat III–V stanowią 45.41% zamiast 33.45%, a mężczyźni z lat I–II 7.34% zamiast 17.70%. Respondenci B są strukturalnie bliżej populacji. Wskaźnik niepodobieństwa (jaki odsetek próby trzeba by przesunąć między grupami, żeby struktura była zgodna) wynosi 12.4% dla A i 9.9% dla B. Na panelu B jest odwrotnie. Średnia A (22.56, 95% CI [21.51, 23.62]) jest zawyżona o 1.01 punktu, a przedział jeszcze obejmuje prawdę. Średnia B (18.31, 95% CI [17.30, 19.32]) jest zaniżona o 3.24 punktu.
Czego ten wykres nie pokazuje. Tabela struktury mówi tylko o cechach, które w niej są. O obciążeniu decyduje to, czy odmowy wiążą się z mierzoną cechą, a tej u osób, które odmówiły, nie znamy. Groves (2006) zwraca uwagę, że brak odpowiedzi może, ale nie musi wywołać obciążenia. W metaanalizie 59 badań Groves i Peytcheva (2008) sprawdzali, w jakich okolicznościach odsetek braku odpowiedzi wiąże się z obciążeniem, a w jakich nie. Pełny obraz daje dopiero rysunek 3.
Podpis do pracy:
Zdanie do Metody (ostrożne, bez słowa „reprezentatywna”):
Rysunek 3: 1000 badań przed ważeniem i po nim
Powtarzamy to samo badanie 1000 razy: losujemy 400 osób, część odmawia według scenariusza A albo B, a średnią liczymy bez wag i z wagami poststratyfikacyjnymi w czterech grupach płeć × rok. Dla porównania liczymy też średnią ze wszystkich 400 zaproszonych, jakby nikt nie odmówił. Środek każdego histogramu pokazuje obciążenie, a jego szerokość – precyzję.
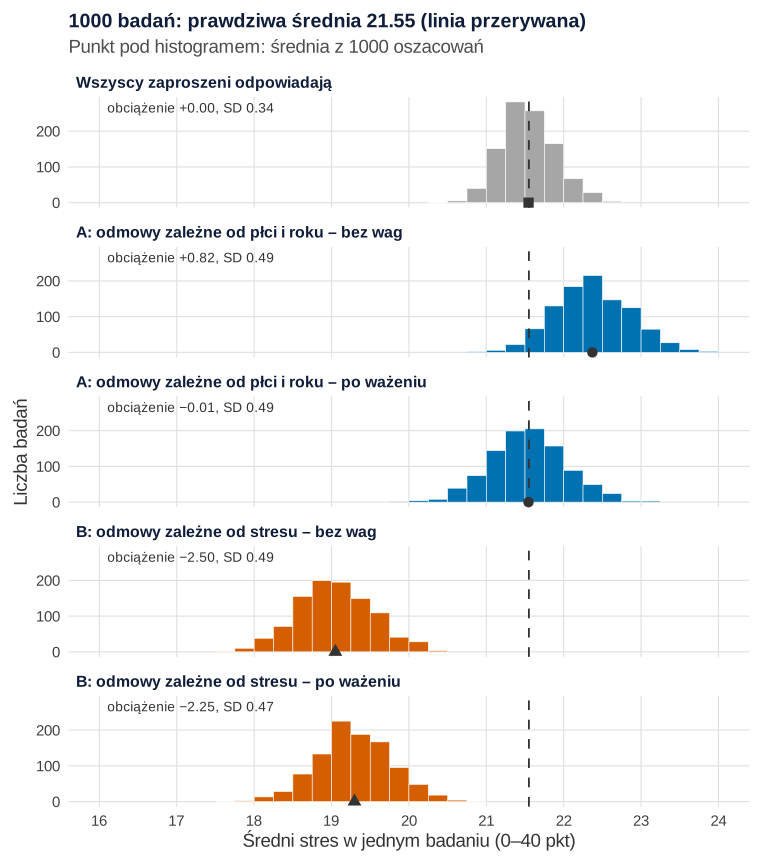
set.seed(586)).Co widać. Bez odmów średnie skupiają się wokół prawdy (obciążenie 0.00, SD = 0.34). W scenariuszu A średnia bez wag jest zawyżona średnio o 0.82 punktu, a po ważeniu obciążenie znika (−0.01). W scenariuszu B ważenie prawie nic nie daje: obciążenie maleje tylko z −2.50 do −2.25. Liczy się też przedział ufności. W A bez wag 95% CI objął prawdę w 62.0% badań, po ważeniu – w 94.4%. W B objął ją w 0.0% badań bez wag i w 0.2% po ważeniu. Błąd Monte Carlo odsetka bliskiego 95% wynosi przy 1000 powtórzeń 0.7 punktu procentowego.
Czego ten wykres nie pokazuje. W prawdziwym badaniu nie wiesz, w którym scenariuszu jesteś. Masz jedną próbę i porównanie struktury, które – jak na rysunku 2 – może wyglądać lepiej w gorszym scenariuszu. Histogramy z odmowami są też szersze niż szary (SD około 0.49 wobec 0.34), bo odpowiada około połowy zaproszonych. Zauważ, że obciążenie nie maleje z liczebnością – większa próba zwęziłaby niebieskie i pomarańczowe histogramy, ale nie przesunęłaby ich środka. Wątek dużych prób z niewielkim obciążeniem rozwija wpis sondaż w obrazkach.
Podpis do pracy (np. w rozdziale teoretycznym albo na obronę):
Zdanie do Dyskusji:
Rysunek 4: wagi, raking i koszt ważenia
Wróćmy do jednej próby ze scenariusza A (218 respondentów). Waga poststratyfikacyjna to iloraz udziału grupy w populacji i jej udziału w próbie. Wagi liczymy pakietem survey do analizy złożonych prób (Lumley, 2004), który szacuje też błąd standardowy z uwzględnieniem wag. Raking robimy w drugim wariancie: znamy tylko osobne rozkłady płci, roku i wydziału, bez ich krzyżowania. Raking koryguje wagi po kolei dla każdej zmiennej, aż wszystkie rozkłady brzegowe zgadzają się z populacją (Battaglia i in., 2009). Więcej o samej metodzie – w haśle raking.
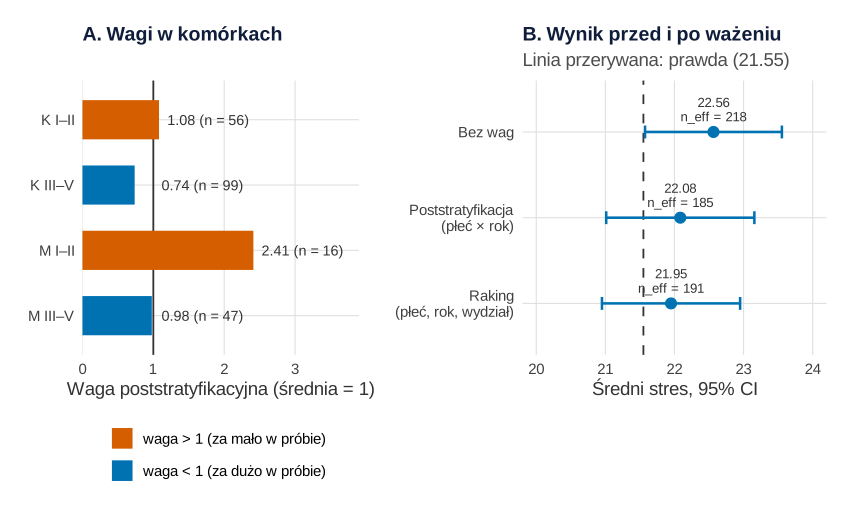
Co widać. Każdy z 16 mężczyzn z lat I–II waży 2.41, a każda z 99 kobiet z lat III–V – 0.74. Po ważeniu struktura płeć × rok zgadza się z populacją co do setnych części procenta. Średnia spada z 22.56 do 22.08 po poststratyfikacji i do 21.95 po rakingu; prawda (21.55) leży we wszystkich trzech przedziałach. Ważenie ma jednak koszt. Efektywna liczebność Kisha, czyli (Σw)² / Σw², wynosi 184.82 zamiast 218. Efekt schematu wynikający z samych wag wynosi 1.18 (1 plus kwadrat współczynnika zmienności wag 0.425). Przedział ufności poszerzył się z 1.98 do 2.14 punktu. Raking ma tu mniej zróżnicowane wagi (neff = 191.40) i przedział o szerokości 2.00.
Czego ten wykres nie pokazuje. Wzór Kisha jest przybliżeniem: zakłada, że wagi nie wiążą się z mierzoną cechą. Tu się wiążą, bo stres różni się między grupami, i poststratyfikacja częściowo to odrabia. W 1000 badaniach neff wynosiło średnio 183.53 przy 216.78 respondentach, a błąd standardowy wzrósł średnio tylko o 2% (stosunek 1.02). Z kolei jedna osoba z wagą 2.41 może mocno przesunąć wynik – dlatego przy bardzo małych komórkach wagi się przycina albo łączy komórki. Pełną procedurę wag (waga schematu, korekta braku odpowiedzi, kalibracja, przycinanie) opisuje wpis ważenie danych sondażowych krok po kroku (Haziza i Beaumont, 2017). Pojęcie efektywnej liczebności przy schematach zespołowych omawia hasło efekt schematu.
Podpis do pracy:
Zdanie do Metody i Wyników:
Rysunek 5: kiedy ważenie pomaga, a kiedy szkodzi
Scenariusze A i B to dwa krańce; w praktyce działają oba mechanizmy naraz. Zaczynamy od scenariusza A i dokładamy zależność od stresu o sile gamma (od 0 do 1 w skali logitu na jedno odchylenie standardowe stresu). Dla każdej wartości gamma – 1000 badań.
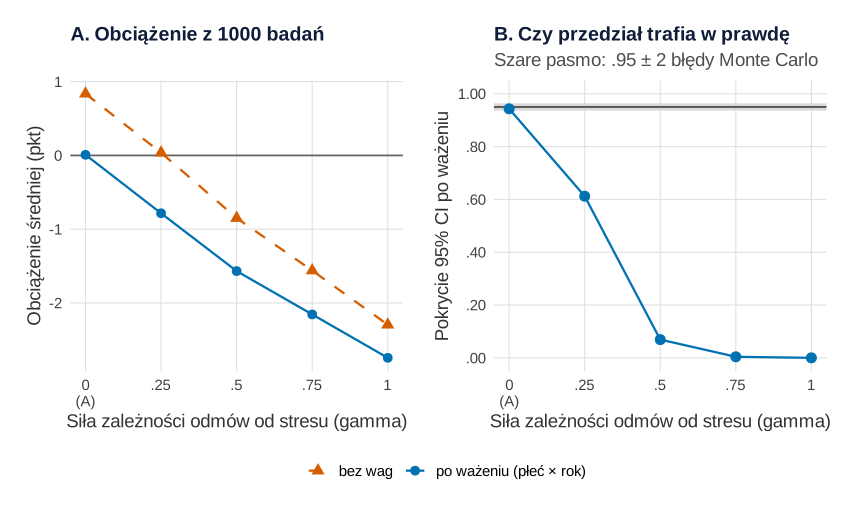
set.seed(586)).Co widać. Przy gamma = 0 ważenie usuwa obciążenie (z 0.84 do 0.01), a przedział trafia w prawdę w 94.3% badań. Już przy gamma = 0.25 sytuacja się odwraca. Bez wag obciążenie wynosi tylko 0.04, bo dwa mechanizmy przypadkiem się znoszą. Po ważeniu rośnie do −0.78, a pokrycie spada do 61.2%. Ważenie usunęło tę część obciążenia, która wynikała z płci i roku, i odsłoniło część wynikającą ze stresu. Przy gamma = 0.5 pokrycie wynosi 6.9%, przy 1 – 0.0%.
Czego ten wykres nie pokazuje. Kierunek i wielkość tych liczb wynikają z naszych ręcznych założeń. W innym badaniu oba mechanizmy mogą działać w tę samą stronę i wtedy ważenie pomaga częściowo. Ogólna lekcja jest jedna: ważenie usuwa obciążenie tylko wtedy, gdy w obrębie grup ważenia osoby odpowiadające nie różnią się od tych, które odmówiły – w języku braków danych to założenie MAR względem zmiennych ważących. Groves (2006) podkreśla, że skuteczność korekty po badaniu zależy od jakości zmiennych pomocniczych. Szukaj więc zmiennych, które wiążą się zarówno z udziałem, jak i z badaną cechą. Inne źródła błędu (pokrycie, pomiar) zestawia wpis całkowity błąd badania sondażowego.
Podpis do pracy (np. w aneksie metodologicznym):
Zdanie do ograniczeń badania:
Co napisać w pracy o reprezentatywności
W pracy dyplomowej zwykle nie ma losowania z listy, tylko próba dostępna: znajomi z roku, grupa w mediach społecznościowych, jedna sala wykładowa. To nie wada sama w sobie, ale zmienia to, co wolno napisać. Szczegóły – we wpisach dobór próby w pracy dyplomowej i dobór nielosowy w obrazkach. Cornesse i in. (2020) przypominają, że zaufanie do prób losowych uzasadnia teoria, a trafność wniosków z prób nielosowych zależy całkowicie od modeli.
- Opisz dobór, nie przymiotnik. Zamiast „próba była reprezentatywna” napisz, skąd pochodzą osoby, ile zaproszono, ile odpowiedziało i jak policzono wskaźnik odpowiedzi.
- Porównaj strukturę z populacją, jeśli masz dane (dziekanat, GUS) – i dopisz, że zgodność w tych cechach nie dowodzi zgodności w badanej zmiennej (rysunek 2).
- Ważenie zgłoś razem z kosztem: zmienne ważące, źródło danych o populacji, zakres wag i efektywną liczebność.
- Nazwij ryzyko w ograniczeniach: kto mógł częściej odmawiać i w którą stronę mogło to przesunąć wynik.
Jak dobrać liczbę zaproszeń przy spodziewanym odsetku odmów, liczy wpis ile zaproszeń wysłać w sondażu. Gdy analizujesz gotowe dane z dużego sondażu z wagami, zajrzyj do wpisu analiza danych z ESS, PGSS i Diagnozy Społecznej. Zależność precyzji od wielkości populacji pokazuje wpis wielkość próby a wielkość populacji w obrazkach.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy populację, paletę, motyw i funkcje, z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy przepis, który losuje (1, 3 i 5), zawiera własne set.seed(586), więc skopiowany osobno (po przepisie 1) da te same liczby co na stronie. Ziarno 586 ustalono raz i nie zmieniano go. Ręcznie ustalono: wielkość i strukturę populacji, efekty płci, roku i wydziału na stres, prawdopodobieństwa odpowiedzi w scenariuszu A (.55, .75, .25 i .45), siłę zależności od stresu w scenariuszu B (−0.7 w skali logitu na 7 punktów stresu), 400 zaproszonych, 1000 powtórzeń i wartości gamma na rysunku 5. Przedziały na rysunku 2 liczy t.test(), a na rysunkach 3–5 pakiet survey z poprawką na skończoną populację (losujemy bez zwracania z 2000 osób) – stąd drobne różnice granic dla tej samej próby. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w około 20 sekund.
1. Populacja, jedno badanie i mapa: Rysunek 1
R
# Rysunek 1. Fikcyjna uczelnia (2000 osób): kto został zaproszony, kto odpowiedział, kto odmówił
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (niebieski i cynober rozróżnialne także przy deuteranopii) i prosty motyw
kol <- c(odp = "#0072B2", odm = "#D55E00", tlo = "grey82", pop = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", d, "f"), x))   # .03 zamiast 0.03

# Populacja: 2000 studentów jednej uczelni. Parametry ustalone ręcznie: 60% kobiet, 55% na latach III–V,
# wydziały 700/500/400/400 osób; stres akademicki (0–40 pkt) wyższy u kobiet (+4), na latach III–V (+3)
# i na wydziale medycznym (+3)
set.seed(586)                                    # ziarno ustalone raz, bez dobierania pod wynik
N <- 2000
pop <- data.frame(id = 1:N,
  wydzial = factor(rep(c("Humanistyczny", "Ścisły", "Medyczny", "Ekonomiczny"), c(700, 500, 400, 400)),
                   c("Humanistyczny", "Ścisły", "Medyczny", "Ekonomiczny")),
  plec = factor(ifelse(runif(N) < 0.60, "K", "M"), c("K", "M")),
  rok = factor(ifelse(runif(N) < 0.55, "III–V", "I–II"), c("I–II", "III–V")))
pop$komorka <- interaction(pop$plec, pop$rok, sep = " ", lex.order = TRUE)   # 4 komórki płeć × rok
efekt_wydz <- c(Humanistyczny = 0, Ścisły = 1, Medyczny = 3, Ekonomiczny = -1)
pop$stres <- round(pmin(40, pmax(0, 17 + 4 * (pop$plec == "K") + 3 * (pop$rok == "III–V") +
                                    efekt_wydz[as.character(pop$wydzial)] + rnorm(N, 0, 7))))
prawda <- mean(pop$stres)
round(c(N = N, srednia_stresu_w_populacji = prawda, SD = sd(pop$stres)), 2)
round(100 * prop.table(table(pop$komorka)), 1)   # struktura populacji (%) w komórkach płeć × rok

# Prawdopodobieństwo odpowiedzi w dwóch scenariuszach (ustalone ręcznie, średnio około 50%)
# A: zależy tylko od płci i roku (kobiety i starsze roczniki odpowiadają chętniej)
# B: zależy tylko od poziomu stresu (im wyższy stres, tym rzadziej ktoś odpowiada)
p_odp_A <- function(d) c("K I–II" = .55, "K III–V" = .75, "M I–II" = .25, "M III–V" = .45)[as.character(d$komorka)]
p_odp_B <- function(d) plogis(-0.7 * (d$stres - 22) / 7)

# Jedno badanie: losujemy 400 osób z listy studentów (losowanie proste bez zwracania), część odmawia
set.seed(586)
zapr <- pop[sort(sample(N, 400)), ]
zapr$odp_A <- runif(400) < p_odp_A(zapr)
u <- runif(400); zapr$odp_B <- u < p_odp_B(zapr)
c(zaproszeni = nrow(zapr), odpowiedzieli_A = sum(zapr$odp_A), odpowiedzieli_B = sum(zapr$odp_B))
round(100 * c(wskaznik_odpowiedzi_A = mean(zapr$odp_A), wskaznik_odpowiedzi_B = mean(zapr$odp_B)), 2)
round(c(prawda = prawda, wszyscy_zaproszeni = mean(zapr$stres),
        respondenci_A = mean(zapr$stres[zapr$odp_A]), respondenci_B = mean(zapr$stres[zapr$odp_B])), 2)
# Dane do pobrania: cała populacja z informacją, kto został zaproszony i kto odpowiedział w scenariuszach A i B
csv <- merge(pop[c("id", "wydzial", "plec", "rok", "stres")], zapr[c("id", "odp_A", "odp_B")], all.x = TRUE)
csv$zaproszony <- !is.na(csv$odp_A)
write.csv(csv[c("id", "wydzial", "plec", "rok", "stres", "zaproszony", "odp_A", "odp_B")],
          "proba-reprezentatywna-populacja.csv", row.names = FALSE)
# Odsetek odpowiedzi w komórkach płeć × rok (scenariusz A i B)
round(100 * sapply(split(zapr, zapr$komorka), function(d) c(A = mean(d$odp_A), B = mean(d$odp_B))), 1)

# Mapa: każda osoba to punkt; wiersze = wydziały, kolumny = komórki płeć × rok
mapa_xy <- function(d) {                         # układa osoby w każdym bloku w siatkę po 12 w rzędzie
  d <- d[order(d$wydzial, d$komorka, d$id), ]
  k <- ave(seq_len(nrow(d)), d$wydzial, d$komorka, FUN = seq_along) - 1
  d$x <- 5 * (k %% 12) + 2; d$y <- -5 * (k %/% 12) - 3; d   # środek pola 5 × 5 jednostek
}
m <- mapa_xy(pop)
# Tło: każdy student jako jasnoszary kwadracik 3 × 3 w polu 5 × 5 (raster, więc plik SVG zostaje mały)
tlo <- do.call(rbind, lapply(split(m, list(m$wydzial, m$komorka), drop = TRUE), function(b) {
  s <- expand.grid(x = 0:59, y = (min(b$y) - 2):(-1))
  s$osoba <- ifelse(paste(s$x - s$x %% 5 + 2, -5 * ((-s$y - 1) %/% 5) - 3) %in% paste(b$x, b$y) &
                      s$x %% 5 %in% 1:3 & (-s$y - 1) %% 5 %in% 1:3, "tak", NA)
  cbind(s, wydzial = b$wydzial[1], komorka = b$komorka[1])
}))
z <- merge(m[c("id", "wydzial", "komorka", "x", "y")], zapr[c("id", "odp_A")], by = "id")
z$status <- factor(ifelse(z$odp_A, "zaproszeni: odpowiedzieli", "zaproszeni: odmówili"),
                   c("zaproszeni: odpowiedzieli", "zaproszeni: odmówili"))
p1 <- ggplot() +
  geom_raster(data = tlo, aes(x, y, fill = osoba), show.legend = FALSE) +
  scale_fill_manual(values = c(tak = kol[["tlo"]]), na.value = "transparent") +
  geom_point(data = z, aes(x, y, colour = status, shape = status), size = 1.9, stroke = 0.9) +
  facet_grid(wydzial ~ komorka, scales = "free_y", space = "free_y", switch = "y") +
  scale_colour_manual(values = c(kol[["odp"]], kol[["odm"]]), name = NULL) +
  scale_shape_manual(values = c(16, 4), name = NULL) +
  labs(x = NULL, y = NULL, title = "Uczelnia: 2000 studentów, 400 zaproszonych",
       subtitle = "Scenariusz A: chętniej odpowiadają kobiety i starsze roczniki\nSzare kwadraciki: osoby niezaproszone") +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank(),
                strip.text.y.left = element_text(angle = 0, hjust = 1), panel.spacing = unit(4, "pt")) +
  guides(colour = guide_legend(override.aes = list(size = 3)))
p1   # zapis: ggsave("proba-reprezentatywna-mapa.svg", p1, width = 8, height = 9)
Wynik w R
                         N srednia_stresu_w_populacji
                   2000.00                      21.55
                        SD
                      7.59

 K I–II K III–V  M I–II M III–V
   27.8    33.5    17.7    21.1
     zaproszeni odpowiedzieli_A odpowiedzieli_B
            400             218             187
wskaznik_odpowiedzi_A wskaznik_odpowiedzi_B
                54.50                 46.75
            prawda wszyscy_zaproszeni      respondenci_A      respondenci_B
             21.55              21.65              22.56              18.31
  K I–II K III–V M I–II M III–V
A   52.8    81.1   21.3    48.5
B   49.1    36.1   53.3    52.6
2. Struktura próby a wynik: Rysunek 2
R
# Rysunek 2. „Reprezentatywna” w strukturze a trafny wynik: respondenci z obu scenariuszy wobec populacji
# (kontynuacja: pop, zapr, prawda, kol, motyw, bz z bloku 1; bez losowania)
library(ggplot2)
library(patchwork)

resp_A <- zapr[zapr$odp_A, ]; resp_B <- zapr[zapr$odp_B, ]
proc <- function(d) 100 * as.numeric(prop.table(table(d$komorka)))
str_tab <- data.frame(komorka = levels(pop$komorka), populacja = proc(pop), A = proc(resp_A), B = proc(resp_B))
print(str_tab, digits = 3, row.names = FALSE)
# Wskaźnik niepodobieństwa: jaki odsetek próby trzeba by „przesunąć” do innych komórek, by struktura była zgodna
round(c(A = sum(abs(str_tab$A - str_tab$populacja)) / 2, B = sum(abs(str_tab$B - str_tab$populacja)) / 2), 1)
# Średni stres respondentów z 95% CI (bez wag) wobec prawdziwej średniej
sr <- do.call(rbind, lapply(list(A = resp_A, B = resp_B), function(d) {
  tt <- t.test(d$stres); data.frame(n = nrow(d), M = mean(d$stres), dolna = tt$conf.int[1], gorna = tt$conf.int[2])
}))
sr$obciazenie <- sr$M - prawda
round(sr, 2)

# A: struktura płeć × rok – populacja i respondenci z dwóch scenariuszy (wykres punktowy Clevelanda)
serie <- c("Populacja (N = 2000)", sprintf("Respondenci A (n = %d)", nrow(resp_A)),
           sprintf("Respondenci B (n = %d)", nrow(resp_B)))
dl <- data.frame(komorka = factor(rep(str_tab$komorka, 3), rev(levels(pop$komorka))),
                 seria = factor(rep(serie, each = 4), serie), proc = c(str_tab$populacja, str_tab$A, str_tab$B))
skala <- list(scale_colour_manual(values = setNames(c(kol[["ciemny"]], kol[["odp"]], kol[["odm"]]), serie), name = NULL),
              scale_shape_manual(values = setNames(c(124, 16, 17), serie), name = NULL))
pa <- ggplot(dl, aes(proc, komorka, colour = seria, shape = seria)) +
  geom_line(aes(group = komorka), colour = "grey80", linewidth = 2.5) +
  geom_point(size = c(rep(8, 4), rep(3.4, 8))) + skala +
  scale_x_continuous(limits = c(0, 50), labels = function(x) paste0(x, "%")) +
  labs(x = "Udział w grupie", y = NULL, title = "A. Struktura płeć × rok") + motyw

# B: średni stres respondentów z 95% CI; linia przerywana – prawdziwa średnia populacji
sr$seria <- factor(serie[2:3], serie)
pb <- ggplot(sr, aes(M, seria, colour = seria, shape = seria)) +
  geom_vline(xintercept = prawda, linetype = "dashed", colour = kol[["ciemny"]]) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.15, linewidth = 0.9, orientation = "y",
                show.legend = FALSE) +
  geom_point(size = 3.6, show.legend = FALSE) + skala +
  annotate("text", x = prawda, y = 2.45, label = sprintf("prawda: %.2f", prawda), hjust = -0.05, size = 3.8,
           colour = kol[["ciemny"]]) +
  scale_y_discrete(limits = rev(serie[2:3]), labels = c("B", "A")) +
  scale_x_continuous(limits = c(15, 25)) +
  labs(x = "Średni stres (0–40 pkt), 95% CI", y = NULL, title = "B. Wynik bez wag") + motyw
p2 <- pa + guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) + pb +
  plot_layout(widths = c(1.35, 1), guides = "collect") & theme(legend.position = "bottom")
p2   # zapis: ggsave("proba-reprezentatywna-struktura-a-wynik.svg", p2, width = 9, height = 5)
Wynik w R
 komorka populacja     A    B
  K I–II      27.8 25.69 27.8
 K III–V      33.5 45.41 23.5
  M I–II      17.7  7.34 21.4
 M III–V      21.1 21.56 27.3
   A    B
12.4  9.9
    n     M dolna gorna obciazenie
A 218 22.56 21.51 23.62       1.01
B 187 18.31 17.30 19.32      -3.24
3. 1000 badań bez wag i z wagami: Rysunek 3
R
# Rysunek 3. 1000 badań tym samym schematem: obciążenie przed ważeniem i po ważeniu w obu scenariuszach
# (symulacja Monte Carlo; kontynuacja: pop, prawda, p_odp_A, p_odp_B, kol, motyw, bz z bloku 1)
library(ggplot2)
library(survey)

udzialy <- data.frame(komorka = levels(pop$komorka), Freq = as.numeric(table(pop$komorka)))  # liczebności populacji
# Jedno badanie: 400 zaproszonych, odpowiedzi według scenariusza, średnia bez wag i z wagami poststratyfikacyjnymi
jedno_badanie <- function() {
  z <- pop[sample(nrow(pop), 400), ]
  odp <- list(A = runif(400) < p_odp_A(z), B = runif(400) < p_odp_B(z))
  wyn <- c(pelna_odpowiedz = mean(z$stres))
  for (s in c("A", "B")) {
    r <- z[odp[[s]], ]
    r$komorka <- factor(as.character(r$komorka), udzialy$komorka)
    proj <- svydesign(ids = ~1, data = r, fpc = rep(nrow(pop), nrow(r)))      # losowanie bez zwracania z 2000
    proj_w <- postStratify(proj, ~komorka, udzialy)                           # wagi poststratyfikacyjne
    m0 <- svymean(~stres, proj); m1 <- svymean(~stres, proj_w)
    w <- weights(proj_w)
    wyn[paste0(s, c("_bez_wag", "_po_wazeniu", "_SE_bez", "_SE_po", "_n", "_n_eff"))] <-
      c(coef(m0), coef(m1), SE(m0), SE(m1), nrow(r), sum(w)^2 / sum(w^2))    # n_eff – efektywna liczebność Kisha
  }
  wyn
}
set.seed(586)
R <- 1000
sym <- as.data.frame(t(replicate(R, jedno_badanie())))

est <- c("pelna_odpowiedz", "A_bez_wag", "A_po_wazeniu", "B_bez_wag", "B_po_wazeniu")
podsum <- data.frame(schemat = est, srednia_oszacowan = colMeans(sym[est]), obciazenie = colMeans(sym[est]) - prawda,
                     SD_oszacowan = apply(sym[est], 2, sd))
podsum$RMSE <- sqrt(podsum$obciazenie^2 + podsum$SD_oszacowan^2)
print(podsum, digits = 3, row.names = FALSE)
# Pokrycie 95% CI (odsetek badań, w których przedział obejmuje prawdę) i błąd Monte Carlo
pokrycie <- function(m, se) mean(abs(m - prawda) <= qnorm(.975) * se)
pok <- c(A_bez_wag = pokrycie(sym$A_bez_wag, sym$A_SE_bez), A_po_wazeniu = pokrycie(sym$A_po_wazeniu, sym$A_SE_po),
         B_bez_wag = pokrycie(sym$B_bez_wag, sym$B_SE_bez), B_po_wazeniu = pokrycie(sym$B_po_wazeniu, sym$B_SE_po))
round(pok, 3)
round(c(blad_MC_przy_0.95 = sqrt(.95 * .05 / R)), 4)
# Koszt ważenia: średnia liczba respondentów, efektywna liczebność i stosunek SE po/przed ważeniem
round(c(A_n = mean(sym$A_n), A_n_eff = mean(sym$A_n_eff), A_SE_po_do_bez = mean(sym$A_SE_po / sym$A_SE_bez),
        B_n = mean(sym$B_n), B_n_eff = mean(sym$B_n_eff), B_SE_po_do_bez = mean(sym$B_SE_po / sym$B_SE_bez)), 2)

etyk <- c(pelna_odpowiedz = "Wszyscy zaproszeni odpowiadają", A_bez_wag = "A: odmowy zależne od płci i roku – bez wag",
          A_po_wazeniu = "A: odmowy zależne od płci i roku – po ważeniu", B_bez_wag = "B: odmowy zależne od stresu – bez wag",
          B_po_wazeniu = "B: odmowy zależne od stresu – po ważeniu")
dl <- data.frame(schemat = factor(rep(etyk[est], each = R), etyk[est]), oszacowanie = unlist(sym[est]))
podsum$scen <- substr(podsum$schemat, 1, 1)                        # p – pełna odpowiedź, A, B – scenariusze
podsum$schemat <- factor(etyk[podsum$schemat], etyk[est])
podsum$opis <- sprintf("obciążenie %s, SD %.2f", sub("-", "−", sprintf("%+.2f", round(podsum$obciazenie, 2) + 0)),
                       podsum$SD_oszacowan)
dl$scen <- podsum$scen[match(dl$schemat, podsum$schemat)]
p3 <- ggplot(dl, aes(oszacowanie, fill = scen)) +
  geom_histogram(binwidth = 0.25, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = prawda, linetype = "dashed", colour = kol[["ciemny"]]) +
  geom_point(data = podsum, aes(x = srednia_oszacowan, y = 0, shape = scen), size = 3.2, colour = kol[["ciemny"]],
             inherit.aes = FALSE) +
  geom_text(data = podsum, aes(x = 16.1, y = Inf, label = opis), inherit.aes = FALSE, hjust = 0, vjust = 1.6,
            size = 3.6, colour = "grey20") +
  facet_wrap(~schemat, ncol = 1) +
  scale_fill_manual(values = c(p = "grey65", A = kol[["odp"]], B = kol[["odm"]]), guide = "none") +
  scale_shape_manual(values = c(p = 15, A = 16, B = 17), guide = "none") +
  scale_x_continuous(limits = c(16, 24), breaks = 16:24) +
  labs(x = "Średni stres w jednym badaniu (0–40 pkt)", y = "Liczba badań",
       title = sprintf("1000 badań: prawdziwa średnia %.2f (linia przerywana)", prawda),
       subtitle = "Punkt pod histogramem: średnia z 1000 oszacowań") +
  motyw + theme(strip.text = element_text(hjust = 0, size = rel(0.85)))
p3   # zapis: ggsave("proba-reprezentatywna-1000-badan.svg", p3, width = 8, height = 9)
Wynik w R
         schemat srednia_oszacowan obciazenie SD_oszacowan  RMSE
 pelna_odpowiedz              21.5   -0.00460        0.344 0.344
       A_bez_wag              22.4    0.82025        0.486 0.953
    A_po_wazeniu              21.5   -0.00535        0.489 0.489
       B_bez_wag              19.0   -2.50147        0.485 2.548
    B_po_wazeniu              19.3   -2.25458        0.471 2.303
   A_bez_wag A_po_wazeniu    B_bez_wag B_po_wazeniu
       0.620        0.944        0.000        0.002
blad_MC_przy_0.95
           0.0069
           A_n        A_n_eff A_SE_po_do_bez            B_n        B_n_eff
        216.78         183.53           1.02         203.80         198.78
B_SE_po_do_bez
          0.96
4. Poststratyfikacja, raking i efektywna liczebność: Rysunek 4
R
# Rysunek 4. Ważenie jednej próby (scenariusz A): wagi, struktura i wynik przed ważeniem i po nim, raking, koszt
# (kontynuacja: pop, zapr, prawda, kol, motyw, bz z bloku 1; bez losowania)
library(ggplot2)
library(patchwork)
library(survey)

resp <- zapr[zapr$odp_A, ]                       # 218 respondentów ze scenariusza A
resp$komorka <- factor(as.character(resp$komorka), levels(pop$komorka))
proj <- svydesign(ids = ~1, data = resp, fpc = rep(nrow(pop), nrow(resp)))   # bez wag (każdy waży tyle samo)
# Poststratyfikacja: liczebności komórek płeć × rok w populacji (z listy studentów)
pop_komorki <- data.frame(komorka = levels(pop$komorka), Freq = as.numeric(table(pop$komorka)))
proj_ps <- postStratify(proj, ~komorka, pop_komorki)
# Raking: tylko rozkłady brzegowe płci, roku i wydziału (bez krzyżowania)
brzegi <- list(data.frame(plec = levels(pop$plec), Freq = as.numeric(table(pop$plec))),
               data.frame(rok = levels(pop$rok), Freq = as.numeric(table(pop$rok))),
               data.frame(wydzial = levels(pop$wydzial), Freq = as.numeric(table(pop$wydzial))))
proj_rk <- rake(proj, list(~plec, ~rok, ~wydzial), brzegi)

# Waga względna = udział komórki w populacji / udział w próbie (średnia wag = 1)
w_ps <- weights(proj_ps) / mean(weights(proj_ps))
wagi <- data.frame(komorka = levels(resp$komorka), n = as.numeric(table(resp$komorka)),
                   waga = tapply(w_ps, resp$komorka, mean))
print(wagi, digits = 3, row.names = FALSE)
# Struktura po ważeniu zgadza się z populacją (różnice najwyżej w zaokrągleniu)
round(100 * cbind(populacja = prop.table(table(pop$komorka)), bez_wag = prop.table(table(resp$komorka)),
                  po_wazeniu = prop.table(svytable(~komorka, proj_ps))), 2)

kish <- function(w) sum(w)^2 / sum(w^2)          # efektywna liczebność Kisha
wyniki <- do.call(rbind, lapply(list(bez_wag = proj, poststratyfikacja = proj_ps, raking = proj_rk), function(d) {
  m <- svymean(~stres, d); ci <- confint(m)
  data.frame(M = unname(coef(m)), SE = as.numeric(SE(m)), dolna = ci[1], gorna = ci[2], n_eff = kish(weights(d)))
}))
wyniki$szerokosc_CI <- wyniki$gorna - wyniki$dolna
wyniki$obciazenie <- wyniki$M - prawda
round(wyniki, 2)
round(c(prawda = prawda, deff_Kisha = nrow(resp) / kish(weights(proj_ps)), CV_wag = sd(w_ps)), 3)

# A: waga osoby w każdej komórce (słupek) i liczba respondentów
wagi$typ <- factor(ifelse(wagi$waga > 1, "waga > 1 (za mało w próbie)", "waga < 1 (za dużo w próbie)"),
                   c("waga > 1 (za mało w próbie)", "waga < 1 (za dużo w próbie)"))
pa <- ggplot(wagi, aes(waga, factor(komorka, rev(komorka)), fill = typ)) +
  geom_vline(xintercept = 1, colour = kol[["ciemny"]]) +
  geom_col(width = 0.6) +
  geom_text(aes(x = pmax(waga, 1), label = sprintf("%.2f (n = %d)", waga, n)), hjust = -0.1, size = 3.8,
            colour = "grey20") +
  scale_fill_manual(values = c(kol[["odm"]], kol[["odp"]]), name = NULL) +
  scale_x_continuous(limits = c(0, 3.9), breaks = 0:3, expand = c(0, 0)) +
  labs(x = "Waga poststratyfikacyjna (średnia = 1)", y = NULL, title = "A. Wagi w komórkach") +
  motyw + guides(fill = guide_legend(nrow = 2))

# B: średnia z 95% CI przed ważeniem i po nim; przy każdej – efektywna liczebność Kisha
wyniki$metoda <- factor(c("Bez wag", "Poststratyfikacja\n(płeć × rok)", "Raking\n(płeć, rok, wydział)"),
                        rev(c("Bez wag", "Poststratyfikacja\n(płeć × rok)", "Raking\n(płeć, rok, wydział)")))
pb <- ggplot(wyniki, aes(M, metoda)) +
  geom_vline(xintercept = prawda, linetype = "dashed", colour = kol[["ciemny"]]) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.15, linewidth = 0.9, colour = kol[["odp"]],
                orientation = "y") +
  geom_point(size = 3.4, colour = kol[["odp"]]) +
  geom_text(aes(label = sprintf("%.2f\nn_eff = %.0f", M, n_eff)), vjust = -0.45, size = 3.5, colour = "grey20",
            lineheight = 0.9) +
  scale_x_continuous(limits = c(20, 24)) +
  labs(x = "Średni stres, 95% CI", y = NULL, title = "B. Wynik przed i po ważeniu",
       subtitle = sprintf("Linia przerywana: prawda (%.2f)", prawda)) + motyw
p4 <- pa + pb + plot_layout(widths = c(1, 1.1)) & theme(legend.position = "bottom")
p4   # zapis: ggsave("proba-reprezentatywna-wagi.svg", p4, width = 9, height = 5.4)
Wynik w R
 komorka  n  waga
  K I–II 56 1.080
 K III–V 99 0.737
  M I–II 16 2.412
 M III–V 47 0.979
        populacja bez_wag po_wazeniu
K I–II      27.75   25.69      27.75
K III–V     33.45   45.41      33.45
M I–II      17.70    7.34      17.70
M III–V     21.10   21.56      21.10
                      M   SE dolna gorna  n_eff szerokosc_CI obciazenie
bez_wag           22.56 0.51 21.57 23.55 218.00         1.98       1.01
poststratyfikacja 22.08 0.55 21.01 23.16 184.82         2.14       0.53
raking            21.95 0.51 20.95 22.95 191.40         2.00       0.40
    prawda deff_Kisha     CV_wag
    21.550      1.180      0.425
5. Od scenariusza A do B: Rysunek 5
R
# Rysunek 5. Od scenariusza A do B: im mocniej odmowy zależą od samej mierzonej cechy, tym mniej pomaga ważenie
# (symulacja Monte Carlo; kontynuacja: pop, prawda, p_odp_A, kol, motyw, bz z bloku 1)
library(ggplot2)
library(patchwork)
library(survey)

udzialy <- data.frame(komorka = levels(pop$komorka), Freq = as.numeric(table(pop$komorka)))
# Prawdopodobieństwo odpowiedzi = scenariusz A (płeć i rok) przesunięty w skali logitu o −gamma × stres (w SD)
# gamma = 0: odmowy zależą tylko od zmiennych ważących; im większe gamma, tym silniej zależą od stresu
badanie_gamma <- function(gamma) {
  z <- pop[sample(nrow(pop), 400), ]
  r <- z[runif(400) < plogis(qlogis(p_odp_A(z)) - gamma * (z$stres - 22) / 7), ]
  r$komorka <- factor(as.character(r$komorka), udzialy$komorka)
  proj <- svydesign(ids = ~1, data = r, fpc = rep(nrow(pop), nrow(r)))
  m0 <- svymean(~stres, proj); m1 <- svymean(~stres, postStratify(proj, ~komorka, udzialy))
  c(bez_wag = unname(coef(m0)), po_wazeniu = unname(coef(m1)),
    pokryte = abs(coef(m1) - prawda) <= qnorm(.975) * as.numeric(SE(m1)))
}
gammy <- c(0, 0.25, 0.5, 0.75, 1)
set.seed(586)
R <- 1000
wyn <- do.call(rbind, lapply(gammy, function(g) {
  s <- t(replicate(R, badanie_gamma(g)))
  data.frame(gamma = g, obciazenie_bez_wag = mean(s[, 1]) - prawda, obciazenie_po_wazeniu = mean(s[, 2]) - prawda,
             pokrycie_po_wazeniu = mean(s[, 3]))
}))
print(round(wyn, 3), row.names = FALSE)
round(c(blad_MC_pokrycia_przy_0.95 = sqrt(.95 * .05 / R)), 4)

dl <- rbind(data.frame(gamma = wyn$gamma, wersja = "bez wag", obciazenie = wyn$obciazenie_bez_wag),
            data.frame(gamma = wyn$gamma, wersja = "po ważeniu (płeć × rok)", obciazenie = wyn$obciazenie_po_wazeniu))
skala <- list(scale_colour_manual(values = c("bez wag" = kol[["odm"]], "po ważeniu (płeć × rok)" = kol[["odp"]]), name = NULL),
              scale_shape_manual(values = c("bez wag" = 17, "po ważeniu (płeć × rok)" = 16), name = NULL),
              scale_linetype_manual(values = c("bez wag" = "dashed", "po ważeniu (płeć × rok)" = "solid"), name = NULL),
              scale_x_continuous(breaks = gammy, labels = c("0\n(A)", ".25", ".5", ".75", "1")))
pa <- ggplot(dl, aes(gamma, obciazenie, colour = wersja, shape = wersja, linetype = wersja)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_line(linewidth = 0.8) + geom_point(size = 3) + skala +
  labs(x = "Siła zależności odmów od stresu (gamma)", y = "Obciążenie średniej (pkt)",
       title = "A. Obciążenie z 1000 badań") + motyw
pb <- ggplot(wyn, aes(gamma, pokrycie_po_wazeniu)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = .95 - 2 * sqrt(.95 * .05 / R),
           ymax = .95 + 2 * sqrt(.95 * .05 / R), fill = "grey85") +
  geom_hline(yintercept = .95, colour = "grey30") +
  geom_line(colour = kol[["odp"]], linewidth = 0.8) + geom_point(colour = kol[["odp"]], size = 3) +
  skala[4] + scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2), labels = bz) +
  labs(x = "Siła zależności odmów od stresu (gamma)", y = "Pokrycie 95% CI po ważeniu",
       title = "B. Czy przedział trafia w prawdę", subtitle = "Szare pasmo: .95 ± 2 błędy Monte Carlo") + motyw
p5 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p5   # zapis: ggsave("proba-reprezentatywna-kiedy-wazenie-pomaga.svg", p5, width = 9, height = 5.4)
Wynik w R
 gamma obciazenie_bez_wag obciazenie_po_wazeniu pokrycie_po_wazeniu
  0.00              0.836                 0.008               0.943
  0.25              0.036                -0.784               0.612
  0.50             -0.850                -1.568               0.069
  0.75             -1.561                -2.156               0.004
  1.00             -2.295                -2.744               0.000
blad_MC_pokrycia_przy_0.95
                    0.0069
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (odpowiedzieli / odmówili; A / B)" = c("#0072B2", "#D55E00"),
             "jasnoszary – niebieski (niezaproszeni / odpowiedzieli)" = c("#D1D1D1", "#0072B2"),
             "jasnoszary – cynober (niezaproszeni / odmówili)" = c("#D1D1D1", "#D55E00"),
             "ciemnoszary – cynober (populacja / respondenci B)" = c("#333333", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                       widzenie_typowe
niebieski – cynober (odpowiedzieli / odmówili; A / B)            114.6
jasnoszary – niebieski (niezaproszeni / odpowiedzieli)            56.2
jasnoszary – cynober (niezaproszeni / odmówili)                   82.2
ciemnoszary – cynober (populacja / respondenci B)                 83.4
czerwony – zielony (do unikania)                                 121.7
                                                       deuteranopia protanopia
niebieski – cynober (odpowiedzieli / odmówili; A / B)         108.3       91.9
jasnoszary – niebieski (niezaproszeni / odpowiedzieli)         60.1       51.4
jasnoszary – cynober (niezaproszeni / odmówili)                67.7       64.9
ciemnoszary – cynober (populacja / respondenci B)              72.7       59.9
czerwony – zielony (do unikania)                               21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowania i t.test() – pakiet stats; ważone średnie, poststratyfikacja (postStratify()), raking (rake()) i błędy standardowe z wagami – pakiet survey. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survey (wersja 4.5): Lumley, T. (2024). survey: Analysis of complex survey samples [R package]. https://doi.org/10.32614/CRAN.package.survey
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- „Próba jest reprezentatywna, bo ma tyle samo kobiet co populacja”. Zgodna struktura nie gwarantuje trafnego wyniku (rysunek 2).
- Ocenianie jakości tylko po wskaźniku odpowiedzi. Ten sam odsetek odpowiedzi daje mały albo duży błąd – zależnie od tego, kto odmawia (rysunki 1 i 3).
- Traktowanie wag jak naprawy wszystkiego. Wagi korygują tylko to, co mierzą zmienne ważące; mogą nawet odsłonić obciążenie (rysunek 5).
- Podawanie wyników ważonych z błędem standardowym bez wag. Ważenie zmniejsza efektywną liczebność – licz błąd z uwzględnieniem wag, np. pakietem survey (rysunek 4).
- Nadzieja, że większa próba naprawi dobór. Większa próba zwęża przedział wokół złej wartości (rysunek 3).
Najczęstsze pytania
Czy próba jest reprezentatywna, jeśli zgadza się z populacją pod względem płci i wieku?
Nie wystarcza to. Zgodność dotyczy tylko porównywanych cech, a obciążenie zależy od tego, czy osoby, które odmówiły, różnią się w badanej zmiennej. W naszej symulacji respondenci ze strukturą bliższą populacji (wskaźnik niepodobieństwa 9.9% wobec 12.4%) zaniżali średni stres o 3.24 punktu, a ci ze strukturą bardziej skrzywioną zawyżali go tylko o 1.01.
Kiedy ważenie poststratyfikacyjne usuwa błąd braku odpowiedzi?
Gdy w obrębie grup ważenia osoby, które odpowiedziały, nie różnią się od tych, które odmówiły. W 1000 symulowanych badaniach z odmowami zależnymi od płci i roku obciążenie spadło z 0.82 do −0.01 punktu, a 95% CI trafiał w prawdę w 94.4% badań. Przy odmowach zależnych od samego stresu obciążenie spadło tylko z −2.50 do −2.25.
Czy ważenie może pogorszyć wynik?
Tak. Gdy na udział wpływają jednocześnie zmienne ważące i sama badana cecha, ich skutki mogą się częściowo znosić. Ważenie usuwa wtedy tylko jedną część i odsłania drugą. W naszej symulacji obciążenie bez wag wynosiło 0.04 punktu, a po ważeniu −0.78; pokrycie przedziału spadło do 61.2%.
Co to jest efektywna liczebność próby Kisha?
To liczba (Σw)² / Σw², która mówi, ilu osobom bez wag odpowiada próba ważona. Im bardziej zróżnicowane wagi, tym mniejsza. W przykładzie 218 respondentów z wagami od 0.74 do 2.41 dało neff = 185, a przedział ufności poszerzył się z 1.98 do 2.14 punktu. Wzór jest przybliżeniem – zakłada, że wagi nie wiążą się z mierzoną cechą.
Czy w pracy magisterskiej mogę napisać, że próba była reprezentatywna?
Tylko jeśli dobór był losowy z pełnej listy populacji, a odsetek i charakter odmów to uzasadniają. Przy próbie dostępnej opisz, skąd pochodzą osoby, ilu zaproszono i ilu odpowiedziało, porównaj strukturę z populacją, jeśli masz dane, i nazwij ryzyko obciążenia w ograniczeniach – zamiast samego przymiotnika.
Powiązane hasła
Przeczytaj też
Schematy losowania w obrazkach
Sześć schematów losowania na mapach jednej populacji, 1000 symulowanych badań, efekt schematu i efektywna liczebność – pięć rysunków z kodem R.
Czytaj →PoradnikDobór nielosowy w obrazkach
Próba wygodna, celowa, kwotowa, kula śnieżna i samoselekcja na mapie fikcyjnej uczelni oraz 1000 badań każdym sposobem – sześć rysunków z R.
Czytaj →PoradnikWażenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →PoradnikSondaż w obrazkach
Margines błędu a n i odsetek 50%, 1000 sondaży, różnica dwóch odsetków, duża ankieta online z błędem i liczba zaproszeń – sześć rysunków z R.
Czytaj →Masz ankietę z odmowami i nie wiesz, czy ważyć?
Pomożemy porównać próbę z populacją, policzyć wagi i błędy standardowe z ich uwzględnieniem oraz opisać dobór próby i ograniczenia tak, żebyś umiał(a) je obronić przed promotorem i recenzentem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Battaglia, M. P., Hoaglin, D. C., & Frankel, M. R. (2009). Practical considerations in raking survey data. Survey Practice, 2(5), 1–10. https://doi.org/10.29115/sp-2009-0019 ● Otwarty dostęp
- Cornesse, C., Blom, A. G., Dutwin, D., Krosnick, J. A., De Leeuw, E. D., Legleye, S., Pasek, J., Pennay, D., Phillips, B., Sakshaug, J. W., Struminskaya, B., & Wenz, A. (2020). A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research. Journal of Survey Statistics and Methodology, 8(1), 4–36. https://doi.org/10.1093/jssam/smz041 ● Otwarty dostęp
- Groves, R. M. (2006). Nonresponse rates and nonresponse bias in household surveys. Public Opinion Quarterly, 70(5), 646–675. https://doi.org/10.1093/poq/nfl033
- Groves, R. M., & Peytcheva, E. (2008). The impact of nonresponse rates on nonresponse bias: A meta-analysis. Public Opinion Quarterly, 72(2), 167–189. https://doi.org/10.1093/poq/nfn011 ● Otwarty dostęp: pełny tekst
- Haziza, D., & Beaumont, J.-F. (2017). Construction of weights in surveys: A review. Statistical Science, 32(2), 206–226. https://doi.org/10.1214/16-sts608
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08 ● Otwarty dostęp
Cytowania BibTeX
@article{battaglia2009practical, author={Battaglia, Michael P. and Hoaglin, David C. and Frankel, Martin R.}, title={{Practical considerations in raking survey data}}, journal={Survey Practice}, year={2009}, volume={2}, number={5}, pages={1--10}, doi={10.29115/sp-2009-0019}}@article{cornesse2020review, author={Cornesse, Carina and Blom, Annelies G. and Dutwin, David and Krosnick, Jon A. and De Leeuw, Edith D. and Legleye, Stéphane and Pasek, Josh and Pennay, Darren and Phillips, Benjamin and Sakshaug, Joseph W. and Struminskaya, Bella and Wenz, Alexander}, title={{A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research}}, journal={Journal of Survey Statistics and Methodology}, year={2020}, volume={8}, number={1}, pages={4--36}, doi={10.1093/jssam/smz041}}@article{groves2006nonresponse, author={Groves, Robert M.}, title={{Nonresponse rates and nonresponse bias in household surveys}}, journal={Public Opinion Quarterly}, year={2006}, volume={70}, number={5}, pages={646--675}, doi={10.1093/poq/nfl033}}@article{groves2008impact, author={Groves, R. M. and Peytcheva, E.}, title={{The impact of nonresponse rates on nonresponse bias: A meta-analysis}}, journal={Public Opinion Quarterly}, year={2008}, volume={72}, number={2}, pages={167--189}, doi={10.1093/poq/nfn011}}@article{haziza2017construction, author={Haziza, David and Beaumont, Jean-François}, title={{Construction of weights in surveys: A review}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={206--226}, doi={10.1214/16-sts608}}@article{lumley2004analysis, author={Lumley, Thomas}, title={{Analysis of complex survey samples}}, journal={Journal of Statistical Software}, year={2004}, volume={9}, number={8}, doi={10.18637/jss.v009.i08}}