Jedna populacja, sześć sposobów losowania
Definicje schematów losowania znajdziesz w hasłach próba losowa, dobór losowy prosty, dobór systematyczny i dobór wielostopniowy. Tu pokazujemy je na mapach: kto trafia do próby w każdym schemacie i co z tego wynika dla oszacowania. Robimy to na fikcyjnej populacji, więc znamy prawdziwą wartość i możemy sprawdzić, który schemat trafia, a który chybia.
Populacja to 2000 studentów jednej uczelni z czterech wydziałów (800, 600, 400 i 200 osób), podzielonych na 100 grup ćwiczeniowych po 20 osób. Mierzymy deklarowany tygodniowy czas nauki w godzinach. Parametry ustawiliśmy ręcznie tak, by różnice między wydziałami i podobieństwo osób z jednej grupy były wyraźne: średnie wydziałów 14, 16, 18 i 22 godziny, odchylenie standardowe między grupami 2 godziny, między osobami 5 godzin. Ziarno 584 ustalono raz i nie zmieniano go. Pełną listę pobierzesz jako schematy-losowania-populacja.csv. Ta lista to nasz operat losowania: bez niego żaden z opisanych schematów nie jest możliwy. W każdym schemacie losujemy 200 osób.
Rysunek 1: mapa populacji
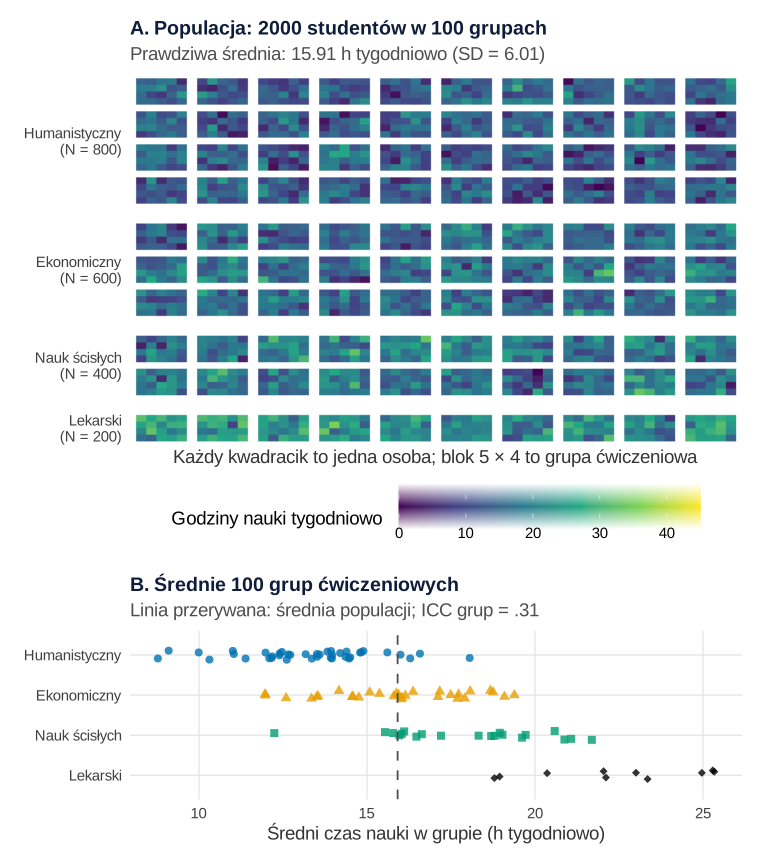
set.seed(584)).Co widać. Każdy kwadracik to jedna osoba, a blok 5 × 4 to grupa ćwiczeniowa. Prawdziwa średnia wynosi 15.91 godziny (SD = 6.01). Wydziały różnią się średnią: humanistyczny 13.27, ekonomiczny 15.89, nauk ścisłych 17.97, lekarski 22.42 godziny. Panel B pokazuje, że różnią się też grupy: średnie grup tego samego wydziału rozchodzą się o kilka godzin. Korelacja wewnątrzklasowa (ICC) grup ćwiczeniowych wynosi .31. To liczba z całej populacji, obejmuje więc także różnice między wydziałami.
Czego ten wykres nie pokazuje. W prawdziwym badaniu takiej mapy nie masz – znasz tylko listę nazwisk, a czas nauki poznajesz dopiero u wylosowanych. Mapa nie mówi też, skąd biorą się różnice między grupami (plan zajęć, prowadzący, dobór znajomych). Dla schematu losowania ważne jest tylko to, że osoby z jednej grupy są do siebie podobne.
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: kto trafia do próby w sześciu schematach
Wszystkie mapy powstały z jednego losowania każdym schematem (set.seed(584)). Lista jest ułożona według wydziału i grupy, a w grupie alfabetycznie.
- Losowanie proste: 200 osób z całej listy, każdy zestaw 200 osób jest równie prawdopodobny.
- Systematyczne: losowy start od 1 do 10, potem co 10. osoba z listy.
- Warstwowe proporcjonalne: osobne losowanie w każdym wydziale, liczebności 80, 60, 40 i 20 jak w populacji.
- Warstwowe nieproporcjonalne: po 50 osób z każdego wydziału; średnią liczymy z wagami 16, 12, 8 i 4 (liczba osób na wydziale podzielona przez 50).
- Zespołowe: losujemy 10 ze 100 grup i badamy wszystkie osoby w wylosowanych grupach.
- Dwustopniowe: losujemy 20 grup, a w każdej 10 osób.
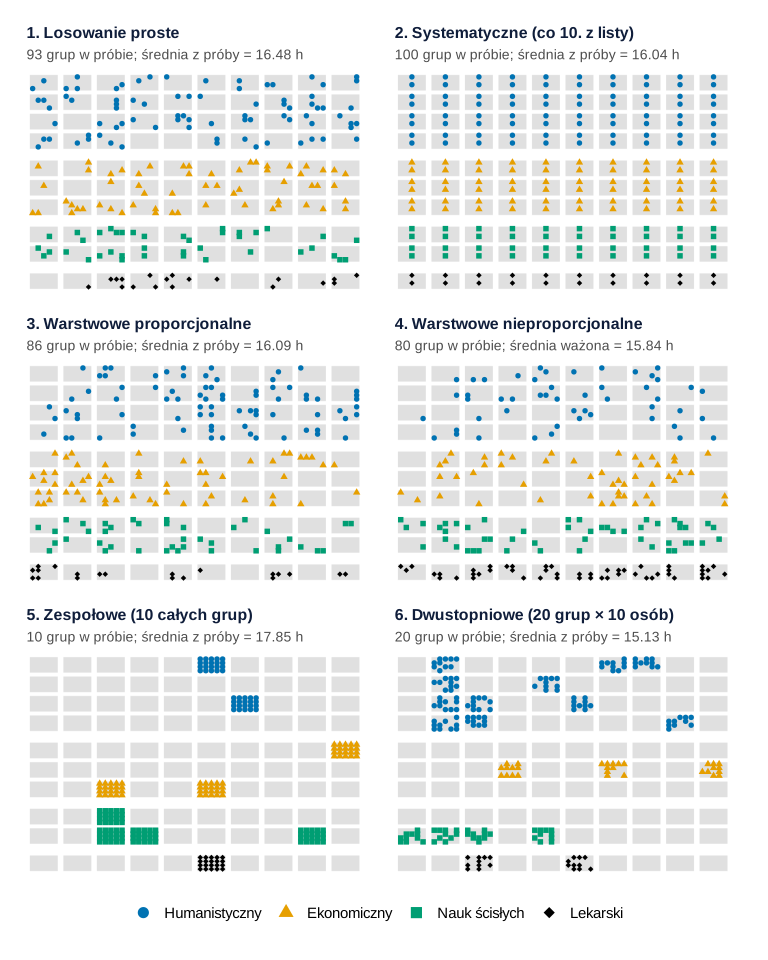
set.seed(584)).Co widać. W losowaniu prostym punkty rozsypały się po 93 grupach, a liczebności wydziałów (82, 59, 40, 19) tylko przypadkiem są bliskie populacji. Losowanie warstwowe proporcjonalne gwarantuje 80, 60, 40 i 20 osób. Systematyczne daje to samo i jeszcze więcej: przy liście ułożonej według grup bierze dokładnie dwie osoby z każdej ze 100 grup (pionowe kreski w blokach). W schemacie nieproporcjonalnym wydział lekarski ma 50 osób zamiast 20, więc da się go opisać osobno. Zespołowe skupia 200 osób w 10 blokach. W tym losowaniu trafiły się aż cztery grupy nauk ścisłych (80 osób zamiast 40), stąd średnia 17.85 godziny wobec prawdziwych 15.91. Dwustopniowe rozkłada te same 200 osób na 20 grup.
Czego ten wykres nie pokazuje. Pojedyncza mapa nie mówi, czy schemat jest dobry. Średnia 17.85 z próby zespołowej mogła wyjść równie dobrze 14. O jakości schematu świadczy dopiero rozkład wyników z wielu powtórzeń (rysunek 4). Mapa wygląda „równo” także przy pułapce, którą pokazuje rysunek 3.
Podpis do pracy:
Zdanie do Metody (wariant warstwowy):
Rysunek 3: pułapka okresowości listy
Losowanie systematyczne wymaga jednego losowania zamiast dwustu, ale zależy od układu listy. Dodaliśmy fikcyjną średnią ocen z poprzedniego roku, ustawioną ręcznie tak, by rosła z czasem nauki (korelacja .77). Potem ułożyliśmy listę inaczej: w każdej grupie od najwyższej średniej ocen. Grupa liczy 20 osób, a interwał wynosi 10, więc start r zawsze wybiera z każdej grupy osoby z tych samych miejsc rankingu.
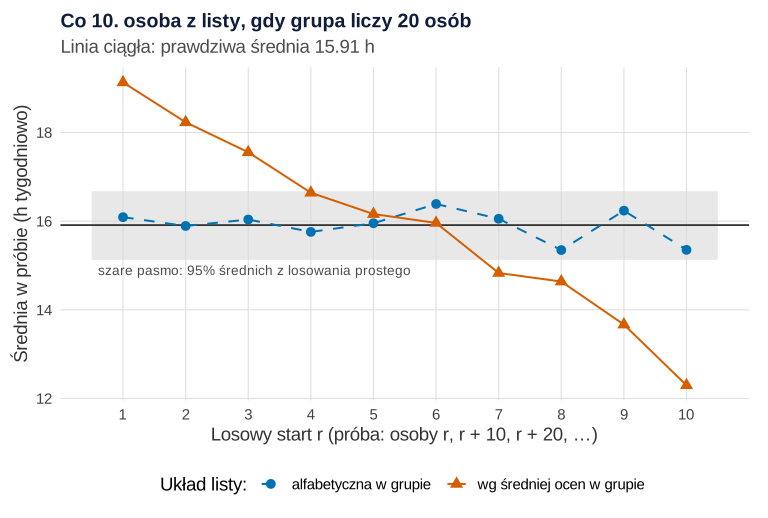
set.seed(584)).Co widać. Na liście alfabetycznej wszystkie 10 możliwych prób dało średnie od 15.35 do 16.39. To mieści się w paśmie 95% średnich z losowania prostego (15.13–16.67). Na liście według ocen start 1 bierze z każdej grupy osobę pierwszą i jedenastą w rankingu, a średnia wychodzi 19.13 godziny. Start 10 bierze dziesiątą i dwudziestą, a średnia spada do 12.30. Losowy start nadal sprawia, że średnia z 10 możliwych prób jest prawdziwa. Jedno badanie trafia jednak na jeden start i może być daleko od prawdy.
Czego ten wykres nie pokazuje. W prawdziwym badaniu widzisz jedną kropkę, nie dziesięć, i nie wiesz, że lista ma cykl. Okres nie musi być równy interwałowi – wystarczy, że jest jego wielokrotnością (tu 20 = 2 × 10). Inny przykład cyklu, listę par małżeńskich, opisuje hasło o doborze systematycznym. Teorię tego schematu rozwinęli Madow i Madow (1944).
Podpis do pracy:
Zdanie do Metody:
Rysunek 4: 1000 badań każdym schematem
Teraz każdy schemat powtarzamy 1000 razy i rysujemy, gdzie wypadły średnie. Przesunięcie środka rozkładu względem prawdziwej wartości to obciążenie. Rozrzut pokazuje precyzję – SD tych 1000 średnich to empiryczny błąd standardowy. Wiersz 4b to ta sama próba nieproporcjonalna policzona zwykłą średnią, bez wag.
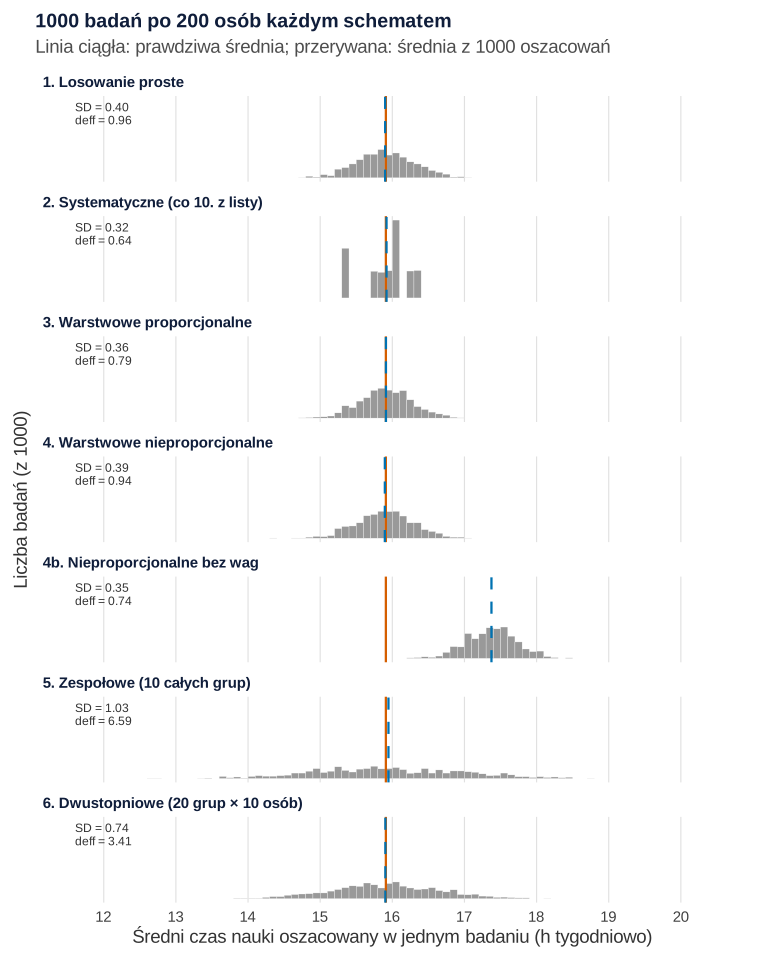
set.seed(584), 1000 powtórzeń na schemat).Co widać. Przy pięciu schematach i poprawnym liczeniu średnia z 1000 badań leży przy prawdziwych 15.91 (obciążenie od −0.01 do 0.04 godziny). Różnią się rozrzutem. Losowanie proste: SD = 0.40, zgodnie ze wzorem (0.40). Warstwowe proporcjonalne: 0.36, bo różnice między wydziałami nie wchodzą do błędu. Systematyczne: 0.32, bo na tej liście działa jak warstwowanie według grup; ma tylko 10 możliwych prób, stąd słupki zamiast rozkładu. Zespołowe: 1.03, dwustopniowe: 0.74. Najbardziej uderza wiersz 4b. Bez wag wydział lekarski waży w średniej 25% zamiast 10%, a wynik przesuwa się do 17.37 godziny. Obciążenie 1.46 godziny jest ponad czterokrotnie większe niż rozrzut oszacowań (SD = 0.35).
Czego ten wykres nie pokazuje. Mała SD nie chroni przed obciążeniem: wiersz 4b jest wąski, a cały chybiony. Wykres nie pokazuje też kosztów. Zespołowe jest najmniej precyzyjne przy 200 osobach, ale wymaga wejścia do 10 sal, a nie do 93 grup. Uczciwe porównanie schematów zakłada więc ten sam koszt badania, a nie tę samą liczbę osób.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: efekt schematu i efektywna liczebność
Efekt schematu (deff) to wariancja oszacowania w danym schemacie podzielona przez wariancję w losowaniu prostym tej samej liczebności. Efektywna liczebność to 200 / deff, czyli liczba osób z losowania prostego, która dałaby tę samą precyzję. Obie liczby bierzemy z symulacji, a nie ze wzoru.
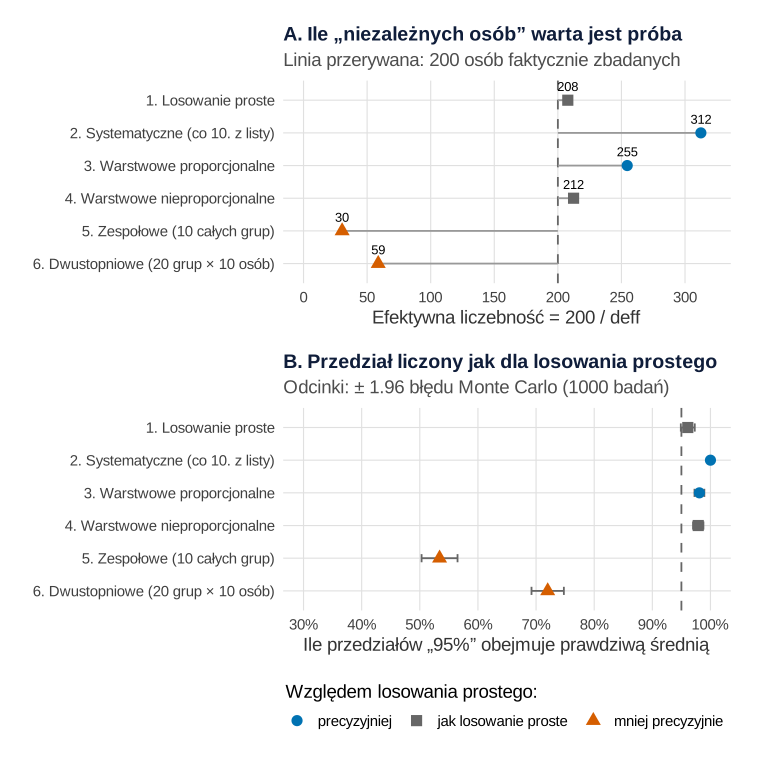
Co widać. Panel A: warstwowe proporcjonalne ma deff = 0.79 (efektywnie 255 osób), systematyczne 0.64 (312 osób). Nieproporcjonalne z wagami ma 0.94 (212 osób) i płaci za nierówne wagi część zysku z warstw. Zespołowe ma deff = 6.59: 200 osób z 10 grup jest wartych tyle co 30 osób z losowania prostego. Wzór 1 + (m − 1) × ICC daje dla grup po 20 osób i ICC = .31 wartość 6.85, bliską symulacji. Dwustopniowe (deff = 3.41, 59 osób) jest w połowie drogi, bo z każdej grupy bierze tylko 10 osób. Panel B pokazuje skutek liczenia przedziału ufności wzorem dla losowania prostego. W losowaniu prostym przedział obejmuje prawdę w 96.1% badań, a w zespołowym tylko w 53.4% (błąd Monte Carlo 1.6 pp). Dla wiersza 4b, czyli bez wag, pokrycie spada do 4.7%.
Czego ten wykres nie pokazuje. Deff dotyczy tej zmiennej i tej populacji. Inna zmienna, słabiej związana z grupą, miałaby mniejszy efekt schematu. Wykres nie pokazuje też, jak oszacować deff z jednej próby. Robi to analiza zgodna ze schematem: w przepisie 6 pakiet survey (Lumley, 2004) z jednej próby zespołowej podał średnią 17.92, błąd standardowy 1.30 i deff 8.79. Wzór dla losowania prostego dawał błąd 0.44, trzy razy za mały. Szacunek deff z 10 grup jest niepewny, stąd różnica względem 6.59 z symulacji. West i in. (2016) pokazali, że pomijanie złożonego schematu w analizach danych sondażowych jest częste i daje błędy standardowe niezgodne ze schematem próby. Szczegóły analizy z warstwami, klastrami i wagami opisuje wpis o danych z dużych badań sondażowych.
Podpis do pracy:
Zdanie do Wyników:
Ten sam efekt w badaniu z losowym przydziałem całych grup do warunków opisuje wpis o randomizacji klastrowej, a liczbę grup potrzebną przy danym ICC policzysz w kalkulatorze ICC i efektu schematu. Gdy chcesz porównywać grupy albo wyjaśniać różnice między nimi, potrzebny jest model wielopoziomowy. Wagi przy nierównych prawdopodobieństwach wyboru to idea estymatora Horvitza–Thompsona.
Co z tego wziąć do pracy dyplomowej
Większość prac dyplomowych nie ma żadnego z tych schematów. Masz zwykle próbę dostępną: ankietę wśród znajomych, na zajęciach albo w grupie internetowej. To nie dyskwalifikuje pracy, ale zmienia to, co wolno napisać. Wnioskowanie oparte na losowaniu, w którym rozkład wyników wynika z mechanizmu doboru, nie ma zastosowania do prób nielosowych (Elliott i Valliant, 2017). Opisz więc uczciwie, kogo zbadałeś(-aś), i nie nazywaj tej grupy próbą losową. Co wolno wnioskować z takiej próby, omawia wpis dobór próby w pracy dyplomowej, a rodzaje doboru nielosowego pokazuje na tych samych mapach wpis dobór nielosowy w obrazkach.
Jeśli losowałeś(-aś), w rozdziale „Metoda” podaj: operat (skąd lista i z jakiego dnia), schemat (który i dlaczego), liczebności w warstwach albo liczbę grup i osób w grupie, sposób losowania (np. funkcja w R, generator na stronie), wagi i to, jak uwzględniono schemat w analizie. Przegląd technik z ich zaletami i wadami podaje Berndt (2020). Klasyczną pracą o losowaniu warstwowym jest artykuł Jerzego Neymana (1934). Gdy większość wylosowanych nie odpowie, losowość schematu niewiele daje. O brakach odpowiedzi i ważeniu piszemy we wpisie próba reprezentatywna w obrazkach. Margines błędu i liczba zaproszeń to temat wpisu sondaż w obrazkach. Wpis wielkość próby a wielkość populacji pokazuje, kiedy liczy się poprawka na skończoną populację. Losowanie osób do próby to co innego niż losowy przydział do warunków – różnicę rysuje wpis losowy przydział w eksperymencie w obrazkach.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy populację, paletę i motyw, przepis 2 – funkcje losujące, z których korzystają następne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy przepis, który losuje (1, 2, 3, 4 i 6), zaczyna się od własnego set.seed(584) – ziarno ustalono raz i nie zmieniano go. Przepisy 2, 4 i 6 korzystają z populacji i funkcji z wcześniejszych przepisów, więc uruchamiaj je po kolei; wtedy dostaniesz dokładnie liczby ze strony. Ręcznie ustalono: liczebności wydziałów (800, 600, 400, 200), średnie wydziałów (14, 16, 18, 22 godziny), SD między grupami (2) i między osobami (5), wielkość grupy (20), liczebność próby (200), parametry schematów (10 grup; 20 grup po 10 osób; po 50 osób z wydziału), współczynniki fikcyjnej średniej ocen w przepisie 3 i 1000 powtórzeń w symulacji. Przepis 1 zapisuje populację do pliku CSV w katalogu roboczym. Cały kod liczy się w kilkanaście sekund.
1. Populacja, paleta i mapa: Rysunek 1
R
# Rysunek 1. Fikcyjna populacja: 2000 studentów, 4 wydziały, 100 grup ćwiczeniowych po 20 osób
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (z czernią) dla wydziałów (z kształtem punktu jako drugim nośnikiem) i prosty motyw
kol_wydz <- c("Humanistyczny" = "#0072B2", "Ekonomiczny" = "#E69F00", "Nauk ścisłych" = "#009E73",
              "Lekarski" = "#000000")
ksz_wydz <- c("Humanistyczny" = 16, "Ekonomiczny" = 17, "Nauk ścisłych" = 15, "Lekarski" = 18)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Populacja (dane fikcyjne). Parametry ustalone ręcznie: liczebności wydziałów 800/600/400/200,
# średni czas nauki 14/16/18/22 godziny tygodniowo, SD między grupami 2 h, SD między osobami 5 h
wydzialy <- data.frame(wydzial = names(kol_wydz), N_h = c(800, 600, 400, 200), mu = c(14, 16, 18, 22))
m <- 20                                              # osób w grupie ćwiczeniowej
set.seed(584)                                        # ziarno ustalone raz, bez dobierania pod wynik
pop <- do.call(rbind, lapply(seq_len(nrow(wydzialy)), function(w) {
  G <- wydzialy$N_h[w] / m                           # liczba grup na wydziale
  efekt_grupy <- rnorm(G, 0, 2)
  data.frame(wydzial = wydzialy$wydzial[w], grupa_w = rep(seq_len(G), each = m), osoba_w = rep(1:m, G),
             godziny = wydzialy$mu[w] + rep(efekt_grupy, each = m) + rnorm(G * m, 0, 5))
}))
pop$godziny <- pmax(0, round(pop$godziny, 1))
pop$wydzial <- factor(pop$wydzial, names(kol_wydz))
pop$grupa <- as.integer(factor(paste(pop$wydzial, pop$grupa_w), unique(paste(pop$wydzial, pop$grupa_w))))
pop$id <- seq_len(nrow(pop))                         # kolejność na liście: wydział, grupa, osoba
N <- nrow(pop); n <- 200

# Współrzędne „mapy”: grupa = blok 5 × 4 osoby, 10 grup w rzędzie, odstęp między wydziałami
w_idx <- as.integer(pop$wydzial)
rzad_grupy <- (pop$grupa - 1) %/% 10                 # 0–9 od góry
pop$x <- ((pop$grupa - 1) %% 10) * 6 + (pop$osoba_w - 1) %% 5 + 1
pop$y <- -(rzad_grupy * 5 + (pop$osoba_w - 1) %/% 5 + (w_idx - 1) * 2)
# Pełna siatka mapy: komórki między blokami grup zostają puste (białe)
siatka <- merge(expand.grid(x = 1:max(pop$x), y = min(pop$y):0), pop, all.x = TRUE)
write.csv(pop[, c("id", "wydzial", "grupa", "osoba_w", "godziny", "x", "y")],
          "schematy-losowania-populacja.csv", row.names = FALSE)

# Prawdziwe wartości w populacji (znane, bo dane są fikcyjne)
mu_pop <- mean(pop$godziny); S2 <- var(pop$godziny)
round(c(N = N, srednia = mu_pop, SD = sqrt(S2)), 3)
aggregate(godziny ~ wydzial, pop, function(x) round(c(N = length(x), srednia = mean(x)), 2))
# ICC grup ćwiczeniowych (jednoczynnikowa ANOVA na całej populacji, grupy po 20 osób)
a <- anova(lm(godziny ~ factor(grupa), pop))
MSB <- a$`Mean Sq`[1]; MSW <- a$`Mean Sq`[2]
icc <- (MSB - MSW) / (MSB + (m - 1) * MSW)
round(c(ICC = icc, deff_wzor = 1 + (m - 1) * icc), 3)

# A: mapa populacji – kolor = czas nauki; B: średnie 100 grup na tle średnich wydziałów
pas <- aggregate(y ~ wydzial, pop, function(v) mean(range(v)))
etyk <- paste0(pas$wydzial, "\n(N = ", table(pop$wydzial), ")")
pa <- ggplot(siatka, aes(x, y, fill = godziny)) +
  geom_raster() +
  scale_fill_viridis_c(name = "Godziny nauki tygodniowo", option = "D", limits = c(0, 45), na.value = "white") +
  scale_y_continuous(breaks = pas$y, labels = etyk, expand = c(0.01, 0)) +
  scale_x_continuous(breaks = NULL, expand = c(0.01, 0)) +
  labs(x = "Każdy kwadracik to jedna osoba; blok 5 × 4 to grupa ćwiczeniowa", y = NULL,
       title = "A. Populacja: 2000 studentów w 100 grupach",
       subtitle = sprintf("Prawdziwa średnia: %.2f h tygodniowo (SD = %.2f)", mu_pop, sqrt(S2))) +
  motyw + theme(panel.grid.major = element_blank(), legend.key.width = unit(1.6, "cm"))
gr <- aggregate(godziny ~ grupa + wydzial, pop, mean)
pb <- ggplot(gr, aes(godziny, wydzial)) +
  geom_point(aes(colour = wydzial, shape = wydzial), size = 2.4, alpha = 0.8,
             position = position_jitter(width = 0, height = 0.12, seed = 584)) +
  geom_vline(xintercept = mu_pop, linetype = "dashed", colour = "grey30") +
  scale_colour_manual(values = kol_wydz, guide = "none") +
  scale_shape_manual(values = ksz_wydz, guide = "none") +
  scale_y_discrete(limits = rev(levels(pop$wydzial))) +
  labs(x = "Średni czas nauki w grupie (h tygodniowo)", y = NULL,
       title = "B. Średnie 100 grup ćwiczeniowych",
       subtitle = paste("Linia przerywana: średnia populacji; ICC grup =", sub("^0", "", sprintf("%.2f", icc)))) +
  motyw
p1 <- pa / pb + plot_layout(heights = c(2.2, 1))
p1   # zapis: ggsave("schematy-losowania-populacja.svg", p1, width = 8, height = 9)
Wynik w R
       N  srednia       SD
2000.000   15.911    6.009
        wydzial godziny.N godziny.srednia
1 Humanistyczny    800.00           13.27
2   Ekonomiczny    600.00           15.89
3 Nauk ścisłych    400.00           17.97
4      Lekarski    200.00           22.42
      ICC deff_wzor
    0.308     6.846
2. Sześć schematów i sześć map: Rysunek 2
R
# Rysunek 2. Sześć schematów losowania 200 osób z tej samej populacji (mapy)
# Każda funkcja zwraca numery wierszy wylosowanych osób; lista (operat) jest ułożona wg wydziału i grupy
proste <- function() sample(N, n)
systematyczne <- function(k = N / n) seq(sample(k, 1), N, by = k)        # losowy start, potem co k-ta
warstwowe_prop <- function() unlist(lapply(split(pop$id, pop$wydzial), function(ids)
  ids[sample(length(ids), n * length(ids) / N)]))                         # 80 / 60 / 40 / 20
warstwowe_nieprop <- function() unlist(lapply(split(pop$id, pop$wydzial), function(ids)
  ids[sample(length(ids), n / 4)]))                                       # po 50 z każdego wydziału
zespolowe <- function(g = 10) which(pop$grupa %in% sample(max(pop$grupa), g))   # całe grupy
dwustopniowe <- function(g = 20, k = 10) unlist(lapply(sample(max(pop$grupa), g), function(gr) {
  ids <- pop$id[pop$grupa == gr]; ids[sample(length(ids), k)] }))         # 20 grup, po 10 osób
# Waga = 1 / prawdopodobieństwo wyboru; potrzebna tylko w schemacie nieproporcjonalnym
waga_nieprop <- (table(pop$wydzial) / (n / 4))[as.character(pop$wydzial)]

schematy <- c("1. Losowanie proste" = "proste", "2. Systematyczne (co 10. z listy)" = "systematyczne",
              "3. Warstwowe proporcjonalne" = "warstwowe_prop", "4. Warstwowe nieproporcjonalne" = "warstwowe_nieprop",
              "5. Zespołowe (10 całych grup)" = "zespolowe", "6. Dwustopniowe (20 grup × 10 osób)" = "dwustopniowe")
set.seed(584)
proby <- lapply(schematy, function(f) sort(do.call(f, list())))
srednia <- function(ids, f) if (f == "warstwowe_nieprop")
  weighted.mean(pop$godziny[ids], waga_nieprop[ids]) else mean(pop$godziny[ids])
podsum <- data.frame(schemat = names(schematy), n = sapply(proby, length),
                     grup_w_probie = sapply(proby, function(ids) length(unique(pop$grupa[ids]))),
                     srednia = round(mapply(srednia, proby, schematy), 2), row.names = NULL)
podsum
t(sapply(proby, function(ids) table(pop$wydzial[ids])))                  # osoby z każdego wydziału

# Mapa: wszyscy jasnoszarzy (raster), wylosowani – punkty w kolorze i kształcie wydziału
mapa <- function(ids, tytul, opis) {
  ggplot(siatka, aes(x, y)) +
    geom_raster(aes(fill = is.na(id))) +
    scale_fill_manual(values = c("FALSE" = "grey88", "TRUE" = "white"), guide = "none") +
    geom_point(data = pop[ids, ], aes(colour = wydzial, shape = wydzial), size = 1.5) +
    scale_colour_manual(values = kol_wydz, name = NULL, drop = FALSE) +
    scale_shape_manual(values = ksz_wydz, name = NULL, drop = FALSE) +
    scale_x_continuous(breaks = NULL, expand = c(0.01, 0)) +
    scale_y_continuous(breaks = NULL, expand = c(0.01, 0)) +
    labs(x = NULL, y = NULL, title = tytul, subtitle = opis) +
    motyw + theme(panel.grid.major = element_blank(), plot.title = element_text(size = rel(0.85)),
                  plot.subtitle = element_text(size = rel(0.75)))
}
opisy <- sprintf("%d grup w próbie; średnia %s = %.2f h", podsum$grup_w_probie,
                 ifelse(schematy == "warstwowe_nieprop", "ważona", "z próby"), podsum$srednia)
p2 <- wrap_plots(Map(mapa, proby, names(schematy), opisy), ncol = 2) +
  plot_layout(guides = "collect") &
  theme(legend.position = "bottom") & guides(colour = guide_legend(override.aes = list(size = 3.5)))
p2   # zapis: ggsave("schematy-losowania-szesc-map.svg", p2, width = 8, height = 10)
Wynik w R
                              schemat   n grup_w_probie srednia
1                 1. Losowanie proste 200            93   16.48
2   2. Systematyczne (co 10. z listy) 200           100   16.04
3         3. Warstwowe proporcjonalne 200            86   16.09
4      4. Warstwowe nieproporcjonalne 200            80   15.84
5       5. Zespołowe (10 całych grup) 200            10   17.85
6 6. Dwustopniowe (20 grup × 10 osób) 200            20   15.13
                                    Humanistyczny Ekonomiczny Nauk ścisłych
1. Losowanie proste                            82          59            40
2. Systematyczne (co 10. z listy)              80          60            40
3. Warstwowe proporcjonalne                    80          60            40
4. Warstwowe nieproporcjonalne                 50          50            50
5. Zespołowe (10 całych grup)                  40          60            80
6. Dwustopniowe (20 grup × 10 osób)           110          30            40
                                    Lekarski
1. Losowanie proste                       19
2. Systematyczne (co 10. z listy)         20
3. Warstwowe proporcjonalne               20
4. Warstwowe nieproporcjonalne            50
5. Zespołowe (10 całych grup)             20
6. Dwustopniowe (20 grup × 10 osób)       20
3. Pułapka okresowości listy: Rysunek 3
R
# Rysunek 3. Pułapka okresowości: ta sama populacja, dwa układy listy, losowanie co 10. osoby
# Druga lista: w każdej grupie osoby ułożone od najwyższej średniej ocen z poprzedniego roku.
# Średnia ocen jest fikcyjna i ustalona ręcznie tak, by rosła z czasem nauki (plus szum)
set.seed(584)
pop$srednia_ocen <- round(pmin(5, pmax(3, 3.9 + 0.06 * (pop$godziny - mu_pop) + rnorm(N, 0, 0.3))), 2)
round(cor(pop$srednia_ocen, pop$godziny), 2)
listy <- list("alfabetyczna w grupie" = pop$id,
              "wg średniej ocen w grupie" = pop$id[order(pop$grupa, -pop$srednia_ocen)])
k <- N / n                                           # interwał 10, a grupa liczy 20 osób (okres listy)
sys_starty <- do.call(rbind, lapply(names(listy), function(l) data.frame(lista = l, start = 1:k,
  srednia = sapply(1:k, function(r) mean(pop$godziny[listy[[l]][seq(r, N, by = k)]])))))
sys_starty$lista <- factor(sys_starty$lista, names(listy))
# Punkt odniesienia: środkowe 95% średnich z 1000 prób losowania prostego
set.seed(584)
srednie_proste <- replicate(1000, mean(pop$godziny[sample(N, n)]))
pasmo <- quantile(srednie_proste, c(.025, .975))
round(c(prawdziwa = mu_pop, pasmo_proste = pasmo), 2)
round(sapply(split(sys_starty$srednia, sys_starty$lista), range), 2)   # najniższa i najwyższa
round(xtabs(srednia ~ start + lista, sys_starty), 2)

p3 <- ggplot(sys_starty, aes(start, srednia, colour = lista, shape = lista, linetype = lista)) +
  annotate("rect", xmin = 0.5, xmax = k + 0.5, ymin = pasmo[1], ymax = pasmo[2], fill = "grey85", alpha = 0.6) +
  geom_hline(yintercept = mu_pop, colour = "grey20") +
  geom_line(linewidth = 0.7) + geom_point(size = 3) +
  annotate("text", x = 0.6, y = pasmo[1] - 0.12, hjust = 0, vjust = 1, size = 3.6, colour = "grey30",
           label = "szare pasmo: 95% średnich z losowania prostego") +
  scale_colour_manual(values = c("#0072B2", "#D55E00"), name = "Układ listy:") +
  scale_shape_manual(values = c(16, 17), name = "Układ listy:") +
  scale_linetype_manual(values = c("dashed", "solid"), name = "Układ listy:") +
  scale_x_continuous(breaks = 1:k) +
  labs(x = "Losowy start r (próba: osoby r, r + 10, r + 20, …)", y = "Średnia w próbie (h tygodniowo)",
       title = "Co 10. osoba z listy, gdy grupa liczy 20 osób",
       subtitle = sprintf("Linia ciągła: prawdziwa średnia %.2f h", mu_pop)) + motyw
p3   # zapis: ggsave("schematy-losowania-okresowosc-listy.svg", p3, width = 8, height = 5.4)
Wynik w R
[1] 0.77
         prawdziwa  pasmo_proste.2.5% pasmo_proste.97.5%
             15.91              15.13              16.67
     alfabetyczna w grupie wg średniej ocen w grupie
[1,]                 15.35                     12.30
[2,]                 16.39                     19.13
     lista
start alfabetyczna w grupie wg średniej ocen w grupie
   1                  16.09                     19.13
   2                  15.89                     18.23
   3                  16.04                     17.55
   4                  15.76                     16.64
   5                  15.95                     16.16
   6                  16.39                     15.96
   7                  16.05                     14.83
   8                  15.35                     14.64
   9                  16.24                     13.67
   10                 15.35                     12.30
4. 1000 badań każdym schematem: Rysunek 4
R
# Rysunek 4. 1000 badań każdym schematem: rozkład oszacowań średniej wokół prawdziwej wartości
R <- 1000
set.seed(584)
sym <- do.call(rbind, lapply(seq_along(schematy), function(s) {
  f <- schematy[[s]]
  do.call(rbind, lapply(1:R, function(i) {
    ids <- do.call(f, list()); y <- pop$godziny[ids]
    se_naiwny <- sd(y) / sqrt(length(y))             # błąd jak dla losowania prostego (bez schematu)
    est <- data.frame(schemat = names(schematy)[s], srednia = mean(y), se_naiwny)
    if (f == "warstwowe_nieprop")                     # ta sama próba: średnia ważona i (błędnie) bez wag
      est <- data.frame(schemat = c("4. Warstwowe nieproporcjonalne", "4b. Nieproporcjonalne bez wag"),
                        srednia = c(weighted.mean(y, waga_nieprop[ids]), mean(y)), se_naiwny)
    est
  }))
}))
sym$schemat <- factor(sym$schemat, unique(sym$schemat))
sym$pokrywa <- abs(sym$srednia - mu_pop) <= qt(.975, n - 1) * sym$se_naiwny

# Wariancja średniej w losowaniu prostym bez zwracania (wzór z poprawką na skończoną populację)
var_proste <- (1 - n / N) * S2 / n
wyniki <- do.call(rbind, lapply(split(sym, sym$schemat), function(d) data.frame(
  schemat = d$schemat[1], srednia_oszacowan = mean(d$srednia), obciazenie = mean(d$srednia) - mu_pop,
  SD_oszacowan = sd(d$srednia), deff = var(d$srednia) / var_proste,
  pokrycie_naiwnego_CI = mean(d$pokrywa))))
wyniki$n_efektywne <- n / wyniki$deff
wyniki$blad_MC_pokrycia <- sqrt(wyniki$pokrycie_naiwnego_CI * (1 - wyniki$pokrycie_naiwnego_CI) / R)
rownames(wyniki) <- NULL
print(cbind(wyniki[1], round(wyniki[-1], 3)), right = FALSE)
round(c(prawdziwa_srednia = mu_pop, SD_proste_wzor = sqrt(var_proste)), 3)
length(unique(round(sym$srednia[sym$schemat == "2. Systematyczne (co 10. z listy)"], 6)))   # ile różnych prób

p4 <- ggplot(sym, aes(srednia)) +
  geom_histogram(binwidth = 0.1, boundary = 0, fill = "grey60", colour = "white", linewidth = 0.1) +
  geom_vline(xintercept = mu_pop, colour = "#D55E00", linewidth = 0.8) +
  geom_vline(data = wyniki, aes(xintercept = srednia_oszacowan), colour = "#0072B2", linetype = "dashed",
             linewidth = 0.8) +
  geom_text(data = wyniki, aes(x = 11.6, y = Inf, label = sprintf("SD = %.2f\ndeff = %.2f", SD_oszacowan, deff)),
            hjust = 0, vjust = 1.3, size = 3.2, colour = "grey20", lineheight = 0.9) +
  facet_wrap(~ schemat, ncol = 1, strip.position = "top") +
  scale_x_continuous(limits = c(11.5, 20.5), breaks = 12:20) +
  scale_y_continuous(breaks = NULL) +
  labs(x = "Średni czas nauki oszacowany w jednym badaniu (h tygodniowo)", y = "Liczba badań (z 1000)",
       title = "1000 badań po 200 osób każdym schematem",
       subtitle = "Linia ciągła: prawdziwa średnia; przerywana: średnia z 1000 oszacowań") +
  motyw + theme(strip.text = element_text(hjust = 0, size = rel(0.8)), panel.spacing.y = unit(0.3, "lines"))
p4   # zapis: ggsave("schematy-losowania-1000-badan.svg", p4, width = 8, height = 10)
Wynik w R
  schemat                             srednia_oszacowan obciazenie SD_oszacowan
1 1. Losowanie proste                 15.901            -0.010     0.395
2 2. Systematyczne (co 10. z listy)   15.920             0.009     0.322
3 3. Warstwowe proporcjonalne         15.912             0.001     0.357
4 4. Warstwowe nieproporcjonalne      15.896            -0.014     0.391
5 4b. Nieproporcjonalne bez wag       17.374             1.464     0.347
6 5. Zespołowe (10 całych grup)       15.946             0.036     1.035
7 6. Dwustopniowe (20 grup × 10 osób) 15.904            -0.007     0.744
  deff  pokrycie_naiwnego_CI n_efektywne blad_MC_pokrycia
1 0.962 0.961                207.815     0.006
2 0.640 1.000                312.467     0.000
3 0.786 0.981                254.538     0.004
4 0.942 0.979                212.354     0.005
5 0.739 0.047                270.533     0.007
6 6.590 0.534                 30.350     0.016
7 3.405 0.720                 58.733     0.014
prawdziwa_srednia    SD_proste_wzor
           15.911             0.403
[1] 10
5. Efektywna liczebność i pokrycie: Rysunek 5
R
# Rysunek 5. Efektywna liczebność próby i pokrycie przedziału liczonego „jak dla losowania prostego”
# Korzysta z tabeli wyniki z przepisu 4 (bez nowego losowania)
w5 <- wyniki[wyniki$schemat != "4b. Nieproporcjonalne bez wag", ]
w5$schemat <- factor(w5$schemat, rev(w5$schemat))
w5$typ <- cut(w5$deff, c(0, 0.9, 1.1, Inf), labels = c("precyzyjniej", "jak losowanie proste", "mniej precyzyjnie"))
kol_typ <- c("precyzyjniej" = "#0072B2", "jak losowanie proste" = "#666666", "mniej precyzyjnie" = "#D55E00")
ksz_typ <- c("precyzyjniej" = 16, "jak losowanie proste" = 15, "mniej precyzyjnie" = 17)
pa5 <- ggplot(w5, aes(n_efektywne, schemat)) +
  geom_vline(xintercept = n, colour = "grey40", linetype = "dashed") +
  geom_segment(aes(x = n, xend = n_efektywne, yend = schemat), colour = "grey60") +
  geom_point(aes(colour = typ, shape = typ), size = 3.5) +
  geom_text(aes(label = sprintf("%.0f", n_efektywne)), vjust = -1, size = 3.4) +
  scale_colour_manual(values = kol_typ, name = "Względem losowania prostego:") +
  scale_shape_manual(values = ksz_typ, name = "Względem losowania prostego:") +
  scale_x_continuous(limits = c(0, 320), breaks = seq(0, 300, 50)) +
  labs(x = "Efektywna liczebność = 200 / deff", y = NULL, title = "A. Ile „niezależnych osób” warta jest próba",
       subtitle = "Linia przerywana: 200 osób faktycznie zbadanych") + motyw
pb5 <- ggplot(w5, aes(pokrycie_naiwnego_CI, schemat)) +
  geom_vline(xintercept = .95, colour = "grey40", linetype = "dashed") +
  geom_errorbar(aes(xmin = pokrycie_naiwnego_CI - 1.96 * blad_MC_pokrycia,
                    xmax = pokrycie_naiwnego_CI + 1.96 * blad_MC_pokrycia), orientation = "y", width = 0.25,
                colour = "grey40") +
  geom_point(aes(colour = typ, shape = typ), size = 3.5) +
  scale_colour_manual(values = kol_typ, name = "Względem losowania prostego:") +
  scale_shape_manual(values = ksz_typ, name = "Względem losowania prostego:") +
  scale_x_continuous(limits = c(0.3, 1), breaks = seq(.3, 1, .1), labels = function(x) paste0(100 * x, "%")) +
  labs(x = "Ile przedziałów „95%” obejmuje prawdziwą średnią", y = NULL,
       title = "B. Przedział liczony jak dla losowania prostego",
       subtitle = "Odcinki: ± 1.96 błędu Monte Carlo (1000 badań)") + motyw
p5 <- pa5 / pb5 + plot_layout(guides = "collect") & theme(legend.position = "bottom", legend.title.position = "top")
p5   # zapis: ggsave("schematy-losowania-efekt-schematu.svg", p5, width = 8, height = 8)
6. Jedna próba, analiza zgodna ze schematem (pakiet survey)
R
# Jedno badanie, analiza zgodna ze schematem: pakiet survey (bez rysunku)
library(survey)
set.seed(584)
# a) próba zespołowa: 10 całych grup z 100
pz <- pop[zespolowe(), ]
pz$N_grup <- max(pop$grupa)                          # liczba grup w populacji (poprawka na skończoną populację)
sch_zesp <- svydesign(ids = ~grupa, fpc = ~N_grup, data = pz)
zle_zesp <- svydesign(ids = ~1, fpc = rep(N, nrow(pz)), data = pz)   # błędnie: jak losowanie proste osób
print(svymean(~godziny, sch_zesp, deff = TRUE))
print(svymean(~godziny, zle_zesp))
round(confint(svymean(~godziny, sch_zesp), df = degf(sch_zesp)), 2)    # t z df = liczba grup − 1
# b) próba warstwowa nieproporcjonalna: po 50 osób z każdego wydziału, wagi N_h / 50
pw <- pop[warstwowe_nieprop(), ]
pw$N_h <- as.numeric(table(pop$wydzial)[as.character(pw$wydzial)])
sch_warst <- svydesign(ids = ~1, strata = ~wydzial, fpc = ~N_h, data = pw)
print(svymean(~godziny, sch_warst, deff = TRUE))
round(c(waga_min = min(weights(sch_warst)), waga_max = max(weights(sch_warst)),
        srednia_bez_wag = mean(pw$godziny), prawdziwa = mu_pop), 2)
Wynik w R
           mean      SE   DEff
godziny 17.9210  1.2983 8.7916
          mean     SE
godziny 17.921 0.4379
        2.5 % 97.5 %
godziny 14.98  20.86
            mean       SE   DEff
godziny 16.20240  0.40253 0.9061
       waga_min        waga_max srednia_bez_wag       prawdziwa
           4.00           16.00           17.80           15.91
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy (Humanistyczny / Ekonomiczny)" = c("#0072B2", "#E69F00"),
             "niebieski – zielony (Humanistyczny / Nauk ścisłych)" = c("#0072B2", "#009E73"),
             "niebieski – czarny (Humanistyczny / Lekarski)" = c("#0072B2", "#000000"),
             "pomarańczowy – zielony (Ekonomiczny / Nauk ścisłych)" = c("#E69F00", "#009E73"),
             "pomarańczowy – czarny (Ekonomiczny / Lekarski)" = c("#E69F00", "#000000"),
             "zielony – czarny (Nauk ścisłych / Lekarski)" = c("#009E73", "#000000"),
             "pomarańczowy – jasnoszary tło (Ekonomiczny / niewylosowani)" = c("#E69F00", "#E0E0E0"),
             "niebieski – cynober (dwie listy; precyzyjniej / mniej precyzyjnie)" = c("#0072B2", "#D55E00"),
             "szary – cynober (jak losowanie proste / mniej precyzyjnie)" = c("#666666", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                   widzenie_typowe
niebieski – pomarańczowy (Humanistyczny / Ekonomiczny)                       120.2
niebieski – zielony (Humanistyczny / Nauk ścisłych)                           70.1
niebieski – czarny (Humanistyczny / Lekarski)                                 61.9
pomarańczowy – zielony (Ekonomiczny / Nauk ścisłych)                          88.7
pomarańczowy – czarny (Ekonomiczny / Lekarski)                               104.1
zielony – czarny (Nauk ścisłych / Lekarski)                                   74.8
pomarańczowy – jasnoszary tło (Ekonomiczny / niewylosowani)                   78.7
niebieski – cynober (dwie listy; precyzyjniej / mniej precyzyjnie)           114.6
szary – cynober (jak losowanie proste / mniej precyzyjnie)                    77.4
czerwony – zielony (do unikania)                                             121.7
                                                                   deuteranopia
niebieski – pomarańczowy (Humanistyczny / Ekonomiczny)                    121.5
niebieski – zielony (Humanistyczny / Nauk ścisłych)                        55.4
niebieski – czarny (Humanistyczny / Lekarski)                              62.8
pomarańczowy – zielony (Ekonomiczny / Nauk ścisłych)                       66.3
pomarańczowy – czarny (Ekonomiczny / Lekarski)                            103.5
zielony – czarny (Nauk ścisłych / Lekarski)                                56.6
pomarańczowy – jasnoszary tło (Ekonomiczny / niewylosowani)                75.0
niebieski – cynober (dwie listy; precyzyjniej / mniej precyzyjnie)        108.3
szary – cynober (jak losowanie proste / mniej precyzyjnie)                 64.4
czerwony – zielony (do unikania)                                           21.1
                                                                   protanopia
niebieski – pomarańczowy (Humanistyczny / Ekonomiczny)                  109.3
niebieski – zielony (Humanistyczny / Nauk ścisłych)                      58.0
niebieski – czarny (Humanistyczny / Lekarski)                            62.4
pomarańczowy – zielony (Ekonomiczny / Nauk ścisłych)                     51.5
pomarańczowy – czarny (Ekonomiczny / Lekarski)                           96.6
zielony – czarny (Nauk ścisłych / Lekarski)                              63.3
pomarańczowy – jasnoszary tło (Ekonomiczny / niewylosowani)              73.4
niebieski – cynober (dwie listy; precyzyjniej / mniej precyzyjnie)       91.9
szary – cynober (jak losowanie proste / mniej precyzyjnie)               54.0
czerwony – zielony (do unikania)                                         31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowania, ANOVA do ICC i symulacje – funkcje podstawowe R (pakiet stats); analiza zgodna ze schematem – pakiet survey. Rysunki wykonano w pakiecie ggplot2 (skala kolorów viridis z pakietu viridisLite), panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survey (wersja 4.5): Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- viridisLite (wersja 0.4.3): Garnier, S., Ross, N., Rudis, R., Camargo, P. A., Sciaini, M., & Scherer, C. (2026). viridis(Lite): Colorblind-friendly color maps for R [Computer software]. https://doi.org/10.5281/zenodo.4678326
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Analiza próby zespołowej jak losowania prostego. Błąd standardowy wychodzi kilka razy za mały, a przedział „95%” obejmuje prawdę tylko w około połowie badań (rysunek 5).
- Średnia bez wag przy losowaniu nieproporcjonalnym. Wąski rozkład, ale przesunięty o 1.46 godziny (rysunek 4, wiersz 4b).
- Co k-ta osoba z listy bez sprawdzenia jej układu. Lista z cyklem może dać próbę skrajnie nietypową (rysunek 3).
- „Co dziesiąta osoba od początku listy”. Bez losowego startu to nie jest dobór probabilistyczny.
- Liczenie liczebności próby dla losowania prostego, a losowanie całymi grupami. Pomnóż liczebność przez przewidywany efekt schematu.
- Nazywanie próby dostępnej „losową” albo „reprezentatywną”. Opisz, jak dobrano osoby, i ogranicz uogólnienia.
Najczęstsze pytania
Które losowanie daje najdokładniejszy wynik przy tej samej liczbie osób?
Zwykle warstwowe, gdy warstwy różnią się średnią badanej cechy. W naszej symulacji 1000 badań po 200 osób SD oszacowań wyniosło 0.36 w losowaniu warstwowym proporcjonalnym i 0.40 w prostym (efekt schematu 0.79). Losowanie zespołowe było najmniej dokładne (SD = 1.03), ale bywa jedynym wykonalnym, gdy masz dostęp do całych grup, a nie do listy osób.
Co to jest efektywna liczebność próby przy losowaniu grupami?
To liczba osób z losowania prostego, która dałaby tę samą precyzję: liczebność podzielona przez efekt schematu. W przykładzie 200 studentów z 10 całych grup ćwiczeniowych miało efekt schematu 6.59, czyli było wartych tyle co 30 osób wylosowanych pojedynczo. Przy 20 grupach po 10 osób – 59 osób.
Czy losowanie co k-tej osoby z listy jest losowaniem losowym?
Tak, jeśli punkt startowy wybierasz losowo – każda osoba ma wtedy prawdopodobieństwo 1/k. Sprawdź jednak układ listy. Gdy lista ma cykl zgodny z interwałem, np. w każdej grupie osoby ułożone według ocen, pojedyncza próba może być skrajna: w przykładzie średnia wahała się od 12.30 do 19.13 godziny zależnie od startu.
Czy przy losowaniu warstwowym trzeba ważyć dane?
Przy alokacji proporcjonalnej nie – próba odtwarza udziały warstw. Przy nieproporcjonalnej tak: w przykładzie po 50 osób z wydziałów liczących od 200 do 800 osób średnia bez wag była zawyżona o 1.46 godziny, a przedział „95%” obejmował prawdę tylko w 4.7% badań. Waga to odwrotność prawdopodobieństwa wyboru, tu od 4 do 16.
Jak opisać losowanie próby w rozdziale Metoda?
Podaj operat (jaka lista i z jakiego dnia), schemat losowania, liczebności w warstwach albo liczbę grup i osób w grupie, sposób losowania i to, czy w analizie użyto wag i błędów standardowych uwzględniających grupy. Jeśli próba była dostępna, a nie losowa, napisz to wprost i ogranicz uogólnienia.
Powiązane hasła
Przeczytaj też
Dobór próby w pracy dyplomowej
Metody losowe i nielosowe, co wolno wnioskować z próby wygodnej, symulacja w R, kryteria włączenia i gotowy opis doboru do rozdziału metodologicznego.
Czytaj →PoradnikDobór nielosowy w obrazkach
Próba wygodna, celowa, kwotowa, kula śnieżna i samoselekcja na mapie fikcyjnej uczelni oraz 1000 badań każdym sposobem – sześć rysunków z R.
Czytaj →PoradnikWielkość próby a wielkość populacji w obrazkach
Mapy populacji, krzywe marginesu błędu dla N od 200 do 38 mln, 1000 sondaży w mieście i w kraju, mała populacja i efektywne n – sześć rysunków z R.
Czytaj →PoradnikAnaliza danych z ESS, PGSS i Diagnozy Społecznej
Dostęp i rejestracja, wagi dweight, pspwght i anweight, warstwy i klastry, błędy standardowe ze schematu i regresja w R z wzorem opisu.
Czytaj →Planujesz losowanie próby albo analizujesz dane z grup?
Pomożemy dobrać schemat losowania, policzyć liczebność z uwzględnieniem efektu schematu, przygotować wagi i opisać dobór próby w pracy – tak, żebyś umiał(a) wyjaśnić promotorowi i recenzentowi każdą decyzję.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Berndt, A. E. (2020). Sampling methods. Journal of Human Lactation, 36(2), 224–226. https://doi.org/10.1177/0890334420906850
- Elliott, M. R., & Valliant, R. (2017). Inference for nonprobability samples. Statistical Science, 32(2), 249–264. https://doi.org/10.1214/16-sts598 ● Otwarty dostęp
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08 ● Otwarty dostęp
- Madow, W. G., & Madow, L. H. (1944). On the theory of systematic sampling, I. The Annals of Mathematical Statistics, 15(1), 1–24. https://doi.org/10.1214/aoms/1177731312 ● Otwarty dostęp
- Neyman, J. (1934). On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection. Journal of the Royal Statistical Society, 97(4), 558–625. https://doi.org/10.2307/2342192
- West, B. T., Sakshaug, J. W., & Aurelien, G. A. S. (2016). How big of a problem is analytic error in secondary analyses of survey data? PLOS ONE, 11(6), Article e0158120. https://doi.org/10.1371/journal.pone.0158120 ● Otwarty dostęp
Cytowania BibTeX
@article{berndt2020sampling, author={Berndt, Andrea E.}, title={{Sampling methods}}, journal={Journal of Human Lactation}, year={2020}, volume={36}, number={2}, pages={224--226}, doi={10.1177/0890334420906850}}@article{elliott2017inference, author={Elliott, Michael R. and Valliant, Richard}, title={{Inference for nonprobability samples}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={249--264}, doi={10.1214/16-sts598}}@article{lumley2004analysis, author={Lumley, Thomas}, title={{Analysis of complex survey samples}}, journal={Journal of Statistical Software}, year={2004}, volume={9}, number={8}, doi={10.18637/jss.v009.i08}}@article{madow1944theory, author={Madow, William G. and Madow, Lillian H.}, title={{On the theory of systematic sampling, I}}, journal={The Annals of Mathematical Statistics}, year={1944}, volume={15}, number={1}, pages={1--24}, doi={10.1214/aoms/1177731312}}@article{neyman1934two, author={Neyman, Jerzy}, title={{On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection}}, journal={Journal of the Royal Statistical Society}, year={1934}, volume={97}, number={4}, pages={558--625}, doi={10.2307/2342192}}@article{west2016how, author={West, Brady T. and Sakshaug, Joseph W. and Aurelien, Guy Alain S.}, title={{How big of a problem is analytic error in secondary analyses of survey data?}}, journal={PLOS ONE}, year={2016}, volume={11}, number={6}, eid={e0158120}, doi={10.1371/journal.pone.0158120}}