Jedna uczelnia, pięć sposobów doboru
Większość prac dyplomowych opiera się na próbie nielosowej: ankieta na zajęciach, link w grupie roku, znajomi znajomych. Błędem bywa dopiero zdanie we wnioskach. Ten wpis pokazuje na mapie jednej fikcyjnej uczelni, kto trafia do próby przy doborze wygodnym, celowym, kwotowym, metodą kuli śnieżnej i przy samoselekcji w ankiecie internetowej, a symulacje „1000 badań” – gdzie lądują średnie z takich prób.
Definicje i odmiany metod opisują hasła dobór celowy, dobór wygodny i metoda kuli śnieżnej oraz próba kwotowa. Ogólny przewodnik to dobór próby w pracy dyplomowej, a schematy losowe na podobnej „mapie” pokazuje wpis schematy losowania w obrazkach.
Populacja. Uczelnia liczy 6400 studentów na czterech wydziałach: Humanistycznym (2400 osób), Ekonomicznym (2000), Nauk ścisłych (1200) i Lekarskim (800). Na mapie każda osoba to szary kwadracik, pasy rzędów to roczniki 1–5, a osiem prawych kolumn wydziału – studia niestacjonarne (20% osób). Mierzymy godziny nauki własnej w tygodniu. Dane są fikcyjne, więc znamy prawdziwą średnią: 16.71 h (SD = 5.78), od 14.56 h na Humanistycznym do 22.37 h na Lekarskim. Każda osoba ma też ukrytą skłonność do wypełnienia ankiety internetowej (średnio 0.15), która rośnie z godzinami nauki, jest wyższa u kobiet i niższa po 25. roku życia. To sedno wpisu: chętniej odpowiadają ci, którzy więcej się uczą.
Wszystkie parametry ustawiliśmy ręcznie (lista w sekcji z kodem). Po pierwszym uruchomieniu osłabiliśmy samoselekcję (z 0.9 do 0.5 na logicie na jedno SD godzin) i frekwencję na wykładzie, bo obraz był przerysowany. Ziarna 585 nie zmienialiśmy. Dane pobierzesz jako plik CSV (link w sekcji z kodem).
Rysunek 1: próba wygodna na mapie
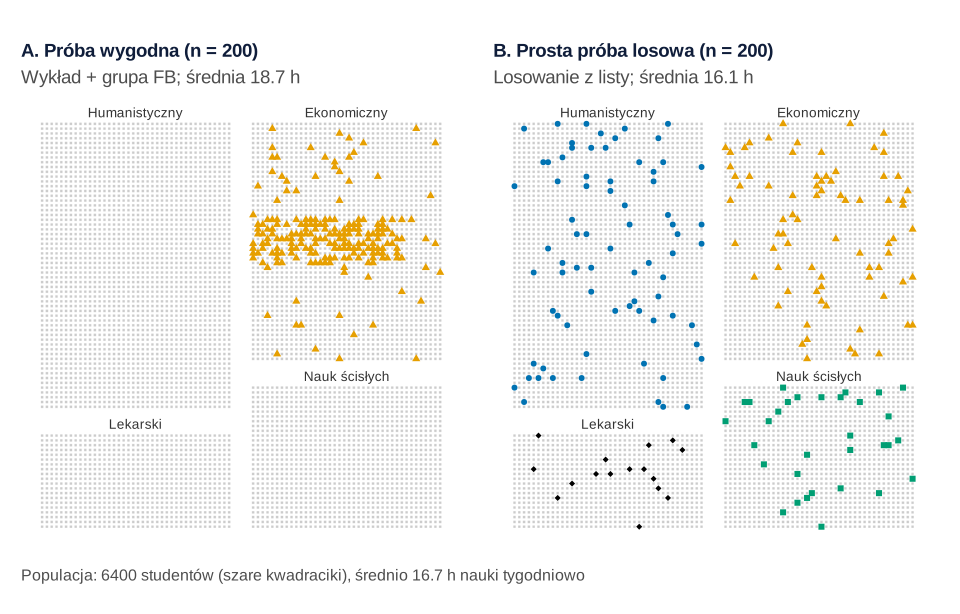
set.seed(585)).Co widać. Autorka pracy studiuje na 3. roku ekonomii. Ankietę rozdała na swoim wykładzie i wrzuciła link do grupy wydziału na Facebooku. Na wykład z listy 320 osób przyszło 138, a resztę do 200 dopełniły 62 osoby z grupy. Na mapie (A) cała próba siedzi w jednym prostokącie, z gęstym pasem jednego rocznika. Średnia wyszła 18.75 h, o dwie godziny za dużo: na wykład częściej przychodzą osoby, które więcej się uczą, a w grupie pierwsi odpowiadają najchętniejsi. Prosta próba losowa (panel B) rozsiewa się po całej mapie: 38.50% osób z ekonomii i średnia 16.11 h.
Jak może zmylić. Losowa próba też chybiła, tylko o 0.6 h i w przypadkowym kierunku – z jednej mapy nie odróżnisz błędu losowego od systematycznego (do tego służą rysunki 3 i 6). Mapa nie zdradza też, że 138 osób z jednej sali to skupienie, a nie 138 niezależnych odpowiedzi – zob. badanie na studentach i ankieta na zajęciach.
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: dobór celowy i kwotowy
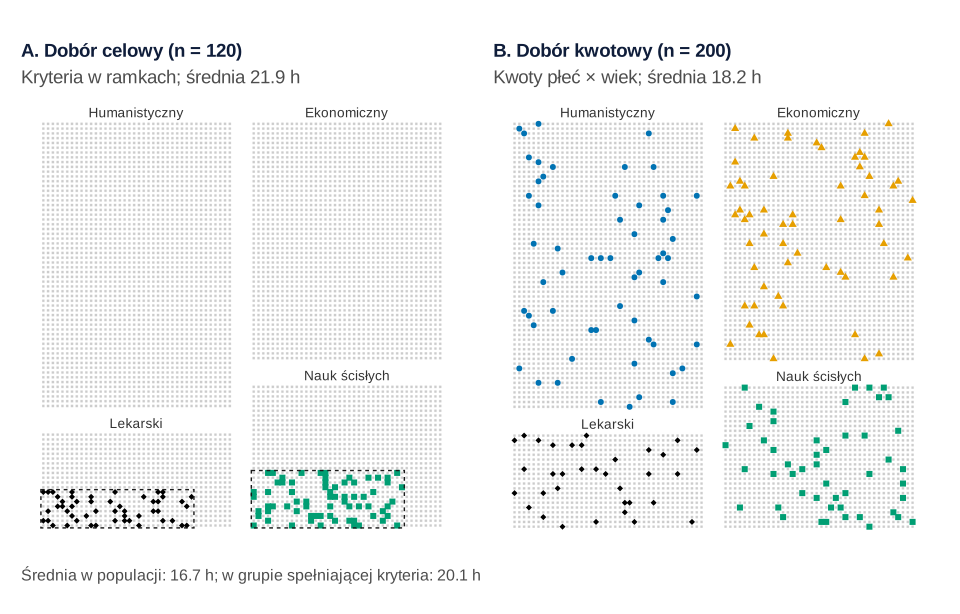
set.seed(585)).Co widać. Panel A to dobór celowy w badaniu ilościowym: pytanie dotyczy studentów stacjonarnych 4. i 5. roku na wydziałach Lekarskim i Nauk ścisłych. Ramki to kryteria włączenia – 640 osób o średniej 20.13 h. Zaproszenie poszło przez starostów, a ankietę zamknięto po 120 odpowiedziach. Punkty leżą w ramkach, ale średnia wynosi 21.90 h: kryteria zawęziły populację, a w jej obrębie znów zadziałała samoselekcja. Andrade (2021) podkreśla, że wyniki z prób wygodnych i celowych można uogólniać tylko na (pod)populację, z której pobrano próbę.
Panel B to dobór kwotowy. Kwoty płci i trzech grup wieku (19–21, 22–24, 25+) są proporcjonalne do populacji, np. 48 kobiet w wieku 19–21 lat i 13 mężczyzn po 25. roku życia; w każdej komórce przyjmowano pierwsze zgłoszenia z całej uczelni. Mapa wygląda „porządnie”: kobiety stanowią 61.50%, osoby 25+ – 16.50%, prawie jak w populacji. Mimo to średnia wynosi 18.16 h. Wydział Lekarski, gdzie uczy się najwięcej, ma w próbie 17.0% osób wobec 12.5% w populacji, a studenci niestacjonarni to 17% próby wobec 20% w populacji.
Jak może zmylić. Rozproszone punkty kuszą, by uznać próbę kwotową za „prawie losową”, ale wydział, tryb studiów i godziny nauki nie były w kwotach i rozjechały się swobodnie.
Podpis do pracy:
Zdanie do Metody (dobór kwotowy):
Rysunek 3: kwoty trafiają w strukturę, nie w średnią
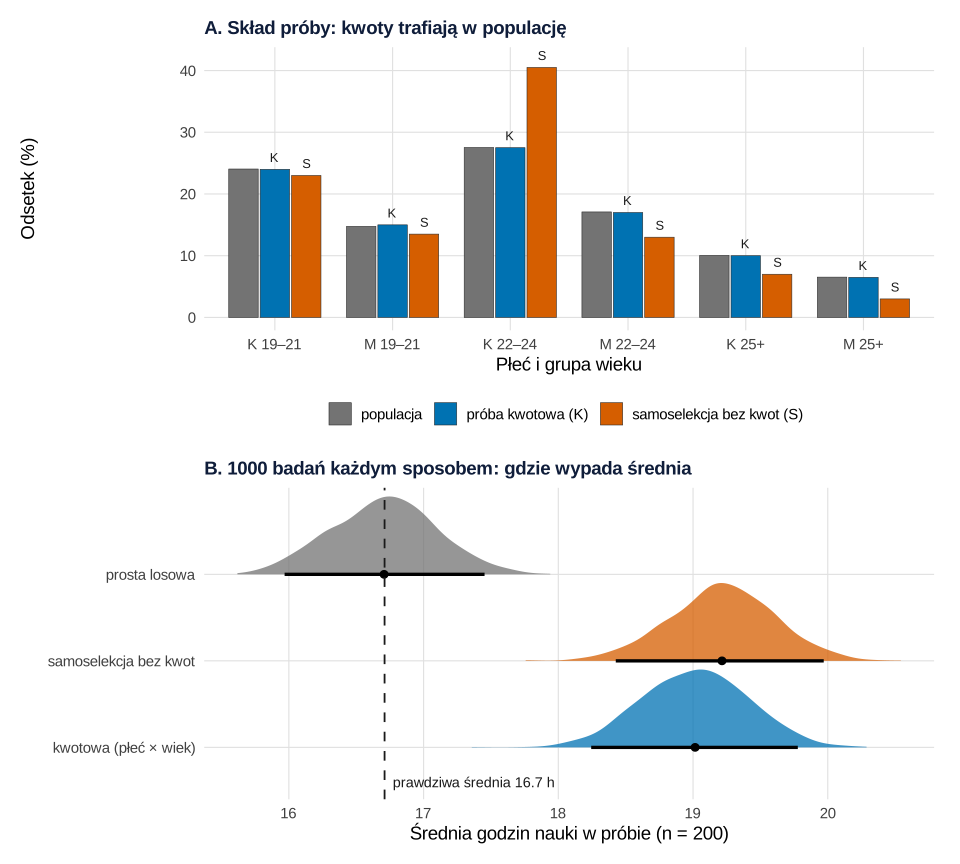
set.seed(585)).Co widać. Panel A: w jednej próbie z samoselekcji bez kwot kobiety w wieku 22–24 lat stanowią 40.5% wobec 27.5% w populacji, a mężczyźni po 25. roku życia – 3.0% wobec 6.5%. Próba kwotowa trafia w populację. Panel B to 1000 badań po 200 osób każdym sposobem. Prosta próba losowa daje obciążenie 0.00 h, samoselekcja bez kwot przesuwa cały rozkład o 2.50 h, a kwoty zmniejszają przesunięcie tylko do 2.31 h. Rozrzut (SD oszacowań) jest wszędzie taki sam, 0.39 h; różni się wyłącznie położenie. To dwa składniki błędu: obciążenie to przesunięcie środka, precyzja – szerokość.
Kwoty naprawiły tylko część obciążenia idącą przez płeć i wiek (0.19 h z 2.50 h), bo w każdej komórce i tak zgłaszają się najpierw osoby uczące się więcej. Mercer i in. (2017) opisują, w jakich warunkach próba nielosowa daje oszacowania wolne od obciążenia selekcyjnego, przez analogię do wnioskowania przyczynowego z danych obserwacyjnych. Kwoty działałyby, gdyby w obrębie komórki udział nie zależał od mierzonej cechy.
Czego ten wykres nie pokazuje. W prawdziwym badaniu masz jedną próbę i nie znasz prawdziwej średniej. Siła samoselekcji jest tu założeniem; w innej populacji przesunięcie może być mniejsze, większe albo w drugą stronę.
Podpis do pracy:
Zdanie do Ograniczeń:
Rysunek 4: kula śnieżna jako sieć zaproszeń
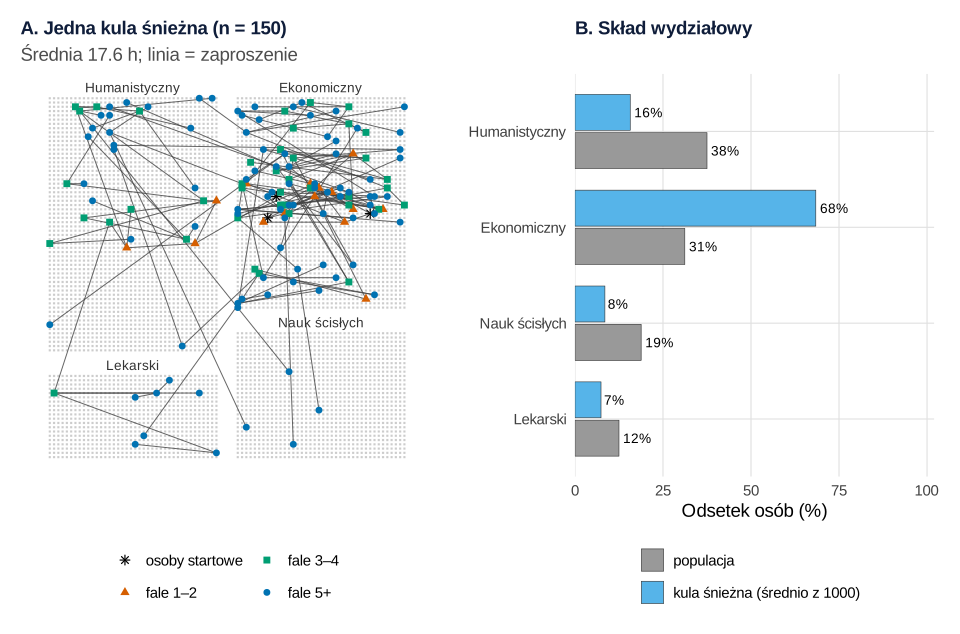
set.seed(585)).Co widać. Fikcyjna sieć znajomości: każdy student wskazuje trzech znajomych – w 70% z tego samego wydziału i rocznika, w 20% z innego rocznika wydziału, w 10% z dowolnego miejsca uczelni (razem 19 057 znajomości, średnio 5.96 na osobę). Kula startuje od trzech znajomych autorki z 3. roku ekonomii; każdy uczestnik zaprasza do trzech znajomych. W panelu A linia łączy zapraszającego z zaproszonym. Do 150 osób kula potrzebowała sześciu fal, a 69.33% uczestników pochodzi z ekonomii. Panel B uśrednia 1000 takich rekrutacji: ekonomia to 68.4% próby wobec 31.2% w populacji, a wydział Humanistyczny – 15.7% wobec 37.5%.
Średnia godzin z 1000 kul to 17.74 h, czyli obciążenie 1.03 h. Rozrzut oszacowań (SD = 0.79 h) jest wyraźnie większy niż w prostej próbie losowej tej samej wielkości (0.47 h). Kula to kilka skupisk znajomych, a nie 150 niezależnych osób. W klasycznym ujęciu Goodmana (1961) próba początkowa jest losowa, a dane z kolejnych etapów służą do wnioskowania o relacjach między ludźmi, a nie o średniej w populacji.
Jak może zmylić. W prawdziwym badaniu nie znasz sieci ani liczby odmów, a kilka „dalekich” linii nie oznacza, że kula dotarła wszędzie. Dla populacji naprawdę ukrytych (brak operatu) istnieje metoda z kuponami i ważeniem – dobór sterowany przez respondentów (RDS).
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: samoselekcja w ankiecie internetowej
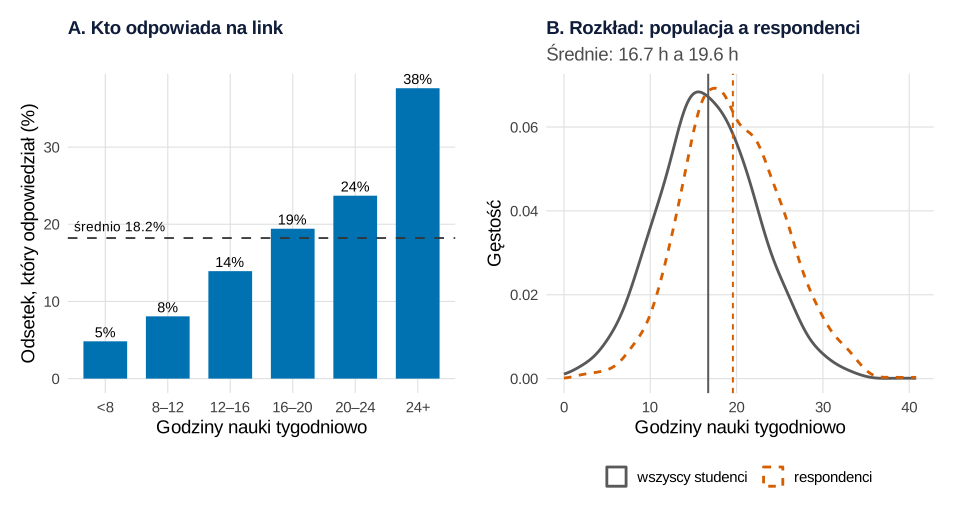
set.seed(585)).Co widać. Link poszedł mailem do wszystkich 6400 studentów. Odpowiedziało 1166 osób (18.22%; zob. wskaźnik odpowiedzi). Panel A pokazuje to, czego badacz nie widzi: wśród osób uczących się mniej niż 8 h tygodniowo odpowiedziało 4.8%, a wśród uczących się 24 h lub więcej – 37.6%. W panelu B rozkład respondentów jest przesunięty w prawo: średnia 19.57 h wobec 16.71 h w populacji. Bethlehem (2010) opisuje dwa źródła obciążenia ankiet internetowych – niedopokrycie i samoselekcję – i dochodzi do wniosku, że problem dostępu do internetu może z czasem zniknąć, ale samoselekcja prowadzi do niewiarygodnych wyników.
Czego ten wykres nie pokazuje. W prawdziwej ankiecie panelu A nie narysujesz, bo nie znasz godzin nauki osób, które nie odpowiedziały. Porównasz tylko cechy znane dla wszystkich (płeć, wydział, tryb), a ich zgodność nic nie mówi o cesze mierzonej (rysunek 3). Mechanizm ten opisują hasło błąd selekcji i wpis próba reprezentatywna w obrazkach (braki odpowiedzi i ważenie).
Podpis do pracy:
Zdanie do Metody:
Rysunek 6: większa próba nie usuwa obciążenia
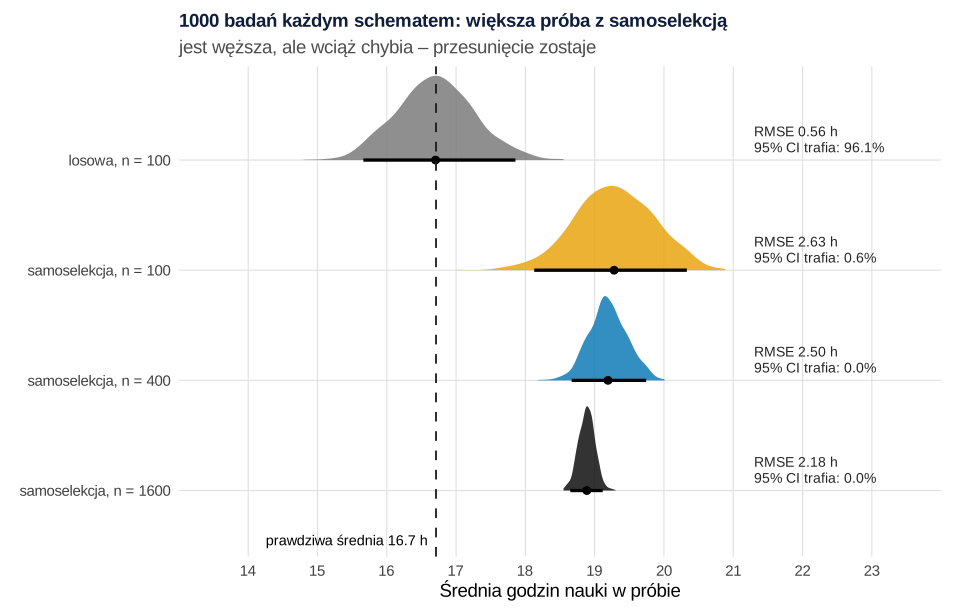
set.seed(585)).Co widać. Ankietę z samoselekcją zamykamy po n pierwszych odpowiedziach (n = 100, 400, 1600), za każdym razem 1000 razy; dla porównania – 1000 prostych prób losowych po 100 osób. Rozkład samoselekcji się zwęża (SD oszacowań z 0.57 do 0.12 h), a środek prawie stoi: obciążenie 2.57, 2.48 i 2.18 h. Błąd średniokwadratowy (RMSE) dużej próby z samoselekcją, 2.18 h, jest prawie cztery razy większy niż małej próby losowej (0.56 h). Niewielki spadek przy n = 1600 wynika z tego, że to już czwarta część populacji, więc trafiają też mniej chętni; obciążenie zniknęłoby dopiero, gdyby odpowiedzieli prawie wszyscy.
Zwykły 95% przedział ufności dla średniej obejmował prawdziwą wartość w 96.1% prób losowych (błąd Monte Carlo 0.6 pp), ale tylko w 0.6% ankiet z samoselekcją przy n = 100 (błąd MC 0.2 pp). Przy n = 400 i 1600 – w żadnej. Im większa próba, tym węższy przedział wokół złej wartości. Elliott i Valliant (2017) zwracają uwagę, że wnioskowanie oparte na schemacie losowania nie ma zastosowania do prób nieprobabilistycznych; alternatywą są modele (pseudo-prawdopodobieństwa włączenia albo modelowanie superpopulacji). Co znaczy „95%”, pokazuje wpis przedział ufności w obrazkach, ten sam paradoks w sondażach – sondaż w obrazkach, a podział błędu na obciążenie i wariancję – całkowity błąd badania sondażowego.
Jak może zmylić. Gdyby chęć udziału nie wiązała się z godzinami nauki, wszystkie rozkłady leżałyby na linii. Symulacja nie dowodzi, że każda ankieta internetowa jest obciążona – pokazuje, że duże n nie chroni przed obciążeniem, jeśli ono istnieje.
Podpis do pracy:
Zdanie do Ograniczeń:
Co wolno napisać w pracy
Student zwykle ma próbę dostępną: zajęcia, link w grupie, kulę znajomych. To normalne i nie dyskwalifikuje pracy, zwłaszcza gdy celem są związki między zmiennymi, a nie odsetek w populacji. Cornesse i in. (2020) ujmują to tak: zaufanie do prób losowych uzasadnia teoria statystyczna, a trafność wnioskowania z prób nielosowych zależy w całości od modeli i założeń. W pracy wynikają z tego cztery rzeczy:
- Nazwij dobór wprost („dobór wygodny”, „kwotowy według płci i wieku”, „metodą kuli śnieżnej od trzech osób”) i opisz drogę rekrutacji: gdzie, kiedy, ile osób zaproszono, ile odpowiedziało (wzory przy rysunkach 1, 2, 4 i 5; zob. też rozdział metodologiczny).
- Nazwij populację, której dotyczą wnioski, i nie podawaj średnich ani odsetków z próby jako wartości dla całej populacji. Ograniczenie uogólniania to sprawa trafności zewnętrznej.
- Porównaj strukturę próby z populacją (płeć, wiek, wydział), pamiętając, że zgodność tych cech nie gwarantuje braku obciążenia (rysunki 2 i 3). O słowie „reprezentatywna” – hasło reprezentatywność próby.
- W ograniczeniach wskaż kierunek możliwego obciążenia (np. „bardziej zaangażowani chętniej odpowiadali, więc średni czas nauki może być zawyżony”) – zob. ograniczenia badania – jak je opisać.
Jak rozproszyć rekrutację, opisuje poradnik gdzie znaleźć respondentów do ankiety, a zasady rysunków – wykresy w pracy dyplomowej.
Kod R wszystkich rysunków i liczb
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 definiuje motyw, paletę, populację i funkcję rysującą mapę, z których korzystają następne. Każdy przepis tworzy obiekt wykresu (p1–p6); wpisz jego nazwę, żeby go wyświetlić, a do zapisu użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały dokładnie z tego kodu: motyw to skrócona wersja motywu serwisu, a pliki zapisano w formacie SVG. Tło mapy to jeden obrazek rastrowy (geom_raster), dzięki czemu plik z 6400 osobami waży kilkadziesiąt kilobajtów.
Dane są fikcyjne, a wszystkie parametry (liczebności i średnie wydziałów, efekty płci i trybu studiów, współczynniki skłonności do odpowiedzi, frekwencja na wykładzie, proporcje znajomości w sieci, wielkości prób) ustawiliśmy ręcznie. Po pierwszym uruchomieniu osłabiliśmy samoselekcję i frekwencję na wykładzie, żeby efekt nie był przerysowany. Każdy blok, który losuje (przepisy 1–6), zaczyna od set.seed(585); ziarno ustaliliśmy raz i go nie zmienialiśmy. Symulacje mają po 1000 powtórzeń; przy odsetkach przedziałów trafiających w prawdziwą średnią podajemy błąd Monte Carlo. Całą populację pobierzesz jako plik dobor-nielosowy-populacja.csv (6400 wierszy; kolumny id, wydzial, rok, tryb, plec, wiek, godziny, sklonnosc oraz współrzędne mapy x, y).
1. Motyw, populacja, mapa i próba wygodna: Rysunek 1
R
# Rysunek 1. Fikcyjna uczelnia jako „mapa” 6400 studentów: próba wygodna (wykład + grupa na FB) i próba losowa
options(width = 100)
library(ggplot2)
library(patchwork)

# Krótki motyw i paleta Okabe–Ito dla wydziałów (kolor + kształt; sprawdzona w symulacji deuteranopii)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25"), strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
kol_wydz <- c("Humanistyczny" = "#0072B2", "Ekonomiczny" = "#E69F00", "Nauk ścisłych" = "#009E73",
              "Lekarski" = "black")
ksz_wydz <- c("Humanistyczny" = 16, "Ekonomiczny" = 17, "Nauk ścisłych" = 15, "Lekarski" = 18)

# Populacja (dane fikcyjne): 4 wydziały jako prostokąty 40 osób szerokości; pasy rzędów = roczniki 1–5,
# prawe 8 kolumn = studia niestacjonarne. Parametry ustalone ręcznie (liczebności, średnie, efekty, skłonność)
set.seed(585)                                        # ziarno ustalone raz, bez dobierania pod wynik
wydz <- data.frame(wydzial = names(kol_wydz), rzedy = c(60, 50, 30, 20), mu = c(14, 16, 18, 22),
                   x0 = c(0, 44, 44, 0), y0 = c(0, 0, -55, -65), k = c(.75, .55, .40, .70))
pop <- do.call(rbind, lapply(1:4, function(w) {
  d <- expand.grid(kol = 1:40, rzad = 1:wydz$rzedy[w])
  data.frame(wydzial = wydz$wydzial[w], x = wydz$x0[w] + d$kol, y = wydz$y0[w] - d$rzad,
             rok = (d$rzad - 1) %/% (wydz$rzedy[w] / 5) + 1,
             tryb = ifelse(d$kol > 32, "niestacjonarne", "stacjonarne"), mu = wydz$mu[w], k = wydz$k[w])
}))
pop$wydzial <- factor(pop$wydzial, names(kol_wydz))
N <- nrow(pop)
pop$plec <- ifelse(runif(N) < pop$k, "K", "M")
pop$wiek <- ifelse(pop$tryb == "stacjonarne", 18 + pop$rok + rbinom(N, 2, 0.3), 20 + pop$rok + round(rexp(N, 1 / 5)))
pop$wiek_gr <- cut(pop$wiek, c(0, 21, 24, Inf), labels = c("19–21", "22–24", "25+"))
# Cecha mierzona: godziny nauki własnej tygodniowo
pop$godziny <- pmax(0, round(pop$mu + 1.5 * (pop$plec == "K") - 3 * (pop$tryb == "niestacjonarne") +
                               rnorm(N, 0, 5), 1))
pop$z <- as.numeric(scale(pop$godziny))
# Skłonność do wypełnienia ankiety internetowej: rośnie z godzinami nauki, wyższa u kobiet, niższa po 25. r.ż.
pop$sklonnosc <- plogis(-2.0 + 0.5 * pop$z + 0.4 * (pop$plec == "K") - 0.5 * (pop$wiek_gr == "25+"))
pop$id <- seq_len(N)
# write.csv(transform(pop[, c("id", "wydzial", "rok", "tryb", "plec", "wiek", "godziny", "sklonnosc", "x", "y")], sklonnosc = round(sklonnosc, 4)),
#           "dobor-nielosowy-populacja.csv", row.names = FALSE)   # te same dane co w pliku CSV

mu_pop <- mean(pop$godziny)                          # prawdziwa średnia – znana, bo populacja jest fikcyjna
round(c(N = N, srednia = mu_pop, SD = sd(pop$godziny), proc_K = 100 * mean(pop$plec == "K"),
        proc_niestac = 100 * mean(pop$tryb == "niestacjonarne"), sr_sklonnosc = mean(pop$sklonnosc)), 2)
aggregate(godziny ~ wydzial, pop, function(v) round(c(N = length(v), srednia = mean(v)), 2))

# Tło mapy: każda osoba to jasnoszary kwadracik; między osobami i wydziałami – białe przerwy
siatka <- expand.grid(x = seq(1, max(pop$x), by = 0.5), y = seq(min(pop$y), -1, by = 0.5))
siatka$fill <- ifelse(paste(siatka$x, siatka$y) %in% paste(pop$x, pop$y), "grey80", "white")
etyk_w <- data.frame(x = wydz$x0 + 20.5, y = wydz$y0 + 0.4, wydzial = wydz$wydzial)
mapa <- function(wybrani, tytul, podtytul) {
  ggplot(wybrani, aes(x, y)) +
    geom_raster(data = siatka, aes(x, y, fill = I(fill))) +
    geom_point(aes(colour = wydzial, shape = wydzial), size = 1.7) +
    geom_text(data = etyk_w, aes(label = wydzial), vjust = 0, size = 3.6, colour = "grey20") +
    scale_colour_manual(values = kol_wydz, guide = "none") +   # wydział podpisany na mapie
    scale_shape_manual(values = ksz_wydz, guide = "none") +
    coord_equal(clip = "off") + labs(title = tytul, subtitle = podtytul) + motyw +
    theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
}

# Próba wygodna: ankieta na wykładzie (3. rok ekonomii, stacjonarne) + post w grupie wydziału na FB.
# Na wykład częściej przychodzą osoby, które więcej się uczą; w grupie FB odpowiadają najpierw najchętniejsi
set.seed(585)
wyklad <- which(pop$wydzial == "Ekonomiczny" & pop$rok == 3 & pop$tryb == "stacjonarne")
obecni <- wyklad[runif(length(wyklad)) < plogis(-0.4 + 1.2 * pop$z[wyklad])]
fb <- setdiff(which(pop$wydzial == "Ekonomiczny"), obecni)
fb <- fb[order(rexp(length(fb)) / pop$sklonnosc[fb])]   # kolejność zgłoszeń: najpierw najbardziej skłonni
wygodna <- c(obecni, fb)[1:200]
losowa <- sample(N, 200)                             # dla porównania: prosta próba losowa n = 200
opis <- function(i) round(c(n = length(i), srednia = mean(pop$godziny[i]),
                            proc_ekon = 100 * mean(pop$wydzial[i] == "Ekonomiczny"),
                            proc_K = 100 * mean(pop$plec[i] == "K")), 2)
c(na_wykladzie = length(obecni), na_liscie_roku = length(wyklad), z_grupy_fb = 200 - length(obecni))
rbind(populacja = opis(1:N), wygodna = opis(wygodna), losowa = opis(losowa))

p1 <- mapa(pop[wygodna, ], "A. Próba wygodna (n = 200)",
           sprintf("Wykład + grupa FB; średnia %.1f h", mean(pop$godziny[wygodna]))) +
  mapa(pop[losowa, ], "B. Prosta próba losowa (n = 200)",
       sprintf("Losowanie z listy; średnia %.1f h", mean(pop$godziny[losowa]))) +
  plot_annotation(caption = sprintf("Populacja: %d studentów (szare kwadraciki), średnio %.1f h nauki tygodniowo",
                                    N, mu_pop)) &
  theme(plot.caption = element_text(size = 12, colour = "grey30", hjust = 0))
# p1   # zapis: ggsave("dobor-nielosowy-mapa-wygodna.svg", p1, width = 10, height = 6.4)
Wynik w R
           N      srednia           SD       proc_K proc_niestac sr_sklonnosc
     6400.00        16.71         5.78        61.62        20.00         0.15
        wydzial godziny.N godziny.srednia
1 Humanistyczny   2400.00           14.56
2   Ekonomiczny   2000.00           16.30
3 Nauk ścisłych   1200.00           17.92
4      Lekarski    800.00           22.37
  na_wykladzie na_liscie_roku     z_grupy_fb
           138            320             62
             n srednia proc_ekon proc_K
populacja 6400   16.71     31.25  61.62
wygodna    200   18.75    100.00  69.00
losowa     200   16.11     38.50  59.00
2. Dobór celowy i kwotowy: Rysunek 2
R
# Rysunek 2. Dobór celowy (kryteria włączenia) i dobór kwotowy (kwoty płeć × wiek) na tej samej mapie
set.seed(585)                                        # kontynuacja: pop, mapa(), motyw z bloku 1

# Czas zgłoszenia każdej osoby do ankiety internetowej: im większa skłonność, tym wcześniej
czas <- rexp(N) / pop$sklonnosc

# Dobór celowy: kryteria – 4. i 5. rok, studia stacjonarne, wydział Lekarski lub Nauk ścisłych;
# zaproszenie przez starostów roczników, ankietę zamykamy po 120 odpowiedziach
kryteria <- which(pop$rok >= 4 & pop$tryb == "stacjonarne" & pop$wydzial %in% c("Lekarski", "Nauk ścisłych"))
celowa <- kryteria[order(czas[kryteria])][1:120]

# Dobór kwotowy: kwoty płeć × grupa wieku proporcjonalne do populacji (n = 200); w każdej komórce
# trafiają do próby osoby, które zgłosiły się najwcześniej (ankieta rozesłana na całą uczelnię)
kom <- interaction(pop$plec, pop$wiek_gr, sep = " ")
kwoty <- round(200 * prop.table(table(kom)))
kwoty; sum(kwoty)
kwotowa <- unlist(lapply(names(kwoty), function(k) {
  ids <- which(kom == k); ids[order(czas[ids])][seq_len(kwoty[[k]])]
}))
opis2 <- function(i) round(c(n = length(i), srednia = mean(pop$godziny[i]), proc_K = 100 * mean(pop$plec[i] == "K"),
                             proc_25plus = 100 * mean(pop$wiek_gr[i] == "25+"),
                             proc_niestac = 100 * mean(pop$tryb[i] == "niestacjonarne")), 2)
rbind(populacja = opis2(1:N), grupa_z_kryteriow = opis2(kryteria), celowa = opis2(celowa), kwotowa = opis2(kwotowa))
round(100 * prop.table(table(pop$wydzial[kwotowa])), 1)        # skład wydziałowy próby kwotowej

ramka <- data.frame(xmin = c(44.5, 0.5), xmax = c(76.5, 32.5),      # obszar spełniający kryteria
                    ymin = c(-85.5, -85.5), ymax = c(-73.5, -77.5))
p2 <- (mapa(pop[celowa, ], "A. Dobór celowy (n = 120)",
            sprintf("Kryteria w ramkach; średnia %.1f h", mean(pop$godziny[celowa]))) +
         geom_rect(data = ramka, aes(xmin = xmin, xmax = xmax, ymin = ymin, ymax = ymax), inherit.aes = FALSE,
                   fill = NA, colour = "grey10", linewidth = 0.5, linetype = "22")) +
  mapa(pop[kwotowa, ], sprintf("B. Dobór kwotowy (n = %d)", length(kwotowa)),
       sprintf("Kwoty płeć × wiek; średnia %.1f h", mean(pop$godziny[kwotowa]))) +
  plot_annotation(caption = sprintf("Średnia w populacji: %.1f h; w grupie spełniającej kryteria: %.1f h",
                                    mu_pop, mean(pop$godziny[kryteria]))) &
  theme(plot.caption = element_text(size = 12, colour = "grey30", hjust = 0))
# p2   # zapis: ggsave("dobor-nielosowy-mapa-celowa-kwotowa.svg", p2, width = 10, height = 6.4)
Wynik w R
kom
K 19–21 M 19–21 K 22–24 M 22–24   K 25+   M 25+
     48      30      55      34      20      13
[1] 200
                     n srednia proc_K proc_25plus proc_niestac
populacja         6400   16.71  61.62       16.58           20
grupa_z_kryteriow  640   20.13  48.59        4.69            0
celowa             120   21.90  56.67        4.17            0
kwotowa            200   18.16  61.50       16.50           17

Humanistyczny   Ekonomiczny Nauk ścisłych      Lekarski
         29.0          29.5          24.5          17.0
3. Kwoty a 1000 badań: Rysunek 3
R
# Rysunek 3. Kwoty wyrównują strukturę płci i wieku, ale nie średnią: 1000 badań każdym sposobem doboru
library(ggdist)                                      # kontynuacja: pop, kom, kwoty, motyw z bloków 1–2
set.seed(585)

samoselekcja <- function(n) order(rexp(N) / pop$sklonnosc)[1:n]   # n pierwszych zgłoszeń, bez kwot
kwotowa_f <- function() {
  czas <- rexp(N) / pop$sklonnosc
  unlist(lapply(names(kwoty), function(k) { ids <- which(kom == k); ids[order(czas[ids])][seq_len(kwoty[[k]])] }))
}
R <- 1000
wyniki3 <- data.frame(
  schemat = rep(c("prosta losowa", "samoselekcja bez kwot", "kwotowa (płeć × wiek)"), each = R),
  srednia = c(replicate(R, mean(pop$godziny[sample(N, 200)])),
              replicate(R, mean(pop$godziny[samoselekcja(200)])),
              replicate(R, mean(pop$godziny[kwotowa_f()]))))
wyniki3$schemat <- factor(wyniki3$schemat, c("kwotowa (płeć × wiek)", "samoselekcja bez kwot", "prosta losowa"))
podsum3 <- do.call(rbind, lapply(split(wyniki3$srednia, wyniki3$schemat), function(s)
  round(c(srednia_oszacowan = mean(s), obciazenie = mean(s) - mu_pop, SD_oszacowan = sd(s),
          RMSE = sqrt(mean((s - mu_pop)^2))), 2)))
podsum3

# Struktura płeć × wiek: populacja, jedna próba kwotowa i jedna próba z samoselekcji bez kwot (n = 200)
jedna_ss <- samoselekcja(200)
struktura <- rbind(
  data.frame(zrodlo = "populacja", prop.table(table(komorka = kom))),
  data.frame(zrodlo = "próba kwotowa", prop.table(table(komorka = kom[kwotowa]))),
  data.frame(zrodlo = "samoselekcja bez kwot", prop.table(table(komorka = kom[jedna_ss]))))
struktura$zrodlo <- factor(struktura$zrodlo, c("populacja", "próba kwotowa", "samoselekcja bez kwot"))
xtabs(round(100 * Freq, 1) ~ zrodlo + komorka, struktura)

kol3 <- c("populacja" = "grey45", "próba kwotowa" = "#0072B2", "samoselekcja bez kwot" = "#D55E00",
          "prosta losowa" = "grey45", "kwotowa (płeć × wiek)" = "#0072B2")
pa <- ggplot(struktura, aes(komorka, 100 * Freq, fill = zrodlo)) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75, colour = "grey15", linewidth = 0.2) +
  geom_text(aes(label = c("", "K", "S")[as.integer(zrodlo)], y = 100 * Freq + 1.2),   # litera = źródło
            position = position_dodge(width = 0.8), size = 3.4, vjust = 0, colour = "grey10") +
  scale_fill_manual(values = kol3[1:3], name = NULL,
                    labels = c("populacja", "próba kwotowa (K)", "samoselekcja bez kwot (S)")) +
  labs(x = "Płeć i grupa wieku", y = "Odsetek (%)", title = "A. Skład próby: kwoty trafiają w populację") + motyw
pb <- ggplot(wyniki3, aes(srednia, schemat, fill = schemat)) +
  stat_halfeye(.width = 0.95, point_interval = "mean_qi", slab_alpha = 0.75, normalize = "groups") +
  geom_vline(xintercept = mu_pop, linetype = "dashed", colour = "grey10") +
  annotate("text", x = mu_pop, y = 0.6, label = sprintf("prawdziwa średnia %.1f h", mu_pop),
           hjust = -0.05, size = 3.8, colour = "grey10") +
  scale_fill_manual(values = kol3, guide = "none") +
  labs(x = "Średnia godzin nauki w próbie (n = 200)", y = NULL,
       title = "B. 1000 badań każdym sposobem: gdzie wypada średnia") + motyw
p3 <- pa / pb + plot_layout(heights = c(1, 1.1))
# p3   # zapis: ggsave("dobor-nielosowy-kwoty-1000-badan.svg", p3, width = 10, height = 9)
Wynik w R
                      srednia_oszacowan obciazenie SD_oszacowan RMSE
kwotowa (płeć × wiek)             19.02       2.31         0.39 2.34
samoselekcja bez kwot             19.21       2.50         0.39 2.53
prosta losowa                     16.71       0.00         0.39 0.39
                       komorka
zrodlo                  K 19–21 M 19–21 K 22–24 M 22–24 K 25+ M 25+
  populacja                24.0    14.8    27.5    17.1  10.0   6.5
  próba kwotowa            24.0    15.0    27.5    17.0  10.0   6.5
  samoselekcja bez kwot    23.0    13.5    40.5    13.0   7.0   3.0
4. Kula śnieżna w sieci znajomości: Rysunek 4
R
# Rysunek 4. Kula śnieżna: kto kogo zaprosił (sieć na mapie uczelni) i skład wydziałowy z 1000 powtórzeń
suppressPackageStartupMessages(library(igraph))   # kontynuacja: pop, siatka, motyw z bloku 1
library(ggraph)
set.seed(585)

# Sieć znajomości (fikcyjna): każdy wskazuje 3 znajomych – 70% z tego samego wydziału i rocznika,
# 20% z innego rocznika tego samego wydziału, 10% z dowolnego miejsca uczelni (proporcje ustalone ręcznie)
grupa_wr <- split(pop$id, paste(pop$wydzial, pop$rok)); grupa_w <- split(pop$id, pop$wydzial)
znajomy <- function(i) {
  u <- runif(1)
  pula <- if (u < 0.7) grupa_wr[[paste(pop$wydzial[i], pop$rok[i])]] else if (u < 0.9) grupa_w[[pop$wydzial[i]]] else pop$id
  pula[sample.int(length(pula), 1)]
}
kraw <- data.frame(od = rep(pop$id, each = 3)); kraw$do <- vapply(kraw$od, znajomy, integer(1))
siec <- simplify(graph_from_data_frame(kraw, directed = FALSE, vertices = pop["id"]))
sasiedzi <- lapply(as_adj_list(siec), as.integer)
round(c(osob = vcount(siec), znajomosci = ecount(siec), sredni_stopien = mean(degree(siec))), 2)

# Kula śnieżna: 3 osoby startowe (znajomi autora z 3. roku ekonomii), każdy uczestnik zaprasza do 3 znajomych;
# osobiste zaproszenie przyjmuje się chętniej niż post (szansa na logicie wyższa o 2), stop przy 150 osobach
kula <- function(n_max = 150) {
  start <- which(pop$wydzial == "Ekonomiczny" & pop$rok == 3 & pop$tryb == "stacjonarne")
  ucz <- start[sample.int(length(start), 3)]; fala <- rep(0L, 3); kto <- rep(NA_integer_, 3)
  biezacy <- ucz; f <- 0L
  while (length(ucz) < n_max && length(biezacy) > 0) {
    f <- f + 1L; nowi <- integer(0); od <- integer(0)
    for (i in biezacy) {
      zn <- setdiff(sasiedzi[[i]], c(ucz, nowi))
      if (!length(zn)) next
      zapr <- zn[sample.int(length(zn), min(3, length(zn)))]
      tak <- zapr[runif(length(zapr)) < plogis(qlogis(pop$sklonnosc[zapr]) + 2)]
      nowi <- c(nowi, tak); od <- c(od, rep(i, length(tak)))
    }
    ucz <- c(ucz, nowi); fala <- c(fala, rep(f, length(nowi))); kto <- c(kto, od); biezacy <- nowi
  }
  k <- seq_len(min(n_max, length(ucz)))
  data.frame(id = ucz[k], fala = fala[k], zaprosil = kto[k])
}
jedna <- kula()
table(fala = jedna$fala)
round(c(n = nrow(jedna), srednia = mean(pop$godziny[jedna$id]),
        proc_ekon = 100 * mean(pop$wydzial[jedna$id] == "Ekonomiczny")), 2)

# 1000 powtórzeń: średnia godzin i skład wydziałowy
R <- 1000
powt <- replicate(R, { k <- kula(); c(srednia = mean(pop$godziny[k$id]), n = nrow(k),
                                     table(pop$wydzial[k$id]) / nrow(k)) })
round(c(srednia_oszacowan = mean(powt["srednia", ]), obciazenie = mean(powt["srednia", ]) - mu_pop,
        SD_oszacowan = sd(powt["srednia", ]), proc_prob_ponizej_150 = 100 * mean(powt["n", ] < 150),
        SD_losowa_n150 = sd(replicate(R, mean(pop$godziny[sample(N, 150)])))), 2)   # porównanie: losowa n = 150
sklad <- data.frame(wydzial = factor(names(kol_wydz), names(kol_wydz)),
                    populacja = 100 * as.numeric(table(pop$wydzial)) / N,
                    kula = 100 * rowMeans(powt[names(kol_wydz), ]))
sklad[, 2:3] <- round(sklad[, 2:3], 1); sklad

# A: drzewo rekrutacji na mapie (ggraph, współrzędne = miejsce osoby na mapie)
wezly <- data.frame(id = jedna$id, x = pop$x[jedna$id], y = pop$y[jedna$id],
                    fala = cut(jedna$fala, c(-1, 0, 2, 4, Inf), c("osoby startowe", "fale 1–2", "fale 3–4", "fale 5+")))
drzewo <- graph_from_data_frame(na.omit(data.frame(from = as.character(jedna$zaprosil), to = as.character(jedna$id))),
                                vertices = data.frame(name = as.character(wezly$id), wezly[, -1]))
kol4 <- c("osoby startowe" = "black", "fale 1–2" = "#D55E00", "fale 3–4" = "#009E73", "fale 5+" = "#0072B2")
ksz4 <- c("osoby startowe" = 8, "fale 1–2" = 17, "fale 3–4" = 15, "fale 5+" = 16)
pa <- ggraph(drzewo, layout = "manual", x = V(drzewo)$x, y = V(drzewo)$y) +
  geom_raster(data = siatka, aes(x, y, fill = I(fill))) +
  geom_edge_link0(colour = "grey25", width = 0.35, alpha = 0.8) +
  geom_node_point(aes(colour = fala, shape = fala), size = 2) +
  geom_text(data = etyk_w, aes(x, y, label = wydzial), vjust = 0, size = 3.6, colour = "grey20") +
  scale_colour_manual(values = kol4, name = NULL) + scale_shape_manual(values = ksz4, name = NULL) +
  coord_equal(clip = "off") +
  labs(title = sprintf("A. Jedna kula śnieżna (n = %d)", nrow(jedna)),
       subtitle = sprintf("Średnia %.1f h; linia = zaproszenie", mean(pop$godziny[jedna$id]))) + motyw +
  theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank(),
        legend.position = "bottom") + guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2))
sklad_d <- rbind(data.frame(zrodlo = "populacja", wydzial = sklad$wydzial, proc = sklad$populacja),
                 data.frame(zrodlo = "kula śnieżna (średnio z 1000)", wydzial = sklad$wydzial, proc = sklad$kula))
sklad_d$zrodlo <- factor(sklad_d$zrodlo, unique(sklad_d$zrodlo))
pb <- ggplot(sklad_d, aes(proc, wydzial, fill = zrodlo)) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75, colour = "grey15", linewidth = 0.2) +
  geom_text(aes(label = sprintf("%.0f%%", proc)), position = position_dodge(width = 0.8), hjust = -0.15, size = 3.6) +
  scale_fill_manual(values = c("grey60", "#56B4E9"), name = NULL) +
  scale_x_continuous(limits = c(0, 100), expand = expansion(c(0, 0.02))) +
  scale_y_discrete(limits = rev) +
  labs(x = "Odsetek osób (%)", y = NULL, title = "B. Skład wydziałowy") + motyw +
  theme(legend.position = "bottom") + guides(fill = guide_legend(nrow = 2))
p4 <- pa + pb + plot_layout(widths = c(1.15, 1))
# p4   # zapis: ggsave("dobor-nielosowy-kula-sniezna.svg", p4, width = 10, height = 6.6)
Wynik w R
          osob     znajomosci sredni_stopien
       6400.00       19057.00           5.96
fala
 0  1  2  3  4  5  6
 3  5 10 17 24 42 49
        n   srednia proc_ekon
   150.00     17.61     69.33
    srednia_oszacowan            obciazenie          SD_oszacowan proc_prob_ponizej_150
                17.74                  1.03                  0.79                  0.90
       SD_losowa_n150
                 0.47
                    wydzial populacja kula
Humanistyczny Humanistyczny      37.5 15.7
Ekonomiczny     Ekonomiczny      31.2 68.4
Nauk ścisłych Nauk ścisłych      18.8  8.5
Lekarski           Lekarski      12.5  7.4
5. Samoselekcja w ankiecie internetowej: Rysunek 5
R
# Rysunek 5. Samoselekcja w ankiecie internetowej: link do wszystkich, odpowiadają częściej osoby uczące się więcej
set.seed(585)                                        # kontynuacja: pop, mu_pop, motyw z bloku 1

pop$odp <- runif(N) < pop$sklonnosc                  # link w mailu do wszystkich 6400 studentów
round(c(odpowiedzi = sum(pop$odp), proc_odpowiedzi = 100 * mean(pop$odp),
        srednia_respondentow = mean(pop$godziny[pop$odp]), srednia_populacji = mu_pop,
        roznica = mean(pop$godziny[pop$odp]) - mu_pop), 2)
# Odsetek odpowiedzi w przedziałach godzin nauki (to, czego badacz w praktyce nie widzi)
pop$godz_gr <- cut(pop$godziny, c(-Inf, 8, 12, 16, 20, 24, Inf), c("<8", "8–12", "12–16", "16–20", "20–24", "24+"),
                   right = FALSE)
odp_gr <- aggregate(odp ~ godz_gr, pop, function(v) c(n = length(v), proc = 100 * mean(v)))
odp_gr <- data.frame(godz_gr = odp_gr$godz_gr, n = odp_gr$odp[, "n"], proc = odp_gr$odp[, "proc"])
transform(odp_gr, proc = round(proc, 1))

pa <- ggplot(odp_gr, aes(godz_gr, proc)) +
  geom_col(fill = "#0072B2", width = 0.7) +
  geom_text(aes(label = sprintf("%.0f%%", proc)), vjust = -0.4, size = 3.8) +
  geom_hline(yintercept = 100 * mean(pop$odp), linetype = "dashed", colour = "grey20") +
  annotate("text", x = 0.5, y = 100 * mean(pop$odp) + 1.5, hjust = 0, size = 3.6,
           label = sprintf("średnio %.1f%%", 100 * mean(pop$odp))) +
  labs(x = "Godziny nauki tygodniowo", y = "Odsetek, który odpowiedział (%)",
       title = "A. Kto odpowiada na link") + motyw
gest <- rbind(data.frame(grupa = "wszyscy studenci", godziny = pop$godziny),
              data.frame(grupa = "respondenci", godziny = pop$godziny[pop$odp]))
gest$grupa <- factor(gest$grupa, c("wszyscy studenci", "respondenci"))
srednie5 <- data.frame(grupa = factor(levels(gest$grupa), levels(gest$grupa)),
                       m = c(mu_pop, mean(pop$godziny[pop$odp])))
pb <- ggplot(gest, aes(godziny, colour = grupa, linetype = grupa)) +
  geom_density(linewidth = 1, bw = 1.2) +
  geom_vline(data = srednie5, aes(xintercept = m, colour = grupa, linetype = grupa), linewidth = 0.7,
             show.legend = FALSE) +
  scale_colour_manual(values = c("grey35", "#D55E00"), name = NULL) +
  scale_linetype_manual(values = c("solid", "22"), name = NULL) +
  labs(x = "Godziny nauki tygodniowo", y = "Gęstość", title = "B. Rozkład: populacja a respondenci",
       subtitle = sprintf("Średnie: %.1f h a %.1f h", mu_pop, mean(pop$godziny[pop$odp]))) + motyw
p5 <- pa + pb
# p5   # zapis: ggsave("dobor-nielosowy-samoselekcja.svg", p5, width = 10, height = 5.4)
Wynik w R
          odpowiedzi      proc_odpowiedzi srednia_respondentow    srednia_populacji
             1166.00                18.22                19.57                16.71
             roznica
                2.86
  godz_gr    n proc
1      <8  393  4.8
2    8–12  917  8.1
3   12–16 1623 13.9
4   16–20 1658 19.4
5   20–24 1118 23.7
6     24+  691 37.6
6. Obciążenie a wielkość próby: Rysunek 6
R
# Rysunek 6. Obciążenie nie maleje z n: 1000 ankiet z samoselekcją (n = 100, 400, 1600) i 1000 prób losowych n = 100
set.seed(585)                                        # kontynuacja: pop, mu_pop, motyw z bloku 1
R <- 1000
schematy <- data.frame(schemat = c("losowa, n = 100", "samoselekcja, n = 100", "samoselekcja, n = 400",
                                   "samoselekcja, n = 1600"), n = c(100, 100, 400, 1600), losowa = c(TRUE, FALSE, FALSE, FALSE))
sym <- do.call(rbind, lapply(seq_len(nrow(schematy)), function(s) {
  t(replicate(R, {
    i <- if (schematy$losowa[s]) sample(N, schematy$n[s]) else order(rexp(N) / pop$sklonnosc)[1:schematy$n[s]]
    y <- pop$godziny[i]; m <- mean(y); se <- sd(y) / sqrt(length(y)); q <- qt(0.975, length(y) - 1)
    c(s = s, srednia = m, trafia = (m - q * se <= mu_pop) & (mu_pop <= m + q * se))
  }))
}))
sym <- as.data.frame(sym); sym$schemat <- factor(schematy$schemat[sym$s], rev(schematy$schemat))
tab6 <- do.call(rbind, lapply(split(sym, sym$schemat), function(d) {
  pokr <- mean(d$trafia)
  c(obciazenie = mean(d$srednia) - mu_pop, SD = sd(d$srednia), RMSE = sqrt(mean((d$srednia - mu_pop)^2)),
    pokrycie_95 = 100 * pokr, blad_MC = 100 * sqrt(pokr * (1 - pokr) / R))
}))
round(tab6[rev(rownames(tab6)), ], 2)

etyk6 <- data.frame(schemat = factor(rownames(tab6), levels(sym$schemat)),
                    tekst = sprintf("RMSE %.2f h\n95%% CI trafia: %.1f%%", tab6[, "RMSE"], tab6[, "pokrycie_95"]))
kol6 <- c("losowa, n = 100" = "grey45", "samoselekcja, n = 100" = "#E69F00",
          "samoselekcja, n = 400" = "#0072B2", "samoselekcja, n = 1600" = "black")
p6 <- ggplot(sym, aes(srednia, schemat, fill = schemat)) +
  stat_halfeye(.width = 0.95, point_interval = "mean_qi", slab_alpha = 0.8, normalize = "groups", height = 0.85) +
  geom_vline(xintercept = mu_pop, linetype = "dashed", colour = "grey10") +
  geom_text(data = etyk6, aes(x = 21.3, y = schemat, label = tekst), inherit.aes = FALSE,
            hjust = 0, vjust = -0.3, size = 3.7, colour = "grey15", lineheight = 0.95) +
  annotate("text", x = mu_pop, y = 0.55, label = sprintf("prawdziwa średnia %.1f h", mu_pop), hjust = 1.05,
           size = 3.8) +
  scale_fill_manual(values = kol6, guide = "none") +
  scale_x_continuous(limits = c(13.5, 23.5), breaks = 14:23) +
  labs(x = "Średnia godzin nauki w próbie", y = NULL,
       title = "1000 badań każdym schematem: większa próba z samoselekcją",
       subtitle = "jest węższa, ale wciąż chybia – przesunięcie zostaje") + motyw
# p6   # zapis: ggsave("dobor-nielosowy-obciazenie-a-n.svg", p6, width = 10, height = 6.4)
Wynik w R
                       obciazenie   SD RMSE pokrycie_95 blad_MC
losowa, n = 100             -0.01 0.56 0.56        96.1    0.61
samoselekcja, n = 100        2.57 0.57 2.63         0.6    0.24
samoselekcja, n = 400        2.48 0.28 2.50         0.0    0.00
samoselekcja, n = 1600       2.18 0.12 2.18         0.0    0.00
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy kolory rysunków przetrwają zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
roznica <- function(k) {                        # najmniejsza odległość ΔE (CIELAB) między kolorami zestawu
  lab <- coords(as(hex2RGB(k), "LAB")); min(dist(lab))
}
zestawy <- list("4 wydziały (rysunki 1, 2)" = c("#0072B2", "#E69F00", "#009E73", "black"),
                "populacja, kwotowa, samoselekcja (rys. 3)" = c("grey45", "#0072B2", "#D55E00"),
                "fale kuli śnieżnej (rysunek 4A)" = c("black", "#D55E00", "#009E73", "#0072B2"),
                "skład: populacja a kula (rysunek 4B)" = c("grey60", "#56B4E9"),
                "populacja a respondenci (rys. 5B)" = c("grey35", "#D55E00"),
                "cztery schematy (rysunek 6)" = c("grey45", "#E69F00", "#0072B2", "black"),
                "czerwony – zielony (dla porównania)" = c("#E41A1C", "#4DAF4A"))
zestawy <- lapply(zestawy, function(k) rgb(t(col2rgb(k)), maxColorValue = 255))
round(t(sapply(zestawy, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                      protanopia = roznica(protan(k))))), 1)
Wynik w R
                                          widzenie_typowe deuteranopia protanopia
4 wydziały (rysunki 1, 2)                            61.9         55.4       51.5
populacja, kwotowa, samoselekcja (rys. 3)            41.5         45.1       38.2
fale kuli śnieżnej (rysunek 4A)                      61.9         53.5       37.3
skład: populacja a kula (rysunek 4B)                 37.4         38.3       33.0
populacja a respondenci (rys. 5B)                    78.4         65.8       54.7
cztery schematy (rysunek 6)                          41.5         45.1       38.2
czerwony – zielony (dla porównania)                 121.7         21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie i symulacje – pakiet stats). Sieć znajomości zbudowano pakietem igraph, a drzewo rekrutacji narysowano pakietem ggraph. Rysunki wykonano w ggplot2 i ggdist, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggdist (wersja 3.3.3): Kay, M. (2024). ggdist: Visualizations of distributions and uncertainty in the grammar of graphics. IEEE Transactions on Visualization and Computer Graphics, 30(1), 414–424. https://doi.org/10.1109/TVCG.2023.3327195
- igraph (wersja 2.2.2): Csárdi, G., & Nepusz, T. (2006). The igraph software package for complex network research. InterJournal, Complex Systems, 1695. https://igraph.org
- ggraph (wersja 2.2.2): Pedersen, T. L. (2025). ggraph: An implementation of grammar of graphics for graphs and networks [R package]. https://doi.org/10.32614/CRAN.package.ggraph
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- „Próba reprezentatywna, bo struktura płci i wieku zgadza się z GUS-em”. Kwoty trafiają w strukturę, a nie w cechę mierzoną (rysunek 3).
- „Zebrałem 1000 ankiet, więc wynik jest pewny”. Liczebność zwęża przedział wokół wartości, która może być przesunięta (rysunek 6).
- Dobór celowy jako synonim „starannego”. Kryteria włączenia definiują populację, ale nie usuwają samoselekcji w jej obrębie (rysunek 2).
- Kula śnieżna bez liczby fal i osób startowych – czytelnik nie oceni, jak bardzo próba skupia się wokół startu (rysunek 4).
Najczęstsze pytania
Dlaczego próba kwotowa zgodna z populacją co do płci i wieku może dawać obciążony wynik?
Bo kwoty kontrolują tylko cechy, które do nich wpisano. W obrębie każdej komórki (np. kobiety w wieku 22–24 lat) do próby trafiają osoby, które najchętniej odpowiadają, a ta chęć może wiązać się z mierzoną cechą. W symulacji na tej stronie kwoty zmniejszyły obciążenie średniej z 2.50 h do 2.31 h – usunęły tylko część wynikającą ze składu płci i wieku.
Czy większa próba z ankiety internetowej zmniejsza błąd doboru?
Zmniejsza błąd losowy, a nie błąd doboru. W 1000 symulowanych ankietach z samoselekcją rozrzut średnich spadał z 0.57 h (n = 100) do 0.12 h (n = 1600), ale obciążenie zostało na poziomie 2.18–2.57 h. Duża próba z samoselekcją miała większy błąd średniokwadratowy niż mała próba losowa (2.18 h wobec 0.56 h).
Czym różni się dobór celowy od kwotowego w badaniu ilościowym?
Dobór celowy wyznacza, kto w ogóle może wziąć udział (kryteria włączenia, np. 4. i 5. rok studiów stacjonarnych na dwóch wydziałach), i zawęża populację, do której odnosisz wnioski. Dobór kwotowy nie zawęża populacji, tylko ustala, ile osób o danych cechach (np. płci i wieku) ma trafić do próby, żeby jej struktura przypominała populację. W obu przypadkach osoby wewnątrz kryteriów lub kwot zgłaszają się same.
Czy z próby zebranej metodą kuli śnieżnej można policzyć średnią dla populacji?
Policzyć można, ale nie należy jej przedstawiać jako wartości populacyjnej. Kula śnieżna skupia się wokół osób startowych: w symulacji na tej stronie 68.4% uczestników pochodziło z wydziału, na którym zaczęła się rekrutacja, choć wydział ten stanowił 31.2% uczelni. Rozrzut oszacowań był też większy niż w próbie losowej tej samej wielkości. Dla populacji ukrytych istnieje odmiana z kuponami i ważeniem (RDS).
Jak narysować w R mapę populacji z zaznaczoną próbą?
Każdej osobie nadaj współrzędne x i y (np. wydział jako prostokąt, rocznik jako pas rzędów), tło narysuj funkcją geom_raster() jako jasnoszare piksele, a osoby z próby dodaj na wierzch funkcją geom_point() z kolorem i kształtem według grupy. Raster zamiast tysięcy punktów sprawia, że plik SVG pozostaje mały. Pełny kod jest w sekcji z kodem na tej stronie.
Powiązane hasła
Przeczytaj też
Dobór próby w pracy dyplomowej
Metody losowe i nielosowe, co wolno wnioskować z próby wygodnej, symulacja w R, kryteria włączenia i gotowy opis doboru do rozdziału metodologicznego.
Czytaj →PoradnikSchematy losowania w obrazkach
Sześć schematów losowania na mapach jednej populacji, 1000 symulowanych badań, efekt schematu i efektywna liczebność – pięć rysunków z kodem R.
Czytaj →PoradnikSondaż w obrazkach
Margines błędu a n i odsetek 50%, 1000 sondaży, różnica dwóch odsetków, duża ankieta online z błędem i liczba zaproszeń – sześć rysunków z R.
Czytaj →Masz próbę wygodną i nie wiesz, jak ją opisać?
Pomożemy opisać dobór próby i rekrutację w rozdziale metodologicznym, porównać strukturę próby z populacją i sformułować wnioski oraz ograniczenia tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Andrade, C. (2021). The inconvenient truth about convenience and purposive samples. Indian Journal of Psychological Medicine, 43(1), 86–88. https://doi.org/10.1177/0253717620977000 ● Otwarty dostęp
- Bethlehem, J. (2010). Selection bias in web surveys. International Statistical Review, 78(2), 161–188. https://doi.org/10.1111/j.1751-5823.2010.00112.x ● Otwarty dostęp
- Cornesse, C., Blom, A. G., Dutwin, D., Krosnick, J. A., De Leeuw, E. D., Legleye, S., Pasek, J., Pennay, D., Phillips, B., Sakshaug, J. W., Struminskaya, B., & Wenz, A. (2020). A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research. Journal of Survey Statistics and Methodology, 8(1), 4–36. https://doi.org/10.1093/jssam/smz041 ● Otwarty dostęp
- Elliott, M. R., & Valliant, R. (2017). Inference for nonprobability samples. Statistical Science, 32(2), 249–264. https://doi.org/10.1214/16-sts598 ● Otwarty dostęp
- Goodman, L. A. (1961). Snowball sampling. The Annals of Mathematical Statistics, 32(1), 148–170. https://doi.org/10.1214/aoms/1177705148 ● Otwarty dostęp
- Mercer, A. W., Kreuter, F., Keeter, S., & Stuart, E. A. (2017). Theory and practice in nonprobability surveys: Parallels between causal inference and survey inference. Public Opinion Quarterly, 81(S1), 250–271. https://doi.org/10.1093/poq/nfw060 ● Otwarty dostęp
Cytowania BibTeX
@article{andrade2021inconvenient, author={Andrade, Chittaranjan}, title={{The inconvenient truth about convenience and purposive samples}}, journal={Indian Journal of Psychological Medicine}, year={2021}, volume={43}, number={1}, pages={86--88}, doi={10.1177/0253717620977000}}@article{bethlehem2010selection, author={Bethlehem, Jelke}, title={{Selection bias in web surveys}}, journal={International Statistical Review}, year={2010}, volume={78}, number={2}, pages={161--188}, doi={10.1111/j.1751-5823.2010.00112.x}}@article{cornesse2020review, author={Cornesse, Carina and Blom, Annelies G. and Dutwin, David and Krosnick, Jon A. and De Leeuw, Edith D. and Legleye, Stéphane and Pasek, Josh and Pennay, Darren and Phillips, Benjamin and Sakshaug, Joseph W. and Struminskaya, Bella and Wenz, Alexander}, title={{A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research}}, journal={Journal of Survey Statistics and Methodology}, year={2020}, volume={8}, number={1}, pages={4--36}, doi={10.1093/jssam/smz041}}@article{elliott2017inference, author={Elliott, Michael R. and Valliant, Richard}, title={{Inference for nonprobability samples}}, journal={Statistical Science}, year={2017}, volume={32}, number={2}, pages={249--264}, doi={10.1214/16-sts598}}@article{goodman1961snowball, author={Goodman, Leo A.}, title={{Snowball sampling}}, journal={The Annals of Mathematical Statistics}, year={1961}, volume={32}, number={1}, pages={148--170}, doi={10.1214/aoms/1177705148}}@article{mercer2017theory, author={Mercer, Andrew W. and Kreuter, Frauke and Keeter, Scott and Stuart, Elizabeth A.}, title={{Theory and practice in nonprobability surveys: Parallels between causal inference and survey inference}}, journal={Public Opinion Quarterly}, year={2017}, volume={81}, number={S1}, pages={250--271}, doi={10.1093/poq/nfw060}}