Próba studencka to nie błąd. Błędem bywa zdanie we wnioskach
Najłatwiej dotrzeć do ludzi z własnego roku. Dlatego ankieta rozdana na ćwiczeniach to częsty początek pracy licencjackiej i magisterskiej. Potem pada pytanie: „Kogo właściwie zbadano?”. Studenci są dobrą próbą wtedy, gdy pytanie dotyczy studentów albo gdy umiesz uzasadnić, dlaczego związek ma działać tak samo poza uczelnią. Ten wpis pokazuje, jak to rozstrzygnąć, co wolno napisać w tytule i wnioskach oraz czym grozi sama sala: wąski zakres zmiennych, obecność prowadzącego i grupy zajęciowe, które nie są zbiorem niezależnych osób.
Reszta tematu ma osobne strony. Metody doboru i ich opis znajdziesz we wpisie o doborze próby w pracy dyplomowej, kanały rekrutacji w poradniku gdzie znaleźć respondentów, a pojęcia w haśle o doborze wygodnym i celowym. Jeśli to Ty prowadzisz zajęcia, od których zależy ocena badanych, najpierw przeczytaj badanie we własnym miejscu pracy. Tu chodzi o sytuację studenta badającego studentów. Zasady uczelni i komisji mają pierwszeństwo, a przykłady i liczby poniżej są fikcyjne.
Kiedy próba studencka wystarczy, a kiedy nie
Zacznij od populacji docelowej, czyli od pytania, o kim chcesz mówić w ostatnim zdaniu pracy. Potem porównaj ją z osobami, do których masz dostęp.
- Wystarczy, gdy populacją są studenci. Stres przed sesją, wypalenie akademickie, korzystanie z bibliotek. Wtedy pozostaje pytanie, których studentów naprawdę zbadałeś.
- Może wystarczyć, gdy badasz proces, który ma być wspólny. Na przykład eksperyment z losowym przydziałem do dwóch wersji komunikatu. Argument trzeba jednak podać, bo „to przecież ogólny mechanizm” nie jest argumentem. Wpis o doborze wyjaśnia, jaki wniosek przy doborze nielosowym jest bezpieczny.
- Nie wystarczy, gdy pytasz o częstość lub średnią poza uczelnią. „Ilu młodych dorosłych…” wymaga innej próby.
- Nie wystarczy, gdy kluczowa cecha u studentów prawie się nie zmienia albo w ogóle nie występuje: wiek, doświadczenie zawodowe, rodzicielstwo, wykształcenie, wysokie nasilenie objawów.
Co pokazują badania
Peterson (2001) zebrał metaanalizy porównujące studentów z osobami spoza uczelni. Odpowiedzi studentów były nieco bardziej jednorodne, a wielkości efektów często różniły się kierunkiem i siłą. Różnice nie układały się w żaden systematyczny wzór, więc nie da się ich „przeliczyć”. Autor zaleca replikację na osobach niebędących studentami przed uogólnieniem. Hanel i Vione (2016) porównali studentów z ogółem w 59 krajach dla 12 zmiennych osobowościowych i postaw. Różnice były częściowo duże i niespójne, a studenci różnili się między sobą tak samo jak ogół. Co do jednorodności te badania się nie zgadzają, ale rada jest ta sama: nie zakładaj, że wynik studencki to wynik ogólny.
Szersze zastrzeżenie formułują Henrich i in. (2010): twierdzenia o „ludziach” opierają się zwykle na próbach z bogatych, wykształconych społeczeństw zachodnich, a te bywają nietypowe. Ten argument dotyczy jednak uogólniania na ludzi w ogóle, a nie sensu badania studentów. Trafność zewnętrzna to zawsze pytanie „na kogo i w jakich warunkach”.
Co wolno napisać w tytule, celu i wnioskach
Tytuł, cel i wnioski muszą nazywać tę samą grupę. Jeśli tytuł mówi o „młodych dorosłych”, a Metoda o osobach z jednego kierunku, recenzent zapyta, skąd ten przeskok. Budowę tytułu omawia poradnik tytuł pracy dyplomowej.
| Pytanie | Próba | Jak wolno sformułować | Czego nie pisz |
|---|---|---|---|
| Stres przed sesją a sen | Studenci jednej uczelni, ankieta na zajęciach | „…wśród studentów [kierunek] [typ uczelni]”; wnioski: „w badanej grupie” | „Polscy studenci śpią…” |
| Perfekcjonizm a prokrastynacja | Studenci kilku kierunków | „…w próbie studentów”; przeniesienie poza uczelnię tylko jako hipoteza do sprawdzenia | „Perfekcjonizm wiąże się z prokrastynacją u dorosłych” |
| Ilu młodych dorosłych korzysta z X | Dobór wygodny, studenci | Zmień cel: „odsetek osób korzystających z X wśród zbadanych studentów”, z opisem doboru | „X używa [procent]% młodych Polaków” |
| Wiek a tempo nauki aplikacji | Studenci 19–26 lat | Nie da się odpowiedzieć; zmień pytanie albo dobierz osoby z innych grup wieku | „Wiek nie ma znaczenia” |
| Postawy pracowników wobec pracy zdalnej | Pracujący studenci zaoczni | „…wśród pracujących studentów studiów niestacjonarnych” | „Pracownicy w Polsce oceniają…” |
| Efekt wersji komunikatu, losowo przydzielonej osobom | Studenci, eksperyment online | Sformułowanie przyczynowe w obrębie tej próby; „czy efekt wystąpi poza uczelnią, wymaga replikacji” | „Komunikat A skuteczniej przekonuje ludzi” |
| Ocena przedmiotu przez rocznik | Niemal cały rocznik | „…wśród studentów rocznika [rok]”; zob. populacja czy próba | „Studenci kierunku oceniają…” bez wskazania rocznika |
Słowo „reprezentatywna” w takiej pracy zwykle jest nie na miejscu. Nawet gdy płeć i tryb studiów zgadzają się z danymi uczelni, nie wiesz, czy zgadza się badana cecha. Porównanie możesz i tak wykonać według wpisu o charakterystyce próby. Pokazuje ono, kogo brakuje.
Wąski zakres: dlaczego u studentów korelacja słabnie
Studenci są do siebie podobni pod względem wieku i wykształcenia. Gdy zmienna prawie się nie zmienia, korelacja maleje, nawet jeśli związek jest dokładnie taki sam. Wynik „brak związku” może więc oznaczać brak zmienności.
Symulacja: w populacji dorosłych od 18 do 70 lat każdy kolejny rok życia wydłuża czas nauki nowej aplikacji o 0.50 minuty. Związek jest liniowy i taki sam w całym zakresie (parametry fikcyjne).
| Kogo badasz | SD wieku | r | b (minuty na rok) | Moc przy N = 150 |
|---|---|---|---|---|
| Dorośli 18–70 lat | 15.00 | .50 | 0.50 | 100.00% |
| Studenci i zaoczni, 19–35 lat | 4.62 | .18 | 0.50 | 57.86% |
| Studenci dzienni, 19–26 lat | 2.02 | .08 | 0.51 | 15.80% |
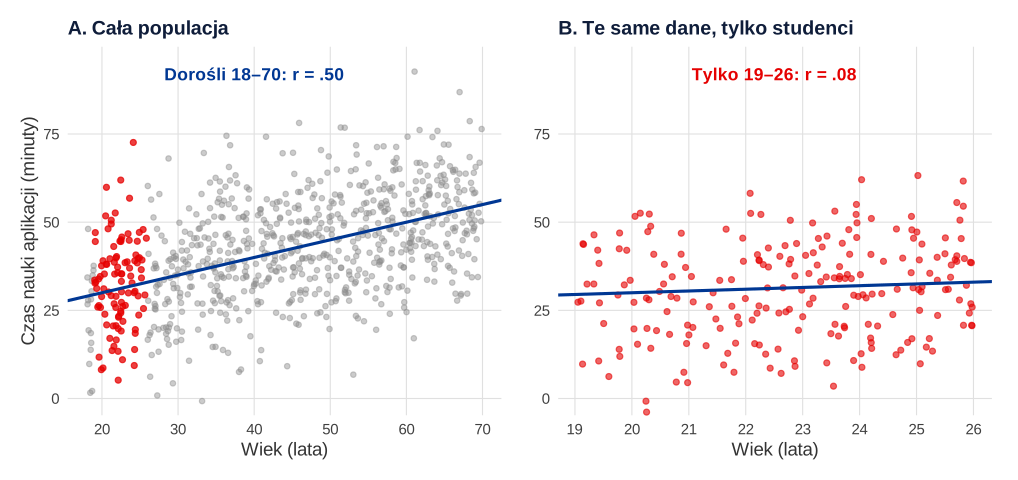
Nachylenie się nie zmieniło: każdy rok to nadal około pół minuty. Zmalała tylko korelacja, bo jest miarą względną: porównuje zmienność wyjaśnioną z rozrzutem, a przy zakresie ośmiu lat rozrzut prawie w całości pochodzi skądinąd. Sackett i Yang (2000) pokazują, że nie ma jednej poprawki na takie zawężenie: opisują 11 scenariuszy, zależnie od tego, po której zmiennej nastąpiła selekcja i czy znasz wariancję bez ograniczenia. Na poziomie pracy dyplomowej zwykle wystarczy raportować SD i napisać o ograniczeniu. Korekty i ich ryzyko omawia hasło o trafności kryterialnej.
Nie tylko wiek: nasilenie i selekcja po wyniku
Drugi częsty przypadek to nasilenie. Jeśli część osób z bardzo wysokim stresem nie przychodzi na zajęcia, w sali ich zabraknie. Tu w populacji r = .50, a u oznacza stosunek SD po doborze do SD przed doborem.
| Kto trafia do próby | Odsetek populacji | u | r | b |
|---|---|---|---|---|
| Wszyscy | 100.0% | 1.00 | .50 | 0.50 |
| Bez wysokiego X (X < 1 SD) | 84.1% | 0.79 | .42 | 0.50 |
| Tylko środek X (±0.5 SD) | 38.3% | 0.28 | .17 | 0.51 |
| Bez wysokiego Y (Y < 1 SD) | 84.2% | 0.95 | .42 | 0.35 |
Przy selekcji po predyktorze spadek r opisuje wzór, a nachylenie pozostaje:
Ostatni wiersz jest groźniejszy. Gdy dobór zależy od zmiennej wynikowej, maleje także b (tu z 0.50 do 0.35), a tego nie naprawi przejście na regresję. To odmiana błędu selekcji. Pamiętaj o tym, zanim napiszesz, że korelacja jest „mała”. Wykształcenie to przypadek prostszy: jeśli wszyscy studiują, zmienna jest stała i niczego nie wyjaśni.
Ankieta na zajęciach: co zmienia sala
Forma „wszyscy wypełniają teraz, ja zbieram” daje wysoki odsetek odpowiedzi, ale nie mówi, jakim kosztem. Każdy wiersz poniżej to decyzja przed wejściem do sali. Dowody i symulację aprobaty pod okiem badacza opisuje wpis o własnym miejscu pracy, tu ich nie powtarzamy.
| Element | Ryzyko | Co zrobić | Co opisać |
|---|---|---|---|
| Kto rozdaje | Autor z roku: koledzy odpowiadają „dla Ciebie” (aprobata społeczna) | Krótka instrukcja czytana z kartki, ta sama w każdej grupie | Kto zapraszał, jaka to była instrukcja |
| Obecność prowadzącego | Trudno odmówić, a pytania o uczelnię są oceną osoby stojącej obok | Prowadzący wychodzi lub stoi z boku; nie wie, kto odmówił | Czy prowadzący był w sali |
| Punkty za udział | Presja, a dobrowolność staje się pozorna | Rozmowa z promotorem i komisją; alternatywa dla osób, które nie chcą uczestniczyć | Czy była gratyfikacja i jaka alternatywa |
| Wypełnianie obok siebie | Podglądanie, rozmowy, wspólne ustalanie odpowiedzi; odpowiedzi przestają być niezależne | Miejsca co jedno lub link na własnym telefonie, cisza do końca | Forma i warunki wypełniania |
| Frekwencja | Badasz tych, którzy przyszli | Zapisz liczbę zapisanych i obecnych; dodaj link dla nieobecnych | Zapisani, obecni, wypełnione ankiety |
| Moment w semestrze | Przed egzaminem stres i pośpiech mają inne źródło | Zbieraj we wszystkich grupach w podobnym czasie; dopasuj okres odniesienia | Daty zbierania, odległość od sesji |
Punkty i presja. Leentjens i Levenson (2013) opisują, że studenci bywają zobowiązywani do udziału albo dostają za niego zaliczenia, a ich prywatność może zostać naruszona. To ogólne zastrzeżenie, nie przepis: zasady ustala uczelnia i komisja. O innych formach gratyfikacji pisze poradnik o nagrodzie za udział. Nawet dobrze zaplanowana odmowa staje się widoczna, gdy w sali jest 20 osób, więc lepsza jest kartka oddawana przez wszystkich, także pusta. Procedurę na wypadek rezygnacji opisuje wpis o wycofaniu po zebraniu danych.
Anonimowość w grupie. W badaniu Ong i Weiss (2000) wśród studentów, którzy faktycznie ściągali, przyznało się 25% przy poufności i 74% przy anonimowości. Przy kartce oddawanej do ręki kolegi granica szybko się zaciera. Sprawdź też metryczkę: płeć, wiek i grupa dziekańska mogą w małej sali wskazać konkretną osobę.
Frekwencja. W metaanalizie Credé i in. (2010) obecność na zajęciach silnie wiązała się z ocenami z przedmiotu (ρ = .44) i ze średnią ocen (ρ = .41). Sala nie jest więc przypadkowym wycinkiem kierunku. Jeśli badasz motywację, wyniki w nauce lub obciążenie, nieobecni mogą różnić się właśnie tym, co mierzysz.
Moment w semestrze. Tu dowody są spokojniejsze, niż podpowiada intuicja. W projekcie Many Labs 3 w 20 pulach uczestników pora semestru miała słaby związek z jakością danych, płcią oraz sumiennością, nastrojem i stresem, a niewiele wskazywało, by zmieniała badane efekty (Ebersole i in., 2016). Autorzy zastrzegają, że ogólność tych wniosków jest nieznana. Nie oznacza to też, że ankieta o stresie rozdana przed egzaminem mierzy to samo co w październiku.
Grupa ćwiczeniowa to skupienie, a nie 20 niezależnych osób
Osoby z jednej grupy mają tego samego prowadzącego, wspólny plan i te same rozmowy. To podobieństwo mierzy ICC. Hasło o pseudoreplikacji pokazuje skrajny przykład (ICC = .15, klasy szkolne). Tu sprawdzamy to, co jest typowe dla pracy dyplomowej: małe ICC i przydział do warunków całymi grupami, np. grupy 1–4 dostają wersję A, a grupy 5–8 wersję B.
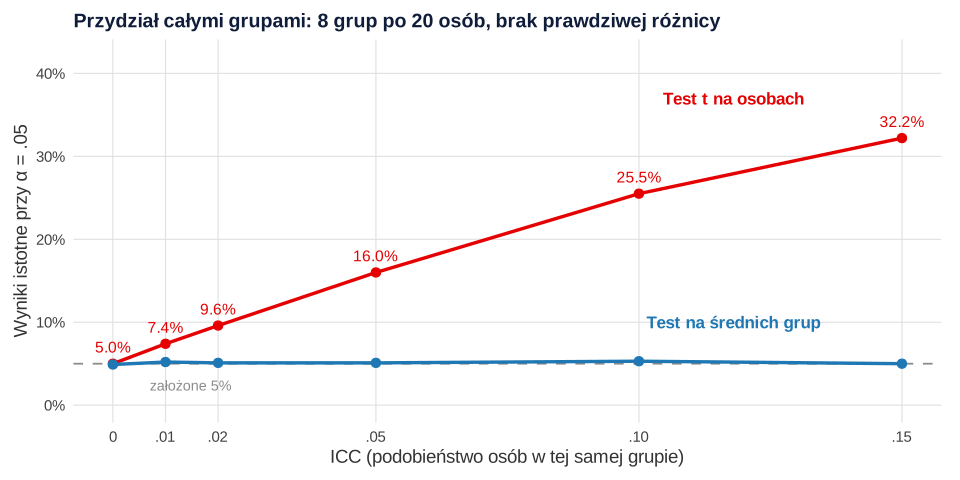
Już przy ICC = .02 test t na osobach daje 9.6% fałszywych alarmów zamiast 5%, a przy ICC = .05 aż 16.0%. Analiza na średnich grup trzyma poziom (5.1%). Dla testu na osobach liczba grup prawie nie ma znaczenia: przy ICC = .05 wychodzi 16.6% dla 4 grup, 16.0% dla 8 i 16.1% dla 16. Liczy się ICC i liczebność grupy, co oddaje efekt schematu:
Przy 20 osobach w grupie i ICC = .05 deff = 1.95, czyli 160 osób niesie mniej więcej tyle informacji co 82.1 niezależnej osoby. Ta cena dotyczy jednak analizy poprawnej. Moc testu na średnich grup przy prawdziwej różnicy d = 0.50, ICC = .05 i 20 osobach w grupie:
| Liczba grup | 4 | 8 | 12 | 16 | 24 |
|---|---|---|---|---|---|
| Moc | 16.0% | 47.3% | 71.4% | 84.3% | 96.1% |
Leyrat i in. (2018) w symulacji badań z najwyżej 40 klastrami pokazali, że analizy na poziomie klastrów i modele mieszane z poprawką stopni swobody trzymają błąd I rodzaju, a metody bez poprawek go zawyżają. Przy mniej niż 20 klastrach moc była niska. Trzy praktyczne wnioski:
- Dwie grupy, po jednej na warunek, to za mało na jakąkolwiek poprawną analizę. Warunek pokrywa się z grupą, a test na osobach myli się tu tak samo (16.2% przy ICC = .05). Różnicy między grupami nie oddzielisz od różnicy między prowadzącymi.
- Jeśli to możliwe, losuj osoby wewnątrz grup, na przykład dwie wersje linku rozdane naprzemiennie, o ile sąsiedzi nie będą ich porównywać. Gdy losowanie osób jest niemożliwe, zaplanuj przydział klastrowy i analizę od początku.
- Przy nierównych grupach lub zmiennych poziomu osoby sięgnij po model wielopoziomowy, mając świadomość, że przy kilku grupach samo ICC jest oszacowane niedokładnie.
A jeśli nie porównuję warunków?
Zbierasz dane w 6 grupach po 25 osób i chcesz podać średnią dla kierunku. Przedział liczony tak, jakby były to niezależne osoby, obejmuje prawdziwą wartość rzadziej, niż obiecuje:
| ICC | Przedział jak dla osób | Przedział ze średnich grup |
|---|---|---|
| 0 | 95.2% | 94.9% |
| .02 | 88.8% | 94.4% |
| .05 | 81.8% | 94.9% |
| .10 | 71.0% | 94.8% |
Przy korelacji dwóch zmiennych indywidualnych w 8 grupach po 25 osób problem jest mniejszy, ale nie znika, i zależy od tego, czy obie zmienne są podobne w grupie. Gdy tylko Y ma ICC = .10, odsetek fałszywych alarmów wynosi 5.0%. Gdy obie zmienne mają ICC = .10, jest to 7.1%, a przy ICC = .25 aż 19.6%. Różnica wynika z tego, że wspólny dla grupy składnik musi istnieć po obu stronach korelacji. Dlatego zanotuj w danych numer grupy: bez tej kolumny nie policzysz ICC. Przykład wyliczenia z tabeli ANOVA znajdziesz w kodzie, a kalkulator w serwisie: ICC i efekt schematu.
Znajomi z roku i jak rozproszyć rekrutację
Znajomi odpowiadają chętniej, ale są do siebie i do Ciebie podobni, znają temat pracy i wiedzą, czego się spodziewasz. Kilka ruchów poprawia sytuację, ale nie zmienia charakteru doboru:
- kilka kierunków, lat i trybów studiów zamiast własnej grupy, najlepiej także innych uczelni;
- w każdej grupie ten sam tekst zaproszenia i ten sam czas;
- osobny link lub kolumna „źródło rekrutacji” i porównanie wyników między źródłami, zaplanowane przed analizą;
- górny limit osób z jednego źródła, żeby jedna grupa nie stanowiła połowy próby;
- liczba zaproszonych i wypełniających dla każdego źródła.
Różnorodność próby to nie to samo co reprezentatywność. Badanie na trzech kierunkach to badanie trzech dostępnych kierunków i tak je opisz. Czego oczekuje się na kolejnych poziomach studiów, omawia wpis licencjat, magisterka, doktorat.
Co napisać w Metodzie i Ograniczeniach
Jak bywa napisane: „Badanie przeprowadzono na reprezentatywnej próbie studentów”.
Co nie tak: ankieta w dostępnych grupach nie jest reprezentatywna, nawet gdy jest liczna.
Poprawione: „Badanie przeprowadzono na próbie wygodnej [n] studentów [kierunek]…”.
Jak bywa napisane: „Nie stwierdzono związku wieku z…, co świadczy o tym, że wiek nie ma znaczenia”.
Co nie tak: w próbie 19–26 lat wiek prawie się nie zmienia.
Poprawione: „Wąski zakres wieku (M i SD) uniemożliwia ocenę związku…”.
Jak bywa napisane: „Grupa A uzyskała istotnie wyższe wyniki niż grupa B”.
Co nie tak: dwie grupy ćwiczeniowe i warunek przypisany całej grupie: różnica może być różnicą między grupami.
Poprawione: opisz to jako ograniczenie, a wynik jako wstępną obserwację.
Metoda – dobór i zbieranie:
Analiza – dane w grupach:
Ograniczenia:
O tej części pracy więcej mówi wpis ograniczenia badania – jak je opisać. Gdy korelacje wyglądają dziwnie, zajrzyj do listy wynik wygląda podejrzanie.
Najczęstsze błędy
- „Młodzi dorośli” w tytule, studenci jednego kierunku w Metodzie. Tytuł obiecuje więcej, niż dają dane.
- Traktowanie braku korelacji z wiekiem jako wyniku. Najpierw podaj SD i zakres.
- Porównanie „grupa A vs grupa B” przy jednej grupie na warunek. Żadna liczebność tego nie naprawi.
- Usunięcie numeru grupy z pliku „dla porządku”. Bez niego nie policzysz ICC.
- Odsetek odpowiedzi bliski 100% podawany jako dowód jakości. Liczony od obecnych, a nie od zapisanych, ukrywa selekcję.
- Wynik z sali i wynik z linku wrzucone do jednego worka bez zmiennej opisującej sposób zbierania.
Zawężony zakres i grupy zajęciowe w R
Dwa przepisy liczą wszystkie liczby z tabel i tekstu. Rysunki powstały w osobnym skrypcie. Ziaren nie wybierano pod wynik, a wszystkie parametry (nachylenia, ICC, liczebności grup, próg doboru) ustawiono ręcznie jako założenia ilustracyjne. Zmień je i sprawdź, co stanie się z tabelami.
Zawężenie zakresu a korelacja
R
# Zawężenie zakresu: ten sam związek, inna korelacja.
# Dane symulowane, parametry fikcyjne i ilustracyjne.
set.seed(521)

# CZĘŚĆ A. Wiek a czas nauki nowej aplikacji (minuty; im starsza osoba, tym dłużej)
# Populacja: dorośli 18-70 lat. Związek jest liniowy i taki sam w całym zakresie.
N_pop <- 1e6
wiek <- runif(N_pop, 18, 70)
czas <- 20 + 0.50 * wiek + rnorm(N_pop, 0, 13)

zakresy <- list("dorośli 18-70" = c(18, 70), "studenci i zaoczni 19-35" = c(19, 35),
                "studenci dzienni 19-26" = c(19, 26))
moc_r <- function(x, y, n, B = 5000) {        # odsetek istotnych wyników r przy N = n
  mean(replicate(B, {
    i <- sample.int(length(x), n)
    cor.test(x[i], y[i])$p.value < .05
  })) * 100
}
wiersz <- function(z) {
  i <- wiek >= z[1] & wiek <= z[2]
  x <- wiek[i]; y <- czas[i]
  c(sd_wieku = sd(x), r = cor(x, y), b_na_rok = unname(coef(lm(y ~ x))[2]),
    moc_N150 = moc_r(x, y, 150))
}
A <- t(sapply(zakresy, wiersz))
cat("A. Wiek a czas nauki aplikacji: zawężenie po wieku\n")
print(round(A, 3))

# CZĘŚĆ B. Nasilenie: stres (X) i problemy ze snem (Y), obie zmienne standaryzowane,
# korelacja w populacji .50. Dobór po X albo po Y zmienia wyniki inaczej.
N_pop <- 1e6
rho <- .50
x <- rnorm(N_pop)
y <- rho * x + sqrt(1 - rho^2) * rnorm(N_pop)

opis <- function(k) c(udzial_proc = mean(k) * 100, u = sd(x[k]) / sd(x), r = cor(x[k], y[k]),
                      b = unname(coef(lm(y[k] ~ x[k]))[2]))
B <- rbind(
  "cała populacja"              = opis(rep(TRUE, N_pop)),
  "bez wysokiego X (X < 1)"     = opis(x < 1),
  "tylko środek X (|X| < 0.5)"  = opis(abs(x) < 0.5),
  "bez wysokiego Y (Y < 1)"     = opis(y < 1))
wzor <- function(rho, u) rho * u / sqrt(1 - rho^2 + rho^2 * u^2)
B <- cbind(B, r_ze_wzoru = c(wzor(rho, B[1:3, "u"]), NA))
cat("\nB. Nasilenie: dobór po X i po Y (r w populacji = .50)\n")
print(round(B, 3))
Wynik
A. Wiek a czas nauki aplikacji: zawężenie po wieku
                         sd_wieku     r b_na_rok moc_N150
dorośli 18-70              15.002 0.499    0.498   100.00
studenci i zaoczni 19-35    4.618 0.176    0.502    57.86
studenci dzienni 19-26      2.017 0.079    0.511    15.80

B. Nasilenie: dobór po X i po Y (r w populacji = .50)
                           udzial_proc     u     r     b r_ze_wzoru
cała populacja                 100.000 1.000 0.501 0.501      0.500
bez wysokiego X (X < 1)         84.104 0.794 0.418 0.502      0.417
tylko środek X (|X| < 0.5)      38.315 0.284 0.166 0.513      0.162
bez wysokiego Y (Y < 1)         84.173 0.953 0.417 0.348         NA
Grupy zajęciowe jako skupienia
R
# Grupy zajęciowe jako skupienia: test t, analiza na średnich grup, ICC.
# Dane symulowane, parametry fikcyjne i ilustracyjne.
set.seed(5211)

# Wynik osoby = efekt grupy + różnica indywidualna; wariancja całkowita = 1.
symuluj <- function(K, m, icc, roznica = 0) {
  # K grup po m osób; połowa grup dostaje wersję A, połowa wersję B
  grupa <- rep(seq_len(K), each = m)
  warunek <- rep(rep(0:1, each = K / 2), each = m)
  y <- rnorm(K, 0, sqrt(icc))[grupa] + rnorm(K * m, 0, sqrt(1 - icc)) + roznica * warunek
  data.frame(y, grupa, warunek)
}
p_osoby <- function(d) t.test(y ~ warunek, d, var.equal = TRUE)$p.value
p_srednie <- function(d) {
  sr <- aggregate(cbind(y, warunek) ~ grupa, d, mean)
  t.test(y ~ warunek, sr, var.equal = TRUE)$p.value
}
B <- 10000

# 1. Fałszywe alarmy (brak prawdziwej różnicy), przydział całymi grupami, m = 20
siatka <- expand.grid(K = c(2, 4, 8, 16), icc = c(0, .01, .02, .05, .10, .15))
wyn <- t(apply(siatka, 1, function(w) {
  p <- replicate(B, {
    d <- symuluj(w[["K"]], 20, w[["icc"]])
    c(p_osoby(d), if (w[["K"]] > 2) p_srednie(d) else NA)
  })
  c(osoby = mean(p[1, ] < .05) * 100, srednie = mean(p[2, ] < .05) * 100)
}))
wyn1 <- cbind(siatka, deff = 1 + 19 * siatka$icc, round(wyn, 1))
cat("1. Odsetek wyników istotnych przy braku różnicy (%), m = 20, alfa = .05\n")
print(wyn1, row.names = FALSE)
cat("Efektywne N: 8 grup po 20 osób, ICC = .05:", round(160 / (1 + 19 * .05), 1), "\n")

# 2. Koszt: moc analizy na średnich (prawdziwa różnica d = 0.50, ICC = .05, m = 20)
moc <- sapply(c(4, 8, 12, 16, 24), function(K) {
  mean(replicate(B, p_srednie(symuluj(K, 20, .05, 0.50)) < .05)) * 100
})
names(moc) <- paste0("K=", c(4, 8, 12, 16, 24))
cat("\n2. Moc analizy na średnich grup (%), d = 0.50, ICC = .05, m = 20\n")
print(round(moc, 1))

# 3. Średnia z kilku grup jednego kierunku: pokrycie 95% CI (K = 6, m = 25)
pokrycie <- function(icc, K = 6, m = 25) {
  w <- replicate(B, {
    d <- symuluj(K, m, icc)
    d$warunek <- NULL
    n <- nrow(d)
    a <- abs(mean(d$y)) <= qt(.975, n - 1) * sd(d$y) / sqrt(n)
    sr <- tapply(d$y, d$grupa, mean)
    b <- abs(mean(sr)) <= qt(.975, K - 1) * sd(sr) / sqrt(K)
    c(a, b)
  })
  rowMeans(w) * 100
}
ic <- c(0, .02, .05, .10)
wyn3 <- t(sapply(ic, pokrycie))
dimnames(wyn3) <- list(paste0("ICC=", ic), c("jak_osoby", "ze_srednich_grup"))
cat("\n3. Pokrycie 95% CI dla średniej (%), 6 grup po 25 osób\n")
print(round(wyn3, 1))

# 4. Korelacja dwóch zmiennych indywidualnych w 8 grupach po 25 osób (r = 0 w populacji)
falszywe_r <- function(icc_x, icc_y, K = 8, m = 25) {
  mean(replicate(B, {
    g <- rep(seq_len(K), each = m)
    x <- rnorm(K, 0, sqrt(icc_x))[g] + rnorm(K * m, 0, sqrt(1 - icc_x))
    y <- rnorm(K, 0, sqrt(icc_y))[g] + rnorm(K * m, 0, sqrt(1 - icc_y))
    cor.test(x, y)$p.value < .05
  })) * 100
}
wyn4 <- c("tylko Y ma ICC = .10"    = falszywe_r(0, .10),
          "X i Y: ICC = .10"        = falszywe_r(.10, .10),
          "X i Y: ICC = .25"        = falszywe_r(.25, .25))
cat("\n4. Korelacja bez związku: odsetek wyników istotnych (%), 8 grup po 25 osób\n")
print(round(wyn4, 1))

# 5. Jeden zbiór: jak policzyć ICC i porównać dwa podejścia (8 grup, po 20 osób)
d <- symuluj(8, 20, .08)
tab <- anova(lm(y ~ factor(grupa), d))
ms_b <- tab[1, "Mean Sq"]; ms_w <- tab[2, "Mean Sq"]; m <- 20
icc <- (ms_b - ms_w) / (ms_b + (m - 1) * ms_w)
cat("\n5. Jeden zbiór (bez prawdziwej różnicy)\n")
cat("ICC z ANOVA:", round(icc, 3), " efekt schematu:", round(1 + (m - 1) * icc, 2),
    " efektywne N:", round(nrow(d) / (1 + (m - 1) * icc), 1), "\n")
t_os <- t.test(y ~ warunek, d, var.equal = TRUE)
sr <- aggregate(cbind(y, warunek) ~ grupa, d, mean)
t_sr <- t.test(y ~ warunek, sr, var.equal = TRUE)
bez0 <- function(p) sub("^0", "", sprintf("%.3f", p))
cat(sprintf("Test na osobach:  t(%d) = %.2f, p = %s\n", t_os$parameter, t_os$statistic, bez0(t_os$p.value)))
cat(sprintf("Test na średnich: t(%d) = %.2f, p = %s\n", t_sr$parameter, t_sr$statistic, bez0(t_sr$p.value)))
Wynik
1. Odsetek wyników istotnych przy braku różnicy (%), m = 20, alfa = .05
  K  icc deff osoby srednie
  2 0.00 1.00   4.9      NA
  4 0.00 1.00   5.0     4.9
  8 0.00 1.00   5.0     4.9
 16 0.00 1.00   5.1     5.0
  2 0.01 1.19   7.2      NA
  4 0.01 1.19   7.8     5.1
  8 0.01 1.19   7.4     5.2
 16 0.01 1.19   7.2     5.1
  2 0.02 1.38   9.2      NA
  4 0.02 1.38   9.7     4.9
  8 0.02 1.38   9.6     5.1
 16 0.02 1.38   9.3     5.0
  2 0.05 1.95  16.2      NA
  4 0.05 1.95  16.6     5.0
  8 0.05 1.95  16.0     5.1
 16 0.05 1.95  16.1     5.0
  2 0.10 2.90  26.5      NA
  4 0.10 2.90  25.0     4.9
  8 0.10 2.90  25.5     5.3
 16 0.10 2.90  25.4     5.5
  2 0.15 3.85  34.8      NA
  4 0.15 3.85  33.2     4.8
  8 0.15 3.85  32.2     5.0
 16 0.15 3.85  32.2     5.3
Efektywne N: 8 grup po 20 osób, ICC = .05: 82.1

2. Moc analizy na średnich grup (%), d = 0.50, ICC = .05, m = 20
 K=4  K=8 K=12 K=16 K=24
16.0 47.3 71.4 84.3 96.1

3. Pokrycie 95% CI dla średniej (%), 6 grup po 25 osób
         jak_osoby ze_srednich_grup
ICC=0         95.2             94.9
ICC=0.02      88.8             94.4
ICC=0.05      81.8             94.9
ICC=0.1       71.0             94.8

4. Korelacja bez związku: odsetek wyników istotnych (%), 8 grup po 25 osób
tylko Y ma ICC = .10     X i Y: ICC = .10     X i Y: ICC = .25
                 5.0                  7.1                 19.6

5. Jeden zbiór (bez prawdziwej różnicy)
ICC z ANOVA: 0.067  efekt schematu: 2.27  efektywne N: 70.5
Test na osobach:  t(158) = 0.67, p = .502
Test na średnich: t(6) = 0.42, p = .690
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim wejdziesz do sali, sprawdź
- Czy populacja z ostatniego zdania pracy to ta sama grupa co w tytule i Metodzie?
- Czy kluczowe zmienne (wiek, wykształcenie, nasilenie) mają w tej próbie jakąkolwiek zmienność?
- Czy znasz liczbę zapisanych, obecnych i wypełniających w każdej grupie?
- Czy prowadzący wie, że nie powinien widzieć odmów ani odpowiedzi?
- Czy punkty za udział są uzgodnione z promotorem i komisją, a niechętni mają alternatywę?
- Czy ankiety wracają do urny, a nie do Twojej ręki?
- Czy ludzie nie mogą widzieć wzajemnie swoich odpowiedzi?
- Czy numer grupy i kanał rekrutacji są zapisane w danych?
- Czy przydział jest losowy na poziomie osób, a jeśli grup, to czy masz ich dość?
- Czy ta sama instrukcja i podobny moment semestru obowiązują we wszystkich grupach?
Najczęstsze pytania
Czy można przeprowadzić badanie do pracy magisterskiej tylko na studentach?
Tak, jeśli pytanie dotyczy studentów albo uzasadnisz, że badany proces jest wspólny dla szerszej grupy. Tytuł, cel i wnioski powinny wtedy nazywać studentów, a nie młodych dorosłych. Peterson (2001) i Hanel i Vione (2016) pokazują, że wyniki studentów i osób spoza uczelni mogą się różnić w sposób trudny do przewidzenia.
Dlaczego korelacja z wiekiem w próbie studentów wychodzi bliska zera?
Bo wiek w takiej grupie prawie się nie zmienia, a korelacja maleje wraz z rozrzutem zmiennej. W symulacji ten sam związek dał r = .50 wśród dorosłych 18–70 lat i r = .08 wśród osób 19–26 lat, a nachylenie pozostało takie samo. Brak korelacji w wąskim zakresie nie jest dowodem, że wiek nie ma znaczenia.
Czy ankietę wypełnianą na ćwiczeniach trzeba analizować z uwzględnieniem grup?
Trzeba, gdy warunek przydzielono całym grupom, i warto sprawdzić, gdy podajesz średnią dla kierunku. Już przy ICC = .05 test t na osobach dawał w symulacji 16.0% fałszywych alarmów. Zapisz numer grupy, policz ICC i użyj analizy na średnich grup lub modelu wielopoziomowego.
Czy prowadzący może dawać punkty za udział w ankiecie studenta?
To zależy od zasad uczelni i komisji, więc zapytaj promotora, zanim to ogłosisz. Z punktu widzenia metodologii punkty osłabiają dobrowolność. Dlatego osoby niechętne powinny mieć równoważną alternatywę, a sposób i wysokość gratyfikacji trzeba opisać w Metodzie.
Czy ankieta na jednych zajęciach może być próbą reprezentatywną?
Zwykle nie. To dobór wygodny, a w sali są tylko osoby, które przyszły: w metaanalizie Credé i in. (2010) obecność silnie wiązała się z ocenami. Możesz porównać strukturę próby z danymi uczelni, ale zgodność płci lub trybu nie dowodzi zgodności badanej cechy.
Powiązane hasła
Przeczytaj też
Ograniczony zakres zmiennej – wizualizacja
Progi przyjęcia, selekcja po X i po Y, skrajne grupy i 1000 badań z poprawką Thorndike’a – pięć rysunków z kodem R.
Czytaj →PoradnikStatystyka w pracy z pedagogiki przedszkolnej
Obserwacja, nauczyciel a rodzic, przed–po, dwa oddziały, ankieta rodziców i wiek w miesiącach: testy, wielkość efektu, zdania APA i kod R.
Czytaj →PoradnikDobór próby w pracy dyplomowej
Metody losowe i nielosowe, co wolno wnioskować z próby wygodnej, symulacja w R, kryteria włączenia i gotowy opis doboru do rozdziału metodologicznego.
Czytaj →PoradnikGdzie znaleźć respondentów do ankiety?
Uczelnia, grupy tematyczne, kula śnieżna, panele i wymiana ankiet – porównanie kanałów, wzór zaproszenia, liczba zaproszeń i opis próby w pracy.
Czytaj →PoradnikBadanie we własnym miejscu pracy
Swoi pacjenci, uczniowie, zespół: zagrożenia, kto ma zbierać dane, symulacja aprobaty społecznej w R i zdania do Metody oraz Ograniczeń.
Czytaj →PoradnikJak opisać charakterystykę próby
Które cechy opisać, średnia czy mediana wieku, przedziały wiekowe, małe kategorie i braki oraz porównanie próby z populacją – z kodem R.
Czytaj →Zebrałeś dane w grupach na zajęciach i nie wiesz, jak je policzyć?
Sprawdzimy plan i analizę w R lub SPSS, a wyniki wyjaśnimy tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Credé, M., Roch, S. G., & Kieszczynka, U. M. (2010). Class attendance in college: A meta-analytic review of the relationship of class attendance with grades and student characteristics. Review of Educational Research, 80(2), 272–295. https://doi.org/10.3102/0034654310362998
- Ebersole, C. R., Atherton, O. E., Belanger, A. L., Skulborstad, H. M., Allen, J. M., Banks, J. B., Baranski, E., Bernstein, M. J., Bonfiglio, D. B. V., Boucher, L., Brown, E. R., Budiman, N. I., Cairo, A. H., Capaldi, C. A., Chartier, C. R., Chung, J. M., Cicero, D. C., Coleman, J. A., Conway, J. G., … Nosek, B. A. (2016). Many Labs 3: Evaluating participant pool quality across the academic semester via replication. Journal of Experimental Social Psychology, 67, 68–82. https://doi.org/10.1016/j.jesp.2015.10.012 ● Otwarty dostęp: pełny tekst
- Hanel, P. H. P., & Vione, K. C. (2016). Do student samples provide an accurate estimate of the general public? PLOS ONE, 11(12), Article e0168354. https://doi.org/10.1371/journal.pone.0168354 ● Otwarty dostęp
- Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2–3), 61–83. https://doi.org/10.1017/s0140525x0999152x
- Leentjens, A. F. G., & Levenson, J. L. (2013). Ethical issues concerning the recruitment of university students as research subjects. Journal of Psychosomatic Research, 75(4), 394–398. https://doi.org/10.1016/j.jpsychores.2013.03.007
- Leyrat, C., Morgan, K. E., Leurent, B., & Kahan, B. C. (2018). Cluster randomized trials with a small number of clusters: Which analyses should be used? International Journal of Epidemiology, 47(1), 321–331. https://doi.org/10.1093/ije/dyx169
- Ong, A. D., & Weiss, D. J. (2000). The impact of anonymity on responses to sensitive questions. Journal of Applied Social Psychology, 30(8), 1691–1708. https://doi.org/10.1111/j.1559-1816.2000.tb02462.x
- Peterson, R. A. (2001). On the use of college students in social science research: Insights from a second-order meta-analysis. Journal of Consumer Research, 28(3), 450–461. https://doi.org/10.1086/323732
- Sackett, P. R., & Yang, H. (2000). Correction for range restriction: An expanded typology. Journal of Applied Psychology, 85(1), 112–118. https://doi.org/10.1037/0021-9010.85.1.112
Cytowania BibTeX
@article{crede2010class, author={Credé, Marcus and Roch, Sylvia G. and Kieszczynka, Urszula M.}, title={{Class attendance in college: A meta-analytic review of the relationship of class attendance with grades and student characteristics}}, journal={Review of Educational Research}, year={2010}, volume={80}, number={2}, pages={272--295}, doi={10.3102/0034654310362998}}@article{ebersole2016many, author={Ebersole, Charles R. and Atherton, Olivia E. and Belanger, Aimee L. and Skulborstad, Hayley M. and Allen, Jill M. and Banks, Jonathan B. and Baranski, Erica and Bernstein, Michael J. and Bonfiglio, Diane B.V. and Boucher, Leanne and Brown, Elizabeth R. and Budiman, Nancy I. and Cairo, Athena H. and Capaldi, Colin A. and Chartier, Christopher R. and Chung, Joanne M. and Cicero, David C. and Coleman, Jennifer A. and Conway, John G. and Davis, William E. and Devos, Thierry and Fletcher, Melody M. and German, Komi and Grahe, Jon E. and Hermann, Anthony D. and Hicks, Joshua A. and Honeycutt, Nathan and Humphrey, Brandon and Janus, Matthew and Johnson, David J. and Joy-Gaba, Jennifer A. and Juzeler, Hannah and Keres, Ashley and Kinney, Diana and Kirshenbaum, Jacqeline and Klein, Richard A. and Lucas, Richard E. and Lustgraaf, Christopher J.N. and Martin, Daniel and Menon, Madhavi and Metzger, Mitchell and Moloney, Jaclyn M. and Morse, Patrick J. and Prislin, Radmila and Razza, Timothy and Re, Daniel E. and Rule, Nicholas O. and Sacco, Donald F. and Sauerberger, Kyle and Shrider, Emily and Shultz, Megan and Siemsen, Courtney and Sobocko, Karin and Weylin Sternglanz, R. and Summerville, Amy and Tskhay, Konstantin O. and van Allen, Zack and Vaughn, Leigh Ann and Walker, Ryan J. and Weinberg, Ashley and Wilson, John Paul and Wirth, James H. and Wortman, Jessica and Nosek, Brian A.}, title={{Many Labs 3: Evaluating participant pool quality across the academic semester via replication}}, journal={Journal of Experimental Social Psychology}, year={2016}, volume={67}, pages={68--82}, doi={10.1016/j.jesp.2015.10.012}}@article{hanel2016student, author={Hanel, Paul H. P. and Vione, Katia C.}, title={{Do student samples provide an accurate estimate of the general public?}}, journal={PLOS ONE}, year={2016}, volume={11}, number={12}, eid={e0168354}, doi={10.1371/journal.pone.0168354}}@article{henrich2010weirdest, author={Henrich, Joseph and Heine, Steven J. and Norenzayan, Ara}, title={{The weirdest people in the world?}}, journal={Behavioral and Brain Sciences}, year={2010}, volume={33}, number={2–3}, pages={61--83}, doi={10.1017/s0140525x0999152x}}@article{leentjens2013ethical, author={Leentjens, Albert F. G. and Levenson, James L.}, title={{Ethical issues concerning the recruitment of university students as research subjects}}, journal={Journal of Psychosomatic Research}, year={2013}, volume={75}, number={4}, pages={394--398}, doi={10.1016/j.jpsychores.2013.03.007}}@article{leyrat2018cluster, author={Leyrat, Clémence and Morgan, Katy E. and Leurent, Baptiste and Kahan, Brennan C.}, title={{Cluster randomized trials with a small number of clusters: Which analyses should be used?}}, journal={International Journal of Epidemiology}, year={2018}, volume={47}, number={1}, pages={321--331}, doi={10.1093/ije/dyx169}}@article{ong2000impact, author={Ong, Anthony D. and Weiss, David J.}, title={{The impact of anonymity on responses to sensitive questions}}, journal={Journal of Applied Social Psychology}, year={2000}, volume={30}, number={8}, pages={1691--1708}, doi={10.1111/j.1559-1816.2000.tb02462.x}}@article{peterson2001use, author={Peterson, Robert A.}, title={{On the use of college students in social science research: Insights from a second-order meta-analysis}}, journal={Journal of Consumer Research}, year={2001}, volume={28}, number={3}, pages={450--461}, doi={10.1086/323732}}@article{sackett2000correction, author={Sackett, Paul R. and Yang, Hyuckseung}, title={{Correction for range restriction: An expanded typology}}, journal={Journal of Applied Psychology}, year={2000}, volume={85}, number={1}, pages={112--118}, doi={10.1037/0021-9010.85.1.112}}