Ankieta zamknięta, a w skrzynce prośba o usunięcie
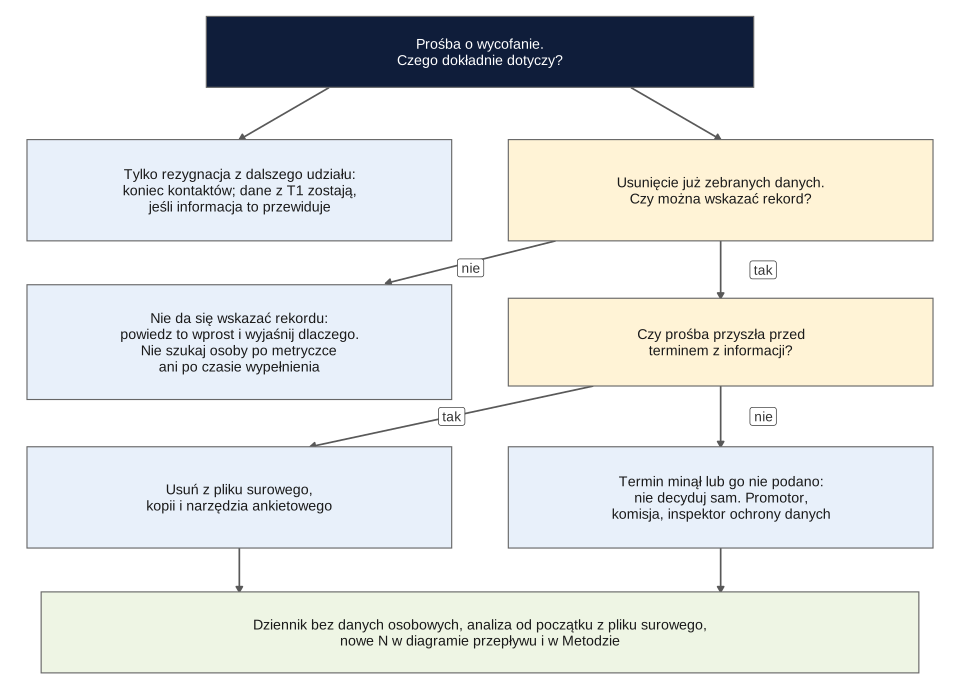
Zebrane 240 ankiet, policzone pierwsze tabele, i nagle wiadomość: „Proszę usunąć moje odpowiedzi”. Najpierw ustal, o co dokładnie prosi ta osoba i czy w ogóle da się znaleźć jej rekord. Dopiero potem cokolwiek kasuj. Od tych dwóch odpowiedzi zależy, co możesz zrobić, co napisać i czy zmieni się Twoje N.
Ten wpis to procedura na taką chwilę: scenariusze, gotowe odpowiedzi, usunięcie rekordu w R i zdania do pracy. Sam temat zgody i wzór całej informacji dla uczestnika opisuje hasło o świadomej zgodzie i RODO, a wycofanie po ujawnieniu zwodzenia ma własny fragment we wpisie o debriefingu. To nie jest porada prawna; zasady ustala komisja i uczelnia.
Przykład przewodni (fikcyjny, dane symulowane). Studentka porównuje poczucie kompetencji (0–100) po warsztacie (120 osób) i w grupie porównawczej (120 osób). Rekordy są opisane kodem tworzonym przez respondenta, bez nazwisk. Po zamknięciu ankiety przychodzi sześć próśb o usunięcie.
Trzy różne rzeczy, które łatwo pomylić
„Wycofuję się” może znaczyć kilka rzeczy, zwłaszcza gdy badanie ma drugi pomiar. Jeśli nie jest to jasne, zapytaj uczestnika jednym zdaniem, bez proszenia o powód.
| Zdarzenie | Co się stało | Co z danymi z T1 | W analizie |
|---|---|---|---|
| Rezygnacja z dalszego udziału | Osoba mówi: „nie chcę kolejnego pomiaru” | Zwykle zostają, jeśli informacja dla uczestnika to przewiduje. W razie wątpliwości zapytaj ją, czego chce | Brak T2 to brak danych; T1 nadal coś wnosi |
| Żądanie usunięcia danych | Osoba mówi: „usuńcie to, co już podałem” | Usuwasz, o ile da się wskazać rekord i zasady na to pozwalają | Rekordu nie ma, więc nie ma czego imputować; liczysz bez niego |
| Utrata uczestnika | Osoba po prostu nie wraca, nic nie mówi | Zostają zgodnie z informacją | Brak T2; sprawdź, kto odpada i kto ginie przy łączeniu kodów |
Różnica jest też statystyczna. Przy zwykłym ubytku masz dane z T1 i możesz porównać osoby, które zostały, z tymi, które odeszły. Ye i in. (2011) zwracają uwagę, że wycofanie wszystkich danych szczególnie utrudnia opisanie takich osób i statystyczne zmierzenie się z obciążeniem. Autorzy, piszący o badaniach randomizowanych, proponują imputację. W studenckiej ankiecie po usunięciu całego rekordu zwykle nie ma na czym jej oprzeć, a sens takiego zabiegu trzeba by uzgodnić z promotorem i komisją. W eksperymencie liczbę wycofań podaj osobno dla grup: decyzja uczestnika ma pierwszeństwo przed analizą ITT.
Co wynika z zasad, krótko
Poniższe punkty odczytano z tekstów źródłowych, ale ich zastosowanie w Twoim badaniu ocenia uczelnia.
- Deklaracja Helsińska (wersja z 2024 r., pkt 26; World Medical Association, 2025) mówi o badaniach medycznych: uczestnik ma usłyszeć, że może odmówić albo wycofać zgodę w każdej chwili, bez odwetu. Fragmenty o wycofaniu dotyczą zgody na udział i nie rozstrzygają losu zebranych danych.
- Dane anonimowe. Według motywu 26 RODO zasady ochrony danych nie mają zastosowania do informacji anonimowych (Parlament Europejski i Rada Unii Europejskiej, 2016).
- Gdy nie da się zidentyfikować osoby. Art. 11 ust. 2: jeśli administrator może wykazać, że nie jest w stanie jej zidentyfikować, w miarę możliwości ją o tym informuje. Prawa z art. 15–20 nie mają wtedy zastosowania, chyba że osoba dostarczy dodatkowe informacje umożliwiające identyfikację. Kod z ankiety może być taką informacją.
- Gdy podstawą była zgoda. Art. 7 ust. 3: zgodę można wycofać w dowolnym momencie, wycofanie nie wpływa na zgodność z prawem wcześniejszego przetwarzania, a ma być równie łatwe jak wyrażenie zgody. Art. 17 ust. 1 lit. b przewiduje usunięcie danych po cofnięciu zgody, gdy nie ma innej podstawy prawnej.
- Wyjątek dla nauki istnieje, ale nie jest Twój do użycia. Art. 17 ust. 3 lit. d wyłącza prawo do usunięcia w zakresie niezbędnym m.in. do celów badań naukowych, gdy prawdopodobnie uniemożliwiłoby ono lub poważnie utrudniło ich realizację. Nie powołuj się na niego samodzielnie w mailu do uczestnika. Administratorem danych bywa uczelnia, więc pytanie kieruj do promotora i inspektora ochrony danych.
Literatura etyczna też nie jest jednomyślna. Edwards (2005) dowodzi, że bezwarunkowe prawo do wycofania może podważać autonomię uczestników, i proponuje warunki oraz bieżące ustalenia między stronami. To stanowisko w dyskusji, a nie instrukcja dla magistranta: u Ciebie obowiązuje to, co obiecano w informacji, i zasady komisji. Ye i in. (2011) nie znaleźli jednoznacznych wytycznych dotyczących wycofania danych i zalecają, by formularz zgody jasno opisywał, co dzieje się z danymi po wycofaniu.
Sześć układów: co da się zrobić
| Układ | Czy da się znaleźć dane | Co zrobić | Co napisać |
|---|---|---|---|
| Ankieta w pełni anonimowa, bez kodu | Nie. Nie szukaj po metryczce ani czasie wypełnienia: to próba identyfikacji i ryzyko usunięcia cudzej odpowiedzi | Nic nie usuwasz; zapisz w dzienniku sam fakt prośby | „Nie mogę wskazać Twojej odpowiedzi, bo ankieta nie zbierała danych pozwalających ją rozpoznać” |
| Kod tworzony przez respondenta (SGIC) | Często tak, jeśli osoba poda kod. Kod bywa z błędem albo należy do dwóch osób | Szukaj dokładnie. Przy dwóch trafieniach dopytaj o element z metryczki; przy zerze poproś o sprawdzenie kodu | „Podaj proszę kod z ankiety. Nie potrzebuję imienia ani powodu” |
| Dane z kontaktem lub klucz pseudonimizacji | Tak, dopóki istnieje klucz | Usuń rekord i wiersz klucza; sprawdź, czy ta osoba nie występuje też na liście kontaktów lub nagród | Potwierdzenie usunięcia i zakresu |
| Drugi pomiar, odejście po T1 | Zależy od kodu | Rozstrzygnij: tylko bez T2 czy także usunięcie T1 (tabela wyżej) | „Czy chcesz tylko zakończyć udział, czy także usunąć odpowiedzi już przekazane?” |
| Po analizie, przed oddaniem | Tak jak w układach wyżej | Usuń i policz wszystko od nowa, także jeśli wynik się zmieni. To nie okazja do nowych wykluczeń | Potwierdzenie; wyników zbiorczych nie omawiaj |
| Po oddaniu pracy lub publikacji | Rekord zwykle tak, wyników zbiorczych nie da się „rozłożyć” na osoby | Nie decyduj sam: promotor, dział nauki, komisja, inspektor. Usuń z udostępnionego pakietu, jeśli był, i dodaj notę o wersji | „Skonsultuję to z uczelnią i wrócę do Ciebie do [data]” |
Co zapisać z góry w informacji dla uczestnika
Najłatwiej tę sytuację rozwiązać, zanim się zdarzy. W informacji dla uczestnika podaj cztery rzeczy: czy po wysłaniu da się wskazać odpowiedź, jak prosić o usunięcie, do kiedy to możliwe i co się stanie po tym terminie. Termin powinien wynikać z pracy, a nie być ozdobą: najczęściej jest to dzień usunięcia klucza albo rozpoczęcia analizy. Nie obiecuj usunięcia „w każdej chwili”, jeśli po obronie nie będziesz w stanie go wykonać. Treść uzgodnij z komisją.
Ankieta anonimowa, bez kodu:
Kod lub klucz pseudonimizacji:
Badanie z drugim pomiarem:
Jeśli zbiór ma trafić do repozytorium, zapisz to już w tej informacji. Meyer (2018) omawia, co pisać o udostępnianiu w formularzach zgody i jak myśleć o ryzyku ponownej identyfikacji, a szerzej ten wątek ujmuje plan zarządzania danymi.
Procedura krok po kroku
- Odpowiedz szybko i bez pytania o powód. Podziękuj, ustal zakres, nie zachęcaj do zmiany decyzji. Tym bardziej nie wolno tego robić, gdy zaproszenie wyszło z Twojego miejsca pracy albo uczestnik ma mniej niż 18 lat. Jeśli z wiadomości wynika, że ktoś potrzebuje pomocy, zajmij się tym osobno: ankieta ujawnia zagrożenie.
- Powiadom promotora, a gdy w grę wchodzą dane osobowe, także inspektora ochrony danych uczelni. Uczelnia może mieć własne terminy.
- Znajdź rekord dokładnie po kodzie lub kluczu. Nie po podobieństwie. Niejasne przypadki zostaw do wyjaśnienia.
- Usuń ze wszystkich miejsc: plik surowy, kopie zapasowe, narzędzie ankietowe (inaczej nowy eksport przywróci rekord), plik u promotora, klucz i listę kontaktów, papierowy kwestionariusz zgodnie z zasadami miejsca, w którym go przechowujesz.
- Zapisz nową wersję pliku surowego. Zwykle plik surowy jest tylko do odczytu. Tu robisz świadomy wyjątek i notujesz nową sumę kontrolną.
- Wpisz wiersz do dziennika według wzoru z reguł kontroli danych, ale bez danych osobowych: numer wniosku, data, skutek, nowa suma kontrolna. Bez kodu, nazwiska i adresu.
- Uruchom analizę od początku z pliku surowego. Nie „odejmuj” osoby od gotowych tabel. Zmienią się wszystkie liczby, które zależą od tych rekordów, także alfa i wyniki testów.
- Zniszcz listę kodów do usunięcia, gdy kontrola się zgodzi, i potwierdź uczestnikowi wykonanie.
Odpowiedź, gdy rekord można znaleźć:
Odpowiedź, gdy nie można:
Co pokazał przykład
Z sześciu próśb cztery dały jedno trafienie (także kod wpisany małymi literami), jedna żadnego, a jedna dwa. W tej ostatniej studentka nie wybrała rekordu sama: uczestnik podał dodatkowo wiek. Kontrola pokazała, że usunięte identyfikatory zniknęły z pliku, natomiast kod z listy nadal występuje raz. To drugi rekord o tym samym kodzie, należący do innej osoby, dlatego kontrolę prowadź po identyfikatorze rekordu, a nie po samym kodzie. Jak często kody się powtarzają, pokazuje wpis o kodzie identyfikacyjnym, do którego prowadzi tabela układów.
| Miara | Przed | Po |
|---|---|---|
| N (warsztat / porównawcza) | 240 (120 / 120) | 235 (117 / 118) |
| Średnia ogółem (SD) | 61.04 (11.56) | 61.00 (11.54) |
| Średnia: warsztat | 63.92 | 63.73 |
| Średnia: porównawcza | 58.15 | 58.29 |
| Różnica | 5.77 | 5.44 |
| Test t Welcha | t(236.85) = 3.99, p < .001 | t(231.48) = 3.71, p < .001 |
| d | 0.515 | 0.484 |
| r ze wsparciem | .268 | .273 |
Wnioski się tu nie zmieniły, ale liczby tak, i to one idą do pracy. W prawdziwym badaniu wartości „przed” pochodzą ze starego raportu, jeśli go już miałaś lub miałeś. Nie licz porównania na danych, o których usunięcie ktoś poprosił: to dalsze ich wykorzystanie.
Co z tym w pracy
W diagramie przepływu dodaj osobne pole: „wycofano zgodę po zebraniu danych, usunięto rekordy”. Nie mieszaj go z kryteriami wykluczeń ani z brakami danych. Podaj wszędzie to samo nowe N. Jeśli planowana liczebność była napięta, skorzystaj z analizy wrażliwości. Nazwisk ani opisu uczestników, którzy się wycofali, w pracy nie umieszczasz. W małej grupie nawet liczba z podziałem na oddział może kogoś wskazać, więc zadbaj o anonimowość w małych zespołach.
Jak bywa napisane: „Z badania wyłączono 5 osób”.
Co nie tak: nie wiadomo, czy była to reguła analityczna, czy decyzja uczestników.
Poprawione: pierwsze zdanie poniżej.
Jak bywa napisane: „Pięć osób zrezygnowało, co nie miało wpływu na wyniki”.
Co nie tak: tego nie wiadomo, bo ich danych już nie ma.
Poprawione: napisz, że nie można tego ocenić (ostatnie zdanie poniżej).
Metoda – wycofania:
Metoda – drugi pomiar:
Ograniczenia:
Szerzej o tej części pracy: ograniczenia badania – jak je opisać. Przykłady i liczby w tym wpisie są fikcyjne.
Czy kilka wycofań może przesunąć wynik?
Zależy od tego, kto się wycofuje. Symulacja bierze dwie grupy po 120 osób (wynik 0–100, SD = 12) i usuwa 2%, 5%, 10% lub 20% osób według trzech mechanizmów. Selektywność ustawiono ręcznie: osoba 1 SD poniżej średniej ma około 4.5 raza większą szansę wycofania niż przeciętna. To parametry fikcyjne, a nie oszacowanie, jak często ludzie się wycofują.
| Kto się wycofuje | Wycofania | Zmiana średniej ogółem | Obciążenie różnicy (brak efektu) | Fałszywe alarmy | Moc przy d = 0.40 |
|---|---|---|---|---|---|
| Niezależnie od wyniku | 2% | 0.00 | 0.02 | 4.98% | 86.42% |
| Niezależnie od wyniku | 20% | 0.00 | 0.02 | 5.27% | 78.39% |
| Niskie wyniki, obie grupy | 5% | 0.82 | 0.00 | 5.18% | 82.65% |
| Niskie wyniki, obie grupy | 20% | 3.01 | 0.00 | 4.88% | 67.74% |
| Niskie wyniki, tylko warsztat | 5% | 0.74 | 1.57 | 18.76% | 98.27% |
| Niskie wyniki, tylko warsztat | 10% | 1.33 | 3.00 | 49.28% | 99.83% |
| Niskie wyniki, tylko warsztat | 20% | 2.21 | 5.90 | 94.86% | 100.00% |
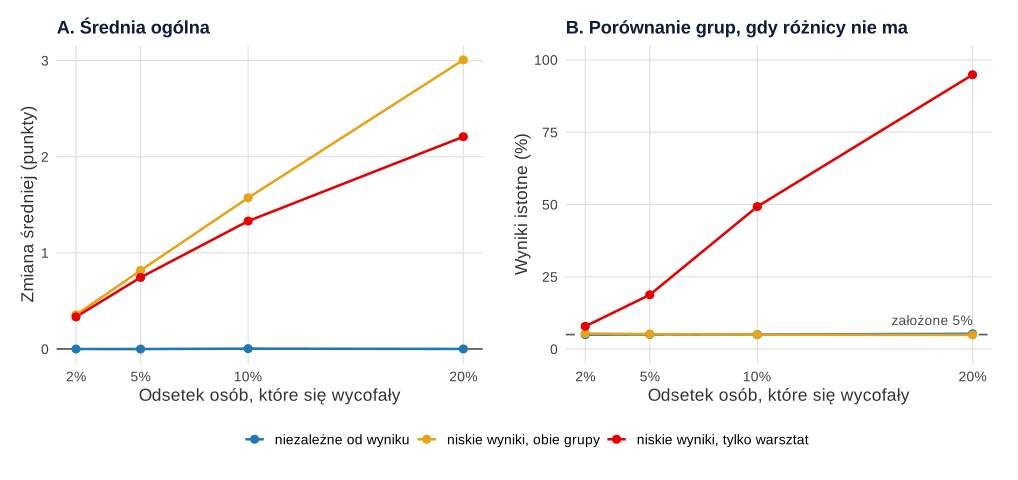
- Wycofania niezależne od wyniku kosztują tylko moc: z 86.65% przy pełnej próbie do 86.42% przy 2% wycofań i 78.39% przy 20%. Przy pięciu osobach na 240 strata mocy jest znikoma.
- Niskie wyniki w obu grupach zawyżają średnią (o 3.01 punktu przy 20%). Gdy różnicy nie ma, porównanie grup zostaje uczciwe (4.88%), ale gdy istnieje, odchodzą głównie osoby z grupy o niższych wynikach: różnica maleje o 1.11 punktu przy 20%, a moc spada do 67.74%.
- Niskie wyniki w jednej grupie to najgroźniejszy układ: 12 wycofań (5%) daje 18.76% fałszywych alarmów, 48 (20%) daje 94.86%. Wysoka „moc” w tym wierszu nie jest zaletą, bo program wygląda lepiej przez to, kto odszedł.
Podobny wzorzec opisano przy utracie uczestników. W symulacji Kristmana i in. (2004) utrata 5–60% osób nie dawała istotnego obciążenia przy mechanizmach MCAR i MAR, ale przy MNAR silne obciążenie pojawiało się już przy niskiej utracie. Bell i in. (2013) pokazują, że równy odsetek odejść w grupach może dać obciążony wynik, a nierówny nieobciążony, więc sama równość odsetków nic nie gwarantuje. Zhou i Fishbach (2016) opisali, jak nieuwzględniony ubytek różniący się między warunkami prowadził do fałszywych wniosków w eksperymentach online. Dumville i in. (2006) podkreślają, że nie ma jednego progu, od którego utrata staje się problemem. Mechanizm opisuje też hasło o błędzie selekcji.
Z tej symulacji nie wynika, że prośbę należy odrzucić, by chronić wynik. Selektywne wycofania są ceną dobrowolnego udziału. Odmowa ich nie „naprawia”, tylko dokłada presję, a odmowa wbrew obietnicy z informacji jest złamaniem tego, co uczestnik usłyszał przed badaniem. Twoim zadaniem jest podać liczbę, policzyć od nowa, a przy większej liczbie wycofań, zwłaszcza w jednej grupie, omówić możliwy kierunek obciążenia, np. w analizie wrażliwości ustalonej z promotorem.
Najczęstsze błędy
- Pytanie o powód i przekonywanie. Nawet życzliwe „a może jednak” bywa presją.
- Szukanie „anonimowego” rekordu po dacie i metryczce. Możesz usunąć cudzą odpowiedź i naruszyć obietnicę anonimowości.
- Usunięcie z pliku roboczego i zostawienie w surowym. Następne uruchomienie skryptu przywróci osobę.
- Pominięcie narzędzia ankietowego i kopii u promotora. Rekord wraca z nowym eksportem.
- Kod lub nazwisko w dzienniku. Dziennik ma pokazywać, co zrobiono, a nie kto o to prosił.
- Ręczne poprawianie tabel zamiast ponownej analizy. Liczby przestają się zgadzać ze skryptem; patrz co sprawdzić, gdy wynik wygląda podejrzanie.
- Łączenie wycofań z wykluczeniami. To inna przyczyna i inne pole diagramu.
- Dobieranie wykluczeń po wycofaniu, żeby „wrócić” do poprzedniego wyniku. Tak zaczyna się selektywne raportowanie.
- Obietnica bez pokrycia. „Możesz usunąć dane w każdej chwili” w ankiecie, w której nie ma ich jak wskazać.
Usuwanie rekordów i symulacja wycofań w R
Dwa przepisy liczą wszystkie liczby z tabel i tekstu. Rysunki powstały w osobnym skrypcie. Ziaren nie wybierano pod wynik. Ręcznie ustawiono wielkość próby, listę próśb, siłę selektywności (b = 1.5) i efekt 4.8 punktu (d = 0.40). Pobierz fikcyjną bazę w CSV (240 wierszy).
Lista kodów, usunięcie, ponowne policzenie
R
# Wycofanie po zebraniu danych: lista kodów, usunięcie, ponowne policzenie.
# Baza i wnioski są w całości fikcyjne.
set.seed(518)

# 1. Fikcyjna baza surowa: kod zamiast nazwiska, 2 grupy, wynik 0-100
n <- 240
litery <- c("AN","BA","EW","JO","KA","MA","TE","ZO")
kod <- paste0(sample(litery, n, TRUE), sprintf("%02d", sample(1:28, n, TRUE)),
              sprintf("%02d", sample(1:12, n, TRUE)))
grupa <- rep(c("warsztat", "porownawcza"), each = n / 2)
wsparcie <- round(rnorm(n, 50, 10))
wynik <- round(pmin(pmax(58 + 4 * (grupa == "warsztat") +
                         0.30 * (wsparcie - 50) + rnorm(n, 0, 11), 0), 100))
wiek <- sample(20:45, n, TRUE)
baza <- data.frame(id = sprintf("R%03d", 1:n), kod, wiek, grupa, wsparcie, wynik)
write.csv(baza, "baza-fikcyjna-wycofania.csv", row.names = FALSE)

# Jedna funkcja analizy: ta sama przed usunięciem i po nim
analiza <- function(d) {
  a <- d$wynik[d$grupa == "warsztat"]; b <- d$wynik[d$grupa == "porownawcza"]
  tt <- t.test(a, b)
  s <- sqrt((var(a) + var(b)) / 2)
  c(N = nrow(d), n_warsztat = length(a), n_porown = length(b),
    M_ogolem = mean(d$wynik), SD_ogolem = sd(d$wynik),
    M_warsztat = mean(a), M_porown = mean(b),
    roznica = mean(a) - mean(b), t = unname(tt$statistic), df = unname(tt$parameter),
    p = tt$p.value, d = (mean(a) - mean(b)) / s,
    r_wsparcie = cor(d$wsparcie, d$wynik))
}
surowe <- read.csv("baza-fikcyjna-wycofania.csv")
przed <- analiza(surowe)

# 2. Wnioski o usunięcie: numer wniosku i kod podany przez uczestnika
licz <- table(surowe$kod)
jedyne <- names(licz)[licz == 1]; podwojne <- names(licz)[licz == 2]
wnioski <- data.frame(wniosek = sprintf("W%02d", 1:6),
  kod = c(sample(jedyne, 3), tolower(sample(jedyne, 1)), "XX9999", podwojne[1]))
wnioski$kod_norm <- toupper(trimws(wnioski$kod))

# 3. Dopasowanie: ile rekordów odpowiada każdemu kodowi?
wnioski$trafienia <- sapply(wnioski$kod_norm, function(k) sum(surowe$kod == k))
print(wnioski[, c("wniosek", "trafienia")], row.names = FALSE)

# Kod zdublowany: nie zgaduj. Tu uczestnik podał dodatkowo swój wiek.
wiek_doprecyzowany <- surowe$wiek[surowe$kod == podwojne[1]][1]
do_usuniecia <- surowe$id[surowe$kod %in% wnioski$kod_norm[wnioski$trafienia == 1]]
ktory <- surowe$id[surowe$kod == podwojne[1] & surowe$wiek == wiek_doprecyzowany]
stopifnot(length(ktory) == 1)
do_usuniecia <- c(do_usuniecia, ktory)
cat("\nRekordy do usunięcia:", length(do_usuniecia), "\n")

# 4. Nowa wersja pliku surowego i kontrola
# (stary plik i wszystkie jego kopie usuwasz dopiero po tej kontroli)
usuniete_kody <- surowe$kod[surowe$id %in% do_usuniecia]
nowe <- surowe[!surowe$id %in% do_usuniecia, ]
write.csv(nowe, "baza-surowa-v2.csv", row.names = FALSE)
spr <- read.csv("baza-surowa-v2.csv")
stopifnot(nrow(spr) == nrow(surowe) - length(do_usuniecia),
          !any(spr$id %in% do_usuniecia))
cat("Rekordów przed:", nrow(surowe), " po:", nrow(spr), "\n")
cat("Usunięte id jeszcze w pliku:", sum(spr$id %in% do_usuniecia), "\n")
cat("Kody z listy nadal w pliku:", sum(spr$kod %in% usuniete_kody), "\n")
cat("  (z tego drugi rekord o zdublowanym kodzie:",
    sum(spr$kod == podwojne[1]), ")\n")
cat("Suma kontrolna v2:", substr(unname(tools::md5sum("baza-surowa-v2.csv")), 1, 12), "\n")

# 5. Analiza od początku, z nowego pliku surowego
po <- analiza(read.csv("baza-surowa-v2.csv"))
tabela <- rbind(przed = przed, po = po, zmiana = po - przed)
cat("\nPrzed i po usunięciu\n")
print(round(tabela[, c("N", "n_warsztat", "n_porown", "M_ogolem", "SD_ogolem")], 2))
print(round(tabela[, c("M_warsztat", "M_porown", "roznica", "t", "df")], 2))
print(round(tabela[, c("d", "r_wsparcie")], 3))
cat("p przed:", format(przed[["p"]], digits = 3),
    " p po:", format(po[["p"]], digits = 3), "\n\n")

# 6. Dziennik bez danych osobowych: bez kodów, nazwisk i adresów
dziennik <- data.frame(
  wniosek = wnioski$wniosek,
  wynik = ifelse(wnioski$trafienia == 0, "nie znaleziono, odpowiedziano",
          ifelse(wnioski$trafienia == 1, "usunieto 1 rekord",
                 "kod niejednoznaczny, doprecyzowano, usunieto 1 rekord")))
print(dziennik, row.names = FALSE)
Wynik
 wniosek trafienia
     W01         1
     W02         1
     W03         1
     W04         1
     W05         0
     W06         2

Rekordy do usunięcia: 5
Rekordów przed: 240  po: 235
Usunięte id jeszcze w pliku: 0
Kody z listy nadal w pliku: 1
  (z tego drugi rekord o zdublowanym kodzie: 1 )
Suma kontrolna v2: f5d3520d0402

Przed i po usunięciu
         N n_warsztat n_porown M_ogolem SD_ogolem
przed  240        120      120    61.04     11.56
po     235        117      118    61.00     11.54
zmiana  -5         -3       -2    -0.04     -0.02
       M_warsztat M_porown roznica     t     df
przed       63.92    58.15    5.77  3.99 236.85
po          63.73    58.29    5.44  3.71 231.48
zmiana      -0.20     0.14   -0.34 -0.28  -5.37
            d r_wsparcie
przed   0.515      0.268
po      0.484      0.273
zmiana -0.031      0.005
p przed: 8.82e-05  p po: 0.000262

 wniosek                                                 wynik
     W01                                     usunieto 1 rekord
     W02                                     usunieto 1 rekord
     W03                                     usunieto 1 rekord
     W04                                     usunieto 1 rekord
     W05                         nie znaleziono, odpowiedziano
     W06 kod niejednoznaczny, doprecyzowano, usunieto 1 rekord
Symulacja: wycofania losowe i selektywne
R
# Czy wycofania przesuwają wynik? Symulacja; wszystkie parametry są fikcyjne.
# Wynik 0-100 (M = 60, SD = 12), dwie grupy po 120 osób.
set.seed(5182)
B <- 10000
sd_y <- 12

# Kto się wycofuje: k osób z całej próby albo z jednej grupy.
# Waga exp(-b * z): im niższy wynik, tym większa szansa wycofania (b = 0: los).
wybierz <- function(y, gr, k, b, tylko_program) {
  z <- (y - mean(y)) / sd(y)
  pula <- if (tylko_program) which(gr == 1) else seq_along(y)
  w <- exp(-b * z[pula])
  pula[sample.int(length(pula), k, prob = w)]
}

jedno <- function(delta, proc, b, tylko_program, n = 240) {
  gr <- rep(1:0, each = n / 2)
  y <- rnorm(n, 60 + delta * gr, sd_y)
  k <- round(n * proc / 100)
  if (k > 0) {
    out <- wybierz(y, gr, k, b, tylko_program)
    pelna <- mean(y); y <- y[-out]; gr <- gr[-out]
  } else pelna <- mean(y)
  a <- y[gr == 1]; c0 <- y[gr == 0]
  se2 <- var(a) / length(a) + var(c0) / length(c0)
  t <- (mean(a) - mean(c0)) / sqrt(se2)
  df <- se2^2 / ((var(a) / length(a))^2 / (length(a) - 1) +
                   (var(c0) / length(c0))^2 / (length(c0) - 1))
  c(sr = mean(y) - pelna, roz = mean(a) - mean(c0) - delta,
    ist = 2 * pt(-abs(t), df) < .05)
}

mechanizmy <- list(
  "niezależne od wyniku"           = list(b = 0,   tylko = FALSE),
  "niskie wyniki, obie grupy"      = list(b = 1.5, tylko = FALSE),
  "niskie wyniki, tylko warsztat"  = list(b = 1.5, tylko = TRUE))
procenty <- c(2, 5, 10, 20)

wyniki <- do.call(rbind, lapply(names(mechanizmy), function(m) {
  do.call(rbind, lapply(procenty, function(p) {
    par <- mechanizmy[[m]]
    h0 <- rowMeans(replicate(B, jedno(0, p, par$b, par$tylko)))
    h1 <- rowMeans(replicate(B, jedno(4.8, p, par$b, par$tylko)))
    data.frame(mechanizm = m, wycofania_proc = p,
               k = round(240 * p / 100),
               zmiana_sredniej = h0[["sr"]],
               zmiana_w_SD = h0[["sr"]] / sd_y,
               obciazenie_roznicy = h0[["roz"]],
               falszywe_alarmy = 100 * h0[["ist"]],
               obciazenie_przy_d040 = h1[["roz"]],
               moc_d040 = 100 * h1[["ist"]])
  }))
}))
pelne0 <- rowMeans(replicate(B, jedno(0, 0, 0, FALSE)))
pelne1 <- rowMeans(replicate(B, jedno(4.8, 0, 0, FALSE)))
cat("Bez wycofań: fałszywe alarmy", round(100 * pelne0[["ist"]], 2),
    "%, moc (d = 0.40)", round(100 * pelne1[["ist"]], 2), "%\n\n")
w <- wyniki
w[, 4:9] <- round(w[, 4:9], 2)
print(w[, 1:6], row.names = FALSE)
print(w[, c(1, 2, 7:9)], row.names = FALSE)
Wynik
Bez wycofań: fałszywe alarmy 4.82 %, moc (d = 0.40) 86.65 %

                     mechanizm wycofania_proc  k zmiana_sredniej zmiana_w_SD
          niezależne od wyniku              2  5            0.00        0.00
          niezależne od wyniku              5 12            0.00        0.00
          niezależne od wyniku             10 24            0.00        0.00
          niezależne od wyniku             20 48            0.00        0.00
     niskie wyniki, obie grupy              2  5            0.35        0.03
     niskie wyniki, obie grupy              5 12            0.82        0.07
     niskie wyniki, obie grupy             10 24            1.57        0.13
     niskie wyniki, obie grupy             20 48            3.01        0.25
 niskie wyniki, tylko warsztat              2  5            0.33        0.03
 niskie wyniki, tylko warsztat              5 12            0.74        0.06
 niskie wyniki, tylko warsztat             10 24            1.33        0.11
 niskie wyniki, tylko warsztat             20 48            2.21        0.18
 obciazenie_roznicy
               0.02
              -0.03
              -0.02
               0.02
               0.00
               0.00
              -0.01
               0.00
               0.69
               1.57
               3.00
               5.90
                     mechanizm wycofania_proc falszywe_alarmy
          niezależne od wyniku              2            4.98
          niezależne od wyniku              5            5.08
          niezależne od wyniku             10            5.01
          niezależne od wyniku             20            5.27
     niskie wyniki, obie grupy              2            5.35
     niskie wyniki, obie grupy              5            5.18
     niskie wyniki, obie grupy             10            4.97
     niskie wyniki, obie grupy             20            4.88
 niskie wyniki, tylko warsztat              2            7.86
 niskie wyniki, tylko warsztat              5           18.76
 niskie wyniki, tylko warsztat             10           49.28
 niskie wyniki, tylko warsztat             20           94.86
 obciazenie_przy_d040 moc_d040
                 0.00    86.42
                 0.01    85.69
                -0.02    82.80
                 0.00    78.39
                -0.16    85.00
                -0.35    82.65
                -0.66    77.07
                -1.11    67.74
                 0.66    93.86
                 1.55    98.27
                 2.98    99.83
                 5.84   100.00
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim uruchomisz ankietę i gdy przyjdzie prośba
- Czy informacja mówi, czy da się wskazać odpowiedź po wysłaniu?
- Czy jest adres, sposób zgłoszenia i termin usunięcia?
- Czy termin zgadza się z datą usunięcia klucza lub rozpoczęcia analizy?
- Czy przy kilku pomiarach odróżniasz rezygnację z dalszego udziału od usunięcia?
- Czy wiesz, czego dokładnie dotyczy prośba, i nie zapytałeś(-aś) o powód?
- Czy powiadomiono promotora, a w razie danych osobowych inspektora?
- Czy rekord został wskazany dokładnie, a zdublowane kody wyjaśnione?
- Czy usunięto go z pliku surowego, kopii, narzędzia ankietowego i klucza?
- Czy dziennik nie zawiera danych osobowych?
- Czy analiza poszła od początku z pliku surowego, a nowe N jest wszędzie takie samo?
Najczęstsze pytania
Czy muszę usunąć dane uczestnika, który się wycofał?
Jeśli rekord da się wskazać, a prośba mieści się w zasadach z informacji dla uczestnika, zwykle tak. Szczegóły zależą od podstawy przetwarzania i zasad uczelni, więc przy danych osobowych skontaktuj się z promotorem i inspektorem ochrony danych. Ten wpis nie jest poradą prawną.
Jak usunąć odpowiedź z anonimowej ankiety, skoro nie wiem, czyja jest?
Nie da się tego zrobić i nie należy próbować zgadywać po metryczce ani czasie wypełnienia. Odpowiedz uczciwie, że ankieta nie zbierała danych pozwalających wskazać odpowiedź. Dlatego informacja przed ankietą powinna mówić wprost, że po wysłaniu usunięcie nie będzie możliwe.
Czy osoba, która nie wypełniła drugiego pomiaru, wycofała się z badania?
Niekoniecznie. Brak drugiego pomiaru bez żadnej wiadomości to utrata uczestnika, a dane z pierwszego zostają zgodnie z informacją. Rezygnacja z kolejnego pomiaru i prośba o usunięcie odpowiedzi to dwie inne sytuacje, które w Metodzie podaje się osobno.
Co zrobić, gdy uczestnik chce się wycofać po oddaniu pracy?
Nie decyduj samodzielnie. Skontaktuj się z promotorem, komisją i inspektorem ochrony danych uczelni. Rekord można zwykle usunąć z plików i z udostępnionego zbioru, natomiast wyników zbiorczych nie da się rozłożyć na osoby. Odpowiedz uczestnikowi, kiedy wrócisz z ustaleniami.
Czy po usunięciu kilku rekordów muszę przeliczać całą analizę?
Tak. Uruchom skrypt od początku z nowej wersji pliku surowego, bo zmienią się liczebności, średnie, testy i rzetelność skal. Nowe N wpisz do diagramu przepływu, tabel i Metody. Wyniku nie poprawiaj ręcznie ani nie dobieraj nowych wykluczeń po to, by wrócić do poprzedniego wyniku.
Powiązane hasła
Przeczytaj też
Kod identyfikacyjny w ankiecie anonimowej
Jak zbudować kod respondenta, ile osób ma taki sam, dopasowanie z odległością Levenshteina, fałszywe pary i RODO – z symulacją w R.
Czytaj →PoradnikDiagram przepływu respondentów
Od 612 wejść w link do 413 analizowanych: etapy, kryteria wykluczeń i ich kolejność, odsetek odpowiedzi i diagram w R.
Czytaj →PoradnikReguły kontroli danych i dziennik zmian
Zakresy, logika pytań i sumy kontrolne zapisane z góry, tabela naruszeń w R, decyzje i dziennik zmian odtwarzający czysty zbiór.
Czytaj →PoradnikZebrano mniej osób, niż planowano
Dobierać dalej czy analizować? Drzewo decyzji, symulacja dobierania w R, analiza wrażliwości i gotowe zdania do Metody i Ograniczeń.
Czytaj →Musisz usunąć rekordy i przeliczyć wyniki przed terminem?
Sprawdzimy kolejność zmian w danych, policzymy analizy od nowa w R lub SPSS, a wyniki wyjaśnimy tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bell, M. L., Kenward, M. G., Fairclough, D. L., & Horton, N. J. (2013). Differential dropout and bias in randomised controlled trials: When it matters and when it may not. BMJ, 346, Article e8668. https://doi.org/10.1136/bmj.e8668 ● Otwarty dostęp
- Dumville, J. C., Torgerson, D. J., & Hewitt, C. E. (2006). Reporting attrition in randomised controlled trials. BMJ, 332(7547), 969–971. https://doi.org/10.1136/bmj.332.7547.969 ● Otwarty dostęp: pełny tekst
- Edwards, S. J. L. (2005). Research participation and the right to withdraw. Bioethics, 19(2), 112–130. https://doi.org/10.1111/j.1467-8519.2005.00429.x
- Kristman, V., Manno, M., & Côté, P. (2004). Loss to follow-up in cohort studies: How much is too much? European Journal of Epidemiology, 19(8), 751–760. https://doi.org/10.1023/b:ejep.0000036568.02655.f8
- Meyer, M. N. (2018). Practical tips for ethical data sharing. Advances in Methods and Practices in Psychological Science, 1(1), 131–144. https://doi.org/10.1177/2515245917747656 ● Otwarty dostęp
- Parlament Europejski i Rada Unii Europejskiej. (2016). Rozporządzenie Parlamentu Europejskiego i Rady (UE) 2016/679 z dnia 27 kwietnia 2016 r. w sprawie ochrony osób fizycznych w związku z przetwarzaniem danych osobowych i w sprawie swobodnego przepływu takich danych oraz uchylenia dyrektywy 95/46/WE (ogólne rozporządzenie o ochronie danych). Dziennik Urzędowy Unii Europejskiej. https://eur-lex.europa.eu/eli/reg/2016/679/oj ● Otwarty dostęp: pełny tekst
- World Medical Association. (2025). World Medical Association Declaration of Helsinki. JAMA, 333(1), 71. https://doi.org/10.1001/jama.2024.21972
- Ye, C., Giangregorio, L., Holbrook, A., Pullenayegum, E., Goldsmith, C. H., & Thabane, L. (2011). Data withdrawal in randomized controlled trials: Defining the problem and proposing solutions. Contemporary Clinical Trials, 32(3), 318–322. https://doi.org/10.1016/j.cct.2011.01.016
- Zhou, H., & Fishbach, A. (2016). The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions. Journal of Personality and Social Psychology, 111(4), 493–504. https://doi.org/10.1037/pspa0000056
Cytowania BibTeX
@article{bell2013differential, author={Bell, Melanie L. and Kenward, Michael G. and Fairclough, Diane L. and Horton, Nicholas J.}, title={{Differential dropout and bias in randomised controlled trials: When it matters and when it may not}}, journal={BMJ}, year={2013}, volume={346}, eid={e8668}, doi={10.1136/bmj.e8668}}@article{dumville2006reporting, author={Dumville, Jo C. and Torgerson, David J. and Hewitt, Catherine E.}, title={{Reporting attrition in randomised controlled trials}}, journal={BMJ}, year={2006}, volume={332}, number={7547}, pages={969--971}, doi={10.1136/bmj.332.7547.969}}@article{edwards2005research, author={Edwards, Sarah J. L.}, title={{Research participation and the right to withdraw}}, journal={Bioethics}, year={2005}, volume={19}, number={2}, pages={112--130}, doi={10.1111/j.1467-8519.2005.00429.x}}@article{kristman2004loss, author={Kristman, Vicki and Manno, Michael and Côté, Pierre}, title={{Loss to follow-up in cohort studies: How much is too much?}}, journal={European Journal of Epidemiology}, year={2004}, volume={19}, number={8}, pages={751--760}, doi={10.1023/b:ejep.0000036568.02655.f8}}@article{meyer2018practical, author={Meyer, Michelle N.}, title={{Practical tips for ethical data sharing}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={131--144}, doi={10.1177/2515245917747656}}@misc{eu2016regulation, author={{Parlament Europejski i Rada Unii Europejskiej}}, title={{Rozporządzenie Parlamentu Europejskiego i Rady (UE) 2016/679 z dnia 27 kwietnia 2016 r. w sprawie ochrony osób fizycznych w związku z przetwarzaniem danych osobowych i w sprawie swobodnego przepływu takich danych oraz uchylenia dyrektywy 95/46/WE (ogólne rozporządzenie o ochronie danych)}}, howpublished={Dziennik Urzędowy Unii Europejskiej}, year={2016}, volume={L 119}, pages={1--88}, url={https://eur-lex.europa.eu/eli/reg/2016/679/oj}}@article{wma2025declaration, author={{World Medical Association}}, title={{World Medical Association Declaration of Helsinki}}, journal={JAMA}, year={2025}, volume={333}, number={1}, pages={71}, doi={10.1001/jama.2024.21972}}@article{ye2011data, author={Ye, Chenglin and Giangregorio, Lora and Holbrook, Anne and Pullenayegum, Eleanor and Goldsmith, Charlie H. and Thabane, Lehana}, title={{Data withdrawal in randomized controlled trials: Defining the problem and proposing solutions}}, journal={Contemporary Clinical Trials}, year={2011}, volume={32}, number={3}, pages={318--322}, doi={10.1016/j.cct.2011.01.016}}@article{zhou2016pitfall, author={Zhou, Haotian and Fishbach, Ayelet}, title={{The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions}}, journal={Journal of Personality and Social Psychology}, year={2016}, volume={111}, number={4}, pages={493--504}, doi={10.1037/pspa0000056}}