Dziwna liczba to sygnał do sprawdzenia, a nie gotowy wynik
Średnia 9.03 na skali od 1 do 7. Alfa −1.92. Korelacja 1.00 między dwiema różnymi zmiennymi. Takie liczby rzadko są odkryciem. Zwykle mówią coś o pliku, a nie o badanych. Zanim napiszesz choć jedno zdanie o wyniku, ustal, skąd się wziął objaw.
Ten wpis działa od objawu do przyczyny. Kontrola spójności liczb dotyczy gotowego tekstu i tabel, reguły kontroli wyłapują usterki przed analizą, a o znaku przeciwnym do hipotezy jest osobny poradnik. Tutaj masz liczbę, która wygląda źle, i pytanie: co ją zepsuło i jak to sprawdzić. Sama logika pochodzi z czyszczenia danych, które Van den Broeck i in. (2005) opisują jako powtarzany cykl przesiewu, diagnozy i edycji, z regułami ustalonymi z góry.
Przykład (fikcyjny, dane symulowane). Ankieta online wśród studentów: jakość snu i samopoczucie (1–7), skala stresu (6 pozycji, 1–5, trzy odwrócone), wypalenie, kawa, dochód, kurs przygotowawczy i zdanie egzaminu. Plik ma 200 wierszy i celowo wstawione usterki. Możesz go pobrać jako CSV i powtórzyć każdy krok.
Objaw, przyczyna, test: tabela do szybkiego sprawdzenia
| Objaw | Najczęstsze przyczyny | Jak sprawdzić |
|---|---|---|
| Średnia poza zakresem skali | Kod braku (99, 999) liczony jak wynik; suma zamiast średniej; inny zakres odpowiedzi w eksporcie | Minimum, maksimum i tabela częstości wobec klucza |
| Ujemna alfa | Pozycje odwrócone bez przekodowania; pomieszane skale | Korelacja pozycja–reszta; klucz narzędzia |
| r od .95 do 1.00 | Ta sama kolumna dwa razy; suma z własną składową; kody braku w obu zmiennych | Przegląd macierzy, porównanie kolumn, wykres rozrzutu |
| Wszystko istotne | Powtórzone wiersze; część i całość; bardzo duże N; czasem efekt prawdziwy | Liczba unikalnych osób, wielkość efektu, definicje zmiennych |
| R² bliskie 1 | Wynik policzony z predyktorów; za dużo predyktorów na liczbę osób | Reszty, liczba predyktorów wobec n |
| Ogromny OR i SE | Separacja: zero w komórce tabeli; wynik zbudowany z predyktora | Tabela krzyżowa predyktora z wynikiem |
| SD = 0 lub prawie 0 | Stała kolumna; filtr zostawił jedną grupę; pole wymuszone | Tabela częstości, kontrola filtrów |
| df niezgodne z N | Usuwanie całych przypadków z brakami; powtórzone wiersze | Liczba obserwacji w modelu, braki w każdej zmiennej |
| Procenty nie sumują się do 100 | Warianty zapisu kategorii; zły mianownik; zaokrąglenia; wielokrotny wybór | Tabela z brakami; mianownik każdej kolumny |
Kolejność też ma znaczenie. Najpierw plik (wiersze, kolumny, kody), potem wyniki skal, na końcu modele. Naprawa kodu 99 zmienia wszystko, co jest dalej.
Dziewięć objawów po kolei
Średnia poza zakresem skali
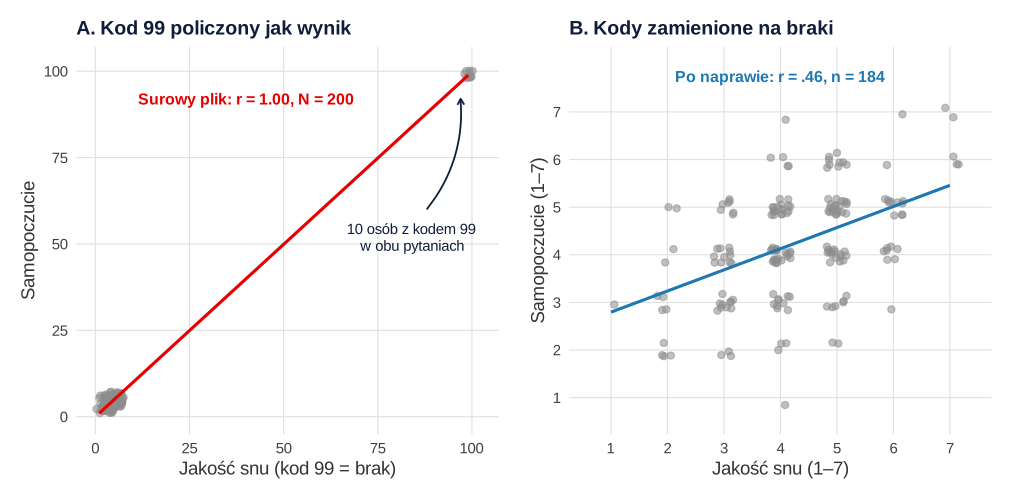
Średnia jakości snu wynosi 9.03, a skala kończy się na 7. To niemożliwe, więc nie trzeba żadnego testu, żeby wiedzieć, że coś jest nie tak. Tabela częstości pokazuje 10 osób z wartością 99, czyli kodem braku, którego program nie dostał do wiadomości. Niezdefiniowany kod jest dla programu zwykłą liczbą. Sprawdź minimum, maksimum i częstości, a kody opisz w książce kodowej. Broman i Woo (2018) zalecają spójne zasady i słownik danych dołączony do pliku; praktyczne ustawienia opisuje poradnik o przygotowaniu bazy danych. Po zamianie 99 na brak średnia wynosi 4.28. Inna częsta przyczyna to suma pozycji podana zamiast średniej. Gdy średnia w cudzym artykule mieści się w skali, ale budzi wątpliwości, sprawdź ją testem GRIM w kalkulatorze spójności.
Ujemna alfa
Skala stresu ma α = −1.92. Alfa nie jest ograniczona do przedziału od 0 do 1, a przekonanie, że jest, Streiner (2003) wymienia wśród mitów. Ujemna wartość oznacza jednak, że średnia kowariancja między pozycjami jest ujemna. Tu wszystkie korelacje pozycja–reszta są ujemne (od −.32 do −.42), bo trzy z sześciu pozycji odwróconych nie przekodowano. Po przekodowaniu zgodnie z kluczem α = .89.
Uwaga praktyczna: gdy odwrócona jest połowa pozycji, ujemne korelacje mają wszystkie, także te poprawne. Kierunek bierz z klucza narzędzia, a nie ze znaku korelacji. Więcej o analizie pozycji znajdziesz we wpisie o alfie Cronbacha.
Korelacja od .95 do 1.00
Przegląd macierzy (wszystkie pary z |r| > .90) daje dwie pary. Wypalenie i „drugi pomiar” wypalenia mają r = 1.000, a funkcja identical() potwierdza, że to ta sama kolumna. Prawdziwy pomiar powtórzony praktycznie nigdy nie zgadza się co do osoby.
Jakość snu i samopoczucie mają r = .998, choć to różne pytania. Rysunek 1 od razu pokazuje przyczynę: 10 osób z kodem 99 w obu pytaniach tworzy punkt daleko od reszty i ciągnie linię. Po naprawie r = .46. Zawsze oglądaj wykres rozrzutu, bo sam współczynnik tego nie zdradzi. Podobny mechanizm działa przy obserwacjach odstających, a o związkach prawdziwych, lecz niewyjaśniających przyczyny, mówi hasło o korelacji pozornej.
Trzecia przyczyna to część i całość. Podskala emocjonalna koreluje z sumą całej skali na poziomie r = .95, bo jest jej składnikiem. Sensowne pytanie o związek obu podskal to korelacja między nimi: r = .80. Nigdy nie koreluj wyniku z sumą, w której ten wynik siedzi.
Wszystko wyszło istotne
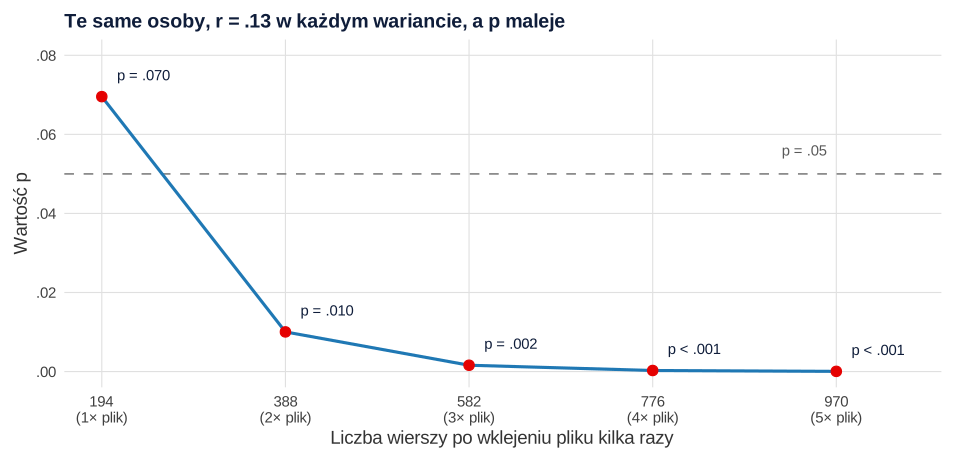
Najpierw policz osoby. W pliku jest 6 ankiet wysłanych dwa razy: te same odpowiedzi, inne id. Duplikaty trafiają się nawet w dużych zbiorach: Kuriakose i Robbins (2016), analizując ponad 1000 publicznie dostępnych zbiorów, ocenili, że blisko jedno na pięć szeroko używanych badań sondażowych ma ponad 5% dokładnych lub niemal dokładnych powtórzeń. Rysunek 2 pokazuje skrajny przypadek: plik wklejony kilka razy. r kawy ze stresem zostaje .13, a p spada z .070 do poniżej .001, choć nie doszła ani jedna nowa osoba. Duplikaty w ankietach online opisuje wpis o botach i fałszywych respondentach; ryzyko rośnie, gdy za wypełnienie jest nagroda.
Uczciwie: czasem wynik jest prawdziwy. Przy bardzo dużej próbie małe wartości p pojawiają się niemal automatycznie (Lin i in., 2013). W symulacji bez usterki N = 40000 daje r = .030 i p < .001, ale R² = .0009. Patrz więc na wielkość efektu. Skale tej samej ankiety bywają też skorelowane przez wspólną metodę pomiaru. Zapisu Sig. = .000 nie traktuj jako objawu: to tylko sposób wyświetlania, objaśniony we wpisie o czytaniu wyników SPSS.
R² bliskie 1
Model sumy skali z dwiema podskalami daje R² = 1.000, a największa reszta to 5.1 × 10⁻¹⁴. Wynik jest tu arytmetyczną sumą predyktorów. R ostrzega wtedy o idealnym dopasowaniu, a gdy jeden predyktor jest kombinacją pozostałych, pokazuje NA przy współczynniku. To skrajna współliniowość, a przy mniejszej skali problemu pomoże wpis o wysokim VIF. Model z predyktorami niebędącymi składnikami wyniku (sen i samopoczucie) ma R² = .277 przy n = 184.
Druga przyczyna to za dużo predyktorów. Sam szum, 25 osób i 22 predyktory, dał R² = .88, a skorygowane −.41. Model tak dopasowany opisuje przypadek w próbie i nie replikuje się w nowych danych (Babyak, 2004).
Ogromny OR i błąd standardowy
Regresja logistyczna zdania egzaminu z kursem daje b = 17.32, SE = 989.05, OR = 3.3 × 10⁷ i p = .986. Tabela krzyżowa wyjaśnia wszystko: po kursie zdało 16 z 16 osób, jest zero w komórce. To separacja, w której oszacowanie dąży do nieskończoności (Heinze i Schemper, 2002). Dane mogą być poprawne: to model nie ma skończonego wyniku. Sprawdź tylko, czy zmienna wynikowa nie została zbudowana z predyktora. Potem nie usuwaj kursu, tylko podaj liczebności i test dokładny (p < .001, 95% CI dla OR od 2.88 bez górnej granicy) albo użyj regresji Firtha.
Odchylenie 0 lub prawie 0
Zgoda ma SD = 0, bo wszyscy zaznaczyli 1, a R zgłasza „the standard deviation is zero” i korelacji nie policzy. To nie błąd, tylko kolumna, której nie ma co analizować. Gorzej, gdy odchylenie 0 pojawia się w grupie albo skali, której wynik miał się różnić: sprawdź, czy filtr nie zostawił jednej kategorii, a pole nie miało odpowiedzi domyślnej. Pytanie kontrolne („zaznacz 3”) ma SD = 0.072, bo 193 ze 194 osób zaznaczyły poprawnie. Tak ma być. Jednakowe odpowiedzi w obrębie jednej osoby to inny problem: straightlining.
Stopnie swobody niezgodne z N
W tekście stoi N = 200, więc model z trzema predyktorami powinien mieć 196 stopni swobody reszt. Ma 144. Liczba obserwacji w modelu wynosi 148, bo program usuwa cały przypadek, gdy brakuje choć jednej wartości. Dochodu brakuje u 38 osób, a jakości snu u 10. Razem odpadło 46 z 194 osób. Rozwiązaniem nie jest przepisanie df, tylko podanie prawdziwego n przy każdej analizie i ocena, kogo ubyło (braki danych w ankiecie). Zmiennej nie usuwaj dlatego, że „psuje” df, jeśli stoi w planie.
Procenty nie sumują się do 100
Kobiety to 51.5%, mężczyźni 29.5%, razem 81.0%. Tabela z brakami pokazuje „Kobieta” (15), „kobieta ” ze spacją na końcu (11), „M” (7) i 5 braków. Spacji w tabeli nie widać, więc pomaga trimws(). Po ujednoliceniu: 124 kobiety i 65 mężczyzn, 65.6% i 34.4% z 189 odpowiedzi, a brak odpowiedzi podajesz osobno. Suma 99.9% to tylko zaokrąglenie, a przy pytaniach wielokrotnego wyboru suma powyżej 100% jest normalna.
Przed naprawą i po naprawie
Wszystkie liczby pochodzą z tego samego pliku. Każda poprawka była jedną linijką skryptu, a surowy plik pozostał nietknięty.
| Wskaźnik | Surowy plik | Po naprawie |
|---|---|---|
| Średnia jakości snu (skala 1–7) | 9.03 (maksimum 99) | 4.28 (maksimum 7) |
| r sen–samopoczucie | 1.00 (N = 200) | .46 (n = 184) |
| Alfa skali stresu | −1.92 | .89 |
| r wypalenie–„pomiar 2” | 1.00 | kolumna usunięta |
| Liczba wierszy | 200 | 194 |
| p kawa–stres (plik wklejony 3 razy / oryginał) | .002 | .070 |
| R² modelu stresu | 1.000 (suma z podskal) | .277 (sen, samopoczucie) |
| OR dla kursu | 3.3 × 10⁷ | nieskończony; 95% CI od 2.88 |
| SD zgody | 0 | kolumna poza analizą |
| df reszt (model z dochodem) | 196 (oczekiwane z N = 200) | 144 (faktyczne) |
| Suma procentów płci | 81.0% | 100.0% |
Sprawdziłeś i wynik zostaje. Co dalej
Część podejrzanych wyników przetrwa kontrolę. Wtedy obowiązuje kilka prostych zasad.
- Nie poprawiaj do oczekiwań. Elastyczność w analizie i raportowaniu mocno zwiększa odsetek fałszywych alarmów (Simmons i in., 2011). Usterka to coś, co umiesz wskazać w pliku, a nie wynik, który Ci nie pasuje.
- Nie usuwaj obserwacji bez reguły. Usuwanie wartości skrajnych według popularnych progów zawyża błąd I rodzaju, zwłaszcza gdy próg zmienia się po obejrzeniu wyników (Bakker i Wicherts, 2014). Zobacz, kiedy można usunąć obserwację i jak ją wykryć. Rekord usuwasz też na prośbę osoby, która wycofuje się z badania, ale to inna sytuacja.
- Tę samą kontrolę przeprowadź dla wszystkich wyników. Jeżeli sprawdzasz tylko liczby sprzeczne z hipotezą, błędy zgodne z nią zostaną w pracy. Zadaj sobie pytanie: czy sprawdzał(a)bym to, gdyby wynik mi pasował?
- Zapisz decyzję. Każda zmiana to wiersz w dzienniku zmian, także decyzja „zostawiam bez zmian”. Usterkę z samej ankiety rozstrzyga wpis o błędzie w ankiecie po zebraniu danych.
- Opisz wynik takim, jaki jest. Gdy dane są poprawne, a wynik zaskakuje, napisz to wprost i zapytaj promotora. Dla wyniku bez efektu zob. hipoteza się nie potwierdziła.
Jak bywa napisane, co nie tak, jak poprawić
| Jak bywa napisane | Co nie tak | Poprawione (dane fikcyjne) |
|---|---|---|
| „Średnia jakość snu wyniosła 9.03, co świadczy o bardzo dobrym śnie.” | Wartość poza skalą 1–7; kod 99 policzony jak wynik. | „Po oznaczeniu kodu 99 jako braku danych (n = 10) średnia jakość snu wyniosła 4.28 na skali od 1 do 7.” |
| „Skala okazała się nierzetelna (α = −1.92), dlatego usunięto trzy pozycje.” | Pozycje nie były przekodowane; ich usunięcie ukrywa błąd. | „Pozycje 2, 4 i 6 przekodowano zgodnie z kluczem. Rzetelność skali wyniosła α = .89.” |
| „Jakość snu była niemal tożsama z samopoczuciem (r = 1.00).” | Korelację tworzy 10 osób z kodem 99. | „Lepsza jakość snu wiązała się z lepszym samopoczuciem, r(182) = .46, p < .001, 95% CI [.33, .56].” |
| „Kurs zwiększał szansę zdania 33 milionów razy (p = .986).” | Separacja: OR i p są artefaktem, a badanie nie uprawnia do języka przyczynowego. | „Egzamin zdały wszystkie osoby po kursie (16 z 16) i 56.2% osób bez kursu. Test dokładny Fishera: p < .001. Z powodu zera w komórce nie podano OR z modelu logistycznego.” |
Gotowy wpis do dziennika i zdanie do Metody
Wiersz dziennika dla jednego z rekordów. Kolumny jak w regułach kontroli danych:
Akapit do rozdziału metodologicznego (liczby z fikcyjnego przykładu; uzupełnij swoimi):
Najczęstsze błędy
- Wyjaśnianie zamiast sprawdzania. Dwie strony Dyskusji o zaskakującym r = 1.00, które było kodem 99.
- Poprawianie w surowym pliku. Bez kopii i dziennika nie da się potem odtworzyć, co się stało.
- Chowanie usterki. Zamiana 99 na średnią albo na 7 nie jest naprawą.
- Usuwanie pozycji przez ujemną alfę, zanim sprawdzisz klucz.
- Usuwanie predyktora przez separację, choć to właśnie on wiąże się z wynikiem najsilniej.
- Sprawdzanie tylko „złych” wyników. Liczba zgodna z hipotezą też może być artefaktem.
- Traktowanie każdej dziwnej liczby jak błędu. Czasem efekt jest prawdziwy, a usterki nie ma.
Dziewięć objawów w R: objaw, test, naprawa
Pierwszy przepis buduje fikcyjny plik, drugi kolejno pokazuje objawy i testy, a na końcu zestawia wartości przed naprawą i po niej. Parametry (zależności między zmiennymi, liczba usterek) ustawiono ręcznie, by przykład odpowiadał opisanym sytuacjom. Dane są symulowane, a gotowy plik CSV możesz wczytać od razu.
Fikcyjna ankieta z usterkami
R
# Fikcyjna ankieta studencka z celowo wstawionymi usterkami (dane symulowane)
set.seed(517)
n <- 194
ogr <- function(x, a, b) round(pmin(pmax(x, a), b))

z <- rnorm(n)                                   # nasilenie stresu (zmienna ukryta)
pozycja <- function() ogr(3 + 0.85 * z + rnorm(n, 0, 0.75), 1, 5)

d <- data.frame(id = sprintf("R%03d", 1:n))
d$plec <- sample(c("kobieta", "mężczyzna"), n, TRUE, c(.72, .28))
d$wiek <- sample(19:27, n, TRUE)
d$zgoda <- 1                                    # wszyscy wyrazili zgodę
d$kontrola <- ifelse(runif(n) < .98, 3, 2)      # pytanie „zaznacz 3”
d$sen <- ogr(4.3 - 0.55 * z + rnorm(n, 0, 1.0), 1, 7)
d$samopoczucie <- ogr(4.4 - 0.40 * z + 0.20 * (d$sen - 4) + rnorm(n, 0, 1.0), 1, 7)
d$s1 <- pozycja(); d$s2 <- 6 - pozycja(); d$s3 <- pozycja()
d$s4 <- 6 - pozycja(); d$s5 <- pozycja(); d$s6 <- 6 - pozycja()   # s2, s4, s6 odwrócone w surowych danych
d$wypalenie <- ogr(20 + 4 * z + rnorm(n, 0, 3.5), 6, 36)
d$kawa <- ogr(2.2 + 0.32 * z + rnorm(n, 0, 1.4), 0, 8)
d$dochod <- round(rnorm(n, 2400, 650), -1)
d$kurs <- rep(0:1, c(n - 16, 16))[sample(n)]
d$zdal <- rbinom(n, 1, plogis(0.25 - 0.40 * z))
d$zdal[d$kurs == 1] <- 1                        # wszyscy po kursie zdali

# USTERKI
d$dochod[sample(n, 38)] <- NA                   # brak odpowiedzi na pytanie o dochód
d$wypalenie_pomiar2 <- d$wypalenie              # „drugi pomiar” to skopiowana kolumna
kody <- sample(n, 10)
d$sen[kody] <- 99; d$samopoczucie[kody] <- 99   # kod braku potraktowany jak liczba
k <- which(d$plec == "kobieta"); m <- which(d$plec == "mężczyzna")
d$plec[sample(k, 16)] <- "Kobieta"; d$plec[sample(k, 9)] <- "kobieta "
d$plec[sample(m, 7)] <- "M"; d$plec[sample(n, 5)] <- NA

dubel <- d[sample(setdiff(1:n, kody), 6), ]     # sześć ankiet wysłanych dwa razy
dubel$id <- sprintf("R%03d", (n + 1):(n + 6))
d <- rbind(d, dubel); rownames(d) <- NULL

write.csv(d, "wynik-podejrzany-dane.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")
cat("Wiersze:", nrow(d), " Kolumny:", ncol(d), "\n")
print(d[c(1, 2, 200), c("id", "plec", "sen", "samopoczucie", "s1", "s2", "wypalenie", "wypalenie_pomiar2")])
Wynik
Wiersze: 200  Kolumny: 19
      id    plec sen samopoczucie s1 s2 wypalenie wypalenie_pomiar2
1   R001 kobieta   4            4  2  3        20                20
2   R002 kobieta   6            4  1  5        22                22
200 R200 kobieta   6            5  1  5         6                 6
Objaw, test diagnostyczny i wynik po naprawie
R
# Objaw → test diagnostyczny → naprawa (dane fikcyjne, plik CSV ze strony)
d <- read.csv("wynik-podejrzany-dane.csv", na.strings = "", strip.white = FALSE,
              fileEncoding = "UTF-8")
cz <- d                                     # d zostaje nietknięte, poprawki tylko w cz
bz <- function(x, k = 2) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", k, "f"), x))
p3 <- function(p) if (p < .001) "p < .001" else paste0("p = ", bz(p, 3))
alfa <- function(x) {
  x <- na.omit(x); k <- ncol(x)
  k / (k - 1) * (1 - sum(apply(x, 2, var)) / var(rowSums(x)))
}
r2 <- function(m) suppressWarnings(summary(m))$r.squared   # przy idealnym dopasowaniu R ostrzega
poz <- paste0("s", 1:6)

cat("1. ŚREDNIA POZA ZAKRESEM SKALI (skala 1-7)\n")
cat("M =", round(mean(d$sen, na.rm = TRUE), 2), " zakres:", range(d$sen, na.rm = TRUE), "\n")
print(table(d$sen))
cat("r(sen, samopoczucie) w surowym pliku =", bz(cor(d$sen, d$samopoczucie)), "\n")
for (v in c("sen", "samopoczucie")) cz[[v]][cz[[v]] == 99] <- NA

cat("\n2. UJEMNA ALFA\n")
cat("alfa =", bz(alfa(d[poz])), "\n")
reszta <- sapply(poz, function(p) cor(d[[p]], rowSums(d[setdiff(poz, p)])))
print(round(reszta, 2))
for (p in c("s2", "s4", "s6")) cz[[p]] <- 6 - cz[[p]]

cat("\n3. KORELACJA BLISKA 1\n")
num <- d[sapply(d, is.numeric)]
r <- cor(num, use = "pairwise.complete.obs"); r[upper.tri(r, TRUE)] <- NA
g <- which(abs(r) > .90, arr.ind = TRUE)
print(data.frame(zm1 = rownames(r)[g[, 1]], zm2 = colnames(r)[g[, 2]], r = round(r[g], 3)),
      row.names = FALSE)
cat("Kolumny identyczne:", identical(d$wypalenie, d$wypalenie_pomiar2), "\n")
powt <- duplicated(d[setdiff(names(d), "id")])
cat("Powtórzone wiersze (bez id):", sum(powt), " ", d$id[powt], "\n")
cz$wypalenie_pomiar2 <- NULL
cz <- cz[!duplicated(cz[setdiff(names(cz), "id")]), ]

cz$emo <- rowSums(cz[c("s1", "s2", "s3")]); cz$poz <- rowSums(cz[c("s4", "s5", "s6")])
cz$suma <- cz$emo + cz$poz
cz$stres <- cz$suma / 6
cat("Część-całość: r(emo, suma) =", bz(cor(cz$emo, cz$suma)),
    " r(emo, poz) =", bz(cor(cz$emo, cz$poz)), "\n")

cat("\n4. WSZYSTKO ISTOTNE\n")
kopie <- 1:5
wynik <- t(sapply(kopie, function(k) {
  x <- do.call(rbind, rep(list(cz[c("kawa", "stres")]), k))
  t <- cor.test(x$kawa, x$stres)
  c(kopie = k, N = nrow(x), r = unname(t$estimate), p = t$p.value)
}))
print(data.frame(kopie = wynik[, 1], N = wynik[, 2], r = bz(wynik[, 3]),
                 p = sapply(wynik[, 4], p3)), row.names = FALSE)
set.seed(5171)
n <- 40000; x <- rnorm(n); y <- 0.03 * x + rnorm(n)
t2 <- cor.test(x, y)
cat("Duża próba bez usterki: N =", n, " r =", bz(t2$estimate, 3), " ", p3(t2$p.value),
    " R2 =", bz(t2$estimate^2, 4), "\n")

cat("\n5. R2 BLISKIE 1\n")
m1 <- lm(suma ~ emo + poz, cz)
cat("suma ~ emo + poz: R2 =", bz(r2(m1), 3),
    " największa |reszta| =", signif(max(abs(resid(m1))), 2), "\n")
m2 <- lm(stres ~ sen + samopoczucie, cz)
cat("stres ~ sen + samopoczucie: R2 =", bz(r2(m2), 3), " n =", nobs(m2), "\n")
set.seed(5172)
szum <- as.data.frame(matrix(rnorm(25 * 22), 25)); szum$y <- rnorm(25)
m3 <- summary(lm(y ~ ., szum))
cat("Sam szum, n = 25, 22 predyktory: R2 =", bz(m3$r.squared), " skorygowane =",
    bz(m3$adj.r.squared), "\n")

cat("\n6. OGROMNY OR I BŁĄD STANDARDOWY\n")
m4 <- suppressWarnings(glm(zdal ~ kurs, binomial, cz))
wsp <- coef(summary(m4))["kurs", ]
cat(sprintf("b = %.2f, SE = %.2f, OR = %.1e, %s\n", wsp[1], wsp[2], exp(wsp[1]), p3(wsp[4])))
tab <- table(kurs = cz$kurs, zdal = cz$zdal)
print(tab)
f <- fisher.test(tab)
cat(sprintf("Test Fishera: %s, 95%% CI dla OR [%.2f, %s]\n", p3(f$p.value), f$conf.int[1],
            ifelse(is.finite(f$conf.int[2]), round(f$conf.int[2], 2), "Inf")))
cat("Odsetek zdanych: bez kursu", round(100 * mean(cz$zdal[cz$kurs == 0]), 1),
    "%, po kursie", round(100 * mean(cz$zdal[cz$kurs == 1]), 1), "%\n")

cat("\n7. ODCHYLENIE 0 LUB PRAWIE 0\n")
print(round(sapply(cz[c("zgoda", "kontrola", "wiek", "kawa")], sd), 3))
print(table(cz$kontrola))

cat("\n8. STOPNIE SWOBODY NIEZGODNE Z N\n")
m5 <- lm(stres ~ sen + samopoczucie + dochod, cz)
cat("Wierszy w cz:", nrow(cz), " n w modelu:", nobs(m5), " df reszt:", df.residual(m5), "\n")
print(colSums(is.na(cz[c("stres", "sen", "samopoczucie", "dochod")])))
cat("Usunięte z modelu:", length(m5$na.action), "\n")

cat("\n9. PROCENTY NIE SUMUJĄ SIĘ DO 100\n")
print(table(d$plec, useNA = "ifany"))
zle <- 100 * table(d$plec)[c("kobieta", "mężczyzna")] / nrow(d)
print(round(zle, 1)); cat("Suma:", round(sum(zle), 1), "\n")
cz$plec <- trimws(tolower(cz$plec))
cz$plec[cz$plec == "m"] <- "mężczyzna"
tp <- table(cz$plec)
print(tp); print(round(100 * prop.table(tp), 1))
cat("Braki:", sum(is.na(cz$plec)), " Suma:", round(sum(round(100 * prop.table(tp), 1)), 1), "\n")

cat("\nPRZED I PO NAPRAWIE\n")
wiersz <- function(o, a, b) data.frame(objaw = o, przed = a, po = b)
print(rbind(
  wiersz("M jakości snu (1-7)", round(mean(d$sen, na.rm = TRUE), 2), round(mean(cz$sen, na.rm = TRUE), 2)),
  wiersz("max jakości snu", max(d$sen), max(cz$sen, na.rm = TRUE)),
  wiersz("r sen-samopoczucie", bz(cor(d$sen, d$samopoczucie)), bz(cor(cz$sen, cz$samopoczucie, use = "complete.obs"))),
  wiersz("alfa stresu", bz(alfa(d[poz])), bz(alfa(cz[poz]))),
  wiersz("r wypalenie-pomiar2", bz(cor(d$wypalenie, d$wypalenie_pomiar2)), "kolumna usunięta"),
  wiersz("wiersze w pliku", nrow(d), nrow(cz)),
  wiersz("p kawa-stres (plik x3)", p3(wynik[3, 4]), p3(wynik[1, 4])),
  wiersz("n r sen-samopoczucie", sum(complete.cases(d$sen, d$samopoczucie)), sum(complete.cases(cz$sen, cz$samopoczucie))),
  wiersz("R2 modelu stresu", bz(r2(m1), 3), bz(r2(m2), 3)),
  wiersz("OR dla kursu", sprintf("%.1e", exp(wsp[1])), sprintf("nieskończony; dolna granica %.2f", f$conf.int[1])),
  wiersz("sd zgody", sd(d$zgoda), "kolumna poza analizą"),
  wiersz("df reszt (oczekiwane z N = 200)", nrow(d) - 4, df.residual(m5)),
  wiersz("suma % płci", round(sum(zle), 1), 100)
), row.names = FALSE)

ct <- cor.test(cz$sen, cz$samopoczucie)
cat(sprintf("\nOpis po naprawie: r(%d) = %s, %s, 95%% CI [%s, %s]\n", ct$parameter, bz(ct$estimate),
            p3(ct$p.value), bz(ct$conf.int[1]), bz(ct$conf.int[2])))
Wynik
1. ŚREDNIA POZA ZAKRESEM SKALI (skala 1-7)
M = 9.03  zakres: 1 99

 1  2  3  4  5  6  7 99
 1 13 31 62 55 23  5 10
r(sen, samopoczucie) w surowym pliku = 1.00

2. UJEMNA ALFA
alfa = -1.92
   s1    s2    s3    s4    s5    s6
-0.39 -0.41 -0.39 -0.37 -0.42 -0.32

3. KORELACJA BLISKA 1
               zm1       zm2     r
      samopoczucie       sen 0.998
 wypalenie_pomiar2 wypalenie 1.000
Kolumny identyczne: TRUE
Powtórzone wiersze (bez id): 6   R195 R196 R197 R198 R199 R200
Część-całość: r(emo, suma) = .95  r(emo, poz) = .80

4. WSZYSTKO ISTOTNE
 kopie   N   r        p
     1 194 .13 p = .070
     2 388 .13 p = .010
     3 582 .13 p = .002
     4 776 .13 p < .001
     5 970 .13 p < .001
Duża próba bez usterki: N = 40000  r = .030   p < .001  R2 = .0009

5. R2 BLISKIE 1
suma ~ emo + poz: R2 = 1.000  największa |reszta| = 5.1e-14
stres ~ sen + samopoczucie: R2 = .277  n = 184
Sam szum, n = 25, 22 predyktory: R2 = .88  skorygowane = -.41

6. OGROMNY OR I BŁĄD STANDARDOWY
b = 17.32, SE = 989.05, OR = 3.3e+07, p = .986
    zdal
kurs   0   1
   0  78 100
   1   0  16
Test Fishera: p < .001, 95% CI dla OR [2.88, Inf]
Odsetek zdanych: bez kursu 56.2 %, po kursie 100 %

7. ODCHYLENIE 0 LUB PRAWIE 0
   zgoda kontrola     wiek     kawa
   0.000    0.072    2.650    1.213

  2   3
  1 193

8. STOPNIE SWOBODY NIEZGODNE Z N
Wierszy w cz: 194  n w modelu: 148  df reszt: 144
       stres          sen samopoczucie       dochod
           0           10           10           38
Usunięte z modelu: 46

9. PROCENTY NIE SUMUJĄ SIĘ DO 100

  kobieta   Kobieta  kobieta          M mężczyzna      <NA>
      103        15        11         7        59         5

  kobieta mężczyzna
     51.5      29.5
Suma: 81

  kobieta mężczyzna
      124        65

  kobieta mężczyzna
     65.6      34.4
Braki: 5  Suma: 100

PRZED I PO NAPRAWIE
                           objaw    przed                               po
             M jakości snu (1-7)     9.03                             4.28
                 max jakości snu       99                                7
              r sen-samopoczucie     1.00                              .46
                     alfa stresu    -1.92                              .89
             r wypalenie-pomiar2     1.00                 kolumna usunięta
                 wiersze w pliku      200                              194
          p kawa-stres (plik x3) p = .002                         p = .070
            n r sen-samopoczucie      200                              184
                R2 modelu stresu    1.000                             .277
                    OR dla kursu  3.3e+07 nieskończony; dolna granica 2.88
                        sd zgody        0             kolumna poza analizą
 df reszt (oczekiwane z N = 200)      196                              144
                     suma % płci       81                              100

Opis po naprawie: r(182) = .46, p < .001, 95% CI [.33, .56]
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety bazowe); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Lista kontrolna na 10 minut, zanim opiszesz wynik
- Czy liczba wierszy równa się liczbie osób i czy nie ma powtórzonych odpowiedzi poza
id? - Czy minimum i maksimum każdej zmiennej mieszczą się w zakresie skali?
- Czy tabele częstości nie pokazują 99, 999 ani kilku zapisów tej samej kategorii?
- Czy pozycje odwrócone przekodowano według klucza i czy alfa jest dodatnia?
- Czy żadna para zmiennych nie ma |r| powyżej .90 bez wyjaśnienia?
- Czy wykres rozrzutu głównych zmiennych nie ma odległej grupy punktów?
- Czy żaden wynik nie jest korelowany ani modelowany ze swoją składową?
- Czy tabela krzyżowa predyktorów z wynikiem binarnym nie ma zer?
- Czy n i df każdej analizy zgadzają się z liczbą osób po usunięciu braków?
- Czy procenty mają właściwy mianownik, a każda zmiana jest w dzienniku?
Najczęstsze pytania
Dlaczego średnia wychodzi większa niż maksimum skali?
Najczęściej w pliku jest kod braku, np. 99 lub 999, liczony jak zwykła liczba. Sprawdź minimum, maksimum i tabelę częstości, a kod oznacz jako brak danych. Inne przyczyny to suma policzona zamiast średniej pozycji albo inny zakres odpowiedzi w eksporcie.
Skąd ujemna alfa Cronbacha w mojej skali?
Ujemna alfa oznacza, że średnia kowariancja między pozycjami jest ujemna. Zwykle pozycji odwróconych nie przekodowano. Porównaj je z kluczem narzędzia i przelicz alfę, a pozycji nie usuwaj tylko z powodu znaku.
Czy korelacja r = 1 w ankiecie może być prawdziwa?
Praktycznie nie, jeżeli to dwa różne pytania. Sprawdź, czy kolumny nie są identyczne, czy jedna nie jest składnikiem drugiej oraz czy kody braku nie występują w obu zmiennych u tych samych osób. Wykres rozrzutu zwykle od razu pokazuje przyczynę.
Dlaczego wszystkie moje wyniki są istotne statystycznie?
Sprawdź liczbę unikalnych osób, bo powtórzone wiersze zaniżają p, oraz to, czy nie korelujesz części z całością. Przy bardzo dużej próbie nawet bardzo małe efekty są istotne, więc spójrz na wielkość efektu. Czasem wynik jest po prostu prawdziwy.
Czy mogę poprawić dane, gdy wynik wygląda dziwnie?
Tak, jeśli umiesz wskazać konkretną usterkę, na przykład kod braku lub powtórzony rekord. Popraw ją skryptem, zapisz w dzienniku zmian i opisz w Metodzie. Nie zmieniaj danych dlatego, że wynik nie pasuje do oczekiwań.
Powiązane hasła
Przeczytaj też
Reguły kontroli danych i dziennik zmian
Zakresy, logika pytań i sumy kontrolne zapisane z góry, tabela naruszeń w R, decyzje i dziennik zmian odtwarzający czysty zbiór.
Czytaj →PoradnikKontrola spójności liczb przed oddaniem pracy
Osiem kontroli: N i sumy w tabelach, procenty, p a statystyka testu, df, przedziały ufności, GRIM i te same liczby w całej pracy – z kodem w R.
Czytaj →PoradnikBłąd w ankiecie po zebraniu danych
Dwanaście usterek formularza: jak je wykryć, co zrobić i co napisać w pracy, z symulowaną ankietą w R i gotowymi zdaniami.
Czytaj →Wynik wygląda dziwnie i nie wiesz, czy to dane, czy analiza?
Sprawdzimy plik i obliczenia w R lub SPSS, a potem wyjaśnimy wynik tak, żebyś umiał(a) samodzielnie go opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Babyak, M. A. (2004). What you see may not be what you get: A brief, nontechnical introduction to overfitting in regression-type models. Psychosomatic Medicine, 66(3), 411–421. https://doi.org/10.1097/01.psy.0000127692.23278.a9 ● Otwarty dostęp
- Bakker, M., & Wicherts, J. M. (2014). Outlier removal, sum scores, and the inflation of the Type I error rate in independent samples t tests: The power of alternatives and recommendations. Psychological Methods, 19(3), 409–427. https://doi.org/10.1037/met0000014
- Broman, K. W., & Woo, K. H. (2018). Data organization in spreadsheets. The American Statistician, 72(1), 2–10. https://doi.org/10.1080/00031305.2017.1375989 ● Otwarty dostęp: pełny tekst
- Heinze, G., & Schemper, M. (2002). A solution to the problem of separation in logistic regression. Statistics in Medicine, 21(16), 2409–2419. https://doi.org/10.1002/sim.1047
- Kuriakose, N., & Robbins, M. (2016). Don't get duped: Fraud through duplication in public opinion surveys. Statistical Journal of the IAOS, 32(3), 283–291. https://doi.org/10.3233/sji-160978 ● Otwarty dostęp: pełny tekst
- Lin, M., Lucas, H. C., & Shmueli, G. (2013). Research commentary—Too big to fail: Large samples and the p-value problem. Information Systems Research, 24(4), 906–917. https://doi.org/10.1287/isre.2013.0480
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Streiner, D. L. (2003). Starting at the beginning: An introduction to coefficient alpha and internal consistency. Journal of Personality Assessment, 80(1), 99–103. https://doi.org/10.1207/s15327752jpa8001_18
- Van den Broeck, J., Argeseanu Cunningham, S., Eeckels, R., & Herbst, K. (2005). Data cleaning: Detecting, diagnosing, and editing data abnormalities. PLoS Medicine, 2(10), Article e267. https://doi.org/10.1371/journal.pmed.0020267 ● Otwarty dostęp
Cytowania BibTeX
@article{babyak2004what, author={Babyak, Michael A.}, title={{What you see may not be what you get: A brief, nontechnical introduction to overfitting in regression-type models}}, journal={Psychosomatic Medicine}, year={2004}, volume={66}, number={3}, pages={411--421}, doi={10.1097/01.psy.0000127692.23278.a9}}@article{bakker2014outlier, author={Bakker, Marjan and Wicherts, Jelte M.}, title={{Outlier removal, sum scores, and the inflation of the Type I error rate in independent samples t tests: The power of alternatives and recommendations}}, journal={Psychological Methods}, year={2014}, volume={19}, number={3}, pages={409--427}, doi={10.1037/met0000014}}@article{broman2018data, author={Broman, Karl W. and Woo, Kara H.}, title={{Data organization in spreadsheets}}, journal={The American Statistician}, year={2018}, volume={72}, number={1}, pages={2--10}, doi={10.1080/00031305.2017.1375989}}@article{heinze2002solution, author={Heinze, Georg and Schemper, Michael}, title={{A solution to the problem of separation in logistic regression}}, journal={Statistics in Medicine}, year={2002}, volume={21}, number={16}, pages={2409--2419}, doi={10.1002/sim.1047}}@article{kuriakose2016dont, author={Kuriakose, Noble and Robbins, Michael}, title={{Don't get duped: Fraud through duplication in public opinion surveys}}, journal={Statistical Journal of the IAOS}, year={2016}, volume={32}, number={3}, pages={283--291}, doi={10.3233/sji-160978}}@article{lin2013too, author={Lin, Mingfeng and Lucas, Henry C. and Shmueli, Galit}, title={{Research commentary—Too big to fail: Large samples and the p-value problem}}, journal={Information Systems Research}, year={2013}, volume={24}, number={4}, pages={906--917}, doi={10.1287/isre.2013.0480}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{streiner2003starting, author={Streiner, David L.}, title={{Starting at the beginning: An introduction to coefficient alpha and internal consistency}}, journal={Journal of Personality Assessment}, year={2003}, volume={80}, number={1}, pages={99--103}, doi={10.1207/s15327752jpa8001_18}}@article{vandenbroeck2005data, author={Van den Broeck, Jan and Argeseanu Cunningham, Solveig and Eeckels, Roger and Herbst, Kobus}, title={{Data cleaning: Detecting, diagnosing, and editing data abnormalities}}, journal={PLoS Medicine}, year={2005}, volume={2}, number={10}, eid={e267}, doi={10.1371/journal.pmed.0020267}}