Co to jest test GRIM?
Test GRIM (ang. granularity-related inconsistency of means) to prosta kontrola, czy podana w artykule średnia danych całkowitoliczbowych jest w ogóle możliwa przy danej liczebności i liczbie pozycji. Zaproponowali ją Brown i Heathers (2017) do sprawdzania średnich z pozycji typu Likerta.
Zasada
Suma odpowiedzi n osób na k pozycji całkowitych też jest liczbą całkowitą, więc średnia może przyjmować tylko wartości co 1/(n·k). Przy n = 28 i jednej pozycji możliwe są np. 145/28 = 5.179 i 146/28 = 5.214. Podana średnia 5.19 nie zaokrągla się z żadnej z nich, więc jest niespójna, a 5.21 jest możliwa. Ta sama średnia 3.45 jest niemożliwa dla jednej pozycji, ale możliwa dla skali z trzech pozycji (290/84 = 3.452). Dlatego przed oceną trzeba znać liczbę pozycji i sposób liczenia wyniku skali.
Na rysunku
Rysunek przenosi zasadę na oś liczbową. Panel A pokazuje średnie możliwe przy n = 28 i jednej pozycji oraz wszystkie średnie z dwoma miejscami po przecinku od 5.10 do 5.30. Panel B sprawdza tą samą funkcją grim() co w przykładzie z R, jaka część średnich od 1.00 do 7.00 przechodzi test przy danym iloczynie n·k.
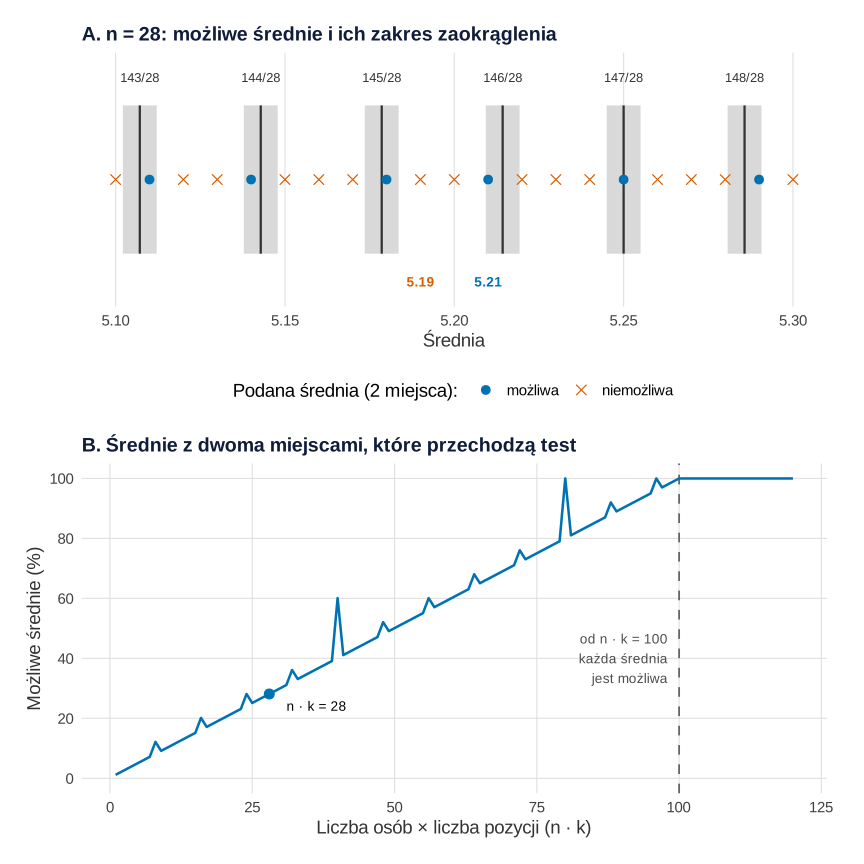
Co widać. Przy n = 28 możliwe średnie leżą co 1/28, a każda zajmuje na osi tylko pas ±0.005. Z 21 średnich od 5.10 do 5.30 możliwych jest 6, a 15 jest niemożliwych. Średnia 5.19 wypada między 145/28 i 146/28, więc test ją odrzuca, a 5.21 leży w pasie wokół 146/28. Panel B pokazuje, że odsetek średnich, które przechodzą test, rośnie prawie dokładnie jak n·k: 10.1% przy 10, 28.1% przy 28 i 50.1% przy 50. Od n·k = 100 każda średnia jest możliwa.
Na co uważać. Ząbki przy n·k = 40 (60.1%) i 80 (100%) to remisy przy zaokrąglaniu. Przy 40 osobach średnia może wynosić np. 201/40 = 5.025, a tę da się podać jako 5.02 albo 5.03, więc funkcja przyjmuje obie wersje. Rysunek zakłada, że znasz n i liczbę pozycji. Przy brakach danych albo skali liczonej jako suma kilku pozycji ten sam wynik bywa możliwy, więc przed oceną sprawdź, jak liczono wynik. Pojedyncze średnie najszybciej sprawdzisz w kalkulatorze spójności wyników.
Podpis do pracy:
Kod nie losuje, więc za każdym razem daje te same liczby. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Test GRIM: możliwe średnie przy n = 28 (A) i odsetek średnich, które test może odrzucić (B)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("możliwa" = "#0072B2", "niemożliwa" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Test GRIM (jak w kodzie hasła): czy średnia m podana z dokładnością do 'miejsca' jest możliwa przy n osobach i k pozycjach?
grim <- function(m, n, k = 1, miejsca = 2) {
  suma <- round(m * n * k)
  kandydaci <- (suma - 1):(suma + 1) / (n * k)
  tol <- 0.5 / 10^miejsca + 1e-9
  any(abs(kandydaci - m) <= tol)
}

# A. n = 28, jedna pozycja: prawdziwe możliwe średnie (suma / 28) i wszystkie średnie z dwoma miejscami od 5.10 do 5.30
n <- 28
mozliwe <- data.frame(suma = 143:148); mozliwe$srednia <- mozliwe$suma / n
podane <- data.frame(M = round(seq(5.10, 5.30, by = 0.01), 2))
podane$wynik <- factor(ifelse(sapply(podane$M, grim, n = n), "możliwa", "niemożliwa"), levels = names(kol))
print(round(mozliwe$srednia, 4))
cat("Możliwe:", podane$M[podane$wynik == "możliwa"], "\n")
cat("Niemożliwe:", sum(podane$wynik == "niemożliwa"), "z", nrow(podane), "\n")

pA <- ggplot() +
  geom_rect(data = mozliwe, aes(xmin = srednia - 0.005, xmax = srednia + 0.005, ymin = 0.55, ymax = 1.45),
            fill = "grey85", colour = NA) +
  geom_segment(data = mozliwe, aes(x = srednia, xend = srednia, y = 0.55, yend = 1.45), colour = "grey20", linewidth = 0.8) +
  geom_text(data = mozliwe, aes(x = srednia, y = 1.62, label = paste0(suma, "/28")), size = 3.4, colour = "grey20") +
  geom_point(data = podane, aes(M, 1, colour = wynik, shape = wynik), size = 3) +
  annotate("text", x = 5.19, y = 0.38, label = "5.19", size = 3.6, colour = kol[["niemożliwa"]], fontface = "bold") +
  annotate("text", x = 5.21, y = 0.38, label = "5.21", size = 3.6, colour = kol[["możliwa"]], fontface = "bold") +
  scale_colour_manual(values = kol, name = "Podana średnia (2 miejsca):") +
  scale_shape_manual(values = c(16, 4), name = "Podana średnia (2 miejsca):") +
  scale_x_continuous(breaks = seq(5.10, 5.30, by = 0.05)) +
  scale_y_continuous(limits = c(0.3, 1.7), breaks = NULL) +
  labs(title = "A. n = 28: możliwe średnie i ich zakres zaokrąglenia", x = "Średnia", y = NULL) +
  motyw

# B. Jaka część średnich z dwoma miejscami (od 1.00 do 7.00) przechodzi test przy danym n · k?
B <- data.frame(nk = 1:120)
B$zgodne <- sapply(B$nk, function(nk) 100 * mean(sapply(seq(1, 7, by = 0.01), grim, n = nk, k = 1)))
print(transform(B[B$nk %in% c(10, 28, 40, 41, 50, 80, 99, 100, 120), ], zgodne = round(zgodne, 1)), row.names = FALSE)

pB <- ggplot(B, aes(nk, zgodne)) +
  geom_vline(xintercept = 100, linetype = "dashed", colour = "grey40") +
  geom_line(linewidth = 0.9, colour = kol[["możliwa"]]) +
  annotate("point", x = 28, y = B$zgodne[B$nk == 28], size = 3, colour = kol[["możliwa"]]) +
  annotate("text", x = 31, y = B$zgodne[B$nk == 28] - 4, label = "n · k = 28", hjust = 0, size = 3.6) +
  annotate("text", x = 98, y = 40, label = "od n · k = 100\nkażda średnia\njest możliwa", hjust = 1, size = 3.6, colour = "grey30") +
  scale_y_continuous(limits = c(0, 100), breaks = seq(0, 100, 20)) +
  labs(title = "B. Średnie z dwoma miejscami, które przechodzą test",
       x = "Liczba osób × liczba pozycji (n · k)", y = "Możliwe średnie (%)") +
  motyw

p <- pA / pB + plot_layout(heights = c(1, 1.3))
p
Wynik w R
[1] 5.1071 5.1429 5.1786 5.2143 5.2500 5.2857
Możliwe: 5.11 5.14 5.18 5.21 5.25 5.29
Niemożliwe: 15 z 21
  nk zgodne
  10   10.1
  28   28.1
  40   60.1
  41   41.1
  50   50.1
  80  100.0
  99   99.0
 100  100.0
 120  100.0
Co wykazali autorzy
Brown i Heathers (2017) przejrzeli 260 artykułów z czołowych czasopism psychologicznych. Test dało się zastosować w 71, a około połowy z nich (36) zawierało co najmniej jedną niespójną średnią. W 9 przypadkach, w których autorzy przekazali dane, potwierdzono co najmniej jeden błąd raportowania. To jedno z narzędzi kontroli spójności, obok sprawdzania wartości p względem statystyki testu – Nuijten i in. (2016) znaleźli niezgodne p w połowie artykułów stosujących testy istotności.
Ograniczenia
- Test działa tylko dla danych całkowitych i małych prób. Przy dwóch miejscach po przecinku i n·k ≥ 100 każda średnia jest możliwa, co pokazuje przykład w R.
- Niespójność nie dowodzi nieuczciwości. Częstsze wyjaśnienia to literówka, inne n po usunięciu braków albo wynik ważony.
- Zanim zgłosisz problem, poproś autorów o dane lub wyjaśnienie.
Test GRIM przydaje się przy reanalizie cudzych wyników i przy sprawdzaniu własnych tabel przed wysłaniem tekstu. Inne narzędzie kontroli danych liczbowych to prawo Benforda, a szerszy kontekst daje hasło kryzys replikacyjny.
Jak opisać w pracy
Test GRIM w R
Funkcja grim() sprawdza, czy po zaokrągleniu do podanej liczby miejsc któraś możliwa średnia (suma całkowita podzielona przez n·k) równa się średniej z artykułu. Wystarcza podstawowy R.
Sprawdzenie średnich z tabeli
R
# Test GRIM: czy średnia z liczb całkowitych jest możliwa przy danym n i liczbie pozycji k?
grim <- function(m, n, k = 1, miejsca = 2) {
  suma <- round(m * n * k)                        # najbliższa możliwa suma odpowiedzi
  kandydaci <- (suma - 1):(suma + 1) / (n * k)     # możliwe średnie wokół podanej
  tol <- 0.5 / 10^miejsca + 1e-9                   # połowa ostatniego miejsca po przecinku
  any(abs(kandydaci - m) <= tol)
}
spr <- data.frame(M = c(5.19, 5.21, 3.45, 3.45), n = c(28, 28, 28, 28), k = c(1, 1, 1, 3))
spr$najblizsza <- round(round(spr$M * spr$n * spr$k) / (spr$n * spr$k), 4)
spr$GRIM_zgodna <- mapply(grim, spr$M, spr$n, spr$k)
print(spr)
# Kiedy test ma sens: przy dwóch miejscach po przecinku i n * k >= 100 każda średnia jest możliwa
mean(sapply(seq(1, 7, by = 0.01), grim, n = 120, k = 1))
Wynik w R
     M  n k najblizsza GRIM_zgodna
1 5.19 28 1     5.1786       FALSE
2 5.21 28 1     5.2143        TRUE
3 3.45 28 1     3.4643       FALSE
4 3.45 28 3     3.4524        TRUE
[1] 1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Obliczenia testu nie wymagają dodatkowych pakietów; rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Do jakich danych stosuje się test GRIM?
Do średnich z odpowiedzi całkowitych, np. pozycji Likerta, liczby punktów lub zliczeń, przy znanym n i liczbie pozycji. Nie działa dla danych ciągłych, takich jak czas reakcji czy wzrost.
Od jakiej liczebności test GRIM przestaje działać?
Przy średnich z dwoma miejscami po przecinku – gdy n razy liczba pozycji wynosi co najmniej 100. Wtedy odstęp między możliwymi średnimi jest mniejszy niż 0.01 i każda podana wartość jest możliwa.
Czy niespójna średnia oznacza fałszerstwo danych?
Nie. Najczęściej to literówka, inne n po usunięciu braków albo średnia ważona. Wynik GRIM jest powodem, by poprosić autorów o dane lub wyjaśnienie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wynik wygląda podejrzanie
Tabela objaw × przyczyna × test, plik CSV z usterkami, kod R z wynikami przed naprawą i po niej oraz lista kontrolna na 10 minut.
Czytaj →PoradnikKalkulator spójności wyników
GRIM, p przeliczone ze statystyki, sumy i odsetki oraz przedział ufności – z tolerancją zaokrągleń, podpowiedziami i gotową notatką z kontroli.
Czytaj →PoradnikKontrola spójności liczb przed oddaniem pracy
Osiem kontroli: N i sumy w tabelach, procenty, p a statystyka testu, df, przedziały ufności, GRIM i te same liczby w całej pracy – z kodem w R.
Czytaj →PoradnikReanaliza i wtórna analiza cudzych danych
Licencje i warunki użycia, prerejestracja danych wtórnych, test GRIM, zgodność p i analiza wieloświatowa w R – z wzorami opisu i listu do autorów.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Brown, N. J. L., & Heathers, J. A. J. (2017). The GRIM test: A simple technique detects numerous anomalies in the reporting of results in psychology. Social Psychological and Personality Science, 8(4), 363–369. https://doi.org/10.1177/1948550616673876 ● Otwarty dostęp: pełny tekst
- Nuijten, M. B., Hartgerink, C. H. J., van Assen, M. A. L. M., Epskamp, S., & Wicherts, J. M. (2016). The prevalence of statistical reporting errors in psychology (1985–2013). Behavior Research Methods, 48(4), 1205–1226. https://doi.org/10.3758/s13428-015-0664-2 ● Otwarty dostęp
Cytowania BibTeX
@article{brown2017grim, author={Brown, Nicholas J. L. and Heathers, James A. J.}, title={{The GRIM test: A simple technique detects numerous anomalies in the reporting of results in psychology}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={4}, pages={363--369}, doi={10.1177/1948550616673876}}@article{nuijten2016prevalence, author={Nuijten, Michèle B. and Hartgerink, Chris H. J. and van Assen, Marcel A. L. M. and Epskamp, Sacha and Wicherts, Jelte M.}, title={{The prevalence of statistical reporting errors in psychology (1985–2013)}}, journal={Behavior Research Methods}, year={2016}, volume={48}, number={4}, pages={1205--1226}, doi={10.3758/s13428-015-0664-2}}