Co to są statcheck i SPRITE?
statcheck i SPRITE to narzędzia kontroli spójności opublikowanych wyników: sprawdzają, czy podane liczby mogą być jednocześnie prawdziwe. statcheck wyszukuje w tekście wyniki zapisane w stylu APA, np. t(40) = 2.50, p = .010, i przelicza wartość p ze statystyki testu i stopni swobody. SPRITE (ang. Sample Parameter Reconstruction via Iterative TEchniques) odtwarza przykładowe zbiory danych całkowitych zgodne z podaną średnią, odchyleniem standardowym, liczebnością i zakresem skali (Heathers i in., 2018).
Co wykrywa statcheck
Nuijten i in. (2016) sprawdzili programem ponad 250 000 wartości p z ośmiu czasopism psychologicznych. W połowie artykułów stosujących testy istotności co najmniej jedno p nie zgadzało się ze statystyką testu, a w co ósmym niezgodność mogła zmienić wniosek. Program odróżnia zwykły błąd (inna wartość p) od błędu decyzji (podane i przeliczone p leżą po różnych stronach progu .05). Nuijten i Polanin (2020) pokazują, jak używać go także przy kodowaniu badań do metaanalizy.
Co dodaje SPRITE
Test GRIM pyta, czy sama średnia jest możliwa. SPRITE szuka rozkładów odpowiedzi, które dają jednocześnie tę średnią i SD, np. na skali Likerta. Jeśli żadnego nie da się znaleźć, wyniki są niespójne. Jeśli wszystkie znalezione rozkłady są nieprawdopodobne (np. same skrajne odpowiedzi), to powód, by zapytać autorów.
Przykład
Kod niżej wykrył, że F(1, 76) = 3.21 daje p = .077, a nie .040 (błąd decyzji), a t(40) = 2.50 daje p = .017 zamiast .010 (błąd bez zmiany wniosku); r(52) = .29, p = .034 jest spójne. Dla średniej 3.45 i SD 1.19 przy n = 20 na skali 1–5 SPRITE znalazł różne zgodne rozkłady, np. 1, 3, 7, 4 i 5 osób przy kolejnych odpowiedziach. Przy średniej 4.60 SD może wynosić najwyżej 1.23, więc podane SD 1.31 jest niemożliwe.
Na rysunku
Panel A to fikcyjny „artykuł” ze 150 wynikami t, F i r zapisanymi w stylu APA i przepuszczonymi przez statcheck. W 20 z nich podaną wartość p celowo zmieniono losowym mnożnikiem. Odsetek błędów (15%) i zakres p od .001 do .6 ustawiono ręcznie, a ziarno (7061) ustalono raz. Panel B pokazuje, jakie SD są w ogóle możliwe przy n = 20 na skali 1–5. Najmniejsze daje rozkład z odpowiedziami jak najbliżej siebie, największe – z odpowiedziami skrajnymi.
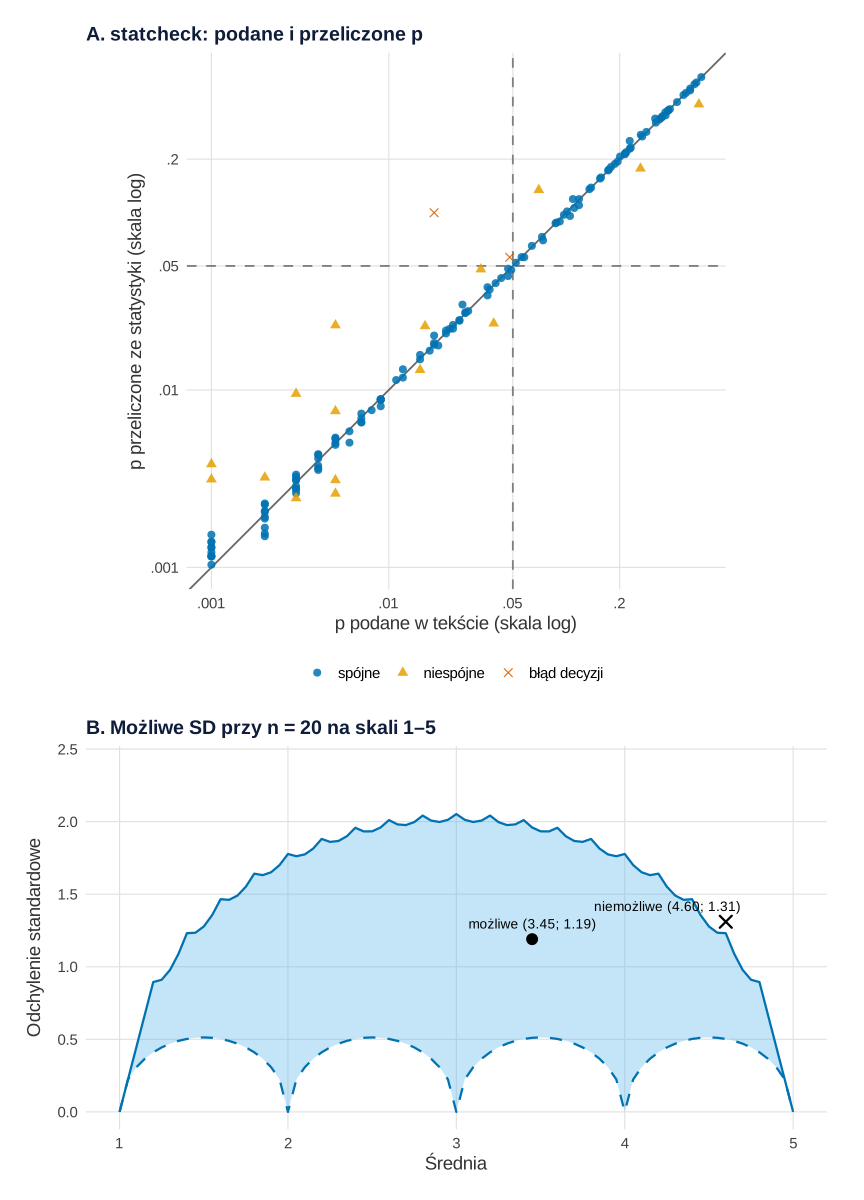
set.seed(7061)).Co widać. Spójne wyniki leżą na przekątnej. statcheck oznaczył 18 z 20 zmienionych wyników: 16 jako niespójne i 2 jako błędy decyzji, w których podane p jest poniżej .05, a przeliczone powyżej. Dwie zmiany były tak małe, że mieszczą się w zaokrągleniu, więc program słusznie ich nie zgłosił. Żaden ze 130 niezmienionych wyników nie dał fałszywego alarmu. W panelu B dozwolone SD tworzy łuk: przy średniej 3.45 może wynosić od 0.51 do 1.96, a przy 4.60 najwyżej 1.23. Dlatego para 3.45 i 1.19 jest możliwa, a 4.60 i 1.31 nie.
Na co uważać. Fikcyjne wyniki są zapisane idealnie w stylu APA. W prawdziwych tekstach program pominie wyniki zapisane nietypowo, a testy jednostronne czy p po poprawkach może zgłosić niesłusznie. Leżenie na przekątnej nie dowodzi poprawności analizy: statcheck sprawdza tylko zgodność p ze statystyką, a nie to, czy statystyka jest dobrze policzona. Podobnie punkt wewnątrz łuku w panelu B oznacza tylko, że pasujące dane mogą istnieć. Czy są wiarygodne, pokażą dopiero rozkłady znalezione przez SPRITE.
Podpis do pracy:
Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. statcheck: podane vs przeliczone p w fikcyjnym zbiorze wyników (A); SPRITE: możliwy zakres SD (B)
library(statcheck)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("spójne" = "#0072B2", "niespójne" = "#E69F00", "błąd decyzji" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# A. 150 fikcyjnych wyników t, F i r zapisanych w stylu APA; w 15% p celowo „zepsuto”
set.seed(7061)                                         # ziarno ustalone raz
k <- 150
typ <- sample(c("t", "F", "r"), k, replace = TRUE)
df <- sample(20:200, k, replace = TRUE)
p_prawd <- 10^runif(k, log10(0.001), log10(0.6))      # prawdziwe p od .001 do .6 (rozkład log-jednostajny)
stat <- ifelse(typ == "t", qt(1 - p_prawd / 2, df),
        ifelse(typ == "F", qf(1 - p_prawd, 1, df), qt(1 - p_prawd / 2, df) / sqrt(qt(1 - p_prawd / 2, df)^2 + df)))
p_podane <- p_prawd
zepsute <- runif(k) < 0.15                             # odsetek błędów ustawiony ręcznie
p_podane[zepsute] <- pmin(p_prawd[zepsute] * exp(rnorm(sum(zepsute), 0, 1)), 0.99)
fmt <- function(x, d) sub("^0\\.", ".", formatC(x, format = "f", digits = d))
tekst <- ifelse(typ == "t", sprintf("t(%d) = %.2f, p = %s", df, stat, fmt(p_podane, 3)),
         ifelse(typ == "F", sprintf("F(1, %d) = %.2f, p = %s", df, stat, fmt(p_podane, 3)),
                sprintf("r(%d) = %s, p = %s", df, fmt(stat, 2), fmt(p_podane, 3))))
head(tekst, 3)
sc <- statcheck(paste(tekst, collapse = ". "), messages = FALSE)
sc$ocena <- factor(ifelse(sc$decision_error, "błąd decyzji", ifelse(sc$error, "niespójne", "spójne")), levels = names(kol))
cat("Wyników odczytanych:", nrow(sc), "; celowo zepsutych:", sum(zepsute), "\n")
table(zepsute = zepsute, ocena = sc$ocena)          # wiersze tekstu i wyniki statcheck są w tej samej kolejności

pA <- ggplot(sc, aes(reported_p, computed_p, colour = ocena, shape = ocena)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey40") +
  geom_hline(yintercept = 0.05, linetype = "dashed", colour = "grey50") +
  geom_vline(xintercept = 0.05, linetype = "dashed", colour = "grey50") +
  geom_point(size = 2.4, alpha = 0.85) +
  scale_x_log10(breaks = c(0.001, 0.01, 0.05, 0.2, 1), labels = c(".001", ".01", ".05", ".2", "1")) +
  scale_y_log10(breaks = c(0.001, 0.01, 0.05, 0.2, 1), labels = c(".001", ".01", ".05", ".2", "1")) +
  scale_colour_manual(values = kol, name = NULL, drop = FALSE) + scale_shape_manual(values = c(16, 17, 4), name = NULL, drop = FALSE) +
  coord_equal() +
  labs(title = "A. statcheck: podane i przeliczone p", x = "p podane w tekście (skala log)", y = "p przeliczone ze statystyki (skala log)") +
  motyw

# B. SPRITE: przy n = 20 na skali 1–5 nie każde SD jest możliwe dla danej średniej
sd_zakres <- function(m, n = 20, lo = 1, hi = 5) {
  s <- round(m * n)                                    # suma odpowiedzi
  # najmniejsze SD: wartości jak najbliżej siebie
  a <- floor(s / n); r <- s - a * n
  x_min <- c(rep(a + 1, r), rep(a, n - r))
  # największe SD: jak najwięcej wartości skrajnych (lo i hi) i co najwyżej jedna pośrednia
  x <- rep(lo, n); reszta <- s - n * lo; i <- 1
  while (reszta > 0) { d <- min(hi - lo, reszta); x[i] <- x[i] + d; reszta <- reszta - d; i <- i + 1 }
  c(min = sd(x_min), max = sd(x))
}
B <- data.frame(srednia = seq(1, 5, by = 0.05))
B <- cbind(B, t(sapply(B$srednia, sd_zakres)))
round(B[B$srednia %in% c(3.45, 4.60), ], 2)
spr <- data.frame(srednia = c(3.45, 4.60), sd = c(1.19, 1.31), wynik = c("możliwe (3.45; 1.19)", "niemożliwe (4.60; 1.31)"), poziomo = c(0.5, 0.9))

pB <- ggplot(B, aes(srednia)) +
  geom_ribbon(aes(ymin = min, ymax = max), fill = "#56B4E9", alpha = 0.35) +
  geom_line(aes(y = max), colour = "#0072B2", linewidth = 0.8) +
  geom_line(aes(y = min), colour = "#0072B2", linewidth = 0.8, linetype = "dashed") +
  geom_point(data = spr, aes(srednia, sd, shape = wynik), size = 3.4, colour = "black", stroke = 1.2) +
  geom_text(data = spr, aes(srednia, sd, label = wynik, hjust = poziomo), vjust = -1.1, size = 3.6) +
  scale_shape_manual(values = c(16, 4), guide = "none") +
  scale_y_continuous(limits = c(0, 2.4)) +
  labs(title = "B. Możliwe SD przy n = 20 na skali 1–5", x = "Średnia", y = "Odchylenie standardowe") +
  motyw

p <- pA / pB + plot_layout(heights = c(1.4, 1))
p
Wynik w R
[1] "r(27) = .53, p = .005"     "r(154) = .18, p = .025"
[3] "F(1, 61) = 3.01, p = .088"
Wyników odczytanych: 150 ; celowo zepsutych: 20
       ocena
zepsute spójne niespójne błąd decyzji
  FALSE    130         0            0
  TRUE       2        16            2
   srednia  min  max
50    3.45 0.51 1.96
73    4.60 0.50 1.23
Jak opisać w pracy
Na co uważać
- Fałszywe alarmy. statcheck czyta tylko zapis w stylu APA; testy jednostronne, p po poprawkach i nietypowy zapis sprawdź ręcznie.
- Niespójność to pytanie, nie zarzut. Częściej to literówka lub inne n niż nieuczciwość; najpierw poproś autorów o wyjaśnienie (zob. reanaliza cudzych danych).
- Sprawdź własny rękopis przed wysłaniem.
statcheck i SPRITE w R
Funkcja statcheck() wyszukuje wyniki w tekście i przelicza p, a pakiet rsprite2 szuka rozkładów zgodnych z podaną średnią i SD. Liczby w tekście pochodzą z tego kodu.
Kontrola trzech wyników testów i dwóch par średnia–SD
R
library(statcheck)
tekst <- "Group A scored higher, t(40) = 2.50, p = .010. The effect of condition
was significant, F(1, 76) = 3.21, p = .040. The correlation was r(52) = .29, p = .034."
wynik <- statcheck(tekst, messages = FALSE)          # wyszukuje wyniki w stylu APA i przelicza p
print(transform(wynik[, c("raw", "reported_p", "computed_p", "error", "decision_error")],
                computed_p = round(computed_p, 4)))

library(rsprite2)
set.seed(706)                                        # SPRITE losuje próby, więc ustalamy ziarno
# średnia 3.45, SD 1.19, n = 20, jedna pozycja 1–5: jakie dane mogły dać takie statystyki?
par1 <- set_parameters(mean = 3.45, sd = 1.19, n_obs = 20, min_val = 1, max_val = 5,
                       m_prec = 2, sd_prec = 2)
proby <- find_possible_distributions(par1, n_distributions = 3)
print(t(sapply(proby$distribution, function(x) table(factor(x, levels = 1:5)))))
# średnia 4.60, SD 1.31 przy tych samych warunkach: SPRITE odrzuca parametry
tryCatch(set_parameters(mean = 4.60, sd = 1.31, n_obs = 20, min_val = 1, max_val = 5,
                        m_prec = 2, sd_prec = 2),
         error = function(e) cat(conditionMessage(e), "\n"))
Wynik w R
                        raw reported_p computed_p error decision_error
1    t(40) = 2.50, p = .010      0.010     0.0166  TRUE          FALSE
2 F(1, 76) = 3.21, p = .040      0.040     0.0772  TRUE           TRUE
3     r(52) = .29, p = .034      0.034     0.0334 FALSE          FALSE
     1 2 3 4 5
[1,] 1 3 7 4 5
[2,] 1 4 4 7 4
[3,] 0 7 1 8 4
The standard deviation is outside the possible range, given the other parameters.
         It should be between 0.5 and 1.23.
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety statcheck 1.6.1 i rsprite2 0.2.1). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- statcheck (wersja 1.6.1): Nuijten, M. B., & Epskamp, S. (2026). statcheck: Extract statistics from articles and recompute p-values (R package version 1.6.1) [Computer software]. https://CRAN.R-project.org/package=statcheck
- rsprite2 (wersja 0.2.1): Wallrich, L. (2023). rsprite2: Identify distributions that match reported sample parameters (SPRITE) (R package version 0.2.1) [Computer software]. https://CRAN.R-project.org/package=rsprite2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Co oznacza błąd decyzji w raporcie statcheck?
To niezgodność, przy której podane i przeliczone p leżą po różnych stronach progu .05, np. podano p = .040, a ze statystyki wynika .077. Zmienia ona wniosek o istotności.
Czy SPRITE odtwarza prawdziwe dane z badania?
Nie. Pokazuje tylko przykładowe zbiory zgodne z podanymi statystykami. Prawdziwe dane mogą wyglądać inaczej; SPRITE przydaje się, gdy żaden zgodny zbiór nie istnieje albo wszystkie są nieprawdopodobne.
Kiedy warto uruchomić statcheck na własnej pracy?
Przed wysłaniem rękopisu lub złożeniem pracy dyplomowej, zwłaszcza gdy wyniki przepisywano ręcznie z programu statystycznego. Wychwytuje literówki w p i stopniach swobody, zanim zrobi to recenzent.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kalkulator spójności wyników
GRIM, p przeliczone ze statystyki, sumy i odsetki oraz przedział ufności – z tolerancją zaokrągleń, podpowiedziami i gotową notatką z kontroli.
Czytaj →PoradnikKontrola spójności liczb przed oddaniem pracy
Osiem kontroli: N i sumy w tabelach, procenty, p a statystyka testu, df, przedziały ufności, GRIM i te same liczby w całej pracy – z kodem w R.
Czytaj →PoradnikReanaliza i wtórna analiza cudzych danych
Licencje i warunki użycia, prerejestracja danych wtórnych, test GRIM, zgodność p i analiza wieloświatowa w R – z wzorami opisu i listu do autorów.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Heathers, J. A. J., Anaya, J., van der Zee, T., & Brown, N. J. L. (2018). Recovering data from summary statistics: Sample Parameter Reconstruction via Iterative TEchniques (SPRITE) [Preprint]. PeerJ Preprints. https://doi.org/10.7287/peerj.preprints.26968v1 ● Otwarty dostęp
- Nuijten, M. B., & Polanin, J. R. (2020). “statcheck”: Automatically detect statistical reporting inconsistencies to increase reproducibility of meta-analyses. Research Synthesis Methods, 11(5), 574–579. https://doi.org/10.1002/jrsm.1408 ● Otwarty dostęp
- Nuijten, M. B., Hartgerink, C. H. J., van Assen, M. A. L. M., Epskamp, S., & Wicherts, J. M. (2016). The prevalence of statistical reporting errors in psychology (1985–2013). Behavior Research Methods, 48(4), 1205–1226. https://doi.org/10.3758/s13428-015-0664-2 ● Otwarty dostęp
Cytowania BibTeX
@misc{heathers2018recovering, author={Heathers, James A. J. and Anaya, Jordan and van der Zee, Tim and Brown, Nicholas J. L.}, title={{Recovering data from summary statistics: Sample Parameter Reconstruction via Iterative TEchniques (SPRITE)}}, howpublished={PeerJ Preprints}, year={2018}, doi={10.7287/peerj.preprints.26968v1}}@article{nuijten2020statcheck, author={Nuijten, Michèle B. and Polanin, Joshua R.}, title={{“statcheck”: Automatically detect statistical reporting inconsistencies to increase reproducibility of meta-analyses}}, journal={Research Synthesis Methods}, year={2020}, volume={11}, number={5}, pages={574--579}, doi={10.1002/jrsm.1408}}@article{nuijten2016prevalence, author={Nuijten, Michèle B. and Hartgerink, Chris H. J. and van Assen, Marcel A. L. M. and Epskamp, Sacha and Wicherts, Jelte M.}, title={{The prevalence of statistical reporting errors in psychology (1985–2013)}}, journal={Behavior Research Methods}, year={2016}, volume={48}, number={4}, pages={1205--1226}, doi={10.3758/s13428-015-0664-2}}