Co to jest prawo Benforda?
Prawo Benforda (ang. Benford’s law, też prawo pierwszej cyfry) mówi, że w wielu zbiorach danych liczbowych pierwsza cyfra znacząca nie jest rozłożona równomiernie. Prawdopodobieństwo cyfry d wynosi P(d) = log10(1 + 1/d): jedynka pojawia się na początku w 30.1% liczb, dwójka w 17.6%, a dziewiątka tylko w 4.6%. Hill (1995) wykazał, że jeśli dane są próbami z wielu losowo wybranych rozkładów, to cyfry znaczące połączonej próby zbiegają do tego rozkładu logarytmicznego. Tłumaczy to, dlaczego wzór pasuje do tak różnych danych.
Kiedy dane spełniają prawo Benforda?
Gdy wartości rozciągają się na kilka rzędów wielkości i powstają naturalnie, np. kwoty faktur, obroty firm, liczby mieszkańców gmin. Dobrze pasują też zmienne silnie prawoskośne, których logarytm ma szeroki rozkład (por. transformacja logarytmiczna), np. rozkład lognormalny o dużym rozrzucie. Hill wymienia wśród zastosowań wykrywanie oszustw w danych księgowych. Wyraźne odstępstwo od rozkładu Benforda bywa sygnałem, że liczby zmieniono, zaokrąglono albo wymyślono – i wskazuje pozycje do sprawdzenia.
Przykład w R
Wylosowaliśmy 1000 „kwot” z rozkładu lognormalnego, rozciągniętych na kilka rzędów wielkości, i 1000 kwot z wąskiego zakresu – z rozkładu jednostajnego od 1000 do 9999. W pierwszym zbiorze jedynka zaczynała 295 liczb (oczekiwane 301), a dziewiątka 52 (oczekiwane 46). Test chi-kwadrat zgodności nie wykazał odchylenia, χ²(8) = 8.03, p = .431. W drugim każda cyfra pojawiała się od 102 do 118 razy, χ²(8) = 399.40, p < .001.
Na rysunku
Na rysunku są trzy zbiory danych rzeczywistych dostępnych w R i jeden symulowany. Liczby ludności 437 hrabstw z pięciu stanów Środkowego Zachodu USA i miesięczne wartości sprzedaży domów w miastach Teksasu (zbiory midwest i txhousing z pakietu ggplot2) obejmują po 3.5 rzędu wielkości. Długości 141 rzek Ameryki Północnej (rivers) – tylko 1.4 rzędu, a kwoty z rozkładu jednostajnego z przykładu – jeden rząd.
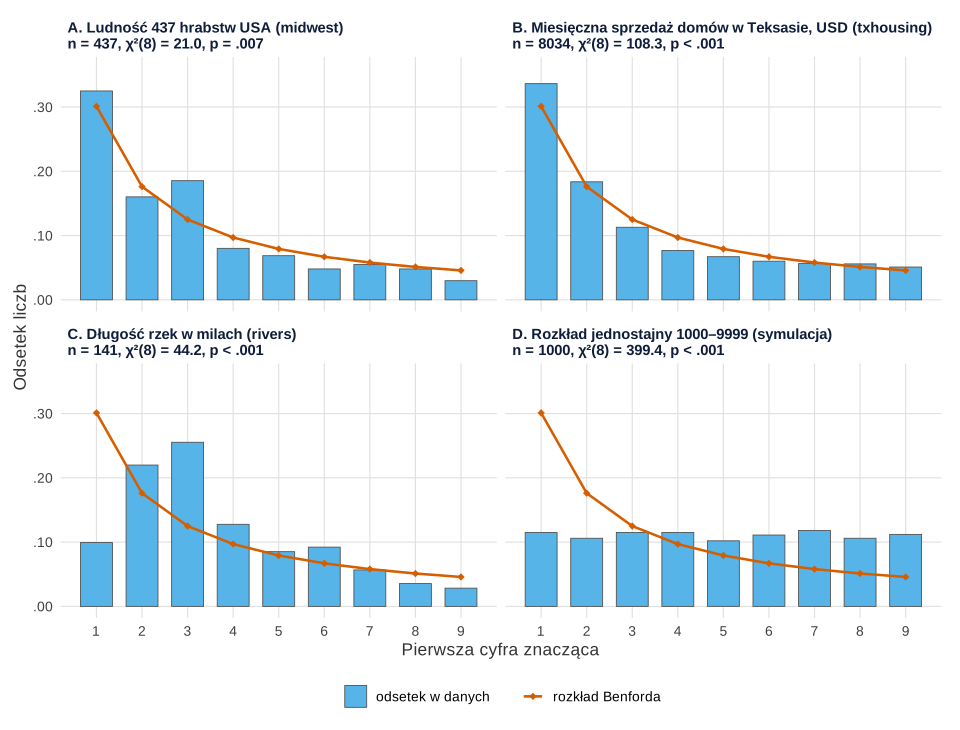
midwest, txhousing i rivers; dane w panelu D z set.seed(4961), jak w przykładzie).Co widać. Dwa zbiory rozciągnięte na kilka rzędów wielkości (A, B) mają kształt Benforda: jedynka zaczyna 32.5% i 33.6% liczb, a odsetki maleją z kolejnymi cyframi. Długości rzek (C) łamią ten wzór – jedynką zaczyna się tylko 9.9% wartości. Zbiór obejmuje wyłącznie duże rzeki, najkrótsza ma 135 mil, więc liczby od 100 do 134 nie mogą się w nim pojawić. W panelu D, gdzie wszystkie kwoty mają cztery cyfry i jednakowe szanse, każda cyfra zaczyna od 10.2% do 11.8% liczb.
Na co uważać. Test chi-kwadrat odrzuca zgodność we wszystkich czterech panelach, także w B, gdzie słupki prawie pokrywają się z linią. Przy 8034 wartościach istotne staje się każde drobne odchylenie, a przy 437 (A) wystarczy nadwyżka trójek. Wynik testu mówi więc o odchyleniu, a nie o jego wadze czy przyczynie – dlatego zawsze pokaż wykres taki jak tu i oceń kształt, zanim zaczniesz szukać nieprawidłowości. Rysunek nie pokazuje też, które pozycje odpowiadają za odstępstwo; do tego służą reszty dla poszczególnych cyfr.
Podpis do pracy:
Kod rysunku drukuje też tabelę: liczebność, najmniejszą i największą wartość, zakres w rzędach wielkości, χ², p oraz odsetek jedynek i dziewiątek w każdym zbiorze. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Pierwsze cyfry w danych rzeczywistych i symulowanych na tle rozkładu Benforda
library(ggplot2)

# Paleta Okabe–Ito i prosty motyw
kol <- c(obs = "#56B4E9", benford = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        strip.text = element_text(face = "bold", colour = "#0f1d3a", hjust = 0),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

benford <- log10(1 + 1 / (1:9))                          # P(pierwsza cyfra = d)
pierwsza <- function(x) floor(x / 10^floor(log10(x)))    # pierwsza cyfra znacząca (x > 0)

# Trzy zbiory rzeczywiste z pakietów R (midwest i txhousing z ggplot2, rivers z datasets) i jeden symulowany – te same kwoty co w przykładzie
set.seed(4961)
kwoty <- rlnorm(1000, meanlog = 6, sdlog = 2)            # losowane w przykładzie przed kwotami „wąskimi”
waskie <- runif(1000, 1000, 9999)
zbiory <- list(
  "A. Ludność 437 hrabstw USA (midwest)" = ggplot2::midwest$poptotal,
  "B. Miesięczna sprzedaż domów w Teksasie, USD (txhousing)" = na.omit(ggplot2::txhousing$volume),
  "C. Długość rzek w milach (rivers)" = datasets::rivers,
  "D. Rozkład jednostajny 1000–9999 (symulacja)" = waskie)

wyniki <- do.call(rbind, lapply(names(zbiory), function(nazwa) {
  x <- zbiory[[nazwa]]; x <- x[x > 0]
  n_d <- tabulate(pierwsza(x), 9)
  test <- suppressWarnings(chisq.test(n_d, p = benford))
  data.frame(zbior = nazwa, n = length(x), min = signif(min(x), 3), max = signif(max(x), 3),
             rzedy = round(log10(max(x) / min(x)), 1),
             chi2 = unname(round(test$statistic, 2)), p = signif(test$p.value, 3),
             odsetek_1 = round(n_d[1] / length(x), 3), odsetek_9 = round(n_d[9] / length(x), 3))
}))
print(wyniki[, -1], row.names = FALSE)                   # rzedy = log10(max / min), czyli ile rzędów wielkości

dane <- do.call(rbind, lapply(names(zbiory), function(nazwa) {
  x <- zbiory[[nazwa]]; x <- x[x > 0]
  w <- wyniki[wyniki$zbior == nazwa, ]
  data.frame(panel = sprintf("%s\nn = %d, χ²(8) = %.1f, %s", nazwa, w$n, w$chi2,
                             ifelse(w$p < .001, "p < .001", paste("p =", sub("^0", "", sprintf("%.3f", w$p))))),
             cyfra = 1:9, odsetek = tabulate(pierwsza(x), 9) / length(x), benford = benford)
}))
dane$panel <- factor(dane$panel, levels = unique(dane$panel))

p <- ggplot(dane, aes(cyfra)) +
  geom_col(aes(y = odsetek, fill = "odsetek w danych"), width = 0.7, colour = "grey30", linewidth = 0.3) +
  geom_line(aes(y = benford, colour = "rozkład Benforda"), linewidth = 0.9) +
  geom_point(aes(y = benford, colour = "rozkład Benforda"), size = 2.2, shape = 18) +
  facet_wrap(~ panel, ncol = 2) +
  scale_fill_manual(values = c("odsetek w danych" = kol[["obs"]]), name = NULL) +
  scale_colour_manual(values = c("rozkład Benforda" = kol[["benford"]]), name = NULL) +
  scale_x_continuous(breaks = 1:9) +
  scale_y_continuous(limits = c(0, 0.36), labels = function(v) sub("^0", "", sprintf("%.2f", v))) +
  labs(x = "Pierwsza cyfra znacząca", y = "Odsetek liczb") + motyw
p
Wynik w R
    n    min      max rzedy   chi2        p odsetek_1 odsetek_9
  437   1700 5.11e+06   3.5  21.04 7.03e-03     0.325     0.030
 8034 835000 2.57e+09   3.5 108.28 8.61e-20     0.336     0.051
  141    135 3.71e+03   1.4  44.18 5.27e-07     0.099     0.028
 1000   1010 1.00e+04   1.0 399.40 2.52e-81     0.115     0.112
Jak opisać w pracy
Na co uważać
- Wąski zakres i skale. Prawo nie dotyczy odpowiedzi na skali Likerta, wieku, wzrostu, wyników testu 0–100 ani numerów nadawanych według reguły. Do wykrywania nierzetelnych odpowiedzi w ankiecie służą inne wskaźniki, opisane we wpisie o botach i fałszywych respondentach.
- Odchylenie to sygnał, nie dowód. Przy dużym n istotne bywają drobne różnice. Diekmann (2007) zauważył, że w zmyślonych współczynnikach regresji pierwsze cyfry też malały monotonicznie; lepiej różnicowały dane późniejsze cyfry.
- Liczby z różnych źródeł. Łącz tylko wartości tego samego rodzaju, np. kwoty bez sum i stawek.
Prawo Benforda w R
Kod liczy rozkład Benforda, wyznacza pierwsze cyfry dwóch symulowanych zbiorów kwot i porównuje je z rozkładem Benforda testem chi-kwadrat zgodności w bazowym R.
Pierwsze cyfry i test chi-kwadrat zgodności z rozkładem Benforda
R
benford <- log10(1 + 1 / (1:9))              # P(pierwsza cyfra = d)
round(benford, 3)
pierwsza <- function(x) floor(x / 10^floor(log10(x)))
set.seed(4961)
kwoty <- rlnorm(1000, meanlog = 6, sdlog = 2)  # kwoty z kilku rzędów wielkości
waskie <- runif(1000, 1000, 9999)              # kwoty z jednego rzędu wielkości
tab <- rbind(benford  = round(1000 * benford),
             kwoty    = tabulate(pierwsza(kwoty), 9),
             waskie   = tabulate(pierwsza(waskie), 9))
colnames(tab) <- 1:9; tab
chisq.test(tabulate(pierwsza(kwoty), 9), p = benford)
chisq.test(tabulate(pierwsza(waskie), 9), p = benford)
Wynik w R
[1] 0.301 0.176 0.125 0.097 0.079 0.067 0.058 0.051 0.046
          1   2   3   4   5   6   7   8   9
benford 301 176 125  97  79  67  58  51  46
kwoty   295 194 135  95  75  51  54  49  52
waskie  115 106 115 115 102 111 118 106 112

	Chi-squared test for given probabilities

data:  tabulate(pierwsza(kwoty), 9)
X-squared = 8.0264, df = 8, p-value = 0.4309


	Chi-squared test for given probabilities

data:  tabulate(pierwsza(waskie), 9)
X-squared = 399.4, df = 8, p-value < 2.2e-16
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład bez dodatkowych pakietów). Rysunek 1 wykonano w pakiecie ggplot2 (z niego pochodzą też zbiory midwest i txhousing), a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak sprawdzić prawo Benforda w R bez dodatkowych pakietów?
Wyznacz pierwsze cyfry wzorem floor(x / 10^floor(log10(x))), policz je funkcją tabulate() i porównaj z log10(1 + 1/(1:9)) testem chisq.test(liczebności, p = benford).
Czy prawo Benforda dotyczy wyników ankiety?
Nie dla odpowiedzi na skali Likerta, wieku ani wyników testu o stałym zakresie. Działa dla danych rozciągniętych na kilka rzędów wielkości, np. kwot, dochodów czy liczby mieszkańców.
Czy niezgodność z prawem Benforda dowodzi fałszowania danych?
Nie. To sygnał do sprawdzenia pozycji, a nie dowód. Odchylenie mogą dać zaokrąglenia, progi kwot albo mieszanie różnych rodzajów liczb, a przy dużym n istotne bywają drobne różnice.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Boty i fałszywi respondenci w ankiecie
Dystrybucja linku, ukryte pole, CAPTCHA, duplikaty i odpowiedzi otwarte, reguła usuwania ustalona przed analizą i symulacja w R: ile botów zmienia korelację.
Czytaj →PoradnikPrawo Benforda w audycie
Pierwsza i dwie pierwsze cyfry faktur, χ² i MAD, wpływ liczebności, kwoty z limitów i sito audytora – sześć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Diekmann, A. (2007). Not the first digit! Using Benford’s law to detect fraudulent scientific data. Journal of Applied Statistics, 34(3), 321–329. https://doi.org/10.1080/02664760601004940 ● Otwarty dostęp: pełny tekst
- Hill, T. P. (1995). A statistical derivation of the significant-digit law. Statistical Science, 10(4), 354–363. https://doi.org/10.1214/ss/1177009869 ● Otwarty dostęp
Cytowania BibTeX
@article{diekmann2007not, author={Diekmann, Andreas}, title={{Not the first digit! Using Benford’s law to detect fraudulent scientific data}}, journal={Journal of Applied Statistics}, year={2007}, volume={34}, number={3}, pages={321--329}, doi={10.1080/02664760601004940}}@article{hill1995statistical, author={Hill, Theodore P.}, title={{A statistical derivation of the significant-digit law}}, journal={Statistical Science}, year={1995}, volume={10}, number={4}, pages={354--363}, doi={10.1214/ss/1177009869}}