Przykład: faktury kosztowe firmy logistycznej
Fikcyjna firma spedycyjno-magazynowa ma osiem działów i w ciągu roku zaksięgowała 11 320 faktur kosztowych: paliwo, części i naprawy, usługi obce, drobne zakupy. Audytor wewnętrzny zdąży obejrzeć z bliska najwyżej kilkadziesiąt dokumentów. Pytanie biznesowe brzmi: które faktury wybrać do kontroli, żeby nie losować w ciemno?
Jednym z narzędzi jest prawo Benforda. W danych rozciągniętych na kilka rzędów wielkości jedynka zaczyna ok. 30% liczb, dziewiątka niecałe 5%. Hill (1995) uzasadnia to twierdzeniem granicznym: gdy dane są próbami z wielu różnych rozkładów, ich cyfry znaczące zbiegają do rozkładu logarytmicznego – a kwoty faktur od wielu dostawców dobrze pasują do tego opisu.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Kwoty czterech rodzajów kosztów wylosowano z rozkładów lognormalnych (mediany 900, 1500, 3000 i 150 zł, odchylenia logarytmu 1.3, 1.5, 1.6 i 1.2; udziały 30, 25, 25 i 20%). W dziale „Serwis floty” podrzuciliśmy 120 fikcyjnych faktur na okrągłe kwoty od 4000 do 4900 zł, tuż pod progiem 5000 zł, od którego fakturę zatwierdza druga osoba. Parametry ustawiono ręcznie; ziarno 637 ustalono raz i nie zmieniano go. Dane pobierzesz jako prawo-benforda-faktury.csv (z kolumną podrzucona, której w prawdziwych danych nie ma).
Krok 1: pierwsza cyfra wszystkich faktur
Analizujemy 11 297 kwot od 10 zł (do 729 206.78 zł – prawie pięć rzędów wielkości). Odsetki cyfr porównujemy z Benfordem na dwa sposoby: testem chi-kwadrat zgodności i średnim odchyleniem bezwzględnym (MAD, ang. mean absolute deviation).
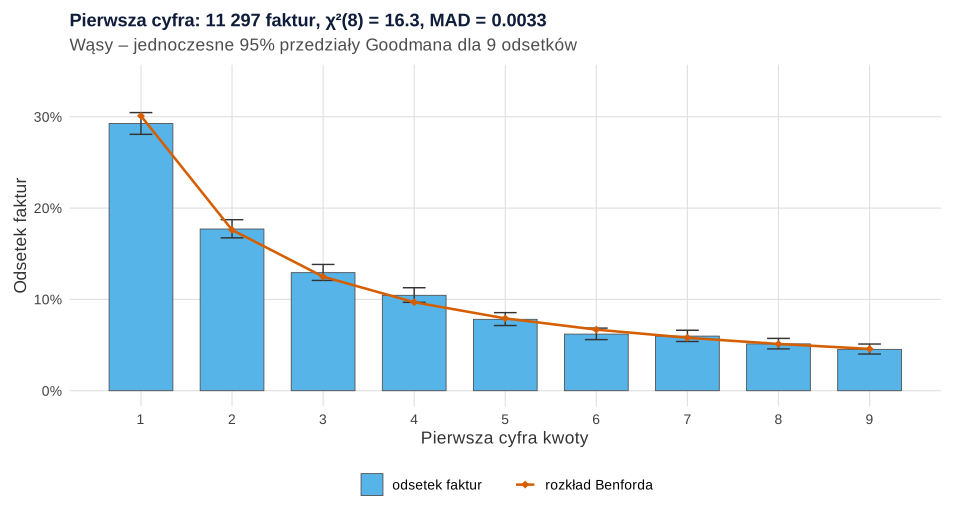
Co widać. Jedynką zaczyna się 29.26% faktur (oczekiwane 30.10%), czwórką 10.45% (oczekiwane 9.69%). χ²(8) = 16.28, p = .039, MAD = 0.0033. Wąsy to jednoczesne 95% przedziały Goodmana dla dziewięciu odsetków naraz; wszystkie punkty Benforda mieszczą się w nich. Lesperance i in. (2016) zalecają takie przedziały, bo osobne przedziały dwumianowe zbyt często odrzucają Benforda w danych naprawdę zgodnych.
Jak może zmylić. p = .039 nie oznacza nadużycia: przy 11 tysiącach kwot test wychwytuje drobiazgi. A 120 podrzuconych faktur to 1% danych – w całej firmie zostawiły tylko lekką nadwyżkę czwórek.
Podpis do pracy:
Zdanie do Wyników:
Krok 2: dwie pierwsze cyfry
Dwie pierwsze cyfry dzielą dane na 90 par (10–99) i pokazują, czy nie powtarza się konkretna wartość – a nadużycia krążą wokół progów zatwierdzania, limitów i „ładnych” liczb. Diekmann (2007) pokazał też, że w zmyślonych liczbach pierwsza cyfra często wygląda naturalnie, a dalsze cyfry odbiegają od Benforda bardziej.
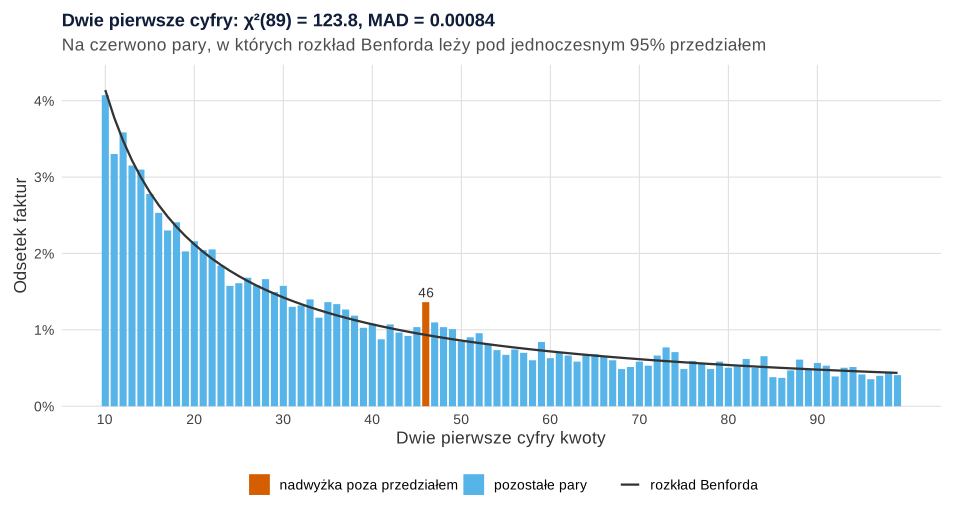
Co widać. Kwoty zaczynające się od 46 stanowią 1.36% faktur zamiast 0.93% (z = 4.69) – to jedyna para z Benfordem poza jednoczesnym przedziałem. Para 47 ma niewielką nadwyżkę (z = 2.00). Całość: χ²(89) = 123.8, p = .009, MAD = 0.00084, czyli według progów Nigriniego ścisła zgodność.
Jak może zmylić. Przy 90 parach kilka wartości z powyżej 2 pojawi się przypadkiem: to problem wielokrotnych porównań. Para 11 ma niedobór o z = 2.63 i nic za nim nie stoi.
Podpis do pracy:
Zdanie do Wyników:
χ² czy MAD? Liczebność zmienia wszystko
Statystyka χ² rośnie z liczbą kwot. Kossovsky (2021) dodaje, że rzeczywiste zbiory kwot nie są losową próbą z większej populacji, więc rutynowy test χ² w analizie Benforda jest najczęściej źle użyty. MAD nie ma wartości p, tylko progi. Pakiet R benford.analysis zapisuje je za monografią Nigriniego (2012): dla pierwszej cyfry 0.006, 0.012 i 0.015 (granice zgodności ścisłej, akceptowalnej i ledwie akceptowalnej; wyżej – brak zgodności), dla dwóch cyfr 0.0012, 0.0018 i 0.0022. Obie miary sprawdziliśmy na 1000 zbiorach dla każdej z siedmiu liczebności (100–100 000 kwot).
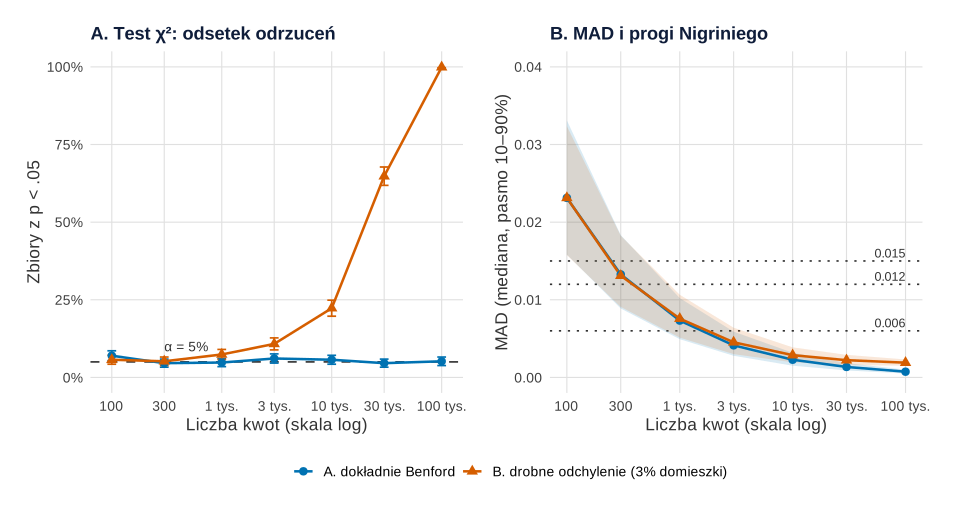
Co widać. Scenariusz A: cyfry dokładnie według Benforda. Scenariusz B: drobna domieszka (3% kwot z równymi szansami cyfr, MAD w populacji 0.0018), bez znaczenia w audycie. W A test χ² myli się w ok. 5% zbiorów, jak powinien. W B odsetek odrzuceń rośnie z 7.4% przy tysiącu kwot do 64.8% przy 30 tysiącach i 99.9% przy 100 tysiącach. MAD ma odwrotną wadę: przy 100 kwotach mediana wynosi 0.0231, a próg 0.015 przekroczyło 92.4% zbiorów idealnie zgodnych z Benfordem (przy 300 kwotach – 30.3%). Barney i Schulzke (2016) opisują ten sam związek MAD z liczebnością i proponują miarę Excess MAD, która go koryguje.
Jak może zmylić. Symulacja losuje cyfry niezależnie; faktury jednego dostawcy bywają do siebie podobne, co dodatkowo zawyża χ². Przy kilkuset fakturach nawet idealne dane wyglądają według progów MAD na „niezgodne”.
Podpis do pracy:
Zdanie do Metody:
Kwoty, które z natury nie spełniają Benforda
Najpierw odsiej kwoty, które z założenia nie wyglądają „po benfordowsku”. W tej firmie to diety z delegacji (45 zł razy 1–12 dób), tankowania kartą z limitem 2000 zł i opłaty z cennika (350, 640, 1250 i 2900 zł).
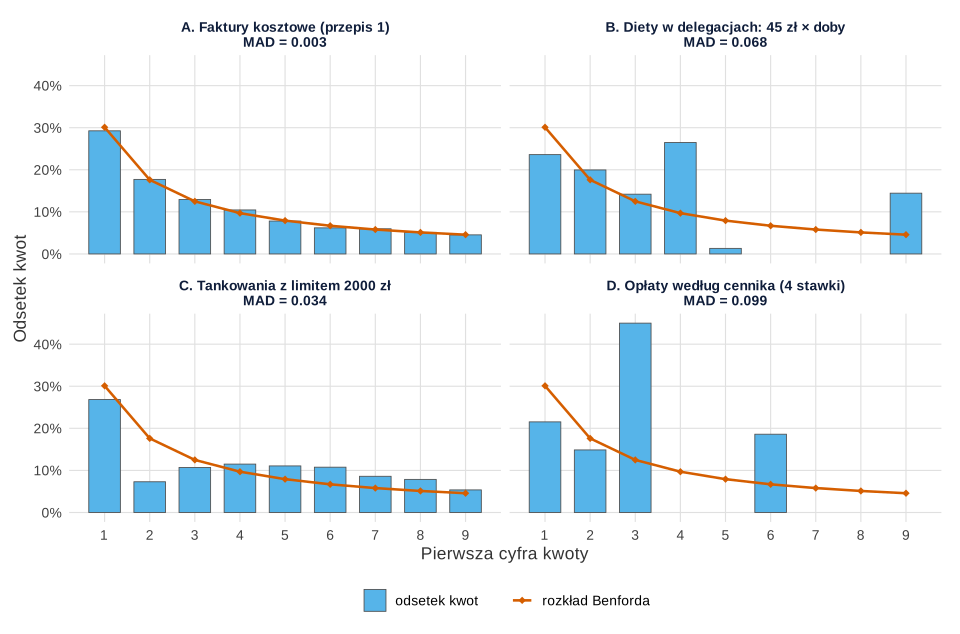
Co widać. Faktury mają MAD = 0.0033, diety 0.0682 (χ²(8) = 1885.2), tankowania 0.0342, opłaty z cennika 0.0987 – wielokrotnie powyżej progu 0.015, choć nic tu nie jest podejrzane. Diety i cennik mają kilka dozwolonych wartości, a limit zawęża tankowania do nieco ponad jednego rzędu wielkości.
Jak może zmylić. Dołączenie tych kwot do faktur zepsułoby test całej firmy. Nigrini (2017) podkreśla, że najpierw trzeba ocenić, jakie dane w ogóle nadają się do analizy Benforda. Dotyczy to też numerów dokumentów i kwot o wąskim zakresie, np. z rozkładu jednostajnego.
Podpis do pracy:
Zdanie do Metody:
Krok 3: działy – gdzie siedzą okrągłe faktury
Całość rozmywa sygnał z jednego działu (o tym, jak obraz całości różni się od obrazu grup, pisze wpis o porównaniu sklepów like-for-like). Dla każdego działu liczymy więc test dwóch cyfr, MAD i odsetek kwot równych pełnym setkom złotych, a p z ośmiu testów korygujemy poprawką Holma.
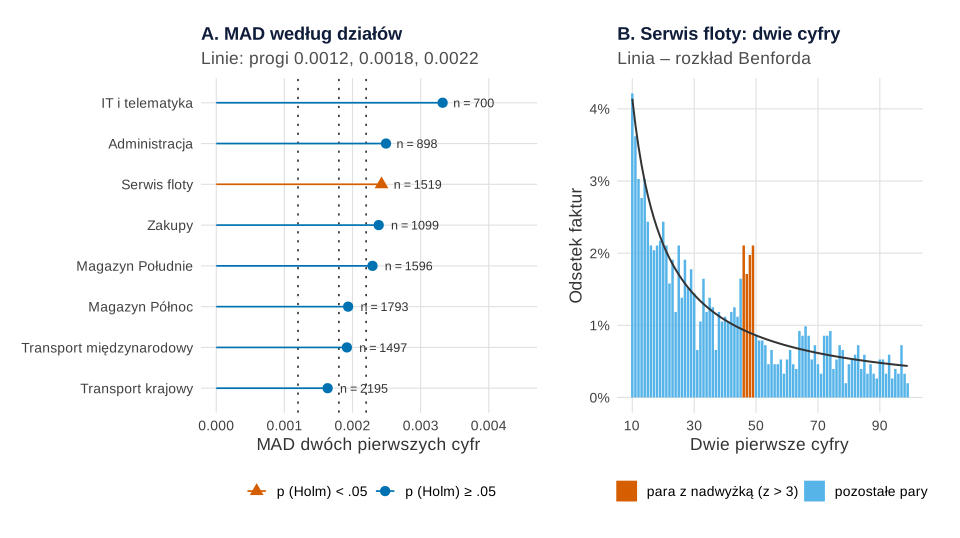
Co widać. Test wskazuje jeden dział: Serwis floty, χ²(89) = 163.6, p < .001 także po poprawce Holma (w pozostałych skorygowane p ≥ .496). Tam 7.9% kwot to pełne setki złotych, w innych działach – 0%. Pary 46–49 stanowią po 1.71–2.11% faktur działu wobec ok. 0.9% według Benforda (z od 3.26 do 5.14); para 45 ma mniejszą nadwyżkę (z = 2.77), para 50 – żadną. Nigrini i Miller (2009) opisują, że analiza cyfr wykrywa w danych transakcyjnych m.in. dane zaokrąglone.
Jak może zmylić. Najwyższe MAD (0.00332) ma najmniejszy dział, IT i telematyka (700 faktur), bez żadnych podrzuconych faktur. Serwis floty (0.00243) jest trzeci, a pięć z ośmiu działów przekracza próg 0.0022 – to efekt liczebności z rysunku 3. Porównuj działy podobnej wielkości i patrz na konkretne pary.
Podpis do pracy:
Zdanie do Wyników:
Sito audytora: od testu do próbki
Z Serwisu floty wybieramy faktury zaczynające się od 46–49 i równe pełnym setkom złotych. Jest ich 73 (4600, 4700, 4800 i 4900 zł) i wszystkie 73 to faktury podrzucone; losowa próbka tej wielkości miałaby ich przeciętnie 5.8. Sito przepuściło jednak 47 ze 120 podrzuconych faktur – na kwoty 4000–4500 zł, bo pary 40–45 nie wyróżniły się dość wyraźnie.
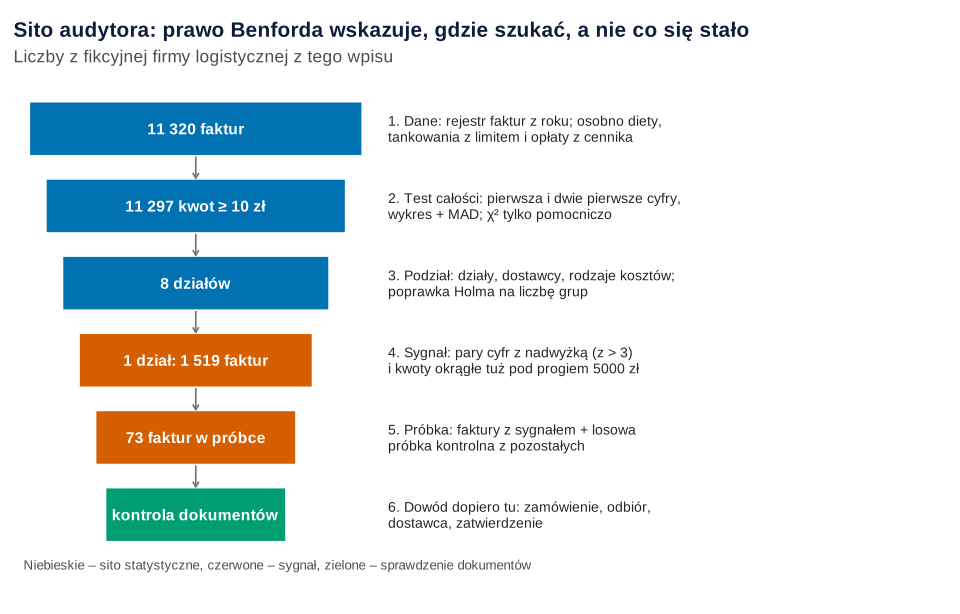
Co widać. Pięć kroków statystyki zawęża 11 320 faktur do 73, ale o tym, czy faktura jest fikcyjna, rozstrzyga dopiero szósty: zamówienie, protokół odbioru, dostawca i ślad zatwierdzenia.
Jak może zmylić. W praktyce wraca się do kroku 3 z innym podziałem (dostawca, osoba zatwierdzająca, miesiąc), a każdy podział to kolejne testy. Nigrini (2017) ostrzega, że dobór próby „aż reszta będzie zgodna z Benfordem” daje duże próby o wątpliwej trafności – dołóż więc losową próbkę kontrolną.
Podpis do pracy:
Co z tym zrobić w firmie
- Kontrola 73 faktur z Serwisu floty – zamówienia, odbiory, dostawcy. W realnym audycie to lista do wyjaśnienia, nie lista winnych.
- Przegląd progu 5000 zł. Nadwyżka kwot tuż pod progiem to sygnał do zmiany reguły (np. akceptacja sumy faktur od jednego dostawcy w miesiącu) niezależnie od wyniku kontroli.
- Osobna analiza diet, tankowań i opłat z cennika – zamiast Benforda: zgodność ze stawką, limitem i liczbą dób.
- Analiza cyfr co kwartał z tym samym podziałem; MAD działów w czasie można śledzić na karcie kontrolnej.
- Gdy kontroli jest za mało na wszystkie sygnały, ustal priorytet według kosztu alarmu i budżetu kontroli – tak jak we wpisie o wykrywaniu nadużyć przy rzadkich zdarzeniach.
Jak opisać w pracy
W Metodzie podaj, które kwoty analizowano i które wyłączono (z uzasadnieniem), które cyfry, jakie miary (MAD ze źródłem progów, χ², jednoczesne przedziały), według jakich grup dzielono dane i jak korygowano wielokrotne testy. W Wynikach: całość, grupy, konkretne pary cyfr. Nie pisz, że analiza „wykazała oszustwo”. Więcej we wpisach statystyka w pracy z finansów i rachunkowości i jak napisać pracę z finansów i rachunkowości; gdy temat dotyczy kosztów transportu i magazynu – także statystyka w pracy z logistyki.
Kod R: analiza cyfr faktur krok po kroku
Kod odtwarza wszystkie liczby z tekstu, sześć rysunków i plik CSV. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcje (pierwsza cyfra, dwie pierwsze cyfry, MAD, przedziały Goodmana), z których korzystają kolejne. Test chi-kwadrat, poprawkę Holma i losowanie liczy bazowy R; pakiet benford.analysis służy tylko do sprawdzenia MAD i progów zgodności. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1, 3 i 4; każdy z nich zaczyna się od własnego set.seed(637). Ziarno 637 ustalono raz i nie zmieniano go. Ręcznie ustalono: liczebności działów (700–2200 faktur), cztery rodzaje kosztów z rozkładów lognormalnych (mediany 900, 1500, 3000 i 150 zł; odchylenia logarytmu 1.3, 1.5, 1.6 i 1.2; udziały 30, 25, 25 i 20%), 120 podrzuconych faktur na pełne setki od 4000 do 4900 zł z wagami rosnącymi od 1 do 10, próg drugiej akceptacji 5000 zł, dietę 45 zł za dobę (1–12 dób, krótsze delegacje częściej), tankowania z rozkładu lognormalnego (mediana 700 zł, odchylenie logarytmu 0.6) ucięte limitem 2000 zł, cztery stawki cennika, 3% domieszki w scenariuszu B symulacji oraz próg z > 3 przy wyborze par do kontroli. Całość liczy się w kilka sekund.
1. Dane, paleta, motyw i pierwsza cyfra: Rysunek 1 i plik CSV
R
# Rysunek 1. Faktury kosztowe fikcyjnej firmy logistycznej: pierwsza cyfra na tle rozkładu Benforda
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw – korzystają z nich kolejne przepisy
kol <- c(niebieski = "#0072B2", blekit = "#56B4E9", cynober = "#D55E00", pomarancz = "#E69F00",
         zielony = "#009E73", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a", hjust = 0), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Narzędzia: pierwsza cyfra, dwie pierwsze cyfry, rozkład Benforda, MAD i przedziały jednoczesne Goodmana
pierwsza <- function(x) floor(x / 10^floor(log10(x)))            # 1–9 (x > 0)
dwie <- function(x) floor(x / 10^(floor(log10(x)) - 1))           # 10–99 (x >= 10)
benford1 <- log10(1 + 1 / (1:9))
benford2 <- log10(1 + 1 / (10:99))
mad <- function(obs, ocz) mean(abs(obs - ocz))                     # średnie odchylenie bezwzględne odsetków
goodman <- function(n_k, alfa = 0.05) {                            # jednoczesne 95% przedziały dla k odsetków
  n <- sum(n_k); A <- qchisq(1 - alfa / length(n_k), 1)
  srodek <- A + 2 * n_k; pol <- sqrt(A * (A + 4 * n_k * (n - n_k) / n))
  data.frame(dolna = (srodek - pol) / (2 * (n + A)), gorna = (srodek + pol) / (2 * (n + A)))
}

# Dane fikcyjne (parametry ustalone ręcznie): 11 200 faktur kosztowych z roku, 8 działów, 4 rodzaje kosztów
# z rozkładów lognormalnych; w dziale „Serwis floty” podrzucono 120 faktur na okrągłe kwoty 4000–4900 zł
# (tuż pod progiem 5000 zł, od którego fakturę zatwierdza druga osoba).
set.seed(637)                                   # ziarno ustalone raz, bez dobierania pod wynik
dzialy <- c("Magazyn Północ" = 1800, "Magazyn Południe" = 1600, "Transport krajowy" = 2200,
            "Transport międzynarodowy" = 1500, "Serwis floty" = 1400, "Administracja" = 900,
            "IT i telematyka" = 700, "Zakupy" = 1100)
rodzaje <- data.frame(rodzaj = c("paliwo i opłaty drogowe", "części i naprawy", "usługi obce", "drobne zakupy"),
                      mediana = c(900, 1500, 3000, 150), sdlog = c(1.3, 1.5, 1.6, 1.2), udzial = c(.30, .25, .25, .20))
faktury <- do.call(rbind, lapply(names(dzialy), function(d) {
  r <- sample(seq_len(nrow(rodzaje)), dzialy[[d]], replace = TRUE, prob = rodzaje$udzial)
  data.frame(dzial = d, rodzaj = rodzaje$rodzaj[r],
             kwota = round(rlnorm(length(r), log(rodzaje$mediana[r]), rodzaje$sdlog[r]), 2), podrzucona = FALSE)
}))
podrzucone <- data.frame(dzial = "Serwis floty", rodzaj = "części i naprawy",
                         kwota = sample(seq(4000, 4900, by = 100), 120, replace = TRUE, prob = 1:10),
                         podrzucona = TRUE)
faktury <- rbind(faktury, podrzucone)
faktury <- faktury[sample(nrow(faktury)), ]                       # przemieszanie wierszy
faktury$id <- sprintf("FK-%05d", seq_len(nrow(faktury)))
write.csv(faktury[, c("id", "dzial", "rodzaj", "kwota", "podrzucona")], "prawo-benforda-faktury.csv",
          row.names = FALSE, fileEncoding = "UTF-8")

# Do analizy cyfr bierzemy kwoty od 10 zł (dla dwóch pierwszych cyfr potrzebne są co najmniej dwie cyfry)
analiza <- faktury[faktury$kwota >= 10, ]
c(faktur = nrow(faktury), do_analizy = nrow(analiza), min = min(faktury$kwota), max = max(faktury$kwota),
  rzedy_wielkosci = round(log10(max(analiza$kwota) / min(analiza$kwota)), 1))

n_d <- tabulate(pierwsza(analiza$kwota), 9)
test1 <- chisq.test(n_d, p = benford1)
gd <- goodman(n_d)
tab1 <- data.frame(cyfra = 1:9, n = n_d, obs = round(n_d / sum(n_d), 4), benford = round(benford1, 4),
                   dolna = round(gd$dolna, 4), gorna = round(gd$gorna, 4))
print(tab1, row.names = FALSE)
c(chi2 = round(unname(test1$statistic), 2), df = unname(test1$parameter), p = signif(test1$p.value, 3),
  MAD = round(mad(n_d / sum(n_d), benford1), 4))

sum(benford1 < gd$dolna | benford1 > gd$gorna)                    # ile cyfr ma Benforda poza przedziałem
p1 <- ggplot(tab1, aes(cyfra)) +
  geom_col(aes(y = obs, fill = "odsetek faktur"), width = 0.7, colour = "grey30", linewidth = 0.3) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.25, colour = kol[["ciemny"]], linewidth = 0.5) +
  geom_line(aes(y = benford, colour = "rozkład Benforda"), linewidth = 0.9) +
  geom_point(aes(y = benford, colour = "rozkład Benforda"), size = 2.4, shape = 18) +
  scale_fill_manual(values = c("odsetek faktur" = kol[["blekit"]]), name = NULL) +
  scale_colour_manual(values = c("rozkład Benforda" = kol[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = 1:9) +
  scale_y_continuous(labels = function(v) paste0(round(100 * v), "%"), limits = c(0, 0.34)) +
  labs(x = "Pierwsza cyfra kwoty", y = "Odsetek faktur",
       title = sprintf("Pierwsza cyfra: %s faktur, χ²(8) = %.1f, MAD = %.4f",
                       format(sum(n_d), big.mark = " "), test1$statistic, mad(n_d / sum(n_d), benford1)),
       subtitle = "Wąsy – jednoczesne 95% przedziały Goodmana dla 9 odsetków") + motyw
p1   # zapis: ggsave("prawo-benforda-pierwsza-cyfra.svg", p1, width = 10, height = 5.4)
Wynik w R
         faktur      do_analizy             min             max rzedy_wielkosci
       11320.00        11297.00            1.96       729206.78            4.90
 cyfra    n    obs benford  dolna  gorna
     1 3305 0.2926  0.3010 0.2808 0.3046
     2 2001 0.1771  0.1761 0.1674 0.1873
     3 1461 0.1293  0.1249 0.1208 0.1383
     4 1181 0.1045  0.0969 0.0968 0.1128
     5  883 0.0782  0.0792 0.0714 0.0855
     6  700 0.0620  0.0669 0.0560 0.0686
     7  675 0.0598  0.0580 0.0539 0.0662
     8  579 0.0513  0.0512 0.0458 0.0573
     9  512 0.0453  0.0458 0.0402 0.0511
   chi2      df       p     MAD
16.2800  8.0000  0.0385  0.0033
[1] 0
2. Dwie pierwsze cyfry: Rysunek 2
R
# Rysunek 2. Dwie pierwsze cyfry (10–99) wszystkich faktur: gdzie są nadwyżki?
# Korzysta z danych analiza, funkcji dwie(), mad(), goodman(), benford2 oraz kol i motyw z przepisu 1.
library(ggplot2)

n_dd <- tabulate(dwie(analiza$kwota), 99)[10:99]                   # liczebności par 10, 11, …, 99
test2 <- chisq.test(n_dd, p = benford2)
obs2 <- n_dd / sum(n_dd)
c(chi2 = round(unname(test2$statistic), 1), df = unname(test2$parameter), p = signif(test2$p.value, 3),
  MAD = round(mad(obs2, benford2), 5))

# Statystyka z dla każdej pary (z poprawką na ciągłość) i jednoczesne przedziały Goodmana dla 90 odsetków
z <- (abs(obs2 - benford2) - 1 / (2 * sum(n_dd))) / sqrt(benford2 * (1 - benford2) / sum(n_dd))
gd2 <- goodman(n_dd)
pary <- data.frame(para = 10:99, n = n_dd, obs = obs2, benford = benford2, z = z,
                   nadwyzka = obs2 > benford2 & benford2 < gd2$dolna)
pary_top <- pary[order(-pary$z), ][1:5, ]
print(transform(pary_top, obs = round(100 * obs, 2), benford = round(100 * benford, 2), z = round(z, 2)),
      row.names = FALSE)

# Kontrola: te same wartości MAD liczy pakiet benford.analysis (progi zgodności według Nigriniego)
b2 <- benford.analysis::benford(analiza$kwota, number.of.digits = 2)
c(MAD_pakiet = round(b2$MAD, 5), zgodnosc = b2$MAD.conformity)

pary$typ <- ifelse(pary$nadwyzka, "nadwyżka poza przedziałem", "pozostałe pary")
p2 <- ggplot(pary, aes(para)) +
  geom_col(aes(y = obs, fill = typ), width = 0.8) +
  geom_line(aes(y = benford, colour = "rozkład Benforda"), linewidth = 0.8) +
  geom_text(data = pary[pary$nadwyzka, ], aes(y = obs, label = para), vjust = -0.5, size = 3.6,
            colour = kol[["ciemny"]]) +
  scale_fill_manual(values = c("nadwyżka poza przedziałem" = kol[["cynober"]], "pozostałe pary" = kol[["blekit"]]),
                    name = NULL) +
  scale_colour_manual(values = c("rozkład Benforda" = kol[["ciemny"]]), name = NULL) +
  scale_x_continuous(breaks = seq(10, 90, 10)) +
  scale_y_continuous(labels = function(v) paste0(round(100 * v, 1), "%"), expand = expansion(mult = c(0, 0.08))) +
  labs(x = "Dwie pierwsze cyfry kwoty", y = "Odsetek faktur",
       title = sprintf("Dwie pierwsze cyfry: χ²(89) = %.1f, MAD = %.5f", test2$statistic, mad(obs2, benford2)),
       subtitle = "Na czerwono pary, w których rozkład Benforda leży pod jednoczesnym 95% przedziałem") + motyw
p2   # zapis: ggsave("prawo-benforda-dwie-cyfry.svg", p2, width = 10, height = 5.4)
Wynik w R
     chi2        df         p       MAD
123.80000  89.00000   0.00867   0.00084
 para   n  obs benford    z nadwyzka
   46 154 1.36    0.93 4.69     TRUE
   11 373 3.30    3.78 2.63    FALSE
   73  87 0.77    0.59 2.42    FALSE
   84  74 0.66    0.51 2.03    FALSE
   47 124 1.10    0.91 2.00    FALSE
        MAD_pakiet           zgodnosc
         "0.00084" "Close conformity"
3. Symulacja: χ² i MAD a liczba kwot – Rysunek 3
R
# Rysunek 3. Symulacja: jak liczebność zmienia wynik testu χ² i wartość MAD (pierwsza cyfra)
# Korzysta z benford1, mad() oraz kol i motyw z przepisu 1.
library(ggplot2)
library(patchwork)

# Dwa scenariusze (ustalone ręcznie): A – cyfry dokładnie według Benforda;
# B – drobne odchylenie bez znaczenia w audycie: 97% według Benforda, 3% kwot z równymi szansami cyfr 1–9.
scen <- list("A. dokładnie Benford" = benford1, "B. drobne odchylenie (3% domieszki)" = 0.97 * benford1 + 0.03 / 9)
sapply(scen, function(p) round(mad(p, benford1), 4))             # „prawdziwe” MAD w populacji

set.seed(637)                                   # to samo ziarno co w przepisie 1
liczebnosci <- c(100, 300, 1000, 3000, 10000, 30000, 100000)
powt <- 1000
sym <- do.call(rbind, lapply(names(scen), function(s) do.call(rbind, lapply(liczebnosci, function(n) {
  X <- rmultinom(powt, n, scen[[s]])                              # 1000 zbiorów po n kwot (liczebności cyfr)
  E <- n * benford1
  p_chi <- pchisq(colSums((X - E)^2 / E), df = 8, lower.tail = FALSE)
  m <- colMeans(abs(X / n - benford1))
  data.frame(scenariusz = s, n = n, odrzucenia = mean(p_chi < .05), mad_med = median(m),
             mad_10 = quantile(m, .10), mad_90 = quantile(m, .90), mad_powyzej_015 = mean(m > 0.015))
}))))
sym$blad_mc <- sqrt(sym$odrzucenia * (1 - sym$odrzucenia) / powt)
print(transform(sym, n = format(n, scientific = FALSE), odrzucenia = round(100 * odrzucenia, 1), blad_mc = round(100 * blad_mc, 1),
                mad_med = round(mad_med, 4), mad_10 = round(mad_10, 4), mad_90 = round(mad_90, 4),
                mad_powyzej_015 = round(100 * mad_powyzej_015, 1)), row.names = FALSE)

etyk_n <- c("100", "300", "1 tys.", "3 tys.", "10 tys.", "30 tys.", "100 tys.")
pA <- ggplot(sym, aes(n, odrzucenia, colour = scenariusz, shape = scenariusz)) +
  geom_hline(yintercept = 0.05, linetype = "dashed", colour = kol[["ciemny"]]) +
  geom_errorbar(aes(ymin = odrzucenia - 1.96 * blad_mc, ymax = odrzucenia + 1.96 * blad_mc), width = 0.08, show.legend = FALSE) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  annotate("text", x = 300, y = 0.1, label = "α = 5%", hjust = 0, size = 3.6, colour = kol[["ciemny"]]) +
  scale_x_log10(breaks = liczebnosci, labels = etyk_n) +
  scale_y_continuous(labels = function(v) paste0(round(100 * v), "%"), limits = c(0, 1)) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(x = "Liczba kwot (skala log)", y = "Zbiory z p < .05", title = "A. Test χ²: odsetek odrzuceń") + motyw
progi <- data.frame(y = c(0.006, 0.012, 0.015), etykieta = c("0.006", "0.012", "0.015"))
pB <- ggplot(sym, aes(n, mad_med, colour = scenariusz, fill = scenariusz, shape = scenariusz)) +
  geom_hline(data = progi, aes(yintercept = y), linetype = "dotted", colour = kol[["ciemny"]]) +
  geom_text(data = progi, aes(x = 100000, y = y, label = etykieta), inherit.aes = FALSE, vjust = -0.4, hjust = 1,
            size = 3.3, colour = kol[["ciemny"]]) +
  geom_ribbon(aes(ymin = mad_10, ymax = mad_90), alpha = 0.15, colour = NA, show.legend = FALSE) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  scale_x_log10(breaks = liczebnosci, labels = etyk_n) +
  scale_y_continuous(limits = c(0, 0.04)) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["cynober"]]), name = NULL) +
  scale_fill_manual(values = c(kol[["niebieski"]], kol[["cynober"]]), guide = "none") +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(x = "Liczba kwot (skala log)", y = "MAD (mediana, pasmo 10–90%)", title = "B. MAD i progi Nigriniego") + motyw
p3 <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p3   # zapis: ggsave("prawo-benforda-liczebnosc.svg", p3, width = 10, height = 5.4)
Wynik w R
               A. dokładnie Benford B. drobne odchylenie (3% domieszki)
                             0.0000                              0.0018
                          scenariusz      n odrzucenia mad_med mad_10 mad_90
                A. dokładnie Benford    100        7.0  0.0231 0.0158 0.0331
                A. dokładnie Benford    300        4.6  0.0133 0.0089 0.0183
                A. dokładnie Benford   1000        4.8  0.0073 0.0049 0.0102
                A. dokładnie Benford   3000        6.1  0.0041 0.0028 0.0059
                A. dokładnie Benford  10000        5.7  0.0023 0.0015 0.0032
                A. dokładnie Benford  30000        4.6  0.0014 0.0009 0.0019
                A. dokładnie Benford 100000        5.2  0.0007 0.0005 0.0010
 B. drobne odchylenie (3% domieszki)    100        5.7  0.0231 0.0158 0.0324
 B. drobne odchylenie (3% domieszki)    300        5.2  0.0131 0.0091 0.0183
 B. drobne odchylenie (3% domieszki)   1000        7.4  0.0076 0.0051 0.0106
 B. drobne odchylenie (3% domieszki)   3000       10.8  0.0045 0.0030 0.0064
 B. drobne odchylenie (3% domieszki)  10000       22.3  0.0029 0.0019 0.0039
 B. drobne odchylenie (3% domieszki)  30000       64.8  0.0022 0.0016 0.0029
 B. drobne odchylenie (3% domieszki) 100000       99.9  0.0019 0.0015 0.0023
 mad_powyzej_015 blad_mc
            92.4     0.8
            30.3     0.7
             0.2     0.7
             0.0     0.8
             0.0     0.7
             0.0     0.7
             0.0     0.7
            91.9     0.7
            31.7     0.7
             0.1     0.8
             0.0     1.0
             0.0     1.3
             0.0     1.5
             0.0     0.1
4. Kwoty niebenfordowskie z natury: Rysunek 4
R
# Rysunek 4. Kwoty, które z natury nie spełniają prawa Benforda (dane fikcyjne tej samej firmy)
# Korzysta z faktury, pierwsza(), mad(), benford1 oraz kol i motyw z przepisu 1.
library(ggplot2)

# Parametry ustalone ręcznie: dieta 45 zł za dobę delegacji (1–12 dób), tankowania kartą z limitem 2000 zł,
# opłaty według cennika (kurs miejski 350 zł, przegląd 640 zł, najem placu 1250 zł, abonament systemu 2900 zł).
set.seed(637)                                   # to samo ziarno co w przepisie 1
doby <- sample(1:12, 2500, replace = TRUE, prob = 12:1)
diety <- 45 * doby
tank <- rlnorm(6000, log(700), 0.6); tank <- round(tank[tank <= 2000][1:3000], 2)   # limit karty: 2000 zł
cennik <- sample(c(350, 640, 1250, 2900), 1500, replace = TRUE, prob = c(.45, .20, .20, .15))
zbiory <- list("A. Faktury kosztowe (przepis 1)" = faktury$kwota[faktury$kwota >= 10],
               "B. Diety w delegacjach: 45 zł × doby" = diety,
               "C. Tankowania z limitem 2000 zł" = tank,
               "D. Opłaty według cennika (4 stawki)" = cennik)
wyn <- do.call(rbind, lapply(names(zbiory), function(z) {
  x <- zbiory[[z]]; n_d <- tabulate(pierwsza(x), 9)
  data.frame(zbior = z, n = length(x), min = min(x), max = max(x),
             chi2 = round(sum((n_d - length(x) * benford1)^2 / (length(x) * benford1)), 1),
             MAD = round(mad(n_d / length(x), benford1), 4), proc_1 = round(100 * n_d[1] / length(x), 1))
}))
print(wyn, row.names = FALSE)

wyk4 <- do.call(rbind, lapply(names(zbiory), function(z) {
  x <- zbiory[[z]]
  data.frame(zbior = z, cyfra = 1:9, obs = tabulate(pierwsza(x), 9) / length(x), benford = benford1)
}))
wyk4$zbior <- factor(wyk4$zbior, levels = names(zbiory),
                     labels = sprintf("%s\nMAD = %.3f", names(zbiory), wyn$MAD))
p4 <- ggplot(wyk4, aes(cyfra)) +
  geom_col(aes(y = obs, fill = "odsetek kwot"), width = 0.7, colour = "grey30", linewidth = 0.3) +
  geom_line(aes(y = benford, colour = "rozkład Benforda"), linewidth = 0.9) +
  geom_point(aes(y = benford, colour = "rozkład Benforda"), size = 2.2, shape = 18) +
  facet_wrap(~ zbior, ncol = 2) +
  scale_fill_manual(values = c("odsetek kwot" = kol[["blekit"]]), name = NULL) +
  scale_colour_manual(values = c("rozkład Benforda" = kol[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = 1:9) +
  scale_y_continuous(labels = function(v) paste0(round(100 * v), "%")) +
  labs(x = "Pierwsza cyfra kwoty", y = "Odsetek kwot") + motyw
p4   # zapis: ggsave("prawo-benforda-kwoty-z-natury.svg", p4, width = 10, height = 6.6)
Wynik w R
                                zbior     n    min       max   chi2    MAD
      A. Faktury kosztowe (przepis 1) 11297  10.18 729206.78   16.3 0.0033
 B. Diety w delegacjach: 45 zł × doby  2500  45.00    540.00 1885.2 0.0682
      C. Tankowania z limitem 2000 zł  3000  89.01   1998.01  410.5 0.0342
  D. Opłaty według cennika (4 stawki)  1500 350.00   2900.00 2125.7 0.0987
 proc_1
   29.3
   23.6
   26.8
   21.5
5. Działy i próbka do kontroli: Rysunek 5
R
# Rysunek 5. Działy firmy: który odstaje i które faktury trafiają do próbki kontrolnej
# Korzysta z analiza, dwie(), mad(), benford2 oraz kol i motyw z przepisu 1.
library(ggplot2)
library(patchwork)

# Dla każdego działu: dwie pierwsze cyfry (χ², MAD) i odsetek kwot okrągłych (pełne setki złotych)
dz <- do.call(rbind, lapply(split(analiza, analiza$dzial), function(d) {
  n_dd <- tabulate(dwie(d$kwota), 99)[10:99]
  E <- nrow(d) * benford2
  data.frame(dzial = d$dzial[1], n = nrow(d), chi2 = sum((n_dd - E)^2 / E),
             p = pchisq(sum((n_dd - E)^2 / E), df = 89, lower.tail = FALSE),
             MAD2 = mad(n_dd / nrow(d), benford2), okragle = mean(d$kwota %% 100 == 0))
}))
dz$p_holm <- p.adjust(dz$p, "holm")                               # 8 działów = 8 testów
dz <- dz[order(-dz$MAD2), ]
print(transform(dz, chi2 = round(chi2, 1), p = signif(p, 3), p_holm = signif(p_holm, 3), MAD2 = round(MAD2, 5),
                okragle = round(100 * okragle, 1)), row.names = FALSE)

# Sito: w dziale, który odstaje, wybierz pary cyfr z nadwyżką (z > 3) i kwoty okrągłe → próbka do kontroli
sf <- analiza[analiza$dzial == "Serwis floty", ]
n_sf <- tabulate(dwie(sf$kwota), 99)[10:99]
z_sf <- (n_sf / nrow(sf) - benford2) / sqrt(benford2 * (1 - benford2) / nrow(sf))
pary_podejrzane <- (10:99)[z_sf > 3]
pary_podejrzane
round(data.frame(para = 44:51, odsetek = 100 * n_sf[35:42] / nrow(sf), benford = 100 * benford2[35:42],
                 z = z_sf[35:42]), 2)
probka <- sf[dwie(sf$kwota) %in% pary_podejrzane & sf$kwota %% 100 == 0, ]
c(faktur_w_dziale = nrow(sf), w_probce = nrow(probka), podrzucone_w_probce = sum(probka$podrzucona),
  podrzucone_w_dziale = sum(sf$podrzucona),
  oczekiwane_w_losowej_probce = round(nrow(probka) * mean(sf$podrzucona), 1))
table(probka$kwota)                                                # kwoty faktur w próbce

wykA <- dz; wykA$dzial <- factor(wykA$dzial, levels = rev(dz$dzial))
wykA$sygnal <- ifelse(wykA$p_holm < .05, "p (Holm) < .05", "p (Holm) ≥ .05")
pA <- ggplot(wykA, aes(MAD2, dzial, colour = sygnal, shape = sygnal)) +
  geom_vline(xintercept = c(0.0012, 0.0018, 0.0022), linetype = "dotted", colour = kol[["ciemny"]]) +
  geom_segment(aes(x = 0, xend = MAD2, yend = dzial), linewidth = 0.6) +
  geom_point(size = 3.2) +
  geom_text(aes(label = sprintf("n = %d", n)), hjust = -0.25, size = 3.3, colour = kol[["ciemny"]]) +
  scale_colour_manual(values = c("p (Holm) < .05" = kol[["cynober"]], "p (Holm) ≥ .05" = kol[["niebieski"]]),
                      name = NULL) +
  scale_shape_manual(values = c("p (Holm) < .05" = 17, "p (Holm) ≥ .05" = 16), name = NULL) +
  scale_x_continuous(limits = c(0, max(dz$MAD2) * 1.35)) +
  labs(x = "MAD dwóch pierwszych cyfr", y = NULL, title = "A. MAD według działów",
       subtitle = "Linie: progi 0.0012, 0.0018, 0.0022") + motyw
wykB <- data.frame(para = 10:99, obs = n_sf / nrow(sf), benford = benford2,
                   typ = ifelse((10:99) %in% pary_podejrzane, "para z nadwyżką (z > 3)", "pozostałe pary"))
pB <- ggplot(wykB, aes(para)) +
  geom_col(aes(y = obs, fill = typ), width = 0.8) +
  geom_line(aes(y = benford), colour = kol[["ciemny"]], linewidth = 0.7) +
  scale_fill_manual(values = c("para z nadwyżką (z > 3)" = kol[["cynober"]], "pozostałe pary" = kol[["blekit"]]),
                    name = NULL) +
  scale_x_continuous(breaks = seq(10, 90, 20)) +
  scale_y_continuous(labels = function(v) paste0(round(100 * v, 1), "%")) +
  labs(x = "Dwie pierwsze cyfry", y = "Odsetek faktur", title = "B. Serwis floty: dwie cyfry",
       subtitle = "Linia – rozkład Benforda") + motyw
p5 <- pA + pB + plot_layout(widths = c(1.1, 1)) & theme(legend.position = "bottom")
p5   # zapis: ggsave("prawo-benforda-dzialy.svg", p5, width = 10, height = 5.6)
Wynik w R
                    dzial    n  chi2        p    MAD2 okragle   p_holm
          IT i telematyka  700  98.4 2.33e-01 0.00332     0.0 1.00e+00
            Administracja  898  80.4 7.31e-01 0.00249     0.0 1.00e+00
             Serwis floty 1519 163.6 2.47e-06 0.00243     7.9 1.98e-05
                   Zakupy 1099  96.7 2.71e-01 0.00238     0.0 1.00e+00
         Magazyn Południe 1596 109.3 7.08e-02 0.00229     0.0 4.96e-01
           Magazyn Północ 1793  94.4 3.29e-01 0.00194     0.0 1.00e+00
 Transport międzynarodowy 1497  77.9 7.93e-01 0.00192     0.0 1.00e+00
        Transport krajowy 2195  92.3 3.85e-01 0.00163     0.0 1.00e+00
[1] 46 47 48 49
  para odsetek benford     z
1   44    1.12    0.98  0.57
2   45    1.65    0.95  2.77
3   46    2.11    0.93  4.75
4   47    1.71    0.91  3.26
5   48    1.97    0.90  4.47
6   49    2.11    0.88  5.14
7   50    0.86    0.86 -0.02
8   51    0.79    0.84 -0.23
            faktur_w_dziale                    w_probce
                     1519.0                        73.0
        podrzucone_w_probce         podrzucone_w_dziale
                       73.0                       120.0
oczekiwane_w_losowej_probce
                        5.8

4600 4700 4800 4900
  21   14   15   23
6. Sito audytora jako schemat: Rysunek 6
R
# Rysunek 6. Sito audytora: od wszystkich faktur do próbki do kontroli (grafika z prostokątów i tekstu w ggplot2)
# Korzysta z faktury, analiza, sf, probka oraz kol z przepisów 1 i 5.
library(ggplot2)

etapy <- data.frame(
  y = 6:1,
  szer = c(1.00, 0.90, 0.80, 0.70, 0.60, 0.54),
  kolor = c(kol[["niebieski"]], kol[["niebieski"]], kol[["niebieski"]], kol[["cynober"]], kol[["cynober"]],
            kol[["zielony"]]),
  liczba = c(sprintf("%s faktur", format(nrow(faktury), big.mark = " ")),
             sprintf("%s kwot ≥ 10 zł", format(nrow(analiza), big.mark = " ")),
             "8 działów", sprintf("1 dział: %s faktur", format(nrow(sf), big.mark = " ")),
             sprintf("%d faktur w próbce", nrow(probka)), "kontrola dokumentów"),
  co = c("1. Dane: rejestr faktur z roku; osobno diety,\n    tankowania z limitem i opłaty z cennika",
         "2. Test całości: pierwsza i dwie pierwsze cyfry,\n    wykres + MAD; χ² tylko pomocniczo",
         "3. Podział: działy, dostawcy, rodzaje kosztów;\n    poprawka Holma na liczbę grup",
         "4. Sygnał: pary cyfr z nadwyżką (z > 3)\n    i kwoty okrągłe tuż pod progiem 5000 zł",
         "5. Próbka: faktury z sygnałem + losowa\n    próbka kontrolna z pozostałych",
         "6. Dowód dopiero tu: zamówienie, odbiór,\n    dostawca, zatwierdzenie"))
p6 <- ggplot(etapy) +
  geom_rect(aes(xmin = 1.5 - szer / 2, xmax = 1.5 + szer / 2, ymin = y - 0.34, ymax = y + 0.34, fill = kolor)) +
  geom_text(aes(1.5, y, label = liczba), colour = "white", fontface = "bold", size = 4.1) +
  geom_text(aes(2.08, y, label = co), hjust = 0, size = 3.7, lineheight = 0.95, colour = "grey15") +
  annotate("segment", x = 1.5, xend = 1.5, y = 5.64:1.64, yend = 5.36:1.36, colour = "grey45",
           arrow = arrow(length = unit(0.16, "cm"))) +
  annotate("text", x = 0.98, y = 0.35, hjust = 0, size = 3.5, colour = "grey30",
           label = "Niebieskie – sito statystyczne, czerwone – sygnał, zielone – sprawdzenie dokumentów") +
  scale_fill_identity() +
  scale_x_continuous(limits = c(0.95, 3.75), expand = c(0, 0)) + scale_y_continuous(limits = c(0.2, 6.5)) +
  labs(title = "Sito audytora: prawo Benforda wskazuje, gdzie szukać, a nie co się stało",
       subtitle = "Liczby z fikcyjnej firmy logistycznej z tego wpisu") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p6   # zapis: ggsave("prawo-benforda-sito-audytora.svg", p6, width = 10, height = 6.4)
7. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("błękit – cynober (słupki / linia Benforda; pary z nadwyżką; rysunki 1, 2, 4, 5)" = c("#56B4E9", "#D55E00"),
             "niebieski – cynober (scenariusze A/B; działy; rysunki 3 i 5)" = c("#0072B2", "#D55E00"),
             "niebieski – zielony (etapy sita; rysunek 6)" = c("#0072B2", "#009E73"),
             "cynober – zielony (etapy sita; rysunek 6)" = c("#D55E00", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                       protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                                widzenie_typowe
błękit – cynober (słupki / linia Benforda; pary z nadwyżką; rysunki 1, 2, 4, 5)           113.6
niebieski – cynober (scenariusze A/B; działy; rysunki 3 i 5)                              114.6
niebieski – zielony (etapy sita; rysunek 6)                                                70.1
cynober – zielony (etapy sita; rysunek 6)                                                 102.4
czerwony – zielony (do unikania)                                                          121.7
                                                                                deuteranopia
błękit – cynober (słupki / linia Benforda; pary z nadwyżką; rysunki 1, 2, 4, 5)        101.1
niebieski – cynober (scenariusze A/B; działy; rysunki 3 i 5)                           108.3
niebieski – zielony (etapy sita; rysunek 6)                                             55.4
cynober – zielony (etapy sita; rysunek 6)                                               53.5
czerwony – zielony (do unikania)                                                        21.1
                                                                                protanopia
błękit – cynober (słupki / linia Benforda; pary z nadwyżką; rysunki 1, 2, 4, 5)       89.0
niebieski – cynober (scenariusze A/B; działy; rysunki 3 i 5)                          91.9
niebieski – zielony (etapy sita; rysunek 6)                                           58.0
cynober – zielony (etapy sita; rysunek 6)                                             37.3
czerwony – zielony (do unikania)                                                      31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, test chi-kwadrat zgodności, poprawka Holma, przedziały Goodmana i MAD liczone wprost – pakiety base i stats). MAD i progi zgodności sprawdzono pakietem benford.analysis. Rysunki wykonano w ggplot2 i patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- benford.analysis (wersja 0.1.5): Cinelli, C. (2018). benford.analysis: Benford analysis for data validation and forensic analytics [R package]. https://doi.org/10.32614/CRAN.package.benford.analysis
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki w skrócie
- Benford jako dowód. Nadwyżka kwot pod progiem może wynikać np. z dzielenia zamówień przez dostawcę.
- Brak odchylenia jako dowód czystości. Fałszerz wymyślający „nieregularne” kwoty z szerokiego zakresu przejdzie test. W przykładzie 47 ze 120 podrzuconych faktur ominęło próbkę – to błąd II rodzaju, a moc testu zależy od liczby podrzuconych kwot.
- Za mało kwot. Przy kilkuset fakturach MAD jest zawyżone (rysunek 3).
- Mieszanie rodzajów kwot. Diety, limity i cenniki analizuj osobno.
- Dziesiątki podziałów bez poprawki. Działy × dostawcy × miesiące to setki testów.
- Tylko pierwsza cyfra. Sygnał z jednego progu rozmywa się w dziewięciu kategoriach.
- Korekty i duplikaty. Faktury korygujące (ujemne) analizuj osobno, powtórzone kwoty – testem duplikatów, a bardzo duże kwoty – jak obserwacje odstające.
Pomoc przy analizie danych finansowych do pracy dyplomowej: analizy statystyczne dla studentów.
Najczęstsze pytania
Czy odchylenie od prawa Benforda na fakturach oznacza nadużycie?
Nie. Odchylenie wskazuje faktury i grupy, które warto obejrzeć, ale przyczyną może być np. stała stawka, limit karty, cennik albo dzielenie zamówień przez dostawcę. W przykładzie najwyższe MAD miał mały dział bez żadnych nieprawidłowości. O nadużyciu rozstrzyga dopiero kontrola dokumentów: zamówienia, odbioru i zatwierdzenia.
Jakie są progi MAD dla prawa Benforda?
W pakiecie R benford.analysis zapisano progi za monografią Nigriniego (2012): dla pierwszej cyfry 0.006, 0.012 i 0.015 (zgodność ścisła, akceptowalna, ledwie akceptowalna; powyżej – brak zgodności), dla dwóch pierwszych cyfr 0.0012, 0.0018 i 0.0022. Progi zakładają tysiące kwot: w symulacji przy 100 kwotach idealnie zgodnych z Benfordem MAD przekroczyło 0.015 w 92.4% zbiorów.
Dlaczego test chi-kwadrat dla prawa Benforda prawie zawsze wychodzi istotny?
Bo statystyka χ² rośnie z liczbą kwot. W symulacji drobne odchylenie bez znaczenia w audycie (3% domieszki) dało 7.4% odrzuceń przy tysiącu kwot i 99.9% przy 100 tysiącach. Przy dużych zbiorach oceniaj wielkość odchylenia (MAD, wykres z jednoczesnymi przedziałami), a χ² traktuj pomocniczo.
Jakie kwoty nie nadają się do analizy prawem Benforda?
Kwoty wyznaczone regułą lub ograniczone: diety według stawki dobowej, opłaty z cennika, transakcje z limitem, numery dokumentów, kwoty o wąskim zakresie (np. wszystkie czterocyfrowe). W przykładzie diety miały MAD = 0.068, a opłaty z cennika 0.099, choć nie było w nich nic podejrzanego. Analizuj je osobno, sprawdzając zgodność ze stawką i limitem.
Ile faktur potrzeba do analizy Benforda?
Im więcej, tym lepiej, ale z dwoma zastrzeżeniami. Przy kilkuset kwotach MAD jest zawyżone nawet w danych idealnych, więc progi Nigriniego wprowadzają w błąd. Przy dziesiątkach tysięcy kwot test χ² odrzuca zgodność z powodu drobiazgów. W praktyce analizuj tysiące kwot, a grupy (działy, dostawców) porównuj przy podobnej liczebności.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z finansów i rachunkowości
Ankieta wśród przedsiębiorców, skośne wskaźniki i winsoryzacja, regresja z błędami odpornymi, dane panelowe i model upadłości – z gotowymi zdaniami APA i kodem R.
Czytaj →PoradnikWykrywanie nadużyć przy rzadkich zdarzeniach
Ubezpieczyciel, 60 000 szkód i 200 kontroli miesięcznie: krzywe ROC i PR, macierz kosztów, wybór według zysku, SMOTE a kalibracja i etykiety z kontroli – pięć rysunków z kodem R.
Czytaj →PoradnikLike-for-like i paradoks Simpsona
Sklepy przy stacjach paliw: sprzedaż porównywalna, indeksy Laspeyresa i Paaschego, efekt mieszanki i średnia ze średnich – pięć rysunków z kodem R.
Czytaj →Analizujesz dane księgowe do pracy dyplomowej?
Pomożemy przygotować dane, wybrać kwoty do analizy cyfr, policzyć MAD i test χ² w grupach oraz opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barney, B. J., & Schulzke, K. S. (2016). Moderating “cry wolf” events with excess MAD in Benford’s law research and practice. Journal of Forensic Accounting Research, 1(1), A66–A90. https://doi.org/10.2308/jfar-51622 ● Otwarty dostęp: pełny tekst
- Diekmann, A. (2007). Not the first digit! Using Benford’s law to detect fraudulent scientific data. Journal of Applied Statistics, 34(3), 321–329. https://doi.org/10.1080/02664760601004940 ● Otwarty dostęp: pełny tekst
- Hill, T. P. (1995). A statistical derivation of the significant-digit law. Statistical Science, 10(4), 354–363. https://doi.org/10.1214/ss/1177009869 ● Otwarty dostęp
- Kossovsky, A. E. (2021). On the mistaken use of the chi-square test in Benford’s law. Stats, 4(2), 419–453. https://doi.org/10.3390/stats4020027 ● Otwarty dostęp
- Lesperance, M., Reed, W. J., Stephens, M. A., Tsao, C., & Wilton, B. (2016). Assessing conformance with Benford’s law: Goodness-of-fit tests and simultaneous confidence intervals. PLOS ONE, 11(3), Article e0151235. https://doi.org/10.1371/journal.pone.0151235 ● Otwarty dostęp
- Nigrini, M. J. (2012). Benford’s law: Applications for forensic accounting, auditing, and fraud detection. Wiley. https://doi.org/10.1002/9781119203094
- Nigrini, M. J. (2017). Audit sampling using Benford’s law: A review of the literature with some new perspectives. Journal of Emerging Technologies in Accounting, 14(2), 29–46. https://doi.org/10.2308/jeta-51783
- Nigrini, M. J., & Miller, S. J. (2009). Data diagnostics using second-order tests of Benford’s law. AUDITING: A Journal of Practice & Theory, 28(2), 305–324. https://doi.org/10.2308/aud.2009.28.2.305
Cytowania BibTeX
@article{barney2016moderating, author={Barney, Bradley J. and Schulzke, Kurt S.}, title={{Moderating “cry wolf” events with excess MAD in Benford’s law research and practice}}, journal={Journal of Forensic Accounting Research}, year={2016}, volume={1}, number={1}, pages={A66--A90}, publisher={American Accounting Association}, doi={10.2308/jfar-51622}}@article{diekmann2007not, author={Diekmann, Andreas}, title={{Not the first digit! Using Benford’s law to detect fraudulent scientific data}}, journal={Journal of Applied Statistics}, year={2007}, volume={34}, number={3}, pages={321--329}, doi={10.1080/02664760601004940}}@article{hill1995statistical, author={Hill, Theodore P.}, title={{A statistical derivation of the significant-digit law}}, journal={Statistical Science}, year={1995}, volume={10}, number={4}, pages={354--363}, doi={10.1214/ss/1177009869}}@article{kossovsky2021mistaken, author={Kossovsky, Alex Ely}, title={{On the mistaken use of the chi-square test in Benford’s law}}, journal={Stats}, year={2021}, volume={4}, number={2}, pages={419--453}, publisher={MDPI}, doi={10.3390/stats4020027}}@article{lesperance2016assessing, author={Lesperance, M. and Reed, W. J. and Stephens, M. A. and Tsao, C. and Wilton, B.}, title={{Assessing conformance with Benford’s law: Goodness-of-fit tests and simultaneous confidence intervals}}, journal={PLOS ONE}, year={2016}, volume={11}, number={3}, eid={e0151235}, publisher={Public Library of Science}, doi={10.1371/journal.pone.0151235}}@book{nigrini2012benford, author={Nigrini, Mark J.}, title={{Benford’s law: Applications for forensic accounting, auditing, and fraud detection}}, year={2012}, publisher={Wiley}, doi={10.1002/9781119203094}}@article{nigrini2017audit, author={Nigrini, Mark J.}, title={{Audit sampling using Benford’s law: A review of the literature with some new perspectives}}, journal={Journal of Emerging Technologies in Accounting}, year={2017}, volume={14}, number={2}, pages={29--46}, publisher={American Accounting Association}, doi={10.2308/jeta-51783}}@article{nigrini2009data, author={Nigrini, Mark J. and Miller, Steven J.}, title={{Data diagnostics using second-order tests of Benford’s law}}, journal={AUDITING: A Journal of Practice \& Theory}, year={2009}, volume={28}, number={2}, pages={305--324}, publisher={American Accounting Association}, doi={10.2308/aud.2009.28.2.305}}