Przykład: sklepy przy 100 stacjach paliw
Fikcyjna sieć ma 100 stacji paliw, a przy każdej sklep: kawa z ekspresu, hot dogi i kanapki, papierosy, napoje, przekąski i drobne artykuły samochodowe. Zarząd dostaje raport: przychód sklepów w 2025 r. wzrósł o 7.7%. Kierownik sprzedaży detalicznej odpowiada: „w porównywalnych sklepach spadł o 1.2%”. Analityk dodaje, że przeciętna stacja urosła o 2.4%, a średnia cena sprzedanej sztuki spadła, choć każda kategoria podrożała. Wszystkie cztery liczby są poprawne. Pokazujemy, skąd się biorą i której użyć do jakiej decyzji. Ogólny mechanizm opisują hasło paradoks Simpsona i wpis paradoks Simpsona – wizualizacja; tu dokładamy narzędzia handlu: like-for-like, indeksy cen i rozkład zmiany przychodu.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy: 82 stacje działające przez cały 2024 i 2025 r. (54 lokalne i 28 przy trasach), 10 otwartych w 2024 r., 5 otwartych w 2025 r. i 3 zamknięte na 4–6 miesięcy remontu w 2025 r. Nowa stacja przez pierwszy rok „rozkręca się” od 60% do 100% sprzedaży. Stacja przy trasie sprzedaje 3 razy więcej sztuk i jest o 8% droższa. W 2025 r. ceny rosną o 2–6% (najbardziej papierosy), liczba sprzedanych papierosów spada o 20%, kawy rośnie o 22%, a ruch na stacjach lokalnych rośnie o 3%, przy trasach maleje o 6%. Zmiany cen i ilości poprawiliśmy po pierwszym uruchomieniu, żeby paradoks był wyraźny; ziarna 654 nie zmienialiśmy. Dane pobierzesz jako like-for-like-sklepy-stacji.csv (wiersz = stacja × rok × kategoria: sztuki, cena, przychód).
Rysunek 1: wszystkie sklepy czy porównywalne?
Porównanie like-for-like (LFL, „sprzedaż w porównywalnych sklepach”) liczy zmianę procentową tylko dla sklepów, które działały w obu porównywanych okresach. U nas: stacje czynne przez cały 2024 i 2025 r. Stacje nowe i remontowane wypadają z porównania, bo ich zmiana mówi o kalendarzu otwarć, a nie o klientach.
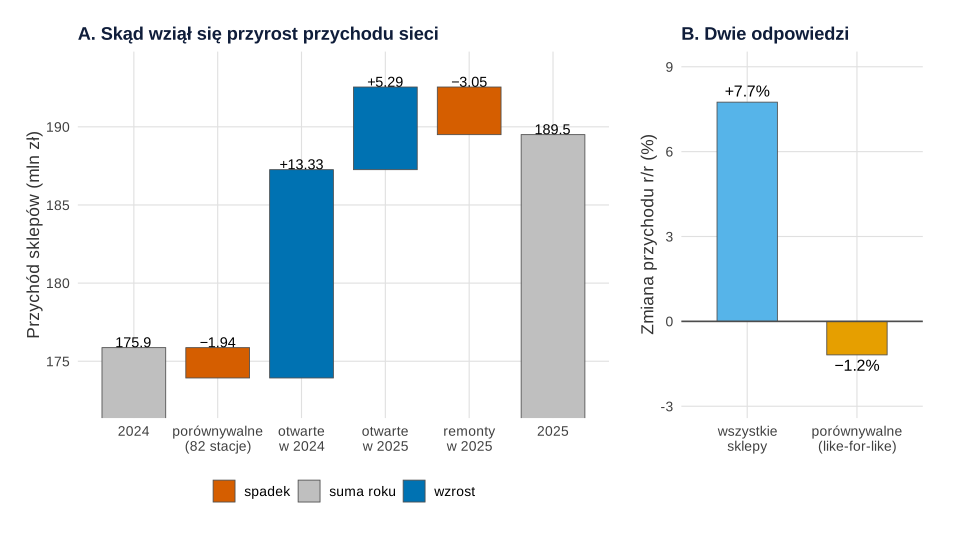
set.seed(654)).Co widać. Przychód sklepów wzrósł ze 175.9 do 189.5 mln zł, czyli o 7.75%. Most na panelu A rozkłada te 13.6 mln zł: stacje otwarte w 2024 r. dały +13.33 mln zł (w 2024 r. działały tylko część roku, w 2025 r. – cały), stacje otwarte w 2025 r. +5.29 mln zł, remonty −3.05 mln zł. Na 82 porównywalnych stacjach przychód spadł ze 163.78 do 161.84 mln zł: LFL = −1.18%.
Jak może zmylić. Wzrost „wszystkich sklepów” mierzy głównie ekspansję. Gdyby sieć zamykała słabe sklepy, LFL też by kłamał, tyle że w drugą stronę: zostają same udane sklepy, jak w błędzie przeżywalności. Dlatego przy LFL zawsze podaj regułę włączenia i liczbę sklepów. Wykres, który rozkłada sumę na składniki, to wykres wodospadowy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: paradoks Simpsona w średniej cenie sztuki
Popularny wskaźnik w handlu to średnia cena sprzedanej sztuki: przychód podzielony przez liczbę sztuk. Liczymy go na 82 porównywalnych stacjach dla każdej kategorii i dla całego sklepu.
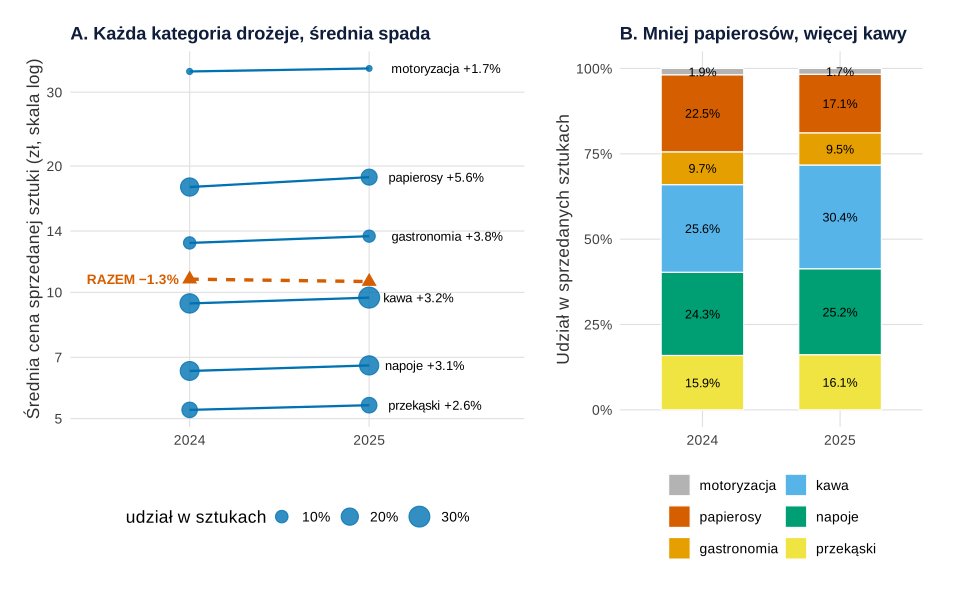
set.seed(654)).Co widać. Panel A: w każdej z sześciu kategorii średnia cena sztuki wzrosła – od 1.7% (motoryzacja) do 5.6% (papierosy, z 17.83 do 18.82 zł). Średnia dla całego sklepu spadła z 10.75 do 10.61 zł, czyli o 1.3%. Panel B tłumaczy dlaczego: udział papierosów w sprzedanych sztukach spadł z 22.5% do 17.1%, a kawy wzrósł z 25.6% do 30.4%. Sztuk sprzedano prawie tyle samo (15.23 i 15.25 mln).
To paradoks Simpsona w czystej postaci. Średnia sklepu jest średnią ważoną średnich kategorii, a wagami są udziały w sztukach. Gdy zmieniają się wagi, średnia może pójść w inną stronę niż każda jej część. Nazwa pochodzi od pracy Simpsona (1951), który na przykładzie tabeli 2 × 2 × 2 przestrzegał przed mechanicznym rozbijaniem i łączeniem tabel. Kievit i in. (2013) pokazują, że odwrócenie kierunku zdarza się częściej, niż się sądzi, zwłaszcza gdy wnioski przenosi się między poziomami.
Jak może zmylić. Żadna z dwóch odpowiedzi nie jest „prawdziwa” sama w sobie. Na pytanie „czy podnieśliśmy ceny?” odpowiadają kategorie (tak). Na pytanie „ile zarabiamy na sztuce?” – średnia sklepu (mniej). Hernán i in. (2011) pokazują, że paradoks znika, gdy analizą kieruje wiedza o mechanizmie, a nie sama tabela. Tu mechanizm znamy: klienci zmienili nawyki (papierosy → kawa), więc zmienił się skład koszyka. To trzecia zmienna, której pominięcie myli wniosek o cenach – podobnie jak zmienna zakłócająca w badaniu przyczynowym.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: indeksy cen i ilości, rozkład na cenę, ilość i mieszankę
Żeby oddzielić „drożej” od „więcej” i od „inaczej”, ekonomiści używają indeksów. Komórką jest stacja × kategoria; p to cena, q liczba sztuk, indeks 0 – rok 2024, 1 – rok 2025:
Indeks Laspeyresa (PL) wycenia stary koszyk po nowych cenach, indeks Paaschego (PP) – nowy koszyk. Indeks Fishera to ich średnia geometryczna. Indeksy ilości liczy się tak samo, zamieniając role p i q. Iloczyn indeksu cen i odpowiadającego mu indeksu ilości daje dokładnie zmianę przychodu. Ta sama idea stałych wag stoi za standaryzacją względem wieku.
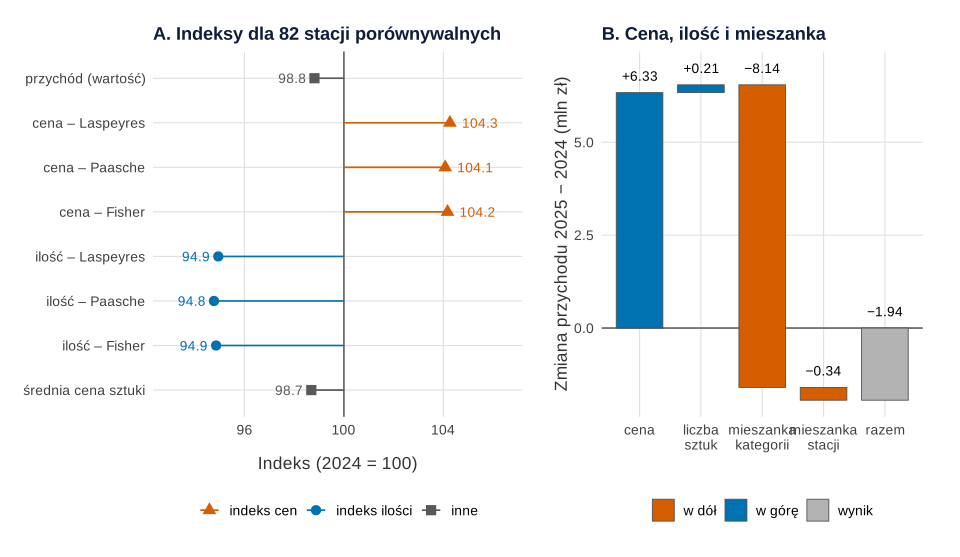
set.seed(654)).Co widać – panel A. Przychód porównywalnych sklepów: 98.8 (−1.2%). Ceny: Laspeyres 104.3, Paasche 104.1, Fisher 104.2. Ilość w stałych cenach (Fisher): 94.9. Średnia cena sztuki: 98.7. Ceny wzrosły o ok. 4%, a „ilość” w stałych cenach spadła o ok. 5%, choć sztuk sprzedano o 0.1% więcej. Różnica między liczbą sztuk a ilością w stałych cenach to właśnie mieszanka: sztuka papierosów „waży” w indeksie prawie dwa razy więcej niż sztuka kawy. Laspeyres jest wyższy od Paaschego, bo klienci odchodzą od tego, co najbardziej podrożało. Diewert (1998) omawia, skąd biorą się rozbieżności między indeksem Laspeyresa ze stałym koszykiem a teoretycznym indeksem kosztów utrzymania, a Hausman (2003) zalicza do nich obciążenie substytucyjne – najczęściej omawiane, choć jedno z kilku.
Co widać – panel B. Zmiana przychodu LFL (−1.94 mln zł) rozkłada się na cztery składniki: cena +6.33 mln zł (+3.87% przychodu 2024), liczba sztuk +0.21 mln zł (+0.13%), mieszanka kategorii −8.14 mln zł (−4.97%) i mieszanka stacji w kategorii −0.34 mln zł (−0.21%; więcej sztuk sprzedają tańsze stacje lokalne).
Jak może zmylić. Rozkład zależy od kolejności. Efekt ceny liczony na ilościach z 2025 r. to 6.33 mln zł, na ilościach z 2024 r. – 6.98 mln zł, a średnia obu – 6.66 mln zł. Taki składnik „resztowy” znają demografowie: Das Gupta (1978) opisuje, że w klasycznym rozkładzie różnicy dwóch współczynników przy kilku czynnikach pojawia się trudny do interpretacji składnik interakcji albo wynik zależny od kolejności liczenia efektów, i proponuje metodę bez tych ograniczeń. W pracy podaj, który wariant liczyłeś. Ten sam problem ma dekompozycja luki płacowej – zob. luka płacowa – dekompozycja Oaxaca–Blindera.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: średnia ze stacji a wzrost sieci
Trzecia rozbieżność: „przeciętna stacja urosła o 2.4%”, a sieć LFL straciła 1.2%. Analityk wziął zwykłą średnią zmian stacji. Wzrost sieci to suma przychodów 2025 przez sumę 2024, czyli średnia zmian ważona przychodem 2024.
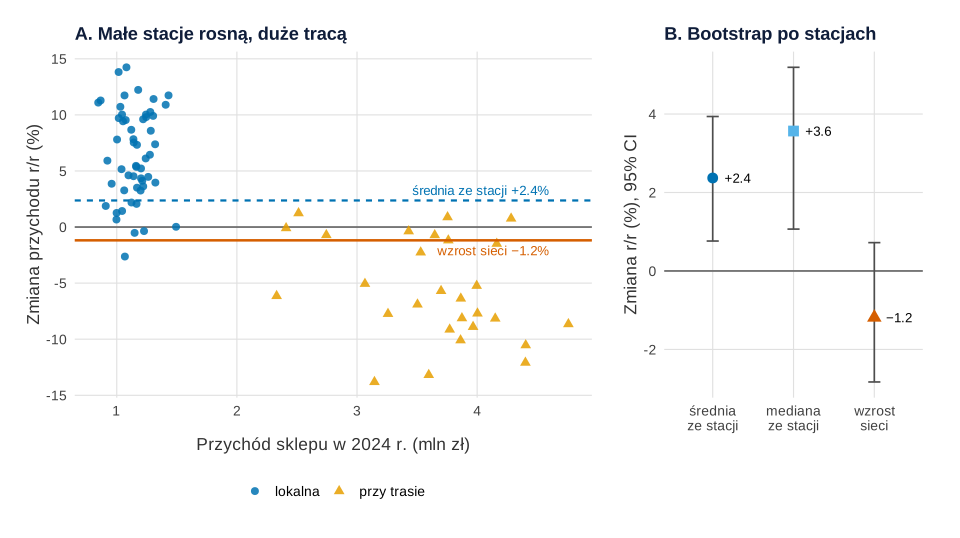
set.seed(654)).Co widać – panel A. 54 stacje lokalne rosną średnio o 6.52%, 28 stacji przy trasach traci średnio 5.63%. Stacje przy trasach to tylko jedna trzecia stacji, ale 62.2% przychodu. Średnia ze stacji (każda waży tyle samo): +2.37%; mediana: +3.57%; wzrost sieci (średnia ważona): −1.18%.
Co widać – panel B. Czy to nie przypadek? Bootstrap po stacjach (2000 prób po 82 stacje ze zwracaniem) daje 95% przedział ufności [0.76, 3.94] dla średniej ze stacji i [−2.83, 0.72] dla wzrostu sieci. W 88.0% prób bootstrapowych średnia ze stacji była dodatnia, a wzrost sieci ujemny. Rozbieżność nie wynika z jednej nietypowej stacji. Sam spadek sieci jest jednak niepewny: przedział obejmuje zero.
Jak może zmylić. Obie średnie odpowiadają na inne pytania. „Czy typowa stacja ma się lepiej?” – średnia lub mediana ze stacji. „Czy sieć zarabia więcej?” – średnia ważona. Wniosek o pojedynczej stacji z liczby dla całej sieci to błąd ekologiczny. Mamy wszystkie stacje, więc przedział bootstrapowy opisuje zmienność między stacjami, a nie błąd losowania.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: efekt mieszanki w jednym obrazku
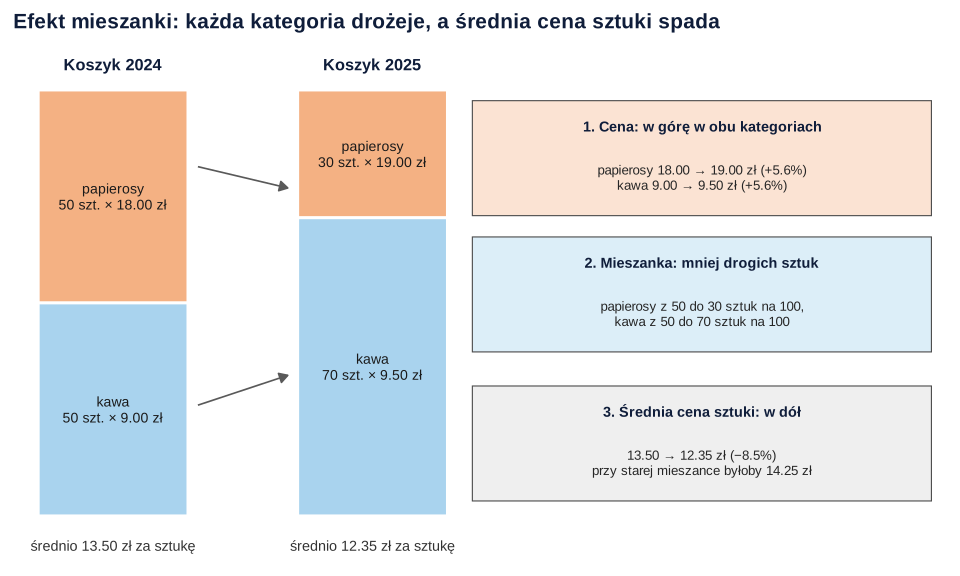
Co widać. Ten sam mechanizm na okrągłych liczbach. W koszyku 100 sztuk papierosy drożeją z 18.00 do 19.00 zł, kawa z 9.00 do 9.50 zł – obie o 5.6%. Ale papierosów jest 30 zamiast 50, a kawy 70 zamiast 50. Średnia cena sztuki spada z 13.50 do 12.35 zł (−8.5%). Przy starej mieszance 50/50 wyniosłaby 14.25 zł. Różnica 14.25 − 13.50 to efekt ceny, a 14.25 − 12.35 – efekt mieszanki.
Podpis do pracy:
Co z tym zrobić w firmie
- Raportuj dwie liczby obok siebie: zmianę całej sieci i LFL, z regułą włączenia (np. „sklepy czynne przez pełne 24 miesiące”) i liczbą sklepów. Ocena wyników sprzedaży – LFL; ocena strategii rozwoju – cała sieć.
- Rozbij LFL na cenę, ilość i mieszankę. W przykładzie „−1.2%” wcale nie znaczy „klienci kupują mniej”: sztuk sprzedano tyle samo, a przychód ciągnie w dół odejście od papierosów. Decyzja dotyczy więc asortymentu (marża na kawie, oferta śniadaniowa), a nie promocji ściągających ruch.
- Nie oceniaj kierowników po średniej cenie sztuki. Spada nawet przy podwyżkach; lepsze są indeksy liczone w kategoriach.
- Analizuj stacje przy trasach osobno. To 62.2% przychodu i średnio −5.63%. Porównanie oddziałów z wieloma nakładami pokazuje wpis efektywność oddziałów – DEA.
- Nowe stacje oceniaj w osobnej grupie (rozruch przez pierwsze 12 miesięcy), a ich wpływ na sąsiednie sklepy – metodą z wpisu kanibalizacja po otwarciu nowego lokalu.
- Zmiany cen planuj z danymi o reakcji klientów: zob. elastyczność cenowa z danych sprzedażowych i głębokość rabatu a sprzedaż.
Jak opisać w pracy
W Metodzie podaj definicję sklepów porównywalnych, okresy, jednostkę analizy (stacja × kategoria), wzory indeksów, wariant rozkładu (na ilościach którego roku wyceniasz efekt ceny) i sposób liczenia przedziałów. W Wynikach – zmianę całości i LFL, indeksy oraz składniki rozkładu w złotych i procentach. Więcej o pracach na danych firmowych: statystyka w pracy z zarządzania i ekonomii.
Kod R: like-for-like, paradoks Simpsona, indeksy i bootstrap
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają przepisy 2–4. Indeksy i rozkład liczymy ręcznie w bazowym R – to kilka sum iloczynów, a kod sprawdza, że cena × ilość daje dokładnie zmianę przychodu. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 (dane) i 4 (bootstrap); oba zaczynają się od własnego set.seed(654). Ziarno 654 ustalono raz i nie zmieniano go. Ręcznie ustalono: liczbę stacji w grupach (82 porównywalne: 54 lokalne i 28 przy trasach; 10 + 5 nowych; 3 remonty), rozruch nowych stacji (60% → 100% w 12 miesięcy), ceny i miesięczne liczby sztuk w kategoriach, mnożniki stacji przy trasie (× 3 sztuki, + 8% ceny), zmiany cen 2025 (2–6%), zmiany liczby sztuk (od −20% dla papierosów do +22% dla kawy), zmianę ruchu (+3% i −6%) oraz rozrzut stacji (SD 0.15 i 0.03 w skali logarytmu) i komórek (SD 0.05 dla sztuk, 0.01 dla cen). Zmiany cen i liczby sztuk poprawiono po pierwszym uruchomieniu, żeby odwrócenie średniej ceny sztuki było wyraźne. Bootstrap: 2000 prób. Całość liczy się w kilka sekund.
1. Paleta, dane i przychód sieci: Rysunek 1
R
# Rysunek 1. Fikcyjna sieć 100 stacji paliw: sprzedaż w sklepach przy stacjach w latach 2024 i 2025 (dane symulowane)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", blekit = "#56B4E9", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie --------------------------------------------------------------
set.seed(654)
stacje <- data.frame(
  stacja = sprintf("S%03d", 1:100),
  typ    = rep(c("lokalna", "przy trasie", "lokalna", "przy trasie", "lokalna", "przy trasie", "lokalna", "przy trasie"),
               c(54, 28, 6, 4, 3, 2, 2, 1)),
  status = rep(c("porównywalna", "nowa 2024", "nowa 2025", "remont 2025"), c(82, 10, 5, 3)))
# Miesiąc otwarcia nowych stacji i liczba miesięcy zamknięcia z powodu remontu w 2025 r.
stacje$otwarcie <- NA
stacje$otwarcie[stacje$status == "nowa 2024"] <- sample(3:11, 10, replace = TRUE)       # miesiąc 2024
stacje$otwarcie[stacje$status == "nowa 2025"] <- 12 + sample(3:9, 5, replace = TRUE)    # miesiąc 2025 (13 = styczeń)
stacje$remont <- 0
stacje$remont[stacje$status == "remont 2025"] <- sample(4:6, 3, replace = TRUE)
# Efektywna liczba miesięcy sprzedaży: nowa stacja przez pierwsze 12 miesięcy rozkręca się od 60% do 100%
efekt_miesiace <- function(otw, remont, rok) {
  m <- if (rok == 2024) 1:12 else 13:24
  if (is.na(otw)) otw <- -100
  k <- m - otw                                  # 0 = miesiąc otwarcia
  w <- ifelse(k < 0, 0, 0.6 + 0.4 * pmin(k, 12) / 12)
  if (rok == 2025 && remont > 0) w[seq_len(remont) + 2] <- 0     # remont od marca
  sum(w)
}
kat <- data.frame(
  kategoria = c("kawa", "gastronomia", "papierosy", "napoje", "przekąski", "motoryzacja"),
  cena_2024 = c(9.0, 12.5, 17.0, 6.2, 5.0, 32.0),      # zł za sztukę na stacji lokalnej
  szt_mies  = c(2400, 900, 2100, 2300, 1500, 180),      # sztuk miesięcznie na stacji lokalnej
  zm_ceny   = c(0.03, 0.04, 0.06, 0.03, 0.03, 0.02),    # zmiana ceny 2025 / 2024
  zm_ilosci = c(0.22, 0.03, -0.20, 0.06, 0.04, -0.06)) # zmiana liczby sztuk (wspólna dla stacji)
mnoznik_typu <- c(lokalna = 1, "przy trasie" = 3)       # stacja przy trasie sprzedaje 3 razy więcej sztuk
narzut_typu  <- c(lokalna = 1, "przy trasie" = 1.08)    # i jest o 8% droższa
ruch_2025    <- c(lokalna = 0.03, "przy trasie" = -0.06) # zmiana ruchu klientów 2025 / 2024

efekt_stacji <- rnorm(100, 0, 0.15)                     # stała różnica wielkości stacji (log)
zmiana_stacji <- rnorm(100, 0, 0.03)                    # indywidualna zmiana 2025 (log)
wiersze <- list()
for (i in 1:100) for (j in 1:6) for (rok in c(2024, 2025)) {
  s <- stacje[i, ]; k <- kat[j, ]
  mies <- efekt_miesiace(s$otwarcie, s$remont, rok)
  if (mies == 0) next
  trend <- if (rok == 2025) (1 + k$zm_ilosci) * (1 + ruch_2025[[s$typ]]) * exp(zmiana_stacji[i]) else 1
  szt <- round(k$szt_mies * mnoznik_typu[[s$typ]] * mies * trend * exp(efekt_stacji[i] + rnorm(1, 0, 0.05)))
  cena <- k$cena_2024 * narzut_typu[[s$typ]] * (if (rok == 2025) 1 + k$zm_ceny else 1) * exp(rnorm(1, 0, 0.01))
  wiersze[[length(wiersze) + 1]] <- data.frame(stacja = s$stacja, typ = s$typ, status = s$status, rok = rok,
                                               kategoria = k$kategoria, miesiace = round(mies, 2),
                                               sztuki = szt, cena = round(cena, 2), przychod = round(szt * round(cena, 2)))
}
sprzedaz <- do.call(rbind, wiersze)
write.csv(sprzedaz, "like-for-like-sklepy-stacji.csv", row.names = FALSE)

# Przychód sklepów (mln zł) według statusu stacji i roku
tab <- aggregate(przychod ~ status + rok, data = sprzedaz, FUN = sum)
tab <- reshape(tab, idvar = "status", timevar = "rok", direction = "wide")
tab[is.na(tab)] <- 0
tab$mln_2024 <- round(tab$przychod.2024 / 1e6, 2); tab$mln_2025 <- round(tab$przychod.2025 / 1e6, 2)
tab[, c("status", "mln_2024", "mln_2025")]
R0 <- sum(tab$przychod.2024); R1 <- sum(tab$przychod.2025)
lfl <- tab[tab$status == "porównywalna", ]
data.frame(wzrost_wszystkie_proc = round(100 * (R1 / R0 - 1), 2),
           wzrost_porownywalne_proc = round(100 * (lfl$przychod.2025 / lfl$przychod.2024 - 1), 2),
           stacje_w_LFL = sum(stacje$status == "porównywalna"))

# Rysunek 1: most przychodu 2024 → 2025 (A) i dwa wskaźniki wzrostu (B)
zm <- setNames(tab$przychod.2025 - tab$przychod.2024, tab$status) / 1e6
most <- data.frame(etap = c("2024", "porównywalne\n(82 stacje)", "otwarte\nw 2024", "otwarte\nw 2025",
                            "remonty\nw 2025", "2025"),
                   zmiana = c(R0 / 1e6, zm[["porównywalna"]], zm[["nowa 2024"]], zm[["nowa 2025"]], zm[["remont 2025"]], R1 / 1e6))
most$koniec <- c(most$zmiana[1], most$zmiana[1] + cumsum(most$zmiana[2:5]), most$zmiana[6])
most$start <- c(0, head(most$koniec, -1)[1:4], 0)
most$x <- seq_len(nrow(most))
most$rodzaj <- ifelse(most$x %in% c(1, 6), "suma roku", ifelse(most$zmiana > 0, "wzrost", "spadek"))
most$etykieta <- ifelse(most$x %in% c(1, 6), sprintf("%.1f", most$zmiana), sub("-", "\u2212", sprintf("%+.2f", most$zmiana)))
pA <- ggplot(most) +
  geom_rect(aes(xmin = x - 0.38, xmax = x + 0.38, ymin = start, ymax = koniec, fill = rodzaj), colour = "grey30", linewidth = 0.3) +
  geom_text(aes(x, pmax(start, koniec) + 0.35, label = etykieta), size = 3.8) +
  scale_fill_manual(values = c("suma roku" = "grey75", wzrost = kol[["niebieski"]], spadek = kol[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = most$x, labels = most$etap) +
  coord_cartesian(ylim = c(min(most$start[2:5], most$koniec[2:5]) - 1.5, max(most$koniec) + 1.2)) +
  labs(x = NULL, y = "Przychód sklepów (mln zł)", title = "A. Skąd wziął się przyrost przychodu sieci") + motyw
wsk <- data.frame(miara = factor(c("wszystkie\nsklepy", "porównywalne\n(like-for-like)"),
                                 levels = c("wszystkie\nsklepy", "porównywalne\n(like-for-like)")),
                  wzrost = c(100 * (R1 / R0 - 1), 100 * (lfl$przychod.2025 / lfl$przychod.2024 - 1)))
pB <- ggplot(wsk, aes(miara, wzrost, fill = miara)) +
  geom_col(width = 0.55, colour = "grey30", linewidth = 0.3) +
  geom_hline(yintercept = 0, colour = "grey30") +
  geom_text(aes(label = sub("-", "\u2212", sprintf("%+.1f%%", wzrost)), vjust = ifelse(wzrost > 0, -0.5, 1.4)), size = 4.2) +
  scale_fill_manual(values = c(kol[["blekit"]], kol[["pomarancz"]]), guide = "none") +
  scale_y_continuous(expand = expansion(mult = c(0.25, 0.2))) +
  labs(x = NULL, y = "Zmiana przychodu r/r (%)", title = "B. Dwie odpowiedzi") + motyw
p1 <- pA + pB + plot_layout(widths = c(2.2, 1)) & theme(legend.position = "bottom")
p1   # zapis: ggsave("like-for-like-most-sprzedazy.svg", p1, width = 10, height = 5.6)
Wynik w R
        status mln_2024 mln_2025
1    nowa 2024     5.20    18.53
2 porównywalna   163.78   161.84
3  remont 2025     6.89     3.85
5    nowa 2025     0.00     5.29
  wzrost_wszystkie_proc wzrost_porownywalne_proc stacje_w_LFL
1                  7.75                    -1.18           82
2. Średnia cena sztuki w kategoriach i razem: Rysunek 2
R
# Rysunek 2. Paradoks Simpsona: średnia cena sprzedanej sztuki rośnie w każdej kategorii, a w całym sklepie spada
# Korzysta z obiektów przepisu 1: sprzedaz, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)

lfl <- sprzedaz[sprzedaz$status == "porównywalna", ]           # tylko 82 stacje porównywalne
kat_rok <- aggregate(cbind(przychod, sztuki) ~ kategoria + rok, data = lfl, FUN = sum)
kat_rok$cena_szt <- kat_rok$przychod / kat_rok$sztuki
kat_rok$udzial_szt <- ave(kat_rok$sztuki, kat_rok$rok, FUN = function(x) x / sum(x))
razem <- aggregate(cbind(przychod, sztuki) ~ rok, data = lfl, FUN = sum)
razem$cena_szt <- razem$przychod / razem$sztuki

# Tabela: średnia cena sztuki (zł), jej zmiana (%) i udział kategorii w sztukach (%)
szer <- reshape(kat_rok[, c("kategoria", "rok", "cena_szt", "udzial_szt")], idvar = "kategoria",
                timevar = "rok", direction = "wide")
szer <- rbind(szer, data.frame(kategoria = "RAZEM", cena_szt.2024 = razem$cena_szt[1], udzial_szt.2024 = 1,
                               cena_szt.2025 = razem$cena_szt[2], udzial_szt.2025 = 1))
data.frame(kategoria = szer$kategoria,
           cena_2024 = round(szer$cena_szt.2024, 2), cena_2025 = round(szer$cena_szt.2025, 2),
           zmiana_proc = round(100 * (szer$cena_szt.2025 / szer$cena_szt.2024 - 1), 1),
           udzial_szt_2024 = round(100 * szer$udzial_szt.2024, 1), udzial_szt_2025 = round(100 * szer$udzial_szt.2025, 1))
# Liczba sztuk razem (mln) w obu latach
round(razem$sztuki / 1e6, 2)

# Rysunek 2A: zmiana ceny sztuki w kategoriach (linie ciągłe) i w całym sklepie (linia przerywana)
kat_rok$etykieta <- ifelse(kat_rok$rok == 2025, sprintf("%s %+.1f%%", kat_rok$kategoria,
  100 * (kat_rok$cena_szt / ave(kat_rok$cena_szt, kat_rok$kategoria, FUN = function(x) x[1]) - 1)), NA)
razem$etykieta <- c(sub("-", "\u2212", sprintf("RAZEM %+.1f%%", 100 * (razem$cena_szt[2] / razem$cena_szt[1] - 1))), NA)
pA <- ggplot(kat_rok, aes(rok, cena_szt, group = kategoria)) +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.8) +
  geom_point(aes(size = udzial_szt), colour = kol[["niebieski"]], alpha = 0.8) +
  geom_line(data = razem, aes(rok, cena_szt, group = 1), colour = kol[["cynober"]], linewidth = 1.2, linetype = "22") +
  geom_point(data = razem, aes(rok, cena_szt, group = 1), colour = kol[["cynober"]], shape = 17, size = 3.5) +
  geom_text(aes(label = etykieta), hjust = -0.2, size = 3.4, na.rm = TRUE) +
  geom_text(data = razem, aes(rok, cena_szt, group = 1, label = etykieta), hjust = 1.12, size = 3.6,
            colour = kol[["cynober"]], fontface = "bold", na.rm = TRUE) +
  scale_x_continuous(breaks = c(2024, 2025), limits = c(2023.45, 2025.75)) +
  scale_y_log10(breaks = c(5, 7, 10, 14, 20, 30)) +
  scale_size_area(max_size = 7, labels = function(x) paste0(round(100 * x), "%"), name = "udział w sztukach") +
  labs(x = NULL, y = "Średnia cena sprzedanej sztuki (zł, skala log)",
       title = "A. Każda kategoria drożeje, średnia spada") + motyw
# Rysunek 2B: udział kategorii w liczbie sprzedanych sztuk
kat_rok$kategoria <- factor(kat_rok$kategoria,
  levels = c("motoryzacja", "papierosy", "gastronomia", "kawa", "napoje", "przekąski"))
pB <- ggplot(kat_rok, aes(factor(rok), udzial_szt, fill = kategoria)) +
  geom_col(width = 0.6, colour = "white", linewidth = 0.4) +
  geom_text(aes(label = sprintf("%.1f%%", 100 * udzial_szt)), position = position_stack(vjust = 0.5), size = 3.3) +
  scale_fill_manual(values = c(motoryzacja = "grey70", papierosy = kol[["cynober"]], gastronomia = kol[["pomarancz"]],
                               kawa = kol[["blekit"]], napoje = kol[["zielony"]], przekąski = "#F0E442"), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(round(100 * x), "%")) +
  labs(x = NULL, y = "Udział w sprzedanych sztukach", title = "B. Mniej papierosów, więcej kawy") +
  motyw + guides(fill = guide_legend(ncol = 2))
p2 <- pA + pB + plot_layout(widths = c(1.5, 1))
p2   # zapis: ggsave("like-for-like-paradoks-simpsona-ceny.svg", p2, width = 10, height = 6)
Wynik w R
    kategoria cena_2024 cena_2025 zmiana_proc udzial_szt_2024 udzial_szt_2025
1 gastronomia     13.12     13.61         3.8             9.7             9.5
2        kawa      9.41      9.72         3.2            25.6            30.4
3 motoryzacja     33.61     34.17         1.7             1.9             1.7
4      napoje      6.50      6.70         3.1            24.3            25.2
5   papierosy     17.83     18.82         5.6            22.5            17.1
6   przekąski      5.25      5.38         2.6            15.9            16.1
7       RAZEM     10.75     10.61        -1.3           100.0           100.0
[1] 15.23 15.25
3. Indeksy Laspeyresa, Paaschego i Fishera i rozkład zmiany przychodu: Rysunek 3
R
# Rysunek 3. Indeksy Laspeyresa, Paaschego i Fishera oraz rozkład zmiany przychodu na cenę, ilość i mieszankę
# Korzysta z obiektów przepisu 1: sprzedaz, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)

lfl <- sprzedaz[sprzedaz$status == "porównywalna", ]
# Jedna komórka = stacja × kategoria; p – cena, q – sztuki; _0 = rok 2024, _1 = rok 2025
k0 <- lfl[lfl$rok == 2024, c("stacja", "kategoria", "cena", "sztuki")]
k1 <- lfl[lfl$rok == 2025, c("stacja", "kategoria", "cena", "sztuki")]
k <- merge(k0, k1, by = c("stacja", "kategoria"), suffixes = c("0", "1"))
p_0 <- k$cena0; q_0 <- k$sztuki0; p_1 <- k$cena1; q_1 <- k$sztuki1
R0 <- sum(p_0 * q_0); R1 <- sum(p_1 * q_1)
P_L <- sum(p_1 * q_0) / R0                  # Laspeyres: ceny 2025 na koszyku 2024
P_P <- R1 / sum(p_0 * q_1)                  # Paasche: ceny 2025 na koszyku 2025
Q_L <- sum(p_0 * q_1) / R0                  # ilości 2025 w cenach 2024
Q_P <- R1 / sum(p_1 * q_0)                  # ilości 2025 w cenach 2025
UV  <- (R1 / sum(q_1)) / (R0 / sum(q_0))    # indeks średniej ceny sztuki (wartości jednostkowej)
ind <- data.frame(indeks = c("przychód (wartość)", "cena – Laspeyres", "cena – Paasche", "cena – Fisher",
                             "ilość – Laspeyres", "ilość – Paasche", "ilość – Fisher", "średnia cena sztuki"),
                  wartosc = 100 * c(R1 / R0, P_L, P_P, sqrt(P_L * P_P), Q_L, Q_P, sqrt(Q_L * Q_P), UV))
# Kontrola: przychód = cena × ilość (Paasche × Laspeyres, Laspeyres × Paasche, Fisher × Fisher)
round(c(V = R1 / R0, PP_QL = P_P * Q_L, PL_QP = P_L * Q_P, PF_QF = sqrt(P_L * P_P * Q_L * Q_P)), 6)
transform(ind, wartosc = round(wartosc, 2))

# Rozkład zmiany przychodu (mln zł): cena + wolumen + mieszanka kategorii + mieszanka stacji
kat0 <- aggregate(cbind(przychod = cena0 * sztuki0, sztuki = sztuki0) ~ kategoria, data = k, FUN = sum)
kat1 <- aggregate(cbind(sztuki = sztuki1) ~ kategoria, data = k, FUN = sum)
kat0$cena_sr0 <- kat0$przychod / kat0$sztuki                       # średnia cena sztuki kategorii w 2024
kat <- merge(kat0, kat1, by = "kategoria", suffixes = c("0", "1"))
Q0 <- sum(q_0); Q1 <- sum(q_1)
s0 <- kat$sztuki0 / Q0; s1 <- kat$sztuki1 / Q1                     # udziały kategorii w sztukach
rozklad <- data.frame(
  skladnik = c("cena", "wolumen (liczba sztuk)", "mieszanka kategorii", "mieszanka stacji w kategorii"),
  mln_zl = c(sum((p_1 - p_0) * q_1),                                       # ceny zmienione na ilościach 2025
             (Q1 - Q0) * R0 / Q0,                                       # więcej / mniej sztuk po średniej cenie 2024
             Q1 * (sum(s1 * kat$cena_sr0) - sum(s0 * kat$cena_sr0)),    # przesunięcie między kategoriami
             sum(p_0 * q_1) - Q1 * sum(s1 * kat$cena_sr0)) / 1e6)  # przesunięcie między stacjami
rozklad$proc_przychodu_2024 <- 100 * rozklad$mln_zl * 1e6 / R0
transform(rozklad, mln_zl = round(mln_zl, 2), proc_przychodu_2024 = round(proc_przychodu_2024, 2))
c(suma_skladnikow = round(sum(rozklad$mln_zl), 2), zmiana_przychodu = round((R1 - R0) / 1e6, 2))
# Kolejność ma znaczenie: efekt ceny liczony na ilościach 2024 (Laspeyres) zamiast 2025 (Paasche)
c(cena_na_ilosciach_2025 = round(sum((p_1 - p_0) * q_1) / 1e6, 2),
  cena_na_ilosciach_2024 = round(sum((p_1 - p_0) * q_0) / 1e6, 2),
  srednia_obu = round(sum((p_1 - p_0) * (q_0 + q_1) / 2) / 1e6, 2))

# Rysunek 3A: indeksy (2024 = 100)
ind$rodzaj <- ifelse(grepl("^cena", ind$indeks), "indeks cen", ifelse(grepl("^ilość", ind$indeks), "indeks ilości", "inne"))
ind$indeks <- factor(ind$indeks, levels = rev(ind$indeks))
pA <- ggplot(ind, aes(wartosc, indeks, colour = rodzaj, shape = rodzaj)) +
  geom_vline(xintercept = 100, colour = "grey40") +
  geom_segment(aes(x = 100, xend = wartosc, yend = indeks), linewidth = 0.6) +
  geom_point(size = 3.2) +
  geom_text(aes(label = sprintf("%.1f", wartosc), hjust = ifelse(wartosc > 100, -0.35, 1.35)), size = 3.6, show.legend = FALSE) +
  scale_colour_manual(values = c("indeks cen" = kol[["cynober"]], "indeks ilości" = kol[["niebieski"]], inne = "grey35"), name = NULL) +
  scale_shape_manual(values = c("indeks cen" = 17, "indeks ilości" = 16, inne = 15), name = NULL) +
  scale_x_continuous(limits = c(93, 106.5)) +
  labs(x = "Indeks (2024 = 100)", y = NULL, title = "A. Indeksy dla 82 stacji porównywalnych") + motyw
# Rysunek 3B: most zmiany przychodu
wod <- data.frame(etap = c("cena", "liczba\nsztuk", "mieszanka\nkategorii", "mieszanka\nstacji"), zmiana = rozklad$mln_zl)
wod$koniec <- cumsum(wod$zmiana); wod$start <- c(0, head(wod$koniec, -1)); wod$x <- 1:4
wod <- rbind(wod, data.frame(etap = "razem", zmiana = sum(wod$zmiana), koniec = sum(wod$zmiana), start = 0, x = 5))
wod$kier <- ifelse(wod$x == 5, "wynik", ifelse(wod$zmiana > 0, "w górę", "w dół"))
pB <- ggplot(wod) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_rect(aes(xmin = x - 0.38, xmax = x + 0.38, ymin = start, ymax = koniec, fill = kier), colour = "grey30", linewidth = 0.3) +
  geom_text(aes(x, ifelse(zmiana > 0, koniec, start) + 0.45, label = sub("-", "\u2212", sprintf("%+.2f", zmiana))), size = 3.6) +
  scale_fill_manual(values = c("w górę" = kol[["niebieski"]], "w dół" = kol[["cynober"]], wynik = "grey70"), name = NULL) +
  scale_x_continuous(breaks = wod$x, labels = wod$etap) +
  labs(x = NULL, y = "Zmiana przychodu 2025 − 2024 (mln zł)", title = "B. Cena, ilość i mieszanka") + motyw
p3 <- pA + pB + plot_layout(widths = c(1.15, 1))
p3   # zapis: ggsave("like-for-like-indeksy-dekompozycja.svg", p3, width = 10, height = 5.8)
Wynik w R
       V    PP_QL    PL_QP    PF_QF
0.988153 0.988153 0.988153 0.988153
               indeks wartosc
1  przychód (wartość)   98.82
2    cena – Laspeyres  104.26
3      cena – Paasche  104.07
4       cena – Fisher  104.17
5   ilość – Laspeyres   94.95
6     ilość – Paasche   94.78
7      ilość – Fisher   94.86
8 średnia cena sztuki   98.69
                      skladnik mln_zl proc_przychodu_2024
1                         cena   6.33                3.87
2       wolumen (liczba sztuk)   0.21                0.13
3          mieszanka kategorii  -8.14               -4.97
4 mieszanka stacji w kategorii  -0.34               -0.21
 suma_skladnikow zmiana_przychodu
           -1.94            -1.94
cena_na_ilosciach_2025 cena_na_ilosciach_2024            srednia_obu
                  6.33                   6.98                   6.66
4. Średnia ze stacji, mediana i wzrost sieci z bootstrapem: Rysunek 4
R
# Rysunek 4. Średnia ze wzrostów stacji a wzrost sieci (średnia ważona przychodem) z bootstrapem po stacjach
# Korzysta z obiektów przepisu 1: sprzedaz, kol, motyw. Losuje (bootstrap) – własne ziarno.
library(ggplot2)
library(patchwork)

lfl <- sprzedaz[sprzedaz$status == "porównywalna", ]
st <- aggregate(przychod ~ stacja + typ + rok, data = lfl, FUN = sum)
st <- reshape(st, idvar = c("stacja", "typ"), timevar = "rok", direction = "wide")
st$wzrost <- st$przychod.2025 / st$przychod.2024 - 1
miary <- function(d) c(srednia_stacji = mean(d$wzrost),                              # każda stacja waży tyle samo
                       mediana_stacji = median(d$wzrost),
                       wzrost_sieci = sum(d$przychod.2025) / sum(d$przychod.2024) - 1)  # = średnia ważona przychodem 2024
round(100 * miary(st), 2)
# Ta sama średnia ważona wprost: wagi = przychód 2024
round(100 * weighted.mean(st$wzrost, st$przychod.2024), 2)
# Według typu stacji: liczba stacji, udział w przychodzie 2024 (%), średni wzrost (%)
data.frame(typ = c("lokalna", "przy trasie"), stacje = as.vector(table(st$typ)),
           udzial_przychodu = round(100 * tapply(st$przychod.2024, st$typ, sum) / sum(st$przychod.2024), 1),
           sredni_wzrost = round(100 * tapply(st$wzrost, st$typ, mean), 2),
           wzrost_sumy = round(100 * (tapply(st$przychod.2025, st$typ, sum) / tapply(st$przychod.2024, st$typ, sum) - 1), 2))

# Bootstrap po stacjach: 2000 prób po 82 stacje ze zwracaniem, przedział percentylowy 95%
set.seed(654)
B <- 2000
boot_m <- t(replicate(B, miary(st[sample(nrow(st), replace = TRUE), ])))
ci <- data.frame(miara = colnames(boot_m), oszacowanie = 100 * miary(st),
                 dolna = 100 * apply(boot_m, 2, quantile, 0.025), gorna = 100 * apply(boot_m, 2, quantile, 0.975))
transform(ci, oszacowanie = round(oszacowanie, 2), dolna = round(dolna, 2), gorna = round(gorna, 2))
# Odsetek prób bootstrapowych, w których średnia stacji > 0, a wzrost sieci < 0
round(100 * mean(boot_m[, "srednia_stacji"] > 0 & boot_m[, "wzrost_sieci"] < 0), 1)

# Rysunek 4A: wzrost każdej stacji a jej wielkość
pA <- ggplot(st, aes(przychod.2024 / 1e6, 100 * wzrost, colour = typ, shape = typ)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_point(size = 2.4, alpha = 0.85) +
  geom_hline(yintercept = 100 * miary(st)[["srednia_stacji"]], colour = kol[["niebieski"]], linetype = "22", linewidth = 0.8) +
  geom_hline(yintercept = 100 * miary(st)[["wzrost_sieci"]], colour = kol[["cynober"]], linewidth = 0.9) +
  annotate("text", x = 4.6, y = 100 * miary(st)[["srednia_stacji"]] + 0.9, hjust = 1, size = 3.5, colour = kol[["niebieski"]],
           label = sub("-", "\u2212", sprintf("średnia ze stacji %+.1f%%", 100 * miary(st)[["srednia_stacji"]]))) +
  annotate("text", x = 4.6, y = 100 * miary(st)[["wzrost_sieci"]] - 0.9, hjust = 1, size = 3.5, colour = kol[["cynober"]],
           label = sub("-", "\u2212", sprintf("wzrost sieci %+.1f%%", 100 * miary(st)[["wzrost_sieci"]]))) +
  scale_colour_manual(values = c(lokalna = kol[["niebieski"]], "przy trasie" = kol[["pomarancz"]]), name = NULL) +
  scale_shape_manual(values = c(lokalna = 16, "przy trasie" = 17), name = NULL) +
  labs(x = "Przychód sklepu w 2024 r. (mln zł)", y = "Zmiana przychodu r/r (%)",
       title = "A. Małe stacje rosną, duże tracą") + motyw
# Rysunek 4B: oszacowania z 95% przedziałem bootstrapowym
ci$miara <- factor(c("średnia\nze stacji", "mediana\nze stacji", "wzrost\nsieci"),
                   levels = c("średnia\nze stacji", "mediana\nze stacji", "wzrost\nsieci"))
pB <- ggplot(ci, aes(miara, oszacowanie)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.15, colour = "grey30") +
  geom_point(aes(colour = miara, shape = miara), size = 3.4) +
  geom_text(aes(label = sub("-", "\u2212", sprintf("%+.1f", oszacowanie))), hjust = -0.45, size = 3.5) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["blekit"]], kol[["cynober"]]), guide = "none") +
  scale_shape_manual(values = c(16, 15, 17), guide = "none") +
  labs(x = NULL, y = "Zmiana r/r (%), 95% CI", title = "B. Bootstrap po stacjach") + motyw
p4 <- pA + pB + plot_layout(widths = c(2, 1))
p4   # zapis: ggsave("like-for-like-stacje-srednia-wazona.svg", p4, width = 10, height = 5.6)
Wynik w R
srednia_stacji mediana_stacji   wzrost_sieci
          2.37           3.57          -1.18
[1] -1.18
                    typ stacje udzial_przychodu sredni_wzrost wzrost_sumy
lokalna         lokalna     54             37.8          6.52        6.52
przy trasie przy trasie     28             62.2         -5.63       -5.86
                        miara oszacowanie dolna gorna
srednia_stacji srednia_stacji        2.37  0.76  3.94
mediana_stacji mediana_stacji        3.57  1.07  5.19
wzrost_sieci     wzrost_sieci       -1.18 -2.83  0.72
[1] 88
5. Grafika: efekt mieszanki na dwóch koszykach: Rysunek 5
R
# Rysunek 5. Grafika: efekt mieszanki na okrągłych liczbach – dwa koszyki po 100 sztuk
# Samodzielny przepis: niczego nie losuje i nie korzysta z innych przepisów.
library(ggplot2)

koszyk <- data.frame(rok = c("2024", "2024", "2025", "2025"),
                     kategoria = c("papierosy", "kawa", "papierosy", "kawa"),
                     sztuk = c(50, 50, 30, 70), cena = c(18.0, 9.0, 19.0, 9.5))
koszyk$przychod <- koszyk$sztuk * koszyk$cena
srednia <- tapply(koszyk$przychod, koszyk$rok, sum) / 100           # średnia cena sztuki w koszyku
round(srednia, 3); round(100 * (srednia[["2025"]] / srednia[["2024"]] - 1), 2)
# Średnia cena sztuki w 2025 r. przy mieszance z 2024 r. (50/50) – sam efekt ceny
round((50 * 19 + 50 * 9.5) / 100, 2)

# Bloki: wysokość = liczba sztuk; x = 1 (2024) i x = 3 (2025)
koszyk$x <- ifelse(koszyk$rok == "2024", 1, 3.6)
koszyk$ymin <- ifelse(koszyk$kategoria == "papierosy", 100 - koszyk$sztuk, 0)
koszyk$ymax <- ifelse(koszyk$kategoria == "papierosy", 100, koszyk$sztuk)
koszyk$opis <- sprintf("%s\n%d szt. × %.2f zł", koszyk$kategoria, koszyk$sztuk, koszyk$cena)
karty <- data.frame(x = c(6.9, 6.9, 6.9), y = c(84, 52, 17),
                    tytul = c("1. Cena: w górę w obu kategoriach", "2. Mieszanka: mniej drogich sztuk",
                              "3. Średnia cena sztuki: w dół"),
                    opis = c("papierosy 18.00 → 19.00 zł (+5.6%)\nkawa 9.00 → 9.50 zł (+5.6%)",
                             "papierosy z 50 do 30 sztuk na 100,\nkawa z 50 do 70 sztuk na 100",
                             sub("-", "\u2212", sprintf("%.2f → %.2f zł (%.1f%%)\nprzy starej mieszance byłoby %.2f zł",
                                     srednia[["2024"]], srednia[["2025"]],
                                     100 * (srednia[["2025"]] / srednia[["2024"]] - 1), (50 * 19 + 50 * 9.5) / 100))),
                    typ = c("cena", "mieszanka", "wynik"))
p5 <- ggplot() +
  geom_rect(data = koszyk, aes(xmin = x - 0.75, xmax = x + 0.75, ymin = ymin, ymax = ymax, fill = kategoria),
            colour = "white", linewidth = 1) +
  geom_text(data = koszyk, aes(x, (ymin + ymax) / 2, label = opis), size = 3.7, lineheight = 0.95, colour = "grey10") +
  annotate("text", x = c(1, 3.6), y = 106, label = c("Koszyk 2024", "Koszyk 2025"), fontface = "bold", size = 4.3, colour = "#0f1d3a") +
  annotate("text", x = c(1, 3.6), y = -7, size = 3.8, colour = "grey20",
           label = sprintf("średnio %.2f zł za sztukę", srednia)) +
  annotate("segment", x = 1.85, xend = 2.75, y = 82, yend = 77, arrow = arrow(length = unit(0.25, "cm"), type = "closed"),
           colour = "grey35") +
  annotate("segment", x = 1.85, xend = 2.75, y = 26, yend = 33, arrow = arrow(length = unit(0.25, "cm"), type = "closed"),
           colour = "grey35") +
  geom_tile(data = karty, aes(x, y, fill = typ), width = 4.6, height = 27, colour = "grey30", linewidth = 0.4) +
  geom_text(data = karty, aes(x, y + 7.5, label = tytul), fontface = "bold", size = 3.8, colour = "#0f1d3a") +
  geom_text(data = karty, aes(x, y - 4.5, label = opis), size = 3.5, lineheight = 0.95, colour = "grey15") +
  scale_fill_manual(values = c(papierosy = "#F4B183", kawa = "#A9D3EE", cena = "#FBE3D3", mieszanka = "#DCEEF8", wynik = "#EFEFEF"),
                    breaks = c("papierosy", "kawa"), name = NULL) +
  coord_cartesian(xlim = c(0, 9.3), ylim = c(-11, 111), expand = FALSE) +
  labs(title = "Efekt mieszanki: każda kategoria drożeje, a średnia cena sztuki spada") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 8)), legend.position = "none",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p5   # zapis: ggsave("like-for-like-schemat-efekt-mieszanki.svg", p5, width = 10, height = 6)
Wynik w R
 2024  2025
13.50 12.35
[1] -8.52
[1] 14.25
6. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (wzrost / spadek; kategorie / razem)" = c("#0072B2", "#D55E00"),
             "niebieski – pomarańczowy (stacja lokalna / przy trasie)" = c("#0072B2", "#E69F00"),
             "błękit – pomarańczowy (wszystkie sklepy / porównywalne)" = c("#56B4E9", "#E69F00"),
             "błękit – zielony (kawa / napoje)" = c("#56B4E9", "#009E73"),
             "cynober – pomarańczowy (papierosy / gastronomia)" = c("#D55E00", "#E69F00"),
             "jasnopomarańczowy – jasnoniebieski (papierosy / kawa na schemacie)" = c("#F4B183", "#A9D3EE"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                   widzenie_typowe
niebieski – cynober (wzrost / spadek; kategorie / razem)                     114.6
niebieski – pomarańczowy (stacja lokalna / przy trasie)                      120.2
błękit – pomarańczowy (wszystkie sklepy / porównywalne)                      113.1
błękit – zielony (kawa / napoje)                                              59.5
cynober – pomarańczowy (papierosy / gastronomia)                              33.4
jasnopomarańczowy – jasnoniebieski (papierosy / kawa na schemacie)            57.7
czerwony – zielony (do unikania)                                             121.7
                                                                   deuteranopia
niebieski – cynober (wzrost / spadek; kategorie / razem)                  108.3
niebieski – pomarańczowy (stacja lokalna / przy trasie)                   121.5
błękit – pomarańczowy (wszystkie sklepy / porównywalne)                   111.4
błękit – zielony (kawa / napoje)                                           48.8
cynober – pomarańczowy (papierosy / gastronomia)                           18.4
jasnopomarańczowy – jasnoniebieski (papierosy / kawa na schemacie)         54.8
czerwony – zielony (do unikania)                                           21.1
                                                                   protanopia
niebieski – cynober (wzrost / spadek; kategorie / razem)                 91.9
niebieski – pomarańczowy (stacja lokalna / przy trasie)                 109.3
błękit – pomarańczowy (wszystkie sklepy / porównywalne)                 101.5
błękit – zielony (kawa / napoje)                                         51.9
cynober – pomarańczowy (papierosy / gastronomia)                         24.9
jasnopomarańczowy – jasnoniebieski (papierosy / kawa na schemacie)       46.6
czerwony – zielony (do unikania)                                         31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, sumy, indeksy i bootstrap – pakiety base i stats). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- LFL bez reguły włączenia. Bez niej dwie firmy podają nieporównywalne LFL.
- Średnia cena sztuki jako miara cen. Miesza cenę z mieszanką; Moulton (1996) pokazuje na prostych przykładach, jak sam wzór indeksu potrafi obciążyć wynik.
- Średnia ze średnich zamiast sumy. Zwykła średnia zmian stacji traktuje mały sklep jak duży; podawaj obie i nazwij je jasno.
- Jeden wariant rozkładu podany jak fakt. Efekt ceny różni się o 0.65 mln zł zależnie od kolejności; pokaż oba albo średnią.
- Procenty od różnych podstaw. „Ceny +4.2%, ilość −5.1%” nie sumują się dokładnie do −1.2%: zmiany mnożą się (1.042 × 0.949 ≈ 0.988).
Najczęstsze pytania
Co to jest sprzedaż like-for-like (LFL)?
To zmiana sprzedaży liczona tylko dla sklepów, które działały w obu porównywanych okresach, np. przez pełne 24 miesiące. Wyłącza efekt otwarć, zamknięć i remontów. W przykładzie przychód całej sieci wzrósł o 7.75%, a w 82 sklepach porównywalnych spadł o 1.18%. Zawsze podawaj regułę włączenia i liczbę sklepów.
Jak średnia cena sztuki może spaść, skoro każdy produkt zdrożał?
Średnia dla całego sklepu jest średnią ważoną cen kategorii, a wagami są udziały w sprzedanych sztukach. Gdy klienci przesuwają się do tańszych kategorii (w przykładzie z papierosów na kawę), średnia spada mimo podwyżek – to paradoks Simpsona. Ceny mierz indeksem cen, a nie średnią ceną sztuki.
Czym różni się indeks Laspeyresa od indeksu Paaschego?
Laspeyres wycenia koszyk z okresu bazowego po nowych cenach, Paasche – koszyk z okresu bieżącego, a indeks Fishera to średnia geometryczna obu. Gdy klienci odchodzą od produktów, które najbardziej podrożały, Laspeyres zwykle wychodzi wyżej (w przykładzie 104.3 wobec 104.1). Źródła rozbieżności między indeksem o stałym koszyku a indeksem kosztów utrzymania omawia Diewert (1998).
Jak rozłożyć zmianę przychodu na efekt ceny, ilości i mieszanki?
Efekt ceny to suma zmian cen razy ilości, efekt ilości – zmiana liczby sztuk po średniej cenie bazowej, efekt mieszanki – reszta wynikająca z przesunięć między kategoriami. Wynik zależy od tego, na ilościach którego okresu wycenisz efekt ceny (w przykładzie 6.33 albo 6.98 mln zł), więc napisz, który wariant liczyłeś (Das Gupta, 1978).
Dlaczego średnia wzrostów sklepów różni się od wzrostu całej sieci?
Zwykła średnia traktuje każdy sklep jednakowo, a wzrost sieci to średnia ważona przychodem. Jeśli małe sklepy rosną, a duże tracą, znaki mogą się rozjechać: w przykładzie średnia ze stacji wyniosła +2.37%, a wzrost sieci −1.18%. Podaj obie miary i nazwij je jednoznacznie.
Powiązane hasła
Przeczytaj też
Paradoks Simpsona – wizualizacja
Chmury punktów z przeciwnymi znakami, zmiana znaku w regresji w 1000 badaniach, odsetki jako średnia ważona i graf przyczynowy – pięć rysunków z kodem R.
Czytaj →PoradnikEfektywność oddziałów – DEA
Firma kurierska i 25 oddziałów: granica efektywności, modele CCR i BCC w R, efektywność skali, wzorce, cele i wrażliwość – pięć rysunków.
Czytaj →PoradnikGłębokość rabatu a sprzedaż
Sieć sklepów z elektroniką: krzywa odpowiedzi na rabat 10–40%, dołek po promocji, kanibalizacja, zysk zamiast przychodu i pułapka dobrych tygodni – z kodem R.
Czytaj →PoradnikRok do roku bez pułapek kalendarza
Sieć kwiaciarni: dzień tygodnia, Wielkanoc, święta w weekend i dni otwarte w porównaniu r/r – regresja z efektami kalendarza i kod R.
Czytaj →PoradnikIndeks cen: Laspeyres, Paasche i Fisher
30 produktów bezglutenowych i 3 lata cen: trzy wzory ręcznie w R, substytucja, dryf łańcucha, przychód na ceny i ilości oraz mniejsza paczka.
Czytaj →Analizujesz sprzedaż sieci sklepów w pracy dyplomowej?
Pomożemy zdefiniować sklepy porównywalne, policzyć indeksy cen i ilości, rozłożyć zmianę przychodu na cenę, ilość i mieszankę oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Das Gupta, P. (1978). A general method of decomposing a difference between two rates into several components. Demography, 15(1), 99–112. https://doi.org/10.2307/2060493 ● Otwarty dostęp
- Diewert, W. E. (1998). Index number issues in the Consumer Price Index. Journal of Economic Perspectives, 12(1), 47–58. https://doi.org/10.1257/jep.12.1.47 ● Otwarty dostęp
- Hausman, J. (2003). Sources of bias and solutions to bias in the Consumer Price Index. Journal of Economic Perspectives, 17(1), 23–44. https://doi.org/10.1257/089533003321164930 ● Otwarty dostęp
- Hernán, M. A., Clayton, D., & Keiding, N. (2011). The Simpson's paradox unraveled. International Journal of Epidemiology, 40(3), 780–785. https://doi.org/10.1093/ije/dyr041 ● Otwarty dostęp
- Kievit, R. A., Frankenhuis, W. E., Waldorp, L. J., & Borsboom, D. (2013). Simpson's paradox in psychological science: A practical guide. Frontiers in Psychology, 4, Article 513. https://doi.org/10.3389/fpsyg.2013.00513 ● Otwarty dostęp
- Moulton, B. R. (1996). Bias in the Consumer Price Index: What is the evidence? Journal of Economic Perspectives, 10(4), 159–177. https://doi.org/10.1257/jep.10.4.159 ● Otwarty dostęp
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
Cytowania BibTeX
@article{dasgupta1978general, author={Das Gupta, Prithwis}, title={{A general method of decomposing a difference between two rates into several components}}, journal={Demography}, year={1978}, volume={15}, number={1}, pages={99--112}, doi={10.2307/2060493}}@article{diewert1998index, author={Diewert, W. Erwin}, title={{Index number issues in the Consumer Price Index}}, journal={Journal of Economic Perspectives}, year={1998}, volume={12}, number={1}, pages={47--58}, doi={10.1257/jep.12.1.47}}@article{hausman2003sources, author={Hausman, Jerry}, title={{Sources of bias and solutions to bias in the Consumer Price Index}}, journal={Journal of Economic Perspectives}, year={2003}, volume={17}, number={1}, pages={23--44}, doi={10.1257/089533003321164930}}@article{hernan2011simpson, author={Hern{\'a}n, Miguel A. and Clayton, David and Keiding, Niels}, title={{The Simpson's paradox unraveled}}, journal={International Journal of Epidemiology}, year={2011}, volume={40}, number={3}, pages={780--785}, doi={10.1093/ije/dyr041}}@article{kievit2013simpson, author={Kievit, Rogier A. and Frankenhuis, Willem E. and Waldorp, Lourens J. and Borsboom, Denny}, title={{Simpson's paradox in psychological science: A practical guide}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={513}, doi={10.3389/fpsyg.2013.00513}}@article{moulton1996bias, author={Moulton, Brent R.}, title={{Bias in the Consumer Price Index: What is the evidence?}}, journal={Journal of Economic Perspectives}, year={1996}, volume={10}, number={4}, pages={159--177}, doi={10.1257/jep.10.4.159}}@article{simpson1951interpretation, author={Simpson, E. H.}, title={{The interpretation of interaction in contingency tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1951}, volume={13}, number={2}, pages={238--241}, doi={10.1111/j.2517-6161.1951.tb00088.x}}