Przykład: firma kurierska i 25 oddziałów
Fikcyjna firma kurierska ma 25 oddziałów, od 18 do 89 etatów. Dyrektor operacyjny pyta: które oddziały pracują najsprawniej, a które przy tych samych zasobach mogłyby obsłużyć więcej przesyłek? Wskaźnik „przesyłki na etat” nie wystarczy: oddział ma trzy nakłady (pracowników, samochody, powierzchnię magazynu) i dwa wyniki (doręczenia i nadania).
Taką ocenę daje analiza obwiedni danych (ang. data envelopment analysis, DEA). Metoda rysuje z najlepszych oddziałów granicę najlepszej praktyki i mierzy, jak daleko od niej leży każdy pozostały. Nie zakłada postaci funkcji produkcji ani wag (Banker i in., 1984). To częsty temat prac z logistyki i zarządzania (zob. statystyka w pracy z logistyki i statystyka w pracy z zarządzania i ekonomii).
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy granicę najlepszej praktyki ze stałymi przychodami skali przy ok. 45 etatach, rosnącymi w mniejszych i malejącymi w większych oddziałach. Pięć oddziałów (O-03, O-09, O-12, O-18, O-22) leży na granicy, a pozostałe tracą od kilku do kilkudziesięciu procent przesyłek. Terminowość wynosi 93.9–96.9%. Do tego jeden błąd w danych: oddział O-07 wlicza do nadań przeładunki dla sąsiedniej sortowni (nadania × 2.5). Jego prawdziwa efektywność to .719. Ziarno 651 ustalono raz i nie zmieniano. Dane pobierzesz jako efektywnosc-dea-oddzialy-kurierskie.csv (wiersz = oddział).
Terminowość wchodzi do modelu jako liczba doręczeń w terminie (tys. miesięcznie), a nie odsetek – dlaczego, wyjaśniamy w Pułapkach. Drugi wynik to nadania, czyli przesyłki odebrane od klientów.
Rysunek 1: nakłady → oddział → wyniki
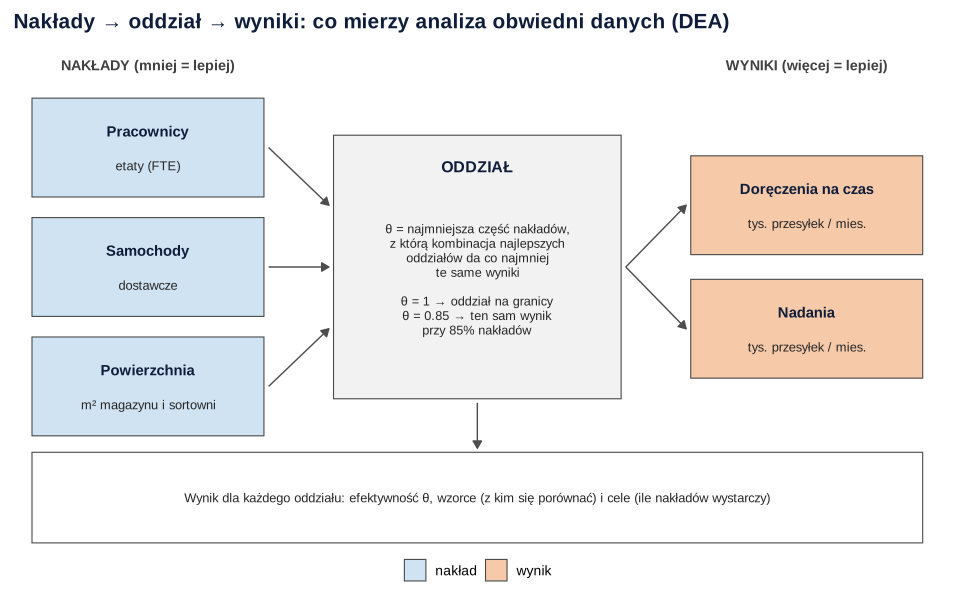
Co widać. Wersja DEA zorientowana na nakłady pyta, jaką najmniejszą część obecnych nakładów wystarczyłoby zużyć, żeby kombinacja najlepszych oddziałów dała co najmniej te same wyniki. Ta część to efektywność θ (theta). θ = 1 oznacza oddział na granicy, θ = 0.85 – te same wyniki byłyby osiągalne przy 85% każdego nakładu. Dostajesz też wzorce i cele.
Jak może zmylić. „Efektywny” znaczy tylko „na granicy wyznaczonej przez te 25 oddziałów i te zmienne”. Najlepszy oddział w słabej sieci też ma θ = 1.
Podpis do pracy:
Rysunek 2: granica efektywności na dwóch wymiarach
Najpierw granica tam, gdzie da się ją narysować.
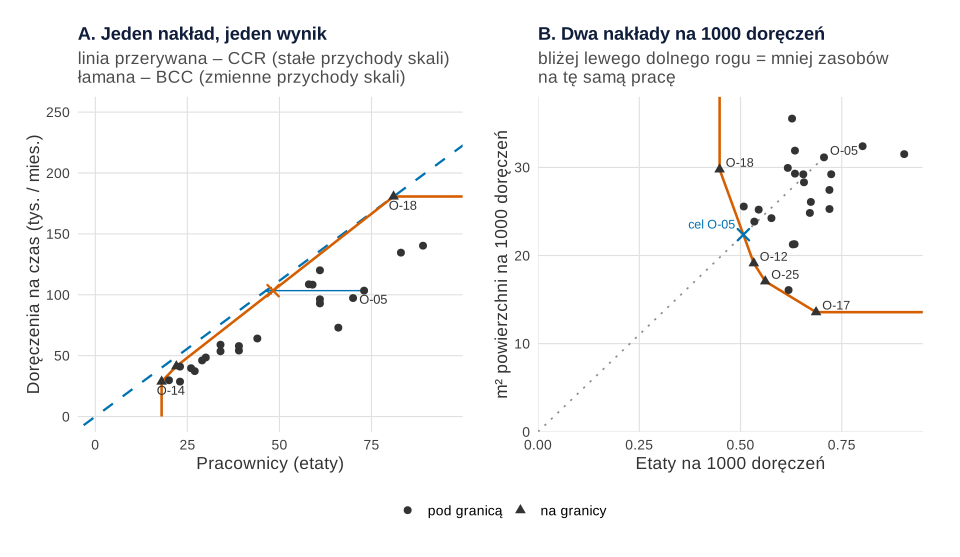
set.seed(651)).Co widać – panel A. Najwięcej doręczeń na etat ma O-18: 2231 miesięcznie. Linia z punktu (0, 0) przez O-18 to granica modelu CCR (Charnes, Cooper, Rhodes) ze stałymi przychodami skali – zakłada, że wydajność nie zależy od wielkości. Oddział O-05 ma 1416 doręczeń na etat, więc jego θ w tym uproszczonym modelu wynosi 0.635. Łamana to granica modelu BCC (Banker, Charnes, Cooper) ze zmiennymi przychodami skali. Porównuje z oddziałami podobnej wielkości i daje O-05 θ = 0.661. Strzałka (CCR) i krzyżyk (BCC) pokazują, ile etatów „wystarczyłoby” w każdym modelu.
Co widać – panel B. Na osiach są etaty i m² na 1000 doręczeń. Granicę tworzą O-18, O-12, O-25 i O-17 – każdy dobry w innej proporcji zasobów. O-05 rzutujemy po linii do początku układu, bo θ zmniejsza oba nakłady w tej samej proporcji. Wychodzi θ = 0.718.
Jak może zmylić. Granica to obwiednia danych, a nie średnia. Przy regresji liniowej połowa punktów leży nad linią, a tu żaden punkt nie leży nad granicą. Do porównania z „typowym”, a nie najlepszym oddziałem bliżej jest regresja kwantylowa dla wysokiego kwantyla.
Podpis do pracy:
Rysunek 3: modele CCR i BCC i efektywność skali
Pełny model ma 3 nakłady i 2 wyniki. Dla każdego oddziału rozwiązujemy jedno zadanie programowania liniowego (pakiet lpSolve, 25 zadań na model):
Słowami: szukamy „mieszanki” oddziałów (wagi λ), która daje co najmniej wyniki oddziału o, zużywając najmniejszą część θ jego nakładów.
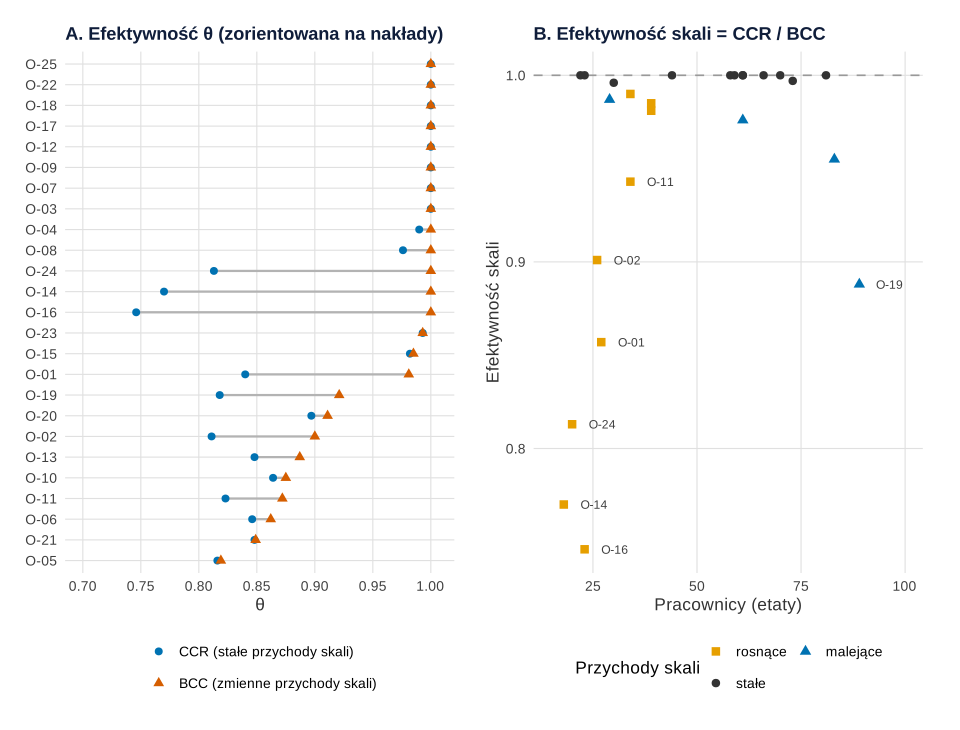
set.seed(651)).Co widać – panel A. W modelu CCR efektywnych jest 8 oddziałów, średnia θ = .907, najniższa .746 (O-16). W modelu BCC efektywnych jest 13, średnia .954, najniższa .819 (O-05).
Co widać – panel B. Iloraz CCR / BCC to efektywność skali. Najniższą mają małe oddziały: O-16 (.746), O-14 (.770), O-24 (.813) i O-01 (.857). Są za małe – działają przy rosnących przychodach skali. Po drugiej stronie jest O-19 (89 etatów, .888) z malejącymi przychodami skali. Rodzaj przychodów skali ustalamy, porównując BCC z modelem z warunkiem Σλ ≤ 1 (efektywność skali ≥ 0.995 = stałe; próg ręczny): 12 oddziałów stałe, 9 rosnące, 4 malejące. Ta klasyfikacja jest niepewna: O-10 i O-15 (ok. 30 etatów) wyszły z malejącymi.
Wagi wybiera sam oddział. Ta sama efektywność wychodzi z postaci ilorazowej: ważona suma wyników / ważona suma nakładów, z wagami dobranymi najkorzystniej dla ocenianego oddziału (kod sprawdza zgodność; różnica 1.9 · 10−13). O-14 dostaje wagi zerowe dla samochodów i powierzchni – jest oceniany tylko przez etaty, w których wypada najlepiej. Oddział może więc być „efektywny” dzięki jednej zmiennej.
Ranking efektywnych. Wszystkie efektywne mają θ = 1, więc DEA ich nie porządkuje. Superefektywność (Andersen i Petersen, 1993) ocenia oddział efektywny względem pozostałych. O-07 ma 1.845: mógłby zużywać o 84.5% więcej nakładów i nadal leżeć na granicy pozostałych oddziałów. Kolejny jest O-17 (1.397), pozostałe mają 1.006–1.165. Tak duża przewaga to sygnał, żeby sprawdzić dane – i rzeczywiście O-07 to nasz błąd w nadaniach. Zob. też ranking a ocena pozycji.
Jak może zmylić. Dane są fikcyjne, więc znamy prawdziwą efektywność. Zgodność rang z θ to tylko ρ = .66 (korelacja Spearmana) w obu modelach. Z 13 oddziałów efektywnych w BCC naprawdę na granicy jest 5. Małe O-14, O-16 i O-24 (prawdziwie .842–.895) nie mają się z kim porównać. O-07 (prawdziwie .719) jest „efektywny” przez błąd w danych.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: wzorce i cele dla nieefektywnych
Dla każdego nieefektywnego oddziału model BCC wskazuje wzorce – oddziały efektywne z wagą λ > 0 – i cele. Cel to najpierw cięcie wszystkich nakładów o (1 − θ), a potem dodatkowe luzy: nadwyżki pojedynczych nakładów i niedobory wyników, które zostają nawet po cięciu.
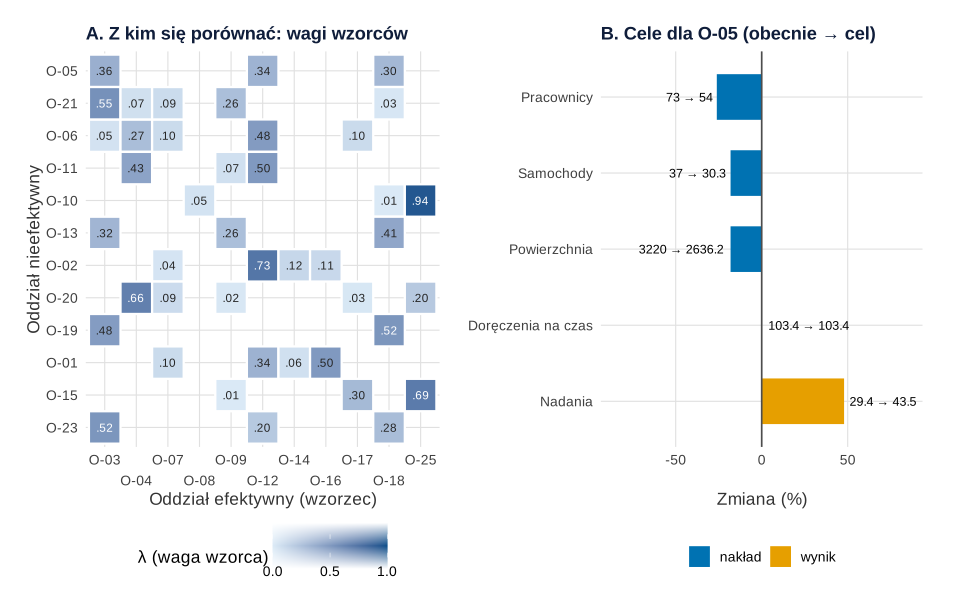
set.seed(651)).Co widać – panel A. Najczęściej wzorcem są O-03, O-12 i O-18 (po 6 razy), potem O-07 i O-09 (po 5). O-07 jest więc wzorcem dla pięciu oddziałów, choć jego dane są błędne. Oddział O-05 ma trzech wzorców: O-03 (λ = .360), O-12 (.336) i O-18 (.303).
Co widać – panel B. Przy θ = .819 O-05 powinien obsłużyć te same doręczenia przy 18.1% mniej każdego nakładu. Dla etatów luz jest większy: cel to 54 zamiast 73 etatów (−26.1%). Do tego wzorce mają więcej nadań, więc cel nadań to 43.5 tys. zamiast 29.4 tys. (+47.9%). Banker i Morey (1986) pokazują, jak wyznaczać cele, gdy część nakładów jest poza kontrolą kierownika – tu np. powierzchni nie zmienisz w miesiąc.
Jak może zmylić. Cel to punkt na granicy, a nie norma. Wzorce mogą mieć inne warunki: zabudowę, klientów, odległości.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: wrażliwość granicy i za dużo zmiennych
DEA nie daje przedziałów ufności. Najprostsza analiza wrażliwości to usunąć po kolei każdy oddział efektywny i policzyć model od nowa – podobnie jak w metodzie jackknife. Ile zmiennych udźwignie 25 oddziałów, pokazuje symulacja ze znaną prawdziwą efektywnością (200 powtórzeń na układ, nakłady niezależne, mały szum).
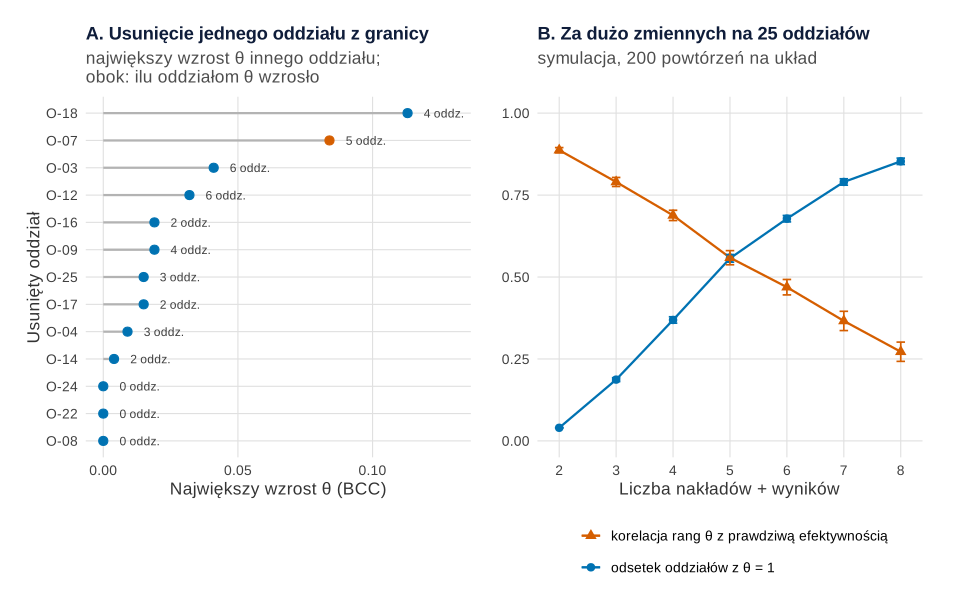
set.seed(651)).Co widać – panel A. Usunięcie O-18, największego oddziału na granicy (81 etatów), podnosi θ czterech oddziałów, w tym O-13 z .887 do 1 i O-19 z .921 do 1. Usunięcie O-07 (błąd w danych) podnosi θ pięciu oddziałów: O-20 z .911 do .995, O-21 z .849 do .930.
Co widać – panel B. Przy 1 nakładzie i 1 wyniku efektywny jest 4.0% oddziałów (jeden z 25), a korelacja rang z prawdziwą efektywnością wynosi .887. Przy 3 + 2 zmiennych (jak w naszym modelu) efektywnych jest już 55.7%, a korelacja spada do .559. Przy 5 + 3 to 85.3% i .272. Błąd Monte Carlo nie przekracza 0.015. W naszych danych nakłady są silnie skorelowane, więc efektywnych w CCR jest mniej (8 z 25). Pedraja-Chaparro i in. (1999) wskazują właśnie wielkość próby, liczbę zmiennych i korelacje między nimi jako czynniki, od których zależy jakość modelu DEA.
Jak może zmylić. To przybliżenie wrażliwości, nie wnioskowanie statystyczne. Granica DEA w skończonej próbie leży poniżej prawdziwej granicy (Banker, 1993), więc θ jest zawyżone. Do przedziałów ufności służy bootstrap dostosowany do modeli granicy – Simar i Wilson (1998) podkreślają, że wymaga on rozsądnie zdefiniowanego procesu generującego dane. Jak zaplanować własną symulację: badanie symulacyjne ADEMP.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w firmie
- Najpierw sprawdź dane oddziałów z najwyższą superefektywnością. O-07 był „najlepszy” przez błąd definicji nadań. Jeden taki oddział przesuwa granicę dla pięciu innych.
- Oddziałom z niską efektywnością skali nie mów „pracujcie lepiej”. O-14, O-16 i O-24 są w BCC na granicy; problemem jest wielkość. Decyzja to połączenie z sąsiednim oddziałem albo większy rejon.
- Cele traktuj jako punkt wyjścia do rozmowy. Dla O-05 to „mniej etatów i więcej nadań”, ale najpierw sprawdź, czym różni się od O-03, O-12 i O-18: rejonem, klientami, odległościami.
- Oceniaj w czasie. Policz DEA dla kolejnych kwartałów; jednorazowy wynik może być przypadkiem.
- Nie wiąż premii z samym θ. Pokazuj je obok prostych wskaźników (przesyłki na etat, terminowość).
- Porównania oddziałów w czasie i w grupach mają swoje pułapki – zob. porównanie sklepów „like-for-like” i paradoks Simpsona. Ranking zespołów z niepewnością pokazuje wpis o zaangażowaniu pracowników i modelu wielopoziomowym, a stabilność procesu w jednym miejscu – zdolność procesu Cp i Cpk.
Jak opisać w pracy
W Metodzie podaj jednostki (DMU) i ich liczbę, nakłady i wyniki z uzasadnieniem wyboru, orientację modelu (na nakłady czy na wyniki), przychody skali (CCR, BCC), sposób liczenia luzów i oprogramowanie. W Wynikach – rozkład θ w obu modelach, liczbę efektywnych, efektywność skali, wzorce i cele dla wybranych jednostek oraz analizę wrażliwości. Ogólny układ pracy: jak napisać pracę z zarządzania i ekonomii.
W ograniczeniach napisz, że DEA nie oddziela nieefektywności od szumu i błędów pomiaru. Jacobs (2001) porównał DEA ze stochastyczną analizą graniczną (SFA) na tych samych danych: różnice wyników mogą wynikać m.in. z losowego szumu. Zaleca on podawanie zakresów z kilku specyfikacji zamiast pojedynczej liczby. Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Kod R: DEA w lpSolve krok po kroku
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, dane i funkcję dea(), z których korzystają kolejne. Pakiety do DEA (np. Benchmarking) robią to samo jednym poleceniem, ale tu każde zadanie programowania liniowego zapisujemy wprost w lpSolve::lp(), żeby było widać, co liczy model. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 (dane) i 6 (symulacja); oba zaczynają losowanie od własnego set.seed(651). Ziarno 651 ustalono raz i nie zmieniano go. Ręcznie ustalono: 25 oddziałów; etaty z rozkładu jednostajnego na skali logarytmu między 18 a 95; samochody ≈ 0.62 na etat (SD 0.15 w skali logarytmu); powierzchnię ≈ 38 m² na etat (SD 0.25); granicę 2.0 · etaty0.60 · samochody0.25 · powierzchnia0.15 · exp(−0.35 · ln(etaty / 45)2); nieefektywność |N(0, 0.20)| w skali logarytmu z pięcioma oddziałami na granicy; udział nadań 20–45%; terminowość 97 − 30 · |N(0, 0.05)|; błąd O-07 (nadania × 2.5); próg stałych przychodów skali (efektywność skali ≥ 0.995); pomijanie wag λ < 0.005; w symulacji – 7 układów zmiennych, 200 powtórzeń, nakłady z rozkładu logarytmicznie normalnego (ln 40, SD 0.4), nieefektywność |N(0, 0.20)|, szum N(0, 0.05) i udziały wyników z rozkładu jednostajnego 0.5–1.5. Plik CSV zawiera też kolumnę efektywnosc_prawdziwa. Całość liczy się w kilka sekund.
1. Paleta, dane i funkcja DEA
R
# Przepis 1. Fikcyjna firma kurierska: 25 oddziałów, 3 nakłady i 2 wyniki (dane symulowane) + funkcja DEA
library(ggplot2)
library(patchwork)
library(lpSolve)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie (ujawnione na stronie)
set.seed(651)
n <- 25
oddzial <- sprintf("O-%02d", 1:n)
pracownicy <- round(exp(runif(n, log(18), log(95))))                     # etaty (FTE)
samochody <- pmax(6, round(pracownicy * 0.62 * exp(rnorm(n, 0, 0.15))))  # samochody dostawcze
powierzchnia <- round(pracownicy * 38 * exp(rnorm(n, 0, 0.25)), -1)      # m² magazynu i sortowni
# Granica „najlepszej praktyki” (tys. przesyłek miesięcznie): stałe przychody skali przy ok. 45 etatach,
# rosnące w mniejszych oddziałach i malejące w większych
granica <- 2.0 * pracownicy^0.60 * samochody^0.25 * powierzchnia^0.15 *
  exp(-0.35 * log(pracownicy / 45)^2)
# Ukryta nieefektywność: 5 oddziałów na granicy, pozostałe tracą od kilku do kilkudziesięciu procent
u <- abs(rnorm(n, 0, 0.20)); u[c(3, 9, 12, 18, 22)] <- 0
udzial_nadan <- runif(n, 0.20, 0.45)                     # część przesyłek to nadania (odbiory od firm)
ogolem <- granica * exp(-u)
terminowosc <- round(pmin(98.5, 97 - 30 * abs(rnorm(n, 0, 0.05))), 1)  # % doręczeń na czas
dorecz_terminowe <- round(ogolem * (1 - udzial_nadan) * terminowosc / 100, 1)  # tys. doręczeń na czas
nadania <- round(ogolem * udzial_nadan, 1)                                     # tys. odebranych przesyłek
# Błąd w danych: oddział O-07 wlicza do nadań przeładunki dla sąsiedniej sortowni (nadania × 2.5)
nadania[7] <- round(nadania[7] * 2.5, 1)
kurier <- data.frame(oddzial, pracownicy, samochody, powierzchnia, dorecz_terminowe, nadania, terminowosc,
                     efektywnosc_prawdziwa = round(exp(-u), 3))
write.csv(kurier, "efektywnosc-dea-oddzialy-kurierskie.csv", row.names = FALSE)

# Przegląd danych: zakres nakładów i wyników oraz wydajność na etat
summary(kurier[, c("pracownicy", "samochody", "powierzchnia", "dorecz_terminowe", "nadania", "terminowosc")])
kurier$na_etat <- round(1000 * (kurier$dorecz_terminowe + kurier$nadania) / kurier$pracownicy)  # przesyłek na etat
head(kurier[order(-kurier$na_etat), c("oddzial", "pracownicy", "dorecz_terminowe", "nadania", "na_etat")], 4)

# Funkcja DEA zorientowana na nakłady (postać obwiedniowa, programowanie liniowe w lpSolve).
# X – macierz nakładów (oddziały × nakłady), Y – macierz wyników, o – oceniany oddział,
# rts = "crs" (model CCR), "vrs" (model BCC) albo "nirs" (sum(lambda) <= 1),
# ref – oddziały, z których budujemy granicę.
dea <- function(X, Y, o, rts = "crs", ref = seq_len(nrow(X))) {
  k <- length(ref)                                # zmienne: theta, lambda_1..lambda_k
  A <- rbind(cbind(-X[o, ], t(X[ref, , drop = FALSE])),   # sum(lambda * x) - theta * x_o <= 0
             cbind(0, t(Y[ref, , drop = FALSE])))          # sum(lambda * y) >= y_o
  kier <- c(rep("<=", ncol(X)), rep(">=", ncol(Y)))
  prawa <- c(rep(0, ncol(X)), Y[o, ])
  if (rts != "crs") { A <- rbind(A, c(0, rep(1, k))); kier <- c(kier, if (rts == "vrs") "=" else "<="); prawa <- c(prawa, 1) }
  w <- lp("min", c(1, rep(0, k)), A, kier, prawa)
  if (w$status != 0) return(list(theta = NA, lambda = rep(NA, k)))   # brak rozwiązania (np. superefektywność VRS)
  list(theta = w$solution[1], lambda = setNames(w$solution[-1], ref))
}
X <- as.matrix(kurier[, c("pracownicy", "samochody", "powierzchnia")])
Y <- as.matrix(kurier[, c("dorecz_terminowe", "nadania")])
rownames(X) <- rownames(Y) <- kurier$oddzial
Wynik w R
   pracownicy     samochody      powierzchnia  dorecz_terminowe
 Min.   :18.0   Min.   :13.00   Min.   : 700   Min.   : 28.70
 1st Qu.:27.0   1st Qu.:16.00   1st Qu.: 980   1st Qu.: 41.30
 Median :39.0   Median :24.00   Median :1510   Median : 59.00
 Mean   :46.8   Mean   :28.52   Mean   :1994   Mean   : 75.42
 3rd Qu.:61.0   3rd Qu.:39.00   3rd Qu.:2670   3rd Qu.:103.40
 Max.   :89.0   Max.   :55.00   Max.   :5380   Max.   :180.70
    nadania        terminowosc
 Min.   : 11.70   Min.   :93.90
 1st Qu.: 20.30   1st Qu.:95.30
 Median : 40.40   Median :96.20
 Mean   : 44.14   Mean   :95.96
 3rd Qu.: 58.30   3rd Qu.:96.60
 Max.   :148.20   Max.   :96.90
   oddzial pracownicy dorecz_terminowe nadania na_etat
7     O-07         66             73.0   148.2    3352
9     O-09         58            108.6    75.4    3172
4     O-04         34             59.0    40.4    2924
18    O-18         81            180.7    51.0    2860
2. Grafika „nakłady → oddział → wyniki”: Rysunek 1
R
# Rysunek 1. Grafika: nakłady → oddział → wyniki i jak DEA liczy efektywność
# Samodzielny przepis: niczego nie losuje i nie korzysta z innych przepisów.
library(ggplot2)

pola <- data.frame(
  x = c(1.45, 1.45, 1.45, 5, 8.55, 8.55, 5),
  y = c(5.0, 3.55, 2.1, 3.55, 4.3, 2.8, 0.75),
  szer = c(1.25, 1.25, 1.25, 1.55, 1.25, 1.25, 4.8),
  wys = c(0.6, 0.6, 0.6, 1.6, 0.6, 0.6, 0.55),
  typ = c("naklad", "naklad", "naklad", "oddzial", "wynik", "wynik", "decyzja"),
  tytul = c("Pracownicy", "Samochody", "Powierzchnia", "ODDZIAŁ", "Doręczenia na czas", "Nadania", ""),
  opis = c("etaty (FTE)", "dostawcze", "m² magazynu i sortowni",
           "θ = najmniejsza część nakładów,\nz którą kombinacja najlepszych\noddziałów da co najmniej\nte same wyniki\n\nθ = 1 → oddział na granicy\nθ = 0.85 → ten sam wynik\nprzy 85% nakładów",
           "tys. przesyłek / mies.", "tys. przesyłek / mies.",
           "Wynik dla każdego oddziału: efektywność θ, wzorce (z kim się porównać) i cele (ile nakładów wystarczy)"))
strzalki <- data.frame(x = c(2.75, 2.75, 2.75, 6.6, 6.6), xend = c(3.4, 3.4, 3.4, 7.25, 7.25),
                       y = c(5.0, 3.55, 2.1, 3.55, 3.55), yend = c(4.3, 3.55, 2.8, 4.3, 2.8))
p1 <- ggplot() +
  geom_rect(data = pola, aes(xmin = x - szer, xmax = x + szer, ymin = y - wys, ymax = y + wys, fill = typ),
            colour = "grey30", linewidth = 0.4) +
  geom_text(data = pola[pola$typ != "oddzial", ], aes(x, y + ifelse(typ == "decyzja", 0, 0.2), label = tytul),
            fontface = "bold", size = 3.9, colour = "#0f1d3a") +
  geom_text(data = pola[pola$typ %in% c("naklad", "wynik"), ], aes(x, y - 0.22, label = opis), size = 3.4, colour = "grey15") +
  geom_text(data = pola[pola$typ == "oddzial", ], aes(x, y + 1.22, label = tytul), fontface = "bold", size = 4.2, colour = "#0f1d3a") +
  geom_text(data = pola[pola$typ == "oddzial", ], aes(x, y - 0.15, label = opis), size = 3.35, lineheight = 0.95, colour = "grey15") +
  geom_text(data = pola[pola$typ == "decyzja", ], aes(x, y, label = opis), size = 3.4, colour = "grey15") +
  geom_segment(data = strzalki, aes(x, y, xend = xend, yend = yend),
               arrow = arrow(length = unit(0.22, "cm"), type = "closed"), colour = "grey30", linewidth = 0.5) +
  annotate("segment", x = 5, xend = 5, y = 1.9, yend = 1.35, arrow = arrow(length = unit(0.22, "cm"), type = "closed"),
           colour = "grey30", linewidth = 0.5) +
  annotate("text", x = c(1.45, 8.55), y = 6.0, label = c("NAKŁADY (mniej = lepiej)", "WYNIKI (więcej = lepiej)"),
           fontface = "bold", size = 3.8, colour = "grey25") +
  scale_fill_manual(values = c(naklad = "#CFE3F2", oddzial = "#F2F2F2", wynik = "#F6C9A9", decyzja = "#FFFFFF"),
                    breaks = c("naklad", "wynik"), labels = c(naklad = "nakład", wynik = "wynik"), name = NULL) +
  coord_cartesian(xlim = c(0, 10), ylim = c(0.1, 6.3), expand = FALSE) +
  labs(title = "Nakłady → oddział → wyniki: co mierzy analiza obwiedni danych (DEA)") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 6)),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
p1   # zapis: ggsave("efektywnosc-dea-schemat.svg", p1, width = 10, height = 6.2)
3. Granica na dwóch wymiarach: Rysunek 2
R
# Rysunek 2. Intuicja na dwóch wymiarach: granica efektywności z jednym nakładem i z dwoma nakładami
# Korzysta z obiektów przepisu 1: kurier, dea, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)

# A. Jeden nakład (etaty) i jeden wynik (doręczenia na czas)
d1 <- data.frame(oddzial = kurier$oddzial, x = kurier$pracownicy, y = kurier$dorecz_terminowe)
X1 <- matrix(d1$x); Y1 <- matrix(d1$y)
d1$crs <- sapply(1:nrow(d1), function(o) dea(X1, Y1, o, "crs")$theta)
d1$vrs <- sapply(1:nrow(d1), function(o) dea(X1, Y1, o, "vrs")$theta)
best <- d1[which.max(d1$y / d1$x), ]                         # najwyższa wydajność na etat wyznacza promień CCR
gr_vrs <- d1[d1$vrs > 0.9999, ]; gr_vrs <- gr_vrs[order(gr_vrs$x), ]
gr_vrs <- rbind(data.frame(oddzial = NA, x = gr_vrs$x[1], y = 0, crs = NA, vrs = NA), gr_vrs,
                data.frame(oddzial = NA, x = 100, y = max(gr_vrs$y), crs = NA, vrs = NA))
o5 <- d1[d1$oddzial == "O-05", ]
data.frame(oddzial = c(best$oddzial, "O-05"), doreczen_na_etat = round(1000 * c(best$y / best$x, o5$y / o5$x)),
           CCR_1x1 = round(c(best$crs, o5$crs), 3), BCC_1x1 = round(c(best$vrs, o5$vrs), 3))
pA <- ggplot(d1, aes(x, y)) +
  geom_abline(slope = best$y / best$x, intercept = 0, colour = kol[["niebieski"]], linewidth = 0.8, linetype = "dashed") +
  geom_path(data = gr_vrs, colour = kol[["cynober"]], linewidth = 0.9) +
  annotate("segment", x = o5$x, xend = o5$x * o5$crs, y = o5$y, yend = o5$y, colour = kol[["niebieski"]],
           arrow = arrow(length = unit(0.18, "cm")), linewidth = 0.5) +
  annotate("point", x = o5$x * o5$vrs, y = o5$y, shape = 4, size = 3.2, stroke = 1.2, colour = kol[["cynober"]]) +
  geom_point(aes(shape = vrs > 0.9999), size = 2.4, colour = kol[["ciemny"]]) +
  geom_text(data = d1[d1$oddzial %in% c(best$oddzial, "O-05", "O-14", "O-18"), ], aes(label = oddzial),
            nudge_x = 2.5, nudge_y = -7, size = 3.4, colour = kol[["ciemny"]]) +
  scale_shape_manual(values = c(`TRUE` = 17, `FALSE` = 16), labels = c(`TRUE` = "na granicy", `FALSE` = "pod granicą"), name = NULL) +
  coord_cartesian(xlim = c(0, 95), ylim = c(0, 250)) +
  labs(title = "A. Jeden nakład, jeden wynik", subtitle = "linia przerywana – CCR (stałe przychody skali)\nłamana – BCC (zmienne przychody skali)",
       x = "Pracownicy (etaty)", y = "Doręczenia na czas (tys. / mies.)") + motyw

# B. Dwa nakłady na 1000 doręczeń: etaty i samochody (model CCR) – granica to „izokwanta”
d2 <- data.frame(oddzial = kurier$oddzial, x1 = kurier$pracownicy / d1$y, x2 = kurier$powierzchnia / d1$y)   # d1$y jest w tys.
X2 <- as.matrix(kurier[, c("pracownicy", "powierzchnia")])
d2$crs <- sapply(1:nrow(d2), function(o) dea(X2, Y1, o, "crs")$theta)
gr2 <- d2[d2$crs > 0.9999, ]; gr2 <- gr2[order(gr2$x1, -gr2$x2), ]
gr2 <- rbind(data.frame(oddzial = NA, x1 = gr2$x1[1], x2 = 1e4, crs = NA), gr2,
             data.frame(oddzial = NA, x1 = 100, x2 = gr2$x2[nrow(gr2)], crs = NA))
o5b <- d2[d2$oddzial == "O-05", ]
data.frame(oddzial = gr2$oddzial[!is.na(gr2$oddzial)])               # oddziały wyznaczające izokwantę
round(o5b$crs, 3)                                                    # efektywność O-05 w modelu z dwoma nakładami
pB <- ggplot(d2, aes(x1, x2)) +
  geom_path(data = gr2, colour = kol[["cynober"]], linewidth = 0.9) +
  annotate("segment", x = 0, y = 0, xend = o5b$x1, yend = o5b$x2, colour = "grey55", linetype = "dotted") +
  annotate("point", x = o5b$x1 * o5b$crs, y = o5b$x2 * o5b$crs, shape = 4, size = 3.2, stroke = 1.2, colour = kol[["niebieski"]]) +
  annotate("text", x = o5b$x1 * o5b$crs - 0.02, y = o5b$x2 * o5b$crs + 1.2, label = "cel O-05", size = 3.3,
           colour = kol[["niebieski"]], hjust = 1) +
  geom_point(aes(shape = crs > 0.9999), size = 2.4, colour = kol[["ciemny"]]) +
  geom_text(data = d2[d2$crs > 0.9999 | d2$oddzial == "O-05", ], aes(label = oddzial), nudge_x = 0.015, nudge_y = 0.8,
            size = 3.3, colour = kol[["ciemny"]], hjust = 0) +
  scale_shape_manual(values = c(`TRUE` = 17, `FALSE` = 16), labels = c(`TRUE` = "na granicy", `FALSE` = "pod granicą"), name = NULL) +
  coord_cartesian(xlim = c(0, 0.95), ylim = c(0, 38), expand = FALSE) +
  labs(title = "B. Dwa nakłady na 1000 doręczeń", subtitle = "bliżej lewego dolnego rogu = mniej zasobów\nna tę samą pracę",
       x = "Etaty na 1000 doręczeń", y = "m² powierzchni na 1000 doręczeń") + motyw
p2 <- (pA | pB) + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p2   # zapis: ggsave("efektywnosc-dea-intuicja-granica.svg", p2, width = 10, height = 5.8)
Wynik w R
  oddzial doreczen_na_etat CCR_1x1 BCC_1x1
1    O-18             2231   1.000   1.000
2    O-05             1416   0.635   0.661
  oddzial
1    O-18
2    O-12
3    O-25
4    O-17
[1] 0.718
4. Modele CCR i BCC, skala, wagi i superefektywność: Rysunek 3
R
# Rysunek 3. Modele CCR i BCC zorientowane na nakłady: efektywność, efektywność skali, superefektywność
# Korzysta z obiektów przepisu 1: kurier, X, Y, dea, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)
library(lpSolve)

n <- nrow(X)
ccr <- lapply(1:n, function(o) dea(X, Y, o, "crs"))
wyn <- data.frame(oddzial = kurier$oddzial, pracownicy = kurier$pracownicy,
                  CCR = sapply(ccr, `[[`, "theta"),
                  BCC = sapply(1:n, function(o) dea(X, Y, o, "vrs")$theta))
wyn$skala <- wyn$CCR / wyn$BCC                                  # efektywność skali
# Rodzaj przychodów skali: porównanie z modelem z ograniczeniem sum(lambda) <= 1 (NIRS);
# efektywność skali >= 0.995 (strata poniżej 0.5%) traktujemy jako stałe przychody skali – próg ustalony ręcznie
wyn$NIRS <- sapply(1:n, function(o) dea(X, Y, o, "nirs")$theta)
wyn$przychody <- ifelse(wyn$skala >= 0.995, "stałe", ifelse(abs(wyn$NIRS - wyn$BCC) < 1e-6, "malejące", "rosnące"))
wyn$NIRS <- NULL
wyn[, 3:5] <- round(wyn[, 3:5], 3)
wyn[order(wyn$BCC, wyn$CCR), c("oddzial", "pracownicy", "CCR", "BCC", "skala", "przychody")]
data.frame(model = c("CCR", "BCC"), efektywne = c(sum(wyn$CCR > 0.9999), sum(wyn$BCC > 0.9999)),
           srednia = round(c(mean(wyn$CCR), mean(wyn$BCC)), 3), minimum = c(min(wyn$CCR), min(wyn$BCC)))
table(wyn$przychody)
# Dane są fikcyjne, więc znamy prawdziwą efektywność: zgodność rang (Spearman)
round(cor(wyn[, c("CCR", "BCC")], kurier$efektywnosc_prawdziwa, method = "spearman"), 2)
data.frame(oddzial = wyn$oddzial, BCC = wyn$BCC, prawdziwa = kurier$efektywnosc_prawdziwa)[wyn$BCC > 0.9999, ]

# Sprawdzenie: postać ilorazowa (mnożnikowa) CCR daje tę samą efektywność.
# Wagi u (wyniki) i v (nakłady) dobiera się osobno dla każdego oddziału – najkorzystniej dla niego.
mnoznikowa <- function(o) {
  A <- rbind(c(rep(0, ncol(Y)), X[o, ]),                        # v · x_o = 1
             cbind(Y, -X))                                      # u · y_j − v · x_j <= 0 dla każdego j
  w <- lp("max", c(Y[o, ], rep(0, ncol(X))), A, c("=", rep("<=", n)), c(1, rep(0, n)))
  w$solution
}
wagi <- t(sapply(1:n, mnoznikowa))
colnames(wagi) <- c(paste0("u_", colnames(Y)), paste0("v_", colnames(X))); rownames(wagi) <- rownames(X)
max(abs(rowSums(wagi[, 1:2] * Y) - sapply(ccr, `[[`, "theta")))   # różnica ≈ 0
signif(wagi[kurier$oddzial %in% c("O-14", "O-18"), ], 3)        # przykładowe wagi dwóch oddziałów

# Superefektywność (Andersen i Petersen): oddział efektywny oceniany względem pozostałych
efektywne <- which(wyn$CCR > 0.9999)
data.frame(oddzial = kurier$oddzial[efektywne],
           super_CCR = round(sapply(efektywne, function(o) dea(X, Y, o, "crs", ref = setdiff(1:n, o))$theta), 3))

# Pułapka: terminowość jako odsetek (%) zamiast liczby doręczeń w modelu CCR
Y_proc <- cbind(przesylki = kurier$dorecz_terminowe / kurier$terminowosc * 100 + kurier$nadania,
                terminowosc_proc = kurier$terminowosc)
ccr_proc <- sapply(1:n, function(o) dea(X, Y_proc, o, "crs")$theta)
data.frame(oddzial = kurier$oddzial, pracownicy = kurier$pracownicy, CCR = wyn$CCR,
           CCR_z_odsetkiem = round(ccr_proc, 3))[ccr_proc > 0.9999 & wyn$CCR < 0.9999, ]

# Rysunek 3: A – efektywność w obu modelach; B – efektywność skali a wielkość oddziału
kolej <- wyn$oddzial[order(wyn$BCC, wyn$CCR)]
dl <- rbind(data.frame(oddzial = wyn$oddzial, model = "CCR (stałe przychody skali)", theta = wyn$CCR),
            data.frame(oddzial = wyn$oddzial, model = "BCC (zmienne przychody skali)", theta = wyn$BCC))
dl$oddzial <- factor(dl$oddzial, levels = kolej)
pA <- ggplot(dl, aes(theta, oddzial)) +
  geom_line(aes(group = oddzial), colour = "grey70", linewidth = 0.8) +
  geom_point(aes(colour = model, shape = model), size = 2.4) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["cynober"]]),
                      breaks = c("CCR (stałe przychody skali)", "BCC (zmienne przychody skali)"), name = NULL) +
  scale_shape_manual(values = c(16, 17), breaks = c("CCR (stałe przychody skali)", "BCC (zmienne przychody skali)"), name = NULL) +
  scale_x_continuous(limits = c(0.7, 1.005), breaks = seq(0.7, 1, 0.05)) +
  labs(title = "A. Efektywność θ (zorientowana na nakłady)", x = "θ", y = NULL) + motyw +
  theme(axis.text.y = element_text(size = 9), legend.position = "bottom") + guides(colour = guide_legend(nrow = 2))
pB <- ggplot(wyn, aes(pracownicy, skala)) +
  geom_hline(yintercept = 1, colour = "grey60", linetype = "dashed") +
  geom_point(aes(colour = przychody, shape = przychody), size = 2.6) +
  geom_text(data = wyn[wyn$skala < 0.95, ], aes(label = oddzial), nudge_x = 4, size = 3.2, colour = "grey25", hjust = 0) +
  scale_colour_manual(values = c("rosnące" = kol[["pomarancz"]], "stałe" = kol[["ciemny"]], "malejące" = kol[["niebieski"]]),
                      breaks = c("rosnące", "stałe", "malejące"), name = "Przychody skali") +
  scale_shape_manual(values = c("rosnące" = 15, "stałe" = 16, "malejące" = 17), breaks = c("rosnące", "stałe", "malejące"),
                     name = "Przychody skali") +
  coord_cartesian(xlim = c(15, 100)) +
  labs(title = "B. Efektywność skali = CCR / BCC", x = "Pracownicy (etaty)", y = "Efektywność skali") + motyw +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2))
p3 <- pA | pB
p3   # zapis: ggsave("efektywnosc-dea-ccr-bcc.svg", p3, width = 10, height = 7.6)
Wynik w R
   oddzial pracownicy   CCR   BCC skala przychody
5     O-05         73 0.816 0.819 0.997     stałe
21    O-21         70 0.848 0.849 1.000     stałe
6     O-06         39 0.846 0.862 0.981   rosnące
11    O-11         34 0.823 0.872 0.943   rosnące
10    O-10         29 0.864 0.875 0.987  malejące
13    O-13         83 0.848 0.887 0.955  malejące
2     O-02         26 0.811 0.900 0.901   rosnące
20    O-20         39 0.897 0.911 0.985   rosnące
19    O-19         89 0.818 0.921 0.888  malejące
1     O-01         27 0.840 0.981 0.857   rosnące
15    O-15         30 0.982 0.985 0.996     stałe
23    O-23         59 0.993 0.993 1.000     stałe
16    O-16         23 0.746 1.000 0.746   rosnące
14    O-14         18 0.770 1.000 0.770   rosnące
24    O-24         20 0.813 1.000 0.813   rosnące
8     O-08         61 0.976 1.000 0.976  malejące
4     O-04         34 0.990 1.000 0.990   rosnące
3     O-03         61 1.000 1.000 1.000     stałe
7     O-07         66 1.000 1.000 1.000     stałe
9     O-09         58 1.000 1.000 1.000     stałe
12    O-12         22 1.000 1.000 1.000     stałe
17    O-17         44 1.000 1.000 1.000     stałe
18    O-18         81 1.000 1.000 1.000     stałe
22    O-22         61 1.000 1.000 1.000     stałe
25    O-25         23 1.000 1.000 1.000     stałe
  model efektywne srednia minimum
1   CCR         8   0.907   0.746
2   BCC        13   0.954   0.819

malejące  rosnące    stałe
       4        9       12
    [,1]
CCR 0.66
BCC 0.66
   oddzial BCC prawdziwa
3     O-03   1     1.000
4     O-04   1     0.982
7     O-07   1     0.719
8     O-08   1     0.887
9     O-09   1     1.000
12    O-12   1     1.000
14    O-14   1     0.895
16    O-16   1     0.842
17    O-17   1     0.977
18    O-18   1     1.000
22    O-22   1     1.000
24    O-24   1     0.886
25    O-25   1     0.995
[1] 1.857403e-13
     u_dorecz_terminowe u_nadania v_pracownicy v_samochody v_powierzchnia
O-14            0.02160  0.011600      0.05560           0       0.00e+00
O-18            0.00532  0.000763      0.00809           0       6.41e-05
  oddzial super_CCR
1    O-03     1.090
2    O-07     1.845
3    O-09     1.074
4    O-12     1.060
5    O-17     1.397
6    O-18     1.165
7    O-22     1.006
8    O-25     1.028
   oddzial pracownicy   CCR CCR_z_odsetkiem
14    O-14         18 0.770               1
16    O-16         23 0.746               1
24    O-24         20 0.813               1
5. Wzorce i cele: Rysunek 4
R
# Rysunek 4. Wzorce (peers) i cele dla nieefektywnych oddziałów w modelu BCC
# Korzysta z obiektów przepisów 1 i 4: kurier, X, Y, dea, wyn, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)
library(lpSolve)

# Etap 2: przy ustalonym θ szukamy największych luzów (slacks) – nadwyżek nakładów ponad cięcie radialne
# i niedoborów wyników. Luzy liczone względem wartości oddziału, żeby jednostki (etaty, m²) się nie mieszały.
etap2 <- function(o, theta) {
  m <- ncol(X); s <- ncol(Y); n <- nrow(X)
  A <- rbind(cbind(t(X), diag(m), matrix(0, m, s)),             # sum(lambda * x) + s_minus = theta * x_o
             cbind(t(Y), matrix(0, s, m), -diag(s)),            # sum(lambda * y) - s_plus  = y_o
             c(rep(1, n), rep(0, m + s)))                       # sum(lambda) = 1 (BCC)
  w <- lp("max", c(rep(0, n), 1 / X[o, ], 1 / Y[o, ]), A, rep("=", m + s + 1), c(theta * X[o, ], Y[o, ], 1))
  list(lambda = setNames(w$solution[1:n], rownames(X)), luz_n = w$solution[n + 1:m], luz_w = w$solution[n + m + 1:s])
}
bcc_theta <- sapply(1:nrow(X), function(o) dea(X, Y, o, "vrs")$theta)
nieef <- which(bcc_theta < 0.9999)
e2 <- lapply(nieef, function(o) etap2(o, bcc_theta[o]))
names(e2) <- rownames(X)[nieef]

# Wzorce: oddziały efektywne z lambda > 0 i ich wagi
wzorce <- do.call(rbind, lapply(names(e2), function(k) {
  l <- e2[[k]]$lambda; l <- l[l >= 0.005]          # pomijamy wagi bliskie zera
  data.frame(oddzial = k, wzorzec = names(l), lambda = round(l, 3))
}))
rownames(wzorce) <- NULL
sort(table(wzorce$wzorzec), decreasing = TRUE)                   # jak często oddział jest wzorcem

# Cele dla oddziału O-05 (najniższa efektywność BCC): obecnie → cel
o <- which(rownames(X) == "O-05"); k <- e2[["O-05"]]
cel <- data.frame(zmienna = c(colnames(X), colnames(Y)),
                  obecnie = c(X[o, ], Y[o, ]),
                  cel = c(bcc_theta[o] * X[o, ] - k$luz_n, Y[o, ] + k$luz_w))
cel$zmiana_proc <- round(100 * (cel$cel / cel$obecnie - 1), 1)
cel$cel <- round(cel$cel, 1)
wzorce[wzorce$oddzial == "O-05", ]
cel

# Rysunek 4: A – mapa wag wzorców; B – cele dla O-05
wzorce$oddzial <- factor(wzorce$oddzial, levels = rev(wyn$oddzial[order(wyn$BCC)][wyn$oddzial[order(wyn$BCC)] %in% names(e2)]))
pA <- ggplot(wzorce[wzorce$lambda >= 0.005, ], aes(wzorzec, oddzial, fill = lambda)) +
  geom_tile(colour = "white", linewidth = 0.8) +
  geom_text(aes(label = sub("^0\\.", ".", formatC(lambda, format = "f", digits = 2)),
                colour = lambda > 0.5), size = 3.1, show.legend = FALSE) +
  scale_fill_gradient(low = "#DCEBF7", high = "#0B4F8A", limits = c(0, 1), breaks = c(0, 0.5, 1), name = "λ (waga wzorca)") +
  scale_x_discrete(guide = guide_axis(n.dodge = 2)) +
  scale_colour_manual(values = c(`TRUE` = "white", `FALSE` = "grey15")) +
  labs(title = "A. Z kim się porównać: wagi wzorców", x = "Oddział efektywny (wzorzec)", y = "Oddział nieefektywny") +
  motyw + theme(panel.grid = element_blank())
cel$etykieta <- c("Pracownicy", "Samochody", "Powierzchnia", "Doręczenia na czas", "Nadania")
cel$rodzaj <- rep(c("nakład", "wynik"), c(3, 2))
pB <- ggplot(cel, aes(zmiana_proc, factor(etykieta, levels = rev(etykieta)), fill = rodzaj)) +
  geom_col(width = 0.6) +
  geom_vline(xintercept = 0, colour = "grey30") +
  geom_text(aes(label = paste0(obecnie, " → ", cel), hjust = ifelse(zmiana_proc < 0, 1.08, -0.08)), size = 3.3) +
  scale_fill_manual(values = c("nakład" = kol[["niebieski"]], "wynik" = kol[["pomarancz"]]), name = NULL) +
  scale_x_continuous(limits = c(-85, 85)) +
  labs(title = "B. Cele dla O-05 (obecnie → cel)", x = "Zmiana (%)", y = NULL) + motyw
p4 <- (pA | pB) + plot_layout(widths = c(1.1, 1))
p4   # zapis: ggsave("efektywnosc-dea-wzorce-cele.svg", p4, width = 10, height = 6.4)
Wynik w R
O-03 O-12 O-18 O-07 O-09 O-04 O-17 O-25 O-14 O-16 O-08
   6    6    6    5    5    4    3    3    2    2    1
   oddzial wzorzec lambda
9     O-05    O-03  0.360
10    O-05    O-12  0.336
11    O-05    O-18  0.303
                          zmienna obecnie    cel zmiana_proc
pracownicy             pracownicy    73.0   54.0       -26.1
samochody               samochody    37.0   30.3       -18.1
powierzchnia         powierzchnia  3220.0 2636.2       -18.1
dorecz_terminowe dorecz_terminowe   103.4  103.4         0.0
nadania                   nadania    29.4   43.5        47.9
6. Usunięcie jednego oddziału i symulacja liczby zmiennych: Rysunek 5
R
# Rysunek 5. Wrażliwość: usunięcie jednego oddziału z granicy i symulacja „za dużo zmiennych”
# Korzysta z obiektów przepisu 1: kurier, X, Y, dea, kol, motyw. Losuje tylko część B (własne ziarno).
library(ggplot2)
library(patchwork)
library(lpSolve)

# A. Usuń po kolei każdy oddział efektywny w BCC i policz efektywność pozostałych od nowa
n <- nrow(X)
bcc <- sapply(1:n, function(o) dea(X, Y, o, "vrs")$theta)
ef <- which(bcc > 0.9999)
bez <- do.call(rbind, lapply(ef, function(j) {
  zostaja <- setdiff(1:n, j)
  nowe <- sapply(zostaja, function(o) dea(X, Y, o, "vrs", ref = zostaja)$theta)
  wzrost <- nowe - bcc[zostaja]
  data.frame(usuniety = rownames(X)[j], zmienione = sum(wzrost > 0.001),
             max_wzrost = round(max(wzrost), 3), nowe_efektywne = sum(nowe > 0.9999 & bcc[zostaja] < 0.9999))
}))
bez[order(-bez$max_wzrost), ]
# Które oddziały zyskują po usunięciu O-07 (błąd w danych) i O-18 (największy oddział na granicy)?
for (j in c(7, 18)) {
  zostaja <- setdiff(1:n, j)
  po <- sapply(zostaja, function(o) dea(X, Y, o, "vrs", ref = zostaja)$theta)
  zm <- data.frame(usuniety = rownames(X)[j], oddzial = rownames(X)[zostaja], przed = round(bcc[zostaja], 3), po = round(po, 3))
  print(zm[po - bcc[zostaja] > 0.001, ], row.names = FALSE)
}

# B. Symulacja: 25 oddziałów, prawdziwa efektywność znana; coraz więcej nakładów i wyników w modelu CCR
set.seed(651)
uklady <- data.frame(nakl = c(1, 2, 2, 3, 4, 4, 5), wyn = c(1, 1, 2, 2, 2, 3, 3))
powt <- 200
sym <- do.call(rbind, lapply(seq_len(nrow(uklady)), function(i) {
  m <- uklady$nakl[i]; s <- uklady$wyn[i]
  r <- replicate(powt, {
    Xs <- matrix(exp(rnorm(25 * m, log(40), 0.4)), 25, m)          # nakłady
    u <- abs(rnorm(25, 0, 0.2)); v <- rnorm(25, 0, 0.05)             # nieefektywność i mały szum pomiaru
    Q <- exp(rowMeans(log(Xs))) * exp(-u + v)                        # łączny wynik przy stałych przychodach skali
    udz <- matrix(runif(25 * s, 0.5, 1.5), 25, s); udz <- udz / rowSums(udz)
    Ys <- Q * udz                                                    # podział wyniku na s rodzajów
    th <- sapply(1:25, function(o) dea(Xs, Ys, o, "crs")$theta)
    c(efektywne = mean(th > 0.9999), spearman = cor(th, exp(-u), method = "spearman"))
  })
  data.frame(zmienne = m + s, uklad = paste0(m, " + ", s), efektywne = mean(r[1, ]),
             se_ef = sd(r[1, ]) / sqrt(powt), spearman = mean(r[2, ]), se_sp = sd(r[2, ]) / sqrt(powt))
}))
sym[, 3:6] <- round(sym[, 3:6], 3)
sym

# Rysunek 5
pA <- ggplot(bez, aes(max_wzrost, reorder(usuniety, max_wzrost))) +
  geom_segment(aes(x = 0, xend = max_wzrost, yend = reorder(usuniety, max_wzrost)), colour = "grey70", linewidth = 0.8) +
  geom_point(aes(colour = usuniety == "O-07"), size = 2.8) +
  geom_text(aes(label = paste0(zmienione, " oddz.")), nudge_x = 0.006, hjust = 0, size = 3.2, colour = "grey25") +
  scale_colour_manual(values = c(`TRUE` = kol[["cynober"]], `FALSE` = kol[["niebieski"]]), guide = "none") +
  scale_x_continuous(limits = c(0, 0.13)) +
  labs(title = "A. Usunięcie jednego oddziału z granicy",
       subtitle = "największy wzrost θ innego oddziału;\nobok: ilu oddziałom θ wzrosło", x = "Największy wzrost θ (BCC)", y = "Usunięty oddział") + motyw
dlB <- rbind(data.frame(zmienne = sym$zmienne, miara = "odsetek oddziałów z θ = 1", w = sym$efektywne, se = sym$se_ef),
             data.frame(zmienne = sym$zmienne, miara = "korelacja rang θ z prawdziwą efektywnością", w = sym$spearman, se = sym$se_sp))
pB <- ggplot(dlB, aes(zmienne, w, colour = miara, shape = miara)) +
  geom_line(linewidth = 0.8) + geom_point(size = 2.6) +
  geom_errorbar(aes(ymin = w - 1.96 * se, ymax = w + 1.96 * se), width = 0.15) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_x_continuous(breaks = 2:8) + scale_y_continuous(limits = c(0, 1)) +
  labs(title = "B. Za dużo zmiennych na 25 oddziałów", subtitle = "symulacja, 200 powtórzeń na układ",
       x = "Liczba nakładów + wyników", y = NULL) + motyw + guides(colour = guide_legend(nrow = 2))
p5 <- pA | pB
p5   # zapis: ggsave("efektywnosc-dea-wrazliwosc.svg", p5, width = 10, height = 6.4)
Wynik w R
   usuniety zmienione max_wzrost nowe_efektywne
10     O-18         4      0.113              3
3      O-07         5      0.084              1
1      O-03         6      0.041              1
6      O-12         6      0.032              1
5      O-09         4      0.019              0
8      O-16         2      0.019              1
9      O-17         2      0.015              1
13     O-25         3      0.015              1
2      O-04         3      0.009              0
7      O-14         2      0.004              0
4      O-08         0      0.000              0
11     O-22         0      0.000              0
12     O-24         0      0.000              0
 usuniety oddzial przed    po
     O-07    O-01 0.981 1.000
     O-07    O-02 0.900 0.910
     O-07    O-06 0.862 0.891
     O-07    O-20 0.911 0.995
     O-07    O-21 0.849 0.930
 usuniety oddzial przed    po
     O-18    O-05 0.819 0.827
     O-18    O-13 0.887 1.000
     O-18    O-19 0.921 1.000
     O-18    O-23 0.993 1.000
  zmienne uklad efektywne se_ef spearman se_sp
1       2 1 + 1     0.040 0.000    0.887 0.004
2       3 2 + 1     0.187 0.003    0.790 0.007
3       4 2 + 2     0.369 0.005    0.688 0.008
4       5 3 + 2     0.557 0.006    0.559 0.011
5       6 4 + 2     0.678 0.005    0.469 0.012
6       7 4 + 3     0.790 0.005    0.366 0.015
7       8 5 + 3     0.853 0.005    0.272 0.015
7. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (CCR / BCC; granice na rys. 2)" = c("#0072B2", "#D55E00"),
             "pomarańczowy – niebieski (przychody rosnące / malejące; nakład / wynik)" = c("#E69F00", "#0072B2"),
             "pomarańczowy – grafit (rosnące / stałe)" = c("#E69F00", "#333333"),
             "jasnoniebieski – jasnopomarańczowy (nakład / wynik na schemacie)" = c("#CFE3F2", "#F6C9A9"),
             "skala wag λ: jasny – ciemny niebieski" = c("#DCEBF7", "#0B4F8A"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                        widzenie_typowe
niebieski – cynober (CCR / BCC; granice na rys. 2)                                114.6
pomarańczowy – niebieski (przychody rosnące / malejące; nakład / wynik)           120.2
pomarańczowy – grafit (rosnące / stałe)                                            91.0
jasnoniebieski – jasnopomarańczowy (nakład / wynik na schemacie)                   35.4
skala wag λ: jasny – ciemny niebieski                                              67.2
czerwony – zielony (do unikania)                                                  121.7
                                                                        deuteranopia
niebieski – cynober (CCR / BCC; granice na rys. 2)                             108.3
pomarańczowy – niebieski (przychody rosnące / malejące; nakład / wynik)        121.5
pomarańczowy – grafit (rosnące / stałe)                                         89.7
jasnoniebieski – jasnopomarańczowy (nakład / wynik na schemacie)                34.6
skala wag λ: jasny – ciemny niebieski                                           69.8
czerwony – zielony (do unikania)                                                21.1
                                                                        protanopia
niebieski – cynober (CCR / BCC; granice na rys. 2)                            91.9
pomarańczowy – niebieski (przychody rosnące / malejące; nakład / wynik)      109.3
pomarańczowy – grafit (rosnące / stałe)                                       83.3
jasnoniebieski – jasnopomarańczowy (nakład / wynik na schemacie)              29.9
skala wag λ: jasny – ciemny niebieski                                         64.5
czerwony – zielony (do unikania)                                              31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie i korelacje – pakiety base i stats; programowanie liniowe – pakiet lpSolve). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lpSolve (wersja 5.6.23): Berkelaar, M. (2024). lpSolve: Interface to 'Lp_solve' v. 5.5 to solve linear/integer programs [R package]. https://doi.org/10.32614/CRAN.package.lpSolve
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Za dużo zmiennych na mało jednostek. Przy 25 oddziałach i 8 zmiennych w symulacji efektywnych było 85.3% jednostek. Łącz podobne zmienne albo zredukuj je (np. PCA) – to odpowiednik przeuczenia w modelach predykcyjnych.
- Odsetki w modelu CCR. Gdy zamiast liczby doręczeń w terminie wstawiliśmy terminowość w %, małe oddziały O-14, O-16 i O-24 stały się w CCR efektywne (wcześniej .746–.813). Odsetek nie skaluje się z wielkością oddziału; przy wskaźnikach używaj BCC (Hollingsworth i Smith, 2003).
- Obserwacja odstająca wyznacza granicę. W regresji jedna obserwacja odstająca przesuwa linię; w DEA staje się wzorcem dla innych. Sprawdzaj superefektywność i analizę bez jednego oddziału.
- Brak błędu losowego. Każde odchylenie od granicy DEA traktuje jako nieefektywność – także zły miesiąc albo błąd w systemie. Przy danych z szumem rozważ SFA (Jacobs, 2001).
- Jednostki nieporównywalne. Oddział miejski i wiejski mają inne odległości. Dodaj zmienną środowiskową albo licz DEA w grupach podobnych oddziałów.
Najczęstsze pytania
Co to jest analiza obwiedni danych (DEA)?
To metoda oceny względnej efektywności podobnych jednostek (oddziałów, szpitali, szkół), które z kilku nakładów wytwarzają kilka wyników. Programowanie liniowe wyznacza z danych granicę najlepszej praktyki i dla każdej jednostki liczy efektywność θ, wzorce i cele. Nie trzeba zakładać postaci funkcji produkcji ani ustalać wag z góry (Banker i in., 1984).
Czym różni się model CCR od BCC?
CCR zakłada stałe przychody skali, więc porównuje oddział także z dużo większymi i mniejszymi. BCC dodaje warunek, że suma wag λ wynosi 1, więc porównuje z jednostkami podobnej wielkości i daje wyniki nie niższe niż CCR. Iloraz CCR / BCC to efektywność skali – w przykładzie najniższą miały małe oddziały.
Ile jednostek potrzeba do DEA?
Im więcej nakładów i wyników, tym więcej jednostek wychodzi efektywnych. W symulacji z 25 jednostkami przy 2 zmiennych efektywne było 4.0% jednostek, przy 5 zmiennych 55.7%, a przy 8 – 85.3%, a zgodność z prawdziwą efektywnością spadała. Ogranicz liczbę zmiennych i sprawdź, ile jednostek wychodzi efektywnych.
Czy w DEA można użyć wskaźników procentowych, np. terminowości?
Ostrożnie. Odsetek nie rośnie z wielkością jednostki, więc w modelu CCR faworyzuje małe jednostki – w przykładzie trzy małe oddziały stały się przez to efektywne. Przy wskaźnikach ilorazowych używaj modelu BCC (Hollingsworth i Smith, 2003) albo zamień odsetek na liczbę, np. doręczeń w terminie.
Jak sprawdzić, czy wyniki DEA są wiarygodne?
Licz model bez kolejnych jednostek efektywnych i sprawdź superefektywność, czyli ocenę jednostki efektywnej względem pozostałych (Andersen i Petersen, 1993) – bardzo wysoka wartość to sygnał, żeby sprawdzić dane. DEA nie oddziela nieefektywności od szumu, więc porównaj wyniki z innymi specyfikacjami, a przedziały ufności licz bootstrapem dostosowanym do modeli granicy (Simar i Wilson, 1998).
Powiązane hasła
Przeczytaj też
Statystyka w pracy z logistyki
Czasy dostaw i percentyle, błędy kompletacji na 1000 linii, przerwany szereg czasowy w magazynie, dostawcy jako skupienia i prognoza popytu: analizy, zdania APA i kod R.
Czytaj →PoradnikStatystyka w pracy z zarządzania i ekonomii
Ankieta wśród pracowników i model ekonometryczny na danych wtórnych: regresja, weryfikacja modelu, elastyczności, kod R i gotowe opisy wyników.
Czytaj →PoradnikZdolność procesu – Cp i Cpk
Toczenie wałków: karta X̄–R, Cp, Cpk, Pp, Ppk, ppm, przedziały ufności dla Cpk z symulacją i rozkład skośny – pięć rysunków z kodem R.
Czytaj →Oceniasz efektywność oddziałów w pracy dyplomowej?
Pomożemy dobrać nakłady i wyniki, policzyć modele CCR i BCC, sprawdzić wrażliwość i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Andersen, P., & Petersen, N. C. (1993). A procedure for ranking efficient units in data envelopment analysis. Management Science, 39(10), 1261–1264. https://doi.org/10.1287/mnsc.39.10.1261
- Banker, R. D. (1993). Maximum likelihood, consistency and data envelopment analysis: A statistical foundation. Management Science, 39(10), 1265–1273. https://doi.org/10.1287/mnsc.39.10.1265
- Banker, R. D., & Morey, R. C. (1986). Efficiency analysis for exogenously fixed inputs and outputs. Operations Research, 34(4), 513–521. https://doi.org/10.1287/opre.34.4.513
- Banker, R. D., Charnes, A., & Cooper, W. W. (1984). Some models for estimating technical and scale inefficiencies in data envelopment analysis. Management Science, 30(9), 1078–1092. https://doi.org/10.1287/mnsc.30.9.1078
- Hollingsworth, B., & Smith, P. (2003). Use of ratios in data envelopment analysis. Applied Economics Letters, 10(11), 733–735. https://doi.org/10.1080/1350485032000133381
- Jacobs, R. (2001). Alternative methods to examine hospital efficiency: Data envelopment analysis and stochastic frontier analysis. Health Care Management Science, 4(2), 103–115. https://doi.org/10.1023/a:1011453526849
- Pedraja-Chaparro, F., Salinas-Jiménez, J., & Smith, P. (1999). On the quality of the data envelopment analysis model. Journal of the Operational Research Society, 50(6), 636–644. https://doi.org/10.1057/palgrave.jors.2600741
- Simar, L., & Wilson, P. W. (1998). Sensitivity analysis of efficiency scores: How to bootstrap in nonparametric frontier models. Management Science, 44(1), 49–61. https://doi.org/10.1287/mnsc.44.1.49
Cytowania BibTeX
@article{andersen1993procedure, author={Andersen, Per and Petersen, Niels Christian}, title={{A procedure for ranking efficient units in data envelopment analysis}}, journal={Management Science}, year={1993}, volume={39}, number={10}, pages={1261--1264}, doi={10.1287/mnsc.39.10.1261}}@article{banker1993maximum, author={Banker, Rajiv D.}, title={{Maximum likelihood, consistency and data envelopment analysis: A statistical foundation}}, journal={Management Science}, year={1993}, volume={39}, number={10}, pages={1265--1273}, doi={10.1287/mnsc.39.10.1265}}@article{banker1986efficiency, author={Banker, Rajiv D. and Morey, Richard C.}, title={{Efficiency analysis for exogenously fixed inputs and outputs}}, journal={Operations Research}, year={1986}, volume={34}, number={4}, pages={513--521}, doi={10.1287/opre.34.4.513}}@article{banker1984some, author={Banker, R. D. and Charnes, A. and Cooper, W. W.}, title={{Some models for estimating technical and scale inefficiencies in data envelopment analysis}}, journal={Management Science}, year={1984}, volume={30}, number={9}, pages={1078--1092}, doi={10.1287/mnsc.30.9.1078}}@article{hollingsworth2003use, author={Hollingsworth, B. and Smith, P.}, title={{Use of ratios in data envelopment analysis}}, journal={Applied Economics Letters}, year={2003}, volume={10}, number={11}, pages={733--735}, doi={10.1080/1350485032000133381}}@article{jacobs2001alternative, author={Jacobs, Rowena}, title={{Alternative methods to examine hospital efficiency: Data envelopment analysis and stochastic frontier analysis}}, journal={Health Care Management Science}, year={2001}, volume={4}, number={2}, pages={103--115}, doi={10.1023/a:1011453526849}}@article{pedrajachaparro1999quality, author={Pedraja-Chaparro, F. and Salinas-Jim{\'e}nez, J. and Smith, P.}, title={{On the quality of the data envelopment analysis model}}, journal={Journal of the Operational Research Society}, year={1999}, volume={50}, number={6}, pages={636--644}, doi={10.1057/palgrave.jors.2600741}}@article{simar1998sensitivity, author={Simar, L{\'e}opold and Wilson, Paul W.}, title={{Sensitivity analysis of efficiency scores: How to bootstrap in nonparametric frontier models}}, journal={Management Science}, year={1998}, volume={44}, number={1}, pages={49--61}, doi={10.1287/mnsc.44.1.49}}