Przykład: tokarnia, wałki i pytanie klienta „czy Cpk ≥ 1.33?”
Fikcyjny zakład obróbki metali toczy wałki dla producenta przekładni. Na rysunku średnica ma 25.000 mm z tolerancją ±0.050 mm, czyli dolna granica (LSL) to 24.950, a górna (USL) 25.050. Klient pyta: czy proces jest zdolny – czy Cpk wynosi co najmniej 1.33? Kierownik jakości ma dane z dwóch tygodni: co godzinę operator mierzy 5 kolejnych wałków. Faza 1 to 25 godzin przed zmianą, faza 2 – 25 godzin po włączeniu automatycznej korekty zużycia płytki skrawającej.
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy: rozrzut wewnątrz godziny σ = 0.010 mm w obu fazach; w fazie 1 płytka zużywa się o 0.0025 mm na godzinę i jest wymieniana co 10 godzin (średnia rośnie od 25.004 do 25.0265 i wraca); w fazie 2 średnia jest stała, 25.008 mm, z drobnym szumem między godzinami (SD 0.0015). Prawdziwe Cpk w fazie 2 wynosi więc 1.40. Ziarno 646 ustalono raz i nie zmienialiśmy ani jego, ani parametrów po obejrzeniu wyników. Dane: zdolnosc-procesu-walki.csv (wiersz = wałek) i zdolnosc-procesu-bicie.csv.
Rysunek 1: najpierw stabilność – karta X̄–R
Wskaźnik zdolności opisuje proces, który jutro zachowa się tak jak dziś. Jeśli średnia „pływa”, liczba z dzisiejszej próby nic nie mówi o jutrze. Dlatego zaczynamy od karty kontrolnej Shewharta: X̄ (średnie godzin) i R (rozstęp w godzinie). Także klasyczne granice ufności dla Cpk wyprowadzono przy założeniu, że proces jest normalny i statystycznie uregulowany (Chou i in., 1990).
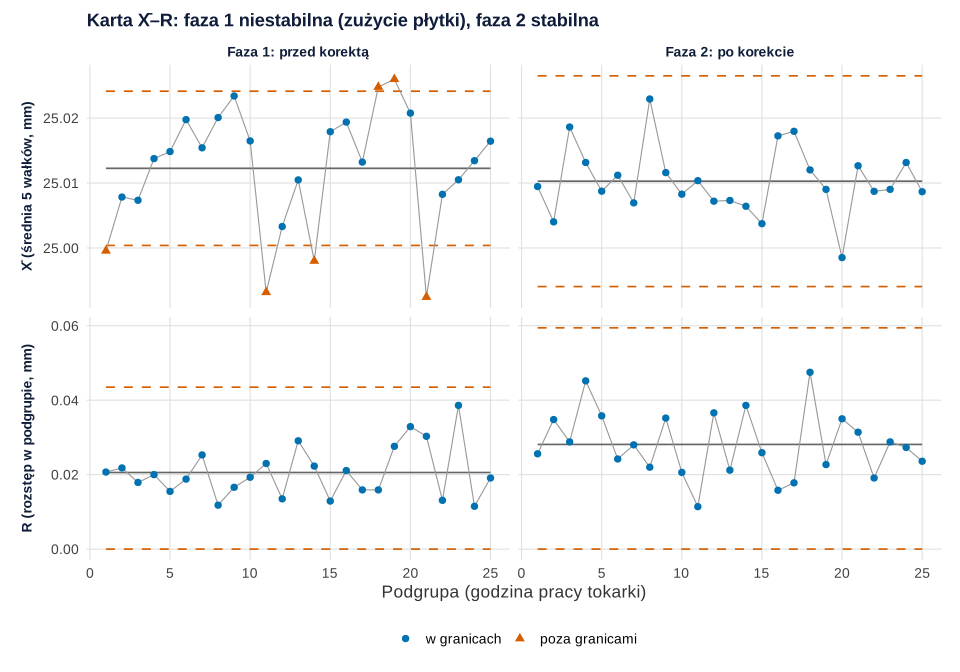
set.seed(646)).Co widać. W fazie 1 średnie godzin układają się w „piłę”: 6 z 25 wychodzi poza granice 25.0004–25.0241 mm (godziny 1, 11, 14, 18, 19 i 21). Rozstępy są w normie – rozrzut wewnątrz godziny się nie zmienia, przesuwa się tylko średnia. W fazie 2 obie karty są czyste: granice X̄ 24.9941–25.0265, żaden punkt poza nimi.
Jak może zmylić. Granice karty X̄ liczy się z rozrzutu wewnątrz godzin (R̄ / d2). Ten sam rozrzut wejdzie do Cp i Cpk – więc proces, który wędruje między godzinami, może mieć piękne Cp. Brak sygnałów to też nie dowód stabilności na zawsze: 25 godzin to krótki okres. Monitorowanie po fazie analizy opisuje wpis anomalie w KPI – karta kontrolna.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: Cp, Cpk, Pp i Ppk – proces w bramce
Wyobraź sobie tolerancję jako bramkę, a rozkład wałków jako piłkę: liczy się, czy piłka jest wąska (rozrzut) i czy leci środkiem (położenie). Cp i Cpk (Kane, 1986) mierzą to tak:
Cpk = min(USL − M, M − LSL) / 3σ
Cp porównuje szerokość bramki z szerokością procesu (6σ) i nie patrzy, gdzie jest średnia. Cpk mierzy odległość średniej M od bliższej granicy w jednostkach 3σ. Pp i Ppk mają te same wzory, ale σ to zwykłe odchylenie standardowe wszystkich sztuk (zmienność długoterminowa). W Cp i Cpk σ to rozrzut wewnątrz podgrup – krótkoterminowy, z karty R. Duża różnica między Cpk a Ppk znaczy: średnia wędruje między godzinami.
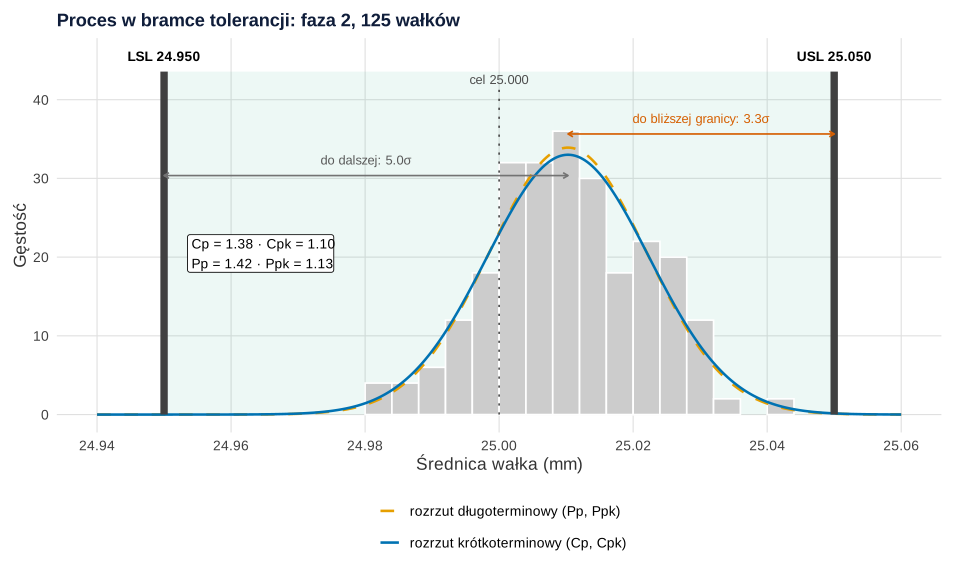
set.seed(646)).Co widać. W fazie 2 średnia to 25.0103 mm, σ krótkoterminowa 0.0121, długoterminowa 0.0118. Cp = 1.38, ale Cpk = 1.10: średnia jest 3.3σ od górnej granicy i 5.0σ od dolnej. Pp = 1.42 i Ppk = 1.13 są bliskie Cp i Cpk – tak wygląda proces stabilny. W fazie 1 jest inaczej: Cp = 1.88 i Cpk = 1.42 wyglądają dobrze, a Pp = 1.39 i Ppk = 1.05 zdradzają wędrówkę średniej. Tam liczy się Ppk, a Cpk tylko obiecuje, co dałby proces po ustabilizowaniu.
Od Cpk do ppm. Przy rozkładzie normalnym wskaźnik przekłada się na oczekiwany odsetek sztuk niezgodnych – i tak warto go czytać (Pearn i in., 1992). Cpk = 1.10 to ok. 508 ppm (sztuk na milion), Ppk = 1.13 – ok. 367 ppm. Wyśrodkowanie procesu przy tym samym rozrzucie dałoby Cpk = Cp = 1.38 i ok. 35 ppm.
Jak może zmylić. W 125 wałkach nie ma ani jednego braku, ale to nie dowodzi niskiego ppm. Górna 95% granica odsetka braków przy 0 na 125 to 23 681 ppm. Liczby ppm pochodzą z modelu normalnego, a nie z policzenia braków. I jeszcze jedno: prawdziwy rozrzut w obu fazach jest ten sam (0.010 mm), a oszacowania wyszły 0.0089 i 0.0121. To zwykła losowość z 25 godzin – stąd potrzeba przedziałów ufności (Rysunek 4).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: przesunięcie średniej czy rozrzut?
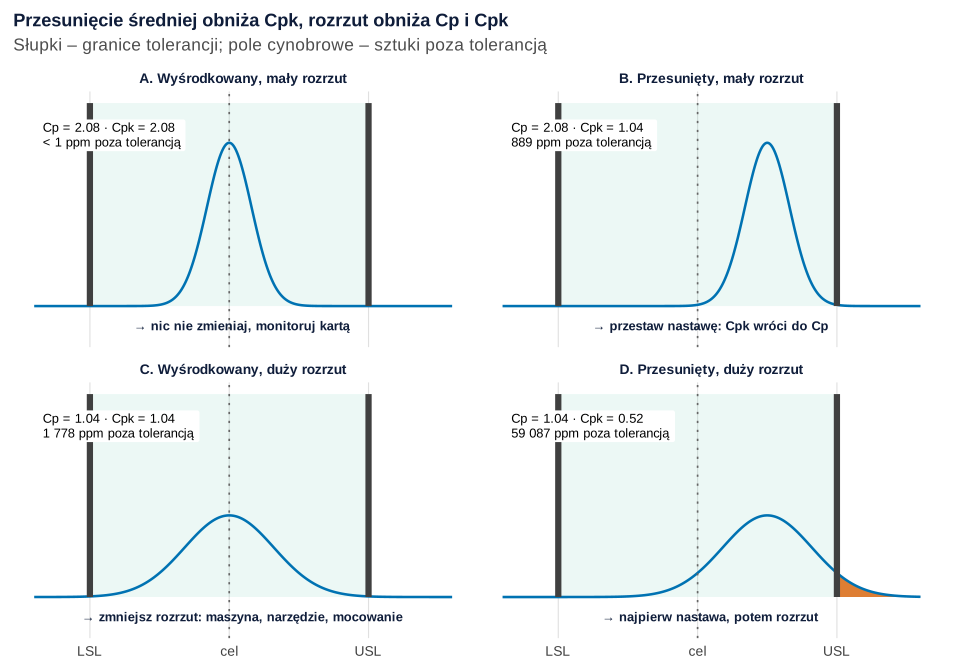
Co widać. Przesunięcie średniej o 0.025 mm obniża Cpk z 2.08 do 1.04 przy tym samym Cp (panel B). Podwojenie σ obniża oba wskaźniki (panel C). Cpk jest w B i C takie samo, ale przyczyna i decyzja są różne: w B wystarczy przestawić nastawę, w C trzeba szukać źródła rozrzutu (maszyna, narzędzie, mocowanie, materiał). Różnica Cp − Cpk mówi, ile zyskasz na samym wyśrodkowaniu.
Jak może zmylić. Ten sam Cpk nie oznacza tego samego ppm: B ma 889 ppm (jeden ogon), C – 1778 ppm (dwa ogony). Schemat zakłada rozkład normalny.
Podpis do pracy:
Rysunek 4: przedziały ufności – jak pewne jest Cpk?
Cpk z próby to oszacowanie – ma błąd standardowy, jak każda statystyka (Bissell, 1990). Bissell podaje proste przybliżenie, którego używa też funkcja process.capability() z pakietu qcc:
Dla fazy 2 (n = 125): SE = 0.076, 95% CI [0.947, 1.244], a jednostronna dolna granica 95% – 0.971. Drugi sposób to bootstrap. Losujemy ze zwracaniem całe godziny (a nie pojedyncze wałki), bo σ liczymy wewnątrz godzin. 2000 powtórzeń dało SE = 0.067, przedział percentylowy [0.976, 1.239] i przedział BCa [0.965, 1.225]. Bootstrapowe przedziały dla Cpk opisali Franklin i Wasserman (1991), przypominając, że klasyczne granice opierają się na założeniu normalności procesu.
Uczciwie o naszej próbie. Prawdziwe Cpk to 1.40, a przedział ufności go nie objął: w tej próbie rozstępy wyszły wyjątkowo duże. Tak bywa w ok. 5% prób. Jak często i jak szeroko – pokazuje symulacja: 1000 prób z procesu o Cpk = 1.40 dla n = 30, 50 i 125.
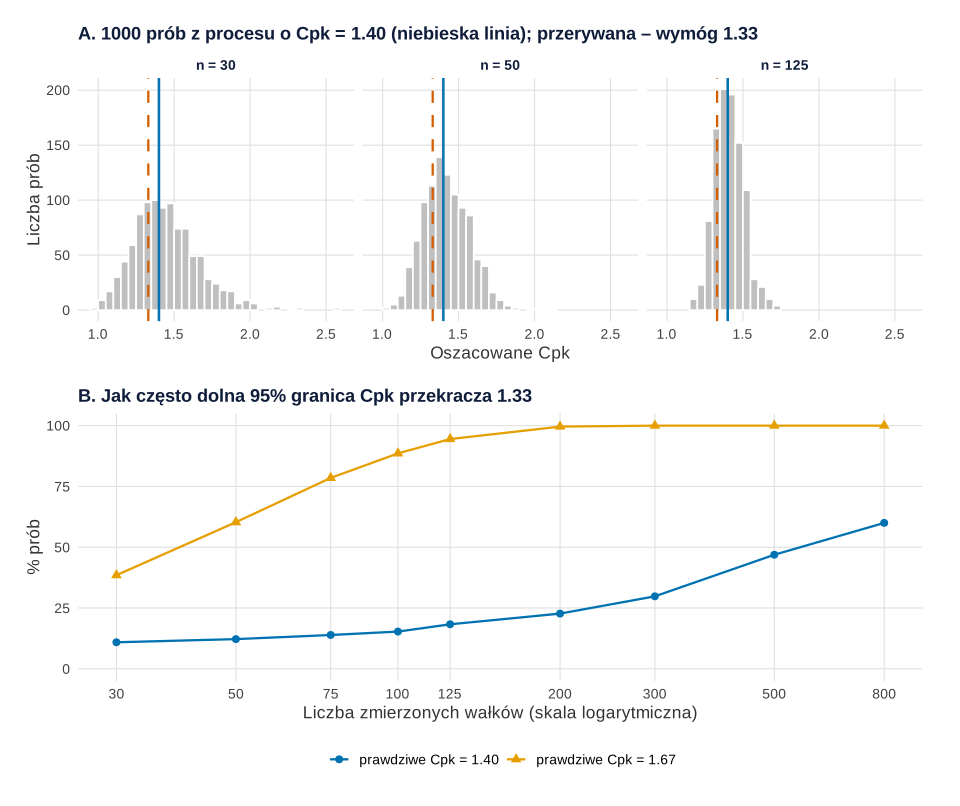
set.seed(646)).Co widać – panel A. Przy n = 30 co dziesiąta próba daje Cpk poza zakresem 1.14–1.84, przy n = 125 – poza 1.26–1.57. Mediana szerokości 95% przedziału Bissella: 0.77, 0.59 i 0.37. Proces naprawdę zdolny (1.40) w 30.9%, 29.0% i 19.9% prób pokazuje Cpk poniżej 1.33. Przedział Bissella trzyma pokrycie: 94.3%, 96.0% i 94.8% (błąd Monte Carlo 0.7 pp). Bootstrap percentylowy z pojedynczych sztuk przy małych próbach jest za wąski: 86.3% przy n = 30 i 93.7% przy 125.
Co widać – panel B. Klient chce dowodu, a nie oszacowania: dolnej granicy powyżej 1.33. Gdy prawdziwe Cpk to 1.40, przy 125 wałkach udaje się to w 18.9% prób, a przy 800 – w 60.0%. Proces o Cpk 1.67 „zdaje” przy 125 sztukach w 94.5% prób. Im bliżej wymogu jest prawdziwy wskaźnik, tym więcej pomiarów potrzeba.
Jak może zmylić. Symulacja zakłada proces normalny i stabilny. Przy wędrującej średniej albo skośnym rozkładzie przedziały są zbyt optymistyczne.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: bicie promieniowe – gdy rozkład jest skośny
Ten sam zakład mierzy bicie promieniowe wałka. Bicie nie może być ujemne, ma tylko górną granicę (USL = 0.040 mm) i z natury ma długi prawy ogon. Ustawiliśmy ręcznie rozkład lognormalny (mediana 0.012 mm, σ logarytmu 0.42), w którym prawdziwe ppm powyżej USL to 2075, a prawdziwy wskaźnik liczony z kwantyli – 0.92.
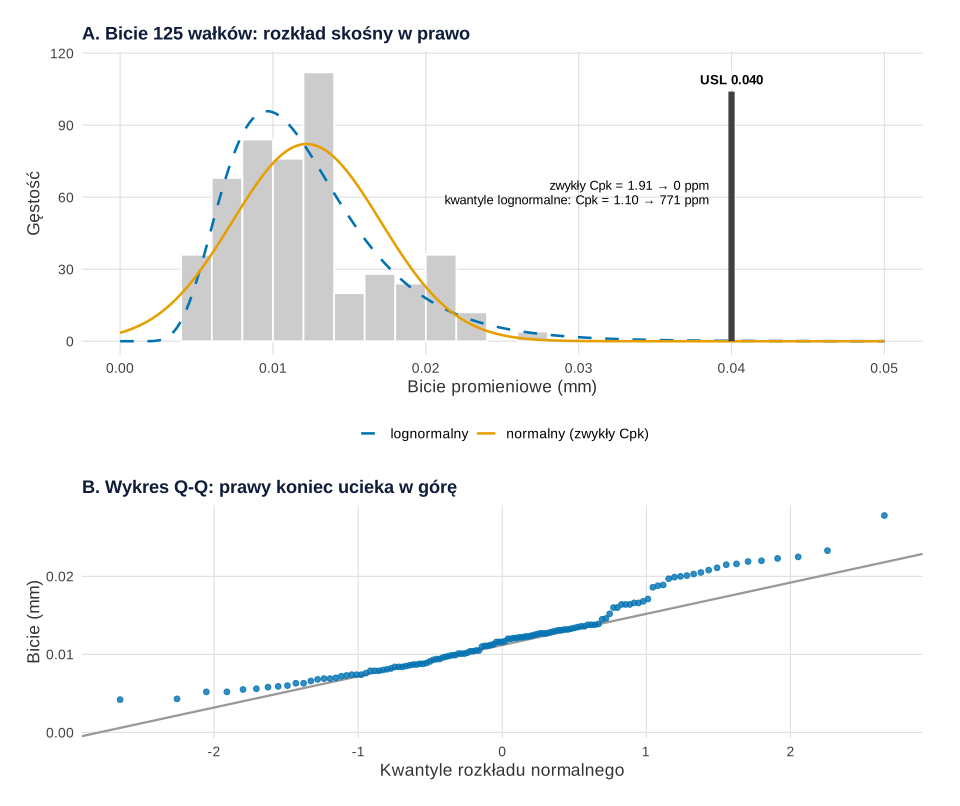
set.seed(646)).Co widać. M = 0.0122 mm, SD = 0.0049, skośność 0.75; test Shapiro-Wilka W = .946, p < .001. Zwykły wzór (tu Cpk = CPU = (USL − M) / 3σ) daje 1.91 i praktycznie 0 ppm. Metoda kwantylowa na dopasowanym rozkładzie lognormalnym zastępuje 3σ odległością od mediany do percentyla 99.865%: daje 1.10 i 771 ppm. Prawda (0.92, 2075 ppm) jest jeszcze gorsza – próba trafiła się „łagodna”. W 1000 próbach po 125 wałków zwykły Cpk miał medianę 1.58 i w 92.5% prób przekraczał 1.33 (błąd MC 0.8 pp), choć proces ma ok. 2075 ppm wad.
Jak może zmylić. Ogon za USL to obszar, którego w 125 sztukach prawie nie widać – o ppm decyduje wybrany model. English i Taylor (1993) pokazują, że Cp i Cpk nie są odporne na odejście od normalności, i zalecają najpierw sprawdzić rozkład procesu. Jak to zrobić, opisuje wpis jak sprawdzić normalność rozkładu.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w firmie
- Nie licz Cpk na niestabilnym procesie. Najpierw karta X̄–R; w fazie 1 przyczyną była wymiana płytki, a lekarstwem – korekta zużycia.
- Raportuj Cpk z dolną granicą ufności, nie samą liczbę. Wynik „Cpk = 1.10, dolna granica 0.97” to jasna odpowiedź dla klienta: wymogu 1.33 nie spełniamy.
- Najpierw wyśrodkuj. Różnica Cp − Cpk (1.38 − 1.10) to zysk z samej nastawy: ok. 508 → 35 ppm bez kosztownych zmian maszyny.
- Planuj liczbę pomiarów pod decyzję. Przy procesie bliskim wymogu 125 sztuk nie wystarczy; ustal z klientem n i sposób liczenia przedziału z góry.
- Pokazuj Cpk razem z Ppk. Duża różnica to sygnał, że proces wędruje między zmianami, partiami materiału albo operatorami.
- Sprawdź miernik. Część zmienności to błąd pomiaru, który zaniża Cp – zob. analiza systemu pomiarowego (Gage R&R).
- Dla cech jednostronnych i skośnych (bicie, chropowatość, siła zrywania) licz wskaźnik z kwantyli dopasowanego rozkładu i podaj, jaki to rozkład.
Inne typowe analizy z produkcji i magazynu – czasy realizacji, odsetki błędów, porównanie dostawców – zebraliśmy we wpisie statystyka w pracy z logistyki.
Jak opisać w pracy
W Metodzie podaj granice specyfikacji, plan pobierania próbek (liczba i wielkość podgrup, okres), sposób oceny stabilności, estymator σ (R̄/d2 czy SD całości), sposób liczenia przedziałów ufności i sprawdzenie rozkładu. W Wynikach – wskaźniki z przedziałami, ppm i odpowiedź na pytanie o wymóg. Przegląd publikacji o wskaźnikach zdolności i ocenę najczęściej używanych z nich znajdziesz u Kotza i Johnsona (2002). O strukturze całej pracy pisze wpis jak napisać pracę z zarządzania i ekonomii.
Jeśli potrzebujesz pomocy przy takiej analizie w pracy dyplomowej: analizy statystyczne dla studentów.
Kod R: karta X̄–R, wskaźniki zdolności, przedziały ufności i rozkład skośny
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Granice karty i wskaźniki liczymy ręcznie i sprawdzamy funkcjami qcc() i process.capability() z pakietu qcc; bootstrap danych – pakietem boot. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; zapis do SVG – ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1, 5 i 6; każde losowanie poprzedza set.seed(646). Ziarno 646 ustalono raz i nie zmieniano go. Ręcznie ustalono: tolerancję 25.000 ± 0.050 mm, 25 podgrup po 5 sztuk w każdej fazie, σ wewnątrz podgrup 0.010 mm, zużycie płytki 0.0025 mm/h z wymianą co 10 godzin od 25.004 mm (faza 1), średnią 25.008 mm z szumem między godzinami SD 0.0015 mm (faza 2), w symulacji procesy o Cpk 1.40 (średnia 25.008, σ 0.010) i 1.67, wymóg 1.33, a dla bicia rozkład lognormalny o medianie 0.012 mm i σ logarytmu 0.42 z USL 0.040 mm.
1. Paleta, motyw i dane
R
# Dane. Fikcyjny zakład obróbki metali: średnica toczonych wałków, 2 × 25 podgrup po 5 sztuk (dane symulowane)
# Paleta, motyw i dane z tego przepisu wykorzystują kolejne przepisy (uruchamiaj je po kolei w jednej sesji R).
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Wymiar z rysunku: średnica 25.000 mm ± 0.050 mm
LSL <- 24.950; USL <- 25.050; cel <- 25.000

# Parametry ustalone ręcznie
set.seed(646)
k <- 25; n <- 5                                   # 25 podgrup (co godzinę) po 5 kolejnych wałków
sigma_w <- 0.010                                  # rozrzut wewnątrz podgrupy (krótkoterminowy), mm
# Faza 1: płytka skrawająca zużywa się (+0.0025 mm na godzinę), wymiana co 10 godzin – „piła”
zuzycie <- 0.0025 * ((seq_len(k) - 1) %% 10)
mu_f1 <- 25.004 + zuzycie
# Faza 2: po wprowadzeniu korekcji zużycia narzędzia – średnia stała 25.008, mały szum między godzinami (SD 0.0015)
mu_f2 <- 25.008 + rnorm(k, 0, 0.0015)
srednica_f1 <- as.vector(sapply(mu_f1, function(m) rnorm(n, m, sigma_w)))
srednica_f2 <- as.vector(sapply(mu_f2, function(m) rnorm(n, m, sigma_w)))
walki <- data.frame(faza = rep(c("Faza 1: przed korektą", "Faza 2: po korekcie"), each = k * n),
                    podgrupa = rep(rep(seq_len(k), each = n), 2),
                    sztuka = rep(seq_len(n), 2 * k),
                    srednica = round(c(srednica_f1, srednica_f2), 4))
write.csv(walki, "zdolnosc-procesu-walki.csv", row.names = FALSE)

# Przegląd: średnia, SD i zakres średnicy w obu fazach, liczba wałków poza tolerancją
aggregate(srednica ~ faza, data = walki, FUN = function(x)
  c(n = length(x), M = round(mean(x), 4), SD = round(sd(x), 4), min = min(x), max = max(x),
    poza_tolerancja = sum(x < LSL | x > USL)))
Wynik w R
                   faza srednica.n srednica.M srednica.SD srednica.min
1 Faza 1: przed korektą   125.0000    25.0123      0.0120      24.9804
2   Faza 2: po korekcie   125.0000    25.0103      0.0118      24.9801
  srednica.max srednica.poza_tolerancja
1      25.0396                   0.0000
2      25.0410                   0.0000
2. Karta X̄–R: Rysunek 1
R
# Rysunek 1. Najpierw stabilność: karta X̄–R dla obu faz (granice liczone osobno dla każdej fazy)
# Korzysta z obiektów przepisu 1: walki, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(qcc)

stale <- c(A2 = 0.577, D3 = 0, D4 = 2.114, d2 = 2.326)       # stałe kart dla podgrup n = 5
karta <- function(d) {
  m <- tapply(d$srednica, d$podgrupa, mean); r <- tapply(d$srednica, d$podgrupa, function(x) diff(range(x)))
  sr <- mean(m); rb <- mean(r)
  data.frame(podgrupa = as.integer(names(m)), xbar = m, R = r, CL_x = sr,
             LCL_x = sr - stale[["A2"]] * rb, UCL_x = sr + stale[["A2"]] * rb,
             CL_R = rb, LCL_R = stale[["D3"]] * rb, UCL_R = stale[["D4"]] * rb, faza = d$faza[1])
}
kk <- do.call(rbind, lapply(split(walki, walki$faza), karta))

# Kontrola: granice karty X̄ z qcc są takie same jak z tablicowych stałych (do 4 miejsc)
for (f in unique(walki$faza)) {
  d <- walki[walki$faza == f, ]
  q <- qcc(qcc.groups(d$srednica, d$podgrupa), type = "xbar", plot = FALSE)
  cat(f, "| qcc:", round(q$limits, 4), "| ręcznie:",
      round(unlist(kk[kk$faza == f, c("LCL_x", "UCL_x")][1, ]), 4),
      "| sigma z R̄/d2:", round(q$std.dev, 5), "\n")
}
# Granice i liczba podgrup poza granicami w każdej fazie
kk$poza_x <- kk$xbar < kk$LCL_x | kk$xbar > kk$UCL_x
kk$poza_R <- kk$R > kk$UCL_R
aggregate(cbind(CL_x, LCL_x, UCL_x, CL_R, UCL_R) ~ faza, data = kk, FUN = function(x) round(x[1], 4))
aggregate(cbind(poza_x, poza_R) ~ faza, data = kk, FUN = sum)
kk$podgrupa[kk$poza_x & kk$faza == "Faza 1: przed korektą"]    # które godziny fazy 1 wyszły poza granice

# Rysunek 1: górny rząd – średnie podgrup, dolny – rozstępy; trójkąty – poza granicami
dl <- rbind(data.frame(faza = kk$faza, podgrupa = kk$podgrupa, wykres = "X̄ (średnia 5 wałków, mm)", y = kk$xbar,
                       CL = kk$CL_x, LCL = kk$LCL_x, UCL = kk$UCL_x, poza = kk$poza_x),
            data.frame(faza = kk$faza, podgrupa = kk$podgrupa, wykres = "R (rozstęp w podgrupie, mm)", y = kk$R,
                       CL = kk$CL_R, LCL = kk$LCL_R, UCL = kk$UCL_R, poza = kk$poza_R))
dl$wykres <- factor(dl$wykres, levels = c("X̄ (średnia 5 wałków, mm)", "R (rozstęp w podgrupie, mm)"))
dl$stan <- factor(ifelse(dl$poza, "poza granicami", "w granicach"), levels = c("w granicach", "poza granicami"))
p1 <- ggplot(dl, aes(podgrupa, y)) +
  geom_line(aes(y = UCL), linetype = "dashed", colour = kol[["cynober"]]) +
  geom_line(aes(y = LCL), linetype = "dashed", colour = kol[["cynober"]]) +
  geom_line(aes(y = CL), colour = "grey40") +
  geom_line(colour = kol[["szary"]], linewidth = 0.4) +
  geom_point(aes(shape = stan, colour = stan), size = 2.2) +
  scale_colour_manual(values = c("w granicach" = kol[["niebieski"]], "poza granicami" = kol[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c("w granicach" = 16, "poza granicami" = 17), name = NULL) +
  facet_grid(wykres ~ faza, scales = "free_y", switch = "y") +
  labs(x = "Podgrupa (godzina pracy tokarki)", y = NULL,
       title = "Karta X̄–R: faza 1 niestabilna (zużycie płytki), faza 2 stabilna") +
  motyw + theme(strip.placement = "outside")
p1   # zapis: ggsave("zdolnosc-procesu-karta-xbar-r.svg", p1, width = 10, height = 7)
Wynik w R
Faza 1: przed korektą | qcc: 25.0004 25.0241 | ręcznie: 25.0004 25.0241 | sigma z R̄/d2: 0.00885
Faza 2: po korekcie | qcc: 24.9941 25.0265 | ręcznie: 24.9941 25.0265 | sigma z R̄/d2: 0.01209
                   faza    CL_x   LCL_x   UCL_x   CL_R  UCL_R
1 Faza 1: przed korektą 25.0123 25.0004 25.0241 0.0206 0.0435
2   Faza 2: po korekcie 25.0103 24.9941 25.0265 0.0281 0.0594
                   faza poza_x poza_R
1 Faza 1: przed korektą      6      0
2   Faza 2: po korekcie      0      0
[1]  1 11 14 18 19 21
3. Cp, Cpk, Pp, Ppk i ppm: Rysunek 2
R
# Rysunek 2. Cp, Cpk, Pp i Ppk oraz ppm poza tolerancją; grafika „proces w bramce” (faza 2)
# Korzysta z obiektów przepisów 1–2: walki, kk, stale, LSL, USL, cel, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(qcc)

wskazniki <- function(d) {
  x <- d$srednica; M <- mean(x)
  s_w <- mean(tapply(x, d$podgrupa, function(v) diff(range(v)))) / stale[["d2"]]   # krótkoterminowa: R̄ / d2
  s_c <- sd(x)                                                                    # długoterminowa: SD wszystkich sztuk
  ppm <- function(s) 1e6 * c(pnorm(LSL, M, s), pnorm(USL, M, s, lower.tail = FALSE))
  c(M = M, sigma_krotko = s_w, sigma_dlugo = s_c,
    Cp = (USL - LSL) / (6 * s_w), Cpk = min(USL - M, M - LSL) / (3 * s_w),
    Pp = (USL - LSL) / (6 * s_c), Ppk = min(USL - M, M - LSL) / (3 * s_c),
    ppm_Cpk = sum(ppm(s_w)), ppm_Ppk = sum(ppm(s_c)), ppm_ponad_USL_Ppk = ppm(s_c)[2])
}
tab <- sapply(split(walki, walki$faza), wskazniki)
round(tab[1:3, ], 5); round(tab[4:7, ], 2); round(tab[8:10, ], 1)

# Co da wyśrodkowanie procesu (M = 25.000 przy tym samym rozrzucie)? Wtedy Cpk = Cp
f2 <- walki[walki$faza == "Faza 2: po korekcie", ]
s_w2 <- tab["sigma_krotko", 2]; M2 <- tab["M", 2]
c(Cpk_po_wysrodkowaniu = round((USL - cel) / (3 * s_w2), 2),
  ppm_po_wysrodkowaniu = round(2e6 * pnorm(LSL, cel, s_w2), 2))

# 125 wałków bez braku nie dowodzi niskiego ppm: górna 95% granica odsetka braków przy 0 / 125
c(braki_w_probie = sum(f2$srednica < LSL | f2$srednica > USL),
  gorna_granica_ppm = round(1e6 * (1 - 0.05^(1 / nrow(f2)))))

# To samo w qcc: Cp, Cp_l, Cp_u, Cp_k z 95% przedziałami (sigma z karty X̄ = R̄ / d2); funkcja rysuje też wykres
q2 <- qcc(qcc.groups(f2$srednica, f2$podgrupa), type = "xbar", plot = FALSE)
pc <- process.capability(q2, spec.limits = c(LSL, USL), target = cel, print = FALSE)
round(pc$indices, 3)

# Rysunek 2: histogram fazy 2 w „bramce” tolerancji; krzywe normalne z rozrzutem krótko- i długoterminowym
siatka <- data.frame(x = seq(24.94, 25.06, length.out = 400))
siatka$krotko <- dnorm(siatka$x, M2, s_w2); siatka$dlugo <- dnorm(siatka$x, M2, tab["sigma_dlugo", 2])
krzywe <- rbind(data.frame(x = siatka$x, y = siatka$krotko, rodzaj = "rozrzut krótkoterminowy (Cp, Cpk)"),
                data.frame(x = siatka$x, y = siatka$dlugo, rodzaj = "rozrzut długoterminowy (Pp, Ppk)"))
szczyt <- max(siatka$krotko)
etyk <- sprintf("Cp = %.2f · Cpk = %.2f\nPp = %.2f · Ppk = %.2f", tab["Cp", 2], tab["Cpk", 2], tab["Pp", 2], tab["Ppk", 2])
p2 <- ggplot() +
  annotate("rect", xmin = LSL, xmax = USL, ymin = 0, ymax = szczyt * 1.32, fill = kol[["zielony"]], alpha = 0.07) +
  geom_histogram(data = f2, aes(srednica, after_stat(density)), binwidth = 0.004, boundary = 25,
                 fill = "grey80", colour = "white") +
  geom_line(data = krzywe, aes(x, y, colour = rodzaj, linetype = rodzaj), linewidth = 0.9) +
  annotate("segment", x = c(LSL, USL), xend = c(LSL, USL), y = 0, yend = szczyt * 1.32,
           linewidth = 2.6, colour = "grey25", lineend = "butt") +
  annotate("segment", x = cel, xend = cel, y = 0, yend = szczyt * 1.25, linetype = "dotted", colour = "grey30") +
  annotate("label", x = c(LSL, USL), y = szczyt * 1.38, label = c("LSL 24.950", "USL 25.050"),
           size = 3.6, fontface = "bold", linewidth = 0, fill = "white") +
  annotate("text", x = cel, y = szczyt * 1.29, label = "cel 25.000", size = 3.4, colour = "grey30") +
  annotate("segment", x = M2, xend = USL, y = szczyt * 1.08, yend = szczyt * 1.08,
           arrow = arrow(ends = "both", length = unit(0.15, "cm")), colour = kol[["cynober"]]) +
  annotate("text", x = (M2 + USL) / 2, y = szczyt * 1.14, colour = kol[["cynober"]], size = 3.4,
           label = sprintf("do bliższej granicy: %.1fσ", (USL - M2) / s_w2)) +
  annotate("segment", x = LSL, xend = M2, y = szczyt * 0.92, yend = szczyt * 0.92,
           arrow = arrow(ends = "both", length = unit(0.15, "cm")), colour = "grey45") +
  annotate("text", x = (LSL + M2) / 2, y = szczyt * 0.98, colour = "grey35", size = 3.4,
           label = sprintf("do dalszej: %.1fσ", (M2 - LSL) / s_w2)) +
  annotate("label", x = 24.9535, y = szczyt * 0.62, label = etyk, hjust = 0, size = 3.6, linewidth = 0.3, fill = "white") +
  scale_colour_manual(values = c("rozrzut krótkoterminowy (Cp, Cpk)" = kol[["niebieski"]],
                                 "rozrzut długoterminowy (Pp, Ppk)" = kol[["pomarancz"]]), name = NULL) +
  scale_linetype_manual(values = c("rozrzut krótkoterminowy (Cp, Cpk)" = "solid",
                                   "rozrzut długoterminowy (Pp, Ppk)" = "dashed"), name = NULL) +
  scale_x_continuous(breaks = seq(24.94, 25.06, 0.02), labels = function(b) sprintf("%.2f", b)) +
  coord_cartesian(xlim = c(24.94, 25.06)) +
  labs(x = "Średnica wałka (mm)", y = "Gęstość", title = "Proces w bramce tolerancji: faza 2, 125 wałków") +
  motyw + guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2))
p2   # zapis: ggsave("zdolnosc-procesu-bramka.svg", p2, width = 10, height = 6)
Wynik w R
             Faza 1: przed korektą Faza 2: po korekcie
M                         25.01226            25.01028
sigma_krotko               0.00885             0.01209
sigma_dlugo                0.01202             0.01176
    Faza 1: przed korektą Faza 2: po korekcie
Cp                   1.88                1.38
Cpk                  1.42                1.10
Pp                   1.39                1.42
Ppk                  1.05                1.13
                  Faza 1: przed korektą Faza 2: po korekcie
ppm_Cpk                            10.0               508.4
ppm_Ppk                           843.5               367.4
ppm_ponad_USL_Ppk                 843.4               367.2
Cpk_po_wysrodkowaniu ppm_po_wysrodkowaniu
                1.38                35.27
   braki_w_probie gorna_granica_ppm
                0             23681
     Value  2.5% 97.5%
Cp   1.379 1.207 1.550
Cp_l 1.662 1.482 1.843
Cp_u 1.095 0.971 1.220
Cp_k 1.095 0.947 1.244
Cpm  1.050 0.895 1.205
4. Grafika: przesunięcie czy rozrzut – Rysunek 3
R
# Rysunek 3. Grafika: przesunięcie średniej czy rozrzut? Cztery teoretyczne procesy w tej samej bramce tolerancji
# Samodzielny przepis (potrzebuje tylko palety kol i motywu z przepisu 1). Niczego nie losuje.
library(ggplot2)

LSL <- 24.950; USL <- 25.050
scen <- data.frame(
  nazwa = c("A. Wyśrodkowany, mały rozrzut", "B. Przesunięty, mały rozrzut",
            "C. Wyśrodkowany, duży rozrzut", "D. Przesunięty, duży rozrzut"),
  mu = c(25.000, 25.025, 25.000, 25.025), sigma = c(0.008, 0.008, 0.016, 0.016),
  decyzja = c("nic nie zmieniaj, monitoruj kartą", "przestaw nastawę: Cpk wróci do Cp",
              "zmniejsz rozrzut: maszyna, narzędzie, mocowanie", "najpierw nastawa, potem rozrzut"))
scen$Cp <- (USL - LSL) / (6 * scen$sigma)
scen$Cpk <- pmin(USL - scen$mu, scen$mu - LSL) / (3 * scen$sigma)
scen$ppm <- 1e6 * (pnorm(LSL, scen$mu, scen$sigma) + pnorm(USL, scen$mu, scen$sigma, lower.tail = FALSE))
scen[, c("nazwa", "Cp", "Cpk", "ppm")] |> transform(Cp = round(Cp, 2), Cpk = round(Cpk, 2), ppm = round(ppm, 1))

x <- seq(24.93, 25.08, length.out = 500)
krzywe <- do.call(rbind, lapply(seq_len(nrow(scen)), function(i)
  data.frame(nazwa = scen$nazwa[i], x = x, y = dnorm(x, scen$mu[i], scen$sigma[i]))))
krzywe$poza <- krzywe$x < LSL | krzywe$x > USL
ppm_tekst <- ifelse(scen$ppm < 1, "< 1", formatC(round(scen$ppm), format = "d", big.mark = " "))
scen$opis <- sprintf("Cp = %.2f · Cpk = %.2f\n%s ppm poza tolerancją", scen$Cp, scen$Cpk, ppm_tekst)
p3 <- ggplot(krzywe, aes(x, y)) +
  annotate("rect", xmin = LSL, xmax = USL, ymin = 0, ymax = 62, fill = kol[["zielony"]], alpha = 0.08) +
  geom_area(data = subset(krzywe, x > USL), fill = kol[["cynober"]], alpha = 0.8) +
  geom_area(data = subset(krzywe, x < LSL), fill = kol[["cynober"]], alpha = 0.8) +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.9) +
  annotate("segment", x = c(LSL, USL), xend = c(LSL, USL), y = 0, yend = 62, linewidth = 2.2, colour = "grey25") +
  geom_vline(xintercept = 25, linetype = "dotted", colour = "grey40") +
  geom_label(data = scen, aes(x = 24.932, y = 57, label = opis), hjust = 0, vjust = 1, size = 3.4,
             linewidth = 0, fill = "white", lineheight = 0.95) +
  geom_text(data = scen, aes(x = 25.005, y = -6, label = paste("→", decyzja)), size = 3.4,
            colour = "#0f1d3a", fontface = "bold") +
  facet_wrap(~ nazwa, ncol = 2) +
  scale_x_continuous(breaks = c(LSL, 25, USL), labels = c("LSL", "cel", "USL")) +
  coord_cartesian(ylim = c(-9, 62), clip = "off") +
  labs(x = NULL, y = NULL, title = "Przesunięcie średniej obniża Cpk, rozrzut obniża Cp i Cpk",
       subtitle = "Słupki – granice tolerancji; pole cynobrowe – sztuki poza tolerancją") +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())
p3   # zapis: ggsave("zdolnosc-procesu-schemat-przesuniecie-rozrzut.svg", p3, width = 10, height = 7)
Wynik w R
                          nazwa   Cp  Cpk     ppm
1 A. Wyśrodkowany, mały rozrzut 2.08 2.08     0.0
2  B. Przesunięty, mały rozrzut 2.08 1.04   889.0
3 C. Wyśrodkowany, duży rozrzut 1.04 1.04  1778.1
4  D. Przesunięty, duży rozrzut 1.04 0.52 59086.5
5. Przedziały ufności i symulacja: Rysunek 4
R
# Rysunek 4. Jak niepewny jest Cpk? Przedział Bissella, bootstrap podgrup i symulacja dla n = 30, 50, 125
# Korzysta z obiektów przepisów 1–3: walki, stale, LSL, USL, tab, kol, motyw. Losuje: set.seed(646) przed każdym losowaniem.
library(ggplot2)
library(patchwork)
library(boot)

# Przybliżenie Bissella (1990): SE(Cpk) ≈ √(1/(9n) + Cpk² / (2(n − 1)))
bissell <- function(cpk, n, poziom = 0.95) {
  se <- sqrt(1 / (9 * n) + cpk^2 / (2 * (n - 1)))
  c(Cpk = cpk, SE = se, dolna = cpk - qnorm(1 - (1 - poziom) / 2) * se,
    gorna = cpk + qnorm(1 - (1 - poziom) / 2) * se, dolna_jednostronna_95 = cpk - qnorm(0.95) * se)
}
f2 <- walki[walki$faza == "Faza 2: po korekcie", ]
round(bissell(tab["Cpk", 2], nrow(f2)), 3)

# Bootstrap: losujemy ze zwracaniem całe podgrupy (godziny), bo Cpk liczymy z R̄ / d2 wewnątrz podgrup
cpk_podgrupy <- function(d, i) {
  g <- split(d$srednica, d$podgrupa)[i]
  M <- mean(unlist(g)); s <- mean(sapply(g, function(v) diff(range(v)))) / stale[["d2"]]
  min(USL - M, M - LSL) / (3 * s)
}
# boot() losuje indeksy elementów wektora – podajemy mu numery podgrup 1:25
set.seed(646)
bt <- boot(1:25, function(idx, i) cpk_podgrupy(f2, idx[i]), R = 2000)
round(c(Cpk = bt$t0, SE_bootstrap = sd(bt$t)), 3)
ci <- boot.ci(bt, type = c("perc", "bca"))
round(rbind(percentylowy = ci$percent[4:5], BCa = ci$bca[4:5]), 3)

# Symulacja: proces o znanym Cpk = 1.40 (M = 25.008, σ = 0.010), 1000 prób dla każdego n
mu <- 25.008; sigma <- 0.010; cpk_prawd <- min(USL - mu, mu - LSL) / (3 * sigma)
cpk_hat <- function(x) min(USL - mean(x), mean(x) - LSL) / (3 * sd(x))
set.seed(646)
sym <- do.call(rbind, lapply(c(30, 50, 125), function(n) {
  do.call(rbind, lapply(1:1000, function(r) {
    x <- rnorm(n, mu, sigma); b <- bissell(cpk_hat(x), n)
    xb <- matrix(sample(x, n * 999, replace = TRUE), n)          # 999 prób bootstrapowych
    mb <- colMeans(xb); sb <- sqrt(colSums((xb - rep(mb, each = n))^2) / (n - 1))
    cb <- pmin(USL - mb, mb - LSL) / (3 * sb)
    data.frame(n = n, cpk = b[["Cpk"]], dolna = b[["dolna"]], gorna = b[["gorna"]], d1 = b[["dolna_jednostronna_95"]],
               boot_dolna = quantile(cb, 0.025, names = FALSE), boot_gorna = quantile(cb, 0.975, names = FALSE))
  }))
}))
mc <- function(p, m = 1000) round(100 * sqrt(p * (1 - p) / m), 1)       # błąd Monte Carlo (pp)
wyn <- do.call(rbind, lapply(split(sym, sym$n), function(d) {
  pokr_b <- mean(d$dolna <= cpk_prawd & d$gorna >= cpk_prawd)
  pokr_bt <- mean(d$boot_dolna <= cpk_prawd & d$boot_gorna >= cpk_prawd)
  data.frame(n = d$n[1], mediana_Cpk = round(median(d$cpk), 2),
             P5 = round(quantile(d$cpk, 0.05, names = FALSE), 2), P95 = round(quantile(d$cpk, 0.95, names = FALSE), 2),
             szerokosc_Bissell = round(median(d$gorna - d$dolna), 2),
             pokrycie_Bissell_proc = round(100 * pokr_b, 1), pokrycie_bootstrap_proc = round(100 * pokr_bt, 1),
             blad_MC_pp = mc(0.95), Cpk_ponizej_1.33_proc = round(100 * mean(d$cpk < 1.33), 1),
             dolna_ponad_1.33_proc = round(100 * mean(d$d1 >= 1.33), 1))
}))
wyn

# Ile sztuk trzeba, żeby jednostronna dolna granica 95% przekroczyła 1.33? (prawdziwe Cpk 1.40 i 1.67; Bissell)
set.seed(646)
nn <- c(30, 50, 75, 100, 125, 200, 300, 500, 800)
moc <- expand.grid(n = nn, cpk = c(1.40, 1.67))
moc$odsetek <- mapply(function(n, c0) {
  mu0 <- USL - 3 * sigma * c0                                       # przesunięcie, które daje dane Cpk
  mean(replicate(1000, { x <- rnorm(n, mu0, sigma); c1 <- cpk_hat(x)
    c1 - qnorm(0.95) * sqrt(1 / (9 * n) + c1^2 / (2 * (n - 1))) >= 1.33 }))
}, moc$n, moc$cpk)
moc$cpk_et <- factor(sprintf("prawdziwe Cpk = %.2f", moc$cpk))
reshape(transform(moc[, c("n", "cpk", "odsetek")], odsetek = round(100 * odsetek, 1)),
        idvar = "n", timevar = "cpk", direction = "wide")

# Rysunek 4: A – rozkład oszacowań Cpk w 1000 próbach; B – szansa „udowodnienia” Cpk ≥ 1.33
sym$n_et <- factor(paste("n =", sym$n), levels = paste("n =", c(30, 50, 125)))
pA <- ggplot(sym, aes(cpk)) +
  geom_histogram(binwidth = 0.05, boundary = 1.4, fill = "grey75", colour = "white") +
  geom_vline(xintercept = cpk_prawd, colour = kol[["niebieski"]], linewidth = 0.9) +
  geom_vline(xintercept = 1.33, colour = kol[["cynober"]], linetype = "dashed", linewidth = 0.8) +
  facet_wrap(~ n_et, ncol = 3) +
  labs(x = "Oszacowane Cpk", y = "Liczba prób",
       title = "A. 1000 prób z procesu o Cpk = 1.40 (niebieska linia); przerywana – wymóg 1.33") +
  motyw
pB <- ggplot(moc, aes(n, 100 * odsetek, colour = cpk_et, shape = cpk_et)) +
  geom_line(linewidth = 0.8) + geom_point(size = 2.4) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomarancz"]]), name = NULL) +
  scale_x_log10(breaks = nn) + scale_y_continuous(limits = c(0, 100)) +
  labs(x = "Liczba zmierzonych wałków (skala logarytmiczna)", y = "% prób",
       title = "B. Jak często dolna 95% granica Cpk przekracza 1.33", shape = NULL) +
  motyw
p4 <- pA / pB + plot_layout(heights = c(1, 1.1))
p4   # zapis: ggsave("zdolnosc-procesu-przedzialy-ufnosci.svg", p4, width = 10, height = 8.4)
Wynik w R
                  Cpk                    SE                 dolna
                1.095                 0.076                 0.947
                gorna dolna_jednostronna_95
                1.244                 0.971
         Cpk SE_bootstrap
       1.095        0.067
              [,1]  [,2]
percentylowy 0.976 1.239
BCa          0.965 1.225
      n mediana_Cpk   P5  P95 szerokosc_Bissell pokrycie_Bissell_proc
30   30        1.43 1.14 1.84              0.77                  94.3
50   50        1.41 1.19 1.68              0.59                  96.0
125 125        1.41 1.26 1.57              0.37                  94.8
    pokrycie_bootstrap_proc blad_MC_pp Cpk_ponizej_1.33_proc
30                     86.3        0.7                  30.9
50                     91.2        0.7                  29.0
125                    93.7        0.7                  19.9
    dolna_ponad_1.33_proc
30                   10.9
50                   11.5
125                  18.9
    n odsetek.1.4 odsetek.1.67
1  30        10.9         38.5
2  50        12.2         60.3
3  75        13.9         78.5
4 100        15.3         88.6
5 125        18.3         94.5
6 200        22.7         99.6
7 300        29.8        100.0
8 500        46.9        100.0
9 800        60.0        100.0
6. Rozkład skośny – bicie promieniowe: Rysunek 5
R
# Rysunek 5. Rozkład skośny: bicie promieniowe wałka (tylko górna granica, USL = 0.040 mm)
# Korzysta z palety kol i motywu z przepisu 1. Losuje: set.seed(646) przed każdym losowaniem.
library(ggplot2)
library(patchwork)

USL_b <- 0.040                                        # bicie nie może być ujemne – jest tylko górna granica
med_b <- 0.012; sdlog_b <- 0.42                       # parametry ustalone ręcznie: rozkład lognormalny
set.seed(646)
bicie <- data.frame(bicie = round(rlnorm(125, log(med_b), sdlog_b), 4))
write.csv(bicie, "zdolnosc-procesu-bicie.csv", row.names = FALSE)
x <- bicie$bicie; M <- mean(x); s <- sd(x)

# (1) Jak zwykle, z założeniem normalności: Cpk = CPU = (USL − M) / 3s
cpu_norm <- (USL_b - M) / (3 * s); ppm_norm <- 1e6 * pnorm(USL_b, M, s, lower.tail = FALSE)
# (2) Metoda kwantylowa na dopasowanym rozkładzie lognormalnym: (USL − mediana) / (Q99.865% − mediana)
ml <- mean(log(x)); sl <- sd(log(x))
q_99865 <- qlnorm(pnorm(3), ml, sl); mediana <- qlnorm(0.5, ml, sl)
cpu_logn <- (USL_b - mediana) / (q_99865 - mediana); ppm_logn <- 1e6 * plnorm(USL_b, ml, sl, lower.tail = FALSE)
# (3) Prawda (znamy rozkład, bo dane są fikcyjne)
cpu_prawda <- (USL_b - med_b) / (qlnorm(pnorm(3), log(med_b), sdlog_b) - med_b)
ppm_prawda <- 1e6 * plnorm(USL_b, log(med_b), sdlog_b, lower.tail = FALSE)
data.frame(metoda = c("normalny (zwykły Cpk)", "lognormalny (kwantyle)", "prawda (znany rozkład)"),
           Cpk = round(c(cpu_norm, cpu_logn, cpu_prawda), 2), ppm = round(c(ppm_norm, ppm_logn, ppm_prawda), 1))
sw <- shapiro.test(x)
c(M = round(M, 4), SD = round(s, 4), skosnosc = round(mean((x - M)^3) / s^3, 2),
  Shapiro_W = round(unname(sw$statistic), 3), Shapiro_p = signif(sw$p.value, 2), ponad_USL_w_probie = sum(x > USL_b))

# 1000 prób po 125 wałków: jak często zwykły Cpk „zalicza” 1.33, choć prawdziwe ppm jest takie jak wyżej
set.seed(646)
cpu_sym <- replicate(1000, { y <- rlnorm(125, log(med_b), sdlog_b); (USL_b - mean(y)) / (3 * sd(y)) })
c(mediana_Cpk_normalny = round(median(cpu_sym), 2), odsetek_Cpk_ponad_1.33 = round(100 * mean(cpu_sym >= 1.33), 1),
  blad_MC_pp = round(100 * sqrt(mean(cpu_sym >= 1.33) * (1 - mean(cpu_sym >= 1.33)) / 1000), 1))

# Rysunek 5: A – histogram z krzywą normalną i lognormalną; B – wykres Q-Q względem rozkładu normalnego
s_x <- seq(0, 0.05, length.out = 400)
kr <- rbind(data.frame(x = s_x, y = dnorm(s_x, M, s), model = "normalny (zwykły Cpk)"),
            data.frame(x = s_x, y = dlnorm(s_x, ml, sl), model = "lognormalny"))
pA <- ggplot(bicie, aes(bicie)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 0.002, boundary = 0, fill = "grey80", colour = "white") +
  geom_line(data = kr, aes(x, y, colour = model, linetype = model), linewidth = 0.9) +
  annotate("segment", x = USL_b, xend = USL_b, y = 0, yend = 104, linewidth = 2.2, colour = "grey25") +
  annotate("label", x = USL_b, y = 109, label = "USL 0.040", size = 3.5, fontface = "bold", linewidth = 0, fill = "white") +
  annotate("text", x = 0.0385, y = 62, hjust = 1, size = 3.4, lineheight = 0.95,
           label = sprintf("zwykły Cpk = %.2f → %.0f ppm\nkwantyle lognormalne: Cpk = %.2f → %.0f ppm",
                           cpu_norm, ppm_norm, cpu_logn, ppm_logn)) +
  scale_colour_manual(values = c("normalny (zwykły Cpk)" = kol[["pomarancz"]], "lognormalny" = kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("normalny (zwykły Cpk)" = "solid", "lognormalny" = "dashed"), name = NULL) +
  scale_x_continuous(labels = function(b) sprintf("%.2f", b)) +
  coord_cartesian(xlim = c(0, 0.05), ylim = c(0, 115)) +
  labs(x = "Bicie promieniowe (mm)", y = "Gęstość", title = "A. Bicie 125 wałków: rozkład skośny w prawo") +
  motyw
pB <- ggplot(bicie, aes(sample = bicie)) +
  stat_qq_line(colour = kol[["szary"]], linewidth = 0.8) +
  stat_qq(colour = kol[["niebieski"]], size = 1.6, alpha = 0.8) +
  labs(x = "Kwantyle rozkładu normalnego", y = "Bicie (mm)", title = "B. Wykres Q-Q: prawy koniec ucieka w górę") +
  motyw
p5 <- pA / pB + plot_layout(heights = c(1.3, 1))
p5   # zapis: ggsave("zdolnosc-procesu-bicie-skosne.svg", p5, width = 10, height = 8.4)
Wynik w R
                  metoda  Cpk    ppm
1  normalny (zwykły Cpk) 1.91    0.0
2 lognormalny (kwantyle) 1.10  771.4
3 prawda (znany rozkład) 0.92 2074.5
                 M                 SD           skosnosc          Shapiro_W
          0.012200           0.004900           0.750000           0.946000
         Shapiro_p ponad_USL_w_probie
          0.000075           0.000000
  mediana_Cpk_normalny odsetek_Cpk_ponad_1.33             blad_MC_pp
                  1.58                  92.50                   0.80
7. Sprawdzenie palety
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (w granicach / poza granicami; krzywa / sztuki poza tolerancją)" = c("#0072B2", "#D55E00"),
             "niebieski – pomarańczowy (rozrzut krótko- / długoterminowy; Cpk 1.40 / 1.67; lognormalny / normalny)" = c("#0072B2", "#E69F00"),
             "zielone tło bramki – cynober (tolerancja / poza nią)" = c("#E5F5F0", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                                                     widzenie_typowe
niebieski – cynober (w granicach / poza granicami; krzywa / sztuki poza tolerancją)                            114.6
niebieski – pomarańczowy (rozrzut krótko- / długoterminowy; Cpk 1.40 / 1.67; lognormalny / normalny)           120.2
zielone tło bramki – cynober (tolerancja / poza nią)                                                            89.8
czerwony – zielony (do unikania)                                                                               121.7
                                                                                                     deuteranopia
niebieski – cynober (w granicach / poza granicami; krzywa / sztuki poza tolerancją)                         108.3
niebieski – pomarańczowy (rozrzut krótko- / długoterminowy; Cpk 1.40 / 1.67; lognormalny / normalny)        121.5
zielone tło bramki – cynober (tolerancja / poza nią)                                                         72.6
czerwony – zielony (do unikania)                                                                             21.1
                                                                                                     protanopia
niebieski – cynober (w granicach / poza granicami; krzywa / sztuki poza tolerancją)                        91.9
niebieski – pomarańczowy (rozrzut krótko- / długoterminowy; Cpk 1.40 / 1.67; lognormalny / normalny)      109.3
zielone tło bramki – cynober (tolerancja / poza nią)                                                       71.1
czerwony – zielony (do unikania)                                                                           31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, statystyki opisowe, test Shapiro-Wilka – pakiety base i stats; karty kontrolne i wskaźniki zdolności – pakiet qcc; bootstrap danych – pakiet boot). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- qcc (wersja 2.7): Scrucca, L. (2004). qcc: An R package for quality control charting and statistical process monitoring. R News, 4(1), 11–17. https://CRAN.R-project.org/doc/Rnews/
- boot (wersja 1.3.32): Canty, A., & Ripley, B. D. (2025). boot: Bootstrap functions [R package]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Cpk na procesie niestabilnym. W fazie 1 Cpk = 1.42 wyglądało dobrze, a Ppk = 1.05 pokazywało, co klient naprawdę dostaje.
- Jedna liczba bez przedziału. Przy 30 sztukach 90% oszacowań prawdziwego 1.40 mieści się dopiero w zakresie 1.14–1.84.
- „Zero braków w próbie”, więc ppm ≈ 0. Przy 125 sztukach górna granica to ponad 23 tys. ppm.
- Zwykły wzór dla rozkładu skośnego. Bicie: 1.91 z normalności wobec prawdziwego 0.92.
- Mylenie Cp/Cpk z Pp/Ppk – opisz w pracy, której σ użyłeś (rozrzut krótko- czy długoterminowy).
- Bootstrap pojedynczych sztuk przy danych w podgrupach albo przy bardzo małym n – przedział wychodzi za wąski.
- Reguła trzech sigm jako gwarancja. Granice ±3σ i progi 1.33 to umowa branżowa, nie prawo natury; sprawdzaj założenia.
Najczęstsze pytania
Czym różni się Cp od Cpk?
Cp porównuje szerokość tolerancji z szerokością procesu (6σ) i nie zależy od położenia średniej. Cpk mierzy odległość średniej od bliższej granicy w jednostkach 3σ, więc spada, gdy proces jest przesunięty. W przykładzie Cp = 1.38, a Cpk = 1.10 – wyśrodkowanie podniosłoby Cpk do 1.38.
Czym różnią się Pp i Ppk od Cp i Cpk?
Wzory są te same, ale Pp i Ppk używają odchylenia standardowego wszystkich pomiarów (zmienność długoterminowa), a Cp i Cpk – rozrzutu wewnątrz podgrup, np. R̄/d2. Duża różnica między Cpk a Ppk oznacza, że średnia wędruje w czasie: w niestabilnej fazie przykładu Cpk = 1.42, a Ppk = 1.05.
Jak policzyć przedział ufności dla Cpk?
Najprościej przybliżeniem Bissella (1990): SE ≈ √(1/(9n) + Cpk²/(2(n − 1))), które stosuje też funkcja process.capability() z pakietu qcc. Alternatywą jest bootstrap – przy danych w podgrupach losuj całe podgrupy. Klientowi raportuj jednostronną dolną granicę 95%.
Ile sztuk trzeba zmierzyć, żeby wykazać Cpk ≥ 1.33?
To zależy od tego, jak daleko od 1.33 jest prawdziwy wskaźnik. W symulacji proces o Cpk 1.67 miał dolną granicę 95% powyżej 1.33 w 94.5% prób przy 125 sztukach, a proces o Cpk 1.40 – tylko w 18.9%, a przy 800 sztukach w 60.0%.
Czy można liczyć Cpk, gdy rozkład nie jest normalny?
Zwykły wzór zakłada normalność i przy skośnych cechach, takich jak bicie promieniowe, może mocno zawyżyć wynik. Dopasuj rozkład (np. lognormalny) i licz wskaźnik z kwantyli: odległość od mediany do percentyla 99.865% zamiast 3σ. W przykładzie wynik spadł z 1.91 do 1.10.
Powiązane hasła
Przeczytaj też
Anomalie w KPI – karta kontrolna
Sklep sportowy i dzienna konwersja: karta p, dzień tygodnia, poprawka Laneya, EWMA, CUSUM i symulacja fałszywych alarmów – pięć rysunków z kodem R.
Czytaj →PoradnikAnaliza systemu pomiarowego (Gage R&R)
Grubość folii, 10 próbek × 3 operatorów × 3 powtórzenia: składowe wariancji, %GRR, % tolerancji, ndc i symulacje – pięć rysunków z kodem R.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →Liczysz zdolność procesu w pracy dyplomowej?
Pomożemy sprawdzić stabilność, dobrać wskaźniki i estymator rozrzutu, policzyć przedziały ufności i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bissell, A. F. (1990). How reliable is your capability index? Applied Statistics, 39(3), 331–340. https://doi.org/10.2307/2347383
- Chou, Y.-M., Owen, D. B., & Borrego A., S. A. (1990). Lower confidence limits on process capability indices. Journal of Quality Technology, 22(3), 223–229. https://doi.org/10.1080/00224065.1990.11979242
- English, J. R., & Taylor, G. D. (1993). Process capability analysis—a robustness study. International Journal of Production Research, 31(7), 1621–1635. https://doi.org/10.1080/00207549308956813
- Franklin, L. A., & Wasserman, G. S. (1991). Bootstrap confidence interval estimates of Cpk: An introduction. Communications in Statistics – Simulation and Computation, 20(1), 231–242. https://doi.org/10.1080/03610919108812950
- Kane, V. E. (1986). Process capability indices. Journal of Quality Technology, 18(1), 41–52. https://doi.org/10.1080/00224065.1986.11978984
- Kotz, S., & Johnson, N. L. (2002). Process capability indices—A review, 1992–2000. Journal of Quality Technology, 34(1), 2–19. https://doi.org/10.1080/00224065.2002.11980119
- Pearn, W. L., Kotz, S., & Johnson, N. L. (1992). Distributional and inferential properties of process capability indices. Journal of Quality Technology, 24(4), 216–231. https://doi.org/10.1080/00224065.1992.11979403
Cytowania BibTeX
@article{bissell1990how, author={Bissell, A. F.}, title={{How reliable is your capability index?}}, journal={Applied Statistics}, year={1990}, volume={39}, number={3}, pages={331--340}, doi={10.2307/2347383}}@article{chou1990lower, author={Chou, Youn-Min and Owen, D. B. and Borrego A., Salvador A.}, title={{Lower confidence limits on process capability indices}}, journal={Journal of Quality Technology}, year={1990}, volume={22}, number={3}, pages={223--229}, doi={10.1080/00224065.1990.11979242}}@article{english1993process, author={English, J. R. and Taylor, G. D.}, title={{Process capability analysis—a robustness study}}, journal={International Journal of Production Research}, year={1993}, volume={31}, number={7}, pages={1621--1635}, doi={10.1080/00207549308956813}}@article{franklin1991bootstrap, author={Franklin, LeRoy A. and Wasserman, Gary S.}, title={{Bootstrap confidence interval estimates of Cpk: An introduction}}, journal={Communications in Statistics – Simulation and Computation}, year={1991}, volume={20}, number={1}, pages={231--242}, doi={10.1080/03610919108812950}}@article{kane1986process, author={Kane, Victor E.}, title={{Process capability indices}}, journal={Journal of Quality Technology}, year={1986}, volume={18}, number={1}, pages={41--52}, doi={10.1080/00224065.1986.11978984}}@article{kotz2002process, author={Kotz, Samuel and Johnson, Norman L.}, title={{Process capability indices—A review, 1992–2000}}, journal={Journal of Quality Technology}, year={2002}, volume={34}, number={1}, pages={2--19}, doi={10.1080/00224065.2002.11980119}}@article{pearn1992distributional, author={Pearn, W. L. and Kotz, Samuel and Johnson, Norman L.}, title={{Distributional and inferential properties of process capability indices}}, journal={Journal of Quality Technology}, year={1992}, volume={24}, number={4}, pages={216--231}, doi={10.1080/00224065.1992.11979403}}