Przykład: grubościomierz w zakładzie folii
Fikcyjny zakład tworzyw sztucznych produkuje folię opakowaniową o grubości nominalnej 25 µm z tolerancją 22–28 µm. Grubość rolek mierzy grubościomierz stykowy, obsługiwany przez różne osoby na trzech zmianach. Kierownik jakości chce policzyć zdolność procesu (wskaźniki Cp i Cpk) i prowadzić kartę kontrolną, ale najpierw pyta: ile z rozrzutu, który widzimy w raportach, to różnice między rolkami, a ile dokłada sam pomiar?
Odpowiada na to analiza systemu pomiarowego, zwana badaniem Gage R&R (od repeatability i reproducibility): powtarzalność to rozrzut odczytów jednej osoby mierzącej tę samą próbkę, a odtwarzalność – różnice między osobami. Typowy plan to 10 próbek × 3 operatorów × 3 powtórzenia, czyli 90 pomiarów. Operatorzy mierzą oznaczone próbki w losowej kolejności, nie widząc wcześniejszych odczytów.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy: prawdziwa grubość próbek z rozkładu normalnego o średniej 25 µm i SD 1.0 µm; operator B odczytuje średnio o 0.10 µm mniej, a operator C o 0.25 µm więcej niż A (słabiej dociska trzpień); interakcja próbka × operator o SD 0.08 µm; powtarzalność przyrządu SD 0.22 µm; odczyt zaokrąglony do 0.1 µm. Ziarno 647 ustalono raz; ani ziarna, ani parametrów nie zmienialiśmy po pierwszym uruchomieniu. Dane pobierzesz jako gage-rr-grubosc-folii.csv (wiersz = jeden pomiar).
Rysunek 1: wyniki według operatorów
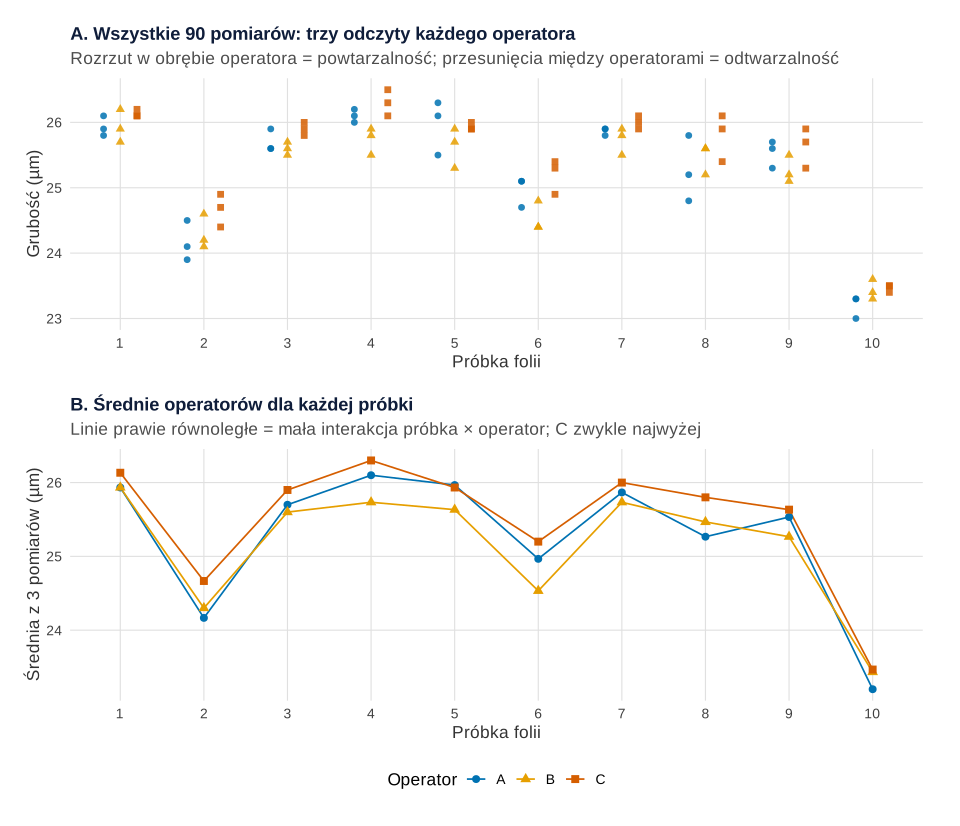
set.seed(647)).Co widać. Próbki wyraźnie się różnią: średnio od 23.37 do 26.04 µm, a wszystkie 90 odczytów mieści się w przedziale 23.0–26.5 µm. Trzy odczyty jednej osoby rozjeżdżają się o kilka dziesiątych mikrometra – średni rozstęp wynosi 0.44 µm u operatora A, 0.41 u B i 0.34 u C. Na panelu B linie są prawie równoległe, a linia C zwykle leży najwyżej: średnio 25.50 µm wobec 25.27 (A) i 25.16 (B).
Jak może zmylić. Na oko nie ocenisz, czy kilka dziesiątych mikrometra to dużo – zależy to od rozrzutu próbek i szerokości tolerancji. Linie na panelu B to wykres interakcji: gdyby się krzyżowały, operatorzy myliliby się różnie na różnych próbkach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: ANOVA i drzewo podziału zmienności
Do badania Gage R&R używa się analizy wariancji dwuczynnikowej z interakcją: próbka i operator to czynniki skrzyżowane (każdy operator mierzy każdą próbkę). Burdick i in. (2003) pokazują, że w takim planie ANOVA daje oszacowania punktowe i przedziałowe składowych wariancji. Próbki i operatorów traktujemy jako losowe – to przykład z populacji rolek i z populacji osób, które mogą mierzyć (zob. efekty stałe i losowe). Interakcja próbka × operator okazała się mała: F(18, 60) = 1.10, p = .378. Składowe liczymy ze średnich kwadratów (MS), gdzie p = 10 próbek, o = 3 operatorów, r = 3 powtórzenia:
Słowami: powtarzalność to rozrzut w komórce „ta próbka – ta osoba”, a pozostałe składowe to nadwyżka ponad ten rozrzut. Odtwarzalność = operator + interakcja; Gage R&R = powtarzalność + odtwarzalność.
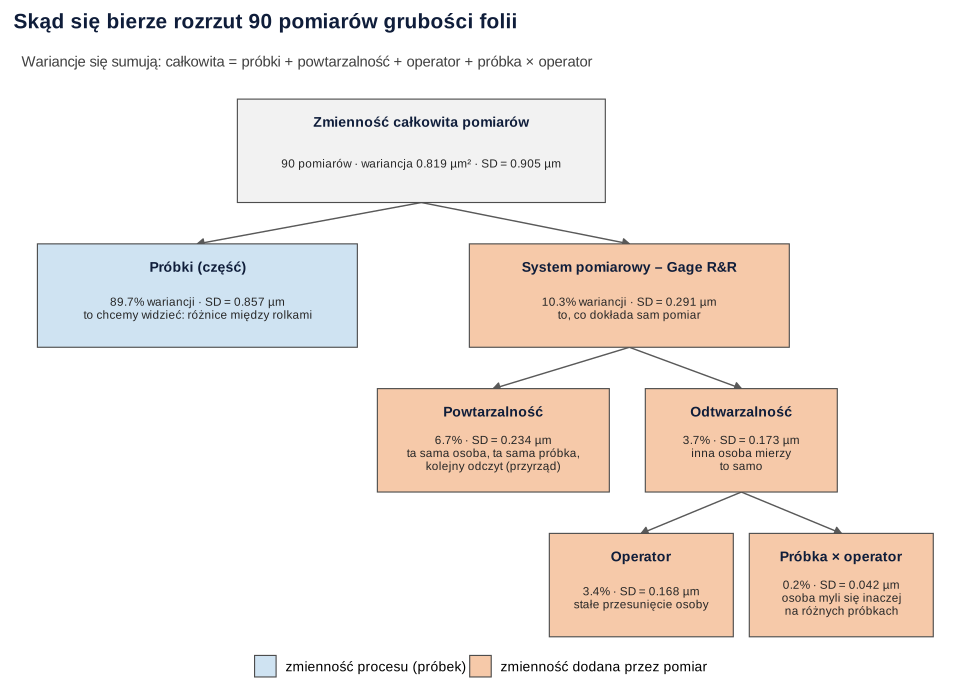
Co widać. Z całkowitej wariancji 0.819 µm² na różnice między próbkami przypada 89.7%, a na system pomiarowy 10.3%. Większy kawałek pomiaru to powtarzalność (6.7%, SD = 0.234 µm), mniejszy – odtwarzalność (3.7%), prawie w całości ze stałego przesunięcia operatora. Interakcja to tylko 0.2%. Model mieszany REML w pakiecie lme4 daje te same wariancje (zgodne do czwartego miejsca po przecinku), bo żadna składowa nie wyszła ujemna.
Jak może zmylić. Procenty sumują się tylko dla wariancji. Odchylenia standardowe się nie sumują: 0.234 + 0.173 to nie 0.291. Dlatego tabele Gage R&R z kolumną „% zmienności badania” (procent SD) nie dodają się do 100%.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: %GRR, % tolerancji i ndc
Tę samą zmienność pomiaru wyraża się trzema liczbami:
- %GRR (% zmienności badania) = σGRR / σcałk · 100 – jaką część rozrzutu obserwowanych próbek stanowi pomiar;
- % tolerancji = 6σGRR / (GGT − DGT) · 100 – jaką część pola tolerancji zajmuje pomiar (tu GGT − DGT = 6 µm);
- ndc (liczba rozróżnialnych kategorii) = 1.41 · σP / σGRR, zaokrąglone w dół – na ile grup przyrząd potrafi rzetelnie podzielić próbki.
W praktyce przemysłowej przyjmuje się zwykle, że %GRR i % tolerancji poniżej 10% to dobry pomiar, 10–30% – warunkowo do przyjęcia, powyżej 30% – za słaby, a ndc powinno wynosić co najmniej 5.
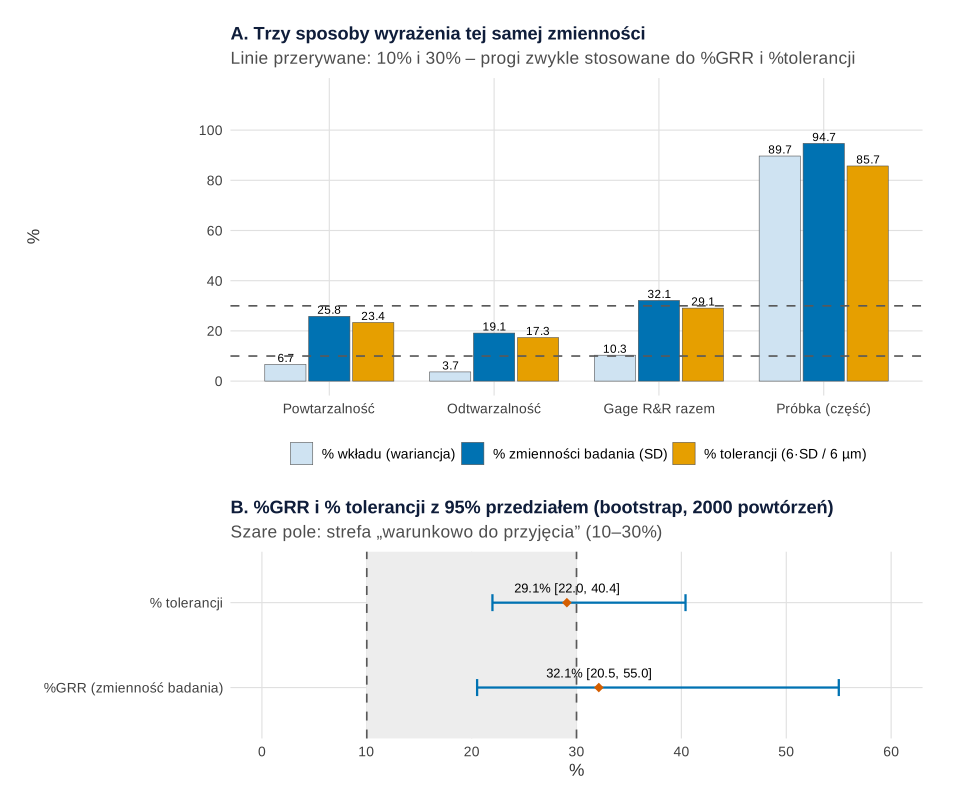
set.seed(647)).Co widać. Ten sam system pomiarowy ma 10.3% wkładu w wariancję, ale 32.1% zmienności badania i 29.1% tolerancji. Według %GRR pomiar jest tuż za granicą 30%, według % tolerancji – tuż przed nią. Liczba kategorii ndc = 4 (1.41 · 0.857 / 0.291 = 4.16), czyli poniżej 5.
Jak może zmylić. Te liczby pochodzą z 3 operatorów i 10 próbek, więc są niepewne. W bootstrapie parametrycznym (2000 nowych badań losowanych z oszacowanych składowych) 95% przedział dla %GRR to [20.5, 55.0], dla % tolerancji [22.0, 40.4], a dla ndc [2.14, 6.72]. Najsłabiej oszacowana jest SD operatora: od 0.00 do 0.32 µm – trzy osoby to za mało, by ocenić różnice między wszystkimi pracownikami. Liczba blisko progu 30% nie rozstrzyga więc „zaliczone/niezaliczone”.
Związek z ICC. Udział próbek w wariancji to współczynnik korelacji wewnątrzklasowej: ICC = σ²P / (σ²P + σ²GRR) = .90. Odpowiada formie dla zgodności bezwzględnej pojedynczego pomiaru z operatorami losowymi – Koo i Li (2016) zalecają, by w pracy zawsze podać model, typ i definicję ICC. Woodall i Borror (2008) pokazują, że ndc jest równoważne stosunkowi SD systemu pomiarowego do całkowitej SD pomiarów, więc nie jest niezależnym kryterium: ndc = 1.41 · √(ICC / (1 − ICC)). Zob. też ocenę 360 stopni (ICC dla oceniających) i zgodność dwóch metod pomiaru.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: dobór próbek zmienia wynik
%GRR dzieli zmienność pomiaru przez zmienność obserwowanych próbek. Jeśli próbki są do siebie podobne, mianownik maleje i ten sam przyrząd wygląda gorzej. Sprawdziliśmy to symulacją: ten sam system pomiarowy (SD powtarzalności 0.22 µm, operatora 0.18 µm, interakcji 0.08 µm – ręcznie, blisko przykładu), 1000 badań 10 × 3 × 3 w każdym z trzech scenariuszy doboru próbek. Prawdziwy % tolerancji wynosi 29.5%.
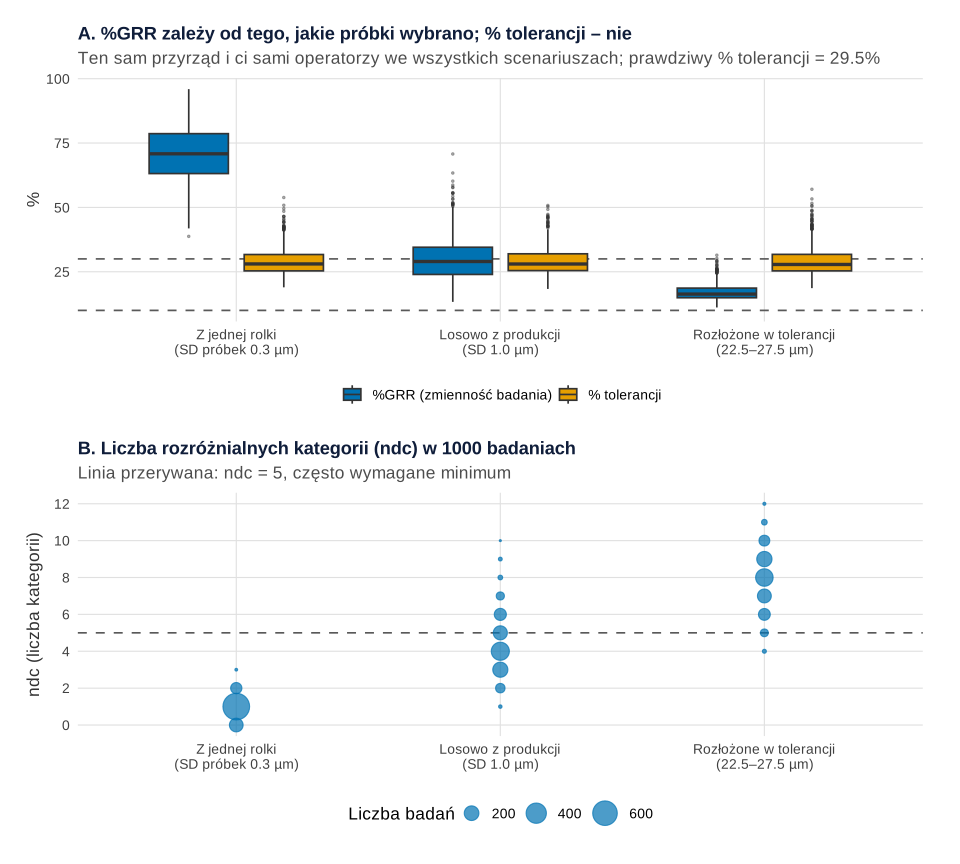
set.seed(647)).Co widać. Przy próbkach z jednej rolki (SD 0.3 µm) mediana %GRR to 70.8%, a ndc – 1: przyrząd „nie przechodzi” w żadnym badaniu. Przy próbkach losowych z produkcji (SD 1.0 µm) mediana %GRR to 29.0% (kwartyle 24.0–34.5), poniżej 30% wypada w 55.8% badań, a ndc ≥ 5 w 39.1%. Przy próbkach celowo rozłożonych w całej tolerancji mediana %GRR spada do 16.3%, a ndc do 8. % tolerancji ma medianę ok. 28% we wszystkich trzech scenariuszach, bo nie zależy od próbek. Błąd Monte Carlo odsetków nie przekracza 1.6 pp.
Jak może zmylić. Scenariusze odpowiadają na różne pytania: próbki z całej tolerancji pasują do kontroli zgodności ze specyfikacją, a do sterowania procesem potrzebne są próbki o rozrzucie typowym dla produkcji. Browne i in. (2010) idą dalej: proponują plan dwuetapowy, w którym najpierw wiele części mierzy się raz, a potem celowo wybrane części skrajne mierzy się wielokrotnie – przy tej samej liczbie pomiarów daje on dokładniejsze oszacowania. Ten sam mechanizm opisuje wpis o ograniczonym zakresie zmiennej.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: ujemna składowa wariancji
Wzory ze średnich kwadratów odejmują jedną liczbę od drugiej. Gdy prawdziwa składowa jest bliska zera, różnica bywa ujemna – a wariancja nie może być ujemna. W przykładzie tak się nie stało, ale w bootstrapie z rysunku 3 interakcja wyszła ujemna w 42.7% badań, a składowa operatora w 7.6%. Druga symulacja: system bez interakcji (SD interakcji = 0), 1000 badań.
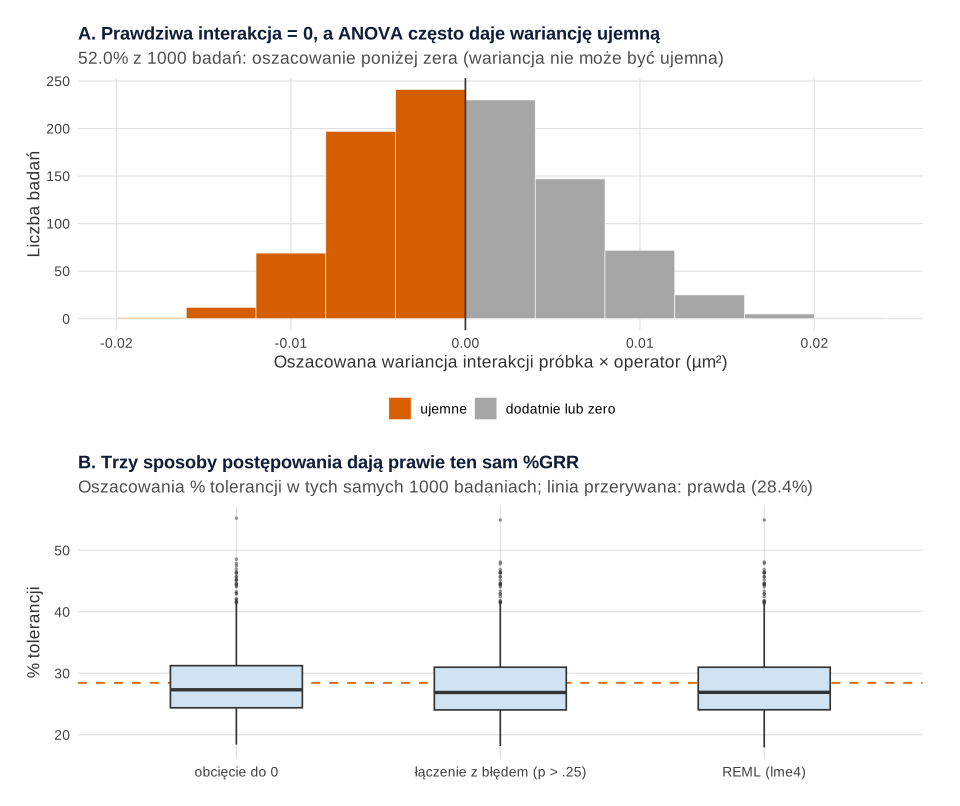
set.seed(647)).Co widać. W 52.0% badań wariancja interakcji wyszła ujemna, choć prawdziwa jest równa zeru – to błąd losowy, nie pomyłka w obliczeniach. Typowe wyjścia: (1) obciąć ujemną wartość do zera, (2) gdy p interakcji > .25 (tak było w 74.3% badań), dołączyć interakcję do błędu i policzyć model bez niej, (3) użyć REML w modelu mieszanym, który nie dopuszcza ujemnych wariancji. Thompson (1962) opisał takie nieujemne oszacowania oparte na ograniczonej największej wiarygodności. Na panelu B wszystkie trzy dają prawie to samo: średni % tolerancji 28.34, 27.97 i 27.98 przy prawdzie 28.4%, a rozrzut między badaniami (SD 5.3–5.4 pp) jest wielokrotnie większy niż różnice między metodami.
Jak może zmylić. Ujemnej składowej nie wpisuj do tabeli jako ujemnej ani nie pierwiastkuj (wyjdzie NaN). Napisz, co z nią zrobiono. W modelu mieszanym składowa równa 0 daje komunikat o „singular fit” – zob. model mieszany się nie zbiega.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w firmie
- Do kontroli rolek względem tolerancji przyrząd jest „warunkowo do przyjęcia” (29.1% tolerancji), ale rolki blisko granic 22 i 28 µm sprawdzaj powtórnie albo przyjmij pas ochronny rzędu dwóch SD Gage R&R (SD = 0.291 µm) od granicy.
- Do sterowania procesem i liczenia Cp/Cpk – jeszcze nie. Przy ndc = 4 pomiar zawyża widoczny rozrzut, a wskaźniki zdolności z wpisu o Cp i Cpk wyjdą zaniżone. Karta kontrolna (Shewharta i CUSUM) też pokaże więcej szumu.
- Zacznij od powtarzalności – to największy kawałek (23.4% tolerancji). Sprawdź docisk trzpienia, czystość i temperaturę; średnia z dwóch odczytów zmniejsza wariancję powtarzalności o połowę.
- Ujednolić pomiar między osobami: instrukcja docisku i krótkie szkolenie dla operatora C, potem powtórz badanie.
- Kolejne badanie zaplanuj szerzej: więcej operatorów (z trzech nie oszacujesz dobrze różnic między ludźmi) i próbki z różnych rolek i zmian.
Jak opisać w pracy
W Metodzie opisz przyrząd, plan badania, dobór próbek, model i postępowanie z ujemnymi składowymi; w Wynikach – tabelę składowych, ndc i przedziały ufności. Opis rzetelności pomiaru w badaniach klinicznych (ICC, SEM, Bland–Altman) znajdziesz we wpisie o badaniu rzetelności pomiaru klinicznego, a szerszy kontekst – w poradniku statystyka w pracy inżynierskiej.
| Źródło | Wariancja (µm²) | % wkładu | SD (µm) | % zmienności badania | % tolerancji |
|---|---|---|---|---|---|
| Gage R&R razem | 0.085 | 10.3 | 0.291 | 32.1 | 29.1 |
| – powtarzalność | 0.055 | 6.7 | 0.234 | 25.8 | 23.4 |
| – odtwarzalność | 0.030 | 3.7 | 0.173 | 19.1 | 17.3 |
| operator | 0.028 | 3.4 | 0.168 | 18.6 | 16.8 |
| próbka × operator | 0.002 | 0.2 | 0.042 | 4.6 | 4.2 |
| Próbki | 0.735 | 89.7 | 0.857 | 94.7 | 85.7 |
| Całkowita | 0.819 | 100.0 | 0.905 | 100.0 | 90.5 |
Szerzej o pracy dyplomowej: statystyka w pracy z zarządzania i ekonomii; pomoc w analizie: analizy statystyczne dla studentów.
Kod R: Gage R&R, składowe wariancji i symulacje
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, przepis 2 – funkcje skladowe() i wsk(), z których korzystają kolejne. Składowe wariancji liczymy ręcznie ze średnich kwadratów i sprawdzamy funkcjami aov() oraz lmer() z pakietu lme4. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane), 2 (bootstrap), 4 i 5 (symulacje); każdy z nich ma własne set.seed(647). Ziarno 647 ustalono raz i nie zmieniano go. Ręcznie ustalono: tolerancję 22–28 µm, plan 10 × 3 × 3, SD próbek 1.0 µm, przesunięcia operatorów (B −0.10 µm, C +0.25 µm), SD interakcji 0.08 µm, SD powtarzalności 0.22 µm, zaokrąglenie odczytu do 0.1 µm; w symulacjach – SD operatora 0.18 µm, trzy sposoby doboru próbek (SD 0.3 i 1.0 µm, 10 próbek równomiernie od 22.5 do 27.5 µm), brak interakcji w przepisie 5, 2000 powtórzeń bootstrapu i 1000 badań na scenariusz; progi 10%, 30% i ndc = 5 są przyjęte z praktyki przemysłowej. Całość liczy się w ok. 20 sekund.
1. Paleta, dane i ich przegląd: Rysunek 1
R
# Rysunek 1. Fikcyjny zakład tworzyw sztucznych: grubość folii, 10 próbek × 3 operatorów × 3 powtórzenia (dane symulowane)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
kol_op <- c(A = "#0072B2", B = "#E69F00", C = "#D55E00")
ksz_op <- c(A = 16, B = 17, C = 15)
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie: folia o grubości nominalnej 25 µm, tolerancja 22–28 µm
DGT <- 22; GGT <- 28                       # dolna i górna granica tolerancji (µm)
n_czesci <- 10; n_oper <- 3; n_powt <- 3
sd_czesc <- 1.00                           # rozrzut prawdziwej grubości próbek z produkcji (µm)
efekt_oper <- c(A = 0, B = -0.10, C = 0.25) # operator C dociska trzpień słabiej i odczytuje grubiej (µm)
sd_interakcja <- 0.08                      # część × operator (µm)
sd_powt <- 0.22                            # powtarzalność grubościomierza (µm)
set.seed(647)
prawda <- rnorm(n_czesci, 25, sd_czesc)
folia <- expand.grid(powtorzenie = 1:n_powt, operator = names(efekt_oper), czesc = 1:n_czesci)
folia <- folia[, c("czesc", "operator", "powtorzenie")]
inter <- matrix(rnorm(n_czesci * n_oper, 0, sd_interakcja), n_czesci, n_oper, dimnames = list(NULL, names(efekt_oper)))
folia$grubosc_um <- round(prawda[folia$czesc] + efekt_oper[as.character(folia$operator)] +
                            inter[cbind(folia$czesc, as.integer(folia$operator))] + rnorm(nrow(folia), 0, sd_powt), 1)
folia$czesc <- factor(folia$czesc); folia$operator <- factor(folia$operator)
write.csv(folia, "gage-rr-grubosc-folii.csv", row.names = FALSE)

# Przegląd: ile pomiarów, zakres, średnie operatorów i średni rozstęp powtórzeń
c(pomiary = nrow(folia), min = min(folia$grubosc_um), max = max(folia$grubosc_um))
round(tapply(folia$grubosc_um, folia$operator, mean), 2)
rozstep <- aggregate(grubosc_um ~ czesc + operator, folia, function(x) diff(range(x)))
round(tapply(rozstep$grubosc_um, rozstep$operator, mean), 3)        # średni rozstęp 3 powtórzeń wg operatora
range(tapply(folia$grubosc_um, folia$czesc, mean))                  # najcieńsza i najgrubsza próbka (średnia)

# Rysunek 1
sr_oc <- aggregate(grubosc_um ~ czesc + operator, folia, mean)
pA <- ggplot(folia, aes(czesc, grubosc_um, colour = operator, shape = operator)) +
  geom_point(position = position_dodge(width = 0.6), size = 2, alpha = 0.85) +
  scale_colour_manual(values = kol_op, name = "Operator") + scale_shape_manual(values = ksz_op, name = "Operator") +
  labs(x = "Próbka folii", y = "Grubość (µm)", title = "A. Wszystkie 90 pomiarów: trzy odczyty każdego operatora",
       subtitle = "Rozrzut w obrębie operatora = powtarzalność; przesunięcia między operatorami = odtwarzalność") + motyw
pB <- ggplot(sr_oc, aes(czesc, grubosc_um, colour = operator, shape = operator, group = operator)) +
  geom_line(linewidth = 0.6) + geom_point(size = 2.4) +
  scale_colour_manual(values = kol_op, name = "Operator") + scale_shape_manual(values = ksz_op, name = "Operator") +
  labs(x = "Próbka folii", y = "Średnia z 3 pomiarów (µm)", title = "B. Średnie operatorów dla każdej próbki",
       subtitle = "Linie prawie równoległe = mała interakcja próbka × operator; C zwykle najwyżej") + motyw
p1 <- (pA + guides(colour = "none", shape = "none")) / pB
p1   # zapis: ggsave("gage-rr-wyniki-operatorow.svg", p1, width = 10, height = 8.6)
Wynik w R
pomiary     min     max
   90.0    23.0    26.5
    A     B     C
25.27 25.16 25.50
   A    B    C
0.44 0.41 0.34
[1] 23.36667 26.04444
2. ANOVA, składowe wariancji, %GRR, % tolerancji, ndc i bootstrap: Rysunek 3
R
# Rysunek 3. ANOVA dwuczynnikowa z interakcją → składowe wariancji, %GRR, %tolerancji, ndc i przedziały bootstrapowe
# Korzysta z obiektów przepisu 1: folia, kol, motyw, DGT, GGT. Losuje tylko bootstrap (własne set.seed).
library(ggplot2)
library(patchwork)
library(lme4)

# ANOVA: próbka i operator jako czynniki skrzyżowane, z interakcją
m_aov <- aov(grubosc_um ~ czesc * operator, data = folia)
summary(m_aov)

# Składowe wariancji z wartości oczekiwanych średnich kwadratów (model losowy; p próbek, o operatorów, r powtórzeń)
skladowe <- function(y, czesc, operator) {
  p <- nlevels(czesc); o <- nlevels(operator); r <- length(y) / (p * o)
  sr <- mean(y); sr_c <- tapply(y, czesc, mean); sr_o <- tapply(y, operator, mean)
  sr_co <- tapply(y, list(czesc, operator), mean)
  MS_C <- o * r * sum((sr_c - sr)^2) / (p - 1)
  MS_O <- p * r * sum((sr_o - sr)^2) / (o - 1)
  MS_CO <- r * sum((sr_co - outer(sr_c, rep(1, o)) - outer(rep(1, p), sr_o) + sr)^2) / ((p - 1) * (o - 1))
  MS_E <- sum((y - sr_co[cbind(as.integer(czesc), as.integer(operator))])^2) / (p * o * (r - 1))
  c(powtarzalnosc = MS_E, czesc_x_operator = (MS_CO - MS_E) / r,
    operator = (MS_O - MS_CO) / (p * r), czesc = (MS_C - MS_CO) / (o * r))
}
wsk <- function(v, tol = GGT - DGT) {          # wskaźniki Gage R&R; ujemne składowe obcinamy do zera
  v <- pmax(v, 0)
  odtw <- v[["operator"]] + v[["czesc_x_operator"]]; grr <- v[["powtarzalnosc"]] + odtw
  calk <- grr + v[["czesc"]]
  c(proc_GRR = 100 * sqrt(grr / calk), proc_tol = 100 * 6 * sqrt(grr) / tol,
    ndc = 1.41 * sqrt(v[["czesc"]] / grr), ICC = v[["czesc"]] / calk)
}
v <- skladowe(folia$grubosc_um, folia$czesc, folia$operator)
round(v, 4)                                   # wariancje (µm²); ujemna wartość = oszacowanie poniżej zera

# Tabela Gage R&R: wariancja, % wkładu (wariancji), SD, % zmienności badania (SD), % tolerancji (6·SD / 6 µm)
v0 <- pmax(v, 0)
tab_var <- c(GRR = v0[["powtarzalnosc"]] + v0[["operator"]] + v0[["czesc_x_operator"]],
             powtarzalnosc = v0[["powtarzalnosc"]], odtwarzalnosc = v0[["operator"]] + v0[["czesc_x_operator"]],
             operator = v0[["operator"]], czesc_x_operator = v0[["czesc_x_operator"]], czesc = v0[["czesc"]])
tab_var <- c(tab_var, calkowita = tab_var[["GRR"]] + tab_var[["czesc"]])
tabela <- data.frame(wariancja = tab_var, proc_wkladu = 100 * tab_var / tab_var[["calkowita"]],
                     SD = sqrt(tab_var), proc_zmiennosci = 100 * sqrt(tab_var / tab_var[["calkowita"]]),
                     proc_tolerancji = 100 * 6 * sqrt(tab_var) / (GGT - DGT))
round(tabela, 3)
round(wsk(v), 3)
floor(wsk(v)[["ndc"]])                        # ndc podaje się jako liczbę całkowitą (część całkowita)

# To samo modelem mieszanym (REML) – oszacowania wariancji nie mogą być ujemne
m_lmer <- lmer(grubosc_um ~ 1 + (1 | czesc) + (1 | operator) + (1 | czesc:operator), data = folia)
vc <- as.data.frame(VarCorr(m_lmer))
round(setNames(vc$vcov, vc$grp), 4)

# Przedziały 95%: bootstrap parametryczny – nowe badania 10 × 3 × 3 z oszacowanych składowych, 2000 powtórzeń
set.seed(647)
B <- 2000
boot <- t(replicate(B, {
  czesc_b <- rnorm(10, 0, sqrt(v0[["czesc"]])); oper_b <- rnorm(3, 0, sqrt(v0[["operator"]]))
  inter_b <- matrix(rnorm(30, 0, sqrt(v0[["czesc_x_operator"]])), 10, 3)
  y <- czesc_b[as.integer(folia$czesc)] + oper_b[as.integer(folia$operator)] +
    inter_b[cbind(as.integer(folia$czesc), as.integer(folia$operator))] + rnorm(90, 0, sqrt(v0[["powtarzalnosc"]]))
  vb <- skladowe(y, folia$czesc, folia$operator)
  c(wsk(vb), sd_operator = sqrt(max(vb[["operator"]], 0)), ujemna_operator = vb[["operator"]] < 0,
    ujemna_interakcja = vb[["czesc_x_operator"]] < 0)
}))
round(apply(boot[, c("proc_GRR", "proc_tol", "ndc", "sd_operator")], 2, quantile, c(.025, .5, .975)), 2)
round(100 * colMeans(boot[, c("ujemna_operator", "ujemna_interakcja")]), 1)   # % badań z ujemną składową

# Rysunek 3
sk <- data.frame(zrodlo = factor(c("Powtarzalność", "Odtwarzalność", "Gage R&R razem", "Próbka (część)"),
                                 levels = c("Powtarzalność", "Odtwarzalność", "Gage R&R razem", "Próbka (część)")),
                 wariancja = tabela[c("powtarzalnosc", "odtwarzalnosc", "GRR", "czesc"), ])
sk <- rbind(data.frame(zrodlo = sk$zrodlo, miara = "% wkładu (wariancja)", wartosc = sk$wariancja.proc_wkladu),
            data.frame(zrodlo = sk$zrodlo, miara = "% zmienności badania (SD)", wartosc = sk$wariancja.proc_zmiennosci),
            data.frame(zrodlo = sk$zrodlo, miara = "% tolerancji (6·SD / 6 µm)", wartosc = sk$wariancja.proc_tolerancji))
sk$miara <- factor(sk$miara, levels = unique(sk$miara))
pA <- ggplot(sk, aes(zrodlo, wartosc, fill = miara)) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75, colour = "grey30", linewidth = 0.2) +
  geom_text(aes(label = sprintf("%.1f", wartosc)), position = position_dodge(width = 0.8), vjust = -0.3, size = 3.1) +
  geom_hline(yintercept = c(10, 30), linetype = "dashed", colour = "grey35") +
  scale_fill_manual(values = c("#CFE3F2", "#0072B2", "#E69F00"), name = NULL) +
  scale_y_continuous(limits = c(0, 115), breaks = seq(0, 100, 20)) +
  labs(x = NULL, y = "%", title = "A. Trzy sposoby wyrażenia tej samej zmienności",
       subtitle = "Linie przerywane: 10% i 30% – progi zwykle stosowane do %GRR i %tolerancji") + motyw
ci <- data.frame(miara = factor(c("%GRR (zmienność badania)", "% tolerancji"), levels = c("%GRR (zmienność badania)", "% tolerancji")),
                 est = c(wsk(v)[["proc_GRR"]], wsk(v)[["proc_tol"]]),
                 lo = c(quantile(boot[, "proc_GRR"], .025), quantile(boot[, "proc_tol"], .025)),
                 hi = c(quantile(boot[, "proc_GRR"], .975), quantile(boot[, "proc_tol"], .975)))
pB <- ggplot(ci, aes(est, miara)) +
  annotate("rect", xmin = 10, xmax = 30, ymin = -Inf, ymax = Inf, fill = "grey93") +
  geom_errorbar(aes(xmin = lo, xmax = hi), width = 0.2, orientation = "y", colour = kol[["niebieski"]], linewidth = 0.8) +
  geom_point(size = 3, colour = kol[["cynober"]], shape = 18) +
  geom_text(aes(label = sprintf("%.1f%% [%.1f, %.1f]", est, lo, hi)), vjust = -1.1, size = 3.4) +
  geom_vline(xintercept = c(10, 30), linetype = "dashed", colour = "grey35") +
  scale_x_continuous(limits = c(0, 60), breaks = seq(0, 60, 10)) +
  labs(x = "%", y = NULL, title = "B. %GRR i % tolerancji z 95% przedziałem (bootstrap, 2000 powtórzeń)",
       subtitle = "Szare pole: strefa „warunkowo do przyjęcia” (10–30%)") + motyw
p3 <- pA / pB + plot_layout(heights = c(1.7, 1))
p3   # zapis: ggsave("gage-rr-skladowe-wariancji.svg", p3, width = 10, height = 8.4)
Wynik w R
               Df Sum Sq Mean Sq F value  Pr(>F)
czesc           9  60.05   6.672 122.306 < 2e-16 ***
operator        2   1.81   0.907  16.627 1.8e-06 ***
czesc:operator 18   1.08   0.060   1.097   0.378
Residuals      60   3.27   0.055
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
   powtarzalnosc czesc_x_operator         operator            czesc
          0.0546           0.0018           0.0282           0.7347
                 wariancja proc_wkladu    SD proc_zmiennosci proc_tolerancji
GRR                  0.085      10.321 0.291          32.126          29.078
powtarzalnosc        0.055       6.659 0.234          25.805          23.357
odtwarzalnosc        0.030       3.662 0.173          19.136          17.321
operator             0.028       3.447 0.168          18.567          16.806
czesc_x_operator     0.002       0.214 0.042           4.631           4.192
czesc                0.735      89.679 0.857          94.699          85.717
calkowita            0.819     100.000 0.905         100.000          90.515
proc_GRR proc_tol      ndc      ICC
  32.126   29.078    4.156    0.897
[1] 4
czesc:operator          czesc       operator       Residual
        0.0018         0.7347         0.0282         0.0546
      proc_GRR proc_tol  ndc sd_operator
2.5%     20.52    21.98 2.14        0.00
50%      33.24    27.93 4.00        0.14
97.5%    55.01    40.39 6.72        0.32
  ujemna_operator ujemna_interakcja
              7.6              42.7
3. Grafika „drzewo podziału zmienności”: Rysunek 2
R
# Rysunek 2. Grafika: drzewo podziału zmienności pomiarów grubości folii
# Korzysta z obiektu tabela z przepisu 2 (liczby w polach). Niczego nie losuje.
library(ggplot2)

f <- function(w) sprintf("%.1f%% wariancji · SD = %.3f µm", tabela[w, "proc_wkladu"], tabela[w, "SD"])
pola <- data.frame(
  id = c("calk", "czesc", "grr", "powt", "odtw", "oper", "inter"),
  x = c(5, 2.2, 7.6, 5.9, 9.0, 7.75, 10.25), y = c(7, 4.9, 4.9, 2.8, 2.8, 0.7, 0.7),
  szer = c(2.3, 2.0, 2.0, 1.45, 1.2, 1.15, 1.15),
  typ = c("calk", "czesc", "pomiar", "pomiar", "pomiar", "pomiar", "pomiar"),
  tytul = c("Zmienność całkowita pomiarów", "Próbki (część)", "System pomiarowy – Gage R&R",
            "Powtarzalność", "Odtwarzalność", "Operator", "Próbka × operator"),
  opis = c(sprintf("90 pomiarów · wariancja %.3f µm² · SD = %.3f µm", tabela["calkowita", "wariancja"], tabela["calkowita", "SD"]),
           paste0(f("czesc"), "\nto chcemy widzieć: różnice między rolkami"),
           paste0(f("GRR"), "\nto, co dokłada sam pomiar"),
           paste0(sprintf("%.1f%% · SD = %.3f µm", tabela["powtarzalnosc", "proc_wkladu"], tabela["powtarzalnosc", "SD"]),
                  "\nta sama osoba, ta sama próbka,\nkolejny odczyt (przyrząd)"),
           paste0(sprintf("%.1f%% · SD = %.3f µm", tabela["odtwarzalnosc", "proc_wkladu"], tabela["odtwarzalnosc", "SD"]),
                  "\ninna osoba mierzy\nto samo"),
           sprintf("%.1f%% · SD = %.3f µm\nstałe przesunięcie osoby", tabela["operator", "proc_wkladu"], tabela["operator", "SD"]),
           sprintf("%.1f%% · SD = %.3f µm\nosoba myli się inaczej\nna różnych próbkach",
                   tabela["czesc_x_operator", "proc_wkladu"], tabela["czesc_x_operator", "SD"])))
wys <- 0.75
krawedzie <- data.frame(od = c("calk", "calk", "grr", "grr", "odtw", "odtw"),
                        do = c("czesc", "grr", "powt", "odtw", "oper", "inter"))
krawedzie$x <- pola$x[match(krawedzie$od, pola$id)]; krawedzie$y <- pola$y[match(krawedzie$od, pola$id)] - wys
krawedzie$xend <- pola$x[match(krawedzie$do, pola$id)]; krawedzie$yend <- pola$y[match(krawedzie$do, pola$id)] + wys
p2 <- ggplot() +
  geom_segment(data = krawedzie, aes(x, y, xend = xend, yend = yend),
               arrow = arrow(length = unit(0.2, "cm"), type = "closed"), colour = "grey35", linewidth = 0.5) +
  geom_rect(data = pola, aes(xmin = x - szer, xmax = x + szer, ymin = y - wys, ymax = y + wys, fill = typ),
            colour = "grey30", linewidth = 0.4) +
  geom_text(data = pola, aes(x, y + 0.42, label = tytul), fontface = "bold", size = 3.7, colour = "#0f1d3a") +
  geom_text(data = pola, aes(x, y - 0.18, label = opis), size = 3.1, lineheight = 0.92, colour = "grey15") +
  annotate("text", x = 0, y = 8.3, hjust = 0, size = 3.9, colour = "grey25",
           label = "Wariancje się sumują: całkowita = próbki + powtarzalność + operator + próbka × operator") +
  scale_fill_manual(values = c(calk = "#F2F2F2", czesc = "#CFE3F2", pomiar = "#F6C9A9"),
                    breaks = c("czesc", "pomiar"), labels = c("zmienność procesu (próbek)", "zmienność dodana przez pomiar"),
                    name = NULL) +
  coord_cartesian(xlim = c(-0.1, 11.5), ylim = c(-0.2, 8.6), expand = FALSE) +
  labs(title = "Skąd się bierze rozrzut 90 pomiarów grubości folii") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 6)),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
p2   # zapis: ggsave("gage-rr-drzewo-zmiennosci.svg", p2, width = 10, height = 7.2)
4. Symulacja doboru próbek: Rysunek 4
R
# Rysunek 4. Symulacja: ten sam grubościomierz, trzy sposoby doboru 10 próbek – 1000 badań na scenariusz
# Korzysta z funkcji skladowe() i wsk() z przepisu 2 oraz z kol, motyw, DGT, GGT z przepisu 1.
library(ggplot2)
library(patchwork)

# Prawdziwy system pomiarowy (ustalony ręcznie, zbliżony do przykładu): SD powtarzalności 0.22 µm,
# SD operatora 0.18 µm (operatorzy losowi), SD interakcji 0.08 µm; odczyt zaokrąglany do 0.1 µm
sd_p <- 0.22; sd_o <- 0.18; sd_po <- 0.08
grr_prawda <- sqrt(sd_p^2 + sd_o^2 + sd_po^2)
round(c(SD_GRR = grr_prawda, proc_tol_prawda = 100 * 6 * grr_prawda / (GGT - DGT)), 2)
scenariusze <- list("Z jednej rolki (SD próbek 0.3 µm)" = function() rnorm(10, 25, 0.3),
                    "Losowo z produkcji (SD 1.0 µm)" = function() rnorm(10, 25, 1.0),
                    "Rozłożone w tolerancji (22.5–27.5 µm)" = function() seq(22.5, 27.5, length.out = 10))
czesc <- factor(rep(1:10, each = 9)); operator <- factor(rep(rep(1:3, each = 3), 10))
jedno_badanie <- function(los_czesci) {
  y <- los_czesci()[as.integer(czesc)] + rnorm(3, 0, sd_o)[as.integer(operator)] +
    rnorm(30, 0, sd_po)[(as.integer(czesc) - 1) * 3 + as.integer(operator)] + rnorm(90, 0, sd_p)
  wsk(skladowe(round(y, 1), czesc, operator))
}
set.seed(647)
R <- 1000
sym <- do.call(rbind, lapply(names(scenariusze), function(s)
  data.frame(scenariusz = s, t(replicate(R, jedno_badanie(scenariusze[[s]]))))))
sym$scenariusz <- factor(sym$scenariusz, levels = names(scenariusze))
podsum <- do.call(rbind, lapply(split(sym, sym$scenariusz), function(d) data.frame(
  scenariusz = d$scenariusz[1], GRR_mediana = median(d$proc_GRR), GRR_q1 = quantile(d$proc_GRR, .25), GRR_q3 = quantile(d$proc_GRR, .75),
  tol_mediana = median(d$proc_tol), ndc_mediana = median(floor(d$ndc)),
  GRR_ponizej_30 = 100 * mean(d$proc_GRR < 30), ndc_co_najmniej_5 = 100 * mean(floor(d$ndc) >= 5))))
rownames(podsum) <- NULL
print(podsum, digits = 3)
round(100 * sqrt(0.25 / R), 1)                 # największy błąd Monte Carlo odsetka (pp) przy 1000 powtórzeń

# Rysunek 4
dl <- rbind(data.frame(scenariusz = sym$scenariusz, miara = "%GRR (zmienność badania)", wartosc = sym$proc_GRR),
            data.frame(scenariusz = sym$scenariusz, miara = "% tolerancji", wartosc = sym$proc_tol))
dl$miara <- factor(dl$miara, levels = c("%GRR (zmienność badania)", "% tolerancji"))
pA <- ggplot(dl, aes(scenariusz, wartosc, fill = miara)) +
  geom_hline(yintercept = c(10, 30), linetype = "dashed", colour = "grey35") +
  geom_boxplot(outlier.size = 0.6, outlier.alpha = 0.4, width = 0.6, position = position_dodge(width = 0.72)) +
  scale_fill_manual(values = c("#0072B2", "#E69F00"), name = NULL) +
  scale_x_discrete(labels = function(x) sub(" \\(", "\n(", x)) +
  labs(x = NULL, y = "%", title = "A. %GRR zależy od tego, jakie próbki wybrano; % tolerancji – nie",
       subtitle = sprintf("Ten sam przyrząd i ci sami operatorzy we wszystkich scenariuszach; prawdziwy %% tolerancji = %.1f%%",
                          100 * 6 * grr_prawda / (GGT - DGT))) + motyw
pB <- ggplot(sym, aes(scenariusz, floor(ndc))) +
  geom_hline(yintercept = 5, linetype = "dashed", colour = "grey35") +
  geom_count(colour = kol[["niebieski"]], alpha = 0.7) + scale_size_area(max_size = 9, name = "Liczba badań") +
  scale_y_continuous(breaks = seq(0, 12, 2)) +
  scale_x_discrete(labels = function(x) sub(" \\(", "\n(", x)) +
  labs(x = NULL, y = "ndc (liczba kategorii)", title = "B. Liczba rozróżnialnych kategorii (ndc) w 1000 badaniach",
       subtitle = "Linia przerywana: ndc = 5, często wymagane minimum") + motyw
p4 <- pA / pB
p4   # zapis: ggsave("gage-rr-dobor-probek-symulacja.svg", p4, width = 10, height = 9)
Wynik w R
         SD_GRR proc_tol_prawda
           0.30           29.53
                             scenariusz GRR_mediana GRR_q1 GRR_q3 tol_mediana
1     Z jednej rolki (SD próbek 0.3 µm)        70.8   63.1   78.6        28.0
2        Losowo z produkcji (SD 1.0 µm)        29.0   24.0   34.5        28.0
3 Rozłożone w tolerancji (22.5–27.5 µm)        16.3   14.9   18.7        27.8
  ndc_mediana GRR_ponizej_30 ndc_co_najmniej_5
1           1            0.0               0.0
2           4           55.8              39.1
3           8           99.8              99.1
[1] 1.6
5. Symulacja ujemnej składowej wariancji: Rysunek 5
R
# Rysunek 5. Symulacja: ujemne oszacowanie składowej wariancji i trzy sposoby postępowania – 1000 badań
# Korzysta z obiektów przepisów 1–2 i 4 (kol, motyw, DGT, GGT, czesc, operator, sd_p, sd_o). Losuje (własne set.seed).
library(ggplot2)
library(patchwork)
library(lme4)

# Prawdziwy system bez interakcji próbka × operator (SD interakcji = 0); próbki losowo z produkcji (SD 1.0 µm)
proc_tol <- function(s2) 100 * 6 * sqrt(sum(pmax(s2, 0))) / (GGT - DGT)
tol_prawda <- proc_tol(c(sd_p^2, sd_o^2))
round(tol_prawda, 2)
kontrola <- lmerControl(check.conv.singular = "ignore", check.conv.grad = "ignore", check.conv.hess = "ignore")  # wariancja na granicy 0 bywa zgłaszana jako ostrzeżenie zbieżności
jedno <- function() {
  y <- round(rnorm(10, 25, 1)[as.integer(czesc)] + rnorm(3, 0, sd_o)[as.integer(operator)] + rnorm(90, 0, sd_p), 1)
  a <- anova(lm(y ~ czesc * operator))
  MS <- a[["Mean Sq"]]; SS <- a[["Sum Sq"]]; df <- a[["Df"]]       # kolejność: czesc, operator, interakcja, reszta
  s2_inter <- (MS[3] - MS[4]) / 3; s2_oper <- (MS[2] - MS[3]) / 30
  # 1) obcięcie ujemnych do zera
  t_obc <- proc_tol(c(MS[4], max(s2_inter, 0), max(s2_oper, 0)))
  # 2) gdy p interakcji > .25 – model bez interakcji (interakcja dołączona do błędu)
  if (a[["Pr(>F)"]][3] > .25) {
    MSE_l <- (SS[3] + SS[4]) / (df[3] + df[4])
    t_lacz <- proc_tol(c(MSE_l, max((MS[2] - MSE_l) / 30, 0)))
  } else t_lacz <- t_obc
  # 3) REML w modelu mieszanym (oszacowania na granicy 0 zamiast ujemnych)
  vc <- as.data.frame(VarCorr(lmer(y ~ 1 + (1 | czesc) + (1 | operator) + (1 | czesc:operator), control = kontrola)))
  t_reml <- proc_tol(vc$vcov[vc$grp != "czesc"])
  c(s2_inter = s2_inter, p_inter = a[["Pr(>F)"]][3], ujemna_oper = s2_oper < 0,
    obciecie = t_obc, laczenie = t_lacz, REML = t_reml)
}
set.seed(647)
R <- 1000
neg <- as.data.frame(t(replicate(R, jedno())))
round(c(proc_ujemna_interakcja = 100 * mean(neg$s2_inter < 0), proc_p_inter_powyzej_25 = 100 * mean(neg$p_inter > .25),
        proc_ujemny_operator = 100 * mean(neg$ujemna_oper)), 1)
round(sapply(neg[, c("obciecie", "laczenie", "REML")], function(x)
  c(srednia = mean(x), mediana = median(x), obciazenie = mean(x) - tol_prawda, sd = sd(x))), 2)

# Rysunek 5
neg$znak <- factor(ifelse(neg$s2_inter < 0, "ujemne", "dodatnie lub zero"), levels = c("ujemne", "dodatnie lub zero"))
pA <- ggplot(neg, aes(s2_inter, fill = znak)) +
  geom_histogram(binwidth = 0.004, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = 0, colour = "grey20") +
  scale_fill_manual(values = c("ujemne" = "#D55E00", "dodatnie lub zero" = "grey65"), name = NULL) +
  labs(x = "Oszacowana wariancja interakcji próbka × operator (µm²)", y = "Liczba badań",
       title = "A. Prawdziwa interakcja = 0, a ANOVA często daje wariancję ujemną",
       subtitle = sprintf("%.1f%% z 1000 badań: oszacowanie poniżej zera (wariancja nie może być ujemna)",
                          100 * mean(neg$s2_inter < 0))) + motyw
dl <- data.frame(metoda = factor(rep(c("obcięcie do 0", "łączenie z błędem (p > .25)", "REML (lme4)"), each = R),
                                 levels = c("obcięcie do 0", "łączenie z błędem (p > .25)", "REML (lme4)")),
                 proc_tol = c(neg$obciecie, neg$laczenie, neg$REML))
pB <- ggplot(dl, aes(metoda, proc_tol)) +
  geom_hline(yintercept = tol_prawda, colour = kol[["cynober"]], linetype = "dashed") +
  geom_boxplot(fill = "#CFE3F2", width = 0.5, outlier.size = 0.6, outlier.alpha = 0.4) +
  labs(x = NULL, y = "% tolerancji", title = "B. Trzy sposoby postępowania dają prawie ten sam %GRR",
       subtitle = sprintf("Oszacowania %% tolerancji w tych samych 1000 badaniach; linia przerywana: prawda (%.1f%%)", tol_prawda)) + motyw
p5 <- pA / pB
p5   # zapis: ggsave("gage-rr-ujemna-skladowa.svg", p5, width = 10, height = 8.4)
Wynik w R
[1] 28.43
 proc_ujemna_interakcja proc_p_inter_powyzej_25    proc_ujemny_operator
                   52.0                    74.3                     5.9
           obciecie laczenie  REML
srednia       28.34    27.97 27.98
mediana       27.31    26.87 26.89
obciazenie    -0.09    -0.45 -0.45
sd             5.34     5.37  5.38
6. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy (operator A / B; %GRR / % tolerancji)" = c("#0072B2", "#E69F00"),
             "pomarańczowy – cynober (operator B / C)" = c("#E69F00", "#D55E00"),
             "niebieski – cynober (operator A / C)" = c("#0072B2", "#D55E00"),
             "jasnoniebieski – niebieski (% wkładu / % zmienności)" = c("#CFE3F2", "#0072B2"),
             "jasnoniebieski – jasnopomarańczowy (proces / pomiar)" = c("#CFE3F2", "#F6C9A9"),
             "cynober – szary (ujemne / dodatnie)" = c("#D55E00", "#A6A6A6"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                               widzenie_typowe
niebieski – pomarańczowy (operator A / B; %GRR / % tolerancji)           120.2
pomarańczowy – cynober (operator B / C)                                   33.4
niebieski – cynober (operator A / C)                                     114.6
jasnoniebieski – niebieski (% wkładu / % zmienności)                      53.7
jasnoniebieski – jasnopomarańczowy (proces / pomiar)                      35.4
cynober – szary (ujemne / dodatnie)                                       77.9
czerwony – zielony (do unikania)                                         121.7
                                                               deuteranopia
niebieski – pomarańczowy (operator A / B; %GRR / % tolerancji)        121.5
pomarańczowy – cynober (operator B / C)                                18.4
niebieski – cynober (operator A / C)                                  108.3
jasnoniebieski – niebieski (% wkładu / % zmienności)                   56.3
jasnoniebieski – jasnopomarańczowy (proces / pomiar)                   34.6
cynober – szary (ujemne / dodatnie)                                    63.5
czerwony – zielony (do unikania)                                       21.1
                                                               protanopia
niebieski – pomarańczowy (operator A / B; %GRR / % tolerancji)      109.3
pomarańczowy – cynober (operator B / C)                              24.9
niebieski – cynober (operator A / C)                                 91.9
jasnoniebieski – niebieski (% wkładu / % zmienności)                 50.0
jasnoniebieski – jasnopomarańczowy (proces / pomiar)                 29.9
cynober – szary (ujemne / dodatnie)                                  57.6
czerwony – zielony (do unikania)                                     31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, ANOVA – pakiety base i stats; model mieszany REML – pakiet lme4). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Próbki z jednej rolki. Przy podobnych próbkach %GRR rośnie, a ndc spada, choć przyrząd się nie zmienił (rysunek 4).
- Jedna liczba zamiast dwóch. %GRR mówi o procesie, % tolerancji – o specyfikacji. Podaj obie i napisz, do czego ma służyć pomiar.
- ndc jako trzecie, niezależne kryterium. To przekształcenie tego samego stosunku SD (Woodall i Borror, 2008).
- Werdykt bez niepewności. Przy 3 operatorach 28% i 32% to w praktyce ten sam przyrząd.
- Operator zna poprzedni odczyt. Pamięć zaniża powtarzalność. Mierz w losowej kolejności, z ukrytymi oznaczeniami próbek.
- Pomiar niszczący. Gdy próbki nie da się zmierzyć ponownie (np. test rozciągania folii), zwykły plan skrzyżowany nie działa – potrzebny jest inny plan, np. z czynnikami zagnieżdżonymi; Burdick i in. (2003) wskazują literaturę dla sytuacji, w których standardowy plan dwuczynnikowy się nie sprawdza.
Najczęstsze pytania
Co to jest Gage R&R i do czego służy?
To badanie, które sprawdza, ile zmienności wyników daje sam pomiar. Kilku operatorów mierzy kilkakrotnie te same próbki, a analiza wariancji dzieli rozrzut na różnice między próbkami, powtarzalność (ta sama osoba, ten sam przedmiot) i odtwarzalność (różnice między osobami). Robi się je przed liczeniem zdolności procesu i przed wprowadzeniem karty kontrolnej.
Jaki wynik %GRR jest akceptowalny?
W praktyce przemysłowej poniżej 10% uznaje się za dobry pomiar, 10–30% za warunkowo do przyjęcia, powyżej 30% za za słaby; ndc powinno wynosić co najmniej 5. Wynik blisko progu traktuj ostrożnie: w przykładzie %GRR = 32.1% miał 95% przedział od 20.5% do 55.0%.
Czym różni się %GRR od procentu tolerancji?
%GRR odnosi SD pomiaru do całkowitej SD wyników z badania, więc zależy od tego, jak bardzo różnią się wybrane próbki. Procent tolerancji odnosi 6 SD pomiaru do szerokości pola tolerancji i od próbek nie zależy. %GRR jest ważniejszy przy sterowaniu procesem, procent tolerancji – przy ocenie zgodności wyrobów ze specyfikacją.
Co zrobić, gdy składowa wariancji wychodzi ujemna?
To normalny skutek błędu losowego, gdy prawdziwa składowa jest bliska zera. Najczęściej obcina się ją do zera, dołącza interakcję do błędu (gdy jej p > .25) albo szacuje model metodą REML, która nie dopuszcza ujemnych wariancji (Thompson, 1962). W symulacji wszystkie trzy sposoby dały prawie ten sam procent tolerancji.
Jak wybrać próbki do badania Gage R&R?
Próbki powinny pokrywać typową zmienność procesu – z różnych partii, maszyn i zmian, a nie z jednej rolki czy jednej serii. Gdy próbki są zbyt podobne, %GRR rośnie, a ndc spada, choć przyrząd się nie zmienił. Browne i in. (2010) proponują plan dwuetapowy z celowym wyborem części skrajnych.
Powiązane hasła
Przeczytaj też
Zdolność procesu – Cp i Cpk
Toczenie wałków: karta X̄–R, Cp, Cpk, Pp, Ppk, ppm, przedziały ufności dla Cpk z symulacją i rozkład skośny – pięć rysunków z kodem R.
Czytaj →PoradnikZgodność dwóch metod pomiaru: CCC, Deming, Passing–Bablok
CCC Lina, regresja Deminga i Passinga–Babloka, błąd stały i proporcjonalny, bootstrapowe przedziały ufności, przykład w R i wzór opisu.
Czytaj →PoradnikOcena 360 stopni: zgodność i łagodność
60 kierowników restauracji: ICC i rwg, samoocena, łagodność przełożonych w modelu lme4, efekt aureoli i ile ocen potrzeba – z kodem R.
Czytaj →Robisz analizę systemu pomiarowego w pracy z zarządzania jakością?
Pomożemy zaplanować badanie Gage R&R, policzyć składowe wariancji z przedziałami ufności i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Browne, R., MacKay, J., & Steiner, S. (2010). Leveraged gauge R&R studies. Technometrics, 52(3), 294–302. https://doi.org/10.1198/tech.2010.09037
- Burdick, R. K., Borror, C. M., & Montgomery, D. C. (2003). A review of methods for measurement systems capability analysis. Journal of Quality Technology, 35(4), 342–354. https://doi.org/10.1080/00224065.2003.11980232
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Thompson, W. A. (1962). The problem of negative estimates of variance components. The Annals of Mathematical Statistics, 33(1), 273–289. https://doi.org/10.1214/aoms/1177704731 ● Otwarty dostęp
- Woodall, W. H., & Borror, C. M. (2008). Some relationships between gage R&R criteria. Quality and Reliability Engineering International, 24(1), 99–106. https://doi.org/10.1002/qre.870
Cytowania BibTeX
@article{browne2010leveraged, author={Browne, Ryan and MacKay, Jock and Steiner, Stefan}, title={{Leveraged gauge R\&R studies}}, journal={Technometrics}, year={2010}, volume={52}, number={3}, pages={294--302}, doi={10.1198/tech.2010.09037}}@article{burdick2003review, author={Burdick, Richard K. and Borror, Connie M. and Montgomery, Douglas C.}, title={{A review of methods for measurement systems capability analysis}}, journal={Journal of Quality Technology}, year={2003}, volume={35}, number={4}, pages={342--354}, doi={10.1080/00224065.2003.11980232}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{thompson1962problem, author={Thompson, W. A.}, title={{The problem of negative estimates of variance components}}, journal={The Annals of Mathematical Statistics}, year={1962}, volume={33}, number={1}, pages={273--289}, doi={10.1214/aoms/1177704731}}@article{woodall2008some, author={Woodall, William H. and Borror, Connie M.}, title={{Some relationships between gage R\&R criteria}}, journal={Quality and Reliability Engineering International}, year={2008}, volume={24}, number={1}, pages={99--106}, doi={10.1002/qre.870}}