Przykład: 60 kierowników restauracji i pytanie „kto naprawdę dobrze zarządza?”
Fikcyjna sieć 60 restauracji raz w roku prowadzi ocenę 360 stopni swoich kierowników. Każdego kierownika ocenia przełożony (kierownik regionu), dwóch współpracowników – kierowników sąsiednich restauracji – i od 3 do 6 podwładnych; kierownik wypełnia też samoocenę. Oceniane są cztery kompetencje: organizacja zmiany, komunikacja z zespołem, dbałość o standardy i rozwój pracowników, każda na skali 1–5 (średnia kilku pytań). Razem 337 oceniających, 507 par „oceniający – kierownik” i 2028 ocen. Dział personalny pyta: czy tym ocenom można ufać, kto ocenia zbyt łagodnie i czy na ich podstawie wolno zrobić ranking do premii?
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy: 10 regionów po 6 restauracji; średnia ocena przełożonego 3.6; współpracownicy oceniają średnio o 0.10, a podwładni o 0.20 punktu wyżej; prawdziwe różnice między kierownikami SD = 0.30, w poszczególnych kompetencjach SD = 0.25; łagodność oceniającego SD = 0.30, jego ogólne wrażenie o konkretnym kierowniku SD = 0.30, błąd oceny SD = 0.30. Samoocena jest o 0.40 wyższa i tylko w połowie zależy od prawdziwego poziomu pracy. Ziarno 644 ustalono raz i nie zmieniano go. Dane pobierzesz jako ocena-360-restauracje-dane.csv (wiersz = jedna ocena jednej kompetencji).
Ocena 360 stopni to typowy temat pracy dyplomowej z zarządzania zasobami ludzkimi. Inne projekty z tej dziedziny opisuje wpis statystyka w pracy z zarządzania i ekonomii.
Rysunek 1: kto ocenia kogo
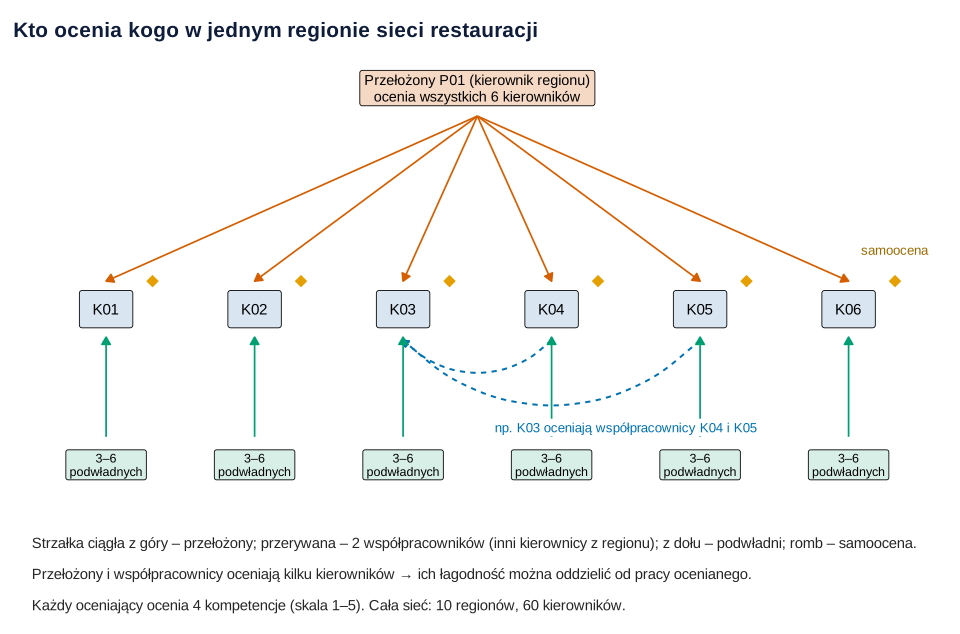
Co widać. Oceniający są różnego rodzaju. Przełożony ocenia wszystkich sześciu kierowników regionu, a każdy kierownik ocenia dwóch kolegów – ci oceniający pojawiają się w danych wiele razy. Podwładni oceniają tylko swojego kierownika. To czynniki skrzyżowane: dzięki nim da się oddzielić łagodność oceniającego od pracy ocenianego.
Jak może zmylić. Podwładni są zagnieżdżeni w kierownikach: ich łagodności nie odróżnisz od wrażenia o jedynym ocenianym szefie.
Podpis do pracy:
Zdanie do Metody:
Zgodność w grupie: ICC(1), ICC(k) i rwg
Pierwsze pytanie: czy podwładni tego samego kierownika widzą go podobnie? Odpowiadają na nie dwie wersje współczynnika korelacji wewnątrzklasowej z jednoczynnikowej analizy wariancji (Shrout i Fleiss, 1979):
- ICC(1) – rzetelność pojedynczej oceny: jaka część różnic w ocenach to różnice między kierownikami. Dla podwładnych ICC(1) = .34, 95% CI [.22, .44] (bootstrap kierowników), dla współpracowników .35.
- ICC(k) – rzetelność średniej z k ocen. Średnia z przeciętnie 4.4 podwładnych ma ICC(k) = .70, średnia dwóch współpracowników – .52.
Według progów Koo i Li (2016) pojedyncza ocena podwładnego jest mało rzetelna, a średnia z kilku – umiarkowanie. Wyniki pasują do metaanalizy Conwaya i Huffcutta (1997): średnia rzetelność pojedynczej oceny wynosiła tam .30 dla podwładnych, .37 dla współpracowników i .50 dla przełożonych. Rzetelności przełożonego w naszych danych nie policzysz – każdy kierownik ma tylko jednego.
rwg (James i in., 1984) mierzy coś innego: czy podwładni jednego kierownika dają bliskie sobie oceny w porównaniu z odpowiadaniem na chybił trafił (rozkład równomierny na skali 1–5, wariancja 2). Mediana rwg wynosi .91, a 95.0% kierowników ma rwg ≥ .70. To wysoka zgodność przy niskiej rzetelności – sprzeczność pozorna. Podwładni oceniają swojego szefa podobnie i raczej wysoko, więc rwg jest duże, ale różnice między kierownikami są małe w porównaniu z różnicami między oceniającymi. James i in. (1984) zwracają uwagę, że tendencje odpowiedzi, np. łagodność, mogą pozornie zawyżać oszacowania zgodności – a rozkład równomierny zakłada, że bez zgody oceniający używaliby całej skali. Więcej o wyborze miar: zgodność sędziów: kappa, ICC, alfa.
Korelacje między źródłami. Średnie ocen kierowników korelują: przełożony ze współpracownikami r = .51, z podwładnymi .48, współpracownicy z podwładnymi .71, a samoocena z innymi źródłami tylko .25–.36. Harris i Schaubroeck (1988) w metaanalizie znaleźli podobny wzór: przełożony i współpracownicy zgadzają się wyraźnie (ρ = .62), samoocena z nimi – umiarkowanie (ρ = .35 i .36).
Rysunek 2: samoocena a ocena innych
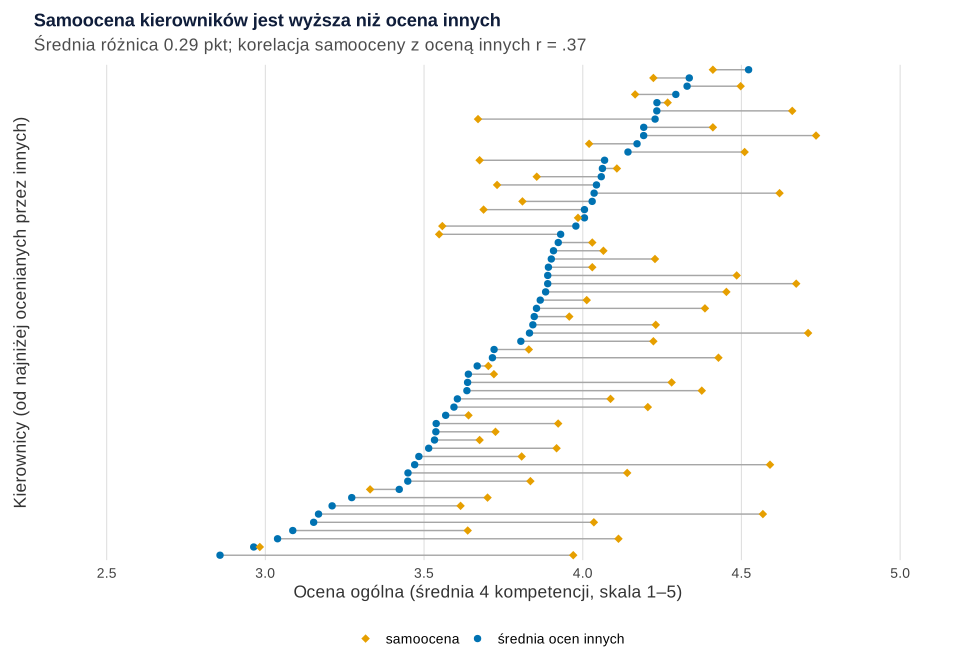
set.seed(644)).Co widać. 76.7% kierowników ocenia się wyżej niż widzą ich inni. Średnia różnica wynosi 0.29 punktu, 95% CI [0.18, 0.39], t(59) = 5.26, p < .001. Samoocena koreluje z oceną innych tylko na poziomie r = .37, więc rozbieżności są bardzo różne u różnych osób (SD różnicy = 0.42).
Jak może zmylić. Wśród najniżej ocenianych przez innych przeszacowanie wynosi średnio 0.53 punktu, a wśród najwyżej ocenianych −0.03. Kusi wniosek, że słabsi gorzej widzą siebie, ale część tego wzoru to regresja do średniej. Gdy sortujesz po jednej z dwóch słabo skorelowanych miar, różnica musi rosnąć na krańcach – nawet gdy wszyscy przeszacowują siebie tak samo.
Podpis do pracy:
Zdanie do Wyników:
Model łagodności: oceniający i oceniany jako efekty losowe
Każda ocena jest sumą kilku składników: prawdziwego poziomu pracy kierownika, jego mocnych i słabych kompetencji, łagodności oceniającego, ogólnego wrażenia, jakie ten oceniający ma o tym konkretnym kierowniku, i przypadkowego błędu. Oszacuje je model mieszany ze skrzyżowanymi efektami losowymi kierownika i oceniającego. W R to jedna formuła pakietu lme4 (Bates i in., 2015):
Źródło i kompetencja to efekty stałe, a cztery efekty losowe – cztery rodzaje różnic. Samoocenę pomijamy.
| Składowa | SD (pkt) | Udział w wariancji |
|---|---|---|
| kierownik – ogólny poziom pracy | 0.31 | 23.6% |
| kierownik × kompetencja | 0.24 | 13.6% |
| oceniający – łagodność | 0.30 | 22.1% |
| oceniający × kierownik – ogólne wrażenie | 0.29 | 21.0% |
| błąd | 0.29 | 19.8% |
Wynik. Oceniający odpowiadają za 43.1% wariancji ocen, a oceniani – za 37.2%. Ocena mówi więc o oceniającym co najmniej tyle samo, co o ocenianym. W prawdziwych danych bywa gorzej: Scullen i in. (2000) w dwóch zbiorach ocen po ponad 2000 menedżerów przypisali efektom oceniającego 62% i 53% wariancji, a pracy ocenianego – 21% i 25%. Współpracownicy oceniają według modelu średnio o 0.21, a podwładni o 0.30 punktu wyżej niż przełożeni (w danych: 0.10 i 0.20 – przy 10 przełożonych ich przeciętna surowość też jest losowa).
Rysunek 3: łagodni i surowi przełożeni
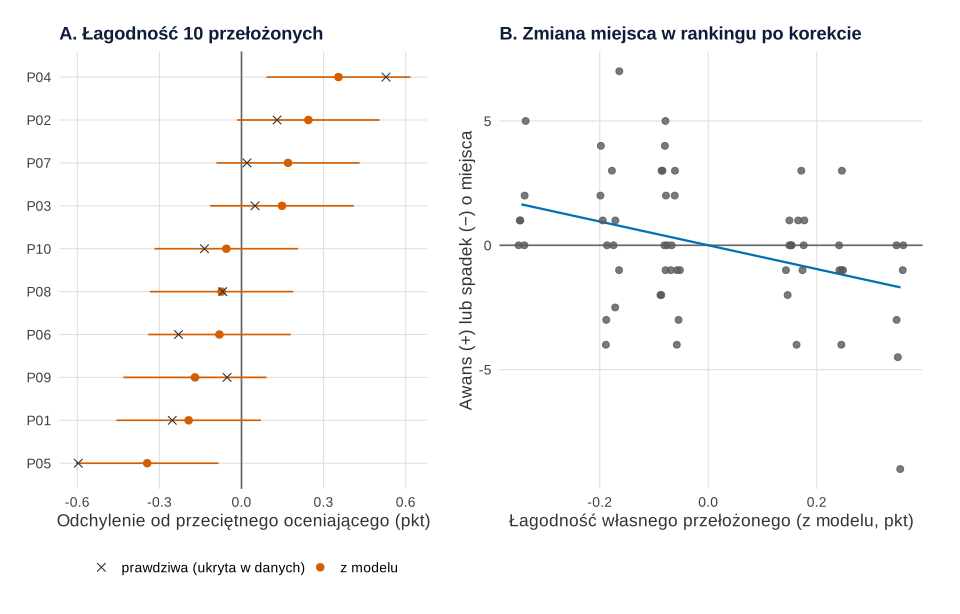
Co widać. Panel A to wykres gąsienicowy łagodności przełożonych: od −0.34 punktu (P05, najsurowszy) do +0.35 (P04, najłagodniejszy), przy SE = 0.13. Oszacowania korelują z prawdziwymi wartościami na poziomie r = .91, ale są ściągnięte do średniej (prawda: −0.60 i +0.53). Panel B: po korekcie kierownik zmienia miejsce w rankingu średnio o 1.93 pozycji, najwięcej o 9, a czterech – o 5 lub więcej. Im łagodniejszy przełożony, tym bardziej kierownik spada (r = −.37). W regionie P04 kierownicy tracą średnio 2.9 miejsca, w regionie P05 zyskują 1.5.
Wynik skorygowany to średni poziom kierownika z modelu (wyraz wolny + efekt losowy kierownika). Usuwa łagodność oceniających, którzy ocenili kilka osób, i różny skład źródeł (kierownik z sześcioma podwładnymi ma w średniej większy udział ocen tego źródła, które ocenia najwyżej). Z prawdziwym poziomem pracy koreluje na poziomie .85, a surowa średnia ocen – .84. Korekta niewiele poprawia trafność całej listy, ale zmienia pozycje pojedynczych osób – a o premii decyduje pozycja.
Jak może zmylić. Przedziały w panelu A nakładają się; tylko P05 i P04 wyraźnie odstają od przeciętnego oceniającego.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: efekt aureoli
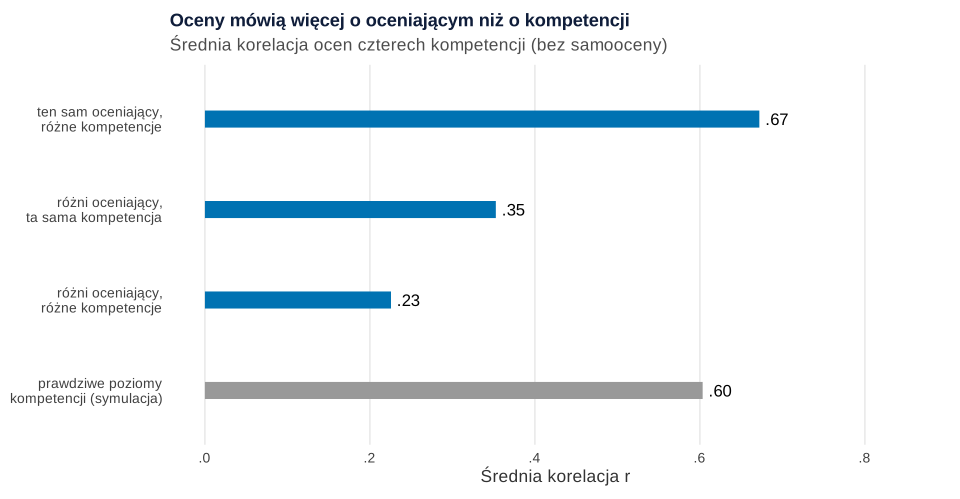
Co widać. Dwie kompetencje ocenione przez tę samą osobę korelują średnio na poziomie .67. Ta sama kompetencja oceniona przez dwie różne osoby – tylko .35. Oceny więcej mówią o tym, kto ocenia, niż o tym, którą kompetencję ocenia. To ślad efektu aureoli: ogólne wrażenie i łagodność oceniającego przenikają do wszystkich kompetencji naraz. Ten sam mechanizm ogólnej sympatii widać w ankietach o markach (mapa percepcji marek).
Jak może zmylić. Wysokie korelacje kompetencji nie są w całości błędem. W naszych danych prawdziwe poziomy kompetencji też korelują (.60), bo dobry kierownik bywa dobry w wielu rzeczach. Murphy i in. (1993) podkreślają, że prawdziwej aureoli nie da się łatwo oddzielić od pozornej. Dlatego porównuj korelacje u tego samego i u różnych oceniających – a nie samą wysokość korelacji.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: ile ocen potrzeba?
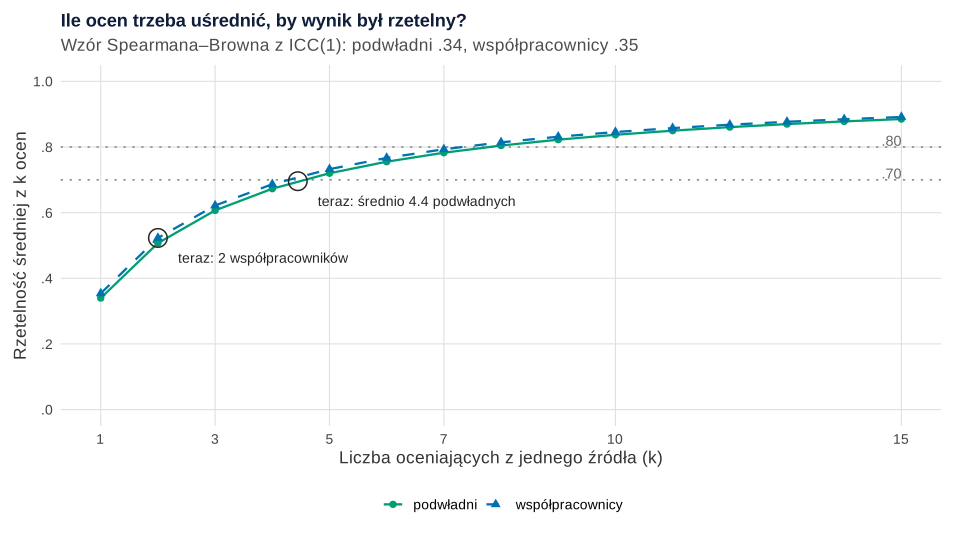
Co widać. Wzór Spearmana–Browna przelicza ICC(1) na rzetelność średniej z k ocen: k × ICC(1) / [1 + (k − 1) × ICC(1)]. Przy ICC(1) = .34 trzy oceny dają .61, sześć – .76, dziesięć – .84. Do rzetelności .70 trzeba 5 podwładnych, do .80 – 8, do .90 – 18. Dwóch współpracowników daje zaledwie .52.
Jak może zmylić. Wzór zakłada, że kolejni oceniający są tak samo dobrzy jak dotychczasowi.
Ranking z 3 ocen. Czy z takich średnich da się wybrać najlepszych? Zasymulowaliśmy 1000 sieci po 60 kierowników z ICC(1) jak w danych:
| Oceny podwładnych na kierownika | Korelacja rang z prawdą | Prawdziwa „dziesiątka” w obserwowanej (z 10) | Lider rankingu w prawdziwej dziesiątce | Lider rankingu = prawdziwy najlepszy |
|---|---|---|---|---|
| 3 | .75 | 5.99 | 87.3% | 30.4% |
| 6 | .85 | 6.76 | 96.0% | 42.8% |
| 12 | .91 | 7.61 | 98.6% | 57.0% |
Przy trzech ocenach tylko 6 z 10 najlepszych trafia do obserwowanej „dziesiątki”, a pierwszy na liście jest naprawdę najlepszy w 30.4% sieci (błąd Monte Carlo do 1.6 punktu procentowego). Nawet 12 ocen nie gwarantuje trafnego wyboru jednej osoby. Różnicę między oceną a pozycją na liście opisuje hasło ranking a ocena pozycji.
Co z tym zrobić w firmie
- Raportuj źródła osobno. Samoocena, przełożony i podwładni to różne perspektywy (Conway i Huffcutt, 1997). Średnia ze wszystkiego, łącznie z samooceną, je zaciera.
- Zbieraj co najmniej 5–8 ocen podwładnych, jeśli wynik ma trafić do decyzji. Gdy zespół jest mniejszy, pokazuj wynik jako informację rozwojową, nie jako miejsce w rankingu.
- Skoryguj łagodność tam, gdzie się da. Gdy przełożeni i współpracownicy oceniają po kilka osób, model z efektem oceniającego wyrówna szanse kierowników z regionów surowych i łagodnych.
- Nie premiuj na podstawie kolejności – używaj progów i przedziałów (np. „wyraźnie powyżej średniej sieci”).
- Łącz z innymi danymi kadrowymi. Czy słabo oceniani kierownicy szybciej tracą ludzi, sprawdzisz analizą przeżycia rotacji pracowników, a porównanie zespołów w ankiecie – w badaniu zaangażowania pracowników.
Jak opisać w pracy
W Metodzie opisz, kto kogo oceniał, liczbę oceniających w każdym źródle, skalę i kompetencje, sposób liczenia zgodności (forma ICC, rwg z założonym rozkładem zerowym) i model mieszany. W Wynikach podaj ICC z przedziałem, różnicę samooceny i ocen innych oraz udział wariancji oceniającego. Badanie we własnej firmie ma też stronę etyczną – zob. badanie we własnym miejscu pracy. Plan całej pracy pomoże ułożyć wpis jak napisać pracę z zarządzania i ekonomii.
Kod R: dane, zgodność, model łagodności i symulacja
Kod odtwarza wszystkie liczby z tekstu, obie tabele i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane), 2 (bootstrap), 4 (tylko rozsunięcie punktów) i 6 (symulacja rankingu); każdy zaczyna losowanie od własnego set.seed(644). Ziarno 644 ustalono raz i nie zmieniano go. Ręcznie ustalono: 10 regionów po 6 restauracji, 3–6 podwładnych na kierownika, średnią ocenę przełożonego (3.6), przesunięcia współpracowników (+0.10) i podwładnych (+0.20), odchylenia standardowe: prawdziwego poziomu pracy 0.30, kompetencji 0.25, łagodności oceniającego 0.30, wrażenia o kierowniku 0.30 i błędu 0.30, a dla samooceny przesunięcie +0.40, wagę prawdziwej pracy 0.5 i własny rozrzut 0.35. Oceny spoza skali przycięto do 1 i 5 (2.9% ocen). W symulacji rankingu prawdziwą wariancję i wariancję błędu ustalono tak, by ICC(1) było równe oszacowanemu w danych.
1. Paleta, dane i rysunek 1
R
# Rysunek 1. Fikcyjna sieć 60 restauracji: kto ocenia kogo w ocenie 360 stopni (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol_zrodlo <- c("przełożony" = "#D55E00", "współpracownik" = "#0072B2", "podwładny" = "#009E73", "samoocena" = "#E69F00")
ksztalt_zrodlo <- c("przełożony" = 15, "współpracownik" = 17, "podwładny" = 16, "samoocena" = 18)
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie (skala 1–5, ocena kompetencji = średnia kilku pytań)
R <- 10; M <- 6; N <- R * M                       # 10 regionów po 6 restauracji = 60 kierowników
kompetencje <- c("organizacja zmiany", "komunikacja z zespołem", "dbałość o standardy", "rozwój pracowników")
srednia <- 3.6                                    # średnia ocena przełożonego dla przeciętnego kierownika
przesuniecie <- c("przełożony" = 0, "współpracownik" = 0.10, "podwładny" = 0.20)  # źródła różnią się poziomem
sd_ogolny <- 0.30      # prawdziwe różnice między kierownikami (ogólny poziom pracy)
sd_wymiar <- 0.25      # prawdziwe różnice w poszczególnych kompetencjach
sd_lagodnosc <- 0.30   # łagodność/surowość oceniającego (ta sama dla wszystkich, których ocenia)
sd_wrazenie <- 0.30    # ogólne wrażenie oceniającego o konkretnym kierowniku (aureola)
sd_blad <- 0.30        # błąd pojedynczej oceny
samo_plus <- 0.40; samo_waga <- 0.5; sd_samo <- 0.35   # samoocena: wyższa i słabo związana z pracą

set.seed(644)                                     # ziarno ustalone raz, bez dobierania pod wynik
kier <- data.frame(kierownik = sprintf("K%02d", 1:N), region = rep(sprintf("R%02d", 1:R), each = M),
                   prawda = rnorm(N, 0, sd_ogolny), n_podwl = sample(3:6, N, replace = TRUE))
wymiar <- matrix(rnorm(N * 4, 0, sd_wymiar), N, 4)  # prawdziwe odchylenia w kompetencjach
# Lista ocen: kto (oceniający) ocenia kogo (kierownik) i z jakiej perspektywy
pary <- do.call(rbind, lapply(1:N, function(i) {
  r <- (i - 1) %/% M; poz <- (i - 1) %% M
  wsp <- r * M + (poz + 1:2) %% M + 1           # dwaj współpracownicy: kolejni kierownicy z regionu
  rbind(data.frame(kierownik = i, oceniajacy = sprintf("P%02d", r + 1), zrodlo = "przełożony"),
        data.frame(kierownik = i, oceniajacy = sprintf("K%02d", wsp), zrodlo = "współpracownik"),
        data.frame(kierownik = i, oceniajacy = sprintf("K%02d-p%d", i, 1:kier$n_podwl[i]), zrodlo = "podwładny"),
        data.frame(kierownik = i, oceniajacy = sprintf("K%02d", i), zrodlo = "samoocena"))
}))
ocen <- unique(pary$oceniajacy)
lagod <- setNames(rnorm(length(ocen), 0, sd_lagodnosc), ocen)       # łagodność każdego oceniającego
pary$wrazenie <- rnorm(nrow(pary), 0, sd_wrazenie)                # wrażenie o tym kierowniku
pary$samo <- rnorm(nrow(pary), 0, sd_samo)
dane <- do.call(rbind, lapply(1:4, function(d) {
  i <- pary$kierownik; inni <- pary$zrodlo != "samoocena"
  y <- ifelse(inni,
              srednia + przesuniecie[pary$zrodlo] + kier$prawda[i] + wymiar[cbind(i, d)] + lagod[pary$oceniajacy] + pary$wrazenie,
              srednia + samo_plus + samo_waga * (kier$prawda[i] + wymiar[cbind(i, d)]) + pary$samo) +
       rnorm(nrow(pary), 0, sd_blad)
  data.frame(kierownik = kier$kierownik[i], region = kier$region[i], oceniajacy = pary$oceniajacy,
             zrodlo = pary$zrodlo, kompetencja = kompetencje[d], ocena = round(pmin(pmax(y, 1), 5), 2))
}))
dane$zrodlo <- factor(dane$zrodlo, levels = names(kol_zrodlo))
dane$kompetencja <- factor(dane$kompetencja, levels = kompetencje)
dane <- dane[order(dane$kierownik, dane$zrodlo, dane$oceniajacy, dane$kompetencja), ]
write.csv(dane, "ocena-360-restauracje-dane.csv", row.names = FALSE)

c(kierownicy = N, oceniajacy = length(unique(dane$oceniajacy)), oceny = nrow(dane), pary_ocen = nrow(pary))
table(zrodlo = pary$zrodlo)
table(podwladni_na_kierownika = kier$n_podwl)
round(tapply(dane$ocena, dane$zrodlo, mean), 2)
mean(dane$ocena %in% c(1, 5))                    # odsetek ocen uciętych na krańcu skali

# Rysunek 1. Grafika: kto ocenia kogo w jednym regionie (6 kierowników)
k6 <- data.frame(id = 1:6, x = c(1, 2.6, 4.2, 5.8, 7.4, 9), y = 5, nazwa = sprintf("K%02d", 1:6))
wsp6 <- data.frame(od = c(4, 5), do = 3)    # przykład: K03 oceniają współpracownicy K04 i K05
p1 <- ggplot() +
  geom_segment(data = k6, aes(x = 5, y = 8.1, xend = x, yend = y + 0.45), colour = kol_zrodlo[["przełożony"]],
               linewidth = 0.6, arrow = arrow(length = unit(2.2, "mm"), type = "closed")) +
  geom_curve(data = transform(wsp6, x = k6$x[od], xend = k6$x[do]), aes(x = x, xend = xend, y = 4.5, yend = 4.5),
             curvature = -0.45, colour = kol_zrodlo[["współpracownik"]], linewidth = 0.7, linetype = "22",
             arrow = arrow(length = unit(1.8, "mm"), type = "closed")) +
  geom_segment(data = k6, aes(x = x, y = 2.95, xend = x, yend = y - 0.45), colour = kol_zrodlo[["podwładny"]],
               linewidth = 0.6, arrow = arrow(length = unit(2.2, "mm"), type = "closed")) +
  annotate("label", x = 5, y = 8.55, label = "Przełożony P01 (kierownik regionu)\nocenia wszystkich 6 kierowników",
           size = 3.8, fill = "#F6D9C4", linewidth = 0.3, lineheight = 0.95) +
  geom_label(data = k6, aes(x, y, label = nazwa), size = 4, fill = "#D9E6F2", linewidth = 0.3,
             label.padding = unit(3.5, "mm")) +
  geom_point(data = k6, aes(x + 0.5, y + 0.45), shape = 18, size = 4, colour = kol_zrodlo[["samoocena"]]) +
  geom_label(data = k6, aes(x, 2.5, label = "3–6\npodwładnych"), size = 3.3, fill = "#D7EFE6", linewidth = 0.3,
             lineheight = 0.9) +
  annotate("text", x = 0.2, y = c(1.25, 0.75, 0.25), hjust = 0, size = 3.9, colour = "grey15",
           label = c("Strzałka ciągła z góry – przełożony; przerywana – 2 współpracowników (inni kierownicy z regionu); z dołu – podwładni; romb – samoocena.",
                     "Przełożony i współpracownicy oceniają kilku kierowników → ich łagodność można oddzielić od pracy ocenianego.",
                     "Każdy oceniający ocenia 4 kompetencje (skala 1–5). Cała sieć: 10 regionów, 60 kierowników.")) +
  annotate("label", x = 6.6, y = 3.1, size = 3.5, colour = kol_zrodlo[["współpracownik"]], fill = "white", linewidth = 0,
           label = "np. K03 oceniają współpracownicy K04 i K05") +
  annotate("text", x = 9.5, y = 5.95, size = 3.5, colour = "#9A6A00", label = "samoocena") +
  coord_cartesian(xlim = c(0, 10), ylim = c(0, 9.3), expand = FALSE) +
  labs(title = "Kto ocenia kogo w jednym regionie sieci restauracji") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
p1   # zapis: ggsave("ocena-360-kto-ocenia-kogo.svg", p1, width = 10, height = 6.6)
Wynik w R
kierownicy oceniajacy      oceny  pary_ocen
        60        337       2028        507
zrodlo
     podwładny     przełożony      samoocena współpracownik
           267             60             60            120
podwladni_na_kierownika
 3  4  5  6
14 15 21 10
    przełożony współpracownik      podwładny      samoocena
          3.54           3.75           3.83           4.06
[1] 0.0290927
2. ICC(1), ICC(k), rwg i korelacje między źródłami
R
# Zgodność oceniających w grupach: ICC(1), ICC(k) i rwg (dane z przepisu 1)
# Wynik ogólny oceniającego = średnia z 4 kompetencji
ogol <- aggregate(ocena ~ kierownik + region + oceniajacy + zrodlo, dane, mean)

icc_jednoczynnikowe <- function(y, grupa) {        # jednoczynnikowa ANOVA, grupy nierówne
  grupa <- factor(grupa); n_g <- tapply(y, grupa, length); G <- nlevels(grupa); N <- length(y)
  a <- anova(lm(y ~ grupa)); msb <- a[1, "Mean Sq"]; msw <- a[2, "Mean Sq"]
  k0 <- (N - sum(n_g^2) / N) / (G - 1)             # „średnia” liczebność grupy przy nierównych grupach
  c(ICC1 = (msb - msw) / (msb + (k0 - 1) * msw), ICCk = (msb - msw) / msb, k0 = k0)
}
pod <- subset(ogol, zrodlo == "podwładny")
wsp <- subset(ogol, zrodlo == "współpracownik")
icc_pod <- icc_jednoczynnikowe(pod$ocena, pod$kierownik)
icc_wsp <- icc_jednoczynnikowe(wsp$ocena, wsp$kierownik)
round(rbind(podwladni = icc_pod, wspolpracownicy = icc_wsp), 3)

# 95% przedział bootstrapowy ICC(1) podwładnych: losujemy kierowników ze zwracaniem
set.seed(644)
b <- replicate(1000, {
  k <- sample(unique(pod$kierownik), replace = TRUE)
  d <- do.call(rbind, lapply(seq_along(k), function(j) transform(pod[pod$kierownik == k[j], ], grupa = j)))
  icc_jednoczynnikowe(d$ocena, d$grupa)[["ICC1"]]
})
round(quantile(b, c(.025, .975)), 3)

# rwg: zgodność podwładnych jednego kierownika względem „losowego” rozkładu równomiernego na skali 1–5
sigma2_EU <- (5^2 - 1) / 12                      # wariancja rozkładu równomiernego dla 5 kategorii = 2
rwg <- tapply(pod$ocena, pod$kierownik, function(x) max(0, 1 - var(x) / sigma2_EU))
round(c(mediana = median(rwg), min = min(rwg), max = max(rwg), odsetek_ponad_70 = mean(rwg >= .70)), 3)

# Korelacje między źródłami (średnia źródła dla kierownika)
szer <- reshape(aggregate(ocena ~ kierownik + zrodlo, ogol, mean), idvar = "kierownik", timevar = "zrodlo",
                direction = "wide")
names(szer) <- sub("ocena\\.", "", names(szer))
round(cor(szer[, c("przełożony", "współpracownik", "podwładny", "samoocena")]), 2)
Wynik w R
                 ICC1  ICCk    k0
podwladni       0.340 0.696 4.446
wspolpracownicy 0.354 0.523 2.000
 2.5% 97.5%
0.219 0.442
         mediana              min              max odsetek_ponad_70
           0.908            0.611            0.998            0.950
               przełożony współpracownik podwładny samoocena
przełożony           1.00           0.51      0.48      0.32
współpracownik       0.51           1.00      0.71      0.25
podwładny            0.48           0.71      1.00      0.36
samoocena            0.32           0.25      0.36      1.00
3. Samoocena a ocena innych: rysunek 2
R
# Rysunek 2. Samoocena a ocena innych: różnica dla każdego z 60 kierowników (obiekty z przepisów 1–2)
library(ggplot2)

inni <- aggregate(ocena ~ kierownik, subset(ogol, zrodlo != "samoocena"), mean)
samo <- subset(ogol, zrodlo == "samoocena", c(kierownik, ocena))
so <- merge(setNames(inni, c("kierownik", "inni")), setNames(samo, c("kierownik", "samo")))
so$roznica <- so$samo - so$inni
t.test(so$samo, so$inni, paired = TRUE)          # średnia różnica samoocena − inni
round(c(r_samo_inni = cor(so$samo, so$inni), odsetek_samo_wyzej = mean(so$roznica > 0),
        sd_roznicy = sd(so$roznica)), 3)
so$tercyl <- cut(rank(so$inni), c(0, 20, 40, 60), labels = c("najniżej oceniani", "środek", "najwyżej oceniani"))
round(tapply(so$roznica, so$tercyl, mean), 2)    # przeszacowanie wg poziomu oceny innych

so$kolej <- factor(so$kierownik, levels = so$kierownik[order(so$inni)])
p2 <- ggplot(so, aes(y = kolej)) +
  geom_segment(aes(x = inni, xend = samo, yend = kolej), colour = "grey65", linewidth = 0.5) +
  geom_point(aes(x = inni, colour = "średnia ocen innych", shape = "średnia ocen innych"), size = 2.2) +
  geom_point(aes(x = samo, colour = "samoocena", shape = "samoocena"), size = 2.6) +
  scale_colour_manual(values = c("średnia ocen innych" = "#0072B2", "samoocena" = "#E69F00"), name = NULL) +
  scale_shape_manual(values = c("średnia ocen innych" = 16, "samoocena" = 18), name = NULL) +
  scale_x_continuous(limits = c(2.4, 5), breaks = seq(2.5, 5, 0.5)) +
  labs(title = "Samoocena kierowników jest wyższa niż ocena innych",
       subtitle = sprintf("Średnia różnica %.2f pkt; korelacja samooceny z oceną innych r = %s",
                          mean(so$roznica), sub("^0", "", sprintf("%.2f", cor(so$samo, so$inni)))),
       x = "Ocena ogólna (średnia 4 kompetencji, skala 1–5)", y = "Kierownicy (od najniżej ocenianych przez innych)") +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())
p2   # zapis: ggsave("ocena-360-samoocena.svg", p2, width = 10, height = 7)
Wynik w R
	Paired t-test

data:  so$samo and so$inni
t = 5.2577, df = 59, p-value = 2.117e-06
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 0.1765546 0.3935162
sample estimates:
mean difference
      0.2850354

       r_samo_inni odsetek_samo_wyzej         sd_roznicy
             0.372              0.767              0.420
najniżej oceniani            środek najwyżej oceniani
             0.53              0.35             -0.03
4. Model ze skrzyżowanymi efektami losowymi i łagodność: rysunek 3
R
# Rysunek 3. Łagodność oceniających: model ze skrzyżowanymi efektami losowymi (obiekty z przepisów 1–3)
library(ggplot2); library(lme4); library(patchwork)

d <- droplevels(subset(dane, zrodlo != "samoocena"))   # samoocenę opisujemy osobno (rysunek 2)
m <- lmer(ocena ~ zrodlo + kompetencja + (1 | kierownik) + (1 | kierownik:kompetencja) +
            (1 | oceniajacy) + (1 | oceniajacy:kierownik), data = d)
print(VarCorr(m), comp = "Std.Dev.", digits = 3)
round(fixef(m), 3)
w <- as.data.frame(VarCorr(m))                   # udział składowych w wariancji pojedynczej oceny
round(setNames(100 * w$vcov / sum(w$vcov), w$grp), 1)

# Wynik skorygowany: średni poziom kierownika z modelu (efekt losowy + wyraz wolny, skala przełożonego)
re <- ranef(m, condVar = TRUE)
kor <- data.frame(kierownik = rownames(re$kierownik), skorygowany = fixef(m)[[1]] + re$kierownik[, 1])
kor <- merge(merge(kor, setNames(inni, c("kierownik", "surowy"))), kier[, c("kierownik", "region", "prawda")])
lag_ocen <- data.frame(oceniajacy = rownames(re$oceniajacy), lagodnosc = re$oceniajacy[, 1],
                       se = sqrt(attr(re$oceniajacy, "postVar")[1, 1, ]))
przel <- subset(lag_ocen, grepl("^P", oceniajacy))
przel$prawdziwa <- lagod[przel$oceniajacy]
tab <- przel[order(przel$lagodnosc), c("oceniajacy", "lagodnosc", "se", "prawdziwa")]
tab[, -1] <- round(tab[, -1], 2); tab
round(c(r_surowy_prawda = cor(kor$surowy, kor$prawda), r_skoryg_prawda = cor(kor$skorygowany, kor$prawda),
        r_przel_est_prawda = cor(przel$lagodnosc, przel$prawdziwa)), 3)
kor$miejsce_surowe <- rank(-kor$surowy); kor$miejsce_skoryg <- rank(-kor$skorygowany)
kor$zmiana <- kor$miejsce_surowe - kor$miejsce_skoryg
round(c(srednia_zmiana_miejsc = mean(abs(kor$zmiana)), max_zmiana = max(abs(kor$zmiana)),
        zmiana_o_5_i_wiecej = sum(abs(kor$zmiana) >= 5)), 2)
kor$lag_przel <- przel$lagodnosc[match(sub("R", "P", kor$region), przel$oceniajacy)]   # łagodność własnego przełożonego
round(c(r_zmiana_lagodnosc = cor(kor$zmiana, kor$lag_przel)), 3)
round(tapply(kor$zmiana, sub("R", "P", kor$region), mean), 1)   # średnia zmiana miejsca w regionie przełożonego (+ = awans)

przel$kolej <- factor(przel$oceniajacy, levels = przel$oceniajacy[order(przel$lagodnosc)])
pA <- ggplot(przel, aes(y = kolej)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = lagodnosc - 1.96 * se, xmax = lagodnosc + 1.96 * se), width = 0, colour = "#D55E00",
                orientation = "y") +
  geom_point(aes(x = lagodnosc, shape = "z modelu"), colour = "#D55E00", size = 2.6) +
  geom_point(aes(x = prawdziwa, shape = "prawdziwa (ukryta w danych)"), colour = "grey20", size = 2.4) +
  scale_shape_manual(values = c("z modelu" = 16, "prawdziwa (ukryta w danych)" = 4), name = NULL) +
  labs(title = "A. Łagodność 10 przełożonych", x = "Odchylenie od przeciętnego oceniającego (pkt)", y = NULL) +
  motyw
set.seed(644)                                    # tylko rozsunięcie punktów w poziomie
pB <- ggplot(kor, aes(lag_przel, zmiana)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "#0072B2", linewidth = 0.8) +
  geom_point(position = position_jitter(width = 0.008, height = 0), colour = "grey35", alpha = 0.8, size = 2) +
  labs(title = "B. Zmiana miejsca w rankingu po korekcie", x = "Łagodność własnego przełożonego (z modelu, pkt)",
       y = "Awans (+) lub spadek (−) o miejsca") +
  motyw
p3 <- pA + pB + plot_layout(widths = c(1, 1.15))
p3   # zapis: ggsave("ocena-360-lagodnosc.svg", p3, width = 10, height = 6.4)
Wynik w R
 Groups                Name        Std.Dev.
 oceniajacy:kierownik  (Intercept) 0.294
 oceniajacy            (Intercept) 0.302
 kierownik:kompetencja (Intercept) 0.237
 kierownik             (Intercept) 0.312
 Residual                          0.285
                      (Intercept)              zrodlowspółpracownik
                            3.579                             0.210
                  zrodlopodwładny kompetencjakomunikacja z zespołem
                            0.300                            -0.110
   kompetencjadbałość o standardy     kompetencjarozwój pracowników
                           -0.029                            -0.031
 oceniajacy:kierownik            oceniajacy kierownik:kompetencja
                 21.0                  22.1                  13.6
            kierownik              Residual
                 23.6                  19.8
    oceniajacy lagodnosc   se prawdziwa
332        P05     -0.34 0.13     -0.60
328        P01     -0.19 0.13     -0.25
336        P09     -0.17 0.13     -0.05
333        P06     -0.08 0.13     -0.23
335        P08     -0.07 0.13     -0.07
337        P10     -0.06 0.13     -0.14
330        P03      0.15 0.13      0.05
334        P07      0.17 0.13      0.02
329        P02      0.24 0.13      0.13
331        P04      0.35 0.13      0.53
   r_surowy_prawda    r_skoryg_prawda r_przel_est_prawda
             0.838              0.852              0.910
srednia_zmiana_miejsc            max_zmiana   zmiana_o_5_i_wiecej
                 1.93                  9.00                  4.00
r_zmiana_lagodnosc
            -0.373
 P01  P02  P03  P04  P05  P06  P07  P08  P09  P10
 0.0 -0.7 -0.3 -2.9  1.5  1.5  0.0  0.3  1.2 -0.7
5. Efekt aureoli: rysunek 4
R
# Rysunek 4. Efekt aureoli: korelacje kompetencji u tego samego i u różnych oceniających (obiekty z przepisów 1–4)
library(ggplot2)

sz <- reshape(d[, c("kierownik", "oceniajacy", "kompetencja", "ocena")], idvar = c("kierownik", "oceniajacy"),
              timevar = "kompetencja", direction = "wide")
Y <- as.matrix(sz[, -(1:2)])                     # wiersz = jeden oceniający o jednym kierowniku, 4 kompetencje
sr_kor <- function(r) mean(r[upper.tri(r)])
ten_sam <- sr_kor(cor(Y))                        # ten sam oceniający, różne kompetencje
# Pary różnych oceniających tego samego kierownika (każda para w obu kolejnościach)
pary_oc <- do.call(rbind, lapply(split(seq_len(nrow(sz)), sz$kierownik), function(w) {
  g <- expand.grid(a = w, b = w); g[g$a != g$b, ] }))
C <- cor(Y[pary_oc$a, ], Y[pary_oc$b, ])         # 4 × 4: kompetencja u oceniającego a × u oceniającego b
rozni_ta_sama <- mean(diag(C)); rozni_inna <- mean(C[row(C) != col(C)])
prawdziwe <- sapply(1:4, function(k) kier$prawda + wymiar[, k])
prawdziwa <- sr_kor(cor(prawdziwe))              # korelacja prawdziwych poziomów kompetencji (znana w symulacji)
wyn <- data.frame(typ = c("ten sam oceniający,\nróżne kompetencje", "różni oceniający,\nta sama kompetencja",
                          "różni oceniający,\nróżne kompetencje", "prawdziwe poziomy\nkompetencji (symulacja)"),
                  r = c(ten_sam, rozni_ta_sama, rozni_inna, prawdziwa))
c(wiersze = nrow(Y), pary_oceniajacych = nrow(pary_oc))
transform(wyn, typ = gsub("\n", " ", typ), r = round(r, 2))
round(sd_ogolny^2 / (sd_ogolny^2 + sd_wymiar^2), 2)   # oczekiwana prawdziwa korelacja z parametrów

wyn$typ <- factor(wyn$typ, levels = rev(wyn$typ))
wyn$rodzaj <- c("oceny", "oceny", "oceny", "prawda")
p4 <- ggplot(wyn, aes(r, typ)) +
  geom_segment(aes(x = 0, xend = r, yend = typ, colour = rodzaj), linewidth = 6, show.legend = FALSE) +
  geom_text(aes(label = sub("^0", "", sprintf("%.2f", r))), hjust = -0.25, size = 4.4) +
  scale_colour_manual(values = c(oceny = "#0072B2", prawda = "grey60")) +
  scale_x_continuous(limits = c(0, 0.85), breaks = seq(0, 0.8, 0.2), labels = function(x) sub("^0", "", sprintf("%.1f", x))) +
  labs(title = "Oceny mówią więcej o oceniającym niż o kompetencji",
       subtitle = "Średnia korelacja ocen czterech kompetencji (bez samooceny)", x = "Średnia korelacja r", y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank())
p4   # zapis: ggsave("ocena-360-aureola.svg", p4, width = 10, height = 5.2)
Wynik w R
          wiersze pary_oceniajacych
              447              2946
                                        typ    r
1     ten sam oceniający, różne kompetencje 0.67
2     różni oceniający, ta sama kompetencja 0.35
3       różni oceniający, różne kompetencje 0.23
4 prawdziwe poziomy kompetencji (symulacja) 0.60
[1] 0.59
6. Spearman–Brown i symulacja rankingu: rysunek 5 i tabela
R
# Rysunek 5 i Tabela 1. Ile ocen potrzeba? Spearman–Brown i symulacja rankingu (obiekty z przepisów 1–2)
library(ggplot2)

sb <- function(icc1, k) k * icc1 / (1 + (k - 1) * icc1)   # rzetelność średniej z k ocen
ile <- function(icc1, cel) ceiling(cel * (1 - icc1) / (icc1 * (1 - cel)))
icc1 <- c("podwładni" = icc_pod[["ICC1"]], "współpracownicy" = icc_wsp[["ICC1"]])
round(sapply(icc1, function(x) setNames(sb(x, c(1, 2, 3, 4, 6, 10)), paste0("k = ", c(1, 2, 3, 4, 6, 10)))), 2)
sapply(icc1, function(x) c(do_70 = ile(x, .70), do_80 = ile(x, .80), do_90 = ile(x, .90)))

krz <- expand.grid(k = 1:15, zrodlo = names(icc1)); krz$rzet <- sb(icc1[as.character(krz$zrodlo)], krz$k)
p5 <- ggplot(krz, aes(k, rzet, colour = zrodlo, shape = zrodlo, linetype = zrodlo)) +
  geom_hline(yintercept = c(.70, .80), colour = "grey55", linetype = "dotted") +
  annotate("text", x = 15, y = c(.70, .80) + .02, label = c(".70", ".80"), hjust = 1, colour = "grey40", size = 3.8) +
  geom_line(linewidth = 0.8) + geom_point(size = 2.2) +
  annotate("point", x = c(icc_pod[["k0"]], 2), y = c(icc_pod[["ICCk"]], icc_wsp[["ICCk"]]), shape = 21, size = 6,
           colour = "grey15", stroke = 0.8) +
  annotate("text", x = c(icc_pod[["k0"]], 2) + 0.35, y = c(icc_pod[["ICCk"]], icc_wsp[["ICCk"]]) - 0.06, hjust = 0,
           size = 3.7, colour = "grey15",
           label = c("teraz: średnio 4.4 podwładnych", "teraz: 2 współpracowników")) +
  scale_colour_manual(values = c("podwładni" = "#009E73", "współpracownicy" = "#0072B2"), name = NULL) +
  scale_shape_manual(values = c("podwładni" = 16, "współpracownicy" = 17), name = NULL) +
  scale_linetype_manual(values = c("podwładni" = "solid", "współpracownicy" = "dashed"), name = NULL) +
  scale_x_continuous(breaks = c(1, 3, 5, 7, 10, 15)) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2), labels = function(x) sub("^0", "", sprintf("%.1f", x))) +
  labs(title = "Ile ocen trzeba uśrednić, by wynik był rzetelny?",
       subtitle = sprintf("Wzór Spearmana–Browna z ICC(1): podwładni %s, współpracownicy %s",
                          sub("^0", "", sprintf("%.2f", icc1[1])), sub("^0", "", sprintf("%.2f", icc1[2]))),
       x = "Liczba oceniających z jednego źródła (k)", y = "Rzetelność średniej z k ocen") +
  motyw
p5   # zapis: ggsave("ocena-360-ile-ocen.svg", p5, width = 10, height = 5.6)

# Tabela 1. Ranking z k ocen podwładnych: 1000 symulowanych sieci, ICC(1) jak w danych
set.seed(644)
symuluj <- function(k, n = 60, icc = icc1[["podwładni"]]) {
  prawda <- rnorm(n, 0, sqrt(icc)); obs <- prawda + rowMeans(matrix(rnorm(n * k, 0, sqrt(1 - icc)), n, k))
  top_p <- order(prawda, decreasing = TRUE)[1:10]; top_o <- order(obs, decreasing = TRUE)[1:10]
  c(r_spearman = cor(prawda, obs, method = "spearman"), trafione_top10 = length(intersect(top_p, top_o)),
    najlepszy_w_top10 = top_o[1] %in% top_p, ten_sam_lider = top_o[1] == top_p[1])
}
tab1 <- t(sapply(c(3, 6, 12), function(k) { s <- replicate(1000, symuluj(k))
  c(k = k, r_rang = mean(s[1, ]), trafione_z_10 = mean(s[2, ]), proc_lider_w_top10 = 100 * mean(s[3, ]),
    proc_ten_sam_lider = 100 * mean(s[4, ]), blad_MC_pp = 100 * sqrt(mean(s[4, ]) * (1 - mean(s[4, ])) / 1000)) }))
round(tab1, 2)   # błąd MC dla odsetka „ten sam lider”; dla pozostałych odsetków jest mniejszy
Wynik w R
       podwładni współpracownicy
k = 1       0.34            0.35
k = 2       0.51            0.52
k = 3       0.61            0.62
k = 4       0.67            0.69
k = 6       0.76            0.77
k = 10      0.84            0.85
      podwładni współpracownicy
do_70         5               5
do_80         8               8
do_90        18              17
      k r_rang trafione_z_10 proc_lider_w_top10 proc_ten_sam_lider blad_MC_pp
[1,]  3   0.75          5.99               87.3               30.4       1.45
[2,]  6   0.85          6.76               96.0               42.8       1.56
[3,] 12   0.91          7.61               98.6               57.0       1.57
7. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – niebieski (przełożony / współpracownik)" = c("#D55E00", "#0072B2"),
             "zielony – niebieski (podwładni / współpracownicy)" = c("#009E73", "#0072B2"),
             "cynober – zielony (przełożony / podwładny)" = c("#D55E00", "#009E73"),
             "pomarańczowy – niebieski (samoocena / inni)" = c("#E69F00", "#0072B2"),
             "pomarańczowy – cynober (samoocena / przełożony)" = c("#E69F00", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                  widzenie_typowe deuteranopia
cynober – niebieski (przełożony / współpracownik)           114.6        108.3
zielony – niebieski (podwładni / współpracownicy)            70.1         55.4
cynober – zielony (przełożony / podwładny)                  102.4         53.5
pomarańczowy – niebieski (samoocena / inni)                 120.2        121.5
pomarańczowy – cynober (samoocena / przełożony)              33.4         18.4
czerwony – zielony (do unikania)                            121.7         21.1
                                                  protanopia
cynober – niebieski (przełożony / współpracownik)       91.9
zielony – niebieski (podwładni / współpracownicy)       58.0
cynober – zielony (przełożony / podwładny)              37.3
pomarańczowy – niebieski (samoocena / inni)            109.3
pomarańczowy – cynober (samoocena / przełożony)         24.9
czerwony – zielony (do unikania)                        31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, analiza wariancji, test t, korelacje – pakiety base i stats). Model mieszany ze skrzyżowanymi efektami losowymi dopasowano pakietem lme4. Rysunki wykonano w ggplot2 (zestawienie paneli – patchwork); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Ranking z 3 ocen. Lider listy jest naprawdę najlepszy tylko w 30.4% symulowanych sieci (tabela wyżej).
- Wysokie rwg jako dowód jakości. rwg = .91 przy ICC(1) = .34: oceniający się zgadzają, ale niewiele mówią o różnicach między kierownikami.
- Jedna średnia z samooceną. Samoocena jest wyższa o 0.29 punktu i słabo związana z ocenami innych – dołączona do średniej przesuwa wyniki zależnie od skromności ocenianego.
- Korelacje kompetencji jako „struktura kompetencji”. Korelacja .67 u tego samego oceniającego to w dużej mierze aureola; analiza czynnikowa takich ocen łatwo znajdzie jeden ogólny czynnik, który opisuje w dużej mierze oceniającego.
- Surowa średnia ze źródeł o różnej liczebności. Kierownik z sześcioma podwładnymi ma nieco wyższą surową średnią niż kierownik z trzema – przy tej samej pracy – bo podwładni oceniają najwyżej.
- Raport z jednej czy dwóch ocen podwładnych. Szef łatwo rozpozna autora, a podwładni przestaną pisać szczerze. Zapewnij anonimowość i pokazuj wynik źródła dopiero od kilku ocen.
Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Najczęstsze pytania
Jak policzyć zgodność oceniających w ocenie 360 stopni?
Osobno dla każdego źródła z kilkoma oceniającymi (podwładni, współpracownicy): ICC(1) z jednoczynnikowej analizy wariancji mówi, jak rzetelna jest pojedyncza ocena, a ICC(k) – jak rzetelna jest średnia z k ocen. Wskaźnik rwg pokazuje, czy oceniający jednej osoby dają bliskie sobie oceny. W przykładzie podwładni mieli ICC(1) = .34 i ICC(k) = .70, a medianę rwg .91.
Czym różni się ICC od rwg?
ICC porównuje różnice między ocenianymi z różnicami między oceniającymi, więc mówi, czy oceny odróżniają ludzi. rwg porównuje rozrzut ocen jednej osoby z rozkładem losowych odpowiedzi, więc mówi tylko, czy oceniający się zgadzają. Gdy wszyscy oceniają podobnie wysoko, rwg bywa wysokie przy niskim ICC – tak było w przykładzie (.91 wobec .34).
Dlaczego samoocena różni się od oceny przełożonego?
Samoocena jest słabiej związana z ocenami innych niż oceny przełożonego i współpracowników między sobą: w metaanalizie Harrisa i Schaubroecka (1988) ρ = .35 z przełożonym i .36 ze współpracownikami wobec .62 między nimi. W przykładzie samoocena była średnio o 0.29 punktu wyższa, 95% CI [0.18, 0.39], i korelowała z oceną innych na poziomie r = .37. Raportuj samoocenę osobno, a nie w jednej średniej z innymi źródłami.
Jak skorygować łagodność oceniających?
Dopasuj model mieszany ze skrzyżowanymi efektami losowymi oceniającego i ocenianego, np. w lme4: ocena ~ zrodlo + (1 | oceniany) + (1 | oceniajacy). Wynik skorygowany to przewidywany efekt losowy ocenianego. Korekta działa tylko dla oceniających, którzy ocenili kilka osób – łagodności podwładnego oceniającego jednego szefa nie da się oddzielić.
Ilu oceniających potrzeba w ocenie 360 stopni?
Policz to wzorem Spearmana–Browna z ICC(1) pojedynczej oceny. Przy ICC(1) = .34 rzetelność .70 daje 5 ocen, .80 – 8, a .90 – 18 ocen z jednego źródła. W symulacji ranking z 3 ocen podwładnych wskazywał prawdziwie najlepszego kierownika tylko w 30.4% przypadków, a z 12 ocen – w 57.0%.
Powiązane hasła
Przeczytaj też
Zgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikEfekty skrzyżowane: uczestnicy × bodźce
Skrzyżowane efekty losowe osób i bodźców w lme4, maksymalna struktura, symulacja błędu I rodzaju, moc zależna od liczby bodźców i opis APA.
Czytaj →PoradnikZaangażowanie pracowników: model wielopoziomowy
Ankieta w 40 zespołach: ICC, styl lidera, ranking zespołów z modelu zamiast średnich i błąd ekologiczny – z kodem R.
Czytaj →Masz w pracy oceny pracowników od kilku oceniających?
Pomożemy policzyć zgodność oceniających, oddzielić łagodność ocen modelem mieszanym i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Conway, J. M., & Huffcutt, A. I. (1997). Psychometric properties of multisource performance ratings: A meta-analysis of subordinate, supervisor, peer, and self-ratings. Human Performance, 10(4), 331–360. https://doi.org/10.1207/s15327043hup1004_2
- Harris, M. M., & Schaubroeck, J. (1988). A meta-analysis of self-supervisor, self-peer, and peer-supervisor ratings. Personnel Psychology, 41(1), 43–62. https://doi.org/10.1111/j.1744-6570.1988.tb00631.x
- James, L. R., Demaree, R. G., & Wolf, G. (1984). Estimating within-group interrater reliability with and without response bias. Journal of Applied Psychology, 69(1), 85–98. https://doi.org/10.1037/0021-9010.69.1.85
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Murphy, K. R., Jako, R. A., & Anhalt, R. L. (1993). Nature and consequences of halo error: A critical analysis. Journal of Applied Psychology, 78(2), 218–225. https://doi.org/10.1037/0021-9010.78.2.218
- Scullen, S. E., Mount, M. K., & Goff, M. (2000). Understanding the latent structure of job performance ratings. Journal of Applied Psychology, 85(6), 956–970. https://doi.org/10.1037/0021-9010.85.6.956
- Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420–428. https://doi.org/10.1037/0033-2909.86.2.420
Cytowania BibTeX
@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{conway1997psychometric, author={Conway, James M. and Huffcutt, Allen I.}, title={{Psychometric properties of multisource performance ratings: A meta-analysis of subordinate, supervisor, peer, and self-ratings}}, journal={Human Performance}, year={1997}, volume={10}, number={4}, pages={331--360}, doi={10.1207/s15327043hup1004_2}}@article{harris1988meta, author={Harris, Michael M. and Schaubroeck, John}, title={{A meta-analysis of self-supervisor, self-peer, and peer-supervisor ratings}}, journal={Personnel Psychology}, year={1988}, volume={41}, number={1}, pages={43--62}, doi={10.1111/j.1744-6570.1988.tb00631.x}}@article{james1984estimating, author={James, Lawrence R. and Demaree, Robert G. and Wolf, Gerrit}, title={{Estimating within-group interrater reliability with and without response bias}}, journal={Journal of Applied Psychology}, year={1984}, volume={69}, number={1}, pages={85--98}, doi={10.1037/0021-9010.69.1.85}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{murphy1993nature, author={Murphy, Kevin R. and Jako, Robert A. and Anhalt, Rebecca L.}, title={{Nature and consequences of halo error: A critical analysis}}, journal={Journal of Applied Psychology}, year={1993}, volume={78}, number={2}, pages={218--225}, doi={10.1037/0021-9010.78.2.218}}@article{scullen2000understanding, author={Scullen, Steven E. and Mount, Michael K. and Goff, Maynard}, title={{Understanding the latent structure of job performance ratings}}, journal={Journal of Applied Psychology}, year={2000}, volume={85}, number={6}, pages={956--970}, doi={10.1037/0021-9010.85.6.956}}@article{shrout1979intraclass, author={Shrout, Patrick E. and Fleiss, Joseph L.}, title={{Intraclass correlations: Uses in assessing rater reliability}}, journal={Psychological Bulletin}, year={1979}, volume={86}, number={2}, pages={420--428}, doi={10.1037/0033-2909.86.2.420}}