Przykład: software house, 40 zespołów i pytanie „który zespół ratować?”
Fikcyjny software house zatrudnia 452 programistów, testerów i analityków w 40 zespołach projektowych liczących od 4 do 22 osób (11 zespołów ma 4–5 osób). Raz w roku dział HR prowadzi anonimową ankietę zaangażowania: wynik to średnia z 9 pozycji na skali 1–7, w duchu krótkich kwestionariuszy mierzących wigor, oddanie i pochłonięcie pracą (Schaufeli i in., 2006). Do wyniku dołączono nadgodziny pracownika (h/tydz.), staż w firmie i – na poziomie zespołu – ocenę coachingowego stylu lidera (1–5) z niezależnej oceny przełożonych.
Zarząd pyta: ile różnic w zaangażowaniu to sprawa zespołów, czy styl lidera ma znaczenie i które zespoły naprawdę potrzebują pomocy? Odpowiada model wielopoziomowy. Pełną procedurę pięciu modeli opisuje wpis model wielopoziomowy krok po kroku w R; tu skupiamy się na tym, co HR robi z wynikiem – na rankingu zespołów.
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy: średnie zaangażowanie 4.60; +0.25 punktu na każdy punkt stylu lidera; +0.06 na godzinę średnich nadgodzin zespołu, ale −0.08 na godzinę, o którą pracownik przekracza średnią swojego zespołu; +0.03 na rok stażu; SD zespołów 0.12 i osób 1.00; liczebności zespołów jak wyżej. Wariancje zmniejszyliśmy po pierwszym przebiegu, żeby różnice między zespołami były umiarkowane, jak w typowej ankiecie pracowniczej; ziarna 642 nie zmienialiśmy. Dane: badanie-zaangazowania-pracownikow-dane.csv (wiersz = pracownik).
Rysunek 1: pracownik w zespole
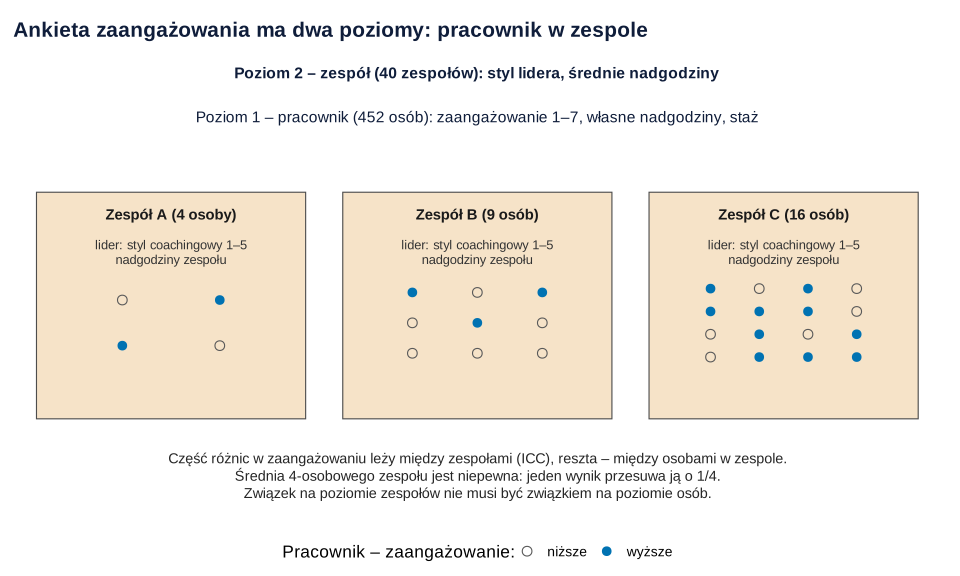
Co widać. Pracownicy (poziom 1) są zagnieżdżeni w zespołach (poziom 2). Zaangażowanie, nadgodziny i staż zmieniają się z osoby na osobę, a styl lidera – tylko między zespołami. Osoby z jednego zespołu dzielą lidera, projekt i klienta, więc ich odpowiedzi są do siebie podobne.
Jak może zmylić. Schemat sugeruje równe karty, a zespoły mają od 4 do 22 osób. Ta nierówność decyduje o tym, jak bardzo można ufać średniej zespołu (rysunki 2 i 3).
Podpis do pracy:
Zdanie do Metody:
Ile różnic to zespoły? ICC z modelu pustego
Model pusty ma tylko średnią i losowy wyraz wolny zespołu. Dzieli wariancję zaangażowania na część między zespołami (τ² = 0.126) i między osobami w zespole (σ² = 1.162). Ich iloraz to ICC:
Słowami: ok. 10% różnic w zaangażowaniu leży między zespołami, 90% – między ludźmi w tym samym zespole. Wariancja zespołów jest różna od zera (test ilorazu wiarygodności χ²(1) = 18.97, p < .001). ICC = .098 wygląda skromnie, ale przy średnio 11.3 osobach w zespole daje efekt schematu 2.01: 452 ankiety niosą tyle informacji, co ok. 225 niezależnych osób.
Drugi wniosek z tych samych liczb dotyczy rankingu. Rzetelność średniej zespołu wynosi τ² / (τ² + σ²/n): .30 dla zespołu 4-osobowego, .52 dla 10-osobowego i .70 dla 22-osobowego. W zespole 4-osobowym tylko 30% zmienności średniej odpowiada stałym różnicom między zespołami, reszta to przypadek – kto akurat w nim pracuje i jak wypełnił ankietę.
Rysunek 2: lejek średnich zespołów
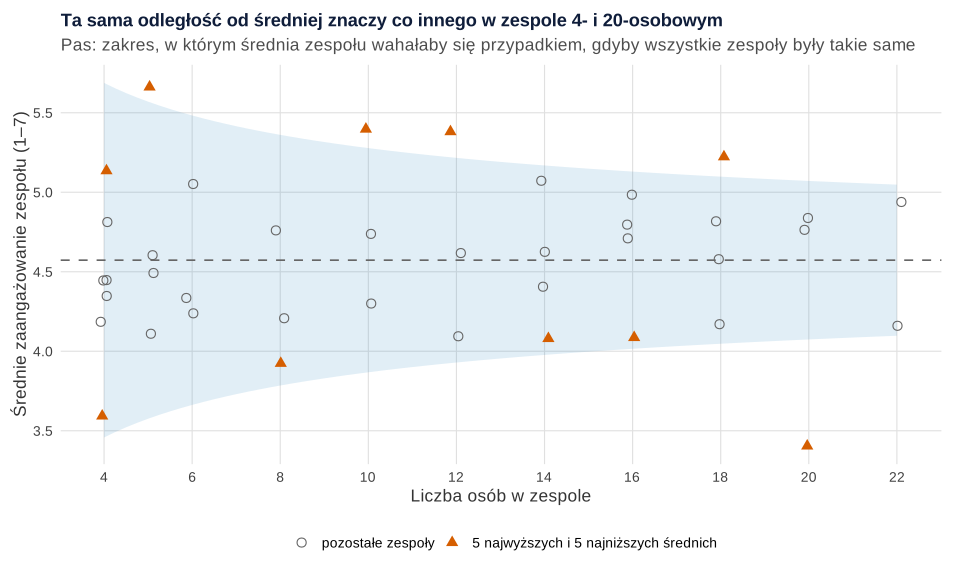
set.seed(642)).Co widać. Średnie zespołów wahają się od 3.40 do 5.66. Pas pokazuje, jak daleko od średniej firmy (4.57) mogłaby odejść średnia przypadkiem: ±1.11 punktu w zespole 4-osobowym i tylko ±0.50 w 20-osobowym. Zespół Z21 (20 osób, średnia 3.40) leży poniżej pasa – to sygnał. Zespół Z19 (4 osoby, 3.59) jest prawie tak samo nisko, ale w pasie – to może być przypadek.
Jak może zmylić. W tej jednej firmie zespoły do 6 osób stanowią 3 z 10 skrajnych średnich (wśród wszystkich zespołów – 14 z 40), więc „przewaga małych na krańcach” nie zawsze jest widoczna gołym okiem. Systematycznie pokazuje ją dopiero symulacja (rysunek 5). Pas liczono z SD całej próby – to przybliżenie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: ranking zespołów – surowe średnie a model
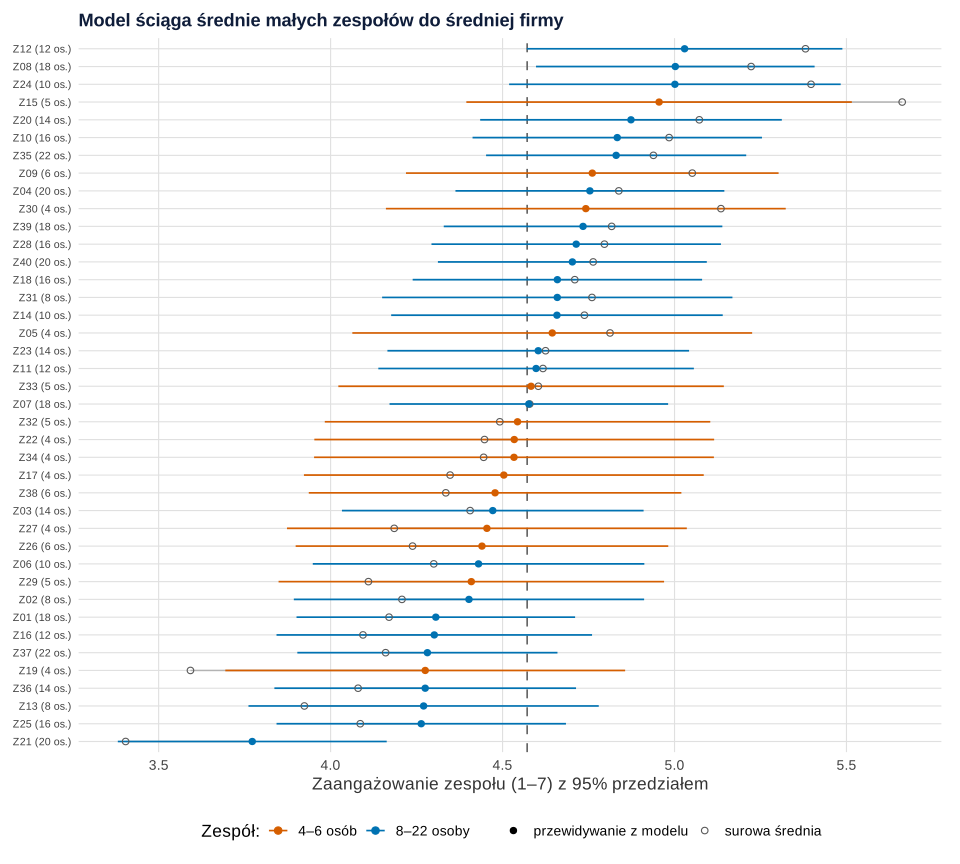
Co widać. To wykres gąsienicowy z dodatkiem: puste kółka to surowe średnie, pełne kropki – przewidywania z modelu pustego (średnia firmy + efekt losowy zespołu). Model łączy średnią zespołu ze średnią firmy proporcjonalnie do rzetelności, więc ściąga wyniki do środka: rozrzut zespołów spada z SD = 0.482 do 0.254. Zespoły 4–6-osobowe przesuwają się średnio o 0.254 punktu, większe – o 0.152. Mechanizm ściągania pokazuje wpis model mieszany w obrazkach.
- Z15 (5 osób) miał najwyższą surową średnią, 5.66; w modelu 4.96 i 4. miejsce.
- Z30 (4 osoby) spada z 5. na 10. miejsce (5.13 → 4.74).
- Z19 (4 osoby) z przedostatniego miejsca (3.59) awansuje na 36. (4.28).
- Z21 (20 osób) zostaje ostatni: 3.77, 95% CI [3.38, 4.16].
Jak może zmylić. Model nie „wie”, że małe zespoły są przeciętne – zakłada to z braku danych. Przedziały prawie wszystkich zespołów obejmują średnią firmy; nie obejmują jej tylko Z21 (w dół) i Z08 (18 osób, w górę: 5.00 [4.60, 5.41]). Kolejność między nimi to szum. Przy rankingach szkół po uwzględnieniu niepewności także tylko nieliczne dały się wiarygodnie odróżnić od średniej (Leckie i Goldstein, 2009); różnicę między miejscem w rankingu a oceną opisuje hasło ranking a ocena pozycji. Przedziały pomijają niepewność samej średniej firmy.
Podpis do pracy:
Zdanie do Wyników:
Styl lidera i nadgodziny: model z predyktorami obu poziomów
Drugi model dodaje predyktory. Nadgodziny rozbijamy na dwie części przez centrowanie do średniej zespołu: odchylenie pracownika od jego zespołu (efekt wewnątrz) i średnią zespołu (efekt między zespołami). Tylko tak oba efekty da się zinterpretować osobno (Enders i Tofighi, 2007). Model dopasowano w lme4 (Bates i in., 2015), a p policzono ze stopniami swobody Satterthwaite’a – przy 40 grupach przybliżenia małopróbkowe ograniczają zawyżenie błędu I rodzaju (McNeish, 2017).
| Predyktor | b | 95% CI | df | p |
|---|---|---|---|---|
| nadgodziny – odchylenie od zespołu (h) | −0.092 | [−0.127, −0.056] | 413.6 | < .001 |
| nadgodziny – średnia zespołu (h) | 0.106 | [0.055, 0.157] | 39.5 | < .001 |
| staż (lata) | 0.027 | [−0.020, 0.074] | 441.6 | .256 |
| styl lidera (1–5) | 0.192 | [−0.038, 0.422] | 34.0 | .110 |
Styl lidera. Punkt wyżej w ocenie lidera wiąże się ze średnio o 0.19 punktu wyższym zaangażowaniem, ale przedział obejmuje zero (p = .110). Prawdziwy efekt w danych to 0.25 – 40 zespołów to mało, żeby precyzyjnie oszacować efekt zmiennej poziomu zespołu. Zwykła regresja na 452 osobach dałaby SE = 0.095 i p = .037, bo udaje, że ma 452 niezależne obserwacje lidera, a ma 40 – to pseudoreplikacja. Predyktory wyjaśniły 57.5% wariancji między zespołami (τ² spadło z 0.126 do 0.054).
Rysunek 4: błąd ekologiczny na nadgodzinach
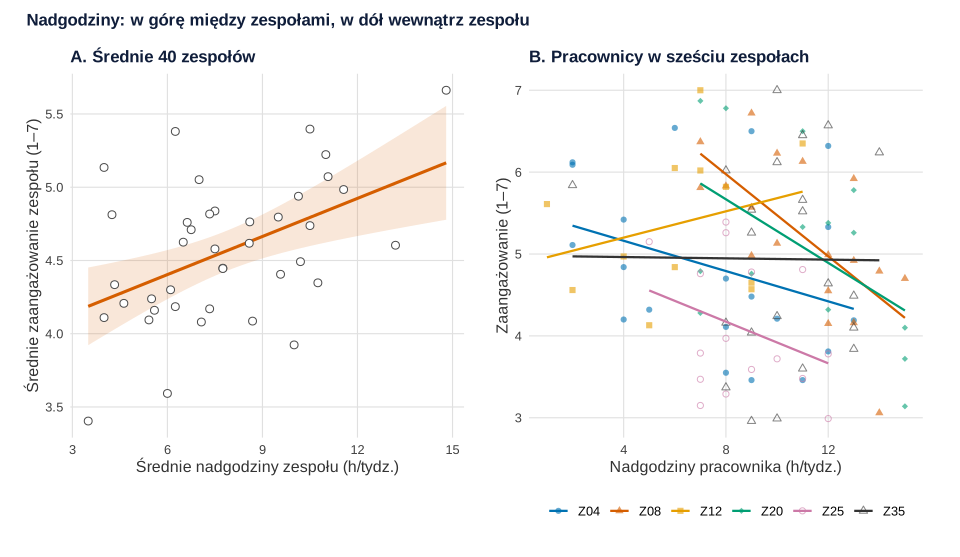
Co widać. Panel A: zespoły z większą średnią liczbą nadgodzin są bardziej zaangażowane (r = .478, +0.087 punktu na godzinę). Panel B: w obrębie zespołu jest odwrotnie – w pięciu z sześciu pokazanych zespołów nachylenie jest ujemne (od −0.251 do −0.004; w jednym 0.080). W całej próbie bez podziału na poziomy korelacja wynosi −.002: dwa przeciwne związki znoszą się.
Jak może zmylić. Wniosek z panelu A „nadgodziny zwiększają zaangażowanie pracownika” to błąd ekologiczny: związek między grupami przeniesiony na osoby. Związek na poziomie zespołów ma jednak własną wartość – mówi coś o projektach, nie o ludziach (Schwartz, 1994). Średnia nadgodzin małego zespołu jest też nierzetelną miarą jego warunków, co może obciążać efekt poziomu zespołu (Lüdtke i in., 2008). Zespoły w panelu B (co najmniej 12-osobowe) wybraliśmy przed rysowaniem.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: kogo wskazuje lista „5 najgorszych zespołów”?
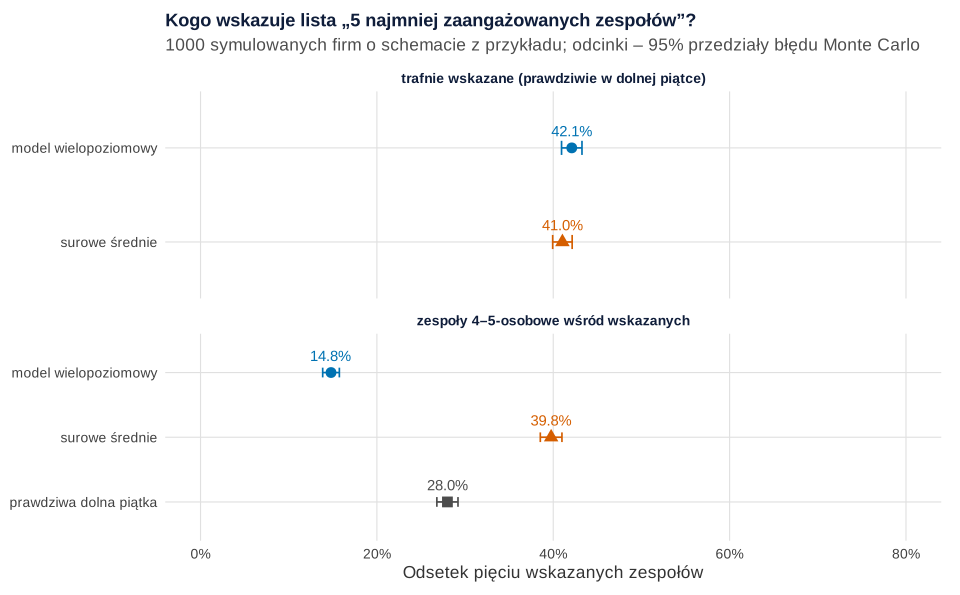
set.seed(642)).Symulujemy 1000 firm o tym samym schemacie (te same liczebności i parametry, nowe osoby i zespoły) i za każdym razem wskazujemy 5 zespołów o najniższym zaangażowaniu – raz według surowych średnich, raz według modelu. Prawdziwe zaangażowanie zespołów znamy.
Co widać. Obie metody trafiają podobnie źle: z pięciu wskazanych zespołów naprawdę w dolnej piątce jest średnio 41.0% (surowe średnie) i 42.1% (model); błąd Monte Carlo ok. 0.6 pp. Różnią się tym, kogo wskazują. W prawdziwej dolnej piątce zespoły 4–5-osobowe stanowią 28.0%, wśród wskazanych przez surowe średnie – 39.8% (małe zespoły trafiają na listę przez przypadek), a przez model – 14.8% (model ich nie „widzi”, bo ma o nich za mało danych). Model za to lepiej szacuje poziom każdego zespołu: średni błąd bezwzględny 0.169 wobec 0.274 punktu.
Jak może zmylić. Wynik dotyczy ICC ok. .10 i 40 zespołów. Przy większych różnicach między zespołami lub większych zespołach obie listy byłyby trafniejsze. W 1.4% symulacji model oszacował wariancję zespołów jako zero (dopasowanie osobliwe).
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w firmie
- Nie publikuj rankingu zespołów z surowych średnich. Pokaż przewidywania z modelu z przedziałami i nazwij wprost tylko zespoły, których przedział nie obejmuje średniej firmy (tu Z21 i Z08).
- Zespołu 4-osobowego nie oceniaj z jednej ankiety. Połącz dwie edycje albo raportuj go razem z pokrewnym zespołem; przy rzetelności .30 rozmowa „dlaczego wypadliście najgorzej” często dotyczy przypadku.
- Z21 to kandydat na rozmowę, a nie na karę. 20 osób i stabilnie niski wynik to sygnał do sprawdzenia: obciążenie, projekt, rotacja. Odejścia w takich zespołach można śledzić analizą z wpisu rotacja pracowników jako analiza przeżycia.
- Nadgodzin nie zarządzaj według korelacji zespołów. Pracownik, który pracuje więcej niż koledzy, jest mniej zaangażowany – to on potrzebuje uwagi, niezależnie od kultury zespołu.
- Efekt lidera sprawdź lepszym planem. Przy 40 zespołach przedział jest szeroki; ocenę liderów uzupełnij danymi z wielu źródeł, jak w ocenie 360 stopni, a program rozwoju liderów oceń jak interwencję (różnica w różnicach).
Ten sam problem rankingu jednostek różnej wielkości pojawia się przy sklepach – zob. promocje w sieci sklepów: model mieszany.
Jak opisać w pracy
W Metodzie podaj strukturę danych (liczbę i wielkość zespołów), ICC z modelu pustego, sposób centrowania predyktorów, estymację i stopnie swobody; w Wynikach – efekty stałe z CI, wariancje i ich spadek po dodaniu predyktorów. Wzory zdań: jak opisać wyniki modelu mieszanego; o miejscu statystyki w pracy dyplomowej z zarządzania – statystyka w pracy z zarządzania i ekonomii.
Jak ułożyć cały rozdział empiryczny, opisuje wpis jak napisać pracę z zarządzania i ekonomii.
Kod R: dane, model wielopoziomowy, ranking i symulacja
Kod odtwarza wszystkie liczby z tekstu, tabelę i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane i rozmieszczenie kropek na rysunku 1) i 4 (symulacja); każdy losujący blok zaczyna od własnego set.seed(642). Ziarno 642 ustalono raz i nie zmieniano go. Ręcznie ustalono: liczebności zespołów (7 zespołów po 4 osoby, 4 po 5, 3 po 6, po 3 zespoły 8-, 10- i 12-osobowe, po 4 zespoły 14-, 16- i 18-osobowe, 3 po 20 i 2 po 22), średnie zaangażowanie 4.60, efekty: styl lidera 0.25, średnie nadgodziny zespołu 0.06, odchylenie nadgodzin od zespołu −0.08, staż 0.03, SD zespołów 0.12 i osób 1.00, rozkład oceny lidera (średnia 3.2, SD 0.6) i nadgodzin (średnia zespołu 2–12 h, SD w zespole 3 h). Wariancje zespołów i osób zmniejszono po pierwszym przebiegu, żeby ICC był umiarkowany; ziarna nie zmieniano. Symulacja ma 1000 powtórzeń.
1. Paleta, dane i rysunki 1–2
R
# Rysunki 1 i 2. Fikcyjny software house: 40 zespołów, ankieta zaangażowania (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie. Wynik: średnia 9 pozycji skali zaangażowania 1–7.
J <- 40
wielkosc <- rep(c(4, 5, 6, 8, 10, 12, 14, 16, 18, 20, 22), times = c(7, 4, 3, 3, 3, 3, 4, 4, 4, 3, 2))   # liczba osób w zespołach
b0 <- 4.60           # średnie zaangażowanie przy przeciętnym liderze i przeciętnych nadgodzinach
b_lider <- 0.25      # +1 punkt wskaźnika coachingowego stylu lidera (skala 1–5)
b_miedzy <- 0.06     # zespoły z większą średnią liczbą nadgodzin: wyżej (projekty produktowe)
b_wewnatrz <- -0.08  # w obrębie zespołu: więcej nadgodzin niż koledzy → niżej
b_staz <- 0.03       # rok stażu w firmie
sd_zespol <- 0.12; sd_osoba <- 1.00

set.seed(642)                                     # ziarno ustalone raz, bez dobierania pod wynik
zespoly <- data.frame(zespol = sprintf("Z%02d", 1:J), n = sample(wielkosc))
zespoly$lider <- round(pmin(5, pmax(1, rnorm(J, 3.2, 0.6))), 1)   # ocena lidera z assessment center
zespoly$nadg_zesp <- runif(J, 2, 12)                               # typowe nadgodziny w zespole (h/tydz.)
zespoly$u0 <- rnorm(J, 0, sd_zespol)
zespoly$prawdziwa <- b0 + b_lider * (zespoly$lider - 3.2) + b_miedzy * (zespoly$nadg_zesp - 7) + zespoly$u0
dane <- do.call(rbind, lapply(1:J, function(j) {
  z <- zespoly[j, ]
  nadg <- round(pmax(0, z$nadg_zesp + rnorm(z$n, 0, 3)))
  staz <- round(rgamma(z$n, shape = 2, scale = 1.5), 1)
  y <- b0 + b_lider * (z$lider - 3.2) + b_miedzy * (z$nadg_zesp - 7) + z$u0 +
       b_wewnatrz * (nadg - z$nadg_zesp) + b_staz * (staz - 3) + rnorm(z$n, 0, sd_osoba)
  data.frame(zespol = z$zespol, wielkosc_zespolu = z$n, lider = z$lider, nadgodziny = nadg,
             staz = staz, zaangazowanie = round(pmin(7, pmax(1, y)), 2))
}))
write.csv(dane, "badanie-zaangazowania-pracownikow-dane.csv", row.names = FALSE)

c(zespoly = J, pracownicy = nrow(dane), zespoly_4_5_osob = sum(zespoly$n <= 5))
round(c(srednia = mean(dane$zaangazowanie), SD = sd(dane$zaangazowanie)), 2)
summary(zespoly$n)

# Rysunek 1. Grafika: dwa poziomy – pracownicy (poziom 1) w zespołach (poziom 2)
set.seed(642)                                     # tylko rozmieszczenie kropek pracowników w kartach
karty <- data.frame(x = c(1.7, 5, 8.3), y = 5.3, n = c(4, 9, 16),
                    tytul = c("Zespół A (4 osoby)", "Zespół B (9 osób)", "Zespół C (16 osób)"))
kropki <- do.call(rbind, lapply(1:3, function(i) {
  k <- karty[i, ]; m <- ceiling(sqrt(k$n))
  siatka <- expand.grid(a = seq_len(m), b = seq_len(m))[seq_len(k$n), ]
  data.frame(x = k$x - 1.05 + (siatka$a - 0.5) * 2.1 / m, y = 4.3 + (siatka$b - 0.5) * 1.45 / m,
             wynik = sample(c("niższe", "wyższe"), k$n, replace = TRUE))
}))
p1 <- ggplot() +
  geom_tile(data = karty, aes(x, y, width = 2.9, height = 3.6), fill = "#F6E3C8", colour = "grey30", linewidth = 0.4) +
  geom_text(data = karty, aes(x, y + 1.45, label = tytul), size = 3.9, fontface = "bold", colour = "grey10") +
  geom_text(data = karty, aes(x, y + 0.85, label = "lider: styl coachingowy 1–5\nnadgodziny zespołu"),
            size = 3.4, lineheight = 0.95, colour = "grey20") +
  geom_point(data = kropki, aes(x, y, shape = wynik, colour = wynik), size = 3) +
  annotate("text", x = 5, y = 9.0, label = "Poziom 2 – zespół (40 zespołów): styl lidera, średnie nadgodziny",
           size = 4.1, fontface = "bold", colour = "#0f1d3a") +
  annotate("text", x = 5, y = 8.3, label = paste0("Poziom 1 – pracownik (", nrow(dane), " osób): zaangażowanie 1–7, własne nadgodziny, staż"),
           size = 4.1, colour = "#0f1d3a") +
  annotate("text", x = 5, y = 2.6, size = 3.8, colour = "grey15", lineheight = 1.0,
           label = paste("Część różnic w zaangażowaniu leży między zespołami (ICC), reszta – między osobami w zespole.",
                         "Średnia 4-osobowego zespołu jest niepewna: jeden wynik przesuwa ją o 1/4.",
                         "Związek na poziomie zespołów nie musi być związkiem na poziomie osób.", sep = "\n")) +
  scale_shape_manual(values = c("niższe" = 1, "wyższe" = 16), name = "Pracownik – zaangażowanie:") +
  scale_colour_manual(values = c("niższe" = "grey35", "wyższe" = kol[["niebieski"]]), name = "Pracownik – zaangażowanie:") +
  coord_cartesian(xlim = c(0, 10), ylim = c(1.7, 9.5), expand = FALSE) +
  labs(title = "Ankieta zaangażowania ma dwa poziomy: pracownik w zespole") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p1   # zapis: ggsave("zaangazowanie-schemat-poziomow.svg", p1, width = 10, height = 6)

# Rysunek 2. Surowe średnie zespołów a liczba osób w zespole („lejek”)
sr <- aggregate(zaangazowanie ~ zespol + wielkosc_zespolu, dane, mean)
names(sr)[3] <- "srednia"
m_all <- mean(dane$zaangazowanie)
lejek <- data.frame(n = seq(4, 22, by = 0.25))
s_w <- sd(dane$zaangazowanie)                      # przybliżenie: SD całej próby
lejek$dol <- m_all - 1.96 * s_w / sqrt(lejek$n); lejek$gora <- m_all + 1.96 * s_w / sqrt(lejek$n)
sr$skrajny <- rank(sr$srednia) <= 5 | rank(-sr$srednia) <= 5
p2 <- ggplot(sr, aes(wielkosc_zespolu, srednia)) +
  geom_ribbon(data = lejek, aes(x = n, ymin = dol, ymax = gora), inherit.aes = FALSE, fill = kol[["niebieski"]], alpha = 0.12) +
  geom_hline(yintercept = m_all, linetype = "dashed", colour = "grey40") +
  geom_point(aes(shape = skrajny, colour = skrajny), size = 2.8, position = position_jitter(width = 0.15, height = 0, seed = 642)) +
  scale_shape_manual(values = c(`FALSE` = 1, `TRUE` = 17), labels = c("pozostałe zespoły", "5 najwyższych i 5 najniższych średnich"), name = NULL) +
  scale_colour_manual(values = c(`FALSE` = "grey40", `TRUE` = kol[["cynober"]]), labels = c("pozostałe zespoły", "5 najwyższych i 5 najniższych średnich"), name = NULL) +
  scale_x_continuous(breaks = seq(4, 22, 2)) +
  labs(title = "Ta sama odległość od średniej znaczy co innego w zespole 4- i 20-osobowym",
       subtitle = "Pas: zakres, w którym średnia zespołu wahałaby się przypadkiem, gdyby wszystkie zespoły były takie same",
       x = "Liczba osób w zespole", y = "Średnie zaangażowanie zespołu (1–7)") +
  motyw
p2   # zapis: ggsave("zaangazowanie-lejek-srednich.svg", p2, width = 10, height = 6)
table(skrajny = sr$skrajny, maly_zespol = sr$wielkosc_zespolu <= 6)
round(c(srednia_firmy = m_all, polowa_pasa_n4 = 1.96 * s_w / sqrt(4), polowa_pasa_n20 = 1.96 * s_w / sqrt(20)), 2)
round(range(sr$srednia), 2)
Wynik w R
         zespoly       pracownicy zespoly_4_5_osob
              40              452               11
srednia      SD
   4.57    1.14
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
    4.0     5.0    11.0    11.3    16.0    22.0
       maly_zespol
skrajny FALSE TRUE
  FALSE    19   11
  TRUE      7    3
  srednia_firmy  polowa_pasa_n4 polowa_pasa_n20
           4.57            1.11            0.50
[1] 3.40 5.66
2. ICC, model z predyktorami i rysunek 4
R
# Model pusty (ICC) i model z predyktorami obu poziomów (dane z przepisu 1)
suppressPackageStartupMessages({library(lme4); library(lmerTest)})   # lmerTest: wartości p ze stopniami swobody Satterthwaite’a

# (a) Model pusty: ile zróżnicowania zaangażowania leży między zespołami?
m0 <- lmer(zaangazowanie ~ 1 + (1 | zespol), data = dane)
vc <- as.data.frame(VarCorr(m0))
tau2 <- vc$vcov[1]; sigma2 <- vc$vcov[2]
icc <- tau2 / (tau2 + sigma2)
n_sr <- mean(table(dane$zespol))
deff <- 1 + (n_sr - 1) * icc                     # efekt schematu
round(c(tau2 = tau2, sigma2 = sigma2, ICC = icc, sr_wielkosc = n_sr, efekt_schematu = deff, n_efektywne = nrow(dane) / deff), 3)
# Rzetelność średniej zespołu: tau2 / (tau2 + sigma2 / n)
round(sapply(c(n4 = 4, n10 = 10, n22 = 22), function(n) tau2 / (tau2 + sigma2 / n)), 2)
ranova(m0)                                       # test ilorazu wiarygodności dla wariancji zespołów

# (b) Centrowanie: nadgodziny rozbite na część „wewnątrz zespołu” i „między zespołami”
dane$nadg_sr  <- ave(dane$nadgodziny, dane$zespol)          # średnia zespołu
dane$nadg_wew <- dane$nadgodziny - dane$nadg_sr              # odchylenie osoby od średniej jej zespołu
dane$nadg_sr_c <- dane$nadg_sr - mean(dane$nadgodziny)
dane$lider_c <- dane$lider - 3.2; dane$staz_c <- dane$staz - 3
m1 <- lmer(zaangazowanie ~ nadg_wew + nadg_sr_c + staz_c + lider_c + (1 | zespol), data = dane)
wsp <- summary(m1)$coefficients
ci <- confint(m1, method = "Wald")[rownames(wsp), ]
round(cbind(b = wsp[, 1], SE = wsp[, 2], df = wsp[, 3], dolna = ci[, 1], gorna = ci[, 2], p = wsp[, 5]), 3)
tau2_m1 <- as.data.frame(VarCorr(m1))$vcov[1]
round(c(tau2_m1 = tau2_m1, wyjasnione_miedzy_zespolami = 1 - tau2_m1 / tau2), 3)

# (c) Ta sama zależność od stylu lidera w zwykłej regresji: 452 osoby jak niezależne obserwacje
m_ols <- lm(zaangazowanie ~ nadg_wew + nadg_sr_c + staz_c + lider_c, data = dane)
round(summary(m_ols)$coefficients["lider_c", ], 3)

# (d) Analiza tylko na średnich zespołów (40 punktów) – źródło błędu ekologicznego
zesp <- aggregate(cbind(zaangazowanie, nadgodziny) ~ zespol, dane, mean)
m_eko <- lm(zaangazowanie ~ nadgodziny, data = zesp)
round(c(nachylenie_zespoly = coef(m_eko)[[2]], r_zespoly = cor(zesp$zaangazowanie, zesp$nadgodziny),
        r_osoby_bez_podzialu = cor(dane$zaangazowanie, dane$nadgodziny)), 3)

# Rysunek 4. Nadgodziny: między zespołami w górę, wewnątrz zespołu w dół
library(patchwork)
pA <- ggplot(zesp, aes(nadgodziny, zaangazowanie)) +
  geom_smooth(method = "lm", formula = y ~ x, se = TRUE, colour = kol[["cynober"]], fill = kol[["cynober"]], alpha = 0.15) +
  geom_point(shape = 21, fill = "white", colour = "grey30", size = 2.4) +
  labs(title = "A. Średnie 40 zespołów", x = "Średnie nadgodziny zespołu (h/tydz.)", y = "Średnie zaangażowanie zespołu (1–7)") +
  motyw
wyb <- c("Z04", "Z08", "Z12", "Z20", "Z25", "Z35")   # zespoły co najmniej 12-osobowe, wybrane przed rysowaniem
dw <- subset(dane, zespol %in% wyb)
pB <- ggplot(dw, aes(nadgodziny, zaangazowanie, colour = zespol, shape = zespol)) +
  geom_point(alpha = 0.6, size = 1.8) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, linewidth = 0.8) +
  scale_colour_manual(values = unname(kol[c("niebieski", "cynober", "pomarancz", "zielony", "fiolet", "ciemny")])) +
  scale_shape_manual(values = c(16, 17, 15, 18, 1, 2)) +
  labs(title = "B. Pracownicy w sześciu zespołach", x = "Nadgodziny pracownika (h/tydz.)", y = "Zaangażowanie (1–7)",
       colour = NULL, shape = NULL) +
  motyw + guides(colour = guide_legend(nrow = 1), shape = guide_legend(nrow = 1))
p4 <- pA + pB + plot_annotation(title = "Nadgodziny: w górę między zespołami, w dół wewnątrz zespołu",
                                theme = theme(plot.title = element_text(face = "bold", colour = "#0f1d3a")))
p4   # zapis: ggsave("zaangazowanie-nadgodziny-dwa-poziomy.svg", p4, width = 10, height = 5.6)
sapply(split(dw, dw$zespol), function(d) round(coef(lm(zaangazowanie ~ nadgodziny, d))[[2]], 3))
Wynik w R
          tau2         sigma2            ICC    sr_wielkosc efekt_schematu
         0.126          1.162          0.098         11.300          2.009
   n_efektywne
       225.041
  n4  n10  n22
0.30 0.52 0.70
ANOVA-like table for random-effects: Single term deletions

Model:
zaangazowanie ~ 1 + (1 | zespol)
             npar  logLik    AIC    LRT Df Pr(>Chisq)
<none>          3 -691.59 1389.2
(1 | zespol)    2 -701.07 1406.1 18.969  1  1.329e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
                 b    SE      df  dolna  gorna     p
(Intercept)  4.609 0.067  30.861  4.478  4.739 0.000
nadg_wew    -0.092 0.018 413.577 -0.127 -0.056 0.000
nadg_sr_c    0.106 0.026  39.450  0.055  0.157 0.000
staz_c       0.027 0.024 441.559 -0.020  0.074 0.256
lider_c      0.192 0.117  34.021 -0.038  0.422 0.110
                    tau2_m1 wyjasnione_miedzy_zespolami
                      0.054                       0.575
  Estimate Std. Error    t value   Pr(>|t|)
     0.198      0.095      2.092      0.037
  nachylenie_zespoly            r_zespoly r_osoby_bez_podzialu
               0.087                0.478               -0.002
   Z04    Z08    Z12    Z20    Z25    Z35
-0.092 -0.251  0.080 -0.194 -0.127 -0.004
3. Ranking zespołów: rysunek 3
R
# Rysunek 3. Ranking zespołów: surowe średnie a przewidywania z modelu pustego (dane i m0 z przepisów 1–2)
re <- ranef(m0, condVar = TRUE)$zespol
se_re <- sqrt(attr(ranef(m0, condVar = TRUE)$zespol, "postVar")[1, 1, ])
rank_df <- data.frame(zespol = rownames(re), model = fixef(m0)[[1]] + re[, 1], se = se_re)
rank_df <- merge(rank_df, sr[, c("zespol", "wielkosc_zespolu", "srednia")], by = "zespol")
rank_df$dolna <- rank_df$model - 1.96 * rank_df$se; rank_df$gorna <- rank_df$model + 1.96 * rank_df$se
rank_df$miejsce_surowe <- rank(-rank_df$srednia); rank_df$miejsce_model <- rank(-rank_df$model)
rank_df$etykieta <- paste0(rank_df$zespol, " (", rank_df$wielkosc_zespolu, " os.)")
rank_df$wielkosc <- factor(ifelse(rank_df$wielkosc_zespolu <= 6, "4–6 osób", "8–22 osoby"), levels = c("4–6 osób", "8–22 osoby"))
rank_df <- rank_df[order(rank_df$model), ]
rank_df$etykieta <- factor(rank_df$etykieta, levels = rank_df$etykieta)
b0_hat <- fixef(m0)[[1]]

p3 <- ggplot(rank_df, aes(y = etykieta)) +
  geom_vline(xintercept = b0_hat, linetype = "dashed", colour = "grey40") +
  geom_segment(aes(x = srednia, xend = model, yend = etykieta), colour = "grey70", linewidth = 0.5) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna, colour = wielkosc), width = 0, linewidth = 0.6, orientation = "y") +
  geom_point(aes(x = srednia, shape = "surowa średnia"), colour = "grey35", size = 1.9) +
  geom_point(aes(x = model, colour = wielkosc, shape = "przewidywanie z modelu"), size = 2.2) +
  scale_shape_manual(values = c("surowa średnia" = 1, "przewidywanie z modelu" = 16), name = NULL) +
  scale_colour_manual(values = c("4–6 osób" = kol[["cynober"]], "8–22 osoby" = kol[["niebieski"]]), name = "Zespół:") +
  scale_x_continuous(breaks = seq(3.5, 6, by = 0.5)) +
  labs(title = "Model ściąga średnie małych zespołów do średniej firmy",
       x = "Zaangażowanie zespołu (1–7) z 95% przedziałem", y = NULL) +
  motyw + theme(axis.text.y = element_text(size = 8))
p3   # zapis: ggsave("zaangazowanie-ranking-zespolow.svg", p3, width = 10, height = 9)

rank_df$przesuniecie <- abs(rank_df$srednia - rank_df$model)
round(tapply(rank_df$przesuniecie, rank_df$wielkosc, mean), 3)          # średnie przesunięcie
round(c(SD_surowych = sd(rank_df$srednia), SD_model = sd(rank_df$model)), 3)
round(b0_hat, 2)                                                          # średnia firmy z modelu pustego
c(przedzial_bez_sredniej_firmy = sum(rank_df$dolna > b0_hat | rank_df$gorna < b0_hat))
as.character(rank_df$zespol[rank_df$dolna > b0_hat | rank_df$gorna < b0_hat])
pokaz <- function(d) d[, c("zespol", "wielkosc_zespolu", "srednia", "model", "dolna", "gorna", "miejsce_surowe", "miejsce_model")]
cat("Pięć najniższych surowych średnich:\n"); print(pokaz(rank_df[order(rank_df$srednia), ][1:5, ]), digits = 3, row.names = FALSE)
cat("Pięć najniższych według modelu:\n");   print(pokaz(rank_df[1:5, ]), digits = 3, row.names = FALSE)
cat("Pięć najwyższych surowych średnich:\n"); print(pokaz(rank_df[order(-rank_df$srednia), ][1:5, ]), digits = 3, row.names = FALSE)
cat("Największe zmiany miejsca:\n")
print(pokaz(head(rank_df[order(-abs(rank_df$miejsce_surowe - rank_df$miejsce_model)), ], 4)), digits = 3, row.names = FALSE)
Wynik w R
  4–6 osób 8–22 osoby
     0.254      0.152
SD_surowych    SD_model
      0.482       0.254
[1] 4.57
przedzial_bez_sredniej_firmy
                           2
[1] "Z21" "Z08"
Pięć najniższych surowych średnich:
 zespol wielkosc_zespolu srednia model dolna gorna miejsce_surowe miejsce_model
    Z21               20    3.40  3.77  3.38  4.16             40            40
    Z19                4    3.59  4.28  3.69  4.86             39            36
    Z13                8    3.92  4.27  3.76  4.78             38            38
    Z36               14    4.08  4.28  3.84  4.71             37            37
    Z25               16    4.09  4.26  3.84  4.68             36            39
Pięć najniższych według modelu:
 zespol wielkosc_zespolu srednia model dolna gorna miejsce_surowe miejsce_model
    Z21               20    3.40  3.77  3.38  4.16             40            40
    Z25               16    4.09  4.26  3.84  4.68             36            39
    Z13                8    3.92  4.27  3.76  4.78             38            38
    Z36               14    4.08  4.28  3.84  4.71             37            37
    Z19                4    3.59  4.28  3.69  4.86             39            36
Pięć najwyższych surowych średnich:
 zespol wielkosc_zespolu srednia model dolna gorna miejsce_surowe miejsce_model
    Z15                5    5.66  4.96  4.39  5.52              1             4
    Z24               10    5.40  5.00  4.52  5.48              2             3
    Z12               12    5.38  5.03  4.57  5.49              3             1
    Z08               18    5.22  5.00  4.60  5.41              4             2
    Z30                4    5.13  4.74  4.16  5.32              5            10
Największe zmiany miejsca:
 zespol wielkosc_zespolu srednia model dolna gorna miejsce_surowe miejsce_model
    Z05                4    4.81  4.64  4.06  5.23             12            17
    Z30                4    5.13  4.74  4.16  5.32              5            10
    Z25               16    4.09  4.26  3.84  4.68             36            39
    Z19                4    3.59  4.28  3.69  4.86             39            36
4. Symulacja 1000 firm: rysunek 5
R
# Rysunek 5. Symulacja 1000 firm o tym samym schemacie: kogo wskazuje „5 najniższych zespołów”?
# Parametry jak w przepisie 1 (wielkości zespołów, efekty, SD); nowe dane w każdym powtórzeniu.
library(lme4)
symuluj_firme <- function() {
  n <- sample(wielkosc)
  lider <- round(pmin(5, pmax(1, rnorm(J, 3.2, 0.6))), 1)
  nadg_zesp <- runif(J, 2, 12)
  prawdziwa <- b0 + b_lider * (lider - 3.2) + b_miedzy * (nadg_zesp - 7) + rnorm(J, 0, sd_zespol)
  zesp <- rep(seq_len(J), n)
  nadg <- round(pmax(0, nadg_zesp[zesp] + rnorm(sum(n), 0, 3)))
  staz <- round(rgamma(sum(n), shape = 2, scale = 1.5), 1)
  y <- prawdziwa[zesp] + b_wewnatrz * (nadg - nadg_zesp[zesp]) + b_staz * (staz - 3) + rnorm(sum(n), 0, sd_osoba)
  list(d = data.frame(zespol = factor(zesp), y = pmin(7, pmax(1, y))), n = n, prawdziwa = prawdziwa)
}
R <- 1000; k <- 5
set.seed(642)
wyn <- t(replicate(R, {
  f <- symuluj_firme()
  surowe <- tapply(f$d$y, f$d$zespol, mean)
  m <- suppressMessages(lmer(y ~ 1 + (1 | zespol), data = f$d))   # komunikat o „singular fit” liczymy niżej
  model <- coef(m)$zespol[, 1]
  prawdziwe_dno <- order(f$prawdziwa)[1:k]
  dno_s <- order(surowe)[1:k]; dno_m <- order(model)[1:k]
  c(trafne_surowe = mean(dno_s %in% prawdziwe_dno), trafne_model = mean(dno_m %in% prawdziwe_dno),
    male_surowe = mean(f$n[dno_s] <= 5), male_model = mean(f$n[dno_m] <= 5), male_prawdziwe = mean(f$n[prawdziwe_dno] <= 5),
    blad_surowe = mean(abs(surowe - f$prawdziwa)), blad_model = mean(abs(model - f$prawdziwa)),
    osobliwy = isSingular(m))
}))
sym <- data.frame(miara = colnames(wyn), srednia = colMeans(wyn), blad_MC = apply(wyn, 2, sd) / sqrt(R))
print(transform(sym, srednia = round(srednia, 3), blad_MC = round(blad_MC, 4)), row.names = FALSE)
c(udzial_zespolow_4_5_osob = mean(wielkosc <= 5))

wykres <- data.frame(
  miara = factor(rep(c("trafnie wskazane (prawdziwie w dolnej piątce)", "zespoły 4–5-osobowe wśród wskazanych"), c(2, 3)),
                 levels = c("trafnie wskazane (prawdziwie w dolnej piątce)", "zespoły 4–5-osobowe wśród wskazanych")),
  metoda = factor(c("surowe średnie", "model wielopoziomowy", "surowe średnie", "model wielopoziomowy", "prawdziwa dolna piątka"),
                  levels = c("prawdziwa dolna piątka", "surowe średnie", "model wielopoziomowy")),
  p = sym$srednia[1:5], se = sym$blad_MC[1:5])
p5 <- ggplot(wykres, aes(p, metoda, colour = metoda, shape = metoda)) +
  geom_errorbar(aes(xmin = p - 1.96 * se, xmax = p + 1.96 * se), width = 0.15, orientation = "y") +
  geom_point(size = 3.4) +
  geom_text(aes(label = sprintf("%.1f%%", 100 * p)), vjust = -1.1, size = 3.9, show.legend = FALSE) +
  scale_x_continuous(labels = scales::percent_format(accuracy = 1), limits = c(0, 0.8)) +
  facet_wrap(~ miara, ncol = 1, scales = "free_y") +
  scale_colour_manual(values = c("prawdziwa dolna piątka" = "grey30", "surowe średnie" = kol[["cynober"]], "model wielopoziomowy" = kol[["niebieski"]])) +
  scale_shape_manual(values = c("prawdziwa dolna piątka" = 15, "surowe średnie" = 17, "model wielopoziomowy" = 16)) +
  labs(title = "Kogo wskazuje lista „5 najmniej zaangażowanych zespołów”?",
       subtitle = "1000 symulowanych firm o schemacie z przykładu; odcinki – 95% przedziały błędu Monte Carlo",
       x = "Odsetek pięciu wskazanych zespołów", y = NULL) +
  motyw + theme(legend.position = "none")
p5   # zapis: ggsave("zaangazowanie-symulacja-listy.svg", p5, width = 10, height = 5.6)
Wynik w R
          miara srednia blad_MC
  trafne_surowe   0.410  0.0056
   trafne_model   0.421  0.0059
    male_surowe   0.398  0.0063
     male_model   0.148  0.0048
 male_prawdziwe   0.280  0.0061
    blad_surowe   0.274  0.0011
     blad_model   0.169  0.0007
       osobliwy   0.014  0.0037
udzial_zespolow_4_5_osob
                   0.275
5. Sprawdzenie palety
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (duże / małe zespoły; dwie metody)" = c("#0072B2", "#D55E00"),
             "szary – cynober (prawdziwa piątka / surowe średnie)" = c("#4D4D4D", "#D55E00"),
             "niebieski – pomarańczowy (zespoły na rysunku 4)" = c("#0072B2", "#E69F00"),
             "zielony – fioletowy (zespoły na rysunku 4)" = c("#009E73", "#CC79A7"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                       widzenie_typowe
niebieski – cynober (duże / małe zespoły; dwie metody)           114.6
szary – cynober (prawdziwa piątka / surowe średnie)               79.6
niebieski – pomarańczowy (zespoły na rysunku 4)                  120.2
zielony – fioletowy (zespoły na rysunku 4)                        87.5
czerwony – zielony (do unikania)                                 121.7
                                                       deuteranopia protanopia
niebieski – cynober (duże / małe zespoły; dwie metody)        108.3       91.9
szary – cynober (prawdziwa piątka / surowe średnie)            67.6       55.8
niebieski – pomarańczowy (zespoły na rysunku 4)               121.5      109.3
zielony – fioletowy (zespoły na rysunku 4)                     18.1       36.2
czerwony – zielony (do unikania)                               21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, regresja – pakiety base i stats). Modele wielopoziomowe dopasowano pakietem lme4, a wartości p ze stopniami swobody Satterthwaite’a i test wariancji zespołów dał pakiet lmerTest. Rysunki wykonano w ggplot2 (oś procentowa – pakiet scales, zestawienie paneli – patchwork); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Ranking z surowych średnich. Na krańcach listy lądują przypadkowo małe zespoły (39.8% wskazań przy 28.0% w prawdziwej dolnej piątce).
- Porównywanie zespołów 4-osobowych. Rzetelność średniej .30; jedna osoba zmienia średnią o jedną czwartą swojego wyniku.
- Wiara, że model „naprawia” ranking. Daje dokładniejsze oszacowania, ale małe zespoły chowa przy średniej – trafność listy prawie się nie zmieniła.
- Błąd ekologiczny. Korelacja średnich zespołów (r = .478) nie mówi nic o pracownikach; tu ma nawet przeciwny znak.
- Zmienna zespołu w zwykłej regresji. Styl lidera „istotny” przy p = .037 tylko dlatego, że 40 liderów policzono jak 452 obserwacje.
- Anonimowość. Wyniki zespołu 4-osobowego łatwo przypisać osobom; ustal z góry minimalną liczebność raportowanego zespołu.
Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Najczęstsze pytania
Jak porównać zaangażowanie zespołów o różnej liczebności?
Nie porównuj surowych średnich – średnia małego zespołu jest mało rzetelna i często trafia na krańce rankingu przypadkiem. Dopasuj model wielopoziomowy z losowym wyrazem wolnym zespołu i porównuj przewidywania z 95% przedziałami. W przykładzie przedział nie obejmował średniej firmy tylko w 2 z 40 zespołów; resztę kolejności trzeba traktować jako szum.
Co oznacza ICC w ankiecie pracowniczej?
ICC z modelu pustego to odsetek wariancji wyniku, który przypada na różnice między zespołami. ICC = .098 oznacza, że ok. 10% różnic w zaangażowaniu leży między zespołami, a 90% między osobami w tym samym zespole. Nawet takie ICC przy średnio 11 osobach w zespole podwaja efekt schematu i zmniejsza efektywną liczebność próby mniej więcej o połowę.
Ile osób musi mieć zespół, żeby raportować jego wynik?
Zależy od ICC. Rzetelność średniej zespołu to τ² / (τ² + σ²/n); w przykładzie wynosiła .30 przy 4 osobach, .52 przy 10 i .70 przy 22. Ustal próg z góry, także ze względu na anonimowość, a małe zespoły raportuj łącznie albo z kilku edycji ankiety.
Czy ranking z modelu wielopoziomowego jest trafniejszy niż ze średnich?
Model daje dokładniejsze oszacowania poziomu zespołów (w symulacji średni błąd 0.169 wobec 0.274 punktu), ale lista „5 najgorszych” trafiała podobnie: 42.1% wobec 41.0%. Model przestaje wyrzucać na krańce przypadkowe małe zespoły, za to rzadziej wskazuje małe zespoły, które naprawdę mają problem – dlatego zamiast listy raportuj przedziały.
Co to jest błąd ekologiczny w badaniu pracowników?
To przeniesienie związku między średnimi zespołów na pojedyncze osoby. W przykładzie zespoły z większą liczbą nadgodzin były bardziej zaangażowane (r = .478), ale w obrębie zespołu pracownicy z większą liczbą nadgodzin byli mniej zaangażowani (b = −0.092 na godzinę). Rozdziel efekty przez centrowanie do średniej zespołu.
Powiązane hasła
Przeczytaj też
Model wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikOcena 360 stopni: zgodność i łagodność
60 kierowników restauracji: ICC i rwg, samoocena, łagodność przełożonych w modelu lme4, efekt aureoli i ile ocen potrzeba – z kodem R.
Czytaj →PoradnikRotacja pracowników jako analiza przeżycia
Magazyn, 1800 pracowników: cenzurowanie, Kaplan–Meier, skok odejść po okresie próbnym, odejścia i zwolnienia jako ryzyka konkurencyjne, model Coxa.
Czytaj →Masz w pracy ankietę pracowniczą z wielu zespołów lub działów?
Pomożemy policzyć ICC, zbudować model wielopoziomowy, porównać zespoły uczciwie wobec ich liczebności i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Enders, C. K., & Tofighi, D. (2007). Centering predictor variables in cross-sectional multilevel models: A new look at an old issue. Psychological Methods, 12(2), 121–138. https://doi.org/10.1037/1082-989x.12.2.121
- Leckie, G., & Goldstein, H. (2009). The limitations of using school league tables to inform school choice. Journal of the Royal Statistical Society: Series A (Statistics in Society), 172(4), 835–851. https://doi.org/10.1111/j.1467-985x.2009.00597.x
- Lüdtke, O., Marsh, H. W., Robitzsch, A., Trautwein, U., Asparouhov, T., & Muthén, B. (2008). The multilevel latent covariate model: A new, more reliable approach to group-level effects in contextual studies. Psychological Methods, 13(3), 203–229. https://doi.org/10.1037/a0012869
- McNeish, D. (2017). Small sample methods for multilevel modeling: A colloquial elucidation of REML and the Kenward-Roger correction. Multivariate Behavioral Research, 52(5), 661–670. https://doi.org/10.1080/00273171.2017.1344538
- Schaufeli, W. B., Bakker, A. B., & Salanova, M. (2006). The measurement of work engagement with a short questionnaire: A cross-national study. Educational and Psychological Measurement, 66(4), 701–716. https://doi.org/10.1177/0013164405282471
- Schwartz, S. (1994). The fallacy of the ecological fallacy: The potential misuse of a concept and the consequences. American Journal of Public Health, 84(5), 819–824. https://doi.org/10.2105/ajph.84.5.819 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{enders2007centering, author={Enders, Craig K. and Tofighi, Davood}, title={{Centering predictor variables in cross-sectional multilevel models: A new look at an old issue}}, journal={Psychological Methods}, year={2007}, volume={12}, number={2}, pages={121--138}, doi={10.1037/1082-989x.12.2.121}}@article{leckie2009limitations, author={Leckie, George and Goldstein, Harvey}, title={{The limitations of using school league tables to inform school choice}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={2009}, volume={172}, number={4}, pages={835--851}, doi={10.1111/j.1467-985x.2009.00597.x}}@article{ludtke2008multilevel, author={Lüdtke, Oliver and Marsh, Herbert W. and Robitzsch, Alexander and Trautwein, Ulrich and Asparouhov, Tihomir and Muthén, Bengt}, title={{The multilevel latent covariate model: A new, more reliable approach to group-level effects in contextual studies}}, journal={Psychological Methods}, year={2008}, volume={13}, number={3}, pages={203--229}, doi={10.1037/a0012869}}@article{mcneish2017small, author={McNeish, Daniel}, title={{Small sample methods for multilevel modeling: A colloquial elucidation of REML and the Kenward-Roger correction}}, journal={Multivariate Behavioral Research}, year={2017}, volume={52}, number={5}, pages={661--670}, doi={10.1080/00273171.2017.1344538}}@article{schaufeli2006measurement, author={Schaufeli, Wilmar B. and Bakker, Arnold B. and Salanova, Marisa}, title={{The measurement of work engagement with a short questionnaire: A cross-national study}}, journal={Educational and Psychological Measurement}, year={2006}, volume={66}, number={4}, pages={701--716}, doi={10.1177/0013164405282471}}@article{schwartz1994fallacy, author={Schwartz, Sharon}, title={{The fallacy of the ecological fallacy: The potential misuse of a concept and the consequences}}, journal={American Journal of Public Health}, year={1994}, volume={84}, number={5}, pages={819--824}, doi={10.2105/ajph.84.5.819}}