Przykład: sześć marek napojów roślinnych i pytanie „jak nas widzą?”
Fikcyjny producent napoju owsianego Verdo chce wiedzieć, jak klienci widzą jego markę na tle pięciu konkurentów: Avenko (lider rynku), Ziarnik, Kremka, Bazik i Fitka. Wszystkie nazwy są zmyślone. Pytanie działu marketingu brzmi: z jakimi cechami kojarzy się każda marka, które marki są do siebie podobne i gdzie na rynku jest wolne miejsce? Odpowiedzią jest mapa percepcji – wykres, na którym marki o podobnym wizerunku leżą blisko siebie. Inne typowe projekty z tej dziedziny opisuje wpis statystyka w pracy z marketingu.
Dane pochodzą z dwóch części fikcyjnej ankiety online:
- Część 1 – „co pasuje do marki”. 1000 osób przy każdej znanej sobie marce zaznaczało dowolnie wiele z 10 cech (smaczny, tani, zdrowy, ekologiczny, naturalny skład, dobry do kawy, nowoczesny, dla całej rodziny, łatwo dostępny, wysoka jakość). Na koniec te same osoby zaznaczały cechy „idealnego napoju”. Razem 8110 wskazań. Z nich powstaje tabela krzyżowa marka × cecha – materiał do analizy korespondencji.
- Część 2 – oceny 1–7. Inne 600 osób oceniało każdą znaną markę na tych samych 10 cechach (1 – zupełnie nie pasuje, 7 – bardzo pasuje). Średnie ocen to materiał do biplotu PCA.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy profil każdej marki (np. Verdo: ekologiczny, naturalny skład, zdrowy; Ziarnik: tani; Kremka: dobry do kawy; Fitka: zdrowy i nowoczesny), znajomość marek (od 92% dla Avenko do 25% dla Fitki), dodatkową „obecność w głowie” lidera i ogólną sympatię do marek, która w części 2 podnosi lub obniża oceny wszystkich cech naraz. Pełna lista parametrów jest przy kodzie. Ziarno 626 ustaliliśmy raz; ani ziarna, ani parametrów nie zmienialiśmy po pierwszym uruchomieniu. Dane pobierzesz jako mapa-percepcji-wskazania.csv (wiersz = osoba × marka, kolumny 0/1 = cechy) i mapa-percepcji-oceny.csv (oceny 1–7).
Rysunek 1: od ankiety do mapy
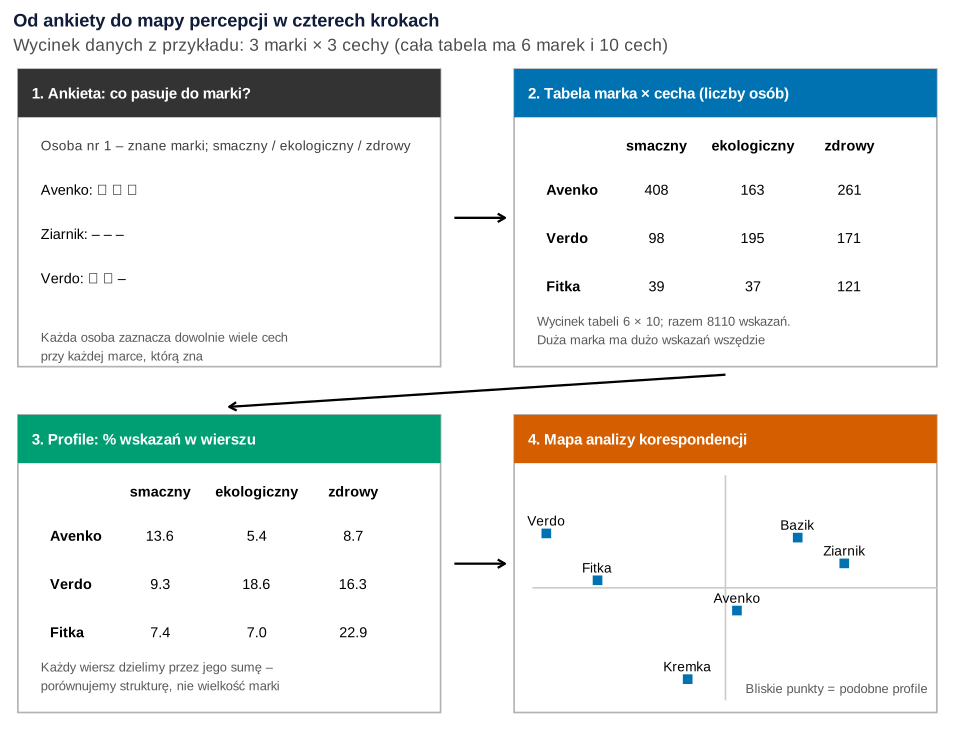
set.seed(626)).Co widać. Odpowiedzi osób sumujemy w tabelę 6 marek × 10 cech. Avenko ma 408 wskazań „smaczny”, a Fitka 39. To jednak głównie skutek tego, że Avenko zna 919 osób, a Fitkę 266. Dlatego trzeci krok dzieli każdy wiersz przez jego sumę. Powstaje profil marki: jaki procent wszystkich wskazań marki dotyczy danej cechy. „Zdrowy” to 22.9% wskazań Fitki i tylko 8.7% wskazań Avenko. Mapa w kroku 4 porównuje właśnie profile.
Jak może zmylić. Schemat pokazuje wycinek 3 × 3. Mapę liczymy z całej tabeli, a położenie marki zależy od wszystkich dziesięciu cech.
Podpis do pracy:
Rysunek 2: pułapka wielkości marki
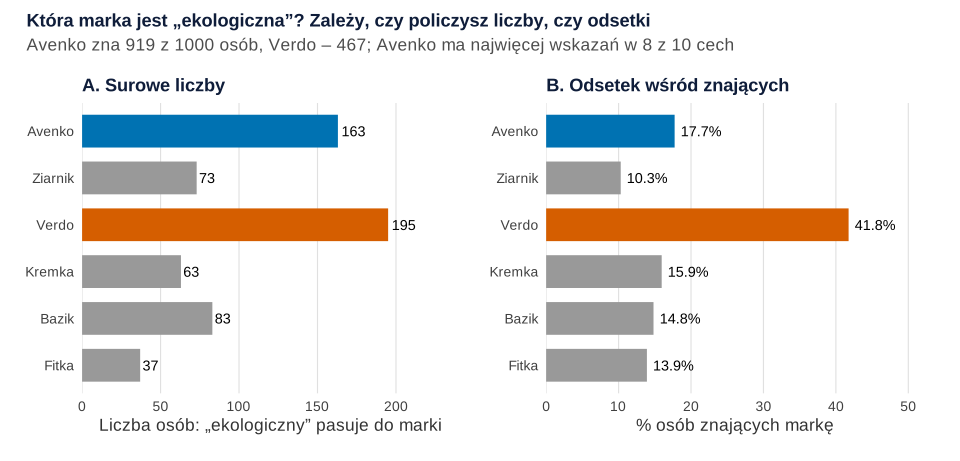
Co widać. W surowych liczbach Avenko (163 wskazania) prawie dorównuje „ekologicznej” Verdo (195). W odsetkach wśród osób, które znają markę, różnica jest wyraźna: 41.8% wobec 17.7%. W całej tabeli Avenko ma najwięcej wskazań w 8 z 10 cech i 37.1% wszystkich wskazań. Wygrywa nawet w cechach, które w danych należą do innych marek, np. „zdrowy” (261 wobec 171 dla Verdo i 121 dla Fitki).
Jak może zmylić. To typowy efekt wielkości marki: marka znana dostaje „wszystkie cechy”, bo więcej osób w ogóle się o niej wypowiada. Ranking marek według liczby wskazań to ranking znajomości, a nie wizerunku.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: mapa z analizy korespondencji
Analiza korespondencji (CA) zamienia tabelę liczebności w mapę, na której wiersze i kolumny są punktami (Greenacre i Hastie, 1987). Hoffman i Franke (1986) przedstawili ją literaturze marketingowej, w której była mało znana, na przykładzie konsumpcji napojów bezalkoholowych. Kluczowe dla nas: CA porównuje profile, a nie liczby, więc z definicji usuwa efekt wielkości wiersza. Duża marka ma tylko większą masę, czyli większą wagę przy wyznaczaniu osi. Liczymy ją pakietem ca (Nenadić i Greenacre, 2007). „Idealny napój” dodajemy jako punkt uzupełniający: nie wpływa na osie, tylko jest na nie rzutowany.
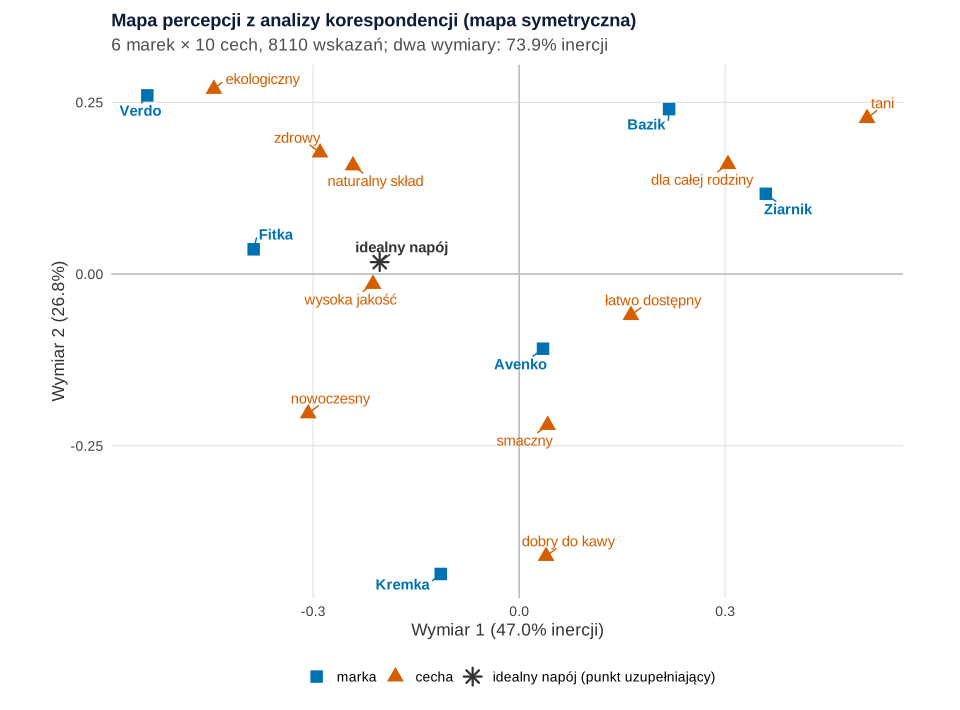
Co widać. Zróżnicowanie tabeli mierzy inercja: 0.1695. Dwa wymiary mapy wyjaśniają 73.9% inercji (47.0% i 26.8%), trzeci jeszcze 13.6%. Wymiar 1 biegnie od „eko i zdrowia” (Verdo, Fitka) do „ceny i rodziny” (Ziarnik, Bazik). Wymiar 2 oddziela Kremkę i kawę (dół) od reszty. Mapa odtworzyła profile, które ukryliśmy w danych. Avenko leży blisko środka. Nie znaczy to, że „nie ma wizerunku”: jej profil jest bliski przeciętnemu, a przeciętny w dużej mierze tworzy ona sama (masa .371). Idealny napój leży przy cesze „wysoka jakość”, najbliżej Fitki (odległość 0.184) i Avenko (0.269), a najdalej od Ziarnika (0.571).
Jak może zmylić. Mapa to rzut na dwa wymiary. Jakość tego rzutu (cos²) jest dla Verdo bardzo dobra (.93), ale dla Fitki tylko .35, a dla Avenko .40. Część ich profilu leży w dalszych wymiarach. Wartość p testu chi-kwadrat (χ²(45) = 1374.82) jest tu tylko orientacyjna: jedna osoba daje wiele wskazań, więc obserwacje nie są niezależne.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: czego nie czytać z mapy symetrycznej
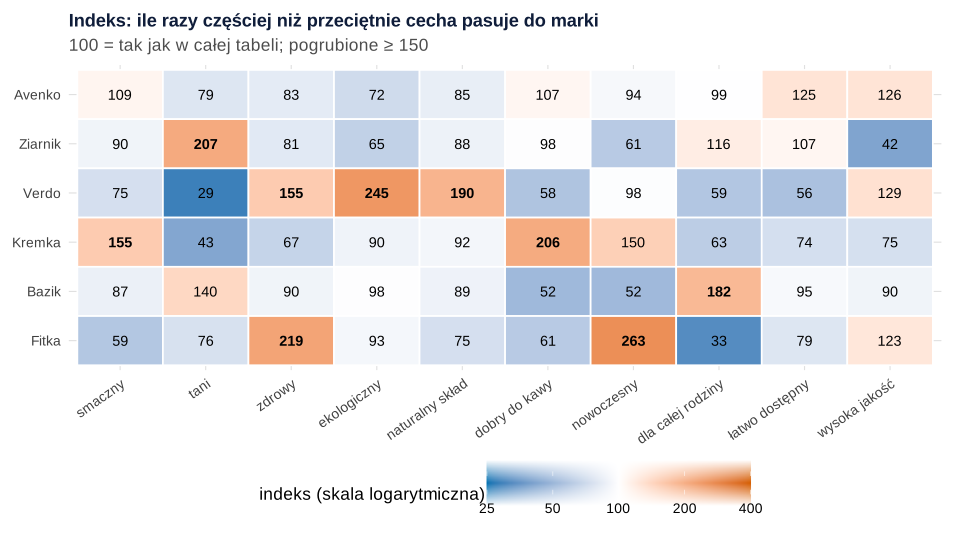
Kusi, żeby czytać mapę tak: „marka leży najbliżej cechy X, więc najbardziej kojarzy się z X”. Na mapie symetrycznej to nieuprawnione – marki i cechy są skalowane osobno, a odległość punktu marki od punktu cechy nie ma prostej interpretacji (o geometrii mapy zob. Greenacre i Hastie, 1987). Wolno porównywać marki z markami i cechy z cechami. Siłę związku marki z cechą pokazuje indeks: liczba wskazań podzielona przez liczbę oczekiwaną przy braku związku, razy 100. Indeks 200 = cecha pasuje do marki dwa razy częściej niż przeciętnie.
Co widać. Ziarnik leży na mapie najbliżej cechy „dla całej rodziny” (odległość 0.070), a dalej od „tani” (0.184). Indeksy mówią odwrotnie: „tani” 207, „dla całej rodziny” tylko 116. Podobnie Fitka: na mapie najbliżej „zdrowy” (219), ale najsilniej wyróżnia ją „nowoczesny” (263). Wiersz Avenko jest blady (72–126) – lider ma profil zbliżony do przeciętnego.
Jak może zmylić. Indeks przy małej marce opiera się na małych liczbach: 89 wskazań „nowoczesny” dla Fitki daje 263, ale niepewność jest większa niż przy Avenko (rysunek 6).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: biplot PCA na średnich ocenach
Drugie popularne podejście to analiza głównych składowych (PCA) macierzy średnich ocen: 6 marek × 10 cech. PCA szuka nowych, nieskorelowanych osi, które kolejno zbierają jak najwięcej wariancji (Jolliffe i Cadima, 2016). Wynik rysujemy jako biplot: marki to punkty, cechy – strzałki (Gabriel, 1971). Mapy percepcji oparte na analizie czynnikowej ocen dawały w porównaniach lepsze przewidywania i łatwiejszą interpretację niż mapy z analizy dyskryminacyjnej czy ocen podobieństwa (Hauser i Koppelman, 1979). Zmienne poddajemy standaryzacji.
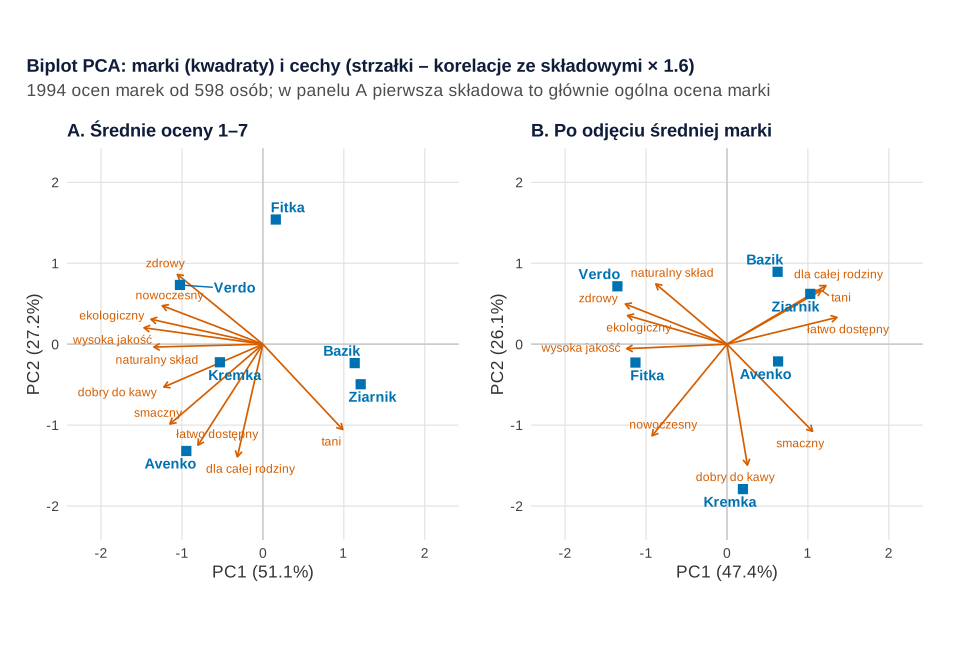
Co widać. W panelu A pierwsza składowa (51.1% wariancji) koreluje ze średnią oceną marki na poziomie r = .946. Prawie wszystkie strzałki wskazują w lewo, gdzie leżą marki ocenione najwyżej, np. Avenko (średnia 5.00), a po prawej są marki ocenione najsłabiej: Bazik (3.72) i Ziarnik (3.83). Pierwsza oś mówi więc głównie „lubię – nie lubię”, a nie „jaki wizerunek”. To efekt halo: ogólna ocena zmienia oceny pojedynczych cech, często bez wiedzy oceniającego (Nisbett i Wilson, 1977). W panelu B od każdej oceny marki odjęliśmy jej średnią. Wtedy strzałki rozchodzą się w różne strony, a układ marek zgadza się z mapą CA: korelacja odległości między markami na obu mapach rośnie z .373 do .937.
Jak może zmylić. Sześć marek to sześć punktów: PCA ma najwyżej 5 składowych, a „wyjaśniona wariancja” opisuje zróżnicowanie tylko tych marek. Dodanie lub usunięcie jednej marki może obrócić mapę. Strzałki wydłużyliśmy 1.6 raza – podaj to w podpisie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: jak pewne jest położenie marek?
Mapa z jednej próby nie ma przedziałów niepewności. Najprostsze uzupełnienie to bootstrap: losujemy ze zwracaniem całe osoby (nie pojedyncze wskazania, bo wskazania jednej osoby są ze sobą powiązane), liczymy tabelę od nowa i rzutujemy profile marek na tę samą mapę jako punkty uzupełniające. Powtarzamy 500 razy.
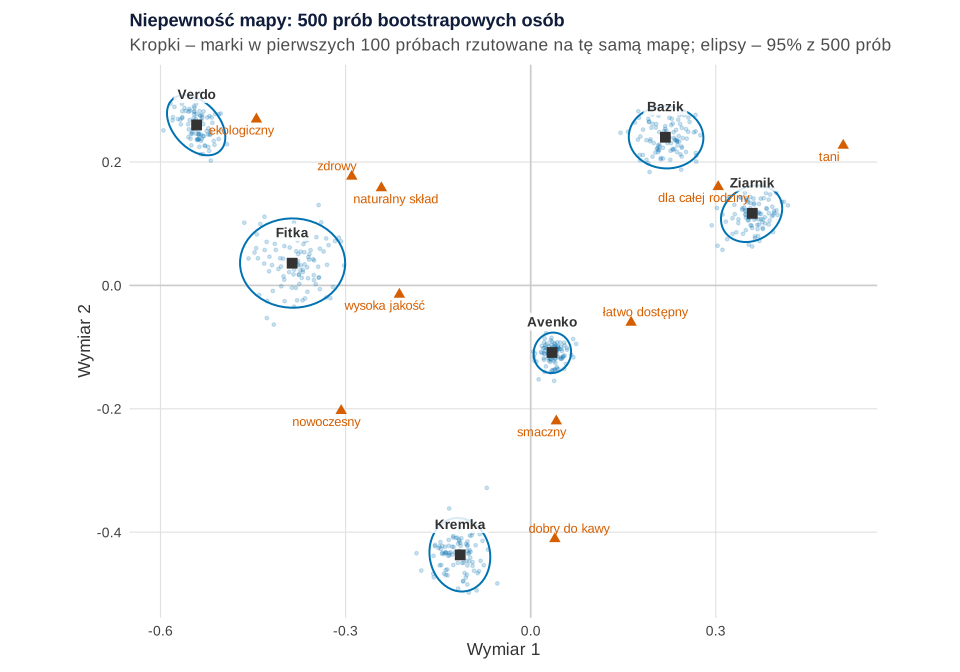
set.seed(626)).Co widać. Żadne dwie elipsy marek się nie nakładają, więc podział rynku na mapie nie jest dziełem przypadku. Rozrzut zależy od liczby osób, które znają markę. Odchylenie standardowe położenia na wymiarze 1 wynosi 0.014 dla Avenko (919 osób) i 0.039 dla Fitki (266 osób) – prawie trzy razy więcej.
Jak może zmylić. Elipsy pokazują zmienność próby przy stałych osiach. Nie obejmują niepewności samych osi ani błędów ankiety (np. kolejności marek w kwestionariuszu).
Podpis do pracy:
Zdanie do Metody:
CA czy PCA – porównanie obu map
| Cecha | Analiza korespondencji | Biplot PCA |
|---|---|---|
| Dane | liczby wskazań „pasuje / nie pasuje” | średnie ocen na skali, np. 1–7 |
| Ankieta | krótka, jedno kliknięcie na cechę | dłuższa, ocena każdej cechy |
| Wielkość marki | usuwa (porównuje profile) | nie dotyczy, ale ogólna sympatia (halo) może zdominować PC1 |
| Co czytać | marki z markami, cechy z cechami, kierunki | rzuty marek na strzałki, kąty między strzałkami |
| Tu | 2 wymiary: 73.9% inercji | po odjęciu średniej marki: 73.5% wariancji |
Obie mapy dały ten sam obraz rynku, gdy z ocen usunęliśmy poziom marki. Jeśli masz tylko macierz podobieństw między markami („jak bardzo podobne są A i B?”), użyj skalowania wielowymiarowego (MDS). Wkłady punktów, mapę asymetryczną i pełną procedurę CA omawia wpis analiza korespondencji krok po kroku, a obsługę w SPSS – analiza korespondencji w SPSS. Różnicę między PCA a modelem czynnikowym wyjaśnia wpis PCA czy analiza czynnikowa?
Co z tym zrobić w marketingu
- Verdo: ma wyraźny, stabilny wizerunek „eko” (indeks 245), ale leży daleko od idealnego napoju (0.416), bo prawie nikt nie uważa go za tani (indeks „tani” 29). Komunikacja: smak i jakość, nie tylko ekologia.
- Fitka: najbliżej ideału, ale zna ją tylko 26.6% badanych. Zadanie: zwiększyć znajomość, a nie zmieniać wizerunek.
- Ziarnik i Bazik leżą obok siebie (cena, rodzina) – walczą o tych samych klientów. Jeden z nich może się przesunąć, np. w stronę jakości.
- Kremka ma niszę „dobry do kawy” (206) bez konkurenta – warto ją bronić, np. w kawiarniach.
- Zmianę w czasie sprawdzaj powtarzanymi falami tej samej ankiety (wpis badanie trackingowe marki).
Pułapki
- Surowe liczby zamiast profili. Lider „wygrywa” w 8 z 10 cech (rysunek 2).
- Odległość marka–cecha na mapie symetrycznej. Ziarnik leży przy „rodzinie”, a wyróżnia go cena (rysunek 4).
- Marka w środku mapy = „bez wizerunku”. Środek to profil przeciętny – a duża marka sama go tworzy.
- PCA na surowych średnich. Pierwsza oś to sympatia do marki (halo), nie pozycjonowanie (rysunek 5).
- Mała marka na obrzeżach. Jej punkt jest najmniej pewny (rysunek 6), a jakość rzutu bywa niska (Fitka: cos² = .35).
- Test χ² jak dla niezależnych obserwacji. Przy pytaniu „zaznacz wszystkie pasujące” jedna osoba daje wiele wskazań.
- Porównanie krajów lub grup bez sprawdzenia, czy cechy rozumiane są tak samo – zob. niezmienność pomiarowa skali marki.
Pomoc przy takiej analizie do pracy dyplomowej: analizy statystyczne dla studentów.
Jak opisać w pracy
W Metodzie podaj sposób zbierania danych (pytanie „zaznacz cechy pasujące do marki” albo oceny na skali), liczbę osób i wskazań, rodzaj mapy (symetryczna, współrzędne główne), punkty uzupełniające i sposób oceny stabilności. W Wynikach – procent inercji (lub wariancji) na wymiarach, opis wymiarów i tabelę indeksów lub profili. Gdy zamiast mapy chcesz pogrupować klientów, sięgnij po analizę skupień w marketingu; oceny produktów w sklepie internetowym omawia wpis oceny gwiazdkowe i ranking produktów.
Kod R: analiza korespondencji, indeksy, biplot PCA i bootstrap
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Analizę korespondencji liczy pakiet ca, PCA – funkcja prcomp() z bazowego R. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dwie części ankiety, każda zaczyna się od set.seed(626)) i 7 (bootstrap, własne set.seed(626)); etykiety rozsuwa ggrepel z seed = 626. Ziarno 626 ustalono raz i nie zmieniano go. Ręcznie ustalono: liczebności (1000 i 600 osób), znajomość marek (.92, .70, .45, .40, .55, .25), „ogólną obecność” marek na skali logitu (Avenko +0.5, Bazik −0.2, Verdo i Fitka −0.1, pozostałe 0), bazową częstość cech, profile marek (wartości w kodzie, od −1.0 do +1.6), skłonność osób do zaznaczania (odchylenie standardowe 0.6), odsetki cech idealnego napoju, a w części 2 – średnią sympatię do marek (od −0.4 do +0.6, odchylenie standardowe 0.8), wagę profilu 0.9 i szum ocen (odchylenie standardowe 1). Parametrów nie zmieniano po pierwszym uruchomieniu. Całość liczy się w kilka sekund.
1. Paleta, motyw i dane z dwóch części ankiety
R
# Dane. Fikcyjne badanie wizerunku 6 marek napojów roślinnych: tabela „cecha pasuje do marki” i oceny 1–7
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", blekit = "#56B4E9", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

marki <- c("Avenko", "Ziarnik", "Verdo", "Kremka", "Bazik", "Fitka")          # nazwy fikcyjne
cechy <- c("smaczny", "tani", "zdrowy", "ekologiczny", "naturalny skład", "dobry do kawy",
           "nowoczesny", "dla całej rodziny", "łatwo dostępny", "wysoka jakość")
# Parametry ustalone ręcznie: znajomość marki, „ogólna obecność” marki w głowie i profil (skala logitu)
znajomosc <- c(Avenko = .92, Ziarnik = .70, Verdo = .45, Kremka = .40, Bazik = .55, Fitka = .25)
ogolna    <- c(Avenko = 0.5, Ziarnik = 0, Verdo = -0.1, Kremka = 0, Bazik = -0.2, Fitka = -0.1)
cecha_baza <- c(0.4, 0, 0.2, -0.2, -0.2, 0, -0.3, 0, 0.3, 0)
profil <- matrix(0, 6, 10, dimnames = list(marki, cechy))
profil["Avenko",  c("smaczny", "łatwo dostępny", "dobry do kawy", "dla całej rodziny", "wysoka jakość", "ekologiczny")] <- c(0.5, 1.2, 0.5, 0.5, 0.3, -0.3)
profil["Ziarnik", c("tani", "łatwo dostępny", "dla całej rodziny", "wysoka jakość", "nowoczesny", "ekologiczny")] <- c(1.5, 0.6, 0.5, -0.9, -0.7, -0.6)
profil["Verdo",   c("ekologiczny", "naturalny skład", "zdrowy", "tani", "wysoka jakość")] <- c(1.6, 1.3, 0.8, -1.0, 0.5)
profil["Kremka",  c("dobry do kawy", "smaczny", "nowoczesny", "zdrowy", "tani")] <- c(1.6, 0.8, 0.8, -0.5, -0.6)
profil["Bazik",   c("dla całej rodziny", "tani", "łatwo dostępny", "nowoczesny", "dobry do kawy")] <- c(1.3, 0.8, 0.4, -0.8, -0.3)
profil["Fitka",   c("zdrowy", "nowoczesny", "wysoka jakość", "dla całej rodziny", "smaczny")] <- c(1.4, 1.2, 0.4, -0.8, -0.4)
idealny <- c(.75, .35, .65, .35, .60, .45, .15, .30, .50, .55)   # jaki napój byłby idealny (pytanie osobne)

# Część 1: 1000 osób; przy każdej znanej marce zaznaczają cechy, które do niej pasują (dowolnie wiele)
set.seed(626)                                    # ziarno ustalone raz, bez dobierania pod wynik
n1 <- 1000
sklonnosc <- rnorm(n1, 0, 0.6)                   # jedni zaznaczają dużo, inni mało
wskazania <- do.call(rbind, lapply(seq_len(n1), function(i) {
  zna <- marki[rbinom(6, 1, znajomosc) == 1]
  wiersze <- lapply(zna, function(m) {
    p <- plogis(-1.6 + ogolna[m] + cecha_baza + profil[m, ] + sklonnosc[i])
    data.frame(osoba = i, marka = m, t(setNames(rbinom(10, 1, p), cechy)), check.names = FALSE)
  })
  ideal <- data.frame(osoba = i, marka = "idealny napój", t(setNames(rbinom(10, 1, idealny), cechy)), check.names = FALSE)
  do.call(rbind, c(wiersze, list(ideal)))
}))
write.csv(wskazania, "mapa-percepcji-wskazania.csv", row.names = FALSE)

# Część 2: inne 600 osób ocenia każdą znaną markę na skali 1–7 („pasuje” od 1 do 7)
set.seed(626)
n2 <- 600
lubienie <- c(Avenko = 0.6, Ziarnik = -0.2, Verdo = 0.3, Kremka = 0.3, Bazik = -0.4, Fitka = 0)
oceny <- do.call(rbind, lapply(seq_len(n2), function(i) {
  zna <- marki[rbinom(6, 1, znajomosc) == 1]
  do.call(rbind, lapply(zna, function(m) {
    lubi <- rnorm(1, lubienie[m], 0.8)            # ogólna sympatia do marki – działa na wszystkie cechy (halo)
    x <- round(4 + 1.2 * (lubi + 0.9 * profil[m, ] + rnorm(10, 0, 1)))
    data.frame(osoba = i, marka = m, t(setNames(pmin(pmax(x, 1), 7), cechy)), check.names = FALSE)
  }))
}))
write.csv(oceny, "mapa-percepcji-oceny.csv", row.names = FALSE)

# Tabela marka × cecha: liczba osób, które uznały, że cecha pasuje do marki
N <- as.matrix(rowsum(wskazania[wskazania$marka %in% marki, cechy], wskazania$marka[wskazania$marka %in% marki]))[marki, ]
ideal_wiersz <- colSums(wskazania[wskazania$marka == "idealny napój", cechy])
zna_marke <- table(factor(wskazania$marka, marki))
c(osoby = n1, wskazan_cech = sum(N), oceniajacych = n2, ocen_marek = nrow(oceny))
zna_marke
N
Wynik w R
       osoby wskazan_cech oceniajacych   ocen_marek
        1000         8110          600         1994

 Avenko Ziarnik   Verdo  Kremka   Bazik   Fitka
    919     709     467     395     560     266
        smaczny tani zdrowy ekologiczny naturalny skład dobry do kawy
Avenko      408  251    261         163             202           331
Ziarnik     167  323    126          73             103           149
Verdo        98   32    171         195             157            62
Kremka      180   42     65          63              67           196
Bazik       121  164    105          83              78            59
Fitka        39   42    121          37              31            33
        nowoczesny dla całej rodziny łatwo dostępny wysoka jakość
Avenko         181               328            569           316
Ziarnik         58               189            240            52
Verdo           66                68             89           113
Kremka          89                64            104            58
Bazik           37               223            159            84
Fitka           89                19             63            54
2. Schemat „od ankiety do mapy”: Rysunek 1
R
# Rysunek 1. Schemat „ankieta → tabela → profile → mapa” (grafika z ggplot2: prostokąty, tekst, strzałki)
# Korzysta z obiektów przepisu 1: wskazania, N, marki, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(ca)

pokaz_m <- c("Avenko", "Verdo", "Fitka"); pokaz_c <- c("smaczny", "ekologiczny", "zdrowy")
os1 <- head(wskazania[wskazania$osoba == 1 & wskazania$marka %in% marki, ], 3)  # pierwsza osoba, do 3 marek
os1_opis <- paste0(os1$marka, ": ", apply(os1[, pokaz_c], 1, function(z) paste(ifelse(z == 1, "✓", "–"), collapse = "  ")))
profile <- 100 * N / rowSums(N)                                               # profil wiersza: % wskazań marki
r0 <- ca(N)
wsp <- data.frame(marka = marki, x = r0$rowcoord[, 1] * r0$sv[1], y = r0$rowcoord[, 2] * r0$sv[2])
os1_opis
N[pokaz_m, pokaz_c]
round(profile[pokaz_m, pokaz_c], 1)

pudla <- data.frame(x0 = c(0, 5.4, 0, 5.4), y0 = c(4.3, 4.3, 0, 0), kolor = c("a", "b", "c", "d"),
                    tytul = c("1. Ankieta: co pasuje do marki?", "2. Tabela marka × cecha (liczby osób)",
                              "3. Profile: % wskazań w wierszu", "4. Mapa analizy korespondencji"))
tabela_tekst <- function(M, x0, y0, fmt) {                                     # mała tabela jako tekst
  d <- expand.grid(i = seq_len(nrow(M)), j = seq_len(ncol(M)))
  rbind(data.frame(x = x0 + 1.55 + 1.05 * (seq_len(ncol(M)) - 1), y = y0 + 2.75, lab = colnames(M), b = "bold"),
        data.frame(x = x0 + 0.35, y = y0 + 2.2 - 0.6 * (seq_len(nrow(M)) - 1), lab = rownames(M), b = "bold"),
        data.frame(x = x0 + 1.55 + 1.05 * (d$j - 1), y = y0 + 2.2 - 0.6 * (d$i - 1), lab = sprintf(fmt, M[cbind(d$i, d$j)]), b = "plain"))
}
t2 <- tabela_tekst(N[pokaz_m, pokaz_c], 5.4, 4.3, "%d"); t2$h <- ifelse(t2$x < 6, 0, 0.5)
t3 <- tabela_tekst(profile[pokaz_m, pokaz_c], 0, 0, "%.1f"); t3$h <- ifelse(t3$x < 0.6, 0, 0.5)
mapa <- transform(wsp, x = 5.4 + 2.3 + 3.6 * x, y = 0 + 1.55 + 2.6 * y)

p1 <- ggplot() +
  geom_rect(data = pudla, aes(xmin = x0, xmax = x0 + 4.6, ymin = y0, ymax = y0 + 3.7), fill = "white", colour = "grey70") +
  geom_rect(data = pudla, aes(xmin = x0, xmax = x0 + 4.6, ymin = y0 + 3.1, ymax = y0 + 3.7, fill = kolor)) +
  geom_text(data = pudla, aes(x0 + 0.15, y0 + 3.4, label = tytul), hjust = 0, fontface = "bold", size = 4, colour = "white") +
  annotate("text", x = 0.25, y = 4.3 + 2.75, hjust = 0, size = 3.6, colour = "grey25",
           label = paste("Osoba nr 1 – znane marki;", paste(pokaz_c, collapse = " / "))) +
  annotate("text", x = 0.25, y = 4.3 + 2.2 - 0.55 * (seq_along(os1_opis) - 1), hjust = 0, size = 3.8, label = os1_opis) +
  annotate("text", x = 0.25, y = 4.55, hjust = 0, size = 3.4, colour = "grey35",
           label = "Każda osoba zaznacza dowolnie wiele cech\nprzy każdej marce, którą zna") +
  geom_text(data = t2, aes(x, y, label = lab, fontface = b, hjust = h), size = 3.8) +
  annotate("text", x = 5.65, y = 4.75, hjust = 0, size = 3.4, colour = "grey35",
           label = sprintf("Wycinek tabeli 6 × 10; razem %d wskazań.\nDuża marka ma dużo wskazań wszędzie", sum(N))) +
  geom_text(data = t3, aes(x, y, label = lab, fontface = b, hjust = h), size = 3.8) +
  annotate("text", x = 0.25, y = 0.45, hjust = 0, size = 3.4, colour = "grey35",
           label = "Każdy wiersz dzielimy przez jego sumę –\nporównujemy strukturę, nie wielkość marki") +
  annotate("segment", x = 5.6, xend = 10.0, y = 1.55, yend = 1.55, colour = "grey80") +
  annotate("segment", x = 7.7, xend = 7.7, y = 0.15, yend = 2.95, colour = "grey80") +
  geom_point(data = mapa, aes(x, y), shape = 15, size = 3, colour = kol[["niebieski"]]) +
  geom_text(data = mapa, aes(x, y, label = marka), vjust = -0.8, size = 3.6) +
  annotate("text", x = 9.9, y = 0.3, hjust = 1, size = 3.4, colour = "grey35", label = "Bliskie punkty = podobne profile") +
  annotate("segment", x = 4.75, xend = 5.3, y = 6.15, yend = 6.15, arrow = arrow(length = unit(0.22, "cm")), linewidth = 0.8) +
  annotate("segment", x = 7.7, xend = 2.3, y = 4.2, yend = 3.8, arrow = arrow(length = unit(0.22, "cm")), linewidth = 0.8) +
  annotate("segment", x = 4.75, xend = 5.3, y = 1.85, yend = 1.85, arrow = arrow(length = unit(0.22, "cm")), linewidth = 0.8) +
  scale_fill_manual(values = c(a = kol[["ciemny"]], b = kol[["niebieski"]], c = kol[["zielony"]], d = kol[["cynober"]]), guide = "none") +
  coord_cartesian(xlim = c(-0.05, 10.05), ylim = c(-0.05, 8.05), expand = FALSE) +
  labs(title = "Od ankiety do mapy percepcji w czterech krokach",
       subtitle = "Wycinek danych z przykładu: 3 marki × 3 cechy (cała tabela ma 6 marek i 10 cech)") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major.x = element_blank(),
                panel.grid.major.y = element_blank())
p1   # zapis: ggsave("mapa-percepcji-schemat.svg", p1, width = 10, height = 7.6)
Wynik w R
[1] "Avenko: ✓  ✓  ✓"  "Ziarnik: –  –  –" "Verdo: ✓  ✓  –"
       smaczny ekologiczny zdrowy
Avenko     408         163    261
Verdo       98         195    171
Fitka       39          37    121
       smaczny ekologiczny zdrowy
Avenko    13.6         5.4    8.7
Verdo      9.3        18.6   16.3
Fitka      7.4         7.0   22.9
3. Efekt wielkości marki: Rysunek 2
R
# Rysunek 2. Efekt wielkości marki: liczba wskazań a odsetek wśród osób, które znają markę
# Korzysta z obiektów przepisu 1: N, zna_marke, marki, cechy, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)

# W ilu kolumnach (cechach) marka ma najwięcej wskazań?
lider_kolumny <- table(factor(marki[apply(N, 2, which.max)], marki))
lider_kolumny
# Udział marki we wszystkich wskazaniach (masa wiersza) i odsetek osób, które ją znają
round(cbind(masa = rowSums(N) / sum(N), zna = as.numeric(zna_marke) / 1000), 3)

eko <- data.frame(marka = factor(marki, rev(marki)), liczba = N[, "ekologiczny"],
                  odsetek = 100 * N[, "ekologiczny"] / as.numeric(zna_marke))
eko$wyroznij <- ifelse(eko$marka %in% c("Avenko", "Verdo"), as.character(eko$marka), "pozostałe")
eko[, -4]

wyk <- function(zm, os, fmt, granica) {
  ggplot(eko, aes(.data[[zm]], marka, fill = wyroznij)) +
    geom_col(width = 0.7) +
    geom_text(aes(label = sprintf(fmt, .data[[zm]])), hjust = -0.15, size = 3.8) +
    scale_fill_manual(values = c(Avenko = kol[["niebieski"]], Verdo = kol[["cynober"]], "pozostałe" = kol[["szary"]]), guide = "none") +
    scale_x_continuous(limits = c(0, granica), expand = c(0, 0)) +
    labs(x = os, y = NULL) + motyw + theme(panel.grid.major.y = element_blank())
}
p2 <- (wyk("liczba", "Liczba osób: „ekologiczny” pasuje do marki", "%.0f", 240) + labs(title = "A. Surowe liczby")) +
  (wyk("odsetek", "% osób znających markę", "%.1f%%", 52) + labs(title = "B. Odsetek wśród znających")) +
  plot_annotation(title = "Która marka jest „ekologiczna”? Zależy, czy policzysz liczby, czy odsetki",
                  subtitle = sprintf("Avenko zna %d z 1000 osób, Verdo – %d; Avenko ma najwięcej wskazań w %d z 10 cech",
                                     zna_marke[["Avenko"]], zna_marke[["Verdo"]], lider_kolumny[["Avenko"]]),
                  theme = motyw)
p2   # zapis: ggsave("mapa-percepcji-efekt-wielkosci-marki.svg", p2, width = 10, height = 4.8)
Wynik w R
 Avenko Ziarnik   Verdo  Kremka   Bazik   Fitka
      8       1       1       0       0       0
         masa   zna
Avenko  0.371 0.919
Ziarnik 0.182 0.709
Verdo   0.130 0.467
Kremka  0.114 0.395
Bazik   0.137 0.560
Fitka   0.065 0.266
          marka liczba  odsetek
Avenko   Avenko    163 17.73667
Ziarnik Ziarnik     73 10.29619
Verdo     Verdo    195 41.75589
Kremka   Kremka     63 15.94937
Bazik     Bazik     83 14.82143
Fitka     Fitka     37 13.90977
4. Analiza korespondencji z punktem uzupełniającym: Rysunek 3
R
# Rysunek 3. Analiza korespondencji tabeli marka × cecha; „idealny napój” jako punkt uzupełniający
# Korzysta z obiektów przepisu 1: N, ideal_wiersz, marki, cechy, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(ggrepel)
library(ca)

# Test χ² tylko orientacyjnie: jedna osoba daje wiele wskazań, więc obserwacje nie są niezależne
chi <- suppressWarnings(chisq.test(N))
round(c(chi2 = unname(chi$statistic), df = unname(chi$parameter), n_wskazan = sum(N),
        inercja = unname(chi$statistic) / sum(N)), 4)

tab <- rbind(N, "idealny napój" = ideal_wiersz)
r <- ca(tab, suprow = 7)                         # wiersz 7 nie wpływa na wymiary, tylko jest rzutowany
inercja <- data.frame(wymiar = seq_along(r$sv), inercja = r$sv^2, procent = 100 * r$sv^2 / sum(r$sv^2))
inercja$skumulowany <- cumsum(inercja$procent)
round(inercja, 4)

# Mapa symetryczna: wiersze i kolumny we współrzędnych głównych (standardowe × wartość osobliwa)
wiersze <- data.frame(nazwa = rownames(tab), x = r$rowcoord[, 1] * r$sv[1], y = r$rowcoord[, 2] * r$sv[2],
                      masa = c(r$rowmass[1:6], NA), typ = c(rep("marka", 6), "idealny napój (punkt uzupełniający)"))
kolumny <- data.frame(nazwa = cechy, x = r$colcoord[, 1] * r$sv[1], y = r$colcoord[, 2] * r$sv[2],
                      masa = r$colmass, typ = "cecha")
print(transform(wiersze, x = round(x, 3), y = round(y, 3), masa = round(masa, 3)), row.names = FALSE)
print(transform(kolumny[, 1:4], x = round(x, 3), y = round(y, 3), masa = round(masa, 3)), row.names = FALSE)
# Jakość odwzorowania marek na dwóch wymiarach (cos²) – jak dobrze punkt pasuje do płaszczyzny
round(setNames(rowSums(r$rowcoord[1:6, 1:2]^2 %*% diag(r$sv[1:2]^2)) /
                 rowSums(r$rowcoord[1:6, ]^2 %*% diag(r$sv^2)), marki), 2)

# Odległość marek od „idealnego napoju” (punkty tego samego rodzaju – tę odległość wolno czytać)
id <- unlist(wiersze[7, c("x", "y")])
round(setNames(sqrt((wiersze$x[1:6] - id[1])^2 + (wiersze$y[1:6] - id[2])^2), marki), 3)

pkt <- rbind(wiersze, kolumny)
pkt$typ <- factor(pkt$typ, c("marka", "cecha", "idealny napój (punkt uzupełniający)"))
p3 <- ggplot(pkt, aes(x, y)) +
  geom_hline(yintercept = 0, colour = "grey75") + geom_vline(xintercept = 0, colour = "grey75") +
  geom_point(aes(shape = typ, colour = typ), size = 3.6, stroke = 1.2) +
  geom_text_repel(aes(label = nazwa, colour = typ, fontface = ifelse(typ == "cecha", "plain", "bold")),
                  size = 3.9, seed = 626, box.padding = 0.45, min.segment.length = 0.3, show.legend = FALSE) +
  scale_shape_manual(values = c(15, 17, 8), name = NULL) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["cynober"]], kol[["ciemny"]]), name = NULL) +
  coord_equal() +
  labs(x = sprintf("Wymiar 1 (%.1f%% inercji)", inercja$procent[1]),
       y = sprintf("Wymiar 2 (%.1f%%)", inercja$procent[2]),
       title = "Mapa percepcji z analizy korespondencji (mapa symetryczna)",
       subtitle = sprintf("6 marek × 10 cech, %d wskazań; dwa wymiary: %.1f%% inercji", sum(N), inercja$skumulowany[2])) +
  motyw + guides(colour = guide_legend(nrow = 1), shape = guide_legend(nrow = 1))
p3   # zapis: ggsave("mapa-percepcji-analiza-korespondencji.svg", p3, width = 10, height = 7.4)
Wynik w R
     chi2        df n_wskazan   inercja
1374.8241   45.0000 8110.0000    0.1695
  wymiar inercja procent skumulowany
1      1  0.0798 47.0493     47.0493
2      2  0.0455 26.8270     73.8763
3      3  0.0230 13.5525     87.4288
4      4  0.0163  9.6353     97.0642
5      5  0.0050  2.9358    100.0000
         nazwa      x      y  masa                                 typ
        Avenko  0.035 -0.109 0.371                               marka
       Ziarnik  0.359  0.117 0.182                               marka
         Verdo -0.541  0.260 0.130                               marka
        Kremka -0.114 -0.437 0.114                               marka
         Bazik  0.218  0.240 0.137                               marka
         Fitka -0.387  0.036 0.065                               marka
 idealny napój -0.203  0.017    NA idealny napój (punkt uzupełniający)
             nazwa      x      y  masa
           smaczny  0.042 -0.220 0.125
              tani  0.507  0.227 0.105
            zdrowy -0.290  0.177 0.105
       ekologiczny -0.445  0.269 0.076
   naturalny skład -0.242  0.158 0.079
     dobry do kawy  0.039 -0.411 0.102
        nowoczesny -0.307 -0.203 0.064
 dla całej rodziny  0.304  0.160 0.110
    łatwo dostępny  0.163 -0.060 0.151
     wysoka jakość -0.213 -0.015 0.083
 Avenko Ziarnik   Verdo  Kremka   Bazik   Fitka
   0.40    0.80    0.93    0.82    0.78    0.35
 Avenko Ziarnik   Verdo  Kremka   Bazik   Fitka
  0.269   0.571   0.416   0.463   0.477   0.184
5. Indeksy i pułapka odległości marka–cecha: Rysunek 4
R
# Rysunek 4. Co naprawdę znaczy bliskość marki i cechy: indeks = obserwowane / oczekiwane × 100
# Korzysta z obiektów przepisów 1 i 4: N, wiersze, kolumny, marki, cechy, kol, motyw. Niczego nie losuje.
library(ggplot2)

E <- outer(rowSums(N), colSums(N)) / sum(N)       # liczebności oczekiwane przy braku związku
indeks <- 100 * N / E                             # 100 = marka ma tę cechę tak często, jak przeciętnie
round(indeks)

# Pułapka mapy symetrycznej: najbliższa cecha na mapie a cecha z najwyższym indeksem
odl <- as.matrix(dist(rbind(as.matrix(wiersze[1:6, c("x", "y")]), as.matrix(kolumny[, c("x", "y")]))))[1:6, 7:16]
dimnames(odl) <- list(marki, cechy)
porownanie <- data.frame(marka = marki,
                         najblizsza_na_mapie = cechy[apply(odl, 1, which.min)],
                         jej_indeks = round(indeks[cbind(1:6, apply(odl, 1, which.min))]),
                         najwyzszy_indeks = cechy[apply(indeks, 1, which.max)],
                         wartosc = round(apply(indeks, 1, max)))
print(porownanie, row.names = FALSE)
round(odl["Ziarnik", c("dla całej rodziny", "tani")], 3)

d4 <- expand.grid(marka = marki, cecha = cechy, stringsAsFactors = FALSE)
d4$indeks <- indeks[cbind(match(d4$marka, marki), match(d4$cecha, cechy))]
d4$marka <- factor(d4$marka, rev(marki)); d4$cecha <- factor(d4$cecha, cechy)
p4 <- ggplot(d4, aes(cecha, marka, fill = log2(indeks / 100))) +
  geom_tile(colour = "white", linewidth = 0.6) +
  geom_text(aes(label = round(indeks), fontface = ifelse(indeks >= 150, "bold", "plain")), size = 3.8) +
  scale_fill_gradient2(low = kol[["niebieski"]], mid = "white", high = kol[["cynober"]], midpoint = 0,
                       limits = c(-2, 2), oob = scales::squish, breaks = -2:2, labels = c("25", "50", "100", "200", "400"),
                       name = "indeks (skala logarytmiczna)") +
  labs(x = NULL, y = NULL, title = "Indeks: ile razy częściej niż przeciętnie cecha pasuje do marki",
       subtitle = "100 = tak jak w całej tabeli; pogrubione ≥ 150") +
  motyw + theme(axis.text.x = element_text(angle = 35, hjust = 1), panel.grid = element_blank(),
                legend.key.width = unit(1.4, "cm"))
p4   # zapis: ggsave("mapa-percepcji-indeksy.svg", p4, width = 10, height = 5.6)
Wynik w R
        smaczny tani zdrowy ekologiczny naturalny skład dobry do kawy
Avenko      109   79     83          72              85           107
Ziarnik      90  207     81          65              88            98
Verdo        75   29    155         245             190            58
Kremka      155   43     67          90              92           206
Bazik        87  140     90          98              89            52
Fitka        59   76    219          93              75            61
        nowoczesny dla całej rodziny łatwo dostępny wysoka jakość
Avenko          94                99            125           126
Ziarnik         61               116            107            42
Verdo           98                59             56           129
Kremka         150                63             74            75
Bazik           52               182             95            90
Fitka          263                33             79           123
   marka najblizsza_na_mapie jej_indeks  najwyzszy_indeks wartosc
  Avenko             smaczny        109     wysoka jakość     126
 Ziarnik   dla całej rodziny        116              tani     207
   Verdo         ekologiczny        245       ekologiczny     245
  Kremka       dobry do kawy        206     dobry do kawy     206
   Bazik   dla całej rodziny        182 dla całej rodziny     182
   Fitka              zdrowy        219        nowoczesny     263
dla całej rodziny              tani
            0.070             0.184
6. Biplot PCA na średnich ocenach: Rysunek 5
R
# Rysunek 5. Biplot PCA na średnich ocenach 1–7: surowe średnie i średnie po odjęciu poziomu marki
# Korzysta z obiektów przepisów 1 i 4: oceny, marki, cechy, wiersze, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(ggrepel)
library(patchwork)

M <- as.matrix(aggregate(oceny[, cechy], list(marka = oceny$marka), mean)[, -1])
rownames(M) <- sort(unique(oceny$marka)); M <- M[marki, ]
table(factor(oceny$marka, marki))                 # ile osób oceniło markę
round(cbind(M, srednia_marki = rowMeans(M)), 2)

ca_wsp <- as.matrix(wiersze[1:6, c("x", "y")])     # położenie marek z analizy korespondencji
pca_mapa <- function(X) {
  pc <- prcomp(X, scale. = TRUE)
  znak <- sign(diag(cor(pc$x[, 1:2], ca_wsp)))     # znak osi jest umowny – ustawiamy jak w CA
  list(pc = pc, punkty = sweep(pc$x[, 1:2], 2, pc$sdev[1:2] * znak, "/"),           # wyniki standaryzowane
       strzalki = sweep(pc$rotation[, 1:2], 2, pc$sdev[1:2] * znak, "*"))            # ładunki = korelacje
}
A <- pca_mapa(M)                                   # surowe średnie
B <- pca_mapa(M - rowMeans(M))                     # po odjęciu średniej marki (poziom „lubienia”)
round(rbind(A = summary(A$pc)$importance[2, 1:3], B = summary(B$pc)$importance[2, 1:3]), 3)
round(c(A_PC1_PC2 = summary(A$pc)$importance[3, 2], B_PC1_PC2 = summary(B$pc)$importance[3, 2]), 3)   # łącznie
round(c(r_PC1_ze_srednia_marki = cor(A$pc$x[, 1], rowMeans(M)),
        zgodnosc_odleglosci_z_CA_A = cor(dist(A$pc$x[, 1:2]), dist(ca_wsp)),
        zgodnosc_odleglosci_z_CA_B = cor(dist(B$pc$x[, 1:2]), dist(ca_wsp))), 3)

panel <- function(m, tytul) {
  pk <- data.frame(nazwa = marki, m$punkty, typ = "marka")
  st <- data.frame(nazwa = cechy, 1.6 * m$strzalki, typ = "cecha")     # strzałki wydłużone 1.6 raza
  imp <- 100 * summary(m$pc)$importance[2, 1:2]
  ggplot() +
    geom_hline(yintercept = 0, colour = "grey80") + geom_vline(xintercept = 0, colour = "grey80") +
    geom_segment(data = st, aes(0, 0, xend = PC1, yend = PC2), colour = kol[["cynober"]],
                 arrow = arrow(length = unit(0.18, "cm")), linewidth = 0.6) +
    geom_point(data = pk, aes(PC1, PC2), shape = 15, size = 3.2, colour = kol[["niebieski"]]) +
    geom_text_repel(data = rbind(pk, st), aes(PC1, PC2, label = nazwa, colour = typ, size = typ,
                                              fontface = ifelse(typ == "marka", "bold", "plain")),
                    seed = 626, box.padding = 0.3, min.segment.length = 0.3, max.overlaps = Inf, show.legend = FALSE) +
    scale_colour_manual(values = c(marka = kol[["niebieski"]], cecha = kol[["cynober"]])) +
    scale_size_manual(values = c(marka = 3.8, cecha = 3.2)) +
    coord_equal(xlim = c(-2.2, 2.2), ylim = c(-2.2, 2.2)) +
    labs(x = sprintf("PC1 (%.1f%%)", imp[1]), y = sprintf("PC2 (%.1f%%)", imp[2]), title = tytul) + motyw
}
p5 <- panel(A, "A. Średnie oceny 1–7") + panel(B, "B. Po odjęciu średniej marki") +
  plot_annotation(title = "Biplot PCA: marki (kwadraty) i cechy (strzałki – korelacje ze składowymi × 1.6)",
                  subtitle = sprintf("%d ocen marek od %d osób; w panelu A pierwsza składowa to głównie ogólna ocena marki",
                                     nrow(oceny), length(unique(oceny$osoba))), theme = motyw)
p5   # zapis: ggsave("mapa-percepcji-biplot-pca.svg", p5, width = 10, height = 6.8)
Wynik w R
 Avenko Ziarnik   Verdo  Kremka   Bazik   Fitka
    551     449     267     236     347     144
        smaczny tani zdrowy ekologiczny naturalny skład dobry do kawy
Avenko     5.28 4.72   4.77        4.43            4.79          5.20
Ziarnik    3.80 5.29   3.77        3.19            3.79          3.77
Verdo      4.20 3.24   5.21        5.80            5.63          4.47
Kremka     5.09 3.69   3.91        4.33            4.21          5.86
Bazik      3.63 4.49   3.53        3.51            3.53          3.33
Fitka      3.52 3.80   5.26        3.81            3.74          3.87
        nowoczesny dla całej rodziny łatwo dostępny wysoka jakość srednia_marki
Avenko        4.72              5.29           5.83          4.94          5.00
Ziarnik       3.12              4.18           4.45          2.90          3.83
Verdo         4.39              4.34           4.36          4.78          4.64
Kremka        5.13              4.21           4.44          4.19          4.51
Bazik         2.76              4.76           4.06          3.61          3.72
Fitka         5.10              2.93           3.87          4.36          4.03
    PC1   PC2   PC3
A 0.511 0.272 0.117
B 0.474 0.261 0.172
A_PC1_PC2 B_PC1_PC2
    0.783     0.735
    r_PC1_ze_srednia_marki zgodnosc_odleglosci_z_CA_A
                     0.946                      0.373
zgodnosc_odleglosci_z_CA_B
                     0.937
7. Bootstrap respondentów: Rysunek 6
R
# Rysunek 6. Jak pewne jest położenie marek? Bootstrap osób i rzutowanie na mapę (500 prób)
# Korzysta z obiektów przepisów 1 i 4: wskazania, r, wiersze, kolumny, marki, cechy, kol, motyw.
library(ggplot2)
library(ggrepel)

dane_marek <- wskazania[wskazania$marka %in% marki, ]
po_osobach <- split(seq_len(nrow(dane_marek)), dane_marek$osoba)   # losujemy całe osoby, nie pojedyncze wskazania
B <- 500
set.seed(626)
boot <- do.call(rbind, lapply(seq_len(B), function(b) {
  wiersze_b <- unlist(po_osobach[sample(length(po_osobach), replace = TRUE)], use.names = FALSE)
  d <- dane_marek[wiersze_b, ]
  Nb <- as.matrix(rowsum(d[, cechy], d$marka))[marki, ]
  prof <- Nb / rowSums(Nb)                         # profile marek z próby bootstrapowej
  xy <- prof %*% r$colcoord[, 1:2]                 # rzut na stałą mapę (współrzędne główne wierszy)
  data.frame(proba = b, marka = marki, x = xy[, 1], y = xy[, 2])
}))
# Rozrzut położenia marek: odchylenie standardowe współrzędnych w 500 próbach
rozrzut <- aggregate(cbind(x, y) ~ marka, boot, sd)
rozrzut <- rozrzut[match(marki, rozrzut$marka), ]
print(transform(rozrzut, x = round(x, 3), y = round(y, 3), zna = as.numeric(table(factor(dane_marek$marka, marki)))),
      row.names = FALSE)
boot$marka <- factor(boot$marka, marki)
pw <- transform(wiersze[1:6, ], marka = factor(nazwa, marki))
p6 <- ggplot() +
  geom_hline(yintercept = 0, colour = "grey80") + geom_vline(xintercept = 0, colour = "grey80") +
  geom_point(data = subset(boot, proba <= 100), aes(x, y), colour = kol[["niebieski"]], alpha = 0.2, size = 0.9) +
  stat_ellipse(data = boot, aes(x, y, group = marka), level = 0.95, colour = kol[["niebieski"]], linewidth = 0.7) +
  geom_point(data = kolumny, aes(x, y), shape = 17, colour = kol[["cynober"]], size = 2.6) +
  geom_text_repel(data = kolumny, aes(x, y, label = nazwa), colour = kol[["cynober"]], size = 3.4, seed = 626) +
  geom_point(data = pw, aes(x, y), shape = 15, size = 3.4, colour = kol[["ciemny"]]) +
  geom_label(data = pw, aes(x, y, label = nazwa), nudge_y = 0.05, size = 3.6, fontface = "bold",
             linewidth = 0, fill = "white", alpha = 0.85, colour = kol[["ciemny"]]) +
  coord_equal() +
  labs(x = "Wymiar 1", y = "Wymiar 2", title = "Niepewność mapy: 500 prób bootstrapowych osób",
       subtitle = "Kropki – marki w pierwszych 100 próbach rzutowane na tę samą mapę; elipsy – 95% z 500 prób") + motyw
p6   # zapis: ggsave("mapa-percepcji-bootstrap.svg", p6, width = 10, height = 7)
Wynik w R
   marka     x     y zna
  Avenko 0.014 0.015 919
 Ziarnik 0.024 0.021 709
   Verdo 0.023 0.023 467
  Kremka 0.023 0.028 395
   Bazik 0.028 0.023 560
   Fitka 0.039 0.034 266
8. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Sprawdzenie palety: odległość barw (ΔE w CIELAB) przy widzeniu typowym, deuteranopii i protanopii
library(colorspace)
pary <- list("niebieski – cynober (marki / cechy; Avenko / Verdo; indeks < 100 / > 100)" = c("#0072B2", "#D55E00"),
             "cynober – szary (Verdo / pozostałe marki na rysunku 2)" = c("#D55E00", "#999999"),
             "niebieski – szary (Avenko / pozostałe marki na rysunku 2)" = c("#0072B2", "#999999"),
             "cynober – ciemnoszary (cechy / punkt uzupełniający)" = c("#D55E00", "#333333"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                          widzenie_typowe
niebieski – cynober (marki / cechy; Avenko / Verdo; indeks < 100 / > 100)           114.6
cynober – szary (Verdo / pozostałe marki na rysunku 2)                               77.2
niebieski – szary (Avenko / pozostałe marki na rysunku 2)                            44.9
cynober – ciemnoszary (cechy / punkt uzupełniający)                                  83.4
czerwony – zielony (do unikania)                                                    121.7
                                                                          deuteranopia
niebieski – cynober (marki / cechy; Avenko / Verdo; indeks < 100 / > 100)        108.3
cynober – szary (Verdo / pozostałe marki na rysunku 2)                            62.9
niebieski – szary (Avenko / pozostałe marki na rysunku 2)                         48.9
cynober – ciemnoszary (cechy / punkt uzupełniający)                               72.7
czerwony – zielony (do unikania)                                                  21.1
                                                                          protanopia
niebieski – cynober (marki / cechy; Avenko / Verdo; indeks < 100 / > 100)       91.9
cynober – szary (Verdo / pozostałe marki na rysunku 2)                          56.0
niebieski – szary (Avenko / pozostałe marki na rysunku 2)                       40.6
cynober – ciemnoszary (cechy / punkt uzupełniający)                             59.9
czerwony – zielony (do unikania)                                                31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, test χ², PCA – pakiety base i stats; analiza korespondencji – pakiet ca). Rysunki wykonano w ggplot2 (etykiety – ggrepel, panele – patchwork, skala kolorów – scales); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ca (wersja 0.71.1): Nenadić, O., & Greenacre, M. (2007). Correspondence analysis in R, with two- and three-dimensional graphics: The ca package. Journal of Statistical Software, 20(3), 1–13. https://doi.org/10.18637/jss.v020.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Co to jest mapa percepcji marek?
To wykres, na którym marki i ich cechy są punktami w dwóch wymiarach: marki postrzegane podobnie leżą blisko siebie, a kierunki osi pokazują, co różnicuje rynek (np. „eko i zdrowie” wobec „ceny i rodziny”). Najczęściej powstaje z analizy korespondencji tabeli marka × cecha albo z PCA średnich ocen marek.
Analiza korespondencji czy PCA do mapy percepcji?
Analizę korespondencji stosuj do liczby wskazań „cecha pasuje do marki” – porównuje profile, więc usuwa przewagę znanych marek. PCA stosuj do średnich ocen na skali, ale sprawdź, czy pierwsza składowa nie jest po prostu ogólną oceną marki. W przykładzie korelacja PC1 ze średnią oceną marki wyniosła .946; po odjęciu średniej marki obie mapy dały ten sam układ (korelacja odległości .937).
Czy na mapie analizy korespondencji można mierzyć odległość marki od cechy?
Na mapie symetrycznej nie. Wolno porównywać marki z markami i cechy z cechami oraz czytać kierunki od środka mapy. Siłę związku marki z cechą sprawdź indeksem (obserwowane / oczekiwane × 100). W przykładzie marka Ziarnik leżała najbliżej cechy „dla całej rodziny” (indeks 116), choć najsilniej wyróżniała ją cecha „tani” (indeks 207).
Dlaczego duża marka leży w środku mapy percepcji?
Bo środek mapy to profil przeciętny, a duża marka z dużą masą sama go w dużej mierze tworzy. W przykładzie lider miał 37.1% wszystkich wskazań i indeksy od 72 do 126. Położenie blisko środka znaczy „profil zbliżony do przeciętnego”, a nie „brak wizerunku”.
Jak sprawdzić, czy mapa percepcji jest stabilna?
Użyj bootstrapu na poziomie respondentów: losuj ze zwracaniem całe osoby, licz tabelę od nowa i rzutuj profile marek na mapę jako punkty uzupełniające. Elipsy obejmujące 95% prób pokazują niepewność. W przykładzie rozrzut położenia małej marki (266 osób) był prawie trzy razy większy niż lidera (919 osób).
Powiązane hasła
Przeczytaj też
Analiza korespondencji krok po kroku
Inercja jako χ²/n, profile, wkłady i cos², mapa symetryczna a asymetryczna, mała kategoria i drugi wymiar, MCA i opis APA – na jednym przykładzie w R.
Czytaj →PoradnikOceny gwiazdkowe i ranking produktów
Sklep z artykułami kuchennymi: rozkład J, wykres lejkowy, przedział Wilsona, średnia wygładzona i symulacja 1000 sklepów z kodem R.
Czytaj →PoradnikNiezmienność skali marki w trzech krajach
Zaufanie do marki w Polsce, Czechach i na Słowacji: wielogrupowa CFA, częściowa niezmienność, średnie latentne kontra sumy i symulacja – pięć rysunków z R.
Czytaj →PoradnikStatystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →Badasz wizerunek marek w pracy z marketingu?
Pomożemy zaplanować pytania o cechy marek, policzyć analizę korespondencji lub PCA, sprawdzić stabilność mapy i opisać wyniki z rysunkami – tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Gabriel, K. R. (1971). The biplot graphic display of matrices with application to principal component analysis. Biometrika, 58(3), 453–467. https://doi.org/10.1093/biomet/58.3.453
- Greenacre, M., & Hastie, T. (1987). The geometric interpretation of correspondence analysis. Journal of the American Statistical Association, 82(398), 437–447. https://doi.org/10.1080/01621459.1987.10478446
- Hauser, J. R., & Koppelman, F. S. (1979). Alternative perceptual mapping techniques: Relative accuracy and usefulness. Journal of Marketing Research, 16(4), 495–506. https://doi.org/10.1177/002224377901600406
- Hoffman, D. L., & Franke, G. R. (1986). Correspondence analysis: Graphical representation of categorical data in marketing research. Journal of Marketing Research, 23(3), 213–227. https://doi.org/10.1177/002224378602300302
- Jolliffe, I. T., & Cadima, J. (2016). Principal component analysis: A review and recent developments. Philosophical Transactions of the Royal Society A: Mathematical, Physical and Engineering Sciences, 374(2065), Article 20150202. https://doi.org/10.1098/rsta.2015.0202 ● Otwarty dostęp: pełny tekst
- Nenadić, O., & Greenacre, M. (2007). Correspondence analysis in R, with two- and three-dimensional graphics: The ca package. Journal of Statistical Software, 20(3), 1–13. https://doi.org/10.18637/jss.v020.i03 ● Otwarty dostęp
- Nisbett, R. E., & Wilson, T. D. (1977). The halo effect: Evidence for unconscious alteration of judgments. Journal of Personality and Social Psychology, 35(4), 250–256. https://doi.org/10.1037/0022-3514.35.4.250
Cytowania BibTeX
@article{gabriel1971biplot, author={Gabriel, K. R.}, title={{The biplot graphic display of matrices with application to principal component analysis}}, journal={Biometrika}, year={1971}, volume={58}, number={3}, pages={453--467}, doi={10.1093/biomet/58.3.453}}@article{greenacre1987geometric, author={Greenacre, Michael and Hastie, Trevor}, title={{The geometric interpretation of correspondence analysis}}, journal={Journal of the American Statistical Association}, year={1987}, volume={82}, number={398}, pages={437--447}, doi={10.1080/01621459.1987.10478446}}@article{hauser1979alternative, author={Hauser, John R. and Koppelman, Frank S.}, title={{Alternative perceptual mapping techniques: Relative accuracy and usefulness}}, journal={Journal of Marketing Research}, year={1979}, volume={16}, number={4}, pages={495--506}, doi={10.1177/002224377901600406}}@article{hoffman1986correspondence, author={Hoffman, Donna L. and Franke, George R.}, title={{Correspondence analysis: Graphical representation of categorical data in marketing research}}, journal={Journal of Marketing Research}, year={1986}, volume={23}, number={3}, pages={213--227}, doi={10.1177/002224378602300302}}@article{jolliffe2016principal, author={Jolliffe, Ian T. and Cadima, Jorge}, title={{Principal component analysis: A review and recent developments}}, journal={Philosophical Transactions of the Royal Society A: Mathematical, Physical and Engineering Sciences}, year={2016}, volume={374}, number={2065}, eid={20150202}, doi={10.1098/rsta.2015.0202}}@article{nenadic2007correspondence, author={Nenadić, Oleg and Greenacre, Michael}, title={{Correspondence analysis in R, with two- and three-dimensional graphics: The ca package}}, journal={Journal of Statistical Software}, year={2007}, volume={20}, number={3}, pages={1--13}, doi={10.18637/jss.v020.i03}}@article{nisbett1977halo, author={Nisbett, Richard E. and Wilson, Timothy D.}, title={{The halo effect: Evidence for unconscious alteration of judgments}}, journal={Journal of Personality and Social Psychology}, year={1977}, volume={35}, number={4}, pages={250--256}, doi={10.1037/0022-3514.35.4.250}}