Co to jest biplot?
Biplot to wykres, który na jednym rysunku pokazuje obserwacje (punkty) i zmienne (strzałki) z tej samej macierzy danych. Gabriel (1971) pokazał, że każdą macierz rzędu 2 można tak przedstawić, by każdy jej element był iloczynem skalarnym wektora wiersza i wektora kolumny; macierz o większej liczbie wymiarów przedstawia się przez jej najlepsze przybliżenie rzędu 2. W praktyce są to dwie pierwsze składowe analizy głównych składowych (PCA) – nowych, nieskorelowanych zmiennych kolejno maksymalizujących wariancję (Jolliffe i Cadima, 2016). Przedrostek „bi” oznacza dwa rodzaje elementów – wiersze i kolumny – a nie dwa wymiary.
Jak czytać biplot
- Rzut punktu na strzałkę przybliża standaryzowaną wartość zmiennej u danej obserwacji: punkt daleko w kierunku strzałki to wynik wysoki.
- Kąt między strzałkami odpowiada korelacji: kąt ostry – dodatnia, prosty – bliska zera, rozwarty – ujemna.
- Długość strzałki mówi, jak dobrze zmienna mieści się na dwóch osiach. Krótka strzałka oznacza, że jej zmienność leży głównie w dalszych składowych.
- Odległość między punktami przybliża odległość między obserwacjami w pełnych danych – ale tylko w formie odległościowej.
Przykład
Wbudowany zbiór USArrests zawiera dla 50 stanów USA liczbę aresztowań za zabójstwa, napaści i gwałty na 100 tys. mieszkańców oraz odsetek ludności miejskiej. Zmienne mają różne jednostki, więc przed PCA poddano je standaryzacji. Pierwsza składowa wyjaśnia 62.0% wariancji, druga 24.7%, razem 86.8%. Trzy wskaźniki przestępczości korelują z pierwszą składową na poziomie od .84 do .92 – to ich ładunki – a odsetek ludności miejskiej z drugą (−.87). Znak składowych jest dowolny; odwrócono go, by strzałki przestępczości wskazywały w prawo.
Na rysunku
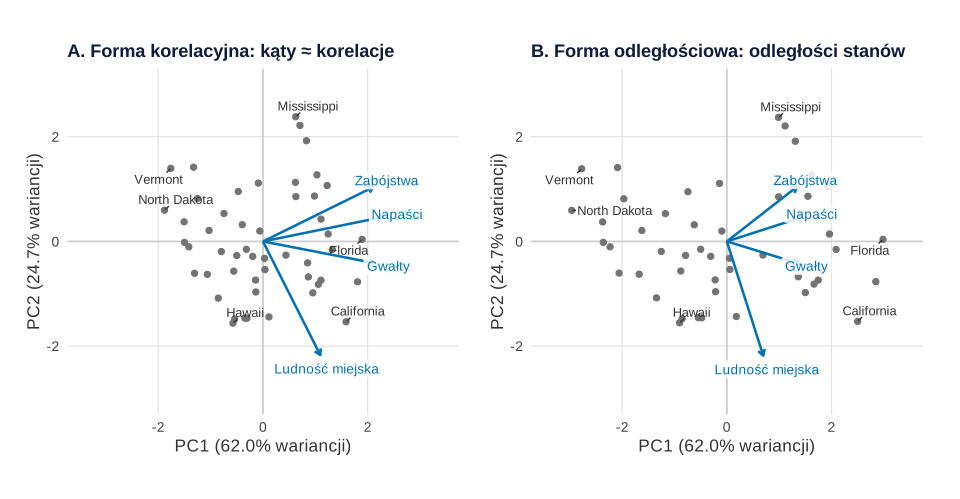
USArrests).Co widać. W obu panelach strzałki zabójstw, napaści i gwałtów leżą blisko siebie, a strzałka ludności miejskiej jest do nich niemal prostopadła. Stany po prawej (Florida, California) mają dużo aresztowań, po lewej (Vermont, North Dakota) – mało; w dole leżą stany silnie zurbanizowane. Formy różnią się skalowaniem. W formie korelacyjnej (A) punkty mają jednakowy rozrzut na obu osiach, a strzałki to korelacje zmiennych ze składowymi: dla zabójstw i ludności miejskiej cosinus kąta wynosi .01 przy korelacji .07. W formie odległościowej (B) punkty zachowują rozrzut składowych, dlatego ich odległości lepiej oddają odległości w czterech wymiarach – korelacja obu zestawów odległości to .969 wobec .915 w panelu A.
Na co uważać. Kąt to tylko przybliżenie. Strzałki zabójstw i napaści są niemal równoległe (cosinus .97), a korelacja wynosi .80; iloczyn skalarny strzałek (.85), który uwzględnia ich długość, jest bliżej. Biplot pokazuje 86.8% wariancji – reszty nie widać. Gabriel (2002) wykazał, że żaden pojedynczy wykres nie odwzorowuje optymalnie jednocześnie zmiennych i odległości między obiektami, choć różne biploty zwykle zachowują dużą część optymalnego dopasowania.
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Brak informacji o formie. Programy stosują różne skalowania punktów i strzałek. Podaj, czy kąty, czy odległości mają być odczytywane.
- Odległości w formie korelacyjnej. W panelu A druga oś jest rozciągnięta względem pierwszej, więc bliskość stanów bywa myląca.
- Brak standaryzacji. Zmienne o dużej wariancji zdominują składowe i strzałki; przy różnych jednostkach PCA licz na korelacjach.
- Biplot jako analiza czynnikowa. Strzałki pokazują ładunki składowych, nie czynników wspólnych – różnicę wyjaśnia wpis PCA czy analiza czynnikowa?
Biplot powstaje także w analizie korespondencji tabel krzyżowych; kiedy jej mapa jest biplotem, wyjaśnia wpis Analiza korespondencji krok po kroku.
Biplot w R
Kod liczy PCA na standaryzowanych danych, buduje współrzędne punktów i strzałek w obu formach, porównuje kąty z korelacjami i odległości na wykresie z odległościami w czterech wymiarach, a na końcu rysuje rysunek 1. Szybki biplot daje też bazowa funkcja biplot(pca, scale = 1) (forma korelacyjna) albo scale = 0 (forma odległościowa). Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne. Kod nie losuje (ziarno w geom_text_repel() ustala tylko położenie podpisów).
Rysunek 1: biplot w formie korelacyjnej i odległościowej
R
# Biplot PCA w dwóch formach – wbudowany zbiór USArrests (50 stanów USA, 4 zmienne)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(ggrepel)})
dane <- USArrests
names(dane) <- c("Zabójstwa", "Napaści", "Ludność miejska", "Gwałty")
X <- scale(dane)                                   # zmienne w różnych jednostkach – standaryzacja
pca <- prcomp(X)
pca$rotation <- -pca$rotation; pca$x <- -pca$x     # znak składowych jest dowolny; odwracamy dla czytelności
round(100 * pca$sdev^2 / sum(pca$sdev^2), 1)       # % wariancji wyjaśnianej przez składowe
round(100 * cumsum(pca$sdev^2) / sum(pca$sdev^2), 1)   # % skumulowany
s <- pca$sdev[1:2]
# Forma korelacyjna (biplot(pca, scale = 1)): punkty – wyniki o wariancji 1, strzałki – ładunki
pkt_A <- sweep(pca$x[, 1:2], 2, s, "/")
str_A <- sweep(pca$rotation[, 1:2], 2, s, "*")     # korelacje zmiennych z PC1 i PC2
# Forma odległościowa (biplot(pca, scale = 0)): punkty – wyniki składowych, strzałki – wektory własne
pkt_B <- pca$x[, 1:2]
str_B <- pca$rotation[, 1:2]
round(str_A, 2)
round(sqrt(rowSums(str_A^2)), 2)                   # długość strzałki ≈ jak dobrze zmienna jest odwzorowana
kat <- function(a, b) sum(a * b) / sqrt(sum(a^2) * sum(b^2))   # cosinus kąta między strzałkami
round(rbind(Zab_Nap = c(r = cor(X[, 1], X[, 2]), iloczyn = sum(str_A[1, ] * str_A[2, ]), cos = kat(str_A[1, ], str_A[2, ])),
            Zab_Lud = c(r = cor(X[, 1], X[, 3]), iloczyn = sum(str_A[1, ] * str_A[3, ]), cos = kat(str_A[1, ], str_A[3, ]))), 2)
d_pelna <- dist(X)                                 # odległości między stanami w 4 wymiarach
round(c(forma_A = cor(d_pelna, dist(pkt_A)), forma_B = cor(d_pelna, dist(pkt_B))), 3)
# Rysunek: strzałki wydłużone 2.5 raza (kąty i proporcje bez zmian)
k <- 2.5
stany <- c("Florida", "North Dakota", "Vermont", "California", "Mississippi", "Hawaii")
kol <- c(strzalka = "#0072B2", punkt = "grey45")   # Okabe–Ito; zmienne = strzałki, stany = punkty
rysuj <- function(pkt, strz, tytul, os) {
  p <- data.frame(pkt, stan = rownames(pkt)); v <- data.frame(strz * k, zm = rownames(strz))
  ggplot() + geom_hline(yintercept = 0, colour = "grey80") + geom_vline(xintercept = 0, colour = "grey80") +
    geom_point(data = p, aes(PC1, PC2), colour = kol[["punkt"]], size = 1.8) +
    geom_text_repel(data = subset(p, stan %in% stany), aes(PC1, PC2, label = stan), size = 3.4,
                    colour = "grey20", seed = 745, min.segment.length = 0) +
    geom_segment(data = v, aes(0, 0, xend = PC1, yend = PC2), colour = kol[["strzalka"]], linewidth = 0.9,
                 arrow = arrow(length = unit(0.18, "cm"))) +
    geom_label(data = v, aes(PC1 * 1.12, PC2 * 1.12, label = zm), colour = kol[["strzalka"]], size = 3.6,
               linewidth = 0, fill = "white", alpha = 0.85) +
    coord_equal(xlim = c(-3.4, 3.4), ylim = c(-3, 3)) +
    labs(title = tytul, x = os[1], y = os[2])
}
osie <- sprintf("PC%d (%.1f%% wariancji)", 1:2, 100 * pca$sdev[1:2]^2 / sum(pca$sdev^2))
p1 <- (rysuj(pkt_A, str_A, "A. Forma korelacyjna: kąty ≈ korelacje", osie) +
       rysuj(pkt_B, str_B, "B. Forma odległościowa: odległości stanów", osie)) &
  theme_minimal(base_size = 13) & theme(panel.grid.minor = element_blank())
p1
Wynik w R
[1] 62.0 24.7  8.9  4.3
[1]  62.0  86.8  95.7 100.0
                 PC1   PC2
Zabójstwa       0.84  0.42
Napaści         0.92  0.19
Ludność miejska 0.44 -0.87
Gwałty          0.86 -0.17
      Zabójstwa         Napaści Ludność miejska          Gwałty
           0.94            0.94            0.97            0.87
           r iloczyn  cos
Zab_Nap 0.80    0.85 0.97
Zab_Lud 0.07    0.01 0.01
forma_A forma_B
  0.915   0.969
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe scale(), prcomp(), dist(); rysunek 1 – pakiety ggplot2, patchwork i ggrepel). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
Najczęstsze pytania
Co oznacza kąt między strzałkami na biplocie?
W formie korelacyjnej kąt przybliża korelację zmiennych: kąt ostry to korelacja dodatnia, prosty – bliska zera, rozwarty – ujemna. Przybliżenie jest dobre tylko dla długich strzałek, czyli zmiennych dobrze odwzorowanych przez dwie składowe.
Czym biplot różni się od wykresu ładunków?
Wykres ładunków pokazuje same zmienne. Biplot dokłada na tej samej płaszczyźnie obserwacje, więc można odczytać, które z nich mają wysokie wartości których zmiennych.
Jak zrobić biplot PCA w R?
Najprościej biplot(prcomp(dane, scale. = TRUE)); argument scale = 1 daje formę korelacyjną, scale = 0 – odległościową. Większą kontrolę nad wyglądem daje ręczne narysowanie wyników i ładunków w ggplot2.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
PCA czy analiza czynnikowa?
Kiedy redukcja danych, a kiedy model konstruktu: tabela „kiedy która” i porównanie PCA z EFA na tych samych danych w R – ładunki, korelacje i wyniki osób.
Czytaj →PoradnikAnaliza korespondencji krok po kroku
Inercja jako χ²/n, profile, wkłady i cos², mapa symetryczna a asymetryczna, mała kategoria i drugi wymiar, MCA i opis APA – na jednym przykładzie w R.
Czytaj →PoradnikAnaliza czynnikowa na wykresie
Osypisko z analizą równoległą, mapa ładunków, varimax vs oblimin, korelacje czynników i h² – pięć rysunków z kodem R i symulacją Monte Carlo.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Gabriel, K. R. (1971). The biplot graphic display of matrices with application to principal component analysis. Biometrika, 58(3), 453–467. https://doi.org/10.1093/biomet/58.3.453
- Gabriel, K. R. (2002). Goodness of fit of biplots and correspondence analysis. Biometrika, 89(2), 423–436. https://doi.org/10.1093/biomet/89.2.423
- Jolliffe, I. T., & Cadima, J. (2016). Principal component analysis: A review and recent developments. Philosophical Transactions of the Royal Society A: Mathematical, Physical and Engineering Sciences, 374(2065), Article 20150202. https://doi.org/10.1098/rsta.2015.0202 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{gabriel1971biplot, author={Gabriel, K. R.}, title={{The biplot graphic display of matrices with application to principal component analysis}}, journal={Biometrika}, year={1971}, volume={58}, number={3}, pages={453--467}, doi={10.1093/biomet/58.3.453}}@article{gabriel2002goodness, author={Gabriel, K. Ruben}, title={{Goodness of fit of biplots and correspondence analysis}}, journal={Biometrika}, year={2002}, volume={89}, number={2}, pages={423--436}, doi={10.1093/biomet/89.2.423}}@article{jolliffe2016principal, author={Jolliffe, Ian T. and Cadima, Jorge}, title={{Principal component analysis: A review and recent developments}}, journal={Philosophical Transactions of the Royal Society A: Mathematical, Physical and Engineering Sciences}, year={2016}, volume={374}, number={2065}, eid={20150202}, doi={10.1098/rsta.2015.0202}}