Kiedy analiza korespondencji w SPSS
Analiza korespondencji zamienia tabelę krzyżową dwóch zmiennych jakościowych w mapę, na której kategorie wierszy i kolumn są punktami. Teorię – profile, masy, inercję, wkłady i to, co wolno odczytać z mapy – omawia wpis analiza korespondencji krok po kroku z przykładem w R. Tu zajmujemy się tylko SPSS. Ogólne zasady czytania wydruku są we wpisie jak czytać wyniki z SPSS.
Analiza korespondencji opisuje związek. Nie zastępuje testu chi-kwadrat niezależności, który w SPSS liczysz procedurą Crosstabs (wpis chi-kwadrat w SPSS). Mapa przydaje się, gdy związek istnieje, a tabela jest za duża na opis samymi odsetkami.
Ścieżki menu, nazwy okien, opcji i tabel sprawdziliśmy w dokumentacji IBM SPSS Statistics 32 (IBM Corp., b.d.-a, b.d.-b, b.d.-c) i podajemy je po angielsku. Polska dokumentacja podaje ścieżkę Analiza → Redukcja wymiarów → Analiza korespondencji (IBM Corp., b.d.-a). Etykiety w polskim interfejsie mogą brzmieć inaczej. Procedura wymaga opcji Categories (IBM Corp., b.d.-a).
Przykład i pliki do pobrania
Dane są fikcyjne. 800 osób w pięciu grupach wieku (18–24, 25–34, 35–49, 50–64, 65+) wskazało główne źródło informacji o zdrowiu: lekarza lub farmaceutę, wyszukiwarkę i portale, media społecznościowe, rodzinę i znajomych albo telewizję i prasę.
Pobierz plik .sav z etykietami zmiennych i wartości albo ten sam zbiór w pliku CSV (format opisuje hasło plik .sav). Jeden wiersz to jedna osoba. Zmienne wiek i zrodlo mają kody 1–5 z etykietami.
- Kody całkowite. SPSS bierze kategorie z zakresu podanego w Define Range. Wartości ułamkowe obcina, a kategorie spoza zakresu pomija (IBM Corp., b.d.-a). Tekst przekoduj na liczby (wpis przygotowanie danych w SPSS).
- Zmienne nominalne. Procedura traktuje obie zmienne jak skalę nominalną (IBM Corp., b.d.-a).
- Masz tylko gotową tabelę liczebności? Wpisz każdą komórkę jako wiersz (kod wiersza, kod kolumny, liczba osób) i zważ przypadki liczbą osób (Data → Weight Cases), jak w studium przypadku IBM (IBM Corp., b.d.-b). Ważenie opisuje wpis o chi-kwadrat w SPSS.
Okna procedury krok po kroku
- Analyze → Dimension Reduction → Correspondence Analysis (IBM Corp., b.d.-a).
- Wiersze i kolumny. Zmienną
wiekprzenieś do pola wierszy (Row), azrodlodo pola kolumn (Column). Dla każdej kliknij Define Range, wpisz minimum 1 i maksimum 5, kliknij Update i Continue. Tu możesz też oznaczyć kategorię jako uzupełniającą (Supplementary): nie wpływa na wymiary, ale pojawia się na mapie (IBM Corp., b.d.-a). - Model. Dimensions in solution: zostaw 2. Maksimum zależy od liczby aktywnych kategorii wierszy i kolumn. Gdy wpiszesz więcej, SPSS użyje maksimum (IBM Corp., b.d.-a). W tabeli 5 × 5 bez ograniczeń są najwyżej 4 wymiary. Distance Measure: Chi-square. Standardization Method: Row and column means are removed. Obie opcje są wymagane w standardowej analizie korespondencji, a wariant euklidesowy i pozostałe standaryzacje to odmiany metody (IBM Corp., b.d.-a). Normalization Method – o wyborze piszemy w następnej części. Na początek zostaw Symmetrical, ustawienie domyślne (IBM Corp., b.d.-c).
- Statistics. Domyślny wydruk to tabela korespondencji i przegląd punktów wierszy i kolumn (IBM Corp., b.d.-c), czyli opcje Correspondence table, Overview of row points i Overview of column points. Dodaj Row profiles i Column profiles, czyli odsetki w wierszach i kolumnach.
- Plots. W grupie Scatterplots zaznacz Biplot, czyli wspólną mapę wierszy i kolumn. Biplot jest niedostępny przy normalizacji Principal. W Plot Dimensions możesz ograniczyć wykres do wymiarów 1 i 2 (IBM Corp., b.d.-a).
- Kliknij OK albo Paste, żeby zapisać składnię.
Wyniki pokazujemy w tabelach o układzie tabel SPSS. Liczby policzono w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS. Nazwy i zawartość tabel pochodzą z dokumentacji (IBM Corp., b.d.-a, b.d.-b, b.d.-c), a nagłówki kolumn odtworzyliśmy z typowego wydruku. Pogrubiono liczby do pracy. Znak wymiaru jest umowny: w Twoim wydruku cała kolumna wyników może mieć przeciwne znaki.
Którą normalizację wybrać
Normalizacja zmienia tylko wyniki punktów i statystyki ufności. Wkłady i profile pozostają takie same (IBM Corp., b.d.-c), podobnie inercje. Decyduje o tym, co wolno odczytać z mapy.
| SPSS | Wyniki wierszy i kolumn | Co porównujesz | Mapa w ca |
|---|---|---|---|
| Symmetrical (domyślna) | współrzędne standardowe × √wartości osobliwej, po równo dla wierszy i kolumn | wiersze z kolumnami (biplot) | map = "symbiplot" |
| Principal | obie zmienne we współrzędnych głównych | wiersze między sobą i kolumny między sobą; biplot niedostępny | map = "symmetric" (domyślna w ca) |
| Row principal | wiersze główne, kolumny standardowe | wiersze między sobą; wiersze to średnie ważone kolumn | map = "rowprincipal" |
| Column principal | kolumny główne, wiersze standardowe | kolumny między sobą | map = "colprincipal" |
| Custom | wartość od −1 do 1: 1 = row principal, 0 = symmetrical, −1 = column principal | biploty „na miarę” | – |
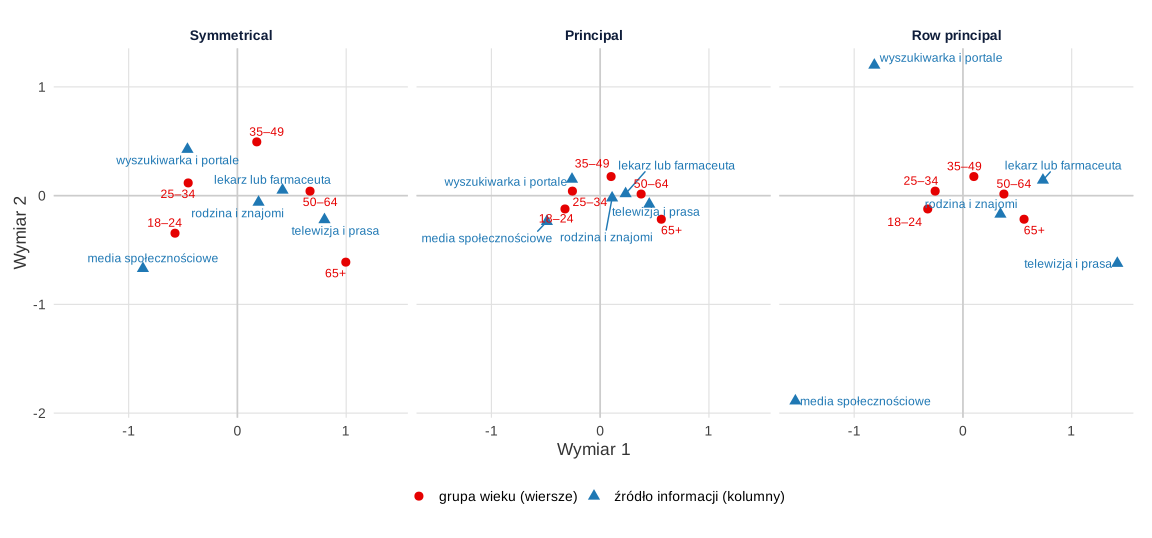
Pułapka nazw: „symetryczna” w SPSS to nie to samo co mapa symetryczna w ca. Mapa symetryczna w ca rysuje wiersze i kolumny we współrzędnych głównych, czyli odpowiada opcji Principal w SPSS. W naszym przykładzie wynik grupy 18–24 na wymiarze 1 to −0.574 przy Symmetrical, −0.324 przy Principal i −1.017 przy Column principal. Sprawdziliśmy też opis z dokumentacji: wynik symetryczny wiersza to średnia ważona wyników kolumn podzielona przez wartość osobliwą (IBM Corp., b.d.-c). Dla grupy 18–24 obie drogi dają −0.574.
Jak wybrać? Gdy pytasz o związek wierszy z kolumnami, zostaw Symmetrical i biplot. Studium przypadku IBM opisuje tę normalizację jako zwykle preferowaną dla biplotów (IBM Corp., b.d.-b). Gdy porównujesz głównie kategorie jednej zmiennej, np. które grupy wieku mają podobne profile, wybierz Row principal: odległości między punktami wierszy przybliżają wtedy odległości chi-kwadrat (IBM Corp., b.d.-b). Taka mapa asymetryczna jest biplotem w ścisłym sensie (Greenacre, 1993). Na rysunku 1 układ punktów jest podobny we wszystkich normalizacjach, zmienia się głównie skala chmur. Gabriel (2002) pokazał, że biplot symetryczny i mapa ze współrzędnymi głównymi zwykle prowadzą do tych samych wniosków. Wybór uzasadnij pytaniem badawczym i podaj w pracy.
Krok 1: Correspondence Table i Summary
Pierwsza tabela to tabela krzyżowa z sumami brzegowymi (IBM Corp., b.d.-c), a profile wierszy i kolumn to te same liczby w procentach.
| wiek | lekarz lub farmaceuta | wyszukiwarka i portale | media społecznościowe | rodzina i znajomi | telewizja i prasa | Active Margin |
|---|---|---|---|---|---|---|
| 18–24 | 38 | 66 | 49 | 28 | 19 | 200 |
| 25–34 | 39 | 75 | 37 | 29 | 20 | 200 |
| 35–49 | 51 | 59 | 13 | 30 | 27 | 180 |
| 50–64 | 43 | 31 | 8 | 22 | 36 | 140 |
| 65+ | 28 | 6 | 6 | 17 | 23 | 80 |
| Active Margin | 199 | 237 | 113 | 126 | 125 | 800 |
Druga tabela, Summary, pojawia się zawsze (IBM Corp., b.d.-c). Dla każdego wymiaru podaje wartość osobliwą, inercję i odsetek wyjaśnionej inercji. Zawiera też statystykę chi-kwadrat z istotnością (IBM Corp., b.d.-b), która dotyczy całej tabeli, dlatego wpisaliśmy ją w wierszu Total. SPSS dodaje jeszcze kolumny statystyk ufności dla wartości osobliwych (IBM Corp., b.d.-c). Tu je pomijamy.
| Dimension | Singular Value | Inertia | Chi Square | Sig. | Proportion of Inertia: Accounted for | Proportion of Inertia: Cumulative |
|---|---|---|---|---|---|---|
| 1 | .318 | .101 | .850 | .850 | ||
| 2 | .126 | .016 | .133 | .983 | ||
| 3 | .043 | .002 | .015 | .999 | ||
| 4 | .013 | .000 | .001 | 1.000 | ||
| Total | .119 | 95.182 | < .001 | 1.000 | 1.000 |
Sprawdź najpierw wiersz Total. Inercja całkowita to χ² podzielone przez liczebność: 95.182 / 800 = 0.119. Statystyka χ² ma (5 − 1)(5 − 1) = 16 stopni swobody, p < .001, więc związek istnieje. Siłę związku opisuje V Craméra = .17. SPSS wyświetla bardzo małe p jako „.000”. W pracy zapisz p < .001.
Potem kolumna Accounted for. Pierwszy wymiar wyjaśnia 85.0% inercji, drugi 13.3%, razem 98.3%. Studium przypadku IBM wybiera liczbę wymiarów tak samo – według skumulowanej proporcji inercji (IBM Corp., b.d.-b). Te procenty nie są testem istotności wymiarów. Drugi wymiar z 13% inercji opisuj ostrożniej niż pierwszy.
Krok 2: Overview Row Points i Overview Column Points
Tabele przeglądu punktów podają dla każdej kategorii (IBM Corp., b.d.-a):
- Mass – udział kategorii w próbie (np. 200 / 800 = .250).
- Score in Dimension – współrzędne punktu na mapie w wybranej normalizacji.
- Inertia – udział kategorii w inercji całkowitej. Suma w wierszu Active Total to .119.
- Of Point to Inertia of Dimension – ile wymiar „zawdzięcza” punktowi. W kolumnie sumuje się do 1. Przy pięciu kategoriach średni wkład to .200, więc wyższe wartości wskazują punkty, które tworzą wymiar.
- Of Dimension to Inertia of Point – jaką część zróżnicowania punktu wyjaśnia wymiar (w literaturze: cos², korelacja kwadratowa). Kolumna Total to jakość odwzorowania punktu na mapie.
| wiek | Mass | Score in Dimension | Inertia | Of Point to Inertia of Dimension | Of Dimension to Inertia of Point | ||||
|---|---|---|---|---|---|---|---|---|---|
| 1 | 2 | 1 | 2 | 1 | 2 | Total | |||
| 18–24 | .250 | −.574 | −.346 | .030 | .259 | .237 | .873 | .125 | .999 |
| 25–34 | .250 | −.453 | .117 | .017 | .161 | .027 | .967 | .025 | .993 |
| 35–49 | .225 | .178 | .494 | .010 | .022 | .436 | .236 | .721 | .957 |
| 50–64 | .175 | .668 | .041 | .026 | .245 | .002 | .959 | .001 | .961 |
| 65+ | .100 | .997 | −.612 | .037 | .312 | .297 | .861 | .128 | .989 |
| Active Total | 1.000 | .119 | 1.000 | 1.000 | |||||
| zrodlo | Mass | Score in Dimension | Inertia | Of Point to Inertia of Dimension | Of Dimension to Inertia of Point | ||||
|---|---|---|---|---|---|---|---|---|---|
| 1 | 2 | 1 | 2 | 1 | 2 | Total | |||
| lekarz lub farmaceuta | .249 | .415 | .050 | .014 | .135 | .005 | .974 | .006 | .979 |
| wyszukiwarka i portale | .296 | −.459 | .426 | .027 | .197 | .426 | .743 | .252 | .995 |
| media społecznościowe | .141 | −.869 | −.670 | .042 | .335 | .503 | .809 | .191 | 1.000 |
| rodzina i znajomi | .158 | .194 | −.061 | .003 | .019 | .005 | .681 | .026 | .708 |
| telewizja i prasa | .156 | .800 | −.221 | .034 | .315 | .061 | .949 | .029 | .978 |
| Active Total | 1.000 | .119 | 1.000 | 1.000 | |||||
Wymiar 1 tworzą najmłodsi i najstarsi. Największe wkłady mają w nim grupy 65+ (.312), 18–24 (.259) i 50–64 (.245) oraz media społecznościowe (.335) i telewizja z prasą (.315). Po ujemnej stronie leżą osoby do 34. roku życia, media społecznościowe i wyszukiwarki. Po dodatniej – osoby od 50 lat, telewizja i prasa oraz lekarz lub farmaceuta. To gradient „źródła cyfrowe – źródła tradycyjne”. Profile to potwierdzają: media społecznościowe wskazało 24.5% osób w wieku 18–24 i 7.5% osób 65+.
Wymiar 2 zależy głównie od grupy 35–49 (wkład .436) oraz od przeciwstawienia wyszukiwarek (.426) mediom społecznościowym (.503). Na mapie grupy wieku układają się w łuk: 18–24 i 65+ na dole, 35–49 na górze. Taki łuk często towarzyszy jednemu silnemu gradientowi. Dlatego drugi wymiar (13.3%) opisz krótko i bez osobnej teorii.
Zwróć uwagę na rodzinę i znajomych. Ma najmniejszą inercję (.003), a jakość odwzorowania tylko .708. Jej profil prawie nie różni się od średniego, więc punkt leży blisko środka mapy. Nie dopisuj mu znaczenia. Odwrotnie z kategoriami o małej masie: rzadka kategoria bywa daleko od środka, choć opiera się na kilku osobach. Połącz ją z sąsiednią albo oznacz jako uzupełniającą.
Krok 3: biplot – co wolno odczytać
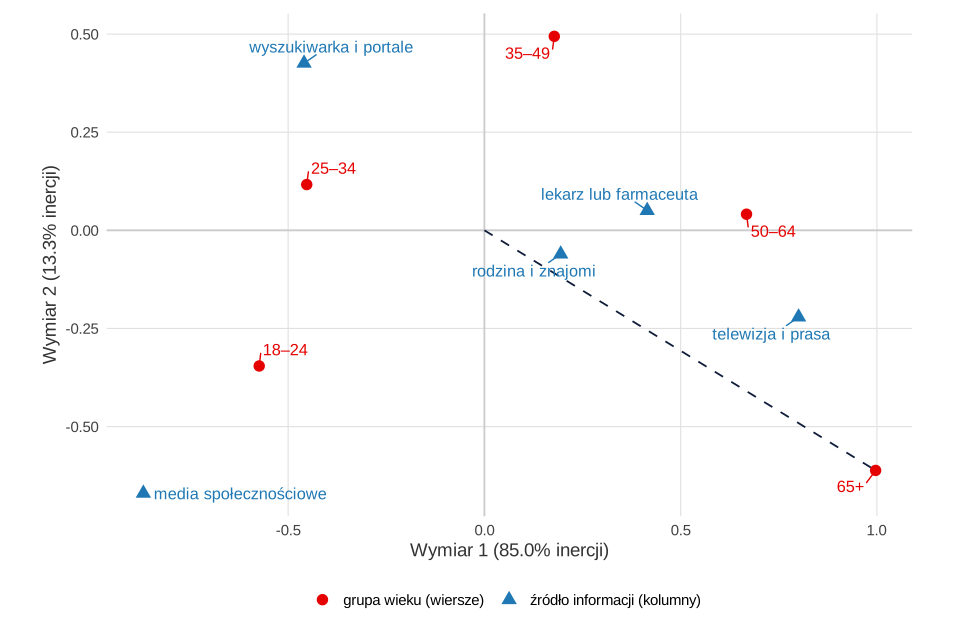
Studium przypadku IBM zaznacza, że przy normalizacji symetrycznej odległości między kategoriami jednej zmiennej nie są interpretowalne. Relacje między zmiennymi odczytuje się tam przez rzutowanie punktów na prostą przechodzącą przez środek układu (IBM Corp., b.d.-b). Odległość punktu wiersza od punktu kolumny nie mówi wprost, jak silna jest ich „korespondencja”. Mówi o tym kierunek od środka i rzut. Poprowadź prostą od środka do grupy 65+ i zobacz, gdzie wypadają rzuty źródeł. Telewizja i prasa leży daleko po tej samej stronie, a wyszukiwarki daleko po przeciwnej. Iloczyn skalarny wyników przybliża względne odchylenie komórki od niezależności. Przy 65+ dla telewizji i prasy jest to 0.933, a prawdziwe odchylenie +0.840 (28.8% wobec 15.6% w całej próbie). Dla wyszukiwarek odpowiednio −0.718 i −0.747. Szczegóły są we wpisie o teorii.
Zapis wyników w stylu APA
Podaj test χ² z V Craméra, inercję całkowitą, odsetek inercji na wymiarach, normalizację i opis wymiarów z wkładów. Wzór do dostosowania:
Tabelę liczebności z odsetkami w wierszach dołącz w wynikach albo w aneksie. Inne zdania przygotuje generator opisu wyników APA.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według wykresu składni CORRESPONDENCE i podkomend PRINT, PLOT i NORMALIZATION w Command Syntax Reference (IBM Corp., b.d.-c), ale nie uruchamialiśmy jej w SPSS. Dla danych już zebranych w tabeli dokumentacja przewiduje też zapis TABLE=ALL(5,5). Przepis 2 w R tworzy pliki do pobrania i liczy liczby z tabel. Rozkład SVD daje wartości osobliwe, inercje, masy, wyniki w normalizacji symetrycznej i wkłady. Kontrolnie liczymy też funkcją ca() z pakietu ca. Kod pokazuje też wyniki w innych normalizacjach i iloczyny skalarne z rysunku 2. Proporcje w tabeli ustawiliśmy ręcznie, a ziarna 553 nie dobieraliśmy pod wynik.
1. Składnia SPSS: CORRESPONDENCE
SPSS
* Składnia zgodna z opisem CORRESPONDENCE w Command Syntax Reference; nie była uruchamiana w SPSS.
CORRESPONDENCE TABLE=wiek(1,5) BY zrodlo(1,5)
  /DIMENSION=2
  /MEASURE=CHISQ
  /STANDARDIZE=RCMEAN
  /NORMALIZATION=SYMMETRICAL
  /PRINT=TABLE RPROF CPROF RPOINTS CPOINTS
  /PLOT=NDIM(1,2) BIPLOT(25).
2. Te same liczby w R i pliki .sav oraz CSV
R
# Analiza korespondencji w SPSS: liczby do tabel procedury Correspondence Analysis (dane symulowane)
# 800 osób: grupa wieku (1–5) × główne źródło informacji o zdrowiu (1–5), dane fikcyjne.
suppressPackageStartupMessages({ library(ca); library(haven) })
set.seed(553)
n_wiek <- c(200, 200, 180, 140, 80)
p_zrodlo <- rbind(c(.14, .34, .30, .14, .08),     # 18–24
                  c(.18, .40, .20, .12, .10),     # 25–34
                  c(.26, .36, .10, .12, .16),     # 35–49
                  c(.34, .22, .06, .14, .24),     # 50–64
                  c(.40, .10, .04, .16, .30))     # 65+
wiek <- rep(1:5, times = n_wiek)
zrodlo <- unlist(lapply(1:5, function(i) sample(1:5, n_wiek[i], replace = TRUE, prob = p_zrodlo[i, ])))
dane <- data.frame(id = seq_along(wiek), wiek = wiek, zrodlo = zrodlo)

# Plik .sav z etykietami zmiennych i wartości oraz ten sam zbiór w CSV
et_wiek <- c("18–24" = 1, "25–34" = 2, "35–49" = 3, "50–64" = 4, "65+" = 5)
et_zrodlo <- c("lekarz lub farmaceuta" = 1, "wyszukiwarka i portale" = 2, "media społecznościowe" = 3,
               "rodzina i znajomi" = 4, "telewizja i prasa" = 5)
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$wiek <- labelled(sav$wiek, labels = et_wiek, label = "Grupa wieku")
sav$zrodlo <- labelled(sav$zrodlo, labels = et_zrodlo, label = "Główne źródło informacji o zdrowiu")
write_sav(sav, "analiza-korespondencji-spss-dane.sav")
write.csv(dane, "analiza-korespondencji-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

# 1. Correspondence Table: tabela liczebności z sumami brzegowymi
N <- table(factor(dane$wiek, 1:5, names(et_wiek)), factor(dane$zrodlo, 1:5, names(et_zrodlo)))
print(addmargins(N))
n <- sum(N)

# 2. Summary: wartości osobliwe, inercja, chi-kwadrat, proporcja inercji (rozkład SVD reszt standaryzowanych)
P <- N / n; r <- rowSums(P); k <- colSums(P)
S <- diag(1 / sqrt(r)) %*% (P - r %o% k) %*% diag(1 / sqrt(k))
dec <- svd(S); m <- min(dim(N)) - 1
sv <- dec$d[1:m]; inercja <- sv^2
chi <- chisq.test(N, correct = FALSE)
cat(sprintf("\nChi-kwadrat Pearsona = %.3f, df = %d, p = %.3g; inercja całkowita = chi2 / n = %.4f\n",
            chi$statistic, chi$parameter, chi$p.value, chi$statistic / n))
print(data.frame(Dimension = 1:m, Singular_Value = round(sv, 3), Inertia = round(inercja, 3),
                 Accounted_for = round(inercja / sum(inercja), 3), Cumulative = round(cumsum(inercja) / sum(inercja), 3)))
cat(sprintf("Total: Inertia = %.3f, Chi Square = %.3f, Sig. = %.3g; maks. liczba wymiarów = %d\n",
            sum(inercja), n * sum(inercja), chi$p.value, m))
cat(sprintf("V Craméra = %.3f; średni wkład punktu przy 5 kategoriach = %.3f\n", sqrt(sum(inercja) / m), 1 / 5))

# 3. Overview Row Points i Overview Column Points przy normalizacji symetrycznej (Symmetrical, domyślnej w SPSS)
#    Wynik symetryczny = współrzędna standardowa × pierwiastek z wartości osobliwej
std_w <- diag(1 / sqrt(r)) %*% dec$u[, 1:m]          # współrzędne standardowe wierszy
std_k <- diag(1 / sqrt(k)) %*% dec$v[, 1:m]          # współrzędne standardowe kolumn
przeglad <- function(std, masa, etykiety, wym = 2) {
  glowne <- sweep(std, 2, sv, "*")                    # współrzędne główne
  in_pkt <- masa * rowSums(glowne^2)                  # inercja punktu
  data.frame(Mass = round(masa, 3),
             Score_1 = round(std[, 1] * sqrt(sv[1]), 3), Score_2 = round(std[, 2] * sqrt(sv[2]), 3),
             Inertia = round(in_pkt, 3),
             Pt_to_Dim_1 = round(masa * std[, 1]^2, 3), Pt_to_Dim_2 = round(masa * std[, 2]^2, 3),
             Dim_to_Pt_1 = round(masa * glowne[, 1]^2 / in_pkt, 3), Dim_to_Pt_2 = round(masa * glowne[, 2]^2 / in_pkt, 3),
             Dim_to_Pt_Total = round(rowSums(masa * glowne[, 1:wym]^2) / in_pkt, 3),
             row.names = etykiety)
}
cat("\nOverview Row Points (Symmetrical normalization)\n")
print(przeglad(std_w, r, names(et_wiek)))
cat("\nOverview Column Points (Symmetrical normalization)\n")
print(przeglad(std_k, k, names(et_zrodlo)))

# 4. Kontrola w pakiecie ca: te same wartości osobliwe, masy, inercje i jakość (summary podaje promile)
Nca <- unclass(N); dimnames(Nca) <- list(paste0("w", 1:5), paste0("z", 1:5))   # krótkie nazwy do wydruku summary()
fit <- ca(Nca)
cat("\nca(): wartości osobliwe", round(fit$sv, 3), "\n")
print(summary(fit, scree = FALSE)$rows)
# Wyniki symetryczne SPSS = mapa "symbiplot" w ca: współrzędne standardowe × sqrt(sv)
sym_ca <- sweep(fit$rowcoord[, 1:2], 2, sqrt(fit$sv[1:2]), "*")
cat("Największa różnica |wynik symetryczny ręcznie| − |ca|:", signif(max(abs(abs(sym_ca) - abs(std_w[, 1:2] %*% diag(sqrt(sv[1:2]))))), 2), "\n")

# 5. Zgodność z opisem IBM: wynik symetryczny wiersza = średnia ważona wyników kolumn podzielona przez wartość osobliwą
sym_w <- std_w[, 1:2] %*% diag(sqrt(sv[1:2])); sym_k <- std_k[, 1:2] %*% diag(sqrt(sv[1:2]))
profile_w <- N / rowSums(N)
cat("Wymiar 1, wiersz 18–24: bezpośrednio", round(sym_w[1, 1], 3),
    "| z kolumn:", round(sum(profile_w[1, ] * sym_k[, 1]) / sv[1], 3), "\n")

# 6. Inne normalizacje SPSS (wymiar 1): Principal, Row principal, Column principal
glowne_w <- std_w[, 1] * sv[1]; glowne_k <- std_k[, 1] * sv[1]
print(round(data.frame(Symmetrical = sym_w[, 1], Principal = glowne_w, Row_principal = glowne_w,
                       Column_principal = std_w[, 1], row.names = names(et_wiek)), 3))
print(round(data.frame(Symmetrical = sym_k[, 1], Principal = glowne_k, Row_principal = std_k[, 1],
                       Column_principal = glowne_k, row.names = names(et_zrodlo)), 3))

# 7. Profile wierszy (Row Profiles) do opisu wyników
print(round(prop.table(N, 1), 3))

# 8. Co wolno odczytać z mapy symetrycznej: rzut, nie odległość. Iloczyn skalarny wyników symetrycznych (2 wymiary)
#    przybliża względne odchylenie komórki od niezależności: p_ij / (r_i * k_j) - 1
odchylenie <- (P / (r %o% k) - 1)[5, ]
iloczyn <- as.vector(sym_k %*% sym_w[5, ])
odleglosc <- sqrt(colSums((t(sym_k) - sym_w[5, ])^2))
print(round(data.frame(odchylenie_65 = as.vector(odchylenie), iloczyn_skalarny = iloczyn, odleglosc_na_mapie = odleglosc,
                       row.names = names(et_zrodlo)), 3))
Wynik:
        lekarz lub farmaceuta wyszukiwarka i portale media społecznościowe rodzina i znajomi
  18–24                    38                     66                    49                28
  25–34                    39                     75                    37                29
  35–49                    51                     59                    13                30
  50–64                    43                     31                     8                22
  65+                      28                      6                     6                17
  Sum                     199                    237                   113               126

        telewizja i prasa Sum
  18–24                19 200
  25–34                20 200
  35–49                27 180
  50–64                36 140
  65+                  23  80
  Sum                 125 800

Chi-kwadrat Pearsona = 95.182, df = 16, p = 2.75e-13; inercja całkowita = chi2 / n = 0.1190
  Dimension Singular_Value Inertia Accounted_for Cumulative
1         1          0.318   0.101         0.850      0.850
2         2          0.126   0.016         0.133      0.983
3         3          0.043   0.002         0.015      0.999
4         4          0.013   0.000         0.001      1.000
Total: Inertia = 0.119, Chi Square = 95.182, Sig. = 2.75e-13; maks. liczba wymiarów = 4
V Craméra = 0.172; średni wkład punktu przy 5 kategoriach = 0.200

Overview Row Points (Symmetrical normalization)
       Mass Score_1 Score_2 Inertia Pt_to_Dim_1 Pt_to_Dim_2 Dim_to_Pt_1 Dim_to_Pt_2 Dim_to_Pt_Total
18–24 0.250  -0.574  -0.346   0.030       0.259       0.237       0.873       0.125           0.999
25–34 0.250  -0.453   0.117   0.017       0.161       0.027       0.967       0.025           0.993
35–49 0.225   0.178   0.494   0.010       0.022       0.436       0.236       0.721           0.957
50–64 0.175   0.668   0.041   0.026       0.245       0.002       0.959       0.001           0.961
65+   0.100   0.997  -0.612   0.037       0.312       0.297       0.861       0.128           0.989

Overview Column Points (Symmetrical normalization)
                        Mass Score_1 Score_2 Inertia Pt_to_Dim_1 Pt_to_Dim_2 Dim_to_Pt_1 Dim_to_Pt_2
lekarz lub farmaceuta  0.249   0.415   0.050   0.014       0.135       0.005       0.974       0.006
wyszukiwarka i portale 0.296  -0.459   0.426   0.027       0.197       0.426       0.743       0.252
media społecznościowe  0.141  -0.869  -0.670   0.042       0.335       0.503       0.809       0.191
rodzina i znajomi      0.158   0.194  -0.061   0.003       0.019       0.005       0.681       0.026
telewizja i prasa      0.156   0.800  -0.221   0.034       0.315       0.061       0.949       0.029
                       Dim_to_Pt_Total
lekarz lub farmaceuta            0.979
wyszukiwarka i portale           0.995
media społecznościowe            1.000
rodzina i znajomi                0.708
telewizja i prasa                0.978

ca(): wartości osobliwe 0.318 0.126 0.043 0.013
  name mass  qlt  inr  k=1 cor ctr  k=2 cor ctr
1   w1  250  999  252 -324 873 259 -123 125 237
2   w2  250  993  141 -255 967 161   41  25  27
3   w3  225  957   81  100 236  22  175 721 436
4   w4  175  961  217  377 959 245   15   1   2
5   w5  100  989  308  562 861 312 -217 128 297
Największa różnica |wynik symetryczny ręcznie| − |ca|: 3.3e-16
Wymiar 1, wiersz 18–24: bezpośrednio -0.574 | z kolumn: -0.574
      Symmetrical Principal Row_principal Column_principal
18–24      -0.574    -0.324        -0.324           -1.017
25–34      -0.453    -0.255        -0.255           -0.803
35–49       0.178     0.100         0.100            0.316
50–64       0.668     0.377         0.377            1.184
65+         0.997     0.562         0.562            1.767
                       Symmetrical Principal Row_principal Column_principal
lekarz lub farmaceuta        0.415     0.234         0.735            0.234
wyszukiwarka i portale      -0.459    -0.259        -0.815           -0.259
media społecznościowe       -0.869    -0.490        -1.541           -0.490
rodzina i znajomi            0.194     0.110         0.345            0.110
telewizja i prasa            0.800     0.451         1.419            0.451

        lekarz lub farmaceuta wyszukiwarka i portale media społecznościowe rodzina i znajomi
  18–24                 0.190                  0.330                 0.245             0.140
  25–34                 0.195                  0.375                 0.185             0.145
  35–49                 0.283                  0.328                 0.072             0.167
  50–64                 0.307                  0.221                 0.057             0.157
  65+                   0.350                  0.075                 0.075             0.212

        telewizja i prasa
  18–24             0.095
  25–34             0.100
  35–49             0.150
  50–64             0.257
  65+               0.288
                       odchylenie_65 iloczyn_skalarny odleglosc_na_mapie
lekarz lub farmaceuta          0.407            0.383              0.881
wyszukiwarka i portale        -0.747           -0.718              1.788
media społecznościowe         -0.469           -0.456              1.866
rodzina i znajomi              0.349            0.231              0.973
telewizja i prasa              0.840            0.933              0.437
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakietach ggplot2 i ggrepel i zapisano pakietem svglite. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ca (wersja 0.71.1): Nenadić, O., & Greenacre, M. (2007). Correspondence analysis in R, with two- and three-dimensional graphics: The ca package. Journal of Statistical Software, 20(3), 1–13. https://doi.org/10.18637/jss.v020.i03
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy i lista kontrolna
- Mapa bez testu χ² – przy słabym, nieistotnym związku mapa pokazuje głównie szum.
- Mieszanie normalizacji – „symetryczna” w SPSS to co innego niż mapa symetryczna w
ca; podaj nazwę opcji z okna Model. - Czytanie odległości wiersz–kolumna jak miary podobieństwa – czytaj kierunki i rzuty.
- Interpretacja punktów słabo odwzorowanych (niska kolumna Total) albo opartych na kilku osobach.
- Procent inercji jako test – to opis, nie test istotności wymiaru.
- Interpretacja znaku – kierunek osi jest umowny; liczy się, co leży po tej samej, a co po przeciwnej stronie.
Lista kontrolna: (1) kody całkowite i zakresy w Define Range; (2) test χ² z V Craméra; (3) inercja całkowita i odsetek inercji na wymiarach; (4) nazwa normalizacji; (5) opis wymiarów z wkładów punktów; (6) jakość odwzorowania punktów, które opisujesz; (7) mapa z procentem inercji na osiach; (8) wersja SPSS.
Więcej niż dwie zmienne? Dokumentacja IBM odsyła wtedy do wielokrotnej analizy korespondencji (IBM Corp., b.d.-a). Tę odmianę, podobnie jak całą metodę – bliską PCA, ale dla tabel liczebności – omawia podręcznik Greenacre (2017).
Najczęstsze pytania
Gdzie w SPSS jest analiza korespondencji?
W menu Analyze → Dimension Reduction → Correspondence Analysis (w polskiej dokumentacji: Analiza → Redukcja wymiarów → Analiza korespondencji). Według dokumentacji IBM procedura wymaga opcji Categories. Zmienną wierszy i kolumn wybierasz w oknie głównym, a dla każdej podajesz zakres kodów przyciskiem Define Range.
Którą normalizację wybrać w SPSS?
Gdy opisujesz związek wierszy z kolumnami, zostaw domyślną Symmetrical i biplot. Gdy porównujesz głównie kategorie jednej zmiennej, wybierz Row principal albo Column principal – wtedy odległości między punktami tej zmiennej przybliżają odległości chi-kwadrat. Principal rysuje obie zmienne we współrzędnych głównych i nie pozwala na biplot. Normalizacja nie zmienia wkładów, profili ani inercji.
Dlaczego wyniki z SPSS różnią się od wyników z R?
Najczęściej przez normalizację. Wyniki Symmetrical w SPSS to współrzędne standardowe pomnożone przez pierwiastek z wartości osobliwej (w pakiecie ca: map = "symbiplot"), a mapa symetryczna w ca odpowiada opcji Principal. Drugą przyczyną jest znak: kierunek każdego wymiaru jest umowny, więc cała kolumna może mieć odwrócone znaki.
Ile wymiarów zostawić w analizie korespondencji?
Patrz na kolumnę skumulowanej proporcji inercji w tabeli Summary – tak robi też studium przypadku IBM. W przykładzie dwa wymiary wyjaśniają 98.3% inercji. Procent inercji nie jest testem istotności wymiaru, więc słaby drugi wymiar opisuj krótko i ostrożnie.
Czy z biplotu mogę odczytać, które kategorie są sobie bliskie?
Kategorie tej samej zmiennej porównujesz na mapie w normalizacji Row principal lub Column principal. Na biplocie symetrycznym odległość punktu wiersza od punktu kolumny nie jest miarą ich związku. Czytaj kierunek od środka mapy i rzut punktu kolumny na prostą prowadzącą do punktu wiersza.
Powiązane hasła
Przeczytaj też
Analiza korespondencji krok po kroku
Inercja jako χ²/n, profile, wkłady i cos², mapa symetryczna a asymetryczna, mała kategoria i drugi wymiar, MCA i opis APA – na jednym przykładzie w R.
Czytaj →PoradnikChi-kwadrat w SPSS krok po kroku
Crosstabs w SPSS od pliku po opis APA: opcje Statistics i Cells, wiersz Pearsona, V Craméra, reszty skorygowane, test dokładny, Weight Cases i składnia CROSSTABS – z plikiem .sav.
Czytaj →PoradnikTest chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →Masz dużą tabelę krzyżową i nie wiesz, jak ją opisać?
Sprawdzimy, czy analiza korespondencji pasuje do Twojego pytania, dobierzemy normalizację i liczbę wymiarów oraz przygotujemy opis wyników z mapą i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je przedstawić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Gabriel, K. R. (2002). Goodness of fit of biplots and correspondence analysis. Biometrika, 89(2), 423–436. https://doi.org/10.1093/biomet/89.2.423
- Greenacre, M. (2017). Correspondence analysis in practice (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315369983
- Greenacre, M. J. (1993). Biplots in correspondence analysis. Journal of Applied Statistics, 20(2), 251–269. https://doi.org/10.1080/02664769300000021
- IBM Corp. (b.d.-a). Correspondence Analysis. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_mainhelp_ddita/spss/categories/idh_cors.html ● Otwarty dostęp
- IBM Corp. (b.d.-b). Correspondence analysis (case studies). IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_casestudies_project_ddita/spss/tutorials/correspondence_table.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). CORRESPONDENCE (Command Syntax Reference). IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_reference_project_ddita/spss/categories/syn_correspondence.html ● Otwarty dostęp
Cytowania BibTeX
@article{gabriel2002goodness, author={Gabriel, K. Ruben}, title={{Goodness of fit of biplots and correspondence analysis}}, journal={Biometrika}, year={2002}, volume={89}, number={2}, pages={423--436}, doi={10.1093/biomet/89.2.423}}@book{greenacre2017correspondence, author={Greenacre, Michael}, title={{Correspondence analysis in practice}}, year={2017}, edition={3}, publisher={Chapman and Hall/CRC}, doi={10.1201/9781315369983}}@article{greenacre1993biplots, author={Greenacre, Michael J.}, title={{Biplots in correspondence analysis}}, journal={Journal of Applied Statistics}, year={1993}, volume={20}, number={2}, pages={251--269}, doi={10.1080/02664769300000021}}@misc{ibmnd32correspondence, author={{IBM Corp.}}, title={{Correspondence Analysis}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_mainhelp_ddita/spss/categories/idh_cors.html}}@misc{ibmnd32correspondencestudium, author={{IBM Corp.}}, title={{Correspondence analysis (case studies)}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_casestudies_project_ddita/spss/tutorials/correspondence_table.html}}@misc{ibmnd32correspondenceskladnia, author={{IBM Corp.}}, title={{CORRESPONDENCE (Command Syntax Reference)}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_32.0.0/statistics_reference_project_ddita/spss/categories/syn_correspondence.html}}