allFit() – zgodne wyniki oznaczają fałszywy alarm. Singular fit oznacza, że macierz kowariancji efektów losowych leży na brzegu (wariancja zero, korelacja ±1 lub zależność liniowa widoczna w rePCA()). Zmiana optymalizatora go nie usunie. Upraszczaj według reguły z planu analizy: najpierw korelacje (||), na końcu losowe nachylenia predyktorów z hipotez.Trzy rodzaje komunikatów, trzy różne problemy
Dopasowujesz model mieszany w lme4 (Bates i in., 2015), a konsola zamiast wyników pokazuje ostrzeżenia. Usuwanie efektów losowych, aż komunikat zniknie, i ignorowanie go bywają równie błędne. Czym jest boundary (singular) fit i co mówi o nim dokumentacja lme4, opisaliśmy we wpisie ANOVA z powtarzanymi pomiarami czy model mieszany. Przeskalowanie predyktora w modelu logitowym pokazuje wpis o wielopoziomowej regresji logistycznej. Tu przechodzimy całą procedurę na jednym przykładzie.
| Komunikat | Co zwykle oznacza | Pierwszy krok |
|---|---|---|
Model is nearly unidentifiable: very large eigenvalue – Rescale variables? | predyktory w bardzo różnych jednostkach (np. minuty i punkty 1–10) | wycentruj i przeskaluj predyktory ciągłe |
Model failed to converge with max|grad| = …, degenerate Hessian, negative eigenvalues | optymalizator zatrzymał się w miejscu, którego nie umie potwierdzić jako maksimum; czasem fałszywy alarm | skalowanie, względny gradient, allFit() |
boundary (singular) fit: see help('isSingular') | macierz kowariancji efektów losowych leży na brzegu przestrzeni parametrów: wariancja zero, korelacja ±1 albo zależność liniowa między efektami | VarCorr(), rePCA(), uproszczenie struktury |
Ostrzeżenie o zbieżności jest pytaniem o optymalizator, a singular fit – pytaniem o to, czy dane udźwigną strukturę efektów losowych. Zmiana optymalizatora może rozwiązać pierwszy problem, ale nie drugi.
Przykład: badanie dziennikowe, 36 osób × 10 dni
Przez dziesięć dni 36 osób zapisywało długość snu poprzedniej nocy (w minutach), stres w ciągu dnia (1–10) i wieczorny nastrój (punkty). Dane są symulowane (set.seed(3295)). Możesz je pobrać jako plik CSV (360 wierszy). Sen trwał średnio 419.7 min (SD = 62.5), stres wynosił M = 4.6 (SD = 1.9), a nastrój M = 55.4 (SD = 11.4). W modelu, z którego wygenerowano dane, osoby różnią się poziomem nastroju (SD = 8), reakcją na sen (SD nachylenia = 1.5 pkt na godzinę) i, słabo, reakcją na stres (SD nachylenia = 0.3). Każda wariancja jest więc w populacji dodatnia.
Plan analizy przewiduje strukturę wynikającą ze schematu: oba predyktory zmieniają się w obrębie osoby, więc model zawiera losowy wyraz wolny i dwa losowe nachylenia z korelacjami, czyli (1 + sen + stres | id). To model maksymalny w sensie Barra i in. (2013). W prawdziwym badaniu dziennikowym rozdzieliłbyś(-łabyś) jeszcze efekt wewnątrz- i międzyosobowy przez centrowanie względem średniej osoby (zob. model wielopoziomowy krok po kroku). Tu pomijamy ten krok, żeby skupić się na diagnostyce.
Krok 1. Ostrzeżenia o zbieżności i skalowanie predyktorów
Model na surowych skalach (sen w minutach) zakończył się dwoma ostrzeżeniami: Model failed to converge with max|grad| = 7.96908 oraz Model is nearly unidentifiable: very large eigenvalue – Rescale variables?. Wartość max|grad| to bezwzględny gradient. Dokumentacja lme4 (?convergence) proponuje sprawdzić gradient względny, czyli gradient przeskalowany przez hesjan. Tu wyniósł 1.778, a więc wiele rzędów wielkości powyżej tolerancji. To nie był fałszywy alarm.
Przyczyna: nachylenie snu na minutę jest bardzo małe, a losowy wyraz wolny oznacza nastrój przy zerowej długości snu, daleko poza danymi. Po przeliczeniu snu na godziny względem 7 h ((sen_min − 420) / 60) i wycentrowaniu stresu na środku skali (stres − 5) ostrzeżenia o zbieżności zniknęły. Efekty stałe zmieniły się nieznacznie: sen z 2.632 na 2.648 pkt na godzinę, stres z −1.784 na −1.748. Przekształcenie liniowe nie zmienia modelu, tylko ułatwia obliczenia.
Krok 2. Singular fit, którego nie widać w VarCorr
Przeskalowany model nie zgłasza już problemów ze zbieżnością, ale zgłasza boundary (singular) fit, a isSingular() zwraca TRUE. Zajrzyj do VarCorr(): odchylenia standardowe wynoszą 8.73 (wyraz wolny), 1.47 (sen) i 0.50 (stres), a korelacje −.65, −.30 i −.53. Żadna wariancja nie jest zerowa i żadna korelacja nie wynosi ±1. Mimo to macierz jest osobliwa: trzy efekty losowe są liniowo zależne, więc w praktyce opisują je dwa wymiary.
Pokazuje to rePCA(), która rozkłada macierz kowariancji efektów losowych na główne składowe, podobnie jak PCA. Pierwsza składowa wyjaśnia 98.13% wariancji, druga 1.87%, a trzecia 0%. Singular fit nie zawsze oznacza zerową wariancję lub korelację ±1. Przy trzech efektach losowych i więcej sprawdzaj rePCA(), a nie tylko VarCorr().
Zwróć uwagę: w populacji wszystkie trzy wariancje są dodatnie. Osobliwość nie dowodzi więc, że nachylenie stresu nie istnieje. Pokazuje tylko, że 36 osób po 10 pomiarów nie wystarcza, by oszacować sześć parametrów macierzy kowariancji z potrzebną precyzją.
Krok 3. allFit: czy winny jest optymalizator?
Funkcja allFit() dopasowuje ten sam model wszystkimi dostępnymi optymalizatorami. Pięć algorytmów (bobyqa, Nelder–Mead, nlminb i dwa warianty nloptwrap) dało tę samą log-wiarygodność (−1208.752), te same efekty stałe (2.6484 i −1.7476) i to samo SD nachylenia stresu (0.4999). Każde z tych dopasowań było osobliwe.
Gdy allFit() daje zgodne wyniki przy ostrzeżeniu o zbieżności, ostrzeżenie jest najpewniej fałszywym alarmem. Wtedy wybierz jeden z optymalizatorów, np. lmerControl(optimizer = "bobyqa", optCtrl = list(maxfun = 2e5)), albo uruchom model od poprzednich oszacowań: update(m, start = getME(m, "theta")). Gdy wyniki się różnią, problem jest prawdziwy.
Krok 4. Upraszczanie struktury efektów losowych
Najpierw usuń te parametry, które najtrudniej oszacować i o które zwykle nie pytasz, czyli korelacje efektów losowych. Zapis (1 + sen_h + stres_c || id) zostawia trzy wariancje i zeruje korelacje. Model bez korelacji nie był osobliwy: SD wyniosły 8.64, 1.22 i 0.37, a trzecia składowa w rePCA() miała już niezerową wariancję (0.18%). Test ilorazu wiarygodności na modelach REML (REML a ML) nie wskazał, że korelacje poprawiają dopasowanie: χ²(3) = 5.53, p = .137.
Uwaga na pułapkę: w lme4 2.0.1 zapis || działa zgodnie z nazwą tylko dla predyktorów liczbowych. Dla czynnika kategorialnego model nadal szacuje korelacje między poziomami. Wtedy zamień czynnik na zmienne zero-jedynkowe albo kontrasty liczbowe (zob. kodowanie efektów) i dopiero je wpisz do części losowej.
Czy upraszczać dalej? Kolejne testy nie wsparły ani wariancji nachylenia stresu, χ²(1) = 0.13, p = .716, ani wariancji nachylenia snu, χ²(1) = 0.74, p = .388. Najniższe AIC miał model z samym losowym wyrazem wolnym (2433.9 wobec 2437.0 dla modelu bez korelacji). (Przy teście wariancji zwykłe p jest zachowawcze, ale nawet jego połowa daleko odbiega od .05.) A przecież nachylenie snu ma w populacji SD = 1.5. Brak istotności oznacza tu niską moc testu wariancji, a nie brak zmienności.
| Część losowa modelu | Singular? | Sen: b (SE) | Stres: b (SE) |
|---|---|---|---|
(1 + sen_h + stres_c | id) | tak | 2.648 (0.475) | −1.748 (0.222) |
(1 + sen_h + stres_c || id) | nie | 2.650 (0.460) | −1.734 (0.219) |
(1 + sen_h || id) | nie | 2.651 (0.461) | −1.720 (0.209) |
(1 | id) | nie | 2.626 (0.413) | −1.736 (0.209) |
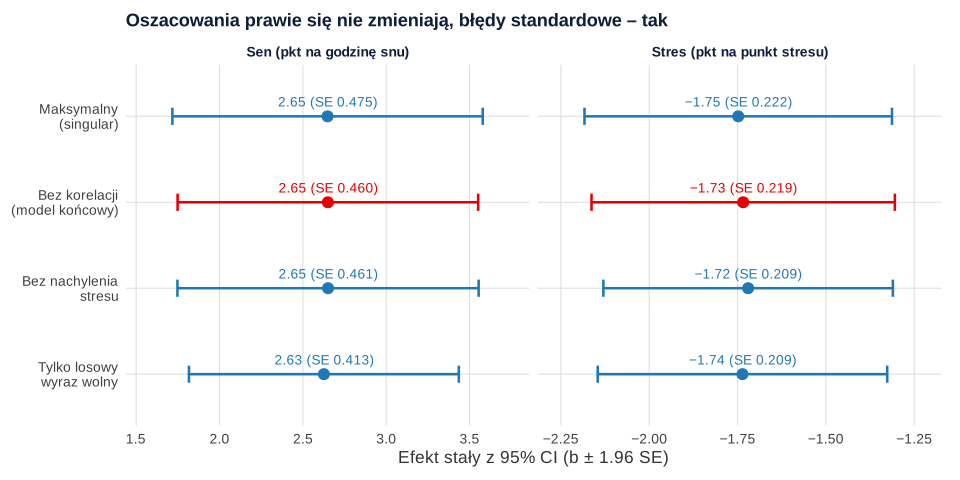
Oszacowania punktowe są prawie takie same we wszystkich modelach. Zmieniają się błędy standardowe. Gdy usuniesz losowe nachylenie snu, błąd efektu snu spada z 0.460 do 0.413, czyli o 10%. To mechanizm, przed którym ostrzegają Barr i in. (2013): bez losowego nachylenia efekt wygląda na pewniejszy, niż jest, a rośnie ryzyko błędu I rodzaju.
Przyjęliśmy regułę ustaloną przed analizą: upraszczamy tylko tyle, ile trzeba, by usunąć osobliwość. Najpierw usuwamy korelacje, potem wariancje o najmniejszym udziale w rePCA(). Modelem końcowym jest więc model bez korelacji. Efekt snu: b = 2.65, 95% CI [1.75, 3.55], t(27.8) = 5.77, p < .001; efekt stresu: b = −1.73, 95% CI [−2.16, −1.31], t(29.5) = −7.93, p < .001 (stopnie swobody Satterthwaite'a).
Jak często singular fit pojawia się bez żadnego błędu?
Jeden przykład może być przypadkiem. Powtórzyliśmy więc to samo badanie po 200 razy dla 12, 24, 48 i 96 osób oraz trzech wartości prawdziwego SD nachylenia stresu (0, 0.3 i 0.6). W każdym zbiorze dopasowaliśmy model maksymalny i model bez korelacji.
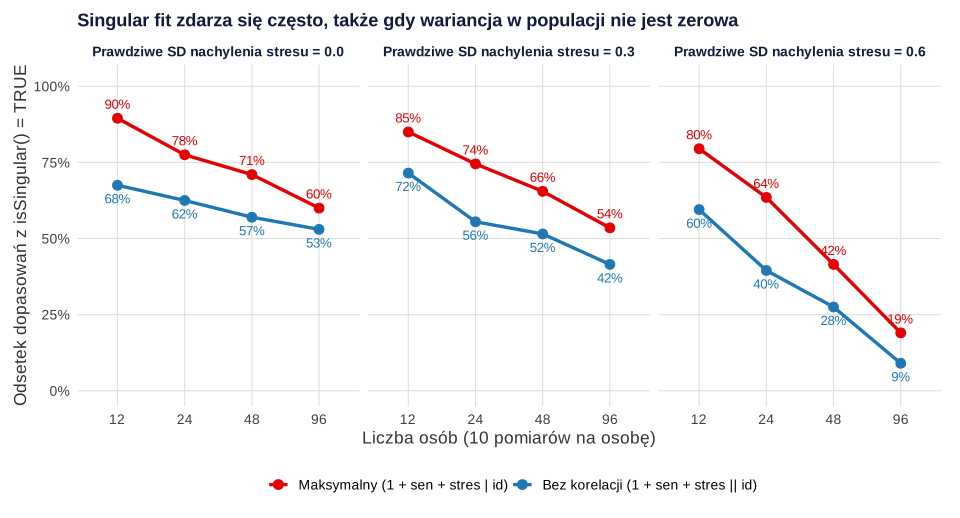
Wyniki są otrzeźwiające. Przy prawdziwym SD nachylenia stresu równym 0.3, jak w przykładzie, model maksymalny był osobliwy w 85.0% zbiorów z 12 osobami, w 74.5% z 24 osobami i nadal w 53.5% z 96 osobami. Nawet przy dwa razy większym SD (0.6) i 48 osobach singular fit pojawił się w 41.5% zbiorów. Usunięcie korelacji zmniejszało odsetek, np. z 41.5% do 27.5% w tej ostatniej komórce, ale nie usuwało problemu. Gdy wariancja w populacji była zerowa, osobliwość pojawiała się w 60.0–89.5% dopasowań modelu maksymalnego.
Wniosek praktyczny: przy kilkudziesięciu osobach i kilku efektach losowych singular fit jest regułą, a nie oznaką błędu w danych. Mała wariancja losowego nachylenia jest wtedy prawie nieodróżnialna od zerowej. Zaplanuj więc z góry, co zrobisz, gdy model maksymalny okaże się osobliwy. Liczbę osób sprawdź symulacją (zob. analiza mocy dla modelu mieszanego).
„Keep it maximal” czy model oszczędny?
Barr i in. (2013) pokazali w symulacjach, że w testowaniu konfirmacyjnym modele najlepiej uogólniają wyniki, gdy zawierają maksymalną strukturę efektów losowych uzasadnioną schematem. Struktury dobierane na podstawie danych dawały rozsądne wyniki tylko w umiarkowanie dużych próbach i przy zachowawczych kryteriach. Matuschek i in. (2017) odpowiedzieli, że model maksymalny chroni przed zawyżeniem błędu I rodzaju, ale może wyraźnie obniżyć moc. Ich zdaniem wyższą moc bez zawyżenia błędu daje struktura wspierana przez dane, wybrana kryterium wyboru modelu.
Nasz przykład pokazuje obie strony. Model maksymalny był osobliwy, więc trzeba było go uprościć. Czysto „danych” wybór (AIC, kolejne testy) usunąłby jednak losowe nachylenie snu, które w populacji istnieje, i zaniżyłby błąd standardowy. Scandola i Tidoni (2024) piszą, że literatura daje tu sprzeczne zalecenia. Proponują procedurę krok po kroku dla schematów w pełni skrzyżowanych (zob. efekty skrzyżowane uczestnicy × bodźce), z uproszczeniami, które nie zawyżają błędu I rodzaju. Brauer i Curtin (2018) opisują, jakie efekty losowe uwzględnić w różnych schematach, i podają kroki naprawcze, gdy model z wieloma parametrami się nie zbiega.
W praktyce sprawdzają się trzy zasady:
- Nie usuwaj efektów losowych, które chronią test Twojej hipotezy. Jeśli hipoteza dotyczy snu, losowe nachylenie snu zostaje, dopóki model da się oszacować. Przy interakcji międzypoziomowej Heisig i Schaeffer (2019) zalecają zawsze zostawić losowe nachylenie zmiennej niższego poziomu. Jego pominięcie zwykle daje silnie antykonserwatywne wnioskowanie.
- Upraszczaj od parametrów, które najmniej wnoszą do pytania: korelacje, potem wariancje zmiennych kontrolnych, na końcu wariancje predyktorów z hipotez.
- Zapisz regułę przed analizą w planie analizy statystycznej. Wybór po obejrzeniu wartości p to jedna z dróg w ogrodzie rozwidlających się ścieżek.
Gdy klastrów jest kilkanaście, problem leży głębiej niż w strukturze efektów losowych. McNeish (2017) zaleca wtedy estymację REML z poprawką Kenwarda–Rogera, bo klasyczna metoda ML zawodzi przy małej liczbie grup. Przy bardzo małej liczbie klastrów rozważ też modele bez efektów losowych, np. z błędami odpornymi na klastrowanie albo GEE (zob. GEE czy model mieszany).
Procedura krok po kroku
- Sprawdź dane i specyfikację, np. czy nachylenie dotyczy zmiennej zmieniającej się w obrębie osoby.
- Wycentruj i przeskaluj predyktory ciągłe.
- Przy ostrzeżeniu o zbieżności policz gradient względny i uruchom
allFit(). - Przy singular fit obejrzyj
VarCorr()irePCA(). - Usuń korelacje (
||, a dla czynników zmienne zero-jedynkowe). - Usuń kolejne wariancje w kolejności z reguły zapisanej w planie, zaczynając od tych o zerowym udziale w
rePCA(). Zatrzymaj się na pierwszym modelu, który nie jest osobliwy. - Porównaj efekty stałe w modelu wyjściowym i końcowym. Gdy wnioski się różnią, opisz to jako analizę wrażliwości.
Jak opisać decyzję w artykule
Meteyard i Davies (2020) przejrzeli 400 artykułów z modelami mieszanymi i za najbardziej niepokojące uznali różnice w sposobie raportowania. Podaj więc strukturę planowaną, problem, kolejne kroki i model końcowy. Dodaj kod do pakietu replikacyjnego. Co jeszcze podać przy samych wynikach, opisuje wpis jak opisać wyniki modelu mieszanego.
Jeśli recenzent pyta, dlaczego model nie ma pełnej struktury efektów losowych, wzory odpowiedzi znajdziesz we wpisie odpowiedź recenzentom. Gdy chcesz, żeby ktoś sprawdził całą ścieżkę decyzji, pomożemy w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Trzy przepisy uruchamiane po kolei w jednej sesji R. Pierwszy tworzy plik model-mieszany-singular-fit-dane.csv (możesz go pobrać tutaj). Potrzebne pakiety: lme4 i lmerTest.
1. Dane, model na surowych skalach i skalowanie
R
# Dane symulowane: badanie dziennikowe, 36 osób × 10 dni.
# sen_min: długość snu poprzedniej nocy (minuty), stres: stres w ciągu dnia (1–10), nastroj: nastrój wieczorem (punkty).
# Prawdziwe odchylenia standardowe efektów losowych: wyraz wolny 8, nachylenie snu 1.5 (na godzinę), nachylenie stresu 0.3.
suppressPackageStartupMessages(library(lme4))
set.seed(3295)
n_os <- 36; n_dni <- 10
os <- data.frame(id = factor(sprintf("u%02d", 1:n_os)), u0 = rnorm(n_os, 0, 8), u_sen = rnorm(n_os, 0, 1.5),
                 u_str = rnorm(n_os, 0, 0.3), sen_sr = rnorm(n_os, 420, 35), str_sr = rnorm(n_os, 5, 1.2))
dane <- os[rep(1:n_os, each = n_dni), ]
dane$dzien <- rep(1:n_dni, n_os)
dane$sen_min <- round(dane$sen_sr + rnorm(nrow(dane), 0, 50))
dane$stres <- pmin(10, pmax(1, round(dane$str_sr + rnorm(nrow(dane), 0, 1.6))))
dane$nastroj <- round(55 + dane$u0 + (2 + dane$u_sen) * (dane$sen_min - 420) / 60 +
                        (-1.5 + dane$u_str) * (dane$stres - 5) + rnorm(nrow(dane), 0, 6), 1)
dane <- dane[, c("id", "dzien", "sen_min", "stres", "nastroj")]
write.csv(dane, "model-mieszany-singular-fit-dane.csv", row.names = FALSE)
round(sapply(dane[, c("sen_min", "stres", "nastroj")], function(x) c(M = mean(x), SD = sd(x), min = min(x), max = max(x))), 1)

# Krok 1. Model maksymalny na surowych skalach (sen w minutach) – ostrzeżenia o zbieżności
m_surowy <- lmer(nastroj ~ sen_min + stres + (1 + sen_min + stres | id), data = dane)
# względny gradient: małe wartości (rzędu 0.001) oznaczają, że ostrzeżenie jest fałszywym alarmem
with(m_surowy@optinfo$derivs, max(abs(solve(Hessian, gradient))))

# Krok 2. Skalowanie: sen w godzinach względem 7 h (420 min), stres względem środka skali (5)
dane$sen_h <- (dane$sen_min - 420) / 60
dane$stres_c <- dane$stres - 5
m_max <- lmer(nastroj ~ sen_h + stres_c + (1 + sen_h + stres_c | id), data = dane)
isSingular(m_max)
print(VarCorr(m_max), digits = 3)
summary(rePCA(m_max))
# efekty stałe na wspólnej skali (sen na godzinę): surowy model a przeskalowany
round(rbind(surowy = fixef(m_surowy) * c(1, 60, 1), przeskalowany = fixef(m_max)), 3)[, -1]
Wynik w R
    sen_min stres nastroj
M     419.7   4.6    55.4
SD     62.5   1.9    11.4
min   192.0   1.0    30.5
max   595.0  10.0    89.2
Warning in checkConv(attr(opt, "derivs"), opt$par, ctrl = control$checkConv,  :
  Model failed to converge with max|grad| = 7.96908 (tol = 0.002, component 1)
  See ?lme4::convergence and ?lme4::troubleshooting.
Warning in checkConv(attr(opt, "derivs"), opt$par, ctrl = control$checkConv,  :
  Model is nearly unidentifiable: very large eigenvalue
 - Rescale variables?;Model is nearly unidentifiable: large eigenvalue ratio
 - Rescale variables?
[1] 1.777747
boundary (singular) fit: see help('isSingular')
[1] TRUE
 Groups   Name        Std.Dev. Corr
 id       (Intercept) 8.73
          sen_h       1.47     -0.65
          stres_c     0.50     -0.30 -0.53
 Residual             5.87
$id
Importance of components:
                         [,1]    [,2] [,3]
Standard deviation     1.4956 0.20617    0
Proportion of Variance 0.9813 0.01865    0
Cumulative Proportion  0.9813 1.00000    1

              sen_min  stres
surowy          2.632 -1.784
przeskalowany   2.648 -1.748
2. allFit i upraszczanie struktury efektów losowych
R
# allFit, rePCA i upraszczanie struktury efektów losowych (wymaga obiektów z przepisu 1)
suppressPackageStartupMessages(library(lmerTest))

# Krok 3. Czy wynik zależy od optymalizatora?
wsz <- summary(allFit(m_max, verbose = FALSE))
round(cbind(logLik = wsz$llik, wsz$fixef[, -1], SD_stres = wsz$sdcor[, "id.stres_c"]), 4)

# Krok 4. Kolejne uproszczenia (REML, te same efekty stałe)
m_bezkor <- lmer(nastroj ~ sen_h + stres_c + (1 + sen_h + stres_c || id), data = dane)   # bez korelacji
m_sen    <- lmer(nastroj ~ sen_h + stres_c + (1 + sen_h || id), data = dane)             # bez nachylenia stresu
m_wolny  <- lmer(nastroj ~ sen_h + stres_c + (1 | id), data = dane)                      # tylko wyraz wolny
sapply(list(maks = m_max, bez_korelacji = m_bezkor, bez_stresu = m_sen, wyraz_wolny = m_wolny), isSingular)
print(VarCorr(m_bezkor), digits = 3)
summary(rePCA(m_bezkor))
anova(m_bezkor, m_max, refit = FALSE)                  # czy korelacje są potrzebne?
anova(m_sen, m_bezkor, refit = FALSE)                  # czy wariancja nachylenia stresu jest potrzebna?
anova(m_wolny, m_sen, refit = FALSE)                   # czy wariancja nachylenia snu jest potrzebna?

# Efekty stałe (b, SE) w kolejnych modelach
tab <- t(sapply(list(maks = m_max, bez_korelacji = m_bezkor, bez_stresu = m_sen, wyraz_wolny = m_wolny),
                function(m) c(coef(summary(m))[2, 1:2], coef(summary(m))[3, 1:2])))
colnames(tab) <- c("b_sen", "SE_sen", "b_stres", "SE_stres"); round(tab, 3)

# Model końcowy: bez korelacji efektów losowych, testy t ze stopniami swobody Satterthwaite'a
m_konc <- as_lmerModLmerTest(m_bezkor)
wsp <- coef(summary(m_konc))
cbind(round(wsp[, 1:4], 3), p = signif(wsp[, 5], 3))
round(confint(m_konc, parm = "beta_", method = "Wald"), 2)
Wynik w R
boundary (singular) fit: see help('isSingular')
boundary (singular) fit: see help('isSingular')
boundary (singular) fit: see help('isSingular')
boundary (singular) fit: see help('isSingular')
boundary (singular) fit: see help('isSingular')
                                 logLik  sen_h stres_c SD_stres
bobyqa                        -1208.752 2.6484 -1.7476   0.4999
Nelder_Mead                   -1208.752 2.6484 -1.7476   0.4999
nlminbwrap                    -1208.752 2.6484 -1.7476   0.4999
nloptwrap.NLOPT_LN_NELDERMEAD -1208.752 2.6484 -1.7476   0.4999
nloptwrap.NLOPT_LN_BOBYQA     -1208.752 2.6484 -1.7476   0.4999
         maks bez_korelacji    bez_stresu   wyraz_wolny
         TRUE         FALSE         FALSE         FALSE
 Groups   Name        Std.Dev.
 id       (Intercept) 8.643
 id.1     sen_h       1.219
 id.2     stres_c     0.371
 Residual             5.946
$id
Importance of components:
                         [,1]    [,2]    [,3]
Standard deviation     1.4537 0.20494 0.06248
Proportion of Variance 0.9787 0.01945 0.00181
Cumulative Proportion  0.9787 0.99819 1.00000

Data: dane
Models:
m_bezkor: nastroj ~ sen_h + stres_c + (1 + sen_h + stres_c || id)
m_max: nastroj ~ sen_h + stres_c + (1 + sen_h + stres_c | id)
         npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m_bezkor    7 2437.0 2464.2 -1211.5    2423.0
m_max      10 2437.5 2476.4 -1208.8    2417.5 5.5257  3     0.1371
Data: dane
Models:
m_sen: nastroj ~ sen_h + stres_c + (1 + sen_h || id)
m_bezkor: nastroj ~ sen_h + stres_c + (1 + sen_h + stres_c || id)
         npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m_sen       6 2435.2 2458.5 -1211.6    2423.2
m_bezkor    7 2437.0 2464.2 -1211.5    2423.0 0.1326  1     0.7157
Data: dane
Models:
m_wolny: nastroj ~ sen_h + stres_c + (1 | id)
m_sen: nastroj ~ sen_h + stres_c + (1 + sen_h || id)
        npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m_wolny    5 2433.9 2453.3 -1212.0    2423.9
m_sen      6 2435.2 2458.5 -1211.6    2423.2 0.7447  1     0.3882
              b_sen SE_sen b_stres SE_stres
maks          2.648  0.475  -1.748    0.222
bez_korelacji 2.650  0.460  -1.734    0.219
bez_stresu    2.651  0.461  -1.720    0.209
wyraz_wolny   2.626  0.413  -1.736    0.209
            Estimate Std. Error     df t value        p
(Intercept)   54.751      1.484 34.784  36.896 1.76e-29
sen_h          2.650      0.460 27.804   5.765 3.54e-06
stres_c       -1.734      0.219 29.465  -7.933 8.48e-09
            2.5 % 97.5 %
(Intercept) 51.84  57.66
sen_h        1.75   3.55
stres_c     -2.16  -1.31
3. Symulacja: częstość singular fit
R
# Symulacja: jak często model maksymalny i model bez korelacji kończą się singular fit?
# 10 dni na osobę, ten sam model co w przykładzie; zmieniamy liczbę osób i prawdziwe SD nachylenia stresu.
# 200 zbiorów na komórkę (obliczenia trwają kilka minut).
suppressPackageStartupMessages(library(lme4))
set.seed(3296)
generuj <- function(n_os, sd_str, n_dni = 10) {
  os <- data.frame(id = factor(1:n_os), u0 = rnorm(n_os, 0, 8), u_sen = rnorm(n_os, 0, 1.5),
                   u_str = rnorm(n_os, 0, sd_str), sen_sr = rnorm(n_os, 420, 35), str_sr = rnorm(n_os, 5, 1.2))
  d <- os[rep(1:n_os, each = n_dni), ]
  d$sen_h <- (round(d$sen_sr + rnorm(nrow(d), 0, 50)) - 420) / 60
  d$stres_c <- pmin(10, pmax(1, round(d$str_sr + rnorm(nrow(d), 0, 1.6)))) - 5
  d$nastroj <- 55 + d$u0 + (2 + d$u_sen) * d$sen_h + (-1.5 + d$u_str) * d$stres_c + rnorm(nrow(d), 0, 6)
  d
}
ctrl <- lmerControl(calc.derivs = FALSE, check.conv.singular = "ignore")   # szybciej, bez komunikatów
dopasuj <- function(f, d) suppressWarnings(lmer(f, data = d, control = ctrl))   # liczy się tylko isSingular()
siatka <- expand.grid(n_os = c(12, 24, 48, 96), sd_str = c(0, 0.3, 0.6))
wyniki <- t(sapply(seq_len(nrow(siatka)), function(k) {
  r <- replicate(200, {
    d <- generuj(siatka$n_os[k], siatka$sd_str[k])
    c(maks = isSingular(dopasuj(nastroj ~ sen_h + stres_c + (1 + sen_h + stres_c | id), d)),
      bez_korelacji = isSingular(dopasuj(nastroj ~ sen_h + stres_c + (1 + sen_h + stres_c || id), d)))
  })
  rowMeans(r)
}))
wynik <- cbind(siatka, round(wyniki, 3))
print(wynik, row.names = FALSE)
Wynik w R
 n_os sd_str  maks bez_korelacji
   12    0.0 0.895         0.675
   24    0.0 0.775         0.625
   48    0.0 0.710         0.570
   96    0.0 0.600         0.530
   12    0.3 0.850         0.715
   24    0.3 0.745         0.555
   48    0.3 0.655         0.515
   96    0.3 0.535         0.415
   12    0.6 0.795         0.595
   24    0.6 0.635         0.395
   48    0.6 0.415         0.275
   96    0.6 0.190         0.090
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lme4 i lmerTest; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Wyciszanie ostrzeżeń zamiast sprawdzenia gradientu względnego i
allFit(). - Zmiana optymalizatora przy singular fit. Wszystkie optymalizatory znajdą to samo maksimum na brzegu.
- Czytanie singular fit jako dowodu, że efekt losowy nie istnieje. W przykładzie wszystkie wariancje były w populacji dodatnie.
- Zapis
||przy czynniku kategorialnym w przekonaniu, że usuwa korelacje. - Usuwanie losowego nachylenia predyktora z hipotezy jako pierwszego kroku. Zaniża to błąd standardowy właśnie tego efektu.
Najczęstsze pytania
Czy singular fit oznacza, że wyniki modelu mieszanego są błędne?
Nie. Model osobliwy jest dobrze zdefiniowany, a efekty stałe często są prawie takie same jak w modelu uproszczonym (w przykładzie 2.648 wobec 2.650 dla snu). Problemem jest przeparametryzowanie: części macierzy kowariancji efektów losowych nie da się oszacować. Opisz to i pokaż model uproszczony według reguły z planu analizy.
Czy można zignorować ostrzeżenie „Model failed to converge” w lme4?
Tylko po sprawdzeniu. Przeskaluj predyktory, policz gradient względny (solve(Hessian, gradient)) i uruchom allFit(). Jeśli optymalizatory dają tę samą log-wiarygodność i te same efekty, ostrzeżenie było fałszywym alarmem. W przykładzie na surowych skalach gradient względny wynosił 1.778, więc problem był prawdziwy i zniknął dopiero po przeskalowaniu snu na godziny.
Czy zmiana optymalizatora usuwa singular fit?
Nie. Osobliwość jest cechą maksimum funkcji wiarygodności, a nie algorytmu. W przykładzie pięć optymalizatorów w allFit() dało tę samą log-wiarygodność (−1208.752) i każde dopasowanie było osobliwe. Zmiana optymalizatora pomaga tylko przy ostrzeżeniach o zbieżności.
Co robi zapis || w formule lmer?
Podwójna kreska, np. (1 + x + z || id), zostawia wariancje efektów losowych, ale zeruje korelacje między nimi. To zwykle pierwszy krok upraszczania, bo korelacje najtrudniej oszacować. Działa tak dla predyktorów liczbowych. Dla czynnika kategorialnego korelacje między poziomami zostają, więc zamień go najpierw na zmienne zero-jedynkowe.
Jak opisać w artykule uproszczenie struktury efektów losowych?
Podaj strukturę planowaną, komunikat (np. singular fit), diagnozę (rePCA(), allFit()), regułę upraszczania ustaloną przed analizą, kolejne kroki z testami LRT i model końcowy. Dodaj, czy efekty stałe zmieniły się między modelem pełnym a końcowym. Kod umieść w materiałach dodatkowych.
Powiązane hasła
Przeczytaj też
ANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikEfekty skrzyżowane: uczestnicy × bodźce
Skrzyżowane efekty losowe osób i bodźców w lme4, maksymalna struktura, symulacja błędu I rodzaju, moc zależna od liczby bodźców i opis APA.
Czytaj →PoradnikJak opisać wyniki modelu mieszanego
Co przepisać z wydruku lmer do pracy: struktura modelu, REML, df Satterthwaite’a, efekty stałe z CI, wariancje losowe, ICC i R² Nakagawy – z tabelą APA i wzorami zdań.
Czytaj →Model mieszany się nie zbiega, a recenzent pyta o strukturę efektów losowych?
Pomożemy zdiagnozować ostrzeżenia, zaplanować regułę upraszczania i sprawdzić, czy wnioski zależą od wybranej struktury, tak żebyś mógł(a) samodzielnie opisać i obronić analizę.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001 ● Otwarty dostęp: pełny tekst
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Brauer, M., & Curtin, J. J. (2018). Linear mixed-effects models and the analysis of nonindependent data: A unified framework to analyze categorical and continuous independent variables that vary within-subjects and/or within-items. Psychological Methods, 23(3), 389–411. https://doi.org/10.1037/met0000159
- Heisig, J. P., & Schaeffer, M. (2019). Why you should always include a random slope for the lower-level variable involved in a cross-level interaction. European Sociological Review, 35(2), 258–279. https://doi.org/10.1093/esr/jcy053 ● Otwarty dostęp
- Matuschek, H., Kliegl, R., Vasishth, S., Baayen, H., & Bates, D. (2017). Balancing Type I error and power in linear mixed models. Journal of Memory and Language, 94, 305–315. https://doi.org/10.1016/j.jml.2017.01.001 ● Otwarty dostęp
- McNeish, D. (2017). Small sample methods for multilevel modeling: A colloquial elucidation of REML and the Kenward-Roger correction. Multivariate Behavioral Research, 52(5), 661–670. https://doi.org/10.1080/00273171.2017.1344538
- Meteyard, L., & Davies, R. A. I. (2020). Best practice guidance for linear mixed-effects models in psychological science. Journal of Memory and Language, 112, Article 104092. https://doi.org/10.1016/j.jml.2020.104092 ● Otwarty dostęp: pełny tekst
- Scandola, M., & Tidoni, E. (2024). Reliability and feasibility of linear mixed models in fully crossed experimental designs. Advances in Methods and Practices in Psychological Science, 7(1), Article 25152459231214454. https://doi.org/10.1177/25152459231214454 ● Otwarty dostęp
Cytowania BibTeX
@article{barr2013random, author={Barr, Dale J. and Levy, Roger and Scheepers, Christoph and Tily, Harry J.}, title={{Random effects structure for confirmatory hypothesis testing: Keep it maximal}}, journal={Journal of Memory and Language}, year={2013}, volume={68}, number={3}, pages={255--278}, doi={10.1016/j.jml.2012.11.001}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{brauer2018linear, author={Brauer, Markus and Curtin, John J.}, title={{Linear mixed-effects models and the analysis of nonindependent data: A unified framework to analyze categorical and continuous independent variables that vary within-subjects and/or within-items}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={389--411}, doi={10.1037/met0000159}}@article{heisig2019why, author={Heisig, Jan Paul and Schaeffer, Merlin}, title={{Why you should always include a random slope for the lower-level variable involved in a cross-level interaction}}, journal={European Sociological Review}, year={2019}, volume={35}, number={2}, pages={258--279}, doi={10.1093/esr/jcy053}}@article{matuschek2017balancing, author={Matuschek, Hannes and Kliegl, Reinhold and Vasishth, Shravan and Baayen, Harald and Bates, Douglas}, title={{Balancing Type I error and power in linear mixed models}}, journal={Journal of Memory and Language}, year={2017}, volume={94}, pages={305--315}, doi={10.1016/j.jml.2017.01.001}}@article{mcneish2017small, author={McNeish, Daniel}, title={{Small sample methods for multilevel modeling: A colloquial elucidation of REML and the Kenward-Roger correction}}, journal={Multivariate Behavioral Research}, year={2017}, volume={52}, number={5}, pages={661--670}, doi={10.1080/00273171.2017.1344538}}@article{meteyard2020best, author={Meteyard, Lotte and Davies, Robert A. I.}, title={{Best practice guidance for linear mixed-effects models in psychological science}}, journal={Journal of Memory and Language}, year={2020}, volume={112}, eid={104092}, doi={10.1016/j.jml.2020.104092}}@article{scandola2024reliability, author={Scandola, Michele and Tidoni, Emmanuele}, title={{Reliability and feasibility of linear mixed models in fully crossed experimental designs}}, journal={Advances in Methods and Practices in Psychological Science}, year={2024}, volume={7}, number={1}, eid={25152459231214454}, doi={10.1177/25152459231214454}}