Dlaczego kalkulator mocy tu nie wystarczy
Planujesz eksperyment, w którym każda osoba wykonuje wiele prób w kilku warunkach, a dane chcesz analizować modelem mieszanym. Recenzent albo komisja grantowa pyta o moc testu. Klasyczna analiza mocy a priori zakłada jedną obserwację na osobę albo prosty schemat powtarzanych pomiarów, więc G*Power nie uwzględni jednocześnie liczby prób, zmienności osób i różnic w sile efektu między osobami.
Dla modeli mieszanych nie ma praktycznego rozwiązania analitycznego. Kumle i in. (2021) proponują dlatego symulację. Losujesz wiele zbiorów danych z założonego modelu, do każdego dopasowujesz model, który naprawdę zaplanowałeś, i liczysz odsetek wyników z p < .05. Ogólną logikę opisuje hasło parametr niecentralności i symulacyjna analiza mocy, a wersję dla SEM wpis liczebność próby do SEM. Tutaj chodzi o eksperyment z powtarzanymi próbami i o pytanie, które w modelach mieszanych pojawia się zawsze: więcej osób czy więcej prób?
Pięć decyzji przed symulacją
Morris i in. (2019) zalecają, by każde badanie symulacyjne zaplanować i opisać według schematu ADEMP: cele, mechanizm generowania danych, estymandy, metody i miary jakości. W analizie mocy dla modelu mieszanego sprowadza się to do pięciu decyzji.
- Model analizy. Zapisz formułę, którą dopasujesz do danych z badania głównego, razem ze strukturą efektów losowych i metodą liczenia p.
- Parametry generujące. Wyraz wolny, SD losowych wyrazów wolnych, SD losowych nachyleń, ich korelacja i wariancja reszt. Bierzesz je z pilotażu, z opublikowanych danych albo z literatury.
- Efekt. Najmniejszy efekt, który ma dla Ciebie znaczenie, a nie efekt zaobserwowany w pilotażu.
- Siatka planów. Liczba osób × liczba prób (a w eksperymentach z bodźcami także liczba bodźców).
- Liczba powtórzeń i miara jakości. Moc z jej błędem Monte Carlo, odsetek modeli osobliwych, średnie oszacowanie efektu.
Arend i Schäfer (2019) pokazują, jak określić model populacyjny parametrami standaryzowanymi, gdy nie masz żadnych danych. Kumle i in. (2021) omawiają też wariant z modelem dopasowanym do opublikowanych danych i wariant z doborem liczby bodźców.
Krok 1. Parametry z pilotażu – co brać, a czego nie
Przykład dotyczy czasu reakcji (ms) w zadaniu z bodźcami negatywnymi i neutralnymi (dane symulowane). Warunek kodujemy −0.5 i +0.5, więc współczynnik to różnica średnich czasów. Badanie pilotażowe objęło 12 osób po 20 prób w każdym warunku. Model z losowym wyrazem wolnym i losowym nachyleniem warunku dał efekt b = 38.3 ms, SE = 14.45, t(38.7) = 2.65, p = .012, 95% CI [10.0, 66.6]. SD osób wyniosło 72.0 ms, SD nachyleń 18.3 ms, a SD reszt 147.3 ms. Korelacja efektów losowych wyniosła 1.00, a isSingular() zwróciło TRUE.
Z tego wyniku bierzemy tylko część liczb:
- Wyraz wolny, SD osób i SD reszt – tak, po zaokrągleniu: 630, 70 i 150 ms. Z 12 osób i 480 prób szacuje się je pewniej niż zmienność nachyleń, choć SD osób też warto sprawdzić w literaturze.
- Efekt 38.3 ms – nie. Przedział od 10 do 67 ms pokazuje, że z 12 osób wiemy niewiele. Gdyby badanie główne planować tylko wtedy, gdy pilotaż „wyszedł” obiecująco, zadziała klątwa zwycięzcy. Albers i Lakens (2018) pokazują, że planowanie na podstawie efektów z małych pilotaży prowadzi do badań o zbyt małej mocy. Zamiast tego przyjmujemy najmniejszy interesujący efekt: 20 ms.
- SD nachyleń 18.3 ms i korelacja 1.00 – nie. Dopasowanie osobliwe oznacza, że danych było za mało, by oszacować tę część modelu (zob. model mieszany się nie zbiega). Przyjmujemy ostrożnie 40 ms i korelację .2, a wartość z pilotażu sprawdzimy w analizie wrażliwości.
Krok 2. Pętla symulacyjna
Pętla ma trzy elementy. Funkcja generuj() losuje dane z założonego modelu. Funkcja jedno_badanie() dopasowuje do nich ten sam model, który zapiszesz w planie analizy, i zwraca p dla efektu warunku. Funkcja moc_komorki() powtarza to R razy i liczy odsetek p < .05. Wartości p liczymy testem t z przybliżeniem Satterthwaite’a z pakietu lmerTest (Kuznetsova i in., 2017), bo w symulacjach Luke’a (2017) to podejście, obok Kenwarda–Rogera, najlepiej utrzymywało błąd I rodzaju na poziomie .05. Model dopasowuje funkcja lmer() z pakietu lme4 (Bates i in., 2015).
Dwa szczegóły techniczne. Opcja calc.derivs = FALSE wyłącza numeryczne sprawdzanie gradientu i przyspiesza tysiące dopasowań, ale nie odbiera informacji o dopasowaniu osobliwym, które zapisujemy osobno. Każda komórka siatki ma własne ziarno, więc wyniki nie zależą od liczby rdzeni użytych w mclapply().
Więcej osób czy więcej prób?
Siatka objęła 5 liczebności (20–100 osób) i 3 liczby prób w warunku (10, 20, 40), po 300 badań na komórkę. Przy 20 próbach w warunku moc wynosiła .260 dla 20 osób, .493 dla 40, .683 dla 60, .803 dla 80 i .893 dla 100. Średnie oszacowanie efektu we wszystkich komórkach mieściło się między 18.7 a 21.5 ms, czyli blisko prawdziwych 20 ms.
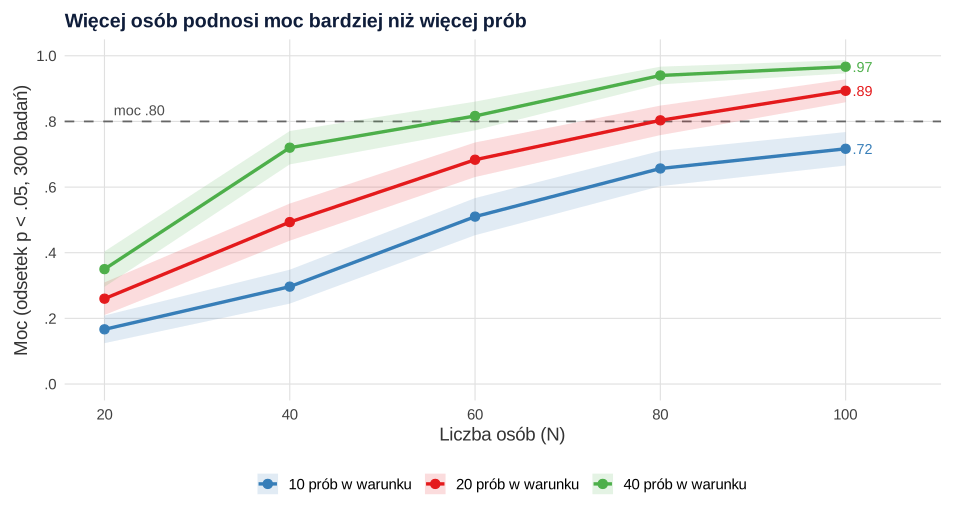
Dlaczego dodatkowe próby pomagają coraz mniej? Efekt warunku u jednej osoby ma wariancję 2σ²/k + τ², gdzie σ to SD reszt, k to liczba prób w warunku, a τ to SD nachyleń. Przy naszych parametrach wynosi ona 6100 dla 10 prób, 3850 dla 20 i 2725 dla 40. Nawet przy nieskończonej liczbie prób nie spadnie poniżej 1600, bo osoby naprawdę różnią się siłą efektu. Ten składnik zmniejsza tylko większa liczba osób. Dlatego przy wyraźnej zmienności nachyleń liczba osób ogranicza moc bardziej niż liczba prób.
Przy tej samej łącznej liczbie 3200 prób plan 80 osób × 20 prób w warunku ma moc .803, a plan 40 osób × 40 prób – .720. Plany o podobnej mocy też mogą się różnić kosztem: 80 × 20 (3200 prób, .803) albo 60 × 40 (4800 prób, .817). Pierwszy wymaga o jedną trzecią mniej prób, drugi o 20 osób mniej. Który jest tańszy, zależy od kosztu rekrutacji i od tego, jak szybko uczestnicy się męczą. Symulacja pozwala ten wybór policzyć zamiast zgadywać. Podobny wniosek dla nachyleń w czasie pokazuje wpis o badaniu podłużnym w doktoracie. W eksperymentach z bodźcami trzecim wymiarem siatki jest liczba bodźców (zob. efekty skrzyżowane uczestników i bodźców).
Siatka pokazuje też koszt małych planów. Przy 20 osobach i 10 próbach w warunku 30.7% dopasowań było osobliwych, a przy 100 osobach i 40 próbach – żadne. Jeśli w małych planach co trzeci model jest osobliwy, w badaniu głównym musisz mieć z góry ustaloną regułę upraszczania modelu, a w symulacji powinna działać ta sama reguła.
Moc licz dla modelu, który naprawdę dopasujesz
Kusi, by w symulacji (albo w badaniu) dopasować prostszy model z samym losowym wyrazem wolnym. Daje on wyższą „moc”, ale za cenę błędu I rodzaju. Przy efekcie 0 i 500 badaniach na warunek model z losowym nachyleniem i testem Satterthwaite’a odrzucał hipotezę zerową w 4.6% badań (20 osób) i 4.2% (40 osób). Ten sam model z testem z dawał 5.6% i 5.0%. Model bez losowego nachylenia – 13.2% i 12.8%. Błąd Monte Carlo odsetka .05 przy 500 powtórzeniach wynosi .010.
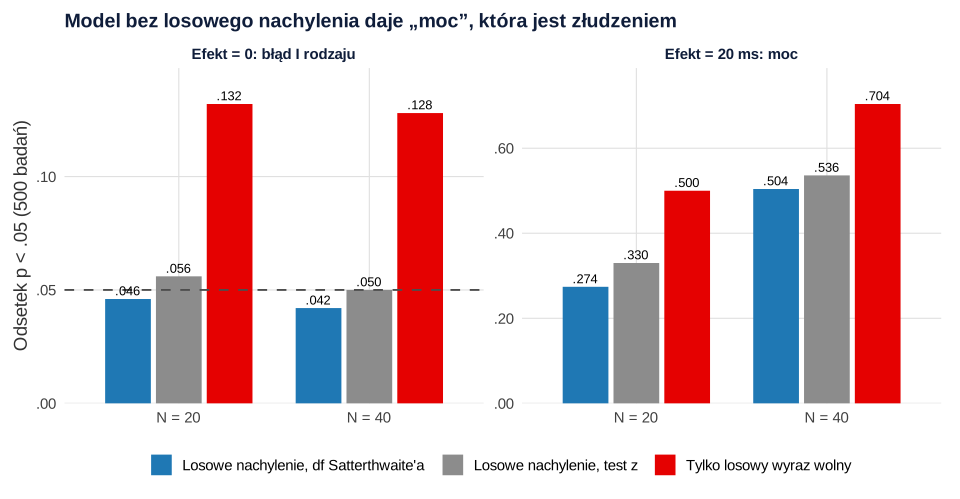
Przy 40 osobach model bez losowego nachylenia „miał” moc .704, a poprawny model .504. Ta różnica nie jest zyskiem, tylko skutkiem zbyt małych błędów standardowych, czyli formą pseudoreplikacji. Barr i in. (2013) pokazali, że modele z samymi losowymi wyrazami wolnymi uogólniają gorzej, gdy osoby różnią się wrażliwością na manipulację. Matuschek i in. (2017) dodają, że model maksymalny chroni przed zawyżeniem błędu I rodzaju, ale może obniżać moc. Dlatego strukturę efektów losowych ustal przed symulacją i stosuj tę samą w badaniu.
Niepewność Monte Carlo: ile powtórzeń?
Moc z symulacji to oszacowanie z błędem standardowym √(moc·(1 − moc)/R). Przy 300 powtórzeniach i mocy około .80 wynosi on około .023, więc 95% przedział ma szerokość prawie ±.05. To wystarcza do przeglądu siatki, ale nie do ostatecznej decyzji.
Dlatego dwa plany bliskie progu policzyliśmy ponownie na 1000 badaniach. Dla 80 osób i 20 prób w warunku moc wyniosła .826, 95% CI [.803, .849], a dla 90 osób – .835 [.812, .858]. Ten sam plan 90 osób w analizie wrażliwości (300 powtórzeń) dał .883. Tak bardzo mogą się różnić dwie symulacje z 300 powtórzeniami. Żeby połowa szerokości 95% przedziału dla mocy .80 wynosiła .02, potrzeba 1537 powtórzeń.
Praktyczna strategia: szybki przegląd siatki z 200–500 powtórzeniami, potem 1000–2000 powtórzeń tylko dla dwóch–trzech kandydatów. W raporcie podaj liczbę powtórzeń i przedział dla mocy.
Analiza wrażliwości: co, jeśli założenia są błędne?
Wynik symulacji zależy od założeń. Dla planu 90 osób × 20 prób sprawdziliśmy więc efekt od 10 do 30 ms i dwie wartości SD nachyleń: 20 ms (jak w pilotażu) i 40 ms (założenie ostrożne).
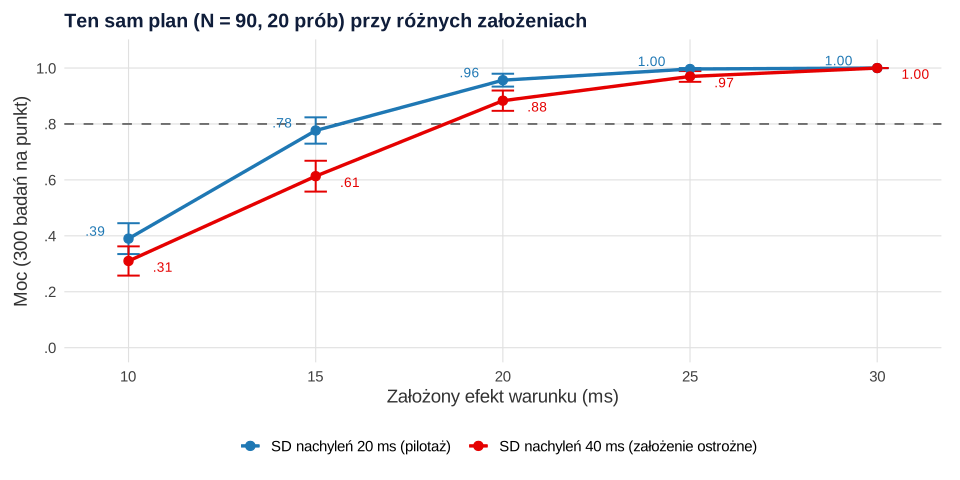
Przy efekcie 15 ms moc wynosi .613 przy założeniu ostrożnym i .777 przy SD nachyleń z pilotażu. Przy 10 ms – .310 i .390. Gdybyśmy uwierzyli pilotażowi, przeszacowalibyśmy moc. Gdyby prawdziwy efekt był o jedną czwartą mniejszy od najmniejszego interesującego, badanie miałoby moc około .6. Pokaż taką tabelę we wniosku grantowym: recenzent widzi wtedy, przy jakich założeniach plan działa.
Pakiet simr: to samo krócej
Green i MacLeod (2016) opisują pakiet simr, który szacuje moc dla modeli z lme4 symulacją Monte Carlo. Funkcja powerSim() liczy moc dla danego modelu i planu, powerCurve() rysuje krzywą mocy, a extend() powiększa plan o osoby albo próby. Model można zbudować z samych założeń funkcją makeLmer(). Na simr opierają się samouczki Arenda i Schäfera (2019) oraz Kumle i in. (2021).
Składnię pokazujemy w ostatnim przepisie niżej. Tego kodu nie uruchamialiśmy, więc nie podajemy wyników. Własna pętla jest dłuższa, ale daje pełną kontrolę nad generowaniem danych, metodą testu, zapisem dopasowań osobliwych i regułą upraszczania modelu. W simr zwróć uwagę, jaki test wybierasz. W przykładzie użyliśmy testu ilorazu wiarygodności, który według Luke’a (2017) bywa w małych próbach nieco liberalny.
Jak opisać analizę mocy w artykule lub wniosku
Opis powinien pozwolić odtworzyć symulację: model, źródło każdego parametru, efekt i jego uzasadnienie, test, liczbę powtórzeń, ziarno i wynik z niepewnością. Udostępnij kod razem z prerejestracją.
Jeśli chcesz, żeby ktoś sprawdził założenia symulacji albo przygotował ją do wniosku, zajrzyj do oferty analiz statystycznych dla badaczy.
Przykład w R
Cztery pierwsze przepisy uruchamiasz po kolei w jednej sesji R. Pierwszy zapisuje dane pilotażu do pliku moc-model-mieszany-pilotaz.csv (możesz go pobrać tutaj). Symulacje liczą się równolegle na czterech rdzeniach i trwają łącznie kilka minut. Piąty przepis to tylko przykład składni pakietu simr. Potrzebne pakiety: lme4, lmerTest i parallel (część R).
1. Pilotaż i parametry do symulacji
R
# Krok 1. Parametry z pilotażu (dane symulowane)
# Eksperyment wewnątrzosobowy: czas reakcji (ms) w zadaniu z bodźcami negatywnymi i neutralnymi.
# Każda osoba wykonuje k prób w każdym warunku; warunek kodowany −0.5 (neutralny) i +0.5 (negatywny).
suppressPackageStartupMessages({library(lme4); library(lmerTest)})

# Generator danych: losowy wyraz wolny osoby (sd_os), losowe nachylenie warunku (sd_nach),
# ich korelacja (rho) i błąd w obrębie osoby (sigma). Ten sam generator posłuży do symulacji mocy.
generuj <- function(N, k, efekt, sd_os, sd_nach, rho, sigma, b0) {
  z1 <- rnorm(N); z2 <- rnorm(N)
  u0 <- sd_os * z1                                   # różnice w ogólnym tempie
  u1 <- sd_nach * (rho * z1 + sqrt(1 - rho^2) * z2)  # różnice w sile efektu warunku
  d <- expand.grid(proba = 1:k, warunek = c(-0.5, 0.5), id = 1:N)
  d$czas <- b0 + u0[d$id] + (efekt + u1[d$id]) * d$warunek + rnorm(nrow(d), 0, sigma)
  d$id <- factor(d$id)
  d
}

# Pilotaż: 12 osób × 20 prób w każdym warunku
set.seed(3311)
pilotaz <- generuj(N = 12, k = 20, efekt = 25, sd_os = 80, sd_nach = 40, rho = .2, sigma = 150, b0 = 650)
pilotaz$czas <- round(pilotaz$czas)
write.csv(pilotaz, "moc-model-mieszany-pilotaz.csv", row.names = FALSE)

m_pilot <- lmer(czas ~ warunek + (1 + warunek | id), data = pilotaz)
round(summary(m_pilot)$coefficients, 3)              # efekty stałe, df Satterthwaite'a
round(confint(m_pilot, parm = "warunek", method = "Wald")[1, ], 1)   # 95% CI efektu warunku
print(VarCorr(m_pilot), comp = "Std.Dev.", digits = 3)
isSingular(m_pilot)

# Parametry do symulacji: wyraz wolny, SD osób i sigma z pilotażu (zaokrąglone do 10 ms).
# SD nachyleń z pilotażu (dopasowanie osobliwe, korelacja 1.00) jest niewiarygodne – przyjmujemy
# ostrożnie 40 ms, a wartość z pilotażu sprawdzimy w analizie wrażliwości (krok 4).
# Korelację efektów losowych ustalamy z góry, a efekt warunku to najmniejszy interesujący efekt
# (20 ms), a nie oszacowanie z pilotażu.
vc <- as.data.frame(VarCorr(m_pilot))
par_sym <- list(b0 = round(fixef(m_pilot)[[1]], -1),
                sd_os = round(vc$sdcor[vc$var1 == "(Intercept)" & is.na(vc$var2) & vc$grp == "id"], -1),
                sd_nach = 40,
                rho = .2,
                sigma = round(sigma(m_pilot), -1),
                efekt = 20)
sd_nach_pilot <- round(vc$sdcor[vc$var1 == "warunek" & is.na(vc$var2) & vc$grp == "id"], -1)
c(unlist(par_sym), sd_nach_pilot = sd_nach_pilot)
Wynik w R
boundary (singular) fit: see help('isSingular')
            Estimate Std. Error     df t value Pr(>|t|)
(Intercept)  628.002     21.845 11.001  28.748    0.000
warunek       38.312     14.450 38.717   2.651    0.012
 2.5 % 97.5 %
  10.0   66.6
 Groups   Name        Std.Dev. Corr
 id       (Intercept)  72.0
          warunek      18.3    1.00
 Residual             147.3
[1] TRUE
           b0         sd_os       sd_nach           rho         sigma
        630.0          70.0          40.0           0.2         150.0
        efekt sd_nach_pilot
         20.0          20.0
2. Pętla symulacyjna i siatka planów
R
# Krok 2. Pętla symulacyjna i siatka: liczba osób × liczba prób (wymaga obiektów z kroku 1)
library(parallel)
ster <- lmerControl(calc.derivs = FALSE)   # szybciej: bez numerycznego sprawdzania gradientu

# Jedno symulowane badanie: generujemy dane, dopasowujemy ZAPLANOWANY model i zapisujemy p
jedno_badanie <- function(N, k, efekt, par) {
  d <- generuj(N, k, efekt, par$sd_os, par$sd_nach, par$rho, par$sigma, par$b0)
  m <- tryCatch(suppressMessages(suppressWarnings(
         lmer(czas ~ warunek + (1 + warunek | id), data = d, control = ster))), error = function(e) NULL)
  if (is.null(m)) return(c(b = NA, p = NA, osobliwy = NA))
  wsp <- summary(m)$coefficients["warunek", ]
  c(b = wsp[["Estimate"]], p = wsp[["Pr(>|t|)"]], osobliwy = isSingular(m))
}

# Moc w jednej komórce siatki: R badań, własne ziarno komórki (wynik nie zależy od liczby rdzeni)
moc_komorki <- function(N, k, efekt, par, R, ziarno, alfa = .05) {
  set.seed(ziarno)
  w <- t(replicate(R, jedno_badanie(N, k, efekt, par)))
  ok <- !is.na(w[, "p"])
  moc <- mean(w[ok, "p"] < alfa)
  mcse <- sqrt(moc * (1 - moc) / sum(ok))           # błąd Monte Carlo oszacowania mocy
  c(N = N, k = k, efekt = efekt, R = sum(ok), moc = moc, mcse = mcse,
    dolna = max(0, moc - 1.96 * mcse), gorna = min(1, moc + 1.96 * mcse),
    sr_b = mean(w[ok, "b"]), osobliwe = mean(w[ok, "osobliwy"]))
}

siatka <- expand.grid(N = c(20, 40, 60, 80, 100), k = c(10, 20, 40))
R_siatka <- 300                                      # mało powtórzeń: szybki przegląd siatki
czas_start <- Sys.time()
wyniki <- mclapply(seq_len(nrow(siatka)), function(i)      # na Windows ustaw mc.cores = 1
  moc_komorki(siatka$N[i], siatka$k[i], par_sym$efekt, par_sym, R_siatka, ziarno = 33120 + i),
  mc.cores = 4)
moc_siatka <- as.data.frame(do.call(rbind, wyniki))
moc_siatka$proby_lacznie <- moc_siatka$N * 2 * moc_siatka$k   # liczba wszystkich prób w badaniu
write.csv(moc_siatka, "moc-siatka.csv", row.names = FALSE)
print(round(moc_siatka[, c("N", "k", "proby_lacznie", "moc", "mcse", "dolna", "gorna", "sr_b", "osobliwe")], 3), row.names = FALSE)
# Wariancja efektu warunku u jednej osoby: 2σ²/k + SD nachyleń² – więcej prób zmniejsza tylko pierwszy składnik
round(sapply(c(k10 = 10, k20 = 20, k40 = 40, k_nieskonczonosc = Inf),
             function(k) 2 * par_sym$sigma^2 / k + par_sym$sd_nach^2))
cat("Czas obliczeń (min):", round(as.numeric(difftime(Sys.time(), czas_start, units = "mins")), 1), "\n")
Wynik w R
   N  k proby_lacznie   moc  mcse dolna gorna   sr_b osobliwe
  20 10           400 0.167 0.022 0.124 0.209 18.862    0.307
  40 10           800 0.297 0.026 0.245 0.348 18.729    0.163
  60 10          1200 0.510 0.029 0.453 0.567 20.370    0.120
  80 10          1600 0.657 0.027 0.603 0.710 20.666    0.063
 100 10          2000 0.717 0.026 0.666 0.768 20.290    0.020
  20 20           800 0.260 0.025 0.210 0.310 19.502    0.087
  40 20          1600 0.493 0.029 0.437 0.550 20.471    0.010
  60 20          2400 0.683 0.027 0.631 0.736 19.889    0.003
  80 20          3200 0.803 0.023 0.758 0.848 19.724    0.007
 100 20          4000 0.893 0.018 0.858 0.928 19.894    0.000
  20 40          1600 0.350 0.028 0.296 0.404 19.550    0.027
  40 40          3200 0.720 0.026 0.669 0.771 21.464    0.000
  60 40          4800 0.817 0.022 0.773 0.860 19.733    0.000
  80 40          6400 0.940 0.014 0.913 0.967 20.073    0.000
 100 40          8000 0.967 0.010 0.946 0.987 19.867    0.000
             k10              k20              k40 k_nieskonczonosc
            6100             3850             2725             1600
Czas obliczeń (min): 1.4
3. Błąd I rodzaju i model bez losowego nachylenia
R
# Krok 3. Ta sama pętla przy efekcie 0: błąd I rodzaju i „moc” modelu bez losowego nachylenia
# (wymaga obiektów z kroków 1–2)
trzy_analizy <- function(N, k, efekt, par) {
  d <- generuj(N, k, efekt, par$sd_os, par$sd_nach, par$rho, par$sigma, par$b0)
  m1 <- suppressMessages(suppressWarnings(lmer(czas ~ warunek + (1 + warunek | id), data = d, control = ster)))
  m0 <- suppressMessages(suppressWarnings(lmer(czas ~ warunek + (1 | id), data = d, control = ster)))
  w1 <- summary(m1)$coefficients["warunek", ]
  c(nachylenie_Satterthwaite = w1[["Pr(>|t|)"]],
    nachylenie_z = 2 * pnorm(-abs(w1[["t value"]])),      # statystyka t traktowana jak z
    tylko_wyraz_wolny = summary(m0)$coefficients["warunek", "Pr(>|t|)"])
}
warunki <- expand.grid(efekt = c(0, 20), N = c(20, 40), k = 20)
R_typ1 <- 500
wyniki3 <- mclapply(seq_len(nrow(warunki)), function(i) {
  set.seed(33130 + i)
  p <- t(replicate(R_typ1, trzy_analizy(warunki$N[i], warunki$k[i], warunki$efekt[i], par_sym)))
  colMeans(p < .05)
}, mc.cores = 4)
odrzucenia <- cbind(warunki, round(do.call(rbind, wyniki3), 3))
print(odrzucenia, row.names = FALSE)
# Błąd Monte Carlo odsetka .05 przy 500 powtórzeniach:
round(sqrt(.05 * .95 / R_typ1), 3)
Wynik w R
 efekt  N  k nachylenie_Satterthwaite nachylenie_z tylko_wyraz_wolny
     0 20 20                    0.046        0.056             0.132
    20 20 20                    0.274        0.330             0.500
     0 40 20                    0.042        0.050             0.128
    20 40 20                    0.504        0.536             0.704
[1] 0.01
4. Doprecyzowanie planu i analiza wrażliwości
R
# Krok 4. Doprecyzowanie wybranego planu i analiza wrażliwości (wymaga obiektów z kroków 1–2)
# a) 1000 powtórzeń dla planów z k = 20 próbami w warunku, które w siatce były blisko mocy .80
dokladnie <- do.call(rbind, mclapply(1:2, function(i)
  moc_komorki(c(80, 90)[i], 20, par_sym$efekt, par_sym, R = 1000, ziarno = 33140 + i), mc.cores = 2))
print(round(dokladnie[, c("N", "k", "R", "moc", "mcse", "dolna", "gorna")], 3), row.names = FALSE)

# b) Wrażliwość: plan N = 90, k = 20, efekt 10–30 ms, SD nachyleń 20 (pilotaż) albo 40 ms (założenie)
wr <- expand.grid(efekt = c(10, 15, 20, 25, 30), sd_nach = c(20, 40))
wyniki4 <- mclapply(seq_len(nrow(wr)), function(i) {
  p <- par_sym; p$sd_nach <- wr$sd_nach[i]
  moc_komorki(90, 20, wr$efekt[i], p, R = 300, ziarno = 33150 + i)
}, mc.cores = 4)
wrazliwosc <- cbind(sd_nach = wr$sd_nach, as.data.frame(do.call(rbind, wyniki4)))
write.csv(wrazliwosc, "moc-wrazliwosc.csv", row.names = FALSE)
print(round(wrazliwosc[, c("sd_nach", "efekt", "moc", "mcse")], 3), row.names = FALSE)

# Ile powtórzeń, żeby połowa szerokości 95% przedziału dla mocy .80 wynosiła 0.02?
ceiling(1.96^2 * .8 * .2 / .02^2)
Wynik w R
      N  k    R   moc  mcse dolna gorna
[1,] 80 20 1000 0.826 0.012 0.803 0.849
[2,] 90 20 1000 0.835 0.012 0.812 0.858
 sd_nach efekt   moc  mcse
      20    10 0.390 0.028
      20    15 0.777 0.024
      20    20 0.957 0.012
      20    25 0.997 0.003
      20    30 1.000 0.000
      40    10 0.310 0.027
      40    15 0.613 0.028
      40    20 0.883 0.019
      40    25 0.970 0.010
      40    30 1.000 0.000
[1] 1537
5. Ten sam plan w pakiecie simr (składnia, kod nieuruchamiany)
R
# Ten sam plan w pakiecie simr – przykład składni. Kodu nie uruchamialiśmy, więc nie ma wyników.
library(simr)

# a) Model zbudowany z założeń, bez danych: 20 osób × 20 prób w każdym warunku
plan <- expand.grid(proba = 1:20, warunek = c(-0.5, 0.5), id = factor(1:20))
V <- matrix(c(70^2, .2 * 70 * 40, .2 * 70 * 40, 40^2), 2)     # SD osób 70, SD nachyleń 40, korelacja .2
m_plan <- makeLmer(czas ~ warunek + (1 + warunek | id), fixef = c(630, 20),
                   VarCorr = list(V), sigma = 150, data = plan)

# b) Moc dla 20 osób: 300 symulowanych badań, test ilorazu wiarygodności efektu warunku
powerSim(m_plan, test = fixed("warunek", "lr"), nsim = 300)

# c) Krzywa mocy względem liczby osób: najpierw powiększ plan do 100 osób
m_100 <- extend(m_plan, along = "id", n = 100)
powerCurve(m_100, test = fixed("warunek", "lr"), along = "id",
           breaks = c(20, 40, 60, 80, 100), nsim = 300)

# d) Więcej prób zamiast więcej osób: 40 wierszy w każdej kombinacji osoba × warunek
m_40prob <- extend(m_plan, within = "id+warunek", n = 40)
powerSim(m_40prob, test = fixed("warunek", "lr"), nsim = 300)

# e) Model dopasowany do pilotażu: efekt warunku zastąp najmniejszym interesującym efektem
# fixef(m_pilot)["warunek"] <- 20
# powerSim(extend(m_pilot, along = "id", n = 80), test = fixed("warunek", "lr"), nsim = 300)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–4 w R 4.5.3 z pakietami lme4 i lmerTest (obliczenia równoległe: pakiet parallel z dystrybucji R); rysunki przygotowano w pakiecie ggplot2. Kodu pakietu simr nie uruchamialiśmy.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Efekt z pilotażu jako założenie. Mały pilotaż daje bardzo niepewny efekt. Planuj na najmniejszy interesujący efekt i pokaż wrażliwość.
- Prostszy model w symulacji niż w analizie. Model bez losowych nachyleń zawyża moc, bo zawyża błąd I rodzaju. Symuluj dokładnie tę analizę, którą prerejestrujesz.
- Zbyt mało powtórzeń przy decyzji. 300 powtórzeń wystarczy do przeglądu, ale nie do wyboru między planami różniącymi się o .03 mocy.
- Pominięcie dopasowań osobliwych. Zapisuj ich odsetek. Jeśli jest wysoki, plan jest za mały albo potrzebna jest reguła upraszczania modelu.
- Zwiększanie tylko liczby prób. Gdy osoby różnią się siłą efektu, moc ogranicza liczba osób.
- Moc obserwowana po badaniu. Symulacja z efektem oszacowanym w gotowych danych to analiza mocy post hoc, która niczego nie dodaje do wartości p.
Najczęstsze pytania
Jak zrobić analizę mocy dla modelu mieszanego w R?
Napisz funkcję, która losuje dane z założonego modelu (efekty stałe, SD efektów losowych, SD reszt), dopasuj do nich ten sam model lmer(), który zaplanowałeś, i zapisz p dla efektu. Powtórz to kilkaset razy dla każdego planu z siatki i policz odsetek p < .05. To samo krócej zrobisz pakietem simr (powerSim(), powerCurve()).
Czy w modelu mieszanym lepiej dodać osoby czy próby?
Zależy od zmienności efektu między osobami. Wariancja efektu u jednej osoby to 2σ²/k + τ², a więcej prób zmniejsza tylko pierwszy składnik. W przykładzie przy tej samej liczbie 3200 prób plan 80 osób × 20 prób miał moc .803, a 40 osób × 40 prób – .720.
Czy mogę wziąć wielkość efektu z pilotażu do symulacji mocy?
Lepiej nie. Efekt z kilkunastu osób jest bardzo niepewny: w przykładzie pilotaż dał 38.3 ms, 95% CI [10.0, 66.6]. Z pilotażu bierz wariancje, a efekt ustal jako najmniejszy interesujący i dodaj analizę wrażliwości.
Ile powtórzeń potrzeba w symulacyjnej analizie mocy modelu mieszanego?
Do przeglądu siatki wystarczy 200–500 powtórzeń na komórkę. Do decyzji policz 1000–2000 powtórzeń dla kilku kandydatów. Błąd Monte Carlo to √(moc·(1 − moc)/R), więc dla przedziału ±.02 przy mocy .80 potrzeba 1537 powtórzeń.
Czy simr i własna pętla dają to samo?
Przy tym samym modelu, teście i liczbie powtórzeń powinny dawać zbliżone wyniki z dokładnością do błędu Monte Carlo. Własna pętla daje więcej kontroli: wybór testu (np. Satterthwaite), zapis dopasowań osobliwych i reguł upraszczania modelu. W simr sprawdź, jaki test wybierasz, bo test ilorazu wiarygodności bywa w małych próbach liberalny.
Powiązane hasła
Przeczytaj też
Model mieszany (MIXED) w SPSS krok po kroku
Linear Mixed Models od pliku w formacie długim po opis APA: Subjects i Repeated, losowy wyraz wolny, ICC, struktury AR(1), CS i UN, średnie brzegowe i składnia MIXED – na przykładzie dwóch grup i trzech pomiarów z brakami.
Czytaj →PoradnikModel mieszany się nie zbiega – singular fit
Skalowanie, gradient względny, allFit, rePCA, model bez korelacji i upraszczanie efektów losowych – procedura na jednym przykładzie w R.
Czytaj →PoradnikLiczebność próby do SEM – symulacja Monte Carlo
Model populacyjny, simulateData() i pętla w lavaan: moc dla wybranej ścieżki, zbieżność, rozwiązania niewłaściwe, krzywa mocy i wzór opisu.
Czytaj →PoradnikEfekty skrzyżowane: uczestnicy × bodźce
Skrzyżowane efekty losowe osób i bodźców w lme4, maksymalna struktura, symulacja błędu I rodzaju, moc zależna od liczby bodźców i opis APA.
Czytaj →Potrzebujesz analizy mocy dla modelu mieszanego do wniosku lub prerejestracji?
Pomożemy dobrać założenia, przygotować i sprawdzić symulację mocy oraz jej opis tak, żebyś mógł(a) samodzielnie uzasadnić liczebność próby przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Albers, C., & Lakens, D. (2018). When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias. Journal of Experimental Social Psychology, 74, 187–195. https://doi.org/10.1016/j.jesp.2017.09.004 ● Otwarty dostęp
- Arend, M. G., & Schäfer, T. (2019). Statistical power in two-level models: A tutorial based on Monte Carlo simulation. Psychological Methods, 24(1), 1–19. https://doi.org/10.1037/met0000195
- Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001 ● Otwarty dostęp: pełny tekst
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Green, P., & MacLeod, C. J. (2016). SIMR: An R package for power analysis of generalized linear mixed models by simulation. Methods in Ecology and Evolution, 7(4), 493–498. https://doi.org/10.1111/2041-210x.12504
- Kumle, L., Võ, M. L.-H., & Draschkow, D. (2021). Estimating power in (generalized) linear mixed models: An open introduction and tutorial in R. Behavior Research Methods, 53(6), 2528–2543. https://doi.org/10.3758/s13428-021-01546-0 ● Otwarty dostęp
- Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13 ● Otwarty dostęp
- Luke, S. G. (2017). Evaluating significance in linear mixed-effects models in R. Behavior Research Methods, 49(4), 1494–1502. https://doi.org/10.3758/s13428-016-0809-y ● Otwarty dostęp
- Matuschek, H., Kliegl, R., Vasishth, S., Baayen, H., & Bates, D. (2017). Balancing Type I error and power in linear mixed models. Journal of Memory and Language, 94, 305–315. https://doi.org/10.1016/j.jml.2017.01.001 ● Otwarty dostęp
- Morris, T. P., White, I. R., & Crowther, M. J. (2019). Using simulation studies to evaluate statistical methods. Statistics in Medicine, 38(11), 2074–2102. https://doi.org/10.1002/sim.8086 ● Otwarty dostęp
Cytowania BibTeX
@article{albers2018power, author={Albers, Casper and Lakens, Daniël}, title={{When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={74}, pages={187--195}, doi={10.1016/j.jesp.2017.09.004}}@article{arend2019statistical, author={Arend, Matthias G. and Schäfer, Thomas}, title={{Statistical power in two-level models: A tutorial based on Monte Carlo simulation}}, journal={Psychological Methods}, year={2019}, volume={24}, number={1}, pages={1--19}, doi={10.1037/met0000195}}@article{barr2013random, author={Barr, Dale J. and Levy, Roger and Scheepers, Christoph and Tily, Harry J.}, title={{Random effects structure for confirmatory hypothesis testing: Keep it maximal}}, journal={Journal of Memory and Language}, year={2013}, volume={68}, number={3}, pages={255--278}, doi={10.1016/j.jml.2012.11.001}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{green2016simr, author={Green, Peter and MacLeod, Catriona J.}, title={{SIMR: An R package for power analysis of generalized linear mixed models by simulation}}, journal={Methods in Ecology and Evolution}, year={2016}, volume={7}, number={4}, pages={493--498}, doi={10.1111/2041-210x.12504}}@article{kumle2021estimating, author={Kumle, Levi and Võ, Melissa L.-H. and Draschkow, Dejan}, title={{Estimating power in (generalized) linear mixed models: An open introduction and tutorial in R}}, journal={Behavior Research Methods}, year={2021}, volume={53}, number={6}, pages={2528--2543}, doi={10.3758/s13428-021-01546-0}}@article{kuznetsova2017lmertest, author={Kuznetsova, Alexandra and Brockhoff, Per B. and Christensen, Rune H. B.}, title={{lmerTest package: Tests in linear mixed effects models}}, journal={Journal of Statistical Software}, year={2017}, volume={82}, number={13}, pages={1--26}, doi={10.18637/jss.v082.i13}}@article{luke2017evaluating, author={Luke, Steven G.}, title={{Evaluating significance in linear mixed-effects models in R}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={4}, pages={1494--1502}, doi={10.3758/s13428-016-0809-y}}@article{matuschek2017balancing, author={Matuschek, Hannes and Kliegl, Reinhold and Vasishth, Shravan and Baayen, Harald and Bates, Douglas}, title={{Balancing Type I error and power in linear mixed models}}, journal={Journal of Memory and Language}, year={2017}, volume={94}, pages={305--315}, doi={10.1016/j.jml.2017.01.001}}@article{morris2019using, author={Morris, Tim P. and White, Ian R. and Crowther, Michael J.}, title={{Using simulation studies to evaluate statistical methods}}, journal={Statistics in Medicine}, year={2019}, volume={38}, number={11}, pages={2074--2102}, doi={10.1002/sim.8086}}