Co to jest klątwa zwycięzcy?
Klątwa zwycięzcy (ang. winner’s curse) to zawyżenie efektu, który „wygrał” selekcję – przekroczył próg istotności albo okazał się najsilniejszy spośród wielu badanych. Wybór następuje na podstawie oszacowania, które zawiera prawdziwy efekt i błąd losowy. Zwycięża więc zwykle ten wynik, któremu los dodał najwięcej, a w kolejnym badaniu ta przewaga znika. Ioannidis (2008) pokazuje, że gdy odkrycie ogłasza się po przekroczeniu progu istotności w badaniu o niskiej mocy, zaobserwowany efekt powinien być zawyżony – od wcześnie przerwanych badań klinicznych po badania asocjacyjne całego genomu.
Przykład w R
Badacz sprawdza 20 predyktorów satysfakcji z pracy na 100 osobach. Każdy ma w populacji tę samą korelację r = .10. W 5000 symulowanych badaniach średnia korelacja wszystkich predyktorów wyniosła .100, ale „zwycięzca” – najsilniejszy predyktor – miał średnio r = .284, a w 97.7% badań był istotny. W niezależnej replikacji z tą samą liczebnością ten sam predyktor dawał średnio r = .100. Nie wybrano go dlatego, że był ważniejszy, tylko dlatego, że miał szczęście.
Na rysunku
Rysunek pokazuje przykład z 20 predyktorami jako dwa histogramy: korelację „zwycięzcy” w każdym z 5000 badań odkrywczych i korelację tego samego predyktora w niezależnej replikacji.
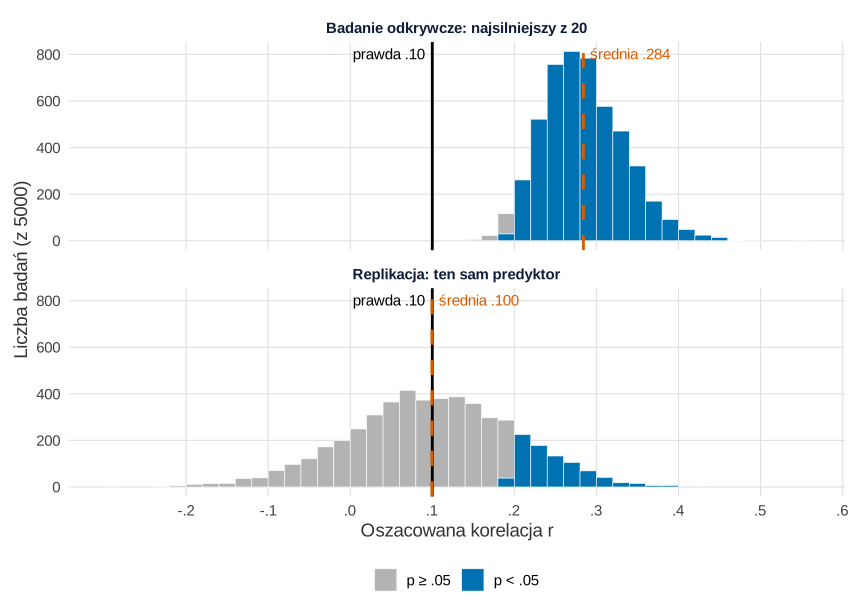
set.seed(527)).Co widać. Górny histogram w ogóle nie obejmuje prawdy: zwycięzca miał średnio r = .284 i w 97.7% badań był istotny (błąd Monte Carlo 0.2 pp). Dolny histogram to ten sam predyktor zmierzony od nowa – średnia spada do .100, a istotny jest już tylko w 16.7% replikacji (błąd MC 0.5 pp), czyli tak często, jak pozwala moc testu dla r = .10 przy 100 osobach. Selekcja nie zmieniła predyktora, tylko wybrała badanie, w którym błąd losowy dodał najwięcej.
Na co uważać. W symulacji wszystkie predyktory są jednakowo ważne, więc całe zawyżenie wynika z wyboru. W prawdziwych danych zwycięzca bywa naprawdę silniejszy od reszty, ale z jednego badania nie da się odróżnić, ile z jego przewagi to efekt, a ile szczęście. Wykres nie pokazuje też, jak klątwa rośnie z liczbą kandydatów i maleje z liczebnością próby. Wersję z jednym efektem (d = 0.3) i progiem istotności zamiast wyboru najlepszego pokazuje wpis Moc testu w obrazkach.
Podpis do pracy (np. w aneksie uzasadniającym replikację):
Kod powtarza symulację z przykładu (to samo ziarno 527, ustalone raz i niezmieniane, ta sama kolejność losowań), więc średnie są identyczne. Liczba predyktorów, liczebność i korelacja .10 to ręcznie przyjęte założenia przykładu. Kod liczy się w około sekundę. Rysunek na stronie różni się od wyniku kodu tylko motywem (krój i kolor czcionki, siatka).
R – kod rysunku
# Rysunek 1. Korelacja „zwycięzcy” w badaniu odkrywczym i tego samego predyktora w replikacji
# Symulacja jak w przykładzie z hasła: 20 predyktorów o prawdziwym r = .10, n = 100, 5000 powtórzeń
library(ggplot2)
set.seed(527)
k <- 20; n <- 100; b <- 0.10; R <- 5000
badanie <- function(n) {
  x <- matrix(rnorm(n * k), n, k)
  y <- x %*% rep(b, k) + rnorm(n, sd = sqrt(0.8))
  cor(x, y)[, 1]
}
w <- t(replicate(R, {
  r1 <- badanie(n); j <- which.max(r1); r2 <- badanie(n)
  c(odkrycie = r1[j], replikacja = r2[j])
}))
prog <- 0.197                                      # r istotne przy p < .05 (n = 100)
round(colMeans(w), 3)                              # średnie: zwycięzca vs replikacja
round(apply(w, 2, sd) / sqrt(R), 4)                # błąd Monte Carlo średnich
ist <- colMeans(w > prog)
round(rbind(odsetek_istotnych = ist, blad_MC = sqrt(ist * (1 - ist) / R)), 3)

d <- data.frame(r = c(w), etap = factor(rep(c("Badanie odkrywcze: najsilniejszy z 20", "Replikacja: ten sam predyktor"),
                                            each = R), levels = c("Badanie odkrywcze: najsilniejszy z 20", "Replikacja: ten sam predyktor")))
d$istotny <- factor(ifelse(d$r > prog, "p < .05", "p ≥ .05"), levels = c("p ≥ .05", "p < .05"))
sr <- data.frame(etap = levels(d$etap), m = colMeans(w))
motyw <- theme_minimal(base_size = 14) + theme(legend.position = "bottom", panel.grid.minor = element_blank())
p1 <- ggplot(d, aes(r, fill = istotny)) +
  geom_histogram(binwidth = 0.02, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = b, linewidth = 1, colour = "black") +
  geom_vline(data = sr, aes(xintercept = m), linewidth = 1, linetype = "dashed", colour = "#D55E00") +
  geom_text(data = sr, aes(x = m, y = Inf, label = sub("0\\.", ".", sprintf("średnia %.3f", m))), vjust = 1.6, hjust = -0.08,
            size = 4, colour = "#D55E00", inherit.aes = FALSE) +
  annotate("text", x = b, y = Inf, label = "prawda .10", vjust = 1.6, hjust = 1.1, size = 4) +
  facet_wrap(~ etap, ncol = 1) +
  scale_fill_manual(values = c("p ≥ .05" = "grey70", "p < .05" = "#0072B2"), name = NULL) +
  scale_x_continuous(breaks = seq(-0.2, 0.6, 0.1), labels = function(x) sub("^(-?)0\\.", "\\1.", sprintf("%.1f", x))) +
  labs(x = "Oszacowana korelacja r", y = "Liczba badań (z 5000)") +
  motyw
p1   # zapis: ggsave("klatwa-zwyciezcy-odkrycie-replikacja.svg", p1, width = 9, height = 6.4)
Wynik w R
  odkrycie replikacja
     0.284      0.100
  odkrycie replikacja
    0.0007     0.0014
                  odkrycie replikacja
odsetek_istotnych    0.977      0.167
blad_MC              0.002      0.005
Związek z pokrewnymi pojęciami
- Błąd typu M (Gelman i Carlin, 2014) mierzy skalę tego samego zjawiska dla progu istotności: ile razy wynik istotny jest średnio większy od prawdy.
- Moc testu. Button i in. (2013) wskazują, że niska moc prowadzi do zawyżonych oszacowań efektu i niskiej replikowalności.
- Regresja do średniej to ten sam mechanizm na poziomie osób: skrajny wynik w pierwszym pomiarze zwykle słabnie w drugim.
- Błąd publikacji wzmacnia klątwę, bo do druku trafiają głównie zwycięzcy.
Jak się bronić
- Traktuj efekt z pierwszego badania jako górną granicę; nie planuj na nim liczebności replikacji.
- Sprawdzaj wybrany predyktor w niezależnej próbie albo zastosuj walidację krzyżową.
- Raportuj wszystkie badane zmienne, nie tylko zwycięzców – ułatwia to prerejestracja.
Jak opisać w pracy
Klątwa zwycięzcy w R
Kod symuluje 5000 badań odkrywczych z 20 predyktorami o tej samej prawdziwej korelacji r = .10, wybiera w każdym najsilniejszy predyktor i sprawdza go w niezależnej replikacji o tej samej liczebności.
Wybór najsilniejszego predyktora i replikacja
R
# Klątwa zwycięzcy: 20 predyktorów, każdy o prawdziwej korelacji r = .10 z wynikiem
set.seed(527)
k <- 20; n <- 100; b <- 0.10            # var(y) = 20 * 0.01 + 0.8 = 1, więc r = .10
badanie <- function(n) {
  x <- matrix(rnorm(n * k), n, k)
  y <- x %*% rep(b, k) + rnorm(n, sd = sqrt(0.8))
  cor(x, y)[, 1]
}
wyniki <- t(replicate(5000, {
  r1 <- badanie(n)                      # badanie odkrywcze
  j <- which.max(r1)                    # „zwycięzca”: najsilniejszy predyktor
  r2 <- badanie(n)                      # niezależna replikacja, ta sama n
  c(wszystkie = mean(r1), zwyciezca = r1[j], replikacja = r2[j],
    istotny = r1[j] > 0.197)  # .197 = próg p < .05 dla n = 100
}))
round(colMeans(wyniki), 3)
Wynik w R
 wszystkie  zwyciezca replikacja    istotny
     0.100      0.284      0.100      0.977
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bez dodatkowych pakietów); Rysunek 1 narysowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czy klątwa zwycięzcy oznacza, że efekt nie istnieje?
Nie. W przykładzie każdy predyktor miał prawdziwą korelację r = .10. Klątwa dotyczy wielkości: wybrany efekt istnieje, ale jest mniejszy, niż pokazało badanie, w którym go wybrano.
Dlaczego replikacja daje mniejszy efekt niż oryginał?
Bo w replikacji nikt nie wybiera wyniku na podstawie jego wartości. Błąd losowy, który pomógł zwycięzcy w pierwszym badaniu, w drugim jest niezależny, więc oszacowanie wraca średnio do prawdziwego efektu.
Czy duża próba usuwa klątwę zwycięzcy?
Zmniejsza ją, bo mniejszy błąd losowy oznacza mniejszą przewagę wynikającą ze szczęścia. Przy wielu kandydatach i selekcji najsilniejszego wyniku pewne zawyżenie zostaje, dlatego potrzebna jest niezależna replikacja.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Moc testu w obrazkach
Pola α, β i mocy na dwóch rozkładach, krzywe mocy z symulacją, klątwa zwycięzcy przy niskiej mocy i moc po fakcie – pięć rysunków z kodem R.
Czytaj →PoradnikJak zaplanować badanie replikacyjne
Rodzaj replikacji, materiały od autorów, liczebność przy zawyżonym efekcie, kryteria sukcesu i protokół registered report z kodem w R.
Czytaj →PoradnikTest A/B z wieloma wariantami
Pięć tematów maila i kontrola: Dunnett, Holm i Tukey, klątwa zwycięzcy w 1000 symulacji, test potwierdzający i moc – pięć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Button, K. S., Ioannidis, J. P. A., Mokrysz, C., Nosek, B. A., Flint, J., Robinson, E. S. J., & Munafò, M. R. (2013). Power failure: Why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, 14(5), 365–376. https://doi.org/10.1038/nrn3475 ● Otwarty dostęp
- Gelman, A., & Carlin, J. (2014). Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors. Perspectives on Psychological Science, 9(6), 641–651. https://doi.org/10.1177/1745691614551642
- Ioannidis, J. P. A. (2008). Why most discovered true associations are inflated. Epidemiology, 19(5), 640–648. https://doi.org/10.1097/ede.0b013e31818131e7
Cytowania BibTeX
@article{button2013power, author={Button, Katherine S. and Ioannidis, John P. A. and Mokrysz, Claire and Nosek, Brian A. and Flint, Jonathan and Robinson, Emma S. J. and Munafò, Marcus R.}, title={{Power failure: Why small sample size undermines the reliability of neuroscience}}, journal={Nature Reviews Neuroscience}, year={2013}, volume={14}, number={5}, pages={365--376}, doi={10.1038/nrn3475}}@article{gelman2014beyond, author={Gelman, Andrew and Carlin, John}, title={{Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors}}, journal={Perspectives on Psychological Science}, year={2014}, volume={9}, number={6}, pages={641--651}, doi={10.1177/1745691614551642}}@article{ioannidis2008why, author={Ioannidis, John P. A.}, title={{Why most discovered true associations are inflated}}, journal={Epidemiology}, year={2008}, volume={19}, number={5}, pages={640--648}, doi={10.1097/ede.0b013e31818131e7}}