Replikacja to osobny projekt, nie powtórka
Chcesz sprawdzić, czy opublikowany efekt się powtarza. Definicje i dane o skali problemu znajdziesz w hasłach replikowalność i kryzys replikacyjny w psychologii. Ten wpis dotyczy planowania. Decyzje trzeba podjąć, zanim zbierzesz pierwsze dane: jaki rodzaj replikacji, jakie materiały, ile osób, co uznasz za sukces i jak to zarejestrujesz.
Powód jest prosty. Po zebraniu danych każdą decyzję można podjąć „pod wynik”. Wybierzesz wtedy kryterium, które daje wygodny werdykt. W projekcie Open Science Collaboration (2015) efekty w replikacjach były średnio o połowę mniejsze niż w oryginałach. Przy takim spadku różne kryteria często dają różne werdykty dla tej samej pary badań. Dlatego cały plan zapisz z góry.
Krok 1. Bezpośrednia czy konceptualna
Najpierw określ, o co pytasz. Replikacja bezpośrednia (bliska) odtwarza procedurę, materiały i analizę na nowej próbie i sprawdza, czy efekt w ogóle istnieje. Replikacja konceptualna testuje tę samą hipotezę inną operacjonalizacją, więc sprawdza, czy efekt nie zależy od jednej metody. Zwaan i in. (2018) przeglądają rodzaje replikacji i odpowiadają na zarzuty wobec replikacji bezpośrednich. Wniosek autorów: nie ma teoretycznych ani statystycznych przeszkód, by replikacje bezpośrednie wykonywać rutynowo.
Nieudana replikacja konceptualna jest trudna do zinterpretowania. Nie wiadomo, czy efektu nie ma, czy nowa operacjonalizacja mierzy coś innego. Jeśli efekt nie był jeszcze replikowany bezpośrednio, zacznij od replikacji bliskiej. Brandt i in. (2014) zaproponowali „Replication Recipe”, czyli standardowe kryteria przekonującej bliskiej replikacji. Na jego podstawie przygotuj tabelę różnic, którą dołączysz do protokołu:
| Element | Oryginał | Replikacja | Czy różnica może zmienić efekt? |
|---|---|---|---|
| Populacja i rekrutacja | np. studenci, laboratorium | np. studenci z dwóch uczelni | uzasadnij |
| Manipulacja i materiały | oryginalne instrukcje | tłumaczenie, test zrozumienia | uzasadnij |
| Pomiar wyniku | skala, wersja, punktacja | ta sama lub adaptacja | uzasadnij |
| Wykluczenia i analiza | reguły z artykułu | te same plus nowe, zapisane osobno | uzasadnij |
Krok 2. Kontakt z autorami i materiały
Napisz do autorów oryginału, zanim zamkniesz protokół. Poproś o instrukcje, bodźce, kod programu eksperymentalnego, dokładne reguły wykluczeń, skrypt analizy i, jeśli to możliwe, dane. Część z tego bywa w materiałach uzupełniających albo w pakiecie replikacyjnym. Zapytaj też, jakie warunki uważają za konieczne do wystąpienia efektu. Odpowiedź zapisz w protokole. Wtedy po nieudanej replikacji nikt nie powie, że „zrobiono inaczej”, skoro autorzy zaakceptowali procedurę z góry.
- Brak odpowiedzi to też informacja. Zapisz datę prośby i to, czego nie udało się uzyskać.
- Kwestionariusze mogą być objęte licencją. Sprawdź warunki użycia i tłumaczenia przed rozpoczęciem badania.
- Odtwórz najpierw wynik oryginału z udostępnionych danych. Jeśli liczby się nie zgadzają, masz problem z odtwarzalnością, a nie z replikacją.
Krok 3. Liczebność: w jaki efekt uwierzyć
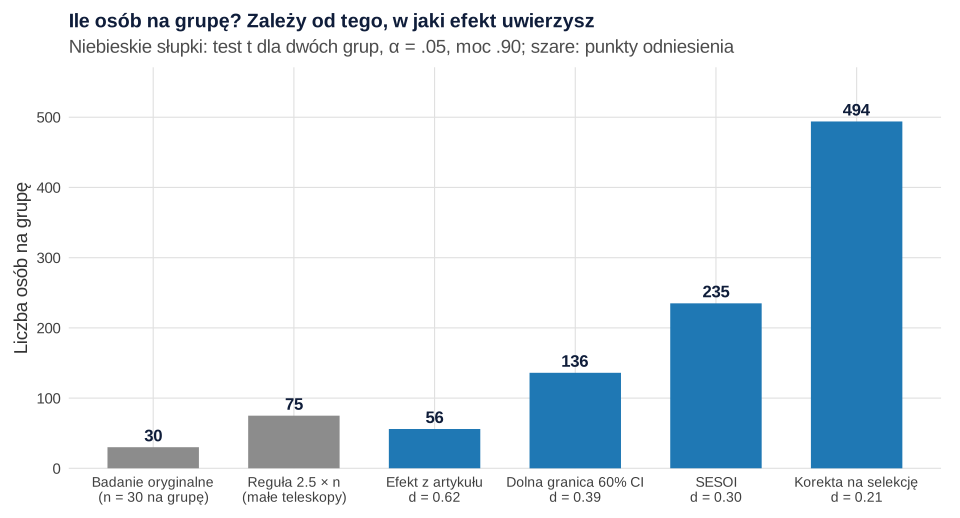
Przykład w tym wpisie jest fikcyjny. Badanie oryginalne miało 30 osób na grupę. Krótka afirmacja wartości obniżała lęk przed testem, d = 0.62, t(58) = 2.40, p = .020. Liczebności replikacji nie opieraj na tym d. Wynik przeszedł przez sito istotności, więc jest prawdopodobnie zawyżony. To klątwa zwycięzcy. Gelman i Carlin (2014) nazywają skalę tego zawyżenia błędem typu M. Zalecają, by efekt do obliczeń projektowych brać z informacji zewnętrznych, a nie z jednego wyniku. Rysunek 1 pokazuje, jak bardzo wynik zależy od przyjętego efektu.
Cztery założenia dają cztery plany:
- Efekt z artykułu (d = 0.62): 56 osób na grupę. To plan, który najczęściej kończy się replikacją o zbyt małej mocy.
- Dolna granica przedziału ufności. Perugini i in. (2014) proponują analizę mocy „safeguard”, w której liczebność liczy się dla dolnej granicy oszacowania efektu. W przykładzie przyjęliśmy dolną granicę 60% CI, czyli d = 0.39. Wymaga to 136 osób na grupę.
- Efekt skorygowany na selekcję. Anderson i in. (2017) korygują efekt z wcześniejszego badania na błąd publikacji i niepewność. Ich metodę implementuje pakiet BUCSS. Tu stosujemy prostszą wersję. Zakładamy, że oryginał trafił do druku tylko dlatego, że p < .05, i szukamy d, przy którym zaobserwowane t jest medianą rozkładu obciętego progiem istotności. Wychodzi d = 0.21, czyli 494 osoby na grupę.
- Najmniejszy interesujący efekt (SESOI, tu d = 0.30): 235 osób na grupę. Ten plan nie zależy od wiary w oryginał. Odpowiada na pytanie, czy efekt jest na tyle duży, by miał znaczenie.
Osobną logikę ma metoda małych teleskopów (Simonsohn, 2015). Pyta, czy efekt jest choćby tak duży, że oryginał mógłby go wykryć. Za taki efekt przyjmuje się d33%, czyli efekt, który oryginał wykryłby z mocą 33%. Przy 30 osobach na grupę d33% = 0.40. Replikacja testuje jednostronnie hipotezę, że prawdziwy efekt jest równy d33%. Z tego podejścia wynika praktyczna reguła: replikacja ma mieć 2.5 raza więcej osób niż oryginał. W R łatwo ją sprawdzić. Przy prawdziwym efekcie zerowym i 75 osobach na grupę (2.5 × 30) test „efekt mniejszy niż d33%” ma moc .79. Przy 30 osobach moc wynosi .46, a przy 150 osobach .97.
Reguła 2.5 × n to minimum, a nie cel. Wystarcza, by wykazać, że oryginał był „za małym teleskopem”. Nie wystarcza, by oszacować mały efekt ani wykazać jego brak testem równoważności. W przykładzie wybieramy 235 osób na grupę (SESOI, moc .90). Ogólne zasady uzasadniania liczebności opisuje wpis dobór liczebności próby.
Krok 4. Kryteria sukcesu zapisane przed danymi
Kryteria omawia hasło replikowalność. W planie ważniejsze jest to, że każde z nich odpowiada na inne pytanie i inaczej zachowuje się przy rosnącym n.
| Kryterium | Pytanie | Uwaga |
|---|---|---|
| K1. Wynik istotny w tym samym kierunku | Czy efekt jest różny od zera? | Zależy od mocy replikacji |
| K2. Efekt oryginału w 95% CI replikacji | Czy replikacja jest zgodna z wartością z artykułu? | Przy dużym n odrzuca każdy przeszacowany oryginał |
| K3. Replikacja w 95% przedziale predykcji | Czy wynik mieści się w tym, czego można było oczekiwać? | Przy nieprecyzyjnym oryginale prawie zawsze „tak” |
| K4. Efekt mniejszy niż d33% | Czy oryginał był za małym teleskopem? | Kryterium porażki, nie sukcesu |
| K5. Równoważność (TOST) | Czy efekt jest mniejszy niż SESOI? | Wymaga dużej próby |
| K6. Metaanaliza obu badań | Jaki jest łączny efekt? | Dziedziczy przeszacowanie oryginału |
Przedział predykcji (K3) opisali Patil i in. (2016). W ich ponownej analizie projektu Open Science Collaboration 77% efektów z replikacji mieściło się w 95% przedziale predykcji obliczonym z oryginału. Autorzy zwracają jednak uwagę, że przy nieprecyzyjnym oryginale przedział jest szeroki i mało mówi o prawdziwym efekcie. Test równoważności (K5) wymaga granic ustalonych z góry na podstawie SESOI (Lakens, 2017). Szerzej opisuje to wpis o badaniach non-inferiority i równoważności. Rysunek 2 pokazuje, jak często każde kryterium daje odpowiedź „tak” w symulacji (1000 replikacji na punkt).
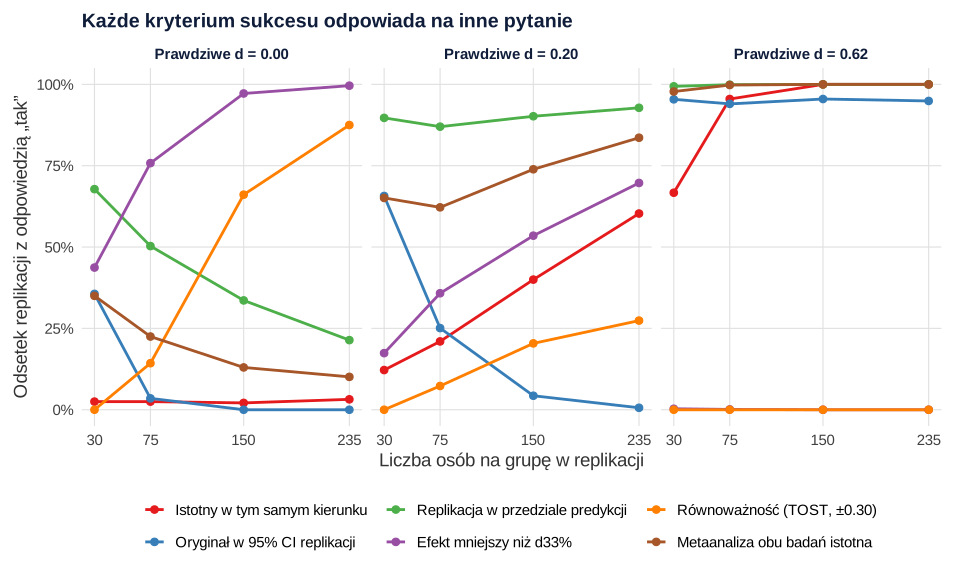
Załóżmy, że prawdziwy efekt to d = 0.20, a replikacja ma 235 osób na grupę. Wtedy:
- wynik istotny daje 60.3% replikacji;
- efekt oryginału mieści się w CI replikacji tylko w 0.6% z nich;
- replikacja mieści się w przedziale predykcji w 92.8%;
- metaanaliza obu badań jest istotna w 83.6%.
Ten sam wynik jest więc jednocześnie „udany” i „nieudany”. Gdy prawdziwy efekt jest zerowy, równoważność przy 235 osobach na grupę wykazuje 87.5% replikacji, a przy 75 osobach tylko 14.3%. Wybierz jedno kryterium główne, a pozostałe zapisz jako dodatkowe. Dla replikacji bezpośredniej rozsądny zestaw to K1 jako kryterium główne oraz K4 i K5 do interpretacji wyniku nieistotnego.
Przykład: wynik replikacji i jego opis
Replikacja objęła 235 osób w grupie kontrolnej i 235 w grupie afirmacji. Wynikiem był lęk przed testem (dane symulowane, prawdziwy efekt d = 0.20). Dane możesz pobrać jako plik CSV (470 wierszy). W grupie kontrolnej M = 48.69, SD = 9.98. W grupie afirmacji M = 47.73, SD = 10.72. Różnica była nieistotna, t(468) = 1.01, p = .315, d = 0.09, 95% CI [−0.09, 0.27].
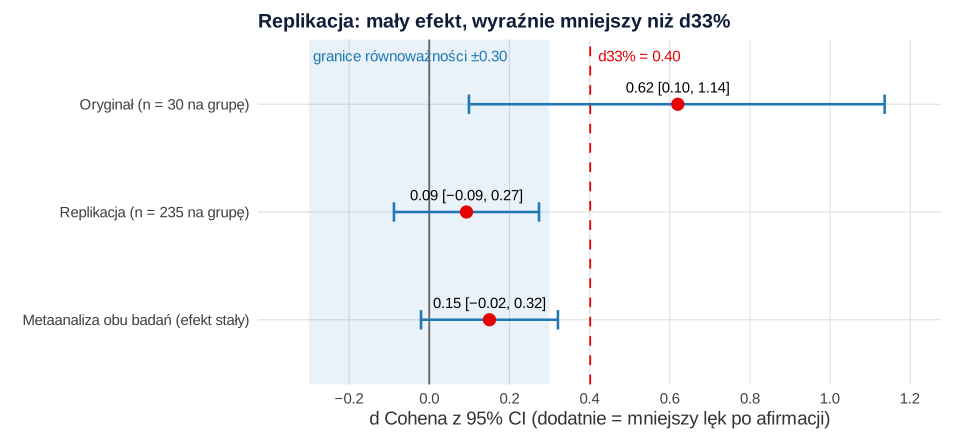
Kryteria z protokołu dały następujące werdykty:
- K1: nie, wynik nieistotny.
- K2: nie, 0.62 leży poza CI replikacji.
- K3: tak, przedział predykcji [0.07, 1.17] obejmuje 0.09. Dobrze pokazuje to ograniczenie, które opisali Patil i in. (2016).
- K4: tak, efekt jest mniejszy niż d33%, p < .001.
- K5: tak, TOST z granicami ±3 punkty (≈ d = 0.30) dał p = .017.
- K6: łączny efekt wyniósł d = 0.15, 95% CI [−0.02, 0.32], p = .085.
Wniosek: efekt, jeśli istnieje, jest mniejszy niż SESOI i dużo mniejszy niż w oryginale. Nie pisz, że „efektu nie ma”. Napisz, jakie wielkości efektu wynik wyklucza.
Krok 5. Rejestracja: protokół jako registered report
Replikacja dobrze pasuje do formatu registered report. Protokół przechodzi recenzję i wstępną akceptację przed badaniem, a o publikacji decydują pytanie i metoda, a nie wynik (Chambers i Tzavella, 2022). Ogólne zasady planu analizy opisuje wpis plan analizy statystycznej i prerejestracja. W replikacji etap 1 powinien zawierać:
- tabelę różnic względem oryginału i korespondencję z autorami;
- uzasadnienie liczebności z rysunku 1, z wybranym założeniem o efekcie;
- kryterium główne i dodatkowe, z granicami równoważności;
- kod analizy jako funkcję, która przyjmuje surowe dane i zwraca werdykt każdego kryterium (przepis 2);
- symulację działania tej funkcji przy zerowym i niezerowym efekcie, czyli rysunek 2.
W etapie 2 uruchamiasz tę samą funkcję na prawdziwych danych (przepis 3). Recenzent widzi, że werdykt powstał z kodu zatwierdzonego przed danymi. Każde odstępstwo zapisz w osobnej tabeli. Gdy wyniki są gotowe, przygotuj pakiet replikacyjny. Jeśli chcesz, żeby ktoś niezależnie sprawdził plan albo kod przed wysłaniem etapu 1, możesz skorzystać z konsultacji statystycznej dla badaczy.
Przykład w R
Trzy przepisy uruchamiane po kolei w jednej sesji R. Trzeci tworzy plik replikacja-afirmacja-lek-dane.csv (możesz go pobrać tutaj). Pierwsze dwa używają tylko bazowego R, a trzeci dodatkowo pakietu metafor.
1. Liczebność replikacji
R
# Badanie oryginalne (przykład fikcyjny): afirmacja wartości a lęk przed testem,
# 30 osób na grupę, opublikowane d = 0.62 (mniejszy lęk w grupie afirmacji).
n_or <- 30; d_or <- 0.62
df_or <- 2 * n_or - 2
t_or <- d_or * sqrt(n_or / 2)                       # t odtworzone z d i n
round(c(t = t_or, df = df_or, p = 2 * pt(-t_or, df_or)), 3)

# Przedział ufności dla d z niecentralnego rozkładu t
ci_d <- function(t, n, poziom = .95) {
  df <- 2 * n - 2; a <- (1 - poziom) / 2
  dol <- uniroot(function(x) pt(t, df, x) - (1 - a), c(t - 5, t + 5))$root
  gor <- uniroot(function(x) pt(t, df, x) - a, c(t - 5, t + 5))$root
  c(dolna = dol, gorna = gor) / sqrt(n / 2)
}
round(rbind(CI95 = ci_d(t_or, n_or), CI60 = ci_d(t_or, n_or, .60)), 3)

# d33%: efekt, który oryginał wykryłby z mocą 33% (małe teleskopy)
d33 <- power.t.test(n = n_or, power = 1/3, sig.level = .05)$delta

# Korekta na selekcję: oryginał opublikowano, bo t > t krytyczne.
# Mediana warunkowa: d, przy którym P(T >= t_obs | T > t_kryt) = 0.5
t_kr <- qt(.975, df_or)
p_war <- function(d) {
  ncp <- d * sqrt(n_or / 2)
  pt(t_or, df_or, ncp, lower.tail = FALSE) / pt(t_kr, df_or, ncp, lower.tail = FALSE)
}
d_kor <- uniroot(function(d) p_war(d) - 0.5, c(-1, 1))$root

# Liczebność na grupę (test t dwustronny, alfa = .05) dla różnych założeń o efekcie
zalozenia <- c(oryginalny_d = d_or, dolna_60CI = unname(ci_d(t_or, n_or, .60)[1]),
               korekta_selekcji = d_kor, SESOI = 0.30)
n90 <- sapply(zalozenia, function(d) ceiling(power.t.test(delta = d, power = .90)$n))
n80 <- sapply(zalozenia, function(d) ceiling(power.t.test(delta = d, power = .80)$n))
print(round(cbind(d = zalozenia, n_moc80 = n80, n_moc90 = n90), 3))
round(c(d33 = d33), 3)

# Reguła małych teleskopów: 2.5 x n oryginału. Jaka jest moc testu "efekt < d33%",
# gdy prawdziwy efekt wynosi 0?
moc_mt <- function(n_rep, d_prawdziwy = 0) {
  df <- 2 * n_rep - 2
  pt(qt(.05, df, d33 * sqrt(n_rep / 2)), df, d_prawdziwy * sqrt(n_rep / 2))
}
n_rep <- c(30, 75, 150, 235)
round(rbind(n_na_grupe = n_rep, moc_mt_przy_d0 = sapply(n_rep, moc_mt)), 3)
Wynik w R
     t     df      p
 2.401 58.000  0.020
     dolna gorna
CI95 0.099 1.136
CI60 0.395 0.840
                     d n_moc80 n_moc90
oryginalny_d     0.620      42      56
dolna_60CI       0.395     102     136
korekta_selekcji 0.206     370     494
SESOI            0.300     176     235
  d33
0.401
                 [,1]   [,2]    [,3]    [,4]
n_na_grupe     30.000 75.000 150.000 235.000
moc_mt_przy_d0  0.464  0.791   0.966   0.996
2. Protokół: funkcja kryteriów i jej symulacja
R
# Protokół etapu 1 (registered report): funkcja z WSZYSTKIMI kryteriami sukcesu,
# zapisana przed zebraniem danych, i symulacja jej działania.
# Wymaga obiektów z przepisu 1 (d_or, n_or, d33, ci_d).
ocen_replikacje <- function(kontrola, afirmacja, granica = 3, d_sesoi = 0.30) {
  n <- length(kontrola)
  tt <- t.test(kontrola, afirmacja, var.equal = TRUE)            # efekt = kontrola - afirmacja
  sd_p <- sqrt((var(kontrola) + var(afirmacja)) / 2)
  d <- (mean(kontrola) - mean(afirmacja)) / sd_p
  ci <- ci_d(unname(tt$statistic), n)
  v_rep <- 2 / n + d^2 / (4 * n); v_or <- 2 / n_or + d_or^2 / (4 * n_or)
  pi95 <- d_or + c(-1, 1) * 1.96 * sqrt(v_or + v_rep)          # przedział predykcji (Patil i in., 2016)
  p_mt <- pt(tt$statistic, 2 * n - 2, d33 * sqrt(n / 2))           # małe teleskopy: H0 d = d33%
  tost <- max(t.test(kontrola, afirmacja, mu = -granica, alternative = "greater", var.equal = TRUE)$p.value,
              t.test(kontrola, afirmacja, mu = granica, alternative = "less", var.equal = TRUE)$p.value)
  w <- 1 / c(v_or, v_rep); d_meta <- sum(w * c(d_or, d)) / sum(w); se_meta <- sqrt(1 / sum(w))
  c(d = d, d_dol = unname(ci[1]), d_gor = unname(ci[2]), p = tt$p.value,
    K1_istotny = tt$p.value < .05 && d > 0,
    K2_oryginal_w_CI = d_or >= ci[1] && d_or <= ci[2],
    pi_dol = pi95[1], pi_gor = pi95[2], K3_w_predykcji = d >= pi95[1] && d <= pi95[2],
    p_mt = unname(p_mt), K4_mniejszy_niz_d33 = unname(p_mt) < .05,
    p_tost = tost, K5_rownowazny = tost < .05,
    d_meta = d_meta, meta_dol = d_meta - 1.96 * se_meta, meta_gor = d_meta + 1.96 * se_meta,
    K6_meta_istotna = d_meta - 1.96 * se_meta > 0)
}

# Symulacja: jak często każde kryterium "mówi tak" przy różnym n i prawdziwym d
set.seed(3362)
siatka <- expand.grid(n = c(30, 75, 150, 235), d_prawdziwy = c(0, 0.20, 0.62))
wyniki <- t(sapply(seq_len(nrow(siatka)), function(i) {
  s <- siatka[i, ]
  r <- replicate(1000, ocen_replikacje(rnorm(s$n, 50, 10), rnorm(s$n, 50 - 10 * s$d_prawdziwy, 10)))
  rowMeans(r[c("K1_istotny", "K2_oryginal_w_CI", "K3_w_predykcji", "K4_mniejszy_niz_d33",
               "K5_rownowazny", "K6_meta_istotna"), ])
}))
symulacja <- cbind(siatka, round(wyniki, 3))
write.csv(symulacja, "b336-symulacja-kryteriow.csv", row.names = FALSE)
print(symulacja, row.names = FALSE)
Wynik w R
   n d_prawdziwy K1_istotny K2_oryginal_w_CI K3_w_predykcji K4_mniejszy_niz_d33
  30        0.00      0.025            0.356          0.678               0.437
  75        0.00      0.025            0.035          0.503               0.758
 150        0.00      0.021            0.000          0.336               0.972
 235        0.00      0.032            0.000          0.214               0.996
  30        0.20      0.122            0.657          0.897               0.174
  75        0.20      0.210            0.251          0.870               0.358
 150        0.20      0.400            0.043          0.902               0.535
 235        0.20      0.603            0.006          0.928               0.697
  30        0.62      0.667            0.954          0.994               0.003
  75        0.62      0.955            0.940          0.999               0.001
 150        0.62      1.000            0.955          1.000               0.000
 235        0.62      1.000            0.949          1.000               0.000
 K5_rownowazny K6_meta_istotna
         0.000           0.350
         0.143           0.225
         0.661           0.130
         0.875           0.101
         0.000           0.651
         0.073           0.622
         0.204           0.739
         0.274           0.836
         0.000           0.978
         0.000           0.998
         0.000           1.000
         0.000           1.000
3. Etap 2: analiza danych z replikacji
R
# Etap 2: dane z replikacji (symulowane) i ta sama funkcja z protokołu.
# Wymaga obiektów z przepisów 1 i 2.
suppressPackageStartupMessages(library(metafor))
set.seed(3363)
n <- 235                                   # liczebność z protokołu (SESOI d = 0.30, moc .90)
dane <- data.frame(grupa = rep(c("kontrola", "afirmacja"), each = n),
                   lek = round(c(rnorm(n, 50, 10), rnorm(n, 48, 10))))   # lęk przed testem (20-80)
write.csv(dane, "replikacja-afirmacja-lek-dane.csv", row.names = FALSE)
round(tapply(dane$lek, dane$grupa, function(x) c(M = mean(x), SD = sd(x))) |> simplify2array(), 2)
t.test(lek ~ factor(grupa, levels = c("kontrola", "afirmacja")), data = dane, var.equal = TRUE)

wynik <- ocen_replikacje(dane$lek[dane$grupa == "kontrola"], dane$lek[dane$grupa == "afirmacja"])
round(wynik, 3)

# Sprawdzenie metaanalizy efektu stałego w metafor
d_rep <- wynik[["d"]]
rma(yi = c(d_or, d_rep), vi = c(2 / n_or + d_or^2 / (4 * n_or), 2 / n + d_rep^2 / (4 * n)), method = "FE")
Wynik w R
   afirmacja kontrola
M      47.73    48.69
SD     10.72     9.98

	Two Sample t-test

data:  lek by factor(grupa, levels = c("kontrola", "afirmacja"))
t = 1.0068, df = 468, p-value = 0.3146
alternative hypothesis: true difference in means between group kontrola and group afirmacja is not equal to 0
95 percent confidence interval:
 -0.9153618  2.8387661
sample estimates:
 mean in group kontrola mean in group afirmacja
               48.69362                47.73191

                  d               d_dol               d_gor                   p
              0.093              -0.088               0.274               0.315
         K1_istotny    K2_oryginal_w_CI              pi_dol              pi_gor
              0.000               0.000               0.071               1.169
     K3_w_predykcji                p_mt K4_mniejszy_niz_d33              p_tost
              1.000               0.000               1.000               0.017
      K5_rownowazny              d_meta            meta_dol            meta_gor
              1.000               0.150              -0.021               0.321
    K6_meta_istotna
              0.000

Fixed-Effects Model (k = 2)

I^2 (total heterogeneity / total variability):   71.79%
H^2 (total variability / sampling variability):  3.54

Test for Heterogeneity:
Q(df = 1) = 3.5446, p-val = 0.0597

Model Results:

estimate      se    zval    pval    ci.lb   ci.ub
  0.1502  0.0871  1.7233  0.0848  -0.0206  0.3210  .

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats) z pakietem metafor; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.2.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Liczebność z efektu w artykule. Opublikowany efekt jest zwykle górną granicą. Planuj dla SESOI albo dla efektu skorygowanego.
- Kryterium wybrane po wyniku. Przy tych samych danych K1 mówi „nie”, a K3 „tak”. Zapisz kryterium główne w protokole.
- „Replikacja się nie udała, więc efektu nie ma”. Bez testu równoważności albo małych teleskopów wynik nieistotny jest tylko brakiem dowodu.
- Metaanaliza oryginału i replikacji jako ostateczny werdykt. Przeszacowany oryginał podnosi łączny efekt. Podaj oba badania osobno.
- Nieudokumentowane zmiany procedury. Każda różnica względem oryginału trafia do tabeli różnic, zanim poznasz wynik.
- Replikacja konceptualna zamiast bezpośredniej przy pierwszej próbie. Jej porażki nie da się jednoznacznie zinterpretować.
Najczęstsze pytania
Czy na replikację cudzego badania potrzebna jest zgoda jego autorów?
Zwykle nie trzeba formalnej zgody, by powtórzyć opublikowaną procedurę. Kontakt z autorami bardzo jednak pomaga: dostajesz materiały, reguły wykluczeń i kod, a autorzy mogą z góry zaakceptować procedurę. Osobną sprawą są licencje kwestionariuszy i zgoda komisji etycznej na Twoje badanie. Sprawdź je przed rozpoczęciem.
Ile osób potrzeba do replikacji, gdy oryginał miał 30 osób na grupę?
To zależy od założonego efektu. W przykładzie z d = 0.62 moc .90 dawało 56 osób na grupę, dolna granica 60% CI – 136, SESOI d = 0.30 – 235, a efekt skorygowany na selekcję – 494. Absolutnym minimum jest 2.5 × 30 = 75 osób na grupę, czyli liczebność wystarczająca do testu małych teleskopów.
Co oznacza d33% w ocenie replikacji?
To efekt, który badanie oryginalne wykryłoby z mocą 33% (Simonsohn, 2015). Przy 30 osobach na grupę d33% = 0.40. Jeśli replikacja pokazuje efekt istotnie mniejszy, oryginał był za małym teleskopem, by wiarygodnie wykryć tak mały efekt.
Czy replikację można opublikować jako registered report?
Tak, ten format dobrze pasuje do replikacji. Protokół z liczebnością, kryteriami sukcesu i kodem analizy przechodzi recenzję przed zebraniem danych, a o publikacji decyduje metoda, nie wynik. Dołącz do niego funkcję zwracającą werdykt każdego kryterium i symulację jej działania.
Czy łączyć oryginał i replikację w metaanalizie?
Można, ale nie jako jedyne kryterium. Jeśli oryginał przeszedł przez sito istotności, jego zawyżony efekt podnosi wynik łączny. W przykładzie metaanaliza efektu stałego dała d = 0.15, 95% CI [−0.02, 0.32], przy d = 0.09 w samej replikacji. Podawaj oba badania osobno.
Powiązane hasła
Przeczytaj też
Replikacja jako praca dyplomowa
Kiedy ma sens, jak przekonać promotora, jak spisać tabelę odstępstw i ocenić wynik. Z kodem R, przykładem i gotowymi zdaniami do pracy.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikPakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →PoradnikBadanie non-inferiority i równoważności
Margines Δ, test jednostronny i przedział ufności, ITT i per protocol, TOST, liczebność próby, przykład w R i wzór opisu wyników.
Czytaj →Planujesz replikację i nie wiesz, ile osób zbadać?
Pomożemy uzasadnić liczebność, dobrać kryteria sukcesu i przygotować kod protokołu tak, żebyś mógł(a) samodzielnie opisać i obronić plan przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Anderson, S. F., Kelley, K., & Maxwell, S. E. (2017). Sample-size planning for more accurate statistical power: A method adjusting sample effect sizes for publication bias and uncertainty. Psychological Science, 28(11), 1547–1562. https://doi.org/10.1177/0956797617723724
- Brandt, M. J., IJzerman, H., Dijksterhuis, A., Farach, F. J., Geller, J., Giner-Sorolla, R., Grange, J. A., Perugini, M., Spies, J. R., & van 't Veer, A. (2014). The Replication Recipe: What makes for a convincing replication? Journal of Experimental Social Psychology, 50, 217–224. https://doi.org/10.1016/j.jesp.2013.10.005 ● Otwarty dostęp
- Chambers, C. D., & Tzavella, L. (2022). The past, present and future of Registered Reports. Nature Human Behaviour, 6(1), 29–42. https://doi.org/10.1038/s41562-021-01193-7 ● Otwarty dostęp
- Gelman, A., & Carlin, J. (2014). Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors. Perspectives on Psychological Science, 9(6), 641–651. https://doi.org/10.1177/1745691614551642
- Lakens, D. (2017). Equivalence tests: A practical primer for t tests, correlations, and meta-analyses. Social Psychological and Personality Science, 8(4), 355–362. https://doi.org/10.1177/1948550617697177 ● Otwarty dostęp
- Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), Article aac4716. https://doi.org/10.1126/science.aac4716 ● Otwarty dostęp: pełny tekst
- Patil, P., Peng, R. D., & Leek, J. T. (2016). What should researchers expect when they replicate studies? A statistical view of replicability in psychological science. Perspectives on Psychological Science, 11(4), 539–544. https://doi.org/10.1177/1745691616646366 ● Otwarty dostęp: pełny tekst
- Perugini, M., Gallucci, M., & Costantini, G. (2014). Safeguard power as a protection against imprecise power estimates. Perspectives on Psychological Science, 9(3), 319–332. https://doi.org/10.1177/1745691614528519 ● Otwarty dostęp
- Simonsohn, U. (2015). Small telescopes: Detectability and the evaluation of replication results. Psychological Science, 26(5), 559–569. https://doi.org/10.1177/0956797614567341
- Zwaan, R. A., Etz, A., Lucas, R. E., & Donnellan, M. B. (2018). Making replication mainstream. Behavioral and Brain Sciences, 41, Article e120. https://doi.org/10.1017/s0140525x17001972 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{anderson2017sample, author={Anderson, Samantha F. and Kelley, Ken and Maxwell, Scott E.}, title={{Sample-size planning for more accurate statistical power: A method adjusting sample effect sizes for publication bias and uncertainty}}, journal={Psychological Science}, year={2017}, volume={28}, number={11}, pages={1547--1562}, doi={10.1177/0956797617723724}}@article{brandt2014replication, author={Brandt, Mark J. and IJzerman, Hans and Dijksterhuis, Ap and Farach, Frank J. and Geller, Jason and Giner-Sorolla, Roger and Grange, James A. and Perugini, Marco and Spies, Jeffrey R. and van 't Veer, Anna}, title={{The Replication Recipe: What makes for a convincing replication?}}, journal={Journal of Experimental Social Psychology}, year={2014}, volume={50}, pages={217--224}, doi={10.1016/j.jesp.2013.10.005}}@article{chambers2022past, author={Chambers, Christopher D. and Tzavella, Loukia}, title={{The past, present and future of Registered Reports}}, journal={Nature Human Behaviour}, year={2022}, volume={6}, number={1}, pages={29--42}, doi={10.1038/s41562-021-01193-7}}@article{gelman2014beyond, author={Gelman, Andrew and Carlin, John}, title={{Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors}}, journal={Perspectives on Psychological Science}, year={2014}, volume={9}, number={6}, pages={641--651}, doi={10.1177/1745691614551642}}@article{lakens2017equivalence, author={Lakens, Daniël}, title={{Equivalence tests: A practical primer for t tests, correlations, and meta-analyses}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={4}, pages={355--362}, doi={10.1177/1948550617697177}}@article{osc2015estimating, author={Open Science Collaboration}, title={{Estimating the reproducibility of psychological science}}, journal={Science}, year={2015}, volume={349}, number={6251}, eid={aac4716}, doi={10.1126/science.aac4716}}@article{patil2016what, author={Patil, Prasad and Peng, Roger D. and Leek, Jeffrey T.}, title={{What should researchers expect when they replicate studies? A statistical view of replicability in psychological science}}, journal={Perspectives on Psychological Science}, year={2016}, volume={11}, number={4}, pages={539--544}, doi={10.1177/1745691616646366}}@article{perugini2014safeguard, author={Perugini, Marco and Gallucci, Marcello and Costantini, Giulio}, title={{Safeguard power as a protection against imprecise power estimates}}, journal={Perspectives on Psychological Science}, year={2014}, volume={9}, number={3}, pages={319--332}, doi={10.1177/1745691614528519}}@article{simonsohn2015small, author={Simonsohn, Uri}, title={{Small telescopes: Detectability and the evaluation of replication results}}, journal={Psychological Science}, year={2015}, volume={26}, number={5}, pages={559--569}, doi={10.1177/0956797614567341}}@article{zwaan2018making, author={Zwaan, Rolf A. and Etz, Alexander and Lucas, Richard E. and Donnellan, M. Brent}, title={{Making replication mainstream}}, journal={Behavioral and Brain Sciences}, year={2018}, volume={41}, eid={e120}, doi={10.1017/s0140525x17001972}}