Sześć typowych projektów w pracy inżynierskiej z badaniem
Praca inżynierska z częścią badawczą rzadko przypomina ankietę z psychologii. Badasz próbki materiału, przebiegi procesu, czujniki, elementy konstrukcji albo prototypy, a wynik pochodzi z maszyny wytrzymałościowej, twardościomierza, profilometru czy oscyloskopu. Statystyka jest tu potrzebna z trzech powodów: żeby odróżnić różnicę między wariantami od rozrzutu próbek, żeby wiedzieć, jak dokładny jest pomiar, i żeby uczciwie zapisać wynik – z niepewnością i bez nadmiaru cyfr. Ten wpis jest dla studentów mechaniki, budownictwa, inżynierii materiałowej, elektrotechniki, inżynierii produkcji i pokrewnych kierunków. Jeśli Twoja praca dotyczy oprogramowania, testów użyteczności albo pomiaru wydajności programów, zajrzyj do wpisu statystyka w pracy z informatyki, a przy pracy o bezpieczeństwie i stanowisku pracy – do wpisu statystyka w pracy z BHP i ergonomii.
| Projekt | Typowe pytanie | Dane | Analiza główna | Co podać |
|---|---|---|---|---|
| 1. Porównanie wariantów | Czy obróbka cieplna W3 daje większą twardość niż obecna? | kilka próbek na wariant, kilka pomiarów na próbce | ANOVA na średnich próbek albo model mieszany | różnice średnich z 95% CI, η² |
| 2. Plan czynnikowy 2k | Które parametry toczenia wpływają na chropowatość? | przebiegi w losowej kolejności, poziomy −1/+1 | regresja na kodach −1/+1, efekty i interakcje | efekty w jednostkach wyniku (µm) z 95% CI |
| 3. Kalibracja | Jak przeliczyć sygnał czujnika na siłę i w jakim zakresie? | wzorce na kilku poziomach, powtórzenia na poziom | regresja liniowa, wykres reszt, test braku dopasowania | równanie, zakres, odwrotne oszacowanie z CI |
| 4. Niepewność pomiaru | Z jaką niepewnością znasz średnicę wałka? | seria odczytów, dane przyrządu | budżet niepewności: typ A i typ B | wynik ± U, współczynnik rozszerzenia k |
| 5. Wytrzymałość i trwałość | Przy jakim naprężeniu pęka 1% próbek ceramiki? | wytrzymałość lub czas do uszkodzenia każdej próbki | rozkład Weibulla (estymacja największej wiarygodności) | moduł Weibulla i wytrzymałość charakterystyczna z CI |
| 6. Zamiennik lub nowy przyrząd | Czy tańszy materiał jest równie wytrzymały? Czy dwa przyrządy mierzą tak samo? | dwie grupy próbek albo pary pomiarów | test równoważności (TOST), metoda Blanda–Altmana | 90% CI różnicy na tle granic równoważności |
Wszystkie dane w przykładach są symulowane i fikcyjne – nie opisują żadnego materiału, maszyny ani zakładu, a parametry symulacji ustawiono ręcznie tak, by ilustrowały typowe sytuacje. Pełny kod znajdziesz w sekcji Przykład w R, a dane z projektu 1 możesz pobrać jako plik CSV (54 pomiary twardości). Jeśli nie wiesz, który test pasuje do Twojego pytania, zacznij od kreatora doboru testu, a całą drogę od pytania do rozdziału wyników opisuje przewodnik po statystyce w pracy dyplomowej.
Zanim zaczniesz: co jest powtórzeniem
W pracach inżynierskich najwięcej błędów bierze się nie z wyboru testu, lecz z liczenia obserwacji. Zanim cokolwiek policzysz, rozpisz strukturę danych od góry do dołu: wytop lub partia materiału → próbka → pomiar na próbce. Powtórzeniem w sensie statystycznym jest najniższy poziom, na którym niezależnie stosowano porównywany wariant. Jeśli każdą próbkę hartowano osobno, jednostką jest próbka. Trzy odciski twardości na tej samej próbce to trzy pomiary jednej jednostki – mówią, jak dokładny jest pomiar, a nie jak bardzo różnią się próbki wykonane tym samym sposobem.
Traktowanie takich pomiarów jak niezależnych obserwacji to pseudoreplikacja. Hurlbert (1984) opisał ją jako testowanie efektu warunku z niewłaściwym członem błędu: warunki nie były powtarzane (choć próbki mogły być) albo powtórzenia nie były niezależne. W przejrzanych przez niego eksperymentach z ekologii problem dotyczył 48% badań, w których użyto testów statystycznych. Lazic (2010) wymienia te same źródła zależności w innych dziedzinach: wiele pomiarów tego samego obiektu, próby zagnieżdżone i pomiary skorelowane w czasie lub przestrzeni. W technice dochodzi jeszcze jedno: jeśli wszystkie próbki wariantu W3 hartowano w jednym wsadzie pieca, to wsad, a nie próbka, jest jednostką, i różnicy między wariantami nie oddzielisz od różnicy między wsadami. Taki plan można uratować tylko w opisie ograniczeń – dlatego o tym, ile wsadów, partii czy nastawień maszyny przypada na wariant, zdecyduj przed przygotowaniem próbek.
Druga sprawa to kolejność. Maszyny się nagrzewają, narzędzia się zużywają, partie materiału się zmieniają. Jeśli najpierw wykonasz wszystkie próbki wariantu W1, a potem W2, różnica wariantów splecie się z dryfem w czasie. Ustal losową kolejność przebiegów i zapisz ją w dzienniku badań, a gdy badanie trwa kilka dni, potraktuj dzień jako blok.
Projekt 1. Porównanie wariantów materiału lub parametru procesu
Przykład: porównano trzy warianty obróbki cieplnej stopu (W1 – obecny, W2, W3). Dla każdego wariantu przygotowano i obrobiono osobno 6 próbek, a na każdej próbce wykonano 3 odciski twardości HV10. Razem jest 54 pomiary, ale tylko 18 jednostek eksperymentalnych. Średnie wariantów, liczone ze średnich próbek, wynosiły 182.33 HV (SD = 5.65), 188.37 HV (SD = 3.72) i 191.28 HV (SD = 5.16). Odchylenie standardowe dotyczy tu rozrzutu między próbkami, czyli tego, czego czytelnik potrzebuje, by ocenić powtarzalność procesu.
Dwie analizy tych samych danych
Jednoczynnikowa ANOVA na wszystkich 54 odciskach dała F(2, 51) = 15.75, p < .001, a porównania Tukeya wskazywały, że oba nowe warianty są twardsze od obecnego: W2 o 6.04 HV, 95% CI [2.12, 9.97], p = .001. Ta sama analiza na 18 średnich próbek dała F(2, 15) = 5.18, p = .019, η² = .41. Według testu Tukeya wariant W3 był twardszy od obecnego o 8.95 HV, 95% CI [1.58, 16.32], p = .017, ale różnica W2 względem W1 (6.04 HV, 95% CI [−1.32, 13.41], p = .117) i W3 względem W2 (2.91 HV, p = .573) nie były istotne. Model mieszany z losowym wyrazem wolnym próbki dał wynik identyczny jak ANOVA na średnich: F(2, 15) = 5.18, p = .019 – przy zrównoważonym planie tak właśnie powinno być. Zwróć uwagę na stopnie swobody mianownika: 15, a nie 51.
Skąd ta różnica? Model mieszany rozdzielił zmienność na dwie części: odchylenie standardowe między próbkami wyniosło 4.79 HV, a między odciskami na tej samej próbce – 1.89 HV. Aż 86% zmienności (ICC = .86) to różnice między próbkami. Analiza 54 odcisków udaje, że masz 54 niezależne próbki o rozrzucie bliskim rozrzutowi odcisków, więc zaniża błąd standardowy różnicy.
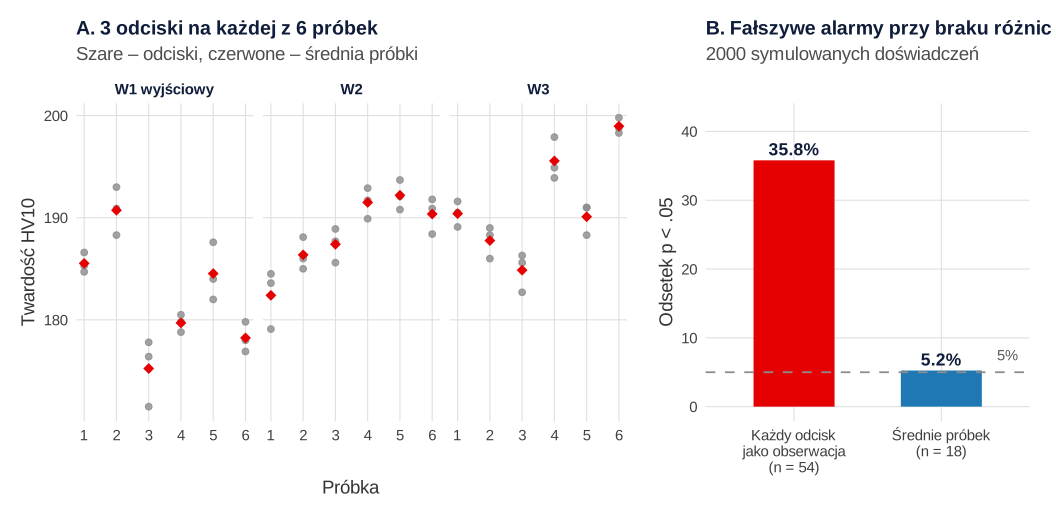
Żeby sprawdzić, czy to tylko przypadek, w symulacji powtórzono to doświadczenie 2000 razy przy braku jakichkolwiek różnic między wariantami (ta sama zmienność próbek i odcisków). Analiza 54 odcisków dawała p < .05 w 35.8% doświadczeń, a analiza średnich próbek w 5.2%, czyli zgodnie z założonym poziomem istotności. Rysunek 1B pokazuje skalę problemu: co trzecie „istotne” porównanie wariantów byłoby fałszywym alarmem.
Wybór analizy jest więc prosty. Przy jednakowej liczbie pomiarów na próbce uśrednij pomiary w próbce i porównaj średnie próbek zwykłą ANOVA lub testem t. Gdy liczba pomiarów jest różna albo część pomiarów odrzucono, użyj modelu mieszanego z losowym efektem próbki (krok po kroku – w poradniku model wielopoziomowy). Tę samą ANOVA z menu pokazuje wpis ANOVA w jamovi, a odczyt tabel przećwiczysz w zadaniach z ANOVA z rozwiązaniami.
Projekt 2. Plan czynnikowy 23: kilka parametrów procesu naraz
Gdy chcesz sprawdzić wpływ kilku parametrów, nie zmieniaj ich po kolei przy pozostałych ustalonych. Plan czynnikowy sprawdza wszystkie kombinacje poziomów, więc każdy przebieg dostarcza informacji o każdym czynniku, a do tego pozwala wykryć interakcje. Ogólną logikę planów pełnych i frakcyjnych, kodowania −1/+1, aliasów i rozdzielczości opisuje wpis eksperyment czynnikowy i frakcyjny; tutaj skupiam się na tym, jak taki plan wygląda w pracy z technologii.
Przykład: chropowatość Ra (µm) po toczeniu przy dwóch poziomach prędkości skrawania (v), posuwu (f) i chłodzenia (c). Osiem kombinacji wykonano dwukrotnie, razem 16 przebiegów w losowej kolejności. Regresja na kodach −1/+1 daje współczynniki, które po pomnożeniu przez 2 są efektami: zmianą średniej Ra przy przejściu parametru z poziomu niskiego na wysoki.
| Efekt | Zmiana Ra (µm) | 95% CI | p |
|---|---|---|---|
| Posuw f | 0.814 | [0.744, 0.884] | < .001 |
| Prędkość v | −0.229 | [−0.299, −0.159] | < .001 |
| Interakcja v × f | −0.166 | [−0.236, −0.096] | .001 |
| Chłodzenie c | 0.144 | [0.074, 0.214] | .001 |
| Interakcje v × c, f × c, v × f × c | 0.054, 0.016, −0.024 | wszystkie obejmują 0 | .115, .607, .457 |
Posuw dominował: zwiększenie posuwu podnosiło Ra średnio o 0.81 µm. Ujemna interakcja v × f oznacza, że przy wyższej prędkości skrawania wzrost Ra wywołany większym posuwem był mniejszy. Gdy interakcja jest istotna, nie opisuj efektów głównych w oderwaniu od niej – pokaż średnie w czterech kombinacjach v i f albo wykres interakcji (zob. jak opisać interakcję w ANOVA). Odchylenie standardowe reszt, 0.061 µm przy 8 stopniach swobody, to oszacowanie powtarzalności procesu przy tych samych nastawach – warto je podać, bo mówi, jaką różnicę ma sens interpretować.
A jeśli nie ma powtórzeń?
Przy drogich próbach często wykonuje się każdą kombinację tylko raz. Wtedy model z wszystkimi interakcjami nie ma stopni swobody na błąd i zwykłe testy nie działają. Jednym z rozwiązań jest metoda Lentha: Lenth (1989) zaproponował prosty sposób oceny wielkości efektów w planach bez powtórzeń, z wynikami w oryginalnych jednostkach pomiaru. Metoda szacuje „pseudobłąd standardowy” (PSE) z mediany bezwzględnych wartości efektów, zakładając, że większość z nich jest bliska zera. Na pierwszych 8 przebiegach z przykładu PSE wyniósł 0.124 µm, a margines błędu (ME) 0.466 µm. Przekroczył go tylko posuw (0.818 µm); efekt prędkości (−0.167 µm) i interakcja v × f (−0.193 µm) zginęły w szumie. To uczciwa cena oszczędności: plan bez powtórzeń wykryje tylko efekty duże. Jeśli kombinacji jest dużo, rozważ plan frakcyjny, a zaoszczędzone przebiegi przeznacz na powtórzenia.
Projekt 3. Krzywa kalibracyjna i reszty
Kalibracja czujnika lub metody pomiarowej to w praktyce regresja liniowa z nietypowym celem: nie chodzi o „wpływ” obciążenia na sygnał, lecz o równanie, z którego potem przeliczysz nieznany sygnał na wielkość mierzoną, oraz o zakres, w którym to równanie jest wiarygodne. Przykład: czujnik siły obciążano wzorcami od 0 do 100 N co 10 N, po trzy odczyty sygnału (mV) na poziom.
Korelacja nie sprawdza liniowości
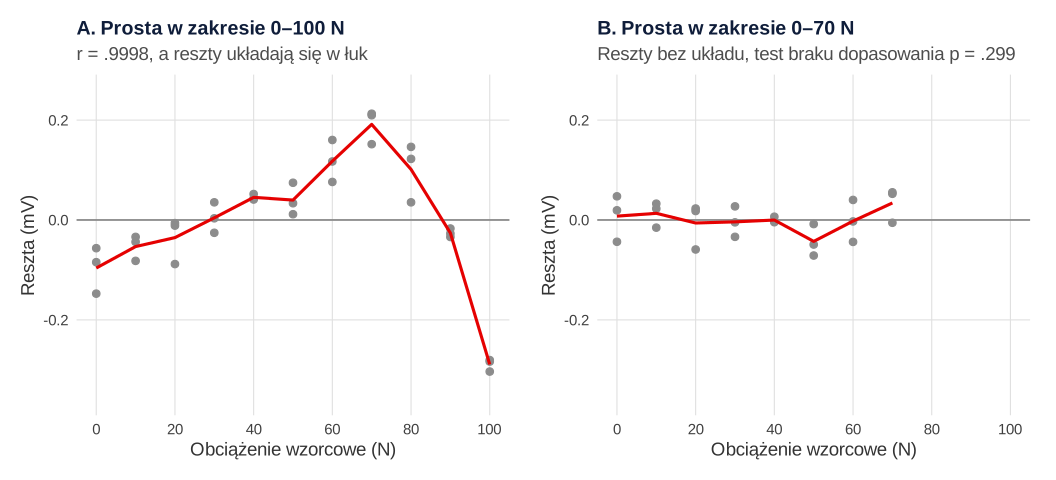
Prosta dopasowana w całym zakresie dała r = .9998 i R² = .9996. W wielu pracach na tym analiza by się skończyła. Analytical Methods Committee (1988) przestrzega, że duża wartość r nie wskazuje na liniową zależność między dwoma pomiarami, i zaleca pokazanie wykresu. Rysunek 2A pokazuje, co ukrywa r: reszty układają się w łuk – od −0.10 mV przy 0 N, przez +0.19 mV przy 70 N, do −0.29 mV przy 100 N. Czujnik w górnej części zakresu przestaje być liniowy.
Ponieważ na każdym poziomie są trzy odczyty, można to sprawdzić formalnie testem braku dopasowania: porównuje się prostą z modelem, który każdemu poziomowi przypisuje własną średnią. Dla zakresu 0–100 N wynik był jednoznaczny, F(9, 22) = 44.00, p < .001. Po zawężeniu zakresu do 0–70 N brak dopasowania nie był istotny, F(6, 16) = 1.33, p = .299, a reszty nie miały układu (Rysunek 2B). Masz więc dwie uczciwe drogi: podać kalibrację liniową dla zakresu 0–70 N albo dopasować model krzywoliniowy w całym zakresie i sprawdzić jego reszty tak samo. Nie przedłużaj prostej poza zakres wzorców.
Odwrotne oszacowanie: z sygnału na siłę
W zakresie 0–70 N równanie miało postać: sygnał = 0.0466 + 0.20037 × siła, przy odchyleniu standardowym reszt 0.0367 mV. Nieznaną siłę zmierzono trzykrotnie (średnia z trzech odczytów 9.047 mV) i przeliczono na 44.92 N. Taka wartość też ma niepewność, bo zarówno odczyty, jak i krzywa są obarczone błędem. Ze standardowego wzoru na odwrotne oszacowanie z prostej kalibracyjnej błąd standardowy wyniósł 0.113 N, a 95% przedział ufności [44.68, 45.15] N. W pracy inżynierskiej zwykle wystarczy ten wzór, wykres reszt i jasno podany zakres. Wybór między podejściem „klasycznym” (sygnał zależny od siły, jak tutaj) a odwrotnym zapisz w metodzie.
Projekt 4. Niepewność pomiaru i zapis wyniku
W pracach z nauk technicznych promotor często oczekuje wyniku „z niepewnością”. To co innego niż odchylenie standardowe próbek z projektu 1. Odchylenie standardowe między próbkami opisuje zmienność wyrobu albo procesu. Niepewność pomiaru mówi, jak dokładnie znasz wartość jednej konkretnej wielkości, np. średnicy jednego wałka. Zasady jej szacowania i zapisu opisuje międzynarodowy przewodnik GUM, wydany jako dokument JCGM 100:2008 i udostępniany przez BIPM (Joint Committee for Guides in Metrology, 2008). Poniżej tylko ogólny schemat – w pracy oprzyj się na samym przewodniku, materiałach z laboratorium i świadectwie wzorcowania przyrządu.
W metrologii rozróżnia się dwa sposoby oceny składowych niepewności. Typ A to ocena statystyczna z serii powtórzonych odczytów: przy pomiarze średnicy jest to odchylenie standardowe średniej, czyli s/√n. Typ B obejmuje wszystko inne: rozdzielczość przyrządu, dane ze świadectwa wzorcowania, wpływ temperatury, specyfikację producenta. Składowe wyrażone jako niepewności standardowe łączy się zwykle pierwiastkiem z sumy kwadratów, a wynik mnoży przez współczynnik rozszerzenia k (często k = 2), otrzymując niepewność rozszerzoną U.
Przykład: średnicę wałka zmierzono 10 razy mikrometrem cyfrowym o rozdzielczości 0.001 mm; na świadectwie wzorcowania podano niepewność rozszerzoną 0.002 mm przy k = 2. Średnia wyniosła 12.4841 mm, a s = 0.0050 mm.
| Składowa | Typ | Jak policzono | Niepewność standardowa (mm) |
|---|---|---|---|
| Rozrzut 10 odczytów | A | 0.0050 / √10 | 0.00157 |
| Rozdzielczość 0.001 mm | B | połowa działki, rozkład prostokątny: 0.0005 / √3 | 0.00029 |
| Wzorcowanie przyrządu | B | U = 0.002 mm, k = 2: 0.002 / 2 | 0.00100 |
| Niepewność złożona | – | √(suma kwadratów) | 0.00188 |
| Niepewność rozszerzona | – | k = 2 | 0.00376 |
Budżet pokazuje, gdzie warto szukać poprawy: rozdzielczość jest pomijalna, a o wyniku decyduje rozrzut odczytów i wzorcowanie. Więcej odczytów zmniejszy tylko pierwszą składową. W prawdziwym pomiarze dopisz też składowe, które w przykładzie pominięto, np. temperaturę przedmiotu i przyrządu, i nie wymyślaj ich wartości – bierz je z dokumentacji albo z własnych pomiarów.
Ile cyfr podać
Komputer zwróci 12.4841 ± 0.00376 mm. Zwykle niepewność zaokrągla się do jednej lub dwóch cyfr znaczących, a wynik do tego samego miejsca po przecinku: d = (12.484 ± 0.004) mm, k = 2 albo d = (12.4841 ± 0.0038) mm. Zapis „12.48412 ± 0.00376” sugeruje dokładność, której nie ma, a „12.48 ± 0.004” gubi cyfrę, którą znasz. Cole (2015) zwraca uwagę, że w publikacjach liczby często podaje się ze zbyt dużą precyzją, i zaleca zaokrąglanie dopiero przy raportowaniu, po obliczeniach na pełnej precyzji. Ogólne zasady zaokrąglania w tabelach opisuje wpis statystyki opisowe w pracy. Jeśli chcesz porównać rozrzut kilku procesów o różnych średnich, przyda się współczynnik zmienności – ale to miara zmienności procesu, a nie niepewność pomiaru.
Projekt 5. Wytrzymałość materiałów kruchych i trwałość: rozkład Weibulla
Wytrzymałość ceramiki, szkła czy kompozytów często ma rozkład asymetryczny, a w projektowaniu liczy się nie średnia, lecz naprężenie, przy którym pęka mały odsetek elementów. Do opisu takich danych służy rozkład Weibulla, przedstawiony przez Weibulla (1951) jako rozkład o szerokim zastosowaniu. Ma dwa parametry: moduł Weibulla m (parametr kształtu; im większy, tym mniejszy rozrzut wytrzymałości) i wytrzymałość charakterystyczną σ0, przy której pęka około 63% próbek.
Przykład: 25 próbek ceramiki zbadano w próbie zginania. Średnia wytrzymałość wynosiła 377.9 MPa (SD = 45.7). Rozkład Weibulla dopasowany metodą największej wiarygodności dał m = 10.9, 95% CI [7.9, 15.0], i σ0 = 397 MPa, 95% CI [382, 412]. Naprężenie, przy którym według modelu pęka 1% próbek, wyniosło 260 MPa (SE = 20 MPa). Zwróć uwagę na dwie rzeczy. Po pierwsze, przedział dla modułu jest szeroki – w symulacji przy prawdziwym m = 10 oszacowania z 10 próbek wahały się (5. i 95. centyl z 2000 powtórzeń) od 7.3 do 17.9, a z 30 próbek od 8.2 do 13.5. Po drugie, 1% z 25 próbek to mniej niż jedna próbka, więc wartość 260 MPa jest ekstrapolacją z modelu, a nie obserwacją. Opisz ją jako taką.
Quinn i Quinn (2010) w przeglądzie analizy Weibulla dla wytrzymałości materiałów podkreślają, że parametry mają sens fizyczny związany z rozkładem wielkości defektów i że wytrzymałości z różnych konfiguracji badania (rozmiar próbki, rodzaj zginania) porównuje się przez pojęcie równoważnej objętości – dlatego nie porównuj wprost σ0 z badań o różnej geometrii próbek. Wskazują też, że trudne bywa potwierdzenie rodzaju źródła pęknięcia; jeśli część próbek pękła np. w uchwycie, zapisz to i nie usuwaj ich po cichu.
W badaniach trwałości zmęczeniowej część próbek często nie ulega zniszczeniu do końca próby. To obserwacje cenzurowane: nie wolno ich usunąć ani wpisać czasu przerwania jako czasu zniszczenia. Model Weibulla z cenzurowaniem (np. survreg() z pakietu survival) uwzględnia je poprawnie.
Projekt 6. Tańszy zamiennik i nowy przyrząd: równoważność i zgodność
Część prac ma udowodnić, że coś się nie różni: tańszy materiał jest równie wytrzymały, a nowy przyrząd mierzy tak samo jak dotychczasowy. Wynik nieistotny w zwykłym teście tego nie pokazuje. Lakens (2017) opisuje alternatywę: test równoważności TOST, w którym granice równoważności ustala się z góry na podstawie najmniejszej różnicy mającej znaczenie. W przykładzie porównano wytrzymałość na rozciąganie 12 próbek obecnego i 12 próbek tańszego materiału przy granicach ±15 MPa (wartość umowna, fikcyjna). Różnica wyniosła 2.4 MPa; zwykły test t Welcha dał p = .455, co samo nic nie dowodzi. TOST dał oba jednostronne testy istotne (p < .001), a 90% przedział ufności różnicy [−3.0, 7.7] MPa mieścił się w granicach ±15 MPa – materiały można uznać za równoważne w tym zakresie. Granice uzasadnij wymaganiami konstrukcji, a nie wynikiem. Szerzej opisuje to wpis badanie non-inferiority i równoważności.
Porównanie dwóch przyrządów to z kolei badanie zgodności metod. Nie licz korelacji – przyrząd, który zawsze zawyża wynik o 5%, będzie z wzorcowym idealnie skorelowany. Użyj metody Blanda–Altmana (średnia różnica i granice zgodności), a przy błędzie w obu zmiennych regresji Deminga lub Passinga–Babloka. Całość z kodem opisuje wpis zgodność metod pomiaru.
Ankieta użytkowników lub pracowników
Część prac inżynierskich łączy rozwiązanie techniczne z ankietą: operatorzy oceniają nową wersję stanowiska, użytkownicy – prototyp aplikacji sterującej, pracownicy – wdrożony system. Tu obowiązują zwykłe zasady badań ankietowych: gotowe, opisane skale zamiast przypadkowych pytań, opis doboru osób, wynik skali zamiast analizy każdego pytania osobno. Jeśli ci sami operatorzy oceniają dwie wersje, to pomiar zależny (test t dla par lub Wilcoxon). Jeśli ankietowani pracują w kilku brygadach lub zmianach, uwzględnij grupy jak w projekcie 1. Krok po kroku prowadzi wpis analiza ankiety do pracy dyplomowej, a ocenę użyteczności prototypu – wpis o informatyce podlinkowany na początku.
Ile próbek i ile pomiarów na próbce
Liczbę próbek planuje się przed badaniem, z mocy testu albo z oczekiwanej szerokości przedziału ufności. Maxwell i in. (2008) podkreślają, że obok mocy warto planować dokładność oszacowania – w pracy inżynierskiej, gdzie celem jest często oszacowanie różnicy, a nie samo „czy jest istotna”, to podejście jest naturalne (szczegóły: liczebność próby z precyzji). W obu przypadkach potrzebujesz zmienności między próbkami, np. z badania pilotażowego lub z poprzedniej serii.
Na danych z projektu 1 (SD między próbkami 4.8 HV, SD odcisków 1.9 HV, 3 odciski na próbce) wykrycie różnicy 6 HV z mocą .80 wymagało 12 próbek na wariant, a zawężenie połowy 95% przedziału ufności różnicy do 4 HV – 13 próbek. Tabela pokazuje, co daje dokładanie pomiarów zamiast próbek: błąd standardowy średniej wariantu prawie się nie zmienia.
| Próbek na wariant | 1 odcisk | 3 odciski | 10 odcisków |
|---|---|---|---|
| 3 | 2.98 | 2.84 | 2.79 |
| 6 | 2.11 | 2.01 | 1.97 |
| 10 | 1.63 | 1.56 | 1.53 |
Przejście z 3 do 10 odcisków na próbce przy 6 próbkach zmniejsza błąd standardowy z 2.01 do 1.97 HV, a dołożenie próbek z 6 do 10 – do 1.56 HV. Kilka pomiarów na próbce ma sens, gdy sam pomiar jest mało precyzyjny albo gdy chcesz oszacować powtarzalność metody; jeśli jednak dominuje rozrzut próbek, budżet przeznacz na próbki.
Jak opisać analizę statystyczną w pracy inżynierskiej
Opis metody w pracy z badaniem powinien pozwolić odtworzyć doświadczenie: jak przygotowano i oznaczono próbki, ile było próbek i pomiarów na próbce, w jakiej kolejności je wykonano, jakimi przyrządami (z rozdzielczością i datą wzorcowania) i co było jednostką analizy. Zakres wymagań i układ rozdziałów ustala promotor i regulamin uczelni, więc traktuj poniższy akapit jako wzór do dopasowania. Liczby we własnym opisie możesz porównać z wynikiem generatora opisu wyników APA.
Jeśli potrzebujesz pomocy w zaplanowaniu liczby próbek, doborze analiz albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Przykład w R: powtórzenia, plan 2³, kalibracja, niepewność i Weibull
Kod odtwarza wszystkie liczby z tego wpisu. Przepis 1 to pełna analiza projektu 1: dane z odciskami w próbkach, analiza błędna i poprawna, model mieszany i symulacja fałszywych alarmów; zapisuje też dane do pobrania (CSV). Przepis 2 zawiera pozostałe projekty i obliczenia liczby próbek. Każdy projekt tworzy własne dane symulowane, a parametry symulacji ustawiono ręcznie. Rysunki przygotowano w pakietach ggplot2 i patchwork na podstawie wyników obu przepisów.
1. Projekt 1: warianty obróbki, próbka jako jednostka i pseudoreplikacja
R
# Projekt 1: trzy warianty obróbki cieplnej, twardość HV10 (dane symulowane, fikcyjne).
# 6 próbek na wariant, na każdej próbce 3 odciski. Jednostką eksperymentalną jest próbka.
suppressPackageStartupMessages({library(lme4); library(lmerTest)})
set.seed(5261)
war <- c("W1 wyjściowy", "W2", "W3")
d <- expand.grid(odcisk = 1:3, probka = 1:6, wariant = war)
d$wariant <- factor(d$wariant, levels = war)
d$id <- interaction(d$wariant, d$probka, sep = "-p")
efekt <- c(0, 2.5, 6)[as.integer(d$wariant)]          # prawdziwe różnice wariantów (HV)
u_probki <- rnorm(nlevels(d$id), 0, 4)                 # zmienność między próbkami (SD = 4 HV)
d$hv <- round(185 + efekt + u_probki[as.integer(d$id)] + rnorm(nrow(d), 0, 2), 1)  # odciski: SD = 2 HV
write.csv(d[, c("wariant", "id", "odcisk", "hv")], "inzynierska-twardosc-dane.csv", row.names = FALSE)

# Opis: średnie wariantów z odchyleniem standardowym średnich próbek
sr <- aggregate(hv ~ wariant + id, data = d, FUN = mean)
print(do.call(rbind, lapply(split(sr$hv, sr$wariant), function(x)
  round(c(n_probek = length(x), M = mean(x), SD = sd(x)), 2))))

# Błąd: każdy odcisk jako osobna obserwacja (54 „powtórzenia”)
cat("\nANOVA na 54 odciskach (pseudoreplikacja):\n")
print(summary(aov(hv ~ wariant, data = d)))
print(TukeyHSD(aov(hv ~ wariant, data = d))$wariant, digits = 4)

# Poprawnie (1): ANOVA na średnich 18 próbek
cat("\nANOVA na średnich 18 próbek:\n")
m_sr <- aov(hv ~ wariant, data = sr)
print(summary(m_sr))
ss <- summary(m_sr)[[1]][["Sum Sq"]]
cat("eta^2 =", round(ss[1] / sum(ss), 2), "\n")
print(TukeyHSD(m_sr)$wariant, digits = 4)

# Poprawnie (2): model mieszany z losowym wyrazem wolnym próbki
mm <- lmer(hv ~ wariant + (1 | id), data = d)
cat("\nModel mieszany:\n")
print(anova(mm))
vc <- as.data.frame(VarCorr(mm))
cat("SD między próbkami =", round(vc$sdcor[1], 2), " SD odcisków =", round(vc$sdcor[2], 2),
    " ICC =", round(vc$vcov[1] / sum(vc$vcov), 2), "\n")

# Symulacja: warianty NIE różnią się; jak często p < .05?
set.seed(5262)
grupa <- factor(sub("-p.*", "", levels(d$id)))       # wariant każdej próbki
p_odc <- p_sr <- numeric(2000)
for (i in 1:2000) {
  u <- rnorm(18, 0, 4)
  y <- 185 + u[as.integer(d$id)] + rnorm(nrow(d), 0, 2)
  p_odc[i] <- summary(aov(y ~ d$wariant))[[1]][1, "Pr(>F)"]
  ys <- tapply(y, d$id, mean)
  p_sr[i] <- summary(aov(ys ~ grupa))[[1]][1, "Pr(>F)"]
}
cat("\nOdsetek p < .05 przy braku różnic (2000 powtórzeń symulacji):\n")
print(round(100 * c(odciski_54 = mean(p_odc < .05), srednie_probek_18 = mean(p_sr < .05)), 1))
Wynik w R
             n_probek      M   SD
W1 wyjściowy        6 182.33 5.65
W2                  6 188.37 3.72
W3                  6 191.28 5.16

ANOVA na 54 odciskach (pseudoreplikacja):
            Df Sum Sq Mean Sq F value   Pr(>F)
wariant      2  750.5   375.2   15.75 4.71e-06 ***
Residuals   51 1214.9    23.8
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
                 diff    lwr    upr     p adj
W2-W1 wyjściowy 6.044  2.117  9.972 1.441e-03
W3-W1 wyjściowy 8.950  5.023 12.877 3.634e-06
W3-W2           2.906 -1.022  6.833 1.845e-01

ANOVA na średnich 18 próbek:
            Df Sum Sq Mean Sq F value Pr(>F)
wariant      2  250.2  125.08   5.184 0.0194 *
Residuals   15  361.9   24.13
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
eta^2 = 0.41
                 diff    lwr   upr   p adj
W2-W1 wyjściowy 6.044 -1.322 13.41 0.11691
W3-W1 wyjściowy 8.950  1.583 16.32 0.01691
W3-W2           2.906 -4.461 10.27 0.57338

Model mieszany:
Type III Analysis of Variance Table with Satterthwaite's method
        Sum Sq Mean Sq NumDF DenDF F value  Pr(>F)
wariant 37.171  18.585     2    15  5.1837 0.01944 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
SD między próbkami = 4.79  SD odcisków = 1.89  ICC = 0.86

Odsetek p < .05 przy braku różnic (2000 powtórzeń symulacji):
       odciski_54 srednie_probek_18
             35.8               5.2
2. Projekty 2–6 i liczba próbek
R
# Projekty 2–5, liczba powtórzeń i równoważność (dane symulowane, fikcyjne).
suppressPackageStartupMessages(library(survival))

## Projekt 2. Plan 2^3 z dwoma powtórzeniami: chropowatość Ra (µm) po toczeniu
set.seed(5263)
plan <- expand.grid(v = c(-1, 1), f = c(-1, 1), c = c(-1, 1))   # prędkość, posuw, chłodzenie
plan <- plan[rep(1:8, 2), ]
plan$powt <- rep(1:2, each = 8)
plan$kolejnosc <- sample(16)                                      # losowa kolejność przebiegów
plan$Ra <- round(1.60 - 0.15 * plan$v + 0.40 * plan$f + 0.03 * plan$c -
                 0.10 * plan$v * plan$f + rnorm(16, 0, 0.10), 2)
m2 <- lm(Ra ~ v * f * c, data = plan)
ef <- cbind(efekt = 2 * coef(m2)[-1], 2 * confint(m2)[-1, ],
            p = summary(m2)$coefficients[-1, 4])
cat("Plan 2^3, 16 przebiegów – efekty (zmiana Ra przy przejściu z −1 na +1):\n")
print(round(ef, 3))
cat("Reszta: SD =", round(sigma(m2), 3), " df =", df.residual(m2), "\n")

# Bez powtórzeń (tylko pierwsze 8 przebiegów): metoda Lentha
k <- 2 * coef(lm(Ra ~ v * f * c, data = plan[plan$powt == 1, ]))[-1]
s0 <- 1.5 * median(abs(k))
pse <- 1.5 * median(abs(k)[abs(k) < 2.5 * s0])
me <- qt(.975, df = length(k) / 3) * pse
cat("\nBez powtórzeń: efekty =", round(k, 3), "\nPSE =", round(pse, 3), " ME =", round(me, 3),
    " efekty powyżej ME:", names(k)[abs(k) > me], "\n")

## Projekt 3. Krzywa kalibracyjna czujnika siły: obciążenie wzorcowe (N) a sygnał (mV)
set.seed(5264)
kal <- data.frame(x = rep(seq(0, 100, 10), each = 3))
kal$y <- round(0.05 + 0.200 * kal$x - 0.0006 * pmax(kal$x - 70, 0)^2 + rnorm(nrow(kal), 0, 0.04), 3)
lin <- lm(y ~ x, data = kal)
bez0 <- function(x, d) sub("^0\\.", ".", formatC(x, format = "f", digits = d))   # zapis APA bez zera
cat("\nKalibracja 0–100 N: r =", bez0(cor(kal$x, kal$y), 4), " R^2 =", bez0(summary(lin)$r.squared, 4), "\n")
cat("Średnie reszty na poziomach x:\n")
print(round(tapply(resid(lin), kal$x, mean), 3))
cat("Test braku dopasowania (prosta vs średnie poziomów):\n")
print(anova(lin, lm(y ~ factor(x), data = kal)))
k70 <- subset(kal, x <= 70)
lin70 <- lm(y ~ x, data = k70)
cat("\nZakres 0–70 N, test braku dopasowania:\n")
print(anova(lin70, lm(y ~ factor(x), data = k70)))
a <- coef(lin70)[1]; b <- coef(lin70)[2]; s <- sigma(lin70); n <- nrow(k70)
y0 <- c(9.04, 9.09, 9.01)                                           # trzy odczyty nieznanej siły
x0 <- (mean(y0) - a) / b
se_x0 <- s / b * sqrt(1 / length(y0) + 1 / n + (mean(y0) - mean(k70$y))^2 / (b^2 * sum((k70$x - mean(k70$x))^2)))
ci <- x0 + c(-1, 1) * qt(.975, n - 2) * se_x0
cat("a =", round(a, 4), " b =", round(b, 5), " s =", round(s, 4),
    "\nśrednia odczytów =", round(mean(y0), 3), "mV, x0 =", round(x0, 2), "N, SE =", round(se_x0, 3), ", 95% CI [", round(ci[1], 2), ",", round(ci[2], 2), "]\n")

## Projekt 4. Niepewność pomiaru średnicy wałka (mm), mikrometr cyfrowy
set.seed(5265)
odczyty <- round(rnorm(10, 12.4832, 0.0035), 3)
cat("\nOdczyty:", format(odczyty, nsmall = 3), "\n")
uA <- sd(odczyty) / sqrt(length(odczyty))       # typ A: odchylenie standardowe średniej
uB_rozdz <- 0.0005 / sqrt(3)                    # typ B: rozdzielczość 0.001 mm, rozkład prostokątny
uB_wzorc <- 0.002 / 2                           # typ B: ze świadectwa wzorcowania, U = 0.002 mm, k = 2
uc <- sqrt(uA^2 + uB_rozdz^2 + uB_wzorc^2)
cat(sprintf("średnia = %.4f mm, s = %.4f mm\nuA = %.5f, uB(rozdz.) = %.5f, uB(wzorc.) = %.5f, uc = %.5f, U(k = 2) = %.5f mm\n",
            mean(odczyty), sd(odczyty), uA, uB_rozdz, uB_wzorc, uc, 2 * uc))

## Projekt 5. Wytrzymałość na zginanie 25 próbek ceramiki (MPa): rozkład Weibulla
set.seed(5266)
sigma_f <- round(rweibull(25, shape = 10, scale = 400), 1)
mw <- survreg(Surv(sigma_f) ~ 1, dist = "weibull")
m_hat <- 1 / mw$scale
ci_m <- 1 / exp(log(mw$scale) + c(1, -1) * 1.96 * sqrt(vcov(mw)["Log(scale)", "Log(scale)"]))
s0_hat <- exp(coef(mw))
ci_s0 <- exp(confint(mw))
q01 <- predict(mw, type = "quantile", p = .01, se.fit = TRUE, newdata = data.frame(1))
cat(sprintf("\nWeibull: m = %.1f, 95%% CI [%.1f, %.1f]; sigma0 = %.0f MPa, 95%% CI [%.0f, %.0f]\n",
            m_hat, ci_m[1], ci_m[2], s0_hat, ci_s0[1], ci_s0[2]))
cat(sprintf("Naprężenie przy 1%% prawdopodobieństwa zniszczenia: %.0f MPa (SE = %.0f); M = %.1f, SD = %.1f\n",
            q01$fit, q01$se.fit, mean(sigma_f), sd(sigma_f)))
set.seed(5267)
rozrzut <- sapply(c(10, 30), function(nn) quantile(replicate(2000,
  1 / survreg(Surv(rweibull(nn, 10, 400)) ~ 1, dist = "weibull")$scale), c(.05, .95)))
colnames(rozrzut) <- c("n = 10", "n = 30")
cat("Rozrzut oszacowań m przy prawdziwym m = 10 (5. i 95. centyl z 2000 symulacji):\n")
print(round(rozrzut, 1))

## Ile powtórzeń: SD między próbkami 4.8 HV, SD odcisków 1.9 HV (z projektu 1)
sb <- 4.8; sw <- 1.9
se_tab <- outer(c(3, 6, 10), c(1, 3, 10), function(n, k) sqrt(sb^2 / n + sw^2 / (n * k)))
dimnames(se_tab) <- list(probki = c(3, 6, 10), odciski = c(1, 3, 10))
cat("\nBłąd standardowy średniej wariantu (HV):\n")
print(round(se_tab, 2))
sd_pr <- sqrt(sb^2 + sw^2 / 3)
pw <- power.t.test(delta = 6, sd = sd_pr, power = .80)
cat("Próbek na wariant dla różnicy 6 HV, moc .80:", ceiling(pw$n), " (SD średniej próbki =", round(sd_pr, 2), ")\n")
n_prec <- 3:40
pol <- qt(.975, 2 * n_prec - 2) * sd_pr * sqrt(2 / n_prec)
cat("Próbek na wariant, by połowa 95% CI różnicy ≤ 4 HV:", n_prec[which(pol <= 4)[1]], "\n")

## Równoważność: tańszy materiał a obecny, granice ±15 MPa (wytrzymałość na rozciąganie)
set.seed(5268)
obecny <- rnorm(12, 520, 12); nowy <- rnorm(12, 516, 12)
tt <- t.test(nowy, obecny)
t_dol <- t.test(nowy, obecny, mu = -15, alternative = "greater")
t_gor <- t.test(nowy, obecny, mu = 15, alternative = "less")
ci90 <- t.test(nowy, obecny, conf.level = .90)$conf.int
cat(sprintf("\nRóżnica = %.1f MPa; zwykły test: p = %s; TOST: p_dolny = %s, p_górny = %s; 90%% CI [%.1f, %.1f]\n",
            mean(nowy) - mean(obecny), bez0(tt$p.value, 3), bez0(t_dol$p.value, 4), bez0(t_gor$p.value, 4), ci90[1], ci90[2]))
Wynik w R
Plan 2^3, 16 przebiegów – efekty (zmiana Ra przy przejściu z −1 na +1):
       efekt  2.5 % 97.5 %     p
v     -0.229 -0.299 -0.159 0.000
f      0.814  0.744  0.884 0.000
c      0.144  0.074  0.214 0.001
v:f   -0.166 -0.236 -0.096 0.001
v:c    0.054 -0.016  0.124 0.115
f:c    0.016 -0.054  0.086 0.607
v:f:c -0.024 -0.094  0.046 0.457
Reszta: SD = 0.061  df = 8

Bez powtórzeń: efekty = -0.167 0.818 0.143 -0.193 0.022 -0.023 -0.022
PSE = 0.124  ME = 0.466  efekty powyżej ME: f

Kalibracja 0–100 N: r = .9998  R^2 = .9996
Średnie reszty na poziomach x:
     0     10     20     30     40     50     60     70     80     90    100
-0.096 -0.053 -0.035  0.004  0.045  0.040  0.118  0.191  0.101 -0.026 -0.289
Test braku dopasowania (prosta vs średnie poziomów):
Analysis of Variance Table

Model 1: y ~ x
Model 2: y ~ factor(x)
  Res.Df     RSS Df Sum of Sq      F    Pr(>F)
1     31 0.51309
2     22 0.02700  9   0.48609 44.004 5.203e-12 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Zakres 0–70 N, test braku dopasowania:
Analysis of Variance Table

Model 1: y ~ x
Model 2: y ~ factor(x)
  Res.Df      RSS Df Sum of Sq      F Pr(>F)
1     22 0.029589
2     16 0.019722  6 0.0098671 1.3342 0.2988
a = 0.0466  b = 0.20037  s = 0.0367
średnia odczytów = 9.047 mV, x0 = 44.92 N, SE = 0.113 , 95% CI [ 44.68 , 45.15 ]

Odczyty: 12.482 12.478 12.488 12.488 12.479 12.480 12.484 12.486 12.482 12.494
średnia = 12.4841 mm, s = 0.0050 mm
uA = 0.00157, uB(rozdz.) = 0.00029, uB(wzorc.) = 0.00100, uc = 0.00188, U(k = 2) = 0.00376 mm

Weibull: m = 10.9, 95% CI [7.9, 15.0]; sigma0 = 397 MPa, 95% CI [382, 412]
Naprężenie przy 1% prawdopodobieństwa zniszczenia: 260 MPa (SE = 20); M = 377.9, SD = 45.7
Rozrzut oszacowań m przy prawdziwym m = 10 (5. i 95. centyl z 2000 symulacji):
    n = 10 n = 30
5%     7.3    8.2
95%   17.9   13.5

Błąd standardowy średniej wariantu (HV):
      odciski
probki    1    3   10
    3  2.98 2.84 2.79
    6  2.11 2.01 1.97
    10 1.63 1.56 1.53
Próbek na wariant dla różnicy 6 HV, moc .80: 12  (SD średniej próbki = 4.92 )
Próbek na wariant, by połowa 95% CI różnicy ≤ 4 HV: 13

Różnica = 2.4 MPa; zwykły test: p = .455; TOST: p_dolny = .0000, p_górny = .0003; 90% CI [-3.0, 7.7]
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje aov(), TukeyHSD(), lm(), anova(), power.t.test() i t.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- survival (wersja 3.8-6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac inżynierskich
- Pomiary na tej samej próbce liczone jak osobne próbki. W przykładzie dawało to F(2, 51) = 15.75 zamiast F(2, 15) = 5.18 i fałszywy alarm w 35.8% symulowanych doświadczeń.
- Wszystkie próbki wariantu z jednego wsadu, jednej partii lub jednego nastawienia maszyny – różnica wariantów nie da się wtedy oddzielić od różnicy wsadów.
- Warianty wykonywane po kolei zamiast w losowej kolejności, przez co efekt wariantu miesza się z nagrzewaniem maszyny i zużyciem narzędzia.
- Zmienianie jednego parametru naraz zamiast planu czynnikowego i opis efektów głównych mimo istotnej interakcji.
- Liniowość kalibracji „potwierdzona” wartością r = .999, bez wykresu reszt, i przeliczanie sygnałów spoza zakresu wzorców.
- Odchylenie standardowe próbek podane jako niepewność pomiaru albo niepewność bez składowych typu B i bez współczynnika rozszerzenia.
- Wynik z ośmioma cyframi z kalkulatora i niepewność z dokładnością większą niż sam wynik.
- Wytrzymałość materiałów kruchych opisana tylko średnią albo dopuszczalne naprężenie przy 1% zniszczeń podane bez zaznaczenia, że to ekstrapolacja z modelu.
- Usunięcie próbek, które nie pękły do końca próby zmęczeniowej, zamiast potraktowania ich jako cenzurowanych.
- „Brak istotnej różnicy” jako dowód równoważności zamiennika i korelacja jako dowód zgodności dwóch przyrządów.
- Liczba próbek dobrana bez uzasadnienia albo z uzasadnieniem opartym na rozrzucie pomiarów, a nie próbek.
Lista kontrolna przed oddaniem rozdziału z badaniami
- W metodzie jest struktura danych: partia lub wsad → próbka → pomiar, i wiadomo, co jest jednostką analizy.
- Kolejność przebiegów była losowa albo opisano, dlaczego nie mogła być.
- Każdy przyrząd ma podaną rozdzielczość, zakres i informację o wzorcowaniu.
- Każda różnica ma wielkość w jednostkach fizycznych i przedział ufności, a nie tylko wartość p.
- Krzywa kalibracyjna ma zakres, równanie, wykres reszt i odchylenie standardowe reszt.
- Wyniki pomiarów mają niepewność rozszerzoną z k i spójną liczbę cyfr.
- Wszystkie próbki są opisane, łącznie z tymi, które odrzucono, z regułą odrzucenia ustaloną przed badaniem.
- Liczba próbek ma uzasadnienie z mocy lub z precyzji.
Najczęstsze pytania
Czy trzy pomiary tej samej próbki to trzy powtórzenia w pracy inżynierskiej?
Nie. Kilka pomiarów jednej próbki zmniejsza tylko błąd samego pomiaru, ale nie mówi nic o tym, jak różnią się próbki wykonane tym samym sposobem. Uśrednij pomiary w obrębie próbki i porównuj średnie próbek albo użyj modelu mieszanego z losowym efektem próbki. W przykładzie z tego wpisu analiza 54 odcisków zamiast 18 próbek dawała fałszywie istotny wynik w 35.8% symulowanych doświadczeń.
Ile próbek przygotować do porównania dwóch wariantów materiału?
Policz to z mocy albo z oczekiwanej szerokości przedziału ufności, a do obliczeń użyj zmienności między próbkami, nie między pomiarami. W przykładzie, przy SD średniej próbki 4.9 HV, wykrycie różnicy 6 HV z mocą .80 wymagało 12 próbek na wariant. Więcej pomiarów na tej samej próbce prawie nie zmniejszało błędu standardowego, bo dominowała zmienność między próbkami.
Czy wysoki współczynnik korelacji potwierdza liniowość krzywej kalibracyjnej?
Nie. W przykładzie prosta dopasowana w zakresie 0–100 N miała r = .9998, a mimo to reszty układały się w łuk, a test braku dopasowania był wyraźnie istotny. Liniowość oceniaj na wykresie reszt i testem braku dopasowania przy powtarzanych punktach wzorcowych; jeśli zależność się zagina, zawęź zakres albo użyj modelu krzywoliniowego.
Jak zapisać wynik pomiaru z niepewnością w pracy inżynierskiej?
Podaj wartość, niepewność rozszerzoną i współczynnik rozszerzenia, np. d = (12.484 ± 0.004) mm przy k = 2. Niepewność zaokrąglij zwykle do jednej lub dwóch cyfr znaczących, a wynik do tego samego miejsca po przecinku. W metodzie wymień składowe: rozrzut powtórzonych odczytów (typ A) oraz rozdzielczość i wzorcowanie przyrządu (typ B).
Kiedy w pracy inżynierskiej użyć rozkładu Weibulla zamiast średniej i odchylenia standardowego?
Gdy badasz wytrzymałość materiałów kruchych lub czas do uszkodzenia i interesuje Cię prawdopodobieństwo zniszczenia przy danym obciążeniu. Podaj moduł Weibulla i wytrzymałość charakterystyczną z przedziałami ufności. Pamiętaj, że przy 10–30 próbkach moduł jest oszacowany mało dokładnie, a wnioski o bardzo małych prawdopodobieństwach zniszczenia są ekstrapolacją.
Powiązane hasła
Przeczytaj też
Eksperyment czynnikowy i frakcyjny
Pięć składników interwencji w 16 warunkach: plan 2^(5−1), aliasy w FrF2, kodowanie −1/+1, liczebność na efekt i pułapka rozdzielczości III.
Czytaj →PoradnikStatystyka w pracy z informatyki
Test użyteczności, test A/B, algorytmy na wielu zbiorach danych, ankieta akceptacji technologii i benchmarki: testy, wielkość efektu, zdania APA i kod R.
Czytaj →PoradnikStatystyka w pracy dyplomowej – przewodnik
Osiem etapów od hipotez do obrony: na każdy etap poradniki, hasła i kalkulatory oraz tabela typowych problemów z odpowiedzią, co przeczytać.
Czytaj →Piszesz pracę inżynierską z badaniem i nie wiesz, jak policzyć wyniki?
Pomożemy zaplanować liczbę próbek, dobrać analizę do Twojego doświadczenia – porównania wariantów, planu czynnikowego, kalibracji albo badań wytrzymałości – policzyć ją z niepewnością i wyjaśnić tak, żebyś umiał(a) samodzielnie ją opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Analytical Methods Committee. (1988). Uses (proper and improper) of correlation coefficients. The Analyst, 113(9), 1469. https://doi.org/10.1039/an9881301469
- Cole, T. J. (2015). Too many digits: The presentation of numerical data. Archives of Disease in Childhood, 100(7), 608–609. https://doi.org/10.1136/archdischild-2014-307149 ● Otwarty dostęp
- Hurlbert, S. H. (1984). Pseudoreplication and the design of ecological field experiments. Ecological Monographs, 54(2), 187–211. https://doi.org/10.2307/1942661
- Joint Committee for Guides in Metrology. (2008). Evaluation of measurement data — Guide to the expression of uncertainty in measurement (JCGM 100:2008). Bureau International des Poids et Mesures. https://doi.org/10.59161/jcgm100-2008e ● Otwarty dostęp: pełny tekst
- Lakens, D. (2017). Equivalence tests: A practical primer for t tests, correlations, and meta-analyses. Social Psychological and Personality Science, 8(4), 355–362. https://doi.org/10.1177/1948550617697177 ● Otwarty dostęp
- Lazic, S. E. (2010). The problem of pseudoreplication in neuroscientific studies: Is it affecting your analysis? BMC Neuroscience, 11(1), Article 5. https://doi.org/10.1186/1471-2202-11-5 ● Otwarty dostęp
- Lenth, R. V. (1989). Quick and easy analysis of unreplicated factorials. Technometrics, 31(4), 469–473. https://doi.org/10.1080/00401706.1989.10488595
- Maxwell, S. E., Kelley, K., & Rausch, J. R. (2008). Sample size planning for statistical power and accuracy in parameter estimation. Annual Review of Psychology, 59(1), 537–563. https://doi.org/10.1146/annurev.psych.59.103006.093735
- Quinn, J. B., & Quinn, G. D. (2010). A practical and systematic review of Weibull statistics for reporting strengths of dental materials. Dental Materials, 26(2), 135–147. https://doi.org/10.1016/j.dental.2009.09.006 ● Otwarty dostęp: pełny tekst
- Weibull, W. (1951). A statistical distribution function of wide applicability. Journal of Applied Mechanics, 18(3), 293–297. https://doi.org/10.1115/1.4010337 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{amc1988uses, author={{Analytical Methods Committee}}, title={{Uses (proper and improper) of correlation coefficients}}, journal={The Analyst}, year={1988}, volume={113}, number={9}, pages={1469}, doi={10.1039/an9881301469}}@article{cole2015too, author={Cole, T. J.}, title={{Too many digits: The presentation of numerical data}}, journal={Archives of Disease in Childhood}, year={2015}, volume={100}, number={7}, pages={608--609}, doi={10.1136/archdischild-2014-307149}}@article{hurlbert1984pseudoreplication, author={Hurlbert, Stuart H.}, title={{Pseudoreplication and the design of ecological field experiments}}, journal={Ecological Monographs}, year={1984}, volume={54}, number={2}, pages={187--211}, doi={10.2307/1942661}}@techreport{jcgm2008evaluation, author={{Joint Committee for Guides in Metrology}}, title={{Evaluation of measurement data — Guide to the expression of uncertainty in measurement}}, year={2008}, institution={Bureau International des Poids et Mesures}, doi={10.59161/jcgm100-2008e}}@article{lakens2017equivalence, author={Lakens, Daniël}, title={{Equivalence tests: A practical primer for t tests, correlations, and meta-analyses}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={4}, pages={355--362}, doi={10.1177/1948550617697177}}@article{lazic2010problem, author={Lazic, Stanley E.}, title={{The problem of pseudoreplication in neuroscientific studies: Is it affecting your analysis?}}, journal={BMC Neuroscience}, year={2010}, volume={11}, number={1}, eid={5}, doi={10.1186/1471-2202-11-5}}@article{lenth1989quick, author={Lenth, Russell V.}, title={{Quick and easy analysis of unreplicated factorials}}, journal={Technometrics}, year={1989}, volume={31}, number={4}, pages={469--473}, doi={10.1080/00401706.1989.10488595}}@article{maxwell2008sample, author={Maxwell, Scott E. and Kelley, Ken and Rausch, Joseph R.}, title={{Sample size planning for statistical power and accuracy in parameter estimation}}, journal={Annual Review of Psychology}, year={2008}, volume={59}, number={1}, pages={537--563}, doi={10.1146/annurev.psych.59.103006.093735}}@article{quinn2010practical, author={Quinn, Janet B. and Quinn, George D.}, title={{A practical and systematic review of Weibull statistics for reporting strengths of dental materials}}, journal={Dental Materials}, year={2010}, volume={26}, number={2}, pages={135--147}, doi={10.1016/j.dental.2009.09.006}}@article{weibull1951statistical, author={Weibull, Waloddi}, title={{A statistical distribution function of wide applicability}}, journal={Journal of Applied Mechanics}, year={1951}, volume={18}, number={3}, pages={293--297}, doi={10.1115/1.4010337}}