Pięć typowych projektów w pracy z informatyki
Praca dyplomowa z informatyki często kończy się rozdziałem „Ewaluacja”, a w nim tabelą liczb: czasów, odsetków, dokładności albo wyników ankiety. Promotor i recenzent pytają wtedy o to samo co na każdym innym kierunku: czy różnica jest większa niż przypadkowa zmienność i jak duża jest naprawdę. Kłopot w tym, że dane w informatyce mają kilka nietypowych cech. Czasy wykonania są prawoskośne. Jeden algorytm testuje się na wielu zbiorach danych naraz. Ten sam program uruchomiony dwa razy daje dwa różne czasy. A w badaniu z użytkownikami ta sama osoba często ocenia obie wersje systemu. Tabela porządkuje pięć projektów omówionych w tym poradniku.
| Projekt | Typowe pytanie | Jednostka analizy | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Test użyteczności | Czy nowy formularz skraca czas zadania i zwiększa odsetek sukcesów? | uczestnik (ocenia obie wersje) | test t dla par na logarytmach czasu; test McNemara | iloraz średnich geometrycznych z 95% CI; odsetki z CI Wilsona |
| 2. Test A/B | Czy nowy przycisk zwiększa odsetek rejestracji? | użytkownik (losowo przydzielony do wersji) | test dla dwóch proporcji | różnica w punktach procentowych z 95% CI, wzrost względny |
| 3. Porównanie algorytmów | Czy nowy klasyfikator jest lepszy od znanych metod? | zbiór danych | test Friedmana, post hoc Nemenyiego, test Wilcoxona dla par | średnie rangi, krytyczna różnica (CD), W Kendalla |
| 4. Akceptacja technologii | Co wiąże się z zamiarem korzystania z platformy? | respondent ankiety | rzetelność skal, regresja wieloraka, efekt pośredni | b i β z 95% CI, R² |
| 5. Pomiar wydajności | Czy nowa implementacja działa szybciej? | uruchomienie procesu | porównanie średnich z uruchomień na skali logarytmicznej | iloraz czasów z 95% CI, ICC |
Wszystkie dane w przykładach są symulowane, a liczby nie opisują żadnego rzeczywistego systemu. Pełny kod znajdziesz w sekcji Przykład w R, a dane z projektu 1 możesz pobrać jako plik CSV. Nie wiesz, który test pasuje do Twojej hipotezy? Pomoże kreator doboru testu, a cały proces od pytania badawczego do rozdziału wyników opisuje przewodnik po statystyce w pracy dyplomowej.
Zanim zaczniesz: co jest jednostką analizy
Najczęstszy błąd w pracach z informatyki to liczenie testu na niewłaściwych obserwacjach. Statystyka zakłada, że obserwacje są niezależne albo że ich zależność jest uwzględniona w modelu. Tymczasem w ewaluacji systemów łatwo „pomnożyć” dane: 10 foldów walidacji krzyżowej na jednym zbiorze to nie 10 niezależnych zbiorów, 300 iteracji pętli w jednym procesie to nie 300 niezależnych pomiarów, a 5 zadań wykonanych przez tę samą osobę to nie 5 osób. Takie traktowanie danych nazywa się pseudoreplikacją i daje zbyt wąskie przedziały ufności oraz zbyt małe wartości p.
Przed analizą odpowiedz więc na trzy pytania. Po pierwsze: czego dotyczy wniosek – użytkowników, zbiorów danych, maszyn, uruchomień programu? To jest jednostka analizy. Po drugie: czy te same jednostki występują w obu warunkach (pomiar zależny), czy w różnych (pomiar niezależny)? Po trzecie: co jest źródłem losowości – dobór uczestników, losowy przydział wersji, wybór zbiorów danych, niedeterminizm systemu? Od odpowiedzi zależy test. W tym poradniku każdy projekt zaczyna się od tej decyzji.
Jeśli badasz ludzi, pamiętaj też o formalnościach. Uczestnik testu użyteczności czy ankiety musi wiedzieć, na co się zgadza i jakie dane zbierasz (np. nagranie ekranu, logi kliknięć). Ustal z promotorem, czy badanie wymaga opinii komisji etycznej, i nie zapisuj danych identyfikujących w tym samym pliku co wyniki.
Projekt 1. Test użyteczności: czas zadania i sukces
Typowy temat: „Projekt i ewaluacja nowego interfejsu…”. Część ewaluacyjna to test z użytkownikami, w którym mierzysz trzy rzeczy: czy uczestnik wykonał zadanie (sukces), ile mu to zajęło (czas) i jak ocenia system (kwestionariusz). Ocena subiektywna to najczęściej SUS – jak policzyć wynik SUS i porównać dwie wersje systemu, opisujemy w osobnym poradniku. Lewis (2018) w przeglądzie historii skali pokazuje, że jest to najczęściej używany standaryzowany kwestionariusz postrzeganej użyteczności. Jeśli interesuje Cię obciążenie pracą, użyj NASA-TLX. Tutaj zajmujemy się miarami obiektywnymi: czasem i sukcesem.
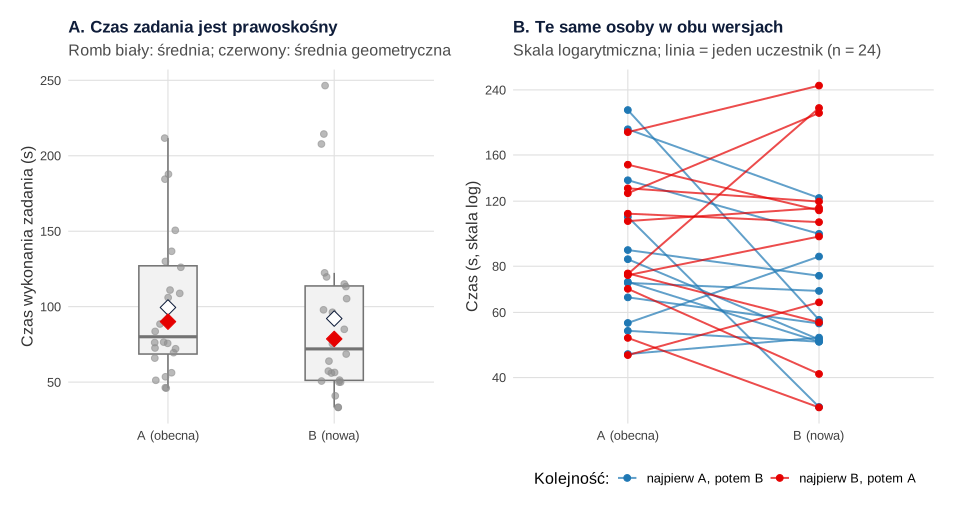
Przykład: 24 osoby wykonały zadanie „załóż konto i ustaw powiadomienia” w obecnej wersji formularza (A) i w nowej (B). Każdy uczestnik testował obie wersje, więc to schemat wewnątrzosobowy: różnice między ludźmi (jedni klikają szybko, inni wolno) znoszą się w porównaniu. Ceną jest efekt kolejności – w drugiej wersji uczestnik zna już zadanie. Dlatego zastosowano kontrbalansowanie: 12 osób zaczynało od A, a 12 od B.
Krok 1. Opis czasu: dlaczego średnia nie wystarcza
Czasy zadań mają prawy ogon: większość osób kończy w podobnym czasie, ale kilka utknie i potrzebuje dwa razy więcej. W przykładzie skośność wynosiła 0.88 w wersji A i 1.32 w wersji B, a najdłuższe czasy (211.7 i 246.5 s) były ponad dwukrotnie dłuższe od mediany. Średnia arytmetyczna (99.46 s w A i 92.11 s w B) jest wtedy zawyżona przez kilka wolnych osób. Sauro i Lewis (2010) w symulacjach na danych z 61 zadań z testów użyteczności pokazali, że mediana z próby jest obciążonym oszacowaniem środka rozkładu czasu, a średnia geometryczna ma średnio o 13% mniejszy błąd i o 22% mniejsze obciążenie. Średnia geometryczna to średnia z logarytmów czasu przeliczona z powrotem na sekundy: w przykładzie 90.07 s w wersji A i 78.62 s w wersji B (mediany: 80.05 i 72.00 s).
Krok 2. Porównanie czasu na skali logarytmicznej
Ponieważ te same osoby testowały obie wersje, użyj testu t dla prób zależnych, ale nie na sekundach, tylko na logarytmach czasu (transformacja logarytmiczna). Ma to dwie zalety. Rozkład różnic logarytmów jest zwykle bliższy normalnemu. A wynik po odwróceniu logarytmu jest ilorazem średnich geometrycznych, czyli łatwą do opisania zmianą procentową: „wersja B skraca czas o tyle a tyle procent”.
W przykładzie iloraz średnich geometrycznych B/A wyniósł 0.87, 95% CI [0.71, 1.08], t(23) = −1.32, p = .198, dz = −0.27 (na skali logarytmów). Oszacowanie wskazuje skrócenie czasu o około 13%, ale przedział jest szeroki: dane są zgodne zarówno ze skróceniem o 29%, jak i z wydłużeniem o 8%. Test Wilcoxona dla par na surowych czasach jako analiza wrażliwości dał ten sam wniosek, V = 108, p = .236. Wynik nieistotny nie oznacza, że wersje są równie dobre – oznacza, że 24 osoby to za mało, by rozstrzygnąć różnicę tej wielkości.
Krok 3. Sprawdź efekt kolejności
Kontrbalansowanie równoważy efekt kolejności w średniej, ale warto go pokazać, bo zwiększa rozrzut różnic. U osób, które zaczynały od A, czas w B był średnio o 29% krótszy (iloraz 0.71), a u osób zaczynających od B – o 7% dłuższy (iloraz 1.07). Różnica między grupami kolejności była istotna, t(21.78) = −2.10, p = .047. To typowy efekt przeniesienia: w drugiej próbie uczestnik zna już zadanie. Bez kontrbalansowania, gdyby wszyscy zaczynali od starej wersji, nowa wersja wyglądałaby na dużo lepszą, niż jest. Jeśli zadanie silnie uczy, rozważ schemat międzyosobowy (każdy testuje jedną wersję) albo dwa równoległe zadania.
Krok 4. Sukces zadania: odsetki z przedziałem ufności
Zadanie bez pomocy moderatora ukończyło 13 z 24 osób w wersji A (54.2%) i 19 z 24 w wersji B (79.2%). Przy tak małych próbach każdy odsetek podaj z przedziałem ufności dla proporcji, ale nie z prostego wzoru Walda. Agresti i Coull (1998) pokazali, że przedział Walda ma zbyt niskie pokrycie, a przedział Wilsona i skorygowany przedział Walda (po dodaniu dwóch sukcesów i dwóch porażek) mają pokrycie bliskie nominalnemu nawet przy bardzo małych próbach. Przedział Wilsona wyniósł [35.1, 72.1]% dla wersji A i [59.5, 90.8]% dla wersji B.
Sukcesy są sparowane (te same osoby), więc porównaj je testem McNemara. Liczą się tylko pary niezgodne: 9 osób poradziło sobie tylko w wersji B, a 3 tylko w wersji A. Dokładny test McNemara dał p = .146. Znów: kierunek jest obiecujący, ale próba za mała na pewny wniosek.
Krok 5. Ile osób do następnego badania
Wyniki pilotażu to najlepsze źródło do planowania liczebności. Odchylenie standardowe różnic logarytmów czasu wyniosło 0.50. Aby z mocą 80% wykryć skrócenie czasu o 15% (iloraz 0.85), potrzeba około 78 uczestników w schemacie wewnątrzosobowym. W pracy dyplomowej zwykle nie da się tego osiągnąć, dlatego uczciwie nazwij badanie pilotażowym lub eksploracyjnym, raportuj przedziały ufności i nie pisz, że „wersje się nie różnią”.
Projekt 2. Test A/B: dwie proporcje
Test A/B to eksperyment na prawdziwych użytkownikach serwisu: każdy nowy odwiedzający losowo trafia do wersji A albo B, a Ty mierzysz jedną metrykę główną, np. odsetek rejestracji. Kohavi i in. (2009) opisują takie kontrolowane eksperymenty w sieci jako najlepszy sposób ustalania związku przyczynowego między zmianą a zachowaniem użytkowników i zwracają uwagę na moc statystyczną, liczebność próby oraz randomizację, która w praktyce bywa trudniejsza, niż się wydaje. Plan testu – metrykę, liczebność, czas trwania i zakaz kończenia testu, „gdy wyjdzie” – omawiamy w poradniku test A/B: plan i analiza. Tu tylko analiza wyniku.
Przykład: po 2400 osób w każdej wersji. Zarejestrowało się 291 osób w wersji A (12.12%) i 374 w wersji B (15.58%). Grupy są niezależne, a wynik to tak/nie, więc właściwy jest test dla dwóch proporcji: χ²(1) = 12.03, p < .001. Sam test nie mówi jednak, jak duża jest różnica. Podaj ją w punktach procentowych z przedziałem Newcombe’a: 3.46 punktu procentowego, 95% CI [1.50, 5.41]. W raportach biznesowych podaje się też wzrost względny: odsetek rejestracji w B był 1.285 raza wyższy, czyli o 28.5%. Uważaj, by nie mylić tych dwóch liczb – „wzrost o 28.5%” brzmi znacznie efektowniej niż „wzrost o 3.5 punktu procentowego”, choć opisuje ten sam wynik.
Projekt 3. Porównanie algorytmów na wielu zbiorach danych
W pracach o uczeniu maszynowym typowa tabela wyników ma algorytmy w kolumnach, zbiory danych w wierszach i pogrubioną najlepszą wartość w każdym wierszu. Policzenie „ile razy wygrał nasz algorytm” to jeszcze nie analiza statystyczna. Demšar (2006) przejrzał praktykę porównywania klasyfikatorów na wielu zbiorach danych i zalecił dwa narzędzia: test Wilcoxona dla par, gdy porównujesz dwa klasyfikatory, oraz test Friedmana z testami post hoc, gdy porównujesz więcej. Wyniki tych drugich można pokazać na wykresie krytycznej różnicy (CD). Kluczowa decyzja: jednostką analizy jest zbiór danych, a zbiory są „blokami”, w których porównujesz algorytmy.
Skąd liczba w każdej komórce tabeli
Wartość w komórce, np. AUC albo dokładność, sama jest oszacowaniem – najczęściej średnią z walidacji krzyżowej. Kusi, by porównać dwa algorytmy na jednym zbiorze testem t na wynikach z kolejnych foldów. Dietterich (1998) porównał pięć takich testów i pokazał, że test t dla par oparty na wielu losowych podziałach na część uczącą i testową oraz test różnicy dwóch proporcji mają w pewnych sytuacjach wysoki błąd I rodzaju i nie powinny być stosowane. Test t na 10-krotnej walidacji krzyżowej miał błąd nieco zawyżony. Dla algorytmów, które można uruchomić tylko raz, autor zaleca test McNemara, a dla tych, które można uruchomić 10 razy – test 5 × 2 cv (pięć powtórzeń dwukrotnej walidacji krzyżowej). Jeśli Twoja praca porównuje metody na jednym zbiorze, wybierz jedną z tych procedur i opisz ją. Jeśli na wielu – przejdź do testu Friedmana.
Test Friedmana i średnie rangi
Przykład: cztery klasyfikatory (regresja logistyczna, las losowy, gradient boosting, k-NN) oceniono na 15 zbiorach danych miarą AUC z walidacji krzyżowej. Średnie AUC wyniosły .826, .856, .849 i .809. Średnie z różnych zbiorów trudno jednak porównywać, bo zbiory różnią się trudnością: AUC .80 może być świetnym wynikiem na jednym zbiorze i słabym na innym. Dlatego w każdym zbiorze nadaj algorytmom rangi (1 = najlepszy) i uśrednij je. Średnie rangi wyniosły 1.40 dla lasu losowego, 1.87 dla gradient boosting, 3.20 dla regresji logistycznej i 3.53 dla k-NN.
Test Friedmana sprawdza, czy średnie rangi różnią się bardziej, niż wynikałoby z przypadku: χ²(3) = 28.52, p < .001. Jako wielkość efektu podaj W Kendalla = .634 (0 – brak zgodności rang między zbiorami, 1 – ta sama kolejność algorytmów w każdym zbiorze). Po istotnym wyniku policz test Nemenyiego: dwa algorytmy różnią się istotnie, jeśli ich średnie rangi dzieli więcej niż krytyczna różnica, tu CD = 1.21. Las losowy był lepszy od regresji logistycznej (p < .001) i k-NN (p < .001), a gradient boosting od regresji logistycznej (p = .024) i k-NN (p = .002). Las losowy i gradient boosting nie różniły się istotnie (p = .755), podobnie regresja logistyczna i k-NN (p = .894).
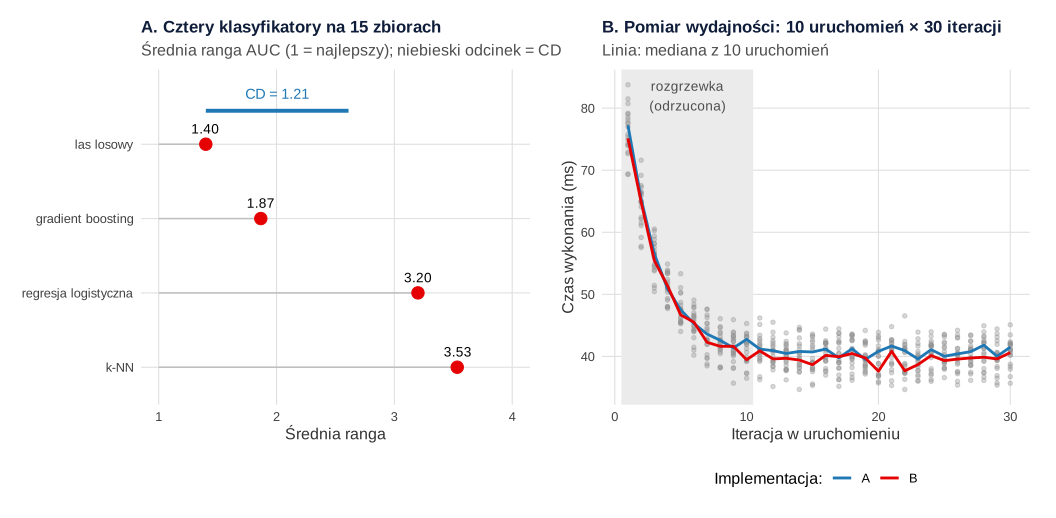
Rysunek 2A to uproszczona wersja wykresu CD: algorytmy, których średnie rangi dzieli mniej niż długość niebieskiego odcinka, nie różnią się istotnie. Gdy interesuje Cię tylko porównanie dwóch najlepszych metod, użyj testu Wilcoxona dla par na 15 zbiorach: gradient boosting a las losowy, V = 27, p = .064. Ten sam schemat analizy w programie z menu pokazujemy w poradniku testy nieparametryczne w jamovi, a przećwiczyć odczyt testów Friedmana i Wilcoxona możesz na zadaniach z testów nieparametrycznych.
Dwie uwagi praktyczne. Zbiory danych dobierz przed eksperymentem i opisz kryterium wyboru – dodawanie zbiorów, „na których nasz algorytm wypada dobrze”, czyni test bezwartościowym. Hiperparametry stroj w tej samej procedurze dla wszystkich algorytmów, wewnątrz walidacji, a nie na zbiorze testowym.
Projekt 4. Ankieta o akceptacji technologii
Gdy praca dotyczy wdrożenia systemu (platformy e-learningowej, aplikacji bankowej, narzędzia w firmie), częstym narzędziem jest ankieta oparta na modelu akceptacji technologii. Davis (1989) opracował i zwalidował dwie skale – postrzeganej użyteczności i postrzeganej łatwości użycia – w dwóch badaniach ze 152 użytkownikami. Użyteczność korelowała z używaniem systemu silniej niż łatwość użycia, a analizy regresji sugerowały, że łatwość użycia działa raczej przez użyteczność niż bezpośrednio. Ten model doczekał się wielu rozszerzeń; w pracy dyplomowej wybierz jedną, uzasadnioną wersję i nie dokładaj konstruktów „na zapas”. Pozycje kwestionariusza weź z opublikowanej, przetłumaczonej i sprawdzonej wersji – nie układaj ich samodzielnie bez pilotażu.
Przykład: 220 studentów oceniło platformę e-learningową na trzech skalach (1–7): postrzegana użyteczność (4 pozycje), postrzegana łatwość użycia (4 pozycje) i zamiar dalszego korzystania (3 pozycje). Spójność wewnętrzna była dobra: α = .87, .85 i .88. Wynik skali to średnia pozycji: M = 4.50 (SD = 1.04) dla użyteczności, 4.50 (1.04) dla łatwości użycia i 4.55 (1.10) dla zamiaru. Zamiar korzystania korelował z użytecznością (r = .51) silniej niż z łatwością użycia (r = .37).
W regresji wielorakiej oba predyktory wyjaśniały 29.7% wariancji zamiaru, R² = .297, F(2, 217) = 45.92, p < .001. Użyteczność: b = 0.46, 95% CI [0.33, 0.59], β = 0.43, p < .001; łatwość użycia: b = 0.22, 95% CI [0.09, 0.35], β = 0.21, p < .001. Ponieważ model zakłada, że łatwość użycia wpływa także na użyteczność, policz efekt pośredni łatwość → użyteczność → zamiar: 0.174, 95% CI bootstrap [0.108, 0.250]. Procedurę i jej interpretację opisuje poradnik analiza mediacji krok po kroku. Pamiętaj, że to dane przekrojowe: pisz o związkach zgodnych z modelem, a nie o udowodnionych przyczynach.
Jeśli skale mają wiele pozycji, a promotor oczekuje sprawdzenia trafności czynnikowej, zamiast średnich z pozycji zbuduj model pomiarowy i strukturalny – modelowanie równań strukturalnych (SEM). Daje ono oszacowania wolne od błędu pomiaru, ale wymaga większej próby i raportowania dopasowania modelu.
Projekt 5. Pomiar wydajności: powtarzalność i rozgrzewka
„Nowa implementacja jest o 2% szybsza” – takie zdanie w pracy inżynierskiej ma sens tylko wtedy, gdy wiesz, jak bardzo zmienia się czas tej samej implementacji między pomiarami. Georges i in. (2007) pokazali na przykładzie Javy, że czas wykonania programu różni się między uruchomieniami z powodu niedeterminizmu (kompilacja JIT, szeregowanie wątków, odśmiecanie pamięci), a popularne praktyki – raportowanie najlepszego wyniku, średniej z iteracji w jednym procesie albo pojedynczego pomiaru – mogą prowadzić do błędnych wniosków. Autorzy zalecają rygorystyczną analizę statystyczną i osobne traktowanie wydajności przy starcie oraz w stanie ustalonym. Mytkowicz i in. (2009) poszli dalej: zmiana pozornie nieistotnego elementu konfiguracji eksperymentu potrafi odwrócić wniosek, a takie obciążenie pomiaru okazało się powszechne – w przeglądzie 133 prac żadna nie uwzględniała go właściwie. Jako zabezpieczenie proponują randomizację układu eksperymentu.
Uruchomienie procesu jako jednostka analizy
Przykład: dwie implementacje tej samej funkcji (A i B), każdą uruchomiono w 10 osobnych procesach, a w każdym procesie wykonano 30 iteracji. Rysunek 2B pokazuje dwie rzeczy. Pierwsze iteracje są wyraźnie wolniejsze (rozgrzewka), więc trzeba je odrzucić, jeśli pytasz o wydajność w stanie ustalonym – tu odrzucono 10 pierwszych. A pomiary z jednego procesu są do siebie podobne: w stanie ustalonym 71.5% zmienności logarytmu czasu przypadało na różnice między uruchomieniami (ICC = .715). Oznacza to, że 20 iteracji w jednym procesie niesie niewiele więcej informacji niż jedna.
Porównaj więc uruchomienia, a nie iteracje: policz średnią (na skali logarytmicznej) z iteracji po rozgrzewce w każdym uruchomieniu i porównaj 10 średnich A z 10 średnimi B testem Welcha. Iloraz czasów B/A wyniósł 0.980, 95% CI [0.934, 1.028], p = .384. Gdyby potraktować wszystkie 300 iteracji na wersję jako niezależne (razem z rozgrzewką), iloraz wyszedłby podobny, 0.981, ale przedział byłby prawie dwa razy węższy, [0.955, 1.007], p = .143. W tym przykładzie żaden z wniosków nie jest istotny, ale przy nieco większej różnicy błędna analiza dałaby „istotny” wynik tam, gdzie poprawna dałaby szeroki przedział. Raportuj też, na czym mierzono: sprzęt, system, wersje kompilatora lub maszyny wirtualnej, obciążenie maszyny, liczbę uruchomień i iteracji oraz regułę odrzucania rozgrzewki.
Jak opisać analizę statystyczną w pracy z informatyki
Rozdział o ewaluacji powinien pozwolić innej osobie powtórzyć eksperyment. W informatyce oznacza to oprócz opisu testów także opis środowiska, wersji oprogramowania, ziaren generatora liczb losowych i procedury podziału danych. Poniżej wzór akapitu dla projektów 1 i 3. Gotowy opis wyniku pojedynczego testu możesz sprawdzić w generatorze opisu wyników APA, a test t dla par bez pisania kodu policzysz w programie z menu według poradnika test t w jamovi.
Jeśli potrzebujesz pomocy w doborze analiz albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Przykład w R: test użyteczności i pozostałe projekty
Kod odtwarza wszystkie liczby z tego wpisu. Najważniejszy jest przepis 1 z pełną analizą testu użyteczności: od opisu rozkładu czasu, przez test t na logarytmach i efekt kolejności, po odsetki sukcesów, test McNemara i liczebność kolejnego badania. Przepis 2 zawiera pozostałe projekty, a przepis 3 – rysunki. Każdy projekt tworzy własne dane symulowane. Test Nemenyiego liczy pakiet PMCMRplus, przedziały dla proporcji – pakiet DescTools, rzetelność skal – pakiet psych, a przedział bootstrapowy efektu pośredniego – pakiet boot.
1. Projekt 1: czas zadania na skali logarytmicznej, efekt kolejności, sukces i liczebność
R
# Projekt 1: test użyteczności dwóch wersji formularza rejestracji (dane symulowane).
# 24 uczestników wykonuje to samo zadanie w wersji A (obecnej) i B (nowej); kolejność
# kontrbalansowana: 12 osób zaczyna od A, 12 od B. Mierzymy czas zadania (s) i sukces (0/1).
suppressPackageStartupMessages(library(DescTools))
set.seed(41401)
n <- 24
kolejnosc <- rep(c("AB", "BA"), each = n / 2)
osoba <- rnorm(n, 0, 0.35)                        # stałe różnice tempa między osobami (log s)
druga <- function(wersja) ifelse((kolejnosc == "AB") == (wersja == "B"), 1, 0)  # 1 = wersja oceniana jako druga
log_A <- log(95) + osoba + log(0.90) * druga("A") + rnorm(n, 0, 0.30)
log_B <- log(95) + osoba + log(0.78) + log(0.90) * druga("B") + rnorm(n, 0, 0.30)
uz <- data.frame(id = 1:n, kolejnosc, czas_A = round(exp(log_A), 1), czas_B = round(exp(log_B), 1),
                 sukces_A = rbinom(n, 1, .62), sukces_B = rbinom(n, 1, .88))

# Krok 1. Opis czasu: średnia, mediana, średnia geometryczna, skośność
opis <- function(x) c(M = mean(x), SD = sd(x), Me = median(x), M_geom = exp(mean(log(x))),
                      Min = min(x), Max = max(x), Skosnosc = Skew(x))
round(rbind(A = opis(uz$czas_A), B = opis(uz$czas_B)), 2)

# Krok 2. Test t dla prób zależnych na logarytmach czasu -> iloraz średnich geometrycznych B/A
roznica_log <- log(uz$czas_B) - log(uz$czas_A)
tt <- t.test(roznica_log)
round(c(t = unname(tt$statistic), df = unname(tt$parameter), p = tt$p.value,
        iloraz_geom = exp(unname(tt$estimate)), CI_d = exp(tt$conf.int[1]), CI_g = exp(tt$conf.int[2]),
        d_z = mean(roznica_log) / sd(roznica_log)), 4)

# Krok 3. Analiza wrażliwości: test Wilcoxona dla par na surowych czasach
wilcox.test(uz$czas_B, uz$czas_A, paired = TRUE, exact = FALSE)

# Krok 4. Czy kolejność ma znaczenie? Różnica log(B) − log(A) w dwóch grupach kolejności
round(tapply(exp(roznica_log), uz$kolejnosc, function(x) exp(mean(log(x)))), 3)
t.test(roznica_log ~ uz$kolejnosc)

# Krok 5. Sukces zadania: odsetki z przedziałami Wilsona i Agrestiego–Coulla oraz dokładny test McNemara
ci <- rbind(BinomCI(sum(uz$sukces_A), n, method = "wilson"), BinomCI(sum(uz$sukces_A), n, method = "agresti-coull"),
            BinomCI(sum(uz$sukces_B), n, method = "wilson"), BinomCI(sum(uz$sukces_B), n, method = "agresti-coull"))
rownames(ci) <- c("A_Wilson", "A_AgrestiCoull", "B_Wilson", "B_AgrestiCoull")
round(ci, 3)
tab <- table(A = uz$sukces_A, B = uz$sukces_B)
tab
binom.test(tab["0", "1"], tab["0", "1"] + tab["1", "0"])   # dokładny McNemar = test dwumianowy na parach niezgodnych

# Krok 6. Ile osób do kolejnego badania? Moc 80% dla ilorazu 0.85 przy SD różnic logarytmów z tego badania
power.t.test(delta = abs(log(0.85)), sd = sd(roznica_log), sig.level = .05, power = .80, type = "one.sample")

# Dane do pobrania (CSV)
write.csv(uz, "../statystyka-informatyka-test-uzytecznosci.csv", row.names = FALSE)
Wynik w R
      M    SD    Me M_geom  Min   Max Skosnosc
A 99.46 47.11 80.05  90.07 46.0 211.7     0.88
B 92.11 57.86 72.00  78.62 33.2 246.5     1.32
          t          df           p iloraz_geom        CI_d        CI_g         d_z
    -1.3243     23.0000      0.1984      0.8729      0.7058      1.0794     -0.2703

	Wilcoxon signed rank test with continuity correction

data:  uz$czas_B and uz$czas_A
V = 108, p-value = 0.2357
alternative hypothesis: true location shift is not equal to 0

   AB    BA
0.714 1.068

	Welch Two Sample t-test

data:  roznica_log by uz$kolejnosc
t = -2.1038, df = 21.777, p-value = 0.04718
alternative hypothesis: true difference in means between group AB and group BA is not equal to 0
95 percent confidence interval:
 -0.800574971 -0.005495879
sample estimates:
mean in group AB mean in group BA
     -0.33749394       0.06554148

                 est lwr.ci upr.ci
A_Wilson       0.542  0.351  0.721
A_AgrestiCoull 0.542  0.351  0.721
B_Wilson       0.792  0.595  0.908
B_AgrestiCoull 0.792  0.591  0.912
   B
A    0  1
  0  2  9
  1  3 10

	Exact binomial test

data:  tab["0", "1"] and tab["0", "1"] + tab["1", "0"]
number of successes = 9, number of trials = 12, p-value = 0.146
alternative hypothesis: true probability of success is not equal to 0.5
95 percent confidence interval:
 0.4281415 0.9451394
sample estimates:
probability of success
                  0.75


     One-sample t test power calculation

              n = 77.12814
          delta = 0.1625189
             sd = 0.5029986
      sig.level = 0.05
          power = 0.8
    alternative = two.sided
2. Projekty 2–5: test A/B, algorytmy na wielu zbiorach, akceptacja technologii i pomiar wydajności
R
# Projekty 2–5: test A/B, porównanie algorytmów, ankieta akceptacji technologii, pomiar wydajności (dane symulowane).
suppressPackageStartupMessages({ library(DescTools); library(PMCMRplus); library(psych); library(boot) })

# ---- Projekt 2. Test A/B: odsetek rejestracji w dwóch wersjach strony ----
set.seed(41402)
n_ab <- c(A = 2400, B = 2400)
x_ab <- c(A = rbinom(1, 2400, .130), B = rbinom(1, 2400, .150))
x_ab; round(100 * x_ab / n_ab, 2)
prop.test(x_ab, n_ab, correct = FALSE)
roznica <- BinomDiffCI(x_ab["B"], n_ab["B"], x_ab["A"], n_ab["A"], method = "score")   # Newcombe (Wilson score)
rownames(roznica) <- "B - A"; round(100 * roznica, 2)
round(c(wzrost_wzgledny = unname((x_ab["B"] / n_ab["B"]) / (x_ab["A"] / n_ab["A"]))), 3)

# ---- Projekt 3. Cztery klasyfikatory na 15 zbiorach danych (AUC z walidacji krzyżowej) ----
set.seed(41403)
N <- 15; algorytmy <- c("reg_logistyczna", "las_losowy", "gradient_boosting", "k_NN")
trudnosc <- runif(N, .70, .92)                                  # zbiory różnią się trudnością
przewaga <- c(reg_logistyczna = 0, las_losowy = .020, gradient_boosting = .025, k_NN = -.015)
auc <- sapply(algorytmy, function(a) pmin(.99, trudnosc + przewaga[a] + rnorm(N, 0, .018)))
rownames(auc) <- paste0("zbior_", 1:N)
round(head(auc, 3), 3)
round(colMeans(auc), 3)
rangi <- t(apply(-auc, 1, rank))                                # ranga 1 = najlepszy AUC w danym zbiorze
round(colMeans(rangi), 2)
fr <- friedman.test(auc)
fr
k <- ncol(auc)
round(c(W_Kendalla = unname(fr$statistic) / (N * (k - 1)),
        CD_Nemenyi = qtukey(.95, k, Inf) / sqrt(2) * sqrt(k * (k + 1) / (6 * N))), 3)
frdAllPairsNemenyiTest(auc)
# Dwa najlepsze algorytmy: test Wilcoxona dla par na 15 zbiorach
wilcox.test(auc[, "gradient_boosting"], auc[, "las_losowy"], paired = TRUE, exact = TRUE)

# ---- Projekt 4. Ankieta akceptacji platformy e-learningowej (użyteczność, łatwość użycia, intencja) ----
set.seed(41404)
n4 <- 220
peou <- rnorm(n4); pu <- .50 * peou + rnorm(n4, 0, .87); bi <- .55 * pu + .15 * peou + rnorm(n4, 0, .78)
pozycje <- function(lat, k, lad) sapply(1:k, function(j) pmin(7, pmax(1, round(4.6 + 1.2 * (lad * lat + rnorm(length(lat), 0, sqrt(1 - lad^2)))))))
PU <- pozycje(pu, 4, .80); PEOU <- pozycje(peou, 4, .75); BI <- pozycje(bi, 3, .85)
round(c(alfa_PU = psych::alpha(PU)$total$raw_alpha, alfa_PEOU = psych::alpha(PEOU)$total$raw_alpha, alfa_BI = psych::alpha(BI)$total$raw_alpha), 2)
d4 <- data.frame(PU = rowMeans(PU), PEOU = rowMeans(PEOU), BI = rowMeans(BI))
round(sapply(d4, function(x) c(M = mean(x), SD = sd(x))), 2)
round(cor(d4), 2)
m4 <- lm(BI ~ PU + PEOU, data = d4)
signif(summary(m4)$coefficients, 4)
round(c(R2 = summary(m4)$r.squared, summary(m4)$fstatistic), 3)
round(coef(lm(scale(BI) ~ scale(PU) + scale(PEOU), data = d4))[-1], 3)      # beta standaryzowane
round(confint(m4), 3)
# Efekt pośredni łatwość użycia -> użyteczność -> intencja: a × b z przedziałem bootstrapowym (2000 prób)
posredni <- function(d, i) { d <- d[i, ]; coef(lm(PU ~ PEOU, d))["PEOU"] * coef(lm(BI ~ PU + PEOU, d))["PU"] }
bt <- boot(d4, posredni, R = 2000)
round(setNames(c(bt$t0, boot.ci(bt, type = "perc")$percent[4:5]), c("a_x_b", "CI_d", "CI_g")), 3)

# ---- Projekt 5. Pomiar wydajności: dwie implementacje, 10 uruchomień procesu × 30 iteracji ----
set.seed(41405)
pomiary <- do.call(rbind, lapply(c("A", "B"), function(w) do.call(rbind, lapply(1:10, function(u) {
  it <- 1:30
  poziom <- log(40) + log(ifelse(w == "B", 0.96, 1)) + rnorm(1, 0, 0.05)    # stan procesu: różny w każdym uruchomieniu
  rozgrzewka <- 0.9 * exp(-(it - 1) / 2.5)                                  # pierwsze iteracje wolniejsze
  data.frame(wersja = w, uruchomienie = u, iteracja = it,
             ms = exp(poziom + log1p(rozgrzewka) + rnorm(30, 0, 0.03)) + rexp(30, 1 / 0.8) * rbinom(30, 1, .1))
}))))
aggregate(ms ~ wersja, data = pomiary, FUN = function(x) round(c(M = mean(x), Me = median(x), Max = max(x)), 2))
# Źle: wszystkie 300 iteracji jako niezależne obserwacje, z rozgrzewką
zle <- t.test(log(ms) ~ wersja, data = pomiary)
round(c(iloraz_B_A = exp(unname(diff(zle$estimate))), CI_d = exp(-zle$conf.int[2]), CI_g = exp(-zle$conf.int[1]), p = zle$p.value), 4)
# Dobrze: bez 10 pierwszych iteracji, średnia (geometryczna) na uruchomienie, porównanie 10 vs 10 uruchomień
ustalony <- subset(pomiary, iteracja > 10)
na_uruch <- aggregate(log(ms) ~ wersja + uruchomienie, data = ustalony, FUN = mean)
names(na_uruch)[3] <- "log_ms"
dobrze <- t.test(log_ms ~ wersja, data = na_uruch)
round(c(iloraz_B_A = exp(unname(diff(dobrze$estimate))), CI_d = exp(-dobrze$conf.int[2]), CI_g = exp(-dobrze$conf.int[1]), p = dobrze$p.value), 4)
# Jaką część zmienności (stan ustalony) stanowią różnice między uruchomieniami?
a5 <- anova(lm(log(ms) ~ factor(paste(wersja, uruchomienie)), data = ustalony))
ms_b <- a5$`Mean Sq`[1]; ms_w <- a5$`Mean Sq`[2]; m_it <- 20
round(c(ICC_uruchomienie = (ms_b - ms_w) / (ms_b + (m_it - 1) * ms_w)), 3)
Wynik w R
  A   B
291 374
    A     B
12.12 15.58

	2-sample test for equality of proportions without continuity correction

data:  x_ab out of n_ab
X-squared = 12.025, df = 1, p-value = 0.0005248
alternative hypothesis: two.sided
95 percent confidence interval:
 -0.05410514 -0.01506152
sample estimates:
   prop 1    prop 2
0.1212500 0.1558333

      est.B lwr.ci upr.ci
B - A  3.46    1.5   5.41
wzrost_wzgledny
          1.285
        reg_logistyczna las_losowy gradient_boosting  k_NN
zbior_1           0.766      0.798             0.793 0.756
zbior_2           0.848      0.893             0.872 0.840
zbior_3           0.822      0.890             0.861 0.841
  reg_logistyczna        las_losowy gradient_boosting              k_NN
            0.826             0.856             0.849             0.809
  reg_logistyczna        las_losowy gradient_boosting              k_NN
             3.20              1.40              1.87              3.53

	Friedman rank sum test

data:  auc
Friedman chi-squared = 28.52, df = 3, p-value = 2.825e-06

W_Kendalla CD_Nemenyi
     0.634      1.211

	Pairwise comparisons using Nemenyi-Wilcoxon-Wilcox all-pairs test for a two-way balanced complete block design

data: y

                  reg_logistyczna las_losowy gradient_boosting
las_losowy        0.00077         -          -
gradient_boosting 0.02418         0.75518    -
k_NN              0.89433         3.6e-05    0.00230

P value adjustment method: single-step

	Wilcoxon signed rank exact test

data:  auc[, "gradient_boosting"] and auc[, "las_losowy"]
V = 27, p-value = 0.06372
alternative hypothesis: true location shift is not equal to 0

  alfa_PU alfa_PEOU   alfa_BI
     0.87      0.85      0.88
     PU PEOU   BI
M  4.50 4.50 4.55
SD 1.04 1.04 1.10
       PU PEOU   BI
PU   1.00 0.38 0.51
PEOU 0.38 1.00 0.37
BI   0.51 0.37 1.00
            Estimate Std. Error t value  Pr(>|t|)
(Intercept)   1.4930    0.33330   4.480 1.208e-05
PU            0.4567    0.06534   6.990 3.344e-11
PEOU          0.2223    0.06528   3.406 7.867e-04
     R2   value   numdf   dendf
  0.297  45.920   2.000 217.000
  scale(PU) scale(PEOU)
       0.43        0.21
            2.5 % 97.5 %
(Intercept) 0.836  2.150
PU          0.328  0.586
PEOU        0.094  0.351
a_x_b  CI_d  CI_g
0.174 0.108 0.250
  wersja  ms.M ms.Me ms.Max
1      A 44.14 41.73  83.77
2      B 43.30 40.98  81.49
iloraz_B_A       CI_d       CI_g          p
    0.9807     0.9554     1.0066     0.1428
iloraz_B_A       CI_d       CI_g          p
    0.9798     0.9338     1.0281     0.3842
ICC_uruchomienie
           0.715
3. Rysunki
R
# Rysunki do wpisu (uruchom z folderu kod/): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b414-rysunki.R > b414-rysunki-wynik.txt
suppressPackageStartupMessages({ library(ggplot2); library(patchwork); library(svglite) })
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", dane = "grey55", granat = "#0f1d3a")
theme_metodolog <- function(base_size = 13) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05), margin = margin(b = 6)),
          plot.subtitle = element_text(colour = "grey30", margin = margin(b = 8)),
          panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
          axis.title = element_text(colour = "grey20"), axis.text = element_text(colour = "grey25"),
          legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
          plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(grDevices::dev.off())
  cat(sprintf("Zapisano %s: w HTML width=\"%d\" height=\"%d\" (%d KB)\n", plik, round(szer * 100), round(wys * 100), round(file.info(plik)$size / 1024)))
}
pdf(NULL)
invisible(capture.output({ for (f in c("b414-1-test-uzytecznosci.R", "b414-2-pozostale-projekty.R")) source(f) }))

# Rysunek 1: czas zadania w teście użyteczności – rozkład (A) i pary pomiarów na skali logarytmicznej (B)
dl <- rbind(data.frame(id = uz$id, kolejnosc = uz$kolejnosc, wersja = "A (obecna)", czas = uz$czas_A),
            data.frame(id = uz$id, kolejnosc = uz$kolejnosc, wersja = "B (nowa)", czas = uz$czas_B))
sr <- aggregate(czas ~ wersja, data = dl, FUN = function(x) c(M = mean(x), Mg = exp(mean(log(x))), Me = median(x)))
sr <- data.frame(wersja = sr$wersja, sr$czas)
print(sr, digits = 4, row.names = FALSE)
r1a <- ggplot(dl, aes(wersja, czas)) +
  geom_boxplot(width = .35, outlier.shape = NA, colour = "grey45", fill = "grey95") +
  geom_jitter(width = .08, height = 0, colour = KOLORY[["dane"]], alpha = .6, size = 2) +
  geom_point(data = sr, aes(wersja, M), shape = 23, size = 4, fill = "white", colour = KOLORY[["granat"]]) +
  geom_point(data = sr, aes(wersja, Mg), shape = 23, size = 4, fill = KOLORY[["akcent"]], colour = KOLORY[["akcent"]]) +
  labs(title = "A. Czas zadania jest prawoskośny", subtitle = "Romb biały: średnia; czerwony: średnia geometryczna",
       x = NULL, y = "Czas wykonania zadania (s)") + theme_metodolog(12)
r1b <- ggplot(dl, aes(wersja, czas, group = id, colour = kolejnosc)) +
  geom_line(alpha = .7, linewidth = .7) + geom_point(size = 2) + scale_y_log10(breaks = c(40, 60, 80, 120, 160, 240)) +
  scale_colour_manual(values = c(AB = KOLORY[["drugi"]], BA = KOLORY[["akcent"]]),
                      labels = c(AB = "najpierw A, potem B", BA = "najpierw B, potem A"), name = "Kolejność:") +
  labs(title = "B. Te same osoby w obu wersjach", subtitle = "Skala logarytmiczna; linia = jeden uczestnik (n = 24)",
       x = NULL, y = "Czas (s, skala log)") + theme_metodolog(12)
zapisz_svg(r1a + r1b + plot_layout(widths = c(1, 1.15)), "../statystyka-informatyka-czas-zadania.svg", szer = 10, wys = 5.4)

# Rysunek 2: porównanie algorytmów (średnie rangi z krytyczną różnicą Nemenyiego) i rozgrzewka w pomiarze wydajności
etyk <- c(reg_logistyczna = "regresja logistyczna", las_losowy = "las losowy", gradient_boosting = "gradient boosting", k_NN = "k-NN")
mr <- data.frame(alg = etyk[names(colMeans(rangi))], ranga = colMeans(rangi))
mr$alg <- factor(mr$alg, levels = mr$alg[order(mr$ranga, decreasing = TRUE)])
CD <- qtukey(.95, k, Inf) / sqrt(2) * sqrt(k * (k + 1) / (6 * N))
mr$y <- as.numeric(mr$alg)
print(mr[order(mr$ranga), c("alg", "ranga")], digits = 3, row.names = FALSE)
r2a <- ggplot(mr, aes(ranga, y)) +
  annotate("segment", x = min(mr$ranga), xend = min(mr$ranga) + CD, y = 4.45, yend = 4.45, colour = KOLORY[["drugi"]], linewidth = 1.4) +
  annotate("text", x = min(mr$ranga) + CD / 2, y = 4.68, label = sprintf("CD = %.2f", CD), colour = KOLORY[["drugi"]], size = 3.8) +
  geom_segment(aes(x = 1, xend = ranga, yend = y), colour = "grey75") +
  geom_point(size = 4, colour = KOLORY[["akcent"]]) + geom_text(aes(label = sprintf("%.2f", ranga)), vjust = -1.1, size = 3.6) +
  scale_x_continuous(limits = c(1, 4), breaks = 1:4) + scale_y_continuous(breaks = 1:4, labels = levels(mr$alg)) +
  coord_cartesian(ylim = c(.7, 4.8)) +
  labs(title = "A. Cztery klasyfikatory na 15 zbiorach", subtitle = "Średnia ranga AUC (1 = najlepszy); niebieski odcinek = CD",
       x = "Średnia ranga", y = NULL) + theme_metodolog(12)
krzywa <- aggregate(ms ~ wersja + iteracja, data = pomiary, FUN = median)
r2b <- ggplot(pomiary, aes(iteracja, ms)) +
  annotate("rect", xmin = .5, xmax = 10.5, ymin = -Inf, ymax = Inf, fill = "grey92") +
  annotate("text", x = 5.5, y = 82, label = "rozgrzewka\n(odrzucona)", size = 3.6, colour = "grey30") +
  geom_point(colour = KOLORY[["dane"]], alpha = .35, size = 1.2) +
  geom_line(data = krzywa, aes(colour = wersja), linewidth = 1) +
  scale_colour_manual(values = c(A = KOLORY[["drugi"]], B = KOLORY[["akcent"]]), name = "Implementacja:") +
  labs(title = "B. Pomiar wydajności: 10 uruchomień × 30 iteracji", subtitle = "Linia: mediana z 10 uruchomień",
       x = "Iteracja w uruchomieniu", y = "Czas wykonania (ms)") + theme_metodolog(12)
zapisz_svg(r2a + r2b + plot_layout(widths = c(1, 1.1)), "../statystyka-informatyka-algorytmy-wydajnosc.svg", szer = 11, wys = 5.4)
Wynik w R
     wersja     M    Mg    Me
 A (obecna) 99.46 90.07 80.05
   B (nowa) 92.11 78.62 72.00
Zapisano ../statystyka-informatyka-czas-zadania.svg: w HTML width="1000" height="540" (26 KB)
                  alg ranga
           las losowy  1.40
    gradient boosting  1.87
 regresja logistyczna  3.20
                 k-NN  3.53
Zapisano ../statystyka-informatyka-algorytmy-wydajnosc.svg: w HTML width="1100" height="540" (98 KB)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje t.test(), wilcox.test(), binom.test(), prop.test(), friedman.test(), lm() i power.t.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- PMCMRplus (wersja 1.9.12): Pohlert, T. (2024). PMCMRplus: Calculate pairwise multiple comparisons of mean rank sums extended (R package version 1.9.12) [Computer software]. https://doi.org/10.32614/CRAN.package.PMCMRplus
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- boot (wersja 1.3.32): Canty, A., & Ripley, B. D. (2025). boot: Bootstrap functions (R package version 1.3.32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z informatyki
- Foldy walidacji krzyżowej albo iteracje pętli traktowane jak niezależne obserwacje. Daje to zbyt wąskie przedziały – w przykładzie z wydajnością przedział był prawie dwa razy węższy niż przy poprawnej analizie uruchomień.
- Średnia arytmetyczna czasu bez informacji o rozkładzie i porównanie czasów zwykłym testem t na sekundach zamiast na logarytmach.
- Schemat wewnątrzosobowy bez kontrbalansowania, w którym wszyscy uczestnicy zaczynają od starej wersji – efekt uczenia się wygląda wtedy jak zaleta nowego interfejsu.
- Odsetki sukcesów z małej próby bez przedziałów ufności albo z przedziałem Walda, który przy małym n ma zbyt niskie pokrycie.
- „Wersje się nie różnią” na podstawie nieistotnego testu przy 10–20 uczestnikach, zamiast opisu przedziału ufności i ograniczonej mocy.
- Tabela algorytmów z pogrubionym zwycięzcą bez testu albo z testem t na średnich z różnych zbiorów danych zamiast testu Friedmana na rangach.
- Dobór zbiorów danych i strojenie hiperparametrów po obejrzeniu wyników – szczególnie strojenie tylko własnego algorytmu.
- Raportowanie najlepszego z kilku pomiarów czasu albo pojedynczego uruchomienia, bez opisu sprzętu, rozgrzewki i liczby powtórzeń.
- Wzrost względny w teście A/B bez różnicy w punktach procentowych i bez przedziału ufności.
- Własne, niesprawdzone pozycje ankiety o akceptacji technologii i wnioski przyczynowe z jednorazowego badania przekrojowego.
Najczęstsze pytania
Jakie analizy statystyczne wybrać do pracy magisterskiej z informatyki?
Zależy to od tego, co mierzysz i kto jest jednostką analizy. Czas zadania tych samych użytkowników w dwóch wersjach porównaj testem t dla prób zależnych na logarytmach, sukces zadania – testem McNemara z przedziałami Wilsona, test A/B – testem dla dwóch proporcji z różnicą i 95% CI, kilka algorytmów na wielu zbiorach danych – testem Friedmana z post hoc Nemenyiego, a ankietę o akceptacji technologii – regresją albo modelem SEM.
Jak porównać czas wykonania zadania w teście użyteczności?
Czasy zadań są prawoskośne, więc przelicz je na logarytmy i porównaj testem t dla par (gdy te same osoby testują obie wersje) albo testem Welcha (gdy grupy są różne). Wynik odwróć z logarytmów i podaj jako iloraz średnich geometrycznych z 95% CI, np. „wersja B skraca czas średnio o 13%”. Jako miarę środka czasu podaj średnią geometryczną, a nie tylko średnią arytmetyczną.
Jakim testem porównać kilka algorytmów uczenia maszynowego na wielu zbiorach danych?
Potraktuj zbiór danych jako jednostkę analizy, w każdym zbiorze nadaj algorytmom rangi i porównaj je testem Friedmana. Po istotnym wyniku policz test Nemenyiego albo krytyczną różnicę średnich rang (CD). Dwa algorytmy porównaj testem Wilcoxona dla par. Nie licz testu t na wynikach z kolejnych foldów walidacji krzyżowej jako niezależnych obserwacjach.
Ile razy powtórzyć pomiar czasu działania programu do pracy dyplomowej?
Ważniejsza od liczby iteracji jest liczba niezależnych uruchomień procesu, bo czasy z jednego uruchomienia są do siebie podobne. W przykładzie 71.5% zmienności w stanie ustalonym przypadało na różnice między uruchomieniami (ICC = .715). Odrzuć iteracje rozgrzewki, policz jedną średnią na uruchomienie i porównuj uruchomienia, a liczbę uruchomień zaplanuj z pilotażu.
Ile osób potrzeba do testu użyteczności w pracy dyplomowej?
Do statystycznego porównania dwóch wersji potrzeba zwykle więcej osób, niż bierze udział w typowym teście użyteczności. W przykładzie, aby z mocą 80% wykryć skrócenie czasu o 15% przy rozrzucie różnic z badania 24 osób, trzeba około 78 uczestników ocenianych w obu wersjach. Policz liczebność z pilotażu, a jeśli jej nie osiągniesz, nazwij badanie eksploracyjnym i raportuj przedziały ufności.
Powiązane hasła
Przeczytaj też
Statystyka w pracy inżynierskiej z badaniem
Co jest powtórzeniem, porównanie wariantów, plan 2^3, krzywa kalibracyjna, niepewność pomiaru i Weibull: analizy, zdania do pracy i kod R.
Czytaj →PoradnikSUS – skala użyteczności systemu: jak policzyć wynik
Co wiadomo o kluczu SUS i skąd go wziąć, wynik 0–100 bez mylenia z procentem i porównanie dwóch wersji systemu w parach – z przykładem w R i wzorem opisu.
Czytaj →PoradnikTest A/B – plan i analiza
Metryka główna, liczebność z power.prop.test, losowanie i czas trwania, skutki podglądania wyników w symulacji oraz różnica odsetków z CI i względny wzrost.
Czytaj →PoradnikStatystyka w pracy dyplomowej – przewodnik
Osiem etapów od hipotez do obrony: na każdy etap poradniki, hasła i kalkulatory oraz tabela typowych problemów z odpowiedzią, co przeczytać.
Czytaj →Piszesz pracę z informatyki i nie wiesz, jak policzyć wyniki badania?
Pomożemy dobrać analizy do Twoich danych – testu z użytkownikami, testu A/B, porównania algorytmów albo pomiarów wydajności – policzyć je w R z wielkością efektu i wyjaśnić tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Agresti, A., & Coull, B. A. (1998). Approximate is better than “exact” for interval estimation of binomial proportions. The American Statistician, 52(2), 119–126. https://doi.org/10.1080/00031305.1998.10480550
- Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319–340. https://doi.org/10.2307/249008 ● Otwarty dostęp: pełny tekst
- Demšar, J. (2006). Statistical comparisons of classifiers over multiple data sets. Journal of Machine Learning Research, 7, 1–30. https://jmlr.org/papers/v7/demsar06a.html ● Otwarty dostęp
- Dietterich, T. G. (1998). Approximate statistical tests for comparing supervised classification learning algorithms. Neural Computation, 10(7), 1895–1923. https://doi.org/10.1162/089976698300017197
- Georges, A., Buytaert, D., & Eeckhout, L. (2007). Statistically rigorous Java performance evaluation. In Proceedings of the 22nd Annual ACM SIGPLAN Conference on Object-Oriented Programming Systems, Languages and Applications (OOPSLA '07) (pp. 57–76). ACM. https://doi.org/10.1145/1297027.1297033 ● Otwarty dostęp: pełny tekst
- Kohavi, R., Longbotham, R., Sommerfield, D., & Henne, R. M. (2009). Controlled experiments on the web: Survey and practical guide. Data Mining and Knowledge Discovery, 18(1), 140–181. https://doi.org/10.1007/s10618-008-0114-1 ● Otwarty dostęp
- Lewis, J. R. (2018). The System Usability Scale: Past, present, and future. International Journal of Human–Computer Interaction, 34(7), 577–590. https://doi.org/10.1080/10447318.2018.1455307
- Mytkowicz, T., Diwan, A., Hauswirth, M., & Sweeney, P. F. (2009). Producing wrong data without doing anything obviously wrong! In Proceedings of the 14th International Conference on Architectural Support for Programming Languages and Operating Systems (ASPLOS XIV) (pp. 265–276). ACM. https://doi.org/10.1145/1508244.1508275
- Sauro, J., & Lewis, J. R. (2010). Average task times in usability tests: What to report? In Proceedings of the SIGCHI Conference on Human Factors in Computing Systems (pp. 2347–2350). ACM. https://doi.org/10.1145/1753326.1753679
Cytowania BibTeX
@article{agresti1998approximate, author={Agresti, Alan and Coull, Brent A.}, title={{Approximate is better than “exact” for interval estimation of binomial proportions}}, journal={The American Statistician}, year={1998}, volume={52}, number={2}, pages={119--126}, doi={10.1080/00031305.1998.10480550}}@article{davis1989perceived, author={Davis, Fred D.}, title={{Perceived usefulness, perceived ease of use, and user acceptance of information technology}}, journal={MIS Quarterly}, year={1989}, volume={13}, number={3}, pages={319--340}, doi={10.2307/249008}}@article{demsar2006statistical, author={Demšar, Janez}, title={{Statistical comparisons of classifiers over multiple data sets}}, journal={Journal of Machine Learning Research}, year={2006}, volume={7}, pages={1--30}, url={https://jmlr.org/papers/v7/demsar06a.html}}@article{dietterich1998approximate, author={Dietterich, Thomas G.}, title={{Approximate statistical tests for comparing supervised classification learning algorithms}}, journal={Neural Computation}, year={1998}, volume={10}, number={7}, pages={1895--1923}, doi={10.1162/089976698300017197}}@inproceedings{georges2007statistically, author={Georges, Andy and Buytaert, Dries and Eeckhout, Lieven}, title={{Statistically rigorous Java performance evaluation}}, booktitle={Proceedings of the 22nd Annual ACM SIGPLAN Conference on Object-Oriented Programming Systems, Languages and Applications (OOPSLA '07)}, year={2007}, pages={57--76}, publisher={ACM}, doi={10.1145/1297027.1297033}}@article{kohavi2009controlled, author={Kohavi, Ron and Longbotham, Roger and Sommerfield, Dan and Henne, Randal M.}, title={{Controlled experiments on the web: Survey and practical guide}}, journal={Data Mining and Knowledge Discovery}, year={2009}, volume={18}, number={1}, pages={140--181}, doi={10.1007/s10618-008-0114-1}}@article{lewis2018system, author={Lewis, James R.}, title={{The System Usability Scale: Past, present, and future}}, journal={International Journal of Human–Computer Interaction}, year={2018}, volume={34}, number={7}, pages={577--590}, doi={10.1080/10447318.2018.1455307}}@inproceedings{mytkowicz2009producing, author={Mytkowicz, Todd and Diwan, Amer and Hauswirth, Matthias and Sweeney, Peter F.}, title={{Producing wrong data without doing anything obviously wrong!}}, booktitle={Proceedings of the 14th International Conference on Architectural Support for Programming Languages and Operating Systems (ASPLOS XIV)}, year={2009}, pages={265--276}, publisher={ACM}, doi={10.1145/1508244.1508275}}@inproceedings{sauro2010average, author={Sauro, Jeff and Lewis, James R.}, title={{Average task times in usability tests: What to report?}}, booktitle={Proceedings of the SIGCHI Conference on Human Factors in Computing Systems}, year={2010}, pages={2347--2350}, publisher={ACM}, doi={10.1145/1753326.1753679}}