Co to jest test Nemenyiego?
Test Nemenyiego (ang. Nemenyi test) to procedura post hoc porównująca wszystkie pary grup na średnich rangach po istotnym teście Friedmana albo teście Kruskala-Wallisa. Jest rangowym odpowiednikiem testu Tukeya: różnice średnich rang ocenia rozkładem rozstępu studentyzowanego, więc sam kontroluje błąd dla całej rodziny porównań i nie wymaga osobnej korekty.
Jak działa i krytyczna różnica
Po teście Friedmana z k warunkami i N blokami (np. osobami) dwie średnie rangi różnią się istotnie, gdy ich różnica przekracza krytyczną różnicę:
CD = qα; k; ∞ / √2 · √(k(k + 1) / (6N))
Demšar (2006) zalecił test Friedmana z testami post hoc do porównywania wielu klasyfikatorów na wielu zbiorach danych i wprowadził wykresy krytycznej różnicy (CD). Test korzysta z przybliżenia dla dużych prób. Eisinga i in. (2017) pokazali, że dokładne wartości p dla różnic sum rang można policzyć szybko, a przybliżenie normalne działa dobrze poza skrajnym ogonem rozkładu.
Przykład w R
Piętnaście osób oceniło cztery wersje materiału (dane symulowane): χ²(3) = 13.16, p = .004. Średnie rangi wynoszą 1.87, 1.93, 3.00 i 3.20, a CD = 1.21. Istotne są tylko różnice M4–M1 (1.33, p = .024) i M4–M2 (1.27, p = .036). Test Conovera z korektą Holma wskazuje cztery pary, bo test Nemenyiego jest bardziej zachowawczy.
Na rysunku
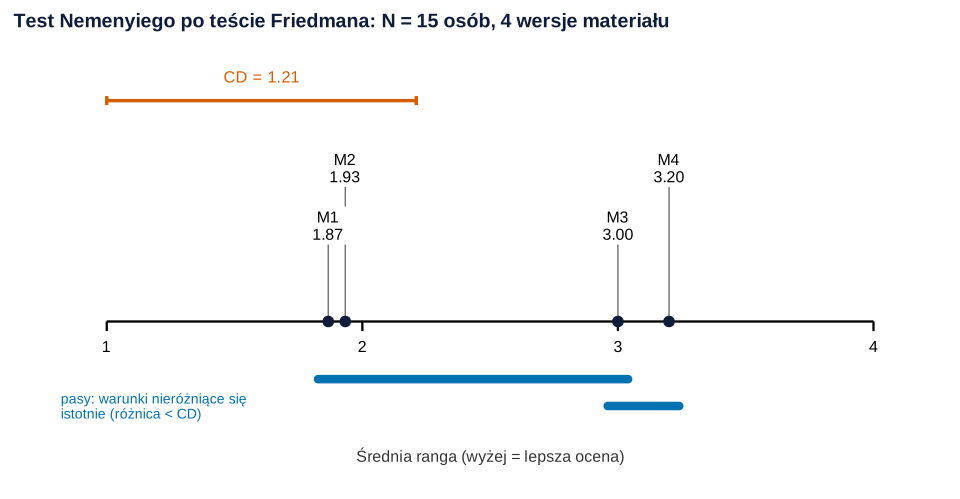
set.seed(589), te same co w przykładzie).Co widać. To wykres krytycznej różnicy, który zaproponował Demšar (2006). Na osi leżą średnie rangi z przykładu: M1 1.87, M2 1.93, M3 3.00 i M4 3.20. Pomarańczowy odcinek u góry ma długość CD = 1.21 – tyle muszą się różnić dwie średnie rangi, żeby test Nemenyiego uznał różnicę za istotną. Niebieskie pasy pod osią łączą warunki, które się nie różnią, bo dzieli je mniej niż CD. Pierwszy pas obejmuje M1, M2 i M3 (rozstęp 1.13), drugi M3 i M4. Istotne są tylko pary, których nie łączy żaden pas: M4 z M1 i M4 z M2. Zgadza się to z macierzą p z przykładu.
Na co uważać. Pasy nie oznaczają, że warunki są równe. M3 należy do obu pasów, choć od M1 dzieli go 1.13 rangi, niewiele mniej niż CD. Przy 15 osobach test po prostu nie rozstrzyga takich różnic. Wykres pokazuje też tylko kolejność i odległości w rangach, a nie różnice w punktach skali ocen ani rozrzut ocen w blokach. Wysokość etykiet ustawiono ręcznie, żeby się nie nakładały. Pasy dotyczą wyłącznie testu Nemenyiego: test Conovera z korektą Holma nie ma jednej wspólnej CD i na tych danych wskazuje cztery istotne pary.
Podpis do pracy:
Kod liczy średnie rangi i CD ze wzoru podanego wyżej (ziarno 589, te same dane co w przykładzie), a potem wyznacza maksymalne grupy warunków różniących się mniej niż CD. Rysunek na stronie powstał z tego kodu po drobnej zmianie stylu tytułu. Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Wykres krytycznej różnicy (CD): średnie rangi czterech wersji materiału i test Nemenyiego
library(ggplot2)

# Prosty motyw bez siatki (oś rang rysujemy sami); kolory Okabe–Ito
motyw <- theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0), margin = margin(b = 8)),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Dane z przykładu w haśle: 4 wersje materiału (M1–M4) oceniane przez 15 osób (dane symulowane)
set.seed(589)
N <- 15; k <- 4
dane <- sapply(c(0, 0.3, 0.6, 1.2), function(d) rnorm(N, 70 + d * 4, 4)) + rnorm(N, 0, 6)
dimnames(dane) <- list(paste0("b", 1:N), c("M1", "M2", "M3", "M4"))
sr <- sort(colMeans(t(apply(dane, 1, rank))))      # średnie rangi (rangi w każdym bloku)
CD <- qtukey(0.95, k, Inf) / sqrt(2) * sqrt(k * (k + 1) / (6 * N))
round(c(sr, CD = CD), 3)

# Grupy warunków, których średnie rangi różnią się mniej niż CD (maksymalne, bez zawierania się)
grupy <- unique(lapply(seq_along(sr), function(i) names(sr)[i:max(which(sr - sr[i] < CD))]))
grupy <- grupy[lengths(grupy) > 1]
grupy <- grupy[!sapply(seq_along(grupy), function(a) any(sapply(seq_along(grupy)[-a], function(b) all(grupy[[a]] %in% grupy[[b]]))))]
grupy
pasy <- data.frame(od = sapply(grupy, function(g) sr[g[1]]) - 0.04, do = sapply(grupy, function(g) sr[g[length(g)]]) + 0.04,
                   y = -0.6 - 0.28 * (seq_along(grupy) - 1))
pasy

# Etykiety warunków: wysokości ustawione ręcznie, żeby się nie nakładały
et <- data.frame(war = names(sr), x = sr, y = c(1.0, 1.6, 1.0, 1.6))
p <- ggplot() +
  annotate("segment", x = 1, xend = 4, y = 0, yend = 0, linewidth = 0.8) +
  annotate("segment", x = 1:4, xend = 1:4, y = 0, yend = -0.1, linewidth = 0.8) +
  annotate("text", x = 1:4, y = -0.2, label = 1:4, size = 4.2, vjust = 1) +
  annotate("text", x = 2.5, y = -1.4, label = "Średnia ranga (wyżej = lepsza ocena)", size = 4.2, colour = "grey20") +
  geom_segment(data = et, aes(x = x, xend = x, y = 0, yend = y - 0.15), colour = "grey45", linewidth = 0.5) +
  geom_point(data = et, aes(x = x, y = 0), size = 3.2, colour = "#0f1d3a") +
  geom_label(data = et, aes(x = x, y = y, label = sprintf("%s\n%.2f", war, x)), size = 4.2, lineheight = 0.9,
             linewidth = 0, fill = "white") +
  geom_segment(data = pasy, aes(x = od, xend = do, y = y, yend = y), colour = "#0072B2", linewidth = 3, lineend = "round") +
  annotate("segment", x = 1, xend = 1 + CD, y = 2.3, yend = 2.3, colour = "#D55E00", linewidth = 1.2,
           arrow = arrow(ends = "both", angle = 90, length = unit(0.12, "cm"))) +
  annotate("text", x = 1 + CD / 2, y = 2.55, label = sprintf("CD = %.2f", CD), colour = "#D55E00", size = 4.3) +
  annotate("text", x = 0.82, y = -0.88, hjust = 0, size = 3.7, colour = "#0072B2", lineheight = 0.9,
           label = "pasy: warunki nieróżniące się\nistotnie (różnica < CD)") +
  coord_cartesian(xlim = c(0.8, 4.1), ylim = c(-1.5, 2.7)) +
  labs(title = "Test Nemenyiego po teście Friedmana: N = 15 osób, 4 wersje materiału") +
  motyw
p
Wynik w R
   M1    M2    M3    M4    CD
1.867 1.933 3.000 3.200 1.211
[[1]]
[1] "M1" "M2" "M3"

[[2]]
[1] "M3" "M4"

         od   do     y
M1 1.826667 3.04 -0.60
M3 2.960000 3.24 -0.88
Jak opisać w pracy
Na co uważać
- Podwójna korekta. Nie dodawaj korekty Bonferroniego do wyników Nemenyiego – procedura już kontroluje FWER.
- Mała moc. Przy małym N różnica musi być duża. Procedury post hoc po teście Friedmana różnią się konserwatywnością (Pereira i in., 2015), więc wybór ustal przed analizą.
- Zależność od zestawu grup. Średnie rangi zależą od wszystkich porównywanych warunków; dodanie warunku może zmienić wynik pary.
Test Nemenyiego w R
Kod liczy test Friedmana, średnie rangi i krytyczną różnicę CD, a potem wszystkie pary funkcją frdAllPairsNemenyiTest() z pakietu PMCMRplus; dla porównania frdAllPairsConoverTest() z korektą Holma. Liczby w tekście pochodzą z tego kodu.
Nemenyi po teście Friedmana: średnie rangi, CD i macierz p
R
# Test Nemenyiego po teście Friedmana: 4 metody oceniane w 15 blokach
library(PMCMRplus)
set.seed(589)
N <- 15; k <- 4
dane <- sapply(c(0, 0.3, 0.6, 1.2), function(d) rnorm(N, 70 + d * 4, 4)) + rnorm(N, 0, 6)
dimnames(dane) <- list(paste0("b", 1:N), c("M1", "M2", "M3", "M4"))
friedman.test(dane)
rangi <- t(apply(dane, 1, rank))                # rangi w każdym bloku
sr <- colMeans(rangi); round(sr, 3)
# Krytyczna różnica średnich rang: q(alfa; k; df = Inf) / sqrt(2) * sqrt(k(k+1) / (6N))
CD <- qtukey(0.95, k, Inf) / sqrt(2) * sqrt(k * (k + 1) / (6 * N))
round(CD, 3)
round(outer(sr, sr, "-"), 3)                     # różnice średnich rang
frdAllPairsNemenyiTest(dane)                     # Nemenyi (rozstęp studentyzowany)
frdAllPairsConoverTest(dane, p.adjust.method = "holm")  # dla porównania: Conover + Holm
Wynik w R
	Friedman rank sum test

data:  dane
Friedman chi-squared = 13.16, df = 3, p-value = 0.004303

   M1    M2    M3    M4
1.867 1.933 3.000 3.200
[1] 1.211
      M1     M2     M3     M4
M1 0.000 -0.067 -1.133 -1.333
M2 0.067  0.000 -1.067 -1.267
M3 1.133  1.067  0.000 -0.200
M4 1.333  1.267  0.200  0.000

	Pairwise comparisons using Nemenyi-Wilcoxon-Wilcox all-pairs test for a two-way balanced complete block design

data: y

   M1    M2    M3
M2 0.999 -     -
M3 0.076 0.107 -
M4 0.024 0.036 0.974

P value adjustment method: single-step

	Pairwise comparisons using Conover's all-pairs test for a two-way balanced complete block design

data: y

   M1    M2    M3
M2 1.000 -     -
M3 0.034 0.039 -
M4 0.014 0.018 1.000

P value adjustment method: holm
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet PMCMRplus 1.9.12). Rysunek 1 wykonano w pakiecie ggplot2, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- PMCMRplus (wersja 1.9.12): Pohlert, T. (2024). PMCMRplus: Calculate pairwise multiple comparisons of mean rank sums extended [R package]. https://doi.org/10.32614/CRAN.package.PMCMRplus
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy po teście Nemenyiego trzeba stosować korektę Bonferroniego?
Nie. Test opiera się na rozkładzie rozstępu studentyzowanego, więc już kontroluje łączny błąd I rodzaju dla wszystkich par. Dodatkowa korekta uczyniłaby go jeszcze bardziej zachowawczym.
Czym test Nemenyiego różni się od testu Conovera?
Oba porównują średnie rangi. Nemenyi to procedura jednokrokowa podobna do testu Tukeya, a Conover używa rozkładu t z mniejszym błędem standardowym i wymaga osobnej korekty, np. Holma. Conover zwykle wykrywa więcej różnic.
Czym jest wykres krytycznej różnicy (CD)?
To oś ze średnimi rangami warunków, na której łączy się poziomą linią warunki różniące się mniej niż CD. Wykres zaproponował Demšar (2006) do porównań klasyfikatorów na wielu zbiorach danych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyka w pracy z informatyki
Test użyteczności, test A/B, algorytmy na wielu zbiorach danych, ankieta akceptacji technologii i benchmarki: testy, wielkość efektu, zdania APA i kod R.
Czytaj →PoradnikTesty post hoc – który wybrać?
Tabela sytuacja → test, Tukey, Games–Howell, Dunnett, Scheffé i Dunn na jednym przykładzie oraz symulacja błędu I rodzaju i mocy w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Demšar, J. (2006). Statistical comparisons of classifiers over multiple data sets. Journal of Machine Learning Research, 7, 1–30. https://jmlr.org/papers/v7/demsar06a.html ● Otwarty dostęp
- Eisinga, R., Heskes, T., Pelzer, B., & Te Grotenhuis, M. (2017). Exact p-values for pairwise comparison of Friedman rank sums, with application to comparing classifiers. BMC Bioinformatics, 18(1), Article 68. https://doi.org/10.1186/s12859-017-1486-2 ● Otwarty dostęp
- Pereira, D. G., Afonso, A., & Medeiros, F. M. (2015). Overview of Friedman’s test and post-hoc analysis. Communications in Statistics - Simulation and Computation, 44(10), 2636–2653. https://doi.org/10.1080/03610918.2014.931971
Cytowania BibTeX
@article{demsar2006statistical, author={Demšar, Janez}, title={{Statistical comparisons of classifiers over multiple data sets}}, journal={Journal of Machine Learning Research}, year={2006}, volume={7}, pages={1--30}, url={https://jmlr.org/papers/v7/demsar06a.html}}@article{eisinga2017exact, author={Eisinga, Rob and Heskes, Tom and Pelzer, Ben and Te Grotenhuis, Manfred}, title={{Exact p-values for pairwise comparison of Friedman rank sums, with application to comparing classifiers}}, journal={BMC Bioinformatics}, year={2017}, volume={18}, number={1}, eid={68}, doi={10.1186/s12859-017-1486-2}}@article{pereira2015overview, author={Pereira, Dulce G. and Afonso, Anabela and Medeiros, Fátima Melo}, title={{Overview of Friedman’s test and post-hoc analysis}}, journal={Communications in Statistics - Simulation and Computation}, year={2015}, volume={44}, number={10}, pages={2636--2653}, doi={10.1080/03610918.2014.931971}}