Co to jest test Conovera?
Test Conovera (test Conovera–Imana, ang. Conover–Iman test) to procedura post hoc do porównań par grup po istotnym teście Kruskala-Wallisa. Wersja dla pomiarów powtarzanych służy do porównań po teście Friedmana. Conover i Iman (1979) opisali ją jako nieparametryczny odpowiednik metody najmniejszej istotnej różnicy (LSD) Fishera, a w ich symulacjach okazała się rozsądnym wyborem. Wpisuje się w ogólną ideę, że wiele testów nieparametrycznych to zwykłe procedury parametryczne zastosowane do rang (Conover i Iman, 1981).
Jak działa
Wszystkie obserwacje rangujesz razem i porównujesz średnie rangi grup. Różnicę średnich rang dzielisz przez błąd standardowy z wariancji rang S², pomnożonej przez (N − 1 − H)/(N − k), gdzie H to statystyka Kruskala-Wallisa. Wynik porównujesz z rozkładem t z N − k stopniami swobody. Tym różni się od testu Dunna, który ocenia różnicę średnich rang rozkładem normalnym z (Dunn, 1964). Gdy H jest duże, błąd Conovera maleje, więc test zwykle daje mniejsze wartości p.
Przykład w R
Cztery grupy po 12 osób (dane symulowane): H(3) = 13.82, p = .003. Średnie rangi wynoszą 14.7, 21.7, 26.3 i 35.3. Dla pary A–D t(44) = 4.17. Po korekcie Holma test Conovera wskazuje różnice A–D (p < .001) i B–D (p = .043). Test Dunna na tych samych danych potwierdza tylko A–D (p = .002); dla B–D p = .084.
Na rysunku
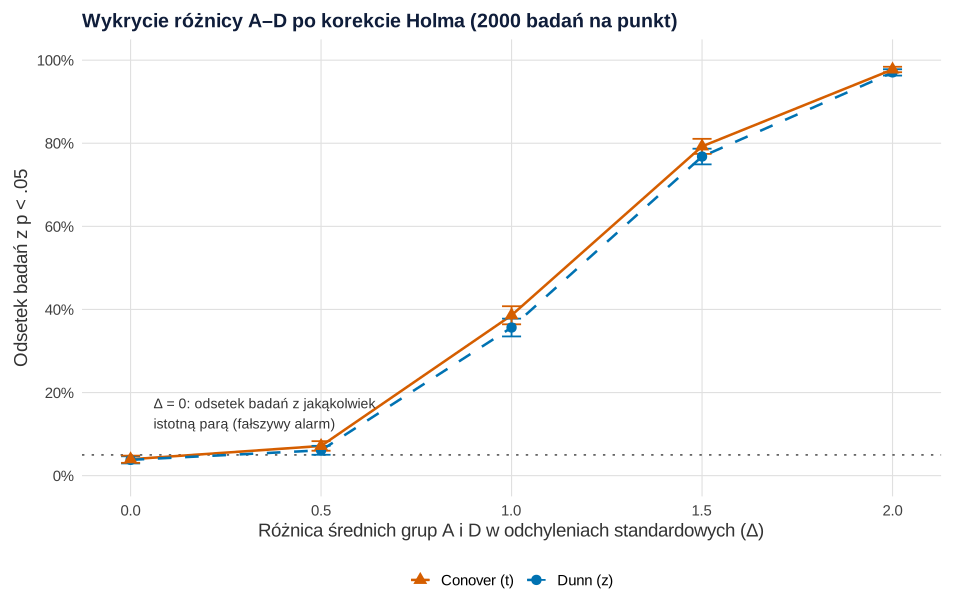
set.seed(5881), 2000 powtórzeń na punkt).Co widać. Każdy punkt to 2000 symulowanych badań z czterema grupami po 12 osób, których średnie rosną liniowo od A do D. Przy braku jakichkolwiek różnic (Δ = 0) obie procedury z korektą Holma dają podobny odsetek badań z choćby jedną istotną parą: Dunn 3.8%, Conover 4.0%, czyli poniżej nominalnych 5%. Gdy grupy się różnią, test Conovera wykrywa różnicę A–D nieco częściej: przy Δ = 1 SD w 38.6% badań wobec 35.7% dla Dunna, przy Δ = 1.5 SD w 79.3% wobec 76.8%. Błąd Monte Carlo każdego odsetka wynosi najwyżej 1.1 pp (wąsy to ±2 błędy). Przewaga Conovera to więc zwykle 2–3 punkty procentowe – mniej, niż sugeruje pojedynczy przykład wyżej, w którym para B–D była istotna tylko w teście Conovera.
Na co uważać. To jeden układ: rozkład normalny, równe liczebności i wariancje, liniowy wzrost średnich. Wartości Δ ustawiono ręcznie, a ziarna nie zmieniano. Wykres nie pokazuje danych skośnych ani grup o różnym rozrzucie, w których oba testy przestają porównywać samo położenie rozkładów. Moc dotyczy jednej pary (A–D), a nie wszystkich sześciu. Niewielka przewaga nie uzasadnia też wybierania testu po obejrzeniu wyników. Jak rośnie ryzyko fałszywego alarmu bez korekty, pokazuje wpis Wielokrotne testy w obrazkach.
Podpis do pracy:
Kod liczy oba testy ze wzorów (szybciej niż funkcje PMCMRplus w pętli) i na danych z przykładu odtwarza wartości p z PMCMRplus (ziarno 588). Symulacja ma ziarno 5881 i trwa kilka sekund. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Test Conovera a test Dunna po teście Kruskala–Wallisa: fałszywe alarmy i moc (symulacja)
library(ggplot2)

# Paleta Okabe–Ito i prosty motyw
kol <- c("Conover (t)" = "#D55E00", "Dunn (z)" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# p po korekcie Holma dla wszystkich par: Dunn (rozkład z) i Conover (rozkład t, df = N - k)
pary_p <- function(y, g) {
  r <- rank(y); N <- length(y); k <- nlevels(g); n <- tabulate(g); sr <- tapply(r, g, mean)
  tt <- table(y); H <- (12 / (N * (N + 1)) * sum(n * (sr - (N + 1) / 2)^2)) / (1 - sum(tt^3 - tt) / (N^3 - N))
  S2 <- (sum(r^2) - N * (N + 1)^2 / 4) / (N - 1)
  ij <- combn(k, 2); roz <- sr[ij[2, ]] - sr[ij[1, ]]; w <- 1 / n[ij[1, ]] + 1 / n[ij[2, ]]
  z <- roz / sqrt((N * (N + 1) / 12 - sum(tt^3 - tt) / (12 * (N - 1))) * w)
  t <- roz / sqrt(S2 * (N - 1 - H) / (N - k) * w)
  nazwy <- paste(levels(g)[ij[1, ]], levels(g)[ij[2, ]], sep = "-")
  cbind(dunn = setNames(p.adjust(2 * pnorm(-abs(z)), "holm"), nazwy),
        conover = p.adjust(2 * pt(-abs(t), N - k), "holm"))
}
# kontrola na danych z przykładu w haśle (set.seed(588)); porównaj z PMCMRplus w kodzie hasła
set.seed(588)
grupa <- factor(rep(c("A", "B", "C", "D"), each = 12))
wynik <- round(c(rnorm(12, 20, 5), rnorm(12, 22, 5), rnorm(12, 25, 5), rnorm(12, 26, 5)))
round(pary_p(wynik, grupa), 4)

# Symulacja: 4 grupy po 12 osób z rozkładu normalnego (SD = 1), średnie 0, Δ/3, 2Δ/3, Δ.
# Δ = 0: prawdziwa H0 – liczymy badania z jakąkolwiek istotną parą (FWER).
# Δ > 0: liczymy badania, w których wykryto różnicę A–D (moc dla tej pary). Wartości Δ ustawiono ręcznie.
set.seed(5881)
R <- 2000
g <- factor(rep(c("A", "B", "C", "D"), each = 12))
wyn <- do.call(rbind, lapply(c(0, 0.5, 1, 1.5, 2), function(D) {
  istotne <- replicate(R, {
    p <- pary_p(rnorm(48, mean = (0:3 * D / 3)[g]), g)
    if (D == 0) apply(p < .05, 2, any) else p["A-D", ] < .05
  })
  odsetek <- rowMeans(istotne)
  data.frame(delta = D, test = c("Dunn (z)", "Conover (t)"), odsetek, blad_MC = sqrt(odsetek * (1 - odsetek) / R))
}))
print(transform(wyn, odsetek = round(odsetek, 4), blad_MC = round(blad_MC, 4)), row.names = FALSE)

p <- ggplot(wyn, aes(delta, odsetek, colour = test, shape = test, linetype = test)) +
  geom_hline(yintercept = 0.05, linetype = "dotted", colour = "grey40") +
  geom_line(linewidth = 0.9) +
  geom_errorbar(aes(ymin = odsetek - 2 * blad_MC, ymax = odsetek + 2 * blad_MC), width = 0.05, linetype = "solid") +
  geom_point(size = 3.2) +
  annotate("text", x = 0.06, y = 0.15, hjust = 0, size = 3.7, colour = "grey20",
           label = "Δ = 0: odsetek badań z jakąkolwiek\nistotną parą (fałszywy alarm)") +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = c(0, 0.5, 1, 1.5, 2)) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1), breaks = seq(0, 1, 0.2)) +
  labs(title = "Wykrycie różnicy A–D po korekcie Holma (2000 badań na punkt)",
       x = "Różnica średnich grup A i D w odchyleniach standardowych (Δ)",
       y = "Odsetek badań z p < .05") +
  motyw
p
Wynik w R
      dunn conover
A-B 0.4380  0.3280
A-C 0.1708  0.0970
A-D 0.0018  0.0008
B-C 0.4380  0.3634
B-D 0.0837  0.0425
C-D 0.3322  0.2190
 delta        test odsetek blad_MC
   0.0    Dunn (z)  0.0380  0.0043
   0.0 Conover (t)  0.0395  0.0044
   0.5    Dunn (z)  0.0610  0.0054
   0.5 Conover (t)  0.0715  0.0058
   1.0    Dunn (z)  0.3565  0.0107
   1.0 Conover (t)  0.3860  0.0109
   1.5    Dunn (z)  0.7680  0.0094
   1.5 Conover (t)  0.7925  0.0091
   2.0    Dunn (z)  0.9705  0.0038
   2.0 Conover (t)  0.9775  0.0033
Jak opisać w pracy
Na co uważać
- Brak korekty. Test Conovera sam w sobie nie kontroluje błędu dla całej rodziny porównań. Dodaj korektę (Holma, Bonferroniego) – zob. problem wielokrotnych porównań.
- Wybór testu po wynikach. Nie sprawdzaj Dunna i Conovera, by zgłosić korzystniejszy wynik. Procedurę ustal przed analizą.
- Interpretacja. Test porównuje rozkłady rang, a nie średnie ani mediany.
Test Conovera w R
Kod liczy test Kruskala-Wallisa, statystykę Conovera dla pary A–D ręcznie (rozkład t), a potem wszystkie pary funkcjami kwAllPairsConoverTest() i kwAllPairsDunnTest() z pakietu PMCMRplus. Liczby w tekście pochodzą z tego kodu.
Conover i Dunn po teście Kruskala-Wallisa
R
# Test Conovera po teście Kruskala-Wallisa: porównania par na średnich rangach
library(PMCMRplus)
set.seed(588)
grupa <- factor(rep(c("A", "B", "C", "D"), each = 12))
wynik <- round(c(rnorm(12, 20, 5), rnorm(12, 22, 5), rnorm(12, 25, 5), rnorm(12, 26, 5)))
kruskal.test(wynik ~ grupa)
# Statystyka Conovera dla pary A-D ręcznie (rozkład t, df = N - k)
r <- rank(wynik); N <- length(wynik); k <- nlevels(grupa); n <- table(grupa)
H <- kruskal.test(wynik ~ grupa)$statistic
S2 <- (sum(r^2) - N * (N + 1)^2 / 4) / (N - 1)
sr <- tapply(r, grupa, mean)
t_AD <- (sr["D"] - sr["A"]) / sqrt(S2 * (N - 1 - H) / (N - k) * (1 / n["A"] + 1 / n["D"]))
round(sr, 3)
c(t_AD = round(unname(t_AD), 3), df = N - k, p = signif(2 * pt(-abs(unname(t_AD)), N - k), 3))
kwAllPairsConoverTest(wynik, grupa, p.adjust.method = "holm")  # Conover (t), Holm
kwAllPairsDunnTest(wynik, grupa, p.adjust.method = "holm")     # Dunn (z), Holm
Wynik w R
	Kruskal-Wallis rank sum test

data:  wynik by grupa
Kruskal-Wallis chi-squared = 13.819, df = 3, p-value = 0.003162

     A      B      C      D
14.708 21.708 26.250 35.333
    t_AD       df        p
 4.17000 44.00000  0.00014

	Pairwise comparisons using Conover's all-pairs test

data: wynik and grupa

  A       B       C
B 0.32796 -       -
C 0.09696 0.36345 -
D 0.00084 0.04252 0.21905

P value adjustment method: holm
Warning message:
In kwAllPairsConoverTest.default(wynik, grupa, p.adjust.method = "holm") :
  Ties are present. Quantiles were corrected for ties.

	Pairwise comparisons using Dunn's all-pairs test

data: wynik and grupa

  A      B      C
B 0.4380 -      -
C 0.1708 0.4380 -
D 0.0018 0.0837 0.3322

P value adjustment method: holm
alternative hypothesis: two.sided
Warning message:
In kwAllPairsDunnTest.default(wynik, grupa, p.adjust.method = "holm") :
  Ties are present. z-quantiles were corrected for ties.
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet PMCMRplus 1.9.12). Rysunek 1 wykonano w pakiecie ggplot2, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- PMCMRplus (wersja 1.9.12): Pohlert, T. (2024). PMCMRplus: Calculate pairwise multiple comparisons of mean rank sums extended [R package]. https://doi.org/10.32614/CRAN.package.PMCMRplus
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym test Conovera różni się od testu Dunna?
Oba porównują średnie rangi ze wspólnego rangowania wszystkich grup. Dunn ocenia różnicę rozkładem normalnym z, a Conover rozkładem t z błędem standardowym pomniejszonym o część wyjaśnioną przez statystykę H, więc zwykle daje mniejsze wartości p.
Czy test Conovera trzeba korygować?
Tak. Sam test podaje wartość p dla każdej pary osobno, więc przy wielu parach zastosuj korektę Holma lub Bonferroniego. W PMCMRplus ustawisz ją argumentem p.adjust.method.
Czy test Conovera działa po teście Friedmana?
Tak, istnieje wersja dla układu bloków (te same osoby w kilku warunkach). W R policzysz ją funkcją frdAllPairsConoverTest() z pakietu PMCMRplus.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Conover, W. J., & Iman, R. L. (1979). Multiple-comparisons procedures. Informal report (LA-7677-MS). Los Alamos Scientific Laboratory. https://doi.org/10.2172/6057803 ● Otwarty dostęp: pełny tekst
- Conover, W. J., & Iman, R. L. (1981). Rank transformations as a bridge between parametric and nonparametric statistics. The American Statistician, 35(3), 124–129. https://doi.org/10.1080/00031305.1981.10479327
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
Cytowania BibTeX
@techreport{conover1979multiple, author={Conover, W. J. and Iman, R. L.}, title={{Multiple-comparisons procedures. Informal report (LA-7677-MS)}}, year={1979}, institution={Los Alamos Scientific Laboratory}, doi={10.2172/6057803}}@article{conover1981rank, author={Conover, W. J. and Iman, Ronald L.}, title={{Rank transformations as a bridge between parametric and nonparametric statistics}}, journal={The American Statistician}, year={1981}, volume={35}, number={3}, pages={124--129}, doi={10.1080/00031305.1981.10479327}}@article{dunn1964multiple, author={Dunn, Olive Jean}, title={{Multiple comparisons using rank sums}}, journal={Technometrics}, year={1964}, volume={6}, number={3}, pages={241--252}, doi={10.1080/00401706.1964.10490181}}