Czym jest SUS
SUS (System Usability Scale), czyli skala użyteczności systemu, to krótki kwestionariusz, w którym użytkownik ocenia, jak łatwo i wygodnie korzystało mu się z systemu: aplikacji, strony internetowej, urządzenia albo panelu sterowania. Opracował go John Brooke w firmie Digital Equipment Co. Ltd, a opublikował jako rozdział książki o ocenie użyteczności w przemyśle (Brooke, 1996). Według przeglądu Lewisa (2018) to dziś najczęściej używany standaryzowany kwestionariusz postrzeganej użyteczności.
SUS spotkasz przede wszystkim w pracach z informatyki, projektowania UX, ergonomii i zarządzania, np. przy ocenie systemu ERP, aplikacji bankowej, sklepu internetowego czy prototypu interfejsu. Ogólny warsztat analityczny tych kierunków opisują wpisy statystyka w pracy z zarządzania i ekonomii oraz statystyka w pracy z marketingu. Gdy obok użyteczności mierzysz obciążenie pracą przy zadaniu, przyda się też wpis o NASA-TLX.
Pamiętaj, co SUS mierzy. To subiektywna ocena po kontakcie z systemem, a nie pomiar skuteczności (czy zadanie się udało) ani efektywności (ile trwało). W badaniu użyteczności warto zbierać obie strony: wynik SUS i miary wykonania zadań.
Budowa i stan weryfikacji klucza
Treści pozycji nie przytaczamy. Klucz przeliczenia odpowiedzi na wynik ogólny opublikował Brooke (1996) w płatnym rozdziale książki. Nie mieliśmy dostępu do pełnego tekstu tego rozdziału ani do pełnych tekstów pozostałych artykułów o SUS, dlatego tabela rozdziela to, co potwierdziliśmy w abstraktach i metadanych, od tego, co musisz wziąć z oryginału.
| Element | Co potwierdziliśmy | Źródło |
|---|---|---|
| Autor i pochodzenie | opracowany przez Johna Brooke'a w DEC, udostępniany od 1986 r. | Brooke (2013), abstrakt |
| Liczba pozycji | 10 pozycji (w badaniu Bangora i in. skala przymiotnikowa była dodana jako pytanie jedenaste) | Bangor, Kortum i Miller (2009), abstrakt |
| Wynik ogólny | jeden wynik od 0 (ocena negatywna) do 100 (ocena pozytywna) | Bangor i in. (2009), abstrakt |
| Brzmienie pozycji | kwestionariusze użyteczności łączą często pozycje sformułowane pozytywnie i negatywnie, co grozi pomyłkami osób badanych i błędnym kodowaniem | Sauro i Lewis (2011), abstrakt |
| Skala odpowiedzi, kierunek każdej pozycji, przeliczenie na 0–100 | nie podajemy – nie mogliśmy tego sprawdzić w źródle autorskim | weź z rozdziału Brooke'a (1996) |
| Podskale, normy, progi | sprawdzone źródła nie podają podskal ani progów do pracy dyplomowej | – |
W sieci łatwo znaleźć arkusze i kalkulatory „SUS score”. Część z nich jest poprawna, ale nie da się tego ocenić bez porównania z oryginałem. W pracy cytuj Brooke'a (1996) jako źródło klucza, a nie stronę z kalkulatorem.
Jak policzyć wynik krok po kroku
- Sprawdź kodowanie odpowiedzi. Formularze online zapisują odpowiedzi jako liczby od 0 albo od 1, a czasem jako tekst etykiety. Porównaj kody w bazie z formularzem i z kluczem, zanim cokolwiek policzysz. Typowe pułapki opisuje wpis o danych z Google Forms i LimeSurvey.
- Ustal kierunek każdej pozycji. Pozycje sformułowane w przeciwnym kierunku trzeba przed zsumowaniem odwrócić. Które to są w SUS – sprawdź w rozdziale Brooke'a (1996). Ten krok łatwo pominąć. Sauro i Lewis (2011) wymieniają zapominanie o odwróceniu skali jako jedną z dwóch wad kwestionariuszy o mieszanym brzmieniu pozycji.
- Przelicz sumę na skalę 0–100 według oryginału. Wynik ogólny SUS nie jest zwykłą sumą ani średnią odpowiedzi, tylko ich przeliczeniem na zakres 0–100. Reguły tego przeliczenia weź z rozdziału Brooke'a (1996).
- Sprawdź zakres. Każdy wynik musi leżeć w przedziale 0–100. Wartość ujemna albo powyżej 100 oznacza błąd w kodzie, a nie bardzo słaby lub bardzo dobry system.
- Ustal regułę dla braków. Sprawdzone źródła nie podają reguły dla pominiętej pozycji. Najprościej nie liczyć wyniku osobie z brakami i podać, ile takich osób było. To decyzja badacza, którą trzeba opisać.
Ogólną technikę przekodowania i sumowania w różnych programach pokazuje poradnik jak policzyć wynik kwestionariusza. Pozycje SUS analizuj tylko jako składniki wyniku ogólnego. Sprawdzone źródła nie podają podskal, więc nie twórz ich na własną rękę.
Interpretacja: bez procentów i bez progów z sieci
Wynik 0–100 to nie procent. Wynik 70 nie znaczy, że system jest „w 70% użyteczny” ani że 70% osób było zadowolonych. To położenie na umownej skali, które ma sens przede wszystkim w porównaniu: dwóch wersji, dwóch systemów albo tego samego systemu przed i po zmianie.
Etykiety słowne tylko z cytowaniem. Bangor, Kortum i Miller (2009) dodali do blisko 1000 ankiet SUS jedenaste pytanie: siedmiostopniową skalę ocen z etykietami przymiotnikowymi. Oceny na tej skali korelowały z wynikiem SUS na poziomie r = .82. Autorzy proponują ją jako pomoc przy wyjaśnianiu wyników osobom spoza branży. Wcześniejszy artykuł tych autorów omawia też, jaki wynik można uznać za akceptowalny (Bangor i in., 2008). Abstrakty nie podają jednak granic liczbowych, a pełnych tekstów nie czytaliśmy. Jeśli promotor chce etykiet słownych, weź je z artykułu i zacytuj go przy każdej tabeli.
Nie twórz własnych przedziałów. Podział „niska, przeciętna, wysoka użyteczność” bez źródła to arbitralny punkt odcięcia. Dlaczego to ryzykowne, wyjaśnia wpis niski, przeciętny, wysoki wynik. Wynik SUS analizuj jako zmienną liczbową. Zwróć też uwagę na efekt sufitu: przy bardzo dobrym systemie część osób osiąga 100 i różnice między wersjami się spłaszczają.
Rzetelność licz na pozycjach po odwróceniu. Alfę albo omegę McDonalda policzysz dopiero wtedy, gdy wszystkie pozycje mają ten sam kierunek. Bez odwrócenia alfa wychodzi zaniżona, nawet ujemna. Więcej we wpisie alfa Cronbacha – rzetelność skali. Zanim podasz jedną alfę, pamiętaj, że rzetelność jednego wyniku zakłada jednowymiarowość skali.
Licencja i wersje językowe
Brooke (2013) opisuje, że za zgodą kierownictwa DEC w 1986 r. udostępnił SUS bezpłatnie współpracownikom, z prawem przekazywania go dalej każdemu, komu się przyda. Nie znaleźliśmy oficjalnej strony autora z warunkami użycia (stan na 1 listopada 2026 r.). W pracy dyplomowej zacytuj rozdział Brooke'a (1996) jako źródło narzędzia i klucza. Ogólne zasady opisuje hasło licencja narzędzia badawczego.
Ten wpis nie powołuje się na żadną polską wersję SUS, bo nie zweryfikowaliśmy publikacji adaptacyjnej. Jeśli używasz tłumaczenia, podaj jego źródło. Jeśli tłumaczysz sam(a), opisz procedurę – pomoże wpis adaptacja kulturowa kwestionariusza.
Przykład: dwie wersje aplikacji, 40 osób
Dane są symulowane i możesz je pobrać jako plik CSV. Czterdzieści osób wykonało te same zadania w obecnej wersji aplikacji (A) i w nowym prototypie (B), a po każdej wersji wypełniło SUS. Połowa zaczynała od A, połowa od B, czyli zastosowano kontrbalansowanie. Plik zawiera tylko wyniki ogólne, już przeliczone według klucza, zaokrąglone do całości. Dwie osoby nie oceniły wersji B, więc porównanie objęło 38 par.
| Wersja | M (SD) | 95% CI | Me | Min–max |
|---|---|---|---|---|
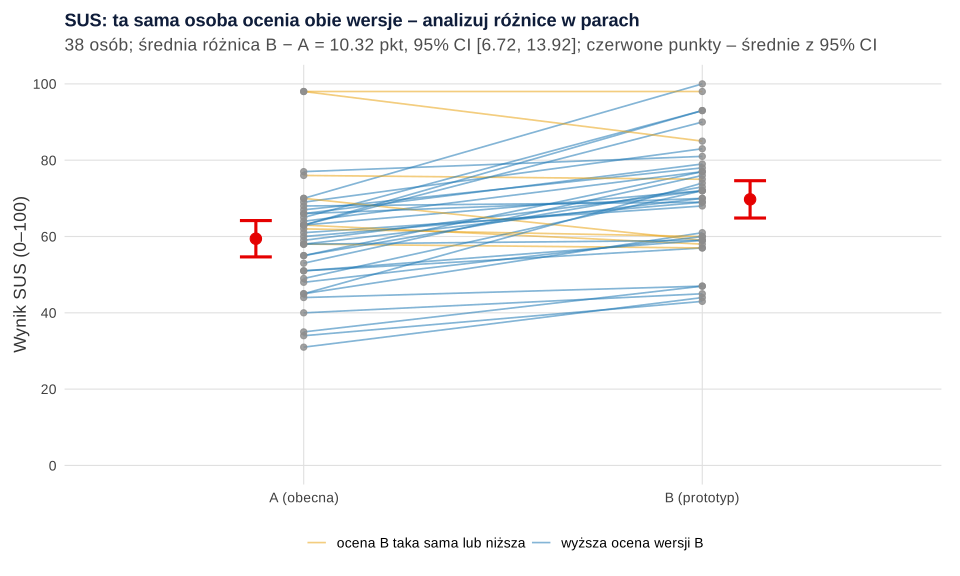
| A – obecna | 59.4 (14.5) | [54.7, 64.2] | 60.5 | 31–98 |
| B – prototyp | 69.7 (14.9) | [64.8, 74.6] | 71.0 | 43–100 |
Porównanie w parach
Ta sama osoba ocenia obie wersje, więc to schemat wewnątrzobiektowy. Oceny jednej osoby korelowały na poziomie r = .72: kto surowo ocenił A, zwykle surowo ocenił też B. Dlatego właściwy jest test t dla prób zależnych, a nie test dla grup niezależnych. Średnia różnica B − A wyniosła 10.32 pkt, 95% CI [6.72, 13.92], t(37) = 5.81, p < .001. Wielkość efektu dz = 0.94 to średnia różnica podzielona przez SD różnic (Lakens, 2013). Wynik B był wyższy u 31 osób, równy u jednej i niższy u sześciu (rysunek 1).
Jako analizę wrażliwości podajemy test Wilcoxona dla par, który nie wymaga normalności różnic: V = 642, p < .001. Oba testy prowadzą do tego samego wniosku. Wielkość efektu dla testu Wilcoxona omawia wpis wielkość efektu dla testów nieparametrycznych.
Kolejność ocen
Przy dwóch ocenach tej samej osoby druga może wypaść inaczej tylko dlatego, że jest druga: osoba zna już zadania albo jest zmęczona (efekt uczenia się). Różnica B − A wyniosła 11.8 pkt (SD = 9.3) w sekwencji AB i 8.8 pkt (SD = 12.4) w sekwencji BA. Test Welcha nie wykazał różnicy między sekwencjami, t(33.39) = 0.83, p = .415. Przy 19 osobach w każdej sekwencji ten test ma jednak małą moc, więc kontrbalansowanie planuj z góry. Pełną analizę takiego planu opisuje wpis schemat naprzemienny (crossover).
Ile osób zbadać
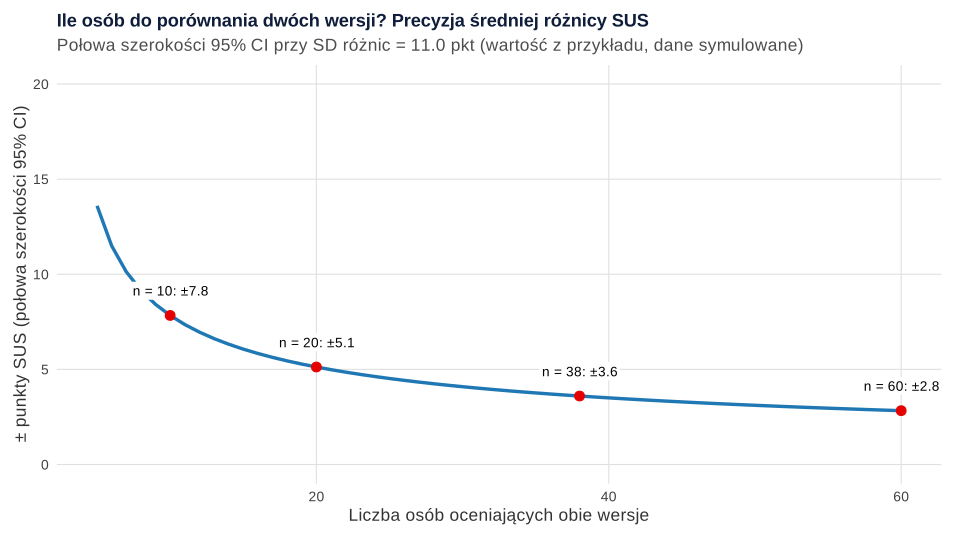
Przy porównaniu dwóch wersji o precyzji decyduje odchylenie standardowe różnic. W przykładzie wynosiło 11 pkt. Połowa szerokości 95% CI dla średniej różnicy to wtedy około ±7.8 pkt przy 10 osobach, ±5.1 przy 20, ±3.6 przy 38 i ±2.8 przy 60 (rysunek 2). Planując badanie, ustal, jaka niepewność jest do przyjęcia, a SD różnic weź z pilotażu albo z podobnego badania (Lakens, 2022). Ogólne zasady wyjaśnia wpis dobór liczebności próby.
Jak opisać SUS w pracy
Wzory zawierają liczby z przykładu. W nawiasach kwadratowych uzupełnij dane swojej wersji.
Ogólny schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór, a zdanie z wynikiem testu t przygotujesz w generatorze opisu wyników APA.
SUS w R: dwie wersje systemu w parach
Kod odtwarza liczby z tekstu i zapisuje plik CSV. Dane są symulowane tylko na poziomie wyniku ogólnego 0–100, więc kod nie zawiera klucza przeliczenia – ten weź z rozdziału Brooke'a (1996). Wszystkie obliczenia korzystają z bazowego R.
Wynik SUS: opis, porównanie w parach i precyzja
R
# B295 – SUS: analiza wyniku ogólnego 0–100 w porównaniu dwóch wersji systemu (dane symulowane, set.seed(2951)).
# Treści pozycji ani klucza przeliczenia nie podajemy: kolumny sus_A i sus_B to wyniki ogólne
# JUŻ policzone według klucza z rozdziału Brooke'a (1996). Dane są symulowane tylko na poziomie wyniku ogólnego
# i zaokrąglone do całości – prawdziwe wyniki SUS przyjmują tylko część wartości z zakresu 0–100.
# 40 osób ocenia dwie wersje aplikacji (A – obecna, B – nowy prototyp) w schemacie wewnątrzosobowym;
# połowa zaczyna od A, połowa od B (kontrbalansowanie).
set.seed(2951)
n <- 40
kolejnosc <- rep(c("AB", "BA"), each = n / 2)
osoba <- rnorm(n, 0, 11)                                     # ogólna skłonność do wysokich ocen
okres2 <- 2                                                  # ocena drugiej wersji nieco wyższa (efekt okresu)
sus_A <- 63 + osoba + rnorm(n, 0, 8) + ifelse(kolejnosc == "BA", okres2, 0)
sus_B <- 68 + osoba + rnorm(n, 0, 8) + ifelse(kolejnosc == "AB", okres2, 0)
ogr <- function(x) round(pmin(100, pmax(0, x)))
dane <- data.frame(id = 1:n, kolejnosc, sus_A = ogr(sus_A), sus_B = ogr(sus_B))
dane$sus_B[c(13, 31)] <- NA                                  # dwie osoby nie dokończyły oceny wersji B
write.csv(dane, "../sus-dane-przyklad.csv", row.names = FALSE, na = "")   # plik do pobrania

# Krok 1. Kontrola: wyniki tylko w zakresie 0–100 albo brak; braki w każdej wersji
all(unlist(dane[, c("sus_A", "sus_B")]) %in% c(0:100, NA))
colSums(is.na(dane[, c("sus_A", "sus_B")]))
d <- dane[complete.cases(dane), ]                            # porównanie wymaga obu ocen od tej samej osoby
nrow(d); table(d$kolejnosc)

# Krok 2. Statystyki opisowe i 95% CI dla średniej każdej wersji
opis <- function(x) {
  ci <- t.test(x)$conf.int
  round(c(M = mean(x), SD = sd(x), lo = ci[1], hi = ci[2], Me = median(x), min = min(x), max = max(x),
          proc_100 = 100 * mean(x == 100)), 1)
}
rbind(A = opis(d$sus_A), B = opis(d$sus_B))

# Krok 3. Różnica B − A: średnia, SD, 95% CI, test t dla prób zależnych i d_z (Lakens, 2013)
roznica <- d$sus_B - d$sus_A
tt <- t.test(d$sus_B, d$sus_A, paired = TRUE)
round(c(M_roznicy = mean(roznica), SD_roznicy = sd(roznica), lo = tt$conf.int[1], hi = tt$conf.int[2],
        t = unname(tt$statistic), df = unname(tt$parameter), d_z = mean(roznica) / sd(roznica)), 2)
format.pval(tt$p.value, digits = 3)
c(lepiej_B = sum(roznica > 0), bez_zmian = sum(roznica == 0), gorzej_B = sum(roznica < 0))
round(cor(d$sus_A, d$sus_B), 2)                              # korelacja ocen tej samej osoby

# Krok 4. Analiza wrażliwości: test Wilcoxona dla par (bez założenia normalności różnic)
wx <- suppressWarnings(wilcox.test(d$sus_B, d$sus_A, paired = TRUE, exact = FALSE))
c(V = unname(wx$statistic)); format.pval(wx$p.value, digits = 3)

# Krok 5. Kolejność ocen (AB/BA): różnica B − A w obu sekwencjach
tapply(roznica, d$kolejnosc, function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 1))
tk <- t.test(roznica ~ d$kolejnosc)                         # Welch: różnica sekwencji = sygnał efektu okresu
round(c(t = unname(tk$statistic), df = unname(tk$parameter)), 2); format.pval(tk$p.value, digits = 3)
round(mean(tapply(roznica, d$kolejnosc, mean)), 2)           # efekt wersji uśredniony po sekwencjach

# Krok 6. Precyzja: połowa szerokości 95% CI dla średniej różnicy przy SD różnic z tego badania
polowa_ci <- function(n_os, s) qt(.975, n_os - 1) * s / sqrt(n_os)
round(sapply(c(10, 20, 38, 60), polowa_ci, s = sd(roznica)), 1)
Wynik w R
[1] TRUE
sus_A sus_B
    0     2
[1] 38

AB BA
19 19
     M   SD   lo   hi   Me min max proc_100
A 59.4 14.5 54.7 64.2 60.5  31  98      0.0
B 69.7 14.9 64.8 74.6 71.0  43 100      2.6
 M_roznicy SD_roznicy         lo         hi          t         df        d_z
     10.32      10.95       6.72      13.92       5.81      37.00       0.94
[1] "1.15e-06"
 lepiej_B bez_zmian  gorzej_B
       31         1         6
[1] 0.72
  V
642
[1] "1.2e-05"
$AB
   M   SD    n
11.8  9.3 19.0

$BA
   M   SD    n
 8.8 12.4 19.0

    t    df
 0.83 33.39
[1] "0.415"
[1] 10.32
[1] 7.8 5.1 3.6 2.8
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy SUS
- Brak odwrócenia pozycji wskazanych w kluczu. Suma bez przekodowania pozycji o przeciwnym kierunku daje wynik bez sensu, a alfa spada do zera albo poniżej.
- Klucz z nieznanego arkusza. Kierunek pozycji i przeliczenie na 0–100 bierz z rozdziału Brooke'a (1996) i cytuj to źródło.
- Czytanie wyniku jak procentu. Wynik 0–100 to umowna skala, nie odsetek zadowolonych użytkowników.
- Test dla grup niezależnych przy ocenie obu wersji przez te same osoby. Ignoruje korelację ocen i zaniża moc.
- Progi i etykiety bez źródła. Etykiety przymiotnikowe pochodzą z badań Bangora i in. (2009) – podawaj je tylko z cytowaniem.
- Brak informacji o kolejności. Bez kontrbalansowania różnica między wersjami może być efektem kolejności.
Całą ścieżkę od kodowania po rzetelność porządkuje przewodnik po analizie kwestionariusza, a inne narzędzia z instrukcją liczenia znajdziesz w katalogu narzędzi badawczych. Jeśli chcesz, żeby ktoś sprawdził liczenie SUS i porównanie wersji w Twojej bazie, skorzystaj z oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jak policzyć wynik SUS?
Przekoduj odpowiedzi, odwróć pozycje o przeciwnym kierunku i przelicz wynik na skalę 0–100 według klucza z rozdziału Brooke'a (1996). Nie mieliśmy dostępu do pełnego tekstu tego rozdziału, więc reguł przeliczenia nie podajemy. Weź je z oryginału i zacytuj go w pracy, a każdy wynik sprawdź, czy mieści się w zakresie 0–100.
Czy wynik SUS 70 oznacza 70% użyteczności?
Nie. Skala 0–100 jest umowna i nie oznacza odsetka zadowolonych osób ani procentu spełnionych wymagań. Wynik ma sens przede wszystkim w porównaniu dwóch wersji, dwóch systemów albo pomiaru przed i po zmianie. Etykiety słowne, np. z badań Bangora i in. (2009), podawaj tylko z cytowaniem źródła.
Jakim testem porównać wyniki SUS dwóch wersji systemu?
Jeśli te same osoby oceniały obie wersje, użyj testu t dla prób zależnych z 95% CI dla średniej różnicy i d_z, a jako analizy wrażliwości testu Wilcoxona dla par. Gdy każda wersja miała inne osoby, użyj testu Welcha. Opisz też kolejność oceniania i to, czy była kontrbalansowana.
Czy SUS jest darmowy?
Brooke (2013) opisuje, że w 1986 r. za zgodą firmy DEC udostępnił SUS bezpłatnie, z prawem przekazywania go dalej. Nie znaleźliśmy oficjalnej strony z warunkami użycia (stan na 1 listopada 2026 r.). W pracy zacytuj rozdział z 1996 r. jako źródło narzędzia i klucza.
Ile osób potrzeba do badania SUS?
Zależy to od tego, jak precyzyjnie chcesz oszacować wynik albo różnicę między wersjami. W przykładzie przy odchyleniu standardowym różnic równym 11 pkt połowa szerokości 95% CI wynosiła około 7.8 pkt przy 10 osobach i 3.6 pkt przy 38 osobach. Odchylenie weź z pilotażu i uzasadnij liczebność (Lakens, 2022).
Powiązane hasła
Przeczytaj też
Jak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikNASA-TLX – obciążenie zadaniem: jak policzyć wynik
Sześć podskal, wynik ważony i nieważony, warunki użycia NASA oraz porównanie warunków zadania na profilu podskal – z przykładem w R i wzorem opisu.
Czytaj →PoradnikSchemat naprzemienny (crossover)
AB/BA krok po kroku: okres, sekwencja, przeniesienie i wypłukiwanie, model mieszany w R, symulacja procedury dwuetapowej i wzór opisu.
Czytaj →PoradnikStatystyka w pracy z zarządzania i ekonomii
Ankieta wśród pracowników i model ekonometryczny na danych wtórnych: regresja, weryfikacja modelu, elastyczności, kod R i gotowe opisy wyników.
Czytaj →Porównujesz dwie wersje systemu w badaniu SUS i nie wiesz, jak to policzyć?
Sprawdzimy kodowanie i przeliczenie wyniku, dobór testu do schematu badania, kontrolę kolejności i opis wyników, a potem wyjaśnimy analizę tak, żebyś umiał(a) samodzielnie ją opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bangor, A., Kortum, P. T., & Miller, J. T. (2008). An empirical evaluation of the System Usability Scale. International Journal of Human–Computer Interaction, 24(6), 574–594. https://doi.org/10.1080/10447310802205776
- Bangor, A., Kortum, P., & Miller, J. (2009). Determining what individual SUS scores mean: Adding an adjective rating scale. Journal of Usability Studies, 4(3), 114–123.
- Brooke, J. (1996). SUS: A “quick and dirty” usability scale. In P. W. Jordan, B. Thomas, I. L. McClelland, & B. Weerdmeester (Eds.), Usability evaluation in industry (pp. 207–212). CRC Press. https://doi.org/10.1201/9781498710411-35
- Brooke, J. (2013). SUS: A retrospective. Journal of Usability Studies, 8(2), 29–40.
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Lewis, J. R. (2018). The System Usability Scale: Past, present, and future. International Journal of Human–Computer Interaction, 34(7), 577–590. https://doi.org/10.1080/10447318.2018.1455307
- Sauro, J., & Lewis, J. R. (2011). When designing usability questionnaires, does it hurt to be positive? In Proceedings of the SIGCHI Conference on Human Factors in Computing Systems (pp. 2215–2224). ACM. https://doi.org/10.1145/1978942.1979266
Cytowania BibTeX
@article{bangor2008empirical, author={Bangor, Aaron and Kortum, Philip T. and Miller, James T.}, title={{An empirical evaluation of the System Usability Scale}}, journal={International Journal of Human–Computer Interaction}, year={2008}, volume={24}, number={6}, pages={574--594}, doi={10.1080/10447310802205776}}@article{bangor2009determining, author={Bangor, Aaron and Kortum, Philip and Miller, James}, title={{Determining what individual SUS scores mean: Adding an adjective rating scale}}, journal={Journal of Usability Studies}, year={2009}, volume={4}, number={3}, pages={114--123}}@incollection{brooke1996sus, author={Brooke, John}, title={{SUS: A “quick and dirty” usability scale}}, booktitle={Usability evaluation in industry}, year={1996}, pages={207--212}, publisher={CRC Press}, doi={10.1201/9781498710411-35}}@article{brooke2013sus, author={Brooke, John}, title={{SUS: A retrospective}}, journal={Journal of Usability Studies}, year={2013}, volume={8}, number={2}, pages={29--40}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{lewis2018system, author={Lewis, James R.}, title={{The System Usability Scale: Past, present, and future}}, journal={International Journal of Human–Computer Interaction}, year={2018}, volume={34}, number={7}, pages={577--590}, doi={10.1080/10447318.2018.1455307}}@inproceedings{sauro2011designing, author={Sauro, Jeff and Lewis, James R.}, title={{When designing usability questionnaires, does it hurt to be positive?}}, booktitle={Proceedings of the SIGCHI Conference on Human Factors in Computing Systems}, year={2011}, pages={2215--2224}, publisher={ACM}, doi={10.1145/1978942.1979266}}