Czym jest NASA-TLX
NASA-TLX (NASA Task Load Index) to kwestionariusz subiektywnej oceny obciążenia zadaniem. Osoba badana ocenia, ile wysiłku, presji i frustracji kosztowało ją konkretne zadanie: lot w symulatorze, obsługa panelu dyspozytorskiego, praca z nową aplikacją albo test w laboratorium. Narzędzie opracowała Sandra Hart w ośrodku NASA Ames w latach 80. jako kwestionariusz papierowy (National Aeronautics and Space Administration, 2026). Opis jego powstania opublikowali Hart i Staveland (1988), a procedurę zbierania i liczenia wyników opisuje podręcznik wersji papierowej (NASA Ames Research Center, b.d.).
Według przeglądu 550 badań NASA-TLX szybko wyszedł poza lotnictwo i poza język angielski (Hart, 2006). Dziś pojawia się w pracach z ergonomii, zarządzania i psychologii pracy, np. przy porównaniu organizacji stanowiska, systemów zmianowych albo procedur, a także w informatyce przy ocenie interfejsów. Ogólny warsztat tych kierunków opisują wpisy statystyka dla psychologa i statystyka w pracy z zarządzania i ekonomii. W badaniach interfejsów NASA-TLX często stoi obok skali SUS: SUS mówi, jak użytkownik ocenia system, a NASA-TLX – ile kosztowało go zadanie.
Nie myl obciążenia zadaniem z obciążeniem respondenta. Tamto pojęcie dotyczy wysiłku związanego z wypełnieniem ankiety, a NASA-TLX mierzy obciążenie badanym zadaniem. Oceny zbiera się po każdym wykonaniu zadania albo jego fragmentu (NASA Ames Research Center, b.d., s. 2), więc w planie badania wyznacz moment pomiaru po każdym warunku.
Budowa i klucz
Treści formularza nie przytaczamy. Klucz opisujemy według podręcznika NASA-TLX w wersji 1.0, opublikowanego na oficjalnej stronie NASA (odczyt 1 listopada 2026 r.). Numery stron podajemy według paginacji podręcznika.
| Element | Reguła | Źródło |
|---|---|---|
| Podskale | sześć: wymagania umysłowe, wymagania fizyczne, presja czasu, wykonanie, wysiłek, frustracja; trzy dotyczą wymagań zadania, trzy – interakcji osoby z zadaniem | podręcznik, s. 1–2 |
| Skala ocen | odcinek podzielony na 20 równych części; 21 kresek dzieli skalę od 0 do 100 co 5 pkt; znak między kreskami liczy się jako wartość wyższej kreski | podręcznik, s. 4 |
| Kotwice i kierunek | pięć podskal od „niskie” do „wysokie”; wykonanie od „dobre” (lewa strona) do „słabe” (prawa) – wyższa liczba oznacza więc gorszą ocenę własnego wykonania | podręcznik, s. 11, 13 |
| Wagi | 15 porównań par podskal na osobnych kartach; osoba wybiera z każdej pary podskalę, która bardziej przyczyniła się do obciążenia; waga = liczba wyborów, od 0 (nieistotna) do 5; suma wag = 15 | podręcznik, s. 3, 18 |
| Wynik ogólny | suma iloczynów ocena × waga podzielona przez 15 | podręcznik, s. 4, 6 |
| Raw TLX | wersja bez ważenia: oceny się uśrednia albo sumuje | Hart (2006, s. 906) |
| Normy, progi | brak; Hart uważa, że do użytecznej granicy „za wysokiego” obciążenia jeszcze daleko | Hart (2006, s. 907) |
Podręcznik ustala też, kiedy zbierać wagi. Jeden zestaw wag uzyskuje się dla każdego wyraźnie odmiennego zadania. Ten sam zestaw można stosować do wielu wersji tego samego zadania, jeśli źródła obciążenia są podobne. Wagi trzeba zebrać po tym, jak osoba choć trochę poznała warunki zadania (s. 3, 5).
Jak policzyć wynik krok po kroku
- Zapisz oceny sześciu podskal. Każda osoba ocenia każdą podskalę po każdym warunku. W bazie trzymaj jeden wiersz na osobę i warunek, z sześcioma kolumnami ocen 0–100. Poprawne wartości to tylko wielokrotności 5.
- Nie odwracaj wykonania. Wykonanie ma kotwice od „dobre” do „słabe”, więc wyższa liczba już oznacza większe obciążenie. Podręcznik zwraca uwagę, że ta kolejność bywa myląca dla osób badanych (s. 11). Dlatego wyjaśnij ją w instrukcji. Jeśli używasz innego formularza, np. ankiety online, sprawdź jego układ, zanim zapiszesz dane.
- Policz wagi. Dla każdej osoby zlicz, ile razy w 15 parach wybrała daną podskalę. Suma sześciu wag musi wynosić 15, a żadna waga nie może przekroczyć 5. To kontrola błędu w zliczaniu, którą podręcznik wpisał w arkusz zliczeń (s. 18).
- Policz wynik ważony. Pomnóż każdą ocenę przez wagę tej podskali, zsumuj i podziel przez 15. To średnia ważona w zakresie 0–100.
- Ustal regułę dla braków. Podręcznik jej nie podaje. W przykładzie nie liczymy wyniku, gdy brakuje którejkolwiek oceny, a osobę bez kompletu w jednym warunku pomijamy w porównaniu. To decyzja badacza, którą trzeba opisać.
Raw TLX. Hart (2006, s. 906) pisze, że najczęstszą modyfikacją jest rezygnacja z ważenia. Taka wersja zyskała popularność, bo jest prostsza. W 29 badaniach porównujących ją z oryginałem bywała bardziej czuła, mniej czuła albo równie czuła, więc według autorki można wybrać którąkolwiek. Wybierz wersję przed analizą, nazwij ją w pracy i nie mieszaj obu wersji w jednym porównaniu. W przykładzie liczymy obie, żeby pokazać, czym się różnią.
Interpretacja: profil podskal, nie tylko jedna liczba
Wynik ogólny to podsumowanie, a nie cały wynik. Ten sam wynik ogólny może wynikać z wysokich wymagań umysłowych albo z dużej frustracji. To różne problemy, które wymagają innych zmian w zadaniu. Hart (2006, s. 907) odnotowuje, że w co najmniej 40 badaniach analizowano podskale zamiast wyniku ogólnego, a w blisko 20% – obok niego. Wartość diagnostyczną podskal uważa za jedną z mocnych stron narzędzia. Same wagi też niosą informację o tym, skąd bierze się obciążenie w zadaniu (podręcznik, s. 3).
Rzetelność. Podręcznik nie przewiduje alfy Cronbacha. Hart (2006, s. 907) zauważa, że podskale często są istotnie skorelowane, i uznaje, że mierzą różne aspekty tego samego zjawiska. Jeśli promotor prosi o alfę, licz ją dla sześciu ocen surowych i nazwij spójnością podskal, a nie rzetelnością wyniku ważonego. Wagi są indywidualne, więc wynik ważony nie jest zwykłą sumą pozycji. Kiedy jedna alfa ma sens, wyjaśnia hasło jednowymiarowość skali.
Porównuj warunki u tych samych osób. NASA-TLX najlepiej działa jako miara względna: to samo zadanie w dwóch wersjach, różna trudność, przed i po szkoleniu. Podręcznik opisuje typowe użycie w schematach wewnątrzosobowych (s. 5). Hart (2006, s. 907) ostrzega też przed efektem kontekstu: ocena jednego zadania może zależeć od tego, co osoba robiła tuż przed nim. Stąd kontrbalansowanie kolejności warunków. Progów „wysokiego obciążenia” nie ma, więc nie dziel wyników na kategorie bez źródła.
Licencja i wersje językowe
Według oficjalnej strony NASA narzędzie jest „open source” i dostępne do natychmiastowego użycia dla każdej osoby i organizacji na świecie. Do użycia NASA-TLX nie trzeba zgody NASA. Nie trzeba jej także do modyfikacji narzędzia, np. tłumaczenia (National Aeronautics and Space Administration, 2026; stan na 1 listopada 2026 r.). Jest też bezpłatna aplikacja na iOS. Strona ma oznaczenie, że nie jest aktywnie utrzymywana i ma charakter historyczny, więc warunki sprawdź ponownie przed badaniem. Ogólne zasady opisuje hasło licencja narzędzia badawczego.
Hart (2006, s. 905) odnotowuje przekłady na wiele języków i zauważa, że nazwy, kotwice i definicje podskal tłumaczono raczej w sposób dopasowany do kultury niż dosłownie. Dodaje też, że przekład wymaga ponownego sprawdzenia trafności i czułości. Ten wpis nie powołuje się na polską wersję NASA-TLX, bo nie zweryfikowaliśmy publikacji adaptacyjnej. Jeśli korzystasz z tłumaczenia, podaj jego źródło, a jeśli tłumaczysz sam(a), opisz procedurę według wpisu adaptacja kulturowa kwestionariusza.
Przykład: dwie wersje panelu, 32 osoby
Dane są symulowane i możesz je pobrać jako plik CSV. Trzydzieści dwie osoby wykonały to samo zadanie dyspozytorskie na panelu standardowym (S) i uproszczonym (U), w kolejności kontrbalansowanej. Po każdym warunku oceniły sześć podskal na skali 0–100 co 5 pkt. Ponieważ to dwie wersje tego samego zadania, każda osoba wykonała jeden zestaw 15 porównań, a wagi 0–5 zapisano w osobnych kolumnach. Jedna osoba nie oceniła frustracji w jednym warunku, więc porównanie objęło 31 osób.
| Wynik | Panel standardowy M (SD) | Panel uproszczony M (SD) | Różnica U − S [95% CI] | t(30) | dz |
|---|---|---|---|---|---|
| Ważony | 52.5 (10.2) | 47.0 (10.5) | −5.45 [−8.12, −2.78] | −4.17 | −0.75 |
| Raw TLX | 49.2 (8.8) | 44.0 (8.9) | −5.22 [−7.38, −3.05] | −4.92 | −0.88 |
Porównanie warunków
Ta sama osoba pracowała w obu warunkach, więc użyliśmy testu t dla prób zależnych. Uproszczony panel dał niższe obciążenie w obu wersjach wyniku, w obu przypadkach p < .001. Wielkość efektu dz to średnia różnica podzielona przez SD różnic (Lakens, 2013). Tu Raw TLX dał nieco większy efekt standaryzowany niż wynik ważony, co dobrze ilustruje uwagę Hart, że żadna wersja nie wygrywa zawsze. Przy więcej niż dwóch warunkach przejdź do ANOVA z powtarzanymi pomiarami, a przy wielu zadaniach i niepełnych danych rozważ model mieszany (zob. ANOVA czy model mieszany).
Profil podskal i wagi
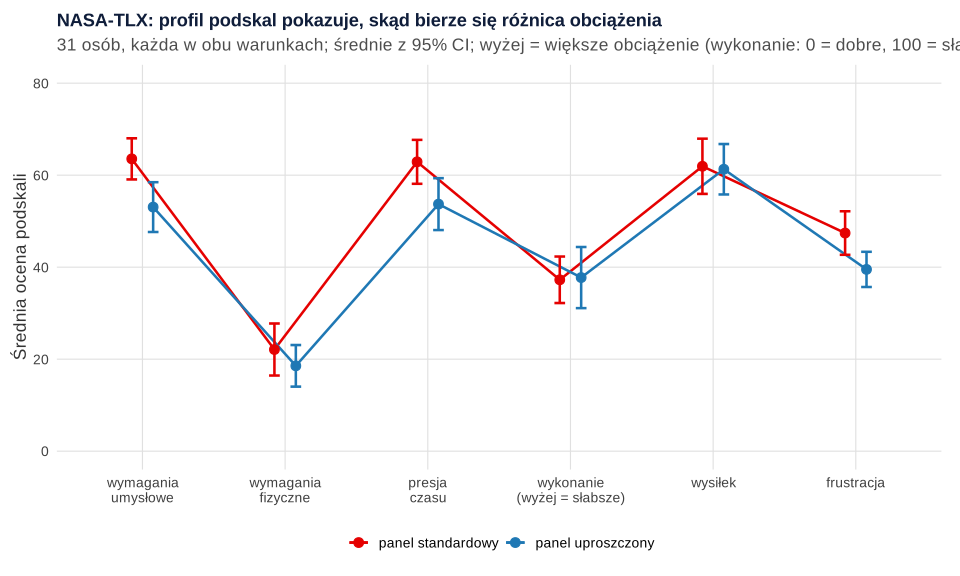
W profilu (rysunek 1) największy spadek dotyczył wymagań umysłowych: −10.48 pkt, 95% CI [−16.03, −4.93], dz = −0.69, pHolm = .003. Spadły też presja czasu, −9.19 [−14.94, −3.45], pHolm = .014, i frustracja, −7.90 [−13.02, −2.79], pHolm = .015. Wymagania fizyczne, wykonanie i wysiłek nie różniły się istotnie (pHolm ≥ .875). Sześć testów to wielokrotne porównania, dlatego p skorygowaliśmy metodą Holma (1979). Kiedy poprawka jest potrzebna, omawia wpis czy stosować poprawkę na wielokrotne porównania.
Średnie wagi pokazują, co osoby uznawały za źródło obciążenia. Najwyższe były dla wymagań umysłowych (3.39) i presji czasu (3.23), najniższa dla wymagań fizycznych (1.52). Co piąta osoba (19.4%) dała wymaganiom fizycznym wagę 0, czyli uznała je za nieistotne w tym zadaniu.
Wynik ważony a Raw TLX
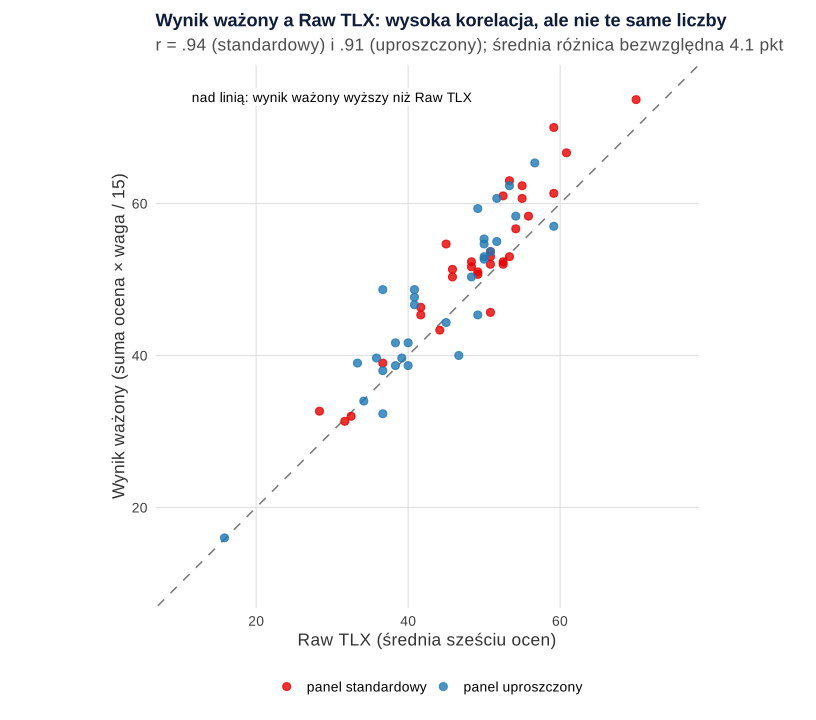
Obie wersje wyniku były silnie skorelowane: r = .94 dla panelu standardowego i r = .91 dla uproszczonego. Nie dawały jednak tych samych liczb. Średnia różnica bezwzględna wynosiła 4.05 pkt, a maksymalna 12 pkt (rysunek 2). Wynik ważony był zwykle wyższy, bo największe wagi dostały podskale oceniane wysoko, a najmniejszą – nisko oceniane wymagania fizyczne. Wniosek dla pracy: nie porównuj wprost średnich ważonych z wynikami Raw TLX z innych badań.
Jak opisać NASA-TLX w pracy
Wzory zawierają liczby z przykładu. W nawiasach kwadratowych uzupełnij dane swojej wersji.
Ogólny schemat opisu narzędzia znajdziesz w poradniku opis narzędzia badawczego – wzór, a zdania o wynikach testów przygotujesz w generatorze opisu wyników APA.
NASA-TLX w R: wagi, wynik ważony, Raw TLX i profil podskal
Kod odtwarza liczby z tekstu i zapisuje plik CSV. Symuluje oceny 0–100 co 5 pkt i 15 porównań parami, zlicza wagi, sprawdza sumę 15 i liczy wynik ważony według podręcznika NASA oraz Raw TLX. Wszystkie obliczenia korzystają z bazowego R.
Wynik NASA-TLX krok po kroku
R
# B296 – NASA-TLX: wagi z 15 porównań parami, wynik ważony i Raw TLX, porównanie dwóch wersji panelu,
# profil podskal (dane symulowane, set.seed(2961)). Treści formularza nie podajemy.
# Reguły według podręcznika NASA-TLX v1.0 (NASA Ames Research Center, b.d., s. 3–4, 6, 11):
# – każda z sześciu podskal: ocena 0–100 co 5 punktów (21 kresek); znak między kreskami = wyższa kreska;
# – podskala wykonania ma kotwice „dobre” (lewo) – „słabe” (prawo), więc wyżej = gorzej = większe obciążenie;
# – wagi: 15 porównań par podskal, waga = liczba wyborów danej podskali (0–5), suma wag = 15;
# – wynik ważony = suma (ocena × waga) / 15. Raw TLX = zwykła średnia sześciu ocen (Hart, 2006, s. 906).
# 32 osoby wykonują to samo zadanie dyspozytorskie na panelu standardowym (S) i uproszczonym (U),
# w kolejności kontrbalansowanej; jeden zestaw wag na osobę (dwie wersje tego samego zadania).
set.seed(2961)
n <- 32
pod <- c("umyslowe", "fizyczne", "czasowe", "wykonanie", "wysilek", "frustracja")
sr_S <- c(62, 18, 58, 40, 60, 45); sr_U <- c(53, 17, 52, 35, 55, 36)   # średnie populacyjne w symulacji
osoba <- rnorm(n, 0, 9)
do_5 <- function(x) pmin(100, pmax(0, 5 * ceiling(x / 5)))              # zaokrąglenie w górę do kreski co 5
oceny <- function(srednie, warunek) {
  x <- sapply(srednie, function(m) do_5(m + osoba + rnorm(n, 0, 12)))
  colnames(x) <- pod
  data.frame(id = 1:n, warunek, x)
}
# Porównania parami: osoba wybiera z każdej pary podskalę ważniejszą dla obciążenia w tym zadaniu
pary <- combn(pod, 2)                                                    # 15 par
waznosc <- c(umyslowe = 1.2, fizyczne = -1.2, czasowe = 0.6, wykonanie = 0, wysilek = 0.6, frustracja = 0)
wybory <- t(sapply(1:n, function(i) {
  u <- waznosc + rnorm(6, 0, 0.8); names(u) <- pod
  apply(pary, 2, function(p) if (runif(1) < plogis(u[p[1]] - u[p[2]])) p[1] else p[2])
}))
wagi <- t(apply(wybory, 1, function(w) table(factor(w, levels = pod))))
colnames(wagi) <- paste0("w_", pod)
dane <- rbind(oceny(sr_S, "S"), oceny(sr_U, "U"))
dane <- cbind(dane, wagi[dane$id, ])
dane$kolejnosc <- rep(rep(c("SU", "US"), each = n / 2), 2)
dane$frustracja[dane$id == 7 & dane$warunek == "U"] <- NA          # jedna brakująca ocena
write.csv(dane, "../tlx-dane-przyklad.csv", row.names = FALSE, na = "")   # plik do pobrania
W <- paste0("w_", pod)

# Krok 1. Kontrola: oceny 0–100 co 5 albo brak; wagi 0–5, suma wag = 15 (kontrola z arkusza zliczeń)
all(unlist(dane[, pod]) %in% c(seq(0, 100, 5), NA))
all(unlist(dane[, W]) %in% 0:5); table(rowSums(dane[, W]))
colSums(is.na(dane[, pod]))

# Krok 2. Wynik ważony = suma(ocena × waga) / 15; Raw TLX = średnia sześciu ocen
# Przy brakującej ocenie nie liczymy wyniku – decyzja badacza, opisana w pracy
dane$tlx_wazony <- rowSums(dane[, pod] * dane[, W]) / 15
dane$raw_tlx <- rowMeans(dane[, pod])
kompletne <- tapply(!is.na(dane$tlx_wazony), dane$id, all)
d <- dane[dane$id %in% as.integer(names(kompletne)[kompletne]), ]
length(unique(d$id))
S <- d[d$warunek == "S", ]; U <- d[d$warunek == "U", ]
stopifnot(all(S$id == U$id))
opis <- function(x) round(c(M = mean(x), SD = sd(x), Me = median(x), min = min(x), max = max(x)), 1)
rbind(S_wazony = opis(S$tlx_wazony), U_wazony = opis(U$tlx_wazony),
      S_raw = opis(S$raw_tlx), U_raw = opis(U$raw_tlx))

# Krok 3. Zgodność wyniku ważonego i Raw TLX
round(c(r_S = cor(S$tlx_wazony, S$raw_tlx), r_U = cor(U$tlx_wazony, U$raw_tlx),
        sr_bezwzgl_roznica = mean(abs(d$tlx_wazony - d$raw_tlx)),
        max_bezwzgl_roznica = max(abs(d$tlx_wazony - d$raw_tlx))), 2)

# Krok 4. Różnica U − S dla obu wersji wyniku: test t dla prób zależnych, 95% CI i d_z
porownaj <- function(u, s) {
  r <- u - s; tt <- t.test(u, s, paired = TRUE)
  c(M_roznicy = mean(r), SD = sd(r), lo = tt$conf.int[1], hi = tt$conf.int[2], t = unname(tt$statistic),
    df = unname(tt$parameter), p = tt$p.value, d_z = mean(r) / sd(r))
}
glowne <- rbind(wazony = porownaj(U$tlx_wazony, S$tlx_wazony),
                raw_tlx = porownaj(U$raw_tlx, S$raw_tlx))
round(glowne[, -7], 2); format.pval(glowne[, "p"], digits = 3)

# Krok 5. Profil podskal: różnica U − S w każdej podskali, p z poprawką Holma
prof <- t(sapply(pod, function(k) porownaj(U[[k]], S[[k]])))
prof <- cbind(prof, p_Holm = p.adjust(prof[, "p"], method = "holm"))
round(prof[, c("M_roznicy", "lo", "hi", "t", "d_z", "p", "p_Holm")], 3)

# Krok 6. Wagi: średnia (0–5) i odsetek osób, które dały podskali wagę 0 (uznały ją za nieistotną)
round(rbind(srednia_waga = colMeans(S[, W]), proc_waga_0 = 100 * colMeans(S[, W] == 0)), 2)
Wynik w R
[1] TRUE
[1] TRUE

15
64
  umyslowe   fizyczne    czasowe  wykonanie    wysilek frustracja
         0          0          0          0          0          1
[1] 31
            M   SD   Me  min  max
S_wazony 52.5 10.2 52.3 31.3 73.7
U_wazony 47.0 10.5 47.7 16.0 65.3
S_raw    49.2  8.8 50.8 28.3 70.0
U_raw    44.0  8.9 45.0 15.8 59.2
                r_S                 r_U  sr_bezwzgl_roznica max_bezwzgl_roznica
               0.94                0.91                4.05               12.00
        M_roznicy   SD    lo    hi     t df   d_z
wazony      -5.45 7.28 -8.12 -2.78 -4.17 30 -0.75
raw_tlx     -5.22 5.90 -7.38 -3.05 -4.92 30 -0.88
[1] "0.000239" "2.88e-05"
           M_roznicy      lo     hi      t    d_z     p p_Holm
umyslowe     -10.484 -16.034 -4.934 -3.858 -0.693 0.001  0.003
fizyczne      -3.548 -10.299  3.202 -1.074 -0.193 0.292  0.875
czasowe       -9.194 -14.937 -3.450 -3.269 -0.587 0.003  0.014
wykonanie      0.484  -6.286  7.253  0.146  0.026 0.885  1.000
wysilek       -0.645  -8.451  7.161 -0.169 -0.030 0.867  1.000
frustracja    -7.903 -13.020 -2.786 -3.154 -0.567 0.004  0.015
             w_umyslowe w_fizyczne w_czasowe w_wykonanie w_wysilek w_frustracja
srednia_waga       3.39       1.52      3.23        2.06      2.58         2.23
proc_waga_0        0.00      19.35      3.23        0.00      3.23         6.45
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy NASA-TLX
- Odwracanie wykonania. Na formularzu NASA wyższa wartość wykonania już oznacza gorzej. Odwracanie jej zaniża wynik. Przekoduj tylko wtedy, gdy Twój formularz ma odwrotny układ.
- Wagi, które nie sumują się do 15. To znak błędu w zliczaniu albo pominiętej karty. Żadna waga nie może przekroczyć 5.
- Dzielenie przez 6 zamiast przez 15. W wersji ważonej mianownikiem jest suma wag, czyli 15.
- Nienazwana wersja wyniku. Napisz, czy liczysz wynik ważony, czy Raw TLX, i podaj źródło procedury.
- Tylko wynik ogólny. Bez profilu podskal nie wiesz, czy zmniejszył się wysiłek umysłowy, czy frustracja.
- Progi „wysokiego obciążenia” bez źródła. Podręcznik ich nie podaje. Porównuj warunki.
Inne narzędzia z instrukcją liczenia wyniku znajdziesz w katalogu narzędzi badawczych. Jeśli chcesz, żeby ktoś sprawdził obliczenie NASA-TLX i plan analizy w Twojej pracy, skorzystaj z oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jak policzyć wynik NASA-TLX?
Zapisz oceny sześciu podskal (0–100 co 5 pkt) po każdym warunku. Z 15 porównań par zlicz, ile razy każda podskala została wybrana – to jej waga od 0 do 5, a wagi sumują się do 15. Wynik ważony to suma iloczynów ocena × waga podzielona przez 15 (NASA Ames Research Center, b.d., s. 4).
Czym różni się Raw TLX od wersji ważonej?
Raw TLX pomija porównania parami: oceny sześciu podskal się uśrednia albo sumuje. Hart (2006) podaje, że w 29 badaniach porównawczych bywał bardziej, mniej albo równie czuły jak wersja ważona. W przykładzie obie wersje korelowały na poziomie .91–.94, ale różniły się średnio o 4.05 pkt. Wybierz jedną wersję przed analizą i nazwij ją w pracy.
Czy do NASA-TLX potrzebna jest zgoda NASA?
Nie. Oficjalna strona NASA opisuje narzędzie jako „open source” i dostępne dla każdego. Zgoda nie jest potrzebna ani do użycia, ani do modyfikacji, np. tłumaczenia (stan na 1 listopada 2026 r.). Strona ma charakter historyczny, więc sprawdź ją jeszcze raz przed badaniem.
Czy podskalę wykonania w NASA-TLX trzeba odwracać?
Na formularzu NASA nie. Wykonanie ma kotwice od „dobre” do „słabe”, więc wyższa liczba oznacza gorszą ocenę własnego wykonania, czyli większe obciążenie (podręcznik NASA, s. 11). Przekoduj tylko wtedy, gdy Twój formularz, np. ankieta online, ma odwrotny układ.
Jaki wynik NASA-TLX oznacza wysokie obciążenie?
Podręcznik nie podaje norm ani progów, a Hart (2006) uważa, że do użytecznej granicy „zbyt wysokiego” obciążenia wciąż daleko. NASA-TLX najlepiej działa jako miara względna: porównuj warunki, wersje narzędzia albo pomiary przed i po zmianie u tych samych osób.
Powiązane hasła
Przeczytaj też
SUS – skala użyteczności systemu: jak policzyć wynik
Co wiadomo o kluczu SUS i skąd go wziąć, wynik 0–100 bez mylenia z procentem i porównanie dwóch wersji systemu w parach – z przykładem w R i wzorem opisu.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami krok po kroku
Cztery warunki, te same osoby: sferyczność i poprawka GG, η²G, porównania parami w emmeans, wykres z CI wewnątrzosobowymi, schemat mieszany i opis APA.
Czytaj →PoradnikJak zaprojektować pomiar latentny
Definicja konstruktu, wskaźniki refleksyjne i formatywne, pozycja globalna i MIMIC, lista kontrolna kwestionariusza oraz symulacja w lavaan i seminr.
Czytaj →PoradnikStatystyka dla psychologa
Analizy w pracy dyplomowej z psychologii: typowe projekty, wynik kwestionariusza, alfa i omega, normy i steny, eksperyment i raport APA – z danymi i kodem R.
Czytaj →Mierzysz obciążenie zadaniem NASA-TLX i nie wiesz, jak porównać warunki?
Sprawdzimy kodowanie ocen i wag, wybór wersji wyniku, dobór testów do schematu z powtarzanym pomiarem i opis profilu podskal, a potem wyjaśnimy analizę tak, żebyś umiał(a) samodzielnie ją opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Hart, S. G. (2006). NASA-Task Load Index (NASA-TLX); 20 years later. Proceedings of the Human Factors and Ergonomics Society Annual Meeting, 50(9), 904–908. https://doi.org/10.1177/154193120605000909
- Hart, S. G., & Staveland, L. E. (1988). Development of NASA-TLX (Task Load Index): Results of empirical and theoretical research. In P. A. Hancock & N. Meshkati (Eds.), Human mental workload (pp. 139–183). North-Holland. https://doi.org/10.1016/s0166-4115(08)62386-9
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- NASA Ames Research Center. (b.d.). NASA Task Load Index (NASA-TLX), version 1.0: Paper and pencil package. https://www.nasa.gov/wp-content/uploads/2026/03/nasa-tlx-v1-0-searchable-text-and-forms.pdf ● Otwarty dostęp
- National Aeronautics and Space Administration. (2026, 11 marca). NASA Task Load Index (TLX). NASA, Human Systems Integration Division. https://www.nasa.gov/human-systems-integration-division/nasa-task-load-index-tlx/ ● Otwarty dostęp
Cytowania BibTeX
@article{hart2006nasa, author={Hart, Sandra G.}, title={{NASA-Task Load Index (NASA-TLX); 20 years later}}, journal={Proceedings of the Human Factors and Ergonomics Society Annual Meeting}, year={2006}, volume={50}, number={9}, pages={904--908}, doi={10.1177/154193120605000909}}@incollection{hart1988development, author={Hart, Sandra G. and Staveland, Lowell E.}, title={{Development of NASA-TLX (Task Load Index): Results of empirical and theoretical research}}, booktitle={Human mental workload}, year={1988}, pages={139--183}, publisher={North-Holland}, doi={10.1016/s0166-4115(08)62386-9}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@techreport{nasaamestlxmanual, author={{NASA Ames Research Center}}, title={{NASA Task Load Index (NASA-TLX), version 1.0: Paper and pencil package}}, institution={NASA Ames Research Center}, url={https://www.nasa.gov/wp-content/uploads/2026/03/nasa-tlx-v1-0-searchable-text-and-forms.pdf}}@misc{nasatlxweb, author={{National Aeronautics and Space Administration}}, title={{NASA Task Load Index (TLX)}}, year={2026}, publisher={NASA, Human Systems Integration Division}, url={https://www.nasa.gov/human-systems-integration-division/nasa-task-load-index-tlx/}}