Co trzeba ustalić przed zebraniem danych
Większość problemów z modelem pomiaru wychodzi dopiero przy analizie: konstrukt formatywny, którego nie da się oszacować, skala z trzema pozycjami, której dopasowania nie można sprawdzić, albo indeks bez żadnej miary, z którą można by go porównać. Wtedy jest już za późno. Danych nie da się uzupełnić o pytanie, którego nie zadano. Pomiar latentny projektuje się więc razem z kwestionariuszem, a nie po nim.
Ten wpis dotyczy etapu planowania. Jak rozstrzygnąć, czy konstrukt jest refleksyjny, czy formatywny, opisuje poradnik model refleksyjny czy formatywny. Pełny cykl budowy nowej skali, od mapy konstruktu po replikację, omawia wpis jak zbudować i zwalidować skalę psychometryczną. Tutaj zbieramy decyzje, które zapadają przed pierwszą odpowiedzią, i pokazujemy, co każda z nich oznacza dla treści ankiety.
| Decyzja przed badaniem | Co się stanie, jeśli jej zabraknie |
|---|---|
| Definicja konstruktu i jego granice | Pozycje mierzą coś szerszego lub węższego niż teoria; nie wiadomo, które dowody trafności zbierać. |
| Kierunek pomiaru (refleksyjny lub formatywny) | Model pomiaru jest błędnie określony, a oszacowania ścieżek mogą być obciążone (Jarvis i in., 2003). |
| Liczba i treść wskaźników refleksyjnych | Przy trzech pozycjach model jest tylko dokładnie zidentyfikowany; po usunięciu jednej słabej pozycji czynnik przestaje być identyfikowalny. |
| Pełna lista wskaźników formatywnych | Pominięty aspekt treści zawęża konstrukt, a w danych nie ma niczego, co by go zastąpiło. |
| Pozycja globalna i skutki konstruktu formatywnego | Brak analizy redundancji w PLS-SEM; w CB-SEM model jest niezidentyfikowany. |
| Pilotaż i liczebność próby | Pozycje niezrozumiałe lub bez zmienności wychodzą na jaw dopiero w badaniu głównym. |
Kolejne sekcje przechodzą przez te decyzje po kolei. Na końcu znajdziesz tabelę „decyzja → co dodać do kwestionariusza”, listę kontrolną i symulację w R, która pokazuje, co się dzieje z modelem, gdy pozycji pomocniczych zabraknie. Szersze tło metod SEM zbiera przewodnik po modelowaniu równań strukturalnych.
Krok 1. Definicja konstruktu i domena treści
MacKenzie i in. (2011) wskazują trzy słabości typowych procedur budowy miar: brak wskazówek, jak napisać definicję pojęciową konstruktu, błędne określanie modelu pomiaru i zbyt skromne dowody trafności. Pierwsza słabość pociąga za sobą dwie pozostałe. Kto nie wie dokładnie, co mierzy, nie rozstrzygnie, w którą stronę biegną strzałki, ani nie wybierze właściwych kryteriów trafności.
Definicja robocza powinna odpowiadać na kilka pytań:
- Czego dotyczy konstrukt? Osoby, zespołu, organizacji, gospodarstwa domowego? To samo słowo może opisywać różne poziomy.
- Jaką właściwość opisuje? Odczucie, zachowanie, zasób, warunki zewnętrzne? Od tego zależy, kto może udzielić odpowiedzi.
- Z jakich aspektów się składa i czy są one przejawami jednej właściwości, czy jej składnikami?
- Czego nie obejmuje? Wypisz pojęcia sąsiednie, od których konstrukt trzeba odróżnić.
- Jak jest stabilny w czasie? Stan wymaga innej ramy czasowej w pozycjach niż cecha.
Zapisana definicja jest punktem odniesienia przy ocenie ekspertów (zob. trafność treściowa i CVI) i przy każdej późniejszej decyzji o usunięciu pozycji. Szerzej o przejściu od pojęcia do pomiaru piszemy w haśle operacjonalizacja.
Krok 2. Kierunek pomiaru: tylko decyzja, nie dane
Kiedy definicja jest gotowa, ustal kierunek związku między konstruktem a wskaźnikami. Jarvis i in. (2003) podają pojęciowe kryteria tego wyboru, a w symulacji pokazują, że błędna specyfikacja obciąża oszacowania związków między konstruktami. Kryteria i przykłady omawiamy szczegółowo w osobnym poradniku. Dla projektu ankiety ważne są trzy konsekwencje:
- w modelu refleksyjnym pozycje są wymienne, a wysoka spójność wewnętrzna jest oczekiwana;
- w modelu formatywnym klasyczne reguły budowy skal, m.in. wymóg spójności wewnętrznej, nie obowiązują (Bollen i Lennox, 1991);
- w modelu formatywnym trzeba jeszcze rozstrzygnąć, czy konstrukt ma zakłócenie (wskaźniki przyczynowe), czy jest kompozytem, bo mylenie tych dwóch przypadków jest najczęstszym źródłem nieporozumień (Bollen i Diamantopoulos, 2017).
Decyzję zapisz w planie badania, zanim zobaczysz dane, razem z uzasadnieniem. Jeśli konstrukt ma kilka wymiarów, ta sama decyzja zapada na dwóch poziomach. Opisuje to wpis o konstruktach wyższego rzędu.
Przykład: obciążenie pracą i status socjoekonomiczny
Przez cały wpis używamy jednego badania (dane symulowane): 400 pracowników, dwa konstrukty. Obciążenie pracą definiujemy jako odczuwaną nadmierną ilość pracy i presję czasu. To jedno doświadczenie, które ujawnia się w podobnych ocenach, więc pomiar jest refleksyjny. Status socjoekonomiczny (SES) definiujemy jako pozycję gospodarstwa domowego wyznaczoną przez wykształcenie, dochód, prestiż zawodu i warunki mieszkaniowe. Wzrost dochodu podnosi status, a nie odwrotnie, więc pomiar jest formatywny.
| Etap | Obciążenie pracą (refleksyjny) | Status socjoekonomiczny (formatywny) |
|---|---|---|
| Definicja | odczuwana nadmierna ilość pracy i presja czasu w ostatnim miesiącu | pozycja gospodarstwa domowego wyznaczona przez cztery zasoby |
| Test usunięcia wskaźnika | po usunięciu jednej pozycji konstrukt się nie zmienia | bez warunków mieszkaniowych to już inny, węższy konstrukt |
| Wskaźniki | 4 pozycje 1–5, np. „Mam więcej zadań, niż mogę wykonać w czasie pracy”, „Pracuję pod presją czasu” | lata nauki, decyl dochodu, prestiż zawodu (10–90), indeks warunków mieszkaniowych (0–10) |
| Oczekiwane korelacje | umiarkowane i podobne | dowolne; w danych od .18 do .45 |
| Co dodać do ankiety | zapasowe pozycje do pilotażu | dwie pozycje globalne: drabina pozycji 1–10 i ocena sytuacji materialnej 1–7 |
| Główna walidacja | CFA, ładunki, rzetelność, trafność różnicowa | analiza redundancji lub MIMIC, VIF, wagi |
Ta sama nazwa nie przesądza jednak kierunku. Gdyby „obciążenie pracą” zdefiniować jako listę wymagań (liczba godzin, dyżury, liczba podopiecznych), byłby to indeks formatywny. Dlatego definicja z kroku 1 musi poprzedzać wybór pozycji.
Krok 3. Wskaźniki refleksyjne: wymienne, ale nie identyczne
Pozycje refleksyjne są przejawami tego samego konstruktu, więc powinny być wymienne. To nie znaczy, że mają być parafrazami jednego zdania. Clark i Watson (1995) przypominają, że celem doboru pozycji jest jednowymiarowość, a nie sama spójność wewnętrzna: korelacje między pozycjami powinny być umiarkowane. Pozycje niemal identyczne podnoszą alfę, ale zawężają treść i mogą tworzyć skorelowane błędy.
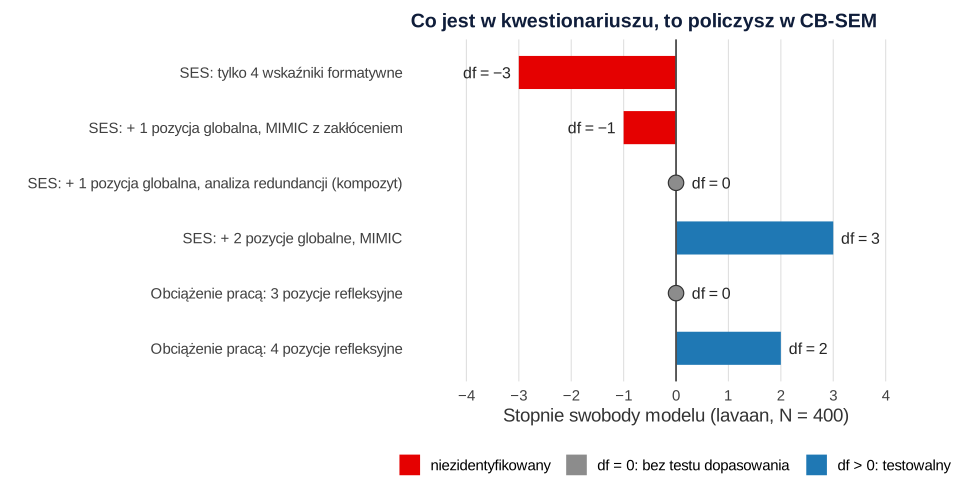
Ile pozycji? Jednoczynnikowy model z trzema pozycjami ma tyle samo parametrów, co informacji w danych. W przykładzie CFA obciążenia pracą z trzema pozycjami miała df = 0 i „idealne” dopasowanie, którego nie można było przetestować. Z czterema pozycjami df = 2, χ²(2) = 4.80, p = .091, CFI = .993, RMSEA = .059, SRMR = .018, a ładunki standaryzowane wynosiły od .66 do .72. Marsh i in. (1998) pokazali w 35 000 symulowanych rozwiązań, że więcej wskaźników na czynnik daje więcej poprawnych rozwiązań, dokładniejsze oszacowania i wyższą rzetelność, a duża liczba wskaźników częściowo kompensuje małą próbę. Stąd praktyczna reguła: w badaniu głównym co najmniej 4 pozycje na czynnik, w pilotażu zapas, bo część pozycji odpadnie.
Nie planuj z góry łączenia pozycji w pakiety, żeby poprawić dopasowanie. W tej samej symulacji rozwiązania z 12 pojedynczymi pozycjami działały nieco lepiej niż te same dane połączone w parcele (Marsh i in., 1998). Kiedy parcelacja pozycji ma sens, a kiedy ukrywa problemy, wyjaśnia hasło w słowniku. Jeśli pozycje mają 4–5 kategorii odpowiedzi, zaplanuj od razu estymację dla danych porządkowych (zob. kategorialna CFA i WLSMV).
Krok 4. Wskaźniki formatywne: pełna treść, brak wymienności
W indeksie formatywnym logika doboru jest odwrotna. Wskaźniki nie są wymienne, więc każdy aspekt z definicji musi mieć swój wskaźnik. Diamantopoulos i Winklhofer (2001) opisują budowę indeksu jako osobną drogę, różną od tworzenia skali: zaczyna się od określenia treści i kompletnego zestawu wskaźników, a nie od puli wymiennych pozycji. Brakującego składnika nie zastąpi żaden inny, bo pozostałe mierzą co innego.
Druga sprawa to współliniowość. Wagi wskaźników formatywnych są współczynnikami regresji, więc silnie skorelowane wskaźniki dają niestabilne wagi. Cenfetelli i Bassellier (2009) omawiają współliniowość, liczbę wskaźników, wagi o przeciwnych znakach oraz różnicę między bezwzględnym a względnym wkładem wskaźnika. Hair i in. (2021) traktują VIF równy 5 lub wyższy jako problem, ale zaznaczają, że kłopoty mogą się pojawić już przy wartościach około 3. W przykładzie VIF wynosiły od 1.11 do 1.39. Na etapie projektu oznacza to dwie rzeczy:
- nie wpisuj dwóch wskaźników tego samego aspektu (np. dochodu osobistego i dochodu gospodarstwa) – podwajasz treść i zwiększasz współliniowość;
- więcej wskaźników to nie zawsze lepiej: liczbę wskaźników Cenfetelli i Bassellier (2009) wymieniają wśród kwestii, które trzeba uwzględnić przy interpretacji wag, bo przy wielu składnikach wkład każdego z osobna jest zwykle mniejszy.
Po zebraniu danych nie usuwaj wskaźnika formatywnego tylko dlatego, że jego waga jest nieistotna. Usunięcie zmienia definicję konstruktu. Decyzję o wskaźnikach podejmuj na podstawie treści, a nie p. Jak raportować wagi w PLS-SEM, opisuje hasło waga zewnętrzna.
Krok 5. Co dodać do kwestionariusza
Konstrukt formatywny potrzebuje w ankiecie czegoś więcej niż własne wskaźniki. Powody są dwa: identyfikacja i walidacja.
Pozycja globalna do analizy redundancji
W PLS-SEM trafność zbieżną konstruktu formatywnego sprawdza się analizą redundancji: konstrukt ma silnie korelować z alternatywną miarą tego samego pojęcia. Hair i in. (2021) piszą wprost, że trzeba to zaplanować na etapie projektu, dodając alternatywną miarę do kwestionariusza. Wymagają ścieżki .708 lub wyższej, czyli wyjaśnienia co najmniej 50% wariancji tej miary. Cheah i in. (2018) pokazali, że zwykle wystarcza jedna pozycja globalna, która oddaje istotę konstruktu. Dla SES może to być: „Ogólnie biorąc, gdzie na drabinie od 1 do 10 umieściłbyś pozycję materialną i społeczną swojego gospodarstwa domowego?”.
Pozycja globalna musi pytać o ten sam konstrukt, a nie o jego skutek. Dla SES pozycja o zadowoleniu z życia nie jest miarą alternatywną, tylko zmienną zależną z innej części modelu.
Dwie zmienne refleksyjne do modelu MIMIC
W CB-SEM konstrukt formatywny z zakłóceniem nie jest zidentyfikowany samodzielnie. MacCallum i Browne (1993) pokazali, że wskaźniki przyczynowe często powodują problemy z identyfikacją. Bollen i Davis (2009) podają warunek konieczny: co najmniej dwie ścieżki wychodzące z konstruktu do innych zmiennych. Dwie pozycje globalne albo pozycja globalna i krótka skala refleksyjna tworzą razem model MIMIC, opisany w haśle o formatywnej zmiennej latentnej. Jedna pozycja globalna nie wystarczy, bo nie da się wtedy oddzielić zakłócenia konstruktu od błędu pomiaru tej pozycji.
| Decyzja | Co dodać do kwestionariusza | Po co |
|---|---|---|
| Konstrukt refleksyjny | co najmniej 4 pozycje w badaniu głównym i zapas pozycji w pilotażu | test dopasowania i zapas na usunięcie słabych pozycji |
| Konstrukt refleksyjny w modelu z innymi konstruktami | pozycje różnych konstruktów o odmiennej treści | trafność różnicowa (HTMT) |
| Konstrukt formatywny, PLS-SEM | 1 pozycja globalna tego samego konstruktu | analiza redundancji (ścieżka ≥ .708) |
| Konstrukt formatywny, CB-SEM | 2 pozycje globalne albo pozycja globalna i skala refleksyjna | identyfikacja i test modelu MIMIC |
| Nie wiesz jeszcze, którą metodą liczyć | 2 pozycje globalne | spełniasz warunki obu podejść |
| Wskaźniki formatywne z danych wrażliwych (np. dochód) | kategorie zamiast kwoty, opcja „wolę nie odpowiadać” | mniej braków w kluczowym składniku |
| Planowana trafność teoretyczna | zmienne z sieci nomologicznej, wpisane do hipotez | dowód, że konstrukt zachowuje się zgodnie z teorią |
Symulacja: co się dzieje, gdy w ankiecie zabraknie pozycji globalnych
Dane wygenerowaliśmy tak, żeby cztery wskaźniki wyjaśniały około 80% wariancji SES, a pozostałe 20% stanowiło zakłócenie. Te same dane analizujemy w kolejnych wariantach kwestionariusza (kod w sekcji Przykład w R).
- Tylko cztery wskaźniki formatywne. Model ma df = −3, a lavaan nie potrafi policzyć błędów standardowych. Z samych korelacji wskaźników nie da się ustalić, jak ważą się one w konstrukcie, bo nie ma niczego, co konstrukt miałby wyjaśniać.
- Jedna pozycja globalna jako jedyny skutek SES z zakłóceniem. Model ma df = −1, a program zgłasza ujemną wariancję zmiennej latentnej. Zakłócenie SES i błąd pozycji globalnej zlewają się w jedną wariancję.
- Jedna pozycja globalna, analiza redundancji. Gdy SES potraktować jako kompozyt (bez zakłócenia), model jest zidentyfikowany, choć ma df = 0. Ścieżka kompozyt → pozycja globalna wyniosła .778, 95% CI [.745, .810], czyli powyżej progu .708. W seminr wynik był identyczny: .778, bootstrapowy 95% CI [.742, .814].
- Dwie pozycje globalne, model MIMIC. Model jest zidentyfikowany i testowalny: χ²(3) = 3.16, p = .367, CFI = 1.000, TLI = .999, RMSEA = .012, SRMR = .009. Ładunki pozycji globalnych wyniosły .88 i .78, a wskaźniki wyjaśniały 78% wariancji SES (standaryzowana wariancja zakłócenia .22).
Pozycja globalna pozwala też wykryć niepełną listę wskaźników, choć tylko częściowo. Gdy z kwestionariusza usunęliśmy warunki mieszkaniowe, współczynnik redundancji spadł z .778 do .702, poniżej progu. W modelu MIMIC odsetek wyjaśnionej wariancji SES spadł z .78 do .65. Czy taki spadek zawsze będzie widoczny? Powtórzyliśmy symulację 1000 razy dla dwóch liczebności.
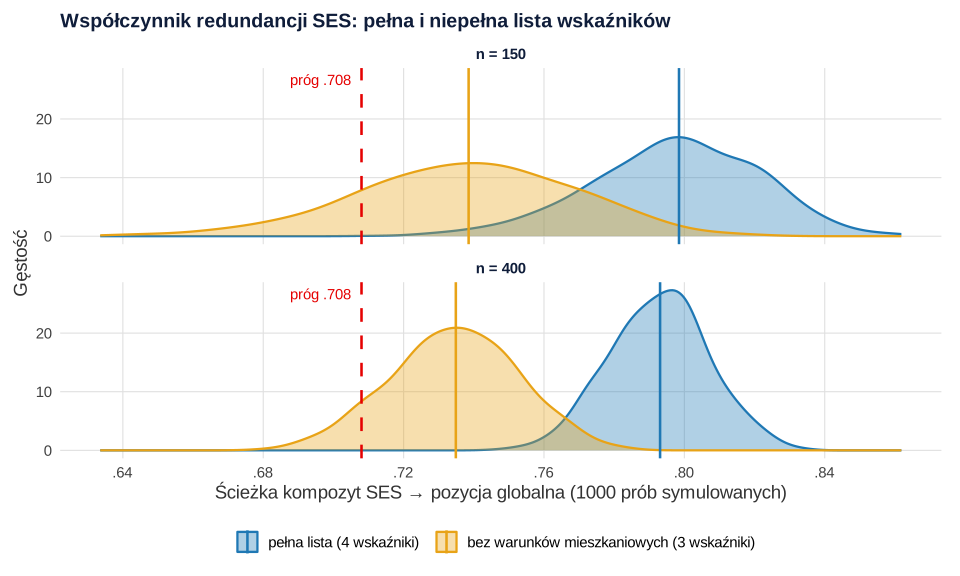
Przy pełnej liście żadna próba nie spadła poniżej .708 (mediany .798 dla n = 150 i .793 dla n = 400). Przy liście bez warunków mieszkaniowych mediany wyniosły .739 i .735, a poniżej progu znalazło się 16.0% prób dla n = 150 i 8.4% dla n = 400. Wniosek dla projektu: analiza redundancji wymaga pozycji globalnej, ale nie zastąpi starannego określenia treści. Wskaźnik pominięty w ankiecie najczęściej „przechodzi” próg. Współczynnik redundancji ogranicza ponadto rzetelność samej pozycji globalnej, bo nie może być wyższy niż jej korelacja z konstruktem.
Krok 6. Pilotaż i liczebność próby
Pilotaż sprawdza, czy respondenci rozumieją pozycje tak, jak zakłada definicja. Dla pozycji refleksyjnych najwięcej mówią wywiady poznawcze (zob. wywiad poznawczy w pilotażu). Dla wskaźników formatywnych sprawdź coś innego: czy każdy wskaźnik ma zmienność w populacji, ile jest braków przy pytaniach wrażliwych i czy pozycja globalna jest rozumiana jako ocena całości, a nie jednego składnika. Pozycja globalna o SES, którą respondenci odczytują jako pytanie o dochód, będzie zawyżać wagę dochodu.
Liczebność planuj dla całego modelu, a nie z reguły „10 osób na parametr”. Wolf i in. (2013) w symulacjach typowych modeli SEM uzyskali wymagane liczebności od 30 do 460 osób, zależnie od liczby wskaźników i czynników, wielkości ładunków i odsetka braków. Wynik ten pokazuje ograniczenia prostych reguł. Liczebność zależy od konkretnego modelu, a większa liczba dobrych wskaźników na czynnik częściowo kompensuje mniejszą próbę (Marsh i in., 1998). Metody planowania próby, w tym symulację Monte Carlo, opisuje wpis dobór liczebności próby.
Krok 7. Plan walidacji osobno dla CB-SEM i PLS-SEM
Plan walidacji zależy od metody estymacji, a tę również warto wybrać przed badaniem (zob. PLS-SEM czy CB-SEM). Wpisz do planu analizy, które kryteria zastosujesz do każdego konstruktu.
| Konstrukt | CB-SEM | PLS-SEM |
|---|---|---|
| Refleksyjny | CFA z testem dopasowania; ładunki; omega lub rzetelność złożona; AVE i HTMT; inwariancja między grupami | ładunki zewnętrzne; rzetelność (ρA, ρC); AVE; HTMT |
| Formatywny | MIMIC z dwoma skutkami; test dopasowania; wagi i wariancja zakłócenia; VIF | analiza redundancji (ścieżka ≥ .708); VIF; wagi z przedziałami bootstrap (Hair i in., 2021) |
| Oba | zaplanowane z góry relacje w sieci nomologicznej i hipotezy trafności | |
Kryteria trafności zbieżnej i różnicowej dla konstruktów refleksyjnych w CB-SEM omawia wpis trafność zbieżna i różnicowa: AVE i HTMT. Pełne przykłady estymacji znajdziesz w poradnikach CB-SEM w R i PLS-SEM w R. Jeśli konstrukt ma być kompozytem, rozważ też konfirmacyjną analizę kompozytów.
Lista kontrolna przed wysłaniem kwestionariusza
- Każdy konstrukt ma pisemną definicję: czego dotyczy, jaką właściwość opisuje, z jakich aspektów się składa i czego nie obejmuje.
- Dla każdego konstruktu zapisano kierunek pomiaru z uzasadnieniem, a dla formatywnych także wariant: wskaźniki przyczynowe lub kompozyt.
- Konstrukty refleksyjne mają co najmniej 4 pozycje w badaniu głównym; pozycje są wymienne, ale nie są parafrazami.
- Konstrukty formatywne mają wskaźnik dla każdego aspektu definicji i nie mają dwóch wskaźników tej samej treści.
- Dla każdego konstruktu formatywnego jest pozycja globalna, a przy CB-SEM druga zmienna refleksyjna.
- Eksperci ocenili pokrycie treści, a wywiady poznawcze sprawdziły rozumienie pozycji, także globalnych.
- W pilotażu sprawdzono zmienność wskaźników, braki odpowiedzi i korelacje między wskaźnikami formatywnymi (VIF).
- Liczebność zaplanowano dla całego modelu, z uwzględnieniem braków danych.
- Plan walidacji (CB-SEM lub PLS-SEM) i hipotezy trafności zapisano przed zebraniem danych, np. w planie analizy lub prerejestracji.
Opis pomiaru w części „Metoda” może wyglądać tak:
Jeśli chcesz, żeby ktoś z zewnątrz sprawdził definicje konstruktów i plan walidacji przed badaniem, możemy to zrobić w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Trzy przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane (możesz je pobrać jako plik CSV: 400 wierszy, 10 kolumn) i szacuje kolejne warianty modelu w lavaan. Drugi powtarza analizę redundancji w seminr. Trzeci to symulacja Monte Carlo do rysunku 2.
1. Identyfikacja i walidacja w lavaan
R
# Dane symulowane: 400 pracowników. Status socjoekonomiczny (SES) – konstrukt formatywny z czterema wskaźnikami
# (wykształcenie, dochód, prestiż zawodu, warunki mieszkaniowe), dwie pozycje globalne SES oraz
# refleksyjna skala obciążenia pracą (4 pozycje, 1–5)
library(lavaan)
generuj <- function(n, seed) {
  set.seed(seed)
  S <- matrix(c(1, .45, .40, .30,  .45, 1, .40, .35,  .40, .40, 1, .25,  .30, .35, .25, 1), 4)
  X <- MASS::mvrnorm(n, rep(0, 4), S)
  ses <- drop(X %*% c(.30, .30, .25, .35))
  ses <- ses + rnorm(n, 0, sqrt(var(ses) * .20 / .80))     # wskaźniki wyjaśniają ok. 80% wariancji SES
  ses <- as.numeric(scale(ses))
  obc <- rnorm(n)                                            # obciążenie pracą (czynnik refleksyjny)
  ogr <- function(x, a, b) pmin(pmax(round(x), a), b)
  data.frame(
    wyksztalcenie = ogr(13 + 2.8 * X[, 1], 8, 22),            # lata nauki
    dochod        = as.integer(cut(X[, 2], quantile(X[, 2], 0:10 / 10), include.lowest = TRUE)),  # decyl dochodu
    prestiz       = ogr(45 + 15 * X[, 3], 10, 90),            # prestiż zawodu, 10–90
    mieszkanie    = ogr(5 + 2 * X[, 4], 0, 10),               # indeks warunków mieszkaniowych, 0–10
    ses_global1   = ogr(5.5 + 2 * (.90 * ses + rnorm(n, 0, sqrt(1 - .90^2))), 1, 10),  # drabina 1–10
    ses_global2   = ogr(4 + 1.3 * (.80 * ses + rnorm(n, 0, .60)), 1, 7),                # ocena sytuacji 1–7
    ob1 = ogr(3 + 1.1 * (.75 * obc + rnorm(n, 0, sqrt(1 - .75^2))), 1, 5),
    ob2 = ogr(3 + 1.1 * (.80 * obc + rnorm(n, 0, .60)), 1, 5),
    ob3 = ogr(3 + 1.1 * (.70 * obc + rnorm(n, 0, sqrt(1 - .70^2))), 1, 5),
    ob4 = ogr(3 + 1.1 * (.72 * obc + rnorm(n, 0, sqrt(1 - .72^2))), 1, 5))
}
dane <- generuj(400, 1701)
write.csv(dane, "pomiar-latentny-dane.csv", row.names = FALSE)
round(cor(dane[, 1:6]), 2)
fm <- c("df", "chisq", "pvalue", "cfi", "tli", "rmsea", "srmr")

# 1. Kwestionariusz bez niczego poza wskaźnikami formatywnymi: model nie jest zidentyfikowany
m_a <- sem("SES <~ wyksztalcenie + dochod + prestiz + mieszkanie", data = dane)
fitMeasures(m_a, "df")

# 2. Jedna pozycja globalna jako jedyny skutek SES z zakłóceniem (MIMIC): df = −1
m_b <- sem("SES =~ 1*ses_global1
           SES ~ wyksztalcenie + dochod + prestiz + mieszkanie
           ses_global1 ~~ ses_global1", data = dane)
fitMeasures(m_b, "df")

# 3. Analiza redundancji: kompozyt (bez zakłócenia) przewiduje pozycję globalną
m_red <- sem("SES <~ wyksztalcenie + dochod + prestiz + mieszkanie
             ses_global1 ~ SES", data = dane)
fitMeasures(m_red, "df")
subset(standardizedSolution(m_red), op %in% c("<~", "~"))[, c("lhs", "op", "rhs", "est.std", "ci.lower", "ci.upper")]
# to samo co pierwiastek z R² regresji pozycji globalnej na wskaźniki
pelny <- lm(ses_global1 ~ wyksztalcenie + dochod + prestiz + mieszkanie, data = dane)
niepelny <- lm(ses_global1 ~ wyksztalcenie + dochod + prestiz, data = dane)
round(c(redundancja_pelny = sqrt(summary(pelny)$r.squared), redundancja_bez_mieszkania = sqrt(summary(niepelny)$r.squared)), 3)

# VIF wskaźników formatywnych (każdy wskaźnik regresowany na pozostałe)
wsk <- c("wyksztalcenie", "dochod", "prestiz", "mieszkanie")
round(sapply(wsk, function(v) 1 / (1 - summary(lm(reformulate(setdiff(wsk, v), v), data = dane))$r.squared)), 2)

# 4. Dwie pozycje globalne jako refleksyjne skutki SES: model MIMIC jest zidentyfikowany i testowalny
mimic <- "SES =~ 1*ses_global1 + ses_global2
          SES ~ wyksztalcenie + dochod + prestiz + mieszkanie"
m_c <- sem(mimic, data = dane)
round(fitMeasures(m_c, fm), 3)
subset(standardizedSolution(m_c), op %in% c("=~", "~") | (lhs == "SES" & op == "~~"))[, c("lhs", "op", "rhs", "est.std", "ci.lower", "ci.upper", "pvalue")]
# ten sam model z niepełną listą wskaźników (bez warunków mieszkaniowych)
m_c2 <- sem("SES =~ 1*ses_global1 + ses_global2
            SES ~ wyksztalcenie + dochod + prestiz", data = dane)
round(c(R2_SES_pelny = unname(lavInspect(m_c, "r2")["SES"]), R2_SES_bez_mieszkania = unname(lavInspect(m_c2, "r2")["SES"])), 3)

# 5. Refleksyjne obciążenie pracą: 3 pozycje (df = 0) a 4 pozycje (df = 2)
cfa3 <- cfa("OBC =~ ob1 + ob2 + ob3", data = dane)
cfa4 <- cfa("OBC =~ ob1 + ob2 + ob3 + ob4", data = dane)
round(rbind(trzy_pozycje = fitMeasures(cfa3, fm), cztery_pozycje = fitMeasures(cfa4, fm)), 3)
round(subset(standardizedSolution(cfa4), op == "=~")$est.std, 2)
Wynik w R
This is lavaan 0.7-2
lavaan is FREE software! Please report any bugs.
              wyksztalcenie dochod prestiz mieszkanie ses_global1 ses_global2
wyksztalcenie          1.00   0.45    0.39       0.18        0.56        0.52
dochod                 0.45   1.00    0.28       0.27        0.51        0.42
prestiz                0.39   0.28    1.00       0.24        0.54        0.51
mieszkanie             0.18   0.27    0.24       1.00        0.53        0.45
ses_global1            0.56   0.51    0.54       0.53        1.00        0.69
ses_global2            0.52   0.42    0.51       0.45        0.69        1.00
Warning: lavaan->lav_model_vcov():
   Could not compute standard errors! The information matrix could not be
   inverted. This may be a symptom that the model is not identified.
df
-3
Warning: lavaan->lav_model_vcov():
   Could not compute standard errors! The information matrix could not be
   inverted. This may be a symptom that the model is not identified.
Warning: lavaan->lav_object_post_check():
   some estimated lv variances are negative
df
-1
df
 0
          lhs op           rhs est.std ci.lower ci.upper
1         SES <~ wyksztalcenie   0.377    0.288    0.465
2         SES <~        dochod   0.255    0.166    0.345
3         SES <~       prestiz   0.367    0.285    0.450
4         SES <~    mieszkanie   0.455    0.379    0.530
5 ses_global1  ~           SES   0.778    0.745    0.810
         redundancja_pelny redundancja_bez_mieszkania
                     0.778                      0.702
wyksztalcenie        dochod       prestiz    mieszkanie
         1.39          1.33          1.23          1.11
    df  chisq pvalue    cfi    tli  rmsea   srmr
 3.000  3.164  0.367  1.000  0.999  0.012  0.009
  lhs op           rhs est.std ci.lower ci.upper pvalue
1 SES =~   ses_global1   0.881    0.846    0.915      0
2 SES =~   ses_global2   0.784    0.742    0.827      0
3 SES  ~ wyksztalcenie   0.350    0.278    0.421      0
4 SES  ~        dochod   0.202    0.130    0.274      0
5 SES  ~       prestiz   0.337    0.270    0.404      0
6 SES  ~    mieszkanie   0.392    0.330    0.455      0
9 SES ~~           SES   0.221    0.162    0.279      0
         R2_SES_pelny R2_SES_bez_mieszkania
                0.779                 0.645
               df chisq pvalue   cfi  tli rmsea  srmr
trzy_pozycje    0 0.000     NA 1.000 1.00 0.000 0.000
cztery_pozycje  2 4.799  0.091 0.993 0.98 0.059 0.018
[1] 0.66 0.72 0.69 0.69
2. Analiza redundancji w PLS-SEM (seminr)
R
# PLS-SEM (seminr): analiza redundancji SES na tych samych danych co w przepisie 1
library(seminr)
redundancja <- function(wskazniki) {
  mm <- constructs(
    composite("SES_F", wskazniki, weights = mode_B),
    composite("SES_G", single_item("ses_global1")))
  sm <- relationships(paths(from = "SES_F", to = "SES_G"))
  estimate_pls(data = dane, measurement_model = mm, structural_model = sm)
}
pls_pelny <- redundancja(c("wyksztalcenie", "dochod", "prestiz", "mieszkanie"))
pls_bez <- redundancja(c("wyksztalcenie", "dochod", "prestiz"))
s_pelny <- summary(pls_pelny)
s_pelny$paths
summary(pls_bez)$paths
round(s_pelny$weights, 3)
s_pelny$validity$vif_items$SES_F
# przedział bootstrap dla ścieżki redundancji
boot <- bootstrap_model(pls_pelny, nboot = 1000, cores = 1, seed = 1702)
summary(boot)$bootstrapped_paths
Wynik w R
Generating the seminr model
All 400 observations are valid.
Generating the seminr model
All 400 observations are valid.
       SES_G
R^2    0.605
AdjR^2 0.604
SES_F  0.778
       SES_G
R^2    0.493
AdjR^2 0.491
SES_F  0.702
              SES_F SES_G
wyksztalcenie 0.377 0.000
dochod        0.255 0.000
prestiz       0.367 0.000
mieszkanie    0.455 0.000
ses_global1   0.000 1.000
wyksztalcenie        dochod       prestiz    mieszkanie
     1.391331      1.334362      1.229500      1.113418
Bootstrapping model using seminr...
SEMinR Model successfully bootstrapped
                 Original Est. Bootstrap Mean Bootstrap SD T Stat. 2.5% CI
SES_F  ->  SES_G         0.778          0.780        0.018  43.132   0.742
                 97.5% CI Bootstrap P Val
SES_F  ->  SES_G    0.814           0.000
3. Symulacja: czy analiza redundancji wykryje brakujący wskaźnik?
R
# Monte Carlo: rozkład współczynnika redundancji (kompozyt SES → pozycja globalna) w 1000 powtórzeniach
# dla n = 150 i n = 400, przy pełnej i niepełnej liście wskaźników (funkcja generuj() z przepisu 1)
red <- function(d, wsk) sqrt(summary(lm(reformulate(wsk, "ses_global1"), data = d))$r.squared)
wsk_pelne <- c("wyksztalcenie", "dochod", "prestiz", "mieszkanie")
siatka <- expand.grid(powt = 1:1000, n = c(150, 400))
mc <- do.call(rbind, lapply(seq_len(nrow(siatka)), function(i) {
  d <- generuj(siatka$n[i], 20000 + i)
  data.frame(n = siatka$n[i], pelna = red(d, wsk_pelne), bez_mieszkania = red(d, wsk_pelne[1:3]))
}))
mc_dlugi <- reshape(mc, direction = "long", varying = c("pelna", "bez_mieszkania"), v.names = "redundancja",
                    timevar = "lista", times = c("pelna", "bez_mieszkania"))
wynik <- aggregate(redundancja ~ lista + n, data = mc_dlugi, FUN = function(x)
  round(c(mediana = median(x), q05 = unname(quantile(x, .05)), q95 = unname(quantile(x, .95)), ponizej_708 = mean(x < .708)), 3))
print(do.call(data.frame, wynik), row.names = FALSE)
Wynik w R
          lista   n redundancja.mediana redundancja.q05 redundancja.q95
 bez_mieszkania 150               0.739           0.684           0.786
          pelna 150               0.798           0.757           0.833
 bez_mieszkania 400               0.735           0.704           0.764
          pelna 400               0.793           0.770           0.816
 redundancja.ponizej_708
                   0.160
                   0.000
                   0.084
                   0.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- seminr (wersja 2.5.0): Ray, S., Danks, N., & Calero Valdez, A. (2026). seminr: Building and estimating structural equation models (R package version 2.5.0) [Computer software]. https://doi.org/10.32614/CRAN.package.seminr
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Konstrukt formatywny bez pozycji globalnej. W PLS-SEM nie ma analizy redundancji, a w CB-SEM model nie jest zidentyfikowany. Po badaniu nie da się tego naprawić.
- Jedna pozycja globalna jako jedyny skutek w CB-SEM. Zakłócenie konstruktu i błąd pozycji zlewają się w jedną wariancję; potrzebne są dwie ścieżki wychodzące.
- Pozycja „globalna”, która mierzy skutek konstruktu. Zadowolenie z życia nie jest alternatywną miarą SES.
- Skala refleksyjna z trzema pozycjami w badaniu głównym. Model nie ma stopni swobody, a usunięcie jednej pozycji uniemożliwia oszacowanie czynnika.
- Pozycje refleksyjne pisane jak parafrazy. Wysoka alfa nie rekompensuje wąskiej treści.
- Usuwanie wskaźników formatywnych po wadze lub p. Każde usunięcie zmienia definicję konstruktu.
- Traktowanie progu .708 jako dowodu kompletności. W symulacji lista bez jednego wskaźnika przechodziła próg w większości prób.
- Kierunek pomiaru wybrany po obejrzeniu danych. Decyzja ma wynikać z definicji i powinna być zapisana w planie badania.
Najczęstsze pytania
Co dodać do ankiety, gdy jeden z konstruktów jest formatywny?
Dodaj co najmniej jedną pozycję globalną, która ogólnie ocenia ten sam konstrukt, np. „Ogólnie biorąc, jak oceniasz…”. W PLS-SEM posłuży do analizy redundancji (Hair i in., 2021). W CB-SEM potrzebujesz dwóch zmiennych, na które konstrukt wpływa, np. dwóch pozycji globalnych albo pozycji globalnej i krótkiej skali refleksyjnej. Bez nich model MIMIC nie jest zidentyfikowany.
Czy pozycja globalna może być jedną pozycją?
Tak. Cheah i in. (2018) pokazali, że jedna pozycja globalna, która oddaje istotę konstruktu, zwykle wystarcza do oceny trafności zbieżnej w analizie redundancji, a nie wydłuża znacząco ankiety. Ogranicza ją jednak rzetelność tej pozycji: współczynnik redundancji nie może być wyższy niż korelacja pozycji z konstruktem.
Ile wskaźników formatywnych powinien mieć konstrukt?
Tyle, ile wymaga definicja. Wskaźniki formatywne mają razem pokrywać całą treść konstruktu, bo pominięcie jednego zawęża to, co mierzysz (Diamantopoulos i Winklhofer, 2001). Liczby nie dobiera się więc pod rzetelność ani pod model. W symulacji pominięcie warunków mieszkaniowych obniżyło odsetek wyjaśnionej wariancji SES z .78 do .65.
Dlaczego skala z trzema pozycjami jest problemem w CFA?
Jednoczynnikowy model z trzema pozycjami ma zero stopni swobody, więc zawsze pasuje idealnie i jego dopasowania nie da się przetestować. Przy czterech pozycjach model ma dwa stopnie swobody. Więcej wskaźników na czynnik daje też więcej poprawnych rozwiązań i dokładniejsze oszacowania (Marsh i in., 1998), dlatego do pilotażu przygotuj zapas pozycji.
Czy projekt pomiaru zależy od tego, czy użyję CB-SEM czy PLS-SEM?
Częściowo tak. W obu podejściach potrzebujesz tej samej definicji i tych samych wskaźników. CB-SEM wymaga dodatkowo dwóch skutków konstruktu formatywnego, a PLS-SEM pozycji globalnej do analizy redundancji. Najbezpieczniej zaplanować kwestionariusz tak, żeby pozwalał na oba podejścia: dwie pozycje globalne spełniają oba warunki.
Powiązane hasła
Przeczytaj też
Model refleksyjny czy formatywny?
Kryteria decyzji Jarvis i in. (2003), symulacja skutków błędnej specyfikacji modelu pomiaru i model MIMIC w lavaan – z opisem do artykułu.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikModelowanie równań strukturalnych (SEM) – przewodnik
Osiem etapów analizy SEM: identyfikacja, pomiar, CB-SEM czy PLS-SEM, CFA i kompozyty, efekty pośrednie, inwariancja, rozszerzenia i raport.
Czytaj →Projektujesz kwestionariusz do modelu SEM z konstruktem formatywnym?
Sprawdzimy definicje konstruktów, listę wskaźników i plan walidacji, zanim zbierzesz dane, i wyjaśnimy każdą decyzję tak, żebyś mógł(a) ją samodzielnie uzasadnić przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bollen, K. A., & Davis, W. R. (2009). Two rules of identification for structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 16(3), 523–536. https://doi.org/10.1080/10705510903008261
- Bollen, K. A., & Diamantopoulos, A. (2017). In defense of causal-formative indicators: A minority report. Psychological Methods, 22(3), 581–596. https://doi.org/10.1037/met0000056 ● Otwarty dostęp: pełny tekst
- Bollen, K., & Lennox, R. (1991). Conventional wisdom on measurement: A structural equation perspective. Psychological Bulletin, 110(2), 305–314. https://doi.org/10.1037/0033-2909.110.2.305
- Cenfetelli, R. T., & Bassellier, G. (2009). Interpretation of formative measurement in information systems research. MIS Quarterly, 33(4), 689–708. https://doi.org/10.2307/20650323
- Cheah, J.-H., Sarstedt, M., Ringle, C. M., Ramayah, T., & Ting, H. (2018). Convergent validity assessment of formatively measured constructs in PLS-SEM. International Journal of Contemporary Hospitality Management, 30(11), 3192–3210. https://doi.org/10.1108/ijchm-10-2017-0649
- Clark, L. A., & Watson, D. (1995). Constructing validity: Basic issues in objective scale development. Psychological Assessment, 7(3), 309–319. https://doi.org/10.1037/1040-3590.7.3.309
- Diamantopoulos, A., & Winklhofer, H. M. (2001). Index construction with formative indicators: An alternative to scale development. Journal of Marketing Research, 38(2), 269–277. https://doi.org/10.1509/jmkr.38.2.269.18845
- Hair, J. F., Jr., Hult, G. T. M., Ringle, C. M., Sarstedt, M., Danks, N. P., & Ray, S. (2021). Partial least squares structural equation modeling (PLS-SEM) using R: A workbook. Springer. https://doi.org/10.1007/978-3-030-80519-7 ● Otwarty dostęp
- Jarvis, C. B., MacKenzie, S. B., & Podsakoff, P. M. (2003). A critical review of construct indicators and measurement model misspecification in marketing and consumer research. Journal of Consumer Research, 30(2), 199–218. https://doi.org/10.1086/376806
- MacCallum, R. C., & Browne, M. W. (1993). The use of causal indicators in covariance structure models: Some practical issues. Psychological Bulletin, 114(3), 533–541. https://doi.org/10.1037/0033-2909.114.3.533
- MacKenzie, S. B., Podsakoff, P. M., & Podsakoff, N. P. (2011). Construct measurement and validation procedures in MIS and behavioral research: Integrating new and existing techniques. MIS Quarterly, 35(2), 293–A5. https://doi.org/10.2307/23044045
- Marsh, H. W., Hau, K.-T., Balla, J. R., & Grayson, D. (1998). Is more ever too much? The number of indicators per factor in confirmatory factor analysis. Multivariate Behavioral Research, 33(2), 181–220. https://doi.org/10.1207/s15327906mbr3302_1
- Wolf, E. J., Harrington, K. M., Clark, S. L., & Miller, M. W. (2013). Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety. Educational and Psychological Measurement, 73(6), 913–934. https://doi.org/10.1177/0013164413495237 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bollen2009two, author={Bollen, Kenneth A. and Davis, Walter R.}, title={{Two rules of identification for structural equation models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2009}, volume={16}, number={3}, pages={523--536}, doi={10.1080/10705510903008261}}@article{bollen2017defense, author={Bollen, Kenneth A. and Diamantopoulos, Adamantios}, title={{In defense of causal-formative indicators: A minority report}}, journal={Psychological Methods}, year={2017}, volume={22}, number={3}, pages={581--596}, doi={10.1037/met0000056}}@article{bollen1991conventional, author={Bollen, Kenneth and Lennox, Richard}, title={{Conventional wisdom on measurement: A structural equation perspective}}, journal={Psychological Bulletin}, year={1991}, volume={110}, number={2}, pages={305--314}, doi={10.1037/0033-2909.110.2.305}}@article{cenfetelli2009interpretation, author={Cenfetelli, Ronald T. and Bassellier, Geneviève}, title={{Interpretation of formative measurement in information systems research}}, journal={MIS Quarterly}, year={2009}, volume={33}, number={4}, pages={689--708}, doi={10.2307/20650323}}@article{cheah2018convergent, author={Cheah, Jun-Hwa and Sarstedt, Marko and Ringle, Christian M. and Ramayah, T. and Ting, Hiram}, title={{Convergent validity assessment of formatively measured constructs in PLS-SEM}}, journal={International Journal of Contemporary Hospitality Management}, year={2018}, volume={30}, number={11}, pages={3192--3210}, doi={10.1108/ijchm-10-2017-0649}}@article{clark1995constructing, author={Clark, Lee Anna and Watson, David}, title={{Constructing validity: Basic issues in objective scale development}}, journal={Psychological Assessment}, year={1995}, volume={7}, number={3}, pages={309--319}, doi={10.1037/1040-3590.7.3.309}}@article{diamantopoulos2001index, author={Diamantopoulos, Adamantios and Winklhofer, Heidi M.}, title={{Index construction with formative indicators: An alternative to scale development}}, journal={Journal of Marketing Research}, year={2001}, volume={38}, number={2}, pages={269--277}, doi={10.1509/jmkr.38.2.269.18845}}@book{hair2021pls, author={Hair, Joseph F., Jr. and Hult, G. Tomas M. and Ringle, Christian M. and Sarstedt, Marko and Danks, Nicholas P. and Ray, Soumya}, title={{Partial least squares structural equation modeling (PLS-SEM) using R: A workbook}}, year={2021}, publisher={Springer}, doi={10.1007/978-3-030-80519-7}}@article{jarvis2003critical, author={Jarvis, Cheryl Burke and MacKenzie, Scott B. and Podsakoff, Philip M.}, title={{A critical review of construct indicators and measurement model misspecification in marketing and consumer research}}, journal={Journal of Consumer Research}, year={2003}, volume={30}, number={2}, pages={199--218}, doi={10.1086/376806}}@article{maccallum1993use, author={MacCallum, Robert C. and Browne, Michael W.}, title={{The use of causal indicators in covariance structure models: Some practical issues}}, journal={Psychological Bulletin}, year={1993}, volume={114}, number={3}, pages={533--541}, doi={10.1037/0033-2909.114.3.533}}@article{mackenzie2011construct, author={MacKenzie, Scott B. and Podsakoff, Philip M. and Podsakoff, Nathan P.}, title={{Construct measurement and validation procedures in MIS and behavioral research: Integrating new and existing techniques}}, journal={MIS Quarterly}, year={2011}, volume={35}, number={2}, pages={293--A5}, doi={10.2307/23044045}}@article{marsh1998more, author={Marsh, Herbert W. and Hau, Kit-Tai and Balla, John R. and Grayson, David}, title={{Is more ever too much? The number of indicators per factor in confirmatory factor analysis}}, journal={Multivariate Behavioral Research}, year={1998}, volume={33}, number={2}, pages={181--220}, doi={10.1207/s15327906mbr3302_1}}@article{wolf2013sample, author={Wolf, Erika J. and Harrington, Kelly M. and Clark, Shaunna L. and Miller, Mark W.}, title={{Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety}}, journal={Educational and Psychological Measurement}, year={2013}, volume={73}, number={6}, pages={913--934}, doi={10.1177/0013164413495237}}