Do czego służy test t w jamovi
Test t porównuje średnie. W jamovi wszystkie jego wersje są w jednym miejscu: na karcie Analyses w grupie T-Tests (The jamovi project, b.d.-b). Wybór procedury zależy od tego, co porównujesz:
| Pytanie | Procedura w jamovi | Układ danych | Opcja nieparametryczna w oknie |
|---|---|---|---|
| Czy dwie grupy osób różnią się średnią? | Independent Samples T-Test | wynik w jednej kolumnie, grupa w drugiej | Mann-Whitney U |
| Czy te same osoby zmieniły się między pomiarami? | Paired Samples T-Test | każdy pomiar w osobnej kolumnie, jedna osoba w jednym wierszu | Wilcoxon rank |
| Czy średnia różni się od wartości odniesienia? | One Sample T-Test | jedna kolumna i liczba wpisana w Test value | Wilcoxon rank |
Logikę testu opisuje poradnik test t Studenta krok po kroku, a definicje – hasła test t dla prób niezależnych, test t dla prób zależnych i test t dla jednej próby. Interfejs jamovi pokazuje wpis jamovi krok po kroku. Tutaj omawiamy każde pole okna i każdą tabelę testu t. Wersję dla SPSS opisuje wpis test t w SPSS krok po kroku.
Nazwy opcji podajemy po angielsku, jak w dokumentacji i plikach definicji analiz (The jamovi project, b.d.-b, b.d.-d), a polskie – według pliku tłumaczeń pakietu jmv. W Twojej wersji mogą się nieco różnić.
Przykład i pliki do pobrania
Liczby pochodzą z symulowanej ankiety 104 osób studiujących:
praca– praca zarobkowa: „nie pracuje” (n = 62) albo „pracuje” (n = 42);zmeczenie– zmęczenie w semestrze, średnia z pozycji skali 1–5;stres_pazistres_sty– stres (1–5) w październiku i w styczniu; cztery osoby nie wypełniły ankiety w styczniu;satysfakcja– satysfakcja ze studiów (1–5).
Pobierz plik CSV albo ten sam zbiór jako plik .sav z etykietami. jamovi otwiera oba formaty z menu ☰ → Open (The jamovi project, b.d.-b).
Przygotowanie danych w jamovi
Otwórz edytor zmiennej (dwuklik na nagłówku kolumny) i sprawdź trzy rzeczy. Szerzej opisuje to wpis przygotowanie danych i statystyki opisowe w jamovi.
- Typ zmiennej. Wynik (
zmeczenie, oba pomiary stresu,satysfakcja) ustaw jako Continuous. Zmienną grupującąpraca– jako Nominal (The jamovi project, b.d.-b). - Dokładnie dwa poziomy. Zmienna grupująca musi mieć dwa poziomy. Przy trzech poziomach analiza zatrzyma się z komunikatem, że Grouping Variable musi mieć dokładnie dwa poziomy (The jamovi project, b.d.-d). Przy trzech grupach użyj ANOVA w jamovi.
- Kolejność poziomów. Pierwszy poziom to Group 1, drugi – Group 2. Różnica średnich to „grupa 1 minus grupa 2” (The jamovi project, b.d.-d). Tu grupą 1 są niepracujący, więc różnica wychodzi ujemna.
Test dla par wymaga formatu szerokiego (danych „obok siebie”): stres_paz i stres_sty to osobne kolumny, a oba pomiary jednej osoby są w jednym wierszu (The jamovi project, b.d.-b).
Test t dla prób niezależnych: okno krok po kroku
Wybierz Analyses → T-Tests → Independent Samples T-Test (po polsku: Testy t → Test t dla prób niezależnych). Przeciągnij zmeczenie do pola Dependent Variables, a praca do pola Grouping Variable (The jamovi project, b.d.-b). Potem ustaw opcje w kolejnych częściach okna (The jamovi project, b.d.-d; Selker i in., 2025):
- Tests: zaznacz Welch's (Test Welcha). Student's jest zaznaczony domyślnie. Mann-Whitney U dodaje trzeci wiersz tabeli.
- Hypothesis: zostaw Group 1 ≠ Group 2 (test dwustronny).
- Missing values: domyślne Exclude cases analysis by analysis usuwa braki osobno dla każdej zmiennej; Exclude cases listwise – osobę z brakiem w którejkolwiek zmiennej.
- Additional Statistics: zaznacz Mean difference z Confidence interval, Effect size z Confidence interval oraz Descriptives. Opcjonalnie Descriptives plots.
- Assumption Checks (Weryfikacja założeń): Homogeneity test (test Levene’a), Normality test (Shapiro–Wilk) i Q-Q plot.
Wyniki zmieniają się przy każdym kliknięciu (The jamovi project, b.d.-b), więc zestaw opcji ustal przed analizą.
Wydruk: jak czytać tabele testu dla grup
Tabele niżej mają układ tabel jamovi z zaokrągleniem do trzech miejsc. Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabeli jak w jamovi. Pogrubiono liczby, które trafią do pracy.
| Statistic | df | p | Mean difference | SE difference | 95% Confidence Interval | Effect Size | 95% Confidence Interval | |||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Lower | Upper | Lower | Upper | |||||||||
| zmeczenie | Student's t | −2.645 | 102.000 | 0.009 | −0.356 | 0.134 | −0.623 | −0.089 | Cohen's d | −0.529 | −0.926 | −0.129 |
| Welch's t | −2.433 | 63.059 | 0.018 | −0.356 | 0.146 | −0.648 | −0.064 | Cohen's d | −0.506 | |||
| Mann-Whitney U | 935.000 | 0.015 | −0.360 | −0.650 | −0.080 | Rank biserial correlation | 0.282 | |||||
Pod tabelą jamovi wypisuje hipotezę alternatywną: średnia grupy „nie pracuje” różna od średniej grupy „pracuje”. To trzy testy na tych samych danych – do pracy przepisz jeden wiersz, wybrany przed analizą.
- Welch's t nie wymaga równych wariancji, stąd ułamkowe stopnie swobody (63.059) i większy błąd standardowy różnicy (0.146 zamiast 0.134). Wynik: t(63.06) = −2.43, p = .018. Różnica średnich wynosi −0.36 punktu, 95% CI [−0.65, −0.06].
- Mann-Whitney U to test rangowy: U = 935, p = .015. Kolumna Mean difference zawiera tu nie różnicę średnich, lecz przesunięcie Hodgesa–Lehmanna (−0.36) – w kodzie jmv to oszacowanie z funkcji
wilcox.test(The jamovi project, b.d.-d).
Test Levene’a i wybór wiersza
| Tabela | Statystyka | df | df2 | p | |
|---|---|---|---|---|---|
| Homogeneity of Variances Test (Levene's) | zmeczenie | F = 7.845 | 1 | 102 | 0.006 |
| Normality Test (Shapiro-Wilk) | zmeczenie | W = 0.989 | 0.590 |
W jmv test Levene’a jest liczony od średniej grupy, a nie od mediany: kod analizy wywołuje car::leveneTest z argumentem "mean" (The jamovi project, b.d.-d). Tu test Levene’a jest istotny, F(1, 102) = 7.84, p = .006. Mniejsza grupa ma większe SD (0.84 wobec 0.53). jamovi dodaje wtedy przypis pod wierszem Studenta.
Dokumentacja jamovi radzi przełączyć się na Welcha po istotnym teście Levene’a (The jamovi project, b.d.-c). My zalecamy: zaznacz Welch's od razu, bez testu wstępnego. Delacre i in. (2017) pokazują, że wybór testu po teście równości wariancji często zawodzi, a test Welcha lepiej kontroluje błąd I rodzaju i niewiele traci przy równych wariancjach. Zob. test Welcha.
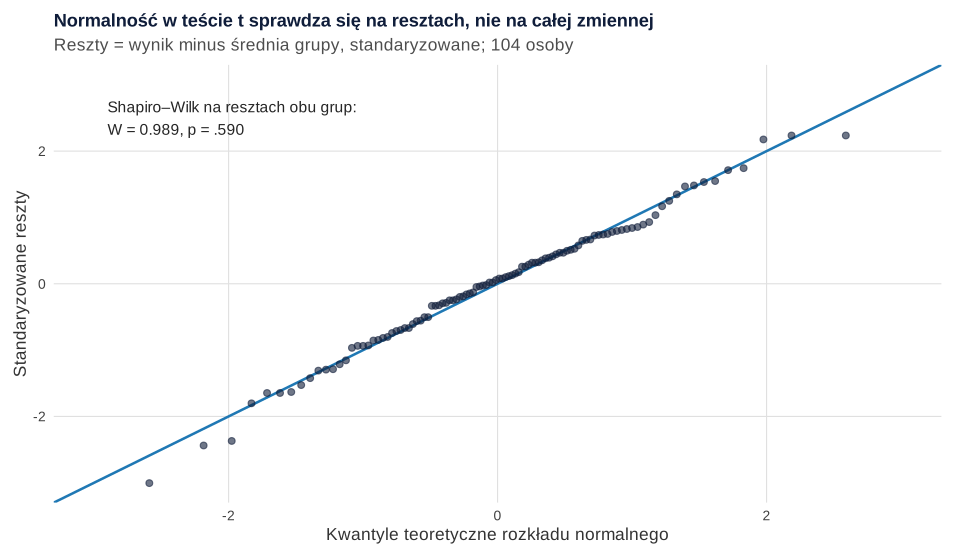
Shapiro–Wilk w oknie testu t bada nie całą zmienną, lecz reszty (wynik minus średnia grupy) łącznie dla obu grup (The jamovi project, b.d.-d). Wynik: W = 0.989, p = .590. Reszty pokazuje wykres Q-Q (rysunek 1).
Group Descriptives i Descriptives plots
| Group | N | Mean | Median | SD | SE | |
|---|---|---|---|---|---|---|
| zmeczenie | nie pracuje | 62 | 3.147 | 3.160 | 0.531 | 0.067 |
| pracuje | 42 | 3.503 | 3.575 | 0.841 | 0.130 |
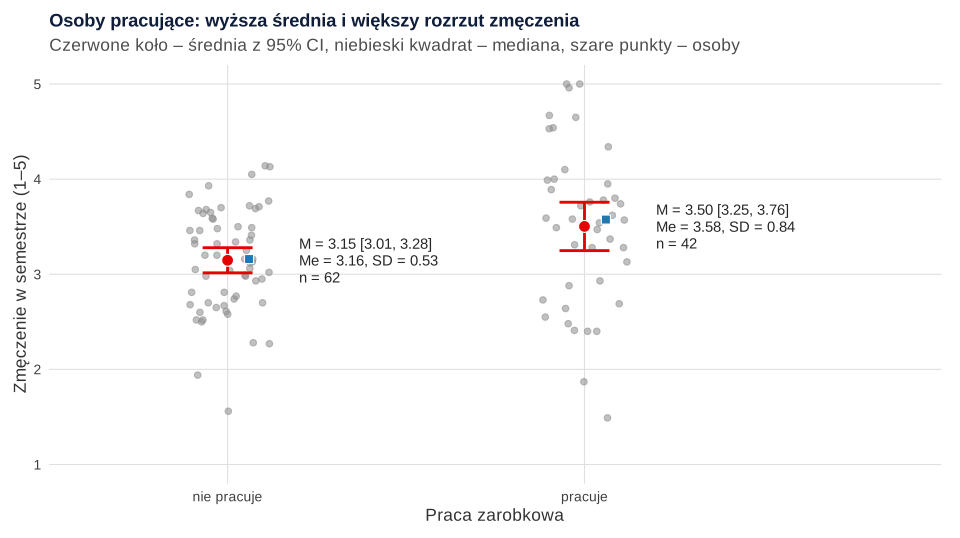
Sprawdź N: 62 + 42 = 104. Descriptives plots rysuje średnie z przedziałami ufności i mediany (rysunek 2). W kodzie jmv przedział na tym wykresie liczony jest z kwantyla rozkładu normalnego (1.96 × SE), a nie z rozkładu t (The jamovi project, b.d.-d). Przy małych grupach jest więc nieco za wąski.
Wielkość efektu: d Cohena i korelacja rangowo-dwuseryjna
W kolumnie Effect Size jamovi podaje d Cohena, ale w każdym wierszu inne. W kodzie jmv (The jamovi project, b.d.-d):
- w wierszu Student's t różnica średnich jest dzielona przez wspólne SD ważone liczebnościami: d = −0.53, 95% CI [−0.93, −0.13];
- w wierszu Welch's t – przez pierwiastek ze zwykłej średniej obu wariancji: d = −0.51. Kolumny przedziału ufności zostają tu puste (jmv 2.7.7);
- przy Mann–Whitneyu kolumna zawiera korelację rangowo-dwuseryjną, liczoną jako 1 − 2U1/(n1n2), gdzie U1 dotyczy grupy 1. Wartość 0.28 jest dodatnia, choć różnica średnich jest ujemna. Obie liczby mówią to samo: wyższe wyniki ma grupa 2, czyli pracujący.
Przy teście Welcha podaj d z jego wiersza, nazwij mianownik i pokaż 95% CI różnicy średnich. Lakens (2013) zaleca pisać, którą wersję d podajesz, bo różne mianowniki dają różne liczby. Pamiętaj też, że Mann–Whitney nie jest testem median. Divine i in. (2018) pokazują, że testuje on prawdopodobieństwo, że wynik z jednej grupy jest wyższy niż z drugiej. O tym, kiedy go wybrać, piszemy we wpisie testy nieparametryczne w jamovi.
Hipoteza kierunkowa: Group 1 < Group 2
Część Hypothesis ma trzy pozycje: Group 1 ≠ Group 2 (dwustronnie), Group 1 > Group 2 i Group 1 < Group 2 (The jamovi project, b.d.-d). Hipoteza „pracujący są bardziej zmęczeni” to tu Group 1 < Group 2. Test Welcha z tą opcją daje t(63.06) = −2.43, p = .009 (połowa dwustronnego .018).
Wolno go podać tylko przy kierunku zapisanym przed zebraniem danych; zmiana po obejrzeniu wyniku to ukryte podwojenie α. Zob. test jednostronny czy dwustronny.
Test t dla prób zależnych: dwa pomiary tych samych osób
Wybierz Analyses → T-Tests → Paired Samples T-Test (Test t dla prób zależnych). Przeciągnij stres_paz i stres_sty do pola Paired Variables (The jamovi project, b.d.-b). Różnica to Measure 1 minus Measure 2. Zaznacz Student's, w razie potrzeby Wilcoxon rank, oraz Mean difference, Effect size (oba z przedziałem ufności), Descriptives i Normality test (The jamovi project, b.d.-d).
| statistic | df | p | Mean difference | SE difference | 95% Confidence Interval | Effect Size | 95% Confidence Interval | ||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Lower | Upper | Lower | Upper | ||||||||||
| stres_paz | stres_sty | Student's t | −4.189 | 99.000 | < .001 | −0.263 | 0.063 | −0.388 | −0.139 | Cohen's d | −0.419 | −0.622 | −0.213 |
| Wilcoxon W | 1381.000 | < .001 | −0.275 | 0.063 | −0.405 | −0.145 | Rank biserial correlation | −0.453 | |||||
| N | Mean | Median | SD | SE | |
|---|---|---|---|---|---|
| stres_paz | 100 | 2.720 | 2.730 | 0.693 | 0.069 |
| stres_sty | 100 | 2.983 | 3.025 | 0.643 | 0.064 |
- N = 100, a nie 104. Do pary wchodzą tylko osoby z oboma pomiarami (The jamovi project, b.d.-d) – napisz o tym w opisie.
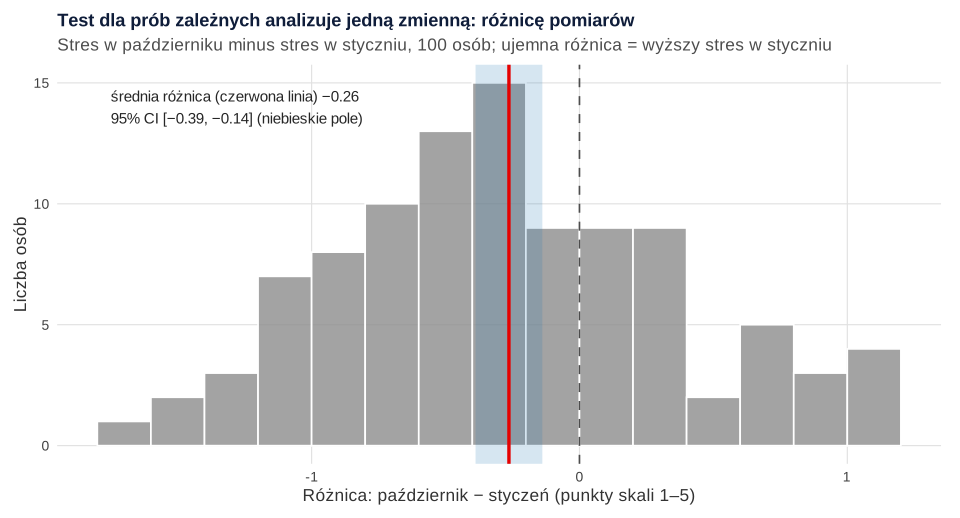
- Znak różnicy. −0.26 to „październik minus styczeń”, czyli w styczniu stres był wyższy. Test: t(99) = −4.19, p < .001, 95% CI [−0.39, −0.14].
- d Cohena = −0.42 to w jmv różnica średnich podzielona przez SD różnic, czyli dz (The jamovi project, b.d.-d). Lakens (2013) opisuje, że nie da się jej wprost porównać z d z badań na grupach niezależnych.
- Normalność jmv sprawdza tu na różnicach pomiarów: W = 0.989, p = .619 (rysunek 3).
- Wilcoxon W to test znakowanych rang. Korelacja rangowo-dwuseryjna ma tu ten sam znak co różnica średnich (−0.45).
Test t dla jednej próby: średnia a wartość odniesienia
Wybierz Analyses → T-Tests → One Sample T-Test (Test t dla jednej próby). Przeciągnij satysfakcja do Dependent Variables, a w części Hypothesis wpisz 3 w polu Test value (The jamovi project, b.d.-b, b.d.-d). Wartość odniesienia (tu środek skali 1–5) wybierz z góry, nie po obejrzeniu średniej.
| Statistic | df | p | Mean difference | 95% Confidence Interval | Effect Size | 95% Confidence Interval | |||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| Lower | Upper | Lower | Upper | ||||||||
| satysfakcja | Student's t | 2.468 | 103.000 | 0.015 | 0.175 | 0.034 | 0.315 | Cohen's d | 0.242 | 0.046 | 0.436 |
Średnia satysfakcja wynosiła 3.17 (SD = 0.72, N = 104) i była o 0.17 punktu wyższa od środka skali: t(103) = 2.47, p = .015, d = 0.24, 95% CI [0.05, 0.44]. Mean difference to odległość od wartości testowej, nie sama średnia.
Zapis wyników w stylu APA
Wzory do dostosowania:
Dwa pomiary bez grupy porównawczej nie pokazują, co spowodowało wzrost stresu – opisuj to jako zmianę. Zdania do innych testów przygotuje generator opisu wyników APA. Ćwiczenia znajdziesz w zbiorze zadania ze statystyki na psychologii (zadania 5 i 6).
To samo w R (pakiet jmv)
Pakiet jmv zawiera analizy jamovi, więc te same funkcje z tymi samymi opcjami dają w R te same tabele co program (The jamovi project, b.d.-b; Selker i in., 2025). Nazwy argumentów odpowiadają polom okna: welchs to Welch's, mann – Mann-Whitney U, eqv – Homogeneity test, norm – Normality test, hypothesis = "twoGreater" – Group 1 < Group 2. Samego jamovi tu nie uruchamialiśmy – liczby w tekście pochodzą z tego kodu. Tabele są szerokie: przewiń je w poziomie.
1. Dane do pobrania: CSV i .sav
R
# B406 – dane symulowane do wpisu /blog/test-t-w-jamovi/ (pliki CSV i .sav do otwarcia w jamovi)
# Uruchomienie z folderu kod/: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b406-0-dane.R
# 104 osoby studiujące: praca zarobkowa (nie / tak), zmęczenie w semestrze (skala 1–5),
# stres w październiku i w styczniu (1–5, te same osoby) oraz satysfakcja ze studiów (1–5).
suppressPackageStartupMessages(library(haven))
set.seed(4061)
n <- c(nie = 62, tak = 42)
praca <- rep(names(n), n)
N <- sum(n)
zmeczenie <- ifelse(praca == "tak", rnorm(N, 3.60, 0.95), rnorm(N, 3.05, 0.55))
stres_paz <- rnorm(N, 2.75, 0.70)
stres_sty <- 0.60 * stres_paz + 1.45 + rnorm(N, 0, 0.55)
satysfakcja <- rnorm(N, 3.30, 0.80)
ogr <- function(x) round(pmin(5, pmax(1, x)), 2)
dane <- data.frame(id = 1:N, praca = ifelse(praca == "tak", "pracuje", "nie pracuje"),
                   zmeczenie = ogr(zmeczenie), stres_paz = ogr(stres_paz),
                   stres_sty = ogr(stres_sty), satysfakcja = ogr(satysfakcja))
dane$stres_sty[c(17, 58, 91, 100)] <- NA        # cztery osoby nie wypełniły ankiety w styczniu
write.csv(dane, "../test-t-jamovi-dane.csv", row.names = FALSE, na = "")

# Ten sam zbiór w .sav: etykiety zmiennych i wartości (praca: 1 = nie pracuje, 2 = pracuje)
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$praca <- labelled(ifelse(dane$praca == "pracuje", 2, 1),
                      labels = c("nie pracuje" = 1, "pracuje" = 2), label = "Praca zarobkowa")
sav$zmeczenie <- labelled(sav$zmeczenie, label = "Zmęczenie w semestrze (1–5)")
sav$stres_paz <- labelled(sav$stres_paz, label = "Stres – październik (1–5)")
sav$stres_sty <- labelled(sav$stres_sty, label = "Stres – styczeń (1–5)")
sav$satysfakcja <- labelled(sav$satysfakcja, label = "Satysfakcja ze studiów (1–5)")
write_sav(sav, "../test-t-jamovi-dane.sav")

# Kontrola: ponowne wczytanie obu plików
csv <- read.csv("../test-t-jamovi-dane.csv")
s <- read_sav("../test-t-jamovi-dane.sav")
cat("CSV:", nrow(csv), "wierszy,", ncol(csv), "kolumn; .sav:", nrow(s), "wierszy\n")
print(table(csv$praca))
print(table(as_factor(s$praca)))
cat("Braki w stres_sty:", sum(is.na(csv$stres_sty)), "\n")
Wynik w R
CSV: 104 wierszy, 6 kolumn; .sav: 104 wierszy

nie pracuje     pracuje
         62          42

nie pracuje     pracuje
         62          42
Braki w stres_sty: 4
2. Trzy testy t funkcjami jmv
R
# Test t w jamovi – te same analizy w R pakietem jmv (silnik analiz jamovi)
library(jmv)
dane <- read.csv("test-t-jamovi-dane.csv")
dane$praca <- factor(dane$praca, levels = c("nie pracuje", "pracuje"))  # Group 1, Group 2

# 1. T-Tests → Independent Samples T-Test: Student's, Welch's i Mann-Whitney U w jednym oknie
ttestIS(data = dane, vars = "zmeczenie", group = "praca",
        students = TRUE, welchs = TRUE, mann = TRUE,
        meanDiff = TRUE, ci = TRUE, effectSize = TRUE, ciES = TRUE,
        desc = TRUE, norm = TRUE, eqv = TRUE)

# 2. Ta sama analiza z hipotezą kierunkową Group 1 < Group 2 (tylko test Welcha)
ttestIS(data = dane, vars = "zmeczenie", group = "praca",
        students = FALSE, welchs = TRUE, hypothesis = "twoGreater")

# 3. T-Tests → Paired Samples T-Test: stres w październiku i w styczniu
ttestPS(data = dane, pairs = list(list(i1 = "stres_paz", i2 = "stres_sty")),
        students = TRUE, wilcoxon = TRUE, meanDiff = TRUE, ci = TRUE,
        effectSize = TRUE, ciES = TRUE, desc = TRUE, norm = TRUE)

# 4. T-Tests → One Sample T-Test: satysfakcja ze studiów a środek skali (Test value = 3)
ttestOneS(data = dane, vars = "satysfakcja", testValue = 3,
          meanDiff = TRUE, ci = TRUE, effectSize = TRUE, ciES = TRUE,
          desc = TRUE, norm = TRUE)
Wynik w R
 INDEPENDENT SAMPLES T-TEST

 Independent Samples T-Test
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
                                  Statistic    df          p            Mean difference    SE difference    Lower         Upper                                       Effect Size    Lower         Upper
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   zmeczenie    Student's t       -2.645350    102.0000    0.0094520         -0.3557604        0.1344852    -0.6225111    -0.08900963    Cohen's d                     -0.5286634    -0.9257438    -0.1290724
                Welch's t         -2.432948    63.05903    0.0178244         -0.3557604        0.1462261    -0.6479645    -0.06355626    Cohen's d                     -0.5059043
                Mann-Whitney U     935.0000                0.0151773         -0.3599985                     -0.6499783    -0.07998751    Rank biserial correlation      0.2818740
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Hₐ μ <sub>nie pracuje</sub> ≠ μ <sub>pracuje</sub>


 ASSUMPTIONS

 Normality Test (Shapiro-Wilk)
 ───────────────────────────────────────
                W            p
 ───────────────────────────────────────
   zmeczenie    0.9894233    0.5903401
 ───────────────────────────────────────
   Note. A low p-value suggests a
   violation of the assumption of
   normality


 Homogeneity of Variances Test (Levene's)
 ───────────────────────────────────────────────────
                F           df    df2    p
 ───────────────────────────────────────────────────
   zmeczenie    7.844997     1    102    0.0060977
 ───────────────────────────────────────────────────
   Note. A low p-value suggests a violation of
   the assumption of equal variances


 Group Descriptives
 ─────────────────────────────────────────────────────────────────────────────────────
                Group          N     Mean        Median      SD           SE
 ─────────────────────────────────────────────────────────────────────────────────────
   zmeczenie    nie pracuje    62    3.147097    3.160000    0.5310750    0.06744659
                pracuje        42    3.502857    3.575000    0.8408250     0.1297421
 ─────────────────────────────────────────────────────────────────────────────────────


 INDEPENDENT SAMPLES T-TEST

 Independent Samples T-Test
 ────────────────────────────────────────────────────────────────
                             Statistic    df          p
 ────────────────────────────────────────────────────────────────
   zmeczenie    Welch's t    -2.432948    63.05903    0.0089122
 ────────────────────────────────────────────────────────────────
   Note. Hₐ μ <sub>nie pracuje</sub> < μ <sub>pracuje</sub>


 PAIRED SAMPLES T-TEST

 Paired Samples T-Test
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
                                            statistic    df          p            Mean difference    SE difference    Lower         Upper                                      Effect Size    Lower         Upper
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   stres_paz    stres_sty    Student's t    -4.189458    99.00000    0.0000608         -0.2633000       0.06284823    -0.3880045    -0.1385955    Cohen's d                     -0.4189458    -0.6224509    -0.2134932
                             Wilcoxon W      1381.000                0.0000843         -0.2750503       0.06284823    -0.4049708    -0.1449854    Rank biserial correlation     -0.4530693
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Hₐ μ <sub>Measure 1 - Measure 2</sub> ≠ 0


 Normality Test (Shapiro-Wilk)
 ─────────────────────────────────────────────────────────
                                  W            p
 ─────────────────────────────────────────────────────────
   stres_paz    -    stres_sty    0.9894285    0.6185773
 ─────────────────────────────────────────────────────────
   Note. A low p-value suggests a violation of the
   assumption of normality


 Descriptives
 ───────────────────────────────────────────────────────────────────────
                N      Mean        Median      SD           SE
 ───────────────────────────────────────────────────────────────────────
   stres_paz    100    2.719900    2.730000    0.6928866    0.06928866
   stres_sty    100    2.983200    3.025000    0.6427700    0.06427700
 ───────────────────────────────────────────────────────────────────────


 ONE SAMPLE T-TEST

 One Sample T-Test
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
                                 Statistic    df          p            Mean difference    Lower         Upper                     Effect Size    Lower         Upper
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   satysfakcja    Student's t     2.468389    103.0000    0.0152184          0.1745192    0.03429912    0.3147393    Cohen's d      0.2420454    0.04646964    0.4364798
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Hₐ μ ≠ 3


 Normality Test (Shapiro-Wilk)
 ─────────────────────────────────────────
                  W            p
 ─────────────────────────────────────────
   satysfakcja    0.9845178    0.2680649
 ─────────────────────────────────────────
   Note. A low p-value suggests a
   violation of the assumption of
   normality


 Descriptives
 ─────────────────────────────────────────────────────────────────────────
                  N      Mean        Median      SD           SE
 ─────────────────────────────────────────────────────────────────────────
   satysfakcja    104    3.174519    3.230000    0.7210185    0.07070168
 ─────────────────────────────────────────────────────────────────────────
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersję jamovi albo R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses [R package]. https://CRAN.R-project.org/package=jmv
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy w teście t w jamovi
- Przepisanie wiersza Student's t, bo jest zaznaczony domyślnie.
- Przełączanie opcji, aż p spadnie poniżej .05 – prosta droga do p-hackingu.
- Zmienna grupująca jako Continuous albo z trzema poziomami (np. literówka „Pracuje” i „pracuje”).
- Pomiary przed i po w jednej kolumnie i test dla prób niezależnych zamiast Paired Samples T-Test.
- Odczytanie znaku bez sprawdzenia kolejności grup – także korelacji rangowo-dwuseryjnej.
- d bez nazwy mianownika albo d z wiersza Studenta dołączone do wyniku testu Welcha.
- Nieopisany spadek N w teście dla par.
- Shapiro–Wilk z Exploration → Descriptives dla całej zmiennej zamiast reszt z okna testu t.
Jeśli nie wiesz, czy test t pasuje do Twojej hipotezy, skorzystaj z kreatora doboru testu. Kolejny wpis z serii o jamovi to korelacja i regresja liniowa w jamovi. Pomoc w sprawdzeniu wyników: analizy statystyczne dla studentów.
Najczęstsze pytania
Dlaczego jamovi nie pokazuje przedziału ufności dla d Cohena przy teście Welcha?
W kodzie analizy (pakiet jmv 2.7.7) przedział ufności dla d liczony jest tylko w wierszu Student's t; w wierszu Welch's t kolumny Lower i Upper zostają puste. Podaj wtedy d z wiersza Welcha i 95% CI różnicy średnich w punktach skali albo policz przedział dla d w innym programie i napisz, jaką metodą.
Jak zmienić kolejność grup w teście t w jamovi?
Grupa 1 to pierwszy poziom zmiennej grupującej. Kolejność poziomów zmienisz w edytorze zmiennej (dwuklik na nagłówku kolumny). Od kolejności zależy znak t, różnicy średnich i d oraz to, co oznacza hipoteza Group 1 > Group 2; sama wartość p testu dwustronnego się nie zmienia.
Dlaczego w jamovi korelacja rangowo-dwuseryjna jest dodatnia, a różnica średnich ujemna?
W teście Manna–Whitneya jmv liczy ją jako 1 − 2U₁/(n₁n₂), gdzie U₁ dotyczy grupy 1. Wartość dodatnia oznacza tu, że wyższe wyniki ma grupa 2. W przykładzie różnica średnich wynosi −0.36, a korelacja rangowo-dwuseryjna 0.28 – obie mówią to samo. Kierunek opisuj więc według średnich lub median grup, a nie według znaku.
Gdzie w jamovi jest test Shapiro–Wilka przy teście t?
W oknie testu t w części Assumption Checks zaznacz Normality test. W teście dla grup jamovi sprawdza reszty, czyli wyniki minus średnia własnej grupy, łącznie dla obu grup, a w teście dla par – różnice pomiarów. To nie to samo co Shapiro–Wilk w Descriptives dla całej zmiennej.
Jak w jamovi zrobić test t jednostronny?
W części Hypothesis wybierz Group 1 > Group 2 albo Group 1 < Group 2 (w teście dla par Measure 1 > Measure 2 lub <, w teście dla jednej próby > Test value lub <). Pod tabelą pojawi się notka z hipotezą alternatywną. Zrób to tylko wtedy, gdy kierunek zapisałeś przed zebraniem danych.
Powiązane hasła
Przeczytaj też
jamovi krok po kroku
Descriptives, test t Welcha, Correlation Matrix i One-Way ANOVA na jednym zbiorze danych: nazwy opcji z dokumentacji, gotowe zdania APA, kod jmv.
Czytaj →PoradnikTest t w SPSS krok po kroku
Test t dla prób niezależnych i zależnych w SPSS: układ pliku, okna procedur, wiersz Welcha, wielkość efektu, jednostronne p i składnia T-TEST – z plikiem .sav do pobrania.
Czytaj →PoradnikTest t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →Masz wyniki testu t z jamovi i nie wiesz, który wiersz opisać?
Sprawdzimy przygotowanie danych, wybór testu i wielkości efektu oraz opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je przedstawić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses (Version 2.7.7) [R package]. https://CRAN.R-project.org/package=jmv ● Otwarty dostęp: pełny tekst
- The jamovi project. (b.d.-b). jamovi documentation: Getting started, Data handling and Analyses. jamovi docs. https://docs.jamovi.org/ ● Otwarty dostęp
- The jamovi project. (b.d.-c). From SPSS to jamovi: Comparison of analyses and side-by-side comparisons. jamovi docs. https://docs.jamovi.org/spss2jamovi/s2j_side-by-side.html ● Otwarty dostęp
- The jamovi project. (b.d.-d). jmv: The jamovi analyses – source code, analysis definitions and translations. GitHub. https://github.com/jamovi/jmv ● Otwarty dostęp
Cytowania BibTeX
@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{divine2018wilcoxon, author={Divine, George W. and Norton, H. James and Barón, Anna E. and Juarez-Colunga, Elizabeth}, title={{The Wilcoxon–Mann–Whitney procedure fails as a test of medians}}, journal={The American Statistician}, year={2018}, volume={72}, number={3}, pages={278--286}, doi={10.1080/00031305.2017.1305291}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@misc{selker2025jmv, author={Selker, Ravi and Love, Jonathon and Dropmann, Damian}, title={{jmv: The 'jamovi' analyses (R package version 2.7.7) [Computer software]}}, year={2025}, url={https://CRAN.R-project.org/package=jmv}}@misc{jamovindocs, author={{The jamovi project}}, title={{jamovi documentation: Getting started, Data handling and Analyses}}, howpublished={jamovi docs}, year={b.d.-b}, url={https://docs.jamovi.org/}}@misc{jamovindspss, author={{The jamovi project}}, title={{From SPSS to jamovi: Comparison of analyses and side-by-side comparisons}}, howpublished={jamovi docs}, year={b.d.-c}, url={https://docs.jamovi.org/spss2jamovi/s2j_side-by-side.html}}@misc{jamovindjmvrepo, author={{The jamovi project}}, title={{jmv: The jamovi analyses – source code, analysis definitions and translations}}, howpublished={GitHub}, year={b.d.-d}, url={https://github.com/jamovi/jmv}}