Korelacja czy regresja: na jakie pytanie odpowiadasz
Korelacja mówi, jak silnie wiążą się dwie zmienne. Regresja liniowa przewiduje jedną zmienną ilościową z kilku predyktorów naraz i pokazuje, ile każdy z nich wnosi przy kontroli pozostałych. W pracy zwykle robisz obie analizy: najpierw macierz korelacji, potem model regresji.
Ten wpis pokazuje, co kliknąć w jamovi. Instalację, interfejs i pierwszą prostą korelację opisuje jamovi krok po kroku – tu idziemy dalej: Spearman obok Pearsona, przedziały ufności, regresja w blokach i diagnostyka. Odpowiedniki w SPSS to korelacja i regresja w SPSS oraz regresja hierarchiczna w SPSS. Obie analizy są w menu Regression (The jamovi project, b.d.-a, b.d.-b). Nazwy opcji podajemy po angielsku, jak w dokumentacji i w definicjach analiz pakietu jmv, który jamovi uruchamia (Selker i in., 2025). Polskie odpowiedniki w nawiasach pochodzą z pliku tłumaczeń tego pakietu; w Twojej wersji programu mogą brzmieć inaczej.
Przykład. 172 osoby studiujące (dane symulowane) podały płeć, wiek i liczbę godzin pracy zarobkowej w tygodniu (praca; 69 osób nie pracowało). Wypełniły skalę prokrastynacji akademickiej (średnia 1–5), skalę wsparcia społecznego (średnia 1–7) i skalę wypalenia akademickiego (średnia 1–5) – to zmienna zależna. Dwie osoby nie wypełniły skali prokrastynacji, a trzy – skali wsparcia. Dane pobierzesz jako plik CSV albo plik .sav z etykietami zmiennych i wartości. jamovi otworzy oba.
Przygotowanie danych w jamovi
Po otwarciu pliku sprawdź typ każdej kolumny (dwuklik na nagłówku). wiek, praca, prokrastynacja, wsparcie i wypalenie ustaw jako Continuous, plec jako Nominal, a id jako ID. W Linear Regression zmienna nominalna trafi do pola Factors, gdzie jamovi sam utworzy dla niej zmienne zero-jedynkowe. Wyniki skal policz wcześniej (zob. przygotowanie danych i statystyki opisowe w jamovi).
Zmienna praca jest skośna (mediana 6.5 godziny, średnia 9.61), więc obok Pearsona policzymy też Spearmana.
Krok 1. Analyses → Regression → Correlation Matrix (Macierz korelacji)
- Przeciągnij
praca,prokrastynacja,wsparcieiwypaleniedo pola zmiennych. - W części Correlation Coefficients zostaw Pearson i dodaj Spearman. Trzecia możliwość to Kendall's tau-b.
- W Additional Options zostaw Report significance i zaznacz Flag significant correlations, N oraz Confidence intervals (domyślnie 95%).
- Hypothesis zostaw na Correlated (test dwustronny).
- W części Plot zaznacz Correlation matrix – dostaniesz macierz wykresów rozrzutu (Selker i in., 2025).
Tabela 1. Correlation Matrix. Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabeli jak w jamovi.
| praca | prokrastynacja | wsparcie | wypalenie | ||
|---|---|---|---|---|---|
| praca | Pearson's r | — | |||
| df | — | ||||
| p−value | — | ||||
| 95% CI Upper | — | ||||
| 95% CI Lower | — | ||||
| Spearman's rho | — | ||||
| df | — | ||||
| p−value | — | ||||
| N | — | ||||
| prokrastynacja | Pearson's r | −0.041 | — | ||
| df | 168 | — | |||
| p−value | 0.597 | — | |||
| 95% CI Upper | 0.110 | — | |||
| 95% CI Lower | −0.190 | — | |||
| Spearman's rho | −0.037 | — | |||
| df | 168 | — | |||
| p−value | 0.630 | — | |||
| N | 170 | — | |||
| wsparcie | Pearson's r | −0.110 | 0.065 | — | |
| df | 167 | 165 | — | ||
| p−value | 0.153 | 0.403 | — | ||
| 95% CI Upper | 0.041 | 0.215 | — | ||
| 95% CI Lower | −0.257 | −0.088 | — | ||
| Spearman's rho | −0.087 | 0.069 | — | ||
| df | 167 | 165 | — | ||
| p−value | 0.259 | 0.376 | — | ||
| N | 169 | 167 | — | ||
| wypalenie | Pearson's r | 0.298 *** | 0.374 *** | −0.351 *** | — |
| df | 170 | 168 | 167 | — | |
| p−value | < .001 | < .001 | < .001 | — | |
| 95% CI Upper | 0.428 | 0.496 | −0.211 | — | |
| 95% CI Lower | 0.155 | 0.237 | −0.477 | — | |
| Spearman's rho | 0.266 *** | 0.327 *** | −0.339 *** | — | |
| df | 170 | 168 | 167 | — | |
| p−value | < .001 | < .001 | < .001 | — | |
| N | 172 | 170 | 169 | — |
Note. * p < .05, ** p < .01, *** p < .001
jamovi pokazuje współczynniki tylko pod przekątną, a gwiazdki oznaczają p < .05, .01 i .001 (The jamovi project, b.d.-b). Wypalenie rosło z pracą (r = .30) i prokrastynacją (r = .37), a malało ze wsparciem (r = −.35). Predyktory prawie nie korelowały ze sobą (od −.11 do .07).
Trzy rzeczy, które łatwo przeoczyć. Po pierwsze, wiersz N: braki są usuwane parami, więc korelacja pracy z wypaleniem opiera się na 172 osobach, a prokrastynacji ze wsparciem na 167. Po drugie, przedział ufności jamovi podaje tylko dla Pearsona. Dla rho Spearmana dostajesz współczynnik, df i p, ale bez przedziału. Po trzecie, przy skośnej pracy Spearman dał prawie to samo co Pearson (.27 wobec .30). Pearson mierzy tylko związek liniowy i jest wrażliwy na obserwacje odstające (Schober i in., 2018). Kiedy wybrać którą miarę, wyjaśnia wpis korelacja Pearsona i Spearmana krok po kroku.
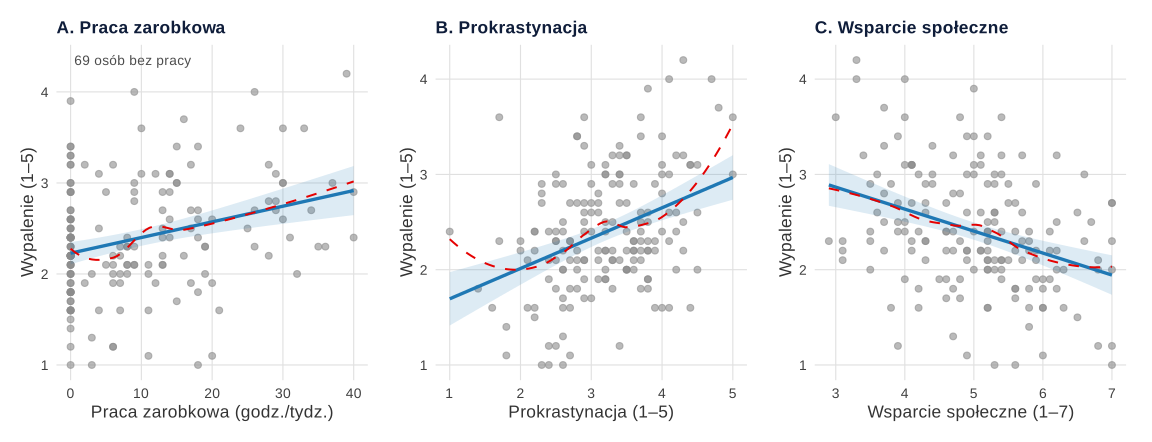
W tym samym menu jest też Partial Correlation (Korelacja cząstkowa) z polem Control Variables. Policzysz w nim korelację cząstkową albo semicząstkową.
Krok 2. Okno Analyses → Regression → Linear Regression (Regresja liniowa)
Pytanie: czy prokrastynacja i wsparcie wyjaśniają wypalenie ponad płeć, wiek i pracę? To regresja hierarchiczna. Teorię omawia regresja hierarchiczna krok po kroku.
- Zmienne.
wypalenieprzenieś do Dependent Variable, awiek,praca,prokrastynacjaiwsparciedo Covariates (Współzmienne).plecprzenieś do Factors (Czynniki) – to pole na predyktory kategorialne (The jamovi project, b.d.-a). - Model Builder (Kreator modelu). Na początku wszystkie predyktory są w Block 1. Zostaw tam płeć, wiek i pracę, kliknij Add New Block (Dodaj nowy blok) i przeciągnij prokrastynację i wsparcie do Block 2.
- Reference Levels. Sprawdź, który poziom płci jest poziomem odniesienia. Tu ustawiamy kobieta, więc współczynnik pokaże różnicę „mężczyzna – kobieta”.
- Assumption Checks (Weryfikacja założeń). Zaznacz Collinearity statistics, Normality test, Q-Q plot of residuals i Residual plots, a w Data Summary – Cook's distance. Autocorrelation test (Durbin–Watson) zaznacz tylko wtedy, gdy wiersze mają porządek w czasie.
- Model Fit. Do zaznaczonych domyślnie R i R² dodaj Adjusted R² oraz F test w części Overall Model Test.
- Model Coefficients. Zaznacz Confidence interval przy Estimate oraz Standardized estimate z jego Confidence interval. ANOVA test (Omnibus Test) przydaje się przy czynnikach o więcej niż dwóch poziomach (Selker i in., 2025).
Okno nie ma metody krokowej (stepwise) – bloki ustalasz sam(a).
Krok 3. Tabele regresji: co przepisać
Pod tabelą Model Fit Measures jamovi dopisuje: „Models estimated using sample size of N=167”. Program usuwa wiersze z brakiem w którejkolwiek zmiennej z obu bloków. Dzięki temu oba modele liczy na tych samych 167 osobach.
Tabela 2. Model Fit Measures i Model Comparisons. Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabel jak w jamovi.
| Model | R | R² | Adjusted R² | F | df1 | df2 | p |
|---|---|---|---|---|---|---|---|
| 1 | 0.333 | 0.111 | 0.094 | 6.77 | 3 | 163 | < .001 |
| 2 | 0.614 | 0.377 | 0.358 | 19.49 | 5 | 161 | < .001 |
Note. Models estimated using sample size of N=167
| Comparison | ΔR² | F | df1 | df2 | p | ||
|---|---|---|---|---|---|---|---|
| Model | Model | ||||||
| 1 | − | 2 | 0.266 | 34.41 | 2 | 161 | < .001 |
Model Fit Measures. Płeć, wiek i praca wyjaśniały 11% wariancji wypalenia, F(3, 163) = 6.77, p < .001. Po dodaniu drugiego bloku R² wzrosło do .38 (skorygowane .36), F(5, 161) = 19.49, p < .001. Model Comparisons (Porównania modeli) to odpowiedź na pytanie badawcze. Prokrastynacja i wsparcie dodały ΔR² = .27, F(2, 161) = 34.41, p < .001 (rysunek 2). jamovi nie pokazuje błędu standardowego oszacowania ani całkowitej sumy kwadratów, które znasz z SPSS (The jamovi project, b.d.-b).
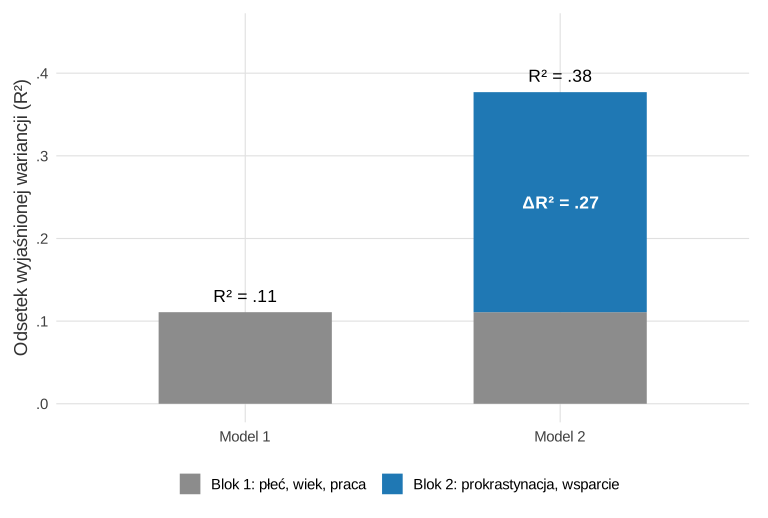
jamovi tworzy osobną tabelę współczynników dla każdego modelu. Do opisu hipotez bierz tabelę modelu końcowego.
Tabela 3. Model Coefficients – wypalenie, model 2. Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabeli jak w jamovi.
| Predictor | Estimate | SE | 95% Confidence Interval | t | p | Stand. Estimate | 95% Confidence Interval | ||
|---|---|---|---|---|---|---|---|---|---|
| Lower | Upper | Lower | Upper | ||||||
| Intercept ᵃ | 2.805 | 0.502 | 1.813 | 3.797 | 5.582 | < .001 | |||
| plec: | |||||||||
| mężczyzna – kobieta | −0.201 | 0.083 | −0.364 | −0.037 | −2.428 | 0.016 | −0.314 | −0.569 | −0.059 |
| wiek | −0.018 | 0.019 | −0.056 | 0.019 | −0.968 | 0.335 | −0.061 | −0.184 | 0.063 |
| praca | 0.014 | 0.004 | 0.007 | 0.022 | 3.961 | < .001 | 0.250 | 0.126 | 0.375 |
| prokrastynacja | 0.343 | 0.053 | 0.238 | 0.448 | 6.429 | < .001 | 0.402 | 0.279 | 0.526 |
| wsparcie | −0.233 | 0.041 | −0.314 | −0.151 | −5.643 | < .001 | −0.355 | −0.479 | −0.231 |
ᵃ Represents reference level
Estimate to b w jednostkach zmiennych. Punkt prokrastynacji więcej to wypalenie wyższe średnio o 0.34 punktu przy pozostałych predyktorach bez zmian. Stand. Estimate to β (zob. współczynniki standaryzowane czy niestandaryzowane). Najsilniejszym predyktorem była prokrastynacja (β = .40), potem wsparcie (β = −.35) i praca (β = .25). Przy β jamovi może od razu podać przedział ufności.
Uwaga na płeć. jmv przed policzeniem β standaryzuje tylko zmienne liczbowe, a czynników nie (Selker i in., 2025). Wartość −0.314 to więc różnica mężczyźni – kobiety w odchyleniach standardowych wypalenia, a nie klasyczne β. W modelu 1 płeć nie była istotna (b = −0.16, p = .095), a w modelu 2 jest (b = −0.20, p = .016). Dlatego w pracy podaj, z którego modelu pochodzą współczynniki.
Krok 4. Assumption Checks: współliniowość, reszty, obserwacje wpływowe
Tabela 4. Collinearity Statistics, Normality Test, Durbin–Watson i Cook's Distance dla modelu 2. Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabel jak w jamovi.
| VIF | Tolerance | |
|---|---|---|
| plec | 1.015 | 0.985 |
| wiek | 1.013 | 0.988 |
| praca | 1.033 | 0.968 |
| prokrastynacja | 1.012 | 0.988 |
| wsparcie | 1.021 | 0.979 |
| Statistic | p |
|---|---|
| 0.996 | 0.956 |
| Autocorrelation | DW Statistic | p |
|---|---|---|
| −0.009 | 1.993 | 0.888 |
| Mean | Median | SD | Min | Max |
|---|---|---|---|---|
| 0.007 | 0.002 | 0.011 | 0.000 | 0.083 |
Collinearity Statistics. VIF od 1.01 do 1.03 oznacza, że predyktory prawie się nie pokrywają. Progów typu „VIF powyżej 10” nie stosuj mechanicznie. Wariancja współczynnika zależy też od liczebności próby i R² modelu (O’Brien, 2007). Co robić przy wysokim VIF, opisuje wpis wysoki VIF – co zrobić.
Reszty. Założenia regresji dotyczą reszt, a nie rozkładów samych zmiennych (Williams i in., 2013). Test Shapiro–Wilka dla reszt był nieistotny (W = 0.996, p = .956). Ważniejsze są wykresy: Q-Q plot of residuals oraz Residual plots, czyli reszty względem wartości dopasowanych (Fitted), zmiennej zależnej i każdego predyktora ilościowego (rysunek 3).
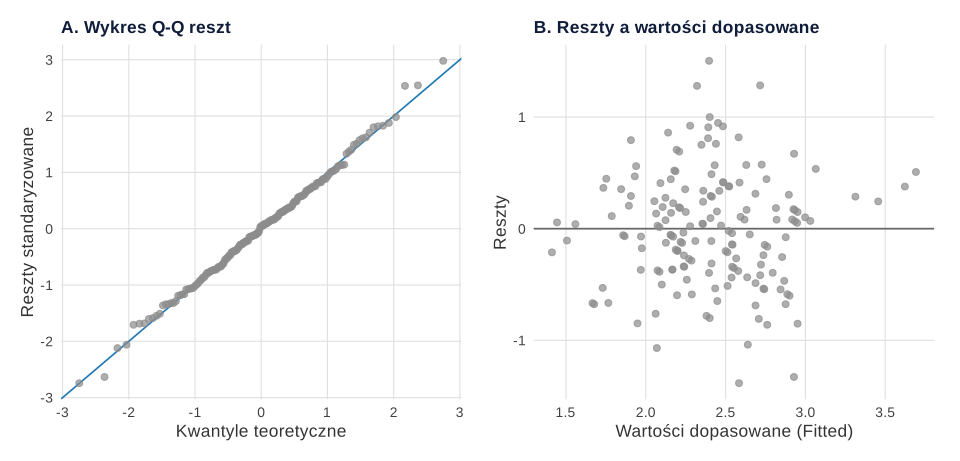
Punkty na wykresie Q-Q leżą przy przekątnej. Chmura reszt nie tworzy łuku (nieliniowość) ani lejka (niestała wariancja). Więcej o tym, kiedy normalność reszt ma znaczenie, w poradniku normalność reszt czy zmiennych.
Cook's distance. jamovi podaje tylko podsumowanie odległości Cooka, czyli miary wpływu jednej obserwacji na współczynniki (Cook, 1977). Maksimum wyniosło .083, więc żadna osoba nie dominuje nad wynikiem. Żeby zobaczyć, kto ma największą wartość, użyj sekcji Save (Zapisz). Opcje Predicted values, Residuals i Cook's distance dopisują nowe kolumny do arkusza (Selker i in., 2025).
Durbin–Watson. Test Durbina–Watsona ma sens tylko wtedy, gdy kolejność wierszy coś znaczy, np. kolejne dni pomiaru; w ankiecie go pomiń. jmv liczy jego p funkcją durbinWatsonTest z pakietu car metodą bootstrapu, więc p może się nieco różnić przy każdym przeliczeniu.
Zapis wyników w stylu APA
Wzory zawierają liczby z przykładu. Korelację zapisuj z df z tabeli, a regresję hierarchiczną z R² obu modeli, ΔR² z testem F i współczynnikami modelu końcowego. Zdania do innych analiz złożysz w generatorze opisu wyników APA.
Przy pracy b = 0.01 wygląda na zero, bo jednostką jest godzina; 10 godzin to około 0.14 punktu wypalenia. Jeśli nie wiesz, czy Twoje pytanie wymaga korelacji, regresji czy innego testu, sprawdź kreator doboru testu.
To samo w R (pakiet jmv)
Pakiet jmv zawiera analizy jamovi, więc funkcje corrMatrix() i linReg() dają te same tabele co okna Correlation Matrix i Linear Regression; argumenty funkcji odpowiadają opcjom w oknie (Selker i in., 2025). Samego jamovi tu nie uruchamialiśmy – liczby w tabelach 1–4 pochodzą z tego kodu. W R wynik jest drukowany z pełną precyzją, a jamovi zaokrągla go do trzech miejsc. Uruchom przepisy po kolei z folderu, w którym zapiszesz pliki danych. Przepis 1 tworzy plik CSV i plik .sav (pakiet haven).
1. Dane: CSV i plik .sav z etykietami
R
# B409 – dane przykładowe: wypalenie akademickie a praca zarobkowa, prokrastynacja i wsparcie (dane symulowane)
# 172 osoby studiujące; plik CSV (do otwarcia w jamovi) i plik SPSS .sav z etykietami (jamovi też go otworzy)
suppressPackageStartupMessages(library(haven))
set.seed(4091)
n <- 172
plec  <- sample(c("kobieta", "mężczyzna"), n, replace = TRUE, prob = c(.62, .38))
wiek  <- pmin(19 + round(rgamma(n, shape = 1.6, rate = 0.55)), 32)                  # lata
praca <- ifelse(runif(n) < .45, 0, pmin(round(rgamma(n, shape = 2.2, rate = 0.12)), 40))  # godziny pracy tygodniowo
prokrastynacja <- round(pmin(pmax(rnorm(n, 3.0, 0.75), 1), 5), 1)                  # średnia z 10 pozycji (1–5)
wsparcie <- round(pmin(pmax(rnorm(n, 5.1, 1.05), 1), 7), 1)                         # średnia z 12 pozycji (1–7)
wypalenie <- 2.15 + 0.014 * praca + 0.36 * prokrastynacja - 0.21 * wsparcie +
  0.14 * (plec == "kobieta") - 0.012 * (wiek - 22) + rnorm(n, 0, 0.52)
wypalenie <- round(pmin(pmax(wypalenie, 1), 5), 1)                                  # średnia z 15 pozycji (1–5)
wsparcie[sample(n, 3)] <- NA                                                        # braki: nie wypełniono skali
prokrastynacja[sample(n, 2)] <- NA
dane <- data.frame(id = 1:n, plec, wiek, praca, prokrastynacja, wsparcie, wypalenie)
write.csv(dane, "../korelacja-regresja-jamovi-dane.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

sav <- dane
sav$plec <- labelled(ifelse(dane$plec == "kobieta", 1, 2), c("kobieta" = 1, "mężczyzna" = 2), label = "Płeć")
attr(sav$id, "label")             <- "Numer osoby"
attr(sav$wiek, "label")           <- "Wiek (lata)"
attr(sav$praca, "label")          <- "Praca zarobkowa – godziny tygodniowo"
attr(sav$prokrastynacja, "label") <- "Prokrastynacja akademicka (średnia 1–5)"
attr(sav$wsparcie, "label")       <- "Wsparcie społeczne (średnia 1–7)"
attr(sav$wypalenie, "label")      <- "Wypalenie akademickie (średnia 1–5)"
write_sav(sav, "../korelacja-regresja-jamovi-dane.sav")

table(plec = dane$plec)
summary(dane[, -(1:2)])
c(osoby_bez_pracy = sum(dane$praca == 0), komplet_danych = sum(complete.cases(dane)))
Wynik w R
plec
  kobieta mężczyzna
      107        65
      wiek           praca       prokrastynacja     wsparcie       wypalenie
 Min.   :19.00   Min.   : 0.00   Min.   :1.000   Min.   :2.900   Min.   :1.000
 1st Qu.:20.00   1st Qu.: 0.00   1st Qu.:2.625   1st Qu.:4.300   1st Qu.:2.000
 Median :21.00   Median : 6.50   Median :3.200   Median :5.100   Median :2.300
 Mean   :21.96   Mean   : 9.61   Mean   :3.205   Mean   :5.017   Mean   :2.394
 3rd Qu.:23.00   3rd Qu.:16.00   3rd Qu.:3.700   3rd Qu.:5.700   3rd Qu.:2.825
 Max.   :28.00   Max.   :40.00   Max.   :5.000   Max.   :7.000   Max.   :4.200
                                 NA's   :2       NA's   :3
osoby_bez_pracy  komplet_danych
             69             167
2. Correlation Matrix: Pearson z CI i Spearman
R
# Regression → Correlation Matrix w R (pakiet jmv – te same funkcje, których używa jamovi)
library(jmv)
dane <- read.csv("../korelacja-regresja-jamovi-dane.csv", encoding = "UTF-8")
corrMatrix(data = dane, vars = c("praca", "prokrastynacja", "wsparcie", "wypalenie"),
           pearson = TRUE, spearman = TRUE, sig = TRUE, flag = TRUE, n = TRUE, ci = TRUE)
Wynik w R
 CORRELATION MATRIX

 Correlation Matrix
 ───────────────────────────────────────────────────────────────────────────────────────────────
                                       praca         prokrastynacja    wsparcie      wypalenie
 ───────────────────────────────────────────────────────────────────────────────────────────────
   praca             Pearson's r                —
                     df                         —
                     p-value                    —
                     95% CI Upper               —
                     95% CI Lower               —
                     Spearman's rho             —
                     df                         —
                     p-value                    —
                     N                          —

   prokrastynacja    Pearson's r       -0.0408363                 —
                     df                       168                 —
                     p-value            0.5969914                 —
                     95% CI Upper       0.1103563                 —
                     95% CI Lower      -0.1901816                 —
                     Spearman's rho    -0.0372510                 —
                     df                       168                 —
                     p-value            0.6296084                 —
                     N                        170                 —

   wsparcie          Pearson's r       -0.1104430         0.0651704             —
                     df                       167               165             —
                     p-value            0.1528663         0.4027322             —
                     95% CI Upper       0.0412040         0.2149071             —
                     95% CI Lower      -0.2571163        -0.0875598             —
                     Spearman's rho    -0.0872890         0.0689523             —
                     df                       167               165             —
                     p-value            0.2591126         0.3759292             —
                     N                        169               167             —

   wypalenie         Pearson's r        0.2977500         0.3737908    -0.3510474            —
                     df                       170               168           167            —
                     p-value            0.0000728         0.0000005     0.0000029            —
                     95% CI Upper       0.4283020         0.4963784    -0.2112842            —
                     95% CI Lower       0.1550224         0.2365871    -0.4767428            —
                     Spearman's rho     0.2657667         0.3269697    -0.3392229            —
                     df                       170               168           167            —
                     p-value            0.0004256         0.0000135     0.0000064            —
                     N                        172               170           169            —
 ───────────────────────────────────────────────────────────────────────────────────────────────
   Note. * p < .05, ** p < .01, *** p < .001
3. Linear Regression: dwa bloki, β, VIF, Cook, Durbin–Watson
R
# Regression → Linear Regression w R (pakiet jmv): dwa bloki, czyli regresja hierarchiczna
library(jmv)
dane <- read.csv("../korelacja-regresja-jamovi-dane.csv", encoding = "UTF-8")
dane$plec <- factor(dane$plec, levels = c("kobieta", "mężczyzna"))
set.seed(4093)  # p testu Durbina–Watsona pochodzi z bootstrapu (car::durbinWatsonTest)
linReg(data = dane, dep = "wypalenie", covs = c("wiek", "praca", "prokrastynacja", "wsparcie"),
       factors = "plec",
       blocks = list(list("plec", "wiek", "praca"),
                     list("prokrastynacja", "wsparcie")),
       refLevels = list(list(var = "plec", ref = "kobieta")),
       r2Adj = TRUE, modelTest = TRUE, ci = TRUE, stdEst = TRUE, ciStdEst = TRUE,
       norm = TRUE, qqPlot = FALSE, resPlots = FALSE, durbin = TRUE, collin = TRUE, cooks = TRUE)
Wynik w R
 LINEAR REGRESSION

 Model Fit Measures
 ───────────────────────────────────────────────────────────────────────────────────────────
   Model    R            R²           Adjusted R²    F            df1    df2    p
 ───────────────────────────────────────────────────────────────────────────────────────────
       1    0.3328975    0.1108207     0.09445549     6.771706      3    163     0.0002482
       2    0.6140523    0.3770603     0.35771431    19.490393      5    161    < .0000001
 ───────────────────────────────────────────────────────────────────────────────────────────
   Note. Models estimated using sample size of N=167


 Model Comparisons
 ────────────────────────────────────────────────────────────────────────────
   Model         Model    ΔR²          F           df1    df2    p
 ────────────────────────────────────────────────────────────────────────────
       1    -        2    0.2662395    34.40506      2    161    < .0000001
 ────────────────────────────────────────────────────────────────────────────


 MODEL SPECIFIC RESULTS

 MODEL 1

 Model Coefficients - wypalenie
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Predictor                Estimate       SE             Lower           Upper         t            p             Stand. Estimate    Lower         Upper
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Intercept           ᵃ     2.98906060    0.499983007     2.001781849    3.97633936     5.978324    < .0000001
   plec:
   mężczyzna – kobieta      -0.16468862    0.097944545    -0.358092327    0.02871509    -1.681448     0.0945910         -0.2577177    -0.5603710    0.04493563
   wiek                     -0.03079062    0.022342648    -0.074908957    0.01332773    -1.378109     0.1700583         -0.1020755    -0.2483343    0.04418339
   praca                     0.01562897    0.004303091     0.007131975    0.02412596     3.632032     0.0003763          0.2705051     0.1234398    0.41757051
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   ᵃ Represents reference level


 DATA SUMMARY

 Cook's Distance
 ────────────────────────────────────────────────────────────────────────
   Mean           Median         SD            Min            Max
 ────────────────────────────────────────────────────────────────────────
   0.006641780    0.001856383    0.01384060    1.347104e-6    0.1293114
 ────────────────────────────────────────────────────────────────────────


 ASSUMPTION CHECKS

 Durbin–Watson Test for Autocorrelation
 ────────────────────────────────────────────────
   Autocorrelation    DW Statistic    p
 ────────────────────────────────────────────────
       0.004038264        1.972633    0.8740000
 ────────────────────────────────────────────────


 Collinearity Statistics
 ──────────────────────────────────
            VIF         Tolerance
 ──────────────────────────────────
   plec     1.011292    0.9888343
   wiek     1.005712    0.9943207
   praca    1.016834    0.9834447
 ──────────────────────────────────


 Normality Test (Shapiro-Wilk)
 ─────────────────────────────
   Statistic    p
 ─────────────────────────────
   0.9907657    0.3541517
 ─────────────────────────────


 MODEL 2

 Model Coefficients - wypalenie
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Predictor                Estimate       SE             Lower           Upper          t             p             Stand. Estimate    Lower         Upper
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Intercept           ᵃ     2.80495045    0.502462910     1.812682629     3.79721827     5.5824030    < .0000001
   plec:
   mężczyzna – kobieta      -0.20059688    0.082634963    -0.363785071    -0.03740869    -2.4275061     0.0163056        -0.31390974    -0.5692794    -0.05854005
   wiek                     -0.01826779    0.018880775    -0.055553697     0.01901812    -0.9675338     0.3347284        -0.06056043    -0.1841687     0.06304789
   praca                     0.01446713    0.003651938     0.007255249     0.02167900     3.9614929     0.0001116         0.25039610     0.1255734     0.37521881
   prokrastynacja            0.34295064    0.053344939     0.237604622     0.44829666     6.4289255    < .0000001         0.40231000     0.2787302     0.52588976
   wsparcie                 -0.23274631    0.041247529    -0.314202267    -0.15129036    -5.6426728    < .0000001        -0.35473262    -0.4788810    -0.23058421
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   ᵃ Represents reference level


 DATA SUMMARY

 Cook's Distance
 ─────────────────────────────────────────────────────────────────────────
   Mean           Median         SD            Min            Max
 ─────────────────────────────────────────────────────────────────────────
   0.006576534    0.001916262    0.01122053    3.567571e-6    0.08255789
 ─────────────────────────────────────────────────────────────────────────


 ASSUMPTION CHECKS

 Durbin–Watson Test for Autocorrelation
 ────────────────────────────────────────────────
   Autocorrelation    DW Statistic    p
 ────────────────────────────────────────────────
      -0.008974639        1.993004    0.8880000
 ────────────────────────────────────────────────


 Collinearity Statistics
 ───────────────────────────────────────────
                     VIF         Tolerance
 ───────────────────────────────────────────
   plec              1.014905    0.9853144
   wiek              1.012571    0.9875852
   praca             1.032565    0.9684624
   prokrastynacja    1.012103    0.9880417
   wsparcie          1.021439    0.9790112
 ───────────────────────────────────────────


 Normality Test (Shapiro-Wilk)
 ─────────────────────────────
   Statistic    p
 ─────────────────────────────
   0.9962934    0.9560734
 ─────────────────────────────
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem jmv, który do VIF i testu Durbina–Watsona wywołuje pakiet car. Rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersję jamovi, której używałeś(-aś).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses [R package]. https://doi.org/10.32614/CRAN.package.jmv
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE. https://www.john-fox.ca/Companion/
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files (R package version 2.5.5) [Computer software]. https://CRAN.R-project.org/package=haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy przy korelacji i regresji w jamovi
- Zmienna nominalna zakodowana liczbami w polu Covariates. Kierunek studiów zapisany jako 1, 2, 3 w Covariates jamovi potraktuje jak liczby. Ustaw go jako Nominal i przenieś do Factors.
- Niesprawdzony poziom odniesienia. Znak współczynnika dla czynnika zależy od Reference Levels. Napisz w pracy, względem której grupy liczona jest różnica.
- Raportowanie R² modelu 2 zamiast ΔR², gdy hipoteza dotyczy przyrostu.
- Przepisanie gwiazdek zamiast dokładnego p i zapis „p = .000”. W tekście podaj p < .001.
- Sprawdzanie normalności zmiennych zamiast reszt.
Kolejne analizy z tej serii to chi-kwadrat i tabele krzyżowe w jamovi oraz regresja logistyczna w jamovi – dla wyniku tak/nie. Rachunki ręczne i odczyt wydruków przećwiczysz w zbiorze korelacja i regresja – zadania z rozwiązaniami. Jeśli chcesz, żeby ktoś sprawdził ustawienia regresji i opis wyników w Twojej pracy, skorzystaj z oferty analizy statystyczne dla studentów.
Najczęstsze pytania
Jak zrobić regresję hierarchiczną w jamovi?
W oknie Linear Regression przenieś wszystkie predyktory do pól Covariates (zmienne ilościowe) i Factors (zmienne nominalne), a potem otwórz sekcję Model Builder. Zostaw w Block 1 zmienne kontrolne, kliknij Add New Block i przeciągnij do Block 2 predyktory z hipotez. Wynik przyrostu odczytasz w tabeli Model Comparisons: ΔR², F, df1, df2 i p.
Gdzie w jamovi są współczynniki beta (β) w regresji?
W sekcji Model Coefficients zaznacz Standardized estimate, a obok niego Confidence interval, jeśli chcesz przedział dla β. W tabeli współczynników pojawi się kolumna Stand. Estimate. Dla zmiennej z pola Factors (np. płci) ta wartość to różnica grup wyrażona w odchyleniach standardowych zmiennej zależnej, bo jamovi nie standaryzuje zmiennych nominalnych.
Jak w jamovi sprawdzić VIF i odległość Cooka?
Oba wskaźniki są w sekcji Assumption Checks. Collinearity statistics daje tabelę z VIF i Tolerance dla każdego predyktora, a Cook's distance daje tabelę podsumowującą (średnia, mediana, SD, minimum i maksimum). Żeby zobaczyć, która osoba ma największą odległość Cooka, zapisz ją jako nową kolumnę w sekcji Save.
Dlaczego jamovi nie podaje przedziału ufności dla korelacji Spearmana?
W Correlation Matrix opcja Confidence intervals dotyczy tylko współczynnika Pearsona. Dla rho Spearmana tabela pokazuje współczynnik, df, p i N, ale bez granic przedziału. Jeśli promotor wymaga przedziału dla Spearmana, policz go poza jamovi, np. bootstrapem w R, i napisz w pracy, jak go uzyskano.
Czy w jamovi jest regresja krokowa (stepwise)?
Nie. Okno Linear Regression ma tylko bloki, które ustalasz sam(a) w Model Builder. To dobra wiadomość dla pracy, która sprawdza hipotezy: kolejność bloków wynika z teorii, a nie z tego, który predyktor akurat wypadł istotnie w Twojej próbie.
Powiązane hasła
Przeczytaj też
jamovi krok po kroku
Descriptives, test t Welcha, Correlation Matrix i One-Way ANOVA na jednym zbiorze danych: nazwy opcji z dokumentacji, gotowe zdania APA, kod jmv.
Czytaj →PoradnikKorelacja i regresja w SPSS
Bivariate i Linear Regression krok po kroku: które opcje zaznaczyć, jak czytać Model Summary, Coefficients i Collinearity Diagnostics, wykresy reszt i zapis APA.
Czytaj →PoradnikRegresja hierarchiczna krok po kroku
Plan bloków, wspólna próba dla wszystkich kroków, ΔR² i test F zmiany, f², interakcja w ostatnim kroku i tabela APA – z pełnym przykładem w R.
Czytaj →Masz regresję w jamovi i nie wiesz, co z niej przepisać?
Sprawdzimy Twój plik .omv: kolejność bloków, kodowanie zmiennych, założenia i wykresy reszt, a potem wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- O’Brien, R. M. (2007). A caution regarding rules of thumb for variance inflation factors. Quality & Quantity, 41(5), 673–690. https://doi.org/10.1007/s11135-006-9018-6
- Schober, P., Boer, C., & Schwarte, L. A. (2018). Correlation coefficients: Appropriate use and interpretation. Anesthesia & Analgesia, 126(5), 1763–1768. https://doi.org/10.1213/ANE.0000000000002864 ● Otwarty dostęp
- Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses (Version 2.7.7) [R package]. https://CRAN.R-project.org/package=jmv ● Otwarty dostęp: pełny tekst
- The jamovi project. (b.d.-a). Linear Regression. jamovi documentation. https://docs.jamovi.org/analyses/jg_42_regression-linear.html ● Otwarty dostęp
- The jamovi project. (b.d.-b). From SPSS to jamovi: Correlation; From SPSS to jamovi: Linear regression. jamovi documentation. https://docs.jamovi.org/spss2jamovi/s2j_linReg.html ● Otwarty dostęp
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{cook1977detection, author={Cook, R. Dennis}, title={{Detection of influential observation in linear regression}}, journal={Technometrics}, year={1977}, volume={19}, number={1}, pages={15--18}, doi={10.1080/00401706.1977.10489493}}@article{obrien2007caution, author={O’Brien, Robert M.}, title={{A caution regarding rules of thumb for variance inflation factors}}, journal={Quality \& Quantity}, year={2007}, volume={41}, number={5}, pages={673--690}, doi={10.1007/s11135-006-9018-6}}@article{schober2018correlation, author={Schober, Patrick and Boer, Christa and Schwarte, Lothar A.}, title={{Correlation coefficients: Appropriate use and interpretation}}, journal={Anesthesia \& Analgesia}, year={2018}, volume={126}, number={5}, pages={1763--1768}, doi={10.1213/ane.0000000000002864}}@misc{selker2025jmv, author={Selker, Ravi and Love, Jonathon and Dropmann, Damian}, title={{jmv: The 'jamovi' analyses (R package version 2.7.7) [Computer software]}}, year={2025}, url={https://CRAN.R-project.org/package=jmv}}@misc{jamovindlinreg, author={{The jamovi project}}, title={{Linear Regression}}, howpublished={jamovi documentation}, year={b.d.-a}, publisher={The jamovi project}, url={https://docs.jamovi.org/analyses/jg_42_regression-linear.html}}@misc{jamovinds2jlinreg, author={{The jamovi project}}, title={{From SPSS to jamovi: Correlation; From SPSS to jamovi: Linear regression}}, howpublished={jamovi documentation}, year={b.d.-b}, publisher={The jamovi project}, url={https://docs.jamovi.org/spss2jamovi/s2j_linReg.html}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}