Regresja hierarchiczna w SPSS: co tu znajdziesz
Regresja hierarchiczna sprawdza, czy kolejna grupa predyktorów wyjaśnia zmienną zależną ponad to, co wyjaśniły zmienne wprowadzone wcześniej. Jak zaplanować bloki, dlaczego ich kolejność zmienia wnioski i jak policzyć to samo w R, opisuje poradnik regresja hierarchiczna krok po kroku. Zastosowanie przy nowej skali omawia wpis trafność przyrostowa nowej skali. Tutaj zajmujemy się tylko SPSS: tym, jak zbudować bloki w oknie, które opcje zaznaczyć i co przepisać z wydruku.
Zakładamy, że znasz zwykłą regresję w SPSS z wpisu korelacja i regresja w SPSS. Wykresy reszt i diagnostyka przypadków działają tu tak samo, więc ich nie powtarzamy. Ścieżki menu, opcje i składnię sprawdziliśmy w dokumentacji IBM SPSS Statistics 32 (IBM Corp., b.d.-a, b.d.-c). Polskie nazwy podajemy według polskiej dokumentacji (IBM Corp., b.d.-b), ale w interfejsie mogą brzmieć inaczej. Części nagłówków kolumn dokumentacja nie potwierdza – odtwarzamy je z typowego wydruku. Ogólne zasady czytania wydruku zebraliśmy we wpisie jak czytać wyniki z SPSS.
Przykład i pliki do pobrania
230 osób studiujących (dane symulowane) wypełniło skalę zaangażowania w studia 1–7 (zaang, zmienna zależna). Podały też płeć (plec: 0 = kobieta, 1 = mężczyzna), wiek (wiek) i liczbę godzin pracy zarobkowej w tygodniu (praca). Wypełniły również skalę poczucia skuteczności w nauce 10–40 (skut) i skalę motywacji wewnętrznej 1–7 (motyw). Pytanie badawcze brzmi: czy poczucie skuteczności i motywacja wyjaśniają zaangażowanie ponad cechy demograficzne i pracę zarobkową?
Plan bloków ustalamy przed analizą. Blok 1 to płeć i wiek, czyli zmienne kontrolne (czy w ogóle je dodawać, rozważa wpis czy kontrolować wiek i płeć). Blok 2 to praca zarobkowa, a blok 3 – oba predyktory psychologiczne razem. Pięć osób nie podało godzin pracy, a dziewięć nie wypełniło skali motywacji. Dane pobierzesz jako plik SPSS .sav (z etykietami zmiennych i wartości) albo plik CSV.
Przygotowanie danych
Wszystkie predyktory muszą być liczbowe. Dokumentacja IBM przypomina, że zmienne jakościowe trzeba przekodować na zmienne zero-jedynkowe (IBM Corp., b.d.-a). Płeć ma już kody 0 i 1. Zmienną o trzech lub więcej kategoriach zamień na kilka zmiennych 0–1 i wprowadź je razem, w jednym bloku (zob. dummy coding). Etykiety, braki danych zdefiniowane przez użytkownika i liczenie wyniku skali opisuje wpis przygotowanie danych w SPSS.
Braki danych. Wszystkie bloki muszą być liczone na tych samych osobach, inaczej ΔR² miesza wkład zmiennych ze zmianą próby. W SPSS dzieje się to samo, jeśli wszystkie bloki ustawisz w jednym oknie regresji. Polecenie REGRESSION domyślnie obejmuje wszystkie zmienne z bloków i usuwa wiersze z brakiem w którejkolwiek z nich (IBM Corp., b.d.-c). W przykładzie każdy model, także pierwszy, opiera się więc na 216 osobach. Model 1 policzony w osobnym oknie objąłby 230 osób. Gdy braków jest dużo, rozważ imputację wielokrotną (zob. braki danych w ankiecie).
Krok 1. Bloki w oknie Linear Regression
- Wybierz Analyze → Regression → Linear (w polskiej dokumentacji: Analiza → Regresja → Liniowa). Przenieś
zaangdo pola Dependent. - Blok 1. Przenieś
pleciwiekdo Independent(s). Metodę zostaw na Enter (Wprowadź), czyli wszystkie zmienne bloku w jednym kroku. - Blok 2. Kliknij Next (Dalej), żeby otworzyć drugi blok (IBM Corp., b.d.-a, b.d.-b), i przenieś do niego
praca. - Blok 3. Jeszcze raz kliknij Next i przenieś
skutorazmotyw. Każdy blok może mieć własną metodę, dlatego sprawdź, czy przy każdym zostało Enter (IBM Corp., b.d.-a). - Statistics. Zostaw Estimates i Model fit. Koniecznie zaznacz R squared change (Zmiana R²), bo bez tej opcji wydruk nie pokaże przyrostu R² ani jego testu. Dodaj Part and partial correlations i Collinearity diagnostics. Opcja Descriptives doda liczbę ważnych obserwacji, średnie, odchylenia standardowe i macierz korelacji.
- Kliknij Paste (Wklej) zamiast OK, a potem uruchom polecenie z okna składni.
Metod Stepwise, Forward i Backward nie używaj w żadnym bloku. Program sam wybiera wtedy zmienne, a wartości istotności w wydruku są na ogół nieprawidłowe (IBM Corp., b.d.-a; zob. metoda krokowa).
Składnia do wklejenia
Polecenie zbudowaliśmy według opisu REGRESSION w Command Syntax Reference (IBM Corp., b.d.-c). Każdy blok to osobna podkomenda /METHOD=ENTER, a każda kolejna dokłada zmienne do równania z poprzedniego kroku. Słowo CHANGE odpowiada opcji R squared change. ZPP daje korelacje zerowego rzędu, cząstkowe i semicząstkowe. STATISTICS musi stać przed DEPENDENT. Składni nie uruchamialiśmy w SPSS. Liczby na tej stronie pochodzą z R.
REGRESSION
/MISSING=LISTWISE
/STATISTICS=COEFF OUTS R ANOVA CHANGE ZPP COLLIN TOL
/DEPENDENT=zaang
/METHOD=ENTER plec wiek
/METHOD=ENTER praca
/METHOD=ENTER skut motyw.
Krok 2. Model Summary: tu jest odpowiedź na pytanie
Z opcją R squared change tabela Model Summary ma jeden wiersz na każdy blok i dodatkową część ze zmianą R², jej testem F i prawdopodobieństwem (IBM Corp., b.d.-c). Nagłówki tej części odtworzyliśmy z typowego wydruku.
Tabela 1. Model Summary z Change Statistics. Liczby policzone w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS.
| Model | R | R Square | Adjusted R Square | Std. Error of the Estimate | Change Statistics | ||||
|---|---|---|---|---|---|---|---|---|---|
| R Square Change | F Change | df1 | df2 | Sig. F Change | |||||
| 1 | .067 | .004 | −.005 | .976 | .004 | .480 | 2 | 213 | .620 |
| 2 | .383 | .146 | .134 | .906 | .142 | 35.221 | 1 | 212 | .000 |
| 3 | .591 | .349 | .334 | .794 | .203 | 32.755 | 2 | 210 | .000 |
Każdy wiersz to kolejny model, czyli stan równania po dodaniu danego bloku. Czytaj je po kolei:
- Model 1: płeć i wiek wyjaśniały 0.4% wariancji zaangażowania, F(2, 213) = 0.48, p = .620. Skorygowane R² jest ujemne, bo kara za dwa predyktory przewyższa ich wkład (zob. R² skorygowany).
- Model 2: praca zarobkowa dodała 14.2 punktu procentowego, ΔR² = .142, F(1, 212) = 35.22, p < .001.
- Model 3: poczucie skuteczności i motywacja dodały razem kolejne 20.3%, ΔR² = .203, F(2, 210) = 32.76, p < .001. To odpowiedź na pytanie badawcze. df1 = 2, bo blok ma dwie zmienne; df2 to stopnie swobody reszty modelu 3.
Istotność nie mówi, czy przyrost jest duży. Policz f² Cohena dla bloku: ΔR² / (1 − R² modelu pełnego) = .203 / .651 = 0.31. To lokalna wielkość efektu bloku w kontekście całego modelu (Selya i in., 2012). Według umownych progów Cohena (1992) to efekt między średnim (0.15) a dużym (0.35). SPSS tej miary nie podaje.
Krok 3. Tabela ANOVA to nie test przyrostu
Tabela ANOVA testuje każdy model jako całość, czyli porównuje go z modelem bez predyktorów.
Tabela 2. ANOVA dla trzech modeli. Liczby policzone w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS.
| Model | Sum of Squares | df | Mean Square | F | Sig. | |
|---|---|---|---|---|---|---|
| 1 | Regression | 0.913 | 2 | 0.456 | .480 | .620 |
| Residual | 202.782 | 213 | 0.952 | |||
| Total | 203.695 | 215 | ||||
| 2 | Regression | 29.803 | 3 | 9.934 | 12.111 | .000 |
| Residual | 173.892 | 212 | 0.820 | |||
| Total | 203.695 | 215 | ||||
| 3 | Regression | 71.150 | 5 | 14.230 | 22.546 | .000 |
| Residual | 132.544 | 210 | 0.631 | |||
| Total | 203.695 | 215 |
Najczęstszy błąd to opisanie bloku 3 wynikiem F(5, 210) = 22.55 z tej tabeli. Ten test mówi tylko, że model 3 wyjaśnia cokolwiek, co wynikałoby już z samej pracy zarobkowej. Przyrost opisuje część Change Statistics z tabeli 1, a z tabeli ANOVA bierzesz tylko test modelu końcowego. Wiersz Total jest wszędzie taki sam (215 = 216 − 1), co potwierdza wspólną próbę. Sig. = .000 zapisz jako p < .001 (zob. wartość p).
Krok 4. Coefficients w kolejnych blokach
Tabela Coefficients pokazuje osobny zestaw współczynników dla każdego modelu. Kolumny korelacji pochodzą z opcji Part and partial correlations, a tolerancja i VIF z Collinearity diagnostics (IBM Corp., b.d.-a). Wiersze stałej (Constant) pominęliśmy.
Tabela 3. Coefficients dla modeli 1–3. Liczby policzone w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS.
| Model | Unstandardized Coefficients | Standardized Coefficients | t | Sig. | Correlations | Collinearity Statistics | |||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| B | Std. Error | Beta | Zero-order | Partial | Part | Tolerance | VIF | ||||
| 1 | plec | −.121 | .138 | −.060 | −.878 | .381 | −.062 | −.060 | −.060 | .996 | 1.004 |
| wiek | .012 | .031 | .026 | .375 | .708 | .030 | .026 | .026 | .996 | 1.004 | |
| 2 | plec | −.143 | .128 | −.071 | −1.115 | .266 | −.062 | −.076 | −.071 | .995 | 1.005 |
| wiek | .003 | .029 | .007 | .110 | .912 | .030 | .008 | .007 | .993 | 1.007 | |
| praca | −.033 | .006 | −.377 | −5.935 | .000 | −.376 | −.377 | −.377 | .997 | 1.003 | |
| 3 | plec | −.091 | .113 | −.045 | −.804 | .422 | −.062 | −.055 | −.045 | .991 | 1.009 |
| wiek | .031 | .026 | .068 | 1.212 | .227 | .030 | .083 | .067 | .973 | 1.028 | |
| praca | −.020 | .005 | −.225 | −3.830 | .000 | −.376 | −.256 | −.213 | .895 | 1.118 | |
| skut | .037 | .013 | .178 | 2.826 | .005 | .388 | .191 | .157 | .778 | 1.286 | |
| motyw | .316 | .055 | .370 | 5.717 | .000 | .516 | .367 | .318 | .740 | 1.351 | |
Które współczynniki raportować? Hipotezę o bloku opisuje ΔR². Przy pojedynczych predyktorach podaj b, β, t i p z modelu końcowego. Różnicę między B i Beta omawia wpis współczynniki standaryzowane czy niestandaryzowane.
Część Part to most do ΔR². Kolumna Part zawiera korelację semicząstkową. Dokumentacja IBM łączy ją wprost ze zmianą R² po dodaniu zmiennej (IBM Corp., b.d.-a). Gdy blok ma jedną zmienną, jej kwadrat równa się przyrostowi: dla pracy w modelu 2 (−.377)² = .142. Uwaga: polska dokumentacja tłumaczy zarówno Part, jak i Partial jako „korelacja częściowa” (IBM Corp., b.d.-b). Kolumna Partial to inna miara – korelacja cząstkowa.
Rysunek 1 pokazuje kolumnę Beta z trzech modeli. To wykres z R, nie zrzut ekranu z SPSS.
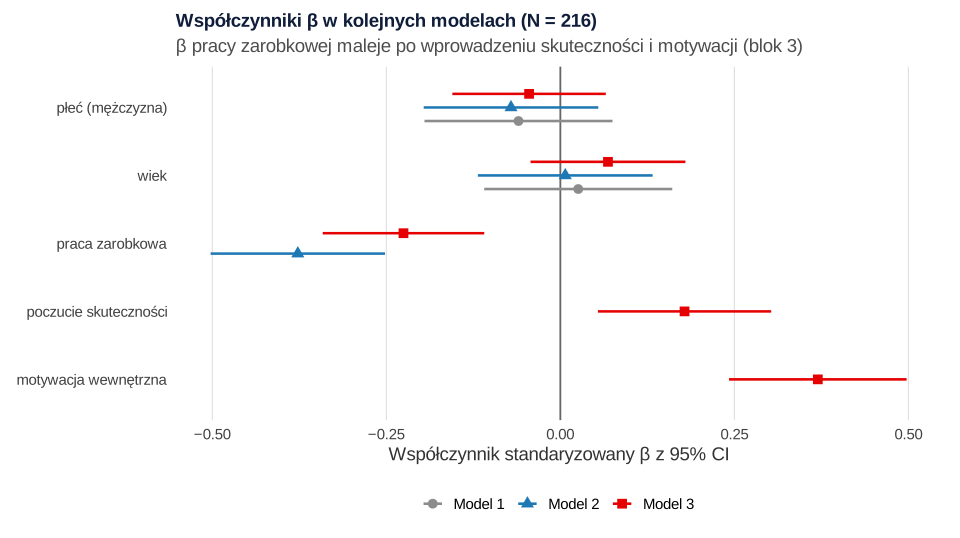
Płeć i wiek nie mają znaczenia w żadnym modelu. β pracy zarobkowej słabnie z −.38 w modelu 2 do −.23 w modelu 3, bo osoby pracujące więcej miały też niższą motywację (r = −.30) i niższe poczucie skuteczności (r = −.20). Na danych z jednego pomiaru to opis współwystępowania, a nie dowód mediacji. Mediację testuje się osobno (zob. mediacja i moderacja w SPSS z PROCESS).
VIF wynosi najwyżej 1.35, więc predyktory nie powielają się w niepokojącym stopniu. Sztywnych progów VIF nie stosuj mechanicznie (O’Brien, 2007; zob. wysoki VIF – co zrobić). Domyślnie SPSS drukuje też tabelę Excluded Variables (opcja OUTS). Pokazuje ona, jaki współczynnik miałyby zmienne z późniejszych bloków, gdyby weszły jako następne (IBM Corp., b.d.-c). Przy planowanych blokach nic z niej nie przepisujesz.
Zapis wyników w stylu APA
Petrocelli (2003) w przeglądzie artykułów z regresją hierarchiczną wskazał typowe problemy w jej użyciu. W tekście podaj plan bloków, wspólne N, ΔR² z testem F dla każdego kroku i współczynniki z modelu końcowego. Tabelę przygotuj według wzoru tabeli regresji w APA, z wierszami ΔR² pod każdym krokiem. Zdania do innych analiz złożysz w generatorze opisu wyników APA.
Jeśli nie wiesz, czy Twoje pytanie wymaga regresji hierarchicznej, czy innej analizy, sprawdź kreator doboru testu.
Te same liczby w R
SPSS nie był używany przy przygotowaniu tej strony. Liczby z tabel 1–3 policzyliśmy w R tymi samymi metodami, których używa SPSS: jedna próba bez braków we wszystkich zmiennych modelu (jak MISSING=LISTWISE), metoda najmniejszych kwadratów dla każdego bloku, test F zmiany z resztą modelu z danego kroku, β jako b × SDx / SDy, korelacje cząstkowe i semicząstkowe z wartości t oraz tolerancja i VIF z pakietu car. Uwaga: funkcja anova(m1, m2, m3) dla trzech modeli naraz dzieli przez resztę największego modelu, więc dla kroku 2 daje inne F niż SPSS – porównuj modele parami. Uruchom przepisy po kolei z folderu, w którym zapiszesz pliki danych. Przepis 1 tworzy plik CSV i plik .sav (pakiet haven).
1. Dane: CSV i plik SPSS .sav z etykietami
R
# B309 – dane przykładowe: zaangażowanie w studia a płeć, wiek, praca zarobkowa, poczucie skuteczności i motywacja
# 230 osób studiujących (dane symulowane, set.seed(3091)); plik CSV i plik SPSS .sav z etykietami zmiennych i wartości
suppressPackageStartupMessages(library(haven))
set.seed(3091)
n <- 230
plec     <- rbinom(n, 1, 0.38)                                               # 0 = kobieta, 1 = mężczyzna
wiek     <- pmin(19 + round(rgamma(n, shape = 2.2, rate = 0.75)), 30)          # wiek w latach
praca    <- ifelse(runif(n) < 0.4, 0, round(pmin(rgamma(n, shape = 3, rate = 0.17), 40)))  # godziny pracy tygodniowo
skut     <- round(pmin(pmax(28 - 0.08 * praca + rnorm(n, 0, 5), 10), 40))       # poczucie skuteczności (10–40)
motyw    <- round(pmin(pmax(1.6 + 0.09 * skut - 0.025 * praca + rnorm(n, 0, 1), 1), 7), 1)  # motywacja wewnętrzna (1–7)
zaang    <- round(pmin(pmax(1.0 - 0.10 * plec + 0.03 * wiek - 0.022 * praca + 0.045 * skut + 0.30 * motyw +
                           rnorm(n, 0, 0.72), 1), 7), 1)                       # zaangażowanie w studia (1–7)
praca[sample(n, 5)] <- NA                                                      # braki: nie podano godzin pracy
motyw[sample(which(!is.na(praca)), 9)] <- NA                                   # braki: nie wypełniono skali motywacji
dane <- data.frame(id = 1:n, plec, wiek, praca, skut, motyw, zaang)
write.csv(dane, "../regresja-hierarchiczna-spss-dane.csv", row.names = FALSE, na = "")

sav <- dane
sav$plec <- labelled(sav$plec, c("kobieta" = 0, "mężczyzna" = 1), label = "Płeć (0 = kobieta, 1 = mężczyzna)")
attr(sav$id, "label")    <- "Numer osoby"
attr(sav$wiek, "label")  <- "Wiek (lata)"
attr(sav$praca, "label") <- "Praca zarobkowa – godziny tygodniowo"
attr(sav$skut, "label")  <- "Poczucie skuteczności w nauce (10–40)"
attr(sav$motyw, "label") <- "Motywacja wewnętrzna (1–7)"
attr(sav$zaang, "label") <- "Zaangażowanie w studia (1–7)"
write_sav(sav, "../regresja-hierarchiczna-spss-dane.sav")

summary(dane[, -1])
table(plec = dane$plec)
round(sapply(dane[, -1], function(x) c(M = mean(x, na.rm = TRUE), SD = sd(x, na.rm = TRUE), n = sum(!is.na(x)))), 2)
sum(complete.cases(dane))
Wynik w R
      plec             wiek        praca           skut           motyw           zaang
 Min.   :0.0000   Min.   :19   Min.   : 0.0   Min.   :14.00   Min.   :1.000   Min.   :1.100
 1st Qu.:0.0000   1st Qu.:20   1st Qu.: 0.0   1st Qu.:23.00   1st Qu.:3.000   1st Qu.:3.025
 Median :0.0000   Median :21   Median : 7.0   Median :27.00   Median :3.700   Median :3.800
 Mean   :0.3609   Mean   :22   Mean   :10.2   Mean   :26.67   Mean   :3.724   Mean   :3.744
 3rd Qu.:1.0000   3rd Qu.:23   3rd Qu.:17.0   3rd Qu.:30.00   3rd Qu.:4.500   3rd Qu.:4.400
 Max.   :1.0000   Max.   :30   Max.   :40.0   Max.   :40.00   Max.   :6.700   Max.   :6.700
                               NA's   :5                      NA's   :9
plec
  0   1
147  83
     plec   wiek  praca   skut  motyw  zaang
M    0.36  22.00  10.20  26.67   3.72   3.74
SD   0.48   2.14  10.97   4.73   1.13   0.96
n  230.00 230.00 225.00 230.00 221.00 230.00
[1] 216
2. Regresja w trzech blokach: Model Summary, ANOVA i Coefficients
R
# Linear Regression w trzech blokach (Enter, Next): wspólna próba – braki usuwane wierszami ze wszystkich zmiennych
suppressPackageStartupMessages(library(car))
dane <- read.csv("../regresja-hierarchiczna-spss-dane.csv")
d <- na.omit(dane)                                   # jak MISSING=LISTWISE dla wszystkich zmiennych z METHOD
nrow(d)
bloki <- list(c("plec", "wiek"), "praca", c("skut", "motyw"))
modele <- lapply(seq_along(bloki), function(k)
  lm(reformulate(unlist(bloki[1:k]), "zaang"), data = d))
# Model Summary z Change Statistics: R, R Square, Adjusted R Square, Std. Error, R² change, F change, df1, df2, Sig. F change
r2 <- sapply(modele, function(m) summary(m)$r.squared)
podsum <- t(sapply(seq_along(modele), function(k) {
  s <- summary(modele[[k]]); r2_przed <- if (k == 1) 0 else r2[k - 1]
  df1 <- length(bloki[[k]]); df2 <- modele[[k]]$df.residual
  f_ch <- ((r2[k] - r2_przed) / df1) / ((1 - r2[k]) / df2)
  c(R = sqrt(r2[k]), R2 = r2[k], R2_adj = s$adj.r.squared, SE = s$sigma, dR2 = r2[k] - r2_przed,
    F_ch = f_ch, df1 = df1, df2 = df2, p_ch = pf(f_ch, df1, df2, lower.tail = FALSE))
}))
print(round(podsum, 3))
signif(podsum[, "p_ch"], 3)
# Test F zmiany funkcją anova() – parami, jak w SPSS (mianownik: reszta modelu z danego kroku)
anova(modele[[1]], modele[[2]])
anova(modele[[2]], modele[[3]])
# Uwaga: anova(m1, m2, m3) dzieli przez resztę największego modelu, więc F dla kroku 2 wychodzi inne niż w SPSS
round(anova(modele[[1]], modele[[2]], modele[[3]])$F, 3)
# ANOVA każdego modelu: Regression, Residual, Total
for (m in modele) {
  s <- summary(m); ss_res <- sum(resid(m)^2); ss_tot <- sum((d$zaang - mean(d$zaang))^2)
  print(round(c(SS_reg = ss_tot - ss_res, SS_res = ss_res, SS_tot = ss_tot, df1 = unname(s$fstatistic[2]),
                df2 = unname(s$fstatistic[3]), MS_reg = (ss_tot - ss_res) / s$fstatistic[[2]],
                MS_res = ss_res / s$fstatistic[[3]], F = unname(s$fstatistic[1]),
                p = pf(s$fstatistic[1], s$fstatistic[2], s$fstatistic[3], lower.tail = FALSE)), 3))
}
# Coefficients dla każdego modelu: B, Std. Error, Beta, t, Sig., korelacje (Zero-order, Partial, Part), Tolerance, VIF
sd_y <- sd(d$zaang)
for (k in seq_along(modele)) {
  m <- modele[[k]]; x <- unlist(bloki[1:k]); s <- summary(m)
  beta <- coef(m)[x] * sapply(d[x], sd) / sd_y
  tw <- s$coefficients[x, "t value"]
  zero <- cor(d[x], d$zaang)[, 1]                                   # korelacja zerowego rzędu
  partial <- tw / sqrt(tw^2 + m$df.residual)                        # korelacja cząstkowa
  part <- tw * sqrt((1 - s$r.squared) / m$df.residual)              # korelacja semicząstkowa (part)
  v <- if (length(x) > 1) vif(m) else setNames(1, x)
  cat("Model", k, "\n")
  print(round(cbind(s$coefficients[, 1:3], p = s$coefficients[, 4], Beta = c(NA, beta),
                    Zero = c(NA, zero), Partial = c(NA, partial), Part = c(NA, part), Tol = c(NA, 1 / v), VIF = c(NA, v)), 3))
}
signif(summary(modele[[3]])$coefficients[, 4], 3)
# Kontrola: przyrost w bloku z jedną zmienną = kwadrat jej korelacji semicząstkowej w tym modelu
s2 <- summary(modele[[2]])
round(c(dR2_blok2 = r2[2] - r2[1], part2_praca = (s2$coefficients["praca", "t value"])^2 * (1 - r2[2]) / modele[[2]]$df.residual), 4)
# f² dla bloku 3 (Cohen): ΔR² / (1 − R² modelu pełnego)
round(c(f2_blok3 = (r2[3] - r2[2]) / (1 - r2[3])), 3)
# Gdyby każdy model liczyć na wszystkich dostępnych danych (bez wspólnej próby): inne N w kroku 1
m1_all <- lm(zaang ~ plec + wiek, data = dane)
c(N_krok1_osobno = nobs(m1_all), N_wspolne = nrow(d))
# Korelacje zerowego rzędu w próbie analitycznej (do opisu)
round(cor(d[, c("zaang", "plec", "wiek", "praca", "skut", "motyw")]), 2)
Wynik w R
[1] 216
         R    R2 R2_adj    SE   dR2   F_ch df1 df2 p_ch
[1,] 0.067 0.004 -0.005 0.976 0.004  0.480   2 213 0.62
[2,] 0.383 0.146  0.134 0.906 0.142 35.221   1 212 0.00
[3,] 0.591 0.349  0.334 0.794 0.203 32.755   2 210 0.00
[1] 6.20e-01 1.19e-08 4.16e-13
Analysis of Variance Table

Model 1: zaang ~ plec + wiek
Model 2: zaang ~ plec + wiek + praca
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    213 202.78
2    212 173.89  1     28.89 35.221 1.187e-08 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Analysis of Variance Table

Model 1: zaang ~ plec + wiek + praca
Model 2: zaang ~ plec + wiek + praca + skut + motyw
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    212 173.89
2    210 132.54  2    41.348 32.755 4.155e-13 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
[1]     NA 45.772 32.755
 SS_reg  SS_res  SS_tot     df1     df2  MS_reg  MS_res       F p.value
  0.913 202.782 203.695   2.000 213.000   0.456   0.952   0.480   0.620
 SS_reg  SS_res  SS_tot     df1     df2  MS_reg  MS_res       F p.value
 29.803 173.892 203.695   3.000 212.000   9.934   0.820  12.111   0.000
 SS_reg  SS_res  SS_tot     df1     df2  MS_reg  MS_res       F p.value
 71.150 132.544 203.695   5.000 210.000  14.230   0.631  22.546   0.000
Model 1
            Estimate Std. Error t value     p   Beta   Zero Partial   Part   Tol   VIF
(Intercept)    3.514      0.692   5.079 0.000     NA     NA      NA     NA    NA    NA
plec          -0.121      0.138  -0.878 0.381 -0.060 -0.062  -0.060 -0.060 0.996 1.004
wiek           0.012      0.031   0.375 0.708  0.026  0.030   0.026  0.026 0.996 1.004
Model 2
            Estimate Std. Error t value     p   Beta   Zero Partial   Part   Tol   VIF
(Intercept)    4.047      0.648   6.241 0.000     NA     NA      NA     NA    NA    NA
plec          -0.143      0.128  -1.115 0.266 -0.071 -0.062  -0.076 -0.071 0.995 1.005
wiek           0.003      0.029   0.110 0.912  0.007  0.030   0.008  0.007 0.993 1.007
praca         -0.033      0.006  -5.935 0.000 -0.377 -0.376  -0.377 -0.377 0.997 1.003
Model 3
            Estimate Std. Error t value     p   Beta   Zero Partial   Part   Tol   VIF
(Intercept)    1.130      0.703   1.606 0.110     NA     NA      NA     NA    NA    NA
plec          -0.091      0.113  -0.804 0.422 -0.045 -0.062  -0.055 -0.045 0.991 1.009
wiek           0.031      0.026   1.212 0.227  0.068  0.030   0.083  0.067 0.973 1.028
praca         -0.020      0.005  -3.830 0.000 -0.225 -0.376  -0.256 -0.213 0.895 1.118
skut           0.037      0.013   2.826 0.005  0.178  0.388   0.191  0.157 0.778 1.286
motyw          0.316      0.055   5.717 0.000  0.370  0.516   0.367  0.318 0.740 1.351
(Intercept)        plec        wiek       praca        skut       motyw
   1.10e-01    4.22e-01    2.27e-01    1.69e-04    5.17e-03    3.70e-08
  dR2_blok2 part2_praca
     0.1418      0.1418
f2_blok3
   0.312
N_krok1_osobno      N_wspolne
           230            216
      zaang  plec  wiek praca  skut motyw
zaang  1.00 -0.06  0.03 -0.38  0.39  0.52
plec  -0.06  1.00 -0.07 -0.03 -0.03 -0.03
wiek   0.03 -0.07  1.00 -0.05 -0.11 -0.09
praca -0.38 -0.03 -0.05  1.00 -0.20 -0.30
skut   0.39 -0.03 -0.11 -0.20  1.00  0.46
motyw  0.52 -0.03 -0.09 -0.30  0.46  1.00
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. Składni SPSS nie uruchamialiśmy. W pracy podaj wersję programu, którego faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE. https://www.john-fox.ca/Companion/
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w regresji hierarchicznej w SPSS
- Brak zaznaczonej opcji R squared change. Bez niej musisz odejmować R² ręcznie i nie masz testu przyrostu.
- Każdy blok w osobnym oknie. Modele liczone na różnych osobach dają przyrosty, których nie da się porównać. Wszystkie bloki ustaw w jednym oknie przyciskiem Next.
- Test z tabeli ANOVA zamiast Sig. F Change przy opisie bloku dodanego jako ostatni.
- Stepwise w którymś bloku albo kolejność bloków ustalona po obejrzeniu wyników.
- Zmienna zero-jedynkowa z jednej zmiennej kategorialnej rozdzielona między bloki. Wszystkie kody jednej zmiennej wprowadzaj razem.
- Współczynniki z modelu 1 opisane jak wynik końcowy. Współczynnik zmiennej zmienia się po dodaniu kolejnych bloków, jak praca zarobkowa w przykładzie.
Z serii o SPSS zob. też regresja logistyczna w SPSS i ANOVA w SPSS. Jeśli chcesz, żeby ktoś sprawdził plan bloków i opis wyników w Twojej pracy, zajrzyj do oferty analizy statystyczne dla studentów.
Najczęstsze pytania
Jak ustawić bloki predyktorów w oknie Linear Regression w SPSS?
Wybierz Analyze → Regression → Linear, ustaw zmienną zależną i przenieś predyktory pierwszego bloku do Independent(s) z metodą Enter. Kliknij Next i dodaj drugi blok, potem kolejne. W Statistics zaznacz R squared change. W składni każdy blok to osobna podkomenda /METHOD=ENTER.
Gdzie w SPSS jest zmiana R²?
W oknie Linear Regression kliknij Statistics i zaznacz R squared change (w składni słowo CHANGE w /STATISTICS). Zmiana R², jej test F i istotność pojawią się w tabeli Model Summary, w osobnej części dla każdego modelu.
Co raportować z regresji hierarchicznej: Sig. z tabeli ANOVA czy Sig. F Change?
Wkład bloku opisujesz przyrostem: ΔR² oraz F zmiany z df1 i df2 i jego p z części Change Statistics w Model Summary. Tabela ANOVA testuje każdy model jako całość, więc z niej bierzesz tylko test modelu końcowego. W przykładzie blok 3 ma ΔF(2, 210) = 32.76, a cały model 3 – F(5, 210) = 22.55.
Dlaczego w regresji hierarchicznej w SPSS N jest mniejsze niż liczba osób w pliku?
Polecenie REGRESSION domyślnie usuwa każdy wiersz z brakiem w którejkolwiek zmiennej wymienionej w blokach. Dlatego wszystkie modele, także pierwszy, liczą się na tych samych osobach. W przykładzie z 230 osób zostało 216. To pożądane, bo przyrosty R² porównujesz na jednej próbie.
Które współczynniki podać z tabeli Coefficients?
Przy pojedynczych predyktorach podaj b, β, t i p z modelu końcowego. Współczynniki z wcześniejszych modeli możesz pokazać w tabeli, by zilustrować, jak zmieniają się po dodaniu bloków. Hipotezę o bloku opisuje ΔR², a nie pojedyncze β.
Powiązane hasła
Przeczytaj też
Regresja hierarchiczna krok po kroku
Plan bloków, wspólna próba dla wszystkich kroków, ΔR² i test F zmiany, f², interakcja w ostatnim kroku i tabela APA – z pełnym przykładem w R.
Czytaj →PoradnikKorelacja i regresja w SPSS
Bivariate i Linear Regression krok po kroku: które opcje zaznaczyć, jak czytać Model Summary, Coefficients i Collinearity Diagnostics, wykresy reszt i zapis APA.
Czytaj →PoradnikTrafność przyrostowa nowej skali
ΔR² z bootstrapowym CI, wagi względne i analiza dominacji, pozorny przyrost przy nierzetelnych miarach kontrolnych, przykład w R i wzór opisu.
Czytaj →PoradnikJak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →Masz regresję hierarchiczną w pracy i nie wiesz, jak opisać bloki?
Sprawdzimy plan bloków, ustawienia w SPSS i wydruk, a potem wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- IBM Corp. (b.d.-a). Linear Regression Variable Selection Methods; Linear Regression Statistics. IBM SPSS Statistics 32.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=regression-linear-variable-selection-methods ● Otwarty dostęp
- IBM Corp. (b.d.-b). Regresja liniowa: Metody wyboru zmiennych; Regresja liniowa: Statystyki. Dokumentacja IBM SPSS Statistics 32.0.0. https://www.ibm.com/docs/pl/spss-statistics/32.0.0?topic=regression-linear-variable-selection-methods ● Otwarty dostęp
- IBM Corp. (b.d.-c). REGRESSION: Overview; VARIABLES, METHOD, MISSING and STATISTICS subcommands. IBM SPSS Statistics 32.0.0 Command Syntax Reference. https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=regression-overview-command ● Otwarty dostęp
- O’Brien, R. M. (2007). A caution regarding rules of thumb for variance inflation factors. Quality & Quantity, 41(5), 673–690. https://doi.org/10.1007/s11135-006-9018-6
- Petrocelli, J. V. (2003). Hierarchical multiple regression in counseling research: Common problems and possible remedies. Measurement and Evaluation in Counseling and Development, 36(1), 9–22. https://doi.org/10.1080/07481756.2003.12069076
- Selya, A. S., Rose, J. S., Dierker, L. C., Hedeker, D., & Mermelstein, R. J. (2012). A practical guide to calculating Cohen’s f², a measure of local effect size, from PROC MIXED. Frontiers in Psychology, 3, Article 111. https://doi.org/10.3389/fpsyg.2012.00111 ● Otwarty dostęp
Cytowania BibTeX
@article{cohen1992power, author={Cohen, Jacob}, title={{A power primer}}, journal={Psychological Bulletin}, year={1992}, volume={112}, number={1}, pages={155--159}, doi={10.1037/0033-2909.112.1.155}}@misc{ibmnd32regresjabloki, author={{IBM Corp.}}, title={{Linear Regression Variable Selection Methods; Linear Regression Statistics}}, howpublished={IBM SPSS Statistics 32.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=regression-linear-variable-selection-methods}}@misc{ibmnd32regresjapl, author={{IBM Corp.}}, title={{Regresja liniowa: Metody wyboru zmiennych; Regresja liniowa: Statystyki}}, howpublished={Dokumentacja IBM SPSS Statistics 32.0.0}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/pl/spss-statistics/32.0.0?topic=regression-linear-variable-selection-methods}}@misc{ibmnd32regressionsyntax, author={{IBM Corp.}}, title={{REGRESSION: Overview; VARIABLES, METHOD, MISSING and STATISTICS subcommands}}, howpublished={IBM SPSS Statistics 32.0.0 Command Syntax Reference}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/32.0.0?topic=regression-overview-command}}@article{obrien2007caution, author={O’Brien, Robert M.}, title={{A caution regarding rules of thumb for variance inflation factors}}, journal={Quality \& Quantity}, year={2007}, volume={41}, number={5}, pages={673--690}, doi={10.1007/s11135-006-9018-6}}@article{petrocelli2003hierarchical, author={Petrocelli, John V.}, title={{Hierarchical multiple regression in counseling research: Common problems and possible remedies}}, journal={Measurement and Evaluation in Counseling and Development}, year={2003}, volume={36}, number={1}, pages={9--22}, doi={10.1080/07481756.2003.12069076}}@article{selya2012practical, author={Selya, Arielle S. and Rose, Jennifer S. and Dierker, Lisa C. and Hedeker, Donald and Mermelstein, Robin J.}, title={{A practical guide to calculating Cohen’s f², a measure of local effect size, from PROC MIXED}}, journal={Frontiers in Psychology}, year={2012}, volume={3}, eid={111}, doi={10.3389/fpsyg.2012.00111}}