Korelacja i regresja – zadania z rozwiązaniami: jak z nich korzystać
Poniżej znajdziesz korelację i regresję – zadania z rozwiązaniami w formie, w jakiej pojawiają się na kolokwium na pierwszym i drugim roku: krótka historyjka, mała tabela danych albo gotowe sumy. Zadania idą od kowariancji i r Pearsona do pytań, których nie rozwiąże sam rachunek: co pokazuje wykres reszt, która obserwacja „ciągnie” prostą i dlaczego cztery zbiory z tym samym r wyglądają zupełnie inaczej.
Każde zadanie ma ten sam układ: treść, rozwiązanie krok po kroku, interpretacja i typowy błąd. Wyniki zaokrąglamy do dwóch miejsc po kropce, a r i p do trzech; wszystkie liczby sprawdziliśmy w R (kod na końcu wpisu). Inna ostatnia cyfra przy liczeniu z tablic to zwykle skutek zaokrągleń, a nie błąd. Wzory znajdziesz w podręcznikach (King i Minium, 2009; Field, 2018) i w przeglądzie Bewicka i in. (2003). Zbiór nie powtarza zadań 7 i 10 z zadań ze statystyki na psychologii (podstawowy test r i prosta regresja z przewidywaniem).
| Zadanie | Historyjka | Co liczysz |
|---|---|---|
| 1 | reklama a sprzedaż w 8 sklepach | tabela pomocnicza, kowariancja, r Pearsona, r² |
| 2 | sen a średnia ocen (gotowe r i n) | test istotności r, r krytyczne, 95% CI z transformacji Fishera |
| 3 | zaangażowanie pracowników a liczba pomysłów | korelacja Spearmana z rangami wiązanymi |
| 4 | temperatura a sprzedaż lodów | metoda najmniejszych kwadratów z sum: b i a |
| 5 | te same dane | SST, SSR, SSE, R², F, błąd standardowy estymacji |
| 6 | prognoza sprzedaży przy 27 °C | przedział ufności dla średniej a przedział predykcji |
| 7 | dawka nawozu a plon | reszty, wykres reszt, nieliniowość |
| 8 | doświadczenie a stawka godzinowa | punkt wpływowy: dźwignia, odległość Cooka, zmiana nachylenia |
| 9 | cena mieszkania, powierzchnia i odległość od centrum | regresja wieloraka – odczyt wydruku summary(lm) |
| 10 | kwartet Anscombe’a | co pokazuje wykres, czego nie pokazują liczby |
Surowe dane do zadań (poza 2, 5 i 6) pobierzesz w pliku korelacja-regresja-zadania-dane.csv (format długi: zadanie, obserwacja, zmienna, wartość). Wartości krytyczne odczytasz z tablic rozkładów t, χ² i F.
Zadanie 1. Kowariancja i współczynnik Pearsona z tabeli pomocniczej
Treść zadania
Sieć ma 8 sklepów. W ostatnim miesiącu wydatki na reklamę lokalną (x, tys. zł) i sprzedaż (y, tys. zł) wyniosły: x: 2, 3, 5, 4, 6, 8, 7, 5; y: 30, 38, 36, 41, 44, 47, 40, 44. Zbuduj tabelę pomocniczą, oblicz kowariancję z próby, współczynnik korelacji Pearsona i r², a następnie sprawdź istotność r (α = .05).
Rozwiązanie krok po kroku
Krok 1. Średnie i tabela pomocnicza. Mx = 40 / 8 = 5.00, My = 320 / 8 = 40.00. Dla każdego sklepu policz odchylenia od średnich, ich iloczyn i kwadraty.
| Sklep | x | y | dx | dy | dxdy | dx² | dy² |
|---|---|---|---|---|---|---|---|
| 1 | 2 | 30 | −3 | −10 | 30 | 9 | 100 |
| 2 | 3 | 38 | −2 | −2 | 4 | 4 | 4 |
| 3 | 5 | 36 | 0 | −4 | 0 | 0 | 16 |
| 4 | 4 | 41 | −1 | 1 | −1 | 1 | 1 |
| 5 | 6 | 44 | 1 | 4 | 4 | 1 | 16 |
| 6 | 8 | 47 | 3 | 7 | 21 | 9 | 49 |
| 7 | 7 | 40 | 2 | 0 | 0 | 4 | 0 |
| 8 | 5 | 44 | 0 | 4 | 0 | 0 | 16 |
| Suma | 40 | 320 | 0 | 0 | SP = 58 | SSx = 28 | SSy = 202 |
Krok 2. Kowariancja (kowariancja z próby):
Krok 3. Współczynnik Pearsona – kowariancja podzielona przez SDx × SDy = 2.000 × 5.372 albo prościej z sum:
Krok 4. Istotność. t = r√(n − 2) / √(1 − r²) = 2.97; tkryt(6) = 2.447, więc odrzucasz H0, p = .025.
Interpretacja
Przy 8 sklepach przedział ufności jest bardzo szeroki. Zob. korelacja Pearsona.
Typowy błąd
Traktowanie kowariancji jako miary siły związku: po zapisaniu sprzedaży w złotych kowariancja rośnie do 8285.71, a r wciąż wynosi .771.
Zadanie 2. Test istotności r z gotowych statystyk i przedział ufności
Treść zadania
U 28 studentów korelacja liczby godzin snu w sesji ze średnią ocen wyniosła r = .38. Czy jest istotna (α = .05, dwustronnie)? Jakie najmniejsze r byłoby istotne przy tym n? Oblicz 95% przedział ufności. Co, gdyby to samo r uzyskano od 12 osób?
Rozwiązanie krok po kroku
Krok 1. Statystyka t.
Krok 2. Decyzja. tkryt(26) = 2.056 < 2.09, więc odrzucasz H0, p = .046.
Krok 3. Korelacja krytyczna. rkryt = tkryt / √(tkryt² + df) = .374 – tak powstają tablice wartości krytycznych r.
Krok 4. Przedział ufności. Rozkład r jest skośny, więc liczysz na skali z Fishera i wracasz do r:
z ± 1.96 × SE = [0.008, 0.792] → r: [.008, .660]
Krok 5. To samo r przy n = 12: t(10) = 1.30, p = .223, rkryt = .576 – inna decyzja.
Interpretacja
Dane są zgodne i z korelacją bliską zera, i z dość silną. Te obliczenia zrobisz też w kalkulatorze korelacji.
Typowy błąd
Liczenie przedziału jako r ± 1.96 × SE bez transformacji Fishera: przy dużych |r| taki przedział może nawet wyjść poza 1.
Zadanie 3. Korelacja Spearmana z rangami wiązanymi
Treść zadania
Kierowniczka oceniła zaangażowanie 10 pracowników na skali 1–5 i policzyła, ile pomysłów usprawnień każdy zgłosił w kwartale. Zaangażowanie: 4, 2, 5, 3, 3, 1, 4, 5, 2, 3. Pomysły: 6, 2, 9, 4, 3, 1, 4, 7, 3, 5. Oblicz korelację Spearmana (zaangażowanie jest zmienną porządkową).
Rozwiązanie krok po kroku
Krok 1. Rangi. W każdej zmiennej nadaj rangi od najmniejszej wartości; wiązaniom przypisz średnią z zajmowanych miejsc. Trzy osoby z oceną 3 zajmują miejsca 4–6, więc każda dostaje 5; dwie osoby z czterema pomysłami – po 5.5.
| Osoba | Zaangażowanie | Ranga Rx | Pomysły | Ranga Ry | d | d² |
|---|---|---|---|---|---|---|
| 1 | 4 | 7.5 | 6 | 8.0 | −0.5 | 0.25 |
| 2 | 2 | 2.5 | 2 | 2.0 | 0.5 | 0.25 |
| 3 | 5 | 9.5 | 9 | 10.0 | −0.5 | 0.25 |
| 4 | 3 | 5.0 | 4 | 5.5 | −0.5 | 0.25 |
| 5 | 3 | 5.0 | 3 | 3.5 | 1.5 | 2.25 |
| 6 | 1 | 1.0 | 1 | 1.0 | 0.0 | 0.00 |
| 7 | 4 | 7.5 | 4 | 5.5 | 2.0 | 4.00 |
| 8 | 5 | 9.5 | 7 | 9.0 | 0.5 | 0.25 |
| 9 | 2 | 2.5 | 3 | 3.5 | −1.0 | 1.00 |
| 10 | 3 | 5.0 | 5 | 7.0 | −2.0 | 4.00 |
| Suma d² | 12.50 | |||||
Krok 2. Wzór uproszczony.
Krok 3. Wersja dokładna. Wzór z Σd² jest dokładny tylko bez wiązań. Przy wiązaniach policz Pearsona na rangach (jak w zadaniu 1): rs = .922, p < .001 – ten wynik zwraca cor.test(…, method = "spearman").
Interpretacja
Różnica .924 vs .922 jest tu kosmetyczna, ale przy wielu wiązaniach bywa wyraźna. Kiedy wybrać Spearmana, opisują Schober i in. (2018) i hasło korelacja Spearmana.
Typowy błąd
Nadawanie wiązaniom kolejnych rang (4, 5, 6) zamiast średniej (5, 5, 5) – wynik zależy wtedy od kolejności wpisania osób.
Zadanie 4. Metoda najmniejszych kwadratów z sum
Treść zadania
Przez 10 dni notowano temperaturę w południe (x, °C) i liczbę porcji lodów sprzedanych w budce (y). Temperatura: 18, 21, 24, 19, 26, 28, 23, 30, 22, 25. Porcje: 80, 100, 145, 88, 130, 154, 117, 176, 118, 125. Prowadzący podaje sumy: Σx = 236, Σy = 1233, Σxy = 30076, Σx² = 5700, Σy² = 159999. Wyznacz prostą regresji i zinterpretuj współczynniki.
Rozwiązanie krok po kroku
Krok 1. Nachylenie. Metoda najmniejszych kwadratów wybiera prostą o najmniejszej sumie kwadratów reszt. Przy gotowych sumach użyj wzoru „z sum”:
Krok 2. Wyraz wolny (prosta przechodzi przez punkt średnich):
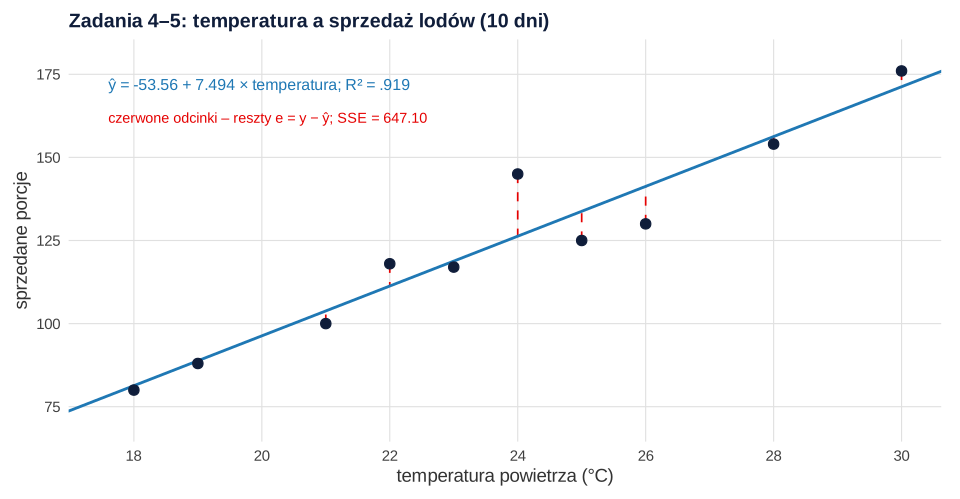
Krok 3. Równanie. ŷ = −53.56 + 7.494 × temperatura. Przy 20 °C: ŷ = −53.56 + 7.494 × 20 = 96.32 porcji.
Interpretacja
Każdy dodatkowy stopień wiązał się średnio z ok. 7.5 porcji więcej. Wyraz wolny −53.56 to formalnie sprzedaż przy 0 °C – bez sensu, bo zero leży daleko poza zakresem danych (18–30 °C); jest tylko „kotwicą” prostej. Zob. regresja liniowa.
Typowy błąd
Pomylenie (Σx)² z Σx²: 236² = 55696, a Σx² = 5700. Mianownik nΣx² − (Σx)² musi być dodatni – to dobra kontrola.
Zadanie 5. Rozkład sum kwadratów, R² i test F
Treść zadania
Dla danych z zadania 4 rozłóż zmienność sprzedaży na część wyjaśnioną i resztową, oblicz R², błąd standardowy estymacji i test F (α = .05).
Rozwiązanie krok po kroku
Krok 1. Całkowita suma kwadratów. SST = Σy² − (Σy)² / n = 159999 − 1233² / 10 = 7970.10.
Krok 2. Suma kwadratów regresji. Potrzebujesz SSx = Σx² − (Σx)² / n = 5700 − 236² / 10 = 130.40. Wtedy SSR = b² × SSx = 7.494² × 130.40 = 7323.00 (z b zaokrąglonym do trzech miejsc kalkulator pokaże ok. 7323.3; 7323.00 to wynik R z pełną precyzją).
Krok 3. Reszty. SSE = SST − SSR = 647.10 (suma kwadratów czerwonych odcinków z rysunku 1).
| Źródło | SS | df | MS | F |
|---|---|---|---|---|
| Regresja | 7323.00 | 1 | 7323.00 | 90.53 |
| Reszty | 647.10 | 8 | 80.89 | |
| Ogółem | 7970.10 | 9 |
Krok 4. R² i błąd estymacji. R² = 7323.00 / 7970.10 = .919; se = √MSE = √80.89 = 8.99 porcji (typowe odchylenie dnia od prostej).
Krok 5. Test F. F(1, 8) = 7323.00 / 80.89 = 90.53 > Fkryt = 5.32, p < .001. To kwadrat testu t dla nachylenia: SE(b) = 8.99 / √130.40 = 0.788, t = 9.51, 9.51² = 90.53.
Interpretacja
Skorygowane R² = .909 – niewiele mniej, bo model ma jeden predyktor (zob. współczynnik determinacji).
Typowy błąd
Dzielenie SSE przez n − 1 zamiast n − 2 – szacujesz dwa parametry (a i b), więc reszty mają 8 stopni swobody.
Zadanie 6. Prognoza: przedział ufności dla średniej a przedział predykcji
Treść zadania
Na sobotę zapowiadają 27 °C. Z modelu z zadań 4–5 (se = 8.99, SSx = 130.40, Mx = 23.60, n = 10) oblicz (a) 95% przedział ufności dla średniej sprzedaży w dni o 27 °C, (b) 95% przedział predykcji dla tej soboty. Który przyda się do zamówienia lodów?
Rozwiązanie krok po kroku
Krok 1. Prognoza punktowa. ŷ0 = −53.56 + 7.494 × 27 = 148.78 porcji.
Krok 2. Składnik odległości. Im dalej od średniej x, tym mniej pewna prosta:
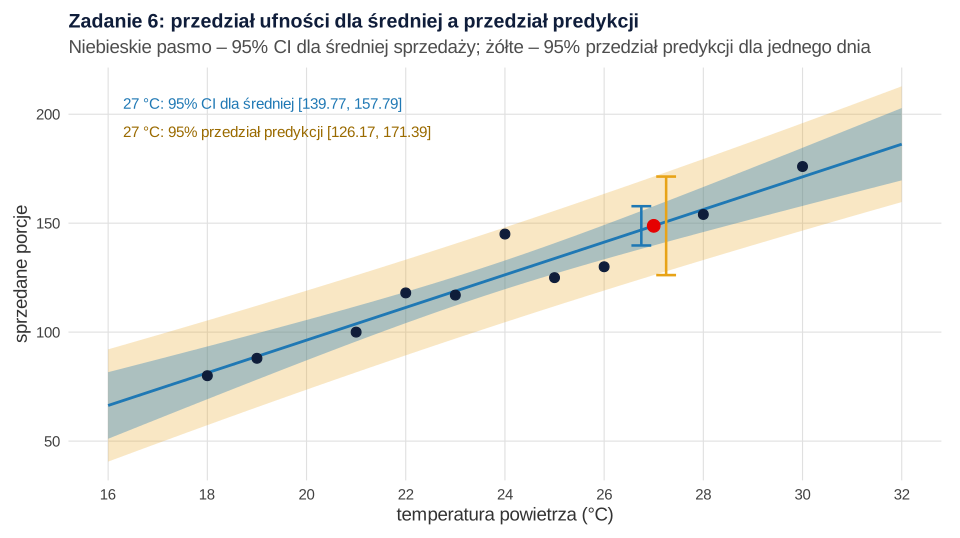
Krok 3. Przedział ufności dla średniej. SE = 8.99 × √0.189 = 3.91; tkryt(8) = 2.306.
Krok 4. Przedział predykcji. Dla jednego dnia dochodzi rozrzut obserwacji wokół prostej („1 +” pod pierwiastkiem): SE = 8.99 × √(1 + 0.189) = 9.81.
Interpretacja
Przeciętna sprzedaż w dni o 27 °C to 148.78 porcji, 95% CI [139.77, 157.79], ale w konkretną sobotę może wynieść od ok. 126 do ok. 171 porcji – ten szerszy przedział przyda się do zamówienia. Nawet przy średniej temperaturze przedział predykcji (szerokość 43.50) jest ponad trzy razy szerszy niż przedział dla średniej (13.12).
Typowy błąd
Podawanie przedziału dla średniej jako zakresu jutrzejszej sprzedaży. Przy dużej próbie kurczy się on prawie do punktu, a przedział predykcji nigdy nie jest węższy niż ok. ±1.96se.
Zadanie 7. Reszty i wykres reszt
Treść zadania
Na 8 poletkach doświadczalnych zastosowano różne dawki nawozu azotowego (kg/ha) i zmierzono plon (dt/ha). Dawka: 0, 10, 20, 30, 40, 50, 60, 70. Plon: 30, 38, 45, 50, 53, 55, 56, 56. Model liniowy: ŷ = 35.17 + 0.363 × dawka, R² = .867. Oblicz reszty i oceń na wykresie reszt, czy model jest odpowiedni.
Rozwiązanie krok po kroku
Krok 1. Reszty. Dla każdego poletka policz ŷ i resztę e = y − ŷ:
| Dawka | Plon y | ŷ | Reszta e |
|---|---|---|---|
| 0 | 30 | 35.17 | −5.17 |
| 10 | 38 | 38.80 | −0.80 |
| 20 | 45 | 42.43 | 2.57 |
| 30 | 50 | 46.06 | 3.94 |
| 40 | 53 | 49.69 | 3.31 |
| 50 | 55 | 53.32 | 1.68 |
| 60 | 56 | 56.95 | −0.95 |
| 70 | 56 | 60.58 | −4.58 |
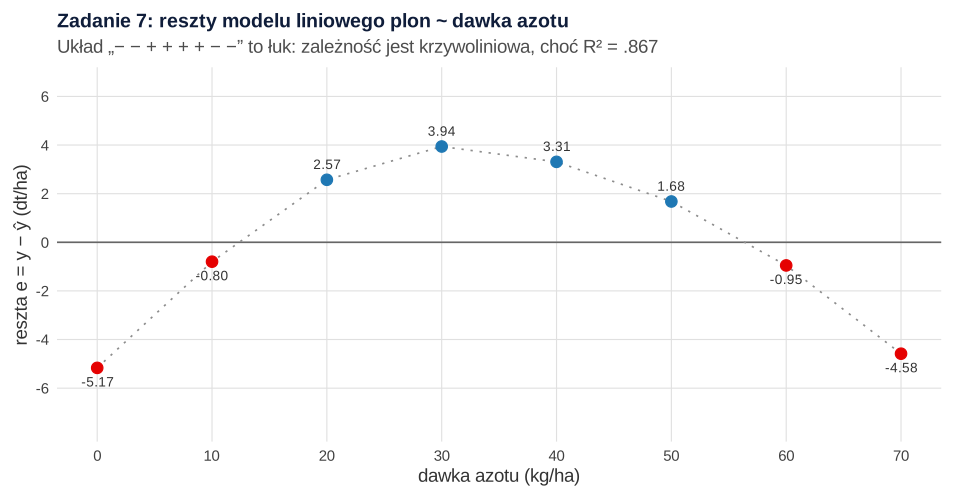
Krok 2. Kontrola i wzór. Suma reszt = 0.00 (w regresji z wyrazem wolnym zawsze), więc nic nie mówi o jakości modelu. Znaki tworzą ciąg „− − + + + + − −”: na krańcach prosta przeszacowuje plon, w środku go niedoszacowuje.
Interpretacja
Mimo R² = .867 model liniowy jest źle określony: plon rośnie coraz wolniej i się wypłaszcza. Model z członem kwadratowym ma R² = .999, a se spada z 3.77 do 0.42 dt/ha. Inne wykresy diagnostyczne omawia poradnik diagnostyka regresji w R.
Typowy błąd
Ocenianie modelu tylko po R² – wysokie R² nie znaczy, że związek jest liniowy.
Zadanie 8. Punkt wpływowy, który zmienia nachylenie
Treść zadania
W małej firmie zebrano dane 10 pracowników: lata doświadczenia i stawkę godzinową (zł). Lata: 1, 2, 3, 4, 5, 6, 7, 8, 9, 20. Stawka: 25, 28, 27, 31, 33, 32, 36, 37, 39, 30. Osoba 10 to emerytowany specjalista na pół etatu. Porównaj prostą z osobą 10 i bez niej, oblicz jej dźwignię i odległość Cooka.
Rozwiązanie krok po kroku
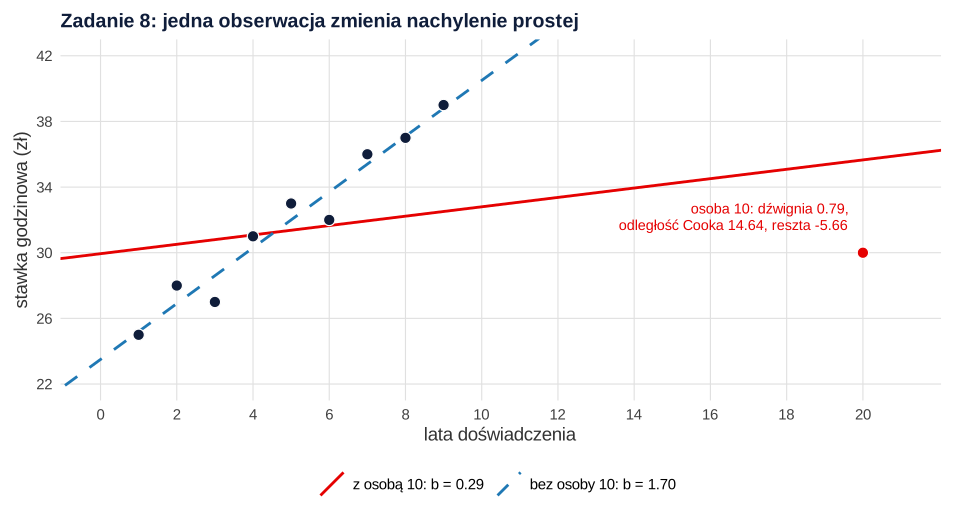
Krok 1. Dwie proste. Z osobą 10: ŷ = 29.94 + 0.286 × lata (r = .340). Bez osoby 10: ŷ = 23.50 + 1.700 × lata (r = .976). Jedna obserwacja zmienia nachylenie prawie sześciokrotnie.
Krok 2. Dźwignia (dźwignia – odległość od średniej x):
Próg 2p/n = 0.40 (p – liczba parametrów); pozostałe osoby mają od 0.101 do 0.215.
Krok 3. Odległość Cooka (Cook, 1977) łączy resztę i dźwignię (liczysz ją w programie): osoba 10 – 14.64, pozostali najwyżej 0.233; progi 4/n = 0.40 albo 1.
Interpretacja
Osoba 10 leży daleko w osi x i nie pasuje do trendu – to połączenie czyni ją wpływową. Jej reszta (−5.66) nie jest jednak największa (osoba 9: 6.49), bo prosta „ugięła się” w jej stronę; samo przeglądanie reszt jej nie wykryje. Model bez niej dałby dla 20 lat 57.50 zł – to ekstrapolacja poza zakres 1–9 lat. W pracy podaj oba wyniki (analiza wrażliwości).
Typowy błąd
Usuwanie obserwacji, bo „psuje” wynik – trzeba to uzasadnić merytorycznie i zgłosić (wartości odstające: jak je wykryć).
Zadanie 9. Regresja wieloraka – odczyt wydruku summary(lm)
Treść zadania
Studentka zebrała 30 ogłoszeń mieszkań: cenę (tys. zł), powierzchnię (m²) i odległość od centrum (km), i dopasowała lm(cena ~ pow + odl):
Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) 267.4358    22.5776   11.85 3.34e-12 ***
pow           8.1526     0.4969   16.41 1.44e-15 ***
odl         -28.3551     3.2003   -8.86 1.78e-09 ***
---
Residual standard error: 37.6 on 27 degrees of freedom
Multiple R-squared:  0.9098,	Adjusted R-squared:  0.9031
F-statistic: 136.2 on 2 and 27 DF,  p-value: 7.85e-15
(a) Zapisz równanie i zinterpretuj współczynniki. (b) Oceń istotność. (c) Przewidź cenę 50 m² w odległości 4 km. (d) W regresji prostej cena ~ odl nachylenie wynosi +4.42 (p = .591). Skąd zmiana znaku?
Rozwiązanie krok po kroku
(a) ŷ = 267.44 + 8.153 × powierzchnia − 28.355 × odległość. Każdy metr kwadratowy to średnio 8.15 tys. zł więcej przy tej samej odległości, każdy kilometr od centrum – 28.36 tys. zł mniej przy tej samej powierzchni. Wyraz wolny nie ma sensu praktycznego (0 m²).
(b) Model: F(2, 27) = 136.2, p < .001 (7.85e-15 to 0.00000000000000785). Oba predyktory: |t| = 16.41 i 8.86 > tkryt(27) = 2.052. R² = .91, skorygowane R² = .90 (regresja wieloraka), se = 37.6 tys. zł.
(c)
Z zaokrąglonymi współczynnikami kalkulator pokaże 561.67; 561.65 to wynik predict() z pełną precyzją.
(d) Powierzchnia i odległość korelują (r = .624): dalej od centrum są większe mieszkania. W regresji prostej odległość niesie też efekt powierzchni, który maskuje spadek ceny; model z dwoma predyktorami te efekty rozdziela.
Interpretacja
Dane są symulowane. Pełną analizę z założeniami pokazuje poradnik regresja wieloraka krok po kroku.
Typowy błąd
Wnioskowanie z surowych współczynników (8.15 vs −28.36), który predyktor „ważniejszy” – są w różnych jednostkach.
Zadanie 10. Kwartet Anscombe’a: co pokazuje wykres
Treść zadania
Cztery zbiory danych po 11 punktów (wbudowany w R zbiór anscombe) mają niemal identyczne statystyki: średnią x = 9, średnią y = 7.50, SDx = 3.32, SDy = 2.03, r = .816 (w zbiorze 4: .817), prostą ŷ = 3.00 + 0.500x i R² = .67. Na podstawie rysunku 5 opisz zbiory i wskaż, gdzie regresja liniowa jest odpowiednia.
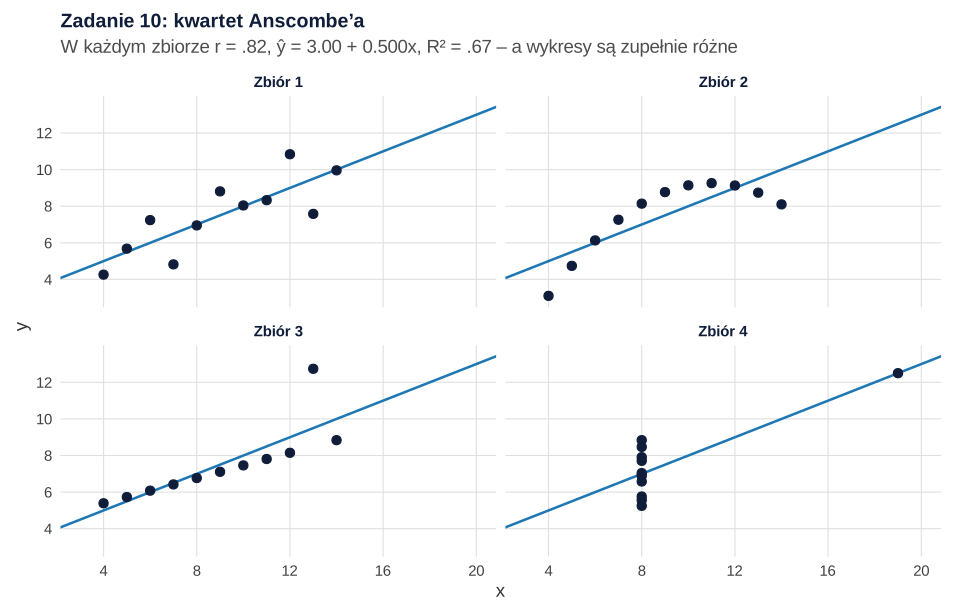
anscombe z pakietu datasets).Rozwiązanie krok po kroku
Zbiór 1. Losowy rozrzut wokół prostej – jedyny, który model liniowy dobrze opisuje.
Zbiór 2. Gładki łuk: zależność krzywoliniowa (model z x² ma R² = 1.000), jak w zadaniu 7.
Zbiór 3. Dziesięć punktów na prostej i jeden odstający (x = 13, y = 12.74); bez niego b = 0.345 i r = 1.000.
Zbiór 4. Dziesięć punktów przy x = 8 i jeden przy x = 19 z dźwignią 1.00 – cała „korelacja” wynika z jednego punktu, jak skrajna wersja zadania 8.
Interpretacja
Te same liczby mogą opisywać zupełnie różne dane, dlatego wykres rozrzutu rysuje się przed liczeniem r – po to Anscombe (1973) skonstruował te zbiory (zob. kwartet Anscombe’a).
Typowy błąd
Odpowiedź „wszystkie zbiory mają silny związek liniowy, bo r = .82” – prawdziwa tylko dla zbioru 1.
Ściąga wzorów do zadań z korelacji i regresji
| Wielkość | Wzór | Szybka kontrola |
|---|---|---|
| r Pearsona | SP / √(SSxSSy) | zawsze od −1 do 1 |
| Test r | t = r√(n − 2) / √(1 − r²), df = n − 2 | to samo t co dla nachylenia b |
| Spearman | Pearson na rangach (bez wiązań: 1 − 6Σd² / [n(n² − 1)]) | suma rang = n(n + 1)/2 |
| Nachylenie | b = SP / SSx = r × SDy / SDx | mianownik dodatni |
| Wyraz wolny | a = My − bMx | prosta przechodzi przez (Mx, My) |
| R² | SSR / SST = 1 − SSE / SST | w regresji prostej R² = r² |
| CI dla średniej / predykcji | ŷ0 ± t × se√([1 +] 1/n + (x0 − Mx)² / SSx) | predykcja zawsze szersza |
Korelacja i regresja opisują związek, ale same nie dowodzą przyczynowości: w zadaniu 1 większe sklepy mogą mieć i większy budżet reklamowy, i więcej klientów (korelacja a przyczynowość). Dłuższy przykład z opisem APA: korelacja Pearsona i Spearmana krok po kroku.
Inne zbiory zadań ze statystyki
Ten wpis należy do serii zbiorów zadań z rozwiązaniami: zadania ze statystyki na psychologii, statystyka opisowa, prawdopodobieństwo i rozkłady, estymacja i testowanie hipotez, testy nieparametryczne i statystyka medyczna. Gdy przyjdzie czas na regresję we własnej pracy dyplomowej, możesz skorzystać z konsultacji analizy statystycznej dla studentów.
Sprawdź wyniki w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z rozwiązań na danych wpisanych w kod (bez losowania). Każde zadanie jest policzone dwa razy: najpierw wzorem, tak jak na kartce, potem gotową funkcją R jako kontrola. Rysunki i plik CSV powstały w osobnym skrypcie, który wczytuje dane z tych przepisów.
Zadania 1–3: kowariancja, korelacja Pearsona, test istotności r i korelacja Spearmana
R
# B381 – zadania 1–3: kowariancja i korelacja Pearsona z tabeli pomocniczej, test istotności r, korelacja Spearmana
# Dane wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R (stats).
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x) sub("^(-?)0\\.", "\\1.", z3(x))   # bez zera przed kropką (p, r, r²)
pp <- function(p) if (p < .001) "< .001" else paste("=", bz(p))   # zapis p jak w APA

# Zadanie 1. Wydatki na reklamę (tys. zł) i sprzedaż (tys. zł) w 8 sklepach
reklama  <- c(2, 3, 5, 4, 6, 8, 7, 5)
sprzedaz <- c(30, 38, 36, 41, 44, 47, 40, 44)
n1 <- length(reklama)
dx <- reklama - mean(reklama); dy <- sprzedaz - mean(sprzedaz)
pomoc <- data.frame(sklep = 1:n1, x = reklama, y = sprzedaz, dx = dx, dy = dy, dxdy = dx * dy, dx2 = dx^2, dy2 = dy^2)
cat("Zadanie 1\n")
print(pomoc, row.names = FALSE)
SP <- sum(dx * dy); SSx <- sum(dx^2); SSy <- sum(dy^2)
cat("Sumy: SP =", SP, "; SSx =", SSx, "; SSy =", SSy, "\n")
cat("Kowariancja z próby = SP / (n - 1) =", z2(SP / (n1 - 1)), "; kontrola cov() =", z2(cov(reklama, sprzedaz)), "\n")
cat("SD x =", z3(sd(reklama)), "; SD y =", z3(sd(sprzedaz)), "\n")
r1 <- SP / sqrt(SSx * SSy)
cat("r = SP / sqrt(SSx * SSy) =", SP, "/", z2(sqrt(SSx * SSy)), "=", bz(r1), "\n")
cat("r = cov / (SDx * SDy) =", bz(cov(reklama, sprzedaz) / (sd(reklama) * sd(sprzedaz))), "; r^2 =", bz(r1^2), "\n")
ct1 <- cor.test(reklama, sprzedaz)
cat("t(", n1 - 2, ") = r * sqrt(n - 2) / sqrt(1 - r^2) =", z2(r1 * sqrt(n1 - 2) / sqrt(1 - r1^2)), "; t krytyczne =", z3(qt(0.975, n1 - 2)), "\n")
cat("Kontrola cor.test(): r =", bz(ct1$estimate), "; t(", ct1$parameter, ") =", z2(ct1$statistic), "; p =", bz(ct1$p.value),
    "; 95% CI [", z2(ct1$conf.int), "]\n")
cat("Błąd: kowariancja w innych jednostkach (sprzedaż w zł zamiast tys. zł) =", z2(cov(reklama, sprzedaz * 1000)),
    "; r =", bz(cor(reklama, sprzedaz * 1000)), "\n\n")

# Zadanie 2. Test istotności r z gotowych statystyk: r = .38 przy n = 28 (sen a średnia ocen)
r2 <- 0.38; n2 <- 28; df2 <- n2 - 2
t2 <- r2 * sqrt(df2) / sqrt(1 - r2^2)
tkr <- qt(0.975, df2)
cat("Zadanie 2\n")
cat("t(", df2, ") =", z2(t2), "; t krytyczne =", z3(tkr), "; p =", bz(2 * pt(-abs(t2), df2)), "\n")
cat("r krytyczne dla n = 28 (alfa = .05, dwustronnie) =", bz(tkr / sqrt(tkr^2 + df2)), "\n")
zf <- atanh(r2); se_z <- 1 / sqrt(n2 - 3)
cat("Fisher z =", z3(zf), "; SE =", z3(se_z), "; z +/- 1.96 SE: [", z3(zf - qnorm(0.975) * se_z), ",", z3(zf + qnorm(0.975) * se_z), "]\n")
cat("95% CI dla r = [", bz(tanh(zf - qnorm(0.975) * se_z)), ",", bz(tanh(zf + qnorm(0.975) * se_z)), "]\n")
r2_12 <- 0.38; t12 <- r2_12 * sqrt(10) / sqrt(1 - r2_12^2)
cat("Ten sam r przy n = 12: t( 10 ) =", z2(t12), "; p =", bz(2 * pt(-abs(t12), 10)), "; r krytyczne =",
    bz(qt(0.975, 10) / sqrt(qt(0.975, 10)^2 + 10)), "\n\n")

# Zadanie 3. Korelacja Spearmana z rangami wiązanymi: zaangażowanie (ocena 1–5) i liczba zgłoszonych pomysłów (10 pracowników)
zaang   <- c(4, 2, 5, 3, 3, 1, 4, 5, 2, 3)
pomysly <- c(6, 2, 9, 4, 3, 1, 4, 7, 3, 5)
Rx <- rank(zaang); Ry <- rank(pomysly); d <- Rx - Ry
cat("Zadanie 3\n")
print(data.frame(osoba = 1:10, zaang, rx = Rx, pomysly, ry = Ry, d = d, d2 = d^2), row.names = FALSE)
n3 <- length(d)
cat("Suma d^2 =", sum(d^2), "\n")
rs_wzor <- 1 - 6 * sum(d^2) / (n3 * (n3^2 - 1))
cat("rs (wzór uproszczony) = 1 - 6 *", sum(d^2), "/ (10 * 99) =", bz(rs_wzor), "\n")
cat("rs (Pearson na rangach, poprawnie przy wiązaniach) =", bz(cor(Rx, Ry)), "\n")
ct3 <- cor.test(zaang, pomysly, method = "spearman", exact = FALSE)
cat("Kontrola cor.test(method = 'spearman'): rho =", bz(ct3$estimate), "; p", pp(ct3$p.value), "\n")
cat("Dla porównania Pearson na surowych danych: r =", bz(cor(zaang, pomysly)), "\n")
Wynik w R
Zadanie 1
 sklep x  y dx  dy dxdy dx2 dy2
     1 2 30 -3 -10   30   9 100
     2 3 38 -2  -2    4   4   4
     3 5 36  0  -4    0   0  16
     4 4 41 -1   1   -1   1   1
     5 6 44  1   4    4   1  16
     6 8 47  3   7   21   9  49
     7 7 40  2   0    0   4   0
     8 5 44  0   4    0   0  16
Sumy: SP = 58 ; SSx = 28 ; SSy = 202
Kowariancja z próby = SP / (n - 1) = 8.29 ; kontrola cov() = 8.29
SD x = 2.000 ; SD y = 5.372
r = SP / sqrt(SSx * SSy) = 58 / 75.21 = .771
r = cov / (SDx * SDy) = .771 ; r^2 = .595
t( 6 ) = r * sqrt(n - 2) / sqrt(1 - r^2) = 2.97 ; t krytyczne = 2.447
Kontrola cor.test(): r = .771 ; t( 6 ) = 2.97 ; p = .025 ; 95% CI [ 0.15 0.96 ]
Błąd: kowariancja w innych jednostkach (sprzedaż w zł zamiast tys. zł) = 8285.71 ; r = .771

Zadanie 2
t( 26 ) = 2.09 ; t krytyczne = 2.056 ; p = .046
r krytyczne dla n = 28 (alfa = .05, dwustronnie) = .374
Fisher z = 0.400 ; SE = 0.200 ; z +/- 1.96 SE: [ 0.008 , 0.792 ]
95% CI dla r = [ .008 , .660 ]
Ten sam r przy n = 12: t( 10 ) = 1.30 ; p = .223 ; r krytyczne = .576

Zadanie 3
 osoba zaang  rx pomysly   ry    d   d2
     1     4 7.5       6  8.0 -0.5 0.25
     2     2 2.5       2  2.0  0.5 0.25
     3     5 9.5       9 10.0 -0.5 0.25
     4     3 5.0       4  5.5 -0.5 0.25
     5     3 5.0       3  3.5  1.5 2.25
     6     1 1.0       1  1.0  0.0 0.00
     7     4 7.5       4  5.5  2.0 4.00
     8     5 9.5       7  9.0  0.5 0.25
     9     2 2.5       3  3.5 -1.0 1.00
    10     3 5.0       5  7.0 -2.0 4.00
Suma d^2 = 12.5
rs (wzór uproszczony) = 1 - 6 * 12.5 / (10 * 99) = .924
rs (Pearson na rangach, poprawnie przy wiązaniach) = .922
Kontrola cor.test(method = 'spearman'): rho = .922 ; p < .001
Dla porównania Pearson na surowych danych: r = .916
Zadania 4–10: metoda najmniejszych kwadratów, R², przedziały, reszty, punkt wpływowy, regresja wieloraka i kwartet Anscombe’a
R
# B381 – zadania 4–10: metoda najmniejszych kwadratów, R² i sumy kwadratów, przedział ufności i predykcji,
# reszty, punkt wpływowy, regresja wielokrotna, kwartet Anscombe’a
# Dane wpisane na sztywno – te same co w treści zadań (kwartet Anscombe’a: zbiór anscombe z pakietu datasets).
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x) sub("^(-?)0\\.", "\\1.", z3(x))
pp <- function(p) if (p < .001) "< .001" else paste("=", bz(p))

# Zadanie 4. Temperatura (°C) a sprzedaż lodów (porcje) w 10 dniach – metoda najmniejszych kwadratów z sum
temp <- c(18, 21, 24, 19, 26, 28, 23, 30, 22, 25)
lody <- c(80, 100, 145, 88, 130, 154, 117, 176, 118, 125)
n <- length(temp)
Sx <- sum(temp); Sy <- sum(lody); Sxy <- sum(temp * lody); Sxx <- sum(temp^2); Syy <- sum(lody^2)
cat("Zadanie 4\n")
cat("n =", n, "; Sx =", Sx, "; Sy =", Sy, "; Sxy =", Sxy, "; Sx2 =", Sxx, "; Sy2 =", Syy, "\n")
licznik <- n * Sxy - Sx * Sy; mianownik <- n * Sxx - Sx^2
b <- licznik / mianownik; a <- Sy / n - b * Sx / n
cat("b = (n*Sxy - Sx*Sy) / (n*Sx2 - Sx^2) =", licznik, "/", mianownik, "=", z3(b), "\n")
cat("a = My - b * Mx =", z2(Sy / n), "-", z3(b), "*", z2(Sx / n), "=", z2(a), "\n")
m4 <- lm(lody ~ temp)
cat("Kontrola lm():", z3(coef(m4)), "\n")
cat("Przewidywana sprzedaż przy 20 st. C =", z2(a + b * 20), "; przy 0 st. C =", z2(a), "\n\n")

# Zadanie 5. Rozkład sum kwadratów, R², F i błąd standardowy estymacji (te same dane)
yhat <- fitted(m4); e <- resid(m4)
SST <- sum((lody - mean(lody))^2); SSR <- sum((yhat - mean(lody))^2); SSE <- sum(e^2)
cat("Zadanie 5\n")
cat("SST = Sy2 - Sy^2 / n =", Syy, "-", Sy, "^2 /", n, "=", z2(Syy - Sy^2 / n), "; kontrola =", z2(SST), "\n")
cat("SSR = b^2 * SSx =", z2(b^2 * (Sxx - Sx^2 / n)), "; SSE = SST - SSR =", z2(SST - SSR), "; kontrola sum(e^2) =", z2(SSE), "\n")
cat("SSx = Sx2 - Sx^2 / n =", z2(Sxx - Sx^2 / n), "\n")
F5 <- (SSR / 1) / (SSE / (n - 2))
cat("R^2 = SSR / SST =", bz(SSR / SST), "; MSE =", z2(SSE / (n - 2)), "; s_e =", z2(sqrt(SSE / (n - 2))), "\n")
cat("F(1,", n - 2, ") =", z2(F5), "; F krytyczne =", z2(qf(0.95, 1, n - 2)), "; p", pp(pf(F5, 1, n - 2, lower.tail = FALSE)), "\n")
cat("SE(b) =", z3(sqrt(SSE / (n - 2)) / sqrt(Sxx - Sx^2 / n)), "; t =", z2(b / (sqrt(SSE / (n - 2)) / sqrt(Sxx - Sx^2 / n))),
    "; t^2 =", z2((b / (sqrt(SSE / (n - 2)) / sqrt(Sxx - Sx^2 / n)))^2), "\n")
print(anova(m4))
s4 <- summary(m4)
cat("Kontrola summary(): R^2 =", bz(s4$r.squared), "; skorygowane R^2 =", bz(s4$adj.r.squared), "; s_e =", z2(s4$sigma), "\n")
cat("95% CI dla b: [", z2(confint(m4)[2, ]), "]\n\n")

# Zadanie 6. Przedział ufności dla średniej i przedział predykcji przy 27 st. C
x0 <- 27; se_e <- s4$sigma; SSx <- Sxx - Sx^2 / n; tkr <- qt(0.975, n - 2)
y0 <- a + b * x0
h <- 1 / n + (x0 - mean(temp))^2 / SSx
cat("Zadanie 6\n")
cat("y0 =", z2(y0), "; Mx =", z2(mean(temp)), "; 1/n + (x0 - Mx)^2 / SSx =", z3(h), "; t krytyczne =", z3(tkr), "\n")
cat("SE średniej =", z2(se_e * sqrt(h)), "; 95% CI = [", z2(y0 - tkr * se_e * sqrt(h)), ",", z2(y0 + tkr * se_e * sqrt(h)), "]\n")
cat("SE predykcji =", z2(se_e * sqrt(1 + h)), "; 95% PI = [", z2(y0 - tkr * se_e * sqrt(1 + h)), ",", z2(y0 + tkr * se_e * sqrt(1 + h)), "]\n")
cat("Kontrola predict(confidence):", z2(predict(m4, data.frame(temp = x0), interval = "confidence")), "\n")
cat("Kontrola predict(prediction):", z2(predict(m4, data.frame(temp = x0), interval = "prediction")), "\n")
cat("Szerokość CI i PI przy 23.6 st. C (średnia):", z2(diff(predict(m4, data.frame(temp = mean(temp)), interval = "confidence")[2:3])),
    z2(diff(predict(m4, data.frame(temp = mean(temp)), interval = "prediction")[2:3])), "\n\n")

# Zadanie 7. Reszty: dawka nawozu azotowego (kg/ha) a plon (dt/ha) na 8 poletkach
dawka <- c(0, 10, 20, 30, 40, 50, 60, 70)
plon  <- c(30, 38, 45, 50, 53, 55, 56, 56)
m7 <- lm(plon ~ dawka)
cat("Zadanie 7\n")
cat("Równanie: a =", z2(coef(m7)[1]), "; b =", z3(coef(m7)[2]), "; R^2 =", bz(summary(m7)$r.squared), "\n")
print(data.frame(dawka, plon, y_hat = round(fitted(m7), 2), reszta = round(resid(m7), 2)), row.names = FALSE)
cat("Suma reszt =", z2(sum(resid(m7))), "; znaki reszt:", ifelse(resid(m7) > 0, "+", "-"), "\n")
m7k <- lm(plon ~ dawka + I(dawka^2))
cat("Model z dawka^2: R^2 =", bz(summary(m7k)$r.squared), "; s_e liniowy =", z2(summary(m7)$sigma),
    "; s_e kwadratowy =", z2(summary(m7k)$sigma), "\n\n")

# Zadanie 8. Punkt wpływowy: lata doświadczenia a stawka godzinowa (zł) u 10 osób
lata   <- c(1, 2, 3, 4, 5, 6, 7, 8, 9, 20)
stawka <- c(25, 28, 27, 31, 33, 32, 36, 37, 39, 30)
m8 <- lm(stawka ~ lata); m8bez <- lm(stawka ~ lata, subset = -10)
cat("Zadanie 8\n")
cat("Z osobą 10:  a =", z2(coef(m8)[1]), "; b =", z3(coef(m8)[2]), "; r =", bz(cor(lata, stawka)), "\n")
cat("Bez osoby 10: a =", z2(coef(m8bez)[1]), "; b =", z3(coef(m8bez)[2]), "; r =", bz(cor(lata[-10], stawka[-10])), "\n")
h8 <- 1 / 10 + (lata - mean(lata))^2 / sum((lata - mean(lata))^2)
cat("Dźwignia osoby 10 ze wzoru = 1/10 + (20 -", z2(mean(lata)), ")^2 /", z2(sum((lata - mean(lata))^2)), "=", z3(h8[10]), "\n")
print(data.frame(osoba = 1:10, lata, stawka, reszta = round(resid(m8), 2), dzwignia = round(hatvalues(m8), 3),
                 cook = round(cooks.distance(m8), 3)), row.names = FALSE)
cat("Próg dźwigni 2p/n =", z2(2 * 2 / 10), "; próg Cooka 4/n =", z2(4 / 10), "\n")
cat("Przewidywana stawka osoby 10 z modelu bez niej =", z2(predict(m8bez, data.frame(lata = 20))), "\n\n")

# Zadanie 9. Regresja wielokrotna: cena mieszkania (tys. zł) a powierzchnia (m²) i odległość od centrum (km), 30 ofert
pow <- c(46, 55, 44, 43, 88, 36, 47, 32, 36, 71, 55, 76, 49, 90, 74, 81, 69, 36, 38, 81, 65, 51, 76, 38, 51, 58, 39, 31, 35, 51)
odl <- c(4.3, 8.3, 5.9, 3.2, 14.2, 3.2, 4, 4.2, 9.8, 6.4, 6.7, 10.2, 5.7, 6.7, 4, 7.3, 9.7, 4.2, 3.1, 7.8, 8.6, 8.9, 8.3, 1.4,
         7.2, 9.3, 3.9, 4.7, 4.3, 5)
cena <- c(553, 456, 445, 553, 606, 459, 580, 499, 217, 633, 493, 629, 542, 767, 708, 743, 588, 450, 482, 726, 561, 388, 648,
          510, 503, 469, 415, 353, 456, 576)
m9 <- lm(cena ~ pow + odl)
cat("Zadanie 9\n")
print(summary(m9))
cat("Przewidywana cena (50 m2, 4 km) =", z2(predict(m9, data.frame(pow = 50, odl = 4))), "\n")
cat("Ręcznie:", z2(coef(m9)[1]), "+", z3(coef(m9)[2]), "* 50 +", "(", z3(coef(m9)[3]), ") * 4 =",
    z2(coef(m9)[1] + coef(m9)[2] * 50 + coef(m9)[3] * 4), "\n")
cat("Korelacja powierzchnia–odległość: r =", bz(cor(pow, odl)), "\n")
cat("Regresja prosta cena ~ odl: b =", z2(coef(lm(cena ~ odl))[2]), "; p", pp(summary(lm(cena ~ odl))$coefficients[2, 4]),
    "; cena ~ pow: b =", z2(coef(lm(cena ~ pow))[2]), "\n")
cat("t krytyczne (df = 27) =", z3(qt(0.975, 27)), "\n")
print(round(confint(m9), 2))
cat("\n")

# Zadanie 10. Kwartet Anscombe’a (zbiór anscombe w R): te same statystyki, różne wykresy
cat("Zadanie 10\n")
kw <- do.call(rbind, lapply(1:4, function(i) {
  x <- anscombe[[paste0("x", i)]]; y <- anscombe[[paste0("y", i)]]; m <- lm(y ~ x)
  data.frame(zbior = i, Mx = mean(x), My = round(mean(y), 2), SDx = round(sd(x), 2), SDy = round(sd(y), 2),
             r = round(cor(x, y), 3), a = round(coef(m)[1], 2), b = round(coef(m)[2], 3), R2 = round(summary(m)$r.squared, 2))
}))
print(kw, row.names = FALSE)
m10_3 <- lm(y3 ~ x3, data = anscombe); i3 <- which.max(abs(resid(m10_3)))
cat("Zbiór 3: punkt odstający nr", i3, "(x =", anscombe$x3[i3], ", y =", anscombe$y3[i3], "); bez niego b =",
    z3(coef(lm(y3 ~ x3, data = anscombe[-i3, ]))[2]), "; r =", bz(cor(anscombe$x3[-i3], anscombe$y3[-i3])), "\n")
m10_4 <- lm(y4 ~ x4, data = anscombe); i4 <- which.max(anscombe$x4)
cat("Zbiór 4: różne wartości x:", sort(unique(anscombe$x4)), "; punkt nr", i4, "(x =", anscombe$x4[i4], ", y =", anscombe$y4[i4],
    "); dźwignia =", z2(hatvalues(m10_4)[i4]), "\n")
m10_2 <- lm(y2 ~ x2 + I(x2^2), data = anscombe)
cat("Zbiór 2: model z x^2 – R^2 =", z3(summary(m10_2)$r.squared), "\n")
Wynik w R
Zadanie 4
n = 10 ; Sx = 236 ; Sy = 1233 ; Sxy = 30076 ; Sx2 = 5700 ; Sy2 = 159999
b = (n*Sxy - Sx*Sy) / (n*Sx2 - Sx^2) = 9772 / 1304 = 7.494
a = My - b * Mx = 123.30 - 7.494 * 23.60 = -53.56
Kontrola lm(): -53.555 7.494
Przewidywana sprzedaż przy 20 st. C = 96.32 ; przy 0 st. C = -53.56

Zadanie 5
SST = Sy2 - Sy^2 / n = 159999 - 1233 ^2 / 10 = 7970.10 ; kontrola = 7970.10
SSR = b^2 * SSx = 7323.00 ; SSE = SST - SSR = 647.10 ; kontrola sum(e^2) = 647.10
SSx = Sx2 - Sx^2 / n = 130.40
R^2 = SSR / SST = .919 ; MSE = 80.89 ; s_e = 8.99
F(1, 8 ) = 90.53 ; F krytyczne = 5.32 ; p < .001
SE(b) = 0.788 ; t = 9.51 ; t^2 = 90.53
Analysis of Variance Table

Response: lody
          Df Sum Sq Mean Sq F value    Pr(>F)
temp       1 7323.0  7323.0  90.534 1.229e-05 ***
Residuals  8  647.1    80.9
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Kontrola summary(): R^2 = .919 ; skorygowane R^2 = .909 ; s_e = 8.99
95% CI dla b: [ 5.68 9.31 ]

Zadanie 6
y0 = 148.78 ; Mx = 23.60 ; 1/n + (x0 - Mx)^2 / SSx = 0.189 ; t krytyczne = 2.306
SE średniej = 3.91 ; 95% CI = [ 139.77 , 157.79 ]
SE predykcji = 9.81 ; 95% PI = [ 126.17 , 171.39 ]
Kontrola predict(confidence): 148.78 139.77 157.79
Kontrola predict(prediction): 148.78 126.17 171.39
Szerokość CI i PI przy 23.6 st. C (średnia): 13.12 43.50

Zadanie 7
Równanie: a = 35.17 ; b = 0.363 ; R^2 = .867
 dawka plon y_hat reszta
     0   30 35.17  -5.17
    10   38 38.80  -0.80
    20   45 42.43   2.57
    30   50 46.06   3.94
    40   53 49.69   3.31
    50   55 53.32   1.68
    60   56 56.95  -0.95
    70   56 60.58  -4.58
Suma reszt = 0.00 ; znaki reszt: - - + + + + - -
Model z dawka^2: R^2 = .999 ; s_e liniowy = 3.77 ; s_e kwadratowy = 0.42

Zadanie 8
Z osobą 10:  a = 29.94 ; b = 0.286 ; r = .340
Bez osoby 10: a = 23.50 ; b = 1.700 ; r = .976
Dźwignia osoby 10 ze wzoru = 1/10 + (20 - 6.50 )^2 / 262.50 = 0.794
 osoba lata stawka reszta dzwignia   cook
     1    1     25  -5.23    0.215  0.233
     2    2     28  -2.51    0.177  0.040
     3    3     27  -3.80    0.147  0.071
     4    4     31  -0.09    0.124  0.000
     5    5     33   1.63    0.109  0.009
     6    6     32   0.34    0.101  0.000
     7    7     36   4.06    0.101  0.050
     8    8     37   4.77    0.109  0.076
     9    9     39   6.49    0.124  0.165
    10   20     30  -5.66    0.794 14.635
Próg dźwigni 2p/n = 0.40 ; próg Cooka 4/n = 0.40
Przewidywana stawka osoby 10 z modelu bez niej = 57.50

Zadanie 9

Call:
lm(formula = cena ~ pow + odl)

Residuals:
    Min      1Q  Median      3Q     Max
-66.050 -30.733   1.906  25.592  89.772

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) 267.4358    22.5776   11.85 3.34e-12 ***
pow           8.1526     0.4969   16.41 1.44e-15 ***
odl         -28.3551     3.2003   -8.86 1.78e-09 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 37.6 on 27 degrees of freedom
Multiple R-squared:  0.9098,	Adjusted R-squared:  0.9031
F-statistic: 136.2 on 2 and 27 DF,  p-value: 7.85e-15

Przewidywana cena (50 m2, 4 km) = 561.65
Ręcznie: 267.44 + 8.153 * 50 + ( -28.355 ) * 4 = 561.65
Korelacja powierzchnia–odległość: r = .624
Regresja prosta cena ~ odl: b = 4.42 ; p = .591 ; cena ~ pow: b = 5.40
t krytyczne (df = 27) = 2.052
             2.5 % 97.5 %
(Intercept) 221.11 313.76
pow           7.13   9.17
odl         -34.92 -21.79

Zadanie 10
 zbior Mx  My  SDx  SDy     r a   b   R2
     1  9 7.5 3.32 2.03 0.816 3 0.5 0.67
     2  9 7.5 3.32 2.03 0.816 3 0.5 0.67
     3  9 7.5 3.32 2.03 0.816 3 0.5 0.67
     4  9 7.5 3.32 2.03 0.817 3 0.5 0.67
Zbiór 3: punkt odstający nr 3 (x = 13 , y = 12.74 ); bez niego b = 0.345 ; r = 1.000
Zbiór 4: różne wartości x: 8 19 ; punkt nr 8 (x = 19 , y = 12.5 ); dźwignia = 1.00
Zbiór 2: model z x^2 – R^2 = 1.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base, stats i datasets); rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jaki wzór na współczynnik korelacji wybrać na kolokwium – z odchyleń czy z sum?
Oba dają ten sam wynik. Wzór z odchyleń, r = SP / √(SSx × SSy), jest wygodny, gdy średnie są liczbami całkowitymi (zadanie 1). Gdy średnie mają długie rozwinięcie albo prowadzący podaje gotowe sumy Σx, Σxy, Σx², użyj wzoru z sum (zadanie 4), bo unikasz zaokrąglania odchyleń.
Czym różni się przedział predykcji od przedziału ufności w regresji?
Przedział ufności dotyczy średniej wartości y przy danym x, a przedział predykcji – pojedynczej nowej obserwacji, dlatego zawsze jest szerszy. W zadaniu 6 przy 27 °C pierwszy ma szerokość ok. 18 porcji, a drugi ok. 45 porcji, bo pod pierwiastkiem dochodzi składnik 1 za rozrzut pojedynczych dni wokół prostej.
Kiedy zamiast korelacji Pearsona policzyć korelację Spearmana?
Gdy co najmniej jedna zmienna jest porządkowa (np. ocena 1–5), gdy związek jest monotoniczny, ale nie liniowy, albo gdy pojedyncze skrajne wartości mocno wpływają na r. Przy rangach wiązanych nadaj im średnią rangę i policz Pearsona na rangach – wzór z Σd² jest wtedy tylko przybliżeniem.
Czy wysokie R² oznacza, że model regresji liniowej jest dobry?
Nie. W zadaniu 7 R² = .867, a mimo to reszty układają się w łuk, czyli prosta źle opisuje zależność. W kwartecie Anscombe’a cztery zbiory mają to samo R² = .67, a tylko jeden pasuje do modelu liniowego. Zawsze obejrzyj wykres rozrzutu i wykres reszt.
Jak sprawdzić, czy jedna obserwacja nie zmienia wyniku regresji?
Policz dźwignię i odległość Cooka (w R: hatvalues() i cooks.distance()) i porównaj nachylenie z tą obserwacją i bez niej. W zadaniu 8 osoba z dźwignią .79 i odległością Cooka 14.64 zmienia nachylenie z 1.70 na 0.29, choć jej reszta nie jest największa w próbie.
Powiązane hasła
Przeczytaj też
Zadania ze statystyki z rozwiązaniami
Wszystkie zbiory zadań w jednym miejscu: tabela działów, poziomów i kierunków, dziewięć przykładowych zadań, ściąga wyboru testu i najczęstsze błędy.
Czytaj →PoradnikKorelacja Pearsona i Spearmana krok po kroku
Wybór miary, wykres rozrzutu, przedział ufności z transformacji Fishera, siła r, korelacja cząstkowa, macierz w APA i opis wyników z kodem R.
Czytaj →PoradnikDiagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →Masz własne dane do pracy i nie wiesz, który test wybrać?
Pomożemy dobrać analizę do hipotez, sprawdzimy obliczenia w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Bewick, V., Cheek, L., & Ball, J. (2003). Statistics review 7: Correlation and regression. Critical Care, 7(6), 451–459. https://doi.org/10.1186/cc2401 ● Otwarty dostęp
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Field, A. (2018). Discovering statistics using IBM SPSS Statistics (5th ed.). SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Schober, P., Boer, C., & Schwarte, L. A. (2018). Correlation coefficients: Appropriate use and interpretation. Anesthesia & Analgesia, 126(5), 1763–1768. https://doi.org/10.1213/ANE.0000000000002864 ● Otwarty dostęp
Cytowania BibTeX
@article{anscombe1973graphs, author={Anscombe, Francis J.}, title={{Graphs in statistical analysis}}, journal={The American Statistician}, year={1973}, volume={27}, number={1}, pages={17--21}, doi={10.1080/00031305.1973.10478966}}@article{bewick2003statistics, author={Bewick, Viv and Cheek, Liz and Ball, Jonathan}, title={{Statistics review 7: Correlation and regression}}, journal={Critical Care}, year={2003}, volume={7}, number={6}, pages={451--459}, doi={10.1186/cc2401}}@article{cook1977detection, author={Cook, R. Dennis}, title={{Detection of influential observation in linear regression}}, journal={Technometrics}, year={1977}, volume={19}, number={1}, pages={15--18}, doi={10.1080/00401706.1977.10489493}}@book{field2018discovering, author={Field, Andy}, title={{Discovering statistics using IBM SPSS Statistics}}, year={2018}, edition={5th}, publisher={SAGE}}@book{king2009statystyka, author={King, Bruce M. and Minium, Edward W.}, title={{Statystyka dla psychologów i pedagogów}}, year={2009}, publisher={Wydawnictwo Naukowe PWN}}@article{schober2018correlation, author={Schober, Patrick and Boer, Christa and Schwarte, Lothar A.}, title={{Correlation coefficients: Appropriate use and interpretation}}, journal={Anesthesia \& Analgesia}, year={2018}, volume={126}, number={5}, pages={1763--1768}, doi={10.1213/ane.0000000000002864}}