Przykład: sieć 30 sklepów z elektroniką
Fikcyjna sieć 30 sklepów z elektroniką użytkową co kilka tygodni daje rabat na jeden model w kategorii: słuchawki, ładowarki albo głośniki. Rabaty mają głębokość od 10 do 40%. Dyrektor handlowy pyta: jaki rabat daje najwięcej zysku, a nie tylko najwyższy słupek sprzedaży?
Mamy 104 tygodnie z każdego sklepu i kategorii, czyli 9360 wierszy i 810 promocji. W każdym wierszu jest głębokość rabatu, liczba sprzedanych sztuk promowanego modelu i liczba sztuk pozostałych produktów tej kategorii. Poza promocją sklep sprzedaje średnio 12.66 sztuki promowanych słuchawek, 30.72 ładowarki i 6.49 głośnika tygodniowo. W tygodniach promocji – 52.78, 132.40 i 29.86. Dane pobierzesz jako rabat-elektronika-sprzedaz-tygodniowa.csv.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Reakcja na rabat ma kształt litery S: do ok. 15% prawie nic się nie dzieje, od ok. 30% sprzedaż przestaje rosnąć. Przed promocją i po niej sprzedaż spada, a inne produkty kategorii tracą klientów. Centrala daje promocje częściej i głębsze w sezonie (Black Friday, grudzień, powrót do szkoły, głośniki także latem): promocja trafiła na 13.7% tygodni sezonu i 7.7% pozostałych, ze średnim rabatem 33.2% wobec 24.7%. Te wartości, ceny i marże ustawiliśmy ręcznie; powiązanie promocji z sezonem wzmocniliśmy po pierwszym przebiegu, by pułapka z rysunku 6 była widoczna. Ziarna 656 nie zmieniano.
Pytanie o głębokość rabatu to pytanie o kształt zależności, jak przy zależności dawka–odpowiedź. Stałą reakcję na cenę regularną opisuje wpis o elastyczności cenowej, a różnice efektu promocji między sklepami – model mieszany. Tu pytamy: jak głęboko i co zostaje po odjęciu kosztów ukrytych.
Rysunek 1: sprzedaż bazowa, szczyt i dołek
Najpierw schemat: z czego składa się słupek z tygodnia promocji. To prawdziwe parametry sieci dla słuchawek przy rabacie 25% w sklepie, który bez promocji sprzedaje 10 sztuk tygodniowo.
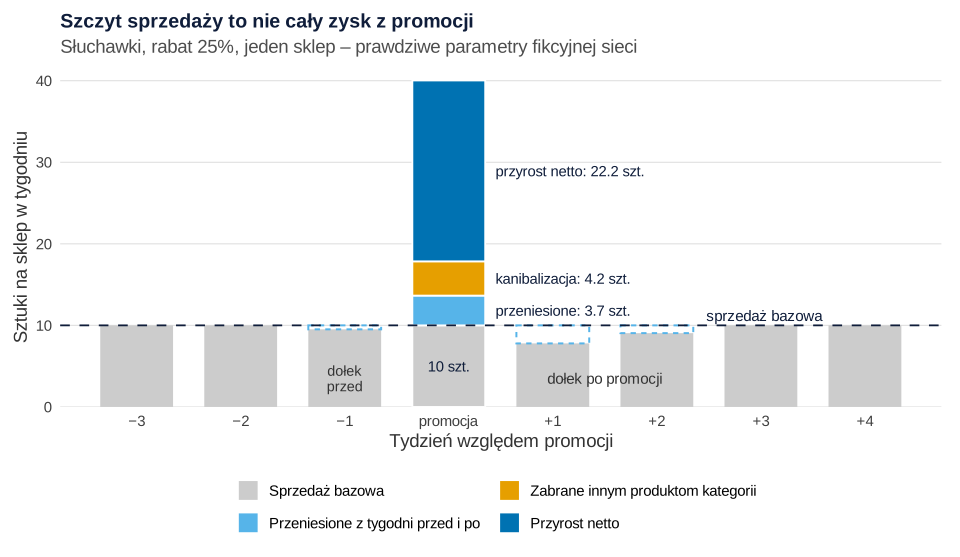
Co widać. W tygodniu promocji sklep sprzedaje 40 sztuk zamiast 10. Część tych klientów i tak by kupiła, tylko w innym tygodniu: przed promocją czekają na nią, a po niej mają już słuchawki. To 3.7 sztuki dołka. Kolejne 4.2 sztuki kupiłoby inne słuchawki z tej samej półki – to kanibalizacja w kategorii. Przyrost netto to 22.2 sztuki, czyli 74% przyrostu z tygodnia promocji.
Jak może zmylić. W danych z kasy tych części nie widać osobno. Dołki giną w szumie i trudno je wykryć prostym modelem i na oko; van Heerde i in. (2000) oszacowali je na 4–25% efektu bieżącego.
Podpis do pracy:
Rysunek 2: jak wyglądają dane
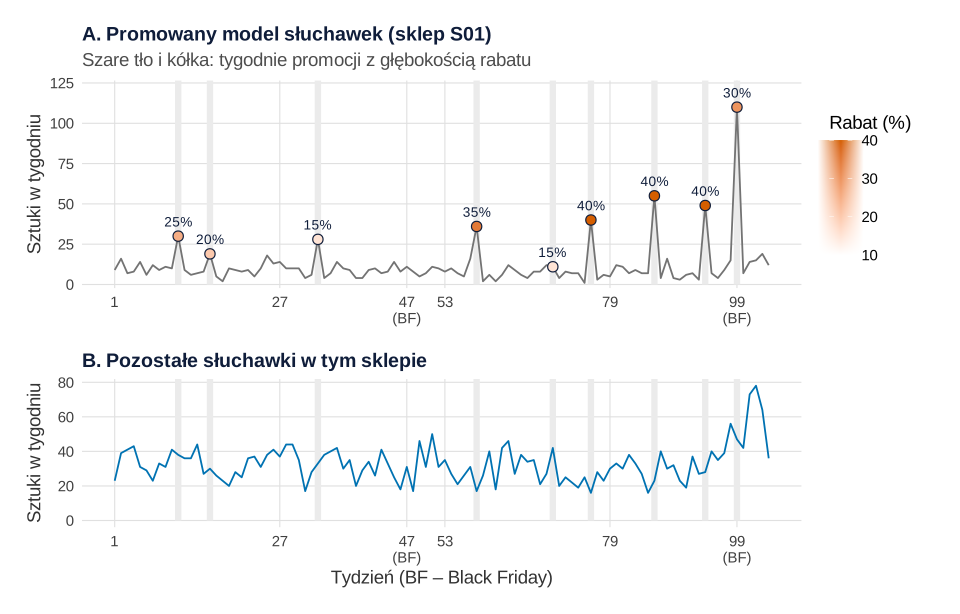
set.seed(656)).Co widać. Szczyty rosną z rabatem, ale nierówno: przy 15% sklep sprzedał 11 i 28 sztuk, przy 40% – od 40 do 55 sztuk. Najwyższy szczyt, 110 sztuk przy rabacie 30%, przypada na Black Friday (tydzień 99). Po niektórych szczytach widać słabszy tydzień.
Jak może zmylić. Na jednym sklepie łatwo pomylić rabat z sezonem: najgłębsze rabaty padają w najlepszych tygodniach. Dlatego model porównuje sklep z promocją z innymi sklepami w tym samym tygodniu (efekty stałe tygodnia).
Podpis do pracy:
Rysunek 3: krzywa odpowiedzi na głębokość rabatu
Sztuki to zliczenie, a rabat działa jak mnożnik, więc używamy regresji Poissona z efektami stałymi sklepu × kategorii i tygodnia × kategorii (sezon i wspólne szoki), z rabatem z sąsiednich tygodni (rysunek 4) i błędami odpornymi na klastrowanie po sklepach. Rabat wchodzi na cztery sposoby:
- liniowo – każdy punkt procentowy rabatu mnoży sprzedaż o tyle samo;
- segmentowo – dwie proste z punktami załamania (próg i nasycenie) wybranymi siatką, jak w regresji segmentowej;
- splajnem naturalnym z węzłami przy 15 i 25% – gładka krzywa bez zakładania kształtu (splajny i GAM);
- osobnym efektem każdego poziomu (10, 15, …, 40%) – możliwe, bo rabaty mają tylko siedem wartości.
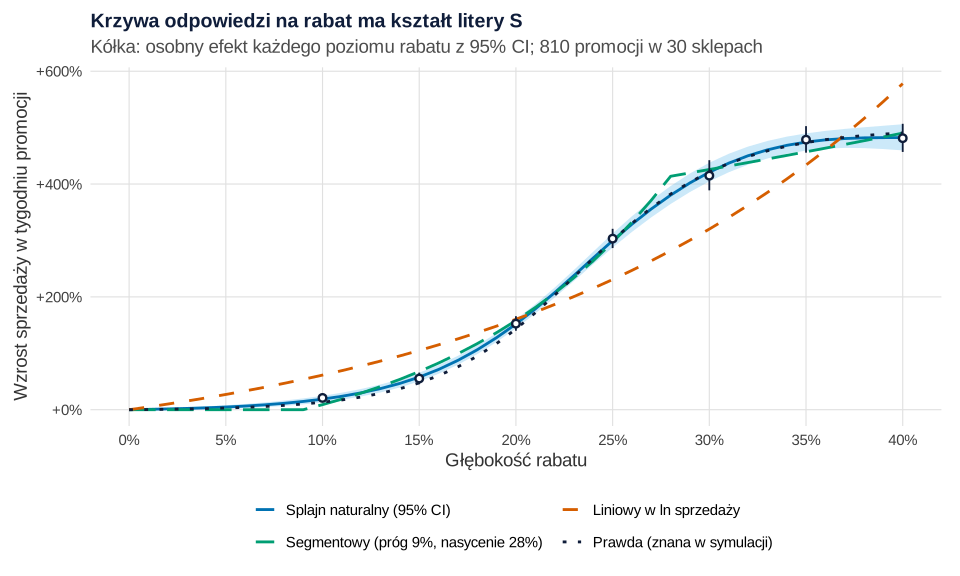
set.seed(656)).Co widać. Splajn daje +19% przy rabacie 10%, +300%, 95% CI [287, 312], przy 25% i +482% [460, 506] przy 40% (prawda: +13%, +300%, +491%). Każde kolejne 5 punktów procentowych dokłada najpierw 39, potem 94, 148 i 121 punktów procentowych wzrostu, a powyżej 30% już tylko 53 i 8. Model segmentowy znalazł próg przy 9% i nasycenie przy 28%.
Jak może zmylić. Model liniowy w ln sprzedaży zawyża efekt rabatu 10% (+61%) i 40% (+578%), a zaniża środek krzywej (+231% przy 25%). Jego AIC to 60765.2, wobec 59514.5 dla segmentowego, 59459.0 dla splajnu i 59463.6 dla osobnych poziomów. Wynik splajnu zależy od węzłów: różne funkcje splajnowe dają różne krzywe, głównie przez wybór liczby węzłów lub wygładzenia (Perperoglou i in., 2019). Między 0 a 10% danych nie ma.
Kształt S ma oparcie w literaturze. W eksperymencie intencja zakupu nie zmieniała się, dopóki rabat nie przekroczył progu, a powyżej punktu nasycenia dalszy rabat niewiele zmieniał (Gupta i Cooper, 1992). Na danych sklepowych efekty progu i nasycenia znaleźli van Heerde i in. (2001).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: dołek po promocji i kanibalizacja
Dołki mierzy ten sam model – rabat z tygodni przed i po promocji to osobne zmienne. Kanibalizację mierzy drugi model: sprzedaż reszty kategorii zależy od krzywej odpowiedzi promowanego modelu.
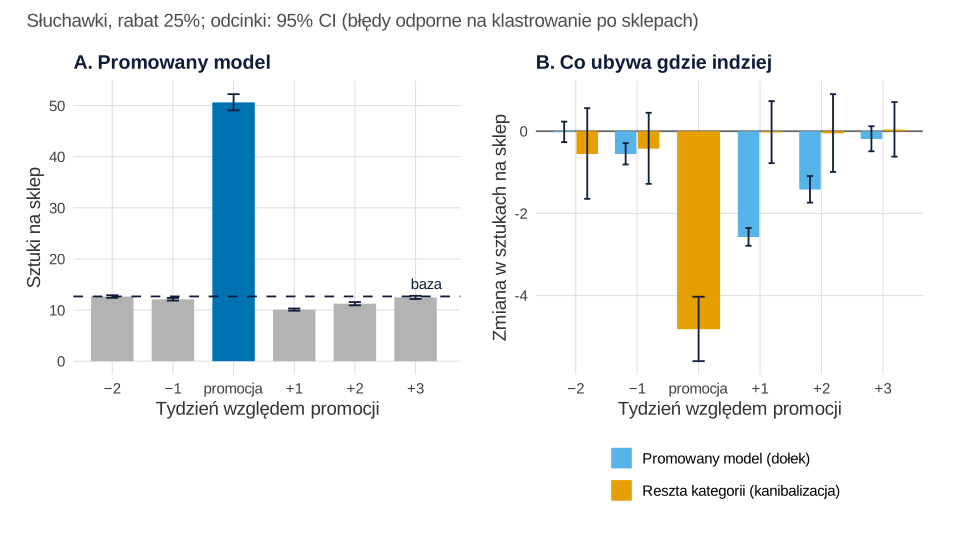
set.seed(656)).Co widać. Przy rabacie 25% sklep sprzedaje w tygodniu promocji o 37.96 sztuki więcej, 95% CI [36.40, 39.57]. W tygodniu przed traci 0.55 sztuki, w pierwszym po – 2.58 [2.36, 2.79], w drugim – 1.42; trzeci tydzień nie różni się od bazy. Dołek zabiera 12.5% przyrostu z tygodnia promocji, a pozostałe słuchawki tracą 4.82 sztuki [4.03, 5.60], czyli kolejne 12.7%. Współczynnik kanibalizacji to −0.074, 95% CI [−0.086, −0.061] (prawda: −0.08).
Jak może zmylić. Model zakłada dołek rosnący liniowo z rabatem i taki sam w każdej kategorii. Macé i Neslin (2004) na 39 441 elastycznościach pokazali, że dołki zależą od cech produktu, kategorii i klientów – są silniejsze m.in. dla drogich, często promowanych produktów. Według van Heerde i in. (2003) ok. 33% przyrostu sztuk to straty innych marek kategorii, więc nasze 12.7% to wynik jednej fikcyjnej sieci, a nie norma.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: przyrost netto i zysk
Teraz składamy wszystko w bilans jednej promocji w jednym sklepie:
Zysk liczymy z marży: sztuka w promocji zarabia marżę pomniejszoną o rabat, a sztuki z dołka i kanibalizacji tracą pełną marżę. Fikcyjne ceny (koszty): słuchawki 199 zł (109 zł), ładowarki 59 zł (24 zł), głośniki 349 zł (249 zł). Niepewność daje bootstrap: 200 razy losujemy 30 sklepów ze zwracaniem i liczymy modele od nowa.
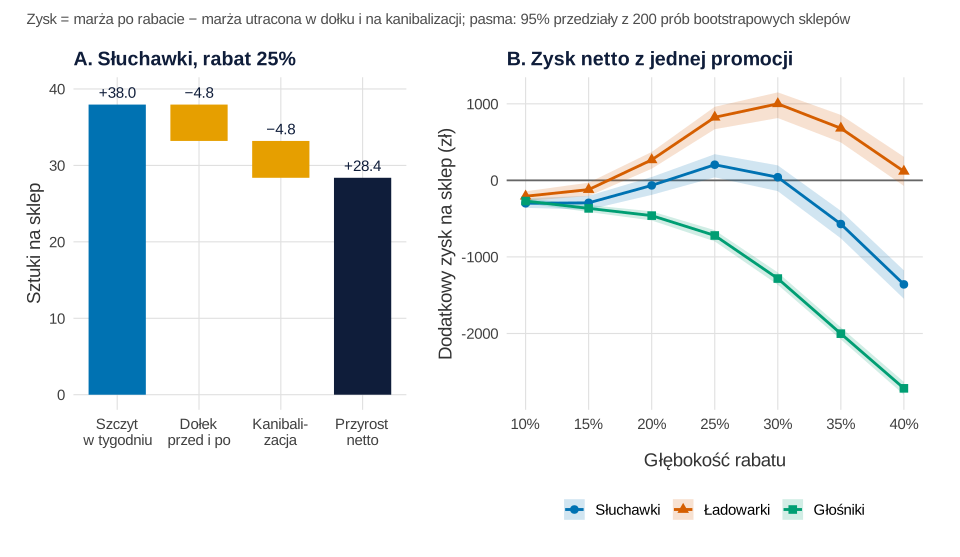
set.seed(656) i set.seed(6560)).Co widać. Ze szczytu 38.0 sztuk słuchawek zostaje 28.4 sztuki przyrostu netto (wykres wodospadowy). Przychód rośnie najbardziej przy rabacie 35% we wszystkich kategoriach, zysk – nie. Słuchawki wyraźnie zarabiają tylko przy 25%: +205 zł, 95% CI [39, 342]; przy 30% +41 zł z przedziałem obejmującym zero, przy 35% tracą 570 zł. Ładowarki z wysoką marżą zarabiają najwięcej przy 30% (+1000 zł [814, 1150]). Głośniki tracą przy każdym rabacie, od 270 do 2717 zł, choć przychód przy 30% rośnie o 4302 zł. Rabat 10% nigdzie nie dał przyrostu netto.
Jak może zmylić. Pasma obejmują tylko losowość sklepów, a nie błąd założeń: zysk zależy od marży, którą wpisujesz ręcznie, i od tego, czy klienci z kanibalizacji kupiliby droższy produkt. Promocja może też przyciągnąć klientów do sklepu po inne rzeczy – tego tu nie liczymy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: promocje planowane na dobre tygodnie
Centrala daje głębokie rabaty na Black Friday, kiedy sprzedaż i tak rośnie. Model, który nie zna sezonu, przypisze go rabatowi – sezon jest zmienną zakłócającą. Villas-Boas i Winer (1999) piszą, że zmienne marketingu mix ustalają menedżerowie, a pominięcie tego może dawać znaczne obciążenie. Gorzej, gdy termin wybiera kierownik, który widzi lokalny popyt, a analityk – nie. Symulacja: 100 sieci z terminami od centrali i 100, w których kierownik wybiera tygodnie z wysokim lokalnym popytem (parametry ręczne, ziarno 6561).
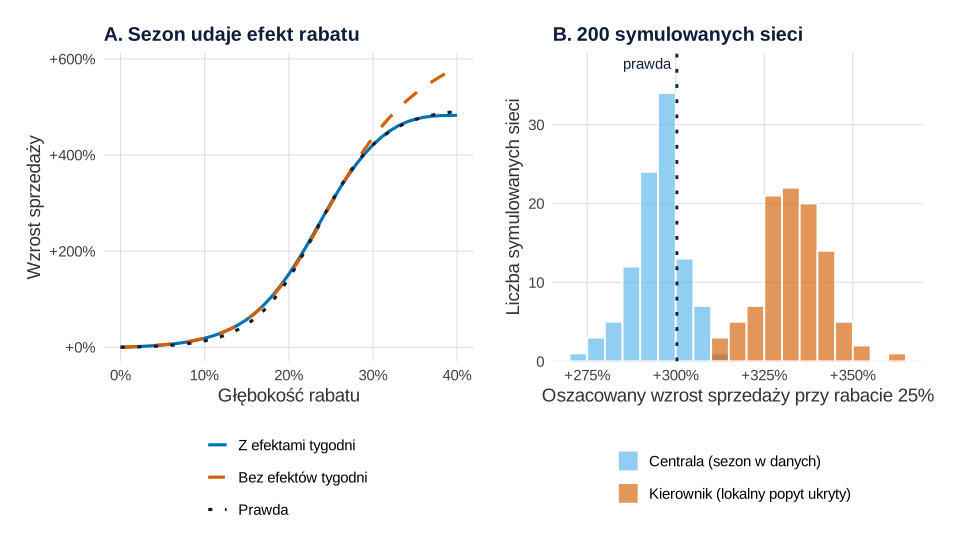
set.seed(656) i set.seed(6561)).Co widać. Bez efektów tygodni rabat 40% daje +583% zamiast +482%: najgłębsze rabaty padały w sezonie, więc model przypisał im efekt Black Friday. Przy 25% różnica jest znikoma (+297% i +300%). W symulacji z centralą model z efektami tygodni daje średnio +295.1% przy prawdzie +300.3% (błąd Monte Carlo średniej 0.7 pp). Gdy terminy wybiera kierownik, średnia to +333.4%, czyli obciążenie +33.0 pp (błąd MC 0.9 pp) – większa próba go nie usunie.
Jak może zmylić. Efekty tygodni chronią tylko przed tym, co wspólne dla sieci. Lokalnych powodów wyboru terminu w danych nie ma. Najpewniejsze wyjście to losowanie terminów i głębokości rabatu między sklepami, czyli eksperyment w stylu testu A/B. To samo zjawisko przy cenie regularnej działa w drugą stronę – opisuje je wpis o elastyczności cenowej.
Podpis do pracy:
Zdanie do Metody (ograniczenia):
Co z tym zrobić w firmie
- Licz zysk, nie szczyt. Przychód rósł najbardziej przy 35%, a zysk ze słuchawek był największy przy 25%. Raportuj przyrost netto po odjęciu dołka i kanibalizacji.
- Nie dawaj 10%. Rabat poniżej progu odczuwalności kosztuje marżę, a sprzedaży prawie nie rusza.
- Nie przekraczaj punktu nasycenia. Powyżej 30% każdy kolejny punkt rabatu zabiera marżę, a nie dokłada klientów.
- Różnicuj kategorie. Ładowarki z wysoką marżą znoszą rabat 30%, głośniki z niską – żadnego. Promocję na głośniki uzasadnij czymś innym niż zysk z jednego tygodnia, np. ruchem w sklepie, i to zmierz.
- Losuj część promocji. Kilka sklepów z losowo wybranym terminem i głębokością rabatu daje krzywą bez pułapki z rysunku 6. Sprzedaż sezonową planuj osobno, np. w prognozie sprzedaży z promocjami.
Przy porównaniach sklepów w czasie pamiętaj o mieszance asortymentu (like-for-like i paradoks Simpsona). Kanibalizację między lokalami mierzy różnica w różnicach (kanibalizacja po otwarciu lokalu), a promocje razem z reklamą – marketing mix modeling.
Jak opisać w pracy
Opisz jednostkę danych, postać krzywej, opóźnienia, kanibalizację, niepewność i założenia o marży. Zob. też statystyka w pracy z zarządzania i ekonomii.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i prawdziwe parametry, przepis 2 – dane, przepis 3 – model używany w przepisach 4–6. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje (przepisy 2, 5 i 6), zaczyna od własnego set.seed(): 656 w przepisie 2, 6560 w przepisie 5 i 6561 w przepisie 6; przepisy 1, 3 i 4 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: kształt krzywej odpowiedzi (S z progiem ok. 15% i nasyceniem ok. 30%), dołki (−0.002, −0.010 i −0.004 ln sprzedaży na punkt procentowy rabatu w tygodniu przed i dwóch po), kanibalizację (−0.08), sprzedaż bazową, ceny i koszty trzech kategorii (przepis 1); 30 sklepów, 104 tygodnie, 9 promocji na sklep i kategorię co najmniej 4 tygodnie od siebie, poziomy rabatu 10–40% co 5 pp, sezon, częstsze i głębsze promocje w sezonie (siłę tego powiązania zwiększyliśmy po pierwszym przebiegu), wielkość sklepów, szoki i szum (przepis 2); węzły splajnu 15 i 25% oraz siatkę punktów załamania (przepis 3); 200 prób bootstrapowych (przepis 5); lokalny szok popytu (AR(1), ρ = 0.7, SD = 0.15), siłę wyboru tygodni przez kierownika i 2 × 100 powtórzeń (przepis 6). Najdłuższy przepis (6) liczy się ok. 15 sekund.
1. Prawdziwe parametry i schemat: Rysunek 1
R
# Rysunek 1. Sprzedaż bazowa – szczyt – dołek: na co rozkłada się słupek z tygodnia promocji
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Prawdziwe parametry fikcyjnej sieci (ustawione ręcznie; znamy je tylko dlatego, że dane są fikcyjne)
# Krzywa odpowiedzi: ln(mnożnik sprzedaży) przy rabacie d% – kształt S: próg ok. 15%, nasycenie od ok. 30%
f_prawda <- function(d) 1.8 * (plogis((d - 20) / 4) - plogis(-5))
prawda <- list(przed = -0.002,    # tydzień przed promocją: ln sprzedaży zmienia się o −0.002 na 1 pp rabatu
               po1 = -0.010,      # 1. tydzień po promocji
               po2 = -0.004,      # 2. tydzień po promocji
               kanib = -0.08)     # pozostałe produkty kategorii: ln sprzedaży = −0.08 × f(d)
kat <- data.frame(kategoria = c("Słuchawki", "Ładowarki", "Głośniki"),
                  baza = c(10, 25, 5),            # sztuki promowanego produktu / sklep / tydzień
                  baza_reszta = c(40, 70, 18),    # sztuki pozostałych produktów kategorii
                  cena = c(199, 59, 349), koszt = c(109, 24, 249),
                  cena_reszta = c(150, 45, 260), marza_reszta = c(55, 22, 70))

# Skutki rabatu 25% na słuchawki w jednym sklepie – z prawdziwych parametrów
d <- 25; b <- kat[1, ]
szczyt <- b$baza * exp(f_prawda(d))
ubytek <- c(przed = b$baza * (1 - exp(prawda$przed * d)), po1 = b$baza * (1 - exp(prawda$po1 * d)),
            po2 = b$baza * (1 - exp(prawda$po2 * d)))
kanib <- b$baza_reszta * (1 - exp(prawda$kanib * f_prawda(d)))
netto <- szczyt - b$baza - sum(ubytek) - kanib
round(c(baza = b$baza, szczyt = szczyt, przyrost_w_tygodniu = szczyt - b$baza, ubytek, kanibalizacja = kanib,
        przyrost_netto = netto, proc_netto_z_przyrostu = 100 * netto / (szczyt - b$baza)), 2)

# Grafika: tygodnie −3…+4; słupek tygodnia 0 podzielony na bazę, część „przeniesioną” z sąsiednich tygodni,
# część zabraną innym produktom kategorii i prawdziwy przyrost
tyg <- data.frame(t = -3:4, sprzedaz = b$baza)
tyg$sprzedaz[tyg$t == -1] <- b$baza - ubytek[["przed"]]
tyg$sprzedaz[tyg$t == 1] <- b$baza - ubytek[["po1"]]
tyg$sprzedaz[tyg$t == 2] <- b$baza - ubytek[["po2"]]
czesci <- data.frame(
  czesc = factor(c("Sprzedaż bazowa", "Przeniesione z tygodni przed i po", "Zabrane innym produktom kategorii",
                   "Przyrost netto"),
                 c("Przyrost netto", "Zabrane innym produktom kategorii", "Przeniesione z tygodni przed i po",
                   "Sprzedaż bazowa")),
  ile = c(b$baza, sum(ubytek), kanib, netto))
czesci$gora <- cumsum(czesci$ile); czesci$dol <- czesci$gora - czesci$ile
wypelnienie <- c("Sprzedaż bazowa" = "grey80", "Przeniesione z tygodni przed i po" = kol[["blekit"]],
                 "Zabrane innym produktom kategorii" = kol[["zolty"]], "Przyrost netto" = kol[["niebieski"]])
p1 <- ggplot() +
  geom_col(data = subset(tyg, t != 0), aes(t, sprzedaz), fill = "grey80", width = 0.7) +
  geom_rect(data = subset(tyg, t %in% c(-1, 1, 2)), aes(xmin = t - 0.35, xmax = t + 0.35, ymin = sprzedaz, ymax = b$baza),
            fill = NA, colour = kol[["blekit"]], linetype = "22", linewidth = 0.7) +
  geom_rect(data = czesci, aes(xmin = -0.35, xmax = 0.35, ymin = dol, ymax = gora, fill = czesc), colour = "white") +
  geom_hline(yintercept = b$baza, linetype = "dashed", colour = "#0f1d3a") +
  annotate("text", x = 3.6, y = b$baza + 1.2, label = "sprzedaż bazowa", hjust = 1, size = 4, colour = "#0f1d3a") +
  annotate("text", x = 1.5, y = 3.5, label = "dołek po promocji", size = 4, colour = "grey20") +
  annotate("text", x = -1, y = 3.5, label = "dołek\nprzed", size = 3.8, colour = "grey20", lineheight = 0.9) +
  annotate("text", x = 0, y = b$baza / 2, size = 3.9, colour = "#0f1d3a", label = sprintf("%.0f szt.", b$baza)) +
  annotate("text", x = 0.45, y = (czesci$dol + czesci$ile / 2)[-1], hjust = 0, size = 3.9, colour = "#0f1d3a",
           label = sprintf("%s: %.1f szt.", c("przeniesione", "kanibalizacja", "przyrost netto"), czesci$ile[-1])) +
  scale_fill_manual(values = wypelnienie, name = NULL, breaks = levels(czesci$czesc)[4:1]) +
  scale_x_continuous(breaks = -3:4, labels = c("−3", "−2", "−1", "promocja", "+1", "+2", "+3", "+4")) +
  scale_y_continuous(breaks = seq(0, 40, 10), expand = expansion(mult = c(0, 0.04))) +
  labs(x = "Tydzień względem promocji", y = "Sztuki na sklep w tygodniu",
       title = "Szczyt sprzedaży to nie cały zysk z promocji",
       subtitle = "Słuchawki, rabat 25%, jeden sklep – prawdziwe parametry fikcyjnej sieci") +
  guides(fill = guide_legend(nrow = 2)) + motyw
p1   # zapis: ggsave("rabat-schemat-baza-szczyt-dolek.svg", p1, width = 10, height = 5.8)
Wynik w R
                  baza                 szczyt    przyrost_w_tygodniu
                 10.00                  40.03                  30.03
                 przed                    po1                    po2
                  0.49                   2.21                   0.95
         kanibalizacja         przyrost_netto proc_netto_z_przyrostu
                  4.20                  22.18                  73.85
2. Dane sieci: Rysunek 2
R
# Rysunek 2. Fikcyjna sieć 30 sklepów z elektroniką: 104 tygodnie, trzy kategorie, promocje z rabatem 10–40%
# (korzysta z kol, motyw, f_prawda, prawda i kat z przepisu 1)
library(ggplot2)
library(patchwork)

# Sezon (na skali ln): Black Friday, grudzień, powrót do szkoły; głośniki – także lato. Ustawiony ręcznie.
sezon <- function(t, kategoria) {
  w <- (t - 1) %% 52 + 1
  0.45 * (w == 47) + 0.35 * (w %in% 49:51) +
    (if (kategoria == "Głośniki") 0.30 * (w %in% 22:31) else 0.15 * (w %in% 35:36))
}
# Jedna symulacja całej sieci. wybor = "centrala": tygodnie promocji wybiera centrala, częściej w sezonie
# (sezon widać w danych); wybor = "kierownik": dodatkowo kierownik sklepu wybiera tygodnie, w których
# lokalny popyt jest wysoki (lokalny szok u, którego analityk nie widzi)
symuluj_siec <- function(S = 30, Tt = 104, wybor = "centrala", poziomy = seq(10, 40, 5), n_promo = 9) {
  wielkosc <- exp(rnorm(S, 0, 0.3))
  wiersze <- list()
  for (k in seq_len(nrow(kat))) {
    sz_tyg <- rnorm(Tt, 0, 0.05)                         # wspólny szok tygodnia w kategorii
    sez <- sezon(1:Tt, kat$kategoria[k])
    for (s in 1:S) {
      u <- as.numeric(arima.sim(list(ar = 0.7), Tt, sd = 0.15 * sqrt(1 - 0.7^2)))  # lokalny szok, SD 0.15
      waga <- exp(3 * sez + if (wybor == "kierownik") 4 * u else 0)
      wolne <- 3:(Tt - 3); rabat <- numeric(Tt)
      for (i in 1:n_promo) {                              # promocje co najmniej 4 tygodnie od siebie
        t0 <- if (length(wolne) == 1) wolne else sample(wolne, 1, prob = waga[wolne])
        rabat[t0] <- sample(poziomy, 1, prob = exp(0.15 * (poziomy - 25) * sez[t0] / 0.45))  # w sezonie głębiej
        wolne <- setdiff(wolne, (t0 - 3):(t0 + 3))
      }
      przed <- c(rabat[-1], 0); po1 <- c(0, rabat[-Tt]); po2 <- c(0, 0, rabat[-c(Tt - 1, Tt)])
      tlo <- log(wielkosc[s]) + sez + sz_tyg + u + 0.05 * (1:Tt) / 52
      mu_p <- kat$baza[k] * exp(tlo + f_prawda(rabat) + prawda$przed * przed + prawda$po1 * po1 + prawda$po2 * po2 +
                                  rnorm(Tt, 0, 0.15))
      mu_r <- kat$baza_reszta[k] * exp(tlo + prawda$kanib * f_prawda(rabat) + rnorm(Tt, 0, 0.10))
      wiersze[[length(wiersze) + 1]] <- data.frame(
        sklep = sprintf("S%02d", s), kategoria = kat$kategoria[k], tydzien = 1:Tt, rabat = rabat,
        sztuki = rpois(Tt, mu_p), sztuki_reszta = rpois(Tt, mu_r))
    }
  }
  d <- do.call(rbind, wiersze)
  d$kategoria <- factor(d$kategoria, kat$kategoria)
  d$sk_kat <- interaction(d$sklep, d$kategoria, drop = TRUE)      # sklep × kategoria
  d$tydz_kat <- interaction(d$tydzien, d$kategoria, drop = TRUE)  # tydzień × kategoria
  # Rabat w sąsiednich tygodniach tego samego sklepu i kategorii (do dołków)
  d <- d[order(d$sk_kat, d$tydzien), ]
  przesun <- function(x, k) ave(x, d$sk_kat, FUN = function(v) if (k > 0) c(rep(0, k), head(v, -k)) else c(tail(v, k), rep(0, -k)))
  d$przed2 <- przesun(d$rabat, -2); d$przed1 <- przesun(d$rabat, -1)
  d$po1 <- przesun(d$rabat, 1); d$po2 <- przesun(d$rabat, 2); d$po3 <- przesun(d$rabat, 3)
  d
}

set.seed(656)                                    # ziarno ustalone raz, bez dobierania pod wynik
d <- symuluj_siec()
write.csv(d[c("sklep", "kategoria", "tydzien", "rabat", "sztuki", "sztuki_reszta")],
          "rabat-elektronika-sprzedaz-tygodniowa.csv", row.names = FALSE)

# Opis danych
c(wiersze = nrow(d), sklepy = length(unique(d$sklep)), promocje = sum(d$rabat > 0))
table(rabat = d$rabat[d$rabat > 0])
# Średnia sprzedaż w tygodniach bez promocji (i bez promocji ±3 tygodnie) oraz w tygodniach promocji
czysty <- with(d, rabat == 0 & przed2 == 0 & przed1 == 0 & po1 == 0 & po2 == 0 & po3 == 0)
round(cbind(baza = tapply(d$sztuki[czysty], d$kategoria[czysty], mean),
            w_promocji = tapply(d$sztuki[d$rabat > 0], d$kategoria[d$rabat > 0], mean),
            reszta_baza = tapply(d$sztuki_reszta[czysty], d$kategoria[czysty], mean)), 2)
# Promocje trafiają częściej na tygodnie sezonu: odsetek tygodni z promocją
d$sezon_wysoki <- mapply(function(t, k) sezon(t, k) > 0, d$tydzien, as.character(d$kategoria))
round(100 * tapply(d$rabat > 0, d$sezon_wysoki, mean), 1)
round(tapply(d$rabat[d$rabat > 0], d$sezon_wysoki[d$rabat > 0], mean), 1)

# Rysunek: jeden sklep (S01), słuchawki – promowany model i reszta kategorii
d1 <- subset(d, sklep == "S01" & kategoria == "Słuchawki")
pr <- subset(d1, rabat > 0)
print(pr[c("tydzien", "rabat", "sztuki", "sztuki_reszta")], row.names = FALSE)
pa <- ggplot(d1, aes(tydzien, sztuki)) +
  geom_col(data = pr, aes(tydzien, Inf), inherit.aes = FALSE, fill = "grey92", width = 1) +
  geom_line(colour = "grey45") +
  geom_point(data = pr, aes(fill = rabat), shape = 21, size = 3.2, colour = "#0f1d3a") +
  geom_text(data = pr, aes(label = paste0(rabat, "%")), vjust = -1, size = 3.6, colour = "#0f1d3a") +
  scale_fill_gradient(low = "#FFFFFF", high = kol[["pomaranczowy"]], limits = c(10, 40), name = "Rabat (%)") +
  scale_x_continuous(breaks = c(1, 27, 47, 53, 79, 99), labels = c("1", "27", "47\n(BF)", "53", "79", "99\n(BF)")) +
  scale_y_continuous(expand = expansion(mult = c(0.02, 0.15))) +
  labs(x = NULL, y = "Sztuki w tygodniu", title = "A. Promowany model słuchawek (sklep S01)",
       subtitle = "Szare tło i kółka: tygodnie promocji z głębokością rabatu") + motyw
pb <- ggplot(d1, aes(tydzien, sztuki_reszta)) +
  geom_col(data = pr, aes(tydzien, Inf), inherit.aes = FALSE, fill = "grey92", width = 1) +
  geom_line(colour = kol[["niebieski"]]) +
  scale_x_continuous(breaks = c(1, 27, 47, 53, 79, 99), labels = c("1", "27", "47\n(BF)", "53", "79", "99\n(BF)")) +
  labs(x = "Tydzień (BF – Black Friday)", y = "Sztuki w tygodniu",
       title = "B. Pozostałe słuchawki w tym sklepie") + motyw
p2 <- pa / pb + plot_layout(heights = c(1.4, 1))
p2   # zapis: ggsave("rabat-dane-jeden-sklep.svg", p2, width = 10, height = 6.4)
Wynik w R
 wiersze   sklepy promocje
    9360       30      810
rabat
 10  15  20  25  30  35  40
 93 102  97 102 117 124 175
           baza w_promocji reszta_baza
Słuchawki 12.66      52.78       49.63
Ładowarki 30.72     132.40       85.84
Głośniki   6.49      29.86       23.20
FALSE  TRUE
  7.7  13.7
FALSE  TRUE
 24.7  33.2
 tydzien rabat sztuki sztuki_reszta
      11    25     30            38
      16    20     19            30
      33    15     28            33
      58    35     36            17
      70    15     11            42
      76    40     40            16
      86    40     55            23
      94    40     49            28
      99    30    110            47
3. Cztery modele krzywej odpowiedzi: Rysunek 3
R
# Rysunek 3. Krzywa odpowiedzi sprzedaży na głębokość rabatu: liniowa, segmentowa, splajn i osobne poziomy
# (korzysta z kol, motyw, f_prawda z przepisu 1 i danych d z przepisu 2)
library(ggplot2)
library(fixest)
library(splines)

# Baza splajnu naturalnego: węzły 15 i 25%, granice 0 i 40% (przy d = 0 wszystkie kolumny są równe 0)
baza_splajnu <- function(x) ns(x, knots = c(15, 25), Boundary.knots = c(0, 40))
B <- baza_splajnu(d$rabat); d$s1 <- B[, 1]; d$s2 <- B[, 2]; d$s3 <- B[, 3]
# Wszystkie modele: regresja Poissona (sztuki), efekty stałe sklep × kategoria i tydzień × kategoria,
# rabat z sąsiednich tygodni dla dołków, błędy standardowe odporne na klastrowanie po sklepach
dolki <- "przed2 + przed1 + po1 + po2 + po3"
fe <- "| sk_kat + tydz_kat"
m_lin <- fepois(as.formula(paste("sztuki ~ rabat +", dolki, fe)), d, cluster = ~sklep)
m_spl <- fepois(as.formula(paste("sztuki ~ s1 + s2 + s3 +", dolki, fe)), d, cluster = ~sklep)
m_poz <- fepois(as.formula(paste("sztuki ~ i(rabat, ref = 0) +", dolki, fe)), d, cluster = ~sklep)
# Regresja segmentowa z dwoma punktami załamania: do progu k1 rabat nie działa, od k1 do k2 efekt rośnie
# liniowo, po k2 – z innym nachyleniem (nasycenie). k1 i k2 wybrane siatką po log-wiarygodności
siatka <- expand.grid(k1 = seq(0, 20, 1), k2 = seq(24, 38, 1))
siatka$ll <- mapply(function(k1, k2) {
  d$z1 <- pmax(d$rabat - k1, 0); d$z2 <- pmax(d$rabat - k2, 0)
  as.numeric(logLik(fepois(as.formula(paste("sztuki ~ z1 + z2 +", dolki, fe)), d)))
}, siatka$k1, siatka$k2)
k_best <- unlist(siatka[which.max(siatka$ll), c("k1", "k2")])
d$z1 <- pmax(d$rabat - k_best[["k1"]], 0); d$z2 <- pmax(d$rabat - k_best[["k2"]], 0)
m_seg <- fepois(as.formula(paste("sztuki ~ z1 + z2 +", dolki, fe)), d, cluster = ~sklep)
k_best
round(c(AIC_liniowy = AIC(m_lin), AIC_segmentowy = AIC(m_seg) + 4, AIC_splajn = AIC(m_spl),
        AIC_osobne_poziomy = AIC(m_poz)), 1)  # +4 w segmentowym: dwa punkty załamania też są szacowane

# Krzywe: % wzrostu sprzedaży w tygodniu promocji przy rabacie x (z 95% CI metodą delta)
x <- seq(0, 40, by = 1)
krzywa <- function(X, m, kol_b) {
  b <- coef(m)[kol_b]; V <- vcov(m)[kol_b, kol_b]
  f <- drop(X %*% b); se <- sqrt(rowSums((X %*% V) * X))
  data.frame(rabat = x, proc = 100 * (exp(f) - 1), dol = 100 * (exp(f - 1.96 * se) - 1), gora = 100 * (exp(f + 1.96 * se) - 1))
}
k_spl <- krzywa(baza_splajnu(x), m_spl, c("s1", "s2", "s3"))
k_lin <- krzywa(cbind(x), m_lin, "rabat")
k_seg <- krzywa(cbind(pmax(x - k_best[["k1"]], 0), pmax(x - k_best[["k2"]], 0)), m_seg, c("z1", "z2"))
poz <- data.frame(rabat = seq(10, 40, 5), b = coef(m_poz)[grep("rabat::", names(coef(m_poz)))],
                  se = se(m_poz)[grep("rabat::", names(coef(m_poz)))])
poz <- transform(poz, proc = 100 * (exp(b) - 1), dol = 100 * (exp(b - 1.96 * se) - 1), gora = 100 * (exp(b + 1.96 * se) - 1))
tab <- data.frame(rabat = seq(10, 40, 5), prawda = 100 * (exp(f_prawda(seq(10, 40, 5))) - 1),
                  osobne_poziomy = poz$proc, splajn = k_spl$proc[match(seq(10, 40, 5), x)],
                  segmentowy = k_seg$proc[match(seq(10, 40, 5), x)], liniowy = k_lin$proc[match(seq(10, 40, 5), x)])
round(tab, 0)
round(k_spl[match(c(25, 40), x), ], 0)
# Ile dokłada każde kolejne 5 pp rabatu (splajn, punkty procentowe wzrostu sprzedaży)
round(diff(tab$splajn), 0)

linie <- rbind(data.frame(k_spl[, c("rabat", "proc")], model = "Splajn naturalny (95% CI)"),
               data.frame(k_seg[, c("rabat", "proc")], model = sprintf("Segmentowy (próg %d%%, nasycenie %d%%)", k_best[["k1"]], k_best[["k2"]])),
               data.frame(k_lin[, c("rabat", "proc")], model = "Liniowy w ln sprzedaży"),
               data.frame(rabat = x, proc = 100 * (exp(f_prawda(x)) - 1), model = "Prawda (znana w symulacji)"))
linie$model <- factor(linie$model, unique(linie$model))
p3 <- ggplot() +
  geom_ribbon(data = k_spl, aes(rabat, ymin = dol, ymax = gora), fill = kol[["blekit"]], alpha = 0.3) +
  geom_line(data = linie, aes(rabat, proc, colour = model, linetype = model), linewidth = 1) +
  geom_pointrange(data = poz, aes(rabat, proc, ymin = dol, ymax = gora), colour = "#0f1d3a", size = 0.45,
                  shape = 21, fill = "white") +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["zielony"]], kol[["pomaranczowy"]], "#0f1d3a"), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash", "dashed", "dotted"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 40, 5), labels = function(v) paste0(v, "%")) +
  scale_y_continuous(labels = function(v) paste0("+", v, "%")) +
  labs(x = "Głębokość rabatu", y = "Wzrost sprzedaży w tygodniu promocji",
       title = "Krzywa odpowiedzi na rabat ma kształt litery S",
       subtitle = "Kółka: osobny efekt każdego poziomu rabatu z 95% CI; 810 promocji w 30 sklepach") +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) + motyw
p3   # zapis: ggsave("rabat-krzywa-odpowiedzi.svg", p3, width = 10, height = 6)
Wynik w R
k1 k2
 9 28
       AIC_liniowy     AIC_segmentowy         AIC_splajn AIC_osobne_poziomy
           60765.2            59514.5            59459.0            59463.6
  rabat prawda osobne_poziomy splajn segmentowy liniowy
1    10     13             21     19          9      61
2    15     48             55     58         68     105
3    20    143            153    152        158     160
4    25    300            303    300        297     231
5    30    421            415    421        426     320
6    35    474            479    474        457     434
7    40    491            481    482        490     578
   rabat proc dol gora
26    25  300 287  312
41    40  482 460  506
[1]  39  94 148 121  53   8
4. Dołki i kanibalizacja: Rysunek 4
R
# Rysunek 4. Dołek przed i po promocji oraz kanibalizacja w kategorii – tydzień po tygodniu
# (korzysta z kol, motyw z przepisu 1, d i czysty z przepisu 2, baza_splajnu, dolki, fe, m_spl z przepisu 3)
library(ggplot2)
library(patchwork)
library(fixest)

# Pozostałe produkty kategorii: ich sprzedaż (ln) zależy od krzywej odpowiedzi promowanego modelu f(rabat)
# ze współczynnikiem kanib (ile ln sprzedaży reszty ubywa na 1 jednostkę ln przyrostu promowanego modelu)
d$f_hat <- drop(as.matrix(d[c("s1", "s2", "s3")]) %*% coef(m_spl)[c("s1", "s2", "s3")])
m_reszta <- fepois(as.formula(paste("sztuki_reszta ~ f_hat +", dolki, fe)), d, cluster = ~sklep)
wsp <- function(m) round(cbind(b = coef(m), dol = confint(m)[, 1], gora = confint(m)[, 2]), 4)
wsp(m_spl)[c("przed2", "przed1", "po1", "po2", "po3"), ]
wsp(m_reszta)

# Profil tygodni dla słuchawek przy rabacie 25%: sztuki na sklep (baza = średnia z tygodni bez promocji w pobliżu)
rabat0 <- 25
baza_s <- mean(d$sztuki[czysty & d$kategoria == "Słuchawki"])
baza_r <- mean(d$sztuki_reszta[czysty & d$kategoria == "Słuchawki"])
efekt <- function(m, nazwa) {                    # ln mnożnika i jego SE dla jednego tygodnia
  if (nazwa == "promocja" && "s1" %in% names(coef(m))) { X <- baza_splajnu(rabat0); kb <- c("s1", "s2", "s3") }
  else if (nazwa == "promocja") { X <- matrix(drop(baza_splajnu(rabat0) %*% coef(m_spl)[c("s1", "s2", "s3")])); kb <- "f_hat" }
  else { X <- matrix(rabat0); kb <- nazwa }
  c(f = drop(X %*% coef(m)[kb]), se = sqrt(drop(X %*% vcov(m)[kb, kb] %*% t(X))))
}
tygodnie <- c("przed2", "przed1", "promocja", "po1", "po2", "po3")
profil <- do.call(rbind, lapply(c("promowany", "reszta"), function(co) {
  m <- if (co == "promowany") m_spl else m_reszta; baza <- if (co == "promowany") baza_s else baza_r
  e <- sapply(tygodnie, function(n) efekt(m, n))
  data.frame(co = co, t = -2:3, zmiana = baza * (exp(e["f", ]) - 1),
             dol = baza * (exp(e["f", ] - 1.96 * e["se", ]) - 1), gora = baza * (exp(e["f", ] + 1.96 * e["se", ]) - 1))
}))
print(transform(profil, zmiana = round(zmiana, 2), dol = round(dol, 2), gora = round(gora, 2)), row.names = FALSE)
round(c(baza_promowany = baza_s, baza_reszta = baza_r), 2)
# Dołek (przed + po) jako % przyrostu w tygodniu promocji i kanibalizacja jako % przyrostu
pp <- subset(profil, co == "promowany"); rr <- subset(profil, co == "reszta")
round(c(dolek_proc_szczytu = -100 * sum(pp$zmiana[pp$t != 0]) / pp$zmiana[pp$t == 0],
        kanibalizacja_proc_szczytu = -100 * rr$zmiana[rr$t == 0] / pp$zmiana[pp$t == 0]), 1)

# A: sztuki promowanego modelu w kolejnych tygodniach; B: zmiana w sztukach poza szczytem (zbliżenie)
pp$sztuki <- baza_s + pp$zmiana; pp$s_dol <- baza_s + pp$dol; pp$s_gora <- baza_s + pp$gora
etyk <- c("−2", "−1", "promocja", "+1", "+2", "+3")
pa <- ggplot(pp, aes(t, sztuki)) +
  geom_col(aes(fill = t == 0), width = 0.7, show.legend = FALSE) +
  geom_errorbar(aes(ymin = s_dol, ymax = s_gora), width = 0.2, colour = "#0f1d3a") +
  geom_hline(yintercept = baza_s, linetype = "dashed", colour = "#0f1d3a") +
  annotate("text", x = 3.45, y = baza_s + 2.5, label = "baza", hjust = 1, size = 3.9, colour = "#0f1d3a") +
  scale_fill_manual(values = c("grey70", kol[["niebieski"]])) +
  scale_x_continuous(breaks = -2:3, labels = etyk) +
  labs(x = "Tydzień względem promocji", y = "Sztuki na sklep", title = "A. Promowany model") + motyw
zb <- rbind(data.frame(subset(pp, t != 0)[, c("t", "zmiana", "dol", "gora")], co = "Promowany model (dołek)"),
            data.frame(rr[, c("t", "zmiana", "dol", "gora")], co = "Reszta kategorii (kanibalizacja)"))
pb <- ggplot(zb, aes(t, zmiana, fill = co)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_col(position = position_dodge(0.75), width = 0.7) +
  geom_errorbar(aes(ymin = dol, ymax = gora), position = position_dodge(0.75), width = 0.2, colour = "#0f1d3a") +
  scale_fill_manual(values = c(kol[["blekit"]], kol[["zolty"]]), name = NULL) +
  scale_x_continuous(breaks = -2:3, labels = etyk) +
  labs(x = "Tydzień względem promocji", y = "Zmiana w sztukach na sklep", title = "B. Co ubywa gdzie indziej") +
  guides(fill = guide_legend(nrow = 2)) + motyw
p4 <- pa + pb + plot_annotation(subtitle = sprintf("Słuchawki, rabat %d%%; odcinki: 95%% CI (błędy odporne na klastrowanie po sklepach)", rabat0)) &
  theme(plot.subtitle = element_text(colour = "grey30"))
p4   # zapis: ggsave("rabat-dolek-kanibalizacja.svg", p4, width = 10, height = 5.6)
Wynik w R
             b     dol    gora
przed2 -0.0001 -0.0009  0.0007
przed1 -0.0018 -0.0026 -0.0009
po1    -0.0091 -0.0099 -0.0082
po2    -0.0048 -0.0059 -0.0036
po3    -0.0006 -0.0016  0.0004
             b     dol    gora
f_hat  -0.0737 -0.0864 -0.0611
przed2 -0.0004 -0.0013  0.0004
przed1 -0.0003 -0.0010  0.0004
po1     0.0000 -0.0006  0.0006
po2     0.0000 -0.0008  0.0007
po3     0.0000 -0.0005  0.0006
        co  t zmiana   dol  gora
 promowany -2  -0.02 -0.27  0.23
 promowany -1  -0.55 -0.81 -0.29
 promowany  0  37.96 36.40 39.57
 promowany  1  -2.58 -2.79 -2.36
 promowany  2  -1.42 -1.74 -1.09
 promowany  3  -0.19 -0.49  0.12
    reszta -2  -0.56 -1.65  0.56
    reszta -1  -0.42 -1.28  0.45
    reszta  0  -4.82 -5.60 -4.03
    reszta  1  -0.03 -0.78  0.73
    reszta  2  -0.05 -0.99  0.90
    reszta  3   0.04 -0.62  0.71
baza_promowany    baza_reszta
         12.66          49.63
        dolek_proc_szczytu kanibalizacja_proc_szczytu
                      12.5                       12.7
5. Bilans promocji i bootstrap sklepów: Rysunek 5
R
# Rysunek 5. Przyrost netto i zysk z promocji w funkcji głębokości rabatu – trzy kategorie, bootstrap sklepów
# (korzysta z kol, motyw, kat z przepisu 1, d i czysty z przepisu 2, baza_splajnu, dolki, fe, m_spl z przepisu 3, m_reszta z przepisu 4)
library(ggplot2)
library(patchwork)
library(fixest)

poziomy <- seq(10, 40, 5)
bazy <- data.frame(kategoria = kat$kategoria,
                   baza = sapply(kat$kategoria, function(k) mean(d$sztuki[czysty & d$kategoria == k])),
                   baza_reszta = sapply(kat$kategoria, function(k) mean(d$sztuki_reszta[czysty & d$kategoria == k])))
# Bilans jednej promocji w jednym sklepie (sztuki i zł) przy rabacie r, z współczynników dwóch modeli
bilans <- function(bp, br, r, k) {
  X <- baza_splajnu(r); g <- kat[k, ]; b0 <- bazy$baza[k]; r0 <- bazy$baza_reszta[k]
  szczyt <- b0 * (exp(drop(X %*% bp[c("s1", "s2", "s3")])) - 1)
  dolek <- b0 * sum(1 - exp(bp[c("przed2", "przed1", "po1", "po2", "po3")] * r))
  kanib <- r0 * (1 - exp(br[["f_hat"]] * drop(X %*% bp[c("s1", "s2", "s3")])))
  cena_p <- g$cena * (1 - r / 100); marza <- g$cena - g$koszt
  c(szczyt = szczyt, dolek = dolek, kanib = kanib, netto = szczyt - dolek - kanib,
    przychod = (b0 + szczyt) * cena_p - b0 * g$cena - dolek * g$cena - kanib * g$cena_reszta,
    zysk = (b0 + szczyt) * (cena_p - g$koszt) - b0 * marza - dolek * marza - kanib * g$marza_reszta)
}
siatka <- expand.grid(rabat = poziomy, k = 1:3)
wynik <- cbind(siatka, t(mapply(function(r, k) bilans(coef(m_spl), coef(m_reszta), r, k), siatka$rabat, siatka$k)))
wynik$kategoria <- factor(kat$kategoria[wynik$k], kat$kategoria)

# Bootstrap sklepów (losujemy 30 sklepów ze zwracaniem i liczymy oba modele od nowa), 200 powtórzeń
set.seed(6560)
R <- 200
sklepy <- unique(d$sklep)
wiersze_sklepu <- split(seq_len(nrow(d)), d$sklep)
boot <- replicate(R, {
  los <- sample(sklepy, replace = TRUE)
  db <- d[unlist(wiersze_sklepu[los]), ]
  db$sk_kat <- interaction(rep(seq_along(los), lengths(wiersze_sklepu[los])), db$kategoria, drop = TRUE)
  bp <- coef(fepois(as.formula(paste("sztuki ~ s1 + s2 + s3 +", dolki, fe)), db))
  db$f_hat <- drop(as.matrix(db[c("s1", "s2", "s3")]) %*% bp[c("s1", "s2", "s3")])
  br <- coef(fepois(as.formula(paste("sztuki_reszta ~ f_hat +", dolki, fe)), db))
  mapply(function(r, k) bilans(bp, br, r, k)[c("netto", "przychod", "zysk")], siatka$rabat, siatka$k)
})
ci <- function(wiersz, q) apply(boot[wiersz, , ], 1, quantile, q)
wynik$zysk_dol <- ci("zysk", 0.025); wynik$zysk_gora <- ci("zysk", 0.975)
wynik$netto_dol <- ci("netto", 0.025); wynik$netto_gora <- ci("netto", 0.975)
wynik$p_zysk_dodatni <- apply(boot["zysk", , ] > 0, 1, mean)
print(within(wynik[, c("kategoria", "rabat", "szczyt", "dolek", "kanib", "netto", "przychod", "zysk", "zysk_dol", "zysk_gora")],
             { szczyt <- round(szczyt, 1); dolek <- round(dolek, 1); kanib <- round(kanib, 1); netto <- round(netto, 1)
               przychod <- round(przychod); zysk <- round(zysk); zysk_dol <- round(zysk_dol); zysk_gora <- round(zysk_gora) }),
      row.names = FALSE)
# Rabat z najwyższym przychodem i najwyższym zyskiem w każdej kategorii
do.call(rbind, lapply(split(wynik, wynik$kategoria), function(w)
  data.frame(kategoria = w$kategoria[1], max_przychod = w$rabat[which.max(w$przychod)], max_zysk = w$rabat[which.max(w$zysk)],
             zysk_max = round(max(w$zysk)), odsetek_boot_zysk_dodatni = round(100 * w$p_zysk_dodatni[which.max(w$zysk)], 1))))

# A: wodospad dla słuchawek przy rabacie 25%; B: zysk z promocji w funkcji rabatu w trzech kategoriach
w25 <- subset(wynik, kategoria == "Słuchawki" & rabat == 25)
wod <- data.frame(krok = factor(c("Szczyt w tygodniu", "Dołek przed i po", "Kanibalizacja", "Przyrost netto"),
                                c("Szczyt w tygodniu", "Dołek przed i po", "Kanibalizacja", "Przyrost netto")),
                  zmiana = c(w25$szczyt, -w25$dolek, -w25$kanib, w25$netto))
wod$koniec <- c(cumsum(wod$zmiana[1:3]), w25$netto); wod$poczatek <- c(0, wod$koniec[1:2], 0)
wod$typ <- c("plus", "minus", "minus", "netto")
pa <- ggplot(wod, aes(xmin = as.numeric(krok) - 0.35, xmax = as.numeric(krok) + 0.35, ymin = poczatek, ymax = koniec, fill = typ)) +
  geom_rect(show.legend = FALSE) +
  geom_text(aes(x = as.numeric(krok), y = pmax(poczatek, koniec) + 1.6, label = sub("-", "−", sprintf("%+.1f", zmiana))),
            size = 4, colour = "#0f1d3a") +
  scale_fill_manual(values = c(plus = kol[["niebieski"]], minus = kol[["zolty"]], netto = "#0f1d3a")) +
  scale_x_continuous(breaks = 1:4, labels = c("Szczyt\nw tygodniu", "Dołek\nprzed i po", "Kanibali-\nzacja", "Przyrost\nnetto")) +
  labs(x = NULL, y = "Sztuki na sklep", title = "A. Słuchawki, rabat 25%") + motyw
pb <- ggplot(wynik, aes(rabat, zysk, colour = kategoria, fill = kategoria, shape = kategoria)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_ribbon(aes(ymin = zysk_dol, ymax = zysk_gora), alpha = 0.18, colour = NA) +
  geom_line(linewidth = 1) + geom_point(size = 2.6) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]], kol[["zielony"]]), name = NULL) +
  scale_fill_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]], kol[["zielony"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_x_continuous(breaks = poziomy, labels = function(v) paste0(v, "%")) +
  labs(x = "Głębokość rabatu", y = "Dodatkowy zysk na sklep (zł)", title = "B. Zysk netto z jednej promocji") + motyw
p5 <- pa + pb + plot_layout(widths = c(1, 1.25)) +
  plot_annotation(subtitle = "Zysk = marża po rabacie − marża utracona w dołku i na kanibalizacji; pasma: 95% przedziały z 200 prób bootstrapowych sklepów") &
  theme(plot.subtitle = element_text(colour = "grey30", size = rel(0.85)))
p5   # zapis: ggsave("rabat-bilans-zysk.svg", p5, width = 10, height = 5.8)
Wynik w R
 kategoria rabat szczyt dolek kanib netto przychod  zysk zysk_dol zysk_gora
 Słuchawki    10    2.4   2.0   0.6  -0.2     -318  -300     -359      -233
 Słuchawki    15    7.3   2.9   1.6   2.7       27  -293     -382      -202
 Słuchawki    20   19.2   3.9   3.3  12.1     1300   -66     -189        44
 Słuchawki    25   38.0   4.8   4.8  28.4     3366   205       39       342
 Słuchawki    30   53.3   5.6   5.7  42.0     4700    41     -141       196
 Słuchawki    35   60.1   6.5   6.0  47.6     4705  -570     -757      -398
 Słuchawki    40   61.1   7.3   6.0  47.8     3934 -1359    -1547     -1176
 Ładowarki    10    5.8   4.8   1.1  -0.2     -210  -207     -269      -142
 Ładowarki    15   17.8   7.1   2.8   7.8       69  -120     -204       -30
 Ładowarki    20   46.7   9.4   5.7  31.7     1033   268      152       372
 Ładowarki    25   92.1  11.5   8.3  72.2     2565   824      669       962
 Ładowarki    30  129.3  13.6   9.8 105.9     3551  1000      814      1150
 Ładowarki    35  145.7  15.7  10.4 119.7     3564   681      496       855
 Ładowarki    40  148.2  17.6  10.5 120.1     3011   118      -73       308
  Głośniki    10    1.2   1.0   0.3  -0.1     -277  -270     -301      -235
  Głośniki    15    3.8   1.5   0.8   1.5       46  -366     -413      -321
  Głośniki    20    9.9   2.0   1.5   6.4     1213  -460     -524      -405
  Głośniki    25   19.5   2.4   2.3  14.8     3090  -720     -797      -651
  Głośniki    30   27.3   2.9   2.7  21.8     4302 -1282    -1364     -1203
  Głośniki    35   30.8   3.3   2.8  24.7     4310 -2002    -2078     -1921
  Głośniki    40   31.3   3.7   2.8  24.8     3618 -2717    -2800     -2633
          kategoria max_przychod max_zysk zysk_max odsetek_boot_zysk_dodatni
Słuchawki Słuchawki           35       25      205                        99
Ładowarki Ładowarki           35       30     1000                       100
Głośniki   Głośniki           35       10     -270                         0
6. Promocje w dobrych tygodniach: Rysunek 6
R
# Rysunek 6. Pułapka: promocje planowane na dobre tygodnie
# (korzysta z kol, motyw, f_prawda z przepisu 1, symuluj_siec i d z przepisu 2, baza_splajnu, dolki, x, krzywa, k_spl z przepisu 3)
library(ggplot2)
library(patchwork)
library(fixest)

# A. Te same dane, model bez efektów tygodni: sezon (Black Friday, grudzień) zostaje przypisany rabatowi
m_bez_tyg <- fepois(as.formula(paste("sztuki ~ s1 + s2 + s3 +", dolki, "| sk_kat")), d, cluster = ~sklep)
k_bez <- krzywa(baza_splajnu(x), m_bez_tyg, c("s1", "s2", "s3"))
round(rbind(prawda = 100 * (exp(f_prawda(c(10, 25, 40))) - 1), z_tygodniami = k_spl$proc[match(c(10, 25, 40), x)],
            bez_tygodni = k_bez$proc[match(c(10, 25, 40), x)]), 0)

# B. Symulacja: 100 sieci, w których tygodnie promocji wybiera centrala (sezon widoczny w danych),
# i 100 sieci, w których kierownik sklepu dodatkowo wybiera tygodnie z wysokim lokalnym popytem (niewidocznym).
# Zawsze ten sam model z efektami tygodni; zapisujemy oszacowany wzrost sprzedaży przy rabacie 25%
ocen_25 <- function(dd) {
  B <- baza_splajnu(dd$rabat); dd$s1 <- B[, 1]; dd$s2 <- B[, 2]; dd$s3 <- B[, 3]
  m <- fepois(as.formula(paste("sztuki ~ s1 + s2 + s3 +", dolki, "| sk_kat + tydz_kat")), dd)
  100 * (exp(drop(baza_splajnu(25) %*% coef(m)[c("s1", "s2", "s3")])) - 1)
}
set.seed(6561)
R <- 100
sym <- data.frame(scenariusz = rep(c("centrala", "kierownik"), each = R),
                  proc_25 = c(replicate(R, ocen_25(symuluj_siec(wybor = "centrala"))),
                              replicate(R, ocen_25(symuluj_siec(wybor = "kierownik")))))
prawda_25 <- 100 * (exp(f_prawda(25)) - 1)
do.call(rbind, lapply(split(sym, sym$scenariusz), function(s)
  data.frame(scenariusz = s$scenariusz[1], srednia = round(mean(s$proc_25), 1), sd = round(sd(s$proc_25), 1),
             obciazenie_pp = round(mean(s$proc_25) - prawda_25, 1),
             blad_MC_sredniej = round(sd(s$proc_25) / sqrt(R), 1))))
round(prawda_25, 1)

linie <- rbind(data.frame(k_spl[, c("rabat", "proc")], model = "Z efektami tygodni"),
               data.frame(k_bez[, c("rabat", "proc")], model = "Bez efektów tygodni"),
               data.frame(rabat = x, proc = 100 * (exp(f_prawda(x)) - 1), model = "Prawda"))
linie$model <- factor(linie$model, c("Z efektami tygodni", "Bez efektów tygodni", "Prawda"))
pa <- ggplot(linie, aes(rabat, proc, colour = model, linetype = model)) +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]], "#0f1d3a"), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotted"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 40, 10), labels = function(v) paste0(v, "%")) +
  scale_y_continuous(labels = function(v) paste0("+", v, "%")) +
  labs(x = "Głębokość rabatu", y = "Wzrost sprzedaży", title = "A. Sezon udaje efekt rabatu") +
  guides(colour = guide_legend(nrow = 3), linetype = guide_legend(nrow = 3)) + motyw
sym$scenariusz <- factor(ifelse(sym$scenariusz == "centrala", "Centrala (sezon w danych)", "Kierownik (lokalny popyt ukryty)"),
                         c("Centrala (sezon w danych)", "Kierownik (lokalny popyt ukryty)"))
pb <- ggplot(sym, aes(proc_25, fill = scenariusz)) +
  geom_histogram(binwidth = 5, boundary = 0, position = "identity", alpha = 0.65, colour = "white") +
  geom_vline(xintercept = prawda_25, linetype = "dotted", colour = "#0f1d3a", linewidth = 1) +
  annotate("text", x = prawda_25, y = Inf, label = "prawda", vjust = 1.5, hjust = 1.1, size = 3.9, colour = "#0f1d3a") +
  scale_fill_manual(values = c(kol[["blekit"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_x_continuous(labels = function(v) paste0("+", v, "%")) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.15))) +
  labs(x = "Oszacowany wzrost sprzedaży przy rabacie 25%", y = "Liczba symulowanych sieci",
       title = "B. 200 symulowanych sieci") +
  guides(fill = guide_legend(nrow = 2)) + motyw
p6 <- pa + pb
p6   # zapis: ggsave("rabat-endogenicznosc-dobre-tygodnie.svg", p6, width = 10, height = 5.8)
Wynik w R
             [,1] [,2] [,3]
prawda         13  300  491
z_tygodniami   19  300  482
bez_tygodni    19  297  583
          scenariusz srednia  sd obciazenie_pp blad_MC_sredniej
centrala    centrala   295.1 7.3          -5.2              0.7
kierownik  kierownik   333.4 9.0          33.0              0.9
[1] 300.3
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "niebieski – zielony" = c("#0072B2", "#009E73"),
             "pomarańczowy – zielony" = c("#D55E00", "#009E73"), "błękit – żółty" = c("#56B4E9", "#E69F00"),
             "błękit – pomarańczowy" = c("#56B4E9", "#D55E00"), "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
niebieski – zielony                         70.1         55.4       58.0
pomarańczowy – zielony                     102.4         53.5       37.3
błękit – żółty                             113.1        111.4      101.5
błękit – pomarańczowy                      113.6        101.1       89.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i bootstrap – pakiet stats, bazy splajnów naturalnych – pakiet splines (oba z podstawowej instalacji R). Regresję Poissona z efektami stałymi i błędami odpornymi na klastrowanie policzono pakietem fixest. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- fixest (wersja 0.14.2): Bergé, L. R., Butts, K., & McDermott, G. (2026). Fast and user-friendly econometrics estimations: The R package fixest. arXiv preprint arXiv:2601.21749. https://doi.org/10.48550/arXiv.2601.21749
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Prosta zamiast krzywej. Model liniowy zawyżył efekt 10% prawie pięciokrotnie (rysunek 3). Sprawdź osobne poziomy rabatu albo splajn.
- Tydzień promocji jako cały efekt. Około jednej czwartej przyrostu z tygodnia promocji to dołek i kanibalizacja (rysunki 4–5).
- Przychód zamiast zysku. Najwyższy słupek sprzedaży często oznacza stratę (rysunek 5).
- Promocje w dobrych tygodniach. Sezon i lokalny popyt udają efekt rabatu (rysunek 6).
- Ekstrapolacja. Krzywa obowiązuje tylko w zakresie rabatów z danych (10–40%).
Najczęstsze pytania
Jak zmierzyć, jak sprzedaż reaguje na wielkość rabatu?
Zbierz tygodniową sprzedaż sklepów z promocjami o różnej głębokości i policz regresję Poissona liczby sztuk z efektami stałymi sklepu i tygodnia. Rabat wprowadź elastycznie – splajnem albo osobnym efektem każdego poziomu – a nie jedną prostą. W przykładzie model liniowy dawał +61% przy rabacie 10%, a prawda wynosiła +13%.
Co to jest dołek po promocji?
To spadek sprzedaży w tygodniach po promocji (i czasem przed nią), bo część klientów kupiła wcześniej, kupiła więcej albo czekała na rabat. W przykładzie przy rabacie 25% dołek trwał dwa tygodnie i zabierał 12.5% przyrostu z tygodnia promocji. Van Heerde i in. (2000) szacowali go na 4–25% efektu bieżącego.
Jak policzyć przyrost netto promocji?
Od przyrostu sprzedaży w tygodniu promocji odejmij spadek w tygodniach przed i po promocji oraz spadek sprzedaży pozostałych produktów kategorii (kanibalizację). W przykładzie dla słuchawek przy rabacie 25% z 38.0 sztuki przyrostu na sklep zostało 28.4 sztuki.
Jaki rabat jest najbardziej opłacalny?
Ten, przy którym dodatkowa marża z większej sprzedaży przewyższa marżę oddaną w rabacie, dołku i kanibalizacji – zależy więc od marży kategorii. W przykładzie przychód rósł najbardziej przy 35%, ale zysk był najwyższy przy 25% dla słuchawek (205 zł na promocję, 95% CI [39, 342]) i 30% dla ładowarek, a głośniki z niską marżą traciły przy każdym rabacie.
Dlaczego efekt promocji z danych sprzedażowych bywa zawyżony?
Bo promocje planuje się na dobre tygodnie – sezon, Black Friday, lokalne okazje. Model bez efektów tygodni przypisał rabatowi 40% wzrost +583% zamiast +482%, a gdy terminy wybierał kierownik znający lokalny popyt, efekt przy 25% był zawyżony średnio o 33.0 pp. Pomaga losowanie terminów i głębokości rabatu.
Powiązane hasła
Przeczytaj też
Nieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →PoradnikElastyczność cenowa z danych sprzedażowych
Sieć 10 sklepów i granola: regresja log–log z przedziałem, elastyczność krzyżowa, marża i cena optymalna oraz pułapka ceny ustalanej pod popyt – z kodem R.
Czytaj →PoradnikPromocje w sieci sklepów: model mieszany
Efekt promocji w 40 sklepach: fałszywe alarmy testu t, losowe nachylenie w lme4, wykres gąsienicowy i wielkość miasta z kodem R.
Czytaj →Poradnik„2 za 1” czy −50%? Forma promocji
Sieć sklepów papierniczych: eksperyment z trzema formami promocji, sztuki na paragon, model mieszany, kanibalizacja, dołek i bilans marży – z kodem R.
Czytaj →PoradnikPrzecena końca sezonu
Sieć z odzieżą narciarską: krzywa wyprzedaży, elastyczność słabnąca z tygodniami, pułapka przecen słabych modeli i symulacja strategii – z kodem R.
Czytaj →Analizujesz promocje w pracy dyplomowej?
Pomożemy przygotować dane sprzedażowe, dobrać model krzywej odpowiedzi, policzyć dołki, kanibalizację i zysk z niepewnością oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Gupta, S., & Cooper, L. G. (1992). The discounting of discounts and promotion thresholds. Journal of Consumer Research, 19(3), 401–411. https://doi.org/10.1086/209310 ● Otwarty dostęp
- Macé, S., & Neslin, S. A. (2004). The determinants of pre- and postpromotion dips in sales of frequently purchased goods. Journal of Marketing Research, 41(3), 339–350. https://doi.org/10.1509/jmkr.41.3.339.35992
- Perperoglou, A., Sauerbrei, W., Abrahamowicz, M., & Schmid, M. (2019). A review of spline function procedures in R. BMC Medical Research Methodology, 19(1), Article 46. https://doi.org/10.1186/s12874-019-0666-3 ● Otwarty dostęp
- van Heerde, H. J., Gupta, S., & Wittink, D. R. (2003). Is 75% of the sales promotion bump due to brand switching? No, only 33% is. Journal of Marketing Research, 40(4), 481–491. https://doi.org/10.1509/jmkr.40.4.481.19386
- van Heerde, H. J., Leeflang, P. S. H., & Wittink, D. R. (2000). The estimation of pre- and postpromotion dips with store-level scanner data. Journal of Marketing Research, 37(3), 383–395. https://doi.org/10.1509/jmkr.37.3.383.18782 ● Otwarty dostęp: pełny tekst
- van Heerde, H. J., Leeflang, P. S. H., & Wittink, D. R. (2001). Semiparametric analysis to estimate the deal effect curve. Journal of Marketing Research, 38(2), 197–215. https://doi.org/10.1509/jmkr.38.2.197.18842 ● Otwarty dostęp: pełny tekst
- Villas-Boas, J. M., & Winer, R. S. (1999). Endogeneity in brand choice models. Management Science, 45(10), 1324–1338. https://doi.org/10.1287/mnsc.45.10.1324
Cytowania BibTeX
@article{gupta1992discounting, author={Gupta, Sunil and Cooper, Lee G.}, title={{The discounting of discounts and promotion thresholds}}, journal={Journal of Consumer Research}, year={1992}, volume={19}, number={3}, pages={401--411}, doi={10.1086/209310}}@article{mace2004determinants, author={Mac{\'e}, Sandrine and Neslin, Scott A.}, title={{The determinants of pre- and postpromotion dips in sales of frequently purchased goods}}, journal={Journal of Marketing Research}, year={2004}, volume={41}, number={3}, pages={339--350}, doi={10.1509/jmkr.41.3.339.35992}}@article{perperoglou2019review, author={Perperoglou, Aris and Sauerbrei, Willi and Abrahamowicz, Michal and Schmid, Matthias}, title={{A review of spline function procedures in R}}, journal={BMC Medical Research Methodology}, year={2019}, volume={19}, number={1}, eid={46}, doi={10.1186/s12874-019-0666-3}}@article{vanheerde2003is, author={van Heerde, Harald J. and Gupta, Sachin and Wittink, Dick R.}, title={{Is 75\% of the sales promotion bump due to brand switching? No, only 33\% is}}, journal={Journal of Marketing Research}, year={2003}, volume={40}, number={4}, pages={481--491}, doi={10.1509/jmkr.40.4.481.19386}}@article{vanheerde2000estimation, author={van Heerde, Harald J. and Leeflang, Peter S. H. and Wittink, Dick R.}, title={{The estimation of pre- and postpromotion dips with store-level scanner data}}, journal={Journal of Marketing Research}, year={2000}, volume={37}, number={3}, pages={383--395}, doi={10.1509/jmkr.37.3.383.18782}}@article{vanheerde2001semiparametric, author={van Heerde, Harald J. and Leeflang, Peter S. H. and Wittink, Dick R.}, title={{Semiparametric analysis to estimate the deal effect curve}}, journal={Journal of Marketing Research}, year={2001}, volume={38}, number={2}, pages={197--215}, doi={10.1509/jmkr.38.2.197.18842}}@article{villasboas1999endogeneity, author={Villas-Boas, J. Miguel and Winer, Russell S.}, title={{Endogeneity in brand choice models}}, journal={Management Science}, year={1999}, volume={45}, number={10}, pages={1324--1338}, doi={10.1287/mnsc.45.10.1324}}