Przykład: zakład meblarski i pytanie „skąd ta różnica?”
Fikcyjny zakład meblarski zatrudnia 900 osób: 540 mężczyzn i 360 kobiet w stolarni, maszynowni CNC, lakierni, tapicerni i biurze. Dział kadr przygotowuje raport o wynagrodzeniach i dostaje proste pytanie zarządu: o ile kobiety zarabiają mniej i jaka część tej różnicy wynika z tego, że pracują w innych działach, mają inny staż i wykształcenie, a jaka zostaje po uwzględnieniu tych cech?
Narzędziem jest dekompozycja Oaxaca–Blindera: regresja liniowa logarytmu płacy liczona osobno w dwóch grupach, a potem rozbicie różnicy średnich na dwie części. Policzymy ją ręcznie w bazowym R, z przedziałami z bootstrapu. Wpis nie ocenia niczego prawnie – pokazuje, co liczby mówią, a czego nie.
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy: kobiety trafiają do tapicerni z prawdopodobieństwem .50 i do biura .25 (mężczyźni: .10 i .10), częściej mają wyższe wykształcenie (.20 wobec .12) i średnio krótszy staż; premie działów od −8% (tapicernia) do +10% (CNC) względem stolarni; za rok stażu mężczyźni dostają 1.4%, kobiety 0.7%; stanowisko kierownicze daje +25% mężczyznom i +18% kobietom (w log-punktach), a przy tych samych cechach kobiety zarabiają o 5 log-punktów mniej. Awans też zależy od płci (−1.0 w logicie szansy awansu). Ziarno 643 ustalono raz i nie zmieniano go. Dane pobierzesz jako luka-placowa-zaklad-meblarski.csv (wiersz = pracownik).
Rysunek 1: surowa luka – średnia, mediana i logarytm
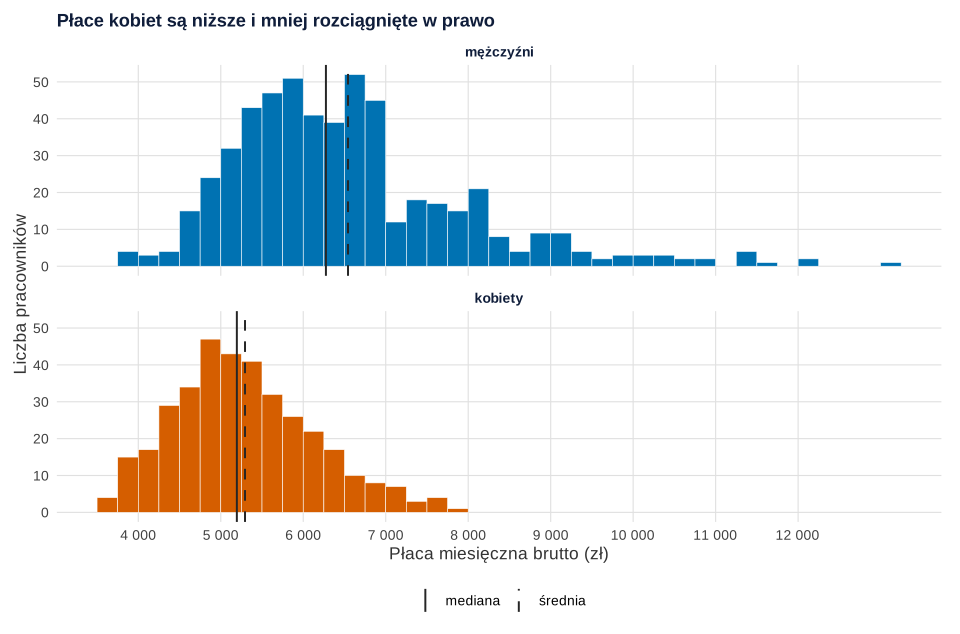
set.seed(643)).Co widać. Średnia płaca mężczyzn to 6542.78 zł, kobiet 5293.92 zł – różnica 1248.86 zł, czyli 19.1% płacy mężczyzn. Mediany: 6275 i 5195 zł, różnica 1080 zł (17.2%). Rozkład mężczyzn ma dłuższy prawy ogon (brygadziści, kierownicy), więc luka średnich jest większa niż luka median.
Dlaczego logarytm. Płace są prawoskośne, a premie działają procentowo. Po transformacji logarytmicznej różnica średnich logarytmów wynosi 0.2025, czyli 20.2 punktu logarytmicznego (log-punktu) – w przybliżeniu 18.3% (1 − e−0.2025). Dalej wszystkie części luki podajemy w log-punktach, bo tylko w tej skali sumują się do całości. Inne skośne miary i ich mediany opisuje wpis o skośnych metrykach.
Jak może zmylić. Wykres nie mówi, czy kobiety i mężczyźni wykonują tę samą pracę. W tapicerni pracuje 49.2% kobiet i 10.2% mężczyzn, w stolarni i maszynowni CNC – 17.0% kobiet i 63.1% mężczyzn. Surowa luka miesza więc „inne stanowiska” z „inną płacą za to samo”.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: jak dekompozycja dzieli lukę
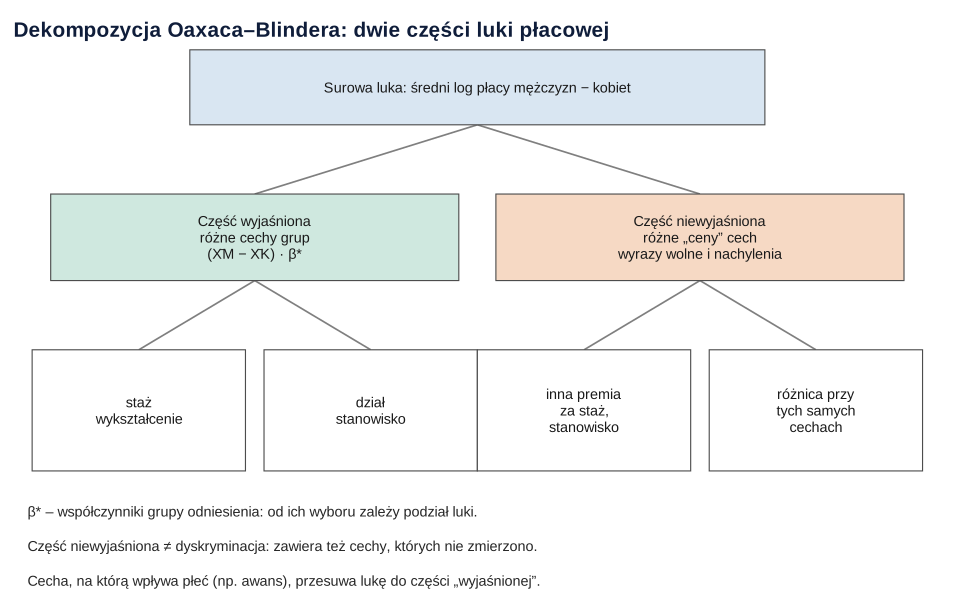
Dekompozycję, opisaną przez Oaxacę (1973) i Blindera, Jann (2008) nazywa techniką kontrfaktyczną: pyta, ile zarabiałyby kobiety, gdyby ich cechy były wyceniane tak jak cechy mężczyzn. Najpierw liczymy regresję log płacy osobno dla mężczyzn (współczynniki βM) i kobiet (βK). Ponieważ prosta regresji przechodzi przez średnie, luka rozkłada się dokładnie na dwie części:
Słowami: część wyjaśniona to różnica średnich cech (staż, odsetek z wyższym wykształceniem, odsetki w działach) przemnożona przez „ceny” tych cech β*. Część niewyjaśniona to wszystko inne: inne nachylenia (np. mniejsza premia za staż) i inne wyrazy wolne. Dekompozycja „szczegółowa” rozbija część wyjaśnioną na wkład każdej zmiennej.
Jak może zmylić. Nazwy kuszą: „wyjaśniona” brzmi jak „uczciwa”, a „niewyjaśniona” jak „dyskryminacja”. Tak nie jest. Oaxaca (1973) zwracał uwagę, że dyskryminacja może działać też przez niekorzystny rozkład kobiet między zawodami – wtedy siedzi w części „wyjaśnionej”. A część niewyjaśniona zawiera cechy, których nie zmierzono.
Podpis do pracy:
Zdanie do Metody:
Regresja log płac w obu grupach
Model to regresja wieloraka logarytmu płacy na staż, wykształcenie i dział (zmienne zero-jedynkowe, poziomy odniesienia: zasadnicze zawodowe i stolarnia) oraz stanowisko kierownicze. Współczynnik 0.105 przy maszynowni CNC u mężczyzn oznacza płacę wyższą o ok. 10.5 log-punktu (ok. 11%) niż w stolarni przy tych samych pozostałych cechach.
| Zmienna | Mężczyźni | Kobiety | Model wspólny |
|---|---|---|---|
| wyraz wolny | 8.527 | 8.469 | 8.545 |
| staż (rok) | 0.013 | 0.008 | 0.012 |
| wykształcenie średnie | 0.055 | 0.061 | 0.058 |
| wykształcenie wyższe | 0.171 | 0.163 | 0.167 |
| maszynownia CNC | 0.105 | 0.122 | 0.106 |
| lakiernia | 0.049 | 0.006 | 0.039 |
| tapicernia | −0.083 | −0.087 | −0.078 |
| biuro | 0.053 | 0.017 | 0.037 |
| stanowisko kierownicze | 0.266 | 0.209 | 0.255 |
| R² | .644 | .485 | .678 |
W modelu wspólnym ze zmienną „kobieta” jej współczynnik wynosi b = −0.117, SE = 0.010, 95% CI [−0.137, −0.098], p < .001, czyli przy tych samych cechach kobiety zarabiają o 11.1% mniej [9.3, 12.8]. To jedna liczba, ale zakłada, że staż czy awans są wyceniane tak samo w obu grupach. Model z interakcjami wszystkich zmiennych z płcią pasuje lepiej: F(8, 882) = 2.77, p = .005 – staż kobiet „kosztuje” 0.008 zamiast 0.013 na rok. Dlatego dekompozycja korzysta z dwóch osobnych regresji.
Rysunek 3: dekompozycja na wykresie wodospadowym
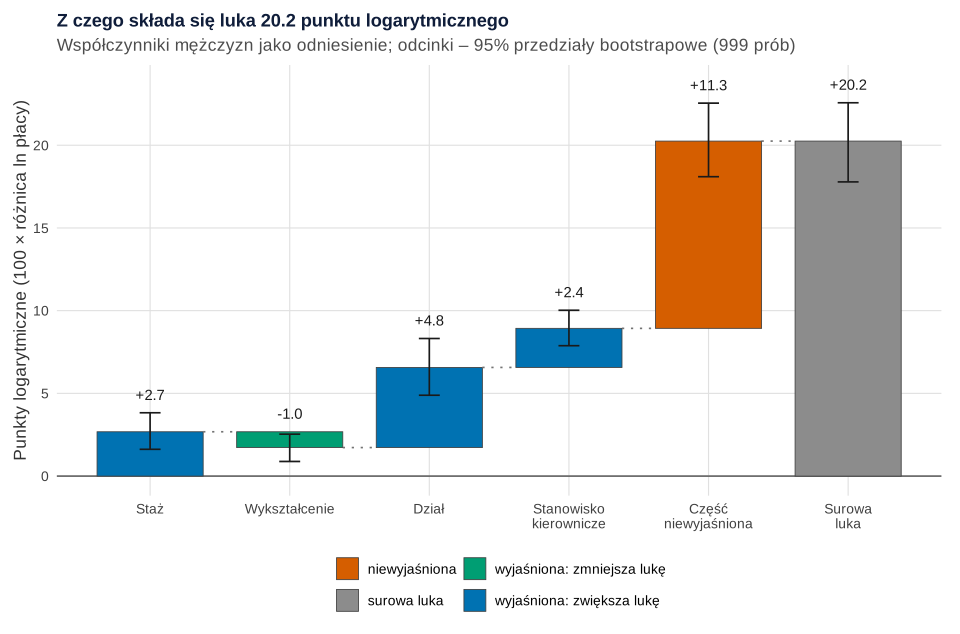
set.seed(643)).Jako β* bierzemy najpierw współczynniki mężczyzn: pytamy, ile zarabiałyby kobiety, gdyby ich cechy wyceniano „po męsku”. Niepewność liczymy bootstrapem (Efron, 1979): 999 razy losujemy ze zwracaniem 540 mężczyzn i 360 kobiet, liczymy obie regresje i dekompozycję od nowa, a 95% przedział to 2.5. i 97.5. centyl wyników. Mechanizm pokazuje wpis bootstrap – wizualizacja na obrazkach.
Co widać. Z 20.2 log-punktu luki część wyjaśniona to 8.9 [6.1, 11.5] (44.1%), a niewyjaśniona 11.3 [9.2, 13.6] (55.9%). Najwięcej wyjaśnia dział: 4.8 [3.2, 6.6] – kobiety częściej pracują w gorzej płatnej tapicerni. Staż dodaje 2.7 [1.6, 3.8], stanowisko kierownicze 2.4 [1.3, 3.5]. Wykształcenie zmniejsza lukę o 1.0 [0.2, 1.8]: kobiety są lepiej wykształcone, więc „według cech” powinny zarabiać więcej.
Jak może zmylić. Kolejność słupków nie ma znaczenia, ale ich wielkość zależy od wyboru β* (rysunek 4) i od tego, które zmienne wpuścisz do modelu. W dekompozycji szczegółowej części niewyjaśnionej wkład zmiennej kategorialnej zależy od wybranej kategorii odniesienia (Jann, 2008), dlatego na rysunku tę część pokazujemy w całości.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: grupa odniesienia i pułapka nadkontroli
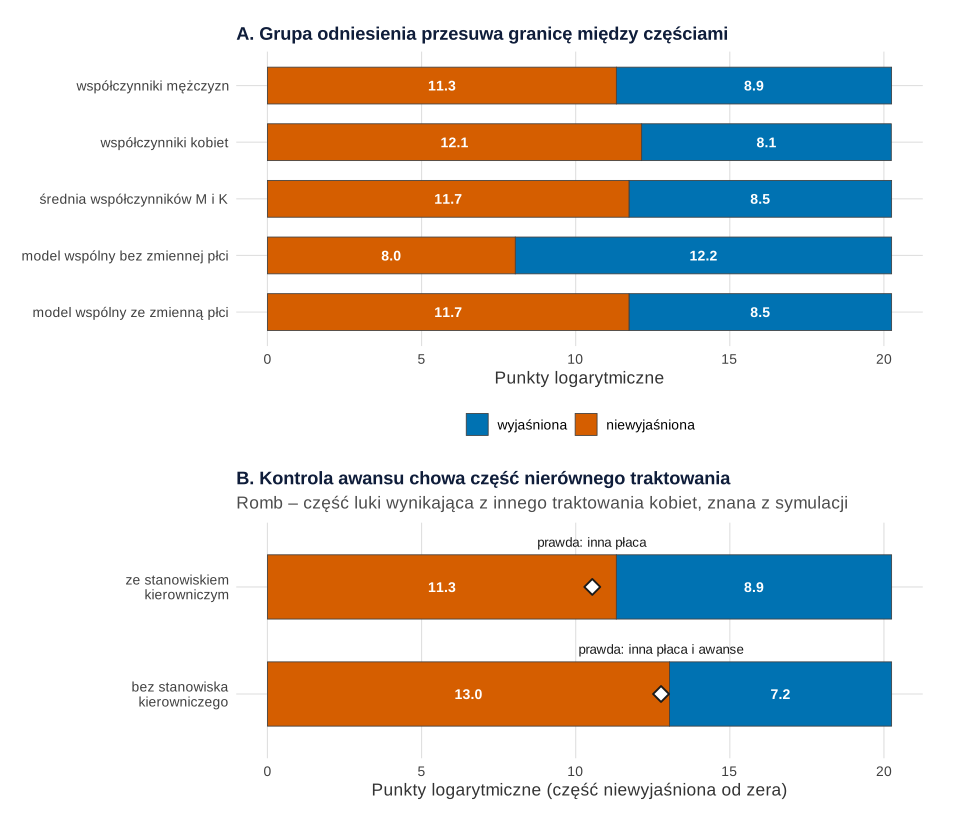
Panel A – kto jest „normą”? Ta sama luka 20.25 log-punktu daje część niewyjaśnioną od 8.0 do 12.1 – od 39.7% do 60.0% luki – zależnie od tego, czyje współczynniki uznamy za wzorcowe. Neumark (1988) pokazał, że każdy wybór odpowiada innym założeniom o zachowaniu pracodawców, i wyprowadził alternatywny estymator. Najbardziej odstaje model wspólny bez zmiennej płci (8.0): jego współczynniki „wchłaniają” część luki, bo np. tapicernia jest gorzej płatna m.in. dlatego, że pracują w niej kobiety. Dodanie zmiennej płci do modelu wspólnego to naprawia (11.7 – w tych danych prawie tyle samo, co średnia współczynników obu grup).
Panel B – „zła kontrola”. W danych awans zależy od płci: przy swoich cechach kobiety miałyby średnio 15.6% szans na stanowisko kierownicze, gdyby awansowano je jak mężczyzn, a mają 6.7%. Stanowisko jest więc częściowo skutkiem nierównego traktowania – zmienną pośredniczącą. Gdy je kontrolujemy, część luki „przechodzi” do części wyjaśnionej: niewyjaśniona spada z 13.0 do 11.3 log-punktu. Cinelli i in. (2024) nazywają to problemem złej kontroli: po dodaniu zmiennej współczynnik przestaje odpowiadać efektowi, o który pytamy. Więcej o tym w haśle zmienna kontrolna i we wpisie o grafach przyczynowych (DAG).
Co widać (romby). Z parametrów symulacji wiemy, że inna płaca przy tych samych cechach (w tym stanowisku) to 10.5 log-punktu, a inna płaca razem z rzadszymi awansami – 12.8. Model ze stanowiskiem trafia w pierwszą liczbę (11.3), model bez stanowiska – w drugą (13.0). Oba są „poprawne”, ale odpowiadają na różne pytania: „czy za tę samą pracę na tym samym stanowisku płaci się mniej?” oraz „ile kobiety tracą łącznie, także przez awanse?”.
Jak może zmylić. W prawdziwych danych nie ma rombów. Która specyfikacja jest właściwa, wynika z pytania i z założeń o przyczynach, nie z dopasowania modelu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: luka w różnych miejscach rozkładu
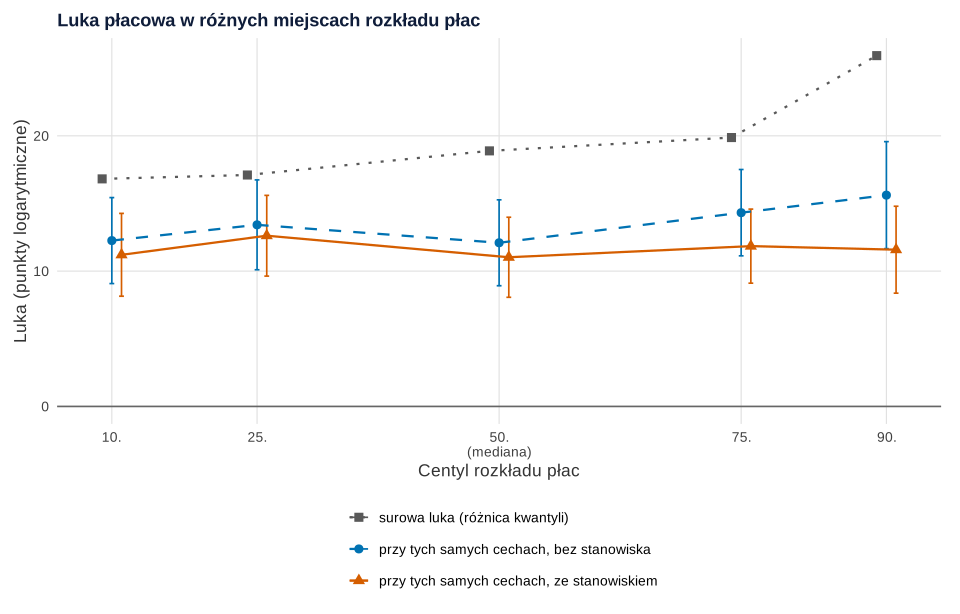
Dekompozycja Oaxaca–Blindera dotyczy średnich. Regresja kwantylowa szacuje modele dla różnych warunkowych kwantyli zamiast samej średniej warunkowej (Koenker i Hallock, 2001). Liczymy ją dla 10., 25., 50., 75. i 90. centyla ze zmienną „kobieta” i tymi samymi cechami; procedurę opisuje wpis regresja kwantylowa krok po kroku.
Co widać. Surowa luka rośnie od 16.8 log-punktu na 10. centylu do 25.9 na 90. – na górze rozkładu różnica jest największa. Przy tych samych cechach ze stanowiskiem luka jest prawie płaska: od 11.0 do 12.6 (średnio 11.7 w MNK). Bez stanowiska rośnie do 15.6 na 90. centylu – „szklany sufit” w tych danych działa przez awanse. Podobny obraz – luka malejąca najwolniej na szczycie rozkładu – opisują Blau i Kahn (2017).
Jak może zmylić. Współczynnik regresji kwantylowej to różnica warunkowych kwantyli, a nie luka „dla najlepiej zarabiających kobiet”. Pełna dekompozycja kwantylowa wymaga osobnych metod (np. kontrfaktycznych rozkładów) – tu wystarczy sygnał, że średnia nie mówi wszystkiego.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w firmie
- Raportuj trzy liczby, nie jedną: surową lukę (19.1% średnich, 17.2% median), lukę przy tych samych cechach i jej zakres przy różnych założeniach (tu 8.0–13.0 log-punktu).
- Sprawdź ścieżki awansu. Kobiety awansują przy tych samych cechach ponad dwa razy rzadziej (6.7% wobec 15.6%). To osobna analiza – regresja logistyczna awansu albo czas do awansu jak w analizie rotacji pracowników.
- Przejrzyj siatkę płac działów. Dział wyjaśnia największą część luki (4.8 log-punktu). Warto zapytać, czy tapicernia jest gorzej płatna z powodu wymagań pracy, czy dlatego, że pracują tam głównie kobiety.
- Porównaj premię za staż. 1.3% rocznie u mężczyzn i 0.8% u kobiet to konkretna reguła do sprawdzenia w systemie wynagrodzeń.
- Zmiany oceniaj jak interwencję. Jeśli firma zmieni zasady awansów lub siatkę płac, efekt najlepiej ocenić porównaniem z grupą bez zmiany – jak we wpisie o efekcie szkolenia metodą różnicy w różnicach. Różnice między zespołami lepiej porównywać modelem wielopoziomowym, jak w badaniu zaangażowania pracowników.
Pułapki
- „Część niewyjaśniona = dyskryminacja”. To górna lub dolna granica tylko przy mocnych założeniach: brak pominiętych cech i brak cech będących skutkiem płci.
- Nadkontrola. Stanowisko, dział, a nawet wymiar etatu mogą być skutkiem nierównego traktowania. Pokaż wyniki z nimi i bez nich (rysunek 4B).
- Jedna grupa odniesienia bez uzasadnienia. Podaj, którą wybrałeś i dlaczego, a w aneksie inne warianty.
- Procenty zamiast log-punktów. Części sumują się tylko w skali logarytmu; procent licz na końcu.
- Szczegółowa część niewyjaśniona dla działów – zależy od kategorii odniesienia, więc nie interpretuj jej słupek po słupku.
- Błędy standardowe bez bootstrapu lub bez uwzględnienia losowości średnich cech – przedziały będą za wąskie.
Jak opisać w pracy
W Metodzie opisz zmienną zależną (logarytm płacy miesięcznej brutto), zmienne objaśniające i uzasadnienie każdej z nich, wybór współczynników odniesienia i sposób liczenia przedziałów. W Wynikach – surową lukę, obie części z CI, dekompozycję szczegółową części wyjaśnionej i co najmniej jeden wariant odporności. Ogólne zasady pracy empirycznej z zarządzania opisują wpisy statystyka w pracy z zarządzania i ekonomii oraz jak napisać pracę z zarządzania i ekonomii.
Kod R: dane, regresje, dekompozycja, bootstrap i rysunki
Kod odtwarza wszystkie liczby z tekstu, tabelę i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, przepis 3 – funkcję dekompozycja(), z których korzystają kolejne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane) i 3 (bootstrap); każdy zaczyna losowanie od własnego set.seed(643). Ziarno 643 ustalono raz i nie zmieniano go. Ręcznie ustalono: 900 pracowników (360 kobiet), prawdopodobieństwa działów i wykształcenia w grupach, rozkład stażu (gamma o kształcie 2 i skali 4.5 dla mężczyzn i 3.5 dla kobiet, najwyżej 35 lat), model awansu (logit: −3.0 + 0.08 × staż + 0.8 średnie + 1.5 wyższe − 1.0 kobieta), płacę bazową 5000 zł, premie wykształcenia (0.06, 0.18) i działów (0.10, 0.03, −0.08, 0.05), zwrot ze stażu (0.014 i 0.007), premię za stanowisko (0.25 i 0.18), różnicę −0.05 dla kobiet przy tych samych cechach, SD składnika losowego 0.12 oraz liczbę prób bootstrapowych (999).
1. Paleta, dane, surowa luka i rysunki 1–2
R
# Rysunki 1 i 2. Fikcyjny zakład meblarski: 900 pracowników, płace i surowa luka płacowa (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
kol_plec <- c("mężczyźni" = "#0072B2", "kobiety" = "#D55E00")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie: skład załogi, przydział do działów, awanse i płace (log płacy miesięcznej brutto)
N <- 900; N_k <- 360                                        # 360 kobiet i 540 mężczyzn
dzialy <- c("stolarnia", "maszynownia CNC", "lakiernia", "tapicernia", "biuro")
p_dzial <- list(M = c(.40, .25, .15, .10, .10), K = c(.10, .05, .10, .50, .25))
wyksz <- c("zasadnicze zawodowe", "średnie", "wyższe")
p_wyksz <- list(M = c(.50, .38, .12), K = c(.40, .40, .20))  # kobiety częściej mają wyższe wykształcenie
premia_dzial <- c(0, .10, .03, -.08, .05)                   # względem stolarni
premia_wyksz <- c(0, .06, .18)                              # względem zasadniczego zawodowego
staz_na_rok <- c(M = .014, K = .007)                        # zwrot z roku stażu różny w grupach
premia_kier <- c(M = .25, K = .18)                          # premia za stanowisko kierownicze
kara_k <- -.05                                              # bezpośrednia różnica dla kobiet przy tych samych cechach
sd_e <- .12

set.seed(643)                                               # ziarno ustalone raz, bez dobierania pod wynik
plec <- rep(c("K", "M"), times = c(N_k, N - N_k))
dzial <- wyksz_os <- character(N); staz <- numeric(N)
for (g in c("K", "M")) {
  i <- which(plec == g)
  dzial[i] <- sample(dzialy, length(i), replace = TRUE, prob = p_dzial[[g]])
  wyksz_os[i] <- sample(wyksz, length(i), replace = TRUE, prob = p_wyksz[[g]])
  staz[i] <- pmin(round(rgamma(length(i), shape = 2, scale = ifelse(g == "M", 4.5, 3.5)), 1), 35)
}
kob <- as.integer(plec == "K")
# Awans na brygadzistę lub kierownika zależy od stażu, wykształcenia – i od płci (to „zła kontrola” w dalszej części)
p_awans <- plogis(-3.0 + .08 * staz + .8 * (wyksz_os == "średnie") + 1.5 * (wyksz_os == "wyższe") - 1.0 * kob)
kierownik <- rbinom(N, 1, p_awans)
lnw <- log(5000) + ifelse(kob == 1, staz_na_rok["K"], staz_na_rok["M"]) * staz +
  premia_wyksz[match(wyksz_os, wyksz)] + premia_dzial[match(dzial, dzialy)] +
  ifelse(kob == 1, premia_kier["K"], premia_kier["M"]) * kierownik + kara_k * kob + rnorm(N, 0, sd_e)
dane <- data.frame(id = 1:N, plec = factor(ifelse(kob == 1, "kobiety", "mężczyźni"), levels = c("mężczyźni", "kobiety")),
                   kobieta = kob, staz = staz, wyksztalcenie = factor(wyksz_os, levels = wyksz),
                   dzial = factor(dzial, levels = dzialy), kierownik = kierownik, placa = round(exp(lnw), -1))
dane$ln_placa <- log(dane$placa)
write.csv(dane, "luka-placowa-zaklad-meblarski.csv", row.names = FALSE)

# Surowa luka: średnia, mediana i różnica średnich logarytmów
table(dane$plec)
sr <- tapply(dane$placa, dane$plec, mean); me <- tapply(dane$placa, dane$plec, median)
ln <- tapply(dane$ln_placa, dane$plec, mean)
round(rbind(srednia = sr, mediana = me, srednia_log = ln), 3)
c(luka_srednia_zl = unname(sr[1] - sr[2]), luka_srednia_proc = unname(100 * (1 - sr[2] / sr[1])),
  luka_mediana_zl = unname(me[1] - me[2]), luka_mediana_proc = unname(100 * (1 - me[2] / me[1])),
  luka_log = unname(ln[1] - ln[2]), luka_log_proc = unname(100 * (1 - exp(-(ln[1] - ln[2])))))
# Skład grup: odsetki w działach, wykształcenie, staż, stanowiska kierownicze
round(100 * prop.table(table(dane$dzial, dane$plec), 2), 1)
round(100 * prop.table(table(dane$wyksztalcenie, dane$plec), 2), 1)
round(rbind(staz = tapply(dane$staz, dane$plec, mean), kierownik_proc = 100 * tapply(dane$kierownik, dane$plec, mean)), 2)

# Rysunek 1. Rozkład płac w obu grupach: histogram z medianą (linia ciągła) i średnią (przerywana)
linie <- data.frame(plec = factor(rep(levels(dane$plec), 2), levels = levels(dane$plec)),
                    wartosc = c(me, sr), miara = rep(c("mediana", "średnia"), each = 2))
p1 <- ggplot(dane, aes(placa, fill = plec)) +
  geom_histogram(binwidth = 250, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(data = linie, aes(xintercept = wartosc, linetype = miara), colour = "grey15", linewidth = 0.7) +
  facet_wrap(~ plec, ncol = 1) +
  scale_fill_manual(values = kol_plec, guide = "none") +
  scale_linetype_manual(values = c("mediana" = "solid", "średnia" = "dashed")) +
  scale_x_continuous(labels = scales::label_number(big.mark = " "), breaks = seq(4000, 12000, 1000)) +
  labs(title = "Płace kobiet są niższe i mniej rozciągnięte w prawo",
       x = "Płaca miesięczna brutto (zł)", y = "Liczba pracowników", linetype = NULL) +
  motyw
p1   # zapis: ggsave("luka-placowa-rozklad-plac.svg", p1, width = 10, height = 6.6)

# Rysunek 2. Grafika: jak dekompozycja dzieli lukę na część wyjaśnioną i niewyjaśnioną
pud <- data.frame(
  x = c(5, 2.6, 7.4, 1.35, 3.85, 6.15, 8.65), y = c(8.9, 6.3, 6.3, 3.3, 3.3, 3.3, 3.3),
  w = c(6.2, 4.4, 4.4, 2.3, 2.3, 2.3, 2.3), h = c(1.3, 1.5, 1.5, 2.1, 2.1, 2.1, 2.1),
  typ = c("luka", "wyj", "niewyj", "wyj2", "wyj2", "niewyj2", "niewyj2"),
  tekst = c("Surowa luka: średni log płacy mężczyzn − kobiet",
            "Część wyjaśniona\nróżne cechy grup\n(X̄M − X̄K) · β*",
            "Część niewyjaśniona\nróżne „ceny” cech\nwyrazy wolne i nachylenia",
            "staż\nwykształcenie", "dział\nstanowisko",
            "inna premia\nza staż,\nstanowisko", "różnica przy\ntych samych\ncechach"))
odc <- data.frame(x = c(5, 5, 2.6, 2.6, 7.4, 7.4), y = c(8.25, 8.25, 5.55, 5.55, 5.55, 5.55),
                  xend = c(2.6, 7.4, 1.35, 3.85, 6.15, 8.65), yend = c(7.05, 7.05, 4.35, 4.35, 4.35, 4.35))
opis <- data.frame(x = 0.15, y = c(1.55, 0.95, 0.35), hjust = 0,
  tekst = c("β* – współczynniki grupy odniesienia: od ich wyboru zależy podział luki.",
            "Część niewyjaśniona ≠ dyskryminacja: zawiera też cechy, których nie zmierzono.",
            "Cecha, na którą wpływa płeć (np. awans), przesuwa lukę do części „wyjaśnionej”."))
p2 <- ggplot() +
  geom_segment(data = odc, aes(x, y, xend = xend, yend = yend), colour = "grey50", linewidth = 0.6) +
  geom_tile(data = pud, aes(x, y, width = w, height = h, fill = typ), colour = "grey30", linewidth = 0.4) +
  geom_text(data = pud, aes(x, y, label = tekst), size = 3.8, lineheight = 0.95, colour = "grey10") +
  geom_text(data = opis, aes(x, y, label = tekst, hjust = hjust), size = 3.8, colour = "grey15") +
  scale_fill_manual(values = c(luka = "#D9E6F2", wyj = "#CFE8DF", wyj2 = "#FFFFFF",
                               niewyj = "#F6D9C4", niewyj2 = "#FFFFFF"), guide = "none") +
  coord_cartesian(xlim = c(0, 10), ylim = c(0, 9.7), expand = FALSE) +
  labs(title = "Dekompozycja Oaxaca–Blindera: dwie części luki płacowej") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
p2   # zapis: ggsave("luka-placowa-schemat-dekompozycji.svg", p2, width = 10, height = 6.4)
Wynik w R
mężczyźni   kobiety
      540       360
            mężczyźni  kobiety
srednia      6542.778 5293.917
mediana      6275.000 5195.000
srednia_log     8.764    8.562
  luka_srednia_zl luka_srednia_proc   luka_mediana_zl luka_mediana_proc
     1248.8611111        19.0876284      1080.0000000        17.2111554
         luka_log     luka_log_proc
        0.2024867        18.3302651

                  mężczyźni kobiety
  stolarnia            38.3    11.4
  maszynownia CNC      24.8     5.6
  lakiernia            16.3    10.0
  tapicernia           10.2    49.2
  biuro                10.4    23.9

                      mężczyźni kobiety
  zasadnicze zawodowe      50.7    45.3
  średnie                  36.9    36.7
  wyższe                   12.4    18.1
               mężczyźni kobiety
staz                9.26    7.24
kierownik_proc     15.56    6.67
2. Regresje logarytmu płacy: Tabela 1
R
# Tabela 1. Regresja logarytmu płacy: osobno dla mężczyzn i kobiet oraz model wspólny ze zmienną kobieta (dane z przepisu 1)
wzor <- ln_placa ~ staz + wyksztalcenie + dzial + kierownik
m_M <- lm(wzor, data = subset(dane, plec == "mężczyźni"))
m_K <- lm(wzor, data = subset(dane, plec == "kobiety"))
m_W <- lm(update(wzor, . ~ . + kobieta), data = dane)      # model wspólny z „efektem płci”

tab <- cbind(mezczyzni = coef(m_M), kobiety = coef(m_K), wspolny = coef(m_W)[names(coef(m_M))])
round(tab, 3)
round(c(R2_M = summary(m_M)$r.squared, R2_K = summary(m_K)$r.squared, R2_wspolny = summary(m_W)$r.squared), 3)

# Współczynnik zmiennej kobieta w modelu wspólnym: log-punkty i procent (exp(b) − 1)
b <- coef(summary(m_W))["kobieta", ]
ci <- confint(m_W)["kobieta", ]
round(c(b = b[["Estimate"]], SE = b[["Std. Error"]], t = b[["t value"]], dolna = ci[[1]], gorna = ci[[2]]), 3)
signif(b[["Pr(>|t|)"]], 3)
round(100 * (exp(c(b = b[["Estimate"]], ci)) - 1), 1)        # różnica w procentach przy tych samych cechach
# Czy „ceny” cech różnią się między grupami? Test F modelu z interakcjami wszystkich zmiennych z płcią
m_int <- lm(ln_placa ~ (staz + wyksztalcenie + dzial + kierownik) * kobieta, data = dane)
anova(m_W, m_int)
Wynik w R
                     mezczyzni kobiety wspolny
(Intercept)              8.527   8.469   8.545
staz                     0.013   0.008   0.012
wyksztalcenieśrednie     0.055   0.061   0.058
wyksztalceniewyższe      0.171   0.163   0.167
dzialmaszynownia CNC     0.105   0.122   0.106
dziallakiernia           0.049   0.006   0.039
dzialtapicernia         -0.083  -0.087  -0.078
dzialbiuro               0.053   0.017   0.037
kierownik                0.266   0.209   0.255
      R2_M       R2_K R2_wspolny
     0.644      0.485      0.678
      b      SE       t   dolna   gorna
 -0.117   0.010 -11.763  -0.137  -0.098
[1] 8.55e-30
     b  2.5 % 97.5 %
 -11.1  -12.8   -9.3
Analysis of Variance Table

Model 1: ln_placa ~ staz + wyksztalcenie + dzial + kierownik + kobieta
Model 2: ln_placa ~ (staz + wyksztalcenie + dzial + kierownik) * kobieta
  Res.Df    RSS Df Sum of Sq      F   Pr(>F)
1    890 13.103
2    882 12.781  8   0.32169 2.7749 0.004918 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
3. Dekompozycja ręcznie i bootstrap: Rysunek 3
R
# Rysunek 3. Dekompozycja Oaxaca–Blindera „ręcznie” z bootstrapowymi przedziałami i wykres wodospadowy (dane z przepisu 1)
library(ggplot2)                                  # paleta kol i motyw z przepisu 1

# Dekompozycja dwuczęściowa: luka = (X̄M − X̄K)·β* [wyjaśniona] + reszta [niewyjaśniona]
# ref: "M" – współczynniki mężczyzn, "K" – kobiet, "wspolny" – model wspólny ze zmienną kobieta,
#      "wspolny_bez" – model wspólny bez zmiennej kobieta, "polowa" – średnia współczynników M i K
dekompozycja <- function(d, wzor, ref = "M") {
  dM <- d[d$kobieta == 0, ]; dK <- d[d$kobieta == 1, ]
  XM <- model.matrix(wzor, dM); XK <- model.matrix(wzor, dK)
  bM <- coef(lm(wzor, dM)); bK <- coef(lm(wzor, dK))
  b_ref <- switch(ref, M = bM, K = bK, polowa = (bM + bK) / 2,
                  wspolny = coef(lm(update(wzor, . ~ . + kobieta), d))[names(bM)],
                  wspolny_bez = coef(lm(wzor, d)))
  roznica_x <- colMeans(XM) - colMeans(XK)
  luka <- mean(dM$ln_placa) - mean(dK$ln_placa)
  czesci <- roznica_x * b_ref                     # wkład każdej kolumny do części wyjaśnionej
  grupa <- sub("^(wyksztalcenie|dzial).*", "\\1", names(czesci))  # poziomy zmiennej kategorialnej sumujemy
  wyj <- tapply(czesci, grupa, sum)[c("staz", "wyksztalcenie", "dzial", "kierownik")]
  wyj <- wyj[!is.na(wyj)]
  c(luka = luka, wyjasniona = sum(czesci), niewyjasniona = luka - sum(czesci), wyj)
}

wzor <- ln_placa ~ staz + wyksztalcenie + dzial + kierownik
d0 <- dekompozycja(dane, wzor, ref = "M")
round(d0, 4)
round(100 * d0[c("wyjasniona", "niewyjasniona")] / d0[["luka"]], 1)   # udział części w luce (%)

# Bootstrap: losowanie ze zwracaniem osobno w grupie mężczyzn i kobiet (liczebności grup stałe)
set.seed(643)
B <- 999
iM <- which(dane$kobieta == 0); iK <- which(dane$kobieta == 1)
boot <- t(replicate(B, dekompozycja(dane[c(sample(iM, replace = TRUE), sample(iK, replace = TRUE)), ], wzor, ref = "M")))
ci <- apply(boot, 2, quantile, probs = c(.025, .975))
tab <- data.frame(oszacowanie = d0, SE_boot = apply(boot, 2, sd), dolna = ci[1, ], gorna = ci[2, ])
round(tab, 4)

# Wykres wodospadowy w punktach logarytmicznych (100 × różnica logarytmów)
kroki <- c("staz", "wyksztalcenie", "dzial", "kierownik", "niewyjasniona")
etyk <- c("Staż", "Wykształcenie", "Dział", "Stanowisko\nkierownicze", "Część\nniewyjaśniona")
w <- data.frame(krok = factor(etyk, levels = c(etyk, "Surowa\nluka")), wartosc = 100 * d0[kroki],
                dolna = 100 * ci[1, kroki], gorna = 100 * ci[2, kroki])
w$koniec <- cumsum(w$wartosc); w$start <- w$koniec - w$wartosc
w$rodzaj <- ifelse(w$krok == "Część\nniewyjaśniona", "niewyjaśniona", ifelse(w$wartosc >= 0, "wyjaśniona: zwiększa lukę", "wyjaśniona: zmniejsza lukę"))
suma <- data.frame(krok = factor("Surowa\nluka", levels = levels(w$krok)), wartosc = 100 * d0[["luka"]],
                   dolna = 100 * ci[1, "luka"], gorna = 100 * ci[2, "luka"], koniec = 100 * d0[["luka"]], start = 0, rodzaj = "surowa luka")
w <- rbind(w, suma); w$x <- seq_len(nrow(w))
# przedział bootstrapowy rysujemy wokół końca słupka (długość słupka ± niepewność)
w$y_d <- w$start + w$dolna; w$y_g <- w$start + w$gorna
p3 <- ggplot(w) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_rect(aes(xmin = x - 0.38, xmax = x + 0.38, ymin = start, ymax = koniec, fill = rodzaj), colour = "grey25", linewidth = 0.3) +
  geom_segment(data = w[w$x < nrow(w), ], aes(x = x + 0.38, xend = x + 0.62, y = koniec, yend = koniec), colour = "grey45", linetype = "dotted") +
  geom_errorbar(aes(x = x, ymin = y_d, ymax = y_g), width = 0.15, colour = "grey10") +
  geom_text(aes(x = x, y = pmax(start, koniec, y_g) + 1.1, label = sprintf("%+.1f", wartosc)), size = 3.9, colour = "grey10") +
  scale_x_continuous(breaks = w$x, labels = levels(w$krok)) +
  scale_fill_manual(values = c("wyjaśniona: zwiększa lukę" = kol[["niebieski"]], "wyjaśniona: zmniejsza lukę" = kol[["zielony"]],
                               "niewyjaśniona" = kol[["cynober"]], "surowa luka" = "grey55")) +
  labs(title = sprintf("Z czego składa się luka %.1f punktu logarytmicznego", 100 * d0[["luka"]]),
       subtitle = "Współczynniki mężczyzn jako odniesienie; odcinki – 95% przedziały bootstrapowe (999 prób)",
       x = NULL, y = "Punkty logarytmiczne (100 × różnica ln płacy)", fill = NULL) +
  guides(fill = guide_legend(nrow = 2)) +
  motyw
p3   # zapis: ggsave("luka-placowa-wodospad.svg", p3, width = 10, height = 6.6)
Wynik w R
         luka    wyjasniona niewyjasniona          staz wyksztalcenie
       0.2025        0.0893        0.1132        0.0268       -0.0095
        dzial     kierownik
       0.0484        0.0236
   wyjasniona niewyjasniona
         44.1          55.9
              oszacowanie SE_boot   dolna   gorna
luka               0.2025  0.0125  0.1778  0.2256
wyjasniona         0.0893  0.0131  0.0606  0.1146
niewyjasniona      0.1132  0.0112  0.0917  0.1361
staz               0.0268  0.0056  0.0162  0.0383
wyksztalcenie     -0.0095  0.0041 -0.0179 -0.0015
dzial              0.0484  0.0086  0.0316  0.0659
kierownik          0.0236  0.0055  0.0131  0.0346
4. Grupa odniesienia i nadkontrola: Rysunek 4
R
# Rysunek 4. Wybór grupy odniesienia i pułapka nadkontroli (funkcja dekompozycja() z przepisu 3, parametry z przepisu 1)
library(ggplot2); library(patchwork)

# (A) Ta sama luka, pięć wersji współczynników odniesienia β*
wzor <- ln_placa ~ staz + wyksztalcenie + dzial + kierownik
warianty <- c("M" = "współczynniki mężczyzn", "K" = "współczynniki kobiet", "polowa" = "średnia współczynników M i K",
              "wspolny_bez" = "model wspólny bez zmiennej płci", "wspolny" = "model wspólny ze zmienną płci")
A <- t(sapply(names(warianty), function(r) dekompozycja(dane, wzor, ref = r)[c("luka", "wyjasniona", "niewyjasniona")]))
A <- data.frame(wariant = warianty, round(100 * A, 2), udzial_niewyj_proc = round(100 * A[, 3] / A[, 1], 1), row.names = NULL)
A

# (B) Czy kontrolować stanowisko kierownicze? Awans sam zależy od płci (przepis 1: −1.0 w logicie awansu)
wzor_bez <- ln_placa ~ staz + wyksztalcenie + dzial
B_tab <- rbind("ze stanowiskiem" = dekompozycja(dane, wzor, "M")[c("luka", "wyjasniona", "niewyjasniona")],
               "bez stanowiska"  = dekompozycja(dane, wzor_bez, "M")[c("luka", "wyjasniona", "niewyjasniona")])
round(100 * B_tab, 2)

# Prawda znana z symulacji (oczekiwane wartości z parametrów przepisu 1, dla cech kobiet z próby)
k <- dane[dane$kobieta == 1, ]
x_aw <- -3.0 + .08 * k$staz + .8 * (k$wyksztalcenie == "średnie") + 1.5 * (k$wyksztalcenie == "wyższe")
p_jak_M <- plogis(x_aw); p_jak_K <- plogis(x_aw - 1.0)            # szansa awansu „jak mężczyzna” i faktyczna
placa_tylko <- mean((staz_na_rok["M"] - staz_na_rok["K"]) * k$staz +
                    (premia_kier["M"] - premia_kier["K"]) * k$kierownik - kara_k)       # inne traktowanie w płacy
calosc <- mean((staz_na_rok["M"] - staz_na_rok["K"]) * k$staz + premia_kier["M"] * p_jak_M -
               premia_kier["K"] * p_jak_K - kara_k)                                    # w płacy i w awansach
round(100 * c(prawda_tylko_placa = placa_tylko, prawda_placa_i_awanse = calosc), 2)
round(100 * c(awans_jak_M = mean(p_jak_M), awans_faktyczny = mean(p_jak_K)), 1)

# Rysunek 4: dwa panele jeden pod drugim
dA <- rbind(data.frame(wariant = A$wariant, czesc = "wyjaśniona", wartosc = A$wyjasniona),
            data.frame(wariant = A$wariant, czesc = "niewyjaśniona", wartosc = A$niewyjasniona))
dA$wariant <- factor(dA$wariant, levels = rev(warianty))
dA$czesc <- factor(dA$czesc, levels = c("wyjaśniona", "niewyjaśniona"))
pA <- ggplot(dA, aes(wartosc, wariant, fill = czesc)) +
  geom_col(width = 0.65, colour = "grey25", linewidth = 0.3) +
  geom_text(aes(label = sprintf("%.1f", wartosc)), position = position_stack(vjust = 0.5), size = 3.7, colour = "white", fontface = "bold") +
  scale_fill_manual(values = c("wyjaśniona" = kol[["niebieski"]], "niewyjaśniona" = kol[["cynober"]]), breaks = c("wyjaśniona", "niewyjaśniona")) +
  labs(title = "A. Grupa odniesienia przesuwa granicę między częściami",
       x = "Punkty logarytmiczne", y = NULL, fill = NULL) +
  motyw
dB <- data.frame(model = factor(rep(c("ze stanowiskiem\nkierowniczym", "bez stanowiska\nkierowniczego"), 2),
                                levels = c("bez stanowiska\nkierowniczego", "ze stanowiskiem\nkierowniczym")),
                 czesc = factor(rep(c("wyjaśniona", "niewyjaśniona"), each = 2), levels = c("wyjaśniona", "niewyjaśniona")),
                 wartosc = 100 * c(B_tab[, "wyjasniona"], B_tab[, "niewyjasniona"]))
prawda <- data.frame(model = factor(c("ze stanowiskiem\nkierowniczym", "bez stanowiska\nkierowniczego"), levels = levels(dB$model)),
                     wartosc = 100 * c(placa_tylko, calosc),
                     opis = c("prawda: inna płaca", "prawda: inna płaca i awanse"))
pB <- ggplot(dB, aes(wartosc, model)) +
  geom_col(aes(fill = czesc), width = 0.6, colour = "grey25", linewidth = 0.3) +
  geom_text(aes(label = sprintf("%.1f", wartosc), group = czesc), position = position_stack(vjust = 0.5), size = 3.7, colour = "white", fontface = "bold") +
  geom_point(data = prawda, aes(x = wartosc), shape = 23, size = 3.8, fill = "white", colour = "grey10", stroke = 1) +
  geom_text(data = prawda, aes(x = wartosc, label = opis), nudge_y = 0.42, size = 3.5, colour = "grey10") +
  scale_fill_manual(values = c("wyjaśniona" = kol[["niebieski"]], "niewyjaśniona" = kol[["cynober"]]), guide = "none") +
  labs(title = "B. Kontrola awansu chowa część nierównego traktowania",
       subtitle = "Romb – część luki wynikająca z innego traktowania kobiet, znana z symulacji",
       x = "Punkty logarytmiczne (część niewyjaśniona od zera)", y = NULL) +
  motyw
p4 <- pA / pB + plot_layout(heights = c(1.25, 1))
p4   # zapis: ggsave("luka-placowa-warianty-i-nadkontrola.svg", p4, width = 10, height = 8.6)
Wynik w R
                          wariant  luka wyjasniona niewyjasniona
1          współczynniki mężczyzn 20.25       8.93         11.32
2            współczynniki kobiet 20.25       8.10         12.14
3    średnia współczynników M i K 20.25       8.52         11.73
4 model wspólny bez zmiennej płci 20.25      12.21          8.04
5   model wspólny ze zmienną płci 20.25       8.52         11.73
  udzial_niewyj_proc
1               55.9
2               60.0
3               57.9
4               39.7
5               57.9
                 luka wyjasniona niewyjasniona
ze stanowiskiem 20.25       8.93         11.32
bez stanowiska  20.25       7.21         13.04
   prawda_tylko_placa prawda_placa_i_awanse
                10.54                 12.77
    awans_jak_M awans_faktyczny
           15.6             6.7
5. Regresja kwantylowa: Rysunek 5
R
# Rysunek 5. Luka w różnych miejscach rozkładu: surowe różnice kwantyli i regresja kwantylowa (dane z przepisu 1)
library(quantreg); library(ggplot2)

tau <- c(.10, .25, .50, .75, .90)
qM <- quantile(dane$ln_placa[dane$kobieta == 0], tau, type = 7)
qK <- quantile(dane$ln_placa[dane$kobieta == 1], tau, type = 7)
surowa <- 100 * (qM - qK)                                    # surowa luka w punktach logarytmicznych

# Luka przy tych samych cechach: −100 × współczynnik zmiennej kobieta w regresji kwantylowej
rq_luka <- function(wzor) t(sapply(tau, function(t) {
  s <- summary(rq(wzor, tau = t, data = dane, method = "fn"), se = "ker")$coefficients["kobieta", ]
  -100 * c(luka = s[["Value"]], dolna = s[["Value"]] + 1.96 * s[["Std. Error"]], gorna = s[["Value"]] - 1.96 * s[["Std. Error"]])
}))
war_pelny <- rq_luka(ln_placa ~ kobieta + staz + wyksztalcenie + dzial + kierownik)
war_bez <- rq_luka(ln_placa ~ kobieta + staz + wyksztalcenie + dzial)
round(data.frame(tau, surowa = surowa, war_pelny, bez_stanowiska = war_bez[, "luka"], row.names = NULL), 2)
# Dla porównania: średnia (MNK) – ta sama specyfikacja
round(-100 * coef(lm(ln_placa ~ kobieta + staz + wyksztalcenie + dzial + kierownik, dane))[["kobieta"]], 2)

k5 <- rbind(data.frame(tau, luka = surowa, dolna = NA, gorna = NA, rodzaj = "surowa luka (różnica kwantyli)"),
            data.frame(tau, war_bez, rodzaj = "przy tych samych cechach, bez stanowiska"),
            data.frame(tau, war_pelny, rodzaj = "przy tych samych cechach, ze stanowiskiem"))
k5$rodzaj <- factor(k5$rodzaj, levels = unique(k5$rodzaj))
p5 <- ggplot(k5, aes(tau, luka, colour = rodzaj, shape = rodzaj, linetype = rodzaj)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.015, linetype = "solid", na.rm = TRUE,
                position = position_dodge(width = 0.03)) +
  geom_line(linewidth = 0.8, position = position_dodge(width = 0.03)) +
  geom_point(size = 2.8, position = position_dodge(width = 0.03)) +
  scale_x_continuous(breaks = tau, labels = c("10.", "25.", "50.\n(mediana)", "75.", "90.")) +
  scale_colour_manual(values = c("grey35", kol[["niebieski"]], kol[["cynober"]])) +
  scale_shape_manual(values = c(15, 16, 17)) +
  scale_linetype_manual(values = c("dotted", "dashed", "solid")) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  labs(title = "Luka płacowa w różnych miejscach rozkładu płac",
       x = "Centyl rozkładu płac", y = "Luka (punkty logarytmiczne)", colour = NULL, shape = NULL, linetype = NULL) +
  motyw
p5   # zapis: ggsave("luka-placowa-kwantyle.svg", p5, width = 10, height = 6.4)
Wynik w R
   tau surowa  luka dolna gorna bez_stanowiska
1 0.10  16.82 11.21  8.15 14.27          12.26
2 0.25  17.10 12.62  9.63 15.60          13.42
3 0.50  18.89 11.02  8.06 13.98          12.09
4 0.75  19.87 11.85  9.11 14.58          14.32
5 0.90  25.93 11.58  8.37 14.80          15.61
[1] 11.73
6. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (mężczyźni / kobiety; części luki)" = c("#0072B2", "#D55E00"),
             "niebieski – zielony (wodospad: zwiększa / zmniejsza lukę)" = c("#0072B2", "#009E73"),
             "zielony – cynober (wodospad)" = c("#009E73", "#D55E00"),
             "szary – niebieski (rysunek 5)" = c("#595959", "#0072B2"),
             "szary – cynober (rysunek 5)" = c("#595959", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                          widzenie_typowe
niebieski – cynober (mężczyźni / kobiety; części luki)              114.6
niebieski – zielony (wodospad: zwiększa / zmniejsza lukę)            70.1
zielony – cynober (wodospad)                                        102.4
szary – niebieski (rysunek 5)                                        42.2
szary – cynober (rysunek 5)                                          78.4
czerwony – zielony (do unikania)                                    121.7
                                                          deuteranopia
niebieski – cynober (mężczyźni / kobiety; części luki)           108.3
niebieski – zielony (wodospad: zwiększa / zmniejsza lukę)         55.4
zielony – cynober (wodospad)                                      53.5
szary – niebieski (rysunek 5)                                     45.3
szary – cynober (rysunek 5)                                       65.8
czerwony – zielony (do unikania)                                  21.1
                                                          protanopia
niebieski – cynober (mężczyźni / kobiety; części luki)          91.9
niebieski – zielony (wodospad: zwiększa / zmniejsza lukę)       58.0
zielony – cynober (wodospad)                                    37.3
szary – niebieski (rysunek 5)                                   39.9
szary – cynober (rysunek 5)                                     54.7
czerwony – zielony (do unikania)                                31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, regresja liniowa, test F, dekompozycja i bootstrap – pakiety base i stats). Regresję kwantylową oszacowano pakietem quantreg (z zależnością SparseM). Rysunki wykonano w ggplot2 (osie liczbowe – pakiet scales, zestawienie paneli – patchwork); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- quantreg (wersja 6.1): Koenker, R. (2025). quantreg: Quantile regression (R package version 6.1) [Computer software]. https://doi.org/10.32614/CRAN.package.quantreg
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Najczęstsze pytania
Jak policzyć dekompozycję Oaxaca–Blindera w R bez pakietu oaxaca?
Oszacuj funkcją lm() regresję logarytmu płacy osobno dla obu grup, policz średnie kolumn macierzy model.matrix() w każdej grupie i przemnóż różnicę średnich cech przez wybrane współczynniki odniesienia – to część wyjaśniona. Część niewyjaśniona to luka minus część wyjaśniona. Przedziały ufności daje bootstrap: losowanie ze zwracaniem osobno w każdej grupie i powtórzenie całego rachunku, np. 999 razy.
Czy niewyjaśniona część luki płacowej to dyskryminacja?
Nie wprost. Zawiera różnice w wynagradzaniu tych samych cech, ale też wpływ cech, których nie zmierzono (np. wydajności czy nadgodzin). Z drugiej strony część dyskryminacji może być ukryta w części wyjaśnionej, jeśli płeć wpływa na zmienne w modelu – w przykładzie rzadsze awanse kobiet przesuwały ok. 1.7 punktu logarytmicznego luki do części wyjaśnionej.
Którą grupę wybrać jako odniesienie w dekompozycji Oaxaca–Blindera?
Nie ma jednej poprawnej odpowiedzi. Współczynniki mężczyzn odpowiadają pytaniu, ile zarabiałyby kobiety wynagradzane jak mężczyźni; często stosuje się też model wspólny ze zmienną płci. Unikaj modelu wspólnego bez zmiennej płci, bo przesuwa część luki do części wyjaśnionej. W przykładzie część niewyjaśniona wahała się od 8.0 do 12.1 punktu logarytmicznego zależnie od wyboru – podaj wariant główny i pozostałe w aneksie.
Dlaczego lukę płacową liczy się na logarytmie płacy?
Płace są prawoskośne, a premie za staż czy stanowisko działają procentowo, więc logarytm lepiej pasuje do regresji. Części dekompozycji sumują się dokładnie tylko w skali logarytmu. Różnicę w log-punktach przelicz na procent na końcu: luka 0.2025 to ok. 18.3% (1 − e−0.2025).
Czy w analizie luki płacowej kontrolować stanowisko pracy?
To zależy od pytania. Jeśli pytasz, czy za tę samą pracę na tym samym stanowisku płaci się mniej – tak. Jeśli pytasz, ile kobiety tracą łącznie, także przez rzadsze awanse – nie, bo stanowisko może być skutkiem nierównego traktowania (zła kontrola). Najlepiej pokaż obie wersje: w przykładzie część niewyjaśniona wynosiła 11.3 punktu ze stanowiskiem i 13.0 bez niego.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z zarządzania i ekonomii
Ankieta wśród pracowników i model ekonometryczny na danych wtórnych: regresja, weryfikacja modelu, elastyczności, kod R i gotowe opisy wyników.
Czytaj →PoradnikZaangażowanie pracowników: model wielopoziomowy
Ankieta w 40 zespołach: ICC, styl lidera, ranking zespołów z modelu zamiast średnich i błąd ekologiczny – z kodem R.
Czytaj →PoradnikEfekt szkolenia – różnica w różnicach
60 salonów, szkolenie w 20 wybranych po dobrym kwartale: regresja do średniej, DiD, model zdarzeń i błędy klastrowane – pięć rysunków z kodem R.
Czytaj →PoradnikRegresja kwantylowa krok po kroku
Model dla kilku τ, błędy standardowe, wykres współczynników w funkcji τ, test równości nachyleń i porównanie z MNK – na jednym przykładzie w R.
Czytaj →PoradnikGrafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →Analizujesz lukę płacową w pracy dyplomowej?
Pomożemy dobrać zmienne, oszacować regresje i dekompozycję Oaxaca–Blindera z przedziałami z bootstrapu, sprawdzić warianty grupy odniesienia i opisać wyniki z tabelą i rysunkami – tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Blau, F. D., & Kahn, L. M. (2017). The gender wage gap: Extent, trends, and explanations. Journal of Economic Literature, 55(3), 789–865. https://doi.org/10.1257/jel.20160995 ● Otwarty dostęp
- Cinelli, C., Forney, A., & Pearl, J. (2024). A crash course in good and bad controls. Sociological Methods & Research, 53(3), 1071–1104. https://doi.org/10.1177/00491241221099552 ● Otwarty dostęp: pełny tekst
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Jann, B. (2008). The Blinder–Oaxaca decomposition for linear regression models. The Stata Journal, 8(4), 453–479. https://doi.org/10.1177/1536867x0800800401 ● Otwarty dostęp: pełny tekst
- Koenker, R., & Hallock, K. F. (2001). Quantile regression. Journal of Economic Perspectives, 15(4), 143–156. https://doi.org/10.1257/jep.15.4.143
- Neumark, D. (1988). Employers' discriminatory behavior and the estimation of wage discrimination. The Journal of Human Resources, 23(3), 279–295. https://doi.org/10.2307/145830
- Oaxaca, R. (1973). Male-female wage differentials in urban labor markets. International Economic Review, 14(3), 693–709. https://doi.org/10.2307/2525981
Cytowania BibTeX
@article{blau2017gender, author={Blau, Francine D. and Kahn, Lawrence M.}, title={{The gender wage gap: Extent, trends, and explanations}}, journal={Journal of Economic Literature}, year={2017}, volume={55}, number={3}, pages={789--865}, doi={10.1257/jel.20160995}}@article{cinelli2024crash, author={Cinelli, Carlos and Forney, Andrew and Pearl, Judea}, title={{A crash course in good and bad controls}}, journal={Sociological Methods \& Research}, year={2024}, volume={53}, number={3}, pages={1071--1104}, doi={10.1177/00491241221099552}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{jann2008blinder, author={Jann, Ben}, title={{The Blinder–Oaxaca decomposition for linear regression models}}, journal={The Stata Journal}, year={2008}, volume={8}, number={4}, pages={453--479}, doi={10.1177/1536867x0800800401}}@article{koenker2001quantile, author={Koenker, Roger and Hallock, Kevin F.}, title={{Quantile regression}}, journal={Journal of Economic Perspectives}, year={2001}, volume={15}, number={4}, pages={143--156}, doi={10.1257/jep.15.4.143}}@article{neumark1988employers, author={Neumark, David}, title={{Employers' discriminatory behavior and the estimation of wage discrimination}}, journal={The Journal of Human Resources}, year={1988}, volume={23}, number={3}, pages={279--295}, doi={10.2307/145830}}@article{oaxaca1973male, author={Oaxaca, Ronald}, title={{Male-female wage differentials in urban labor markets}}, journal={International Economic Review}, year={1973}, volume={14}, number={3}, pages={693--709}, doi={10.2307/2525981}}