Przykład: sieć sklepów z żywnością bezglutenową
Fikcyjna sieć 12 sklepów z żywnością bezglutenową sprzedaje 30 stałych produktów w sześciu kategoriach: pieczywo, mąki i mieszanki, makarony, płatki i kasze, słodycze i przekąski, dania gotowe. Mamy miesięczne ceny i liczbę sprzedanych sztuk z całej sieci od stycznia 2023 do grudnia 2025, a od lipca 2024 także dwa nowe produkty. Przychód wzrósł z 5.035 mln zł w 2023 r. do 6.856 mln zł w 2025 r., czyli o 36.2%. Zarząd pyta: o ile podrożał nasz koszyk i jaka część wzrostu przychodu to ceny, a jaka – więcej sprzedanych produktów?
Indeks prosty jednego produktu to cena bieżąca / cena bazowa × 100 (112 = +12%, zob. zmiana procentowa). Indeks koszyka waży te indeksy, bo chleb sprzedawany w tysiącach sztuk znaczy więcej niż niszowa mąka. Pytanie brzmi: ilościami z którego okresu ważyć?
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie: roczny wzrost cen kategorii od 3% (dania gotowe) do 12% (mąki) plus losowe odchylenie produktu (wyszło od −1.3% do 18.7% rocznie); promocje w 10% miesięcy (cena −25%, w następnym miesiącu sprzedaż niższa o 15%); skłonność do zamiany produktów σ = 2 w obrębie kategorii i 0.6 między kategoriami; wzrost liczby klientów o 4% rocznie; grudniowy wzrost sprzedaży mąk i słodyczy o 25%. Makaron kukurydziany od stycznia 2025 ma paczkę 400 g zamiast 500 g w tej samej cenie. Ziarno 696 ustaliliśmy raz i nie zmienialiśmy go. Dane pobierzesz jako indeks-cen-sklep-bezglutenowy.csv (1116 wierszy: miesiąc × produkt).
Rysunek 1: koszyk bazowy i koszyk bieżący na trzech mąkach
Trzy mąki: średnia cena w 2023 i 2025 r. (p0, p1) i średnia miesięczna sprzedaż w sztukach (q0, q1).
| Produkt | p0 (zł) | q0 (szt.) | p1 (zł) | q1 (szt.) | Indeks prosty ceny | Zmiana ilości |
|---|---|---|---|---|---|---|
| mąka uniwersalna | 17.58 | 1339 | 19.67 | 1831 | 111.9 | +36.7% |
| mieszanka do chleba | 19.20 | 1104 | 26.08 | 1032 | 135.8 | −6.5% |
| mąka ryżowa | 9.72 | 823 | 14.31 | 624 | 147.2 | −24.2% |
Klienci zrobili to, co robią zawsze: kupowali więcej tego, co podrożało najmniej. Trzy indeksy liczą to na trzy sposoby:
Słowami: Laspeyres pyta, ile dziś kosztuje koszyk z okresu bazowego; Paasche – ile w cenach bazowych kosztowałby dzisiejszy koszyk; Fisher to średnia geometryczna obu. Każdy z nich jest średnią ważoną indeksów prostych, tylko z innymi wagami.
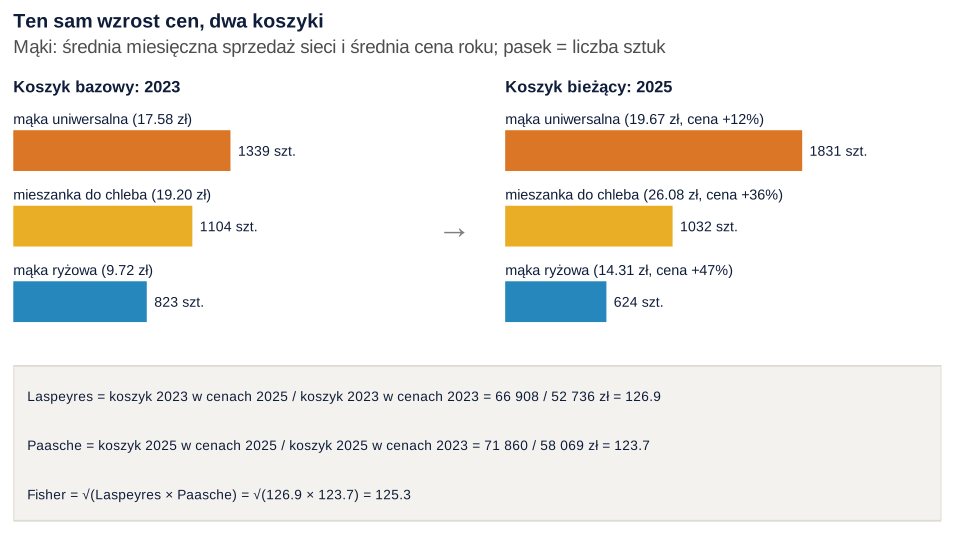
set.seed(696)).Co widać. Laspeyres = 66 908 / 52 736 zł = 126.9, Paasche = 71 860 / 58 069 zł = 123.7, Fisher = 125.3. Laspeyres jest wyższy, bo daje większą wagę mące ryżowej, która podrożała najbardziej i której klienci kupują już mniej.
Jak może zmylić. Zwykła średnia trzech indeksów prostych to 131.6 – za dużo, bo traktuje niszową mąkę ryżową jak najpopularniejszą mąkę uniwersalną. Laspeyres nie zawsze jest wyższy: dla trzech produktów z różnych kategorii Paasche wyszedł minimalnie wyżej (108.30 wobec 108.14), bo makaronu nie zamienia się na chleb. Te same wzory krok po kroku, na innych liczbach, ćwiczy zadanie 4 w zadaniach ze statystyki w ekonomii.
Podpis do pracy:
Rysunek 2: 30 produktów i trzy indeksy
Cały koszyk: 30 produktów, 2025 wobec 2023 (panel A), i indeksy miesięczne o stałej bazie – średnich cenach i ilościach z 2023 r. (panel B). Ceny liczymy za 500 g (zob. rysunek 6).
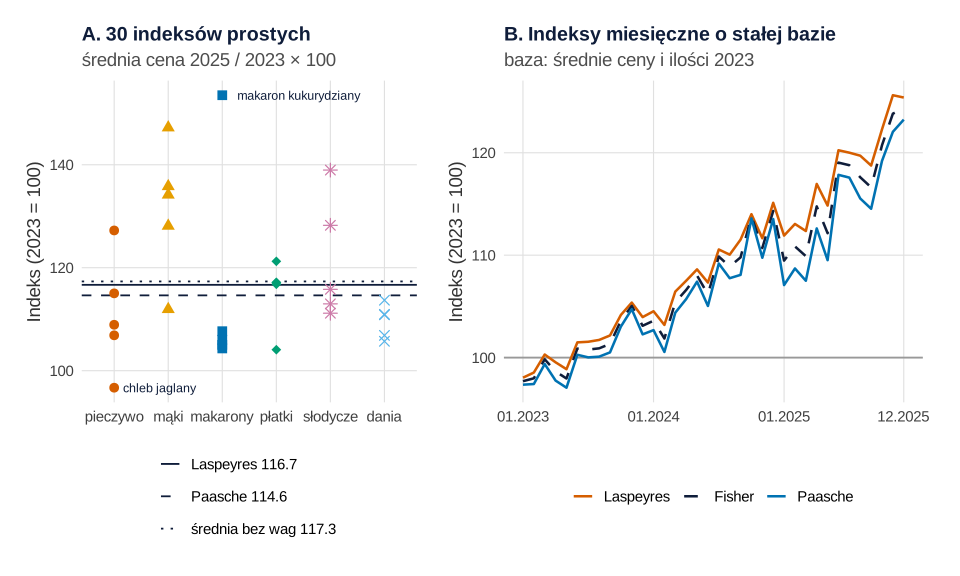
set.seed(696)).Co widać. Indeksy proste rozciągają się od 96.7 (chleb jaglany potaniał) do 153.5 (makaron kukurydziany). Koszyk podrożał według Laspeyresa o 16.7%, według Paaschego o 14.6%, według Fishera o 15.6%. Im bardziej produkt drożał, tym bardziej spadała jego sprzedaż: korelacja logarytmów zmiany ceny i zmiany ilości wynosi −0.92. W ujęciu miesięcznym (panel B) indeks w grudniu 2025 r. to 125.4 (Laspeyres) i 123.2 (Paasche) – luka 2.16 pkt rośnie z czasem, bo koszyk bazowy coraz bardziej się starzeje.
Jak może zmylić. Ząbki w panelu B to promocje, nie zmiana trendu (w styczniu 2023 r. indeks wynosił 98.0). Dlatego bazą są średnie roczne – chronią też przed sezonowością. Indeks miesięczny opisuj jak szereg czasowy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: klienci przechodzą na tańsze – symulacja z prawdą
Który indeks jest „prawdziwy”? Ten, który mierzy wzrost kosztu utrzymania tego samego poziomu zadowolenia klienta. Diewert (1998) omawia rozbieżności między indeksem Laspeyresa ze stałym koszykiem a takim teoretycznym indeksem kosztów utrzymania. W danych go nie znamy, w symulacji – tak. Bierzemy trendy cen 30 produktów bez promocji, a klienci dzielą wydatki według prostego modelu (CES) ze skłonnością do zamiany produktów σ: przy σ = 0 kupują zawsze to samo, przy σ = 4 chętnie przechodzą na tańsze.
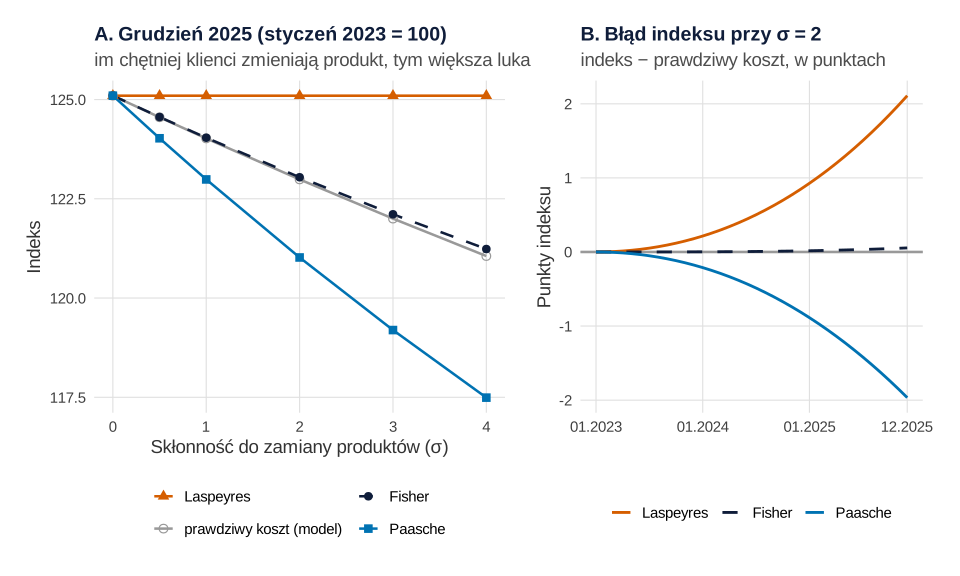
Co widać. Gdy klienci niczego nie zamieniają (σ = 0), wszystkie indeksy dają 125.1 i są równe prawdzie. Z rosnącą zamianą Laspeyres zostaje na 125.1, Paasche spada (121.0 przy σ = 2), a prawda leży między nimi: 123.0. Fisher myli się o 0.055 pkt przy σ = 2 i o 0.177 pkt przy σ = 4. Luka Laspeyres − Paasche rośnie z 1.1 pkt (σ = 0.5) do 7.6 pkt (σ = 4).
Jak może zmylić. To obciążenie substytucyjne. Hausman (2003) zalicza je do czterech źródeł obciążenia indeksu cen konsumpcyjnych i pokazuje, że jest obciążeniem drugiego rzędu, a trzy pozostałe źródła – pierwszego rzędu; nie należy więc mylić go z całym błędem indeksu. Model symulacji jest uproszczony: jedna σ dla wszystkich produktów. Sam indeks Fishera ma długą historię: Diewert (2013) przegląda wkład Irvinga Fishera w cztery podejścia do teorii indeksów – koszyka stałego, stochastyczne, testowe i ekonomiczne – wciąż używane w praktyce.
Podpis do pracy:
Rysunek 4: indeks łańcuchowy a stała baza
Indeks łańcuchowy mnoży indeksy kolejnych ogniw (styczeń → luty, luty → marzec…). Wagi są zawsze świeże, a nowe produkty wchodzą do koszyka od drugiego miesiąca sprzedaży. Bazą jest tu styczeń 2023, stąd inne liczby niż na rysunku 2.
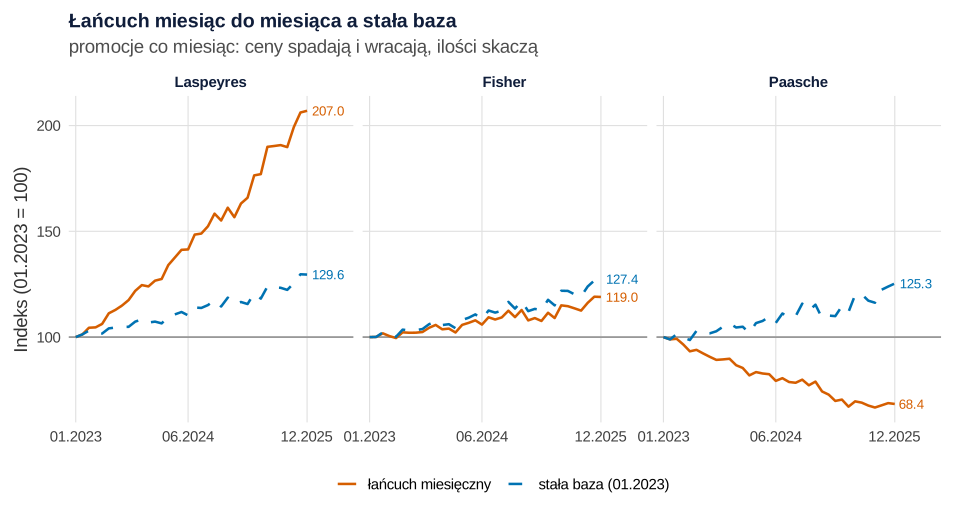
set.seed(696)).Co widać. Stała baza daje w grudniu 2025 r. 129.6 (Laspeyres), 127.4 (Fisher) i 125.3 (Paasche). Łańcuch miesięczny odjeżdża: Laspeyres 207.0 (+59.8% wobec stałej bazy), Paasche 68.4 (−45.4%) – czyli „ceny spadły o jedną trzecią”, choć prawie wszystkie produkty drożały. Nawet Fisher łańcuchowy zaniża o 6.6% (119.0). To dryf łańcucha. Przyczyna to promocje: w miesiącu promocji cena spada, a sprzedaż skacze; w następnym cena wraca, a sprzedaż jest niższa niż zwykle. Ogniwa „w dół” i „w górę” mają różne wagi, więc się nie znoszą.
Jak może zmylić. Łańcuch sam w sobie nie jest zły: łańcuch roczny (2023 → 2024 → 2025 na średnich rocznych) daje Fishera 115.21 wobec 115.65 bezpośrednio. Szkodzą częste ogniwa przy cenach, które skaczą i wracają. Białek i Beręsewicz (2021) piszą, że przy danych skanerowych z sieci handlowych wybór wzoru indeksu jest jednym z nowych wyzwań, a wynik zależy też od sposobu filtrowania i agregowania danych.
Podpis do pracy:
Rysunek 5: zmiana przychodu – ceny, ilości i nowe produkty
Zmianę przychodu produktów koszyka bazowego dzielimy bez reszty: efekt ceny = zmiana ceny × średnia ilość z obu lat, efekt ilości = zmiana ilości × średnia cena z obu lat. Nowe produkty to osobny składnik.
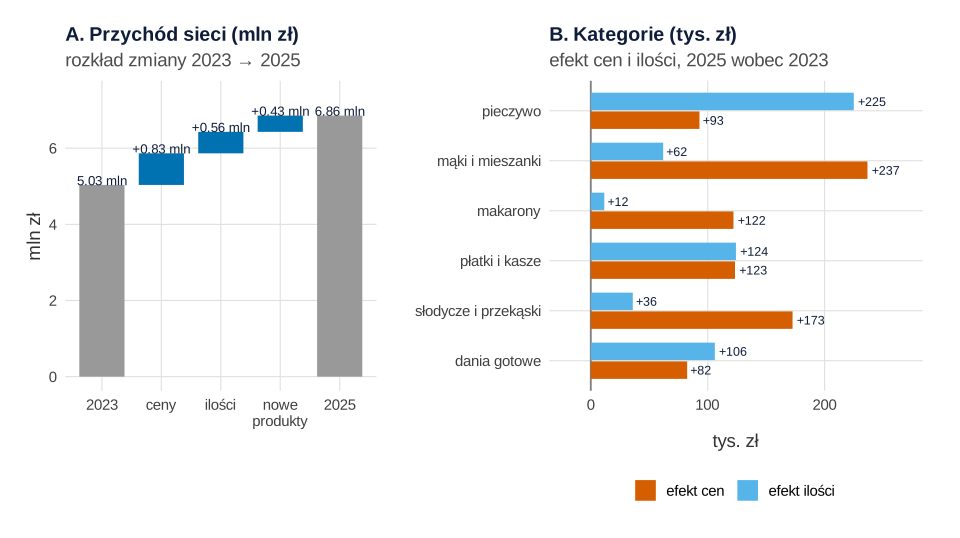
set.seed(696)).Co widać. Przychód wzrósł o 1821.6 tys. zł: 830.0 tys. zł (45.6%) to ceny, 564.6 tys. zł (31.0%) – większa sprzedaż tych samych produktów, a 427.0 tys. zł (23.4%) – dwa nowe produkty. W mąkach wzrost to głównie ceny (237 tys. zł wobec 62 tys. zł z ilości), w pieczywie – głównie ilości (225 wobec 93 tys. zł). Wersja iloczynowa: przychód koszyka bazowego wzrósł 1.277 razy = Fisher cen 1.1565 × Fisher ilości 1.1042.
Jak może zmylić. „Efekt ilości” zawiera też zmianę struktury: gdy klienci przechodzą na droższe produkty, rośnie, choć liczba sztuk stoi w miejscu (i odwrotnie). Rozbicie na cenę, wolumen i strukturę – także względem planu – opisuje wpis o odchyleniu plan–wykonanie, a wersję dla sklepów porównywalnych i paradoks Simpsona – wpis like-for-like. Jak czytać taki wykres wodospadowy, wyjaśnia hasło w słowniku.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: mniejsza paczka i nowe produkty
Makaron kukurydziany od stycznia 2025 r. ma 400 g zamiast 500 g w tej samej cenie (shrinkflacja), a indeks o stałej bazie nie widzi produktów, których w bazie nie było.
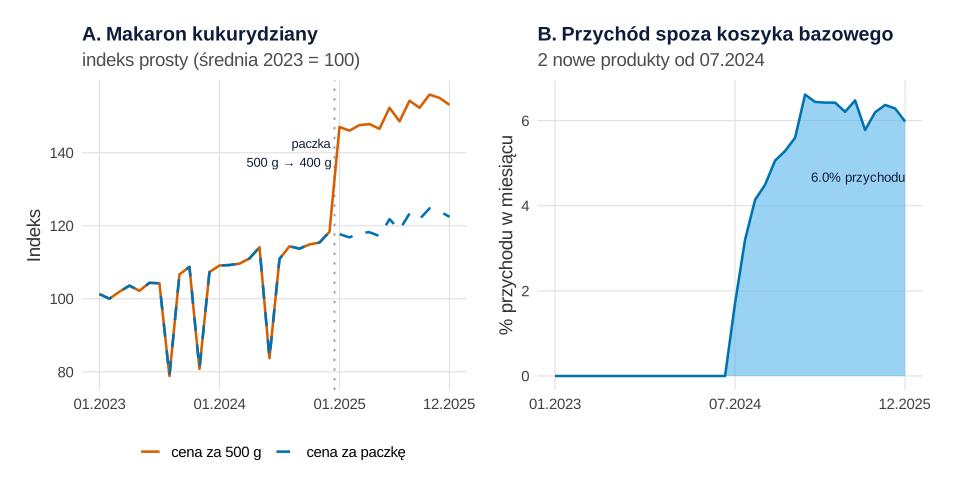
set.seed(696)).Co widać. Za paczkę makaron podrożał w 2025 r. o 20.4%, za 500 g – o 50.6%. Indeks Fishera kategorii makaronów liczony za paczkę daje 110.9, a za 500 g – 119.3; dla całego koszyka 114.6 wobec 115.6. W panelu B nowe produkty dają w grudniu 2025 r. 6.0% przychodu, a koszyk bazowy z 2023 r. ich nie obejmuje. Chleb z ciecierzycą kosztuje 18.08 zł za 500 g, a przeciętny produkt pieczywa z koszyka bazowego – 14.12 zł.
Jak może zmylić. Kim (2024) pokazał na rynku mleka, że konsumenci wyraźnie wolą zmniejszenie opakowania od podwyżki ceny dającej taki sam wzrost ceny jednostkowej. Licz więc cenę za jednostkę miary. Nordhaus (1998) opisuje, jak trudny jest pomiar zmian jakości w indeksach cen; jedną z metod jest regresja hedoniczna. Nowe produkty dopisuj do koszyka przy zmianie bazy albo przez łańcuch roczny.
Podpis do pracy:
Co z tym zrobić w firmie
- Do raportu bierz Fishera, a obok podaj Laspeyresa i Paaschego (116.7 i 114.6): ich rozpiętość pokazuje, jak mocno klienci zmieniają koszyk.
- Bazą niech będzie rok, nie miesiąc; wagi aktualizuj raz w roku.
- Nie łącz indeksu miesiąc do miesiąca przy promocjach. Łańcuch miesięczny dał od 68 do 207, gdy stała baza pokazywała 125–130. Łańcuch roczny dał tu prawie to samo co stała baza.
- Ceny licz za kilogram lub 500 g. Zmiana gramatury, składu czy wielkości opakowania to zmiana ceny, nawet gdy cena na półce stoi.
- Wzrost przychodu rozbijaj na ceny, ilości i nowości – czy sieć sprzedaje więcej, czy tylko drożej? Reakcję sprzedaży na cenę zmierzysz elastycznością cenową albo losowym testem ceny, a cenę wobec rynku – względnym indeksem ceny.
- Indeks własny porównuj z rynkiem ostrożnie – inny koszyk to inny indeks. Liczy się też koncentracja rynku. Produkty o dużym udziale w przychodzie wskaże analiza ABC/XYZ.
Jak opisać w pracy
Podaj okres bazowy, wzór indeksu, źródło wag, jednostkę ceny, sposób traktowania nowych i wycofanych produktów oraz to, czy indeks jest łańcuchowy. Gotowe funkcje do indeksów mają pakiety IndexNumR i PriceIndices (ten drugi Białek, 2023, pokazuje na danych skanerowych), ale trzy wzory łatwo policzyć ręcznie, jak w kodzie niżej. Więcej o analizach w pracach z tej dziedziny: statystyka w pracy z zarządzania i ekonomii.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 2 – funkcje indeksy() i roczne() używane dalej. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne. Indeksy liczymy ręcznie trzema wzorami w funkcji indeksy().
Losuje tylko przepis 1 i zaczyna od set.seed(696); przepisy 2–8 nie losują (rysunek 3 to symulacja deterministyczna na trendach cen z przepisu 1). Ziarno ustalono raz i nie zmieniano go. Ręcznie ustalono (przepis 1): ceny i sprzedaż bazową 30 produktów, roczny wzrost cen kategorii (3–12%) i rozrzut produktów (3 pp), promocje (10% miesięcy, −25%, sprzedaż w kolejnym miesiącu ×0.85), skłonność do zamiany produktów (2 w kategorii, 0.6 między kategoriami), wzrost liczby klientów (4% rocznie), sezon grudniowy mąk i słodyczy (+25%), zmniejszenie paczki makaronu kukurydzianego od 01.2025 i dwa nowe produkty od 07.2024; w przepisie 4 – wartości σ od 0 do 4. Po pierwszym uruchomieniu nie zmieniano parametrów danych. Zmieniono: wybór trzech produktów do rachunku w przepisie 2 – pierwotnie były to chleb gryczany, mąka uniwersalna i makaron ryżowy z trzech kategorii, dla których Paasche wyszedł minimalnie wyżej niż Laspeyres (108.30 wobec 108.14), więc do pokazania substytucji wzięliśmy trzy produkty z jednej kategorii (oba wyniki opisujemy przy rysunku 1); usunięto jeden pomocniczy wydruk z przepisu 5; poprawiono układ rysunków 1, 5 i 6 (wzory pod koszykami, oś przychodu od zera, położenie etykiety). Wszystkie przepisy liczą się w kilka sekund.
1. Dane: 30 produktów, 36 miesięcy
R
# Dane. Fikcyjna sieć 12 sklepów z żywnością bezglutenową: 30 produktów (+2 nowe), 36 miesięcy 2023–2025
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
kol_kat <- c("pieczywo" = "#D55E00", "mąki i mieszanki" = "#E69F00", "makarony" = "#0072B2",
             "płatki i kasze" = "#009E73", "słodycze i przekąski" = "#CC79A7", "dania gotowe" = "#56B4E9")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie
produkty <- data.frame(
  produkt = c("chleb gryczany", "chleb jaglany", "bułki kukurydziane", "bagietka", "tortille kukurydziane",
              "mąka uniwersalna", "mieszanka do chleba", "mąka ryżowa", "mąka gryczana", "mieszanka naleśnikowa",
              "makaron kukurydziany", "makaron ryżowy", "makaron z soczewicy", "spaghetti gryczane", "lasagne",
              "płatki owsiane", "musli orzechowe", "płatki jaglane", "granola", "kasza jaglana",
              "ciastka kakaowe", "wafle ryżowe", "batony daktylowe", "herbatniki", "paluszki kukurydziane",
              "pierogi", "pizza mrożona", "naleśniki gotowe", "kopytka", "zupa krem"),
  kategoria = rep(names(kol_kat), each = 5),
  cena0 = c(14.9, 13.5, 9.9, 11.5, 12.9,   16.9, 18.5, 9.5, 11.9, 14.5,   7.9, 8.5, 10.9, 11.5, 13.9,
            12.9, 21.9, 10.5, 18.9, 7.5,   9.9, 5.9, 3.5, 8.9, 6.5,   19.9, 24.9, 17.5, 15.9, 12.5),
  sztuki0 = c(2600, 1500, 1900, 900, 700,   1300, 1100, 800, 600, 700,   2200, 1400, 900, 600, 400,
              1800, 900, 700, 800, 1000,   1500, 2400, 3000, 1200, 1600,   900, 700, 500, 600, 800))
infl_kat <- c("pieczywo" = 0.08, "mąki i mieszanki" = 0.12, "makarony" = 0.05,       # roczny wzrost cen kategorii
              "płatki i kasze" = 0.06, "słodycze i przekąski" = 0.09, "dania gotowe" = 0.03)
sigma_w <- 2.0      # substytucja między produktami w kategorii
sigma_m <- 0.6      # substytucja między kategoriami
wzrost  <- 0.04     # roczny wzrost liczby klientów sieci
p_promo <- 0.10; glebokosc <- 0.25; dolek <- 0.85   # promocja: 10% miesięcy, −25%; miesiąc po promocji ×0.85

set.seed(696)
n_p <- nrow(produkty); t_max <- 36
produkty$wzrost_ceny <- infl_kat[produkty$kategoria] + rnorm(n_p, 0, 0.03)        # roczny wzrost ceny produktu
trend <- sapply(1:t_max, function(t) produkty$cena0 * exp(produkty$wzrost_ceny * (t - 1) / 12))
promo <- matrix(rbinom(n_p * t_max, 1, p_promo), n_p, t_max)
cena <- trend * ifelse(promo == 1, 1 - glebokosc, 1) * exp(matrix(rnorm(n_p * t_max, 0, 0.01), n_p, t_max))
cena <- round(cena, 2)
gramatura <- matrix(500, n_p, t_max)
gramatura[produkty$produkt == "makaron kukurydziany", 25:36] <- 400   # od 2025-01 mniejsza paczka, ta sama cena
# Popyt: klienci reagują na cenę paczki (zmniejszenia paczki nie zauważają)
wzgl <- cena / produkty$cena0
kat_idx <- sapply(names(kol_kat), function(k) exp(colMeans(log(wzgl[produkty$kategoria == k, , drop = FALSE]))))
ogol <- exp(rowMeans(log(kat_idx)))
sezon <- matrix(1, n_p, t_max)
grudzien <- seq(12, t_max, 12)
sezon[produkty$kategoria %in% c("mąki i mieszanki", "słodycze i przekąski"), grudzien] <- 1.25
po_promo <- cbind(0, promo[, -t_max])
sztuki_oczek <- produkty$sztuki0 * (wzgl / t(kat_idx[, produkty$kategoria]))^(-sigma_w) *
  t((kat_idx / ogol)^(-sigma_m))[produkty$kategoria, ] * rep(exp(wzrost * (0:(t_max - 1)) / 12), each = n_p) *
  sezon * ifelse(po_promo == 1 & promo == 0, dolek, 1)
sztuki <- round(sztuki_oczek * exp(matrix(rnorm(n_p * t_max, 0, 0.06), n_p, t_max)))

dane <- data.frame(miesiac = rep(1:t_max, each = n_p),
                   data = rep(format(seq(as.Date("2023-01-01"), by = "month", length.out = t_max), "%Y-%m"), each = n_p),
                   produkt = produkty$produkt, kategoria = produkty$kategoria,
                   gramatura_g = as.vector(gramatura), cena_zl = as.vector(cena), promocja = as.vector(promo),
                   sztuki = as.vector(sztuki), w_koszyku_bazowym = 1)
# Dwa nowe produkty od 2024-07 (miesiąc 19): cena startowa i powolne rozkręcanie sprzedaży
nowe <- expand.grid(miesiac = 19:36, produkt = c("chleb z ciecierzycą", "makaron z ciecierzycy"),
                    stringsAsFactors = FALSE)
nowe$kategoria <- ifelse(nowe$produkt == "chleb z ciecierzycą", "pieczywo", "makarony")
nowe$data <- format(seq(as.Date("2023-01-01"), by = "month", length.out = t_max), "%Y-%m")[nowe$miesiac]
nowe$gramatura_g <- 500
nowe$cena_zl <- round(ifelse(nowe$kategoria == "pieczywo", 17.9, 12.9) *
                        exp(rnorm(nrow(nowe), 0, 0.01)), 2)
nowe$promocja <- 0
nowe$sztuki <- round(ifelse(nowe$kategoria == "pieczywo", 1400, 1000) * (1 - exp(-(nowe$miesiac - 18) / 4)) *
                       exp(rnorm(nrow(nowe), 0, 0.06)))
nowe$w_koszyku_bazowym <- 0
dane <- rbind(dane, nowe[names(dane)])
dane <- dane[order(dane$miesiac, dane$kategoria, dane$produkt), ]
dane$rok <- as.integer(substr(dane$data, 1, 4))
dane$cena_500g <- round(dane$cena_zl * 500 / dane$gramatura_g, 2)    # cena porównywalna (za 500 g)
dane$przychod <- dane$cena_zl * dane$sztuki
write.csv(dane[c("data", "miesiac", "kategoria", "produkt", "gramatura_g", "cena_zl", "promocja", "sztuki",
                 "w_koszyku_bazowym")], "indeks-cen-sklep-bezglutenowy.csv", row.names = FALSE)

cat("Wiersze:", nrow(dane), "| produkty:", length(unique(dane$produkt)), "| miesiące:", t_max, "\n")
cat("Odsetek miesięcy z promocją:", round(100 * mean(dane$promocja[dane$w_koszyku_bazowym == 1]), 1), "%\n")
cat("Roczny wzrost cen produktów (parametr), min–max:", round(100 * range(produkty$wzrost_ceny), 1), "%\n")
przych_rok <- tapply(dane$przychod, dane$rok, sum)
print(round(przych_rok / 1e6, 3))
cat("Zmiana przychodu 2025/2023:", round(100 * (przych_rok[["2025"]] / przych_rok[["2023"]] - 1), 1), "%\n")
Wynik w R
Wiersze: 1116 | produkty: 32 | miesiące: 36
Odsetek miesięcy z promocją: 10.7 %
Roczny wzrost cen produktów (parametr), min–max: -1.3 18.7 %
 2023  2024  2025
5.035 5.818 6.856
Zmiana przychodu 2025/2023: 36.2 %
2. Trzy mąki i trzy wzory: Rysunek 1
R
# Rysunek 1. Laspeyres, Paasche i Fisher na trzech produktach: koszyk bazowy a bieżący
# (korzysta z kol, motyw i obiektu dane z przepisu 1 – bez nowego losowania)
library(ggplot2)

# Indeksy agregatowe dla dwóch okresów: p0, q0 – okres bazowy, p1, q1 – okres badany
indeksy <- function(p0, q0, p1, q1) {
  L <- sum(p1 * q0) / sum(p0 * q0)          # stary koszyk w nowych cenach
  P <- sum(p1 * q1) / sum(p0 * q1)          # nowy koszyk w nowych cenach
  c(Laspeyres = L, Paasche = P, Fisher = sqrt(L * P))
}
# Dane roczne: ilość w opakowaniach 500 g (ekwiwalent), cena = przychód / ilość (średnia cena roczna)
roczne <- function(d) {
  d$q <- d$sztuki * d$gramatura_g / 500
  a <- aggregate(cbind(przychod, q) ~ produkt + kategoria + rok + w_koszyku_bazowym, data = d, FUN = sum)
  a$p <- a$przychod / a$q
  a
}
r <- roczne(dane)
trzy <- c("mąka uniwersalna", "mieszanka do chleba", "mąka ryżowa")
x <- merge(subset(r, rok == 2023 & produkt %in% trzy, c(produkt, p, q)),
           subset(r, rok == 2025 & produkt %in% trzy, c(produkt, p, q)), by = "produkt", suffixes = c("0", "1"))
x <- x[match(trzy, x$produkt), ]
x$q0 <- round(x$q0 / 12); x$q1 <- round(x$q1 / 12)          # średnio sztuk miesięcznie
x$p0 <- round(x$p0, 2); x$p1 <- round(x$p1, 2)
x$indeks_prosty <- round(100 * x$p1 / x$p0, 1)
x$zmiana_ilosci <- round(100 * (x$q1 / x$q0 - 1), 1)
print(x, row.names = FALSE)
cat("Koszyk 2023 w cenach 2023:", sum(x$p0 * x$q0), "zł | w cenach 2025:", sum(x$p1 * x$q0), "zł\n")
cat("Koszyk 2025 w cenach 2023:", sum(x$p0 * x$q1), "zł | w cenach 2025:", sum(x$p1 * x$q1), "zł\n")
i3 <- indeksy(x$p0, x$q0, x$p1, x$q1)
print(round(100 * i3, 2))
cat("Średnia arytmetyczna indeksów prostych (bez wag):", round(mean(x$indeks_prosty), 2), "\n")

# Grafika: dwa koszyki i trzy wzory
k <- rbind(data.frame(koszyk = "bazowy", x0 = 0, produkt = x$produkt, q = x$q0, p = x$p0),
           data.frame(koszyk = "bieżący", x0 = 5.3, produkt = x$produkt, q = x$q1, p = x$p1))
k$y <- rep(c(5.2, 4.2, 3.2), 2)
k$szer <- 3.2 * k$q / max(k$q)
k$etykieta <- ifelse(k$koszyk == "bazowy", sprintf("%s (%.2f zł)", k$produkt, k$p),
                     sprintf("%s (%.2f zł, cena %+.0f%%)", k$produkt, k$p, rep(x$indeks_prosty - 100, 2)))
k$kolor <- rep(unname(kol[c("pomaranczowy", "zolty", "niebieski")]), 2)
zl <- function(v) format(round(v), big.mark = " ")
wzory <- data.frame(y = c(1.95, 1.3, 0.65), tekst = c(
  sprintf("Laspeyres = koszyk 2023 w cenach 2025 / koszyk 2023 w cenach 2023 = %s / %s zł = %.1f",
          zl(sum(x$p1 * x$q0)), zl(sum(x$p0 * x$q0)), 100 * i3[1]),
  sprintf("Paasche = koszyk 2025 w cenach 2025 / koszyk 2025 w cenach 2023 = %s / %s zł = %.1f",
          zl(sum(x$p1 * x$q1)), zl(sum(x$p0 * x$q1)), 100 * i3[2]),
  sprintf("Fisher = √(Laspeyres × Paasche) = √(%.1f × %.1f) = %.1f", 100 * i3[1], 100 * i3[2], 100 * i3[3])))
p1 <- ggplot() +
  geom_rect(data = k, aes(xmin = x0, xmax = x0 + szer, ymin = y - 0.27, ymax = y + 0.27), fill = k$kolor, alpha = 0.85) +
  geom_text(data = k, aes(x = x0, y = y + 0.42, label = etykieta), hjust = 0, size = 3.8,
            colour = "#0f1d3a") +
  geom_text(data = k, aes(x = x0 + szer + 0.08, y = y, label = paste(q, "szt.")), hjust = 0, size = 3.7,
            colour = "#0f1d3a") +
  annotate("text", x = c(0, 5.3), y = 6.05, hjust = 0, size = 4.3, fontface = "bold", colour = "#0f1d3a",
           label = c("Koszyk bazowy: 2023", "Koszyk bieżący: 2025")) +
  annotate("text", x = 4.75, y = 4.2, label = "→", size = 9, colour = "grey50") +
  annotate("rect", xmin = 0, xmax = 10, ymin = 0.3, ymax = 2.35, fill = "#f4f2ee", colour = "#dedbd4") +
  geom_text(data = wzory, aes(x = 0.15, y = y, label = tekst), hjust = 0, size = 3.6, colour = "#0f1d3a") +
  coord_cartesian(xlim = c(0, 10), ylim = c(0.25, 6.3), expand = FALSE) +
  labs(title = "Ten sam wzrost cen, dwa koszyki",
       subtitle = "Mąki: średnia miesięczna sprzedaż sieci i średnia cena roku; pasek = liczba sztuk", x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank())
p1                       # do pliku: ggsave("indeks-cen-koszyk-bazowy-biezacy.svg", p1, width = 10, height = 5.6)
Wynik w R
             produkt    p0   q0    p1   q1 indeks_prosty zmiana_ilosci
    mąka uniwersalna 17.58 1339 19.67 1831         111.9          36.7
 mieszanka do chleba 19.20 1104 26.08 1032         135.8          -6.5
         mąka ryżowa  9.72  823 14.31  624         147.2         -24.2
Koszyk 2023 w cenach 2023: 52735.98 zł | w cenach 2025: 66907.58 zł
Koszyk 2025 w cenach 2023: 58068.66 zł | w cenach 2025: 71859.77 zł
Laspeyres   Paasche    Fisher
   126.87    123.75    125.30
Średnia arytmetyczna indeksów prostych (bez wag): 131.63
3. 30 produktów, indeksy roczne i miesięczne: Rysunek 2
R
# Rysunek 2. Indeksy proste 30 produktów i indeksy agregatowe miesiąc po miesiącu (średnia 2023 = 100)
# (korzysta z kol, kol_kat, motyw, dane z przepisu 1 oraz funkcji indeksy() i roczne() z przepisu 2)
library(ggplot2)
library(patchwork)

# A. 2025 wobec 2023: średnie ceny roczne (za 500 g) i ilości roczne, tylko produkty koszyka bazowego
a <- merge(subset(r, rok == 2023 & w_koszyku_bazowym == 1), subset(r, rok == 2025 & w_koszyku_bazowym == 1),
           by = c("produkt", "kategoria"), suffixes = c("0", "1"))
a$indeks_prosty <- 100 * a$p1 / a$p0
i_rok <- 100 * indeksy(a$p0, a$q0, a$p1, a$q1)
print(round(i_rok, 2))
cat("Indeksy proste 2025/2023: min", round(min(a$indeks_prosty), 1), "(", a$produkt[which.min(a$indeks_prosty)],
    ") | max", round(max(a$indeks_prosty), 1), "(", a$produkt[which.max(a$indeks_prosty)], ")\n")
cat("Średnia indeksów prostych bez wag:", round(mean(a$indeks_prosty), 2),
    "| korelacja zmiany ceny i zmiany ilości (log):", round(cor(log(a$p1 / a$p0), log(a$q1 / a$q0)), 2), "\n")

# B. Indeksy miesięczne o stałej bazie: ceny i ilości bazowe = średnie z 2023 r.
baz <- subset(dane, w_koszyku_bazowym == 1)
baz$q <- baz$sztuki * baz$gramatura_g / 500
p0 <- a$p0[match(unique(baz$produkt), a$produkt)]; names(p0) <- unique(baz$produkt)
q0 <- (a$q0 / 12)[match(names(p0), a$produkt)]; names(q0) <- names(p0)
mies <- do.call(rbind, lapply(split(baz, baz$miesiac), function(d) {
  i <- indeksy(p0[d$produkt], q0[d$produkt], d$cena_500g, d$q)
  data.frame(miesiac = d$miesiac[1], data = d$data[1], t(100 * i))
}))
print(subset(mies, miesiac %in% c(1, 12, 24, 36)), row.names = FALSE, digits = 5)
cat("Grudzień 2025: Laspeyres − Paasche =", round(mies$Laspeyres[36] - mies$Paasche[36], 2), "pkt\n")

a$kategoria <- factor(a$kategoria, levels = names(kol_kat))
skrajne <- a[a$indeks_prosty %in% c(max(a$indeks_prosty), min(a$indeks_prosty)), ]
linie <- data.frame(y = c(i_rok[["Laspeyres"]], i_rok[["Paasche"]], mean(a$indeks_prosty)),
                    co = c(sprintf("Laspeyres %.1f", i_rok[["Laspeyres"]]), sprintf("Paasche %.1f", i_rok[["Paasche"]]),
                           sprintf("średnia bez wag %.1f", mean(a$indeks_prosty))))
pA <- ggplot(a, aes(kategoria, indeks_prosty)) +
  geom_hline(data = linie, aes(yintercept = y, linetype = co), colour = "#0f1d3a") +
  geom_point(aes(colour = kategoria, shape = kategoria), size = 3, position = position_nudge(x = 0)) +
  geom_text(data = skrajne, aes(label = produkt), hjust = -0.12, size = 3.3, colour = "#0f1d3a") +
  scale_colour_manual(values = kol_kat, guide = "none") + scale_shape_manual(values = c(16, 17, 15, 18, 8, 4), guide = "none") +
  scale_linetype_manual(values = c("solid", "dashed", "dotted"), name = NULL) +
  scale_x_discrete(labels = c("pieczywo", "mąki", "makarony", "płatki", "słodycze", "dania")) +
  labs(title = "A. 30 indeksów prostych", subtitle = "średnia cena 2025 / 2023 × 100",
       x = NULL, y = "Indeks (2023 = 100)") +
  motyw + guides(linetype = guide_legend(ncol = 1)) + theme(axis.text.x = element_text(angle = 30, hjust = 1))
dl <- rbind(data.frame(mies[c("miesiac", "data")], indeks = mies$Laspeyres, co = "Laspeyres"),
            data.frame(mies[c("miesiac", "data")], indeks = mies$Paasche, co = "Paasche"),
            data.frame(mies[c("miesiac", "data")], indeks = mies$Fisher, co = "Fisher"))
dl$co <- factor(dl$co, levels = c("Laspeyres", "Fisher", "Paasche"))
pB <- ggplot(dl, aes(miesiac, indeks, colour = co, linetype = co)) +
  geom_hline(yintercept = 100, colour = "grey60") +
  geom_line(linewidth = 0.9) +
  scale_colour_manual(values = unname(kol[c("pomaranczowy", "granat", "niebieski")]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "solid"), name = NULL) +
  scale_x_continuous(breaks = c(1, 13, 25, 36), labels = c("01.2023", "01.2024", "01.2025", "12.2025")) +
  labs(title = "B. Indeksy miesięczne o stałej bazie", subtitle = "baza: średnie ceny i ilości 2023",
       x = NULL, y = "Indeks (2023 = 100)") + motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.25))
p2                       # do pliku: ggsave("indeks-cen-proste-i-agregatowe.svg", p2, width = 10, height = 6)
Wynik w R
Laspeyres   Paasche    Fisher
   116.68    114.63    115.65
Indeksy proste 2025/2023: min 96.7 ( chleb jaglany ) | max 153.5 ( makaron kukurydziany )
Średnia indeksów prostych bez wag: 117.33 | korelacja zmiany ceny i zmiany ilości (log): -0.92
 miesiac    data Laspeyres Paasche  Fisher
       1 2023-01    98.039  97.355  97.697
      12 2023-12   103.953 102.268 103.107
      24 2024-12   115.112 113.526 114.316
      36 2025-12   125.392 123.236 124.309
Grudzień 2025: Laspeyres − Paasche = 2.16 pkt
4. Substytucja i prawdziwy koszt w modelu: Rysunek 3
R
# Rysunek 3. Substytucja: klienci przechodzą na tańsze – Laspeyres, Paasche i Fisher wobec prawdy z modelu
# (korzysta z kol, motyw, produkty, trend z przepisu 1 i funkcji indeksy() z przepisu 2 – bez losowania)
library(ggplot2)
library(patchwork)

# Ceny: trendy 30 produktów z przepisu 1 bez promocji i szumu. Klienci mają stały „poziom zadowolenia”
# i dzielą wydatki według modelu CES z elastycznością substytucji sigma (0 = nie zmieniają koszyka).
# Wtedy prawdziwy wzrost kosztu utrzymania tego samego poziomu zadowolenia jest znany dokładnie.
s0 <- produkty$cena0 * produkty$sztuki0 / sum(produkty$cena0 * produkty$sztuki0)   # udziały w wydatkach bazy
q_baza <- produkty$sztuki0
koszt_prawdziwy <- function(rel, sigma)               # rel = p_t / p_0 dla każdego produktu
  if (abs(sigma - 1) < 1e-9) exp(sum(s0 * log(rel))) else sum(s0 * rel^(1 - sigma))^(1 / (1 - sigma))
symuluj <- function(sigma) do.call(rbind, lapply(1:ncol(trend), function(t) {
  rel <- trend[, t] / trend[, 1]
  C <- koszt_prawdziwy(rel, sigma)
  q_t <- q_baza * rel^(-sigma) * C^sigma               # ilości przy tym samym poziomie zadowolenia
  i <- indeksy(trend[, 1], q_baza, trend[, t], q_t)
  data.frame(sigma = sigma, miesiac = t, t(100 * i), prawdziwy = 100 * C)
}))
sym <- do.call(rbind, lapply(c(0, 0.5, 1, 2, 3, 4), symuluj))
gr <- subset(sym, miesiac == 36)
gr$L_minus_P <- gr$Laspeyres - gr$Paasche
gr$blad_Fishera <- gr$Fisher - gr$prawdziwy
print(round(gr[, -2], 3), row.names = FALSE)

dA <- rbind(data.frame(sigma = gr$sigma, indeks = gr$Laspeyres, co = "Laspeyres"),
            data.frame(sigma = gr$sigma, indeks = gr$prawdziwy, co = "prawdziwy koszt (model)"),
            data.frame(sigma = gr$sigma, indeks = gr$Fisher, co = "Fisher"),
            data.frame(sigma = gr$sigma, indeks = gr$Paasche, co = "Paasche"))
dA$co <- factor(dA$co, levels = c("Laspeyres", "prawdziwy koszt (model)", "Fisher", "Paasche"))
kolory <- c(kol[["pomaranczowy"]], kol[["szary"]], kol[["granat"]], kol[["niebieski"]])
pA <- ggplot(dA, aes(sigma, indeks, colour = co, shape = co, linetype = co)) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  scale_colour_manual(values = kolory, name = NULL) + scale_shape_manual(values = c(17, 1, 16, 15), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "dashed", "solid"), name = NULL) +
  labs(title = "A. Grudzień 2025 (styczeń 2023 = 100)", subtitle = "im chętniej klienci zmieniają produkt, tym większa luka",
       x = "Skłonność do zamiany produktów (σ)", y = "Indeks") +
  motyw + guides(colour = guide_legend(ncol = 2))
dB <- subset(sym, sigma == 2)
dB <- rbind(data.frame(miesiac = dB$miesiac, roznica = dB$Laspeyres - dB$prawdziwy, co = "Laspeyres"),
            data.frame(miesiac = dB$miesiac, roznica = dB$Fisher - dB$prawdziwy, co = "Fisher"),
            data.frame(miesiac = dB$miesiac, roznica = dB$Paasche - dB$prawdziwy, co = "Paasche"))
dB$co <- factor(dB$co, levels = c("Laspeyres", "Fisher", "Paasche"))
pB <- ggplot(dB, aes(miesiac, roznica, colour = co, linetype = co)) +
  geom_hline(yintercept = 0, colour = kol[["szary"]], linewidth = 0.9) +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = kolory[c(1, 3, 4)], name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "solid"), name = NULL) +
  scale_x_continuous(breaks = c(1, 13, 25, 36), labels = c("01.2023", "01.2024", "01.2025", "12.2025")) +
  labs(title = "B. Błąd indeksu przy σ = 2", subtitle = "indeks − prawdziwy koszt, w punktach",
       x = NULL, y = "Punkty indeksu") + motyw
p3 <- pA + pB + plot_layout(widths = c(1.2, 1))
p3                       # do pliku: ggsave("indeks-cen-substytucja.svg", p3, width = 10, height = 6)
Wynik w R
 sigma Laspeyres Paasche  Fisher prawdziwy L_minus_P blad_Fishera
   0.0   125.097 125.097 125.097   125.097     0.000        0.000
   0.5   125.097 124.024 124.560   124.553     1.073        0.007
   1.0   125.097 122.988 124.038   124.020     2.109        0.018
   2.0   125.097 121.022 123.043   122.988     4.075        0.055
   3.0   125.097 119.193 122.109   122.001     5.904        0.109
   4.0   125.097 117.491 121.234   121.058     7.606        0.177
5. Łańcuch a stała baza: Rysunek 4
R
# Rysunek 4. Indeks łańcuchowy miesiąc do miesiąca a indeks o stałej bazie (styczeń 2023 = 100)
# (korzysta z kol, motyw, dane z przepisu 1 i funkcji indeksy(), roczne() z przepisu 2 – bez losowania)
library(ggplot2)
library(patchwork)

d <- dane
d$q <- d$sztuki * d$gramatura_g / 500
mies_lista <- split(d, d$miesiac)
# Stała baza: styczeń 2023, tylko produkty koszyka bazowego
b1 <- subset(mies_lista[["1"]], w_koszyku_bazowym == 1)
stala <- do.call(rbind, lapply(mies_lista, function(m) {
  m <- subset(m, w_koszyku_bazowym == 1)
  j <- match(b1$produkt, m$produkt)
  data.frame(miesiac = m$miesiac[1], t(100 * indeksy(b1$cena_500g, b1$q, m$cena_500g[j], m$q[j])))
}))
# Łańcuch: ogniwa miesiąc t−1 → t na produktach sprzedawanych w obu miesiącach (od 07.2024 także nowych)
ogniwa <- do.call(rbind, lapply(2:36, function(t) {
  a0 <- mies_lista[[t - 1]]; a1 <- mies_lista[[t]]
  wsp <- intersect(a0$produkt, a1$produkt)
  a0 <- a0[match(wsp, a0$produkt), ]; a1 <- a1[match(wsp, a1$produkt), ]
  data.frame(miesiac = t, t(indeksy(a0$cena_500g, a0$q, a1$cena_500g, a1$q)))
}))
lancuch <- data.frame(miesiac = 1:36, rbind(100, 100 * apply(ogniwa[, -1], 2, cumprod)))
wynik <- merge(stala, lancuch, by = "miesiac", suffixes = c("_stala", "_lancuch"))
print(round(subset(wynik, miesiac %in% c(12, 24, 36)), 2), row.names = FALSE)
dryf <- 100 * (unlist(lancuch[36, -1]) / unlist(stala[36, -1]) - 1)
cat("Dryf łańcucha w grudniu 2025 (łańcuch / stała baza − 1, %):", round(dryf, 1), "\n")
# Łańcuch roczny: ogniwa 2023→2024 i 2024→2025 na średnich cenach i ilościach roku (Fisher)
r_ <- roczne(dane)
ogniwo_r <- function(r0, r1) {
  wsp <- intersect(subset(r_, rok == r0)$produkt, subset(r_, rok == r1)$produkt)
  x0 <- subset(r_, rok == r0)[match(wsp, subset(r_, rok == r0)$produkt), ]
  x1 <- subset(r_, rok == r1)[match(wsp, subset(r_, rok == r1)$produkt), ]
  indeksy(x0$p, x0$q, x1$p, x1$q)
}
cat("Fisher 2025/2023 – łańcuch roczny:", round(100 * ogniwo_r(2023, 2024)[["Fisher"]] * ogniwo_r(2024, 2025)[["Fisher"]], 2),
    "| bezpośrednio:", round(100 * ogniwo_r(2023, 2025)[["Fisher"]], 2), "\n")

dl <- rbind(data.frame(miesiac = wynik$miesiac, indeks = wynik$Laspeyres_lancuch, wzor = "Laspeyres", co = "łańcuch miesięczny"),
            data.frame(miesiac = wynik$miesiac, indeks = wynik$Laspeyres_stala, wzor = "Laspeyres", co = "stała baza (01.2023)"),
            data.frame(miesiac = wynik$miesiac, indeks = wynik$Fisher_lancuch, wzor = "Fisher", co = "łańcuch miesięczny"),
            data.frame(miesiac = wynik$miesiac, indeks = wynik$Fisher_stala, wzor = "Fisher", co = "stała baza (01.2023)"),
            data.frame(miesiac = wynik$miesiac, indeks = wynik$Paasche_lancuch, wzor = "Paasche", co = "łańcuch miesięczny"),
            data.frame(miesiac = wynik$miesiac, indeks = wynik$Paasche_stala, wzor = "Paasche", co = "stała baza (01.2023)"))
dl$wzor <- factor(dl$wzor, levels = c("Laspeyres", "Fisher", "Paasche"))
etyk <- subset(dl, miesiac == 36)
p4 <- ggplot(dl, aes(miesiac, indeks, colour = co, linetype = co)) +
  geom_hline(yintercept = 100, colour = "grey60") +
  geom_line(linewidth = 0.9) +
  geom_text(data = etyk, aes(label = sprintf("%.1f", indeks)), hjust = -0.15, size = 3.5, show.legend = FALSE) +
  facet_wrap(~ wzor, nrow = 1) +
  scale_colour_manual(values = unname(kol[c("pomaranczowy", "niebieski")]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = c(1, 18, 36), labels = c("01.2023", "06.2024", "12.2025"), expand = expansion(mult = c(0.03, 0.2))) +
  labs(title = "Łańcuch miesiąc do miesiąca a stała baza", subtitle = "promocje co miesiąc: ceny spadają i wracają, ilości skaczą",
       x = NULL, y = "Indeks (01.2023 = 100)") + motyw
p4                       # do pliku: ggsave("indeks-cen-lancuch-dryf.svg", p4, width = 10, height = 5.4)
Wynik w R
 miesiac Laspeyres_stala Paasche_stala Fisher_stala Laspeyres_lancuch
      12          106.87        104.55       105.70            123.96
      24          118.64        115.32       116.97            161.17
      36          129.55        125.33       127.43            206.98
 Paasche_lancuch Fisher_lancuch
           86.72         103.68
           78.97         112.81
           68.39         118.98
Dryf łańcucha w grudniu 2025 (łańcuch / stała baza − 1, %): 59.8 -45.4 -6.6
Fisher 2025/2023 – łańcuch roczny: 115.21 | bezpośrednio: 115.65
6. Rozkład zmiany przychodu: Rysunek 5
R
# Rysunek 5. Zmiana przychodu 2023 → 2025: ile z cen, ile z ilości, ile z nowych produktów
# (korzysta z kol, kol_kat, motyw, dane z przepisu 1 i funkcji indeksy(), roczne() z przepisu 2 – bez losowania)
library(ggplot2)
library(patchwork)

r_ <- roczne(dane)
x <- merge(subset(r_, rok == 2023 & w_koszyku_bazowym == 1), subset(r_, rok == 2025 & w_koszyku_bazowym == 1),
           by = c("produkt", "kategoria"), suffixes = c("0", "1"))
# Rozkład symetryczny (bez składnika resztowego): cena wyceniona średnią ilością, ilość – średnią ceną
x$ef_ceny <- 0.5 * (x$q0 + x$q1) * (x$p1 - x$p0)
x$ef_ilosci <- 0.5 * (x$p0 + x$p1) * (x$q1 - x$q0)
V0 <- sum(subset(r_, rok == 2023)$przychod); V1 <- sum(subset(r_, rok == 2025)$przychod)
nowe_2025 <- sum(subset(r_, rok == 2025 & w_koszyku_bazowym == 0)$przychod)
skladniki <- c(przychod_2023 = V0, ceny = sum(x$ef_ceny), ilosci = sum(x$ef_ilosci), nowe_produkty = nowe_2025,
               przychod_2025 = V1)
print(round(skladniki / 1e3, 1))
cat("Kontrola: ceny + ilości + nowe = zmiana przychodu:", round((sum(skladniki[2:4]) - (V1 - V0)) / 1e3, 3), "tys. zł\n")
cat("Udział w zmianie przychodu (%):", round(100 * skladniki[2:4] / (V1 - V0), 1), "\n")
iF <- indeksy(x$p0, x$q0, x$p1, x$q1)[["Fisher"]]
qF <- indeksy(x$q0, x$p0, x$q1, x$p1)[["Fisher"]]                 # indeks ilości: role cen i ilości zamienione
cat("Koszyk bazowy: przychód 2025/2023 =", round(sum(x$p1 * x$q1) / sum(x$p0 * x$q0), 4),
    "| Fisher cen × Fisher ilości =", round(iF, 4), "×", round(qF, 4), "=", round(iF * qF, 4), "\n")
kat <- aggregate(cbind(ef_ceny, ef_ilosci) ~ kategoria, data = x, FUN = sum)
print(transform(kat, ef_ceny = round(ef_ceny / 1e3, 1), ef_ilosci = round(ef_ilosci / 1e3, 1)), row.names = FALSE)

w <- data.frame(etap = c("przychód 2023", "zmiana cen", "zmiana ilości", "nowe produkty", "przychód 2025"),
                zmiana = skladniki / 1e6)
w$koniec <- c(w$zmiana[1], w$zmiana[1] + cumsum(w$zmiana[2:4]), w$zmiana[5])
w$poczatek <- c(0, w$koniec[1:3], 0)
w$x <- 1:5
w$typ <- c("suma", "składnik", "składnik", "składnik", "suma")
w$etykieta <- ifelse(w$typ == "suma", sprintf("%.2f mln", w$zmiana), sprintf("+%.2f mln", w$zmiana))
pA <- ggplot(w) +
  geom_rect(aes(xmin = x - 0.38, xmax = x + 0.38, ymin = poczatek, ymax = koniec, fill = typ)) +
  geom_text(aes(x = x, y = pmax(poczatek, koniec) + 0.12, label = etykieta), size = 3.5, colour = "#0f1d3a") +
  scale_fill_manual(values = c(suma = kol[["szary"]], składnik = kol[["niebieski"]]), guide = "none") +
  scale_x_continuous(breaks = 1:5, labels = c("2023", "ceny", "ilości", "nowe\nprodukty", "2025")) +
  coord_cartesian(ylim = c(0, 7.4)) +
  labs(title = "A. Przychód sieci (mln zł)", subtitle = "rozkład zmiany 2023 → 2025", x = NULL, y = "mln zł") + motyw
kd <- rbind(data.frame(kategoria = kat$kategoria, zl = kat$ef_ceny / 1e3, co = "efekt cen"),
            data.frame(kategoria = kat$kategoria, zl = kat$ef_ilosci / 1e3, co = "efekt ilości"))
kd$kategoria <- factor(kd$kategoria, levels = rev(names(kol_kat)))
pB <- ggplot(kd, aes(zl, kategoria, fill = co)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_col(position = position_dodge(width = 0.75), width = 0.7) +
  geom_text(aes(label = sprintf("%+.0f", zl), hjust = ifelse(zl >= 0, -0.15, 1.15)),
            position = position_dodge(width = 0.75), size = 3.3, colour = "#0f1d3a") +
  scale_fill_manual(values = unname(kol[c("pomaranczowy", "blekit")]), name = NULL) +
  scale_x_continuous(expand = expansion(mult = c(0.15, 0.2))) +
  labs(title = "B. Kategorie (tys. zł)", subtitle = "efekt cen i ilości, 2025 wobec 2023", x = "tys. zł", y = NULL) + motyw
p5 <- pA + pB + plot_layout(widths = c(1, 1.2))
p5                       # do pliku: ggsave("indeks-cen-rozklad-przychodu.svg", p5, width = 10, height = 5.6)
Wynik w R
przychod_2023          ceny        ilosci nowe_produkty przychod_2025
       5034.8         830.0         564.6         427.0        6856.4
Kontrola: ceny + ilości + nowe = zmiana przychodu: 0 tys. zł
Udział w zmianie przychodu (%): 45.6 31 23.4
Koszyk bazowy: przychód 2025/2023 = 1.277 | Fisher cen × Fisher ilości = 1.1565 × 1.1042 = 1.277
            kategoria ef_ceny ef_ilosci
         dania gotowe    82.4     106.1
             makarony   122.0      11.5
     mąki i mieszanki   236.7      61.9
             pieczywo    93.0     225.0
       płatki i kasze   123.3     124.2
 słodycze i przekąski   172.6      35.9
7. Mniejsza paczka i nowe produkty: Rysunek 6
R
# Rysunek 6. Pułapki: mniejsza paczka w tej samej cenie i nowe produkty spoza koszyka bazowego
# (korzysta z kol, motyw, dane z przepisu 1 i funkcji indeksy(), roczne() z przepisu 2 – bez losowania)
library(ggplot2)
library(patchwork)

# A. Makaron kukurydziany: od 01.2025 paczka 400 g zamiast 500 g w tej samej cenie
mk <- subset(dane, produkt == "makaron kukurydziany")
baza_mk <- mean(mk$cena_zl[mk$rok == 2023])
mk$za_paczke <- 100 * mk$cena_zl / baza_mk
mk$za_500g <- 100 * mk$cena_500g / baza_mk
print(round(sapply(split(mk[c("za_paczke", "za_500g")], mk$rok), colMeans), 1))
# Indeks Fishera kategorii i całego koszyka: liczony za paczkę (błąd) i za 500 g (poprawnie), 2025 wobec 2023
fisher_rok <- function(d, cena) {
  d$q <- if (cena == "cena_zl") d$sztuki else d$sztuki * d$gramatura_g / 500
  d$v <- d[[cena]] * d$q
  a <- aggregate(cbind(v, q) ~ produkt + rok, data = subset(d, w_koszyku_bazowym == 1 & rok %in% c(2023, 2025)), FUN = sum)
  a$p <- a$v / a$q
  x0 <- subset(a, rok == 2023); x1 <- subset(a, rok == 2025)[match(x0$produkt, subset(a, rok == 2025)$produkt), ]
  100 * indeksy(x0$p, x0$q, x1$p, x1$q)[["Fisher"]]
}
makarony <- subset(dane, kategoria == "makarony")
cat("Fisher makarony 2025/2023 – za paczkę:", round(fisher_rok(makarony, "cena_zl"), 2),
    "| za 500 g:", round(fisher_rok(makarony, "cena_500g"), 2), "\n")
cat("Fisher cały koszyk – za paczkę:", round(fisher_rok(dane, "cena_zl"), 2),
    "| za 500 g:", round(fisher_rok(dane, "cena_500g"), 2), "\n")

# B. Nowe produkty: udział przychodu spoza koszyka bazowego
udz <- aggregate(przychod ~ miesiac, data = dane, FUN = sum)
udz$nowe <- aggregate(przychod ~ miesiac, data = transform(dane, przychod = przychod * (w_koszyku_bazowym == 0)),
                      FUN = sum)$przychod
udz$udzial <- 100 * udz$nowe / udz$przychod
print(round(subset(udz, miesiac %in% c(19, 24, 30, 36), c(miesiac, udzial)), 1), row.names = FALSE)
nowe_cena <- subset(dane, w_koszyku_bazowym == 0 & miesiac == 36, c(produkt, cena_500g))
kat_cena <- aggregate(cena_500g ~ kategoria, data = subset(dane, w_koszyku_bazowym == 1 & miesiac == 36), FUN = mean)
print(nowe_cena, row.names = FALSE); print(subset(kat_cena, kategoria %in% c("pieczywo", "makarony")), row.names = FALSE)

dA <- rbind(data.frame(miesiac = mk$miesiac, indeks = mk$za_paczke, co = "cena za paczkę"),
            data.frame(miesiac = mk$miesiac, indeks = mk$za_500g, co = "cena za 500 g"))
pA <- ggplot(dA, aes(miesiac, indeks, colour = co, linetype = co)) +
  geom_vline(xintercept = 24.5, colour = "grey60", linetype = "dotted") +
  annotate("text", x = 24.2, y = 140, hjust = 1, size = 3.4, colour = "#0f1d3a", label = "paczka\n500 g → 400 g") +
  geom_line(linewidth = 0.9) +
  scale_colour_manual(values = unname(kol[c("pomaranczowy", "niebieski")]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = c(1, 13, 25, 36), labels = c("01.2023", "01.2024", "01.2025", "12.2025")) +
  labs(title = "A. Makaron kukurydziany", subtitle = "indeks prosty (średnia 2023 = 100)", x = NULL, y = "Indeks") + motyw
pB <- ggplot(udz, aes(miesiac, udzial)) +
  geom_area(fill = kol[["blekit"]], alpha = 0.6) + geom_line(colour = kol[["niebieski"]], linewidth = 0.9) +
  annotate("text", x = 36, y = udz$udzial[36] - 1.3, hjust = 1, size = 3.5, colour = "#0f1d3a",
           label = sprintf("%.1f%% przychodu", udz$udzial[36])) +
  scale_x_continuous(breaks = c(1, 19, 36), labels = c("01.2023", "07.2024", "12.2025")) +
  labs(title = "B. Przychód spoza koszyka bazowego", subtitle = "2 nowe produkty od 07.2024", x = NULL,
       y = "% przychodu w miesiącu") + motyw
p6 <- pA + pB
p6                       # do pliku: ggsave("indeks-cen-pulapki.svg", p6, width = 10, height = 5.2)
Wynik w R
          2023  2024  2025
za_paczke  100 110.4 120.4
za_500g    100 110.4 150.6
Fisher makarony 2025/2023 – za paczkę: 110.86 | za 500 g: 119.28
Fisher cały koszyk – za paczkę: 114.62 | za 500 g: 115.65
 miesiac udzial
      19    1.7
      24    5.3
      30    6.2
      36    6.0
               produkt cena_500g
 makaron z ciecierzycy     12.99
   chleb z ciecierzycą     18.08
 kategoria cena_500g
  makarony    12.404
  pieczywo    14.118
8. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – pomarańczowy" = c("#56B4E9", "#D55E00"),
             "niebieski – granat" = c("#0072B2", "#0f1d3a"), "pomarańczowy – żółty" = c("#D55E00", "#E69F00"),
             "zielony – błękit" = c("#009E73", "#56B4E9"), "różowy – pomarańczowy" = c("#CC79A7", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
błękit – pomarańczowy                      113.6        101.1       89.0
niebieski – granat                          41.3         40.8       41.3
pomarańczowy – żółty                        33.4         18.4       24.9
zielony – błękit                            59.5         48.8       51.9
różowy – pomarańczowy                       74.3         70.2       71.9
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie i obliczenia indeksów wykonano w podstawowej instalacji R (pakiet stats i funkcje bazowe). Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Średnia indeksów bez wag (rysunek 1) i jeden miesiąc jako baza (rysunek 2).
- Laspeyres jako „prawda” – przy zamianie produktów zawyża wzrost kosztu (rysunek 3).
- Łańcuch miesięczny przy promocjach – dryf o dziesiątki procent (rysunek 4).
- Cena za paczkę – mniejsza gramatura znika z indeksu (rysunek 6A).
- Stary koszyk – nowe produkty poza indeksem (rysunek 6B).
Najczęstsze pytania
Laspeyres czy Paasche – który indeks cen wybrać dla sklepu?
Najlepiej oba i Fishera. Laspeyres wycenia koszyk z okresu bazowego po nowych cenach, Paasche – dzisiejszy koszyk; gdy klienci przechodzą na produkty, które drożeją mniej, Laspeyres zawyża, a Paasche zaniża wzrost kosztu. W przykładzie trzech mąk: 126.9 wobec 123.7, Fisher 125.3.
Kiedy używać indeksu Fishera?
Gdy masz ceny i ilości z obu okresów – np. dane sprzedażowe sklepu. Fisher to średnia geometryczna Laspeyresa i Paaschego. W symulacji ze znanym prawdziwym wzrostem kosztu leżał prawie na prawdzie (błąd 0.055 pkt przy σ = 2), a iloczyn indeksów Fishera cen i ilości daje dokładnie zmianę przychodu.
Czy Laspeyres jest zawsze wyższy od Paaschego?
Nie. Zwykle tak, bo klienci uciekają od produktów, które najbardziej drożeją. Gdy jednak substytucji prawie nie ma albo klienci kupują więcej tego, co drożeje (np. modne produkty), Paasche może być wyższy. W przykładzie z trzema produktami z różnych kategorii Paasche wyszedł 108.30, a Laspeyres 108.14.
Co to jest dryf indeksu łańcuchowego?
To odjeżdżanie indeksu łańcuchowego od indeksu o stałej bazie, gdy ceny skaczą i wracają (np. promocje), a ilości reagują. W danych miesięcznych sklepu łańcuchowy Laspeyres dał 207.0, Paasche 68.4, a Fisher 119.0, podczas gdy stała baza dawała 125–130. Łańcuch roczny na średnich rocznych był bezpieczny.
Jak uwzględnić mniejszą paczkę w indeksie cen?
Licz cenę za jednostkę miary (kg, 500 g, litr), a nie za opakowanie. Makaron, którego paczkę zmniejszono z 500 do 400 g, podrożał w przykładzie o 20.4% za paczkę, ale o 50.6% za 500 g. Przy zmianie składu lub jakości potrzebna jest dodatkowo korekta jakości, np. regresja hedoniczna.
Powiązane hasła
Przeczytaj też
Like-for-like i paradoks Simpsona
Sklepy przy stacjach paliw: sprzedaż porównywalna, indeksy Laspeyresa i Paaschego, efekt mieszanki i średnia ze średnich – pięć rysunków z kodem R.
Czytaj →PoradnikOdchylenie plan–wykonanie: cena, wolumen, struktura
Plan przekroczony o 3.29 mln zł: ile to wolumen, struktura, cena i kurs euro, czy kolejność rozbicia ma znaczenie i kiedy odchylenie coś znaczy – z kodem R.
Czytaj →PoradnikPozycja cenowa wobec konkurencji
Sklep z oponami i trzech konkurentów: względny indeks ceny, regresja z efektami stałymi, próg najtańszej oferty i pułapka odwrotnej przyczynowości – z kodem R.
Czytaj →PoradnikStatystyka w pracy z zarządzania i ekonomii
Ankieta wśród pracowników i model ekonometryczny na danych wtórnych: regresja, weryfikacja modelu, elastyczności, kod R i gotowe opisy wyników.
Czytaj →PoradnikWielkość opakowania a cena za kg
Kasze i ryż w 4 opakowaniach i 80 sklepach: rabat ilościowy z regresji, efekt sklepu, kara za ilość i logit wyboru opakowania, z kodem R.
Czytaj →Liczysz indeks cen albo rozkład przychodu w pracy dyplomowej?
Pomożemy przygotować dane o cenach i sprzedaży, dobrać wzór indeksu i bazę, policzyć rozkład przychodu na ceny i ilości oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Białek, J. (2023). Scanner data and the problem of selecting a price index formula. Central European Review of Economics & Finance, 44(3), 5–20. https://doi.org/10.24136/ceref.2023.011 ● Otwarty dostęp
- Białek, J., & Beręsewicz, M. (2021). Scanner data in inflation measurement: From raw data to price indices. Statistical Journal of the IAOS, 37(4), 1315–1336. https://doi.org/10.3233/sji-210816 ● Otwarty dostęp: pełny tekst
- Diewert, W. E. (1998). Index number issues in the Consumer Price Index. Journal of Economic Perspectives, 12(1), 47–58. https://doi.org/10.1257/jep.12.1.47 ● Otwarty dostęp
- Diewert, W. E. (2013). Irving Fisher and index number theory. Journal of the History of Economic Thought, 35(2), 199–232. https://doi.org/10.1017/s1053837213000072
- Hausman, J. (2003). Sources of bias and solutions to bias in the Consumer Price Index. Journal of Economic Perspectives, 17(1), 23–44. https://doi.org/10.1257/089533003321164930 ● Otwarty dostęp
- Kim, I. K. (2024). Consumers' preference for downsizing over package price increases. Journal of Economics & Management Strategy, 33(1), 25–52. https://doi.org/10.1111/jems.12548 ● Otwarty dostęp: pełny tekst
- Nordhaus, W. D. (1998). Quality change in price indexes. Journal of Economic Perspectives, 12(1), 59–68. https://doi.org/10.1257/jep.12.1.59 ● Otwarty dostęp
Cytowania BibTeX
@article{bialek2023scanner, author={Białek, Jacek}, title={{Scanner data and the problem of selecting a price index formula}}, journal={Central European Review of Economics \& Finance}, year={2023}, volume={44}, number={3}, pages={5--20}, doi={10.24136/ceref.2023.011}}@article{bialek2021scanner, author={Białek, Jacek and Beręsewicz, Maciej}, title={{Scanner data in inflation measurement: From raw data to price indices}}, journal={Statistical Journal of the IAOS}, year={2021}, volume={37}, number={4}, pages={1315--1336}, doi={10.3233/sji-210816}}@article{diewert1998index, author={Diewert, W. Erwin}, title={{Index number issues in the Consumer Price Index}}, journal={Journal of Economic Perspectives}, year={1998}, volume={12}, number={1}, pages={47--58}, doi={10.1257/jep.12.1.47}}@article{diewert2013irving, author={Diewert, W. Erwin}, title={{Irving Fisher and index number theory}}, journal={Journal of the History of Economic Thought}, year={2013}, volume={35}, number={2}, pages={199--232}, doi={10.1017/s1053837213000072}}@article{hausman2003sources, author={Hausman, Jerry}, title={{Sources of bias and solutions to bias in the Consumer Price Index}}, journal={Journal of Economic Perspectives}, year={2003}, volume={17}, number={1}, pages={23--44}, doi={10.1257/089533003321164930}}@article{kim2024consumers, author={Kim, In Kyung}, title={{Consumers' preference for downsizing over package price increases}}, journal={Journal of Economics \& Management Strategy}, year={2024}, volume={33}, number={1}, pages={25--52}, doi={10.1111/jems.12548}}@article{nordhaus1998quality, author={Nordhaus, William D.}, title={{Quality change in price indexes}}, journal={Journal of Economic Perspectives}, year={1998}, volume={12}, number={1}, pages={59--68}, doi={10.1257/jep.12.1.59}}