Przykład: mieszkania w fikcyjnym mieście z sześcioma dzielnicami
Analityk portalu z ogłoszeniami w fikcyjnym mieście z sześcioma dzielnicami ma 4200 ofert sprzedaży mieszkań z lat 2023–2025 (12 kwartałów) i wie, które zakończyły się transakcją: 2575 (61.3%). Mediana ceny transakcyjnej to 476 000 zł, a ceny metra – 8974 zł.
Pytania zarządu: ile kosztuje dodatkowy metr, balkon albo wyższe piętro, o ile naprawdę podrożały mieszkania i ile jest warte konkretne mieszkanie? Odpowiada na nie regresja hedoniczna: regresja wieloraka, w której cenę dobra opisuje się jako sumę „cen” jego cech. Hill (2013) podkreśla, że każde mieszkanie jest inne, więc porównania cen trzeba korygować o jakość – a metody hedoniczne są do tego szczególnie przydatne.
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy m.in.: cena rośnie jak powierzchnia do potęgi 0.85 (metr tanieje w dużych mieszkaniach), balkon dodaje 0.05 do logarytmu ceny, parter odejmuje 0.07, a ceny rosną łącznie o 19.1% w 11 kwartałów. Rozrzut cen w Centrum i na Starym Mieście jest dwa razy większy niż gdzie indziej, udział nowych, małych mieszkań na Przedmieściu w ofertach rośnie z 8% do 38%, a sprzedający doliczają narzut, który rośnie w czasie. Pełna lista parametrów jest przy kodzie. Ziarno 663 ustalono raz i nie zmieniano go. Dane pobierzesz jako regresja-hedoniczna-mieszkania.csv (wiersz = oferta; cena transakcyjna tylko dla sprzedanych).
Rysunek 1: ile kosztuje balkon, dzielnica i nowy budynek
Model to regresja liniowa logarytmu ceny transakcyjnej:
Rok budowy (cztery okresy), dzielnica i kwartał weszły jako zmienne zero-jedynkowe – poziomy odniesienia to bloki z lat 1945–1989, Osiedle Północ i 2023 K1. Powierzchnię i piętro opisują splajny (rysunek 2). Logarytm pasuje, bo ceny są prawoskośne, a cechy działają procentowo.
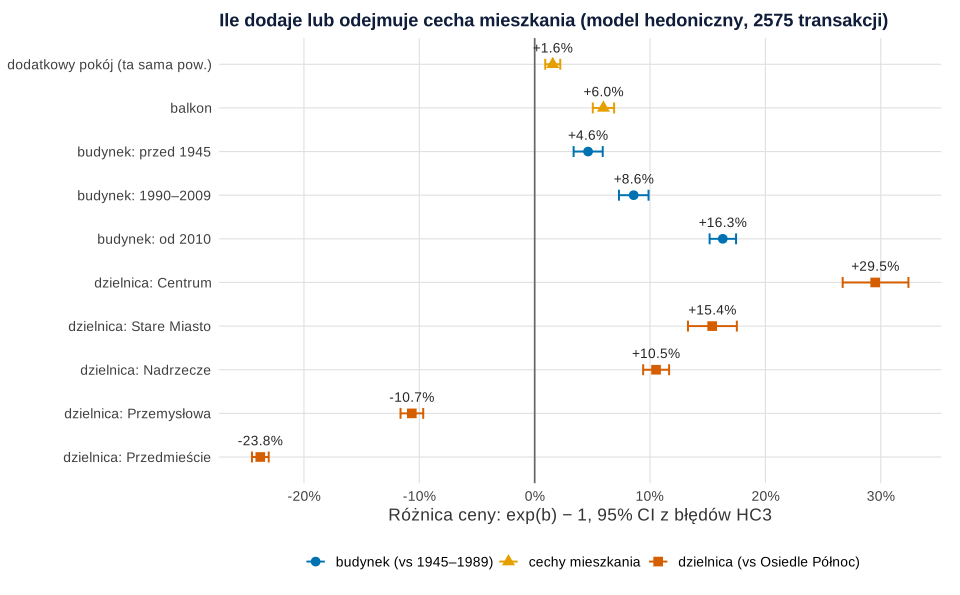
set.seed(663)).Co widać. Balkon podnosi cenę o 6.0%, 95% CI [5.0, 6.9], przy tej samej powierzchni, piętrze, dzielnicy i wieku budynku. Budynek z 2010 r. lub nowszy jest droższy od bloku z lat 1945–1989 o 16.3% [15.2, 17.5]. Mieszkanie w Centrum kosztuje o 29.5% [26.7, 32.4] więcej niż takie samo na Osiedlu Północ, a na Przedmieściu różnica wynosi −23.8% [−24.5, −23.1]. Dodatkowy pokój przy tej samej powierzchni to +1.6% [0.9, 2.2].
Dlaczego exp(b) − 1, a nie 100 × b. Współczynnik to różnica logarytmów, nie procent. Dla małych b to prawie to samo (balkon: b = 0.058, czyli 6.0%), dla dużych już nie: Centrum ma b = 0.259, czyli 25.9% w przybliżeniu, ale 29.5% naprawdę; Przedmieście b = −0.272, czyli −27.2% w przybliżeniu, a −23.8% naprawdę. Przelicz też granice przedziału. Van Garderen i Shah (2002) opisują dokładny estymator zmiany procentowej dla zmiennej zero-jedynkowej i przybliżenie Kennedy’ego, exp(b − SE²/2) − 1; tu zmienia ono wynik o setne części punktu.
Jak może zmylić. „+1.6% za pokój” dotyczy podziału tych samych metrów na więcej pomieszczeń. Powierzchnia i liczba pokoi korelują (r = .83 – zob. współliniowość), więc nie jest to cena mieszkania o pokój większego.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: dodatkowy metr i piętro nie działają liniowo
W modelu liniowym każdy metr dodaje ten sam procent: 1.38%. Ale metr ponad kawalerkę jest wart więcej niż setny metr. Dlatego powierzchnię i piętro opisaliśmy splajnem naturalnym z węzłami ustawionymi z góry (40, 55, 75 m²; piętra 1, 4, 7) – więcej we wpisie o splajnach i modelach GAM. Perperoglou i in. (2019) pokazują, że wynik zależy bardziej od liczby węzłów i wygładzenia niż od rodzaju bazy.
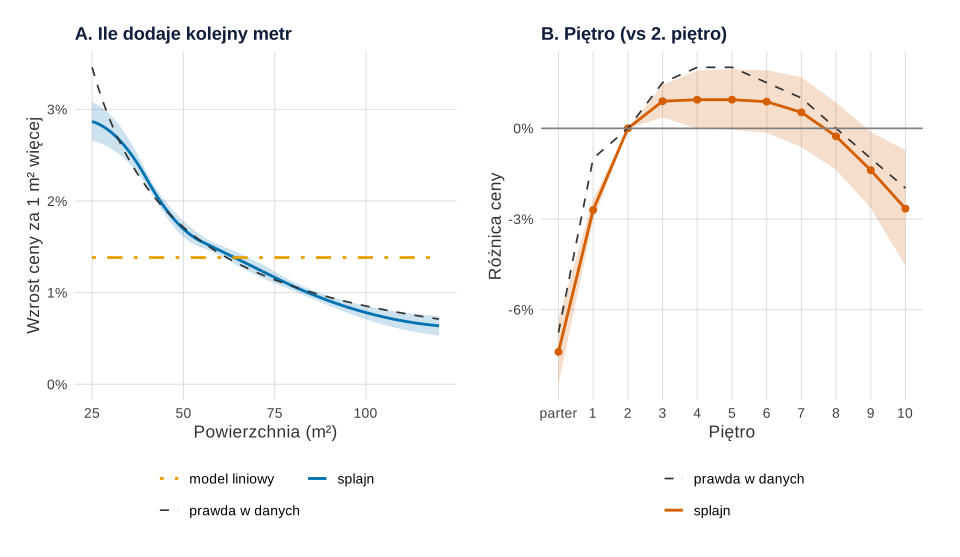
set.seed(663)).Co widać. Panel A: przy 30 m² metr więcej podnosi cenę o 2.76% [2.58, 2.94], przy 50 m² o 1.70%, przy 80 m² o 1.07%, przy 110 m² już tylko o 0.69%. Splajn leży na linii prawdy; model liniowy zawyża wartość metra w dużych mieszkaniach i zaniża w małych. W złotych różnica jest mniejsza: metr kosztuje 8229 zł przy 30 m² i 6602 zł przy 100 m² (Osiedle Północ, 2025 K4). Panel B: parter wobec 2. piętra to −7.4% [−8.5, −6.3], piętra 3–6 to ok. +0.9%, a 10. piętro −2.7% [−4.6, −0.7]. Splajny poprawiają dopasowanie: F(6, 2545) = 193.44, p < .001, R² rośnie z .900 do .931.
Jak może zmylić. Splajn wygładza skoki: prawdziwa strata 1. piętra to 1.0%, a model pokazuje −2.7%. Przy progu dodaj zmienną „parter”.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: nierówny rozrzut cen i błędy odporne
Klasyczne błędy standardowe zakładają jednakowy rozrzut reszt, a w centrum odnowione kamienice stoją obok zaniedbanych oficyn. Test Breuscha–Pagana względem dzielnicy: BP(5) = 341.66, p < .001.
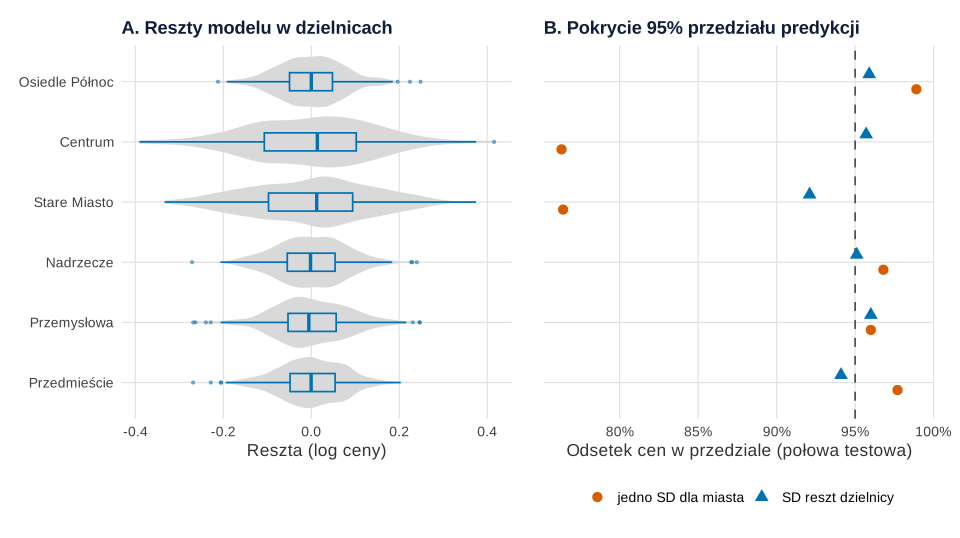
set.seed(663)).Co widać. Panel A: SD reszt wynosi 0.145 w Centrum i 0.136 na Starym Mieście wobec 0.073–0.086 gdzie indziej. Błąd odporny HC3 premii Centrum jest 1.45 raza większy od klasycznego (0.0112 wobec 0.0077), a Przedmieścia – mniejszy (0.0049 wobec 0.0057). White (1980) zaproponował macierz kowariancji zgodną także przy heteroskedastyczności o nieznanej postaci; Long i Ervin (2000) zalecają wersję HC3 i radzą nie uzależniać jej użycia od testu wstępnego. Panel B: model z połowy transakcji sprawdzony na drugiej. Przedział predykcji z jednym SD dla miasta obejmuje 93.9% cen, ale w Centrum tylko 76.3% (błąd standardowy odsetka ±2.3 punktu przy n = 93), a na Osiedlu Północ 98.9%. Z SD reszt danej dzielnicy pokrycie wynosi od 92.1% do 96.0%.
Jak może zmylić. Błędy HC3 naprawiają przedziały dla współczynników, ale nie przedziały predykcji dla pojedynczego mieszkania. Te zależą od rozrzutu tam, gdzie przewidujesz – zob. pasmo ufności i pasmo predykcji.
Podpis do pracy:
Zdanie do Metody:
Rysunek 4: indeks hedoniczny a średnia cena metra
Współczynniki kwartałów mówią, o ile droższe jest to samo mieszkanie w kolejnym kwartale – to hedoniczny indeks cen ze zmiennymi czasu: 100 × exp(bkwartał). Hill (2013) porządkuje warianty indeksów hedonicznych i ocenia, że ich zalety przeważają nad wadami w porównaniu z metodą powtórnych sprzedaży i stratyfikowanej mediany.
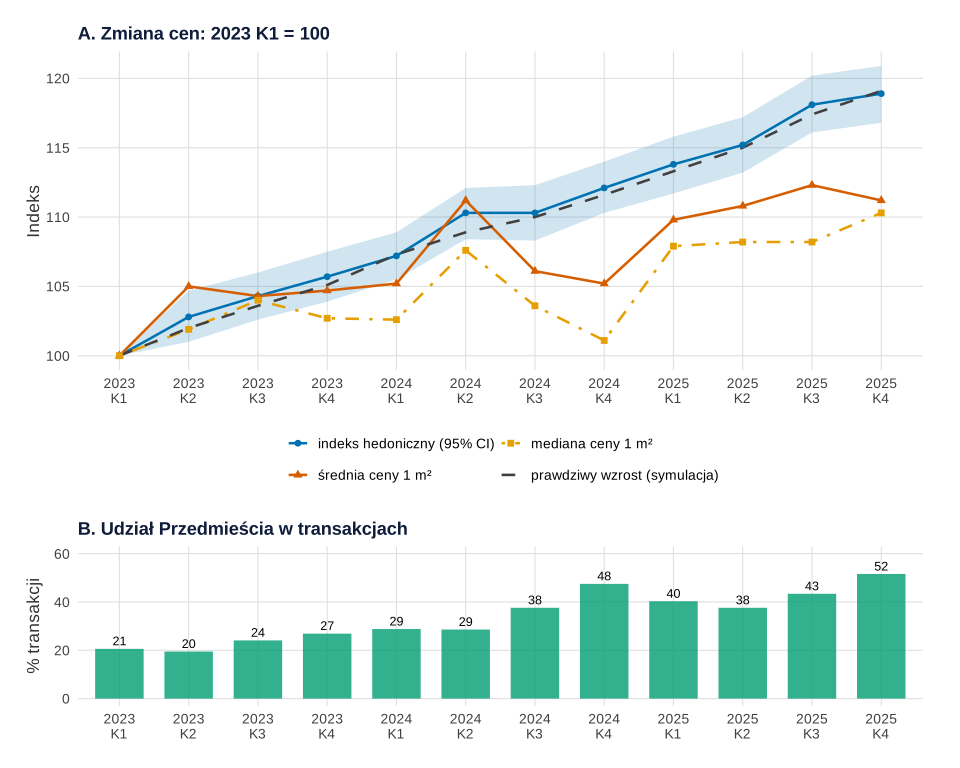
set.seed(663)).Co widać. Indeks hedoniczny w 2025 K4 wynosi 118.9, 95% CI [116.8, 120.9] (prawda: 119.1). Średnia cena metra pokazuje tylko 111.2, a mediana 110.3. W 2024 K4 średnia była niższa niż pół roku wcześniej (105.2 wobec 111.2), choć ceny cały czas rosły. Panel B wyjaśnia dlaczego: udział Przedmieścia, gdzie mieszkanie o tych samych cechach jest o 23.8% tańsze, wzrósł z 20.6% do 51.6% transakcji. Średnia miesza zmianę cen ze zmianą struktury sprzedaży, indeks porównuje mieszkania o tych samych cechach. Ten sam mechanizm w handlu opisuje wpis o porównaniu sklepów like-for-like.
Jak może zmylić. Indeks jest tak dobry, jak lista cech: zmiana niewidoczna w danych (np. standard wykończenia) trafi do współczynników kwartałów. Zakłada też stałe „ceny cech” – przy dłuższych szeregach licz go w kroczących oknach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: ceny ofertowe a transakcyjne
Shimizu i in. (2016) porównali ceny z czterech etapów sprzedaży mieszkań: duże różnice w rozkładach cen i cech po korekcie o jakość w dużej mierze znikały. Oszacowaliśmy ten sam model na cenach 4200 ofert.
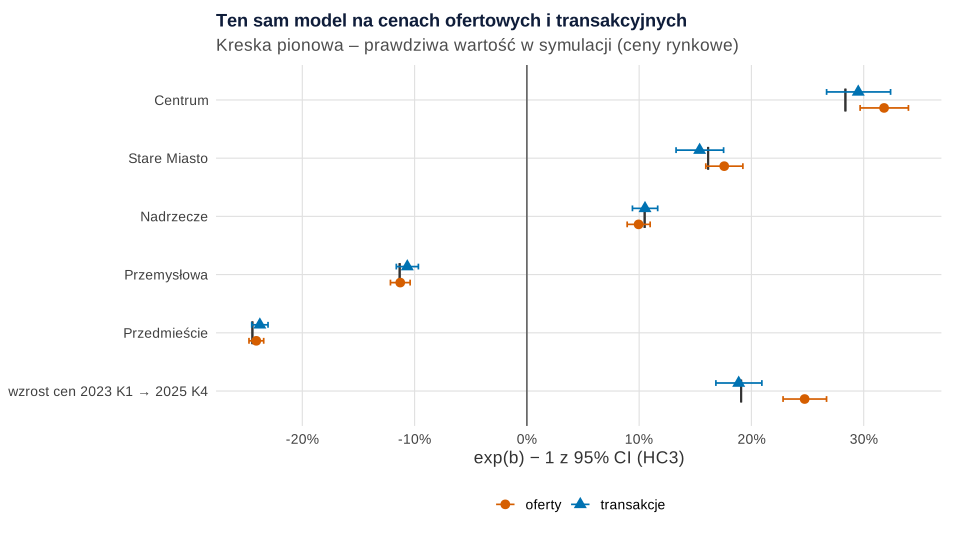
set.seed(663)).Co widać. Przy tych samych cechach ceny ofertowe są o 8.1% wyższe od transakcyjnych, a sprzedane mieszkania poszły średnio o 5.9% poniżej ceny z ogłoszenia. Gorzej, że różnica nie jest stała: w centrum narzut jest większy, więc premia Centrum z ofert to 31.8% [29.7, 34.0], z transakcji 29.5% (prawda 28.4%). Narzut rośnie w czasie, więc indeks z ofert pokazuje wzrost cen o 24.7% [22.8, 26.7] zamiast 18.9% – a odsetek sprzedanych ofert spadł z 72.3% do 43.7%.
Jak może zmylić. Transakcje to też próba wybrana: sprzedają się oferty z mniejszym narzutem. U nas wybór zależał tylko od narzutu, więc model na transakcjach trafia w prawdę. Gdyby sprzedawały się mieszkania o niewidocznych w danych zaletach, oszacowania byłyby obciążone – to błąd selekcji, który można modelować np. modelem selekcji Heckmana.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: z czego składa się cena jednego mieszkania
Ile warte jest 58-metrowe, trzypokojowe mieszkanie na 4. piętrze w Nadrzeczu, z balkonem, w budynku z 2012 r., w IV kwartale 2025 r.?
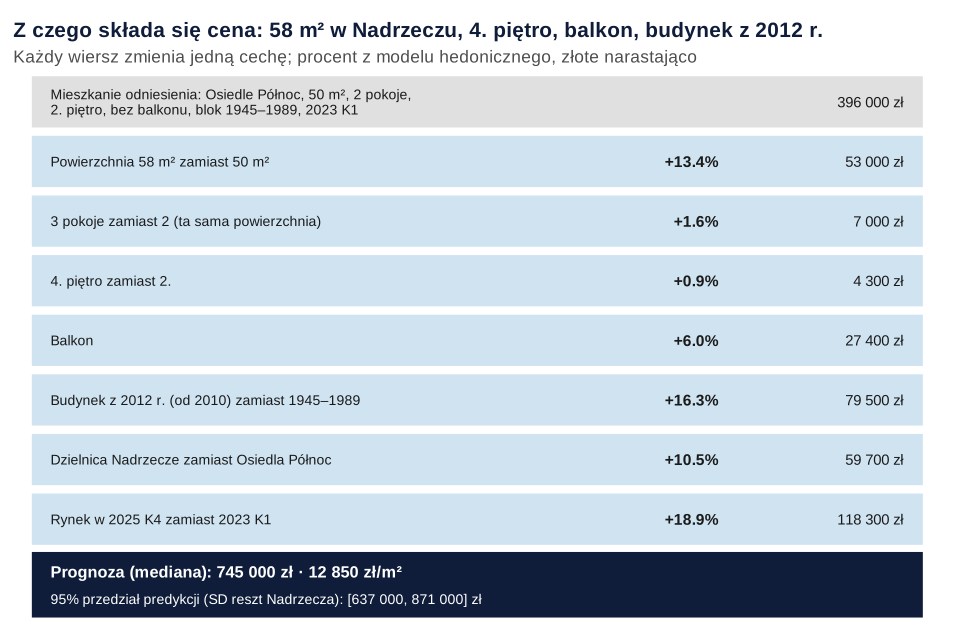
set.seed(663)).Co widać. Mieszkanie odniesienia kosztowałoby 396 000 zł; największy wkład mają wzrost rynku (+18.9%), nowy budynek (+16.3%) i dodatkowe 8 m² (+13.4%). Prognoza: 745 000 zł, 95% przedział predykcji [637 000, 871 000] zł. Prawdziwa mediana w symulacji: 755 683 zł.
Retransformacja. exp(prognozy logarytmu) to mediana ceny; przy rozkładzie lognormalnym średnia jest wyższa. Daje ją czynnik smearing Duana (1983) – średnia z exp(reszt): 1.0041 dla miasta (średnia 748 170 zł) i 1.0105 dla Centrum. Medianę podawaj dla jednego mieszkania, średnią – przy sumowaniu wartości wielu. Granice przedziału predykcji licz na logarytmach i przelicz exp(): z SD reszt miasta [623 000, 891 000] zł, z SD Nadrzecza (0.079) [637 000, 871 000] zł. Przedział ufności dla średniej ceny takich mieszkań, [730 000, 760 000] zł, dotyczy średniej, nie jednego mieszkania.
Jak może zmylić. Procenty nie zależą od kolejności wierszy, ale kwoty w złotych – tak: balkon dodany na końcu „kosztowałby” więcej. Karta rozbija prognozę, nie mierzy przyczynowego wkładu cech – inne sposoby rozkładania prognoz opisuje wpis o interpretacji modelu predykcyjnego.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w firmie
- Cennik dla klientów i wyceny automatyczne. Prognozę pokazuj z przedziałem predykcji z rozrzutu w danej dzielnicy – w Centrum przedział z jednym SD dla miasta myliłby się co czwarty raz.
- Raport o cenach. Publikuj indeks hedoniczny; średnia cena metra „zgubiła” tu prawie 8 punktów wzrostu.
- Źródło danych. Z samych ofert nie mów o cenach rynkowych; różnicę sprawdź na próbce transakcji.
- Cennik dewelopera: balkon (+6%), parter (−7%), układ pokoi – to związki z danych przekrojowych, nie wynik eksperymentu.
- Trafność prognoz sprawdzaj na nowych transakcjach miarami z hasła MAE, RMSE i MAPE. Losowy podział zawyża trafność – zob. wpis o przecieku danych i walidacji w czasie.
Pułapki
- „100 × b procent” dla dużych b – Centrum 25.9% zamiast 29.5%.
- Powierzchnia liniowo – zawyża wartość metra w dużych mieszkaniach.
- Klasyczne błędy przy nierównym rozrzucie – przedział premii Centrum o jedną trzecią za wąski.
- exp(prognozy) jako średnia – to mediana.
- Średnia cena metra jako miara zmian cen – miesza ceny ze strukturą sprzedaży.
- Oferty zamiast transakcji – zawyżony poziom i wzrost cen.
- Zdania przyczynowe („dobudowanie balkonu podniesie cenę o 6%”).
Jak opisać w pracy
W Metodzie opisz źródło cen, okres, postać zmiennych (logarytm, splajny, kategorie odniesienia) i błędy standardowe; w Wynikach – exp(b) − 1 z CI, efekty nieliniowe, indeks i przedział predykcji. Weryfikację modelu opisuje wpis statystyka w pracy z zarządzania i ekonomii, model log–log – wpis o elastyczności cenowej. Strukturę pracy podpowiada wpis jak napisać pracę z zarządzania i ekonomii.
Kod R: dane, model hedoniczny, splajny, błędy odporne, indeks i wycena
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, przepis 2 – modele i macierz V, przepis 3 – mieszkanie odniesienia odn, z których korzystają kolejne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane) i 4 (podział na połowy); każdy zaczyna losowanie od własnego set.seed(663). Ziarno 663 ustalono raz i nie zmieniano go. Ręcznie ustalono: 6 dzielnic i ich premie (0, 0.25, 0.15, 0.10, −0.12, −0.28 w logarytmie ceny) oraz SD składnika losowego (0.07, 0.15, 0.13, 0.08, 0.08, 0.07), cztery okresy budowy (0, 0.04, 0.08, 0.15), efekty pięter 0–10 (od −0.07 dla parteru do +0.02), wykładnik powierzchni 0.85, efekt pokoju 0.015 i balkonu 0.05, cenę 8000 zł/m² dla mieszkania odniesienia, przyrosty indeksu w 12 kwartałach (łącznie 0.175), 350 ofert na kwartał, udział nowych mieszkań na Przedmieściu (od 0.08 do 0.38), rozkłady powierzchni, pokoi, pięter i balkonów, narzut ofertowy (0.05 + 0.004 na kwartał + 0.03 w Centrum i na Starym Mieście, SD 0.04), szansę sprzedaży (logit 3 − 30 × narzut) i rozrzut ceny transakcyjnej (SD 0.015), a także węzły splajnów (40, 55, 75 m²; piętra 1, 4, 7). Wpływu narzutu na cenę transakcyjną nie ma – ustawiliśmy to po pierwszym uruchomieniu, żeby porównanie ofert i transakcji było czytelne; ziarna nie zmienialiśmy.
1. Paleta, motyw i dane: 4200 ofert i 2575 transakcji
R
# Fikcyjne miasto, 6 dzielnic, 12 kwartałów (2023–2025): oferty mieszkań i transakcje (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey55", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie („prawda” w log ceny; dzielnica odniesienia: Osiedle Północ)
dzielnice <- c("Osiedle Północ", "Centrum", "Stare Miasto", "Nadrzecze", "Przemysłowa", "Przedmieście")
efekt_dz  <- c(0, .25, .15, .10, -.12, -.28)
sd_dz     <- c(.07, .15, .13, .08, .08, .07)        # rozrzut cen różny w dzielnicach (heteroskedastyczność)
epoki     <- c("1945–1989", "przed 1945", "1990–2009", "od 2010")
efekt_ep  <- c(0, .04, .08, .15)
efekt_pietro <- c(-.07, -.01, 0, .015, .02, .02, .015, .01, 0, -.01, -.02)   # piętra 0 (parter) – 10
el_pow    <- .85                                     # cena ~ powierzchnia^0.85: metr tanieje w dużych mieszkaniach
efekt_pokoj <- .015; efekt_balkon <- .05
indeks_log <- c(0, .02, .035, .05, .07, .085, .095, .11, .125, .14, .16, .175)  # prawdziwy wzrost cen w kwartałach
kwartaly  <- paste0(rep(2023:2025, each = 4), " K", 1:4)

set.seed(663)                                        # ziarno ustalone raz, bez dobierania pod wynik
n_kw <- 350; N <- n_kw * 12
t <- rep(1:12, each = n_kw)
# Struktura ofert się zmienia: w kolejnych kwartałach coraz więcej nowych, małych mieszkań na Przedmieściu
p_nowe <- .08 + .30 * (t - 1) / 11
nowe <- rbinom(N, 1, p_nowe) == 1
dz <- ifelse(nowe, "Przedmieście",
             sample(dzielnice, N, replace = TRUE, prob = c(.25, .12, .15, .18, .18, .12)))
ep <- ifelse(nowe, "od 2010", sample(epoki, N, replace = TRUE, prob = c(.45, .15, .22, .18)))
pow <- round(pmin(pmax(exp(rnorm(N, ifelse(nowe, log(46), log(56)), .30)), 22), 130), 1)
pokoje <- pmin(pmax(round(pow / 19 + rnorm(N, 0, .5)), 1), 5)
pietro <- sample(0:10, N, replace = TRUE, prob = c(.16, .15, .14, .13, .11, .09, .07, .05, .04, .03, .03))
balkon <- rbinom(N, 1, ifelse(ep == "przed 1945", .30, ifelse(ep == "od 2010", .90, .65)))
i_dz <- match(dz, dzielnice); i_ep <- match(ep, epoki)
# Wartość rynkowa (zł): 8 000 zł/m² dla mieszkania 50 m² na Osiedlu Północ w 2023 K1
ln_wartosc <- log(8000 * 50) + el_pow * log(pow / 50) + efekt_pokoj * (pokoje - 2) + efekt_pietro[pietro + 1] +
  efekt_balkon * balkon + efekt_ep[i_ep] + efekt_dz[i_dz] + indeks_log[t] + rnorm(N, 0, sd_dz[i_dz])
# Cena ofertowa = wartość + narzut sprzedającego (większy w centrum i rosnący w czasie)
narzut <- rnorm(N, .05 + .004 * (t - 1) + .03 * (dz %in% c("Centrum", "Stare Miasto")), .04)
cena_ofertowa <- round(exp(ln_wartosc + narzut), -3)
# Sprzedają się częściej oferty z małym narzutem; w transakcji płaci się wartość rynkową (± negocjacje)
sprzedane <- rbinom(N, 1, plogis(3 - 30 * narzut))
cena_transakcyjna <- ifelse(sprzedane == 1, round(exp(ln_wartosc + rnorm(N, 0, .015)), -3), NA)

oferty <- data.frame(id = 1:N, kwartal = factor(kwartaly[t], levels = kwartaly), t = t,
                     dzielnica = factor(dz, levels = dzielnice), powierzchnia = pow, pokoje = pokoje,
                     pietro = pietro, balkon = balkon, epoka = factor(ep, levels = epoki),
                     cena_ofertowa = cena_ofertowa, sprzedane = sprzedane, cena_transakcyjna = cena_transakcyjna)
write.csv(oferty, "regresja-hedoniczna-mieszkania.csv", row.names = FALSE)
tr <- subset(oferty, sprzedane == 1)                 # transakcje – główna próba modelu
tr$ln_cena <- log(tr$cena_transakcyjna)

# Opis próby
c(ofert = nrow(oferty), transakcji = nrow(tr), odsetek_sprzedanych = round(100 * mean(oferty$sprzedane), 1))
round(c(mediana_ceny = median(tr$cena_transakcyjna), mediana_pow = median(tr$powierzchnia),
        mediana_zl_m2 = median(tr$cena_transakcyjna / tr$powierzchnia)), 0)
round(100 * prop.table(table(tr$dzielnica)), 1)
round(100 * prop.table(table(tr$epoka)), 1)
round(100 * mean(tr$balkon), 1)
round(cor(tr$powierzchnia, tr$pokoje), 2)
Wynik w R
              ofert          transakcji odsetek_sprzedanych
             4200.0              2575.0                61.3
 mediana_ceny   mediana_pow mediana_zl_m2
       476000            53          8974

Osiedle Północ        Centrum   Stare Miasto      Nadrzecze    Przemysłowa
          21.4            7.3            9.5           15.2           13.9
  Przedmieście
          32.7

 1945–1989 przed 1945  1990–2009    od 2010
      35.1       12.5       16.3       36.1
[1] 68.9
[1] 0.83
2. Model hedoniczny i rysunek 1
R
# Tabela 1 i rysunek 1. Regresja hedoniczna log ceny transakcyjnej (dane z przepisu 1)
library(splines)    # ns() – splajn naturalny
library(sandwich)   # vcovHC() – błędy odporne na heteroskedastyczność

# Model 1: powierzchnia i piętro liniowo; model 2: splajny powierzchni i piętra
m_lin <- lm(ln_cena ~ powierzchnia + pokoje + pietro + balkon + epoka + dzielnica + kwartal, data = tr)
m_spl <- lm(ln_cena ~ ns(powierzchnia, knots = c(40, 55, 75), Boundary.knots = c(22, 130)) + pokoje +
              ns(pietro, knots = c(1, 4, 7), Boundary.knots = c(0, 10)) + balkon + epoka + dzielnica + kwartal,
            data = tr)
round(c(R2_liniowy = summary(m_lin)$r.squared, R2_splajny = summary(m_spl)$r.squared), 3)
anova(m_lin, m_spl)                                # czy splajny poprawiają dopasowanie?

# Współczynniki modelu 2 jako procenty: exp(b) − 1, przedziały z błędów HC3
V <- vcovHC(m_spl, type = "HC3")
b <- coef(m_spl); se <- sqrt(diag(V))
wybrane <- c("pokoje", "balkon", grep("^epoka|^dzielnica", names(b), value = TRUE))
tab <- data.frame(b = b[wybrane], SE_HC3 = se[wybrane],
                  proc_100b = 100 * b[wybrane],                       # przybliżenie „100 × b”
                  proc = 100 * (exp(b[wybrane]) - 1),                  # dokładnie: exp(b) − 1
                  dolna = 100 * (exp(b[wybrane] - qt(.975, df.residual(m_spl)) * se[wybrane]) - 1),
                  gorna = 100 * (exp(b[wybrane] + qt(.975, df.residual(m_spl)) * se[wybrane]) - 1),
                  kennedy = 100 * (exp(b[wybrane] - se[wybrane]^2 / 2) - 1))   # poprawka Kennedy’ego
round(tab, 3)
# Model 1: jeden „procent za metr” dla wszystkich mieszkań
round(100 * (exp(coef(m_lin)[c("powierzchnia", "pietro")]) - 1), 2)

# Rysunek 1. Wycena cech: procentowa różnica ceny przy pozostałych cechach bez zmian
tab$cecha <- sub("^epoka", "budynek: ", sub("^dzielnica", "dzielnica: ", rownames(tab)))
tab$cecha[tab$cecha == "pokoje"] <- "dodatkowy pokój (ta sama pow.)"
tab$cecha[tab$cecha == "balkon"] <- "balkon"
tab$grupa <- ifelse(grepl("^dzielnica", tab$cecha), "dzielnica (vs Osiedle Północ)",
                    ifelse(grepl("^budynek", tab$cecha), "budynek (vs 1945–1989)", "cechy mieszkania"))
tab$cecha <- factor(tab$cecha, levels = rev(tab$cecha))
p1 <- ggplot(tab, aes(proc, cecha, colour = grupa, shape = grupa)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, linewidth = 0.7, orientation = "y") +
  geom_point(size = 3) +
  geom_text(aes(label = sprintf("%+.1f%%", proc)), nudge_y = 0.38, size = 3.6, colour = "grey15", show.legend = FALSE) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomarancz"]], kol[["cynober"]])) +
  scale_x_continuous(labels = function(x) paste0(x, "%"), breaks = seq(-30, 30, 10)) +
  labs(title = "Ile dodaje lub odejmuje cecha mieszkania (model hedoniczny, 2575 transakcji)",
       x = "Różnica ceny: exp(b) − 1, 95% CI z błędów HC3", y = NULL, colour = NULL, shape = NULL) +
  motyw
p1   # zapis: ggsave("regresja-hedoniczna-wycena-cech.svg", p1, width = 10, height = 6.2)
Wynik w R
R2_liniowy R2_splajny
     0.900      0.931
Analysis of Variance Table

Model 1: ln_cena ~ powierzchnia + pokoje + pietro + balkon + epoka + dzielnica +
    kwartal
Model 2: ln_cena ~ ns(powierzchnia, knots = c(40, 55, 75), Boundary.knots = c(22,
    130)) + pokoje + ns(pietro, knots = c(1, 4, 7), Boundary.knots = c(0,
    10)) + balkon + epoka + dzielnica + kwartal
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1   2551 30.596
2   2545 21.013  6    9.5829 193.44 < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
                           b SE_HC3 proc_100b    proc   dolna   gorna kennedy
pokoje                 0.016  0.003     1.554   1.566   0.916   2.220   1.565
balkon                 0.058  0.004     5.787   5.958   5.040   6.884   5.957
epokaprzed 1945        0.045  0.006     4.526   4.630   3.376   5.899   4.628
epoka1990–2009         0.082  0.006     8.232   8.580   7.306   9.870   8.578
epokaod 2010           0.151  0.005    15.103  16.304  15.164  17.454  16.302
dzielnicaCentrum       0.259  0.011    25.863  29.515  26.697  32.397  29.507
dzielnicaStare Miasto  0.143  0.009    14.312  15.387  13.289  17.524  15.382
dzielnicaNadrzecze     0.100  0.005    10.004  10.522   9.403  11.652  10.520
dzielnicaPrzemysłowa  -0.113  0.006   -11.261 -10.650 -11.628  -9.662 -10.652
dzielnicaPrzedmieście -0.272  0.005   -27.159 -23.784 -24.506 -23.054 -23.784
powierzchnia       pietro
        1.38         0.71
3. Efekt powierzchni i piętra: rysunek 2
R
# Rysunek 2. Nieliniowość: efekt powierzchni i piętra ze splajnów (model m_spl i macierz V z przepisu 2)
library(patchwork)

# Różnica log ceny względem mieszkania odniesienia (jednego albo osobnego dla każdego wiersza) + 95% CI z HC3 (pozostałe cechy bez zmian)
efekt <- function(nowe, odn) {
  Xn <- model.matrix(delete.response(terms(m_spl)), nowe, xlev = m_spl$xlevels)
  Xo <- model.matrix(delete.response(terms(m_spl)), odn, xlev = m_spl$xlevels)
  D <- Xn - Xo[rep(seq_len(nrow(Xo)), length.out = nrow(Xn)), , drop = FALSE]; est <- drop(D %*% coef(m_spl)); s <- sqrt(rowSums((D %*% V) * D))
  q <- qt(.975, df.residual(m_spl))
  data.frame(proc = 100 * (exp(est) - 1), dolna = 100 * (exp(est - q * s) - 1), gorna = 100 * (exp(est + q * s) - 1))
}
odn <- data.frame(powierzchnia = 50, pokoje = 2, pietro = 2, balkon = 0, epoka = "1945–1989",
                  dzielnica = "Osiedle Północ", kwartal = "2023 K1")
# A. Ile procent ceny dodaje kolejny metr: różnica między (m + 0.5) i (m − 0.5) m²
m2 <- 25:120
ef_pow <- cbind(powierzchnia = m2, efekt(transform(odn[rep(1, 96), ], powierzchnia = m2 + 0.5),
                                         transform(odn[rep(1, 96), ], powierzchnia = m2 - 0.5)),
                liniowy = 100 * (exp(coef(m_lin)[["powierzchnia"]]) - 1),
                prawda = 100 * (((m2 + 0.5) / (m2 - 0.5))^el_pow - 1))
# B. Piętro względem 2. piętra
siatka_pi  <- transform(odn[rep(1, 11), ], pietro = 0:10)
ef_pi  <- cbind(siatka_pi, efekt(siatka_pi, odn), prawda = 100 * (exp(efekt_pietro - efekt_pietro[3]) - 1))

# Ile kosztuje dodatkowy metr? Pochodna ceny dla mieszkania na Osiedlu Północ, 2025 K4, pozostałe cechy jak w odniesieniu
metr <- function(m2) {
  d <- transform(odn[c(1, 1), ], powierzchnia = c(m2 - 0.5, m2 + 0.5), kwartal = "2025 K4")
  p <- exp(predict(m_spl, d)); c(m2 = m2, cena = mean(p), zl_za_metr = unname(diff(p)), proc_za_metr = unname(100 * (p[2] / p[1] - 1)))
}
round(t(sapply(c(30, 40, 50, 65, 80, 100), metr)), 2)
rownames(ef_pow) <- rownames(ef_pi) <- NULL
round(ef_pow[ef_pow$powierzchnia %in% c(30, 50, 80, 110), ], 2)
round(ef_pi[, c("pietro", "proc", "dolna", "gorna", "prawda")], 1)

pA <- ggplot(ef_pow, aes(powierzchnia)) +
  geom_ribbon(aes(ymin = dolna, ymax = gorna), fill = kol[["niebieski"]], alpha = 0.2) +
  geom_line(aes(y = proc, linetype = "splajn"), colour = kol[["niebieski"]], linewidth = 1) +
  geom_line(aes(y = liniowy, linetype = "model liniowy"), colour = kol[["pomarancz"]], linewidth = 1) +
  geom_line(aes(y = prawda, linetype = "prawda w danych"), colour = "grey20", linewidth = 0.6) +
  scale_linetype_manual(values = c("splajn" = "solid", "model liniowy" = "dotdash", "prawda w danych" = "dashed")) +
  scale_y_continuous(labels = function(x) paste0(x, "%"), limits = c(0, NA)) +
  labs(title = "A. Ile dodaje kolejny metr", x = "Powierzchnia (m²)", y = "Wzrost ceny za 1 m² więcej",
       linetype = NULL) + motyw + guides(linetype = guide_legend(nrow = 2,
       override.aes = list(colour = c(kol[["pomarancz"]], "grey20", kol[["niebieski"]]))))
pB <- ggplot(ef_pi, aes(pietro)) +
  geom_ribbon(aes(ymin = dolna, ymax = gorna), fill = kol[["cynober"]], alpha = 0.2) +
  geom_line(aes(y = proc, linetype = "splajn"), colour = kol[["cynober"]], linewidth = 1) +
  geom_point(aes(y = proc), colour = kol[["cynober"]], size = 2) +
  geom_line(aes(y = prawda, linetype = "prawda w danych"), colour = "grey20", linewidth = 0.6) +
  geom_hline(yintercept = 0, colour = "grey50") +
  scale_linetype_manual(values = c("splajn" = "solid", "prawda w danych" = "dashed")) +
  scale_x_continuous(breaks = 0:10, labels = c("parter", 1:10)) +
  scale_y_continuous(labels = function(x) paste0(x, "%")) +
  labs(title = "B. Piętro (vs 2. piętro)", x = "Piętro", y = "Różnica ceny", linetype = NULL) + motyw +
  guides(linetype = guide_legend(nrow = 2, override.aes = list(colour = c("grey20", kol[["cynober"]]))))
p2 <- pA + pB
p2   # zapis: ggsave("regresja-hedoniczna-splajny-powierzchnia-pietro.svg", p2, width = 10, height = 5.8)
Wynik w R
      m2     cena zl_za_metr proc_za_metr
[1,]  30 302526.3    8229.43         2.76
[2,]  40 388390.2    8593.77         2.24
[3,]  50 470533.8    7911.34         1.70
[4,]  65 589389.7    7978.78         1.36
[5,]  80 706503.4    7525.55         1.07
[6,] 100 847557.4    6602.19         0.78
   powierzchnia proc dolna gorna liniowy prawda
6            30 2.76  2.58  2.94    1.38   2.87
26           50 1.70  1.61  1.78    1.38   1.71
56           80 1.07  1.02  1.12    1.38   1.07
86          110 0.69  0.60  0.79    1.38   0.78
   pietro proc dolna gorna prawda
1       0 -7.4  -8.5  -6.3   -6.8
2       1 -2.7  -3.1  -2.3   -1.0
3       2  0.0   0.0   0.0    0.0
4       3  0.9   0.4   1.4    1.5
5       4  0.9   0.0   1.9    2.0
6       5  0.9   0.0   2.0    2.0
7       6  0.9  -0.1   1.9    1.5
8       7  0.5  -0.6   1.7    1.0
9       8 -0.3  -1.4   0.9    0.0
10      9 -1.4  -2.6  -0.1   -1.0
11     10 -2.7  -4.6  -0.7   -2.0
4. Heteroskedastyczność, błędy HC3 i przedziały predykcji: rysunek 3
R
# Rysunek 3. Heteroskedastyczność: reszty w dzielnicach, błędy klasyczne vs HC3, pokrycie przedziałów predykcji
library(lmtest)      # bptest()

bptest(m_spl, ~ dzielnica, data = tr)                         # test Breuscha–Pagana względem dzielnicy
round(tapply(resid(m_spl), tr$dzielnica, sd), 3)             # SD reszt w dzielnicach
# Błąd standardowy klasyczny i HC3 dla premii dzielnic
se_kl <- sqrt(diag(vcov(m_spl))); se_hc <- sqrt(diag(V))
dz_wsp <- grep("^dzielnica", names(se_kl), value = TRUE)
round(cbind(SE_klasyczny = se_kl[dz_wsp], SE_HC3 = se_hc[dz_wsp], iloraz = se_hc[dz_wsp] / se_kl[dz_wsp]), 4)

# Pokrycie 95% przedziałów predykcji na mieszkaniach spoza próby uczącej (losowy podział pół na pół)
set.seed(663)
ucz <- sample(nrow(tr), nrow(tr) / 2)
m_ucz <- update(m_spl, data = tr[ucz, ])
test <- tr[-ucz, ]
pred <- predict(m_ucz, test, interval = "prediction")         # jedno SD reszt dla całego miasta
sd_dz_ucz <- tapply(resid(m_ucz), tr$dzielnica[ucz], sd)    # SD reszt osobno w każdej dzielnicy
fit <- predict(m_ucz, test, se.fit = TRUE)
pol <- qt(.975, df.residual(m_ucz)) * sqrt(fit$se.fit^2 + sd_dz_ucz[as.character(test$dzielnica)]^2)
w_kl <- test$ln_cena >= pred[, "lwr"] & test$ln_cena <= pred[, "upr"]
w_dz <- test$ln_cena >= fit$fit - pol & test$ln_cena <= fit$fit + pol
pokrycie <- data.frame(dzielnica = levels(tr$dzielnica),
                       n = as.vector(table(test$dzielnica)),
                       jedno_SD = 100 * as.vector(tapply(w_kl, test$dzielnica, mean)),
                       SD_dzielnicy = 100 * as.vector(tapply(w_dz, test$dzielnica, mean)))
pokrycie$SE_odsetka_pp <- 100 * sqrt(.95 * .05 / pokrycie$n)  # błąd standardowy odsetka, gdyby pokrycie było 95%
pokrycie[-1] <- round(pokrycie[-1], 1); pokrycie
round(c(calosc_jedno_SD = 100 * mean(w_kl), calosc_SD_dzielnicy = 100 * mean(w_dz)), 1)

# Rysunek 3: reszty (A) i pokrycie przedziałów predykcji (B)
rd <- data.frame(dzielnica = tr$dzielnica, reszta = resid(m_spl))
pA <- ggplot(rd, aes(reszta, dzielnica)) +
  geom_violin(fill = "grey85", colour = NA, scale = "width", width = 0.85) +
  geom_boxplot(outlier.size = 0.8, outlier.alpha = 0.5, fill = NA, colour = kol[["niebieski"]], width = 0.3, linewidth = 0.6) +
  scale_y_discrete(limits = rev(levels(tr$dzielnica))) +
  labs(title = "A. Reszty modelu w dzielnicach", x = "Reszta (log ceny)", y = NULL) + motyw
pk <- rbind(data.frame(dzielnica = pokrycie$dzielnica, wersja = "jedno SD dla miasta", pokrycie = pokrycie$jedno_SD),
            data.frame(dzielnica = pokrycie$dzielnica, wersja = "SD reszt dzielnicy", pokrycie = pokrycie$SD_dzielnicy))
pB <- ggplot(pk, aes(pokrycie, dzielnica, colour = wersja, shape = wersja)) +
  geom_vline(xintercept = 95, linetype = "dashed", colour = "grey30") +
  geom_point(size = 3.2, position = position_dodge(width = 0.5)) +
  scale_y_discrete(limits = rev(levels(tr$dzielnica))) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["niebieski"]])) +
  scale_x_continuous(labels = function(x) paste0(x, "%")) +
  labs(title = "B. Pokrycie 95% przedziału predykcji", x = "Odsetek cen w przedziale (połowa testowa)",
       y = NULL, colour = NULL, shape = NULL) + motyw + theme(axis.text.y = element_blank())
p3 <- pA + pB
p3   # zapis: ggsave("regresja-hedoniczna-heteroskedastycznosc.svg", p3, width = 10, height = 5.6)
Wynik w R
	studentized Breusch-Pagan test

data:  m_spl
BP = 341.66, df = 5, p-value < 2.2e-16

Osiedle Północ        Centrum   Stare Miasto      Nadrzecze    Przemysłowa
         0.074          0.145          0.136          0.079          0.086
  Przedmieście
         0.073
                      SE_klasyczny SE_HC3 iloraz
dzielnicaCentrum            0.0077 0.0112 1.4539
dzielnicaStare Miasto       0.0070 0.0094 1.3301
dzielnicaNadrzecze          0.0060 0.0052 0.8608
dzielnicaPrzemysłowa        0.0062 0.0056 0.9053
dzielnicaPrzedmieście       0.0057 0.0049 0.8502
       dzielnica   n jedno_SD SD_dzielnicy SE_odsetka_pp
1 Osiedle Północ 267     98.9         95.9           1.3
2        Centrum  93     76.3         95.7           2.3
3   Stare Miasto 127     76.4         92.1           1.9
4      Nadrzecze 185     96.8         95.1           1.6
5    Przemysłowa 175     96.0         96.0           1.6
6   Przedmieście 441     97.7         94.1           1.0
    calosc_jedno_SD calosc_SD_dzielnicy
               93.9                94.8
5. Indeks hedoniczny a średnia cena metra: rysunek 4
R
# Rysunek 4. Hedoniczny indeks cen (zmienne kwartałów) vs średnia i mediana ceny metra (m_spl, V z przepisu 2)
kw <- grep("^kwartal", names(coef(m_spl)), value = TRUE)
q <- qt(.975, df.residual(m_spl))
ind <- data.frame(kwartal = factor(levels(tr$kwartal), levels = levels(tr$kwartal)),
                  hedoniczny = 100 * exp(c(0, coef(m_spl)[kw])),
                  dolna = 100 * exp(c(0, coef(m_spl)[kw] - q * sqrt(diag(V))[kw])),
                  gorna = 100 * exp(c(0, coef(m_spl)[kw] + q * sqrt(diag(V))[kw])),
                  prawda = 100 * exp(indeks_log), row.names = NULL)
zl_m2 <- tr$cena_transakcyjna / tr$powierzchnia
sr <- tapply(zl_m2, tr$kwartal, mean); me <- tapply(zl_m2, tr$kwartal, median)
ind$srednia_m2 <- 100 * as.vector(sr / sr[1]); ind$mediana_m2 <- 100 * as.vector(me / me[1])
ind$udzial_przedmiescie <- 100 * as.vector(tapply(tr$dzielnica == "Przedmieście", tr$kwartal, mean))
ind$udzial_od_2010 <- 100 * as.vector(tapply(tr$epoka == "od 2010", tr$kwartal, mean))
ind$sr_pow <- as.vector(tapply(tr$powierzchnia, tr$kwartal, mean))
ind[-1] <- round(ind[-1], 1); ind

# Rysunek 4: trzy miary zmiany cen (A) i zmiana struktury sprzedanych mieszkań (B)
dl <- rbind(data.frame(kwartal = ind$kwartal, miara = "indeks hedoniczny (95% CI)", wartosc = ind$hedoniczny),
            data.frame(kwartal = ind$kwartal, miara = "średnia ceny 1 m²", wartosc = ind$srednia_m2),
            data.frame(kwartal = ind$kwartal, miara = "mediana ceny 1 m²", wartosc = ind$mediana_m2),
            data.frame(kwartal = ind$kwartal, miara = "prawdziwy wzrost (symulacja)", wartosc = ind$prawda))
dl$miara <- factor(dl$miara, levels = unique(dl$miara))
pA <- ggplot(dl, aes(kwartal, wartosc, group = miara)) +
  geom_ribbon(data = ind, aes(kwartal, ymin = dolna, ymax = gorna, group = 1), inherit.aes = FALSE,
              fill = kol[["niebieski"]], alpha = 0.18) +
  geom_line(aes(colour = miara, linetype = miara), linewidth = 0.9) +
  geom_point(aes(colour = miara, shape = miara), size = 2, na.rm = TRUE) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["cynober"]], kol[["pomarancz"]], "grey25")) +
  scale_linetype_manual(values = c("solid", "solid", "dotdash", "dashed")) +
  scale_shape_manual(values = c(16, 17, 15, NA)) +
  scale_x_discrete(labels = function(x) sub(" K", "\nK", x)) +
  labs(title = "A. Zmiana cen: 2023 K1 = 100", x = NULL, y = "Indeks", colour = NULL, linetype = NULL, shape = NULL) +
  motyw + guides(colour = guide_legend(nrow = 2))
pB <- ggplot(ind, aes(kwartal, udzial_przedmiescie, group = 1)) +
  geom_col(fill = kol[["zielony"]], alpha = 0.8, width = 0.7) +
  geom_text(aes(label = round(udzial_przedmiescie)), vjust = -0.4, size = 3.3) +
  scale_x_discrete(labels = function(x) sub(" K", "\nK", x)) +
  scale_y_continuous(limits = c(0, 60)) +
  labs(title = "B. Udział Przedmieścia w transakcjach", x = NULL, y = "% transakcji") + motyw
p4 <- pA / pB + patchwork::plot_layout(heights = c(2, 1))
p4   # zapis: ggsave("regresja-hedoniczna-indeks-cen.svg", p4, width = 10, height = 8)
Wynik w R
   kwartal hedoniczny dolna gorna prawda srednia_m2 mediana_m2
1  2023 K1      100.0 100.0 100.0  100.0      100.0      100.0
2  2023 K2      102.8 101.0 104.7  102.0      105.0      101.9
3  2023 K3      104.3 102.6 106.0  103.6      104.3      104.0
4  2023 K4      105.7 103.9 107.5  105.1      104.7      102.7
5  2024 K1      107.2 105.5 108.9  107.3      105.2      102.6
6  2024 K2      110.3 108.4 112.1  108.9      111.2      107.6
7  2024 K3      110.3 108.3 112.3  110.0      106.1      103.6
8  2024 K4      112.1 110.3 114.0  111.6      105.2      101.1
9  2025 K1      113.8 111.7 115.8  113.3      109.8      107.9
10 2025 K2      115.2 113.2 117.2  115.0      110.8      108.2
11 2025 K3      118.1 116.1 120.2  117.4      112.3      108.2
12 2025 K4      118.9 116.8 120.9  119.1      111.2      110.3
   udzial_przedmiescie udzial_od_2010 sr_pow
1                 20.6           25.7   58.4
2                 19.5           25.6   57.4
3                 24.1           28.4   56.1
4                 26.9           28.5   56.9
5                 28.8           36.3   55.8
6                 28.6           35.7   53.2
7                 37.6           42.9   56.6
8                 47.5           41.1   54.4
9                 40.3           39.3   56.8
10                37.6           41.0   56.5
11                43.4           46.7   53.4
12                51.6           54.9   54.0
6. Ceny ofertowe a transakcyjne: rysunek 5
R
# Rysunek 5. Ceny ofertowe a transakcyjne: ten sam model na dwóch źródłach danych (dane z przepisu 1)
oferty$ln_oferta <- log(oferty$cena_ofertowa)
wzor_of <- update(formula(m_spl), ln_oferta ~ .)
m_of <- lm(wzor_of, data = oferty)                              # wszystkie oferty, także niesprzedane
V_of <- vcovHC(m_of, type = "HC3")

# Ile ceny transakcyjne są niższe od ofertowych (te same mieszkania) i które oferty się sprzedały
sp <- subset(oferty, sprzedane == 1)
round(100 * c(sredni_upust = mean(1 - sp$cena_transakcyjna / sp$cena_ofertowa),
              mediana_upustu = median(1 - sp$cena_transakcyjna / sp$cena_ofertowa)), 1)
round(100 * tapply(oferty$sprzedane, oferty$dzielnica, mean), 1)        # odsetek sprzedanych ofert
round(100 * tapply(oferty$sprzedane, oferty$kwartal, mean), 1)

# Premie dzielnic i wzrost cen do 2025 K4: model na ofertach vs na transakcjach
wsp <- c(grep("^dzielnica", names(coef(m_spl)), value = TRUE), "kwartal2025 K4")
q <- qt(.975, df.residual(m_of))
por <- rbind(
  data.frame(wsp = wsp, zrodlo = "transakcje", proc = 100 * (exp(coef(m_spl)[wsp]) - 1),
             dolna = 100 * (exp(coef(m_spl)[wsp] - q * sqrt(diag(V))[wsp]) - 1),
             gorna = 100 * (exp(coef(m_spl)[wsp] + q * sqrt(diag(V))[wsp]) - 1)),
  data.frame(wsp = wsp, zrodlo = "oferty", proc = 100 * (exp(coef(m_of)[wsp]) - 1),
             dolna = 100 * (exp(coef(m_of)[wsp] - q * sqrt(diag(V_of))[wsp]) - 1),
             gorna = 100 * (exp(coef(m_of)[wsp] + q * sqrt(diag(V_of))[wsp]) - 1)))
por$prawda <- 100 * (exp(c(efekt_dz[-1], indeks_log[12])) - 1)[match(por$wsp, wsp)]
por$etykieta <- sub("^dzielnica", "", sub("^kwartal2025 K4", "wzrost cen 2023 K1 → 2025 K4", por$wsp))
rownames(por) <- NULL
cbind(por[c("etykieta", "zrodlo")], round(por[c("proc", "dolna", "gorna", "prawda")], 1))
# Poziom cen: o ile ceny ofertowe przewyższają transakcyjne przy tych samych cechach (wyraz wolny)
round(100 * (exp(coef(m_of)[1] - coef(m_spl)[1]) - 1), 1)

por$etykieta <- factor(por$etykieta, levels = rev(unique(por$etykieta)))
p5 <- ggplot(por, aes(proc, etykieta, colour = zrodlo, shape = zrodlo)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_point(aes(x = prawda), shape = 124, size = 6, colour = "grey20") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, linewidth = 0.6, orientation = "y",
                position = position_dodge(width = 0.55)) +
  geom_point(size = 3, position = position_dodge(width = 0.55)) +
  scale_colour_manual(values = c(oferty = kol[["cynober"]], transakcje = kol[["niebieski"]])) +
  scale_x_continuous(labels = function(x) paste0(x, "%"), breaks = seq(-30, 40, 10)) +
  labs(title = "Ten sam model na cenach ofertowych i transakcyjnych",
       subtitle = "Kreska pionowa – prawdziwa wartość w symulacji (ceny rynkowe)",
       x = "exp(b) − 1 z 95% CI (HC3)", y = NULL, colour = NULL, shape = NULL) + motyw
p5   # zapis: ggsave("regresja-hedoniczna-oferty-a-transakcje.svg", p5, width = 10, height = 5.6)
Wynik w R
  sredni_upust mediana_upustu
           5.9            6.0
Osiedle Północ        Centrum   Stare Miasto      Nadrzecze    Przemysłowa
          65.7           46.4           51.3           66.2           62.9
  Przedmieście
          63.9
2023 K1 2023 K2 2023 K3 2023 K4 2024 K1 2024 K2 2024 K3 2024 K4 2025 K1 2025 K2
   72.3    70.3    66.3    69.1    64.6    60.9    60.0    57.7    58.9    60.0
2025 K3 2025 K4
   52.0    43.7
                       etykieta     zrodlo  proc dolna gorna prawda
1                       Centrum transakcje  29.5  26.7  32.4   28.4
2                  Stare Miasto transakcje  15.4  13.3  17.5   16.2
3                     Nadrzecze transakcje  10.5   9.4  11.7   10.5
4                   Przemysłowa transakcje -10.7 -11.6  -9.7  -11.3
5                  Przedmieście transakcje -23.8 -24.5 -23.1  -24.4
6  wzrost cen 2023 K1 → 2025 K4 transakcje  18.9  16.8  20.9   19.1
7                       Centrum     oferty  31.8  29.7  34.0   28.4
8                  Stare Miasto     oferty  17.6  15.9  19.2   16.2
9                     Nadrzecze     oferty  10.0   8.9  11.0   10.5
10                  Przemysłowa     oferty -11.3 -12.2 -10.4  -11.3
11                 Przedmieście     oferty -24.1 -24.8 -23.4  -24.4
12 wzrost cen 2023 K1 → 2025 K4     oferty  24.7  22.8  26.7   19.1
(Intercept)
        8.1
7. Wycena jednego mieszkania i karta: rysunek 6
R
# Rysunek 6. Wycena jednego mieszkania: składniki ceny, retransformacja i przedział predykcji (m_spl, odn z przepisów 2–3)
nasze <- data.frame(powierzchnia = 58, pokoje = 3, pietro = 4, balkon = 1, epoka = "od 2010",
                    dzielnica = "Nadrzecze", kwartal = "2025 K4")
# Krok po kroku od mieszkania odniesienia: zmieniamy po jednej cesze (w modelu addytywnym w log kolejność nie zmienia %)
kroki <- c("punkt wyjścia", "powierzchnia", "pokoje", "pietro", "balkon", "epoka", "dzielnica", "kwartal")
d <- odn
lp <- numeric(length(kroki))
for (k in seq_along(kroki)) {
  if (k > 1) d[[kroki[k]]] <- nasze[[kroki[k]]]
  lp[k] <- predict(m_spl, d)
}
skladniki <- data.frame(krok = kroki, proc = c(NA, 100 * (exp(diff(lp)) - 1)), cena = exp(lp))
skladniki$zl <- c(NA, diff(skladniki$cena))
cbind(skladniki["krok"], round(skladniki[-1], 1))

# Retransformacja: exp(prognozy log) to mediana; średnią daje czynnik smearing Duana
fit <- predict(m_spl, nasze, se.fit = TRUE)
e <- resid(m_spl)
smear_miasto <- mean(exp(e)); smear_dz <- mean(exp(e[tr$dzielnica == "Nadrzecze"]))
f <- unname(fit$fit)
round(c(mediana = exp(f), srednia_smearing_miasto = exp(f) * smear_miasto, srednia_smearing_dzielnica = exp(f) * smear_dz))
round(c(czynnik_miasto = smear_miasto, czynnik_Nadrzecze = smear_dz,
        czynnik_Centrum = mean(exp(e[tr$dzielnica == "Centrum"]))), 4)
# Prawdziwa mediana wartości tego mieszkania w symulacji (parametry z przepisu 1)
round(8000 * 50 * (58 / 50)^el_pow * exp(efekt_pokoj + efekt_pietro[5] + efekt_balkon + efekt_ep[4] + efekt_dz[4] + indeks_log[12]))
# Przedział predykcji 95%: liczony na log i przeliczony exp(); wersja z SD reszt całego miasta i dzielnicy
q <- qt(.975, df.residual(m_spl))
sd_mi <- summary(m_spl)$sigma; sd_nd <- sd(e[tr$dzielnica == "Nadrzecze"])
pp <- function(s) exp(f + c(-1, 1) * q * sqrt(fit$se.fit^2 + s^2))
pi_tab <- rbind(SD_miasta = c(sd_mi, pp(sd_mi)), SD_Nadrzecza = c(sd_nd, pp(sd_nd)))
colnames(pi_tab) <- c("sd", "dolna", "gorna"); round(pi_tab, 3)
round(exp(f + c(-1, 1) * q * fit$se.fit))                 # przedział ufności średniej (dla porównania)

# Rysunek 6. Grafika: karta „z czego składa się cena”
opis <- c("Mieszkanie odniesienia: Osiedle Północ, 50 m², 2 pokoje,\n2. piętro, bez balkonu, blok 1945–1989, 2023 K1",
          "Powierzchnia 58 m² zamiast 50 m²", "3 pokoje zamiast 2 (ta sama powierzchnia)", "4. piętro zamiast 2.",
          "Balkon", "Budynek z 2012 r. (od 2010) zamiast 1945–1989", "Dzielnica Nadrzecze zamiast Osiedla Północ",
          "Rynek w 2025 K4 zamiast 2023 K1")
pi_nd <- pp(sd_nd)
karta <- data.frame(y = 9:2, opis = opis,
                    proc = ifelse(is.na(skladniki$proc), "", sprintf("%+.1f%%", skladniki$proc)),
                    zl = ifelse(is.na(skladniki$zl), sprintf("%s zł", format(round(skladniki$cena, -3), big.mark = " ")),
                                sprintf("%+s zł", format(round(skladniki$zl, -2), big.mark = " ", trim = TRUE))))
karta$tlo <- ifelse(karta$y == 9, "start", ifelse(skladniki$proc > 0, "plus", "minus"))
p6 <- ggplot(karta) +
  geom_rect(aes(xmin = 0.2, xmax = 9.8, ymin = y - 0.43, ymax = y + 0.43, fill = tlo), colour = NA) +
  geom_text(aes(x = 0.4, y = y, label = opis), hjust = 0, size = 3.7, colour = "grey10", lineheight = 0.9) +
  geom_text(aes(x = 7.6, y = y, label = proc), hjust = 1, size = 4.1, fontface = "bold", colour = "grey10") +
  geom_text(aes(x = 9.6, y = y, label = zl), hjust = 1, size = 3.9, colour = "grey10") +
  annotate("rect", xmin = 0.2, xmax = 9.8, ymin = 0.35, ymax = 1.45, fill = "#0f1d3a") +
  annotate("text", x = 0.4, y = 1.12, hjust = 0, colour = "white", fontface = "bold", size = 4.3,
           label = sprintf("Prognoza (mediana): %s zł  ·  %s zł/m²", format(round(exp(f), -3), big.mark = " "),
                           format(round(exp(f) / 58, -1), big.mark = " "))) +
  annotate("text", x = 0.4, y = 0.66, hjust = 0, colour = "white", size = 3.7,
           label = sprintf("95%% przedział predykcji (SD reszt Nadrzecza): [%s, %s] zł",
                           format(round(pi_nd[1], -3), big.mark = " "), format(round(pi_nd[2], -3), big.mark = " "))) +
  scale_fill_manual(values = c(start = "grey88", plus = "#cfe3f1", minus = "#f6d5c3"), guide = "none") +
  coord_cartesian(xlim = c(0, 10), ylim = c(0.3, 9.6), expand = FALSE) +
  labs(title = "Z czego składa się cena: 58 m² w Nadrzeczu, 4. piętro, balkon, budynek z 2012 r.",
       subtitle = "Każdy wiersz zmienia jedną cechę; procent z modelu hedonicznego, złote narastająco") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p6   # zapis: ggsave("regresja-hedoniczna-karta-ceny.svg", p6, width = 10, height = 6.6)
Wynik w R
           krok proc     cena       zl
1 punkt wyjścia   NA 395854.4       NA
2  powierzchnia 13.4 448900.6  53046.2
3        pokoje  1.6 455929.5   7028.9
4        pietro  0.9 460251.5   4322.0
5        balkon  6.0 487672.9  27421.5
6         epoka 16.3 567181.4  79508.5
7     dzielnica 10.5 626859.6  59678.2
8       kwartal 18.9 745126.2 118266.6
                   mediana    srednia_smearing_miasto
                    745126                     748170
srednia_smearing_dzielnica
                    747447
   czynnik_miasto czynnik_Nadrzecze   czynnik_Centrum
           1.0041            1.0031            1.0105
[1] 755683
                sd    dolna    gorna
SD_miasta    0.091 622825.2 891442.9
SD_Nadrzecza 0.079 637436.1 871009.8
[1] 730427 760122
8. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (transakcje / oferty; powierzchnia / piętro)" = c("#0072B2", "#D55E00"),
             "niebieski – pomarańczowy (rysunek 1, 4)" = c("#0072B2", "#E69F00"),
             "pomarańczowy – cynober (rysunek 1, 4)" = c("#E69F00", "#D55E00"),
             "jasnoniebieskie – jasnocynobrowe tło (karta, rysunek 6)" = c("#cfe3f1", "#f6d5c3"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                 widzenie_typowe
niebieski – cynober (transakcje / oferty; powierzchnia / piętro)           114.6
niebieski – pomarańczowy (rysunek 1, 4)                                    120.2
pomarańczowy – cynober (rysunek 1, 4)                                       33.4
jasnoniebieskie – jasnocynobrowe tło (karta, rysunek 6)                     25.6
czerwony – zielony (do unikania)                                           121.7
                                                                 deuteranopia
niebieski – cynober (transakcje / oferty; powierzchnia / piętro)        108.3
niebieski – pomarańczowy (rysunek 1, 4)                                 121.5
pomarańczowy – cynober (rysunek 1, 4)                                    18.4
jasnoniebieskie – jasnocynobrowe tło (karta, rysunek 6)                  24.3
czerwony – zielony (do unikania)                                         21.1
                                                                 protanopia
niebieski – cynober (transakcje / oferty; powierzchnia / piętro)       91.9
niebieski – pomarańczowy (rysunek 1, 4)                               109.3
pomarańczowy – cynober (rysunek 1, 4)                                  24.9
jasnoniebieskie – jasnocynobrowe tło (karta, rysunek 6)                20.1
czerwony – zielony (do unikania)                                       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, regresja liniowa, splajny naturalne – pakiety base, stats i splines). Błędy standardowe HC3 policzono pakietem sandwich, a test Breuscha–Pagana pakietem lmtest (z zależnością zoo). Rysunki wykonano w ggplot2 (zestawienie paneli – patchwork); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Najczęstsze pytania
Jak interpretować współczynnik w regresji logarytmu ceny?
Przelicz go jako exp(b) − 1: to procentowa różnica ceny przy wzroście zmiennej o jednostkę (albo dla kategorii względem poziomu odniesienia) przy pozostałych cechach bez zmian. Przybliżenie „100 × b procent” działa tylko dla małych b – w przykładzie premia Centrum b = 0.259 to 29.5%, a nie 25.9%. Granice przedziału ufności przelicz tak samo.
Ile kosztuje dodatkowy metr kwadratowy w modelu hedonicznym?
To zależy od wielkości mieszkania, dlatego powierzchnię warto opisać splajnem zamiast jednego współczynnika. W przykładzie metr więcej podnosił cenę o 2.76% przy 30 m², o 1.70% przy 50 m² i o 0.69% przy 110 m², a model liniowy dawał stałe 1.38%. W złotych różnica jest mniejsza, bo procent liczy się od wyższej ceny.
Czym różni się hedoniczny indeks cen od średniej ceny metra?
Indeks hedoniczny porównuje ceny mieszkań o tych samych cechach – w najprostszej wersji to 100 × exp(b) ze współczynników zmiennych zero-jedynkowych okresów w regresji logarytmu ceny. Średnia cena metra miesza zmianę cen ze zmianą struktury sprzedanych mieszkań. W przykładzie indeks pokazał wzrost o 18.9%, a średnia tylko o 11.2%, bo przybyło tanich mieszkań z obrzeży.
Czy do modelu cen mieszkań można użyć cen ofertowych?
Można, ale wynik opisuje oczekiwania sprzedających, nie rynek. Ceny ofertowe są wyższe od transakcyjnych, a gdy narzut zmienia się w czasie lub między dzielnicami, obciążone są też współczynniki: w przykładzie model na ofertach pokazał wzrost cen o 24.7% zamiast 18.9%. Jeśli masz tylko oferty, sprawdź różnicę na próbce transakcji.
Jak policzyć przedział predykcji ceny mieszkania z modelu logarytmicznego?
Policz prognozę i przedział na logarytmach, a potem przelicz granice funkcją exp() – przedział będzie niesymetryczny. exp(prognozy) to mediana ceny; średnią daje czynnik smearing Duana (średnia z exp(reszt)). Gdy rozrzut cen różni się między dzielnicami, użyj odchylenia standardowego reszt z dzielnicy wycenianego mieszkania.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z zarządzania i ekonomii
Ankieta wśród pracowników i model ekonometryczny na danych wtórnych: regresja, weryfikacja modelu, elastyczności, kod R i gotowe opisy wyników.
Czytaj →PoradnikNieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →PoradnikLike-for-like i paradoks Simpsona
Sklepy przy stacjach paliw: sprzedaż porównywalna, indeksy Laspeyresa i Paaschego, efekt mieszanki i średnia ze średnich – pięć rysunków z kodem R.
Czytaj →PoradnikElastyczność cenowa z danych sprzedażowych
Sieć 10 sklepów i granola: regresja log–log z przedziałem, elastyczność krzyżowa, marża i cena optymalna oraz pułapka ceny ustalanej pod popyt – z kodem R.
Czytaj →PoradnikIndeks cen: Laspeyres, Paasche i Fisher
30 produktów bezglutenowych i 3 lata cen: trzy wzory ręcznie w R, substytucja, dryf łańcucha, przychód na ceny i ilości oraz mniejsza paczka.
Czytaj →PoradnikAukcje internetowe – co podnosi cenę końcową
3000 aukcji zegarków: regresja log(ceny) w %, niesprzedane aukcje i cenzurowanie, model dwuczęściowy, mediator i błędy klastrowane – z kodem R.
Czytaj →Budujesz model cen mieszkań w pracy dyplomowej?
Pomożemy przygotować dane z ofert lub transakcji, dobrać postać zmiennych, oszacować model hedoniczny z błędami odpornymi, policzyć indeks cen i przedziały predykcji oraz opisać wyniki z tabelą i rysunkami – tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Duan, N. (1983). Smearing estimate: A nonparametric retransformation method. Journal of the American Statistical Association, 78(383), 605–610. https://doi.org/10.1080/01621459.1983.10478017
- Hill, R. J. (2013). Hedonic price indexes for residential housing: A survey, evaluation and taxonomy. Journal of Economic Surveys, 27(5), 879–914. https://doi.org/10.1111/j.1467-6419.2012.00731.x
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- Perperoglou, A., Sauerbrei, W., Abrahamowicz, M., & Schmid, M. (2019). A review of spline function procedures in R. BMC Medical Research Methodology, 19(1), Article 46. https://doi.org/10.1186/s12874-019-0666-3 ● Otwarty dostęp
- Shimizu, C., Nishimura, K. G., & Watanabe, T. (2016). House prices at different stages of the buying/selling process. Regional Science and Urban Economics, 59, 37–53. https://doi.org/10.1016/j.regsciurbeco.2016.04.001 ● Otwarty dostęp: pełny tekst
- van Garderen, K. J., & Shah, C. (2002). Exact interpretation of dummy variables in semilogarithmic equations. The Econometrics Journal, 5(1), 149–159. https://doi.org/10.1111/1368-423x.00078
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
Cytowania BibTeX
@article{duan1983smearing, author={Duan, Naihua}, title={{Smearing estimate: A nonparametric retransformation method}}, journal={Journal of the American Statistical Association}, year={1983}, volume={78}, number={383}, pages={605--610}, doi={10.1080/01621459.1983.10478017}}@article{hill2013hedonic, author={Hill, Robert J.}, title={{Hedonic price indexes for residential housing: A survey, evaluation and taxonomy}}, journal={Journal of Economic Surveys}, year={2013}, volume={27}, number={5}, pages={879--914}, doi={10.1111/j.1467-6419.2012.00731.x}}@article{long2000using, author={Long, J. Scott and Ervin, Laurie H.}, title={{Using heteroscedasticity consistent standard errors in the linear regression model}}, journal={The American Statistician}, year={2000}, volume={54}, number={3}, pages={217--224}, doi={10.1080/00031305.2000.10474549}}@article{perperoglou2019review, author={Perperoglou, Aris and Sauerbrei, Willi and Abrahamowicz, Michal and Schmid, Matthias}, title={{A review of spline function procedures in R}}, journal={BMC Medical Research Methodology}, year={2019}, volume={19}, number={1}, eid={46}, doi={10.1186/s12874-019-0666-3}}@article{shimizu2016house, author={Shimizu, Chihiro and Nishimura, Kiyohiko G. and Watanabe, Tsutomu}, title={{House prices at different stages of the buying/selling process}}, journal={Regional Science and Urban Economics}, year={2016}, volume={59}, pages={37--53}, doi={10.1016/j.regsciurbeco.2016.04.001}}@article{vangarderen2002exact, author={van Garderen, Kees Jan and Shah, Chandra}, title={{Exact interpretation of dummy variables in semilogarithmic equations}}, journal={The Econometrics Journal}, year={2002}, volume={5}, number={1}, pages={149--159}, doi={10.1111/1368-423x.00078}}@article{white1980heteroskedasticity, author={White, Halbert}, title={{A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity}}, journal={Econometrica}, year={1980}, volume={48}, number={4}, pages={817--838}, doi={10.2307/1912934}}