Przykład: serwis aukcji używanych zegarków
Fikcyjny serwis aukcji używanych zegarków ma dane o 3000 zakończonych aukcjach 116 modeli. Dla każdego modelu serwis zna cenę referencyjną – typową cenę z wcześniejszych transakcji. Sprzedawca sam wybiera cenę wywoławczą, liczbę zdjęć, długość aukcji (3, 5, 7 lub 10 dni) oraz dzień i godzinę końca. Serwis zna też ocenę sprzedawcy (odsetek pozytywnych opinii) i wie, czy zegarek ma pudełko i dokumenty.
Pytanie marketingu: co podpowiadać sprzedawcom, żeby zegarki sprzedawały się drożej? I czy wysoka cena wywoławcza „chroni” cenę, czy odstrasza licytujących? Sprzedało się 2187 aukcji (72.9%), z medianą ceny końcowej 1520 zł, czyli 0.91 ceny referencyjnej. Pozostałe 813 aukcji zakończyły się bez sprzedaży: nikt nie dał ceny wywoławczej, więc ceny końcowej nie ma.
Dane są fikcyjne i wiemy, jaki mechanizm w nich ukryliśmy. Parametry ustawiliśmy ręcznie: zdjęcia, pora końca i długość aukcji przyciągają licytujących, wysoka cena wywoławcza ich odstrasza, a licytujący podbijają cenę; staranni sprzedawcy dodają więcej zdjęć i mają lepsze oceny. Wartości i zmiany po pierwszym uruchomieniu opisujemy przy kodzie. Dzięki temu widać, które oszacowanie trafia w prawdę. Dane pobierzesz jako aukcje-zegarkow-3000.csv (dla niesprzedanych aukcji cena końcowa jest pusta).
Rysunek 1: jak przebiega aukcja i czego nie widać w danych
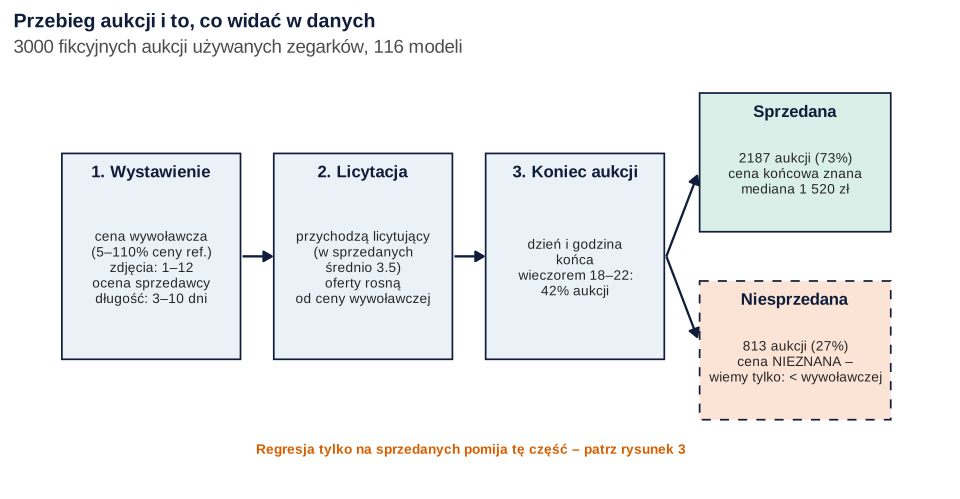
set.seed(699)).Co widać. Sprzedawca decyduje w kroku 1, ale cenę tworzą licytujący w kroku 2. O sprzedaży w dużej mierze decyduje cena wywoławcza: przy cenie wywoławczej do 30% ceny referencyjnej sprzedały się wszystkie aukcje, przy 30–60% – 97.2%, przy 60–90% – 57.4%, a powyżej 90% – tylko 21.5%.
Jak może zmylić. Czynniki z kroku 1 nie są niezależne: zdjęcia, pora końca i niska cena wywoławcza działają w dużej części przez liczbę licytujących (rysunek 4). A niesprzedana aukcja to nie „brak danych” (rysunek 3).
Podpis do pracy:
Rysunek 2: co podnosi cenę – regresja logarytmu ceny
Zaczynamy od analizy, którą zrobiłby każdy: regresja wieloraka logarytmu ceny końcowej na sprzedanych aukcjach. Wśród predyktorów jest logarytm ceny referencyjnej, więc pozostałe współczynniki porównują aukcje tego samego „poziomu cenowego”. Współczynnik b przy logarytmie ceny przeliczamy na procenty:
Przykład: pudełko i dokumenty mają b = 0.0932, więc 100 × (exp(0.0932) − 1) = 9.8%: zegarek z kompletem sprzedaje się średnio o 9.8% drożej niż taki sam bez kompletu. Przedziały liczymy z błędów odpornych na klastrowanie po modelu zegarka (rysunek 5).
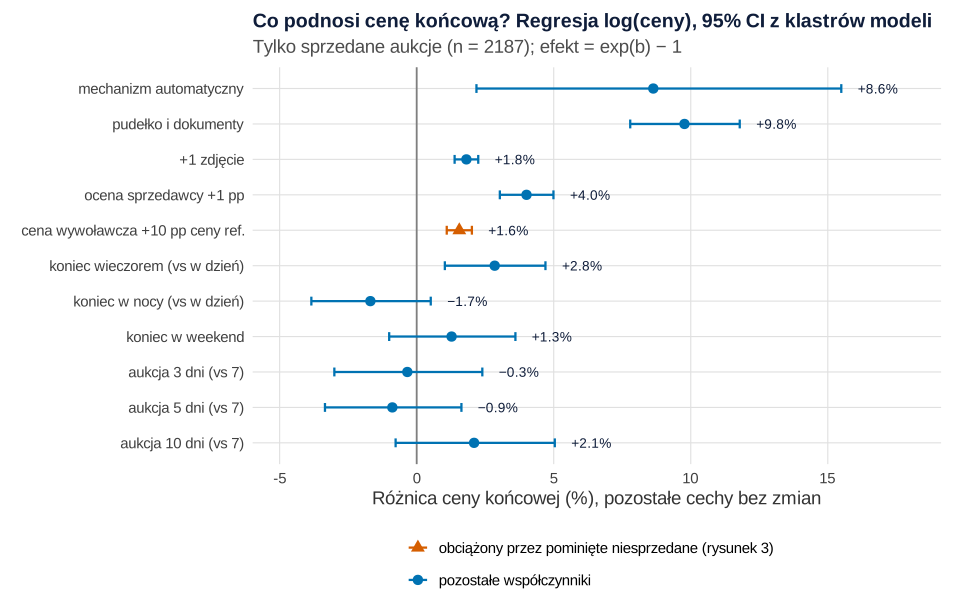
set.seed(699)).Co widać. Największe różnice dają cechy samego zegarka: pudełko i dokumenty +9.8% [7.8, 11.8], mechanizm automatyczny +8.6% [2.2, 15.5]. Sprzedawca z oceną wyższą o 1 pp uzyskuje średnio +4.0% [3.0, 5.0], każde dodatkowe zdjęcie to +1.8% [1.4, 2.2], a koniec aukcji wieczorem (18–22) zamiast w dzień to +2.8% [1.0, 4.7]. Przedziały dla końca w nocy, weekendu i długości aukcji obejmują zero. Elastyczność względem ceny referencyjnej wynosi 0.942, a R² = .885 (n = 2187).
Jak może zmylić. Wykres współczynników ustawia obok siebie cechy w różnych jednostkach: jedno zdjęcie, 1 pp oceny i „tak/nie” dla kompletu. Dłuższy odcinek nie znaczy „ważniejsza cecha”. Trójkąt przy cenie wywoławczej („+1.6% na 10 pp”) jest zniekształcony przez to, czego w tej regresji brakuje. Podobne zmienne badali Lucking-Reiley i in. (2007) na prawdziwych aukcjach monet kolekcjonerskich: oceny sprzedawcy miały mierzalny wpływ na cenę (negatywne silniejszy niż pozytywne), a cena minimalna i dłuższa aukcja wiązały się z wyższą ceną końcową. Ten sam zapis efektów w procentach opisuje wpis o regresji hedonicznej cen mieszkań.
Podpis do pracy:
Rysunek 3: aukcje niesprzedane – cenzurowanie i model dwuczęściowy
Niesprzedana aukcja niesie informację: najwyższa oferta, jaką ktoś był gotów dać, była niższa niż cena wywoławcza. Jeśli takie aukcje wyrzucimy, zostają dane ucięte: tylko wyniki powyżej progu, a próg rośnie razem z ceną wywoławczą. Przy wysokiej cenie wywoławczej z próby znikają słabe wyniki, więc średnia cena sprzedanych rośnie. To klasyczny błąd selekcji. Porównujemy trzy podejścia:
- regresja tylko na sprzedanych (z rysunku 2);
- model z cenzurowaniem – odmiana modelu tobitowego, w której niesprzedana aukcja jest obserwacją ocenzurowaną z progiem równym jej cenie wywoławczej (funkcja
survreg()); - model dwuczęściowy – regresja logistyczna sprzedaży razy regresja ceny sprzedanych. Odpowiada na pytanie: ile średnio przyniesie wystawiona aukcja?
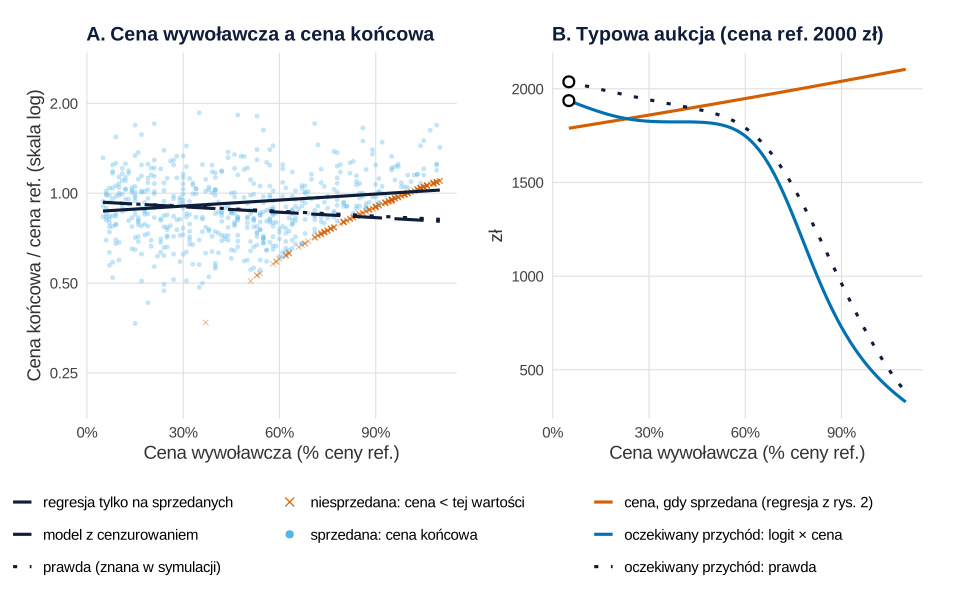
set.seed(699)).Co widać. Dla niesprzedanej aukcji znamy tylko górną granicę ceny (krzyżyki na przekątnej). Regresja na sprzedanych mówi, że każde 10 pp ceny wywoławczej podnosi cenę o 1.6%. Model z cenzurowaniem daje −1.4% [−1.7, −1.0], a prawda z symulacji to −1.2%: wyższa cena wywoławcza odstrasza licytujących i lekko obniża cenę, jaką rynek jest gotów zapłacić. Model z cenzurowaniem poprawia też inne efekty: zdjęcie +2.2% (prawda 2.2%, regresja na sprzedanych 1.8%), komplet +11.7% (prawda 11.2%, na sprzedanych 9.8%).
Panel B pokazuje skutek dla decyzji. Regresja ceny sprzedanych podpowiada „im wyżej, tym lepiej” (1789 zł przy 5%, 2104 zł przy 110%), ale każde 10 pp ceny wywoławczej to iloraz szans sprzedaży 0.348. Model dwuczęściowy daje oczekiwany przychód 1937 zł przy cenie wywoławczej 5%, 1816 zł przy 50%, 728 zł przy 90% i 329 zł przy 110% (prawda: 2037, 1870, 961 i 381 zł). Oba wskazują najniższą cenę wywoławczą.
Jak może zmylić. Model dwuczęściowy potrzebuje giętkiej zależności od ceny wywoławczej: wersja liniowa wskazywała optimum przy 45%, więc użyliśmy splajnu. Cenę z logarytmu przeliczamy z poprawką smearing Duana (1983), tu 1.026, bo sama funkcja exp() zaniża średnią. Przychód 0 zł z niesprzedanej aukcji to uproszczenie – zegarek można wystawić ponownie. Model z cenzurowaniem działa, bo znamy próg każdej aukcji. Gdy próg jest nieznany (np. ukryta cena minimalna), potrzebny jest model selekcji Heckmana (Heckman, 1979) z co najmniej jedną zmienną, która wpływa na sprzedaż, ale nie na cenę. Bajari i Hortaçsu (2003) pokazali, że wejście do aukcji kosztuje licytujących, a droższe przedmioty częściej wystawiano z ukrytą ceną minimalną i niską ceną wywoławczą. Model dwuczęściowy opisuje też wpis o przychodzie na klienta, a cenzurowanie w czasie – wpis o okresie próbnym i freemium.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: zdjęcia, staranny sprzedawca i liczba licytujących
Ile naprawdę daje jedno zdjęcie i koniec aukcji wieczorem? Porównujemy trzy modele na sprzedanych aukcjach: bez oceny sprzedawcy, z oceną i dodatkowo z liczbą licytujących.
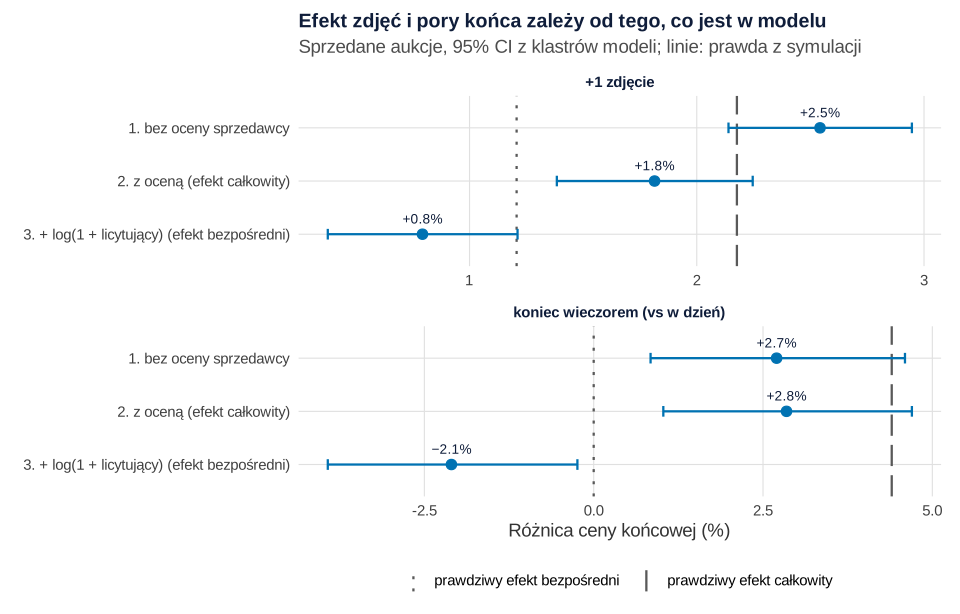
set.seed(699)).Co widać. Bez oceny sprzedawcy zdjęcie „daje” +2.5% [2.1, 3.0]. Po dodaniu oceny efekt spada do +1.8% [1.4, 2.3]. Staranni sprzedawcy dodają więcej zdjęć (korelacja z oceną: .41) i sprzedają drożej, więc pominięta ocena jest zmienną zakłócającą, a zdjęcia przejmują część jej zasługi. Prawdziwy efekt całkowity zdjęcia to 2.2%. Model z oceną trafia nieco poniżej, bo dziedziczy błąd selekcji z rysunku 3 – w modelu z cenzurowaniem było 2.2%.
Trzeci model dodaje liczbę licytujących. Zdjęcie przyciąga ich o 5.9% więcej, koniec wieczorem – o 30.8% więcej, a przejście z 3 do 4 licytujących podnosi cenę o 5.4%. Licytujący są więc mediatorem: leżą na drodze od zdjęć i pory do ceny. Po ich dodaniu zostaje tylko „efekt bezpośredni”: zdjęcie +0.8% (prawda 1.2%), wieczór −2.1% [−3.9, −0.2] (prawda 0).
Jak może zmylić. Kto doda licytujących do modelu „dla lepszego dopasowania”, uzna, że pora końca nie ma znaczenia albo szkodzi, choć cały jej wpływ (+4.4%) idzie przez licytujących. Do decyzji „kiedy kończyć aukcję” potrzebny jest efekt całkowity, czyli model bez mediatora. Efekt bezpośredni z modelu z mediatorem jest wiarygodny tylko przy dodatkowych założeniach, m.in. braku niemierzonych czynników wpływających jednocześnie na licytujących i cenę. Tu ujemny wynik dla wieczoru to artefakt: w próbie samych sprzedanych aukcji model kontroluje zmienną, na którą wpływa pora. Te założenia i analizę wrażliwości opisuje wpis o mediacji przyczynowej.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: wiele aukcji tego samego modelu
Ten sam model zegarka pojawia się w danych wiele razy: mediana to 18.5 aukcji na model, a najpopularniejszy ma 96. Aukcje jednego modelu dzielą niemierzone cechy (np. modę na fason), więc ich reszty są skorelowane, a o cechach modelu mamy tylko 116 niezależnych „porcji informacji”.
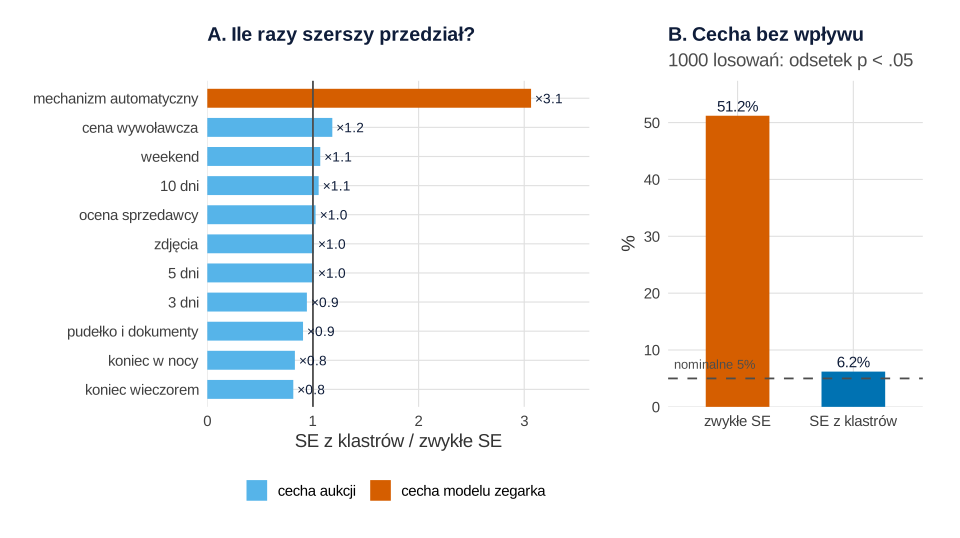
set.seed(699) i set.seed(6995)).Co widać. Dla cech aukcji (zdjęcia, pora, długość) błędy odporne na klastrowanie są podobne do zwykłych (iloraz 0.8–1.2). Dla mechanizmu automatycznego, który jest cechą modelu, błąd standardowy rośnie z 0.0102 do 0.0312, czyli 3.1 raza. W 1000 losowaniach dodaliśmy cechę modelu bez żadnego wpływu na cenę (np. losową „serię limitowaną”). Zwykłe błędy standardowe dały p < .05 w 51.2% powtórzeń (błąd Monte Carlo 1.6 pp), a błędy z klastrów – w 6.2% (0.8 pp).
Jak może zmylić. Dla cech zmieniających się wewnątrz modelu klastrowanie niewiele zmienia, ale cechy całego modelu zegarka bez korekty wyglądają na pewniejsze, niż są. Cameron i Miller (2015) zwracają uwagę, że przy danych w klastrach zwykłe błędy standardowe mogą mocno zawyżać precyzję, a przy małej liczbie klastrów nawet poprawka może nie wystarczyć. W R liczy je funkcja vcovCL() z pakietu sandwich (Zeileis i in., 2020). Alternatywą są efekty stałe lub losowe modelu zegarka.
Podpis do pracy:
Co z tym zrobić w marketingu
- Podpowiadaj zdjęcia i komplet. Każde zdjęcie to ok. +2% ceny i więcej licytujących, komplet – ok. +10%.
- Proponuj koniec aukcji wieczorem. Koniec 18–22 ściąga o ok. 30% więcej licytujących, podnosi szanse sprzedaży (iloraz szans 1.12) i cenę.
- Nie zalecaj wysokiej ceny wywoławczej na podstawie cen sprzedanych. Policz oczekiwany przychód z wystawionej aukcji (rysunek 3B).
- Przed kampanią „dodaj więcej zdjęć” sprawdź, czy nie płacisz za staranność sprzedawcy. Bez oceny sprzedawcy w modelu zdjęcie „dawało” 2.5% zamiast 1.8%. Najpewniej rozstrzygnie to test A/B: losowa połowa sprzedawców dostaje przypomnienie o zdjęciach.
- Raportuj wyniki w procentach z przedziałami z klastrów. Przy cechach modelu zegarka zwykłe przedziały są ponad trzy razy za wąskie.
Jak serwis z ofertami może mierzyć wpływ pozycji oferty na liście, pokazuje wpis o pozycji w wynikach a klikalności. Szacowanie reakcji sprzedaży na cenę opisuje wpis o elastyczności cenowej.
Jak opisać w pracy
Opisz liczbę aukcji i sprzedanych, model, przedziały, sposób potraktowania niesprzedanych aukcji i rolę licytujących. W ograniczeniach napisz, że to dane obserwacyjne: sprzedawcy sami wybierają zdjęcia i cenę wywoławczą. Więcej o analizach w pracach z marketingu: statystyka w pracy z marketingu.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, parametry i dane, przepis 2 – formułę wzor i model m_sprzedane używane dalej. Przepisy 1–5 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują dwa bloki: przepis 1 zaczyna od set.seed(699), a przepis 5 od set.seed(6995); przepisy 2, 3, 4 i 6 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1, lista b): 120 modeli i 3000 aukcji; cenę referencyjną modelu z rozkładu log-normalnego o medianie 1800 zł; liczbę zainteresowanych licytujących jako 1 + Poisson ze stałą 1.30, efektem +0.08 na zdjęcie, −1.4 na cenę wywoławczą równą 100% ceny referencyjnej, +0.35 dla końca wieczorem, −0.35 w nocy, +0.10 w weekend i −0.25, −0.08, 0, +0.08 dla aukcji 3, 5, 7 i 10 dni (na skali logarytmu); logarytm ceny z efektem +0.012 na zdjęcie, +0.04 na 1 pp oceny, +0.25 na log(1 + licytujący), +0.05 na cenę wywoławczą, +0.10 za komplet i +0.10 za mechanizm automatyczny, odchylenia standardowe 0.15 dla modelu i 0.18 dla aukcji; aukcja sprzedaje się, gdy najwyższa gotowość do zapłaty sięga ceny wywoławczej; ręcznie dobrano też rozkłady cech aukcji (staranność sprzedawcy powiązana z oceną, liczbą zdjęć i kompletem, cena wywoławcza 5–110% ceny referencyjnej, udziały długości i godzin końca) – wartości są w kodzie. W przepisie 3 typowa aukcja to zegarek automatyczny za 2000 zł z 5 zdjęciami i oceną 98%, a splajn ma 4 stopnie swobody; w przepisie 5 – 1000 losowań.
Zmiany po pierwszym uruchomieniu (ziarna bez zmian): (1) w pierwszej wersji aukcja bez żadnego chętnego była niesprzedana niezależnie od ceny, przez co niesprzedana aukcja nie zawsze oznaczała ofertę poniżej ceny wywoławczej; ustaliliśmy, że zawsze jest co najmniej jeden zainteresowany, a stałą liczby licytujących zmieniliśmy z 1.55 na 1.30; (2) wpływ licytujących na cenę był za słaby, by pora końca była widoczna w regresji (efekt wieczoru 0.0%), więc wzmocniliśmy go: efekt log(1 + licytujący) z 0.15 na 0.25, wieczór z 0.25 na 0.35, noc z −0.30 na −0.35, długość aukcji z −0.15/−0.05/+0.05 na −0.25/−0.08/+0.08, a stałą ceny z −0.45 na −0.65; (3) w modelu dwuczęściowym cenę wywoławczą opisaliśmy splajnem zamiast liniowo, bo wersja liniowa wskazywała optimum 45% przy prawdziwym 5%; (4) na rysunku 3A pokazujemy co czwartą aukcję, żeby plik był lżejszy. Wszystkie przepisy liczą się w kilka sekund.
1. Dane 3000 aukcji i schemat przebiegu aukcji: Rysunek 1
R
# Rysunek 1. Fikcyjny serwis aukcji używanych zegarków: 3000 aukcji i schemat przebiegu aukcji
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie (prawdziwy mechanizm danych – w prawdziwym serwisie go nie znamy)
n_modeli <- 120; n_aukcji <- 3000
b <- list(
  # liczba licytujących ~ Poisson; log średniej:
  lic_stala = 1.30, lic_zdjecie = 0.08, lic_wywolawcza = -1.4,   # na 1 zdjęcie; na cenę wywoławczą = 100% ceny ref.
  lic_wieczor = 0.35, lic_noc = -0.35, lic_weekend = 0.10,
  lic_dlugosc = c("3" = -0.25, "5" = -0.08, "7" = 0, "10" = 0.08),
  # logarytm ceny, jaką gotów jest zapłacić najwyżej licytujący:
  cena_zdjecie = 0.012, cena_ocena = 0.04, cena_licytujacy = 0.25,  # na 1 zdjęcie; na 1 pp ocen; na log(1 + licyt.)
  cena_wywolawcza = 0.05, cena_komplet = 0.10, cena_automat = 0.10,
  sd_modelu = 0.15, sd_aukcji = 0.18)

set.seed(699)
modele <- data.frame(model_id = sprintf("M%03d", 1:n_modeli),
                     cena_ref = round(pmin(pmax(rlnorm(n_modeli, log(1800), 0.7), 300), 15000), -1),
                     automat = rbinom(n_modeli, 1, 0.5),
                     u_modelu = rnorm(n_modeli, 0, b$sd_modelu),        # cecha modelu, której nie mierzymy
                     popularnosc = rgamma(n_modeli, shape = 1.2))
a <- data.frame(aukcja_id = 1:n_aukcji,
                model_id = sample(modele$model_id, n_aukcji, replace = TRUE, prob = modele$popularnosc))
a <- cbind(a, modele[match(a$model_id, modele$model_id), c("cena_ref", "automat", "u_modelu")])
jakosc <- rnorm(n_aukcji)                                               # staranność sprzedawcy (niemierzona)
a$ocena_sprzedawcy <- round(pmin(pmax(98 + 1.0 * jakosc + rnorm(n_aukcji, 0, 0.8), 90), 100), 1)
a$zdjecia <- pmin(pmax(rpois(n_aukcji, exp(log(4.5) + 0.30 * jakosc)), 1), 12)
a$komplet <- rbinom(n_aukcji, 1, plogis(-0.4 + 0.5 * jakosc))          # pudełko i dokumenty
a$wywolawcza_proc <- round(runif(n_aukcji, 0.05, 1.10), 2)               # cena wywoławcza jako ułamek ceny ref.
a$cena_wywolawcza <- pmax(1, round(a$wywolawcza_proc * a$cena_ref, -1))
a$dlugosc_dni <- sample(c(3, 5, 7, 10), n_aukcji, replace = TRUE, prob = c(0.15, 0.25, 0.40, 0.20))
a$dzien_konca <- factor(sample(c("pn", "wt", "śr", "cz", "pt", "sob", "nd"), n_aukcji, replace = TRUE),
                        levels = c("pn", "wt", "śr", "cz", "pt", "sob", "nd"))
a$godzina_konca <- sample(0:23, n_aukcji, replace = TRUE,
                          prob = c(rep(0.5, 7), rep(1, 11), rep(2.2, 5), 0.8))
a$pora_konca <- factor(ifelse(a$godzina_konca >= 18 & a$godzina_konca <= 22, "wieczór (18–22)",
                              ifelse(a$godzina_konca >= 8 & a$godzina_konca <= 17, "dzień (8–17)", "noc (23–7)")),
                       levels = c("dzień (8–17)", "wieczór (18–22)", "noc (23–7)"))
a$weekend <- as.integer(a$dzien_konca %in% c("sob", "nd"))

# Mechanizm: zdjęcia, pora i długość ściągają licytujących, wysoka cena wywoławcza ich odstrasza
a$lambda <- exp(b$lic_stala + b$lic_zdjecie * (a$zdjecia - 4.5) + b$lic_wywolawcza * a$wywolawcza_proc +
                b$lic_wieczor * (a$pora_konca == "wieczór (18–22)") + b$lic_noc * (a$pora_konca == "noc (23–7)") +
                b$lic_weekend * a$weekend + b$lic_dlugosc[as.character(a$dlugosc_dni)])
a$licytujacy_ukryci <- 1 + rpois(n_aukcji, a$lambda)                 # co najmniej jeden zainteresowany
a$log_cena_ukryta <- log(a$cena_ref) + a$u_modelu + b$cena_automat * a$automat + b$cena_komplet * a$komplet +
  b$cena_zdjecie * a$zdjecia + b$cena_ocena * (a$ocena_sprzedawcy - 98) +
  b$cena_licytujacy * log1p(a$licytujacy_ukryci) + b$cena_wywolawcza * a$wywolawcza_proc - 0.65 +
  rnorm(n_aukcji, 0, b$sd_aukcji)
# Aukcja kończy się sprzedażą, gdy najwyższa gotowość do zapłaty sięga ceny wywoławczej
a$sprzedana <- as.integer(a$log_cena_ukryta >= log(a$cena_wywolawcza))
a$cena_koncowa <- ifelse(a$sprzedana == 1, round(exp(a$log_cena_ukryta), -1), NA)
a$licytujacy <- ifelse(a$sprzedana == 1, a$licytujacy_ukryci, 0)

aukcje <- a[c("aukcja_id", "model_id", "cena_ref", "automat", "komplet", "zdjecia", "ocena_sprzedawcy",
              "cena_wywolawcza", "wywolawcza_proc", "dlugosc_dni", "dzien_konca", "godzina_konca", "pora_konca",
              "weekend", "licytujacy", "sprzedana", "cena_koncowa")]
write.csv(aukcje, "aukcje-zegarkow-3000.csv", row.names = FALSE, fileEncoding = "UTF-8")
sprzedane <- subset(aukcje, sprzedana == 1)

cat("Aukcji:", nrow(aukcje), "| modeli zegarków:", length(unique(aukcje$model_id)),
    "| aukcji na model: mediana", median(table(aukcje$model_id)), "maks.", max(table(aukcje$model_id)), "\n")
cat("Sprzedanych:", nrow(sprzedane), sprintf("(%.1f%%)", 100 * mean(aukcje$sprzedana)),
    "| niesprzedanych:", sum(aukcje$sprzedana == 0), "\n")
cat("Cena końcowa: mediana", median(sprzedane$cena_koncowa), "zł | cena końcowa / cena ref.: mediana",
    round(median(sprzedane$cena_koncowa / sprzedane$cena_ref), 2), "\n")
cat("Licytujących w sprzedanych: średnio", round(mean(sprzedane$licytujacy), 1), "| zdjęć: średnio",
    round(mean(aukcje$zdjecia), 1), "| koniec wieczorem:", sprintf("%.1f%%", 100 * mean(aukcje$pora_konca == "wieczór (18–22)")), "\n")
cat("Odsetek sprzedanych wg ceny wywoławczej (ułamek ceny ref.):\n")
print(round(100 * tapply(aukcje$sprzedana, cut(aukcje$wywolawcza_proc, c(0, 0.3, 0.6, 0.9, 1.1)), mean), 1))
cat("Korelacja zdjęć z oceną sprzedawcy:", round(cor(aukcje$zdjecia, aukcje$ocena_sprzedawcy), 2), "\n")

# Schemat przebiegu aukcji (grafika z prostokątów i strzałek, liczby z danych)
proc <- function(x) sprintf("%.0f%%", 100 * x)
pud <- data.frame(
  x = c(1, 3.55, 6.1, 8.75, 8.75), y = c(2, 2, 2, 3.05, 0.95), szer = c(2.15, 2.15, 2.15, 2.3, 2.3),
  wys = c(2.3, 2.3, 2.3, 1.55, 1.55),
  tytul = c("1. Wystawienie", "2. Licytacja", "3. Koniec aukcji", "Sprzedana", "Niesprzedana"),
  opis = c(paste0("cena wywoławcza\n(5–110% ceny ref.)\nzdjęcia: 1–12\nocena sprzedawcy\ndługość: 3–10 dni"),
           paste0("przychodzą licytujący\n(w sprzedanych\nśrednio ", round(mean(sprzedane$licytujacy), 1), ")\n",
                  "oferty rosną\nod ceny wywoławczej"),
           paste0("dzień i godzina\nkońca\nwieczorem 18–22:\n", proc(mean(aukcje$pora_konca == "wieczór (18–22)")),
                  " aukcji"),
           paste0(nrow(sprzedane), " aukcji (", proc(mean(aukcje$sprzedana)), ")\ncena końcowa znana\nmediana ",
                  format(median(sprzedane$cena_koncowa), big.mark = " "), " zł"),
           paste0(sum(aukcje$sprzedana == 0), " aukcji (", proc(1 - mean(aukcje$sprzedana)),
                  ")\ncena NIEZNANA –\nwiemy tylko: < wywoławczej")),
  rodzaj = c("proces", "proces", "proces", "sprzedana", "niesprzedana"))
strz <- data.frame(x = c(2.1, 4.65, 7.2, 7.2), y = c(2, 2, 2, 2), xend = c(2.45, 5.0, 7.57, 7.57),
                   yend = c(2, 2, 2.9, 1.1))
p1 <- ggplot() +
  geom_rect(data = pud, aes(xmin = x - szer / 2, xmax = x + szer / 2, ymin = y - wys / 2, ymax = y + wys / 2,
                            fill = rodzaj, linetype = rodzaj), colour = "#0f1d3a", linewidth = 0.6) +
  geom_text(data = pud, aes(x = x, y = y + wys / 2 - 0.2, label = tytul), fontface = "bold", size = 4.4,
            colour = "#0f1d3a") +
  geom_text(data = pud, aes(x = x, y = y - 0.12, label = opis), size = 3.6, colour = "grey15", lineheight = 0.95) +
  geom_segment(data = strz, aes(x = x, y = y, xend = xend, yend = yend), linewidth = 0.8, colour = "#0f1d3a",
               arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  annotate("text", x = 4.85, y = -0.15, size = 3.6, colour = kol[["pomaranczowy"]], fontface = "bold",
           label = "Regresja tylko na sprzedanych pomija tę część – patrz rysunek 3") +
  scale_fill_manual(values = c(proces = "#eaf2f8", sprzedana = "#d9efe7", niesprzedana = "#fbe3d6"), guide = "none") +
  scale_linetype_manual(values = c(proces = "solid", sprzedana = "solid", niesprzedana = "dashed"), guide = "none") +
  coord_cartesian(xlim = c(-0.15, 10), ylim = c(-0.35, 3.9)) +
  labs(title = "Przebieg aukcji i to, co widać w danych",
       subtitle = paste0(nrow(aukcje), " fikcyjnych aukcji używanych zegarków, ", length(unique(aukcje$model_id)), " modeli")) +
  theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 10, 10, 10))
p1                       # do pliku: ggsave("aukcje-schemat-przebiegu.svg", p1, width = 10, height = 5.2)
Wynik w R
Aukcji: 3000 | modeli zegarków: 116 | aukcji na model: mediana 18.5 maks. 96
Sprzedanych: 2187 (72.9%) | niesprzedanych: 813
Cena końcowa: mediana 1520 zł | cena końcowa / cena ref.: mediana 0.91
Licytujących w sprzedanych: średnio 3.5 | zdjęć: średnio 4.7 | koniec wieczorem: 42.2%
Odsetek sprzedanych wg ceny wywoławczej (ułamek ceny ref.):
  (0,0.3] (0.3,0.6] (0.6,0.9] (0.9,1.1]
    100.0      97.2      57.4      21.5
Korelacja zdjęć z oceną sprzedawcy: 0.41
2. Regresja logarytmu ceny i wykres współczynników: Rysunek 2
R
# Rysunek 2. Regresja logarytmu ceny końcowej (tylko sprzedane) i wykres współczynników w %
# (korzysta z kol, motyw i obiektu sprzedane z przepisu 1)
library(ggplot2)
library(sandwich)   # błędy standardowe odporne na klastrowanie
library(lmtest)

sprzedane$dlugosc <- relevel(factor(sprzedane$dlugosc_dni), ref = "7")
sprzedane$wywolawcza_10 <- 10 * sprzedane$wywolawcza_proc          # o 10 pp ceny referencyjnej
wzor <- log(cena_koncowa) ~ log(cena_ref) + automat + komplet + zdjecia + ocena_sprzedawcy + wywolawcza_10 +
  pora_konca + weekend + dlugosc
m_sprzedane <- lm(wzor, data = sprzedane)
V_klastry <- vcovCL(m_sprzedane, cluster = ~ model_id, type = "HC1")  # wiele aukcji tego samego modelu
wsp <- coeftest(m_sprzedane, vcov. = V_klastry)
ci <- coefci(m_sprzedane, vcov. = V_klastry)
tab <- data.frame(zmienna = rownames(wsp), b = wsp[, 1], se = wsp[, 2], p = wsp[, 4],
                  proc = 100 * (exp(wsp[, 1]) - 1), dolna = 100 * (exp(ci[, 1]) - 1), gorna = 100 * (exp(ci[, 2]) - 1))
tab <- tab[!tab$zmienna %in% c("(Intercept)", "log(cena_ref)"), ]
print(data.frame(zmienna = tab$zmienna, round(tab[c("b", "se")], 4), p = signif(tab$p, 2),
                 round(tab[c("proc", "dolna", "gorna")], 1)), row.names = FALSE)
cat("Elastyczność względem ceny referencyjnej:", round(coef(m_sprzedane)[["log(cena_ref)"]], 3),
    "| R2 =", round(summary(m_sprzedane)$r.squared, 3), "| n =", nobs(m_sprzedane), "\n")

etykiety <- c(automat = "mechanizm automatyczny", komplet = "pudełko i dokumenty", zdjecia = "+1 zdjęcie",
              ocena_sprzedawcy = "ocena sprzedawcy +1 pp", wywolawcza_10 = "cena wywoławcza +10 pp ceny ref.",
              `pora_koncawieczór (18–22)` = "koniec wieczorem (vs w dzień)",
              `pora_koncanoc (23–7)` = "koniec w nocy (vs w dzień)", weekend = "koniec w weekend",
              dlugosc3 = "aukcja 3 dni (vs 7)", dlugosc5 = "aukcja 5 dni (vs 7)", dlugosc10 = "aukcja 10 dni (vs 7)")
tab$etykieta <- factor(etykiety[tab$zmienna], levels = rev(etykiety))
tab$grupa <- ifelse(tab$zmienna == "wywolawcza_10", "obciążony przez pominięte niesprzedane (rysunek 3)",
                    "pozostałe współczynniki")
p2 <- ggplot(tab, aes(x = proc, y = etykieta, colour = grupa, shape = grupa)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y", linewidth = 0.8) +
  geom_point(size = 3.2) +
  geom_text(aes(x = gorna + 0.6, label = sub("-", "−", sprintf("%+.1f%%", proc))), hjust = 0, size = 3.6, colour = "#0f1d3a",
            show.legend = FALSE) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  coord_cartesian(xlim = c(min(tab$dolna) - 1, max(tab$gorna) + 2.5)) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(title = "Co podnosi cenę końcową? Regresja log(ceny), 95% CI z klastrów modeli",
       subtitle = paste0("Tylko sprzedane aukcje (n = ", nobs(m_sprzedane), "); efekt = exp(b) − 1"),
       x = "Różnica ceny końcowej (%), pozostałe cechy bez zmian", y = NULL) +
  motyw
p2                       # do pliku: ggsave("aukcje-wykres-wspolczynnikow.svg", p2, width = 10, height = 6.4)
Wynik w R
                   zmienna       b     se       p proc dolna gorna
                   automat  0.0828 0.0312 8.1e-03  8.6   2.2  15.5
                   komplet  0.0932 0.0093 3.0e-23  9.8   7.8  11.8
                   zdjecia  0.0180 0.0022 1.4e-16  1.8   1.4   2.2
          ocena_sprzedawcy  0.0393 0.0048 4.2e-16  4.0   3.0   5.0
             wywolawcza_10  0.0154 0.0023 2.6e-11  1.6   1.1   2.0
 pora_koncawieczór (18–22)  0.0281 0.0091 2.1e-03  2.8   1.0   4.7
      pora_koncanoc (23–7) -0.0170 0.0113 1.3e-01 -1.7  -3.8   0.5
                   weekend  0.0127 0.0116 2.8e-01  1.3  -1.0   3.6
                  dlugosc3 -0.0034 0.0138 8.0e-01 -0.3  -3.0   2.4
                  dlugosc5 -0.0089 0.0128 4.9e-01 -0.9  -3.3   1.6
                 dlugosc10  0.0207 0.0145 1.5e-01  2.1  -0.8   5.0
Elastyczność względem ceny referencyjnej: 0.942 | R2 = 0.885 | n = 2187
3. Niesprzedane aukcje: model z cenzurowaniem i model dwuczęściowy: Rysunek 3
R
# Rysunek 3. Niesprzedane aukcje: regresja tylko na sprzedanych, model z cenzurowaniem i model dwuczęściowy
# (korzysta z kol, motyw, b, a i aukcje z przepisu 1 oraz wzor i m_sprzedane z przepisu 2)
library(ggplot2)
library(patchwork)
library(survival)   # survreg: regresja z obserwacjami ocenzurowanymi

aukcje$dlugosc <- relevel(factor(aukcje$dlugosc_dni), ref = "7")
aukcje$wywolawcza_10 <- 10 * aukcje$wywolawcza_proc
# Niesprzedana aukcja: wiemy tylko, że najwyższa gotowość do zapłaty < cena wywoławcza (cenzurowanie lewostronne)
aukcje$log_y <- ifelse(aukcje$sprzedana == 1, log(aukcje$cena_koncowa), log(aukcje$cena_wywolawcza))
prawe <- update(wzor, NULL ~ .)                                         # te same predyktory co w przepisie 2
m_cenz <- survreg(update(prawe, Surv(log_y, sprzedana, type = "left") ~ .), data = aukcje, dist = "gaussian")
aukcje$log_cena_ukryta <- a$log_cena_ukryta                            # znana tylko w symulacji
m_prawda <- lm(update(prawe, log_cena_ukryta ~ .), data = aukcje)
m_logit <- glm(update(prawe, sprzedana ~ .), data = aukcje, family = binomial)
# Model dwuczęściowy do prognozy przychodu: cena wywoławcza jako splajn (4 st. swobody) w obu częściach
gietka <- update(prawe, . ~ . - wywolawcza_10 + splines::ns(wywolawcza_proc, df = 4))
cz1_logit <- glm(update(gietka, sprzedana ~ .), data = aukcje, family = binomial)
cz2_cena <- lm(update(gietka, log(cena_koncowa) ~ .), data = subset(aukcje, sprzedana == 1))

porownanie <- sapply(list(tylko_sprzedane = coef(m_sprzedane), z_cenzurowaniem = coef(m_cenz),
                          prawda_symulacja = coef(m_prawda)),
                     function(w) 100 * (exp(w[c("wywolawcza_10", "zdjecia", "ocena_sprzedawcy", "komplet",
                                                "pora_koncawieczór (18–22)")]) - 1))
cat("Efekty w % (exp(b) − 1) w trzech modelach:\n"); print(round(porownanie, 2))
se_cenz <- sqrt(diag(vcov(m_cenz)))[["wywolawcza_10"]]
cat("Cena wywoławcza +10 pp w modelu z cenzurowaniem: b =", round(coef(m_cenz)[["wywolawcza_10"]], 4),
    "95% CI [", round(coef(m_cenz)[["wywolawcza_10"]] + c(-1, 1) * 1.96 * se_cenz, 4), "]\n")
cat("Logit sprzedaży, iloraz szans: cena wywoławcza +10 pp =", round(exp(coef(m_logit)[["wywolawcza_10"]]), 3),
    "| +1 zdjęcie =", round(exp(coef(m_logit)[["zdjecia"]]), 3),
    "| koniec wieczorem =", round(exp(coef(m_logit)[["pora_koncawieczór (18–22)"]]), 3), "\n")

# Typowa aukcja: zegarek automatyczny za 2000 zł (cena ref.), 5 zdjęć, ocena 98, 7 dni, koniec wieczorem w tygodniu
siatka <- data.frame(cena_ref = 2000, automat = 1, komplet = 0, zdjecia = 5, ocena_sprzedawcy = 98,
                     wywolawcza_proc = seq(0.05, 1.10, by = 0.01), weekend = 0,
                     pora_konca = factor("wieczór (18–22)", levels = levels(aukcje$pora_konca)),
                     dlugosc = factor("7", levels = levels(aukcje$dlugosc)))
siatka$wywolawcza_10 <- 10 * siatka$wywolawcza_proc
smearing <- mean(exp(residuals(cz2_cena)))                               # retransformacja Duana
siatka$cena_liniowo <- exp(predict(m_sprzedane, siatka)) * mean(exp(residuals(m_sprzedane)))
siatka$cena_gdy_sprzedana <- exp(predict(cz2_cena, siatka)) * smearing
siatka$p_sprzedazy <- predict(cz1_logit, siatka, type = "response")
siatka$przychod_dwuczesciowy <- siatka$p_sprzedazy * siatka$cena_gdy_sprzedana
# Prawda z mechanizmu danych: średnia po liczbie licytujących (1 + Poisson) i normalnym szumie ceny
prawdziwy_przychod <- function(s) {
  lam <- exp(b$lic_stala + b$lic_zdjecie * (5 - 4.5) + b$lic_wywolawcza * s + b$lic_wieczor + b$lic_dlugosc[["7"]])
  k <- 0:60; w <- dpois(k, lam); sig <- sqrt(b$sd_modelu^2 + b$sd_aukcji^2)
  mu <- log(2000) + b$cena_automat + b$cena_zdjecie * 5 + b$cena_licytujacy * log1p(1 + k) + b$cena_wywolawcza * s - 0.65
  c(p = sum(w * pnorm((mu - log(2000 * s)) / sig)),
    przychod = sum(w * exp(mu + sig^2 / 2) * pnorm((mu + sig^2 - log(2000 * s)) / sig)))
}
pr <- t(sapply(siatka$wywolawcza_proc, prawdziwy_przychod))
siatka$p_prawda <- pr[, "p"]; siatka$przychod_prawda <- pr[, "przychod"]
pokaz <- siatka$wywolawcza_proc %in% c(0.05, 0.3, 0.5, 0.7, 0.9, 1.1)
print(data.frame(wywolawcza = paste0(100 * siatka$wywolawcza_proc[pokaz], "%"),
                 cena_liniowo = round(siatka$cena_liniowo[pokaz]), cena_gdy_sprzedana = round(siatka$cena_gdy_sprzedana[pokaz]),
                 p_sprzedazy = round(siatka$p_sprzedazy[pokaz], 3), p_prawda = round(siatka$p_prawda[pokaz], 3),
                 przychod_2cz = round(siatka$przychod_dwuczesciowy[pokaz]),
                 przychod_prawda = round(siatka$przychod_prawda[pokaz])), row.names = FALSE)
naj <- function(y) siatka$wywolawcza_proc[which.max(y)]
cat("Cena wywoławcza maksymalizująca oczekiwany przychód: model dwuczęściowy", 100 * naj(siatka$przychod_dwuczesciowy),
    "% | prawda", 100 * naj(siatka$przychod_prawda), "% | sama regresja ceny sprzedanych:",
    100 * naj(siatka$cena_liniowo), "% (zawsze „im wyżej, tym lepiej”)\n")
cat("Czynnik smearing Duana:", round(smearing, 4), "\n")

# Panel A: ceny względem ceny ref. i niesprzedane jako górne granice; linie dla typowej aukcji z trzech modeli
linie <- rbind(
  data.frame(s = siatka$wywolawcza_proc, y = exp(predict(m_sprzedane, siatka)) / 2000, model = "regresja tylko na sprzedanych"),
  data.frame(s = siatka$wywolawcza_proc, y = exp(predict(m_cenz, siatka)) / 2000, model = "model z cenzurowaniem"),
  data.frame(s = siatka$wywolawcza_proc, y = exp(predict(m_prawda, siatka)) / 2000, model = "prawda (znana w symulacji)"))
linie$model <- factor(linie$model, levels = unique(linie$model))
pkt <- data.frame(s = aukcje$wywolawcza_proc, iloraz = exp(aukcje$log_y) / aukcje$cena_ref,
                  status = ifelse(aukcje$sprzedana == 1, "sprzedana: cena końcowa", "niesprzedana: cena < tej wartości"))
pkt <- pkt[aukcje$aukcja_id %% 4 == 0, ]                                # co czwarta aukcja – lżejszy rysunek
p3a <- ggplot() +
  geom_point(data = pkt, aes(s, iloraz, colour = status, shape = status), alpha = 0.35, size = 1.3) +
  geom_line(data = linie, aes(s, y, linetype = model), linewidth = 1.1, colour = "#0f1d3a") +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["blekit"]]), name = NULL) +
  scale_shape_manual(values = c(4, 16), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash", "dotted"), name = NULL) +
  scale_y_log10(breaks = c(0.25, 0.5, 1, 2)) + scale_x_continuous(labels = function(x) paste0(100 * x, "%")) +
  coord_cartesian(ylim = c(0.2, 2.6)) +
  guides(colour = guide_legend(ncol = 1, override.aes = list(alpha = 1, size = 2.5)), linetype = guide_legend(ncol = 1)) +
  labs(title = "A. Cena wywoławcza a cena końcowa", x = "Cena wywoławcza (% ceny ref.)",
       y = "Cena końcowa / cena ref. (skala log)") +
  motyw
krzywe <- rbind(
  data.frame(s = siatka$wywolawcza_proc, zl = siatka$cena_liniowo, co = "cena, gdy sprzedana (regresja z rys. 2)"),
  data.frame(s = siatka$wywolawcza_proc, zl = siatka$przychod_dwuczesciowy, co = "oczekiwany przychód: logit × cena"),
  data.frame(s = siatka$wywolawcza_proc, zl = siatka$przychod_prawda, co = "oczekiwany przychód: prawda"))
krzywe$co <- factor(krzywe$co, levels = unique(krzywe$co))
maks <- data.frame(s = c(naj(siatka$przychod_dwuczesciowy), naj(siatka$przychod_prawda)),
                   zl = c(max(siatka$przychod_dwuczesciowy), max(siatka$przychod_prawda)))
p3b <- ggplot(krzywe, aes(s, zl, colour = co, linetype = co)) +
  geom_line(linewidth = 1.1) +
  geom_point(data = maks, aes(s, zl), inherit.aes = FALSE, size = 3, shape = 21, fill = "white", stroke = 1.2) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]], "#0f1d3a"), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "dotted"), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%")) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(title = "B. Typowa aukcja (cena ref. 2000 zł)", x = "Cena wywoławcza (% ceny ref.)", y = "zł") +
  motyw
p3 <- p3a + p3b
p3                       # do pliku: ggsave("aukcje-niesprzedane-cenzurowanie.svg", p3, width = 10, height = 6.4)
Wynik w R
Efekty w % (exp(b) − 1) w trzech modelach:
                          tylko_sprzedane z_cenzurowaniem prawda_symulacja
wywolawcza_10                        1.56           -1.39            -1.23
zdjecia                              1.81            2.22             2.15
ocena_sprzedawcy                     4.01            4.50             4.68
komplet                              9.77           11.67            11.18
pora_koncawieczór (18–22)            2.85            2.71             2.18
Cena wywoławcza +10 pp w modelu z cenzurowaniem: b = -0.014 95% CI [ -0.0174 -0.0105 ]
Logit sprzedaży, iloraz szans: cena wywoławcza +10 pp = 0.348 | +1 zdjęcie = 1.189 | koniec wieczorem = 1.118
 wywolawcza cena_liniowo cena_gdy_sprzedana p_sprzedazy p_prawda przychod_2cz
         5%         1789               1937       1.000    1.000         1937
        30%         1860               1827       1.000    1.000         1827
        50%         1918               1841       0.986    0.991         1816
        90%         2040               2169       0.335    0.438          728
       110%         2104               2508       0.131    0.151          329
 przychod_prawda
            2037
            1941
            1870
             961
             381
Cena wywoławcza maksymalizująca oczekiwany przychód: model dwuczęściowy 5 % | prawda 5 % | sama regresja ceny sprzedanych: 110 % (zawsze „im wyżej, tym lepiej”)
Czynnik smearing Duana: 1.0261
4. Zdjęcia, ocena sprzedawcy i licytujący: Rysunek 4
R
# Rysunek 4. Zdjęcia i pora końca: zakłócenie przez ocenę sprzedawcy i liczba licytujących jako mediator
# (korzysta z kol, motyw, b, a, sprzedane z przepisu 1 i wzor z przepisu 2)
library(ggplot2)
library(sandwich)
library(lmtest)

modele_zdj <- list(
  "1. bez oceny sprzedawcy" = update(wzor, . ~ . - ocena_sprzedawcy),
  "2. z oceną (efekt całkowity)" = wzor,
  "3. + log(1 + licytujący) (efekt bezpośredni)" = update(wzor, . ~ . + log1p(licytujacy)))
wyniki <- do.call(rbind, lapply(names(modele_zdj), function(nazwa) {
  m <- lm(modele_zdj[[nazwa]], data = sprzedane)
  V <- vcovCL(m, cluster = ~ model_id, type = "HC1")
  zm <- c("zdjecia", "pora_koncawieczór (18–22)")
  ci <- coefci(m, parm = zm, vcov. = V)
  data.frame(model = nazwa, zmienna = c("+1 zdjęcie", "koniec wieczorem (vs w dzień)"),
             proc = 100 * (exp(coef(m)[zm]) - 1), dolna = 100 * (exp(ci[, 1]) - 1), gorna = 100 * (exp(ci[, 2]) - 1))
}))
rownames(wyniki) <- NULL
print(cbind(wyniki[1:2], round(wyniki[3:5], 2)))
m3 <- lm(modele_zdj[[3]], data = sprzedane)
cat("Licytujący: +1 do log(1 + licytujący) =", round(100 * (exp(coef(m3)[["log1p(licytujacy)"]]) - 1), 1),
    "% ceny | z 3 do 4 licytujących:", round(100 * ((5 / 4)^coef(m3)[["log1p(licytujacy)"]] - 1), 1), "%\n")
m_lic <- glm(update(wzor, licytujacy ~ .), data = sprzedane, family = poisson)
cat("Licytujący (Poisson): +1 zdjęcie =", round(100 * (exp(coef(m_lic)[["zdjecia"]]) - 1), 1),
    "% | koniec wieczorem =", round(100 * (exp(coef(m_lic)[["pora_koncawieczór (18–22)"]]) - 1), 1), "%\n")

# Prawda z mechanizmu danych (średnia po aukcjach): efekt bezpośredni + droga przez licytujących
E_log_lic <- function(lam) sapply(lam, function(l) sum(dpois(0:80, l) * log1p(1 + 0:80)))
lam0 <- a$lambda
lam_wiecz <- lam0 / exp(b$lic_wieczor * (a$pora_konca == "wieczór (18–22)") + b$lic_noc * (a$pora_konca == "noc (23–7)"))
prawda <- data.frame(
  zmienna = c("+1 zdjęcie", "koniec wieczorem (vs w dzień)"),
  bezposredni = 100 * (exp(c(b$cena_zdjecie, 0)) - 1),
  calkowity = 100 * (exp(c(b$cena_zdjecie + b$cena_licytujacy * mean(E_log_lic(lam0 * exp(b$lic_zdjecie)) - E_log_lic(lam0)),
                           b$cena_licytujacy * mean(E_log_lic(lam_wiecz * exp(b$lic_wieczor)) - E_log_lic(lam_wiecz)))) - 1))
cat("Prawdziwe efekty (%), znane tylko w symulacji:\n"); print(cbind(prawda[1], round(prawda[2:3], 2)))

wyniki$model <- factor(wyniki$model, levels = rev(names(modele_zdj)))
linie <- rbind(data.frame(zmienna = prawda$zmienna, x = prawda$calkowity, rodzaj = "prawdziwy efekt całkowity"),
               data.frame(zmienna = prawda$zmienna, x = prawda$bezposredni, rodzaj = "prawdziwy efekt bezpośredni"))
p4 <- ggplot(wyniki, aes(x = proc, y = model)) +
  geom_vline(data = linie, aes(xintercept = x, linetype = rodzaj), colour = "grey35", linewidth = 0.8) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", colour = kol[["niebieski"]],
                linewidth = 0.8) +
  geom_point(size = 3.2, colour = kol[["niebieski"]]) +
  geom_text(aes(label = sub("-", "−", sprintf("%+.1f%%", proc))), vjust = -1.1, size = 3.6, colour = "#0f1d3a") +
  facet_wrap(~ zmienna, ncol = 1, scales = "free_x") +
  scale_linetype_manual(values = c("dotted", "longdash"), name = NULL) +
  labs(title = "Efekt zdjęć i pory końca zależy od tego, co jest w modelu",
       subtitle = "Sprzedane aukcje, 95% CI z klastrów modeli; linie: prawda z symulacji",
       x = "Różnica ceny końcowej (%)", y = NULL) +
  motyw
p4                       # do pliku: ggsave("aukcje-zdjecia-zaklocenie-mediator.svg", p4, width = 10, height = 6.4)
Wynik w R
                                         model                       zmienna
1                      1. bez oceny sprzedawcy                    +1 zdjęcie
2                      1. bez oceny sprzedawcy koniec wieczorem (vs w dzień)
3                 2. z oceną (efekt całkowity)                    +1 zdjęcie
4                 2. z oceną (efekt całkowity) koniec wieczorem (vs w dzień)
5 3. + log(1 + licytujący) (efekt bezpośredni)                    +1 zdjęcie
6 3. + log(1 + licytujący) (efekt bezpośredni) koniec wieczorem (vs w dzień)
   proc dolna gorna
1  2.54  2.14  2.95
2  2.70  0.84  4.60
3  1.81  1.38  2.25
4  2.85  1.03  4.70
5  0.79  0.38  1.21
6 -2.10 -3.93 -0.24
Licytujący: +1 do log(1 + licytujący) = 26.7 % ceny | z 3 do 4 licytujących: 5.4 %
Licytujący (Poisson): +1 zdjęcie = 5.9 % | koniec wieczorem = 30.8 %
Prawdziwe efekty (%), znane tylko w symulacji:
                        zmienna bezposredni calkowity
1                    +1 zdjęcie        1.21      2.18
2 koniec wieczorem (vs w dzień)        0.00      4.40
5. Błędy odporne na klastrowanie i 1000 losowań cechy bez wpływu: Rysunek 5
R
# Rysunek 5. Wiele aukcji tego samego modelu: zwykłe błędy standardowe a odporne na klastrowanie
# (korzysta z kol, motyw, sprzedane z przepisu 1 oraz wzor i m_sprzedane z przepisu 2)
library(ggplot2)
library(patchwork)
library(sandwich)
library(lmtest)

se_zwykle <- sqrt(diag(vcov(m_sprzedane)))
se_klastry <- sqrt(diag(vcovCL(m_sprzedane, cluster = ~ model_id, type = "HC1")))
porown <- data.frame(zmienna = names(se_zwykle), se_zwykle = se_zwykle, se_klastry = se_klastry,
                     iloraz = se_klastry / se_zwykle)
porown <- porown[!porown$zmienna %in% c("(Intercept)", "log(cena_ref)"), ]
print(cbind(porown[1], round(porown[2:4], 4)), row.names = FALSE)
cat("Modeli z co najmniej jedną sprzedaną aukcją:", length(unique(sprzedane$model_id)), "\n")

# 1000 badań: cecha modelu bez żadnego wpływu na cenę (np. losowa „seria limitowana”) – jak często p < .05?
set.seed(6995)
modele_lista <- unique(sprzedane$model_id)
p_wart <- t(replicate(1000, {
  placebo_modelu <- setNames(rbinom(length(modele_lista), 1, 0.5), modele_lista)
  d <- sprzedane; d$placebo <- placebo_modelu[d$model_id]
  m <- lm(update(wzor, . ~ . + placebo), data = d)
  c(zwykle = coeftest(m)["placebo", 4],
    klastry = coeftest(m, vcov. = vcovCL(m, cluster = d$model_id, type = "HC1"))["placebo", 4])
}))
odsetek <- colMeans(p_wart < 0.05)
cat("Odsetek fałszywych alarmów (p < .05) dla cechy bez wpływu: zwykłe SE", sprintf("%.1f%%", 100 * odsetek[1]),
    "| SE z klastrów", sprintf("%.1f%%", 100 * odsetek[2]), "| błąd MC ok.",
    sprintf("%.1f pp", 100 * sqrt(odsetek * (1 - odsetek) / 1000)), "\n")

etyk <- c(automat = "mechanizm automatyczny", komplet = "pudełko i dokumenty", zdjecia = "zdjęcia",
          ocena_sprzedawcy = "ocena sprzedawcy", wywolawcza_10 = "cena wywoławcza",
          `pora_koncawieczór (18–22)` = "koniec wieczorem", `pora_koncanoc (23–7)` = "koniec w nocy",
          weekend = "weekend", dlugosc3 = "3 dni", dlugosc5 = "5 dni", dlugosc10 = "10 dni")
porown$etykieta <- factor(etyk[porown$zmienna], levels = etyk[porown$zmienna[order(porown$iloraz)]])
porown$poziom <- ifelse(porown$zmienna == "automat", "cecha modelu zegarka", "cecha aukcji")
p5a <- ggplot(porown, aes(x = iloraz, y = etykieta, fill = poziom)) +
  geom_col(width = 0.65) +
  geom_vline(xintercept = 1, colour = "grey30") +
  geom_text(aes(label = sprintf("×%.1f", iloraz)), hjust = -0.15, size = 3.6, colour = "#0f1d3a") +
  scale_fill_manual(values = c(kol[["blekit"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_x_continuous(expand = expansion(mult = c(0, 0.18))) +
  labs(title = "A. Ile razy szerszy przedział?", x = "SE z klastrów / zwykłe SE", y = NULL) +
  motyw
p5b <- ggplot(data.frame(se = c("zwykłe SE", "SE z klastrów"), proc = 100 * odsetek),
              aes(x = factor(se, levels = c("zwykłe SE", "SE z klastrów")), y = proc)) +
  geom_col(width = 0.55, fill = c(kol[["pomaranczowy"]], kol[["niebieski"]])) +
  geom_hline(yintercept = 5, linetype = "dashed", colour = "grey30") +
  geom_text(aes(label = sprintf("%.1f%%", proc)), vjust = -0.4, size = 4, colour = "#0f1d3a") +
  annotate("text", x = 0.45, y = 7.5, label = "nominalne 5%", hjust = 0, size = 3.4, colour = "grey30") +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(title = "B. Cecha bez wpływu", subtitle = "1000 losowań: odsetek p < .05", x = NULL, y = "%") +
  motyw
p5 <- p5a + p5b + plot_layout(widths = c(1.5, 1))
p5                       # do pliku: ggsave("aukcje-bledy-klastrowane.svg", p5, width = 10, height = 5.6)
Wynik w R
                   zmienna se_zwykle se_klastry iloraz
                   automat    0.0102     0.0312 3.0647
                   komplet    0.0102     0.0093 0.9061
                   zdjecia    0.0021     0.0022 1.0098
          ocena_sprzedawcy    0.0047     0.0048 1.0250
             wywolawcza_10    0.0019     0.0023 1.1834
 pora_koncawieczór (18–22)    0.0112     0.0091 0.8139
      pora_koncanoc (23–7)    0.0136     0.0113 0.8291
                   weekend    0.0108     0.0116 1.0692
                  dlugosc3    0.0146     0.0138 0.9427
                  dlugosc5    0.0127     0.0128 1.0096
                 dlugosc10    0.0138     0.0145 1.0540
Modeli z co najmniej jedną sprzedaną aukcją: 116
Odsetek fałszywych alarmów (p < .05) dla cechy bez wpływu: zwykłe SE 51.2% | SE z klastrów 6.2% | błąd MC ok. 1.6 pp 0.8 pp
6. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – pomarańczowy" = c("#56B4E9", "#D55E00"),
             "niebieski – błękit" = c("#0072B2", "#56B4E9"), "granat – pomarańczowy" = c("#0f1d3a", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
błękit – pomarańczowy                      113.6        101.1       89.0
niebieski – błękit                          26.4         24.7       24.6
granat – pomarańczowy                      101.6         96.6       81.5
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, regresję liniową i logistyczną oraz splajny wykonano pakietami stats i splines (z podstawowej instalacji R), model z cenzurowaniem – pakietem survival, błędy odporne na klastrowanie – pakietami sandwich i lmtest. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Pominięte niesprzedane aukcje – efekt ceny wywoławczej zmienia znak (rysunek 3).
- Staranny sprzedawca jako zmienna zakłócająca – efekt zdjęć zawyżony bez oceny sprzedawcy (rysunek 4).
- Mediator jako zwykły predyktor – liczba licytujących „zjada” efekt pory i zdjęć (rysunek 4).
- Zwykłe błędy przy wielu aukcjach tego samego modelu – połowa fałszywych alarmów dla cech modelu (rysunek 5).
- exp() bez poprawki – prognoza ceny w złotych zaniżona; użyj smearing.
- Ekstrapolacja – dane obejmują ceny wywoławcze 5–110% ceny referencyjnej; poza tym zakresem model nic nie wie.
Najczęstsze pytania
Jak interpretować współczynnik w regresji logarytmu ceny aukcji?
Przelicz go wzorem 100 × (exp(b) − 1): to procentowa różnica ceny przy pozostałych cechach bez zmian. W przykładzie pudełko i dokumenty miały b = 0.0932, czyli +9.8% [7.8, 11.8]. Przy małych b wynik jest bliski 100 × b. Prognozę w złotych licz z poprawką smearing, bo sama funkcja exp() zaniża średnią.
Co zrobić z aukcjami, które się nie sprzedały?
Nie wyrzucaj ich. Niesprzedana aukcja mówi, że najwyższa oferta była niższa niż cena wywoławcza, więc to obserwacja ocenzurowana z progiem równym cenie wywoławczej. Można ją uwzględnić w modelu z cenzurowaniem (np. survreg w R). Gdy pytasz o przychód z wystawionej aukcji, użyj modelu dwuczęściowego: regresja logistyczna sprzedaży razy regresja ceny sprzedanych.
Czy wysoka cena wywoławcza podnosi cenę końcową aukcji?
Wśród sprzedanych aukcji zwykle tak to wygląda, ale to skutek selekcji: przy wysokiej cenie wywoławczej słabe wyniki nie kończą się sprzedażą i znikają z danych. W przykładzie regresja na sprzedanych dała +1.6% na 10 pp, model z cenzurowaniem −1.4%, a prawda −1.2%. Oczekiwany przychód był najwyższy przy najniższej cenie wywoławczej.
Czy liczbę licytujących dodać do regresji ceny aukcji?
Nie w modelu głównym. Liczba licytujących jest skutkiem zdjęć, pory końca i ceny wywoławczej, a sama podbija cenę – jest mediatorem. Po jej dodaniu efekt końca aukcji wieczorem spadł z +2.8% do −2.1%, choć cały jego prawdziwy wpływ (+4.4%) szedł przez licytujących. Model z licytującymi traktuj jako analizę uzupełniającą.
Dlaczego przy wielu aukcjach tego samego produktu liczyć błędy klastrowane?
Aukcje jednego modelu dzielą niemierzone cechy, więc nie są niezależne. W przykładzie (116 modeli, mediana 18.5 aukcji na model) błąd standardowy cechy modelu zegarka wzrósł po korekcie 3.1 raza, a losowa cecha modelu bez wpływu na cenę była istotna w 51.2% powtórzeń przy zwykłych błędach i w 6.2% przy błędach z klastrów.
Powiązane hasła
Przeczytaj też
Regresja hedoniczna cen mieszkań
Oferty i transakcje mieszkań w 6 dzielnicach: exp(b) − 1, splajny, błędy HC3, indeks hedoniczny, oferty vs transakcje i wycena z przedziałem – sześć rysunków z kodem R.
Czytaj →PoradnikPrzychód z zerami: dwie części i Tweedie
12 000 graczy gry mobilnej, 93% zer: logit × gamma, smearing, Tweedie z profilem p, kalibracja i test A/B przychodu – z kodem R.
Czytaj →PoradnikOkres próbny i freemium – analiza przeżycia
Ilu użytkowników kiedyś kupi i jak szybko? Kaplan–Meier, model frakcji wyleczonych i test 7 vs 14 dni okresu próbnego – z kodem R.
Czytaj →Analizujesz ceny, aukcje albo sprzedaż w pracy?
Pomożemy zbudować model ceny, uwzględnić niesprzedane oferty, policzyć błędy klastrowane i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bajari, P., & Hortaçsu, A. (2003). The winner's curse, reserve prices, and endogenous entry: Empirical insights from eBay auctions. The RAND Journal of Economics, 34(2), 329. https://doi.org/10.2307/1593721 ● Otwarty dostęp: pełny tekst
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Duan, N. (1983). Smearing estimate: A nonparametric retransformation method. Journal of the American Statistical Association, 78(383), 605–610. https://doi.org/10.1080/01621459.1983.10478017
- Heckman, J. J. (1979). Sample selection bias as a specification error. Econometrica, 47(1), 153. https://doi.org/10.2307/1912352
- Lucking-Reiley, D., Bryan, D., Prasad, N., & Reeves, D. (2007). Pennies from eBay: The determinants of price in online auctions. The Journal of Industrial Economics, 55(2), 223–233. https://doi.org/10.1111/j.1467-6451.2007.00309.x ● Otwarty dostęp
- Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01 ● Otwarty dostęp
Cytowania BibTeX
@article{bajari2003winners, author={Bajari, Patrick and Horta{\c{c}}su, Ali}, title={{The winner's curse, reserve prices, and endogenous entry: Empirical insights from eBay auctions}}, journal={The RAND Journal of Economics}, year={2003}, volume={34}, number={2}, pages={329}, doi={10.2307/1593721}}@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{duan1983smearing, author={Duan, Naihua}, title={{Smearing estimate: A nonparametric retransformation method}}, journal={Journal of the American Statistical Association}, year={1983}, volume={78}, number={383}, pages={605--610}, doi={10.1080/01621459.1983.10478017}}@article{heckman1979sample, author={Heckman, James J.}, title={{Sample selection bias as a specification error}}, journal={Econometrica}, year={1979}, volume={47}, number={1}, pages={153}, doi={10.2307/1912352}}@article{lucking2007pennies, author={Lucking-Reiley, David and Bryan, Doug and Prasad, Naghi and Reeves, Daniel}, title={{Pennies from eBay: The determinants of price in online auctions}}, journal={The Journal of Industrial Economics}, year={2007}, volume={55}, number={2}, pages={223--233}, doi={10.1111/j.1467-6451.2007.00309.x}}@article{zeileis2020various, author={Zeileis, Achim and Köll, Susanne and Graham, Nathaniel}, title={{Various versatile variances: An object-oriented implementation of clustered covariances in R}}, journal={Journal of Statistical Software}, year={2020}, volume={95}, number={1}, pages={1--36}, doi={10.18637/jss.v095.i01}}