Przykład: ile gra zarabia na jednym graczu?
Fikcyjne studio wydało darmową grę logiczną na telefony, która zarabia na zakupach w aplikacji. W październiku 2026 roku grę zainstalowało 12 000 graczy. Dla każdego znamy przychód z zakupów w pierwszych 30 dniach (zł), kanał pozyskania (organiczny, reklama społecznościowa, reklama w innych grach, twórcy internetowi), system (iOS lub Android) i liczbę sesji w pierwszym dniu.
Dział pozyskania graczy pyta: ile przynosi jeden zainstalowany gracz z każdego kanału? Od tej liczby, czyli ARPU (średniego przychodu na gracza), zależy, ile wolno zapłacić za instalację. Kłopot w tym, że 93.1% graczy nie wydało ani grosza, a kilku – ponad tysiąc złotych. Taki wynik ma masę w zerze i skrajną skośność. Radzą sobie z nim model dwuczęściowy i regresja Tweedie.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy dwie decyzje gracza: czy płaci (zależy od kanału, systemu i liczby sesji) i ile wydaje płacący (rozkład lognormalny, u graczy od twórców internetowych z większym rozrzutem). Parametry podajemy przy kodzie. Ziarno 655 ustalono raz i nie zmieniano go. Dane pobierzesz jako przychod-na-gracza-gra-mobilna.csv.
Gdy wynikiem jest liczba zakupów, zajrzyj do wpisu liczba zakupów: zliczenia z zerami, a gdy skośna metryka nie ma zer – do wpisu czas na stronie i inne skośne metryki.
Rysunek 1: zera i „wieloryby”
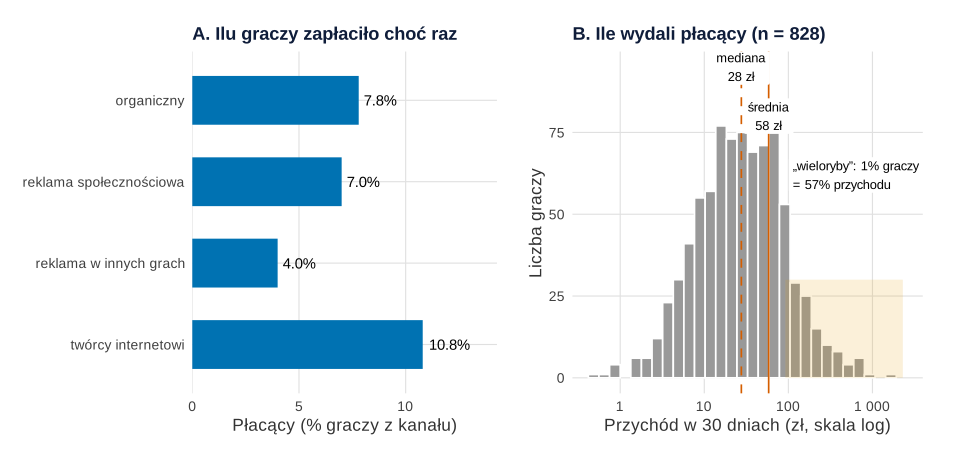
set.seed(655)).Co widać. Zapłaciło 828 z 12 000 graczy (6.9%). ARPU wynosi 4.02 zł, a przychód na płacącego (ARPPU) – 58.30 zł przy medianie 27.59 zł i maksimum 1765.73 zł. Na osi logarytmicznej kwoty układają się w dzwon, jak w rozkładzie lognormalnym. 120 graczy (1%) dało 57.4% przychodu – to „wieloryby”. Najczęściej płacą gracze od twórców internetowych (10.8%), najrzadziej – z reklam w innych grach (4.0%).
Jak może zmylić. Panel B pokazuje tylko płacących. Z 11 172 zerami histogram byłby jednym słupkiem. Ogon jest niestabilny: kilku graczy więcej albo mniej przesuwa średnią kanału o złotówki, dlatego przy ARPU podawaj przedział.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: dwie decyzje – czy płaci i ile
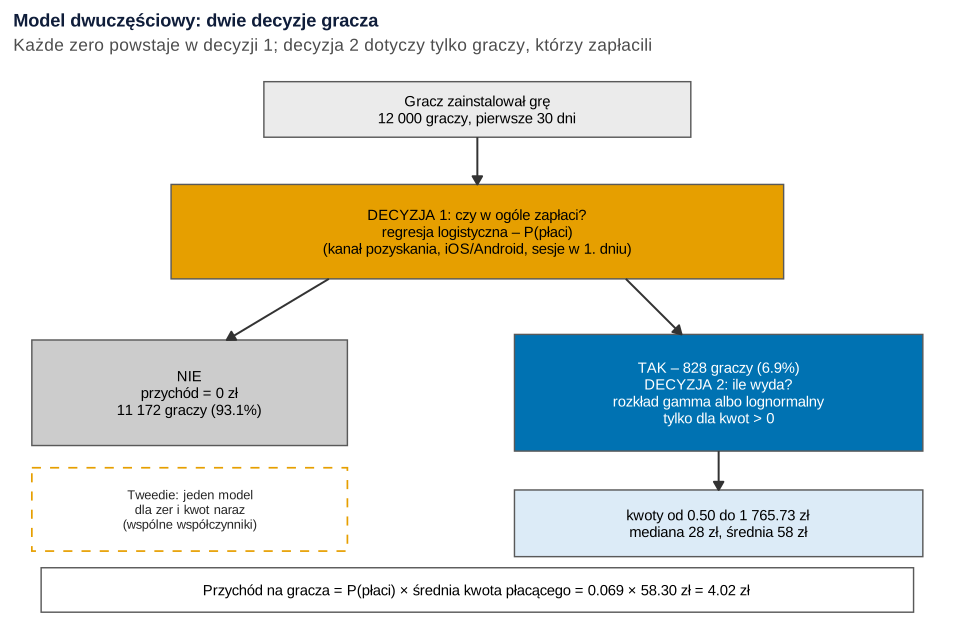
Co widać. Model dwuczęściowy rozkłada przychód na dwa pytania. Czy gracz zapłaci? To opisuje regresja logistyczna dla wszystkich graczy. Ile wyda płacący? To opisuje model dla 828 kwot dodatnich – regresja gamma albo regresja na logarytmie kwoty. Oczekiwany przychód to iloczyn: 0.069 × 58.30 zł = 4.02 zł. W porównaniu modeli wydatków na leczenie lepiej prognozował model bliski rzeczywistemu rozkładowi, z nieparametryczną retransformacją, niż prosta analiza wariancji wrażliwa na obserwacje odstające (Duan i in., 1983).
Jak może zmylić. Obie części to ci sami gracze, więc nie interpretuj ich jak niezależnych procesów. Przerywana ramka to alternatywa: model Tweedie opisuje zera i kwoty jednym rozkładem. Dla zliczeń tę logikę ma model hurdle (Mullahy, 1986).
Podpis do pracy:
Zdanie do Metody:
Dlaczego nie zwykła regresja ani log(y + 1)
Dwa skróty kuszą najbardziej. Zwykła regresja liniowa na przychodzie trafia w średnie kanałów, ale dla 8.4% graczy przewiduje ujemny przychód (do −2.88 zł), zakłada stały rozrzut i dodaje efekty, które w przychodzie działają mnożąco.
Regresja na log(przychód + 1) wygląda porządnie, bo logarytm „prostuje” ogon (zob. transformacja logarytmiczna). Problem pojawia się przy powrocie do złotówek: średnia logarytmów to nie logarytm średniej, a przy 93% zer model opisuje głównie zera. Prognoza exp(ŷ) − 1 daje ARPU kanału organicznego 0.31 zł zamiast 3.87 zł – ponad dwanaście razy za mało.
Rysunek 3: przychód na gracza w kanałach i smearing
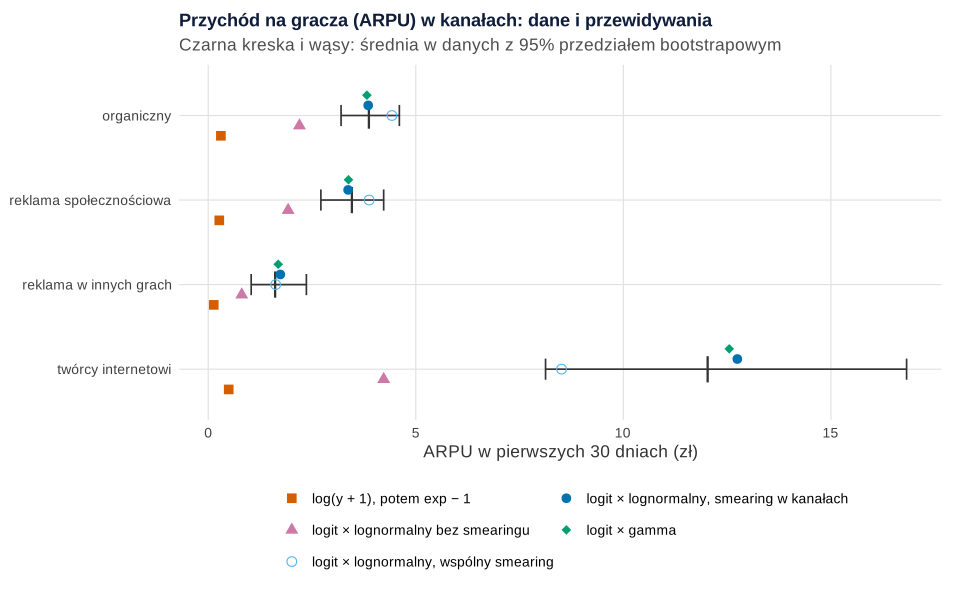
set.seed(655), 2000 prób).Co widać. Wszystkie modele mają te same predyktory (kanał, system, logarytm liczby sesji), a przewidywania uśredniamy w kanałach. Model dwuczęściowy z regresją na log(kwoty) bez poprawki (trójkąty) też zaniża ARPU, bo exp(średniej logarytmów) to mediana, a nie średnia kwot. Naprawia to smearing Duana: prognozę mnożymy przez średnią z exp(reszt), tu 2.014 (Duan, 1983). Wspólny czynnik daje twórcom internetowym 8.51 zł zamiast 12.03 zł, bo ich kwoty mają większy rozrzut i potrzebują czynnika 3.016, a nie około 1.75 jak w kanale organicznym. Ze smearingiem w kanałach prognoza wynosi 12.75 zł. Część z rozkładem gamma (romby) trafia bez retransformacji (12.55 zł), bo modeluje średnią kwot wprost.
Jak może zmylić. Zgodność średnich w kanałach nie dowodzi dobrego modelu – zwykła regresja trafia tu idealnie mimo ujemnych prognoz. Jak skośność i niejednorodny rozrzut wpływają na wybór między regresją na logarytmie a GLM, pokazali w symulacjach Manning i Mullahy (2001). Przedział dla twórców internetowych jest szeroki (8.13–16.82 zł), bo kanał ma 1237 graczy i najdłuższy ogon.
Podpis do pracy:
Zdanie do Wyników:
Model dwuczęściowy mówi też, skąd bierze się różnica. Gracze od twórców internetowych płacą nieco częściej niż organiczni (iloraz szans OR = 1.44), ale przede wszystkim wydają więcej (iloraz średnich kwot 2.38). Gracze z reklam w innych grach płacą o połowę rzadziej (OR = 0.50), a ich kwoty są tylko nieco niższe (0.85).
Rysunek 4: regresja Tweedie i wybór p
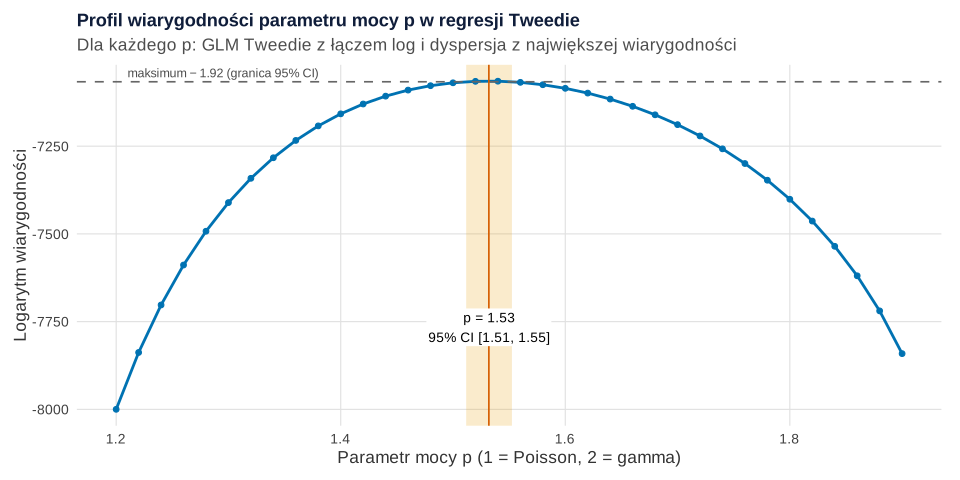
Co widać. Rozkład Tweedie przy 1 < p < 2 to suma poissonowskiej liczby kwot z rozkładu gamma. Bez zakupów suma wynosi 0, więc jeden rozkład ma masę w zerze i ciągły ogon (Jørgensen, 1987; Smyth i Jørgensen, 2002). Parametr p mówi, jak wariancja rośnie ze średnią. Wybraliśmy go profilem wiarygodności: dla każdego p GLM Tweedie z łączem log (rodzina tweedie() z pakietu statmod), a dyspersja φ metodą największej wiarygodności z gęstością dtweedie(). Maksimum: p = 1.53, 95% CI [1.51, 1.55], φ = 52.71. To samo robi funkcja tweedie_profile() z pakietu tweedie.
Jak może zmylić. Wąski przedział nie dowodzi, że dane pochodzą z rozkładu Tweedie – nasze pochodzą z logitu i rozkładu lognormalnego. W modelu Tweedie exp(b) to iloraz średnich przychodów: gracze od twórców internetowych przynoszą 3.34 razy więcej niż organiczni, 95% CI [2.27, 4.91], z reklam w innych grach – 0.45 raza, 95% CI [0.31, 0.67], a z reklamy społecznościowej podobnie (0.90, p = .544). Ta jedna liczba nie powie jednak, czy różnica dotyczy odsetka płacących, czy kwot.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: kalibracja na nowych graczach
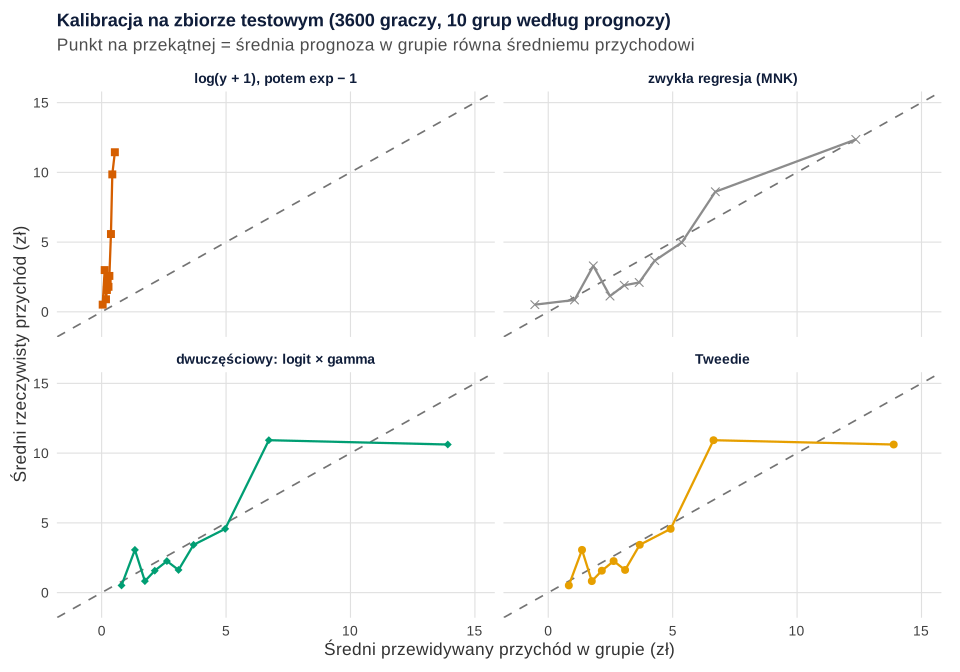
set.seed(655)).Co widać. Modele uczyliśmy na losowych 70% graczy, a sprawdzaliśmy na pozostałych 3600, podzielonych na 10 grup według prognozy (kalibracja). Rzeczywisty przychód testowy to 14 187.54 zł. Model dwuczęściowy (logit × gamma) przewidział 14 761.72 zł, Tweedie 14 734.34 zł, zwykła regresja 14 487.14 zł, a log(y + 1) tylko 977.24 zł, czyli 7% prawdziwej sumy. Model dwuczęściowy i Tweedie dają tu prawie te same prognozy (RMSE po 29.28 zł).
Jak może zmylić. W dwóch najwyższych grupach punkty odskakują w przeciwne strony (10.93 zł przy prognozie 6.72 zł i 10.62 zł przy 13.91 zł) – to kilku „wielorybów”, a nie wada modelu. Uważaj też na miarę błędu: najmniejsze MAE ma log(y + 1) (4.17 zł wobec 7.29 zł), bo MAE nagradza prognozy bliskie medianie, a mediana przychodu to 0.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: test A/B przychodu na gracza
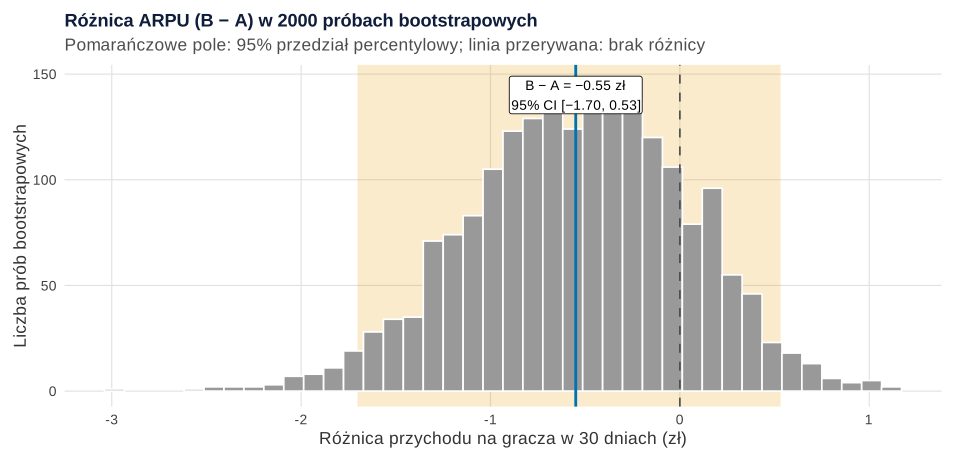
set.seed(655), 2000 prób).Co widać. Osobny, fikcyjny test A/B: po 5000 nowych graczy widziało obecną ofertę (A) albo tańszy pakiet startowy (B). W B płaciło więcej graczy (9.2% wobec 7.5%; różnica 1.7 pp, 95% CI [0.6, 2.8], p = .002), ale wydawali mniej (ARPPU 35.68 zł wobec 51.10 zł). ARPU spadło z 3.83 do 3.28 zł. Bootstrap po graczach daje różnicę −0.55 zł, 95% CI [−1.70, 0.53], a test Welcha – [−1.71, 0.61], p = .354.
Jak może zmylić. Wzrost konwersji ogłoszony jako sukces to klasyczny błąd – przychód na gracza mógł spaść. Przedział jest szeroki, bo decyduje kilku dużych płatników: bez jednego największego gracza w każdej grupie różnica zmienia się z −0.55 do −0.39 zł. Jednostki analizy i metody delta dotyczy wpis o wskaźnikach ilorazowych w testach A/B.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w firmie
- Budżet na pozyskanie dziel według ARPU z przedziałem i porównuj go z kosztem instalacji. Twórcy internetowi wyglądają najlepiej, ale mają najszerszy przedział – zwiększaj ich budżet stopniowo.
- Różne kanały wymagają różnych działań. W reklamie w innych grach problemem jest konwersja (OR = 0.50), więc pomoże oferta na pierwszy zakup. U twórców internetowych przewagę dają kwoty, więc liczy się oferta dla dużych płatników.
- Wynikiem testów ofert niech będzie przychód na gracza. Konwersję i ARPPU raportuj jako jego składniki, a liczebność planuj pod przychód.
- Przychód z 30 dni to nie wartość gracza. Dalsze miesiące i retencję łączy wartość klienta w czasie (CLV).
Pułapki
- log(y + 1) i powrót przez exp − 1 – zaniżona średnia, a „+1” zmienia wynik zależnie od jednostki (złote czy grosze).
- Jeden czynnik smearing przy różnym rozrzucie w grupach – licz go w grupach albo użyj regresji gamma.
- Usuwanie „wielorybów” jako obserwacji odstających. To oni robią przychód. Regułę przycinania ustal przed analizą i pokaż wynik z nimi i bez nich.
- Tweedie z p „z przyzwyczajenia” (np. 1.5) bez profilu. Przy innym p zmieniają się błędy standardowe.
- Przyczynowość. Kanał to nie losowy przydział: twórcy internetowi mogą przyciągać innych ludzi, a nie zmieniać ich zachowanie.
Jak opisać w pracy
W Metodzie podaj definicję przychodu (okres, waluta, zwroty), odsetek zer, porównane modele, sposób retransformacji i wyboru p oraz podział na zbiór uczący i testowy. W Wynikach – średnie przewidywania w grupach z przedziałami, ilorazy z obu części modelu i tabelę oceny na zbiorze testowym. Inne analizy typowe dla tego kierunku opisuje wpis statystyka w pracy z zarządzania i ekonomii, a walidację modeli – modele predykcyjne: walidacja i kalibracja.
| Model | Przewidywana suma (zł) | Suma / rzeczywista | MAE (zł) | RMSE (zł) | Przychód u 10% graczy z najwyższą prognozą |
|---|---|---|---|---|---|
| log(y + 1), potem exp − 1 | 977.24 | 0.07 | 4.17 | 29.77 | 29.0% |
| Zwykła regresja (MNK) | 14 487.14 | 1.02 | 7.38 | 29.34 | 31.6% |
| Dwuczęściowy: logit × gamma | 14 761.72 | 1.04 | 7.29 | 29.28 | 30.0% |
| Tweedie (p = 1.53) | 14 734.34 | 1.04 | 7.29 | 29.28 | 30.0% |
Podpis tabeli:
Do Metody:
Kod R: model dwuczęściowy, Tweedie, kalibracja i test A/B
Kod odtwarza wszystkie liczby z tekstu, tabelę i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, przepis 3 – wzór modelu f, a przepis 4 – parametr p_moc, z których korzystają następne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane), 3 (bootstrap), 5 (podział na zbiór uczący i testowy) i 6 (dane testu A/B i bootstrap); każdy losujący blok ma własne set.seed(655). Ziarno 655 ustalono raz i nie zmieniano go. Ręcznie ustalono: 12 000 graczy; udziały kanałów .35, .30, .25 i .10; 40% graczy na iOS; liczba sesji w pierwszym dniu 1 + Poisson(3); decyzja „czy płaci” plogis(−2.7 + kanał [0, −0.2, −0.8, 0.3] + 0.6 × iOS + 0.5 × log(sesje/4)); kwota płacącego – rozkład lognormalny ze średnią logarytmu 3.0 + kanał [0, 0.1, −0.3, 0.2] + 0.4 × iOS + 0.2 × log(sesje/4) i odchyleniem logarytmu 1.1 (u twórców internetowych 1.5); siatkę p od 1.20 do 1.90 co 0.02; podział 70/30; w teście A/B 5000 graczy na grupę, odsetek płacących .070 i .090, średnią logarytmu kwoty 3.1 i 2.85 przy odchyleniu 1.2; 2000 prób bootstrapowych. Po próbnym uruchomieniu zmieniono kilka parametrów, nie zmieniając ziarna: wyraz wolny decyzji „czy płaci” (z −3.0 na −2.7) i odchylenia logarytmu kwot (z 1.2 i 1.7 na 1.1 i 1.5), żeby płaciło ok. 7% graczy, a nie 5%, oraz w teście A/B odsetek płacących w B (z .082 na .090) i średnią logarytmu kwoty w B (z 2.95 na 2.85), żeby różnica konwersji była wyraźna. Całość liczy się w ok. 10 sekund.
1. Paleta, dane i rozkład przychodu: Rysunek 1
R
# Rysunek 1. Przychód z gracza w pierwszych 30 dniach: ilu w ogóle płaci i ile wydają płacący (dane fikcyjne)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(obserwowana = "grey20", log1 = "#D55E00", bez_smearingu = "#CC79A7", smearing_wsp = "#56B4E9", smearing = "#0072B2",
         gamma = "#009E73", tweedie = "#E69F00", ols = "grey55", jasny = "grey80", akcent = "#0072B2")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Fikcyjna gra mobilna (logiczna gra z zakupami w aplikacji): 12 000 graczy, którzy zainstalowali grę
# w październiku 2026, i ich wydatki w pierwszych 30 dniach (zł). Parametry ustalone ręcznie.
set.seed(655)                                     # ziarno ustalone raz, bez dobierania pod wynik
N <- 12000
kanaly <- c("organiczny", "reklama społecznościowa", "reklama w innych grach", "twórcy internetowi")
kanal <- factor(sample(kanaly, N, replace = TRUE, prob = c(.35, .30, .25, .10)), levels = kanaly)
ios <- rbinom(N, 1, .40)                          # 1 = iOS, 0 = Android
sesje_d1 <- rpois(N, 3) + 1                       # liczba sesji w pierwszym dniu
k <- as.integer(kanal)
# Decyzja 1 – czy gracz zapłacił choć raz (logit)
placi <- rbinom(N, 1, plogis(-2.7 + c(0, -0.2, -0.8, 0.3)[k] + 0.6 * ios + 0.5 * log(sesje_d1 / 4)))
# Decyzja 2 – ile wydał płacący: rozkład lognormalny; u graczy od twórców internetowych większy rozrzut
srednia_log <- 3.0 + c(0, 0.1, -0.3, 0.2)[k] + 0.4 * ios + 0.2 * log(sesje_d1 / 4)
sd_log <- c(1.1, 1.1, 1.1, 1.5)[k]
przychod <- ifelse(placi == 1, round(rlnorm(N, srednia_log, sd_log), 2), 0)
gracze <- data.frame(id = 1:N, przychod, kanal, ios, sesje_d1)
write.csv(gracze, "przychod-na-gracza-gra-mobilna.csv", row.names = FALSE, fileEncoding = "UTF-8")

placacy <- przychod[przychod > 0]
top1 <- sort(przychod, decreasing = TRUE)[1:(N / 100)]          # 1% graczy z najwyższym przychodem
c(N = N, placacy = length(placacy), zera_proc = round(100 * mean(przychod == 0), 1),
  ARPU = round(mean(przychod), 2), ARPPU = round(mean(placacy), 2), mediana_placacych = round(median(placacy), 2),
  maks = max(przychod), prog_top1 = min(top1), udzial_top1_proc = round(100 * sum(top1) / sum(przychod), 1))
# Kanały pozyskania: liczba graczy, odsetek płacących, ARPU (na gracza) i ARPPU (na płacącego)
tab <- do.call(rbind, lapply(split(gracze, gracze$kanal), function(g)
  data.frame(n = nrow(g), placacy_proc = round(100 * mean(g$przychod > 0), 1), ARPU = round(mean(g$przychod), 2),
             ARPPU = round(mean(g$przychod[g$przychod > 0]), 2), mediana_placacych = round(median(g$przychod[g$przychod > 0]), 2))))
tab

# Panel A: odsetek płacących w kanałach; panel B: kwoty płacących na osi logarytmicznej
pa <- ggplot(tab, aes(x = placacy_proc, y = factor(rownames(tab), levels = rev(kanaly)))) +
  geom_col(fill = kol[["akcent"]], width = 0.6) +
  geom_text(aes(label = sprintf("%.1f%%", placacy_proc)), hjust = -0.15, size = 3.9) +
  scale_x_continuous(limits = c(0, 14), expand = expansion(mult = c(0, 0.02))) +
  labs(title = "A. Ilu graczy zapłaciło choć raz", x = "Płacący (% graczy z kanału)", y = NULL) + motyw
pb <- ggplot(data.frame(kwota = placacy), aes(kwota)) +
  geom_histogram(bins = 30, fill = "grey60", colour = "white", boundary = 0) +
  geom_vline(xintercept = c(median(placacy), mean(placacy)), linetype = c("dashed", "solid"), colour = kol[["log1"]]) +
  annotate("label", x = c(median(placacy), mean(placacy)), y = c(95, 80), size = 3.4, linewidth = 0,
           label = c(sprintf("mediana\n%.0f zł", median(placacy)), sprintf("średnia\n%.0f zł", mean(placacy)))) +
  annotate("rect", xmin = min(top1), xmax = max(przychod) * 1.3, ymin = 0, ymax = 30, alpha = 0.15, fill = kol[["tweedie"]]) +
  annotate("label", x = min(top1) * 1.1, y = 62, hjust = 0, size = 3.4, linewidth = 0, fill = "white",
           label = sprintf("„wieloryby”: 1%% graczy\n= %.0f%% przychodu", 100 * sum(top1) / sum(przychod))) +
  scale_x_log10(labels = scales::label_number(big.mark = " "), breaks = c(1, 10, 100, 1000)) +
  labs(title = sprintf("B. Ile wydali płacący (n = %d)", length(placacy)), x = "Przychód w 30 dniach (zł, skala log)",
       y = "Liczba graczy") + motyw
p1 <- pa + pb + plot_layout(widths = c(1, 1.15))
p1   # ggsave("przychod-rozklad.svg", p1, width = 10, height = 4.8)
Wynik w R
                N           placacy         zera_proc              ARPU
         12000.00            828.00             93.10              4.02
            ARPPU mediana_placacych              maks         prog_top1
            58.30             27.59           1765.73             92.08
 udzial_top1_proc
            57.40
                           n placacy_proc  ARPU  ARPPU mediana_placacych
organiczny              4206          7.8  3.87  49.89             27.77
reklama społecznościowa 3564          7.0  3.46  49.67             27.88
reklama w innych grach  2993          4.0  1.61  39.75             17.28
twórcy internetowi      1237         10.8 12.03 111.86             40.44
2. Grafika „dwie decyzje gracza”: Rysunek 2
R
# Rysunek 2. Dwie decyzje gracza: czy płaci i ile wydaje – grafika narysowana w ggplot2
# Dane wejściowe: gracze, kol i motyw z przepisu 1. Liczby w ramkach pochodzą z danych.
n_zero <- sum(gracze$przychod == 0); n_plac <- sum(gracze$przychod > 0)
kwoty <- gracze$przychod[gracze$przychod > 0]
c(nie_placi = n_zero, placi = n_plac, placi_proc = round(100 * n_plac / nrow(gracze), 1),
  ARPPU = round(mean(kwoty), 2), mediana = round(median(kwoty), 2), ARPU = round(mean(gracze$przychod), 2),
  iloczyn = round(n_plac / nrow(gracze) * mean(kwoty), 2))

ramki <- data.frame(
  x = c(5, 5, 1.9, 7.6, 7.6, 5),
  y = c(9.2, 7.0, 4.1, 4.1, 1.75, 0.55),
  szer = c(4.6, 6.6, 3.4, 4.4, 4.4, 9.4), wys = c(1.0, 1.7, 1.9, 2.1, 1.2, 0.8),
  typ = c("start", "decyzja1", "zero", "decyzja2", "kwota", "wzor"),
  tekst = c(sprintf("Gracz zainstalował grę\n%s graczy, pierwsze 30 dni", format(nrow(gracze), big.mark = " ")),
            "DECYZJA 1: czy w ogóle zapłaci?\nregresja logistyczna – P(płaci)\n(kanał pozyskania, iOS/Android, sesje w 1. dniu)",
            sprintf("NIE\nprzychód = 0 zł\n%s graczy (%.1f%%)", format(n_zero, big.mark = " "), 100 * n_zero / nrow(gracze)),
            sprintf("TAK – %d graczy (%.1f%%)\nDECYZJA 2: ile wyda?\nrozkład gamma albo lognormalny\ntylko dla kwot > 0", n_plac,
                    100 * n_plac / nrow(gracze)),
            sprintf("kwoty od %.2f do %s zł\nmediana %.0f zł, średnia %.0f zł", min(kwoty),
                    format(max(kwoty), big.mark = " "), median(kwoty), mean(kwoty)),
            sprintf("Przychód na gracza = P(płaci) × średnia kwota płacącego = %.3f × %.2f zł = %.2f zł",
                    n_plac / nrow(gracze), mean(kwoty), mean(gracze$przychod))))
strzalki <- data.frame(x = c(5, 3.4, 6.6, 7.6), y = c(8.7, 6.15, 6.15, 3.05),
                       xend = c(5, 2.3, 7.2, 7.6), yend = c(7.85, 5.05, 5.15, 2.35))
p2 <- ggplot() +
  geom_rect(data = ramki, aes(xmin = x - szer / 2, xmax = x + szer / 2, ymin = y - wys / 2, ymax = y + wys / 2, fill = typ),
            colour = "grey35", linewidth = 0.5) +
  geom_text(data = ramki, aes(x, y, label = tekst, colour = typ), size = 3.9, lineheight = 0.95) +
  geom_segment(data = strzalki, aes(x, y, xend = xend, yend = yend), linewidth = 0.7, colour = "grey20",
               arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  annotate("rect", xmin = 0.2, xmax = 3.6, ymin = 1.25, ymax = 2.75, fill = "white", colour = kol[["tweedie"]],
           linetype = "dashed", linewidth = 0.6) +
  annotate("text", x = 1.9, y = 2, size = 3.4, lineheight = 0.95, colour = "grey15",
           label = "Tweedie: jeden model\ndla zer i kwot naraz\n(wspólne współczynniki)") +
  scale_fill_manual(values = c(start = "grey92", decyzja1 = "#E69F00", zero = "grey80", decyzja2 = "#0072B2",
                               kwota = "#DCEBF7", wzor = "white"), guide = "none") +
  scale_colour_manual(values = c(start = "black", decyzja1 = "black", zero = "black", decyzja2 = "white",
                                 kwota = "black", wzor = "black"), guide = "none") +
  coord_cartesian(xlim = c(0, 10), ylim = c(0, 10), expand = FALSE) +
  labs(title = "Model dwuczęściowy: dwie decyzje gracza",
       subtitle = "Każde zero powstaje w decyzji 1; decyzja 2 dotyczy tylko graczy, którzy zapłacili") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(),
                panel.grid.major = element_blank(), panel.grid.minor = element_blank())
p2   # ggsave("przychod-schemat.svg", p2, width = 10, height = 6.6)
Wynik w R
 nie_placi      placi placi_proc      ARPPU    mediana       ARPU    iloczyn
  11172.00     828.00       6.90      58.30      27.59       4.02       4.02
3. Model dwuczęściowy, log(y + 1) i smearing: Rysunek 3
R
# Rysunek 3. Przewidywany przychód na gracza według kanału: log(y + 1), model dwuczęściowy i retransformacja
# Dane wejściowe: gracze, kanaly, kol i motyw z przepisu 1.
f <- ~ kanal + ios + log(sesje_d1)                       # te same predyktory we wszystkich modelach
plac <- subset(gracze, przychod > 0)

# Dwa „skróty”: zwykła regresja na przychodzie i regresja na log(przychód + 1)
m_ols <- lm(update(f, przychod ~ .), data = gracze)
m_log1 <- lm(update(f, log(przychod + 1) ~ .), data = gracze)
# Model dwuczęściowy: część 1 – logit P(płaci); część 2 – kwoty płacących (lognormalny albo gamma)
m_logit <- glm(update(f, I(przychod > 0) ~ .), family = binomial, data = gracze)
m_ln <- lm(update(f, log(przychod) ~ .), data = plac)
m_gam <- glm(update(f, przychod ~ .), family = Gamma(link = "log"), data = plac)

# Smearing Duana: średnia z exp(reszt) – wspólna i osobno w każdym kanale
smear <- mean(exp(resid(m_ln)))
smear_k <- tapply(exp(resid(m_ln)), plac$kanal, mean)
round(c(smearing_wspolny = smear, smear_k), 3)

p_hat <- predict(m_logit, gracze, type = "response")
xb_ln <- predict(m_ln, gracze)
przew <- data.frame(kanal = gracze$kanal,
  log1_naiwnie = exp(predict(m_log1, gracze)) - 1,
  bez_smearingu = p_hat * exp(xb_ln),
  smearing_wspolny = p_hat * exp(xb_ln) * smear,
  smearing_w_kanalach = p_hat * exp(xb_ln) * smear_k[as.character(gracze$kanal)],
  logit_x_gamma = p_hat * predict(m_gam, gracze, type = "response"),
  ols = fitted(m_ols))
c(ols_ujemne_proc = round(100 * mean(przew$ols < 0), 1), ols_min = round(min(przew$ols), 2))

# Obserwowany ARPU w kanałach z 95% przedziałem bootstrapowym (percentylowym)
set.seed(655)
boot_ci <- t(sapply(split(gracze$przychod, gracze$kanal), function(y) {
  b <- replicate(2000, mean(sample(y, replace = TRUE)))
  c(obserwowany = mean(y), dolna = unname(quantile(b, .025)), gorna = unname(quantile(b, .975)))
}))
porownanie <- cbind(boot_ci, aggregate(przew[, -1], list(kanal = przew$kanal), mean)[, -1])
round(porownanie, 2)
# Iloraz szans (część 1) i iloraz średnich kwot (część 2, gamma) dla kanałów i platformy
round(cbind(OR_placi = exp(coef(m_logit)), iloraz_kwot_gamma = exp(coef(m_gam)))[-1, ], 2)

dl <- data.frame(kanal = rep(rownames(porownanie), 5),
                 metoda = rep(c("log(y + 1), potem exp − 1", "logit × lognormalny bez smearingu",
                                "logit × lognormalny, wspólny smearing", "logit × lognormalny, smearing w kanałach",
                                "logit × gamma"), each = 4),
                 arpu = c(porownanie$log1_naiwnie, porownanie$bez_smearingu, porownanie$smearing_wspolny,
                          porownanie$smearing_w_kanalach, porownanie$logit_x_gamma))
dl$metoda <- factor(dl$metoda, levels = unique(dl$metoda))
dl$kanal <- factor(dl$kanal, levels = rev(kanaly))
ob <- data.frame(kanal = factor(rownames(porownanie), levels = rev(kanaly)), porownanie[, 1:3])
p3 <- ggplot() +
  geom_errorbar(data = ob, aes(y = kanal, xmin = dolna, xmax = gorna), width = 0.25, colour = kol[["obserwowana"]]) +
  geom_point(data = ob, aes(y = kanal, x = obserwowany), shape = 124, size = 7, colour = kol[["obserwowana"]]) +
  geom_point(data = dl, aes(y = kanal, x = arpu, colour = metoda, shape = metoda), size = 3,
             position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = unname(kol[c("log1", "bez_smearingu", "smearing_wsp", "smearing", "gamma")]), name = NULL) +
  scale_shape_manual(values = c(15, 17, 1, 16, 18), name = NULL) +
  guides(colour = guide_legend(ncol = 2), shape = guide_legend(ncol = 2)) +
  labs(title = "Przychód na gracza (ARPU) w kanałach: dane i przewidywania",
       subtitle = "Czarna kreska i wąsy: średnia w danych z 95% przedziałem bootstrapowym",
       x = "ARPU w pierwszych 30 dniach (zł)", y = NULL) + motyw
p3   # ggsave("przychod-kanaly.svg", p3, width = 10, height = 6)
Wynik w R
       smearing_wspolny              organiczny reklama społecznościowa
                  2.014                   1.754                   1.750
 reklama w innych grach      twórcy internetowi
                  2.152                   3.016
ols_ujemne_proc         ols_min
           8.40           -2.88
                        obserwowany dolna gorna log1_naiwnie bez_smearingu
organiczny                     3.87  3.20  4.60         0.31          2.20
reklama społecznościowa        3.46  2.71  4.23         0.27          1.93
reklama w innych grach         1.61  1.04  2.36         0.13          0.81
twórcy internetowi            12.03  8.13 16.82         0.49          4.23
                        smearing_wspolny smearing_w_kanalach logit_x_gamma
organiczny                          4.43                3.85          3.82
reklama społecznościowa             3.88                3.37          3.38
reklama w innych grach              1.63                1.74          1.69
twórcy internetowi                  8.51               12.75         12.55
                          ols
organiczny               3.87
reklama społecznościowa  3.46
reklama w innych grach   1.61
twórcy internetowi      12.03
                             OR_placi iloraz_kwot_gamma
kanalreklama społecznościowa     0.90              0.99
kanalreklama w innych grach      0.50              0.85
kanaltwórcy internetowi          1.44              2.38
ios                              1.62              1.44
log(sesje_d1)                    1.56              1.48
4. Regresja Tweedie i profil parametru p: Rysunek 4
R
# Rysunek 4. Regresja Tweedie: wybór parametru mocy p profilem wiarygodności
# Dane wejściowe: gracze, f, porownanie, kol i motyw z przepisów 1 i 3. Niczego nie losuje.
library(statmod)   # rodzina tweedie() do glm()
library(tweedie)   # gęstość dtweedie() do logarytmu wiarygodności

# Profil: dla danego p dopasuj GLM Tweedie (łącze log), potem dobierz dyspersję phi największą wiarygodnością
profil <- function(p, dane = gracze) {
  m <- glm(update(f, przychod ~ .), family = tweedie(var.power = p, link.power = 0), data = dane,
           control = glm.control(maxit = 100))
  mu <- fitted(m)
  logL <- function(lphi) sum(log(dtweedie(dane$przychod, mu = mu, phi = exp(lphi), power = p)))
  o <- optimize(logL, c(log(1), log(5000)), maximum = TRUE)
  c(p = p, logL = o$objective, phi = exp(o$maximum))
}
siatka <- as.data.frame(t(sapply(seq(1.20, 1.90, by = 0.02), profil)))
naj <- optimize(function(p) profil(p)[["logL"]], c(1.2, 1.9), maximum = TRUE)
p_moc <- naj$maximum
# 95% przedział z profilu: p, dla których logL spada o mniej niż qchisq(.95, 1) / 2 = 1.92
prog <- naj$objective - qchisq(.95, 1) / 2
ci_p <- c(uniroot(function(p) profil(p)[["logL"]] - prog, c(1.2, p_moc))$root,
          uniroot(function(p) profil(p)[["logL"]] - prog, c(p_moc, 1.9))$root)
round(c(p = p_moc, dolna = ci_p[1], gorna = ci_p[2], logL = naj$objective, phi = profil(p_moc)[["phi"]]), 3)

# Model końcowy: GLM Tweedie z p z profilu; exp(b) = iloraz średnich przychodów (ARPU)
m_tw <- glm(update(f, przychod ~ .), family = tweedie(var.power = p_moc, link.power = 0), data = gracze,
            control = glm.control(maxit = 100))
b <- summary(m_tw)$coefficients
round(cbind(iloraz_ARPU = exp(b[-1, 1]), dolna = exp(b[-1, 1] - 1.96 * b[-1, 2]),
            gorna = exp(b[-1, 1] + 1.96 * b[-1, 2]), p = b[-1, 4]), 3)
# Średni przewidywany ARPU w kanałach: Tweedie obok danych i modelu dwuczęściowego (logit × gamma)
porownanie$tweedie <- tapply(fitted(m_tw), gracze$kanal, mean)
round(porownanie[, c("obserwowany", "logit_x_gamma", "smearing_w_kanalach", "tweedie")], 2)

p4 <- ggplot(siatka, aes(p, logL)) +
  annotate("rect", xmin = ci_p[1], xmax = ci_p[2], ymin = -Inf, ymax = Inf, fill = kol[["tweedie"]], alpha = 0.2) +
  geom_line(colour = kol[["akcent"]], linewidth = 1) + geom_point(colour = kol[["akcent"]], size = 1.6) +
  geom_hline(yintercept = prog, linetype = "dashed", colour = "grey40") +
  geom_vline(xintercept = p_moc, colour = kol[["log1"]]) +
  annotate("label", x = p_moc, y = min(siatka$logL) + 0.25 * diff(range(siatka$logL)), size = 3.6, linewidth = 0,
           label = sprintf("p = %.2f\n95%% CI [%.2f, %.2f]", p_moc, ci_p[1], ci_p[2])) +
  annotate("text", x = 1.21, y = prog, vjust = -0.5, hjust = 0, size = 3.3, colour = "grey30",
           label = "maksimum − 1.92 (granica 95% CI)") +
  labs(title = "Profil wiarygodności parametru mocy p w regresji Tweedie",
       subtitle = "Dla każdego p: GLM Tweedie z łączem log i dyspersja z największej wiarygodności",
       x = "Parametr mocy p (1 = Poisson, 2 = gamma)", y = "Logarytm wiarygodności") + motyw
p4   # ggsave("przychod-tweedie-profil.svg", p4, width = 10, height = 5)
Wynik w R
        p     dolna     gorna      logL       phi
    1.532     1.512     1.552 -7064.528    52.712
                             iloraz_ARPU dolna gorna     p
kanalreklama społecznościowa       0.901 0.643 1.262 0.544
kanalreklama w innych grach        0.452 0.305 0.669 0.000
kanaltwórcy internetowi            3.341 2.273 4.909 0.000
ios                                2.176 1.664 2.846 0.000
log(sesje_d1)                      2.245 1.669 3.020 0.000
                        obserwowany logit_x_gamma smearing_w_kanalach tweedie
organiczny                     3.87          3.82                3.85    3.81
reklama społecznościowa        3.46          3.38                3.37    3.36
reklama w innych grach         1.61          1.69                1.74    1.69
twórcy internetowi            12.03         12.55               12.75   12.62
5. Zbiór testowy i krzywe kalibracji: Rysunek 5
R
# Rysunek 5. Kalibracja na zbiorze testowym: czy przewidywany przychód zgadza się z rzeczywistym
# Dane wejściowe: gracze, f, p_moc, kol i motyw z przepisów 1, 3 i 4.
library(statmod)
set.seed(655)
uczacy <- sample(nrow(gracze), round(0.7 * nrow(gracze)))      # 70% graczy do uczenia, 30% do testu
tr <- gracze[uczacy, ]; te <- gracze[-uczacy, ]
tr_plac <- subset(tr, przychod > 0)

m1 <- lm(update(f, log(przychod + 1) ~ .), data = tr)
m2 <- lm(update(f, przychod ~ .), data = tr)
m3a <- glm(update(f, I(przychod > 0) ~ .), family = binomial, data = tr)
m3b <- glm(update(f, przychod ~ .), family = Gamma(link = "log"), data = tr_plac)
m4 <- glm(update(f, przychod ~ .), family = tweedie(var.power = p_moc, link.power = 0), data = tr,
          control = glm.control(maxit = 100))
przew_te <- data.frame(
  "log(y + 1), potem exp − 1" = exp(predict(m1, te)) - 1,
  "zwykła regresja (MNK)" = predict(m2, te),
  "dwuczęściowy: logit × gamma" = predict(m3a, te, type = "response") * predict(m3b, te, type = "response"),
  "Tweedie" = predict(m4, te, type = "response"), check.names = FALSE)

# Suma przychodu w teście: rzeczywista i przewidywana; udział przychodu u 10% graczy z najwyższą prognozą
ocena <- t(sapply(przew_te, function(pr) c(suma_przewidywana = sum(pr), suma_do_rzeczywistej = sum(pr) / sum(te$przychod),
  MAE = mean(abs(te$przychod - pr)), RMSE = sqrt(mean((te$przychod - pr)^2)),
  udzial_top10_proc = 100 * sum(te$przychod[pr >= quantile(pr, .9)]) / sum(te$przychod))))
c(n_test = nrow(te), suma_rzeczywista = sum(te$przychod))
round(ocena, 2)

# Krzywa kalibracji: gracze testowi w 10 grupach według prognozy; średnia prognoza vs średni przychód
kalib <- do.call(rbind, lapply(names(przew_te), function(m) {
  pr <- przew_te[[m]]; grupa <- cut(rank(pr, ties.method = "first"), 10, labels = FALSE)
  data.frame(model = m, decyl = 1:10, prognoza = tapply(pr, grupa, mean), rzeczywisty = tapply(te$przychod, grupa, mean))
}))
kalib$model <- factor(kalib$model, levels = names(przew_te))
subset(transform(kalib, prognoza = round(prognoza, 2), rzeczywisty = round(rzeczywisty, 2)), decyl %in% c(1, 5, 9, 10))

p5 <- ggplot(kalib, aes(prognoza, rzeczywisty)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = "grey45") +
  geom_line(aes(colour = model), linewidth = 0.8) + geom_point(aes(colour = model, shape = model), size = 2.4) +
  facet_wrap(~ model, ncol = 2) +
  scale_colour_manual(values = unname(kol[c("log1", "ols", "gamma", "tweedie")]), guide = "none") +
  scale_shape_manual(values = c(15, 4, 18, 16), guide = "none") +
  coord_cartesian(xlim = c(-1, 15), ylim = c(-1, 15)) +
  labs(title = "Kalibracja na zbiorze testowym (3600 graczy, 10 grup według prognozy)",
       subtitle = "Punkt na przekątnej = średnia prognoza w grupie równa średniemu przychodowi",
       x = "Średni przewidywany przychód w grupie (zł)", y = "Średni rzeczywisty przychód (zł)") + motyw
p5   # ggsave("przychod-kalibracja.svg", p5, width = 10, height = 7)
Wynik w R
          n_test suma_rzeczywista
         3600.00         14187.54
                            suma_przewidywana suma_do_rzeczywistej  MAE  RMSE
log(y + 1), potem exp − 1              977.24                 0.07 4.17 29.77
zwykła regresja (MNK)                14487.14                 1.02 7.38 29.34
dwuczęściowy: logit × gamma          14761.72                 1.04 7.29 29.28
Tweedie                              14734.34                 1.04 7.29 29.28
                            udzial_top10_proc
log(y + 1), potem exp − 1               29.03
zwykła regresja (MNK)                   31.62
dwuczęściowy: logit × gamma             30.02
Tweedie                                 30.02
                          model decyl prognoza rzeczywisty
1     log(y + 1), potem exp − 1     1     0.04        0.52
5     log(y + 1), potem exp − 1     5     0.24        2.19
9     log(y + 1), potem exp − 1     9     0.43        9.85
10    log(y + 1), potem exp − 1    10     0.53       11.44
11        zwykła regresja (MNK)     1    -0.54        0.52
51        zwykła regresja (MNK)     5     3.06        1.90
91        zwykła regresja (MNK)     9     6.72        8.61
101       zwykła regresja (MNK)    10    12.36       12.36
12  dwuczęściowy: logit × gamma     1     0.80        0.52
52  dwuczęściowy: logit × gamma     5     2.62        2.26
92  dwuczęściowy: logit × gamma     9     6.72       10.93
102 dwuczęściowy: logit × gamma    10    13.91       10.62
13                      Tweedie     1     0.83        0.52
53                      Tweedie     5     2.63        2.26
93                      Tweedie     9     6.64       10.93
103                     Tweedie    10    13.88       10.62
6. Test A/B i bootstrap różnicy ARPU: Rysunek 6
R
# Rysunek 6. Test A/B nowego pakietu startowego: różnica ARPU z przedziałem bootstrapowym
# Dane wejściowe: kol i motyw z przepisu 1. Nowe, osobne dane: 2 × 5000 nowych graczy (parametry ustalone ręcznie).
set.seed(655)
n <- 5000
grupa <- rep(c("A: obecna oferta", "B: tańszy pakiet startowy"), each = n)
placi_ab <- rbinom(2 * n, 1, ifelse(grupa == "A: obecna oferta", .070, .090))
kwota_ab <- rlnorm(2 * n, ifelse(grupa == "A: obecna oferta", 3.1, 2.85), 1.2)
ab <- data.frame(grupa, przychod = ifelse(placi_ab == 1, round(kwota_ab, 2), 0))
wA <- ab$przychod[ab$grupa == "A: obecna oferta"]; wB <- ab$przychod[ab$grupa != "A: obecna oferta"]

# Dwie części wyniku: odsetek płacących i średnia kwota płacącego; razem – ARPU
round(rbind(A = c(placacy_proc = 100 * mean(wA > 0), ARPPU = mean(wA[wA > 0]), ARPU = mean(wA), maks = max(wA)),
            B = c(placacy_proc = 100 * mean(wB > 0), ARPPU = mean(wB[wB > 0]), ARPU = mean(wB), maks = max(wB))), 2)
pt <- prop.test(c(sum(wB > 0), sum(wA > 0)), c(n, n))              # różnica odsetków płacących, B − A
round(c(roznica_pp = 100 * (mean(wB > 0) - mean(wA > 0)), dolna = 100 * pt$conf.int[1], gorna = 100 * pt$conf.int[2],
        p = pt$p.value), 3)
tw <- t.test(wB, wA)                                               # test Welcha na ARPU (dla porównania)
round(c(t = unname(tw$statistic), df = unname(tw$parameter), p = tw$p.value, dolna = tw$conf.int[1], gorna = tw$conf.int[2]), 3)

# Bootstrap: losujemy graczy ze zwracaniem osobno w każdej grupie (2000 powtórzeń)
set.seed(655)
roznice <- replicate(2000, mean(sample(wB, replace = TRUE)) - mean(sample(wA, replace = TRUE)))
ci_ab <- quantile(roznice, c(.025, .975))
round(c(roznica_ARPU = mean(wB) - mean(wA), dolna = unname(ci_ab[1]), gorna = unname(ci_ab[2])), 2)
# Jak bardzo wynik zależy od jednego gracza: różnica ARPU bez największego wydatku w każdej grupie
round(mean(wB[-which.max(wB)]) - mean(wA[-which.max(wA)]), 2)

p6 <- ggplot(data.frame(roznice), aes(roznice)) +
  annotate("rect", xmin = ci_ab[1], xmax = ci_ab[2], ymin = -Inf, ymax = Inf, fill = kol[["tweedie"]], alpha = 0.2) +
  geom_histogram(bins = 40, fill = "grey60", colour = "white") +
  geom_vline(xintercept = 0, linetype = "dashed", colour = "grey30") +
  geom_vline(xintercept = mean(wB) - mean(wA), colour = kol[["akcent"]], linewidth = 1) +
  annotate("label", x = mean(wB) - mean(wA), y = Inf, vjust = 1.3, size = 3.6,
           label = gsub("-", "−", sprintf("B − A = %.2f zł\n95%% CI [%.2f, %.2f]", mean(wB) - mean(wA), ci_ab[1], ci_ab[2]))) +
  labs(title = "Różnica ARPU (B − A) w 2000 próbach bootstrapowych",
       subtitle = "Pomarańczowe pole: 95% przedział percentylowy; linia przerywana: brak różnicy",
       x = "Różnica przychodu na gracza w 30 dniach (zł)", y = "Liczba prób bootstrapowych") + motyw
p6   # ggsave("przychod-test-ab.svg", p6, width = 10, height = 4.8)
Wynik w R
  placacy_proc ARPPU ARPU    maks
A          7.5 51.10 3.83 1509.78
B          9.2 35.68 3.28  694.14
roznica_pp      dolna      gorna          p
     1.700      0.596      2.804      0.002
       t       df        p    dolna    gorna
  -0.928 8094.416    0.354   -1.712    0.612
roznica_ARPU        dolna        gorna
       -0.55        -1.70         0.53
[1] -0.39
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – różowy (log(y + 1) / bez smearingu)" = c("#D55E00", "#CC79A7"),
             "błękit – niebieski (dwa smearingi)" = c("#56B4E9", "#0072B2"),
             "niebieski – zielony (smearing / gamma)" = c("#0072B2", "#009E73"),
             "zielony – pomarańczowy (gamma / Tweedie)" = c("#009E73", "#E69F00"),
             "cynober – zielony (log(y + 1) / gamma)" = c("#D55E00", "#009E73"),
             "cynober – pomarańczowy (log(y + 1) / Tweedie)" = c("#D55E00", "#E69F00"),
             "szary – pomarańczowy (MNK / Tweedie)" = c("#8C8C8C", "#E69F00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k)
  c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)), protanopia = roznica(protan(k))))), 1)
Wynik w R
                                              widzenie_typowe deuteranopia
cynober – różowy (log(y + 1) / bez smearingu)            74.3         70.2
błękit – niebieski (dwa smearingi)                       26.4         24.7
niebieski – zielony (smearing / gamma)                   70.1         55.4
zielony – pomarańczowy (gamma / Tweedie)                 88.7         66.3
cynober – zielony (log(y + 1) / gamma)                  102.4         53.5
cynober – pomarańczowy (log(y + 1) / Tweedie)            33.4         18.4
szary – pomarańczowy (MNK / Tweedie)                     77.5         74.8
czerwony – zielony (do unikania)                        121.7         21.1
                                              protanopia
cynober – różowy (log(y + 1) / bez smearingu)       71.9
błękit – niebieski (dwa smearingi)                  24.6
niebieski – zielony (smearing / gamma)              58.0
zielony – pomarańczowy (gamma / Tweedie)            51.5
cynober – zielony (log(y + 1) / gamma)              37.3
cynober – pomarańczowy (log(y + 1) / Tweedie)       24.9
szary – pomarańczowy (MNK / Tweedie)                70.4
czerwony – zielony (do unikania)                    31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Regresję liniową, logistyczną i gamma oszacowano funkcjami lm() i glm() (pakiet stats), regresję Tweedie – funkcją glm() z rodziną tweedie() z pakietu statmod, a gęstość rozkładu Tweedie do profilu wiarygodności policzono funkcją dtweedie() z pakietu tweedie. Rysunki wykonano w ggplot2 z pakietem scales, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- statmod (wersja 1.5.2): Giner, G., & Smyth, G. K. (2016). statmod: Probability calculations for the inverse Gaussian distribution. The R Journal, 8(1), 339–351. https://doi.org/10.32614/RJ-2016-024
- tweedie (wersja 3.1.0): Dunn, P. K. (2026). tweedie: Evaluation of Tweedie exponential family models (R package version 3.1.0) [Computer software]. https://CRAN.R-project.org/package=tweedie
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Kiedy użyć modelu dwuczęściowego, a kiedy regresji Tweedie dla przychodu?
Oba modele dobrze przewidują średni przychód; w przykładzie dały prawie te same prognozy na zbiorze testowym (RMSE po 29.28 zł). Model dwuczęściowy wybierz, gdy chcesz wiedzieć, czy grupa różni się odsetkiem płacących, czy kwotami. Tweedie wybierz, gdy wystarczy jeden iloraz średnich na predyktor i prosty opis w tabeli.
Dlaczego nie liczyć regresji na log(y + 1)?
Bo powrót do złotówek przez exp(ŷ) − 1 daje coś bliższego medianie niż średniej, a przy wielu zerach – prawie zero. W przykładzie model przewidział 977.24 zł przychodu wobec 14 187.54 zł w rzeczywistości. Do tego wynik zależy od jednostki (złote czy grosze), bo stała „+1” ma inną wagę.
Co to jest smearing Duana?
To poprawka przy powrocie z regresji na logarytmie do skali pierwotnej: prognozę exp(ŷ) mnoży się przez średnią z exp(reszt) (Duan, 1983). W przykładzie czynnik wynosił 2.014. Gdy rozrzut kwot różni się między grupami, licz czynnik osobno w grupach albo użyj regresji gamma, która modeluje średnią wprost.
Jak wybrać parametr mocy p w regresji Tweedie?
Dopasuj model dla siatki wartości p między 1 a 2 i wybierz tę z największym logarytmem wiarygodności (profil wiarygodności). W przykładzie maksimum wypadło przy p = 1.53, 95% CI [1.51, 1.55]. W R służy do tego funkcja tweedie_profile() z pakietu tweedie albo prosta pętla z glm() i dtweedie().
Jak porównać przychód na klienta w teście A/B?
Porównaj średni przychód na wszystkich klientów (ARPU), a nie tylko konwersję. Przedział dla różnicy policz bootstrapem po klientach albo testem Welcha i sprawdź, ile zmienia wynik jeden największy płatnik. W przykładzie konwersja wzrosła o 1.7 pp (p = .002), a ARPU spadło o 0.55 zł, 95% CI [−1.70, 0.53].
Powiązane hasła
Przeczytaj też
Liczba zakupów: zliczenia z zerami
2000 kont sklepu dla zwierząt: Poisson, NB, ZINB i hurdle, rootogram, wagi Akaikego, offset i co naprawdę zmienia karta stałego klienta – z kodem R.
Czytaj →PoradnikCzas na stronie – skośne metryki
Portal z ofertami pracy: średnia, mediana i średnia geometryczna, Welch, logarytm, Mann–Whitney, bootstrap, boty i symulacja mocy – kod R.
Czytaj →PoradnikWartość klienta w czasie (CLV)
Sklep z abonamentem na karmę: koncentracja marży, prosty wzór CLV, wrażliwość na retencję, model rezygnacji i bootstrap – pięć rysunków z kodem R.
Czytaj →Analizujesz przychód albo wydatki z wieloma zerami w pracy?
Pomożemy dobrać model dwuczęściowy lub Tweedie, poprawnie wrócić do złotówek, ocenić model na nowych danych i opisać wyniki z tabelą i rysunkami – tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Duan, N. (1983). Smearing estimate: A nonparametric retransformation method. Journal of the American Statistical Association, 78(383), 605–610. https://doi.org/10.1080/01621459.1983.10478017
- Duan, N., Manning, W. G., Morris, C. N., & Newhouse, J. P. (1983). A comparison of alternative models for the demand for medical care. Journal of Business & Economic Statistics, 1(2), 115–126. https://doi.org/10.1080/07350015.1983.10509330
- Jørgensen, B. (1987). Exponential dispersion models. Journal of the Royal Statistical Society: Series B (Methodological), 49(2), 127–145. https://doi.org/10.1111/j.2517-6161.1987.tb01685.x
- Manning, W. G., & Mullahy, J. (2001). Estimating log models: To transform or not to transform? Journal of Health Economics, 20(4), 461–494. https://doi.org/10.1016/s0167-6296(01)00086-8 ● Otwarty dostęp: pełny tekst
- Mullahy, J. (1986). Specification and testing of some modified count data models. Journal of Econometrics, 33(3), 341–365. https://doi.org/10.1016/0304-4076(86)90002-3 ● Otwarty dostęp
- Smyth, G. K., & Jørgensen, B. (2002). Fitting Tweedie's compound Poisson model to insurance claims data: Dispersion modelling. ASTIN Bulletin, 32(1), 143–157. https://doi.org/10.2143/ast.32.1.1020 ● Otwarty dostęp
Cytowania BibTeX
@article{duan1983smearing, author={Duan, Naihua}, title={{Smearing estimate: A nonparametric retransformation method}}, journal={Journal of the American Statistical Association}, year={1983}, volume={78}, number={383}, pages={605--610}, doi={10.1080/01621459.1983.10478017}}@article{duan1983comparison, author={Duan, Naihua and Manning, Willard G. and Morris, Carl N. and Newhouse, Joseph P.}, title={{A comparison of alternative models for the demand for medical care}}, journal={Journal of Business \& Economic Statistics}, year={1983}, volume={1}, number={2}, pages={115--126}, doi={10.1080/07350015.1983.10509330}}@article{jorgensen1987exponential, author={Jørgensen, Bent}, title={{Exponential dispersion models}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1987}, volume={49}, number={2}, pages={127--145}, doi={10.1111/j.2517-6161.1987.tb01685.x}}@article{manning2001estimating, author={Manning, Willard G. and Mullahy, John}, title={{Estimating log models: To transform or not to transform?}}, journal={Journal of Health Economics}, year={2001}, volume={20}, number={4}, pages={461--494}, doi={10.1016/s0167-6296(01)00086-8}}@article{mullahy1986specification, author={Mullahy, John}, title={{Specification and testing of some modified count data models}}, journal={Journal of Econometrics}, year={1986}, volume={33}, number={3}, pages={341--365}, doi={10.1016/0304-4076(86)90002-3}}@article{smyth2002fitting, author={Smyth, Gordon K. and Jørgensen, Bent}, title={{Fitting Tweedie's compound Poisson model to insurance claims data: Dispersion modelling}}, journal={ASTIN Bulletin}, year={2002}, volume={32}, number={1}, pages={143--157}, doi={10.2143/ast.32.1.1020}}