Co to jest model Tweedie?
Model Tweedie to uogólniony model liniowy z rozkładem z rodziny Tweediego, w której wariancja jest potęgą średniej: Var(Y) = φ·μp. Parametr mocy p wybiera znane przypadki: p = 0 – rozkład normalny, p = 1 – Poisson, p = 2 – gamma. Rodzina należy do wykładniczych modeli dyspersyjnych, których ogólne własności opisał Jørgensen (1987).
Najczęściej używa się przedziału 1 < p < 2. Wtedy Y jest sumą losowej liczby zmiennych gamma, a liczba składników ma rozkład Poissona (złożony rozkład Poissona–gamma). Gdy żadne zdarzenie nie zaszło, Y = 0, więc rozkład ma masę w zerze, a dla Y > 0 jest ciągły i prawoskośny. Tak wyglądają koszty leczenia, wydatki, opady czy czas poświęcony na zajęcie, które części osób w ogóle nie dotyczy. Smyth i Jørgensen (2002) opisali ten model dla roszczeń ubezpieczeniowych (poissonowska liczba roszczeń, koszty gamma) i pokazali, że opłaca się modelować także dyspersję.
Przykład
W symulowanych danych 400 osób 40.2% miało koszt równy 0. Średni koszt wyniósł 73.8 w grupie kontrolnej i 111.4 w grupie programu. Model Tweedie z p = 1.5 i logarytmiczną funkcją łączącą dał iloraz średnich 1.51, 95% CI [1.16, 1.96]. Funkcja tw() z mgcv oszacowała p = 1.355; dla danych generowanych z kształtem gamma 2 wartość teoretyczna to (2 + 2)/(2 + 1) = 1.333. Profil wiarygodności z tweedie_profile() dał p = 1.35, 95% CI [1.29, 1.40].
Na rysunku
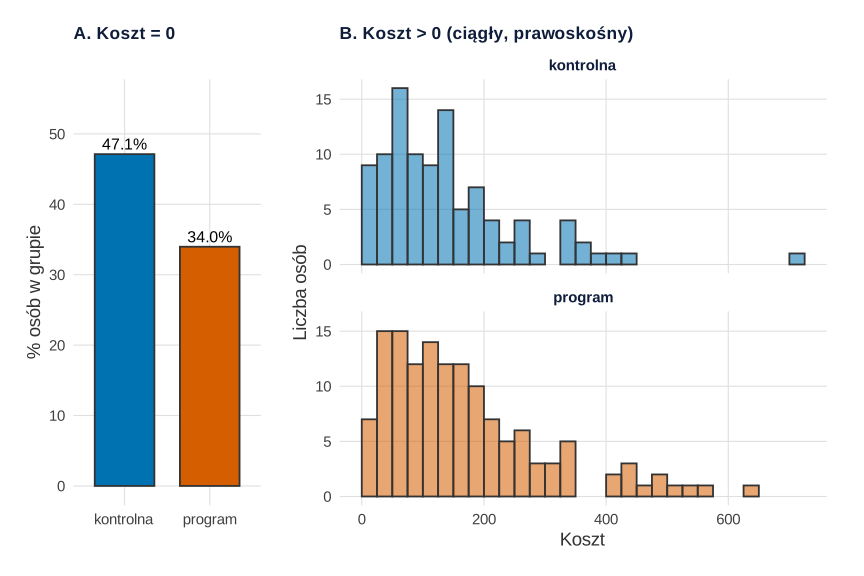
set.seed(639)).Co widać. Te same 400 kosztów co w przykładzie, rozdzielone na dwie części. Koszt równy 0 ma 47.1% osób w grupie kontrolnej i 34.0% w grupie programu (A). Koszty dodatnie są ciągłe i prawoskośne: mediana 128.3, maksimum 721.7 (B). Model Tweedie opisuje oba panele jednym rozkładem, a program zmienia jednocześnie odsetek zer i wysokość kwot.
Na co uważać. Zwykły histogram wrzuciłby zera do pierwszego przedziału razem z małymi kwotami i ukrył masę w zerze – dlatego zera są tu osobnym panelem. Rysunek nie mówi, czy zera i kwoty mają wspólny mechanizm; jeśli nie, rozważ model hurdle. O doborze szerokości przedziałów pisze wpis Rozkład zmiennej na wykresie.
Podpis do pracy:
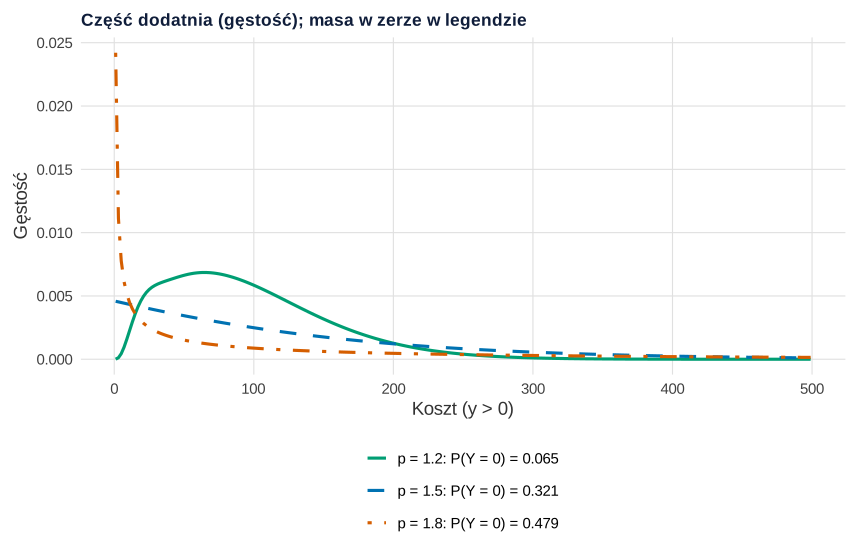
Co widać. Średnia μ = 90 i dyspersja φ = 16.7 są stałe, zmienia się tylko p. Im większe p, tym mniej zdarzeń w złożonym rozkładzie Poissona–gamma, więc więcej zer (od 0.065 przy p = 1.2 do 0.479 przy p = 1.8) i bardziej skośna część dodatnia. Przy p blisko 1 rozkład przypomina przeskalowany rozkład Poissona, przy p blisko 2 – rozkład gamma.
Na co uważać. Parametr mocy zmienia kształt całego rozkładu, a nie tylko odsetek zer, dlatego warto go szacować, a nie przyjmować z przyzwyczajenia. Wartości μ i φ ustawiono ręcznie (φ jak w modelu z przykładu); przy innych wartościach liczby się zmienią, kierunek – nie.
Podpis do pracy:
Ziarno set.seed(639) to ziarno danych z przykładu; nie było zmieniane. Rysunek 2 nie losuje. Rysunki na stronie różnią się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Koszty z przykładu: masa w zerze i prawoskośna część dodatnia (dane symulowane)
library(ggplot2)
library(patchwork)

kol <- c(kontrolna = "#0072B2", program = "#D55E00")   # paleta Okabe–Ito
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

set.seed(639)                                        # te same dane co w przykładzie wyżej
n <- 400
grupa <- rbinom(n, 1, 0.5)
liczba <- rpois(n, exp(log(0.8) + log(1.5) * grupa))
koszt <- sapply(liczba, function(k) sum(rgamma(k, shape = 2, scale = 50)))
d <- data.frame(koszt, grupa = factor(grupa, 0:1, c("kontrolna", "program")))
table(d$grupa)
zera <- aggregate(koszt ~ grupa, d, function(x) 100 * mean(x == 0))
names(zera)[2] <- "proc"
transform(zera, proc = round(proc, 1))
round(c(max = max(koszt), mediana_dodatnich = median(koszt[koszt > 0])), 1)

pA <- ggplot(zera, aes(grupa, proc, fill = grupa)) +
  geom_col(width = 0.7, colour = "grey20") +
  geom_text(aes(label = sprintf("%.1f%%", proc)), vjust = -0.4, size = 4.2) +
  scale_fill_manual(values = kol) + scale_y_continuous(limits = c(0, 55), breaks = seq(0, 50, 10)) +
  labs(title = "A. Koszt = 0", x = NULL, y = "% osób w grupie") + motyw + theme(legend.position = "none")
pB <- ggplot(subset(d, koszt > 0), aes(koszt, fill = grupa)) +
  geom_histogram(aes(y = after_stat(count)), binwidth = 25, boundary = 0, colour = "grey20",
                 position = "identity", alpha = 0.55) +
  facet_wrap(~ grupa, ncol = 1) +
  scale_fill_manual(values = kol, guide = "none") +
  labs(title = "B. Koszt > 0 (ciągły, prawoskośny)", x = "Koszt", y = "Liczba osób") + motyw
p1 <- pA + pB + plot_layout(widths = c(1, 2.6))
p1
Wynik w R (rysunek 1)
kontrolna   program
      191       209
      grupa proc
1 kontrolna 47.1
2   program 34.0
              max mediana_dodatnich
            721.7             128.3
Kod R rysunku 2
# Rysunek 2. Rozkład Tweedie o tej samej średniej (μ = 90) i dyspersji (φ = 16.7) dla trzech wartości p
library(ggplot2)
library(tweedie)

motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

mu <- 90; phi <- 16.7                                # wartości ustawione ręcznie (φ jak w modelu z przykładu)
p <- c(1.2, 1.5, 1.8)
P0 <- exp(-mu^(2 - p) / (phi * (2 - p)))             # P(Y = 0) = exp(−λ), λ = μ^(2−p) / [φ(2−p)]
round(cbind(p, lambda = mu^(2 - p) / (phi * (2 - p)), P0 = P0,
            P0_dtweedie = sapply(p, function(pp) dtweedie(0, mu = mu, phi = phi, power = pp))), 3)
y <- seq(1, 500, by = 2)
g <- do.call(rbind, lapply(seq_along(p), function(i)
  data.frame(y, gest = dtweedie(y, mu = mu, phi = phi, power = p[i]),
             p = sprintf("p = %.1f: P(Y = 0) = %.3f", p[i], P0[i]))))

kol <- c("#009E73", "#0072B2", "#D55E00")
p2 <- ggplot(g, aes(y, gest, colour = p, linetype = p)) +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = c("solid", "dashed", "dotdash"), name = NULL) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  labs(title = "Część dodatnia (gęstość); masa w zerze w legendzie", x = "Koszt (y > 0)", y = "Gęstość") + motyw
p2
Wynik w R (rysunek 2)
       p lambda    P0 P0_dtweedie
[1,] 1.2  2.739 0.065       0.065
[2,] 1.5  1.136 0.321       0.321
[3,] 1.8  0.736 0.479       0.479
Jak opisać w pracy
Na co uważać
- Jeden mechanizm dla zer i kwot. Predyktor zmienia jednocześnie szansę zera i wysokość kwoty. Gdy te procesy są różne, lepszy bywa model hurdle (część binarna + dodatnia).
- Parametr p wybierz świadomie – oszacuj go albo porównaj wiarygodność profilową dla kilku wartości; podaj go w pracy.
- Nie dla zliczeń. Dla liczb całkowitych zostań przy Poissonie, modelu ujemnym dwumianowym lub modelu z nadmiarem zer.
- Nie zastępuj go log(y + 1). Transformacja logarytmiczna ze stałą zmienia wynik zależnie od jej wyboru, a model Tweedie pracuje na skali oryginalnej.
Model Tweedie w R
Kod generuje koszty jako sumę poissonowskiej liczby kwot gamma, dopasowuje glm() z rodziną tweedie() z pakietu statmod (p = 1.5) i model gam() z rodziną tw() z mgcv, który szacuje p, a na koniec liczy profil wiarygodności dla p funkcją tweedie_profile() z pakietu tweedie. Liczby w tekście pochodzą z tego kodu.
Iloraz średnich kosztów i oszacowanie parametru mocy
R
# Model Tweedie (1 < p < 2): masa w zerze i dodatnie kwoty ciągłe (dane symulowane)
suppressPackageStartupMessages({library(statmod); library(mgcv)})
set.seed(639)
n <- 400
grupa <- rbinom(n, 1, 0.5)                          # np. program wsparcia (1) vs brak (0)
lam <- exp(log(0.8) + log(1.5) * grupa)             # średnia liczba wizyt
liczba <- rpois(n, lam)                             # ile razy coś się wydarzyło
koszt <- sapply(liczba, function(k) sum(rgamma(k, shape = 2, scale = 50)))  # suma kwot (0, gdy k = 0)
d <- data.frame(koszt, grupa)
round(c(odsetek_zer = mean(koszt == 0), srednia_0 = mean(koszt[grupa == 0]),
        srednia_1 = mean(koszt[grupa == 1]), iloraz_srednich = mean(koszt[grupa == 1]) / mean(koszt[grupa == 0])), 3)
# glm z rodziną Tweedie (statmod): p = 1.5, łącznik logarytmiczny (link.power = 0)
m_tw <- glm(koszt ~ grupa, family = tweedie(var.power = 1.5, link.power = 0), data = d)
round(c(iloraz_srednich_model = exp(unname(coef(m_tw)["grupa"])),
        exp(confint.default(m_tw)["grupa", ]), dyspersja = summary(m_tw)$dispersion), 3)
# mgcv: tw() szacuje parametr mocy p razem z modelem
m_gam <- gam(koszt ~ grupa, family = tw(), data = d, method = "REML")
round(c(p_oszacowane = m_gam$family$getTheta(TRUE), iloraz_srednich_gam = exp(unname(coef(m_gam)["grupa"]))), 3)
# Teoria dla tych danych: p = (alfa + 2) / (alfa + 1) przy kształcie gamma alfa = 2
round((2 + 2) / (2 + 1), 3)
# Pakiet tweedie: profil wiarygodności dla p (z wygładzeniem i 95% CI)
invisible(capture.output(                          # capture.output() ukrywa pasek postępu
  prof <- tweedie::tweedie_profile(koszt ~ grupa, data = d, p.vec = seq(1.2, 1.8, by = 0.1))))
round(c(p_profil = prof$p.max, p_dolna = prof$ci[1], p_gorna = prof$ci[2]), 3)
Wynik w R
    odsetek_zer       srednia_0       srednia_1 iloraz_srednich
          0.402          73.825         111.428           1.509
iloraz_srednich_model                 2.5 %                97.5 %
                1.509                 1.162                 1.960
            dyspersja
               16.739
       p_oszacowane iloraz_srednich_gam
              1.355               1.509
[1] 1.333
p_profil  p_dolna  p_gorna
   1.347    1.292    1.401
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety statmod 1.5.2, mgcv 1.9-4 i tweedie 3.1.0). Rysunki 1 i 2 wykonano w pakiecie ggplot2 4.0.2, panele rysunku 1 złożono pakietem patchwork 1.3.2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- statmod (wersja 1.5.2): Giner, G., & Smyth, G. K. (2016). statmod: Probability calculations for the inverse Gaussian distribution. The R Journal, 8(1), 339–351. https://doi.org/10.32614/RJ-2016-024
- mgcv (wersja 1.9-4): Wood, S. N. (2011). Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 73(1), 3–36. https://doi.org/10.1111/j.1467-9868.2010.00749.x
- tweedie (wersja 3.1.0): Dunn, P. K. (2026). tweedie: Evaluation of Tweedie exponential family models (R package version 3.1.0) [Computer software]. https://CRAN.R-project.org/package=tweedie
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kiedy wybrać model Tweedie, a kiedy model hurdle?
Model Tweedie zakłada jeden proces: zero oznacza, że nie zaszło żadne zdarzenie, a predyktory działają jednocześnie na szansę zera i wysokość kwoty. Model hurdle ma dwie osobne części, binarną i dodatnią, z własnymi współczynnikami. Jeśli spodziewasz się, że różne czynniki decydują o tym, czy ktoś w ogóle ponosi koszt, i o tym, ile wydaje, wybierz model hurdle.
Jak wybrać parametr mocy p?
Oszacuj go razem z modelem (np. rodzina tw() w mgcv) albo dopasuj model dla kilku wartości p między 1 a 2 i wybierz tę o najwyższej wiarygodności profilowej. Współczynniki zwykle niewiele zależą od dokładnej wartości p, ale błędy standardowe już tak, dlatego podaj p w pracy.
Czy regresja gamma nie wystarczy?
Nie, jeśli w danych są zera. Rozkład gamma dotyczy tylko wartości dodatnich, więc regresja gamma wymaga usunięcia zer albo dodania stałej. Model Tweedie z 1 < p < 2 obejmuje zera bez takich zabiegów; gdy zer nie ma, p bliskie 2 daje wynik zbliżony do regresji gamma.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikPrzychód z zerami: dwie części i Tweedie
12 000 graczy gry mobilnej, 93% zer: logit × gamma, smearing, Tweedie z profilem p, kalibracja i test A/B przychodu – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Jørgensen, B. (1987). Exponential dispersion models. Journal of the Royal Statistical Society: Series B (Methodological), 49(2), 127–145. https://doi.org/10.1111/j.2517-6161.1987.tb01685.x
- Smyth, G. K., & Jørgensen, B. (2002). Fitting Tweedie's compound Poisson model to insurance claims data: Dispersion modelling. ASTIN Bulletin, 32(1), 143–157. https://doi.org/10.2143/ast.32.1.1020 ● Otwarty dostęp
Cytowania BibTeX
@article{jorgensen1987exponential, author={Jørgensen, Bent}, title={{Exponential dispersion models}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1987}, volume={49}, number={2}, pages={127--145}, doi={10.1111/j.2517-6161.1987.tb01685.x}}@article{smyth2002fitting, author={Smyth, Gordon K. and Jørgensen, Bent}, title={{Fitting Tweedie's compound Poisson model to insurance claims data: Dispersion modelling}}, journal={ASTIN Bulletin}, year={2002}, volume={32}, number={1}, pages={143--157}, doi={10.2143/ast.32.1.1020}}