Przykład: dziesięciu przewoźników autokarowych
Fikcyjny przewoźnik C wozi pasażerów autokarami dalekobieżnymi w całym kraju i rozważa przejęcie mniejszego, regionalnego przewoźnika F ze wschodu. Zarząd pyta: jak bardzo skupiony jest ten rynek i ile zmieni się po fuzji? Analityk ma próbę 6000 biletów z fikcyjnej platformy sprzedaży: województwo wyjazdu, przewoźnika i cenę. Na rynku jeździ dziesięciu przewoźników (A–J). Pięciu (A–E) obsługuje cały kraj, pięciu (F–J) to firmy regionalne, silne w dwóch województwach każda. Dane pobierzesz jako koncentracja-bilety-autokarowe-proba.csv.
Dane są fikcyjne i znamy prawdziwe udziały, z których losowaliśmy bilety. Ręcznie ustawiliśmy: udział województw w ruchu (od 2.4% w opolskim do 14.2% w mazowieckim), ogólnokrajową siłę przewoźników, ich „swoje” województwa, średnie ceny biletów (od 46 zł u taniego przewoźnika A do 86 zł u D) i rozrzut cen. Po pierwszym uruchomieniu nie zmienialiśmy ani tych parametrów, ani ziaren (695 i 6951) – poprawialiśmy tylko wygląd rysunków.
Inne analizy do prac z ekonomii zbiera przegląd statystyka w pracy z zarządzania i ekonomii.
Rysunek 1: udziały, CR4 i HHI
Udział w rynku to część całości przypadająca na firmę: liczba biletów przewoźnika podzielona przez liczbę wszystkich biletów albo jego przychód podzielony przez przychód rynku. Z udziałów liczy się dwie najpopularniejsze miary koncentracji:
- CR4 (wskaźnik koncentracji czterech firm) – suma udziałów czterech największych firm, w %;
- HHI (wskaźnik Herfindahla–Hirschmana) – suma kwadratów udziałów wszystkich firm, gdy udziały są w procentach. Wynik leży między prawie 0 (bardzo wiele małych firm) a 10 000 (monopol).
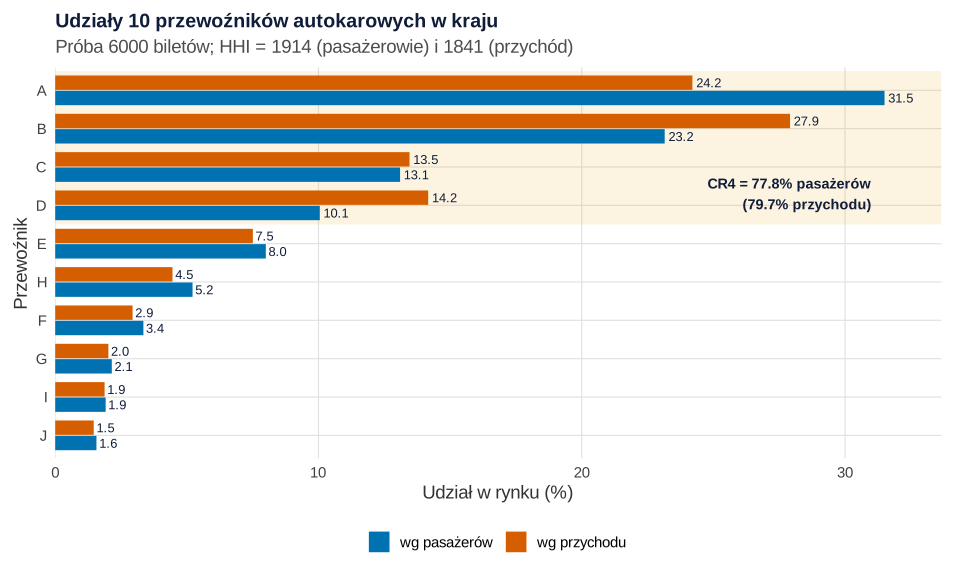
set.seed(695)).Co widać. Czterej najwięksi przewoźnicy mają 77.8% pasażerów. HHI liczymy wprost: 31.5² + 23.2² + 13.1² + … + 1.6² = 992 + 536 + 172 + 101 + 64 + 27 + 11 + 5 + 4 + 2 = 1914. Lider A daje ponad połowę wyniku, a pięciu najmniejszych przewoźników razem – 49 punktów. Wg przychodu HHI wynosi 1841, a liderem jest B (27.9%), bo jego bilety są droższe; tani A ma 31.5% pasażerów, ale tylko 24.2% przychodu. Prawdziwe wartości, z których losowaliśmy bilety, to 1930 i 1831.
Jak może zmylić. CR4 nie widzi, jak udziały rozkładają się w pierwszej czwórce ani poza nią: 77.8% to tyle samo przy czterech firmach po 19.5%, co przy jednej z 70%. HHI to uwzględnia, bo bierze wszystkie firmy, a duże waży mocniej. Hall i Tideman (1967) uznali sam wskaźnik koncentracji za analitycznie słabszy, choć w danych z branż dawał oszacowania niezbyt odległe od HHI. Podobnie Bailey i Boyle (1971) nie znaleźli miary wyraźnie lepszej od pozostałych. Gdy znasz tylko udziały kilku największych firm, HHI da się i tak ograniczyć z dołu i z góry, a przedział bywa wąski nawet przy ok. 30% rynku nieznanym (Naldi i Flamini, 2014). W praktyce podaj obie miary.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: jak czytać HHI
Karta pokazuje wynik na tle rynków wzorcowych i zbiera potrzebne rachunki.
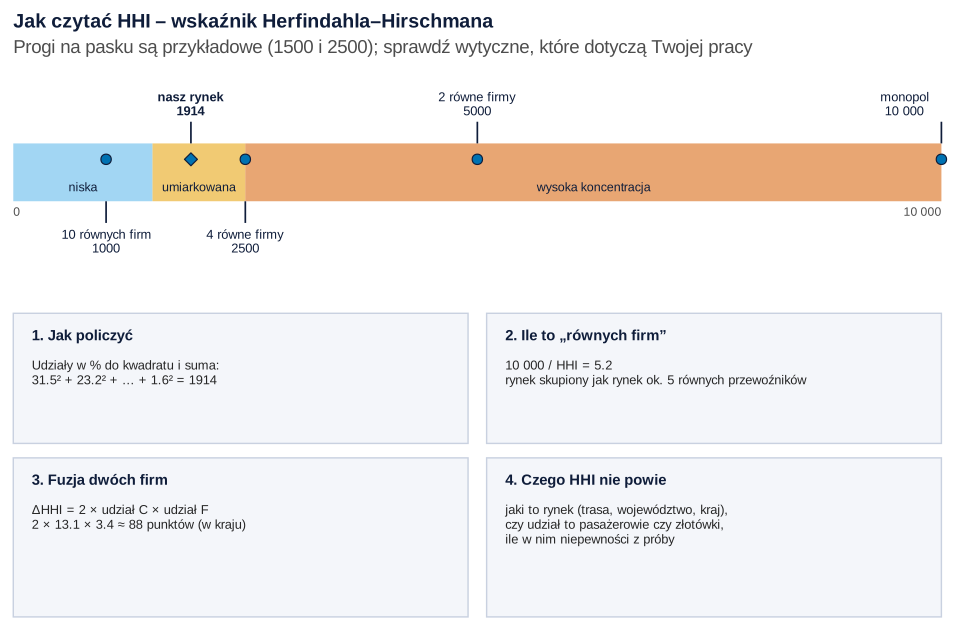
Co widać. Rynek N równych firm ma HHI = 10 000 / N: 10 firm daje 1000, 4 firmy 2500, 2 firmy 5000. Odwracając wzór, dostajemy ekwiwalent liczby równych firm: 10 000 / 1914 = 5.2. Rynek dziesięciu przewoźników jest więc skupiony tak, jak rynek ok. pięciu równych firm.
Jak może zmylić. Strefy na pasku są przykładowe. Organy ochrony konkurencji w różnych krajach używają podobnie zbudowanych progów, ale ich wartości różnią się i były zmieniane. Jeśli piszesz o konkretnej sprawie, sprawdź aktualny dokument i zacytuj go. Nocke i Whinston (2022) pokazują poza tym, że przy wstępnej ocenie fuzji ważniejsza od poziomu HHI jest jego zmiana. Do tego wrócimy przy rysunku 5.
Podpis do pracy:
Rysunek 3: krzywa Lorenza i Gini – dlaczego mylą przy kilku firmach
Krzywa Lorenza (Lorenz, 1905) układa firmy od najmniejszej i pokazuje, jaką część rynku mają kolejne firmy łącznie. Indeks Giniego to dwukrotne pole między nią a przekątną. W pakiecie ineq liczymy oba dla udziałów naszych przewoźników.
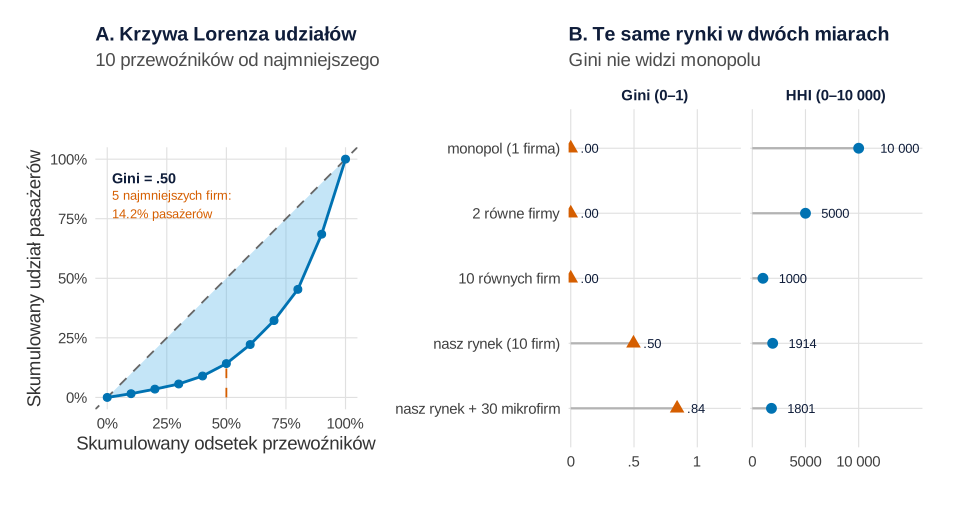
set.seed(695)).Co widać. Pięciu najmniejszych przewoźników ma razem 14.2% pasażerów, a Gini udziałów wynosi .50 (z poprawką na małą liczbę jednostek .55). Panel B pokazuje sedno: Gini mierzy nierówność wielkości firm, a nie to, ile firm dzieli rynek. Monopol, duopol i dziesięć równych firm mają Gini = 0, bo w każdym z tych rynków firmy są „równe”. HHI odróżnia je od razu: 10 000, 5000 i 1000. Gdy do naszego rynku dołożymy 30 mikroprzewoźników po 0.1%, Gini skacze do .84 („dużo większa nierówność”), a HHI spada z 1914 do 1801, bo rynek stał się odrobinę mniej skupiony.
Jak może zmylić. Przy kilku firmach Gini ma też kłopot techniczny: wzór klasyczny przy 10 jednostkach nie przekroczy 0.9 i zaniża nierówność w małych zbiorach (Deltas, 2003). Krzywa Lorenza dobrze opisuje różnice wielkości firm, ale koncentrację mierz HHI. Inna miara różnorodności udziałów, entropia Shannona, też zależy od liczby firm i ich równości jednocześnie.
Podpis do pracy:
Rysunek 4: HHI w województwach – który rynek?
Pasażer z Rzeszowa nie wybiera między wszystkimi przewoźnikami w kraju, tylko między tymi, którzy jeżdżą z jego miasta. Liczymy więc HHI osobno w każdym województwie (od 143 do 873 biletów) i rysujemy je na kartogramie w uproszczonej wersji: kafelki leżą mniej więcej tam, gdzie województwa na mapie.
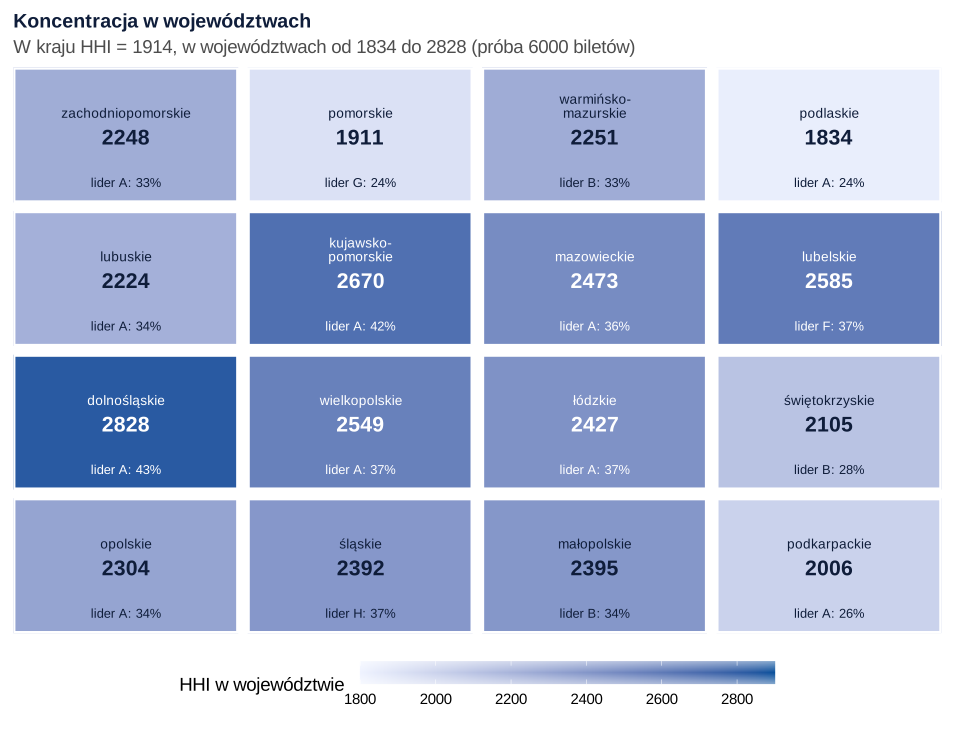
set.seed(695)).Co widać. HHI w województwach waha się od 1834 (podlaskie) do 2828 (dolnośląskie, gdzie A ma 43.5% pasażerów). Średnia ważona liczbą biletów to 2384 – o 470 punktów więcej niż HHI kraju (1914). W czterech województwach HHI przekracza 2500. Liderzy też się zmieniają: w lubelskim prowadzi regionalny F (36.7%), w śląskim H (37.4%), a w małopolskim, warmińsko-mazurskim i świętokrzyskim B.
Jak może zmylić. HHI kraju jest niższy niż w 14 z 16 województw, bo przewoźnicy regionalni dzielą kraj między siebie: każdy jest mały w skali kraju, a duży u siebie. Wynik zależy od definicji rynku, a ta jest decyzją merytoryczną, nie statystyczną. Na pojedynczej trasie, gdzie jeżdżą dwie firmy, HHI wyniesie kilka tysięcy. Jeśli dane mają współrzędne, zależność między sąsiednimi regionami zbadasz metodami z wpisu sprzedaż na mapie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: fuzja C i F – ΔHHI
Gdy łączą się firmy o udziałach sC i sF, przed fuzją do HHI wchodzą dwa kwadraty, a po fuzji – kwadrat sumy. Reszta rynku się nie zmienia (przy założeniu, że klienci zostają), więc:
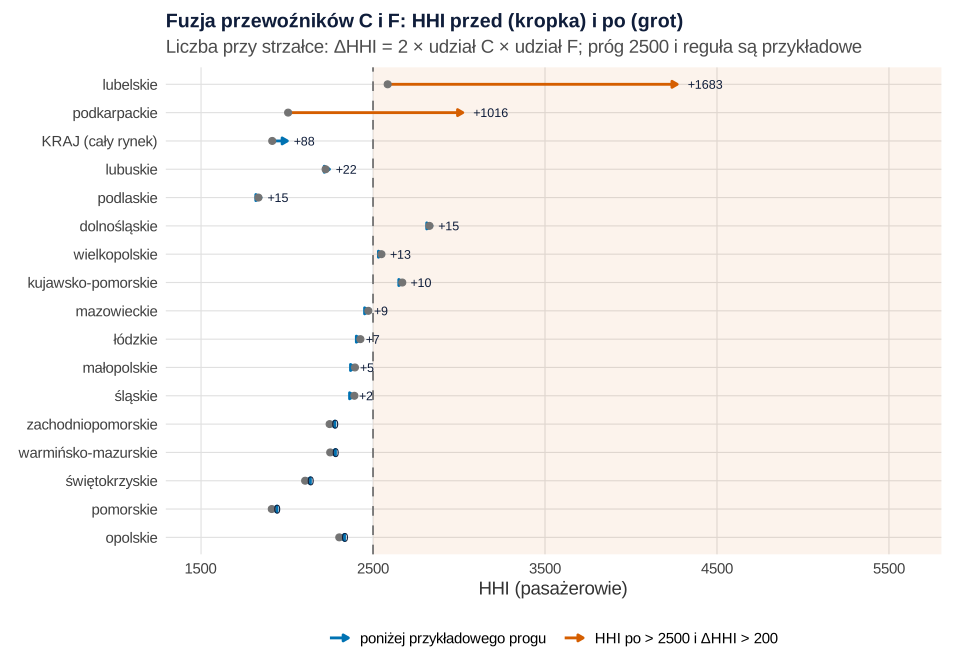
set.seed(695)).Co widać. W kraju C ma 13.1%, a F 3.4% pasażerów, więc ΔHHI ≈ 2 × 13.1 × 3.4 = 88 punktów (z dokładnych udziałów 87.8): HHI rośnie z 1914 do 2002. Ale F jeździ prawie tylko w dwóch województwach, w których także C jest silny. W lubelskim (C 22.9%, F 36.7%) ΔHHI wynosi 1683, a HHI po fuzji 4269; w podkarpackim +1016, do 3022. W pięciu województwach F nie sprzedał w próbie ani jednego biletu, więc tam ΔHHI = 0.
Jak może zmylić. Reguła na rysunku (HHI po fuzji powyżej 2500 i ΔHHI powyżej 200) jest przykładowa, a wzór zakłada, że po fuzji połączona firma zatrzyma wszystkich klientów obu firm. W rzeczywistości część pasażerów przejdzie do konkurencji albo przyjdą nowi przewoźnicy. Nocke i Whinston (2022) uzasadniają, dlaczego przy wstępnej selekcji fuzji warto patrzeć na samą zmianę koncentracji, i oceniają, że obecne progi są raczej zbyt łagodne. Stąd lekcja z rysunku: licz ΔHHI na rynkach, na których firmy naprawdę się spotykają, a nie tylko w skali kraju.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: niepewność HHI z próby biletów
Udziały policzyliśmy z 6000 biletów, nie ze wszystkich. Inna próba dałaby inne HHI. Wzory na błąd standardowy HHI z próby istnieją, a Taplin (2003) zaleca podawać go obok wartości indeksu. Prościej użyć bootstrapu (Efron, 1979): losujemy ze zwracaniem 6000 biletów z naszych 6000, liczymy wszystkie miary i powtarzamy to 2000 razy. 2.5. i 97.5. centyl wyników to 95% przedział ufności percentylowy. Dla małych prób rozważ przedział BCa; mechanikę bootstrapu krok po kroku pokazuje wpis bootstrap na obrazkach.
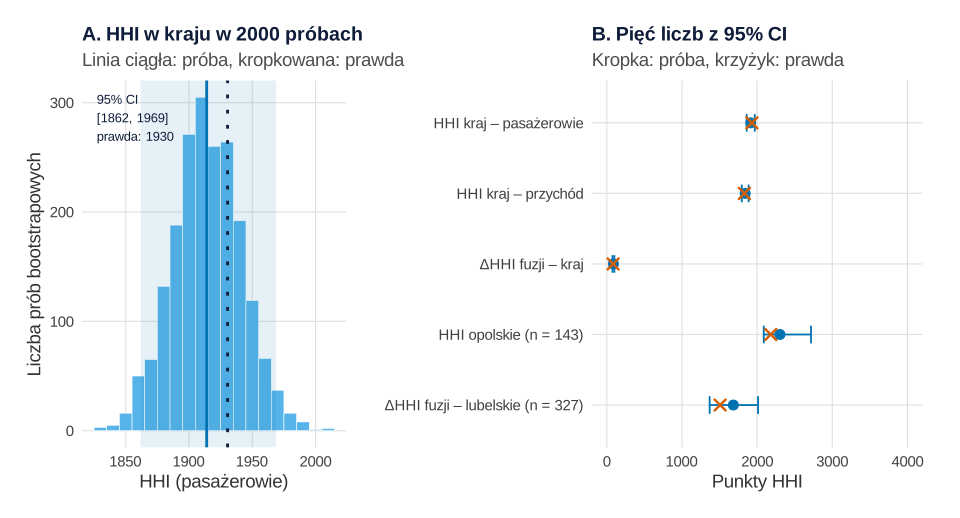
set.seed(6951)).Co widać. HHI kraju: 1914, 95% CI [1862, 1969]; prawda (1930) leży w środku. Wg przychodu: 1841 [1796, 1887]; ΔHHI fuzji w kraju: 88 [75, 100]. W małym województwie jest gorzej: HHI opolskiego to 2304 z przedziałem [2088, 2717] – szerokim na ponad 600 punktów przy 143 biletach. ΔHHI w lubelskim (327 biletów) to 1683 [1368, 2012], prawda 1507. Nawet dolna granica jest jednak wielokrotnie wyższa od przykładowego progu 200 – wniosek o lubelskim nie zależy od losu próby.
Jak może zmylić. HHI z małej próby jest zawyżony: przypadkowe różnice udziałów podnoszone do kwadratu zawsze dodają punkty. W opolskim średnia z prób bootstrapowych jest o 59 punktów wyższa niż wynik z próby, a sam wynik o 123 punkty przewyższa prawdę. Przy 6000 biletów w kraju obciążenie jest pomijalne (0 punktów), co zgadza się z tym, że obciążenie indeksu Herfindahla z próby jest zwykle niewielkie (Taplin, 2003). Bootstrap ujmuje tylko losowość próby. Gdyby platforma nie sprzedawała biletów jakiegoś przewoźnika, przedział byłby wąski i nadal błędny.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w firmie
- Najpierw zdefiniuj rynek. Dla przewoźnika C pytanie „czy fuzja z F coś zmieni?” ma dwie odpowiedzi: w kraju +88 punktów, w lubelskim +1683 (rysunek 5). Analizę fuzji zacznij od mapy, na której obie firmy sprzedają bilety.
- Licz udziały na dwa sposoby. Wg pasażerów liderem jest A, wg przychodu B (rysunek 1). Przy cenach – tak jak w pozycji cenowej wobec konkurencji – ważniejszy bywa przychód, przy przepustowości autokarów – pasażerowie.
- Raportuj HHI z przedziałem i ekwiwalentem firm. „HHI 1914, 95% CI [1862, 1969], czyli rynek jak ok. 5 równych przewoźników” mówi więcej niż sama liczba (rysunki 2 i 6).
- Nie porównuj koncentracji Gini. Wejście kilkudziesięciu mikrofirm podniesie Gini, choć konkurencja się nie zmniejszy (rysunek 3).
- Zestaw HHI z innymi danymi rynku. Skąd biorą się udziały, pokazują model atrakcyjności udziałów i dystrybucja a sprzedaż, a zmianę cen w czasie – indeks cen koszyka. Pamiętaj, że to analiza statystyczna, nie ocena prawna fuzji.
Jak opisać w pracy
Podaj definicję rynku (kraj, województwa), źródło i liczebność próby, sposób liczenia udziałów (pasażerowie i przychód), wzory CR4 i HHI, metodę szacowania niepewności i charakter progów. Ogólną budowę rozdziału empirycznego opisuje poradnik jak napisać pracę z zarządzania i ekonomii.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, funkcje hhi() i pkt() oraz dane, z których korzystają kolejne przepisy. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują dwa przepisy i każdy zaczyna od własnego set.seed(): 695 w przepisie 1 (udziały w województwach, próba biletów, ceny) i 6951 w przepisie 6 (2000 prób bootstrapowych); pozostałe przepisy nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): udziały województw w ruchu, siłę przewoźników (A 30, B 20, C 12, D 9, E 7, F–H po 3, I–J po 2.5), mnożniki „swoich” województw (9 dla przewoźników regionalnych, 0.1 poza nimi, 2.5 dla C w lubelskim i podkarpackim), rozrzut udziałów między województwami (SD = 0.25 na skali ln), średnie ceny biletów (46–86 zł) i rozrzut cen (SD = 0.35 na skali ln), liczebność próby (6000); w przepisach 2 i 5 – przykładowe progi 1500, 2500 i 200 punktów; w przepisie 3 – 30 mikrofirm po 0.1%. Po pierwszym uruchomieniu tych wartości nie zmieniano. Cały kod liczy się kilka sekund.
1. Dane, udziały, CR4 i HHI: Rysunek 1
R
# Rysunek 1. Fikcyjny rynek dalekobieżnych przewozów autokarowych: 10 przewoźników, 16 województw,
# próba 6000 biletów; udziały wg pasażerów i wg przychodu, CR4 i HHI
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# HHI: suma kwadratów udziałów wyrażonych w procentach (0–10 000)
hhi <- function(x) { u <- 100 * x / sum(x); sum(u^2) }
# Zapis punktów HHI na rysunkach: 1914, ale 10 000
pkt <- function(h) ifelse(round(h) >= 10000, formatC(round(h), format = "d", big.mark = " "), sprintf("%d", round(h)))

# Parametry ustawione ręcznie:
#   waga  – udział województwa w liczbie pasażerów kraju (%)
#   sila  – ogólnokrajowa „siła” przewoźnika; A–E jeżdżą w całym kraju, F–J to przewoźnicy regionalni
#   dom   – mnożnik siły w województwie: regionalni 9 w dwóch „swoich” województwach i 0.1 gdzie indziej,
#           C ma 2.5 w lubelskim i podkarpackim
#   szum  – losowe różnice udziałów między województwami (SD 0.25 na skali ln)
#   cena_sr – średnia cena biletu przewoźnika (zł); cena biletu z rozkładu lognormalnego, SD 0.35 na skali ln
woj <- c("dolnośląskie", "kujawsko-pomorskie", "lubelskie", "lubuskie", "łódzkie", "małopolskie",
         "mazowieckie", "opolskie", "podkarpackie", "podlaskie", "pomorskie", "śląskie",
         "świętokrzyskie", "warmińsko-mazurskie", "wielkopolskie", "zachodniopomorskie")
waga <- c(7.6, 5.4, 5.5, 2.7, 6.4, 8.9, 14.2, 2.4, 5.6, 3.0, 6.1, 11.4, 3.1, 3.5, 9.2, 5.0)
przew <- LETTERS[1:10]
sila <- c(A = 30, B = 20, C = 12, D = 9, E = 7, F = 3, G = 3, H = 3, I = 2.5, J = 2.5)
dom <- matrix(1, 16, 10, dimnames = list(woj, przew))
dom[, c("F", "G", "H", "I", "J")] <- 0.1
dom[c("lubelskie", "podkarpackie"), "F"] <- 9
dom[c("pomorskie", "warmińsko-mazurskie"), "G"] <- 9
dom[c("śląskie", "opolskie"), "H"] <- 9
dom[c("zachodniopomorskie", "lubuskie"), "I"] <- 9
dom[c("podlaskie", "świętokrzyskie"), "J"] <- 9
dom[c("lubelskie", "podkarpackie"), "C"] <- 2.5
cena_sr <- c(A = 46, B = 74, C = 63, D = 86, E = 58, F = 52, G = 57, H = 50, I = 61, J = 55)

set.seed(695)
prawda <- sweep(dom, 2, sila, "*") * exp(matrix(rnorm(16 * 10, 0, 0.25), 16))
prawda <- prawda / rowSums(prawda)              # prawdziwe udziały w pasażerach w każdym województwie
n <- 6000                                       # próba biletów z (fikcyjnej) platformy sprzedaży
w_bilet <- sample(woj, n, replace = TRUE, prob = waga)
p_bilet <- vapply(w_bilet, function(w) sample(przew, 1, prob = prawda[w, ]), "", USE.NAMES = FALSE)
cena <- round(rlnorm(n, log(cena_sr[p_bilet]) - 0.35^2 / 2, 0.35), 2)
bilety <- data.frame(bilet_id = seq_len(n), wojewodztwo = w_bilet,
                     przewoznik = factor(p_bilet, levels = przew), cena_zl = cena)
write.csv(bilety, "koncentracja-bilety-autokarowe-proba.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Prawdziwe udziały w kraju (znane tylko dlatego, że dane są symulowane)
pas_prawda <- colSums(prawda * waga / sum(waga))
przych_prawda <- pas_prawda * cena_sr / sum(pas_prawda * cena_sr)

# Udziały z próby: wg liczby pasażerów (biletów) i wg przychodu
udz <- data.frame(przewoznik = przew,
                  pasazerowie = as.vector(100 * prop.table(table(bilety$przewoznik))),
                  przychod = as.vector(100 * tapply(bilety$cena_zl, bilety$przewoznik, sum) / sum(bilety$cena_zl)))
udz <- udz[order(-udz$pasazerowie), ]
print(cbind(udz[1], round(udz[2:3], 1)), row.names = FALSE)
cr4 <- function(x) sum(sort(100 * x / sum(x), decreasing = TRUE)[1:4])
cat("CR4 pasażerowie:", round(cr4(udz$pasazerowie), 1), "| CR4 przychód:", round(cr4(udz$przychod), 1), "\n")
cat("HHI pasażerowie:", round(hhi(udz$pasazerowie)), "| HHI przychód:", round(hhi(udz$przychod)), "\n")
cat("Rachunek HHI:", paste(sprintf("%.1f²", udz$pasazerowie), collapse = " + "), "\n")
cat("Kwadraty:", paste(round(udz$pasazerowie^2), collapse = " + "), "\n")
cat("Ekwiwalent liczby równych firm (10 000 / HHI):", round(10000 / hhi(udz$pasazerowie), 1), "\n")
cat("Prawdziwe HHI pasażerowie:", round(hhi(pas_prawda)), "| przychód:", round(hhi(przych_prawda)), "\n")
cat("Biletów w województwach: od", min(table(bilety$wojewodztwo)), "do", max(table(bilety$wojewodztwo)), "\n")

dl <- rbind(data.frame(przewoznik = udz$przewoznik, miara = "wg pasażerów", u = udz$pasazerowie),
            data.frame(przewoznik = udz$przewoznik, miara = "wg przychodu", u = udz$przychod))
dl$przewoznik <- factor(dl$przewoznik, levels = rev(udz$przewoznik))
p1 <- ggplot(dl, aes(u, przewoznik, fill = miara)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = 6.5, ymax = 10.5, fill = kol[["zolty"]], alpha = 0.12) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75) +
  geom_text(aes(label = sprintf("%.1f", u)), position = position_dodge(width = 0.8), hjust = -0.15, size = 3.4,
            colour = "#0f1d3a") +
  annotate("text", x = 31, y = 7.3, hjust = 1, size = 3.8, colour = "#0f1d3a", fontface = "bold",
           label = sprintf("CR4 = %.1f%% pasażerów\n(%.1f%% przychodu)", cr4(udz$pasazerowie), cr4(udz$przychod))) +
  scale_fill_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_x_continuous(limits = c(0, 33), expand = expansion(mult = c(0, 0.02))) +
  labs(title = "Udziały 10 przewoźników autokarowych w kraju",
       subtitle = sprintf("Próba 6000 biletów; HHI = %d (pasażerowie) i %d (przychód)",
                         round(hhi(udz$pasazerowie)), round(hhi(udz$przychod))),
       x = "Udział w rynku (%)", y = "Przewoźnik") +
  motyw
p1                       # do pliku: ggsave("koncentracja-udzialy-cr4-hhi.svg", p1, width = 10, height = 6)
Wynik w R
 przewoznik pasazerowie przychod
          A        31.5     24.2
          B        23.2     27.9
          C        13.1     13.5
          D        10.1     14.2
          E         8.0      7.5
          H         5.2      4.5
          F         3.4      2.9
          G         2.1      2.0
          I         1.9      1.9
          J         1.6      1.5
CR4 pasażerowie: 77.8 | CR4 przychód: 79.7
HHI pasażerowie: 1914 | HHI przychód: 1841
Rachunek HHI: 31.5² + 23.2² + 13.1² + 10.1² + 8.0² + 5.2² + 3.4² + 2.1² + 1.9² + 1.6²
Kwadraty: 992 + 536 + 172 + 101 + 64 + 27 + 11 + 5 + 4 + 2
Ekwiwalent liczby równych firm (10 000 / HHI): 5.2
Prawdziwe HHI pasażerowie: 1930 | przychód: 1831
Biletów w województwach: od 143 do 873
2. Karta „jak czytać HHI”: Rysunek 2
R
# Rysunek 2. Karta „jak czytać HHI”: skala 0–10 000, rynki wzorcowe, nasz rynek i trzy rachunki
# (korzysta z kol, motyw, hhi, pkt i udz z przepisu 1)
library(ggplot2)

h_nasz <- hhi(udz$pasazerowie)
wzorce <- data.frame(etykieta = c("10 równych firm", "nasz rynek", "4 równe firmy", "2 równe firmy", "monopol"),
                     h = c(hhi(rep(1, 10)), h_nasz, hhi(rep(1, 4)), hhi(rep(1, 2)), hhi(1)),
                     gora = c(FALSE, TRUE, FALSE, TRUE, TRUE))
wzorce$x <- wzorce$h / 100                       # pozycja na pasku szerokości 100
wzorce$y_tekst <- ifelse(wzorce$gora, 6.25, 4.35)
print(data.frame(rynek = wzorce$etykieta, HHI = round(wzorce$h), ekwiwalent = round(10000 / wzorce$h, 1)),
      row.names = FALSE)

# Przykładowe progi (tylko do ilustracji – rzeczywiste wytyczne organów konkurencji różnią się i zmieniają)
strefy <- data.frame(xmin = c(0, 15, 25), xmax = c(15, 25, 100),
                     nazwa = c("niska", "umiarkowana", "wysoka koncentracja"),
                     wyp = c(kol[["blekit"]], kol[["zolty"]], kol[["pomaranczowy"]]))
s_C <- udz$pasazerowie[udz$przewoznik == "C"]; s_F <- udz$pasazerowie[udz$przewoznik == "F"]
pudla <- data.frame(
  xmin = c(0, 51, 0, 51), xmax = c(49, 100, 49, 100), ymin = c(1.55, 1.55, -0.85, -0.85), ymax = c(3.35, 3.35, 1.35, 1.35),
  tytul = c("1. Jak policzyć", "2. Ile to „równych firm”", "3. Fuzja dwóch firm", "4. Czego HHI nie powie"),
  tekst = c(sprintf("Udziały w %% do kwadratu i suma:\n%.1f² + %.1f² + … + %.1f² = %d", udz$pasazerowie[1],
                    udz$pasazerowie[2], udz$pasazerowie[10], round(h_nasz)),
            sprintf("10 000 / HHI = %.1f\nrynek skupiony jak rynek ok. 5 równych przewoźników", 10000 / h_nasz),
            sprintf("ΔHHI = 2 × udział C × udział F\n2 × %.1f × %.1f ≈ %d punktów (w kraju)", s_C, s_F, round(2 * s_C * s_F)),
            "jaki to rynek (trasa, województwo, kraj),\nczy udział to pasażerowie czy złotówki,\nile w nim niepewności z próby"))
p2 <- ggplot() +
  geom_rect(data = strefy, aes(xmin = xmin, xmax = xmax, ymin = 4.9, ymax = 5.7, fill = wyp), alpha = 0.55) +
  geom_text(data = strefy, aes(x = (xmin + xmax) / 2, y = 5.1, label = nazwa), size = 3.3, colour = "#0f1d3a") +
  geom_segment(data = wzorce, aes(x = x, xend = x, y = ifelse(gora, 5.7, 4.9), yend = ifelse(gora, 6.0, 4.6)),
               colour = "#0f1d3a", linewidth = 0.6) +
  geom_point(data = wzorce, aes(x = x, y = 5.48, shape = etykieta == "nasz rynek"), size = 3.2, colour = "#0f1d3a",
             fill = kol[["niebieski"]], show.legend = FALSE) +
  scale_shape_manual(values = c(`FALSE` = 21, `TRUE` = 23)) +
  geom_text(data = wzorce, aes(x = pmin(pmax(x, 6), 96), y = y_tekst, label = sprintf("%s\n%s", etykieta, pkt(h))),
            size = 3.4, lineheight = 0.9, colour = "#0f1d3a", fontface = ifelse(wzorce$etykieta == "nasz rynek", "bold", "plain")) +
  annotate("text", x = c(0, 100), y = 4.82, label = c("0", "10 000"), size = 3.2, colour = "grey30", vjust = 1,
           hjust = c(0, 1)) +
  geom_rect(data = pudla, aes(xmin = xmin, xmax = xmax, ymin = ymin, ymax = ymax), fill = "#f4f6fa",
            colour = "#c9d1e0", linewidth = 0.5) +
  geom_text(data = pudla, aes(x = xmin + 2, y = ymax - 0.3, label = tytul), hjust = 0, size = 3.9, fontface = "bold",
            colour = "#0f1d3a") +
  geom_text(data = pudla, aes(x = xmin + 2, y = ymax - 0.65, label = tekst), hjust = 0, vjust = 1, size = 3.4,
            lineheight = 0.95, colour = "grey15") +
  scale_fill_identity() +
  coord_cartesian(xlim = c(0, 100), ylim = c(-0.9, 6.75), expand = FALSE, clip = "off") +
  labs(title = "Jak czytać HHI – wskaźnik Herfindahla–Hirschmana",
       subtitle = "Progi na pasku są przykładowe (1500 i 2500); sprawdź wytyczne, które dotyczą Twojej pracy",
       x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank())
p2                       # do pliku: ggsave("koncentracja-karta-jak-czytac-hhi.svg", p2, width = 10, height = 6.6)
Wynik w R
           rynek   HHI ekwiwalent
 10 równych firm  1000       10.0
      nasz rynek  1914        5.2
   4 równe firmy  2500        4.0
   2 równe firmy  5000        2.0
         monopol 10000        1.0
3. Krzywa Lorenza i Gini kontra HHI: Rysunek 3
R
# Rysunek 3. Krzywa Lorenza i indeks Giniego udziałów przewoźników – i dlaczego Gini myli przy małej liczbie firm
# (korzysta z kol, motyw, hhi, pkt i udz z przepisu 1)
library(ggplot2)
library(patchwork)
library(ineq)

lc <- Lc(udz$pasazerowie)                        # krzywa Lorenza (pakiet ineq)
g_nasz <- Gini(udz$pasazerowie)
cat("Gini udziałów (10 przewoźników):", round(g_nasz, 3), "| z poprawką n/(n − 1):",
    round(Gini(udz$pasazerowie, corr = TRUE), 3), "\n")
mal5 <- sum(sort(udz$pasazerowie)[1:5])
cat("5 najmniejszych przewoźników ma", round(mal5, 1), "% pasażerów\n")

# Rynki wzorcowe: Gini mierzy nierówność wielkości firm, HHI – skupienie rynku
mikro <- c(0.97 * udz$pasazerowie, rep(0.1, 30))       # nasz rynek + 30 mikroprzewoźników po 0.1%
rynki <- list("monopol (1 firma)" = 100, "2 równe firmy" = c(50, 50), "10 równych firm" = rep(10, 10),
              "nasz rynek (10 firm)" = udz$pasazerowie, "nasz rynek + 30 mikrofirm" = mikro)
por <- data.frame(rynek = names(rynki), n_firm = lengths(rynki),
                  Gini = sapply(rynki, function(x) if (length(x) == 1) 0 else Gini(x)), HHI = sapply(rynki, hhi))
print(cbind(por[1:2], Gini = round(por$Gini, 3), HHI = round(por$HHI)), row.names = FALSE)

lor <- data.frame(F = lc$p, L = lc$L)
pA <- ggplot(lor, aes(F, L)) +
  geom_ribbon(aes(ymin = L, ymax = F), fill = kol[["blekit"]], alpha = 0.35) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = "grey40") +
  geom_line(colour = kol[["niebieski"]], linewidth = 1) + geom_point(colour = kol[["niebieski"]], size = 2.3) +
  annotate("segment", x = 0.5, xend = 0.5, y = 0, yend = mal5 / 100, colour = kol[["pomaranczowy"]],
           linetype = "dashed") +
  annotate("text", x = 0.02, y = 0.92, hjust = 0, size = 3.8, fontface = "bold", colour = "#0f1d3a",
           label = sprintf("Gini = %s", sub("^0", "", sprintf("%.2f", g_nasz)))) +
  annotate("text", x = 0.02, y = 0.81, hjust = 0, size = 3.4, colour = kol[["pomaranczowy"]],
           label = sprintf("5 najmniejszych firm:\n%.1f%% pasażerów", mal5)) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%")) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  coord_equal() +
  labs(title = "A. Krzywa Lorenza udziałów", subtitle = "10 przewoźników od najmniejszego",
       x = "Skumulowany odsetek przewoźników", y = "Skumulowany udział pasażerów") + motyw

dl <- rbind(data.frame(rynek = por$rynek, miara = "Gini (0–1)", w = por$Gini),
            data.frame(rynek = por$rynek, miara = "HHI (0–10 000)", w = por$HHI))
dl$rynek <- factor(dl$rynek, levels = rev(names(rynki)))
dl$etyk <- ifelse(dl$miara == "HHI (0–10 000)", pkt(dl$w), sub("^0", "", sprintf("%.2f", dl$w)))
pB <- ggplot(dl, aes(w, rynek)) +
  geom_segment(aes(x = 0, xend = w, yend = rynek), colour = "grey70", linewidth = 0.8) +
  geom_point(aes(colour = miara, shape = miara), size = 3.4, show.legend = FALSE) +
  geom_text(aes(label = etyk), hjust = -0.55, size = 3.4, colour = "#0f1d3a") +
  facet_wrap(~ miara, scales = "free_x") +
  scale_x_continuous(breaks = function(l) if (max(l) < 5) c(0, 0.5, 1) else c(0, 5000, 10000),
                     labels = function(b) ifelse(b < 5, sub("^0\\.", ".", as.character(b)), pkt(b)),
                     expand = expansion(mult = c(0.02, 0.6))) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]])) +
  scale_shape_manual(values = c(17, 16)) +
  labs(title = "B. Te same rynki w dwóch miarach", subtitle = "Gini nie widzi monopolu",
       x = NULL, y = NULL) + motyw
p3 <- pA + pB + plot_layout(widths = c(1, 1.35))
p3                       # do pliku: ggsave("koncentracja-lorenz-gini.svg", p3, width = 10, height = 5.4)
Wynik w R
Gini udziałów (10 przewoźników): 0.496 | z poprawką n/(n − 1): 0.551
5 najmniejszych przewoźników ma 14.2 % pasażerów
                     rynek n_firm  Gini   HHI
         monopol (1 firma)      1 0.000 10000
             2 równe firmy      2 0.000  5000
           10 równych firm     10 0.000  1000
      nasz rynek (10 firm)     10 0.496  1914
 nasz rynek + 30 mikrofirm     40 0.840  1801
4. HHI w województwach: Rysunek 4
R
# Rysunek 4. HHI w 16 województwach na mapie-schemacie (kafelki w przybliżonym położeniu)
# (korzysta z kol, motyw, hhi, pkt i bilety z przepisu 1)
library(ggplot2)

woj_tab <- do.call(rbind, lapply(split(bilety, bilety$wojewodztwo), function(d) {
  u <- 100 * prop.table(table(d$przewoznik))
  data.frame(wojewodztwo = d$wojewodztwo[1], n_biletow = nrow(d), HHI = hhi(u),
             lider = names(which.max(u)), udzial_lidera = max(u))
}))
woj_tab <- woj_tab[order(-woj_tab$HHI), ]
print(cbind(woj_tab[c(1, 2)], HHI = round(woj_tab$HHI), lider = woj_tab$lider,
            udzial_lidera = round(woj_tab$udzial_lidera, 1)), row.names = FALSE)
h_kraj <- hhi(table(bilety$przewoznik))
cat("HHI w kraju:", round(h_kraj), "| średnie HHI województw (ważone liczbą biletów):",
    round(weighted.mean(woj_tab$HHI, woj_tab$n_biletow)), "| województw z HHI > 2500:", sum(woj_tab$HHI > 2500), "\n")

# Mapa-schemat: siatka 4 × 4, położenie województw przybliżone
siatka <- data.frame(
  wojewodztwo = c("zachodniopomorskie", "pomorskie", "warmińsko-mazurskie", "podlaskie",
                  "lubuskie", "kujawsko-pomorskie", "mazowieckie", "lubelskie",
                  "dolnośląskie", "wielkopolskie", "łódzkie", "świętokrzyskie",
                  "opolskie", "śląskie", "małopolskie", "podkarpackie"),
  kol_x = rep(1:4, 4), wiersz_y = rep(4:1, each = 4))
mapa <- merge(siatka, woj_tab)
mapa$nazwa <- sub("-", "-\n", mapa$wojewodztwo)
mapa$tekst <- ifelse(mapa$HHI > 2400, "white", "#0f1d3a")
p4 <- ggplot(mapa, aes(kol_x, wiersz_y)) +
  geom_tile(aes(fill = HHI), colour = "white", linewidth = 1.5, width = 0.96, height = 0.94) +
  geom_text(aes(label = nazwa, colour = tekst), vjust = 0, nudge_y = 0.12, size = 3.6, lineheight = 0.85) +
  geom_text(aes(label = pkt(HHI), colour = tekst), vjust = 1, nudge_y = 0.04, size = 5.6, fontface = "bold") +
  geom_text(aes(label = sprintf("lider %s: %.0f%%", lider, udzial_lidera), colour = tekst), nudge_y = -0.33,
            size = 3.4) +
  scale_fill_gradient(low = "#eff3ff", high = "#08519c", limits = c(1800, 2900), oob = scales::squish,
                      name = "HHI w województwie", breaks = c(1800, 2000, 2200, 2400, 2600, 2800)) +
  scale_colour_identity() +
  scale_x_continuous(expand = c(0, 0)) + scale_y_continuous(expand = c(0, 0)) +
  labs(title = "Koncentracja w województwach",
       subtitle = sprintf("W kraju HHI = %d, w województwach od %d do %d (próba 6000 biletów)", round(h_kraj),
                          round(min(mapa$HHI)), round(max(mapa$HHI))),
       x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank(),
                legend.key.width = unit(2.2, "cm"))
p4                       # do pliku: ggsave("koncentracja-hhi-wojewodztwa.svg", p4, width = 10, height = 7.6)
Wynik w R
         wojewodztwo n_biletow  HHI lider udzial_lidera
        dolnośląskie       423 2828     A          43.5
  kujawsko-pomorskie       325 2670     A          41.5
           lubelskie       327 2585     F          36.7
       wielkopolskie       576 2549     A          37.0
         mazowieckie       873 2473     A          36.2
             łódzkie       403 2427     A          37.5
         małopolskie       535 2395     B          34.2
             śląskie       700 2392     H          37.4
            opolskie       143 2304     A          33.6
 warmińsko-mazurskie       192 2251     B          33.3
  zachodniopomorskie       292 2248     A          33.2
            lubuskie       174 2224     A          33.9
      świętokrzyskie       174 2105     B          27.6
        podkarpackie       320 2006     A          25.9
           pomorskie       362 1911     G          23.8
           podlaskie       181 1834     A          24.3
HHI w kraju: 1914 | średnie HHI województw (ważone liczbą biletów): 2384 | województw z HHI > 2500: 4
5. Fuzja C i F – ΔHHI: Rysunek 5
R
# Rysunek 5. Fuzja przewoźników C i F: HHI przed i po oraz ΔHHI w kraju i w województwach
# (korzysta z kol, motyw, hhi i bilety z przepisu 1)
library(ggplot2)

po_fuzji <- function(p) factor(ifelse(p %in% c("C", "F"), "C+F", as.character(p)))
policz <- function(d, nazwa) {
  u <- 100 * prop.table(table(d$przewoznik))
  data.frame(rynek = nazwa, n_biletow = nrow(d), s_C = u[["C"]], s_F = u[["F"]],
             przed = hhi(table(d$przewoznik)), po = hhi(table(po_fuzji(d$przewoznik))))
}
fz <- rbind(policz(bilety, "KRAJ (cały rynek)"),
            do.call(rbind, lapply(split(bilety, bilety$wojewodztwo), function(d) policz(d, d$wojewodztwo[1]))))
fz$delta <- fz$po - fz$przed
fz$wzor <- 2 * fz$s_C * fz$s_F                   # ΔHHI = 2 × s_C × s_F – to samo co różnica po − przed
# Przykładowa reguła (ilustracja, nie cytat z wytycznych): sprawdź bliżej, gdy po fuzji HHI > 2500 i ΔHHI > 200
fz$sygnal <- ifelse(fz$po > 2500 & fz$delta > 200, "HHI po > 2500 i ΔHHI > 200", "poniżej przykładowego progu")
fz <- fz[order(fz$delta), ]
print(cbind(fz["rynek"], round(fz[c("s_C", "s_F", "przed", "po", "delta", "wzor")], 1)), row.names = FALSE)
cat("Województw z sygnałem „HHI po > 2500 i ΔHHI > 200”:", sum(fz$sygnal == "HHI po > 2500 i ΔHHI > 200"), "\n")

fz$rynek <- factor(fz$rynek, levels = fz$rynek)
fz$sygnal <- factor(fz$sygnal, levels = c("poniżej przykładowego progu", "HHI po > 2500 i ΔHHI > 200"))
p5 <- ggplot(fz, aes(y = rynek)) +
  annotate("rect", xmin = 2500, xmax = Inf, ymin = -Inf, ymax = Inf, fill = kol[["pomaranczowy"]], alpha = 0.08) +
  geom_vline(xintercept = 2500, linetype = "dashed", colour = "grey45") +
  geom_segment(aes(x = przed, xend = po, yend = rynek, colour = sygnal), linewidth = 1,
               arrow = arrow(length = unit(0.16, "cm"), type = "closed")) +
  geom_point(aes(x = przed), colour = "grey45", size = 2) +
  geom_text(aes(x = pmax(przed, po), label = ifelse(round(delta) == 0, "0", sprintf("+%d", round(delta)))), hjust = -0.3, size = 3.3,
            colour = "#0f1d3a") +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_x_continuous(limits = c(1500, 5600), breaks = seq(1500, 5500, 1000)) +
  labs(title = "Fuzja przewoźników C i F: HHI przed (kropka) i po (grot)",
       subtitle = "Liczba przy strzałce: ΔHHI = 2 × udział C × udział F; próg 2500 i reguła są przykładowe",
       x = "HHI (pasażerowie)", y = NULL) +
  motyw
p5                       # do pliku: ggsave("koncentracja-fuzja-delta-hhi.svg", p5, width = 10, height = 7)
Wynik w R
               rynek  s_C  s_F  przed     po  delta   wzor
            opolskie 16.1  0.0 2303.8 2303.8    0.0    0.0
           pomorskie 13.8  0.0 1911.1 1911.1    0.0    0.0
      świętokrzyskie 12.1  0.0 2105.3 2105.3    0.0    0.0
 warmińsko-mazurskie  5.7  0.0 2251.0 2251.0    0.0    0.0
  zachodniopomorskie  9.9  0.0 2247.6 2247.6    0.0    0.0
             śląskie  8.6  0.1 2391.5 2394.0    2.4    2.4
         małopolskie 12.3  0.2 2394.9 2399.5    4.6    4.6
             łódzkie 13.9  0.2 2426.5 2433.4    6.9    6.9
         mazowieckie  9.4  0.5 2472.8 2481.4    8.6    8.6
  kujawsko-pomorskie 16.6  0.3 2670.1 2680.3   10.2   10.2
       wielkopolskie 12.5  0.5 2548.8 2561.8   13.0   13.0
        dolnośląskie 15.4  0.5 2828.2 2842.7   14.5   14.5
           podlaskie 13.8  0.6 1833.6 1848.8   15.3   15.3
            lubuskie  9.8  1.1 2224.2 2246.7   22.5   22.5
   KRAJ (cały rynek) 13.1  3.4 1914.0 2001.7   87.8   87.8
        podkarpackie 25.0 20.3 2006.2 3021.9 1015.6 1015.6
           lubelskie 22.9 36.7 2585.2 4268.5 1683.4 1683.4
Województw z sygnałem „HHI po > 2500 i ΔHHI > 200”: 2
6. Bootstrap HHI i ΔHHI: Rysunek 6
R
# Rysunek 6. Niepewność HHI z próby biletów: bootstrap (2000 prób) i 95% przedziały percentylowe
# (korzysta z kol, motyw, hhi, bilety, prawda, waga, pas_prawda i przych_prawda z przepisu 1)
library(ggplot2)
library(patchwork)
library(boot)

po_fuzji <- function(p) factor(ifelse(p %in% c("C", "F"), "C+F", as.character(p)))
miary <- function(d, i) {
  b <- d[i, ]
  op <- b[b$wojewodztwo == "opolskie", ]
  lu <- b[b$wojewodztwo == "lubelskie", ]
  c(hhi_pasazerowie = hhi(table(b$przewoznik)),
    hhi_przychod = hhi(tapply(b$cena_zl, b$przewoznik, sum, default = 0)),
    delta_kraj = hhi(table(po_fuzji(b$przewoznik))) - hhi(table(b$przewoznik)),
    hhi_opolskie = hhi(table(op$przewoznik)),
    delta_lubelskie = hhi(table(po_fuzji(lu$przewoznik))) - hhi(table(lu$przewoznik)))
}
set.seed(6951)
bt <- boot(bilety, miary, R = 2000)
ci <- t(sapply(seq_along(bt$t0), function(j) boot.ci(bt, type = "perc", index = j)$percent[4:5]))

# Prawdziwe wartości (znane tylko w symulacji)
pf <- function(p) { q <- p[names(p) != "F"]; q["C"] <- p[["C"]] + p[["F"]]; q }
prawdziwe <- c(hhi(pas_prawda), hhi(przych_prawda), hhi(pf(pas_prawda)) - hhi(pas_prawda),
               hhi(prawda["opolskie", ]), hhi(pf(prawda["lubelskie", ])) - hhi(prawda["lubelskie", ]))
tab <- data.frame(miara = names(bt$t0), z_proby = bt$t0, obciazenie_boot = colMeans(bt$t) - bt$t0,
                  dolna = ci[, 1], gorna = ci[, 2], prawda = prawdziwe)
print(cbind(tab[1], round(tab[-1])), row.names = FALSE)
cat("Biletów: opolskie", sum(bilety$wojewodztwo == "opolskie"), "| lubelskie", sum(bilety$wojewodztwo == "lubelskie"), "\n")

pA <- ggplot(data.frame(h = bt$t[, 1]), aes(h)) +
  geom_histogram(binwidth = 10, fill = kol[["blekit"]], colour = "white", linewidth = 0.2) +
  annotate("rect", xmin = tab$dolna[1], xmax = tab$gorna[1], ymin = -Inf, ymax = Inf, fill = kol[["niebieski"]],
           alpha = 0.10) +
  geom_vline(xintercept = tab$z_proby[1], colour = kol[["niebieski"]], linewidth = 1) +
  geom_vline(xintercept = tab$prawda[1], colour = "#0f1d3a", linetype = "dotted", linewidth = 1) +
  annotate("text", x = min(bt$t[, 1]), y = Inf, vjust = 1.3, hjust = 0, size = 3.4, colour = "#0f1d3a",
           label = sprintf("95%% CI\n[%d, %d]\nprawda: %d", round(tab$dolna[1]), round(tab$gorna[1]), round(tab$prawda[1]))) +
  labs(title = "A. HHI w kraju w 2000 próbach", subtitle = "Linia ciągła: próba, kropkowana: prawda",
       x = "HHI (pasażerowie)", y = "Liczba prób bootstrapowych") + motyw

tab$etykieta <- factor(c("HHI kraj – pasażerowie", "HHI kraj – przychód", "ΔHHI fuzji – kraj",
                         sprintf("HHI opolskie (n = %d)", sum(bilety$wojewodztwo == "opolskie")),
                         sprintf("ΔHHI fuzji – lubelskie (n = %d)", sum(bilety$wojewodztwo == "lubelskie"))))
tab$etykieta <- factor(tab$etykieta, levels = rev(tab$etykieta))
pB <- ggplot(tab, aes(y = etykieta)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(aes(x = z_proby), size = 3, colour = kol[["niebieski"]]) +
  geom_point(aes(x = prawda), shape = 4, size = 3, stroke = 1.3, colour = kol[["pomaranczowy"]]) +
  scale_x_continuous(limits = c(0, 4000)) +
  labs(title = "B. Pięć liczb z 95% CI", subtitle = "Kropka: próba, krzyżyk: prawda",
       x = "Punkty HHI", y = NULL) + motyw
p6 <- pA + pB + plot_layout(widths = c(1, 1.25))
p6                       # do pliku: ggsave("koncentracja-bootstrap-hhi.svg", p6, width = 10, height = 5.4)
Wynik w R
           miara z_proby obciazenie_boot dolna gorna prawda
 hhi_pasazerowie    1914               0  1862  1969   1930
    hhi_przychod    1841               1  1796  1887   1831
      delta_kraj      88               0    75   100     84
    hhi_opolskie    2304              59  2088  2717   2181
 delta_lubelskie    1683              -5  1368  2012   1507
Biletów: opolskie 143 | lubelskie 327
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – pomarańczowy" = c("#56B4E9", "#D55E00"),
             "szary – niebieski" = c("#999999", "#0072B2"), "szary – pomarańczowy" = c("#999999", "#D55E00"),
             "skala HHI: jasny – ciemny" = c("#deebf7", "#08306b"), "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
błękit – pomarańczowy                      113.6        101.1       89.0
szary – niebieski                           44.9         48.9       40.6
szary – pomarańczowy                        77.2         62.9       56.0
skala HHI: jasny – ciemny                   79.1         79.2       75.8
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych wykonano pakietem stats (z podstawowej instalacji R). Krzywą Lorenza i indeks Giniego policzono pakietem ineq, a bootstrap i przedziały percentylowe – pakietem boot. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ineq (wersja 0.2.13): Zeileis, A. (2014). ineq: Measuring inequality, concentration, and poverty [R package]. https://doi.org/10.32614/CRAN.package.ineq
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Zła definicja rynku. Kraj zaniża koncentrację tam, gdzie firmy regionalne dzielą obszar między siebie (rysunek 4).
- Jedna miara udziału. Pasażerowie i przychód mogą wskazać różnych liderów (rysunek 1).
- Gini zamiast HHI. Monopol i dziesięć równych firm mają ten sam Gini = 0 (rysunek 3).
- Szyldy zamiast właścicieli. Dwie marki jednej grupy kapitałowej to dla HHI jedna firma – licz udziały po właścicielu.
- Mała próba w regionie. HHI ze 143 biletów ma przedział szeroki na ponad 600 punktów i jest zawyżony (rysunek 6).
- Próba z jednego kanału sprzedaży. Jeśli część przewoźników sprzedaje bilety tylko w kasach, udziały będą obciążone, a bootstrap tego nie pokaże. Gdy bilety pochodzą z kilku kursów naraz (np. wycieczki grupowe), losuj kursy, nie bilety (bootstrap blokowy).
Najczęstsze pytania
Jak obliczyć wskaźnik HHI?
Wyraź udział każdej firmy w procentach, podnieś do kwadratu i zsumuj. W przykładzie przewoźników: 31.5² + 23.2² + … + 1.6² = 1914. Wynik leży między prawie 0 (bardzo wiele małych firm) a 10 000 (monopol), a rynek N równych firm ma HHI = 10 000 / N.
Jak interpretować wartość HHI?
Najprościej przez ekwiwalent liczby równych firm: 10 000 / HHI. HHI = 1914 oznacza rynek skupiony jak rynek ok. 5 równych firm. Progi w rodzaju 1500 i 2500 punktów pochodzą z wytycznych organów konkurencji, różnią się między krajami i były zmieniane – w pracy podaj, z którego dokumentu korzystasz.
Czym różni się CR4 od HHI?
CR4 to suma udziałów czterech największych firm, więc nie widzi, jak udziały rozkładają się w pierwszej czwórce i poza nią. HHI bierze wszystkie firmy i mocniej waży duże. W branżach oba wskaźniki dają zwykle podobny obraz, dlatego warto podać oba.
Czy indeks Giniego mierzy koncentrację rynku?
Nie wprost. Gini mierzy nierówność wielkości firm, a nie to, ile firm dzieli rynek: monopol, dwie równe firmy i dziesięć równych firm mają Gini = 0. W przykładzie dołożenie 30 mikrofirm podniosło Gini z .50 do .84, a HHI spadło z 1914 do 1801.
Jak obliczyć zmianę HHI po fuzji?
Przy założeniu, że połączona firma zachowa klientów obu firm, ΔHHI = 2 × s1 × s2 (udziały w procentach). Licz ją na rynkach, na których firmy naprawdę się spotykają: w przykładzie fuzja dała w kraju +88 punktów, a w jednym województwie +1683.
Powiązane hasła
Przeczytaj też
Model atrakcyjności udziałów (MCI)
Rynek proszków do prania: udział jako atrakcyjność, log-centrowanie, elastyczności krzyżowe, symulacja obniżki ceny i logit udziałów – z kodem R.
Czytaj →PoradnikIndeks cen: Laspeyres, Paasche i Fisher
30 produktów bezglutenowych i 3 lata cen: trzy wzory ręcznie w R, substytucja, dryf łańcucha, przychód na ceny i ilości oraz mniejsza paczka.
Czytaj →PoradnikPozycja cenowa wobec konkurencji
Sklep z oponami i trzech konkurentów: względny indeks ceny, regresja z efektami stałymi, próg najtańszej oferty i pułapka odwrotnej przyczynowości – z kodem R.
Czytaj →Piszesz pracę o strukturze rynku albo fuzji?
Pomożemy zdefiniować rynek, policzyć udziały, HHI i ich przedziały ufności oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bailey, D., & Boyle, S. E. (1971). The optimal measure of concentration. Journal of the American Statistical Association, 66(336), 702–706. https://doi.org/10.1080/01621459.1971.10482332
- Deltas, G. (2003). The small-sample bias of the Gini coefficient: Results and implications for empirical research. Review of Economics and Statistics, 85(1), 226–234. https://doi.org/10.1162/rest.2003.85.1.226 ● Otwarty dostęp: pełny tekst
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Hall, M., & Tideman, N. (1967). Measures of concentration. Journal of the American Statistical Association, 62(317), 162–168. https://doi.org/10.1080/01621459.1967.10482897
- Lorenz, M. O. (1905). Methods of measuring the concentration of wealth. Publications of the American Statistical Association, 9(70), 209–219. https://doi.org/10.1080/15225437.1905.10503443
- Naldi, M., & Flamini, M. (2014). Interval estimation of the Herfindahl-Hirschman Index under incomplete market information. In 2014 UKSim-AMSS 16th International Conference on Computer Modelling and Simulation (pp. 318–323). IEEE. https://doi.org/10.1109/uksim.2014.66
- Nocke, V., & Whinston, M. D. (2022). Concentration thresholds for horizontal mergers. American Economic Review, 112(6), 1915–1948. https://doi.org/10.1257/aer.20201038 ● Otwarty dostęp: pełny tekst
- Taplin, R. H. (2003). Harmony, statistical inference with the Herfindahl H index and C index. Abacus, 39(1), 82–94. https://doi.org/10.1111/1467-6281.00121
Cytowania BibTeX
@article{bailey1971optimal, author={Bailey, Duncan and Boyle, Stanley E.}, title={{The optimal measure of concentration}}, journal={Journal of the American Statistical Association}, year={1971}, volume={66}, number={336}, pages={702--706}, doi={10.1080/01621459.1971.10482332}}@article{deltas2003small, author={Deltas, George}, title={{The small-sample bias of the Gini coefficient: Results and implications for empirical research}}, journal={Review of Economics and Statistics}, year={2003}, volume={85}, number={1}, pages={226--234}, doi={10.1162/rest.2003.85.1.226}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{hall1967measures, author={Hall, Marshall and Tideman, Nicolaus}, title={{Measures of concentration}}, journal={Journal of the American Statistical Association}, year={1967}, volume={62}, number={317}, pages={162--168}, doi={10.1080/01621459.1967.10482897}}@article{lorenz1905methods, author={Lorenz, M. O.}, title={{Methods of measuring the concentration of wealth}}, journal={Publications of the American Statistical Association}, year={1905}, volume={9}, number={70}, pages={209--219}, doi={10.1080/15225437.1905.10503443}}@inproceedings{naldi2014interval, author={Naldi, Maurizio and Flamini, Marta}, title={{Interval estimation of the Herfindahl-Hirschman Index under incomplete market information}}, booktitle={2014 UKSim-AMSS 16th International Conference on Computer Modelling and Simulation}, year={2014}, pages={318--323}, publisher={IEEE}, doi={10.1109/uksim.2014.66}}@article{nocke2022concentration, author={Nocke, Volker and Whinston, Michael D.}, title={{Concentration thresholds for horizontal mergers}}, journal={American Economic Review}, year={2022}, volume={112}, number={6}, pages={1915--1948}, doi={10.1257/aer.20201038}}@article{taplin2003harmony, author={Taplin, Ross H.}, title={{Harmony, statistical inference with the Herfindahl H index and C index}}, journal={Abacus}, year={2003}, volume={39}, number={1}, pages={82--94}, doi={10.1111/1467-6281.00121}}