Przykład: napój izotoniczny w 30 regionach
Fikcyjny producent napojów izotonicznych sprzedaje swój napój przez sklepy w 30 regionach kraju. W bazie jest 7126 sklepów, od 151 do 350 w regionie, a dla każdego roczny obrót kategorii napojów izotonicznych i informacja, czy nasz napój stoi na półce. Kategoria jest warta 777.2 mln zł rocznie, nasza marka sprzedaje za 86.2 mln zł, co daje 11.1% udziału w rynku. Dyrektor sprzedaży pyta: o ile wzrośnie sprzedaż, jeśli wejdziemy do kolejnych sklepów? Analityk ma pod ręką wykres udziału w rynku regionów w funkcji dystrybucji i chce z niego odczytać odpowiedź.
Dane pobierzesz jako dystrybucja-izotoniki-30-regionow.csv (30 regionów) i dystrybucja-izotoniki-sklepy.csv (7126 sklepów).
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Obrót sklepów ma rozkład lognormalny: 10% największych sklepów robi 41.3% sprzedaży kategorii. Duże sklepy trzymają na półce do 8 marek, małe – 2 lub 3, więc w małym sklepie nasz napój ma większy udział. O wprowadzeniu napoju decydują: wielkość sklepu, siła sieci sprzedaży w regionie i to, czy marka dobrze się tam sprzedaje. Ten trzeci mechanizm – sklepy biorą to, co się sprzedaje – jest sednem wpisu. Parametry ustawiliśmy ręcznie (lista w sekcji z kodem). Po pierwszym przebiegu podnieśliśmy stałą w modelu decyzji sklepów z −0.6 do 0, żeby dystrybucja przypominała markę ze średniej półki (wcześniej ważona wynosiła w kraju 52.7%); ziarna 692 nie zmienialiśmy.
Dystrybucja jako składnik atrakcyjności marki pojawia się też w modelu MCI, a krzywe odpowiedzi zamienione w plan wydatków – w podziale budżetu marketingowego.
Rysunek 1: dystrybucja numeryczna i ważona
Dwie liczby, które zobaczysz w każdym raporcie z panelu sklepów:
- dystrybucja numeryczna (ND) – odsetek sklepów, w których produkt jest na półce; każdy sklep liczy się tak samo;
- dystrybucja ważona (WD, w handlu często ACV – all commodity volume) – odsetek sprzedaży kategorii (albo całego obrotu sklepów), który przypada na sklepy z produktem. To średnia ważona: sklep, który sprzedaje dziesięć razy więcej izotoników, waży dziesięć razy więcej.
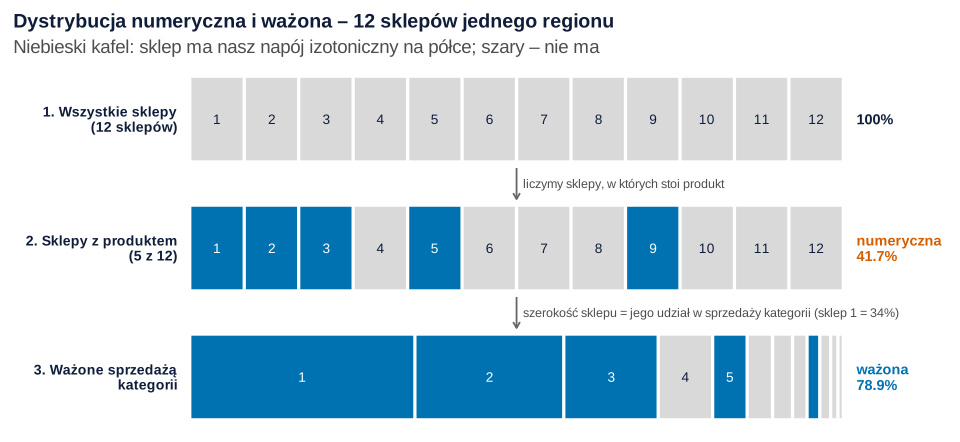
Co widać. Region ma 12 sklepów, które razem sprzedają izotoników za 1800 tys. zł rocznie. Nasz napój stoi w 5 z nich, więc dystrybucja numeryczna to 41.7%. Ale wśród tych pięciu są trzy największe sklepy, w tym sklep 1 z 34% obrotu kategorii. Sklepy z produktem sprzedają 1420 tys. zł, więc dystrybucja ważona wynosi 78.9%: nasz napój jest tam, gdzie klienci kupują prawie 4/5 izotoników.
Jak może zmylić. „Jesteśmy w 42% sklepów” i „docieramy do 79% rynku” opisują ten sam region. Pytaj, którą dystrybucję podano i czym ją ważono: sprzedażą kategorii czy całym obrotem sklepu. Dystrybucja nie mówi też, ile produkt ma miejsca na półce.
Podpis do pracy:
Rysunek 2: duże sklepy mają produkt częściej
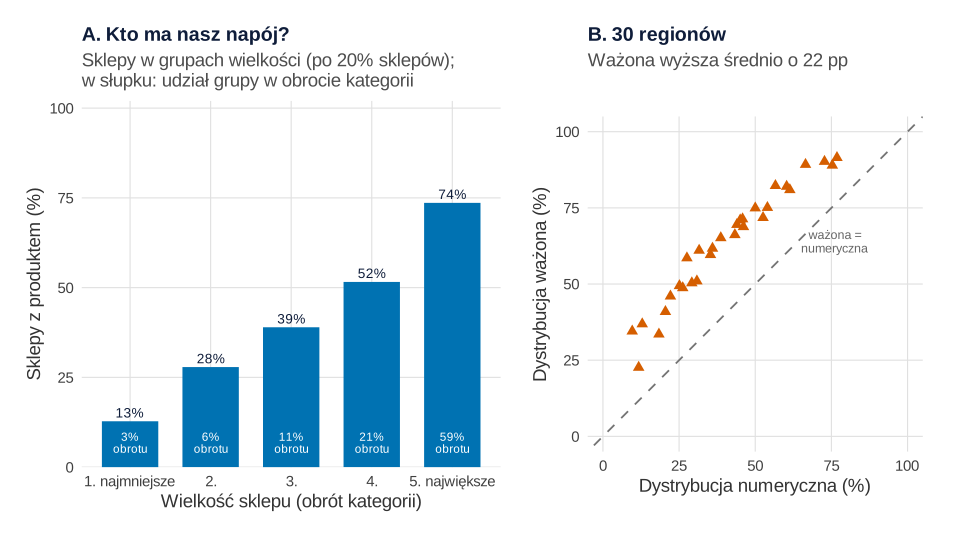
set.seed(692)).Co widać. Wśród 20% najmniejszych sklepów nasz napój ma 12.8% z nich, a wśród 20% największych – 73.6%. Najmniejsze sklepy robią tylko 2.7% obrotu kategorii, największe – 59.0%. Dlatego w każdym regionie dystrybucja ważona jest wyższa od numerycznej, średnio o 22.3 pp. Numeryczna waha się między regionami od 9.6 do 76.8%, ważona od 22.6 do 91.5%. W całym kraju: 40.9% sklepów i 63.4% dystrybucji ważonej.
Jak może zmylić. Obie miary są silnie skorelowane (r = .97), więc łatwo uznać je za zamienne. Nie są: luka między nimi zależy od tego, jak bardzo obrót jest skupiony w dużych sklepach. Do przewidywania sprzedaży używaj ważonej – to ona mówi, jaka część klientów kategorii może kupić produkt.
Podpis do pracy:
Rysunek 3: krzywa udziału w funkcji dystrybucji ważonej
Teraz właściwe pytanie: jak udział w rynku regionu zależy od dystrybucji ważonej? Mamy 30 punktów i trzy modele:
- prosta – zwykła regresja liniowa;
- GAM z pakietu mgcv – gładka krzywa, której wygięcie dobiera kara za krzywiznę szacowana metodą REML (Wood, 2011). Dokładnie opisuje to wpis o splajnach i modelach GAM;
- model potęgowy – regresja ln(udziału) na ln(WD) po transformacji logarytmicznej:
Wykładnik b czytamy jak elastyczność: o ile procent rośnie udział, gdy dystrybucja ważona rośnie o 1%. b = 1 oznacza proporcjonalność (dwa razy szersza dystrybucja – dwa razy większy udział), b > 1 – krzywą wypukłą, która przyspiesza.
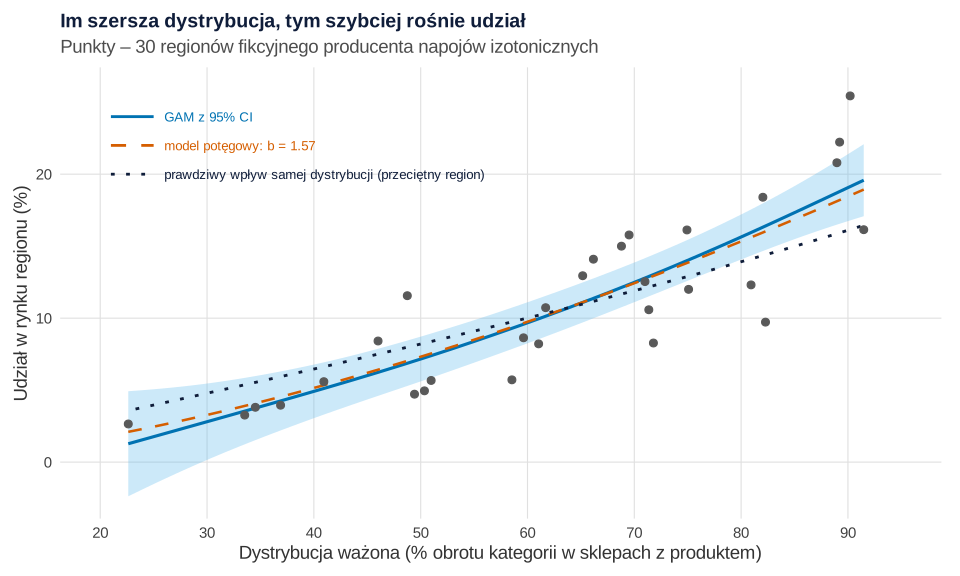
set.seed(692) i set.seed(6921)).Co widać. Krzywa jest wypukła: w modelu potęgowym b = 1.57, 95% CI [1.27, 1.88], a test hipotezy b = 1 daje t(28) = 3.87, p < .001. GAM zużył 1.73 efektywnych stopni swobody (edf = 1 to prosta), F = 37.10, p < .001, i wyjaśnił 74.7% dewiancji. Według GAM udział wynosi 4.9% przy WD 40% (95% CI [3.1, 6.8]), 9.7% przy 60% [8.3, 11.1], 15.6% przy 80% [14.1, 17.2] i 19.1% przy 90% [16.7, 21.4]. Wzrost dystrybucji z 40 do 60% to +4.8 pp udziału, z 60 do 80% – już +6.0 pp. To obraz znany z literatury: na danych przekrojowych udział rośnie z dystrybucją coraz szybciej, a marki duże mają więcej punktów udziału na punkt dystrybucji niż małe (Farris i in., 1989; Reibstein i Farris, 1995).
Jak może zmylić. Po pierwsze, przy 30 regionach GAM i prosta mają identyczne AIC (157.9), więc o przyspieszaniu krzywej lepiej mówi wykładnik b. Po drugie i ważniejsze: kropkowana linia pokazuje, co się stanie, gdy zmienimy tylko dystrybucję w regionie o przeciętnej sile marki. Jest lekko wypukła (wykładnik 1.10), bo nowe sklepy są małe i mają mało konkurencyjnych marek, ale wyraźnie bardziej płaska: wzrost z 40 do 60% WD daje naprawdę +3.5 pp, a z 60 do 80% +3.9 pp – o 1/4 do 1/3 mniej, niż obiecuje GAM. Krzywa z danych miesza wpływ dystrybucji z tym, że silna marka łatwiej wchodzi do sklepów (rysunek 5).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: pułapka „średniej na sklep”
Działy sprzedaży lubią wskaźniki „na punkt”: sprzedaż na sklep z produktem albo udział na punkt dystrybucji ważonej (udział w rynku podzielony przez WD, czyli udział w obrocie sklepów z produktem). Służą do porównań regionów i prognoz „każdy nowy sklep przyniesie średnią”.
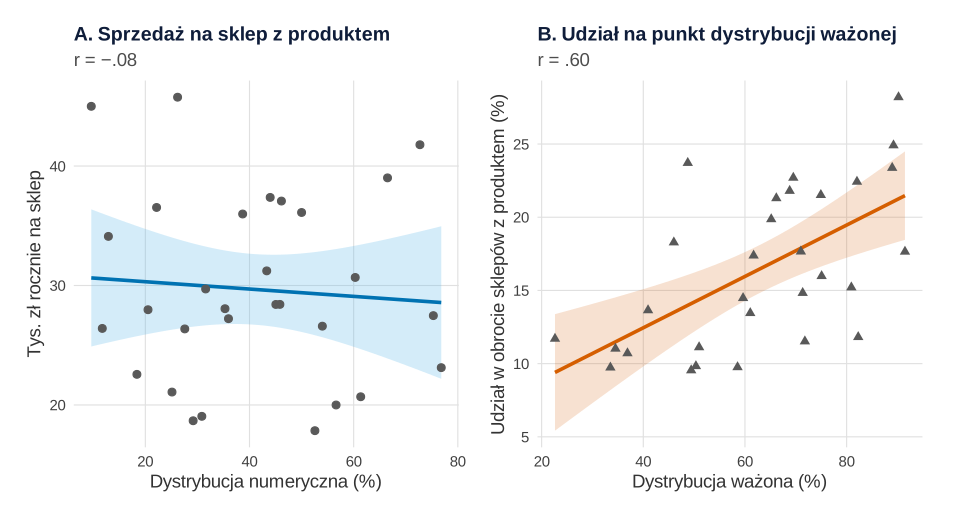
set.seed(692)).Co widać. Udział na punkt dystrybucji rośnie z dystrybucją (r = .60): w 10 regionach o najniższej WD (średnio 41.4%) nasz napój ma 12.9% obrotu sklepów, w których stoi, a w 10 regionach o najwyższej WD (82.7%) – 19.3%. Sprzedaż na sklep prawie się nie zmienia (r = −.08): 29.7, 31.0 i 28.3 tys. zł w trzech grupach regionów.
Jak może zmylić. Płaski panel A sugeruje, że regiony z szeroką dystrybucją „nie sprzedają lepiej na sklep”. To złudzenie składu: przy wysokiej dystrybucji wchodzimy też do małych sklepów, a marka jest tam silniejsza – oba efekty się znoszą. Prognoza „każdy nowy sklep da średnią” też zawodzi: sklepy z naszym napojem mają średnio 169.0 tys. zł obrotu kategorii, sklepy bez niego – 67.5 tys. zł (mediany 107.3 i 42.0). Panel B kusi odwrotnie: że każdy kolejny punkt dystrybucji jest wart coraz więcej. Po części to jednak znów siła marki, która podnosi i dystrybucję, i sprzedaż. Porównując regiony średnimi, ryzykujesz błąd ekologiczny, a porównując sklepy o różnym składzie – kłopot znany z porównań like-for-like.
Podpis do pracy:
Rysunek 5: sklepy biorą to, co się sprzedaje
Dlaczego krzywa z danych jest bardziej stroma niż prawdziwy wpływ dystrybucji? Bo strzałka biegnie w obie strony: sklep chętniej wprowadza napój, o który pytają klienci. Tak tłumaczą wypukłą krzywą Reibstein i Farris (1995): udział jest przyczyną i skutkiem dystrybucji, a przekrojowa krzywa odzwierciedla głównie decyzje sklepów. W nowych kategoriach to sprzężenie zwrotne udziału i dystrybucji zaobserwowano wprost (Bronnenberg i in., 2000). To korelacja, a nie przyczynowość, a siła marki działa jak zmienna zakłócająca.
Sprawdzamy to na 2 × 1000 fikcyjnych rynkach po 30 regionów z regułami jak w naszych danych. W scenariuszu A sklepy patrzą na siłę marki w regionie (jak u nas), w scenariuszu B decydują tylko sieć sprzedaży i wielkość sklepu. Prawdziwy wpływ samej dystrybucji jest w obu scenariuszach taki sam – wykładnik 1.14 w typowym zakresie WD.
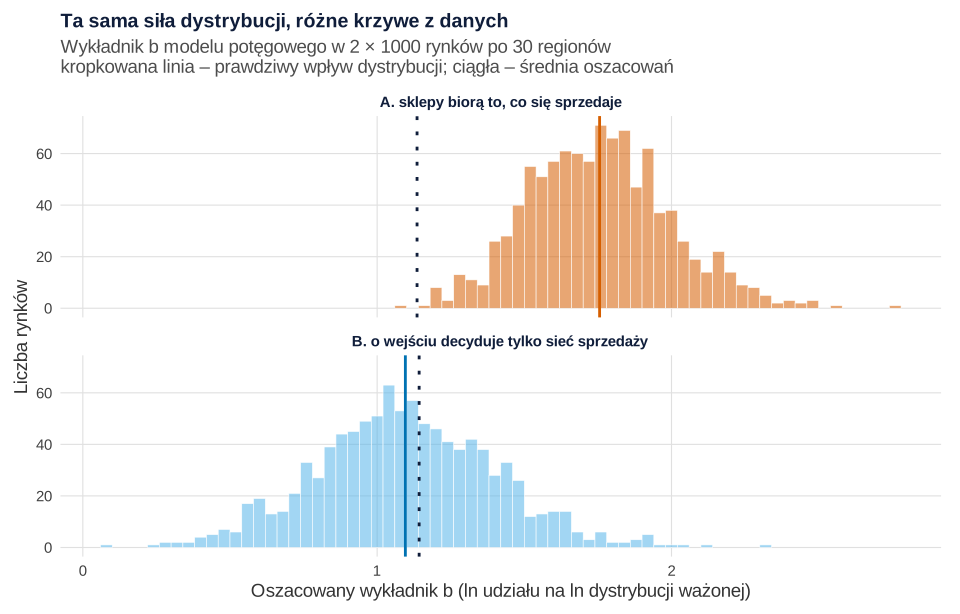
set.seed(6922)).Co widać. W scenariuszu A model potęgowy daje średnio b = 1.76 (błąd Monte Carlo 0.008) zamiast 1.14, a 95% przedział ufności leży w całości powyżej prawdy w 78.9% rynków (błąd MC 1.3 pp). W scenariuszu B średnia to 1.10 (błąd MC 0.010), a przedział leży powyżej prawdy tylko w 1.3% rynków. „Istotnie wypukłą” krzywą (przedział powyżej 1) widzimy w 91.8% rynków A i w 4.6% rynków B – choć dystrybucja działa tak samo.
Jak może zmylić. Wypukła krzywa z danych przekrojowych nie jest więc ani dowodem, że dystrybucja „przyspiesza” sprzedaż, ani gotową prognozą. Zawyża przyrost z nowych sklepów tym bardziej, im mocniej sklepy patrzą na wyniki marki. Wykładnik z naszych danych (1.57) mieści się w rozkładzie scenariusza A. Nie znaczy to, że dystrybucja jest nieważna: w dużym badaniu 70 marek we Francji łączna elastyczność sprzedaży względem dystrybucji wyniosła .74, znacznie więcej niż względem reklamy (.13) i obniżek cen (.04) (Ataman i in., 2010). Ten sam problem odwrotnej przyczynowości dotyczy budżetów reklamowych – zobacz udział w reklamie a udział w rynku.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w marketingu
- Raportuj obie dystrybucje. Numeryczna mówi, ile sklepów obsługuje sieć sprzedaży, ważona – do jakiej części rynku masz dostęp.
- Nie licz przyrostu sprzedaży z krzywej przekrojowej. W przykładzie krzywa z danych obiecuje +6.0 pp udziału za wzrost WD z 60 do 80%, a prawdziwy przyrost to +3.9 pp. Traktuj ją jako górną granicę optymizmu.
- Planuj wejście do sklepów jako eksperyment. Losowo wybrane regiony z dodatkowymi handlowcami przerywają strzałkę „silna marka → dystrybucja”. Jak zaplanować taki test na regionach, opisuje wpis o geo-eksperymencie.
- Myśl o nowych sklepach, nie o średnich. Sklepy bez produktu są mniejsze; prognozę rób dla konkretnej listy sklepów z ich obrotem i liczbą marek.
- Dystrybucja to też wynik. Spadek dystrybucji bywa pierwszym sygnałem słabnącej marki, bo sklepy wycofują to, co się nie sprzedaje (Reibstein i Farris, 1995). Śledź ją razem z ceną i promocjami, a wpływ wszystkich trzech na udziały pokazuje model MCI.
Jak opisać w pracy
Opisz źródło danych o sklepach, definicję obu dystrybucji (czym ważono), jednostkę analizy (region), model krzywej i to, że zależność jest przekrojowa. Szerzej o analizach w pracach z marketingu: statystyka w pracy z marketingu.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę i motyw, przepis 2 – funkcję symulującą rynek i dane, przepis 4 – prawdziwą krzywą używaną w przepisie 6. Przepisy 1–6 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje (przepisy 2, 4 i 6), zaczyna od własnego set.seed(): 692 w przepisie 2, 6921 w przepisie 4 i 6922 w przepisie 6; przepisy 1, 3, 5 i 7 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: w przepisie 1 – obroty 12 sklepów i to, które mają produkt; w przepisie 2 – 30 regionów po 150–350 sklepów, obrót kategorii w sklepie z rozkładu lognormalnego (mediana 60 tys. zł, sdlog 1.1), od 2 do 8 marek na półce zależnie od wielkości sklepu, siłę marki w regionie (SD = 0.35 na skali ln), siłę sieci sprzedaży (SD = 0.8 na skali logitu), regułę wprowadzania produktu (logit = 1.3 × wielkość sklepu + 1.5 × siła marki + siła sieci; stała 0, po pierwszym przebiegu podniesiona z −0.6) i udział napoju w sklepie (atrakcyjność 1.2 × exp(siła marki) wobec konkurentów o atrakcyjności 1, szum SD = 0.2); w przepisie 4 – k = 6 w GAM i 200 000 sklepów do prawdziwej krzywej; w przepisie 6 – 2 × 1000 rynków i wpływ siły marki na decyzję sklepu 1.5 (scenariusz A) albo 0 (scenariusz B). Cały kod liczy się w kilka sekund.
1. Dystrybucja numeryczna i ważona na 12 sklepach: Rysunek 1
R
# Rysunek 1. Dystrybucja numeryczna a ważona na 12 sklepach (liczby ustawione ręcznie, bez losowania)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw – używane w dalszych przepisach
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# 12 sklepów jednego regionu: roczna sprzedaż kategorii napojów izotonicznych (tys. zł)
# i to, czy sklep ma na półce nasz napój (1 = tak)
sklepy <- data.frame(sklep = 1:12,
                     kategoria = c(620, 410, 260, 150, 95, 70, 55, 40, 35, 30, 20, 15),
                     ma_produkt = c(1, 1, 1, 0, 1, 0, 0, 0, 1, 0, 0, 0))
nd <- 100 * mean(sklepy$ma_produkt)                                         # dystrybucja numeryczna
wd <- 100 * sum(sklepy$kategoria[sklepy$ma_produkt == 1]) / sum(sklepy$kategoria)  # dystrybucja ważona
cat("Sprzedaż kategorii razem:", sum(sklepy$kategoria), "tys. zł | w sklepach z produktem:",
    sum(sklepy$kategoria[sklepy$ma_produkt == 1]), "tys. zł\n")
cat(sprintf("Dystrybucja numeryczna: %d z %d sklepów = %.1f%%\n", sum(sklepy$ma_produkt), nrow(sklepy), nd))
cat(sprintf("Dystrybucja ważona: %.1f%%\n", wd))

# Trzy poziomy schematu: wszystkie sklepy -> sklepy z produktem -> ważenie sprzedażą kategorii
kafle <- rbind(
  data.frame(poziom = 3, xmin = (sklepy$sklep - 1) * 100 / 12, xmax = sklepy$sklep * 100 / 12,
             wypelnienie = "brak", etykieta = sklepy$sklep),
  data.frame(poziom = 2, xmin = (sklepy$sklep - 1) * 100 / 12, xmax = sklepy$sklep * 100 / 12,
             wypelnienie = ifelse(sklepy$ma_produkt == 1, "ma", "nie"), etykieta = sklepy$sklep),
  data.frame(poziom = 1, xmax = cumsum(sklepy$kategoria) / sum(sklepy$kategoria) * 100,
             xmin = c(0, head(cumsum(sklepy$kategoria), -1)) / sum(sklepy$kategoria) * 100,
             wypelnienie = ifelse(sklepy$ma_produkt == 1, "ma", "nie"),
             etykieta = ifelse(sklepy$kategoria >= 90, sklepy$sklep, "")))
kafle$etykieta <- as.character(kafle$etykieta)
opisy <- data.frame(poziom = 3:1, x = -2,
                    tekst = c("1. Wszystkie sklepy\n(12 sklepów)", "2. Sklepy z produktem\n(5 z 12)",
                              "3. Ważone sprzedażą\nkategorii"))
wyniki <- data.frame(poziom = 3:1, x = 102,
                     tekst = c("100%", sprintf("numeryczna\n%.1f%%", nd), sprintf("ważona\n%.1f%%", wd)))
p1 <- ggplot(kafle) +
  geom_rect(aes(xmin = xmin + 0.25, xmax = xmax - 0.25, ymin = poziom - 0.32, ymax = poziom + 0.32,
                fill = wypelnienie)) +
  geom_text(aes(x = (xmin + xmax) / 2, y = poziom, label = etykieta,
                colour = ifelse(wypelnienie == "ma", "white", "#0f1d3a")), size = 3.6) +
  geom_text(data = opisy, aes(x = x, y = poziom, label = tekst), hjust = 1, size = 3.7, lineheight = 0.9,
            colour = "#0f1d3a", fontface = "bold") +
  geom_text(data = wyniki, aes(x = x, y = poziom, label = tekst), hjust = 0, size = 3.8, lineheight = 0.9,
            colour = c("#0f1d3a", kol[["pomaranczowy"]], kol[["niebieski"]]), fontface = "bold") +
  annotate("segment", x = 50, xend = 50, y = c(2.62, 1.62), yend = c(2.38, 1.38),
           arrow = arrow(length = unit(0.18, "cm")), colour = "grey40") +
  annotate("text", x = 51, y = c(2.5, 1.5), hjust = 0, size = 3.3, colour = "grey30",
           label = c("liczymy sklepy, w których stoi produkt",
                     "szerokość sklepu = jego udział w sprzedaży kategorii (sklep 1 = 34%)")) +
  scale_fill_manual(values = c(brak = "grey85", ma = kol[["niebieski"]], nie = "grey85"), guide = "none") +
  scale_colour_identity() +
  scale_x_continuous(breaks = NULL) + scale_y_continuous(breaks = NULL) +
  coord_cartesian(xlim = c(-27, 115), ylim = c(0.6, 3.4), expand = FALSE) +
  labs(title = "Dystrybucja numeryczna i ważona – 12 sklepów jednego regionu",
       subtitle = "Niebieski kafel: sklep ma nasz napój izotoniczny na półce; szary – nie ma",
       x = NULL, y = NULL) +
  motyw + theme(panel.grid = element_blank())
p1                       # do pliku: ggsave("dystrybucja-schemat-numeryczna-wazona.svg", p1, width = 10, height = 4.6)
Wynik w R
Sprzedaż kategorii razem: 1800 tys. zł | w sklepach z produktem: 1420 tys. zł
Dystrybucja numeryczna: 5 z 12 sklepów = 41.7%
Dystrybucja ważona: 78.9%
2. Dane: 7126 sklepów w 30 regionach
R
# Dane: fikcyjny producent napojów izotonicznych, sklepy w 30 regionach (rok sprzedaży)
# (korzysta z kol i motyw z przepisu 1)

# Jeden rynek: n_reg regionów, w każdym 150–350 sklepów. Parametry ustawione ręcznie:
#   sprzedaż kategorii w sklepie (tys. zł/rok) – rozkład lognormalny, mediana 60, sdlog 1.1
#                (kilka dużych sklepów robi dużą część obrotu kategorii)
#   liczba marek w kategorii w sklepie: od 2 (mały sklep) do 8 (duży sklep)
#   pref     – siła marki w regionie (preferencje klientów), SD 0.35 na skali ln
#   push     – siła sieci sprzedaży w regionie (handlowcy, hurtownie), SD 0.8 na skali logitu
#   szansa, że sklep ma produkt: logit = 1.3 × wielkość sklepu + wplyw_pref × pref + push
#                (stała 0; po pierwszym przebiegu podniesiona z −0.6, żeby dystrybucja była typowa dla marki średniej)
#   wplyw_pref – jak mocno sklep przy decyzji o wprowadzeniu patrzy na to, czy marka się sprzedaje
#                (1.5 = „sklepy biorą to, co się sprzedaje”; 0 = decyzja bez związku z preferencjami)
#   udział marki w sklepie, który ją ma: a / (a + liczba konkurentów), a = 1.2 × exp(pref) × szum
#                (w małym sklepie z 2 markami nasz napój ma więcej półki i większy udział)
symuluj_rynek <- function(n_reg = 30, wplyw_pref = 1.5, sd_pref = 0.35, sd_push = 0.8, sklepy_od_do = c(150, 350)) {
  n_skl <- sample(sklepy_od_do[1]:sklepy_od_do[2], n_reg, replace = TRUE)
  region <- rep(seq_len(n_reg), n_skl)
  pref <- rnorm(n_reg, 0, sd_pref)
  push <- rnorm(n_reg, 0, sd_push)
  kategoria <- exp(rnorm(length(region), log(60), 1.1))               # tys. zł/rok
  z <- (log(kategoria) - log(60)) / 1.1                               # wielkość sklepu (z-score)
  marek <- 2 + round(6 * pnorm(z))                                    # 2–8 marek na półce
  p_ma <- plogis(1.3 * z + wplyw_pref * pref[region] + push[region])
  ma <- rbinom(length(region), 1, p_ma)
  a <- 1.2 * exp(pref[region] + rnorm(length(region), 0, 0.2))
  udzial_w_sklepie <- a / (a + marek - 1)
  data.frame(region = region, kategoria = kategoria, marek = marek, ma_produkt = ma,
             sprzedaz = ma * kategoria * udzial_w_sklepie, pref = pref[region], push = push[region])
}

# Zestawienie regionów: dystrybucja numeryczna i ważona, udział w rynku, sprzedaż
regiony <- function(s) {
  r <- do.call(rbind, lapply(split(s, s$region), function(x) data.frame(
    region = x$region[1], sklepy = nrow(x), sklepy_z_produktem = sum(x$ma_produkt),
    nd = 100 * mean(x$ma_produkt),                                           # dystrybucja numeryczna, %
    wd = 100 * sum(x$kategoria[x$ma_produkt == 1]) / sum(x$kategoria),       # dystrybucja ważona, %
    kategoria_tys = sum(x$kategoria), sprzedaz_tys = sum(x$sprzedaz))))
  r$udzial <- 100 * r$sprzedaz_tys / r$kategoria_tys                         # udział w rynku regionu, %
  r
}

set.seed(692)
sklepy_all <- symuluj_rynek()
reg <- regiony(sklepy_all)
write.csv(transform(sklepy_all[c("region", "kategoria", "marek", "ma_produkt", "sprzedaz")],
                    kategoria = round(kategoria, 2), sprzedaz = round(sprzedaz, 2)),
          "dystrybucja-izotoniki-sklepy.csv", row.names = FALSE)
write.csv(transform(reg, nd = round(nd, 2), wd = round(wd, 2), kategoria_tys = round(kategoria_tys, 1),
                    sprzedaz_tys = round(sprzedaz_tys, 1), udzial = round(udzial, 3)),
          "dystrybucja-izotoniki-30-regionow.csv", row.names = FALSE)

cat("Sklepy:", nrow(sklepy_all), "| z naszym napojem:", sum(sklepy_all$ma_produkt), "\n")
cat(sprintf("Sprzedaż kategorii: %.1f mln zł | naszej marki: %.1f mln zł | udział w rynku: %.1f%%\n",
            sum(reg$kategoria_tys) / 1000, sum(reg$sprzedaz_tys) / 1000,
            100 * sum(reg$sprzedaz_tys) / sum(reg$kategoria_tys)))
cat(sprintf("Kraj: dystrybucja numeryczna %.1f%%, ważona %.1f%%\n", 100 * mean(sklepy_all$ma_produkt),
            100 * sum(sklepy_all$kategoria * sklepy_all$ma_produkt) / sum(sklepy_all$kategoria)))
duze <- sklepy_all$kategoria >= quantile(sklepy_all$kategoria, 0.9)
cat(sprintf("10%% największych sklepów robi %.1f%% sprzedaży kategorii\n",
            100 * sum(sklepy_all$kategoria[duze]) / sum(sklepy_all$kategoria)))
print(summary(reg[c("sklepy", "nd", "wd", "udzial")]), digits = 3)
Wynik w R
Sklepy: 7126 | z naszym napojem: 2918
Sprzedaż kategorii: 777.2 mln zł | naszej marki: 86.2 mln zł | udział w rynku: 11.1%
Kraj: dystrybucja numeryczna 40.9%, ważona 63.4%
10% największych sklepów robi 41.3% sprzedaży kategorii
     sklepy            nd               wd            udzial
 Min.   :151.0   Min.   : 9.615   Min.   :22.63   Min.   : 2.648
 1st Qu.:189.0   1st Qu.:26.535   1st Qu.:49.66   1st Qu.: 5.681
 Median :215.0   Median :40.997   Median :65.67   Median :10.655
 Mean   :237.5   Mean   :40.873   Mean   :63.13   Mean   :11.008
 3rd Qu.:283.5   3rd Qu.:53.630   3rd Qu.:75.04   3rd Qu.:14.773
 Max.   :350.0   Max.   :76.821   Max.   :91.48   Max.   :25.439
3. Kto ma produkt i luka między dystrybucjami: Rysunek 2
R
# Rysunek 2. Duże sklepy mają produkt częściej, więc dystrybucja ważona > numeryczna
# (korzysta z kol, motyw, sklepy_all i reg z przepisów 1–2)
library(ggplot2)
library(patchwork)

# A: odsetek sklepów z produktem w pięciu grupach wielkości (kwintyle sprzedaży kategorii)
sklepy_all$wielkosc <- cut(sklepy_all$kategoria, quantile(sklepy_all$kategoria, 0:5 / 5), include.lowest = TRUE,
                           labels = c("1. najmniejsze", "2.", "3.", "4.", "5. największe"))
kw <- aggregate(cbind(ma_produkt, marek, kategoria) ~ wielkosc, data = sklepy_all, FUN = mean)
kw$udzial_obrotu <- 100 * tapply(sklepy_all$kategoria, sklepy_all$wielkosc, sum) / sum(sklepy_all$kategoria)
print(data.frame(grupa = kw$wielkosc, proc_z_produktem = round(100 * kw$ma_produkt, 1),
                 marek_na_polce = round(kw$marek, 1), obrot_sklepu_tys = round(kw$kategoria, 1),
                 proc_obrotu_kategorii = round(kw$udzial_obrotu, 1)), row.names = FALSE)

# B: dystrybucja numeryczna a ważona w 30 regionach
cat(sprintf("Regiony: numeryczna %.1f–%.1f%%, ważona %.1f–%.1f%%; ważona wyższa średnio o %.1f pp\n",
            min(reg$nd), max(reg$nd), min(reg$wd), max(reg$wd), mean(reg$wd - reg$nd)))
cat("Korelacja numerycznej z ważoną:", round(cor(reg$nd, reg$wd), 3), "\n")

pA <- ggplot(kw, aes(wielkosc, 100 * ma_produkt)) +
  geom_col(fill = kol[["niebieski"]], width = 0.7) +
  geom_text(aes(label = sprintf("%.0f%%", 100 * ma_produkt)), vjust = -0.4, size = 3.6, colour = "#0f1d3a") +
  geom_text(aes(y = 4, label = sprintf("%.0f%%\nobrotu", udzial_obrotu)), size = 3.1, colour = "white",
            lineheight = 0.85, vjust = 0) +
  scale_y_continuous(limits = c(0, 100), expand = expansion(mult = c(0, 0.02))) +
  labs(title = "A. Kto ma nasz napój?", subtitle = "Sklepy w grupach wielkości (po 20% sklepów);\nw słupku: udział grupy w obrocie kategorii",
       x = "Wielkość sklepu (obrót kategorii)", y = "Sklepy z produktem (%)") +
  motyw + theme(axis.text.x = element_text(size = rel(0.8)))
pB <- ggplot(reg, aes(nd, wd)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = "grey45") +
  geom_point(colour = kol[["pomaranczowy"]], shape = 17, size = 2.6) +
  annotate("text", x = 76, y = 64, label = "ważona =\nnumeryczna", lineheight = 0.9, size = 3.3, colour = "grey40") +
  scale_x_continuous(limits = c(0, 100)) + scale_y_continuous(limits = c(0, 100)) + coord_equal() +
  labs(title = "B. 30 regionów", subtitle = sprintf("Ważona wyższa średnio o %.0f pp", mean(reg$wd - reg$nd)),
       x = "Dystrybucja numeryczna (%)", y = "Dystrybucja ważona (%)") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.25, 1))
p2                       # do pliku: ggsave("dystrybucja-numeryczna-a-wazona-regiony.svg", p2, width = 10, height = 5.6)
Wynik w R
          grupa proc_z_produktem marek_na_polce obrot_sklepu_tys
 1. najmniejsze             12.8            2.6             14.7
             2.             27.9            3.8             34.7
             3.             38.9            5.1             62.0
             4.             51.6            6.3            112.2
  5. największe             73.6            7.4            321.8
 proc_obrotu_kategorii
                   2.7
                   6.4
                  11.4
                  20.6
                  59.0
Regiony: numeryczna 9.6–76.8%, ważona 22.6–91.5%; ważona wyższa średnio o 22.3 pp
Korelacja numerycznej z ważoną: 0.971
4. Krzywa udziału: GAM, model potęgowy i prawdziwy wpływ dystrybucji: Rysunek 3
R
# Rysunek 3. Udział w rynku w funkcji dystrybucji ważonej: GAM, model potęgowy i „prawdziwa” krzywa
# (korzysta z kol, motyw i reg z przepisów 1–2)
library(ggplot2)
library(mgcv)

# 1) GAM: gładka krzywa, stopień wygięcia dobiera kara (REML); k = 6 wystarcza przy 30 regionach
m_gam <- gam(udzial ~ s(wd, k = 6), data = reg, method = "REML")
s_gam <- summary(m_gam)
zapis_p <- function(p) if (p < .001) "p < .001" else sub("0\\.", ".", sprintf("p = %.3f", p))   # zapis APA
cat(sprintf("GAM: edf = %.2f, F = %.2f, %s, wyjaśniona dewiancja = %.1f%%\n",
            s_gam$s.table[1, "edf"], s_gam$s.table[1, "F"], zapis_p(s_gam$s.table[1, "p-value"]), 100 * s_gam$dev.expl))
# 2) Model potęgowy: ln(udział) = a + b × ln(WD); b > 1 oznacza krzywą wypukłą
m_pot <- lm(log(udzial) ~ log(wd), data = reg)
b <- coef(m_pot)[["log(wd)"]]; se_b <- summary(m_pot)$coefficients["log(wd)", "Std. Error"]
ci_b <- confint(m_pot)["log(wd)", ]
t_1 <- (b - 1) / se_b
cat(sprintf("Model potęgowy: b = %.2f, 95%% CI [%.2f, %.2f]; test b = 1: t(%d) = %.2f, %s\n",
            b, ci_b[1], ci_b[2], m_pot$df.residual, t_1, zapis_p(2 * pt(-abs(t_1), m_pot$df.residual))))
# 3) Prosta dla porównania
m_lin <- lm(udzial ~ wd, data = reg)
cat(sprintf("AIC: prosta %.1f | GAM %.1f\n", AIC(m_lin), AIC(m_gam)))

# Przewidywany udział z GAM z 95% CI dla kilku poziomów dystrybucji ważonej
nowe <- data.frame(wd = c(40, 60, 80, 90))
pr <- predict(m_gam, nowe, se.fit = TRUE)
print(data.frame(wd = nowe$wd, udzial = round(pr$fit, 1), dolna = round(pr$fit - 1.96 * pr$se.fit, 1),
                 gorna = round(pr$fit + 1.96 * pr$se.fit, 1)), row.names = FALSE)
cat(sprintf("GAM: przyrost udziału 40→60%% WD: %.1f pp | 60→80%% WD: %.1f pp\n",
            pr$fit[2] - pr$fit[1], pr$fit[3] - pr$fit[2]))

# „Prawdziwa” krzywa przyczynowa: region o przeciętnej sile marki (pref = 0), w którym zmieniamy tylko
# siłę sieci sprzedaży (push). Te same reguły co w symuluj_rynek(), liczone na 200 000 sklepów.
set.seed(6921)
kat <- exp(rnorm(2e5, log(60), 1.1)); z <- (log(kat) - log(60)) / 1.1; marek <- 2 + round(6 * pnorm(z))
a <- 1.2 * exp(rnorm(2e5, 0, 0.2)); s_skl <- a / (a + marek - 1)
krzywa <- do.call(rbind, lapply(seq(-3, 4, by = 0.05), function(push) {
  p <- plogis(1.3 * z + push)
  data.frame(wd = 100 * sum(p * kat) / sum(kat), udzial = 100 * sum(p * kat * s_skl) / sum(kat))
}))
w_krzywej <- function(x) approx(krzywa$wd, krzywa$udzial, xout = x)$y
cat(sprintf("Prawdziwa krzywa (przeciętny region): udział przy WD 40/60/80/90%%: %s pp\n",
            paste(round(w_krzywej(c(40, 60, 80, 90)), 1), collapse = " / ")))
cat(sprintf("Prawdziwy przyrost 40→60%% WD: %.1f pp | 60→80%% WD: %.1f pp\n",
            w_krzywej(60) - w_krzywej(40), w_krzywej(80) - w_krzywej(60)))
zakres <- subset(krzywa, wd >= min(reg$wd) & wd <= max(reg$wd))
cat(sprintf("Wykładnik prawdziwej krzywej w zakresie danych (%.0f–%.0f%% WD): %.2f\n", min(reg$wd), max(reg$wd),
            coef(lm(log(udzial) ~ log(wd), data = zakres))[[2]]))

siatka <- data.frame(wd = seq(min(reg$wd), max(reg$wd), length.out = 200))
pg <- predict(m_gam, siatka, se.fit = TRUE)
siatka$gam <- pg$fit; siatka$dolna <- pg$fit - 1.96 * pg$se.fit; siatka$gorna <- pg$fit + 1.96 * pg$se.fit
siatka$potegowy <- exp(predict(m_pot, siatka) + summary(m_pot)$sigma^2 / 2)
p3 <- ggplot(reg, aes(wd, udzial)) +
  geom_ribbon(data = siatka, aes(x = wd, ymin = dolna, ymax = gorna), inherit.aes = FALSE,
              fill = kol[["blekit"]], alpha = 0.3) +
  geom_line(data = siatka, aes(wd, gam), colour = kol[["niebieski"]], linewidth = 1.1) +
  geom_line(data = siatka, aes(wd, potegowy), colour = kol[["pomaranczowy"]], linewidth = 0.9, linetype = "dashed") +
  geom_line(data = zakres, aes(wd, udzial), colour = "#0f1d3a", linewidth = 1, linetype = "dotted") +
  geom_point(colour = "grey35", size = 2.3) +
  annotate("segment", x = 21, xend = 25, y = c(24, 22, 20), yend = c(24, 22, 20), linewidth = 1,
           colour = c(kol[["niebieski"]], kol[["pomaranczowy"]], "#0f1d3a"), linetype = c("solid", "dashed", "dotted")) +
  annotate("text", x = 26, y = c(24, 22, 20), hjust = 0, size = 3.5,
           colour = c(kol[["niebieski"]], kol[["pomaranczowy"]], "#0f1d3a"),
           label = c("GAM z 95% CI", sprintf("model potęgowy: b = %.2f", b),
                     "prawdziwy wpływ samej dystrybucji (przeciętny region)")) +
  scale_x_continuous(limits = c(20, 95), breaks = seq(20, 90, 10)) +
  scale_y_continuous(limits = c(-2.5, 26)) +
  labs(title = "Im szersza dystrybucja, tym szybciej rośnie udział",
       subtitle = "Punkty – 30 regionów fikcyjnego producenta napojów izotonicznych",
       x = "Dystrybucja ważona (% obrotu kategorii w sklepach z produktem)", y = "Udział w rynku regionu (%)") +
  motyw
p3                       # do pliku: ggsave("dystrybucja-krzywa-udzialu-gam.svg", p3, width = 10, height = 6)
Wynik w R
GAM: edf = 1.73, F = 37.10, p < .001, wyjaśniona dewiancja = 74.7%
Model potęgowy: b = 1.57, 95% CI [1.27, 1.88]; test b = 1: t(28) = 3.87, p < .001
AIC: prosta 157.9 | GAM 157.9
 wd udzial dolna gorna
 40    4.9   3.1   6.8
 60    9.7   8.3  11.1
 80   15.6  14.1  17.2
 90   19.1  16.7  21.4
GAM: przyrost udziału 40→60% WD: 4.8 pp | 60→80% WD: 6.0 pp
Prawdziwa krzywa (przeciętny region): udział przy WD 40/60/80/90%: 6.5 / 10 / 13.9 / 16.1 pp
Prawdziwy przyrost 40→60% WD: 3.5 pp | 60→80% WD: 3.9 pp
Wykładnik prawdziwej krzywej w zakresie danych (23–91% WD): 1.10
5. Wskaźniki „na sklep” i „na punkt dystrybucji”: Rysunek 4
R
# Rysunek 4. Pułapka „średniej na sklep”: wskaźniki na punkt dystrybucji zależą od samej dystrybucji
# (korzysta z kol, motyw, sklepy_all i reg z przepisów 1–2)
library(ggplot2)
library(patchwork)

reg$na_sklep <- reg$sprzedaz_tys / reg$sklepy_z_produktem       # sprzedaż na sklep z produktem, tys. zł
reg$na_punkt_wd <- reg$udzial / reg$wd * 100                     # udział w obrocie sklepów z produktem, %
cat(sprintf("Korelacja sprzedaży na sklep z dystrybucją numeryczną: %.2f\n", cor(reg$na_sklep, reg$nd)))
cat(sprintf("Korelacja udziału w sklepach z produktem z dystrybucją ważoną: %.2f\n", cor(reg$na_punkt_wd, reg$wd)))
t3 <- split(reg, cut(reg$wd, quantile(reg$wd, 0:3 / 3), include.lowest = TRUE, labels = c("niska", "średnia", "wysoka")))
print(do.call(rbind, lapply(names(t3), function(g) data.frame(
  dystrybucja = g, regionow = nrow(t3[[g]]), wd_srednio = round(mean(t3[[g]]$wd), 1),
  na_sklep_tys = round(mean(t3[[g]]$na_sklep), 1), udzial_w_sklepach_z_produktem = round(mean(t3[[g]]$na_punkt_wd), 1)))),
  row.names = FALSE)
# Kto zostaje bez produktu? Obrót kategorii sklepów z produktem i bez niego (cały kraj)
cat(sprintf("Średni obrót kategorii: sklepy z produktem %.1f tys. zł, bez produktu %.1f tys. zł; mediana %.1f vs %.1f\n",
            mean(sklepy_all$kategoria[sklepy_all$ma_produkt == 1]), mean(sklepy_all$kategoria[sklepy_all$ma_produkt == 0]),
            median(sklepy_all$kategoria[sklepy_all$ma_produkt == 1]), median(sklepy_all$kategoria[sklepy_all$ma_produkt == 0])))

pA <- ggplot(reg, aes(nd, na_sklep)) +
  geom_smooth(method = "lm", formula = y ~ x, colour = kol[["niebieski"]], fill = kol[["blekit"]], alpha = 0.25) +
  geom_point(colour = "grey35", size = 2.3) +
  labs(title = "A. Sprzedaż na sklep z produktem", subtitle = sprintf("r = %s", sub("^-0", "−", sprintf("%.2f", cor(reg$na_sklep, reg$nd)))),
       x = "Dystrybucja numeryczna (%)", y = "Tys. zł rocznie na sklep") + motyw
pB <- ggplot(reg, aes(wd, na_punkt_wd)) +
  geom_smooth(method = "lm", formula = y ~ x, colour = kol[["pomaranczowy"]], fill = kol[["pomaranczowy"]], alpha = 0.18) +
  geom_point(colour = "grey35", size = 2.3, shape = 17) +
  labs(title = "B. Udział na punkt dystrybucji ważonej", subtitle = sprintf("r = %s", sub("^0", "", sprintf("%.2f", cor(reg$na_punkt_wd, reg$wd)))),
       x = "Dystrybucja ważona (%)", y = "Udział w obrocie sklepów z produktem (%)") + motyw
p4 <- pA + pB
p4                       # do pliku: ggsave("dystrybucja-pulapka-sredniej-na-sklep.svg", p4, width = 10, height = 5.4)
Wynik w R
Korelacja sprzedaży na sklep z dystrybucją numeryczną: -0.08
Korelacja udziału w sklepach z produktem z dystrybucją ważoną: 0.60
 dystrybucja regionow wd_srednio na_sklep_tys udzial_w_sklepach_z_produktem
       niska       10       41.4         29.7                          12.9
     średnia       10       65.3         31.0                          17.3
      wysoka       10       82.7         28.3                          19.3
Średni obrót kategorii: sklepy z produktem 169.0 tys. zł, bez produktu 67.5 tys. zł; mediana 107.3 vs 42.0
6. Symulacja 2 × 1000 rynków – odwrotna przyczynowość: Rysunek 5
R
# Rysunek 5. Odwrotna przyczynowość: 1000 rynków, na których sklepy biorą to, co się sprzedaje, i 1000,
# na których o wejściu do sklepu decyduje tylko sieć sprzedaży
# (korzysta z kol, motyw i symuluj_rynek z przepisu 2 oraz krzywa z przepisu 4)
library(ggplot2)

wykladnik <- function(s) {                       # szybkie zestawienie regionów + model potęgowy
  kat <- rowsum(s$kategoria, s$region)[, 1]
  wd <- 100 * rowsum(s$kategoria * s$ma_produkt, s$region)[, 1] / kat
  udzial <- 100 * rowsum(s$sprzedaz, s$region)[, 1] / kat
  m <- lm(log(udzial) ~ log(wd))
  ci <- confint(m)[2, ]
  c(b = coef(m)[[2]], dolna = ci[[1]], gorna = ci[[2]], wd_min = min(wd), wd_max = max(wd))
}
set.seed(6922)
R <- 1000
scen <- c("A. sklepy biorą to, co się sprzedaje", "B. o wejściu decyduje tylko sieć sprzedaży")
sym <- rbind(
  data.frame(scenariusz = scen[1], t(replicate(R, wykladnik(symuluj_rynek(wplyw_pref = 1.5))))),
  data.frame(scenariusz = scen[2], t(replicate(R, wykladnik(symuluj_rynek(wplyw_pref = 0))))))

# Wykładnik prawdziwej krzywej (przepis 4) w typowym zakresie dystrybucji każdego scenariusza
b_prawdziwe <- sapply(scen, function(sc) {
  x <- sym[sym$scenariusz == sc, ]
  z <- subset(krzywa, wd >= mean(x$wd_min) & wd <= mean(x$wd_max))
  coef(lm(log(udzial) ~ log(wd), data = z))[[2]]
})
sym$b_prawdziwe <- b_prawdziwe[sym$scenariusz]
podsum <- do.call(rbind, lapply(scen, function(sc) {
  x <- sym[sym$scenariusz == sc, ]
  powyzej <- mean(x$dolna > x$b_prawdziwe)        # 95% CI w całości powyżej prawdziwego wykładnika
  data.frame(scenariusz = sc, b_prawdziwe = round(x$b_prawdziwe[1], 2), b_srednio = round(mean(x$b), 3),
             blad_MC_b = round(sd(x$b) / sqrt(R), 4), proc_CI_powyzej_prawdy = round(100 * powyzej, 1),
             blad_MC_pp = round(100 * sqrt(powyzej * (1 - powyzej) / R), 2),
             proc_b_powyzej_1 = round(100 * mean(x$dolna > 1), 1))
}))
print(podsum, row.names = FALSE)

srednie <- data.frame(scenariusz = scen, b = tapply(sym$b, sym$scenariusz, mean)[scen])
prawda <- data.frame(scenariusz = scen, b = b_prawdziwe)
p5 <- ggplot(sym, aes(b, fill = scenariusz)) +
  geom_histogram(binwidth = 0.04, position = "identity", alpha = 0.55, colour = "white", linewidth = 0.2) +
  geom_vline(data = prawda, aes(xintercept = b), linetype = "dotted", linewidth = 1, colour = "#0f1d3a") +
  geom_vline(data = srednie, aes(xintercept = b, colour = scenariusz), linewidth = 1, show.legend = FALSE) +
  facet_wrap(~ scenariusz, ncol = 1) +
  scale_fill_manual(values = c(kol[["pomaranczowy"]], kol[["blekit"]]), guide = "none") +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]])) +
  labs(title = "Ta sama siła dystrybucji, różne krzywe z danych",
       subtitle = "Wykładnik b modelu potęgowego w 2 × 1000 rynków po 30 regionów\nkropkowana linia – prawdziwy wpływ dystrybucji; ciągła – średnia oszacowań",
       x = "Oszacowany wykładnik b (ln udziału na ln dystrybucji ważonej)", y = "Liczba rynków") +
  motyw
p5                       # do pliku: ggsave("dystrybucja-symulacja-odwrotna-przyczynowosc.svg", p5, width = 10, height = 6.4)
Wynik w R
                                 scenariusz b_prawdziwe b_srednio blad_MC_b
       A. sklepy biorą to, co się sprzedaje        1.14     1.756    0.0076
 B. o wejściu decyduje tylko sieć sprzedaży        1.14     1.096    0.0097
 proc_CI_powyzej_prawdy blad_MC_pp proc_b_powyzej_1
                   78.9       1.29             91.8
                    1.3       0.36              4.6
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – pomarańczowy" = c("#56B4E9", "#D55E00"),
             "niebieski – szary (kafle)" = c("#0072B2", "#D9D9D9"), "pomarańczowy – szary (punkty)" = c("#D55E00", "#595959"),
             "niebieski – granat" = c("#0072B2", "#0f1d3a"), "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
błękit – pomarańczowy                      113.6        101.1       89.0
niebieski – szary (kafle)                   58.1         62.0       53.4
pomarańczowy – szary (punkty)               78.4         65.8       54.7
niebieski – granat                          41.3         40.8       41.3
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresje liniowe i model potęgowy policzono pakietem stats (z podstawowej instalacji R). Model GAM dopasowano pakietem mgcv (wczytuje on pakiet nlme). Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mgcv (wersja 1.9-4): Wood, S. N. (2011). Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 73(1), 3–36. https://doi.org/10.1111/j.1467-9868.2010.00749.x
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Dystrybucja bez półki. Sklep „ma produkt”, nawet gdy stoi on w jednym froncie na dolnej półce. W eksperymencie z eye-trackingiem liczba frontów silnie wpływała na uwagę i ocenę marki, zwłaszcza marki o małym udziale, a górna półka działała lepiej niż dolna (Chandon i in., 2009). Jeśli masz dane o frontach, dodaj je do modelu.
- Braki na półce. Dystrybucja z listy produktów sklepu nie widzi pustej półki.
- Odwrotna przyczynowość. Sklepy biorą to, co się sprzedaje, więc krzywa z danych przekrojowych zawyża wpływ dystrybucji (rysunek 5). Nawet model, w którym kupujący przechodzą do innej marki, gdy ich ulubionej nie ma, wymaga uwzględnienia decyzji handlu (Farris i in., 1989).
- Ekstrapolacja. Najszersza dystrybucja w danych to 91.5%. Przewidywanie przy 100% wychodzi poza obserwowany zakres, a pasmo ufności rośnie na krańcach.
- Mała liczba regionów. 30 punktów nie odróżni łagodnej krzywej od prostej (AIC 157.9 w obu modelach). Kształt opisuj wykładnikiem z przedziałem ufności i rysunkiem, nie samym wyborem modelu (zob. regresja krzywoliniowa).
Najczęstsze pytania
Czym różni się dystrybucja numeryczna od ważonej?
Numeryczna to odsetek sklepów, w których produkt jest na półce – każdy sklep liczy się tak samo. Ważona (ACV) to odsetek sprzedaży kategorii albo obrotu sklepów, który przypada na sklepy z produktem. W przykładzie 12 sklepów napój był w 5 (41.7%), ale te sklepy robiły 78.9% obrotu kategorii.
Dlaczego dystrybucja ważona jest zwykle wyższa od numerycznej?
Bo produkt częściej trafia do dużych sklepów, które robią większość obrotu. W przykładzie produkt miało 73.6% największych sklepów i 12.8% najmniejszych, a ważona była wyższa od numerycznej średnio o 22.3 pp w 30 regionach.
Dlaczego udział w rynku rośnie z dystrybucją coraz szybciej?
Na danych przekrojowych udział jest zwykle wypukłą funkcją dystrybucji (Reibstein i Farris, 1995). Część tego kształtu to prawdziwy mechanizm: nowe, małe sklepy mają mniej konkurencyjnych marek. Część to odwrotna przyczynowość – sklepy chętniej wprowadzają markę, która dobrze się sprzedaje, więc silna marka ma jednocześnie szerszą dystrybucję i większy udział.
Czy z krzywej dystrybucja–udział można przewidzieć efekt wejścia do nowych sklepów?
Ostrożnie. W przykładzie krzywa z danych obiecywała +6.0 pp udziału za wzrost dystrybucji ważonej z 60 do 80%, a prawdziwy przyrost wynosił +3.9 pp. W symulacji 1000 rynków przedział ufności wykładnika leżał w całości powyżej prawdy w 78.9% rynków, gdy sklepy kierowały się siłą marki. Efekt nowych sklepów najlepiej sprawdzić eksperymentem na regionach.
Jak dopasować krzywą dystrybucji w R?
Najprościej modelem potęgowym lm(log(udzial) ~ log(wd)) – wykładnik większy od 1 oznacza krzywą wypukłą – albo modelem GAM mgcv::gam(udzial ~ s(wd), method = "REML"). Wynik przedstaw rysunkiem krzywej z 95% CI i kilkoma wartościami przewidywanymi, a przy kilkudziesięciu regionach nie wymagaj, by AIC rozstrzygnęło o kształcie.
Powiązane hasła
Przeczytaj też
Nieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →PoradnikModel atrakcyjności udziałów (MCI)
Rynek proszków do prania: udział jako atrakcyjność, log-centrowanie, elastyczności krzyżowe, symulacja obniżki ceny i logit udziałów – z kodem R.
Czytaj →PoradnikPodział budżetu marketingowego
Szkoła programowania i cztery kanały reklamy: krzywe odpowiedzi, programowanie liniowe, krańcowy zwrot, 1000 losowań i pułapka ekstrapolacji – z kodem R.
Czytaj →Analizujesz dystrybucję i sprzedaż w pracy dyplomowej?
Pomożemy przygotować dane ze sklepów, policzyć dystrybucję numeryczną i ważoną, dopasować krzywą udziału i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Ataman, M. B., Van Heerde, H. J., & Mela, C. F. (2010). The long-term effect of marketing strategy on brand sales. Journal of Marketing Research, 47(5), 866–882. https://doi.org/10.1509/jmkr.47.5.866
- Bronnenberg, B. J., Mahajan, V., & Vanhonacker, W. R. (2000). The emergence of market structure in new repeat-purchase categories: The interplay of market share and retailer distribution. Journal of Marketing Research, 37(1), 16–31. https://doi.org/10.1509/jmkr.37.1.16.18723
- Chandon, P., Hutchinson, J. W., Bradlow, E. T., & Young, S. H. (2009). Does in-store marketing work? Effects of the number and position of shelf facings on brand attention and evaluation at the point of purchase. Journal of Marketing, 73(6), 1–17. https://doi.org/10.1509/jmkg.73.6.1 ● Otwarty dostęp: pełny tekst
- Farris, P., Olver, J., & De Kluyver, C. (1989). The relationship between distribution and market share. Marketing Science, 8(2), 107–128. https://doi.org/10.1287/mksc.8.2.107
- Reibstein, D. J., & Farris, P. W. (1995). Market share and distribution: A generalization, a speculation, and some implications. Marketing Science, 14(3_supplement), G190–G202. https://doi.org/10.1287/mksc.14.3.g190 ● Otwarty dostęp: pełny tekst
- Wood, S. N. (2011). Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 73(1), 3–36. https://doi.org/10.1111/j.1467-9868.2010.00749.x ● Otwarty dostęp
Cytowania BibTeX
@article{ataman2010long, author={Ataman, M. Berk and Van Heerde, Harald J. and Mela, Carl F.}, title={{The long-term effect of marketing strategy on brand sales}}, journal={Journal of Marketing Research}, year={2010}, volume={47}, number={5}, pages={866--882}, doi={10.1509/jmkr.47.5.866}}@article{bronnenberg2000emergence, author={Bronnenberg, Bart J. and Mahajan, Vijay and Vanhonacker, Wilfried R.}, title={{The emergence of market structure in new repeat-purchase categories: The interplay of market share and retailer distribution}}, journal={Journal of Marketing Research}, year={2000}, volume={37}, number={1}, pages={16--31}, doi={10.1509/jmkr.37.1.16.18723}}@article{chandon2009does, author={Chandon, Pierre and Hutchinson, J. Wesley and Bradlow, Eric T. and Young, Scott H.}, title={{Does in-store marketing work? Effects of the number and position of shelf facings on brand attention and evaluation at the point of purchase}}, journal={Journal of Marketing}, year={2009}, volume={73}, number={6}, pages={1--17}, doi={10.1509/jmkg.73.6.1}}@article{farris1989relationship, author={Farris, Paul and Olver, James and De Kluyver, Cornelis}, title={{The relationship between distribution and market share}}, journal={Marketing Science}, year={1989}, volume={8}, number={2}, pages={107--128}, doi={10.1287/mksc.8.2.107}}@article{reibstein1995market, author={Reibstein, David J. and Farris, Paul W.}, title={{Market share and distribution: A generalization, a speculation, and some implications}}, journal={Marketing Science}, year={1995}, volume={14}, number={3_supplement}, pages={G190--G202}, doi={10.1287/mksc.14.3.g190}}@article{wood2011fast, author={Wood, Simon N.}, title={{Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models}}, journal={Journal of the Royal Statistical Society: Series B (Statistical Methodology)}, year={2011}, volume={73}, number={1}, pages={3--36}, doi={10.1111/j.1467-9868.2010.00749.x}}