Przykład: szkoła programowania online i cztery kanały
Fikcyjna szkoła programowania online sprzedaje kilkumiesięczne kursy (Python, front-end, analiza danych). Na reklamę wydaje 400 tys. zł miesięcznie w czterech kanałach: reklama w wyszukiwarce 200 tys. zł, media społecznościowe 130 tys., wideo online 50 tys. oraz sponsorowane podcasty i newslettery 20 tys. zł. Jeden zapis na kurs daje 1.5 tys. zł marży. Zarząd pyta: jak podzielić te same 400 tys. zł na 2027 rok, żeby zapisów było więcej – i czy w ogóle wydawać więcej?
Potrzebne są dwie rzeczy: krzywe odpowiedzi kanałów z modelu marketing mix (MMM) – tam opisujemy, jak się je szacuje – i optymalizacja przy zasadach firmy, czyli programowanie liniowe.
Dane są fikcyjne. Parametry krzywych, ich błędy standardowe i zakresy wydatków ustawiliśmy ręcznie i traktujemy jak wynik MMM (podzial-budzetu-zalozenia-krzywych.csv). Dzięki temu znamy „prawdę”. Ziarna (693 i 6930) ustalono raz i nie zmieniano. Po pierwszym uruchomieniu zmieniliśmy dwie rzeczy: obecny podział budżetu (pierwotnie 150, 120, 90 i 40 tys. zł – zysk z przesunięć wynosił tylko 1.2%, więc daliśmy wyszukiwarce większą część budżetu, jak w wielu firmach) oraz tempo nasycenia krzywej alternatywnej na rysunku 5 (z 3 na 10 razy szybciej). Wyniki 1000 losowań są w pliku podzial-budzetu-1000-losowan.csv.
Rysunek 1: od krzywych do planu
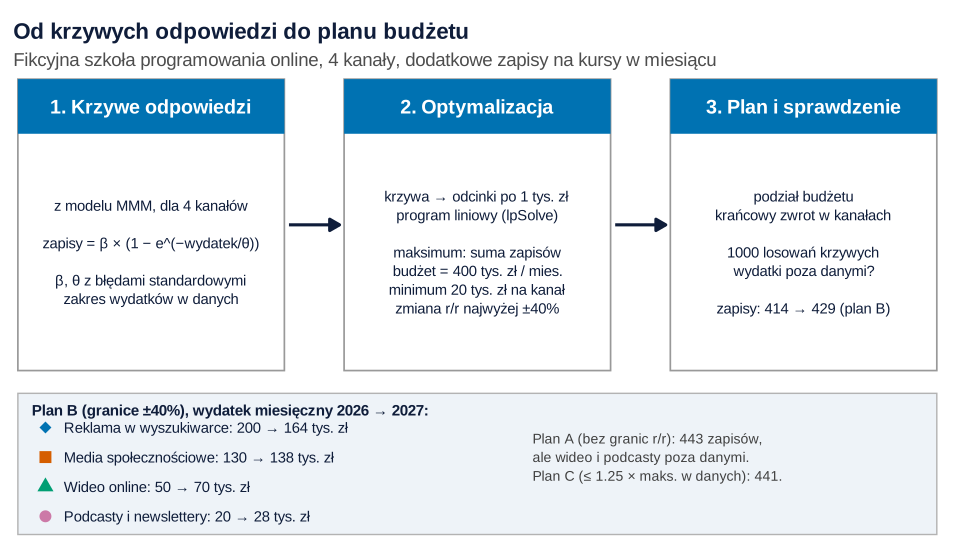
Co widać. Plan B, który szanuje zasady firmy, przesuwa 36 tys. zł z wyszukiwarki do pozostałych kanałów i daje 429 zamiast 414 dodatkowych zapisów miesięcznie.
Jak może zmylić. Optymalizacja jest tak dobra, jak krzywe, które dostaje – dlatego trzeci krok to też sprawdzenie niepewności i ekstrapolacji (rysunki 4 i 5).
Podpis do pracy:
Rysunek 2: krzywe odpowiedzi i ich przybliżenie
Krzywa odpowiedzi mówi, ile dodatkowych zapisów w miesiącu daje wydatek w kanale. Zakładamy kształt wklęsły: każdy kolejny złoty daje mniej. Little (1979) w przeglądzie modeli reklamy zauważa, że odpowiedź sprzedaży bywa wklęsła albo w kształcie litery S; podobne nasycenie widać przy częstotliwości kontaktu z reklamą. Wzór:
Tu x to miesięczny wydatek w tys. zł, βk – górna granica zapisów z kanału, a θk – skala nasycenia (przy wydatku równym θ kanał daje 63% swojej granicy). Wyszukiwarka ma β = 260 i θ = 110, media społecznościowe 200 i 150, wideo 300 i 250, podcasty 90 i 60. Parametry mają błędy standardowe na skali logarytmu (0.08–0.35) i są skorelowane (korelacja 0.8): model dobrze widzi nachylenie krzywej, gorzej – miejsce wypłaszczenia.
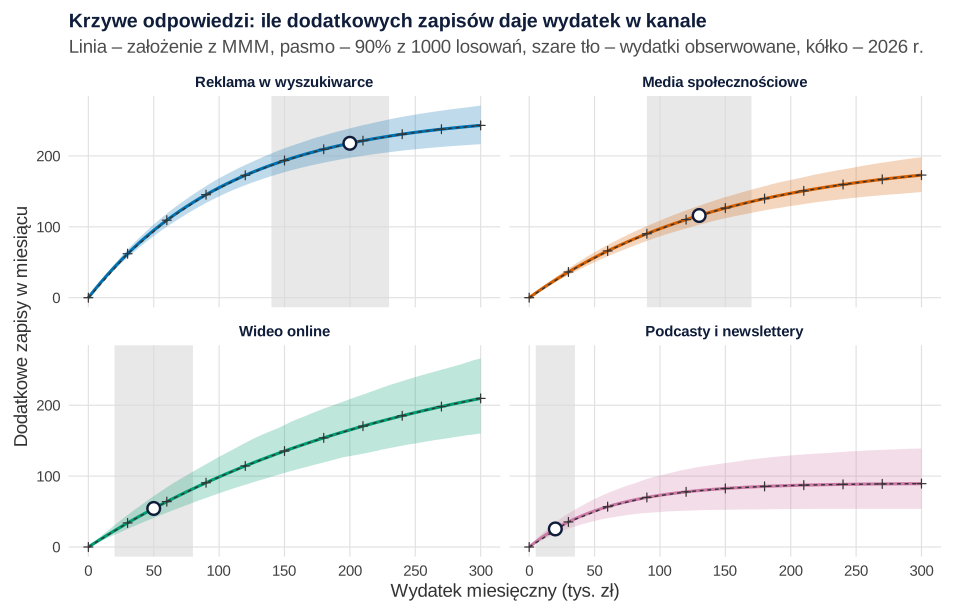
set.seed(693)).Co widać. Obecnie wyszukiwarka daje 217.8 zapisu, media społecznościowe 115.9, wideo 54.4, a podcasty 25.5 – razem 413.6, czyli 967.1 zł reklamy na zapis. O podziale decyduje jednak krańcowy zwrot – nachylenie krzywej przy obecnym wydatku. Dodatkowy 1 tys. zł daje w wyszukiwarce 0.384 zapisu (0.58 zł marży na złotówkę), w mediach społecznościowych 0.560, w wideo 0.982, a w podcastach 1.075 (1.61 zł).
Przybliżenie odcinkami. Program liniowy maksymalizuje tylko sumę „nachylenie × ilość”, więc krzywą zastępujemy łamaną (krzyżyki). Pierwsze odcinki po 10 tys. zł w wyszukiwarce mają nachylenia 2.259, 2.063 i 1.884 zapisu na 1 tys. zł – maleją, bo krzywa jest wklęsła. Łamana odbiega od krzywej najwyżej o 0.29 zapisu; w optymalizacji używamy odcinków po 1 tys. zł.
Jak może zmylić. Poza szarym tłem pasmo szybko się rozszerza: wideo przy obecnym wydatku daje od 41 do 72 zapisów (90% losowań), a przy dwa razy większym – od 76 do 127. Dane MMM mówią coś tylko o wydatkach, które wystąpiły.
Podpis do pracy:
Rysunek 3: programowanie liniowe i krańcowy zwrot
Zmienne decyzyjne to wydatki w kolejnych odcinkach: ykj – ile z odcinka j (od 0 do 1 tys. zł) wydajemy w kanale k. Program liniowy wygląda tak:
gdzie skj to nachylenie odcinka (zapisy na 1 tys. zł), a Lk i Uk – granice wydatku kanału. Nachylenia maleją, więc program wypełnia odcinki po kolei. Rozwiązujemy dwa warianty w pakiecie lpSolve: plan A – tylko minimum 20 tys. zł na kanał (żeby marka nie znikała), plan B – dodatkowo wydatek kanału najwyżej o 40% wyższy lub niższy niż w 2026 r. To samo narzędzie służy w serwisie do oceny efektywności oddziałów (DEA).
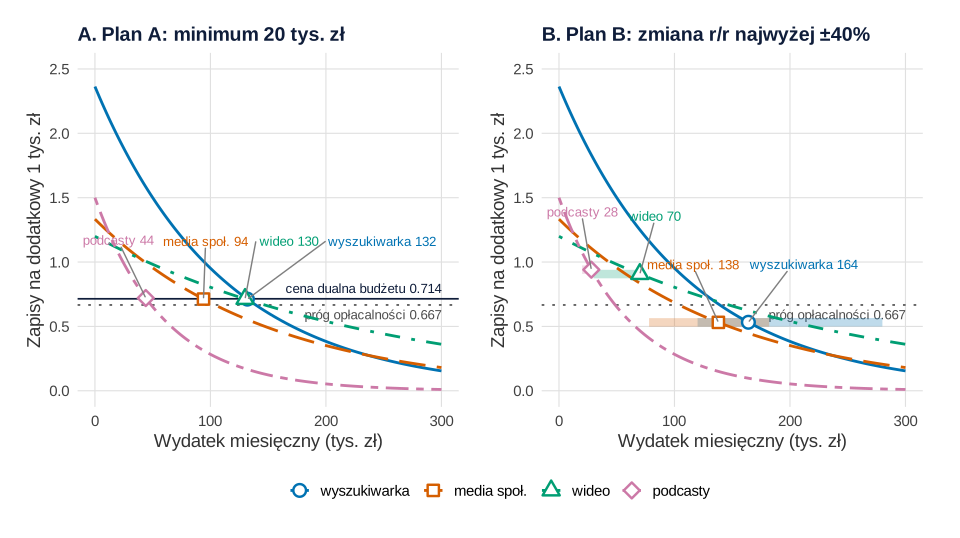
Co widać w panelu A. Plan A daje wyszukiwarce 132 tys. zł, mediom społecznościowym 94, wideo 130, a podcastom 44 tys. zł. Zapisów jest 443.2 zamiast 413.6 (+7.2%), czyli 533.0 tys. zł marży więcej rocznie przy tym samym budżecie. Krańcowy zwrot jest taki sam we wszystkich kanałach (0.712–0.720 zapisu na 1 tys. zł) – gdyby jeden kanał dawał więcej, opłacałoby się przesunąć do niego pieniądze. Wspólny poziom to cena dualna ograniczenia budżetu: 0.714 zapisu za dodatkowy 1 tys. zł, czyli 1.07 zł marży na złotówkę. Dokładne optimum daje 443.23 zapisu – tyle samo co program z odcinkami po 1 tys. zł (po 10 tys. zł: 443.02).
Co widać w panelu B. Z granicami ±40% plan B to 164, 138, 70 i 28 tys. zł, a zapisów jest 428.6 (+3.6%, 269.3 tys. zł marży rocznie). Wideo i podcasty utknęły na górnej granicy, gdzie krańcowy zwrot wynosi 0.907 i 0.941. W wyszukiwarce i mediach społecznościowych krańcowy zwrot spadł do 0.53, czyli 0.80 zł marży na złotówkę. Różnica między planami (14.6 zapisu miesięcznie) to koszt reguły ±40%.
Czy wydawać więcej? Cena dualna spada z budżetem: 0.850 przy 300 tys. zł, 0.714 przy 400 tys. i 0.665 przy 440 tys. zł – poniżej progu 1 / 1.5 = 0.667 zapis kosztuje więcej, niż przynosi. Największy opłacalny budżet to około 435 tys. zł miesięcznie, jeśli krzywe są prawdziwe. Mantrala i in. (1992) pokazują, że zysk zwykle bardziej zależy od reguły podziału budżetu niż od jego wysokości; Fischer i in. (2011) przytaczają ten wniosek z wcześniejszych badań. W przykładzie lepszy podział tych samych 400 tys. zł dał 29.6 zapisu więcej, a dokładanie pieniędzy szybko przestaje się opłacać.
Zdanie do Wyników:
Rysunek 4: niepewność krzywych – 1000 losowań
Plan jest tak niepewny jak krzywe. Losujemy 1000 zestawów parametrów (logarytmy z rozkładu normalnego z błędami standardowymi i korelacją 0.8) i w każdym od nowa rozwiązujemy program liniowy (odcinki po 5 tys. zł). To prosta symulacyjna analiza wrażliwości, podobna do symulacji Monte Carlo opłacalności projektu.
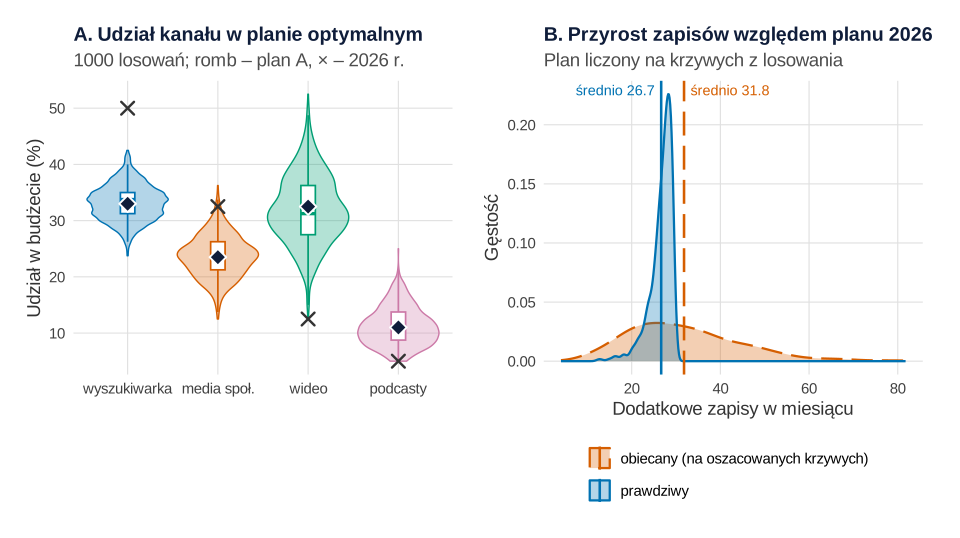
set.seed(6930)).Co widać w panelu A. Udziały kanałów mocno się wahają. Wideo dostaje w planie A 32.5% budżetu, ale w zależności od losowania od 22.5% do 42.5% (5. i 95. percentyl); podcasty od 6.2% do 17.5%. Kierunek jest jednak stały: wyszukiwarka traci w każdym losowaniu (najwyżej 42.5% budżetu wobec 50% dziś), a wideo dostaje co najmniej tyle co dziś (najmniej 12.5%). W planie B wideo i podcasty trafiają na górną granicę w 99.9% i 99.1% losowań – ta decyzja nie zależy od niepewności.
Dobra wiadomość: płaskie maksimum. Plan A z rysunku 3, oceniony na krzywych z każdego losowania, traci wobec optimum tego losowania medianę 0.48% zapisów, a w 95% losowań nie więcej niż 1.78%. Lepszy od planu 2026 jest w 99.7% losowań (błąd Monte Carlo 0.2 pp), średnio o 28.9 zapisu, 90% losowań w przedziale [10.0, 49.4]. Tull i in. (1986) opisują to samo zjawisko przy wysokości budżetu reklamy: w okolicy optimum zysk jest płaski, więc dokładne „co do tysiąca” optimum nie jest potrzebne.
Co widać w panelu B – klątwa optymalizatora. Teraz każde losowanie udaje oszacowanie z MMM, a krzywe z rysunku 2 – prawdę. Plan optymalny dla oszacowania obiecuje średnio 31.8 dodatkowego zapisu, a daje 26.7; rozczarowanie zdarza się w 57.8% losowań. Optymalizator wybiera to, co oszacowanie przecenia, więc obietnica jest zawyżona, nawet gdy oszacowania są nieobciążone (Smith i Winkler, 2006). To kuzyn klątwy zwycięzcy z testów wielu wariantów (zob. ile kreacji testować przy małym budżecie).
Podpis do pracy:
Rysunek 5: pułapka ekstrapolacji
Plan A daje wideo 130 tys. zł, choć w danych wydatek nie przekroczył 80 tys.; podcastom – 44 tys. przy maksimum 35 tys. Wyżej krzywa to tylko założenie. Krzywa alternatywna jest do 80 tys. zł identyczna, a dalej nasyca się 10 razy szybciej (np. kończy się grupa docelowa; tempo ustawione ręcznie). Plan C to kompromis: jak A, ale najwyżej 1.25 × największy wydatek z danych.
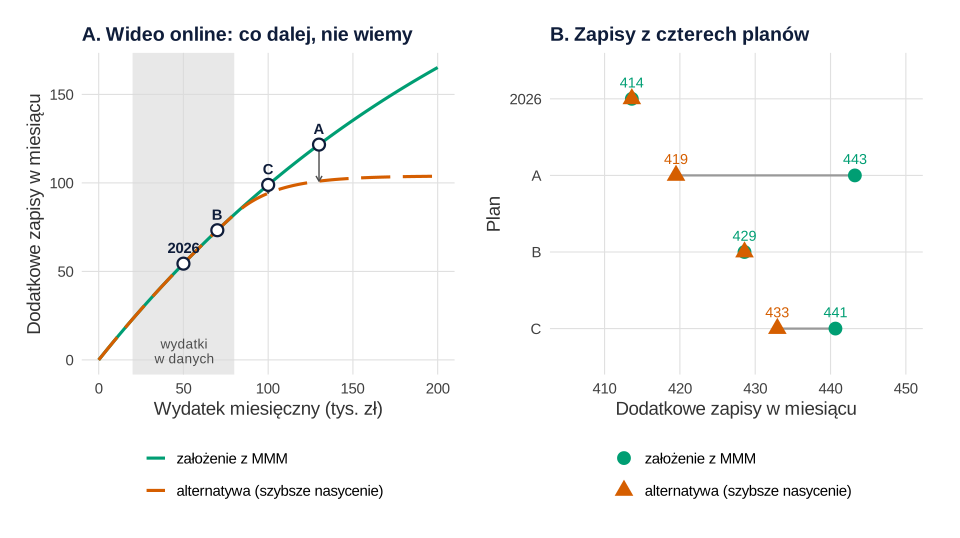
Co widać. Według założenia plan A daje 29.6 zapisu więcej niż plan 2026, ale przy krzywej alternatywnej – tylko 5.9. Plan B, który nie wychodzi poza dane, daje w obu wersjach 15.0. Plan C (wideo 100, podcasty 43.8 tys. zł) obiecuje 27.0, a przy alternatywie zachowuje 19.3. Dane z przeszłości nie rozstrzygną, która krzywa jest prawdziwa.
Jak może zmylić. Pasma z rysunku 2 też nie chronią przed tą pułapką: pokazują niepewność parametrów przy założonym kształcie. Ryzyko złego kształtu poza danymi trzeba sprawdzić osobno, tak jak tutaj.
Podpis do pracy:
Co z tym zrobić w marketingu
- Przenoś pieniądze według krańcowego, nie średniego zwrotu. Wyszukiwarka ma najwięcej zapisów, ale ostatni 1 tys. zł dawał tam 0.384 zapisu, a w podcastach – 1.075.
- Na 2027 rok przyjmij plan B. Mieści się w danych, w 1000 losowaniach przesuwa budżet w tę samą stronę i daje 15.0 zapisu miesięcznie więcej przy obu wersjach krzywej wideo.
- Zbadaj wideo powyżej 80 tys. zł eksperymentem. Podnieś budżet wideo do 100–130 tys. zł w części regionów i porównaj z resztą, jak w geo-eksperymencie. Wynik poprawi krzywą na kolejny rok.
- Nie podnoś budżetu w ciemno. Przy krzywych z MMM opłaca się najwyżej około 435 tys. zł miesięcznie, ale ta liczba zależy od ekstrapolacji tak samo jak plan A.
- Obiecuj ostrożnie. Optymalny plan obiecuje więcej, niż da (średnio 31.8 wobec 26.7 zapisu). W prezentacji dla zarządu podaj przedział z losowań, a nie jedną liczbę.
Krzywe nasycenia opisuje też wpis o dystrybucji a sprzedaży, a planowanie pod ograniczeniami – o obsadzie infolinii. Zapis wyceniaj szerzej jako wartość klienta (CLV). Tematy prac zbiera statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie opisz źródło i kształt krzywych, program liniowy z ograniczeniami i ocenę niepewności; oddziel dane od założeń.
W ograniczeniach napisz, że krzywe są wynikiem modelu obserwacyjnego, a plan poza zakresem danych opiera się na założeniu kształtu.
Kod R: krzywe, program liniowy i losowania
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, założenia i funkcje, przepis 2 – funkcję programu liniowego plan_lp() i plany A i B, z których korzystają przepisy 3–5. Przepisy 1–5 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 i 3 i każdy zaczyna od własnego set.seed(): 693 w przepisie 1 (pasma na rysunku 2) i 6930 w przepisie 3 (1000 losowań do optymalizacji). Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: parametry krzywych β i θ, ich błędy standardowe i korelację 0.8, obecny podział budżetu, zakresy wydatków w danych i marżę 1.5 tys. zł z zapisu (przepis 1); minimum 20 tys. zł na kanał, granicę ±40% i długość odcinków (przepis 2); tempo nasycenia krzywej alternatywnej i granicę 1.25 × maksimum w planie C (przepis 4). Po pierwszym uruchomieniu zmieniono obecny podział budżetu (opis w sekcji „Przykład”), tempo nasycenia krzywej alternatywnej (z 3 na 10 razy szybciej) oraz długość odcinków w optymalizacji (z 10 na 1 tys. zł, żeby krańcowe zwroty w optimum były równe z dokładnością do trzech miejsc). Cały kod liczy się w kilkanaście sekund.
1. Założenia, krzywe odpowiedzi i ich przybliżenie: Rysunek 2
R
# Rysunek 2. Krzywe odpowiedzi czterech kanałów z niepewnością i ich odcinkowo-liniowe przybliżenie
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(wyszukiwarka = "#0072B2", social = "#D55E00", wideo = "#009E73", podcasty = "#CC79A7",
         blekit = "#56B4E9", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Założenia z modelu marketing mix (MMM) dla 4 kanałów – parametry ustawione ręcznie (dane fikcyjne).
# Krzywa: dodatkowe zapisy na kurs w miesiącu = beta × (1 − exp(−wydatek / theta)), wydatek w tys. zł
# beta – górna granica zapisów z kanału, theta – skala nasycenia (przy wydatku = theta kanał daje 63% beta)
# se_* – błędy standardowe logarytmów parametrów; korelacja log(beta) i log(theta) = 0.8
zal <- data.frame(
  kanal    = c("wyszukiwarka", "social", "wideo", "podcasty"),
  nazwa    = c("Reklama w wyszukiwarce", "Media społecznościowe", "Wideo online", "Podcasty i newslettery"),
  beta     = c(260, 200, 300, 90),
  theta    = c(110, 150, 250, 60),
  se_beta  = c(0.08, 0.12, 0.25, 0.30),
  se_theta = c(0.10, 0.15, 0.30, 0.35),
  obecny   = c(200, 130, 50, 20),          # średni wydatek miesięczny w 2026 r. (tys. zł), razem 400
  obs_min  = c(140, 90, 20, 5),            # najmniejszy i największy miesięczny wydatek w danych MMM
  obs_max  = c(230, 170, 80, 35))
rho <- 0.8
marza <- 1.5                               # marża z jednego zapisu: 1.5 tys. zł
write.csv(zal, "podzial-budzetu-zalozenia-krzywych.csv", row.names = FALSE)

krzywa  <- function(x, beta, theta) beta * (1 - exp(-x / theta))     # zapisy w miesiącu
krancowy <- function(x, beta, theta) beta / theta * exp(-x / theta)  # zapisy na 1 tys. zł przy wydatku x

# Obecny plan: zapisy i krańcowy zwrot w każdym kanale
obecne <- with(zal, data.frame(kanal, wydatek = obecny, zapisy = krzywa(obecny, beta, theta),
                               zapisy_na_1_tys = krancowy(obecny, beta, theta)))
obecne$zl_marzy_na_1_zl <- obecne$zapisy_na_1_tys * marza
print(transform(obecne, zapisy = round(zapisy, 1), zapisy_na_1_tys = round(zapisy_na_1_tys, 3),
                zl_marzy_na_1_zl = round(zl_marzy_na_1_zl, 2)), row.names = FALSE)
round(c(razem_zapisy = sum(obecne$zapisy), koszt_zapisu_zl = 1000 * sum(zal$obecny) / sum(obecne$zapisy)), 1)

# Niepewność krzywych: 1000 losowań parametrów z rozkładu normalnego logarytmów (z korelacją rho)
set.seed(693)
R <- 1000
losuj <- function(R) {
  do.call(rbind, lapply(seq_len(nrow(zal)), function(k) {
    z1 <- rnorm(R); z2 <- rho * z1 + sqrt(1 - rho^2) * rnorm(R)
    data.frame(los = 1:R, kanal = zal$kanal[k], beta = zal$beta[k] * exp(zal$se_beta[k] * z1),
               theta = zal$theta[k] * exp(zal$se_theta[k] * z2))
  }))
}
los <- losuj(R)
# Pasmo 90% krzywej w każdym kanale (siatka co 5 tys. zł do 300 tys. zł)
siatka <- seq(0, 300, by = 5)
pasmo <- do.call(rbind, lapply(zal$kanal, function(k) {
  l <- los[los$kanal == k, ]; m <- sapply(siatka, function(x) krzywa(x, l$beta, l$theta))
  data.frame(kanal = k, x = siatka, srodek = krzywa(siatka, zal$beta[zal$kanal == k], zal$theta[zal$kanal == k]),
             dolna = apply(m, 2, quantile, 0.05), gorna = apply(m, 2, quantile, 0.95))
}))
# Jak szerokie jest pasmo przy obecnym wydatku i przy wydatku dwa razy większym (zapisy, 90%)
szer <- do.call(rbind, lapply(zal$kanal, function(k) {
  z <- zal[zal$kanal == k, ]; l <- los[los$kanal == k, ]
  q1 <- quantile(krzywa(z$obecny, l$beta, l$theta), c(0.05, 0.95))
  q2 <- quantile(krzywa(2 * z$obecny, l$beta, l$theta), c(0.05, 0.95))
  data.frame(kanal = k, przy_obecnym = sprintf("[%.0f, %.0f]", q1[1], q1[2]),
             przy_2x = sprintf("[%.0f, %.0f]", q2[1], q2[2]))
}))
print(szer, row.names = FALSE)

# Odcinkowo-liniowe przybliżenie: odcinki po 10 tys. zł; nachylenie odcinka = zapisy na 1 tys. zł
krok <- 10                                 # w rysunku i w kontroli błędu; w optymalizacji odcinki po 1 tys. zł
wezly <- seq(0, 500, by = krok)
odcinki <- do.call(rbind, lapply(seq_len(nrow(zal)), function(k)
  data.frame(kanal = zal$kanal[k], od = head(wezly, -1),
             nachylenie = diff(krzywa(wezly, zal$beta[k], zal$theta[k])) / krok)))
# Pierwsze trzy odcinki każdego kanału (nachylenia maleją – krzywa jest wklęsła)
print(do.call(rbind, lapply(split(odcinki, odcinki$kanal), function(o) round(o$nachylenie[1:3], 3))))
# Największy błąd przybliżenia w zakresie 0–300 tys. zł (zapisy)
blad <- sapply(seq_len(nrow(zal)), function(k) {
  x <- seq(0, 300, by = 0.5)
  max(abs(krzywa(x, zal$beta[k], zal$theta[k]) - approx(wezly, krzywa(wezly, zal$beta[k], zal$theta[k]), x)$y))
})
round(setNames(blad, zal$kanal), 2)

# Rysunek: cztery panele – krzywa z pasmem 90%, zakres obserwowanych wydatków, obecny wydatek, węzły przybliżenia
zal$nazwa_f <- factor(zal$nazwa, zal$nazwa)
pasmo$nazwa_f <- factor(zal$nazwa[match(pasmo$kanal, zal$kanal)], zal$nazwa)
wez <- do.call(rbind, lapply(seq_len(nrow(zal)), function(k) {
  x <- seq(0, 300, by = 30)
  data.frame(nazwa_f = zal$nazwa_f[k], x = x, y = krzywa(x, zal$beta[k], zal$theta[k]))
}))
ob <- transform(zal, y = krzywa(obecny, beta, theta))
p2 <- ggplot(pasmo, aes(x, colour = kanal, fill = kanal)) +
  geom_rect(data = zal, aes(xmin = obs_min, xmax = obs_max, ymin = -Inf, ymax = Inf), inherit.aes = FALSE,
            fill = "grey85", alpha = 0.6) +
  geom_ribbon(aes(ymin = dolna, ymax = gorna), alpha = 0.25, colour = NA) +
  geom_line(aes(y = srodek), linewidth = 1.1) +
  geom_line(data = wez, aes(x, y), inherit.aes = FALSE, linetype = "22", colour = "grey20", linewidth = 0.5) +
  geom_point(data = wez, aes(x, y), inherit.aes = FALSE, shape = 3, size = 1.8, colour = "grey20") +
  geom_point(data = ob, aes(obecny, y), inherit.aes = FALSE, shape = 21, size = 3.6, fill = "white",
             colour = "#0f1d3a", stroke = 1.3) +
  facet_wrap(~ nazwa_f, ncol = 2) +
  scale_colour_manual(values = kol[zal$kanal], guide = "none") +
  scale_fill_manual(values = kol[zal$kanal], guide = "none") +
  scale_x_continuous(breaks = seq(0, 300, 50)) +
  labs(title = "Krzywe odpowiedzi: ile dodatkowych zapisów daje wydatek w kanale",
       subtitle = "Linia – założenie z MMM, pasmo – 90% z 1000 losowań, szare tło – wydatki obserwowane, kółko – 2026 r.",
       x = "Wydatek miesięczny (tys. zł)", y = "Dodatkowe zapisy w miesiącu") +
  motyw
p2   # zapis: ggsave("podzial-budzetu-krzywe-odpowiedzi.svg", p2, width = 10, height = 6.4)
Wynik w R
        kanal wydatek zapisy zapisy_na_1_tys zl_marzy_na_1_zl
 wyszukiwarka     200  217.8           0.384             0.58
       social     130  115.9           0.560             0.84
        wideo      50   54.4           0.982             1.47
     podcasty      20   25.5           1.075             1.61
   razem_zapisy koszt_zapisu_zl
          413.6           967.1
        kanal przy_obecnym    przy_2x
 wyszukiwarka   [197, 239] [223, 286]
       social   [103, 130] [143, 188]
        wideo     [41, 72]  [76, 127]
     podcasty     [19, 35]   [32, 58]
              [,1]  [,2]  [,3]
podcasty     1.382 1.170 0.990
social       1.290 1.207 1.129
wideo        1.176 1.130 1.086
wyszukiwarka 2.259 2.063 1.884
wyszukiwarka       social        wideo     podcasty
        0.26         0.11         0.06         0.29
2. Program liniowy, krańcowy zwrot i wysokość budżetu: Rysunek 3
R
# Rysunek 3. Optymalny podział budżetu programowaniem liniowym i krańcowy zwrot w optimum
# (korzysta z zal, kol, motyw, marza, krzywa, krancowy i wezly z przepisu 1)
library(ggplot2)
library(patchwork)
library(lpSolve)
library(ggrepel)

# Program liniowy: zmienna y[k, j] = część wydatku kanału k w odcinku j (odcinki po 1 tys. zł).
# Cel: maksimum sumy nachylenie[k, j] × y[k, j]; budżet: suma y = B; dolna i górna granica wydatku na kanał.
# Krzywe są wklęsłe (nachylenia maleją), więc program sam wypełnia odcinki po kolei.
plan_lp <- function(beta, theta, budzet, dolna, gorna, krok = 1, maks = 500) {
  w <- seq(0, maks, by = krok); J <- length(w) - 1; K <- length(beta); n <- K * J
  nach <- sapply(seq_len(K), function(k) diff(krzywa(w, beta[k], theta[k])) / krok)   # J × K
  ktory <- rep(seq_len(K), each = J)
  # Ograniczenia w formie rzadkiej (wiersz, zmienna, współczynnik): budżet, minimum i maksimum kanału, odcinki
  rz <- rbind(cbind(1, 1:n, 1), cbind(1 + ktory, 1:n, 1), cbind(1 + K + ktory, 1:n, 1), cbind(1 + 2 * K + 1:n, 1:n, 1))
  dir <- c("=", rep(">=", K), rep("<=", K), rep("<=", n))
  rhs <- c(budzet, dolna, gorna, rep(krok, n))
  wyn <- lp("max", as.vector(nach), const.dir = dir, const.rhs = rhs, dense.const = rz, compute.sens = TRUE)
  x <- as.vector(tapply(wyn$solution, ktory, sum))
  list(x = x, zapisy = sum(krzywa(x, beta, theta)), cena_budzetu = wyn$duals[1], status = wyn$status)
}
B <- sum(zal$obecny)                                      # 400 tys. zł miesięcznie
# Plan A: tylko minimum 20 tys. zł na kanał (obecność marki); plan B: dodatkowo zmiana r/r najwyżej ±40%
dolna_A <- rep(20, 4);                    gorna_A <- rep(B, 4)
dolna_B <- pmax(20, 0.6 * zal$obecny);    gorna_B <- 1.4 * zal$obecny
pA <- plan_lp(zal$beta, zal$theta, B, dolna_A, gorna_A)
pB <- plan_lp(zal$beta, zal$theta, B, dolna_B, gorna_B)
c(status_A = pA$status, status_B = pB$status)              # 0 = znaleziono rozwiązanie

plany <- data.frame(kanal = zal$kanal, obecny = zal$obecny, plan_A = pA$x, plan_B = pB$x,
                    granice_B = sprintf("%.0f–%.0f", dolna_B, gorna_B))
print(plany, row.names = FALSE)
zapisy <- c(obecny = sum(krzywa(zal$obecny, zal$beta, zal$theta)), plan_A = pA$zapisy, plan_B = pB$zapisy)
round(rbind(zapisy = zapisy, zmiana_proc = 100 * (zapisy / zapisy[1] - 1),
            marza_tys_zl_rocznie = 12 * marza * (zapisy - zapisy[1])), 1)

# Krańcowy zwrot w optimum: zapisy na 1 tys. zł (i zł marży na 1 zł) – w planie A równy we wszystkich kanałach
kr <- data.frame(kanal = zal$kanal,
                 plan_A = krancowy(pA$x, zal$beta, zal$theta), plan_B = krancowy(pB$x, zal$beta, zal$theta))
print(transform(kr, plan_A = round(plan_A, 3), plan_B = round(plan_B, 3),
                zl_marzy_A = round(marza * plan_A, 2), zl_marzy_B = round(marza * plan_B, 2)), row.names = FALSE)
# Cena dualna budżetu z programu liniowego: ile zapisów da dodatkowy 1 tys. zł budżetu
round(c(plan_A = pA$cena_budzetu, plan_B = pB$cena_budzetu), 3)

# Kontrola przybliżenia: dokładne optimum (równe krańcowe zwroty, wyszukiwanie wspólnego poziomu)
dokladne <- function(budzet, dolna, gorna) {
  x_l <- function(l) pmin(pmax(zal$theta * log(zal$beta / (zal$theta * l)), dolna), gorna)
  l <- uniroot(function(l) sum(x_l(l)) - budzet, c(1e-4, 10), tol = 1e-10)$root
  x_l(l)
}
xA <- dokladne(B, dolna_A, gorna_A)
round(rbind(dokladne_A = xA, lp_A = pA$x), 1)
round(c(dokladne = sum(krzywa(xA, zal$beta, zal$theta)), lp_odcinki_1 = pA$zapisy,
        lp_odcinki_10 = plan_lp(zal$beta, zal$theta, B, dolna_A, gorna_A, krok = 10)$zapisy), 2)

# Ile budżetu w ogóle? Cena dualna przy różnych budżetach (plan A) a próg opłacalności 1 / marża
budzety <- seq(300, 600, by = 20)
cena <- sapply(budzety, function(b) plan_lp(zal$beta, zal$theta, b, dolna_A, rep(b, 4))$cena_budzetu)
round(rbind(budzet = budzety, zapisy_na_1_tys = cena, zl_marzy_na_1_zl = marza * cena), 3)
round(1 / marza, 3)                                       # próg: 0.667 zapisu na 1 tys. zł
# Największy budżet (co 5 tys. zł), przy którym ostatni 1 tys. zł jeszcze się zwraca
b5 <- seq(400, 500, by = 5)
c5 <- sapply(b5, function(b) plan_lp(zal$beta, zal$theta, b, dolna_A, rep(b, 4))$cena_budzetu)
max(b5[c5 >= 1 / marza])

# Rysunek: krańcowe krzywe kanałów i punkty planu; A – plan A (równe), B – plan B (granice ±40%)
siatka <- seq(0, 300, by = 2)
kk <- do.call(rbind, lapply(seq_len(4), function(k)
  data.frame(kanal = zal$kanal[k], x = siatka, y = krancowy(siatka, zal$beta[k], zal$theta[k]))))
kk$kanal <- factor(kk$kanal, zal$kanal)
pkt <- function(x) data.frame(kanal = factor(zal$kanal, zal$kanal), x = x, y = krancowy(x, zal$beta, zal$theta))
etyk <- c(wyszukiwarka = "wyszukiwarka", social = "media społ.", wideo = "wideo", podcasty = "podcasty")
rys <- function(x, tytul, linia, granice = NULL) {
  g <- ggplot(kk, aes(x, y, colour = kanal, linetype = kanal)) +
    geom_hline(yintercept = 1 / marza, colour = "grey40", linetype = "dotted", linewidth = 0.7) +
    annotate("text", x = 300, y = 1 / marza, label = "próg opłacalności 0.667", hjust = 1, vjust = 1.5,
             size = 3.5, colour = "grey30")
  if (!is.null(granice))
    g <- g + geom_segment(data = data.frame(kanal = factor(zal$kanal, zal$kanal), x0 = granice[[1]], x1 = granice[[2]],
                                            y = krancowy(x, zal$beta, zal$theta)),
                          aes(x = x0, xend = x1, y = y, yend = y, colour = kanal), inherit.aes = FALSE,
                          linewidth = 3, alpha = 0.25, show.legend = FALSE)
  if (!is.null(linia))
    g <- g + geom_hline(yintercept = linia, colour = "#0f1d3a", linewidth = 0.6) +
      annotate("text", x = 300, y = linia, label = sprintf("cena dualna budżetu %.3f", linia), hjust = 1,
               vjust = -0.6, size = 3.5, colour = "#0f1d3a")
  g + geom_line(linewidth = 1) +
    geom_point(data = pkt(x), aes(shape = kanal), size = 3.6, fill = "white", stroke = 1.3) +
    geom_text_repel(data = pkt(x), aes(label = sprintf("%s %.0f", etyk[as.character(kanal)], x)),
                    size = 3.5, nudge_y = 0.45, direction = "x", segment.colour = "grey50", min.segment.length = 0,
                    seed = 1, show.legend = FALSE) +
    scale_colour_manual(values = kol[zal$kanal], labels = etyk, name = NULL) +
    scale_linetype_manual(values = c("solid", "longdash", "dotdash", "twodash"), labels = etyk, name = NULL) +
    scale_shape_manual(values = c(21, 22, 24, 23), labels = etyk, name = NULL) +
    coord_cartesian(xlim = c(0, 300), ylim = c(0, 2.5)) +
    labs(title = tytul, x = "Wydatek miesięczny (tys. zł)", y = "Zapisy na dodatkowy 1 tys. zł") + motyw
}
p3 <- (rys(pA$x, "A. Plan A: minimum 20 tys. zł", pA$cena_budzetu) |
       rys(pB$x, "B. Plan B: zmiana r/r najwyżej ±40%", NULL, list(dolna_B, gorna_B))) +
  plot_layout(guides = "collect") & theme(legend.position = "bottom")
p3   # zapis: ggsave("podzial-budzetu-krancowy-zwrot.svg", p3, width = 10, height = 5.6)
Wynik w R
status_A status_B
       0        0
        kanal obecny plan_A plan_B granice_B
 wyszukiwarka    200    132    164   120–280
       social    130     94    138    78–182
        wideo     50    130     70     30–70
     podcasty     20     44     28     20–28
                     obecny plan_A plan_B
zapisy                413.6  443.2  428.6
zmiana_proc             0.0    7.2    3.6
marza_tys_zl_rocznie    0.0  533.0  269.3
        kanal plan_A plan_B zl_marzy_A zl_marzy_B
 wyszukiwarka  0.712  0.532       1.07       0.80
       social  0.712  0.531       1.07       0.80
        wideo  0.713  0.907       1.07       1.36
     podcasty  0.720  0.941       1.08       1.41
plan_A plan_B
 0.714  0.530
            [,1] [,2]  [,3] [,4]
dokladne_A 131.7 93.8 129.9 44.6
lp_A       132.0 94.0 130.0 44.0
     dokladne  lp_odcinki_1 lp_odcinki_10
       443.23        443.23        443.02
                    [,1]    [,2]    [,3]    [,4]    [,5]    [,6]    [,7]
budzet           300.000 320.000 340.000 360.000 380.000 400.000 420.000
zapisy_na_1_tys    0.850   0.820   0.790   0.764   0.739   0.714   0.690
zl_marzy_na_1_zl   1.275   1.229   1.186   1.146   1.108   1.072   1.034
                    [,8]    [,9]   [,10]   [,11]   [,12]   [,13]   [,14]  [,15]
budzet           440.000 460.000 480.000 500.000 520.000 540.000 560.000 580.00
zapisy_na_1_tys    0.665   0.642   0.619   0.597   0.578   0.558   0.538   0.52
zl_marzy_na_1_zl   0.997   0.963   0.928   0.896   0.866   0.837   0.807   0.78
                   [,16]
budzet           600.000
zapisy_na_1_tys    0.502
zl_marzy_na_1_zl   0.753
[1] 0.667
[1] 435
3. 1000 losowań krzywych i klątwa optymalizatora: Rysunek 4
R
# Rysunek 4. Niepewność krzywych: optymalny podział w 1000 losowaniach parametrów i „klątwa optymalizatora”
# (korzysta z zal, kol, motyw, rho, marza, krzywa, losuj z przepisu 1 oraz plan_lp, B, dolna_*, gorna_*, pA, pB z przepisu 2)
library(ggplot2)
library(patchwork)
library(lpSolve)

set.seed(6930)
R <- 1000
L <- losuj(R)                                    # 1000 zestawów (beta, theta) dla 4 kanałów
bet <- matrix(L$beta, nrow = R); the <- matrix(L$theta, nrow = R)   # wiersz = losowanie, kolumna = kanał
z_obecny <- sum(krzywa(zal$obecny, zal$beta, zal$theta))
wyn <- t(sapply(seq_len(R), function(r) {
  b <- bet[r, ]; t <- the[r, ]
  xa <- plan_lp(b, t, B, dolna_A, gorna_A, krok = 5)$x           # optimum przy tych krzywych (plan A)
  xb <- plan_lp(b, t, B, dolna_B, gorna_B, krok = 5)$x           # optimum z granicami ±40% (plan B)
  c(xa = xa, xb = xb,
    opt = sum(krzywa(xa, b, t)),                                 # zapisy w optimum tych krzywych
    planA = sum(krzywa(pA$x, b, t)),                             # plan A z rysunku 3 oceniony na tych krzywych
    obecny = sum(krzywa(zal$obecny, b, t)),
    # klątwa optymalizatora: losowanie = oszacowanie z MMM, założenia z przepisu 1 = prawda
    obiecany = sum(krzywa(xa, b, t)) - sum(krzywa(zal$obecny, b, t)),
    prawdziwy = sum(krzywa(xa, zal$beta, zal$theta)) - z_obecny)
}))
udzialy <- 100 * wyn[, 1:4] / B
colnames(udzialy) <- zal$kanal
# Udział kanału w optymalnym planie A: punkt z rysunku 3 i rozrzut w 1000 losowaniach (mediana, 5. i 95. centyl)
round(rbind(plan_z_rys_3 = 100 * pA$x / B, apply(udzialy, 2, quantile, c(0, 0.05, 0.5, 0.95, 1))), 1)
# Jak często plan B dochodzi do górnej granicy +40% w kanale (procent losowań)
round(100 * colMeans(sweep(wyn[, 5:8], 2, gorna_B - 0.01, ">=")), 1)

# Plan A z rysunku 3 a optimum w każdym losowaniu: utrata zapisów (w %) i przewaga nad obecnym planem
strata <- 100 * (1 - wyn[, "planA"] / wyn[, "opt"])
round(quantile(strata, c(0.5, 0.95, 1)), 2)
przewaga <- wyn[, "planA"] - wyn[, "obecny"]
round(c(srednia = mean(przewaga), quantile(przewaga, c(0.05, 0.95)), proc_lepszy = 100 * mean(przewaga > 0)), 1)
round(100 * sqrt(mean(przewaga > 0) * (1 - mean(przewaga > 0)) / R), 1)   # błąd Monte Carlo (pp)

# Klątwa optymalizatora: przyrost obiecany przez plan optymalny dla oszacowanych krzywych a przyrost prawdziwy
round(c(obiecany_sredni = mean(wyn[, "obiecany"]), prawdziwy_sredni = mean(wyn[, "prawdziwy"]),
        proc_rozczarowan = 100 * mean(wyn[, "prawdziwy"] < wyn[, "obiecany"]),
        prawdziwy_ponizej_0 = 100 * mean(wyn[, "prawdziwy"] < 0),
        plan_A_z_rys_3 = pA$zapisy - z_obecny), 1)
write.csv(data.frame(los = 1:R, beta = round(bet, 2), theta = round(the, 2), round(wyn, 2)),
          "podzial-budzetu-1000-losowan.csv", row.names = FALSE)

# Rysunek: A – udziały kanałów w optymalnym planie; B – przyrost obiecany a prawdziwy
etyk <- c(wyszukiwarka = "wyszukiwarka", social = "media społ.", wideo = "wideo", podcasty = "podcasty")
du <- data.frame(kanal = factor(rep(zal$kanal, each = R), zal$kanal), udzial = as.vector(udzialy))
pu <- data.frame(kanal = factor(zal$kanal, zal$kanal), udzial = 100 * pA$x / B)
pa <- ggplot(du, aes(kanal, udzial, fill = kanal, colour = kanal)) +
  geom_violin(alpha = 0.3, scale = "width", linewidth = 0.5) +
  geom_boxplot(width = 0.16, fill = "white", outlier.shape = NA, linewidth = 0.6) +
  geom_point(data = pu, shape = 23, size = 4, fill = "#0f1d3a", colour = "white", stroke = 1) +
  geom_point(data = data.frame(kanal = factor(zal$kanal, zal$kanal), udzial = 100 * zal$obecny / B),
             shape = 4, size = 3.6, colour = "grey20", stroke = 1.3) +
  scale_fill_manual(values = kol[zal$kanal], guide = "none") +
  scale_colour_manual(values = kol[zal$kanal], guide = "none") +
  scale_x_discrete(labels = etyk) +
  labs(title = "A. Udział kanału w planie optymalnym",
       subtitle = "1000 losowań; romb – plan A, × – 2026 r.", x = NULL, y = "Udział w budżecie (%)") + motyw
dk <- data.frame(rodzaj = factor(rep(c("obiecany (na oszacowanych krzywych)", "prawdziwy"), each = R),
                                 c("obiecany (na oszacowanych krzywych)", "prawdziwy")),
                 przyrost = c(wyn[, "obiecany"], wyn[, "prawdziwy"]))
sr <- aggregate(przyrost ~ rodzaj, dk, mean)
pb <- ggplot(dk, aes(przyrost, fill = rodzaj, colour = rodzaj, linetype = rodzaj)) +
  geom_density(alpha = 0.3, linewidth = 0.8, adjust = 1.2) +
  geom_vline(data = sr, aes(xintercept = przyrost, colour = rodzaj, linetype = rodzaj), linewidth = 0.9) +
  geom_text(data = sr, aes(x = przyrost, y = Inf, label = sprintf("średnio %.1f", przyrost), colour = rodzaj),
            vjust = 1.4, hjust = c(-0.08, 1.08), size = 3.8, show.legend = FALSE) +
  scale_fill_manual(values = c(kol[["social"]], kol[["wyszukiwarka"]]), name = NULL) +
  scale_colour_manual(values = c(kol[["social"]], kol[["wyszukiwarka"]]), name = NULL) +
  scale_linetype_manual(values = c("longdash", "solid"), name = NULL) +
  guides(fill = guide_legend(nrow = 2), colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(title = "B. Przyrost zapisów względem planu 2026",
       subtitle = "Plan liczony na krzywych z losowania", x = "Dodatkowe zapisy w miesiącu", y = "Gęstość") + motyw
p4 <- pa | pb
p4   # zapis: ggsave("podzial-budzetu-niepewnosc-1000-losowan.svg", p4, width = 10, height = 5.6)
Wynik w R
             wyszukiwarka social wideo podcasty
plan_z_rys_3         33.0   23.5  32.5     11.0
0%                   23.8   12.5  12.5      5.0
5%                   28.8   17.5  22.5      6.2
50%                  33.8   23.8  31.2     11.2
95%                  38.8   30.0  42.5     17.5
100%                 42.5   36.2  52.5     25.0
 xb1  xb2  xb3  xb4
 0.0  0.0 99.9 99.1
 50%  95% 100%
0.48 1.78 3.70
    srednia          5%         95% proc_lepszy
       28.9        10.0        49.4        99.7
[1] 0.2
    obiecany_sredni    prawdziwy_sredni    proc_rozczarowan prawdziwy_ponizej_0
               31.8                26.7                57.8                 0.0
     plan_A_z_rys_3
               29.6
4. Krzywa alternatywna poza danymi: Rysunek 5
R
# Rysunek 5. Pułapka ekstrapolacji: plan, który wychodzi poza obserwowane wydatki
# (korzysta z zal, kol, motyw, krzywa, krancowy z przepisu 1 oraz plan_lp, B, dolna_*, gorna_*, pA, pB z przepisu 2)
library(ggplot2)
library(patchwork)
library(lpSolve)

# Krzywa alternatywna: do największego obserwowanego wydatku m identyczna z założeniem,
# powyżej m nasyca się 10 razy szybciej, np. bo kończy się grupa docelowa (dane MMM nie odróżnią jej od założenia –
# brak obserwacji powyżej m). Po pierwszym uruchomieniu zmieniono 3 razy na 10 razy, by pułapka była wyraźna.
krzywa_alt <- function(x, beta, theta, m) {
  t2 <- theta / 10
  ifelse(x <= m, krzywa(x, beta, theta),
         krzywa(m, beta, theta) + krancowy(m, beta, theta) * t2 * (1 - exp(-(x - m) / t2)))
}
zapisy_alt <- function(x) sum(krzywa_alt(x, zal$beta, zal$theta, zal$obs_max))
# Plan C: jak plan A, ale najwyżej 1.25 × największy obserwowany wydatek w kanale
gorna_C <- 1.25 * zal$obs_max
pC <- plan_lp(zal$beta, zal$theta, B, dolna_A, gorna_C)
plany <- list(obecny = zal$obecny, plan_A = pA$x, plan_B = pB$x, plan_C = pC$x)
round(sapply(plany, identity), 1)                               # wydatki (tys. zł), kolejno 4 kanały
# Ile kanałów i o ile plan wychodzi poza największy obserwowany wydatek (tys. zł)
round(sapply(plany, function(x) pmax(0, x - zal$obs_max)), 1)
tab <- sapply(plany, function(x) c(zalozenie = sum(krzywa(x, zal$beta, zal$theta)), alternatywa = zapisy_alt(x)))
round(rbind(tab, przyrost_zalozenie = tab[1, ] - tab[1, 1], przyrost_alternatywa = tab[2, ] - tab[2, 1]), 1)

# Rysunek: A – wideo online: założenie i krzywa alternatywna; B – zapisy z planów przy obu krzywych
k <- which(zal$kanal == "wideo")
x <- seq(0, 200, by = 1)
dw <- data.frame(x = rep(x, 2), y = c(krzywa(x, zal$beta[k], zal$theta[k]),
                                      krzywa_alt(x, zal$beta[k], zal$theta[k], zal$obs_max[k])),
                 krzywa = factor(rep(c("założenie z MMM", "alternatywa (szybsze nasycenie)"), each = length(x)),
                                 c("założenie z MMM", "alternatywa (szybsze nasycenie)")))
pk <- data.frame(plan = c("2026", "A", "B", "C"), x = sapply(plany, `[`, k))
pk$y <- krzywa(pk$x, zal$beta[k], zal$theta[k]); pk$y2 <- krzywa_alt(pk$x, zal$beta[k], zal$theta[k], zal$obs_max[k])
pa <- ggplot(dw, aes(x, y)) +
  annotate("rect", xmin = zal$obs_min[k], xmax = zal$obs_max[k], ymin = -Inf, ymax = Inf, fill = "grey85", alpha = 0.6) +
  annotate("text", x = mean(c(zal$obs_min[k], zal$obs_max[k])), y = 5, label = "wydatki\nw danych",
           size = 3.6, colour = "grey30", lineheight = 0.9) +
  geom_line(aes(colour = krzywa, linetype = krzywa), linewidth = 1.1) +
  geom_segment(data = pk, aes(x = x, xend = x, y = y2, yend = y), colour = "grey30", linewidth = 0.5,
               arrow = arrow(length = unit(1.6, "mm"), ends = "both")) +
  geom_point(data = pk, aes(x, y), shape = 21, size = 3.4, fill = "white", colour = "#0f1d3a", stroke = 1.2) +
  geom_text(data = pk, aes(x, y, label = plan), vjust = -1, size = 3.9, fontface = "bold", colour = "#0f1d3a") +
  scale_colour_manual(values = c(kol[["wideo"]], kol[["social"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash"), name = NULL) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(title = "A. Wideo online: co dalej, nie wiemy", x = "Wydatek miesięczny (tys. zł)",
       y = "Dodatkowe zapisy w miesiącu") + motyw
db <- data.frame(plan = factor(rep(c("2026", "A", "B", "C"), 2), c("2026", "A", "B", "C")),
                 krzywa = factor(rep(c("założenie z MMM", "alternatywa (szybsze nasycenie)"), each = 4),
                                 c("założenie z MMM", "alternatywa (szybsze nasycenie)")),
                 zapisy = c(tab[1, ], tab[2, ]))
pb <- ggplot(db, aes(zapisy, plan)) +
  geom_line(aes(group = plan), colour = "grey60", linewidth = 0.8) +
  geom_point(aes(colour = krzywa, shape = krzywa), size = 4, stroke = 1.3) +
  geom_text(data = subset(db, krzywa == "założenie z MMM" | abs(zapisy - rep(tab[1, ], 2)) > 0.05),
            aes(label = sprintf("%.0f", zapisy), colour = krzywa), vjust = -1.1, size = 3.8, show.legend = FALSE) +
  scale_colour_manual(values = c(kol[["wideo"]], kol[["social"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_y_discrete(limits = rev(c("2026", "A", "B", "C"))) +
  scale_x_continuous(limits = c(405, 450)) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(title = "B. Zapisy z czterech planów", x = "Dodatkowe zapisy w miesiącu", y = "Plan") + motyw
p5 <- pa | pb
p5   # zapis: ggsave("podzial-budzetu-pulapka-ekstrapolacji.svg", p5, width = 10, height = 5.6)
Wynik w R
     obecny plan_A plan_B plan_C
[1,]    200    132    164  145.0
[2,]    130     94    138  111.2
[3,]     50    130     70  100.0
[4,]     20     44     28   43.8
     obecny plan_A plan_B plan_C
[1,]      0      0      0    0.0
[2,]      0      0      0    0.0
[3,]      0     50      0   20.0
[4,]      0      9      0    8.8
                     obecny plan_A plan_B plan_C
zalozenie             413.6  443.2  428.6  440.7
alternatywa           413.6  419.5  428.6  432.9
przyrost_zalozenie      0.0   29.6   15.0   27.0
przyrost_alternatywa    0.0    5.9   15.0   19.3
5. Schemat „krzywe → optymalizacja → plan”: Rysunek 1
R
# Rysunek 1. Schemat „krzywe → optymalizacja → plan” z liczbami przykładu
# (korzysta z zal, kol z przepisu 1, B, pA, pB z przepisu 2, pC i tab z przepisu 4)
library(ggplot2)

f0 <- function(x) formatC(x, format = "f", digits = 0)
kroki <- data.frame(
  x0 = c(0, 3.55, 7.1), x1 = c(2.9, 6.45, 10),
  naglowek = c("1. Krzywe odpowiedzi", "2. Optymalizacja", "3. Plan i sprawdzenie"),
  tresc = c(paste0("z modelu MMM, dla 4 kanałów\n\nzapisy = β × (1 − e^(−wydatek/θ))\n\n",
                   "β, θ z błędami standardowymi\nzakres wydatków w danych"),
            paste0("krzywa → odcinki po 1 tys. zł\nprogram liniowy (lpSolve)\n\n",
                   "maksimum: suma zapisów\nbudżet = ", f0(B), " tys. zł / mies.\n",
                   "minimum 20 tys. zł na kanał\nzmiana r/r najwyżej ±40%"),
            paste0("podział budżetu\nkrańcowy zwrot w kanałach\n\n",
                   "1000 losowań krzywych\nwydatki poza danymi?\n\n",
                   "zapisy: ", f0(tab[1, "obecny"]), " → ", f0(tab[1, "plan_B"]), " (plan B)")))
kanaly <- data.frame(y = c(0.235, 0.17, 0.105, 0.04), nazwa = zal$nazwa, kanal = zal$kanal,
                     txt = sprintf("%s: %s → %s tys. zł", zal$nazwa, f0(zal$obecny), f0(pB$x)))
p1 <- ggplot() +
  geom_rect(data = kroki, aes(xmin = x0, xmax = x1, ymin = 0.36, ymax = 1), fill = "white", colour = "grey60",
            linewidth = 0.6) +
  geom_rect(data = kroki, aes(xmin = x0, xmax = x1, ymin = 0.88, ymax = 1), fill = kol[["wyszukiwarka"]], colour = NA) +
  geom_text(data = kroki, aes(x = (x0 + x1) / 2, y = 0.94, label = naglowek), colour = "white", fontface = "bold",
            size = 5.2) +
  geom_text(data = kroki, aes(x = (x0 + x1) / 2, y = 0.62, label = tresc), colour = "#0f1d3a", size = 3.9,
            lineheight = 1.05) +
  annotate("segment", x = c(2.95, 6.5), xend = c(3.5, 7.05), y = 0.68, yend = 0.68, colour = "#0f1d3a",
           linewidth = 1.1, arrow = arrow(length = unit(3, "mm"), type = "closed")) +
  annotate("rect", xmin = 0, xmax = 10, ymin = 0, ymax = 0.31, fill = "#eef3f8", colour = "grey70", linewidth = 0.5) +
  annotate("text", x = 0.15, y = 0.285, label = "Plan B (granice ±40%), wydatek miesięczny 2026 → 2027:",
           hjust = 0, vjust = 1, fontface = "bold", size = 4, colour = "#0f1d3a") +
  geom_point(data = kanaly, aes(x = 0.3, y = y, colour = kanal, shape = kanal), size = 3.4, stroke = 1.2) +
  geom_text(data = kanaly, aes(x = 0.5, y = y, label = txt), hjust = 0, size = 3.9, colour = "#0f1d3a") +
  annotate("text", x = 5.6, y = 0.17, hjust = 0, size = 3.7, colour = "grey25", lineheight = 1.1,
           label = paste0("Plan A (bez granic r/r): ", f0(tab[1, "plan_A"]), " zapisów,\n",
                          "ale wideo i podcasty poza danymi.\n",
                          "Plan C (≤ 1.25 × maks. w danych): ", f0(tab[1, "plan_C"]), ".")) +
  scale_colour_manual(values = kol[zal$kanal], guide = "none") +
  scale_shape_manual(values = c(16, 15, 17, 18), guide = "none") +
  coord_cartesian(xlim = c(-0.05, 10.05), ylim = c(-0.02, 1.02), expand = FALSE) +
  labs(title = "Od krzywych odpowiedzi do planu budżetu",
       subtitle = "Fikcyjna szkoła programowania online, 4 kanały, dodatkowe zapisy na kursy w miesiącu") +
  theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p1   # zapis: ggsave("podzial-budzetu-schemat-krzywe-plan.svg", p1, width = 10, height = 5.8)
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
k <- c(wyszukiwarka = "#0072B2", social = "#D55E00", wideo = "#009E73", podcasty = "#CC79A7")
pary <- combn(names(k), 2, simplify = FALSE)
roznica <- function(x) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(x), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
tab <- t(sapply(pary, function(p) { x <- k[p]
  c(widzenie_typowe = roznica(x), deuteranopia = roznica(deutan(x)), protanopia = roznica(protan(x))) }))
rownames(tab) <- sapply(pary, paste, collapse = " – ")
round(rbind(tab, "czerwony – zielony (do unikania)" = c(roznica(c("#E41A1C", "#4DAF4A")),
      roznica(deutan(c("#E41A1C", "#4DAF4A"))), roznica(protan(c("#E41A1C", "#4DAF4A"))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
wyszukiwarka – social                      114.6        108.3       91.9
wyszukiwarka – wideo                        70.1         55.4       58.0
wyszukiwarka – podcasty                     53.6         42.0       22.5
social – wideo                             102.4         53.5       37.3
social – podcasty                           74.3         70.2       71.9
wideo – podcasty                            87.5         18.1       36.2
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie parametrów i wyszukiwanie dokładnego optimum (uniroot()) – pakiet stats z podstawowej instalacji R; program liniowy – pakiet lpSolve. Rysunki wykonano w pakiecie ggplot2, etykiety rozmieszczono pakietem ggrepel, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lpSolve (wersja 5.6.23): Berkelaar, M. (2024). lpSolve: Interface to 'Lp_solve' v. 5.5 to solve linear/integer programs [R package]. https://doi.org/10.32614/CRAN.package.lpSolve
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Ekstrapolacja. Optymalizator chętnie wychodzi poza dane (rysunek 5). Dodaj górną granicę związaną z największym wydatkiem w danych.
- Krzywe brane za pewnik. Zwrot z reklamy trudno zmierzyć nawet w dużych eksperymentach: w 25 testach opisanych przez Lewisa i Rao (2015) mediana szerokości przedziału ufności dla ROI przekraczała 100 punktów procentowych. Przelicz plan w losowaniach parametrów.
- Krzywa w kształcie litery S. Odcinki w programie liniowym działają tylko dla krzywych wklęsłych; przy krzywej S potrzebne są zmienne binarne albo inny algorytm.
- Średni koszt zapisu zamiast krańcowego. Prowadzi do dokładania pieniędzy tam, gdzie krzywa już się wypłaszczyła.
- Pominięta pamięć reklamy. Jeśli reklama działa z opóźnieniem (adstock w MMM), plan roczny licz z tym efektem.
- Ukryty koszt zasad. Granica ±40% kosztowała 14.6 zapisu miesięcznie – pokaż to zarządowi.
Najczęstsze pytania
Jak optymalnie podzielić budżet marketingowy między kanały?
Potrzebujesz krzywej odpowiedzi każdego kanału (np. z modelu marketing mix) i zasady: przesuwaj pieniądze tam, gdzie dodatkowy złoty daje więcej, aż krańcowy zwrot zrówna się we wszystkich kanałach. W praktyce robi to program liniowy na krzywych przybliżonych odcinkami. W przykładzie taki plan dał 443.2 zamiast 413.6 zapisu miesięcznie przy tym samym budżecie.
Jak użyć programowania liniowego do podziału budżetu reklamowego?
Podziel każdą wklęsłą krzywą odpowiedzi na odcinki (np. po 1 tys. zł) i potraktuj wydatek w każdym odcinku jako zmienną z ograniczeniem od 0 do długości odcinka. Celem jest suma nachylenie × wydatek, a ograniczenia to budżet i granice dla kanałów. W R zrobisz to funkcją lp() z pakietu lpSolve; cena dualna ograniczenia budżetu mówi, ile da dodatkowy 1 tys. zł.
Co to jest krańcowy zwrot z reklamy i czym różni się od ROI?
ROI (średni zwrot) to cały efekt kanału podzielony przez cały wydatek. Krańcowy zwrot to efekt dodatkowej złotówki, czyli nachylenie krzywej odpowiedzi przy obecnym wydatku. W przykładzie wyszukiwarka miała najwięcej zapisów, ale ostatni 1 tys. zł dawał tam 0.384 zapisu, a w podcastach 1.075 – o podziale decyduje krańcowy zwrot.
Jak uwzględnić niepewność krzywych odpowiedzi przy planowaniu budżetu?
Losuj parametry krzywych z ich błędami standardowymi (np. 1000 razy) i w każdym losowaniu licz optymalny plan od nowa. Zobaczysz, jak bardzo wahają się udziały kanałów i jak często plan jest lepszy od obecnego. Pamiętaj też, że optymalny plan obiecuje średnio więcej, niż da (klątwa optymalizatora): w przykładzie 31.8 wobec 26.7 dodatkowego zapisu.
Dlaczego nie wolno planować wydatków poza zakresem danych z MMM?
Bo model widzi tylko wydatki, które naprawdę wystąpiły; dalej kształt krzywej to założenie. W przykładzie optymalizator dał wideo 130 tys. zł przy maksimum 80 tys. zł w danych. Przy krzywej, która poza danymi szybciej się nasyca, przyrost spadł z 29.6 do 5.9 zapisu. Ogranicz plan do okolic danych, a większe wydatki sprawdź eksperymentem.
Powiązane hasła
Przeczytaj też
Marketing mix modeling (MMM)
Producent soków, 156 tygodni i dwa kanały reklamy: adstock, nasycenie, rozkład sprzedaży, ROI z bootstrapem blokowym i pułapki – sześć rysunków z kodem R.
Czytaj →PoradnikDystrybucja a sprzedaż – krzywa udziału
Napój izotoniczny w 30 regionach: dystrybucja numeryczna i ważona, wypukła krzywa udziału z GAM i pułapka „sklepy biorą to, co się sprzedaje” – z kodem R.
Czytaj →PoradnikIle kreacji testować przy małym budżecie
20 000 wyświetleń i pytanie: 2, 4 czy 8 kreacji? Szansa wyboru najlepszej, wartość informacji w zł i klątwa zwycięzcy – z kodem R.
Czytaj →PoradnikObsada infolinii – Erlang C i symulacja
Infolinia dostawcy energii: test Poissona, czas rozmowy, Erlang C ręcznie, symulacja kolejki z rozłączeniami i grafik w kwadransach – sześć rysunków z kodem R.
Czytaj →Optymalizujesz budżet marketingowy w pracy?
Pomożemy oszacować krzywe odpowiedzi, zapisać program liniowy z ograniczeniami, sprawdzić niepewność planu i opisać wyniki – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Fischer, M., Albers, S., Wagner, N., & Frie, M. (2011). Practice prize winner—Dynamic marketing budget allocation across countries, products, and marketing activities. Marketing Science, 30(4), 568–585. https://doi.org/10.1287/mksc.1100.0627
- Lewis, R. A., & Rao, J. M. (2015). The unfavorable economics of measuring the returns to advertising. The Quarterly Journal of Economics, 130(4), 1941–1973. https://doi.org/10.1093/qje/qjv023
- Little, J. D. C. (1979). Aggregate advertising models: The state of the art. Operations Research, 27(4), 629–667. https://doi.org/10.1287/opre.27.4.629
- Mantrala, M. K., Sinha, P., & Zoltners, A. A. (1992). Impact of resource allocation rules on marketing investment-level decisions and profitability. Journal of Marketing Research, 29(2), 162–175. https://doi.org/10.1177/002224379202900202
- Smith, J. E., & Winkler, R. L. (2006). The optimizer’s curse: Skepticism and postdecision surprise in decision analysis. Management Science, 52(3), 311–322. https://doi.org/10.1287/mnsc.1050.0451
- Tull, D. S., Wood, V. R., Duhan, D., Gillpatrick, T., Robertson, K. R., & Helgeson, J. G. (1986). “Leveraged” decision making in advertising: The flat maximum principle and its implications. Journal of Marketing Research, 23(1), 25–32. https://doi.org/10.1177/002224378602300103
Cytowania BibTeX
@article{fischer2011dynamic, author={Fischer, Marc and Albers, Sönke and Wagner, Nils and Frie, Monika}, title={{Practice prize winner—Dynamic marketing budget allocation across countries, products, and marketing activities}}, journal={Marketing Science}, year={2011}, volume={30}, number={4}, pages={568--585}, doi={10.1287/mksc.1100.0627}}@article{lewis2015unfavorable, author={Lewis, Randall A. and Rao, Justin M.}, title={{The unfavorable economics of measuring the returns to advertising}}, journal={The Quarterly Journal of Economics}, year={2015}, volume={130}, number={4}, pages={1941--1973}, doi={10.1093/qje/qjv023}}@article{little1979aggregate, author={Little, John D. C.}, title={{Aggregate advertising models: The state of the art}}, journal={Operations Research}, year={1979}, volume={27}, number={4}, pages={629--667}, doi={10.1287/opre.27.4.629}}@article{mantrala1992impact, author={Mantrala, Murali K. and Sinha, Prabhakant and Zoltners, Andris A.}, title={{Impact of resource allocation rules on marketing investment-level decisions and profitability}}, journal={Journal of Marketing Research}, year={1992}, volume={29}, number={2}, pages={162--175}, doi={10.1177/002224379202900202}}@article{smith2006optimizer, author={Smith, James E. and Winkler, Robert L.}, title={{The optimizer’s curse: Skepticism and postdecision surprise in decision analysis}}, journal={Management Science}, year={2006}, volume={52}, number={3}, pages={311--322}, doi={10.1287/mnsc.1050.0451}}@article{tull1986leveraged, author={Tull, Donald S. and Wood, Van R. and Duhan, Dale and Gillpatrick, Tom and Robertson, Kim R. and Helgeson, James G.}, title={{“Leveraged” decision making in advertising: The flat maximum principle and its implications}}, journal={Journal of Marketing Research}, year={1986}, volume={23}, number={1}, pages={25--32}, doi={10.1177/002224378602300103}}