Przykład: serwis VOD i kampania pozyskania
Fikcyjny serwis VOD z abonamentem miesięcznym przez 4 tygodnie pokazuje reklamę wideo osobom, które nie mają abonamentu. Reklama nie ma limitu wyświetleń: kto dużo przegląda internet, widzi ją kilkadziesiąt razy. Dział marketingu pyta: ile razy pokazać reklamę jednej osobie, zanim kolejne wyświetlenia przestaną pomagać, a zaczną szkodzić?
Mamy dane o 60 000 osób: liczbę wyświetleń reklamy w czasie kampanii, liczbę minut spędzonych w sieci reklamowej w miesiącu przed kampanią i informację, czy osoba kupiła abonament. Kupiło 2069 osób (3.45%). Osoba widziała średnio 9.99 reklamy (mediana 7), 3.1% nie widziało żadnej, a 11.0% – ponad 20. Dane pobierzesz jako czestotliwosc-vod-kampania.csv.
Dane są fikcyjne i znamy prawdziwy mechanizm. Każdego dnia osoba może kupić abonament. Świeża reklama zwiększa tę szansę, ale efekt kilku reklam z tego samego dnia się nie sumuje (nasycenie), a pamięć reklamy zanika z dnia na dzień. Po 10 wyświetleniach każda następna reklama obniża szansę zakupu (zmęczenie). Do tego osoby aktywne w sieci kupują częściej same z siebie – i to one widzą najwięcej reklam. Te wartości ustawiliśmy ręcznie (lista w sekcji z kodem), a ziarna ustaliliśmy raz i nie zmienialiśmy ich.
Ten wpis dotyczy liczby kontaktów jednej osoby. Ile osób kampania w ogóle dosięga, opisuje wpis o zasięgu i częstotliwości kampanii, a ile sprzedaży daje reklama w ogóle – test wyłączenia reklamy.
Rysunek 1: kto widzi ile reklam
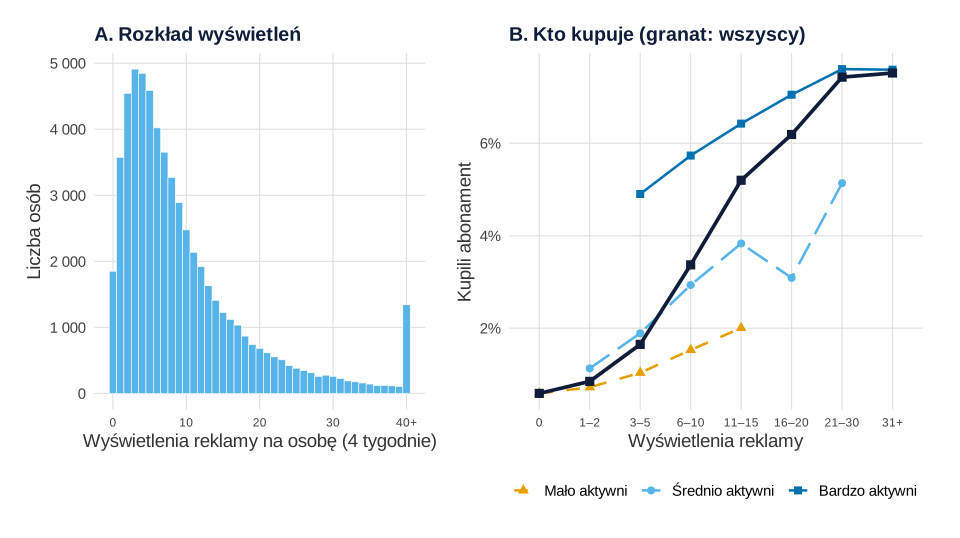
set.seed(667)).Co widać. Rozkład wyświetleń jest mocno skośny: połowa osób widziała reklamę najwyżej 7 razy, a 1% – 51 razy lub więcej. Wśród osób bez wyświetleń kupiło 0.59%, przy 6–10 wyświetleniach – 3.37%, przy 21–30 – 7.43%. Wygląda to tak, jakby każda kolejna reklama pomagała.
Jak może zmylić. Najmniej aktywna trzecia część osób widziała średnio 3.6 reklamy i kupowała w 1.01%, a najbardziej aktywna – 18.7 reklamy i 6.66%. Linia „wszyscy” łączy więc dwie rzeczy: działanie reklamy i to, kto widzi dużo reklam. To klasyczna zmienna zakłócająca. W prawdziwych danych aktywności nie znamy – mamy najwyżej jej zaszumioną miarę (tu minuty online, korelacja z aktywnością r = .78).
Podpis do pracy:
Rysunek 2: krzywa odpowiedzi z modelu GAM
Liczba wyświetleń to zmienna ciągła, a jej związek z zakupem nie musi być prosty: najpierw wzrost, potem nasycenie, a w końcu spadek ze zmęczenia – jak w zależności dawka–odpowiedź. Dlatego używamy uogólnionego modelu addytywnego (GAM): to regresja logistyczna, w której zamiast prostej jest gładka krzywa f:
Kształt krzywej wyznaczają dane, a kara za krzywiznę pilnuje, by nie goniła szumu. Siłę wygładzania dobiera REML (Wood, 2011; zob. REML a ML). Szerzej o splajnach i GAM piszemy w poradniku o nieliniowych zależnościach. Policzyliśmy trzy modele: bez kontroli aktywności, z minutami online i – czego w praktyce zrobić się nie da – z prawdziwą, ukrytą aktywnością. Każdy model dał krzywą „dla całej populacji”: wszystkim osobom ustawiamy tę samą liczbę wyświetleń i uśredniamy przewidywania.
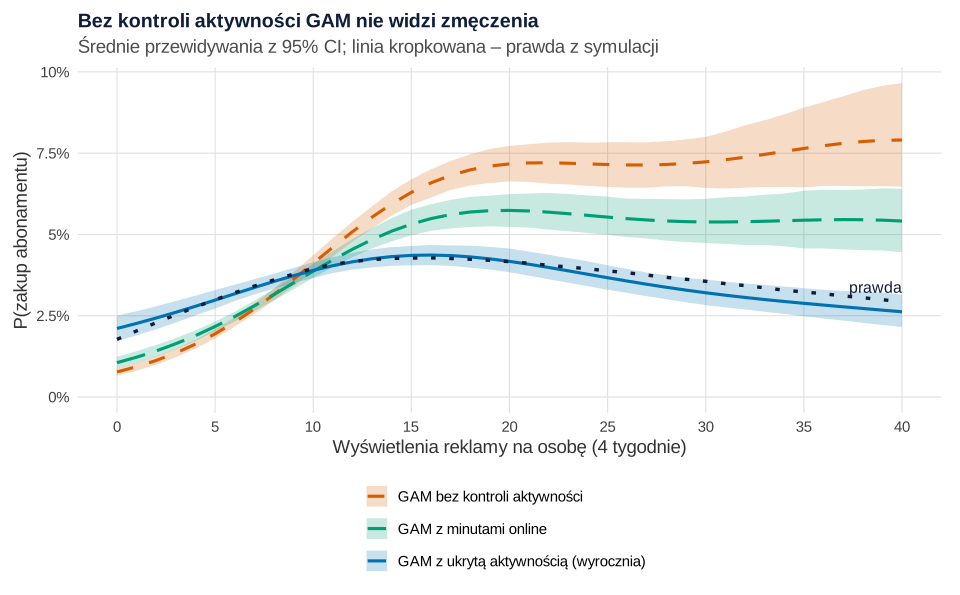
set.seed(667), set.seed(6672), set.seed(6673)).Co widać. Prawdziwa krzywa rośnie od 1.77% bez reklamy do szczytu ok. 4.3% przy 15–16 wyświetleniach, a potem spada: przy 30 wyświetleniach wynosi 3.56%, przy 40 – 2.93%. GAM bez kontroli aktywności daje 6.29% przy 15 wyświetleniach, 95% CI [5.91, 6.70], i 7.23% [6.43, 8.00] przy 30 – czyli przyrost od 0 do 15 wyświetleń o 5.52 punktu procentowego zamiast prawdziwych 2.50. Zmęczenia nie widać wcale. Model z minutami online zawyża mniej (4.26 pp), ale też nie pokazuje spadku. Dopiero model z ukrytą aktywnością odtwarza kształt: szczyt przy 16 wyświetleniach i 3.21% [2.83, 3.61] przy 30.
Jak może zmylić. Wąskie pasma ufności dotyczą tylko szumu losowego, nie zakłócenia: model bez kontroli aktywności jest pewny siebie i zły. Kontrola zaszumionej miary pomaga tylko częściowo, a w prawdziwych danych nie ma „wyroczni”. To samo zjawisko opisują Gordon i in. (2019): metody obserwacyjne często nie odtwarzają efektów reklamy znanych z eksperymentów. Podobny problem ma atrybucja kanałów – reklama „towarzyszy” osobom, które i tak były blisko zakupu.
Kształt z nasyceniem i spadkiem ma oparcie w badaniach. W metaanalizie Schmidt i Eisend (2015) postawa wobec reklamy osiągała maksimum przy ok. 10 ekspozycjach, a efekty powtórzeń z czasem zanikały. Campbell i Keller (2003) pokazali, że przy nieznanej marce powtarzanie reklamy szybciej obniża jej skuteczność niż przy marce znanej. Dla nowego serwisu VOD zmęczenie może więc przyjść wcześnie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: losowy limit wyświetleń
Rozwiązaniem nie jest lepszy model, tylko randomizacja. W kolejnej kampanii serwis przypisał 90 000 nowych osób losowo do jednego z trzech limitów: 2, 4 albo 8 wyświetleń tygodniowo. Aktywni i mało aktywni trafiają do każdej grupy tak samo często, więc różnica między grupami to skutek limitu. To zwykły test A/B z trzema wariantami (o porównaniach wielu wariantów zob. test A/B z wieloma wariantami). Dane: czestotliwosc-vod-eksperyment-limit.csv.
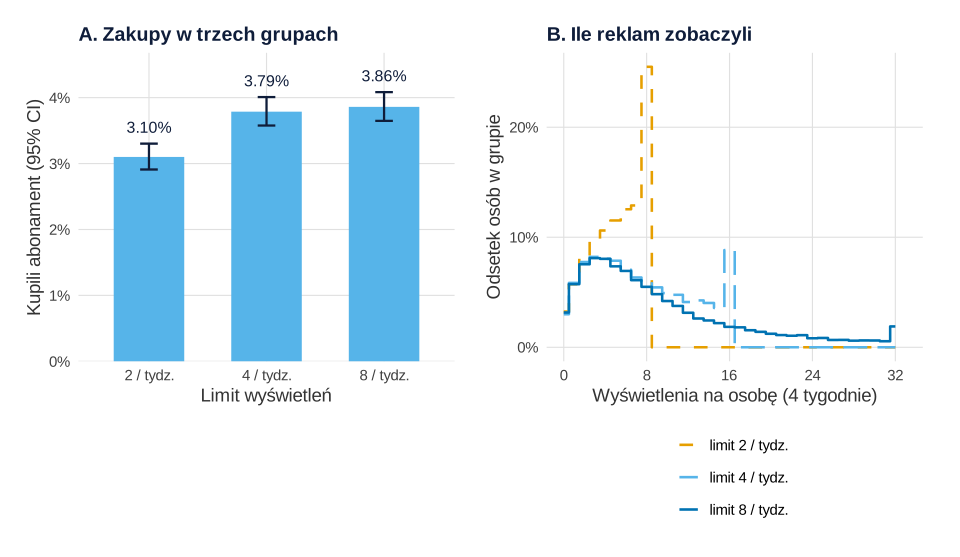
set.seed(6674)).Co widać. Przy limicie 2 kupiło 3.10%, 95% CI [2.91, 3.30], przy 4 – 3.79% [3.58, 4.01], przy 8 – 3.86% [3.65, 4.08] (przedziały Wilsona, zob. przedział ufności dla proporcji). Podniesienie limitu z 2 do 4 dało +0.69 pp [0.39, 0.98], p < .001, a z 4 do 8 – tylko +0.07 pp [−0.23, 0.38], p = .64. Limit 8 dodał osobie średnio 1.68 wyświetlenia (9.26 wobec 7.58).
Jak może zmylić. Limit dotyczy głównie najbardziej aktywnych: mediana wyświetleń w grupach to 6, 7 i 7, ale 90. percentyl – 8, 15 i 21. Prawdziwe odsetki z symulacji to 3.31%, 3.72% i 3.56% – limit 8 naprawdę jest gorszy od 4, lecz różnicy 0.16 pp nie da się wykryć przy 30 000 osób w grupie (moc testu). Eksperyment mówi uczciwie: „między 4 a 8 nie widać różnicy w zakupach”. Porównujemy grupy według przydziału, także gdy ktoś nie zobaczył żadnej reklamy – to analiza ITT.
Ten sposób pomiaru ma oparcie w praktyce: Sahni i in. (2019) w losowym eksperymencie terenowym zmieniali liczbę reklam retargetingowych i pokazali, że włączenie reklamy zwiększało powroty na stronę o 14.6%, a efekt zależał od tygodnia i od wcześniejszych reklam.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: który limit się opłaca
Decyzja zależy od pieniędzy. Przyjęliśmy dwie wartości (założenia ustawione ręcznie): nowy abonent daje 120 zł marży w pierwszych 6 miesiącach, a 1000 wyświetleń reklamy wideo kosztuje 40 zł (CPM). Zysk z osoby to 120 zł × (kupiła: 1 lub 0) minus koszt jej wyświetleń. Średnie zysku w grupach porównujemy testem t Welcha – nie trzeba bootstrapu, bo zysk liczymy dla każdej osoby.
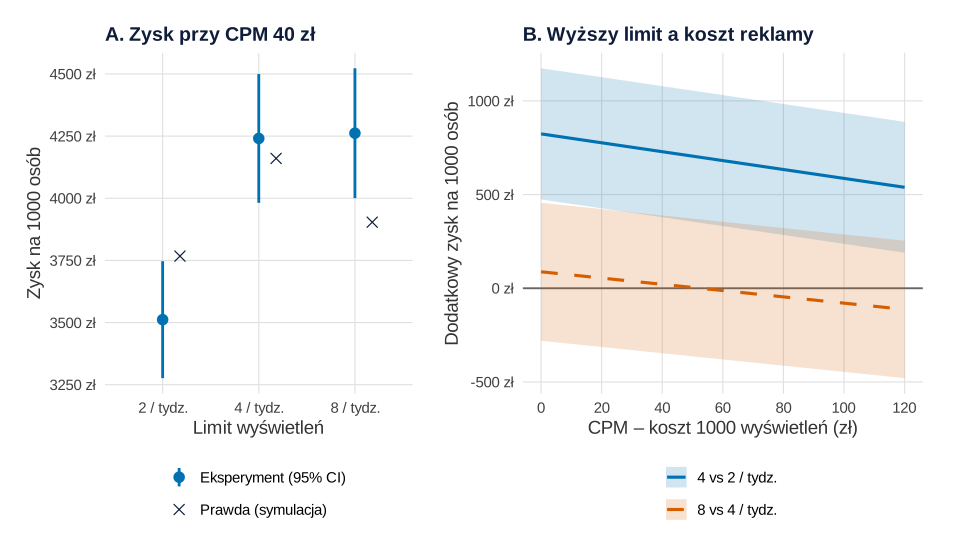
Co widać. Przy CPM 40 zł zysk na 1000 osób wynosi 3512 zł [3276, 3747] przy limicie 2, 4241 zł [3982, 4500] przy 4 i 4262 zł [4001, 4523] przy 8. Przejście z 2 na 4 daje +729 zł [379, 1079] i opłaca się przy każdym CPM do 120 zł. Przejście z 4 na 8 daje +21 zł [−347, 389], a przy CPM powyżej ok. 55 zł średnia różnica jest już ujemna. Koszt reklamy na 1000 osób rośnie z 303 do 370 zł.
Jak może zmylić. Przedział dla 8 vs 4 obejmuje zero, więc dane nie wskazują zwycięzcy – wybieramy tańszy wariant, bo wyższy limit nie ma przewagi, a kosztuje. W symulacji znamy prawdę: najlepszy jest limit 4 przy CPM 20, 40 i 80 zł, a przy 80 zł limit 3 daje prawie to samo (3862 wobec 3873 zł). Wynik zależy od przyjętej wartości abonenta – podaj ją w pracy i sprawdź wrażliwość, np. przy wartości z modelu CLV.
Podpis do pracy:
Rysunek 5: czas od ostatniego kontaktu
Ta sama liczba reklam może działać różnie, zależnie od tego, jak rozłożymy ją w czasie. W naszym mechanizmie efekt reklamy zanika: po dniu zostaje 81% efektu z dnia kontaktu, po 3 dniach – 49%, po tygodniu – 15%. Sprawdziliśmy na 20 000 symulowanych osobach, jak różne plany z 8 reklamami zmieniają szansę zakupu.
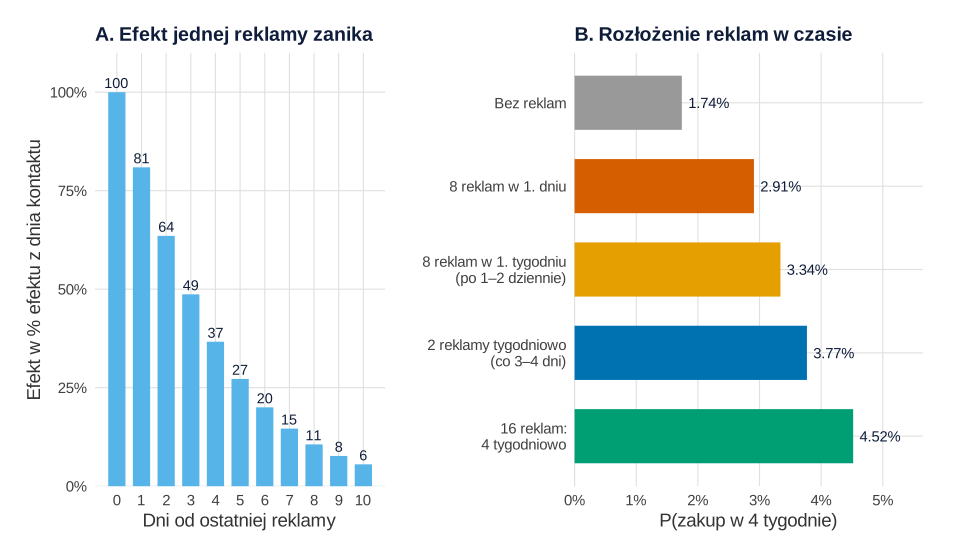
set.seed(6675)).Co widać. Bez reklam kupuje 1.74% osób. Osiem reklam w pierwszym dniu daje 2.91%, w pierwszym tygodniu – 3.34%, a rozłożone co 3–4 dni – 3.77%. Szesnaście reklam po 4 tygodniowo daje 4.52%, więcej niż przy limicie 4 w eksperymencie, bo tam wiele osób widziało mniej reklam, niż pozwalał limit.
Jak może zmylić. To nie jest wynik z danych, tylko z mechanizmu, który sami ustawiliśmy. W prawdziwej kampanii odstęp między reklamami trzeba zmierzyć w eksperymencie – np. losując limit dzienny przy tym samym limicie tygodniowym. Sahni i in. (2019) pokazali, że w pierwszym dniu przypadało 33% efektu reklamy z całego pierwszego tygodnia, a Schmidt i Eisend (2015) – że ekspozycje rozłożone w czasie wzmacniały efekt powtórzeń dla postawy wobec marki.
Podpis do pracy:
Rysunek 6: karta „limit wyświetleń: co wiemy”
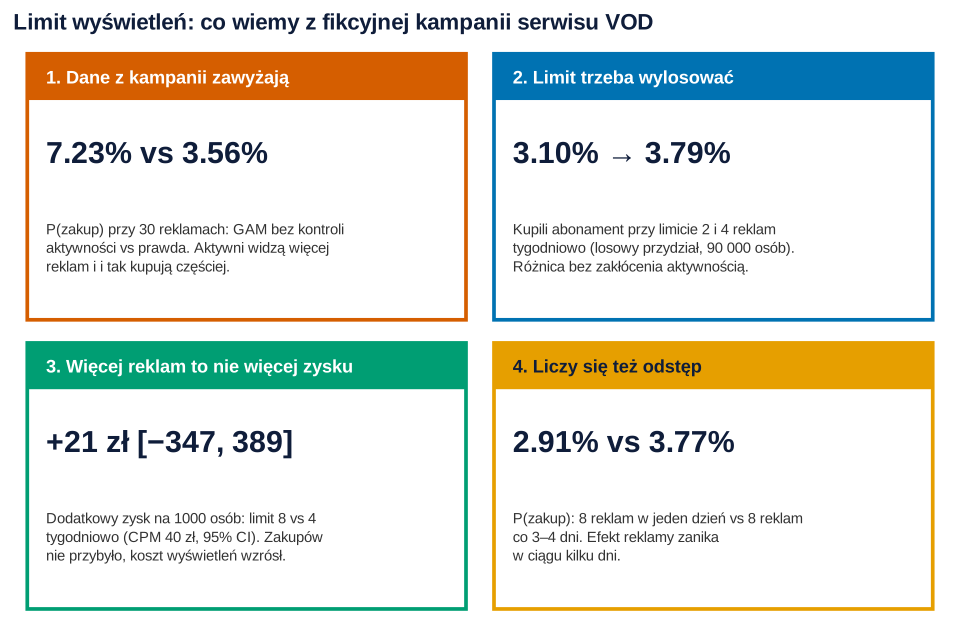
Karta zbiera wynik w czterech zdaniach. Dane obserwacyjne mylą, eksperyment z limitem daje odpowiedź, zysk rozstrzyga remis, a odstęp między reklamami to osobna dźwignia. Liczby wstawia kod, więc po zmianie danych karta się aktualizuje.
Co z tym zrobić w marketingu
- Nie wyznaczaj limitu z danych kampanii. Krzywa „im więcej reklam, tym więcej zakupów” z panelu reklamowego mierzy głównie to, kto jest aktywny w sieci.
- Losuj limit. Trzy grupy z różnym limitem tygodniowym to tani eksperyment: reklama i tak trwa, zmienia się tylko jej rozdział. Liczebność zaplanuj z góry – różnica 0.16 pp wymaga dużo większych grup niż różnica 0.7 pp (dobór liczebności próby).
- Licz zysk na osobę, nie odsetek zakupów. Przy remisie w zakupach wybierz niższy limit, bo każde wyświetlenie kosztuje.
- Rozkładaj reklamy w czasie. Limit dzienny chroni przed ośmioma reklamami jednego wieczoru.
- Odśwież kreację przy dłuższych kampaniach. Zmęczenie dotyczy zwykle konkretnej reklamy, a przy nowej marce przychodzi szybciej (Campbell i Keller, 2003).
Częstotliwość na poziomie tygodni i kanałów – razem z opóźnieniem efektu (adstock) – ujmuje marketing mix modeling. Podobną krzywą odpowiedzi z progiem i nasyceniem, ale dla głębokości rabatu, pokazuje wpis o głębokości rabatu a sprzedaży. Ogólne wskazówki do pracy dyplomowej zebraliśmy w tekście statystyka w pracy z marketingu.
Jak opisać w pracy
Opisz źródło zmienności liczby wyświetleń (naturalna czy losowa), model krzywej, sposób uśredniania przewidywań i założenia ekonomiczne.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, prawdziwy mechanizm i dane z kampanii, przepis 3 – dane eksperymentu używane w przepisie 4, a przepis 6 korzysta z wyników przepisów 2–5. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje, zaczyna od własnego set.seed(): 667 w przepisie 1, 6672 i 6673 w przepisie 2, 6674 w przepisie 3 i 6675 w przepisie 5; przepisy 4, 6 i 7 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: prawdziwy mechanizm zakupu (bazowe log-szanse −7.6, wpływ aktywności 0.7, maksymalny efekt świeżej reklamy 1.3, nasycenie κ = 1, zanikanie τ = 3 dni, zmęczenie −0.09 log-szans za każdą reklamę ponad 10), 60 000 osób, 28 dni i zależność liczby reklam od aktywności (przepis 1); minuty online jako zaszumioną miarę aktywności (przepis 1); k = 15 i k = 10 w modelach GAM, 5000 osób do uśredniania i 300 losowań współczynników (przepis 2); 90 000 osób i limity 2, 4 i 8 (przepis 3); marżę 120 zł i CPM 40 zł (przepis 4); pięć harmonogramów reklam (przepis 5). Parametrów danych nie zmienialiśmy po pierwszym przebiegu. Po nim zmieniliśmy tylko: liczbę osób do uśredniania (z 10 000 na 5000) i losowań (z 500 na 300) oraz sposób rozkładania reklam w prawdziwej krzywej (rmultinom zamiast pętli), by przepis 2 liczył się szybciej; panel B rysunku 3 (rozkład wyświetleń zamiast tercyli aktywności); kolor jednej linii na rysunku 2 po kontroli deuteranopii. Najdłuższy przepis (2) liczy się ok. 30 sekund.
1. Prawdziwy mechanizm i dane z kampanii: Rysunek 1
R
# Rysunek 1. Dane z kampanii: ile reklam widzi osoba i kto kupuje abonament
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Prawdziwy mechanizm (ustawiony ręcznie; znamy go tylko dlatego, że dane są fikcyjne).
# Każdego z 28 dni kampanii osoba, która jeszcze nie kupiła, kupuje abonament z prawdopodobieństwem h:
#   logit(h) = alfa + gamma * aktywnosc + beta * nasycenie(pamiec reklam) - fi * max(reklamy_dotad - c0, 0)
# pamiec reklam: każda reklama dodaje 1, a pamięć zanika o połowę co ok. 2 dni (tau = 3 dni)
par_prawda <- list(alfa = -7.6,    # bazowe dzienne log-szanse zakupu
                   gamma = 0.7,    # aktywne osoby kupują częściej także bez reklam
                   beta = 1.3,     # maksymalny efekt świeżej reklamy (log-szanse)
                   kappa = 1.0,    # nasycenie pamięci: 1 - exp(-pamiec / kappa)
                   tau = 3,        # zanikanie pamięci reklamy (dni)
                   fi = 0.09,      # zmęczenie: spadek log-szans za każdą reklamę ponad c0
                   c0 = 10)
dni <- 28

# P(zakup w czasie kampanii) dla macierzy wyświetleń (osoby × dni) i wektora aktywności
p_zakupu <- function(wysw, akt, par = par_prawda) {
  pamiec <- matrix(0, nrow(wysw), ncol(wysw)); dotad <- pamiec
  pam <- 0; sum_w <- 0
  for (t in seq_len(ncol(wysw))) {
    pam <- pam * exp(-1 / par$tau) + wysw[, t]; sum_w <- sum_w + wysw[, t]
    pamiec[, t] <- pam; dotad[, t] <- sum_w
  }
  eta <- par$alfa + par$gamma * akt + par$beta * (1 - exp(-pamiec / par$kappa)) - par$fi * pmax(dotad - par$c0, 0)
  1 - exp(rowSums(log1p(-plogis(eta))))
}

# Kampania pozyskania: 60 000 osób bez abonamentu, 4 tygodnie, BEZ limitu wyświetleń.
# Liczba reklam dziennie zależy od tego, ile czasu ktoś spędza w sieci (aktywność).
set.seed(667)
N <- 60000
aktywnosc <- rnorm(N)                                       # ukryta aktywność w sieci (niewidoczna w danych)
lambda <- exp(log(0.25) + 0.75 * aktywnosc + rnorm(N, 0, 0.4))  # średnio wyświetleń dziennie
wysw <- matrix(rpois(N * dni, rep(lambda, dni)), N, dni)
d <- data.frame(id = sprintf("U%05d", 1:N),
                wyswietlenia = rowSums(wysw),
                minuty_online = round(exp(3.4 + 0.5 * (aktywnosc + rnorm(N, 0, 0.8)))),  # zaszumiona miara aktywności
                p_prawdziwe = p_zakupu(wysw, aktywnosc))
d$abonament <- rbinom(N, 1, d$p_prawdziwe)
d$aktywnosc <- aktywnosc                                    # tylko do pokazania pułapki; w prawdziwych danych jej nie ma

c(osoby = N, kupili = sum(d$abonament), proc_kupili = round(100 * mean(d$abonament), 2),
  srednia_wysw = round(mean(d$wyswietlenia), 2), mediana_wysw = median(d$wyswietlenia),
  proc_zero = round(100 * mean(d$wyswietlenia == 0), 1), proc_powyzej_20 = round(100 * mean(d$wyswietlenia > 20), 1),
  p99_wysw = unname(quantile(d$wyswietlenia, 0.99)))
round(cor(log(d$minuty_online), d$aktywnosc), 2)        # jak dobrze minuty online mierzą aktywność

# Odsetek kupujących w przedziałach liczby wyświetleń – razem i w tercylach aktywności
d$grupa_w <- cut(d$wyswietlenia, c(-1, 0, 2, 5, 10, 15, 20, 30, Inf),
                 labels = c("0", "1–2", "3–5", "6–10", "11–15", "16–20", "21–30", "31+"))
d$tercyl <- cut(d$aktywnosc, quantile(d$aktywnosc, 0:3 / 3), include.lowest = TRUE,
                labels = c("Mało aktywni", "Średnio aktywni", "Bardzo aktywni"))
razem <- aggregate(cbind(n = 1, kupili = abonament) ~ grupa_w, d, sum)
razem$proc <- round(100 * razem$kupili / razem$n, 2)
razem
w_tercylach <- aggregate(cbind(n = 1, kupili = abonament, wysw = wyswietlenia) ~ tercyl, d, sum)
transform(w_tercylach, srednia_wysw = round(wysw / n, 1), proc = round(100 * kupili / n, 2))

ta <- aggregate(cbind(n = 1, kupili = abonament) ~ grupa_w + tercyl, d, sum)
ta <- subset(ta, n >= 200)                                  # pomijamy komórki z mniej niż 200 osobami
ta$proc <- 100 * ta$kupili / ta$n
pa <- ggplot(d, aes(pmin(wyswietlenia, 40))) +
  geom_histogram(binwidth = 1, boundary = -0.5, fill = kol[["blekit"]], colour = "white", linewidth = 0.2) +
  scale_x_continuous(breaks = seq(0, 40, 10), labels = c(seq(0, 30, 10), "40+")) +
  scale_y_continuous(labels = function(v) format(v, big.mark = " ")) +
  labs(x = "Wyświetlenia reklamy na osobę (4 tygodnie)", y = "Liczba osób", title = "A. Rozkład wyświetleń") + motyw
pb <- ggplot() +
  geom_line(data = ta, aes(grupa_w, proc, colour = tercyl, linetype = tercyl, group = tercyl), linewidth = 0.9) +
  geom_point(data = ta, aes(grupa_w, proc, colour = tercyl, shape = tercyl), size = 2.4) +
  geom_line(data = razem, aes(grupa_w, proc, group = 1), colour = "#0f1d3a", linewidth = 1.3) +
  geom_point(data = razem, aes(grupa_w, proc), colour = "#0f1d3a", size = 2.8, shape = 15) +
  scale_colour_manual(values = c(kol[["zolty"]], kol[["blekit"]], kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("dashed", "longdash", "solid"), name = NULL) +
  scale_shape_manual(values = c(17, 16, 15), name = NULL) +
  scale_y_continuous(labels = function(v) paste0(v, "%")) +
  labs(x = "Wyświetlenia reklamy", y = "Kupili abonament",
       title = "B. Kto kupuje (granat: wszyscy)") + motyw +
  theme(axis.text.x = element_text(size = rel(0.8)))
p1 <- pa + pb + plot_layout(widths = c(1, 1.25))
p1   # zapis: ggsave("czestotliwosc-dane-kampania.svg", p1, width = 10, height = 5.6)
Wynik w R
          osoby          kupili     proc_kupili    srednia_wysw    mediana_wysw
       60000.00         2069.00            3.45            9.99            7.00
      proc_zero proc_powyzej_20        p99_wysw
           3.10           11.00           51.00
[1] 0.78
  grupa_w     n kupili proc
1       0  1850     11 0.59
2     1–2  8116     69 0.85
3     3–5 14346    237 1.65
4    6–10 16309    550 3.37
5   11–15  8320    433 5.20
6   16–20  4445    275 6.19
7   21–30  3928    292 7.43
8     31+  2686    202 7.52
           tercyl     n kupili   wysw srednia_wysw proc
1    Mało aktywni 20000    202  71140          3.6 1.01
2 Średnio aktywni 20000    535 154260          7.7 2.67
3  Bardzo aktywni 20000   1332 373819         18.7 6.66
2. Modele GAM i prawdziwa krzywa: Rysunek 2
R
# Rysunek 2. Krzywa odpowiedzi z modelu GAM: dane obserwacyjne a prawda
# (korzysta z kol, motyw, par_prawda, dni, p_zakupu i danych d z przepisu 1)
library(ggplot2)
library(mgcv)

# Prawdziwa krzywa: P(zakup), gdyby KAŻDY dostał dokładnie n reklam w losowe dni kampanii
set.seed(6672)
M <- 4000
akt_m <- rnorm(M)
x <- 0:40
prawda <- data.frame(n = x, p = sapply(x, function(n) {
  w <- t(rmultinom(M, n, rep(1, dni)))        # n reklam rozłożonych losowo na 28 dni
  mean(p_zakupu(w, akt_m))
}))

# Trzy modele GAM (regresja logistyczna z gładką funkcją liczby wyświetleń, wygładzanie REML)
m_naiwny <- gam(abonament ~ s(wyswietlenia, k = 15), family = binomial, data = d, method = "REML")
m_minuty <- gam(abonament ~ s(wyswietlenia, k = 15) + s(log(minuty_online), k = 10),
                family = binomial, data = d, method = "REML")
m_wyrocznia <- gam(abonament ~ s(wyswietlenia, k = 15) + s(aktywnosc, k = 10),   # niemożliwy w praktyce:
                   family = binomial, data = d, method = "REML")                    # aktywność jest ukryta
# Efektywne stopnie swobody gładkich funkcji i AIC
edf <- function(m) unname(summary(m)$s.table[, "edf"])
round(rbind(naiwny = c(edf_wyswietlenia = edf(m_naiwny), edf_aktywnosc = NA, AIC = AIC(m_naiwny)),
            minuty = c(edf(m_minuty), AIC(m_minuty)),
            wyrocznia = c(edf(m_wyrocznia), AIC(m_wyrocznia))), 1)

# Krzywa „dla całej populacji”: ustawiamy wszystkim n wyświetleń i uśredniamy przewidywania
# (standaryzacja); 95% CI z 300 losowań współczynników z ich rozkładu w modelu
krzywa_gam <- function(m, nazwa, osoby = d[1:5000, ], los = 300) {
  X <- do.call(rbind, lapply(x, function(n) predict(m, transform(osoby, wyswietlenia = n), type = "lpmatrix")))
  B <- rmvn(los, coef(m), vcov(m))
  P <- plogis(X %*% t(B))                                     # (osoby × n) × losowania
  sr <- rowsum(P, rep(x, each = nrow(osoby))) / nrow(osoby)   # średnia po osobach dla każdego n
  data.frame(n = x, p = rowMeans(sr), dol = apply(sr, 1, quantile, 0.025), gora = apply(sr, 1, quantile, 0.975),
             model = nazwa)
}
set.seed(6673)
k <- rbind(krzywa_gam(m_naiwny, "GAM bez kontroli aktywności"),
           krzywa_gam(m_minuty, "GAM z minutami online"),
           krzywa_gam(m_wyrocznia, "GAM z ukrytą aktywnością (wyrocznia)"))
tab <- reshape(k[k$n %in% c(0, 5, 10, 15, 20, 30, 40), c("n", "p", "model")], idvar = "n", timevar = "model",
               direction = "wide")
tab$prawda <- prawda$p[match(tab$n, prawda$n)]
names(tab) <- c("n", "naiwny", "minuty", "wyrocznia", "prawda")
round(cbind(n = tab$n, 100 * tab[, -1]), 2)
# Przewidywania z 95% CI przy 15 i 30 wyświetleniach (%)
ci <- k[k$n %in% c(15, 30), ]
data.frame(model = ci$model, n = ci$n, round(100 * ci[c("p", "dol", "gora")], 2))
# Gdzie krzywa osiąga szczyt?
sapply(split(k, k$model), function(s) s$n[which.max(s$p)])
c(prawda = prawda$n[which.max(prawda$p)])
# Przyrost P(zakup) od 0 do 15 wyświetleń: model a prawda (punkty procentowe, z 95% CI)
round(100 * sapply(split(k, k$model), function(s) s$p[s$n == 15] - s$p[s$n == 0]), 2)
round(100 * (prawda$p[prawda$n == 15] - prawda$p[prawda$n == 0]), 2)

k$model <- factor(k$model, c("GAM bez kontroli aktywności", "GAM z minutami online", "GAM z ukrytą aktywnością (wyrocznia)"))
p2 <- ggplot() +
  geom_ribbon(data = k, aes(n, ymin = 100 * dol, ymax = 100 * gora, fill = model), alpha = 0.22) +
  geom_line(data = k, aes(n, 100 * p, colour = model, linetype = model), linewidth = 1.1) +
  geom_line(data = prawda, aes(n, 100 * p), colour = "#0f1d3a", linewidth = 1.2, linetype = "dotted") +
  annotate("text", x = 40, y = 100 * prawda$p[41] + 0.45, label = "prawda", hjust = 1, size = 4.2, colour = "#0f1d3a") +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["zielony"]], kol[["niebieski"]]), name = NULL) +
  scale_fill_manual(values = c(kol[["pomaranczowy"]], kol[["zielony"]], kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("dashed", "longdash", "solid"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 40, 5)) +
  scale_y_continuous(labels = function(v) paste0(v, "%"), limits = c(0, NA)) +
  labs(x = "Wyświetlenia reklamy na osobę (4 tygodnie)", y = "P(zakup abonamentu)",
       title = "Bez kontroli aktywności GAM nie widzi zmęczenia",
       subtitle = "Średnie przewidywania z 95% CI; linia kropkowana – prawda z symulacji") +
  guides(colour = guide_legend(nrow = 3), fill = guide_legend(nrow = 3), linetype = guide_legend(nrow = 3)) + motyw
p2   # zapis: ggsave("czestotliwosc-gam-krzywa-odpowiedzi.svg", p2, width = 10, height = 6.2)
Wynik w R
          edf_wyswietlenia edf_aktywnosc     AIC
naiwny                 8.0            NA 17110.2
minuty                 7.5           1.9 17002.6
wyrocznia              6.5           1.0 16765.4
    n naiwny minuty wyrocznia prawda
0   0   0.77   1.06      2.11   1.77
5   5   1.94   2.17      2.98   2.99
10 10   4.11   3.87      3.90   3.96
15 15   6.29   5.32      4.36   4.28
20 20   7.17   5.74      4.17   4.16
30 30   7.23   5.38      3.21   3.56
40 40   7.91   5.41      2.62   2.93
                                   model  n    p  dol gora
15           GAM bez kontroli aktywności 15 6.29 5.91 6.70
30           GAM bez kontroli aktywności 30 7.23 6.43 8.00
151                GAM z minutami online 15 5.32 4.98 5.76
301                GAM z minutami online 30 5.38 4.74 6.10
152 GAM z ukrytą aktywnością (wyrocznia) 15 4.36 4.05 4.65
302 GAM z ukrytą aktywnością (wyrocznia) 30 3.21 2.83 3.61
         GAM bez kontroli aktywności                GAM z minutami online
                                  40                                   20
GAM z ukrytą aktywnością (wyrocznia)
                                  16
prawda
    16
         GAM bez kontroli aktywności                GAM z minutami online
                                5.52                                 4.26
GAM z ukrytą aktywnością (wyrocznia)
                                2.25
[1] 2.5
3. Eksperyment z losowym limitem: Rysunek 3
R
# Rysunek 3. Eksperyment: losowy limit wyświetleń (2, 4 albo 8 reklam tygodniowo na osobę)
# (korzysta z kol, motyw, par_prawda, dni i p_zakupu z przepisu 1)
library(ggplot2)
library(patchwork)

# Ogranicza wyświetlenia do „limit” na osobę w każdym tygodniu (dni 1–7, 8–14, …)
przytnij <- function(wysw, limit) {
  for (tydz in split(seq_len(ncol(wysw)), ceiling(seq_len(ncol(wysw)) / 7))) {
    narast <- t(apply(wysw[, tydz, drop = FALSE], 1, cumsum))
    przyc <- pmin(narast, limit)
    wysw[, tydz] <- przyc - cbind(0, przyc[, -length(tydz), drop = FALSE])
  }
  wysw
}

# Kolejna kampania: 90 000 nowych osób, każda losowo przypisana do jednego limitu
set.seed(6674)
N_e <- 90000
akt_e <- rnorm(N_e)
lambda_e <- exp(log(0.25) + 0.75 * akt_e + rnorm(N_e, 0, 0.4))
wysw_e <- matrix(rpois(N_e * dni, rep(lambda_e, dni)), N_e, dni)
e <- data.frame(id = sprintf("E%05d", 1:N_e), limit = sample(rep(c(2, 4, 8), each = N_e / 3)))
for (L in c(2, 4, 8)) {
  i <- e$limit == L
  w <- przytnij(wysw_e[i, ], L)
  e$wyswietlenia[i] <- rowSums(w)
  e$p_prawdziwe[i] <- p_zakupu(w, akt_e[i])
}
e$abonament <- rbinom(N_e, 1, e$p_prawdziwe)

# Odsetek kupujących w każdej grupie z 95% CI (Wilsona) i średnia liczba wyświetleń
wynik <- do.call(rbind, lapply(c(2, 4, 8), function(L) {
  s <- e[e$limit == L, ]
  ci <- prop.test(sum(s$abonament), nrow(s), correct = FALSE)$conf.int
  data.frame(limit = L, n = nrow(s), kupili = sum(s$abonament), proc = 100 * mean(s$abonament),
             dol = 100 * ci[1], gora = 100 * ci[2], sr_wysw = mean(s$wyswietlenia),
             proc_prawdziwe = 100 * mean(s$p_prawdziwe))
}))
round(wynik, 2)
# Różnice odsetków między limitami (punkty procentowe, 95% CI)
roznica <- function(a, b) {
  t <- prop.test(c(sum(e$abonament[e$limit == a]), sum(e$abonament[e$limit == b])),
                 c(sum(e$limit == a), sum(e$limit == b)), correct = FALSE)
  round(c(roznica_pp = 100 * unname(-diff(t$estimate)), dol = 100 * t$conf.int[1], gora = 100 * t$conf.int[2],
          p = t$p.value), 4)
}
rbind("4 vs 2" = roznica(4, 2), "8 vs 4" = roznica(8, 4), "8 vs 2" = roznica(8, 2))
# Test ogólny: czy odsetki różnią się między trzema limitami (chi-kwadrat)
chisq.test(table(e$limit, e$abonament))

# Ten sam limit działa inaczej na mało i bardzo aktywnych (tercyle ukrytej aktywności – znane tylko w symulacji)
e$tercyl <- cut(akt_e, quantile(akt_e, 0:3 / 3), include.lowest = TRUE,
                labels = c("Mało aktywni", "Średnio aktywni", "Bardzo aktywni"))
tt <- aggregate(cbind(proc = abonament, wysw = wyswietlenia) ~ limit + tercyl, e, mean)
tt$proc <- round(100 * tt$proc, 2); tt$wysw <- round(tt$wysw, 1)
tt

wynik$etykieta <- factor(paste(wynik$limit, "/ tydz."), paste(c(2, 4, 8), "/ tydz."))
pa <- ggplot(wynik, aes(etykieta, proc)) +
  geom_col(fill = kol[["blekit"]], width = 0.6) +
  geom_errorbar(aes(ymin = dol, ymax = gora), width = 0.15, linewidth = 0.8, colour = "#0f1d3a") +
  geom_text(aes(y = gora + 0.25, label = sprintf("%.2f%%", proc)), size = 4.2, colour = "#0f1d3a") +
  scale_y_continuous(labels = function(v) paste0(v, "%"), expand = expansion(mult = c(0, 0.08))) +
  labs(x = "Limit wyświetleń", y = "Kupili abonament (95% CI)", title = "A. Zakupy w trzech grupach") + motyw
# Ile reklam faktycznie zobaczyli: mediana, 90. percentyl i maksimum wyświetleń w grupach
round(sapply(c(2, 4, 8), function(L) c(limit = L, mediana = median(e$wyswietlenia[e$limit == L]),
                                       p90 = unname(quantile(e$wyswietlenia[e$limit == L], 0.9)),
                                       max = max(e$wyswietlenia[e$limit == L]))), 1)
r <- as.data.frame(table(limit = e$limit, w = e$wyswietlenia))
r$w <- as.numeric(as.character(r$w)); r$proc <- 100 * r$Freq / (N_e / 3)
r$etykieta <- factor(paste("limit", r$limit, "/ tydz."), paste("limit", c(2, 4, 8), "/ tydz."))
pb <- ggplot(r, aes(w, proc, colour = etykieta, linetype = etykieta)) +
  geom_step(linewidth = 0.9, direction = "mid") +
  scale_colour_manual(values = c(kol[["zolty"]], kol[["blekit"]], kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("dashed", "longdash", "solid"), name = NULL) +
  scale_x_continuous(breaks = c(0, 8, 16, 24, 32), limits = c(0, 33)) +
  scale_y_continuous(labels = function(v) paste0(v, "%")) +
  labs(x = "Wyświetlenia na osobę (4 tygodnie)", y = "Odsetek osób w grupie", title = "B. Ile reklam zobaczyli") +
  guides(colour = guide_legend(nrow = 3)) + motyw
p3 <- pa + pb
p3   # zapis: ggsave("czestotliwosc-eksperyment-limit.svg", p3, width = 10, height = 5.8)
Wynik w R
  limit     n kupili proc  dol gora sr_wysw proc_prawdziwe
1     2 30000    930 3.10 2.91 3.30    5.21           3.31
2     4 30000   1136 3.79 3.58 4.01    7.58           3.72
3     8 30000   1158 3.86 3.65 4.08    9.26           3.56
       roznica_pp     dol   gora      p
4 vs 2     0.6867  0.3949 0.9784 0.0000
8 vs 4     0.0733 -0.2335 0.3802 0.6395
8 vs 2     0.7600  0.4668 1.0532 0.0000

	Pearson's Chi-squared test

data:  table(e$limit, e$abonament)
X-squared = 30.53, df = 2, p-value = 2.346e-07

  limit          tercyl proc wysw
1     2    Mało aktywni 0.91  3.1
2     4    Mało aktywni 1.18  3.5
3     8    Mało aktywni 1.04  3.6
4     2 Średnio aktywni 2.42  5.4
5     4 Średnio aktywni 2.82  7.2
6     8 Średnio aktywni 3.10  7.7
7     2  Bardzo aktywni 5.99  7.1
8     4  Bardzo aktywni 7.35 12.1
9     8  Bardzo aktywni 7.42 16.4
        [,1] [,2] [,3]
limit      2    4    8
mediana    6    7    7
p90        8   15   21
max        8   16   32
4. Zysk i koszt wyświetleń: Rysunek 4
R
# Rysunek 4. Który limit się opłaca? Zysk na 1000 osób przy koszcie wyświetlenia
# (korzysta z kol, motyw z przepisu 1 i danych e z przepisu 3)
library(ggplot2)
library(patchwork)

wartosc <- 120   # zł: marża z nowego abonenta w pierwszych 6 miesiącach (założenie ustawione ręcznie)
cpm <- 40        # zł za 1000 wyświetleń reklamy wideo (założenie ustawione ręcznie)

# Zysk z osoby = wartość × (kupił? 1 : 0) − koszt jej wyświetleń; porównujemy średnie (t Welcha)
zysk_osoby <- function(cpm) wartosc * e$abonament - cpm / 1000 * e$wyswietlenia
z <- zysk_osoby(cpm)
zysk <- do.call(rbind, lapply(c(2, 4, 8), function(L) {
  t <- t.test(z[e$limit == L])
  data.frame(limit = L, zysk_1000 = 1000 * mean(z[e$limit == L]), dol = 1000 * t$conf.int[1], gora = 1000 * t$conf.int[2],
             zysk_prawdziwy_1000 = 1000 * mean(wartosc * e$p_prawdziwe[e$limit == L] - cpm / 1000 * e$wyswietlenia[e$limit == L]),
             koszt_1000 = cpm * mean(e$wyswietlenia[e$limit == L]))
}))
round(zysk)

# Różnica zysku na 1000 osób przy różnych CPM: 4 vs 2 i 8 vs 4 (95% CI)
roznice <- do.call(rbind, lapply(seq(0, 120, by = 5), function(c_) {
  z <- zysk_osoby(c_)
  do.call(rbind, lapply(list(c(4, 2), c(8, 4)), function(ab) {
    t <- t.test(z[e$limit == ab[1]], z[e$limit == ab[2]])
    data.frame(cpm = c_, porownanie = paste(ab[1], "vs", ab[2], "/ tydz."),
               roznica = 1000 * unname(-diff(t$estimate)), dol = 1000 * t$conf.int[1], gora = 1000 * t$conf.int[2])
  }))
}))
wybrane <- subset(roznice, cpm %in% c(0, 20, 40, 60, 80, 120))
wybrane[c("roznica", "dol", "gora")] <- round(wybrane[c("roznica", "dol", "gora")])
wybrane
# Przy jakim CPM wyższy limit przestaje się opłacać (punktowo)?
sapply(split(roznice, roznice$porownanie), function(s) s$cpm[which(s$roznica < 0)[1]])

# Tylko w symulacji: prawdziwy zysk dla limitów 1–12 tygodniowo (20 000 osób z eksperymentu, ich naturalne wyświetlenia)
# (korzysta też z wysw_e, akt_e i przytnij z przepisu 3)
prawdziwy <- do.call(rbind, lapply(1:12, function(L) {
  w <- przytnij(wysw_e[1:20000, ], L)
  data.frame(limit = L, proc = 100 * mean(p_zakupu(w, akt_e[1:20000])), sr_wysw = mean(rowSums(w)))
}))
for (c_ in c(20, 40, 80)) prawdziwy[[paste0("zysk_cpm", c_)]] <- 1000 * (wartosc * prawdziwy$proc / 100 - c_ / 1000 * prawdziwy$sr_wysw)
round(prawdziwy, 2)
sapply(prawdziwy[grep("zysk", names(prawdziwy))], function(v) prawdziwy$limit[which.max(v)])  # najlepszy limit

zysk$etykieta <- factor(paste(zysk$limit, "/ tydz."), paste(c(2, 4, 8), "/ tydz."))
pa <- ggplot(zysk, aes(etykieta)) +
  geom_pointrange(aes(y = zysk_1000, ymin = dol, ymax = gora, shape = "Eksperyment (95% CI)"),
                  colour = kol[["niebieski"]], size = 0.8, linewidth = 1) +
  geom_point(aes(y = zysk_prawdziwy_1000, shape = "Prawda (symulacja)"), colour = "#0f1d3a", size = 3.2,
             position = position_nudge(x = 0.18)) +
  scale_shape_manual(values = c(16, 4), name = NULL) +
  scale_y_continuous(labels = function(v) paste(v, "zł")) +
  labs(x = "Limit wyświetleń", y = "Zysk na 1000 osób", title = sprintf("A. Zysk przy CPM %d zł", cpm)) +
  guides(shape = guide_legend(nrow = 2)) + motyw
pb <- ggplot(roznice, aes(cpm, roznica, colour = porownanie, fill = porownanie, linetype = porownanie)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_ribbon(aes(ymin = dol, ymax = gora), alpha = 0.18, colour = NA) +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_fill_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 120, 20)) +
  scale_y_continuous(labels = function(v) paste(v, "zł")) +
  labs(x = "CPM – koszt 1000 wyświetleń (zł)", y = "Dodatkowy zysk na 1000 osób", title = "B. Wyższy limit a koszt reklamy") +
  guides(colour = guide_legend(nrow = 2)) + motyw
p4 <- pa + pb + plot_layout(widths = c(1, 1.3))
p4   # zapis: ggsave("czestotliwosc-zysk-limit-cpm.svg", p4, width = 10, height = 5.8)
Wynik w R
  limit zysk_1000  dol gora zysk_prawdziwy_1000 koszt_1000
1     2      3512 3276 3747                3767        208
2     4      4241 3982 4500                4160        303
3     8      4262 4001 4523                3904        370
   cpm     porownanie roznica  dol gora
1    0 4 vs 2 / tydz.     824  474 1174
2    0 8 vs 4 / tydz.      88 -280  456
9   20 4 vs 2 / tydz.     776  427 1126
10  20 8 vs 4 / tydz.      55 -313  423
17  40 4 vs 2 / tydz.     729  379 1079
18  40 8 vs 4 / tydz.      21 -347  389
25  60 4 vs 2 / tydz.     681  332 1031
26  60 8 vs 4 / tydz.     -12 -380  355
33  80 4 vs 2 / tydz.     634  284  983
34  80 8 vs 4 / tydz.     -46 -413  321
49 120 4 vs 2 / tydz.     539  190  888
50 120 8 vs 4 / tydz.    -113 -480  254
4 vs 2 / tydz. 8 vs 4 / tydz.
            NA             55
   limit proc sr_wysw zysk_cpm20 zysk_cpm40 zysk_cpm80
1      1 2.72    3.07    3202.09    3140.60    3017.63
2      2 3.34    5.20    3901.65    3797.59    3589.46
3      3 3.66    6.64    4259.94    4127.20    3861.71
4      4 3.73    7.60    4328.56    4176.55    3872.53
5      5 3.72    8.25    4297.57    4132.52    3802.41
6      6 3.67    8.71    4224.89    4050.76    3702.51
7      7 3.62    9.03    4161.72    3981.08    3619.78
8      8 3.58    9.27    4111.30    3925.95    3555.25
9      9 3.55    9.44    4073.26    3884.45    3506.84
10    10 3.53    9.57    4045.32    3853.92    3471.13
11    11 3.51    9.67    4021.38    3828.06    3441.43
12    12 3.50    9.74    4004.37    3809.56    3419.95
zysk_cpm20 zysk_cpm40 zysk_cpm80
         4          4          4
5. Odstęp między reklamami: Rysunek 5
R
# Rysunek 5. Czas od ostatniego kontaktu: ta sama liczba reklam, różne rozłożenie w czasie
# (korzysta z kol, motyw, par_prawda, dni i p_zakupu z przepisu 1)
library(ggplot2)
library(patchwork)

# A. Ile zostaje z efektu jednej reklamy po k dniach (prawdziwy mechanizm: pamięć zanika z tau = 3 dni)
po_dniach <- data.frame(dzien = 0:10)
po_dniach$efekt <- 100 * (1 - exp(-exp(-po_dniach$dzien / par_prawda$tau) / par_prawda$kappa)) /
  (1 - exp(-1 / par_prawda$kappa))
round(po_dniach$efekt[po_dniach$dzien %in% c(1, 3, 7)], 1)

# B. Osiem reklam w 4 tygodnie – cztery sposoby rozłożenia; P(zakup) uśrednione po 20 000 osób
set.seed(6675)
akt_s <- rnorm(20000)
plan <- function(dni_reklam) {           # wektor dni, w które pada reklama (powtórzenia = kilka reklam dziennie)
  w <- matrix(tabulate(dni_reklam, dni), length(akt_s), dni, byrow = TRUE)
  100 * mean(p_zakupu(w, akt_s))
}
schematy <- data.frame(
  schemat = c("Bez reklam", "8 reklam w 1. dniu", "8 reklam w 1. tygodniu (po 1–2 dziennie)",
              "2 reklamy tygodniowo (co 3–4 dni)", "16 reklam: 4 tygodniowo"),
  p = c(plan(integer(0)), plan(rep(1, 8)), plan(c(1, 1, 2, 3, 4, 5, 6, 7)),
        plan(c(1, 4, 8, 11, 15, 18, 22, 25)), plan(c(1, 2, 4, 6, 8, 9, 11, 13, 15, 16, 18, 20, 22, 23, 25, 27))))
schematy$p <- round(schematy$p, 2)
schematy

pa <- ggplot(po_dniach, aes(dzien, efekt)) +
  geom_col(fill = kol[["blekit"]], width = 0.7) +
  geom_text(aes(label = round(efekt)), vjust = -0.4, size = 3.8, colour = "#0f1d3a") +
  scale_x_continuous(breaks = 0:10) +
  scale_y_continuous(labels = function(v) paste0(v, "%"), expand = expansion(mult = c(0, 0.1))) +
  labs(x = "Dni od ostatniej reklamy", y = "Efekt w % efektu z dnia kontaktu",
       title = "A. Efekt jednej reklamy zanika") + motyw
schematy$schemat <- factor(schematy$schemat, rev(schematy$schemat))
pb <- ggplot(schematy, aes(p, schemat)) +
  geom_col(fill = c(kol[["szary"]], kol[["pomaranczowy"]], kol[["zolty"]], kol[["niebieski"]], kol[["zielony"]]), width = 0.65) +
  geom_text(aes(label = sprintf("%.2f%%", p)), hjust = -0.15, size = 3.9, colour = "#0f1d3a") +
  scale_x_continuous(labels = function(v) paste0(v, "%"), expand = expansion(mult = c(0, 0.25))) +
  scale_y_discrete(labels = function(v) gsub(": ", ":\n", gsub(" \\(", "\n(", v))) +
  labs(x = "P(zakup w 4 tygodnie)", y = NULL, title = "B. Rozłożenie reklam w czasie") + motyw
p5 <- pa + pb + plot_layout(widths = c(1, 1.2))
p5   # zapis: ggsave("czestotliwosc-odstep-miedzy-reklamami.svg", p5, width = 10, height = 5.8)
Wynik w R
[1] 80.9 48.7 14.6
                                   schemat    p
1                               Bez reklam 1.74
2                       8 reklam w 1. dniu 2.91
3 8 reklam w 1. tygodniu (po 1–2 dziennie) 3.34
4        2 reklamy tygodniowo (co 3–4 dni) 3.77
5                  16 reklam: 4 tygodniowo 4.52
6. Karta „limit wyświetleń: co wiemy”: Rysunek 6
R
# Rysunek 6. Karta „Limit wyświetleń: co wiemy” – liczby wstawiane z wyników przepisów 2–5
# (korzysta z kol, prawda i k z przepisu 2, wynik z przepisu 3, zysk i roznice z przepisu 4, schematy z przepisu 5)
library(ggplot2)

f2 <- function(v) formatC(v, format = "f", digits = 2)
karty <- data.frame(
  x = c(0, 1, 0, 1), y = c(1, 1, 0, 0),
  naglowek = c("1. Dane z kampanii zawyżają", "2. Limit trzeba wylosować",
               "3. Więcej reklam to nie więcej zysku", "4. Liczy się też odstęp"),
  liczba = c(sprintf("%s%% vs %s%%", f2(100 * k$p[k$n == 30 & k$model == "GAM bez kontroli aktywności"]),
                     f2(100 * prawda$p[prawda$n == 30])),
             sprintf("%s%% → %s%%", f2(wynik$proc[wynik$limit == 2]), f2(wynik$proc[wynik$limit == 4])),
             with(subset(roznice, cpm == 40 & porownanie == "8 vs 4 / tydz."),
                  gsub("-", "\u2212", sprintf("%+.0f zł [%.0f, %.0f]", roznica, dol, gora))),
             sprintf("%s%% vs %s%%", f2(schematy$p[schematy$schemat == "8 reklam w 1. dniu"]),
                     f2(schematy$p[schematy$schemat == "2 reklamy tygodniowo (co 3–4 dni)"]))),
  opis = c("P(zakup) przy 30 reklamach: GAM bez kontroli\naktywności vs prawda. Aktywni widzą więcej\nreklam i i tak kupują częściej.",
           "Kupili abonament przy limicie 2 i 4 reklam\ntygodniowo (losowy przydział, 90 000 osób).\nRóżnica bez zakłócenia aktywnością.",
           "Dodatkowy zysk na 1000 osób: limit 8 vs 4\ntygodniowo (CPM 40 zł, 95% CI). Zakupów\nnie przybyło, koszt wyświetleń wzrósł.",
           "P(zakup): 8 reklam w jeden dzień vs 8 reklam\nco 3–4 dni. Efekt reklamy zanika\nw ciągu kilku dni."),
  kolor = c(kol[["pomaranczowy"]], kol[["niebieski"]], kol[["zielony"]], kol[["zolty"]]))
p6 <- ggplot(karty) +
  geom_rect(aes(xmin = x + 0.03, xmax = x + 0.97, ymin = y + 0.04, ymax = y + 0.96), fill = "white",
            colour = karty$kolor, linewidth = 1.3) +
  geom_rect(aes(xmin = x + 0.03, xmax = x + 0.97, ymin = y + 0.80, ymax = y + 0.96), fill = karty$kolor) +
  geom_text(aes(x + 0.07, y + 0.88, label = naglowek), hjust = 0, size = 4.8, fontface = "bold",
            colour = ifelse(karty$kolor == kol[["zolty"]], "#0f1d3a", "white")) +
  geom_text(aes(x + 0.07, y + 0.62, label = liczba), hjust = 0, size = 8, fontface = "bold", colour = "#0f1d3a") +
  geom_text(aes(x + 0.07, y + 0.29, label = opis), hjust = 0, size = 3.9, colour = "grey20", lineheight = 1.05) +
  scale_x_continuous(limits = c(0, 2), expand = c(0, 0)) + scale_y_continuous(limits = c(0, 2), expand = c(0, 0)) +
  labs(title = "Limit wyświetleń: co wiemy z fikcyjnej kampanii serwisu VOD") +
  theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 6)),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 10, 10, 10))
karty[c("naglowek", "liczba")]
p6   # zapis: ggsave("czestotliwosc-karta-limit-wyswietlen.svg", p6, width = 10, height = 6.6)
Wynik w R
                              naglowek             liczba
1          1. Dane z kampanii zawyżają     7.23% vs 3.56%
2            2. Limit trzeba wylosować      3.10% → 3.79%
3 3. Więcej reklam to nie więcej zysku +21 zł [−347, 389]
4              4. Liczy się też odstęp     2.91% vs 3.77%
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "niebieski – zielony" = c("#0072B2", "#009E73"),
             "pomarańczowy – zielony" = c("#D55E00", "#009E73"), "błękit – żółty" = c("#56B4E9", "#E69F00"),
             "żółty – pomarańczowy" = c("#E69F00", "#D55E00"), "błękit – niebieski" = c("#56B4E9", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
niebieski – zielony                         70.1         55.4       58.0
pomarańczowy – zielony                     102.4         53.5       37.3
błękit – żółty                             113.1        111.4      101.5
żółty – pomarańczowy                        33.4         18.4       24.9
błękit – niebieski                          26.4         24.7       24.6
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, testy proporcji, test chi-kwadrat i test t Welcha – pakiet stats z podstawowej instalacji R. Modele GAM i losowanie współczynników (rmvn) – pakiet mgcv. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mgcv (wersja 1.9.4): Wood, S. N. (2011). Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 73(1), 3–36. https://doi.org/10.1111/j.1467-9868.2010.00749.x
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Aktywni widzą więcej. Zależność z danych kampanii zawyża efekt kolejnych reklam i ukrywa zmęczenie (rysunki 1–2). Korelacja to nie przyczynowość (korelacja a przyczynowość).
- Wąski przedział ≠ trafny wynik. Duża próba zwęża przedział wokół złej odpowiedzi.
- Brak różnicy ≠ brak efektu. Limit 8 był naprawdę gorszy od 4, ale eksperyment tego nie wykrył (rysunek 3).
- Średnia częstotliwość ukrywa rozkład. Średnio 10 wyświetleń to dla jednych 2, dla innych 50.
- Ekstrapolacja. Krzywa i limit dotyczą tej kreacji, tego kanału i tej grupy odbiorców.
Najczęstsze pytania
Ile razy pokazać reklamę jednej osobie?
Nie ma jednej liczby – zależy od kreacji, marki, kanału i kosztu wyświetlenia, dlatego limit najlepiej wyznaczyć w eksperymencie z kilkoma losowo przydzielonymi limitami. W przykładzie serwisu VOD limit 4 reklam tygodniowo dał więcej zakupów niż 2, a limit 8 nie dał więcej niż 4. W metaanalizie Schmidt i Eisend (2015) postawa wobec reklamy była najlepsza przy ok. 10 ekspozycjach.
Dlaczego krzywa częstotliwości z danych kampanii jest zawyżona?
Bo liczba wyświetleń nie jest losowa: najwięcej reklam widzą osoby aktywne w sieci, a one i tak kupują częściej. W przykładzie najbardziej aktywna trzecia część osób widziała średnio 18.7 reklamy i kupowała w 6.66%, a najmniej aktywna – 3.6 reklamy i 1.01%. GAM bez kontroli aktywności zawyżył przyrost zakupów od 0 do 15 wyświetleń ponad dwukrotnie i nie pokazał zmęczenia.
Jak w R narysować krzywą odpowiedzi na liczbę wyświetleń?
Dopasuj model GAM pakietem mgcv: gam(zakup ~ s(wyswietlenia), family = binomial, method = "REML"), dodaj zmienne kontrolne, a potem ustaw wszystkim osobom tę samą liczbę wyświetleń i uśrednij przewidywania. Przedziały ufności uzyskasz z losowań współczynników (rmvn). Pamiętaj, że to nadal opis zależności, a nie efekt przyczynowy.
Jak zaplanować eksperyment z limitem wyświetleń?
Przydziel osoby losowo do 2–4 limitów tygodniowych, porównaj odsetek zakupów i zysk na osobę według przydziału (ITT) i zaplanuj liczebność z góry. W przykładzie 30 000 osób w grupie wystarczyło, by wykryć różnicę 0.7 pp między limitem 2 i 4, ale nie prawdziwy spadek o 0.16 pp przy limicie 8.
Czy liczy się czas od ostatniego kontaktu z reklamą?
Tak – efekt reklamy zanika, więc ta sama liczba reklam działa słabiej, gdy padnie w jednym dniu. W symulowanym mechanizmie 8 reklam w pierwszym dniu dawało 2.91% zakupów, a 8 reklam co 3–4 dni – 3.77%. Sahni i in. (2019) pokazali w eksperymencie, że efekt reklamy był największy zaraz po kontakcie.
Powiązane hasła
Przeczytaj też
Nieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →PoradnikMarketing mix modeling (MMM)
Producent soków, 156 tygodni i dwa kanały reklamy: adstock, nasycenie, rozkład sprzedaży, ROI z bootstrapem blokowym i pułapki – sześć rysunków z kodem R.
Czytaj →PoradnikTest wyłączenia reklamy (holdout)
Sklep z odzieżą: przyrost sprzedaży z holdoutu, ITT i CACE, iCPA wobec CPA z panelu, duże zamówienia i wielkość holdoutu – kod R.
Czytaj →PoradnikZasięg i częstotliwość kampanii
Herbatniki w TV i internecie: zasięg, GRP, rozkład beta-dwumianowy zamiast Poissona, prognoza przy większym budżecie i łączenie kanałów – z kodem R.
Czytaj →PoradnikIle powiadomień push wysyłać
Aplikacja do nauki języków i 4 dawki powiadomień: krzywe dawka–odpowiedź, kliknięcia, wypisy, zmęczenie i optimum z bootstrapu – z kodem R.
Czytaj →Analizujesz skuteczność reklamy w pracy dyplomowej?
Pomożemy zaplanować eksperyment z limitem wyświetleń, dopasować krzywą odpowiedzi w GAM, policzyć zysk z niepewnością i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Campbell, M. C., & Keller, K. L. (2003). Brand familiarity and advertising repetition effects. Journal of Consumer Research, 30(2), 292–304. https://doi.org/10.1086/376800
- Gordon, B. R., Zettelmeyer, F., Bhargava, N., & Chapsky, D. (2019). A comparison of approaches to advertising measurement: Evidence from big field experiments at Facebook. Marketing Science, 38(2), 193–225. https://doi.org/10.1287/mksc.2018.1135
- Sahni, N. S., Narayanan, S., & Kalyanam, K. (2019). An experimental investigation of the effects of retargeted advertising: The role of frequency and timing. Journal of Marketing Research, 56(3), 401–418. https://doi.org/10.1177/0022243718813987 ● Otwarty dostęp: pełny tekst
- Schmidt, S., & Eisend, M. (2015). Advertising repetition: A meta-analysis on effective frequency in advertising. Journal of Advertising, 44(4), 415–428. https://doi.org/10.1080/00913367.2015.1018460
- Wood, S. N. (2011). Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 73(1), 3–36. https://doi.org/10.1111/j.1467-9868.2010.00749.x ● Otwarty dostęp
Cytowania BibTeX
@article{campbell2003brand, author={Campbell, Margaret C. and Keller, Kevin Lane}, title={{Brand familiarity and advertising repetition effects}}, journal={Journal of Consumer Research}, year={2003}, volume={30}, number={2}, pages={292--304}, doi={10.1086/376800}}@article{gordon2019comparison, author={Gordon, Brett R. and Zettelmeyer, Florian and Bhargava, Neha and Chapsky, Dan}, title={{A comparison of approaches to advertising measurement: Evidence from big field experiments at Facebook}}, journal={Marketing Science}, year={2019}, volume={38}, number={2}, pages={193--225}, doi={10.1287/mksc.2018.1135}}@article{sahni2019experimental, author={Sahni, Navdeep S. and Narayanan, Sridhar and Kalyanam, Kirthi}, title={{An experimental investigation of the effects of retargeted advertising: The role of frequency and timing}}, journal={Journal of Marketing Research}, year={2019}, volume={56}, number={3}, pages={401--418}, doi={10.1177/0022243718813987}}@article{schmidt2015advertising, author={Schmidt, Susanne and Eisend, Martin}, title={{Advertising repetition: A meta-analysis on effective frequency in advertising}}, journal={Journal of Advertising}, year={2015}, volume={44}, number={4}, pages={415--428}, doi={10.1080/00913367.2015.1018460}}@article{wood2011fast, author={Wood, Simon N.}, title={{Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models}}, journal={Journal of the Royal Statistical Society: Series B (Statistical Methodology)}, year={2011}, volume={73}, number={1}, pages={3--36}, doi={10.1111/j.1467-9868.2010.00749.x}}