Przykład: 16 000 użytkowników i cztery dawki
Fikcyjna aplikacja do nauki języków obcych wysyła powiadomienia push („Czas na 5 minut hiszpańskiego”). Zespół marketingu chce wiedzieć, ile ich wysyłać. Za mało – użytkownik zapomina o nauce. Za dużo – wyłącza powiadomienia albo usuwa aplikację, a wtedy kontaktu z nim już nie ma. Pytanie biznesowe: przy ilu powiadomieniach tygodniowo aplikacja zyskuje najwięcej, licząc także straty?
Zespół zrobił eksperyment z dawkami: 16 000 użytkowników wylosowano po równo (4000 osób) do 1, 3, 5 albo 7 powiadomień tygodniowo na 4 tygodnie. To test A/B z czterema wariantami, ale warianty leżą na jednej osi, więc pytamy o kształt zależności dawka–odpowiedź, a nie tylko o zwycięzcę (porównania wariantów bez takiej osi omawia wpis o teście A/B z wieloma wariantami). Mierzymy cztery rzeczy: dni z lekcją (0–28), kliknięcia w powiadomienia, wypis z powiadomień i odinstalowanie aplikacji. 5629 osób (35.2%) to nowi użytkownicy, z kontem młodszym niż 30 dni.
Dane są fikcyjne i znamy prawdę. Symulowaliśmy każdy dzień każdej osoby. Ręcznie ustaliliśmy: skłonność do nauki bez powiadomień (niższą u nowych), naturalny spadek aktywności z tygodniami, siłę powiadomienia (większą u nowych), która słabnie z każdym otrzymanym powiadomieniem (zmęczenie), szansę kliknięcia, wypisu po każdym powiadomieniu (rosnącą z częstością) i odinstalowania. Po wypisie powiadomienia przestają przychodzić, po odinstalowaniu znika też aktywność. Wartości podajemy przy kodzie. Parametrów danych i ziarna 721 nie zmienialiśmy po pierwszym uruchomieniu. Dane pobierzesz jako push-nauka-jezykow-16000-uzytkownikow.csv.
Rysunek 1: karta „4 dawki”
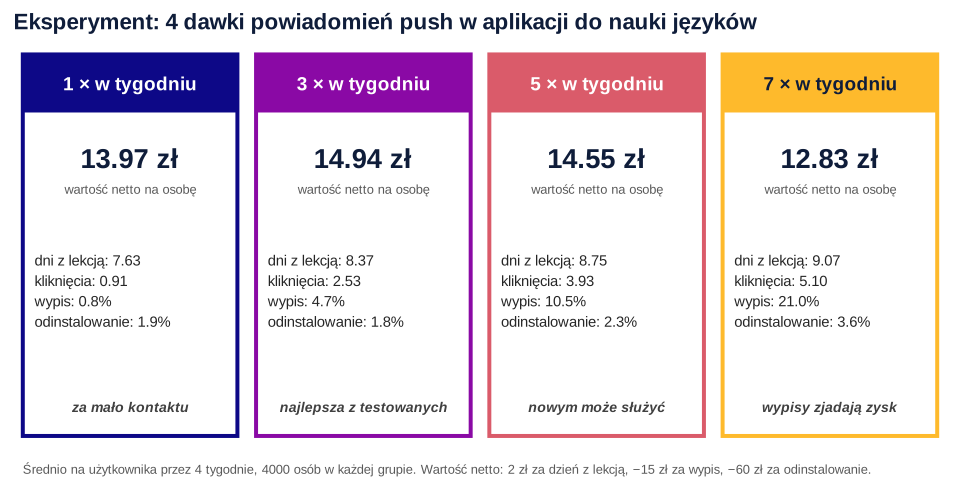
Co widać. Każda kolejna dawka daje więcej dni z lekcją (od 7.63 do 9.07) i dużo więcej kliknięć (od 0.91 do 5.10), ale też więcej wypisów: od 0.8% przy 1 powiadomieniu do 21.0% przy 7. Wartość netto (opis w rysunku 6) jest najwyższa przy 3 powiadomieniach.
Jak może zmylić. Karta pokazuje tylko testowane dawki i średnie z 4 tygodni. Nie pokazuje przedziałów ufności, różnic między grupami użytkowników ani tego, że wypis działa także po zakończeniu testu.
Podpis do pracy:
Rysunek 2: cztery krzywe dawka–odpowiedź
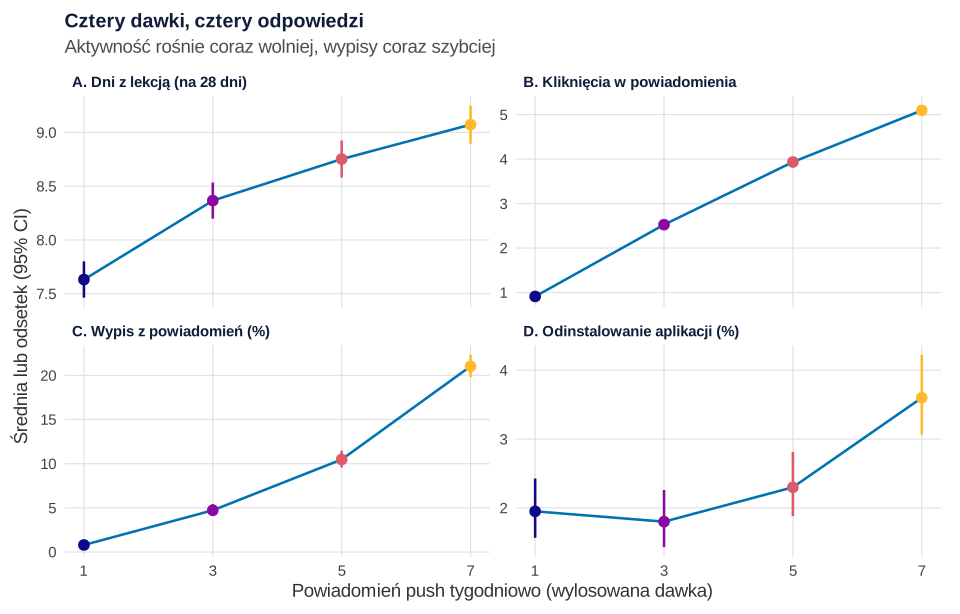
set.seed(721)).Co widać. Liczymy według przydziału (analiza ITT): osoba, która się wypisała, zostaje w swojej grupie. Dni z lekcją różnią się między dawkami (F(3, 15996) = 50.08, p < .001). Względem 1 powiadomienia tygodniowo 3 powiadomienia dają 0.73 dnia więcej, 95% CI [0.49, 0.98], 5 – 1.12 [0.88, 1.36], a 7 – 1.44 [1.20, 1.68]. Każde kolejne dwa powiadomienia dodają mniej. Wypisy rosną odwrotnie: coraz szybciej. Przy 7 powiadomieniach wypisało się o 20.22 pp więcej osób niż przy 1, a odinstalowało o 1.65 pp więcej.
Jak może zmylić. Panele mają różne skale; wspólną miarę dają dopiero złotówki (rysunek 6).
Zdanie do Wyników:
Rysunek 3: prosta, logarytm czy splajn
Cztery dawki to cztery punkty. Między nimi (2, 4, 6 powiadomień) krzywą „dopowiada” model. Porównaliśmy model liniowy w dawce, model z logarytmem dawki i splajn z modelu GAM (procedurę opisuje wpis o splajnach i GAM). Dni z lekcją modelujemy jako liczbę dni z 28 (model quasi-dwumianowy). Każdy model porównujemy z modelem, który ma osobną średnią dla każdej dawki: jeśli prosty model od niego odbiega, kształt jest zły. Splajny dla zależności dawka–odpowiedź opisują Desquilbet i Mariotti (2010).
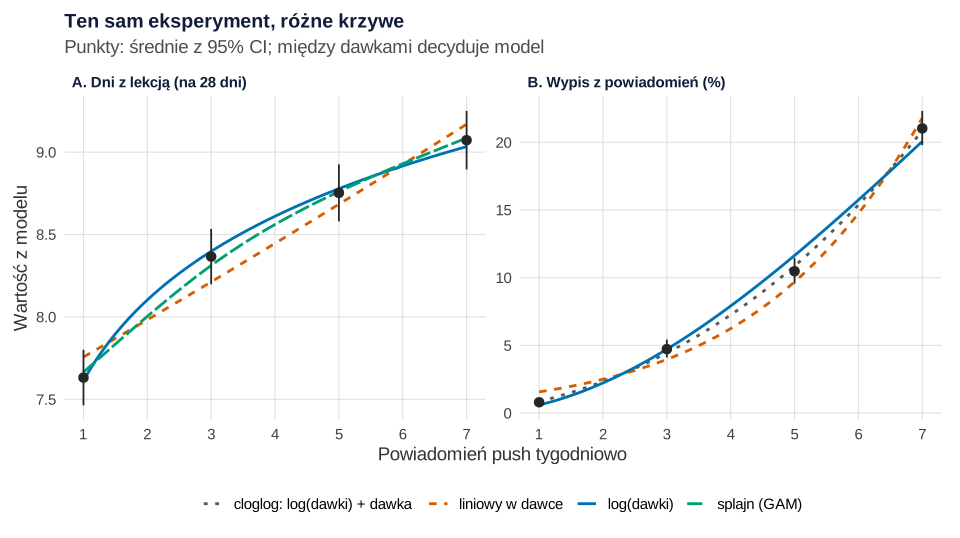
Co widać. Dla dni z lekcją prosta odbiega od średnich (F = 3.50, p = .030), a model z log(dawki) nie (F = 0.23, p = .797). Splajn ma edf = 2.11, czyli lekko wygiętą krzywą, bardzo bliską logarytmowi. Przy 4 powiadomieniach prosta przewiduje 8.45 dnia, a logarytm 8.61. Dla wypisów nie wystarcza ani logit liniowy (OR = 1.61 [1.56, 1.66] na każde powiadomienie tygodniowo; p < .001 dla odchylenia od średnich), ani logit z log(dawki) (p = .006). Dobrze pasuje model z łącznikiem cloglog (p = .208), który opisuje ryzyko łączne: każde powiadomienie to kolejna okazja do wypisu. Współczynnik przy log(dawki) wynosi 1.26, a dodatni współczynnik przy dawce (0.14, p = .015) mówi, że pojedyncze powiadomienie jest groźniejsze, gdy przychodzą częściej.
Jak może zmylić. Przy czterech dawkach splajn nie ma skąd wziąć szczegółów: dopuszczalna liczba węzłów jest mała, a test zgodności ma tylko 2 stopnie swobody. Wszystkie krzywe zgadzają się w punktach, a różnią między nimi. Poza zakresem (np. 10 powiadomień) żaden model nic nie wie. Model cloglog wybraliśmy po pierwszym uruchomieniu, bo wcześniej użyty logit kwadratowy odbiegał od średnich; w pracy opisz taki wybór jako decyzję po obejrzeniu danych.
Zdanie do Wyników:
Rysunek 4: kliknięcia to nie dodatkowe lekcje
Raport z narzędzia do wysyłki pokazuje kliknięcia. Kusi, by liczyć je jako efekt. Liczbę kliknięć modelujemy regresją ujemną dwumianową z offsetem log(liczby otrzymanych powiadomień), więc wynik to kliknięcia na jedno powiadomienie (szerzej o modelach zliczeń w regresji dla zliczeń).
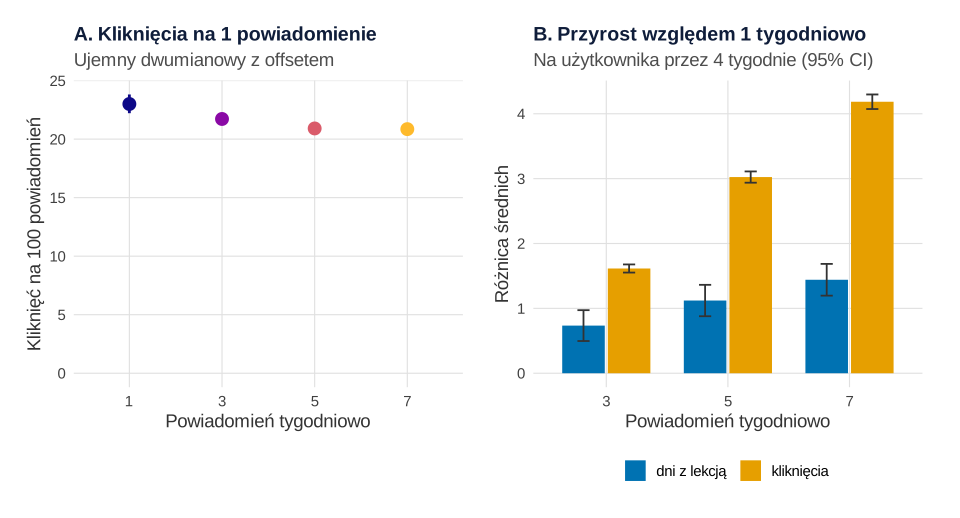
Co widać. Odsetek kliknięć na powiadomienie spada łagodnie: z 23.0 do 20.9 na 100 powiadomień. Liczba kliknięć rośnie więc prawie proporcjonalnie do dawki: 7 powiadomień daje 4.18 kliknięcia więcej niż 1, ale tylko 1.44 dnia z lekcją więcej. Na jedno dodatkowe kliknięcie przypada 0.34 dodatkowego dnia nauki.
Jak może zmylić. Wiele osób klika w powiadomienie w dniu, w którym i tak usiadłaby do lekcji. Powiadomienie staje się wtedy tylko drogą wejścia. Dane są fikcyjne, więc to wiemy: 66.6% wszystkich kliknięć przypadło na dni z lekcją, która odbyłaby się bez powiadomienia (60.9% przy 1 powiadomieniu, 68.8% przy 7). W prawdziwych danych tego nie widać. Efekt dodatkowy pokazuje tylko porównanie losowych grup, zgodnie z modelem potencjalnych wyników. W badaniu mikrorandomizowanym aplikacji prozdrowotnej wysłanie powiadomienia zwiększało szansę skorzystania z aplikacji w ciągu doby tylko o 3.9% (Bidargaddi i in., 2018).
Rysunek 5: zmęczenie w czasie i dwie grupy użytkowników
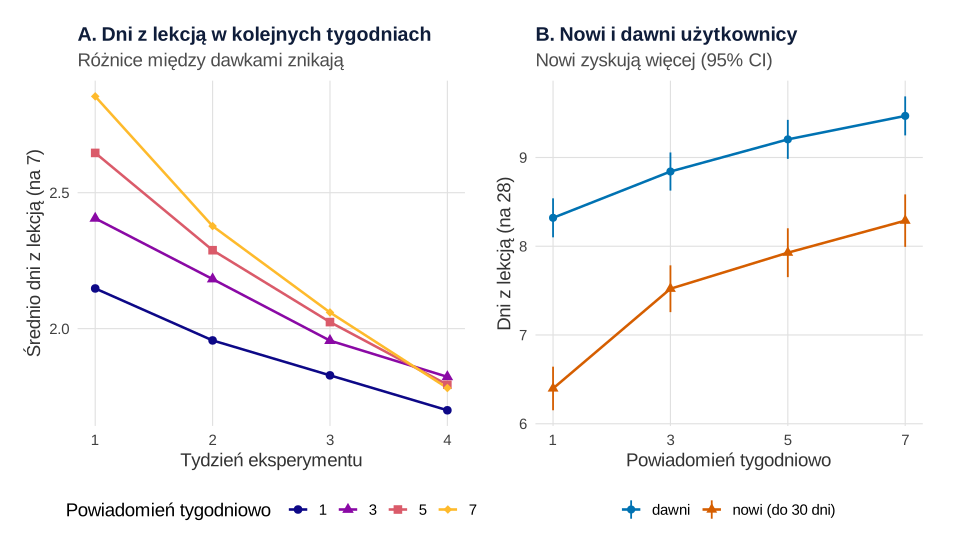
Co widać. W 1. tygodniu 7 powiadomień daje 0.71 dnia z lekcją więcej niż 1 powiadomienie, 95% CI [0.63, 0.79]. W 4. tygodniu już tylko 0.08 [0.01, 0.15]. Porównaliśmy zmianę „tydzień 4 minus tydzień 1” u każdej osoby: przy 7 powiadomieniach spadek jest o 0.62 dnia większy niż przy 1, [−0.70, −0.55], p < .001. To nie tylko skutek wypisów: w 4. tygodniu powiadomienia nadal dostawało 81.3% osób z tej grupy. Działa zmęczenie: kolejne powiadomienia przestają działać. Podobny spadek reakcji z czasem opisali Freyne i in. (2017) w aplikacji dietetycznej. Panel B pokazuje interakcję dawki ze stażem. U nowych użytkowników 7 powiadomień daje 1.89 dnia więcej niż 1, u dawnych 1.15. W modelu z log(dawki) interakcja wynosi 0.38 dnia na jednostkę log(dawki), p = .002.
Jak może zmylić. Test trwał 4 tygodnie, a efekt wciąż malał. Wynik z 1. tygodnia (0.71 dnia) przeszacowałby korzyść prawie dwukrotnie: średnio przez 4 tygodnie było to 1.44 / 4 = 0.36 dnia tygodniowo. Podział na nowych i dawnych zaplanowano przed testem. Gdybyś szukał(a) podgrup po fakcie, licz się z problemem wielokrotnych porównań.
Zdanie do Wyników:
Rysunek 6: wartość netto i optymalna dawka z niepewnością
Żeby zważyć lekcje i wypisy, potrzebna jest wspólna miara. Przyjęliśmy ręcznie, przed policzeniem: dzień z lekcją = 2 zł (wpływ na odnowienie abonamentu), wypis = −15 zł (utracona możliwość kontaktu na kolejne miesiące) i odinstalowanie = −60 zł. Wypis jest trwały: do osoby, która go wybrała, nie wyślesz już nic, także po teście. Dlatego jego koszt to wartość przyszłych kontaktów, jak w wartości klienta (CLV). Podobny rachunek dla e-maili pokazał, że liczba wysyłek wpływa na zysk nieliniowo i że za mało i za dużo wiadomości kosztuje (Zhang i in., 2017).
Krzywą netto składamy z trzech modeli: dni z lekcją z log(dawki), wypis z modelu cloglog i odinstalowanie z logitu kwadratowego (zgodnego ze średnimi, p = .808). Szukamy dawki z najwyższą wartością na siatce 1–7 co 0.1. Niepewność oceniamy bootstrapem (Efron i Tibshirani, 1993): 1000 razy losujemy użytkowników ze zwracaniem w obrębie każdej grupy dawki i stażu, dopasowujemy modele od nowa i zapisujemy optimum.
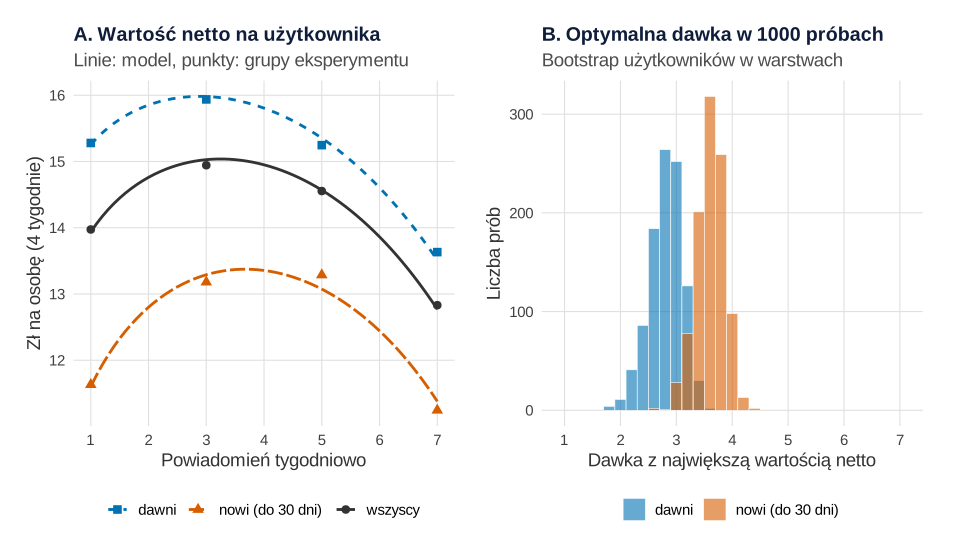
set.seed(7211)).Co widać. W grupach netto wynosi 13.97 zł (1 powiadomienie), 14.94 zł (3), 14.55 zł (5) i 12.83 zł (7). Model wskazuje optimum 3.2 powiadomienia tygodniowo, 95% przedział percentylowy [2.8, 3.6]. Spośród testowanych dawek 3 wygrywa w 87.0% prób bootstrapowych, a 5 w 13.0%. U nowych użytkowników optimum wynosi 3.7 [3.1, 4.1], a dawka 5 wygrywa w 57.6% prób. U dawnych optimum to 2.9 [2.2, 3.4].
Jak może zmylić. Przedział dotyczy losowości próby, nie założeń. Gdy wypis kosztuje 5 zł zamiast 15, optimum przesuwa się do 4.4. Przy 30 zł spada do 2.4. Zmiana kształtu krzywej lekcji (prosta zamiast logarytmu) daje 3.3, więc tu decydują złotówki, nie model. Podawaj wynik dla kilku wartości kosztu i powiedz wprost, skąd je wziąłeś (wziętaś).
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Ustaw domyślnie 3 powiadomienia tygodniowo. Siedem daje najwięcej lekcji w 1. tygodniu, ale po 4 tygodniach przewaga prawie znika, a co piąta osoba wyłącza powiadomienia.
- Nowym użytkownikom wysyłaj więcej przez pierwsze tygodnie (3–5), potem schodź niżej. Sprawdź to osobnym testem – zmiana dawki w czasie to inna interwencja niż stała dawka. Schematy, w których osoba jest losowana wiele razy, opisują Klasnja i in. (2015).
- Raportuj dni z lekcją i wypisy, nie kliknięcia. Wypisy i odinstalowania traktuj jako metryki ochronne z ustalonym przed testem dopuszczalnym pogorszeniem (Kohavi i in., 2020).
- Zostaw grupę z niską dawką na dłużej. Efekt maleje z tygodniami, więc decyzję po 4 tygodniach sprawdź na długoterminowym holdoucie.
- Policz koszt wypisu z danych. Złotówki z tego wpisu to założenia. Weź swoje: ile lekcji i odnowień tracisz po wypisie (np. z analizy przeżycia odejść).
Częstotliwość reklam w kampanii pozyskania, z limitem wyświetleń i odstępem między kontaktami, omawiamy osobno we wpisie o częstotliwości kontaktu z reklamą. Inne tematy na pracę zbiera wpis statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie opisz losowanie, dawki, czas trwania, miary, modele i założone wartości. W Wynikach podaj różnice z przedziałami, testy kształtu krzywej, interakcję i optimum z przedziałem bootstrapowym. W Dyskusji: krótki test, model między dawkami i złotówki przyjęte z założenia.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane u, macierze dzień po dniu, paletę i motyw, przepis 2 – funkcję sr_ci() i tabelę krzywe, przepis 6 – obiekt punkt potrzebny karcie. Przepisy z rysunkami kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki) – dane, geometrie i skale są identyczne.
Losują dwa bloki, każdy z własnym ziarnem: 721 (dane, przepis 1) i 7211 (1000 prób bootstrapowych, przepis 6). Ziaren nie dobieraliśmy pod wynik. Ręcznie ustalono (przepis 1): 16 000 użytkowników, 35% nowych, dni z powiadomieniem (1: poniedziałek; 3: poniedziałek, środa, piątek; 5: dni robocze; 7: codziennie), skłonność do nauki bez powiadomień (logit ze średnią −0.95 u dawnych i −1.45 u nowych, SD 1.0), spadek o 0.12 logitu na tydzień, siłę powiadomienia (0.60 u dawnych i 1.10 u nowych) malejącą wykładniczo ze stałą 22 otrzymanych powiadomień, szansę kliknięcia (55% przy lekcji, 3% bez niej), ryzyko wypisu po powiadomieniu (logit −6.2 + 0.22 · dawka − 0.3 dla nowych) oraz dzienne ryzyko odinstalowania (logit −7.2, w dniu z powiadomieniem −8.1 + 0.20 · dawka). Ręcznie przyjęto też wartości w złotych (2, −15 i −60 zł; przepis 6), siatkę dawek co 0.1 i liczbę prób bootstrapowych (1000). Parametrów danych nie zmienialiśmy po pierwszym uruchomieniu. Po pierwszym uruchomieniu zmieniliśmy dwie rzeczy w analizie i rysunkach: model wypisów w przepisach 3 i 6 (logit kwadratowy odbiegał od czterech średnich, więc zastąpił go model cloglog) oraz paletę dawek (viridis → plasma, bo dwie pierwsze dawki zlewały się przy deuteranopii). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w około 40 sekund.
1. Dane: 16 000 użytkowników i 28 dni
R
# Przepis 1. Fikcyjna aplikacja do nauki języków: 16 000 użytkowników losowo przydzielonych do 1, 3, 5 lub 7
# powiadomień push tygodniowo przez 4 tygodnie (28 dni). Symulacja dzień po dniu.
library(ggplot2); library(patchwork)

# Paleta: 4 dawki w kolejności (plasma z viridisLite, czytelna przy deuteranopii) i kolory pomocnicze Okabe–Ito
kol_dawki <- setNames(viridisLite::plasma(4, end = 0.85), c("1", "3", "5", "7"))
kol <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", zielony = "#009E73",
         blekit = "#56B4E9", szary = "grey55", ciemny = "grey20")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

apa_p <- function(p) ifelse(p < .001, "p < .001", sub("0\\.", ".", sprintf("p = %.3f", p)))   # zapis p w stylu APA

# Ręczne parametry (opisane na stronie)
n <- 16000; dni <- 28
dni_push <- list(`1` = 1, `3` = c(1, 3, 5), `5` = 1:5, `7` = 1:7)    # dni tygodnia z powiadomieniem
set.seed(721)                                         # ziarno ustalone raz, bez dobierania pod wynik
u <- data.frame(id = sprintf("U%05d", 1:n),
                dawka = rep(c(1, 3, 5, 7), each = n / 4)[sample(n)],    # losowy przydział, po 4000 osób
                nowy = rbinom(n, 1, 0.35))                             # 1 = konto założone w ostatnich 30 dniach
u$a <- rnorm(n, ifelse(u$nowy == 1, -1.45, -0.95), 1.0)                # skłonność do nauki bez powiadomień (logit)
lift <- ifelse(u$nowy == 1, 1.10, 0.60)                                # ile powiadomienie podnosi szansę lekcji (logit)
tau <- 22                                                              # zmęczenie: efekt maleje z liczbą otrzymanych powiadomień

harmonogram <- t(sapply(as.character(u$dawka), function(d) 1:7 %in% dni_push[[d]]))   # użytkownik × dzień tygodnia
L <- O <- K <- P <- matrix(0L, n, dni)               # lekcja, lekcja „i tak”, kliknięcie, otrzymane powiadomienie
wypis <- odinst <- rep(0L, n); dzien_wypisu <- dzien_odinst <- rep(NA_integer_, n)
otrzymane <- rep(0, n)
for (t in 1:dni) {
  tydz <- (t - 1) %/% 7 + 1; dzien_tyg <- (t - 1) %% 7 + 1
  aktywny <- odinst == 0
  push <- aktywny & wypis == 0 & harmonogram[, dzien_tyg]
  p0 <- plogis(u$a - 0.12 * (tydz - 1))             # naturalny spadek aktywności z tygodniami
  o <- aktywny & runif(n) < p0                        # lekcja, która odbyłaby się i bez powiadomienia
  p1 <- plogis(u$a - 0.12 * (tydz - 1) + lift * exp(-otrzymane / tau))
  dodatkowa <- push & !o & runif(n) < (p1 - p0) / (1 - p0)              # lekcja wywołana powiadomieniem
  l <- o | dodatkowa
  k <- push & ((l & runif(n) < 0.55) | (!l & runif(n) < 0.03))          # kliknięcie w powiadomienie
  L[, t] <- l; O[, t] <- o; K[, t] <- k; P[, t] <- push
  # wypis z powiadomień (po powiadomieniu) i odinstalowanie (codziennie; częściej w dniu z powiadomieniem)
  nowy_wypis <- push & runif(n) < plogis(-6.2 + 0.22 * u$dawka - 0.3 * u$nowy)
  nowe_odinst <- aktywny & runif(n) < plogis(-7.2 + push * (-0.9 + 0.20 * u$dawka))
  dzien_wypisu[nowy_wypis & wypis == 0] <- t; wypis[nowy_wypis] <- 1L
  dzien_odinst[nowe_odinst] <- t; odinst[nowe_odinst] <- 1L
  otrzymane <- otrzymane + push
}
u$lekcje <- rowSums(L); u$lekcje_i_tak <- rowSums(O & L); u$klikniecia <- rowSums(K)
u$powiadomienia <- rowSums(P); u$wypis <- wypis; u$odinstalowanie <- odinst
for (w in 1:4) u[[paste0("lekcje_t", w)]] <- rowSums(L[, (7 * w - 6):(7 * w)])
u$klik_i_tak <- rowSums(K & O)                        # kliknięcia w dniu, w którym lekcja i tak by się odbyła
write.csv(u[, c("id", "dawka", "nowy", "powiadomienia", "klikniecia", "lekcje", paste0("lekcje_t", 1:4),
                "wypis", "odinstalowanie")], "push-nauka-jezykow-16000-uzytkownikow.csv", row.names = FALSE)

cat("Użytkowników:", n, "| nowych:", sum(u$nowy), sprintf("(%.1f%%)", 100 * mean(u$nowy)), "\n")
tab <- do.call(rbind, lapply(split(u, u$dawka), function(d) data.frame(
  dawka = d$dawka[1], osob = nrow(d), powiadomien = round(mean(d$powiadomienia), 2),
  dni_z_lekcja = round(mean(d$lekcje), 2), klikniec = round(mean(d$klikniecia), 2),
  wypis_proc = round(100 * mean(d$wypis), 2), odinst_proc = round(100 * mean(d$odinstalowanie), 2))))
print(tab, row.names = FALSE)
cat(sprintf("Kliknięcia w dniu, w którym lekcja i tak by się odbyła: %.1f%% wszystkich kliknięć\n",
            100 * sum(u$klik_i_tak) / sum(u$klikniecia)))
Wynik w R
Użytkowników: 16000 | nowych: 5629 (35.2%)
 dawka osob powiadomien dni_z_lekcja klikniec wypis_proc odinst_proc
     1 4000        3.96         7.63     0.91       0.80        1.95
     3 4000       11.63         8.37     2.53       4.72        1.80
     5 4000       18.82         8.75     3.93      10.47        2.30
     7 4000       24.54         9.07     5.10      21.02        3.60
Kliknięcia w dniu, w którym lekcja i tak by się odbyła: 66.6% wszystkich kliknięć
2. Krzywe dawka–odpowiedź: Rysunek 2
R
# Przepis 2. Krzywe dawka–odpowiedź z eksperymentu: dni z lekcją, kliknięcia, wypisy i odinstalowania (Rysunek 2)
# Analiza według przydziału (ITT): każdy użytkownik liczy się w grupie, do której go wylosowano.
sr_ci <- function(x) { m <- mean(x); s <- sd(x) / sqrt(length(x)); c(m = m, d = m - 1.96 * s, g = m + 1.96 * s) }
odsetek_ci <- function(x) { pt <- prop.test(sum(x), length(x), correct = FALSE); 100 * c(m = mean(x), d = pt$conf.int[1], g = pt$conf.int[2]) }
miary <- list(`A. Dni z lekcją (na 28 dni)` = function(d) sr_ci(d$lekcje),
              `B. Kliknięcia w powiadomienia` = function(d) sr_ci(d$klikniecia),
              `C. Wypis z powiadomień (%)` = function(d) odsetek_ci(d$wypis),
              `D. Odinstalowanie aplikacji (%)` = function(d) odsetek_ci(d$odinstalowanie))
krzywe <- do.call(rbind, lapply(names(miary), function(m) do.call(rbind, lapply(split(u, u$dawka), function(d)
  data.frame(miara = m, dawka = d$dawka[1], t(miary[[m]](d)))))))
krzywe$miara <- factor(krzywe$miara, names(miary))
print(transform(krzywe, m = round(m, 2), d = round(d, 2), g = round(g, 2)), row.names = FALSE)

# Różnice względem 1 powiadomienia tygodniowo (dni z lekcją) i test globalny
m_czynnik <- lm(lekcje ~ factor(dawka), data = u)
cat("Test globalny różnic w dniach z lekcją: F =", round(anova(m_czynnik)$`F value`[1], 2),
    "|", apa_p(anova(m_czynnik)$`Pr(>F)`[1]), "\n")
print(round(cbind(roznica = coef(m_czynnik)[-1], confint(m_czynnik)[-1, ]), 2))
cat(sprintf("Wypis: 7 vs 1 tygodniowo: %.2f pp więcej; odinstalowanie: %.2f pp więcej\n",
            100 * (mean(u$wypis[u$dawka == 7]) - mean(u$wypis[u$dawka == 1])),
            100 * (mean(u$odinstalowanie[u$dawka == 7]) - mean(u$odinstalowanie[u$dawka == 1]))))

p2 <- ggplot(krzywe, aes(dawka, m)) +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.9) +
  geom_pointrange(aes(ymin = d, ymax = g, colour = factor(dawka)), size = 0.6, linewidth = 0.9, show.legend = FALSE) +
  scale_colour_manual(values = kol_dawki) +
  scale_x_continuous(breaks = c(1, 3, 5, 7)) +
  facet_wrap(~ miara, scales = "free_y", ncol = 2) +
  labs(x = "Powiadomień push tygodniowo (wylosowana dawka)", y = "Średnia lub odsetek (95% CI)",
       title = "Cztery dawki, cztery odpowiedzi", subtitle = "Aktywność rośnie coraz wolniej, wypisy coraz szybciej") +
  motyw + theme(strip.text = element_text(face = "bold", hjust = 0))
p2   # zapis: ggsave("push-krzywe-dawka-odpowiedz.svg", p2, width = 10, height = 6.4)
Wynik w R
                           miara dawka     m     d     g
     A. Dni z lekcją (na 28 dni)     1  7.63  7.46  7.80
     A. Dni z lekcją (na 28 dni)     3  8.37  8.20  8.53
     A. Dni z lekcją (na 28 dni)     5  8.75  8.58  8.93
     A. Dni z lekcją (na 28 dni)     7  9.07  8.90  9.25
   B. Kliknięcia w powiadomienia     1  0.91  0.88  0.94
   B. Kliknięcia w powiadomienia     3  2.53  2.47  2.58
   B. Kliknięcia w powiadomienia     5  3.93  3.85  4.02
   B. Kliknięcia w powiadomienia     7  5.10  4.99  5.20
      C. Wypis z powiadomień (%)     1  0.80  0.57  1.13
      C. Wypis z powiadomień (%)     3  4.72  4.11  5.43
      C. Wypis z powiadomień (%)     5 10.47  9.56 11.46
      C. Wypis z powiadomień (%)     7 21.02 19.79 22.32
 D. Odinstalowanie aplikacji (%)     1  1.95  1.57  2.43
 D. Odinstalowanie aplikacji (%)     3  1.80  1.43  2.26
 D. Odinstalowanie aplikacji (%)     5  2.30  1.88  2.81
 D. Odinstalowanie aplikacji (%)     7  3.60  3.07  4.22
Test globalny różnic w dniach z lekcją: F = 50.08 | p < .001
               roznica 2.5 % 97.5 %
factor(dawka)3    0.73  0.49   0.98
factor(dawka)5    1.12  0.88   1.36
factor(dawka)7    1.44  1.20   1.68
Wypis: 7 vs 1 tygodniowo: 20.22 pp więcej; odinstalowanie: 1.65 pp więcej
3. Kształt krzywej: prosta, logarytm, splajn i cloglog: Rysunek 3
R
# Przepis 3. Jaki kształt ma krzywa? Model liniowy w dawce, model z log(dawki), splajn (GAM) i model z dawką jako czynnikiem
library(mgcv)
u$dni_bez <- dni - u$lekcje
modele <- list(`liniowy w dawce` = glm(cbind(lekcje, dni_bez) ~ dawka, quasibinomial, data = u),
               `log(dawki)` = glm(cbind(lekcje, dni_bez) ~ log(dawka), quasibinomial, data = u),
               `czynnik (4 średnie)` = glm(cbind(lekcje, dni_bez) ~ factor(dawka), quasibinomial, data = u))
m_gam <- gam(cbind(lekcje, dni_bez) ~ s(dawka, k = 4), family = quasibinomial, data = u, method = "REML")
cat("Brak dopasowania względem modelu z czynnikiem (test F):\n")
for (m in c("liniowy w dawce", "log(dawki)")) {
  a <- anova(modele[[m]], modele[["czynnik (4 średnie)"]], test = "F")
  cat(sprintf("  %-16s F = %.2f, %s\n", m, a$F[2], apa_p(a$`Pr(>F)`[2])))
}
cat(sprintf("Splajn (GAM, k = 4): edf = %.2f\n", summary(m_gam)$s.table[1, "edf"]))
siatka <- data.frame(dawka = seq(1, 7, by = 0.1))
for (m in names(modele)[1:2]) siatka[[m]] <- dni * predict(modele[[m]], siatka, type = "response")
siatka$splajn <- dni * as.numeric(predict(m_gam, siatka, type = "response"))
print(round(siatka[siatka$dawka %in% 1:7, ], 2), row.names = FALSE)

# Wypisy: logit liniowy w dawce kontra czynnik (test ilorazu wiarygodności)
w_lin <- glm(wypis ~ dawka, binomial, data = u); w_log <- glm(wypis ~ log(dawka), binomial, data = u)
# Model „ryzyka łącznego”: każde powiadomienie to kolejna okazja do wypisu (łącznik cloglog, log liczby powiadomień
# i dawka – czy pojedyncze powiadomienie jest groźniejsze, gdy przychodzą częściej)
w_kw <- glm(wypis ~ log(dawka) + dawka, binomial(link = "cloglog"), data = u); w_fac <- glm(wypis ~ factor(dawka), binomial, data = u)
cat(sprintf("Wypis: OR na 1 powiadomienie tygodniowo = %.2f [%.2f, %.2f]\n",
            exp(coef(w_lin)[2]), exp(confint.default(w_lin)[2, 1]), exp(confint.default(w_lin)[2, 2])))
cat(sprintf("Wypis – brak dopasowania: liniowy %s | log(dawki) %s | cloglog %s\n",
            apa_p(anova(w_lin, w_fac, test = "LRT")$`Pr(>Chi)`[2]), apa_p(anova(w_log, w_fac, test = "LRT")$`Pr(>Chi)`[2]),
            apa_p(anova(w_kw, w_fac, test = "LRT")$`Pr(>Chi)`[2])))
print(round(summary(w_kw)$coef, 3))
siatka$wypis_lin <- 100 * predict(w_lin, siatka, type = "response")
siatka$wypis_log <- 100 * predict(w_log, siatka, type = "response")
siatka$wypis_kw <- 100 * predict(w_kw, siatka, type = "response")

dl <- rbind(data.frame(panel = "A. Dni z lekcją (na 28 dni)", dawka = siatka$dawka, model = "liniowy w dawce", y = siatka$`liniowy w dawce`),
            data.frame(panel = "A. Dni z lekcją (na 28 dni)", dawka = siatka$dawka, model = "log(dawki)", y = siatka$`log(dawki)`),
            data.frame(panel = "A. Dni z lekcją (na 28 dni)", dawka = siatka$dawka, model = "splajn (GAM)", y = siatka$splajn),
            data.frame(panel = "B. Wypis z powiadomień (%)", dawka = siatka$dawka, model = "liniowy w dawce", y = siatka$wypis_lin),
            data.frame(panel = "B. Wypis z powiadomień (%)", dawka = siatka$dawka, model = "log(dawki)", y = siatka$wypis_log),
            data.frame(panel = "B. Wypis z powiadomień (%)", dawka = siatka$dawka, model = "cloglog: log(dawki) + dawka", y = siatka$wypis_kw))
pkt <- subset(krzywe, miara %in% c("A. Dni z lekcją (na 28 dni)", "C. Wypis z powiadomień (%)"))
pkt$panel <- ifelse(pkt$miara == "C. Wypis z powiadomień (%)", "B. Wypis z powiadomień (%)", "A. Dni z lekcją (na 28 dni)")
p3 <- ggplot(dl, aes(dawka, y)) +
  geom_line(aes(colour = model, linetype = model), linewidth = 1) +
  geom_pointrange(data = pkt, aes(y = m, ymin = d, ymax = g), colour = "grey15", size = 0.5) +
  scale_colour_manual(values = c(`liniowy w dawce` = kol[["cynober"]], `log(dawki)` = kol[["niebieski"]],
                                 `splajn (GAM)` = kol[["zielony"]], `cloglog: log(dawki) + dawka` = "grey35"), name = NULL) +
  scale_linetype_manual(values = c(`liniowy w dawce` = "22", `log(dawki)` = "solid", `splajn (GAM)` = "41",
                                   `cloglog: log(dawki) + dawka` = "12"), name = NULL) +
  scale_x_continuous(breaks = 1:7) + facet_wrap(~ panel, scales = "free_y") +
  labs(x = "Powiadomień push tygodniowo", y = "Wartość z modelu",
       title = "Ten sam eksperyment, różne krzywe", subtitle = "Punkty: średnie z 95% CI; między dawkami decyduje model") +
  motyw + theme(strip.text = element_text(face = "bold", hjust = 0))
p3   # zapis: ggsave("push-modele-ksztalt-krzywej.svg", p3, width = 10, height = 5.6)
Wynik w R
Brak dopasowania względem modelu z czynnikiem (test F):
  liniowy w dawce  F = 3.50, p = .030
  log(dawki)       F = 0.23, p = .797
Splajn (GAM, k = 4): edf = 2.11
 dawka liniowy w dawce log(dawki) splajn
     1            7.76       7.61   7.67
     2            7.98       8.10   8.00
     3            8.21       8.40   8.31
     4            8.45       8.61   8.56
     5            8.68       8.78   8.76
     6            8.92       8.92   8.93
     7            9.17       9.03   9.09
Wypis: OR na 1 powiadomienie tygodniowo = 1.61 [1.56, 1.66]
Wypis – brak dopasowania: liniowy p < .001 | log(dawki) p = .006 | cloglog p = .208
            Estimate Std. Error z value Pr(>|z|)
(Intercept)   -4.903      0.130 -37.699    0.000
log(dawka)     1.257      0.243   5.173    0.000
dawka          0.143      0.059   2.424    0.015
4. Kliknięcia a dodatkowe lekcje: Rysunek 4
R
# Przepis 4. Kliknięcia to nie dodatkowa aktywność: odsetek kliknięć na powiadomienie (regresja ujemna dwumianowa
# z offsetem) i przyrost kliknięć kontra przyrost dni z lekcją względem 1 powiadomienia tygodniowo (Rysunek 4)
library(MASS)
uk <- subset(u, powiadomienia > 0)
m_nb <- glm.nb(klikniecia ~ factor(dawka) + offset(log(powiadomienia)), data = uk)
ctr <- data.frame(dawka = c(1, 3, 5, 7))
pr <- predict(m_nb, transform(ctr, powiadomienia = 1), type = "link", se.fit = TRUE)
ctr$proc <- 100 * exp(pr$fit); ctr$d <- 100 * exp(pr$fit - 1.96 * pr$se.fit); ctr$g <- 100 * exp(pr$fit + 1.96 * pr$se.fit)
cat(sprintf("Ujemny dwumianowy: theta = %.2f\n", m_nb$theta)); print(round(ctr, 2), row.names = FALSE)

# Przyrost względem dawki 1: kliknięcia i dni z lekcją (z 95% CI); prawda: lekcje wywołane powiadomieniem
przyrost <- do.call(rbind, lapply(c(3, 5, 7), function(k) {
  a <- u[u$dawka == k, ]; b <- u[u$dawka == 1, ]
  rbind(data.frame(dawka = k, miara = "kliknięcia", r = mean(a$klikniecia) - mean(b$klikniecia),
                   se = sqrt(var(a$klikniecia) / nrow(a) + var(b$klikniecia) / nrow(b))),
        data.frame(dawka = k, miara = "dni z lekcją", r = mean(a$lekcje) - mean(b$lekcje),
                   se = sqrt(var(a$lekcje) / nrow(a) + var(b$lekcje) / nrow(b))))
}))
przyrost$d <- przyrost$r - 1.96 * przyrost$se; przyrost$g <- przyrost$r + 1.96 * przyrost$se
print(transform(przyrost, r = round(r, 2), se = NULL, d = round(d, 2), g = round(g, 2)), row.names = FALSE)
cat(sprintf("Na 1 dodatkowe kliknięcie przypada %.2f dodatkowego dnia z lekcją (7 vs 1)\n",
            with(przyrost, r[dawka == 7 & miara == "dni z lekcją"] / r[dawka == 7 & miara == "kliknięcia"])))
# Wiemy, które lekcje odbyłyby się i bez powiadomienia (dane są fikcyjne)
for (k in c(1, 7)) cat(sprintf("Dawka %d: kliknięć w dniu lekcji, która i tak by się odbyła: %.1f%%\n", k,
                               100 * sum(u$klik_i_tak[u$dawka == k]) / sum(u$klikniecia[u$dawka == k])))

p4a <- ggplot(ctr, aes(factor(dawka), proc, colour = factor(dawka))) +
  geom_pointrange(aes(ymin = d, ymax = g), size = 0.8, linewidth = 1, show.legend = FALSE) +
  scale_colour_manual(values = kol_dawki) + expand_limits(y = 0) +
  labs(title = "A. Kliknięcia na 1 powiadomienie", subtitle = "Ujemny dwumianowy z offsetem",
       x = "Powiadomień tygodniowo", y = "Kliknięć na 100 powiadomień") + motyw
p4b <- ggplot(przyrost, aes(factor(dawka), r, fill = miara)) +
  geom_col(position = position_dodge(0.75), width = 0.7) +
  geom_errorbar(aes(ymin = d, ymax = g), position = position_dodge(0.75), width = 0.2, colour = "grey20") +
  scale_fill_manual(values = c(`kliknięcia` = kol[["pomaranczowy"]], `dni z lekcją` = kol[["niebieski"]]), name = NULL) +
  labs(title = "B. Przyrost względem 1 tygodniowo", subtitle = "Na użytkownika przez 4 tygodnie (95% CI)",
       x = "Powiadomień tygodniowo", y = "Różnica średnich") + motyw
p4 <- p4a + p4b
p4   # zapis: ggsave("push-klikniecia-a-aktywnosc.svg", p4, width = 10, height = 5.4)
Wynik w R
Ujemny dwumianowy: theta = 6.23
 dawka  proc     d     g
     1 23.00 22.21 23.81
     3 21.72 21.22 22.23
     5 20.91 20.49 21.33
     7 20.85 20.46 21.25
 dawka        miara    r    d    g
     3   kliknięcia 1.61 1.55 1.68
     3 dni z lekcją 0.73 0.50 0.97
     5   kliknięcia 3.02 2.94 3.11
     5 dni z lekcją 1.12 0.88 1.36
     7   kliknięcia 4.18 4.07 4.30
     7 dni z lekcją 1.44 1.20 1.69
Na 1 dodatkowe kliknięcie przypada 0.34 dodatkowego dnia z lekcją (7 vs 1)
Dawka 1: kliknięć w dniu lekcji, która i tak by się odbyła: 60.9%
Dawka 7: kliknięć w dniu lekcji, która i tak by się odbyła: 68.8%
5. Efekt w czasie i nowi kontra dawni: Rysunek 5
R
# Przepis 5. Efekt w czasie (tydzień 1 kontra 4) i niejednorodność: nowi kontra dawni użytkownicy (Rysunek 5)
tyg <- do.call(rbind, lapply(1:4, function(w) do.call(rbind, lapply(split(u, u$dawka), function(d)
  data.frame(tydzien = w, dawka = d$dawka[1], t(sr_ci(d[[paste0("lekcje_t", w)]])))))))
print(reshape(transform(tyg[, c("tydzien", "dawka", "m")], m = round(m, 2)), idvar = "tydzien", timevar = "dawka",
              direction = "wide"), row.names = FALSE)                      # średnie dni z lekcją w tygodniu
efekt_tyg <- do.call(rbind, lapply(1:4, function(w) {
  y <- u[[paste0("lekcje_t", w)]]; a <- y[u$dawka == 7]; b <- y[u$dawka == 1]
  r <- mean(a) - mean(b); se <- sqrt(var(a) / length(a) + var(b) / length(b))
  data.frame(tydzien = w, roznica_7_vs_1 = r, d = r - 1.96 * se, g = r + 1.96 * se) }))
print(round(efekt_tyg, 2), row.names = FALSE)
# Zmęczenie: zmiana (tydzień 4 − tydzień 1) u tej samej osoby, porównana między dawkami
u$zmiana_t4_t1 <- u$lekcje_t4 - u$lekcje_t1
m_zm <- lm(zmiana_t4_t1 ~ factor(dawka), data = u)
cat(sprintf("Spadek efektu 7 vs 1 między tygodniem 1 a 4: %.2f dnia [%.2f, %.2f], %s\n", coef(m_zm)[4],
            confint(m_zm)[4, 1], confint(m_zm)[4, 2], apa_p(summary(m_zm)$coef[4, 4])))
# Ilu użytkowników dawki 7 dostawało jeszcze powiadomienia w 4. tygodniu (bez wypisu i odinstalowania przed 22. dniem)
cat(sprintf("Dawka 7: odsetek nadal otrzymujących powiadomienia w 4. tygodniu: %.1f%%\n",
            100 * mean(rowSums(P[u$dawka == 7, 22:28]) > 0)))

# Niejednorodność: interakcja log(dawki) × nowy użytkownik
m_int <- lm(lekcje ~ log(dawka) * nowy, data = u)
print(round(summary(m_int)$coef, 3))
grupy <- do.call(rbind, lapply(split(u, list(u$dawka, u$nowy)), function(d)
  data.frame(dawka = d$dawka[1], grupa = ifelse(d$nowy[1] == 1, "nowi (do 30 dni)", "dawni"), t(sr_ci(d$lekcje)),
             wypis = 100 * mean(d$wypis))))
grupy <- grupy[order(grupy$grupa, grupy$dawka), ]
print(transform(grupy, m = round(m, 2), d = round(d, 2), g = round(g, 2), wypis = round(wypis, 2)), row.names = FALSE)
for (g in unique(grupy$grupa)) cat(sprintf("%s: przyrost 7 vs 1 = %.2f dnia\n", g,
                                           grupy$m[grupy$grupa == g & grupy$dawka == 7] - grupy$m[grupy$grupa == g & grupy$dawka == 1]))

p5a <- ggplot(tyg, aes(tydzien, m, colour = factor(dawka), shape = factor(dawka))) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  scale_colour_manual(values = kol_dawki, name = "Powiadomień tygodniowo") +
  scale_shape_manual(values = c(16, 17, 15, 18), name = "Powiadomień tygodniowo") +
  labs(title = "A. Dni z lekcją w kolejnych tygodniach", subtitle = "Różnice między dawkami znikają",
       x = "Tydzień eksperymentu", y = "Średnio dni z lekcją (na 7)") + motyw
p5b <- ggplot(grupy, aes(dawka, m, colour = grupa, shape = grupa)) +
  geom_line(linewidth = 0.9) + geom_pointrange(aes(ymin = d, ymax = g), size = 0.5) +
  scale_colour_manual(values = c(`nowi (do 30 dni)` = kol[["cynober"]], dawni = kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(`nowi (do 30 dni)` = 17, dawni = 16), name = NULL) +
  scale_x_continuous(breaks = c(1, 3, 5, 7)) +
  labs(title = "B. Nowi i dawni użytkownicy", subtitle = "Nowi zyskują więcej (95% CI)",
       x = "Powiadomień tygodniowo", y = "Dni z lekcją (na 28)") + motyw
p5 <- p5a + p5b
p5   # zapis: ggsave("push-tygodnie-i-grupy.svg", p5, width = 10, height = 5.6)
Wynik w R
 tydzien  m.1  m.3  m.5  m.7
       1 2.15 2.41 2.65 2.85
       2 1.96 2.18 2.29 2.38
       3 1.83 1.96 2.02 2.06
       4 1.70 1.82 1.79 1.78
 tydzien roznica_7_vs_1    d    g
       1           0.71 0.63 0.79
       2           0.42 0.35 0.50
       3           0.23 0.16 0.30
       4           0.08 0.01 0.15
Spadek efektu 7 vs 1 między tygodniem 1 a 4: -0.62 dnia [-0.70, -0.55], p < .001
Dawka 7: odsetek nadal otrzymujących powiadomienia w 4. tygodniu: 81.3%
                Estimate Std. Error t value Pr(>|t|)
(Intercept)        8.283      0.101  81.615    0.000
log(dawka)         0.581      0.073   7.920    0.000
nowy              -1.870      0.170 -11.016    0.000
log(dawka):nowy    0.382      0.124   3.087    0.002
 dawka            grupa    m    d    g wypis
     1            dawni 8.32 8.10 8.54  1.13
     3            dawni 8.84 8.63 9.06  5.55
     5            dawni 9.20 8.98 9.42 11.48
     7            dawni 9.47 9.25 9.69 23.02
     1 nowi (do 30 dni) 6.40 6.15 6.64  0.21
     3 nowi (do 30 dni) 7.52 7.26 7.78  3.26
     5 nowi (do 30 dni) 7.93 7.65 8.20  8.63
     7 nowi (do 30 dni) 8.29 7.99 8.58 17.06
dawni: przyrost 7 vs 1 = 1.15 dnia
nowi (do 30 dni): przyrost 7 vs 1 = 1.89 dnia
6. Wartość netto i optimum z bootstrapu: Rysunek 6
R
# Przepis 6. Wartość netto i optymalna dawka z niepewnością: bootstrap użytkowników w obrębie grup (Rysunek 6)
# Ręczne założenia biznesowe: dzień z lekcją = 2 zł, wypis z powiadomień = −15 zł (utracony kontakt), odinstalowanie = −60 zł
v_lekcja <- 2; k_wypis <- 15; k_odinst <- 60
u$netto <- v_lekcja * u$lekcje - k_wypis * u$wypis - k_odinst * u$odinstalowanie
siatka_d <- seq(1, 7, by = 0.1)

# Krzywa netto z trzech modeli dopasowanych do sum w grupach dawek (te same oszacowania co na danych jednostkowych):
# dni z lekcją – logit z log(dawki); wypis – cloglog z log(dawki) i dawką (przepis 3); odinstalowanie – logit kwadratowy
krzywa_netto <- function(s, wzor_lekcji = ~ log(dawka)) {
  m_l <- glm(update(wzor_lekcji, cbind(lekcje, dni * osob - lekcje) ~ .), quasibinomial, data = s)
  m_w <- glm(cbind(wypis, osob - wypis) ~ log(dawka) + dawka, binomial(link = "cloglog"), data = s)
  m_o <- glm(cbind(odinst, osob - odinst) ~ dawka + I(dawka^2), binomial, data = s)
  nd <- data.frame(dawka = siatka_d)
  v_lekcja * dni * predict(m_l, nd, type = "response") - k_wypis * predict(m_w, nd, type = "response") -
    k_odinst * predict(m_o, nd, type = "response")
}
sumy <- function(d) do.call(rbind, lapply(split(d, d$dawka), function(x) data.frame(dawka = x$dawka[1], osob = nrow(x),
  lekcje = sum(x$lekcje), wypis = sum(x$wypis), odinst = sum(x$odinstalowanie), netto = sum(x$netto))))
grupy_u <- list(wszyscy = u, `nowi (do 30 dni)` = u[u$nowy == 1, ], dawni = u[u$nowy == 0, ])
punkt <- lapply(grupy_u, function(d) { s <- sumy(d); list(s = s, k = krzywa_netto(s)) })
for (g in names(punkt)) cat(sprintf("%-17s netto w grupach dawek (zł/os.): %s | optimum z modelu: %.1f\n", g,
  paste(sprintf("%d: %.2f", punkt[[g]]$s$dawka, punkt[[g]]$s$netto / punkt[[g]]$s$osob), collapse = ", "),
  siatka_d[which.max(punkt[[g]]$k)]))
for (g in names(punkt)) cat(sprintf("%-17s maksimum krzywej netto: %.2f zł\n", g, max(punkt[[g]]$k)))

# Bootstrap: 1000 razy losujemy użytkowników ze zwracaniem w obrębie każdej grupy dawki × staż
set.seed(7211)
B <- 1000
warstwy <- split(seq_len(nrow(u)), list(u$dawka, u$nowy))
boot_wyn <- replicate(B, {
  idx <- unlist(lapply(warstwy, function(i) i[sample.int(length(i), length(i), replace = TRUE)]))
  ub <- u[idx, ]
  sapply(list(wszyscy = ub, nowi = ub[ub$nowy == 1, ], dawni = ub[ub$nowy == 0, ]), function(d) {
    s <- sumy(d); k <- krzywa_netto(s)
    c(optimum = siatka_d[which.max(k)], najlepsza_testowana = s$dawka[which.max(s$netto / s$osob)])
  })
})
opt <- data.frame(grupa = rep(c("wszyscy", "nowi (do 30 dni)", "dawni"), each = B),
                  optimum = c(boot_wyn["optimum", "wszyscy", ], boot_wyn["optimum", "nowi", ], boot_wyn["optimum", "dawni", ]),
                  najlepsza = c(boot_wyn["najlepsza_testowana", "wszyscy", ], boot_wyn["najlepsza_testowana", "nowi", ],
                                boot_wyn["najlepsza_testowana", "dawni", ]))
for (g in unique(opt$grupa)) {
  o <- opt[opt$grupa == g, ]
  cat(sprintf("%-17s optimum: mediana %.1f, 95%% przedział percentylowy [%.1f, %.1f] | najlepsza testowana dawka (%% prób): %s\n",
              g, median(o$optimum), quantile(o$optimum, 0.025), quantile(o$optimum, 0.975),
              paste(sprintf("%s: %.1f%%", c(1, 3, 5, 7), 100 * sapply(c(1, 3, 5, 7), function(k) mean(o$najlepsza == k))), collapse = ", ")))
}
# Wrażliwość na założenie: koszt wypisu 5 zł i 30 zł zamiast 15 zł
for (kw in c(5, 30)) { k_wypis <- kw; cat(sprintf("Koszt wypisu %d zł: optimum (wszyscy) = %.1f\n", kw,
                                                  siatka_d[which.max(krzywa_netto(sumy(u)))])) }
k_wypis <- 15
# Odinstalowanie: czy logit kwadratowy nie odbiega od 4 średnich (test ilorazu wiarygodności)
cat(sprintf("Odinstalowanie – brak dopasowania modelu kwadratowego: %s\n",
            anova(glm(odinstalowanie ~ dawka + I(dawka^2), binomial, data = u),
                  glm(odinstalowanie ~ factor(dawka), binomial, data = u), test = "LRT")$`Pr(>Chi)`[2] |> apa_p()))
# Wrażliwość na kształt krzywej aktywności: logit liniowy w dawce zamiast log(dawki)
cat(sprintf("Dni z lekcją liniowo w dawce: optimum (wszyscy) = %.1f\n",
            siatka_d[which.max(krzywa_netto(sumy(u), ~ dawka))]))

kr <- do.call(rbind, lapply(names(punkt), function(g) data.frame(grupa = g, dawka = siatka_d, netto = punkt[[g]]$k)))
pk <- do.call(rbind, lapply(names(punkt), function(g) data.frame(grupa = g, dawka = punkt[[g]]$s$dawka,
                                                                 netto = punkt[[g]]$s$netto / punkt[[g]]$s$osob)))
kol_gr <- c(wszyscy = "grey20", `nowi (do 30 dni)` = kol[["cynober"]], dawni = kol[["niebieski"]])
p6a <- ggplot(kr, aes(dawka, netto, colour = grupa)) +
  geom_line(aes(linetype = grupa), linewidth = 1) + geom_point(data = pk, aes(shape = grupa), size = 2.6) +
  scale_colour_manual(values = kol_gr, name = NULL) + scale_linetype_manual(values = c(wszyscy = "solid", `nowi (do 30 dni)` = "41", dawni = "22"), name = NULL) +
  scale_shape_manual(values = c(wszyscy = 16, `nowi (do 30 dni)` = 17, dawni = 15), name = NULL) +
  scale_x_continuous(breaks = 1:7) + guides(colour = guide_legend(nrow = 1)) +
  labs(title = "A. Wartość netto na użytkownika", subtitle = "Linie: model, punkty: grupy eksperymentu",
       x = "Powiadomień tygodniowo", y = "Zł na osobę (4 tygodnie)") + motyw
p6b <- ggplot(opt[opt$grupa != "wszyscy", ], aes(optimum, fill = grupa)) +
  geom_histogram(binwidth = 0.2, boundary = 0.9, position = "identity", alpha = 0.6, colour = "white", linewidth = 0.2) +
  scale_fill_manual(values = kol_gr[-1], name = NULL) + scale_x_continuous(breaks = 1:7) + coord_cartesian(xlim = c(0.9, 7.1)) +
  labs(title = "B. Optymalna dawka w 1000 próbach", subtitle = "Bootstrap użytkowników w warstwach",
       x = "Dawka z największą wartością netto", y = "Liczba prób") + motyw
p6 <- p6a + p6b
p6   # zapis: ggsave("push-wartosc-netto-optimum.svg", p6, width = 10, height = 5.8)
Wynik w R
wszyscy           netto w grupach dawek (zł/os.): 1: 13.97, 3: 14.94, 5: 14.55, 7: 12.83 | optimum z modelu: 3.2
nowi (do 30 dni)  netto w grupach dawek (zł/os.): 1: 11.63, 3: 13.18, 5: 13.29, 7: 11.25 | optimum z modelu: 3.7
dawni             netto w grupach dawek (zł/os.): 1: 15.28, 3: 15.94, 5: 15.25, 7: 13.63 | optimum z modelu: 2.9
wszyscy           maksimum krzywej netto: 15.04 zł
nowi (do 30 dni)  maksimum krzywej netto: 13.37 zł
dawni             maksimum krzywej netto: 15.98 zł
wszyscy           optimum: mediana 3.2, 95% przedział percentylowy [2.8, 3.6] | najlepsza testowana dawka (% prób): 1: 0.0%, 3: 87.0%, 5: 13.0%, 7: 0.0%
nowi (do 30 dni)  optimum: mediana 3.7, 95% przedział percentylowy [3.1, 4.1] | najlepsza testowana dawka (% prób): 1: 0.0%, 3: 42.4%, 5: 57.6%, 7: 0.0%
dawni             optimum: mediana 2.9, 95% przedział percentylowy [2.2, 3.4] | najlepsza testowana dawka (% prób): 1: 4.7%, 3: 91.1%, 5: 4.2%, 7: 0.0%
Koszt wypisu 5 zł: optimum (wszyscy) = 4.4
Koszt wypisu 30 zł: optimum (wszyscy) = 2.4
Odinstalowanie – brak dopasowania modelu kwadratowego: p = .808
Dni z lekcją liniowo w dawce: optimum (wszyscy) = 3.3
7. Grafika: karta „4 dawki” (Rysunek 1)
R
# Przepis 7. Grafika: karta „4 dawki” (Rysunek 1). Liczby pochodzą z obiektów krzywe (przepis 2) i punkt (przepis 6)
f <- function(x, d = 1) formatC(x, format = "f", digits = d)
wart <- function(m, k) krzywe$m[krzywe$miara == m & krzywe$dawka == k]
s_all <- punkt$wszyscy$s
karty <- data.frame(x = 0:3, dawka = c(1, 3, 5, 7))
karty$naglowek <- sprintf("%d × w tygodniu", karty$dawka)
karty$netto <- sprintf("%s zł", f(s_all$netto / s_all$osob, 2))
karty$opis <- sapply(karty$dawka, function(k) paste0(
  "dni z lekcją: ", f(wart("A. Dni z lekcją (na 28 dni)", k), 2), "\n",
  "kliknięcia: ", f(wart("B. Kliknięcia w powiadomienia", k), 2), "\n",
  "wypis: ", f(wart("C. Wypis z powiadomień (%)", k)), "%\n",
  "odinstalowanie: ", f(wart("D. Odinstalowanie aplikacji (%)", k)), "%"))
karty$werdykt <- c("za mało kontaktu", "najlepsza z testowanych", "nowym może służyć", "wypisy zjadają zysk")
tekst_naglowka <- c("white", "white", "white", "#0f1d3a")
p1 <- ggplot(karty) +
  geom_rect(aes(xmin = x + 0.04, xmax = x + 0.96, ymin = 0.05, ymax = 0.97), fill = "white",
            colour = kol_dawki, linewidth = 1.4) +
  geom_rect(aes(xmin = x + 0.04, xmax = x + 0.96, ymin = 0.83, ymax = 0.97), fill = kol_dawki) +
  geom_text(aes(x + 0.5, 0.90, label = naglowek), size = 5, fontface = "bold", colour = tekst_naglowka) +
  geom_text(aes(x + 0.5, 0.72, label = netto), size = 7.2, fontface = "bold", colour = "#0f1d3a") +
  annotate("text", x = 0:3 + 0.5, y = 0.645, label = "wartość netto na osobę", size = 3.4, colour = "grey35") +
  geom_text(aes(x + 0.09, 0.40, label = opis), hjust = 0, size = 3.9, colour = "grey15", lineheight = 1.15) +
  geom_text(aes(x + 0.5, 0.12, label = werdykt), size = 3.7, fontface = "bold.italic", colour = "grey25") +
  annotate("text", x = 0.04, y = -0.03, hjust = 0, size = 3.4, colour = "grey35",
           label = "Średnio na użytkownika przez 4 tygodnie, 4000 osób w każdej grupie. Wartość netto: 2 zł za dzień z lekcją, −15 zł za wypis, −60 zł za odinstalowanie.") +
  scale_x_continuous(limits = c(0, 4), expand = c(0, 0)) + scale_y_continuous(limits = c(-0.07, 1), expand = c(0, 0)) +
  labs(title = "Eksperyment: 4 dawki powiadomień push w aplikacji do nauki języków") +
  theme_void(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 6)),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 10, 10, 10))
karty[c("dawka", "netto", "werdykt")]
p1   # zapis: ggsave("push-karta-4-dawki.svg", p1, width = 10, height = 5.2)
Wynik w R
  dawka    netto                 werdykt
1     1 13.97 zł        za mało kontaktu
2     3 14.94 zł najlepsza z testowanych
3     5 14.55 zł       nowym może służyć
4     7 12.83 zł     wypisy zjadają zysk
8. Sprawdzenie palety (deuteranopia i protanopia)
R
# Przepis 8. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
v <- viridisLite::plasma(4, end = 0.85)
pary <- list("plasma: dawka 1 – 3 (rys. 1, 2, 4A, 5A)" = v[1:2], "plasma: dawka 3 – 5" = v[2:3],
             "plasma: dawka 5 – 7" = v[3:4],
             "cynober – niebieski (rys. 3, 5B, 6)" = c("#D55E00", "#0072B2"),
             "niebieski – zielony (rys. 3A)" = c("#0072B2", "#009E73"),
             "cynober – zielony (rys. 3A)" = c("#D55E00", "#009E73"),
             "pomarańczowy – niebieski (rys. 4B)" = c("#E69F00", "#0072B2"),
             "ciemnoszary – cynober (rys. 6A)" = c("grey20", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(hex(k))),
                                   protanopia = roznica(protan(hex(k)))))), 1)
Wynik w R
                                        widzenie_typowe deuteranopia protanopia
plasma: dawka 1 – 3 (rys. 1, 2, 4A, 5A)            30.0         31.0       13.1
plasma: dawka 3 – 5                                73.0         74.4       67.8
plasma: dawka 5 – 7                                72.9         55.7       76.3
cynober – niebieski (rys. 3, 5B, 6)               114.6        108.3       91.9
niebieski – zielony (rys. 3A)                      70.1         55.4       58.0
cynober – zielony (rys. 3A)                       102.4         53.5       37.3
pomarańczowy – niebieski (rys. 4B)                120.2        121.5      109.3
ciemnoszary – cynober (rys. 6A)                    83.4         72.7       59.9
czerwony – zielony (do unikania)                  121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Splajn (GAM) dopasowano pakietem mgcv, regresję ujemną dwumianową – pakietem MASS, a modele quasi-dwumianowe, logitowe i cloglog, losowanie danych i bootstrap – funkcjami glm(), lm(), sample.int() i replicate() z pakietów stats i base. Rysunki wykonano w pakiecie ggplot2 (paleta plasma z pakietu viridisLite), panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mgcv (wersja 1.9-4): Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315370279
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- viridisLite (wersja 0.4.3): Garnier, S., Ross, N., Rudis, R., Camargo, P. A., Sciaini, M., & Scherer, C. (2026). viridis(Lite): Colorblind-friendly color maps for R [Computer software]. https://doi.org/10.5281/zenodo.4678326
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Kliknięcia jako efekt. Dwie trzecie kliknięć przypadło na lekcje, które i tak by się odbyły. Efekt dodatkowy daje tylko porównanie losowych grup.
- Wypis jako drobny koszt. Wypis jest trwały, a w danych z 4 tygodni widać tylko początek jego kosztu.
- Wynik z 1. tygodnia. Efekt 7 powiadomień spadł z 0.71 do 0.08 dnia tygodniowo. Krótki test przeszacowuje korzyść z dużej dawki.
- Krzywa między dawkami jako fakt. Przy czterech dawkach kształt między nimi pochodzi z modelu. Sprawdź zgodność z czterema średnimi i nie ekstrapoluj poza 1–7.
- Jedna dawka dla wszystkich. Nowi i dawni użytkownicy mają różne optima (3.7 i 2.9). Podgrupy zaplanuj przed testem.
- Optimum bez założeń. Przedział bootstrapowy nie obejmuje niepewności co do złotówek.
Najczęstsze pytania
Ile powiadomień push tygodniowo wysyłać użytkownikom aplikacji?
Nie ma jednej liczby – zależy od tego, ile zyskujesz na dodatkowej aktywności i ile tracisz na wypisach. Sprawdź to eksperymentem z kilkoma dawkami (np. 1, 3, 5, 7 tygodniowo). W fikcyjnym przykładzie aplikacji do nauki języków najlepsze były około 3 powiadomienia tygodniowo (95% przedział bootstrapowy 2.8–3.6), a u nowych użytkowników nieco więcej.
Czy liczba kliknięć w powiadomienia mierzy ich skuteczność?
Nie. Wiele osób klika w dniu, w którym i tak by z aplikacji skorzystała. W przykładzie 66.6% kliknięć przypadło na lekcje, które odbyłyby się bez powiadomienia, a na jedno dodatkowe kliknięcie przypadało tylko 0.34 dodatkowego dnia nauki. Efekt pokazuje porównanie losowo przydzielonych grup, nie kliknięcia.
Jak zaplanować eksperyment z częstotliwością powiadomień?
Wylosuj użytkowników do co najmniej trzech–czterech dawek rozłożonych na sensownym zakresie, ustal z góry metryki (aktywność, wypisy, odinstalowania) i czas testu – co najmniej kilka tygodni, bo efekt słabnie. Zaplanuj podgrupy (np. nowi i dawni użytkownicy) przed testem i analizuj według przydziału.
Jak wyznaczyć optymalną częstotliwość z niepewnością?
Przelicz wyniki na wspólną miarę (np. złotówki za dzień aktywności i koszt wypisu), dopasuj krzywe do dawek i znajdź maksimum krzywej netto. Niepewność oceń bootstrapem: losuj użytkowników ze zwracaniem w obrębie grup, dopasuj modele od nowa i zbierz rozkład optimum. Podaj też wynik przy innych założeniach o kosztach.
Dlaczego efekt powiadomień maleje w kolejnych tygodniach?
Część osób się wypisuje, ale główną przyczyną jest zmęczenie: kolejne powiadomienia działają słabiej. W przykładzie różnica między 7 a 1 powiadomieniem spadła z 0.71 dnia z lekcją w 1. tygodniu do 0.08 w 4., choć 81.3% osób z najwyższej dawki wciąż dostawało powiadomienia. Krótki test przeszacowuje więc korzyść z wysokiej dawki.
Powiązane hasła
Przeczytaj też
Częstotliwość kontaktu z reklamą
Serwis VOD: krzywa odpowiedzi z GAM, nasycenie i zmęczenie reklamą, pułapka aktywnych użytkowników, losowy limit wyświetleń i zysk – z kodem R.
Czytaj →PoradnikTest A/B z wieloma wariantami
Pięć tematów maila i kontrola: Dunnett, Holm i Tukey, klątwa zwycięzcy w 1000 symulacji, test potwierdzający i moc – pięć rysunków z kodem R.
Czytaj →PoradnikPopyt ukryty przez braki towaru
Sprzedaż ucięta zapasem, model z cenzurowaniem, godzina wyczerpania i dostawa z kwantyla popytu – na fikcyjnych sklepach z sokami, z kodem R.
Czytaj →Analizujesz eksperyment z powiadomieniami, e-mailami lub częstotliwością kontaktu?
Pomożemy zaplanować test z kilkoma dawkami, dobrać model krzywej, policzyć optimum z przedziałem i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bidargaddi, N., Almirall, D., Murphy, S., Nahum-Shani, I., Kovalcik, M., Pituch, T., Maaieh, H., & Strecher, V. (2018). To prompt or not to prompt? A microrandomized trial of time-varying push notifications to increase proximal engagement with a mobile health app. JMIR mHealth and uHealth, 6(11), Article e10123. https://doi.org/10.2196/10123 ● Otwarty dostęp
- Desquilbet, L., & Mariotti, F. (2010). Dose-response analyses using restricted cubic spline functions in public health research. Statistics in Medicine, 29(9), 1037–1057. https://doi.org/10.1002/sim.3841
- Efron, B., & Tibshirani, R. J. (1993). An introduction to the bootstrap. Chapman & Hall.
- Freyne, J., Yin, J., Brindal, E., Hendrie, G. A., Berkovsky, S., & Noakes, M. (2017). Push notifications in diet apps: Influencing engagement times and tasks. International Journal of Human–Computer Interaction, 33(10), 833–845. https://doi.org/10.1080/10447318.2017.1289725
- Klasnja, P., Hekler, E. B., Shiffman, S., Boruvka, A., Almirall, D., Tewari, A., & Murphy, S. A. (2015). Microrandomized trials: An experimental design for developing just-in-time adaptive interventions. Health Psychology, 34(Suppl), 1220–1228. https://doi.org/10.1037/hea0000305 ● Otwarty dostęp
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Zhang, X., Kumar, V., & Cosguner, K. (2017). Dynamically managing a profitable email marketing program. Journal of Marketing Research, 54(6), 851–866. https://doi.org/10.1509/jmr.16.0210
Cytowania BibTeX
@article{bidargaddi2018prompt, author={Bidargaddi, Niranjan and Almirall, Daniel and Murphy, Susan and Nahum-Shani, Inbal and Kovalcik, Michael and Pituch, Timothy and Maaieh, Haitham and Strecher, Victor}, title={{To prompt or not to prompt? A microrandomized trial of time-varying push notifications to increase proximal engagement with a mobile health app}}, journal={JMIR mHealth and uHealth}, year={2018}, volume={6}, number={11}, eid={e10123}, doi={10.2196/10123}}@article{desquilbet2010dose, author={Desquilbet, Loïc and Mariotti, François}, title={{Dose-response analyses using restricted cubic spline functions in public health research}}, journal={Statistics in Medicine}, year={2010}, volume={29}, number={9}, pages={1037--1057}, doi={10.1002/sim.3841}}@book{efron1993introduction, author={Efron, Bradley and Tibshirani, Robert J.}, title={{An introduction to the bootstrap}}, year={1993}, publisher={Chapman \& Hall}}@article{freyne2017push, author={Freyne, Jill and Yin, Jie and Brindal, Emily and Hendrie, Gilly A. and Berkovsky, Shlomo and Noakes, Manny}, title={{Push notifications in diet apps: Influencing engagement times and tasks}}, journal={International Journal of Human–Computer Interaction}, year={2017}, volume={33}, number={10}, pages={833--845}, doi={10.1080/10447318.2017.1289725}}@article{klasnja2015microrandomized, author={Klasnja, Predrag and Hekler, Eric B. and Shiffman, Saul and Boruvka, Audrey and Almirall, Daniel and Tewari, Ambuj and Murphy, Susan A.}, title={{Microrandomized trials: An experimental design for developing just-in-time adaptive interventions}}, journal={Health Psychology}, year={2015}, volume={34}, number={Suppl}, pages={1220--1228}, doi={10.1037/hea0000305}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{zhang2017dynamically, author={Zhang, Xi (Alan) and Kumar, V. and Cosguner, Koray}, title={{Dynamically managing a profitable email marketing program}}, journal={Journal of Marketing Research}, year={2017}, volume={54}, number={6}, pages={851--866}, doi={10.1509/jmr.16.0210}}