Przykład: soki tłoczone, 25 sklepów i pytanie „ile naprawdę moglibyśmy sprzedać?”
Fikcyjny producent soków tłoczonych ma 25 sklepów firmowych. Sok jabłko–imbir w butelce 0.5 l ma krótką datę: każdego ranka sklep dostaje świeżą dostawę, a to, co zostanie wieczorem, idzie do utylizacji. Kasy zapisują dzienną sprzedaż, a system magazynowy – dostawę i godzinę ostatniej sprzedaży. Mamy cały rok 2025: 9125 dni sklepowych (25 sklepów × 365 dni).
Dział sprzedaży pyta: o ile rośnie popyt w upał i w promocji „druga butelka −50%” – i ile soku zamawiać? Kłopot w tym, że w 21.7% dni sok skończył się przed zamknięciem. W takim dniu kasa pokazuje sprzedaż równą dostawie, a ilu klientów odeszło z niczym – nie wiadomo.
Dane są fikcyjne i wiemy, jaki popyt w nich ukryliśmy. Parametry ustawiliśmy ręcznie (pełna lista przy kodzie): popyt ma rozkład lognormalny, każde 5 °C ponad 15 °C podnosi go o 12%, promocja o 35%, a dzień po pustej półce obniża o 5%. Dostawę wyznacza obecny plan firmy: typowy poziom popytu sklepu w danym dniu tygodnia × 1.15, w promocji jeszcze × 1.20 – bez pogody. Ziarna (722, 7222, 7223) ustaliliśmy raz; po pierwszym uruchomieniu nie zmienialiśmy ani ziaren, ani parametrów. Dane pobierzesz jako braki-towaru-soki-sprzedaz-dzienna.csv (kolumna popyt_prawdziwy istnieje tylko w symulacji).
Wpis o modelu gazeciarza i zapasie bezpieczeństwa pokazał, jak z rozkładu popytu jednego produktu w jednej piekarni wybrać wielkość wypieku. Tu pytanie jest inne: jak oszacować wpływ pogody i promocji na popyt, gdy w najgorętsze i promocyjne dni dane są ucięte najczęściej.
Rysunek 1: popyt – zapas – sprzedaż
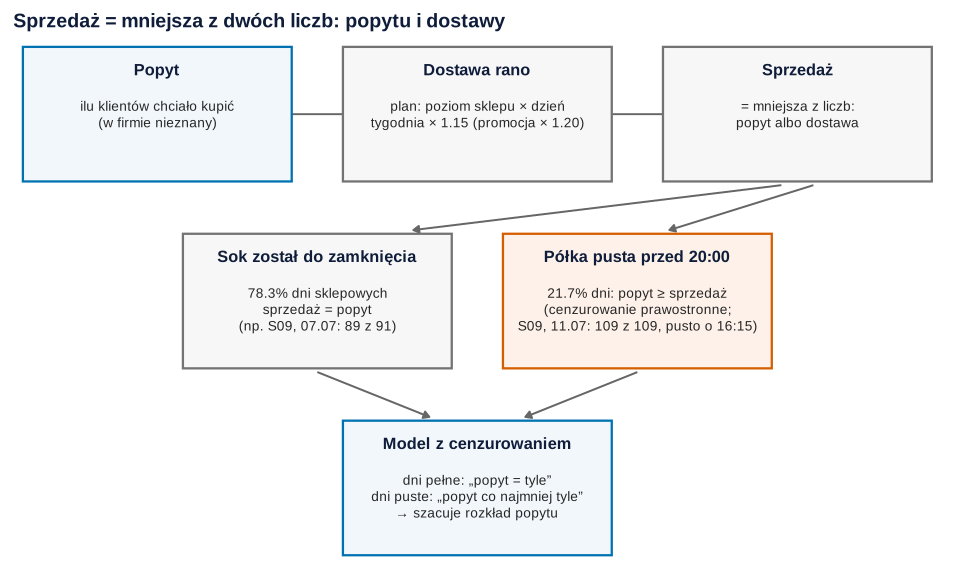
set.seed(722)).Co widać. Sprzedaż to mniejsza z dwóch liczb: popytu i dostawy. W 78.3% dni sok został na półce i sprzedaż mówi całą prawdę o popycie. W pozostałych 21.7% dni mówi tylko, że popyt był co najmniej taki. W piątek 11 lipca sklep S09 sprzedał 109 butelek ze 109 i o 16:15 półka była pusta; prawdziwy popyt (znany tylko w symulacji) wynosił 157.
Jak może zmylić. W arkuszu oba dni wyglądają tak samo – liczba w kolumnie „sprzedaż”. To obserwacja cenzurowana prawostronnie: znamy dolną granicę wyniku. Różnicę między sprzedażą a popytem opisał już Conrad (1976).
Podpis do pracy:
Rysunek 2: sufit z dostawy
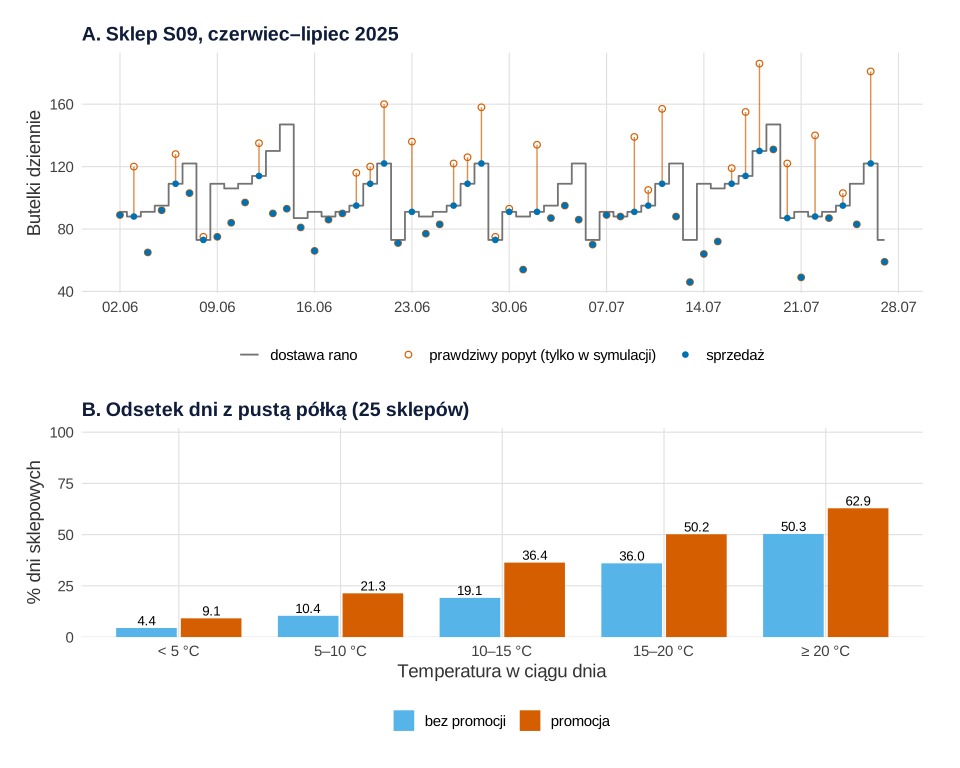
set.seed(722)).Co widać. W sklepie S09 latem sok skończył się w 25 z 56 dni. Średnia sprzedaż w tym okresie to 89.5 butelki, a średni popyt 101.7. Panel B pokazuje sedno problemu: braki nie są przypadkowe. Przy temperaturze poniżej 5 °C półka pustoszeje w 4.4% dni, przy 20 °C i więcej – w 50.3%, a w promocji w upale – w 62.9%. W całym roku średnia sprzedaż (46.8 butelki) zaniża średni popyt (49.3) o 5.1%, ale w dniach promocji różnica jest większa: 60.6 wobec 66.5.
Jak może zmylić. 5% w średniej rocznej wygląda niewinnie. Tyle że ucięcie dotyka właśnie dni, o które pyta dział sprzedaży: gorące i promocyjne. Dlatego bardziej niż średnią zniekształca różnice – efekt temperatury i promocji.
Zdanie do Wyników:
Rysunek 3: trzy sposoby liczenia, jedna prawda
We wszystkich trzech modelach zmienną zależną jest logarytm sprzedaży (transformacja logarytmiczna zamienia współczynniki na zmiany procentowe), a predyktorami: sklep (efekty stałe), dzień tygodnia, temperatura, promocja i to, czy dzień wcześniej półka była pusta. Różni je tylko sposób potraktowania dni z brakiem:
- Regresja na sprzedaży – sprzedaż traktowana jak popyt.
- Bez dni z brakiem – „wyrzućmy dni zepsute przez braki”. To zamienia cenzurowanie w ucięcie: zostają tylko dni, w których popyt był mniejszy niż dostawa (dane ucięte).
- Model z cenzurowaniem – model tobitowy (Tobin, 1958) z progiem górnym dla logarytmu popytu, czyli regresja log-normalna z cenzurowaniem prawostronnym. Szacuje się go metodą największej wiarygodności.
Wiarygodność modelu z cenzurowaniem składa się z dwóch rodzajów dni:
Słowami: dzień z sokiem do końca mówi „popyt wyniósł tyle”, a dzień z pustą półką – „popyt wyniósł co najmniej tyle”. Nahmias (1994) porównał takie estymatory dla popytu z utraconą sprzedażą. Różnica wobec wpisu o efekcie sufitu i modelu Tobita: tam próg jest jeden dla wszystkich (maksimum skali), tu każdy dzień sklepowy ma własny próg – swoją dostawę.
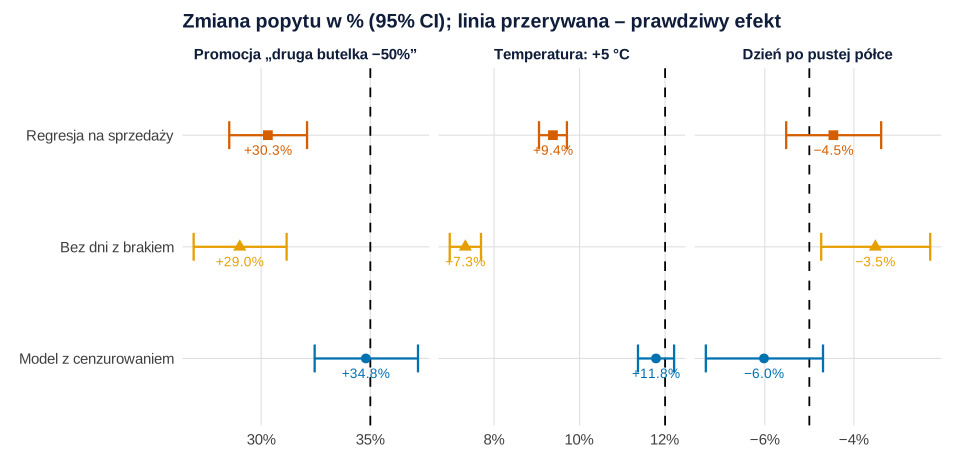
set.seed(722)).Co widać. Model z cenzurowaniem trafia: promocja +34.8% (95% CI [32.5, 37.2]) przy prawdziwych +35%, temperatura +11.8% na 5 °C [11.4, 12.2] przy 12%. Regresja na sprzedaży daje +30.3% [28.5, 32.1] i +9.4% [9.1, 9.7]. Wyrzucenie dni z brakiem pogarsza sprawę: +29.0% i +7.3%. Model z cenzurowaniem odtwarza też średni popyt w roku (49.5 butelki wobec prawdziwych 49.3) i jego rozrzut (σ = 0.25, w prostych metodach 0.21 i 0.20).
Jak może zmylić. Wąskie przedziały prostych metod wyglądają solidnie, ale leżą obok prawdy. Duża próba nie leczy obciążenia – tylko zawęża przedział wokół złej wartości. Usunięcie dni z brakiem to klasyczny błąd selekcji: wypadają dni z najwyższym popytem, a najwięcej wypada ich w upał i w promocji, więc różnice się spłaszczają. Rysunek to wykres współczynników – w pracy podaj obok tabelę z liczbami.
Zdanie do Wyników:
Rysunek 4: czy to nie przypadek? 200 symulowanych lat
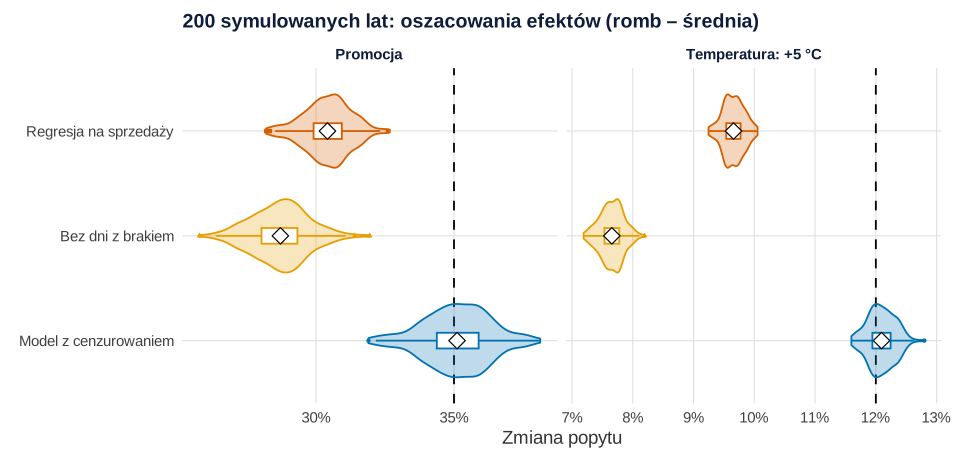
set.seed(7222)).Co widać. Powtarzamy cały rok 200 razy z tymi samymi parametrami (puste półki w 19.8–22.4% dni). Regresja na sprzedaży zaniża efekt promocji średnio o 4.6 punktu procentowego (30.4% zamiast 35%), a usunięcie dni z brakiem – o 6.3 punktu. Średnia z modelu z cenzurowaniem to 35.1%. Dla temperatury: 9.7%, 7.7% i 12.1% przy prawdziwych 12%. Błąd Monte Carlo średnich nie przekracza 0.08 punktu.
Jak może zmylić. Symulacja zakłada, że model jest prawdziwy: popyt naprawdę jest log-normalny, a wpływ temperatury liniowy w logarytmie. Model z cenzurowaniem płaci za poprawkę założeniem o rozkładzie – w części cenzurowanej nic go nie sprawdza. Dlatego jego rozrzut jest nieco większy niż w prostych metodach.
Zdanie do Metody:
Rysunek 5: godzina wyczerpania jako dodatkowa informacja
Sklep, w którym sok skończył się o 14:00, stracił więcej klientów niż sklep, w którym skończył się o 19:45. Model z cenzurowaniem tego nie wie – zna tylko „co najmniej 109”. Jeśli z dni bez braków znasz typowy rozkład ruchu w ciągu dnia (np. do 16:15 przychodzi zwykle 69.4% dziennych klientów), możesz oszacować popyt dnia jako dostawa / udział ruchu do godziny wyczerpania. Anupindi i in. (1998) pokazali, że gdy momenty wyczerpania zapasu są znane, estymatory największej wiarygodności popytu stają się proste.
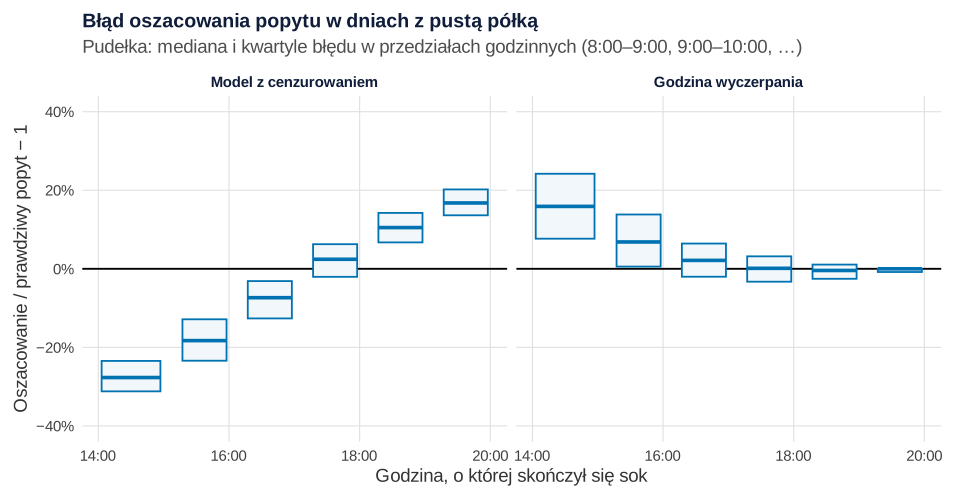
set.seed(722)).Co widać. Średni błąd bezwzględny w dniach z pustą półką wynosi 11.6 butelki dla samej sprzedaży, 8.2 dla oczekiwanego popytu z modelu z cenzurowaniem i 3.2 dla oszacowania z godziny. Model daje każdemu pustemu dniu podobny „typowy nadmiar” – zaniża więc dni z wczesnym brakiem (mediana błędu −21.3% przed 16:00) i zawyża te z późnym (+12.4% po 18:00). Godzina rozróżnia je: przy wyczerpaniu po 18:00 (1005 dni) błąd to 1.3 butelki zamiast 7.7.
Jak może zmylić. Przy wczesnym wyczerpaniu (148 dni przed 16:00) oszacowanie z godziny też jest niepewne (błąd 11.7 butelki): dzielimy przez mały udział, a ruch w konkretnym dniu odbiega od typowego. Do oszacowania efektów (Rysunek 3) wciąż potrzebny jest model; godzina służy do lepszego odtworzenia pojedynczych dni, a w większych analizach można ją włączyć do wiarygodności.
Rysunek 6: zamawiaj z kwantyla popytu, nie sprzedaży
Załóżmy, że firma chce pustej półki najwyżej w co piątym dniu. Wtedy dostawa powinna być 80. centylem rozkładu popytu na dany dzień – w sklepie, dniu tygodnia, prognozowanej temperaturze i promocji. Sprawdzamy trzy reguły na nowym, symulowanym roku 2026 (te same dni i klienci dla każdej reguły, trafna prognoza temperatury).
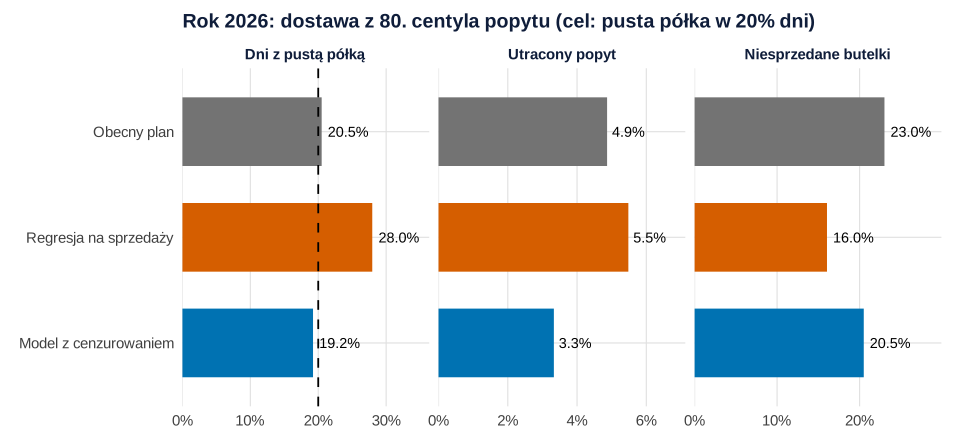
set.seed(7223)).Co widać. 80. centyl z regresji na sprzedaży jest za niski dwa razy: zaniżona średnia i zaniżony rozrzut. Półka pustoszeje w 28.0% dni zamiast w 20%. Model z cenzurowaniem trafia w cel (19.2%). Względem obecnego planu traci mniej popytu (3.3% wobec 4.9%) i zostawia mniej butelek do utylizacji (20.5% wobec 23.0%), bo dostawy rosną w upał i maleją w chłodne dni.
Jak może zmylić. Mniej niesprzedanych butelek w regule z regresji na sprzedaży (16.0%) to nie zaleta, tylko skutek za małych dostaw. Porównuj reguły na wszystkich trzech miarach naraz. Jak dobrać centyl do kosztów braku i nadmiaru, pokazuje wpis o modelu gazeciarza.
Zdanie do Wyników:
Co z tym zrobić w firmie
- Zapisuj, kiedy towar się skończył. Sama flaga „wyprzedane” wystarczy do modelu z cenzurowaniem; godzina ostatniej sprzedaży poprawia oszacowanie pojedynczych dni (Rysunek 5).
- Nie wyrzucaj dni z brakiem i nie licz efektów promocji na surowej sprzedaży. Promocja w upale wygląda wtedy słabiej, niż działa.
- Planuj dostawy z rozkładu popytu, nie sprzedaży – i uwzględnij pogodę, jeśli wpływa na popyt. Wybór centyla to decyzja o kosztach, nie o statystyce.
- Policz utraconą sprzedaż. Model szacuje 24 405 butelek niezaspokojonego popytu w 2025 r. (prawdziwe: 23 087), ale nie wszystko to strata (patrz Pułapki).
- Jeśli promocje to Twój temat, połącz ten wpis z analizą promocji w sieci sklepów modelem mieszanym i prognozą sprzedaży z sezonowością i promocjami; innych zastosowań szukaj w przeglądzie statystyki w pracy z logistyki.
Jak opisać w pracy
Zdanie do Metody:
Jeśli nie masz informacji o brakach, napisz to wprost w ograniczeniach: „Dane nie zawierały informacji o wyczerpaniu zapasu, więc oszacowania dotyczą sprzedaży, nie popytu, i mogą zaniżać wpływ czynników zwiększających popyt”. Więcej o pisaniu takich prac – w przeglądzie statystyki w pracy z zarządzania i ekonomii.
Kod R: symulacja sprzedaży, model z cenzurowaniem i reguła dostaw
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcję symulującą rok sprzedaży, z których korzystają następne. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(722)), 5 (set.seed(7222)) i 7 (set.seed(7223), ustawiane przed każdą regułą, żeby wszystkie reguły spotkały tę samą pogodę i tych samych klientów); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: 25 sklepów z medianą popytu w poniedziałek przy 15 °C losowaną wokół 45 butelek (rozrzut 0.25 na skali logarytmu), mnożniki dni tygodnia (1.00, 0.97, 1.00, 1.05, 1.20, 1.35, 0.80), efekty: +12% na 5 °C, promocja +35%, dzień po pustej półce −5%, rozrzut dzienny σ = 0.25, sześć tygodni promocji (10, 18, 24, 29, 35, 46), temperaturę (sezonowo od ok. 0 do 20 °C plus losowe odchylenia o SD = 3 °C), plan dostaw (× 1.15, w promocji × 1.20), godziny otwarcia 8–20 i profil ruchu w ciągu dnia (rozkład beta(2.2, 1.8) z losowymi odchyleniami parametrów), 200 powtórzeń symulacji i cel 80. centyla. Po pierwszym uruchomieniu nie zmieniono żadnego parametru. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Przepis 5 liczy się ok. 30 sekund, pozostałe – po ułamku sekundy.
1. Dane: 25 sklepów, rok sprzedaży soku
R
# Przepis 1. Fikcyjny producent soków tłoczonych: 25 sklepów firmowych, rok 2025, sok jabłko–imbir 0.5 l
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Prawda" = "#000000", "Regresja na sprzedaży" = "#D55E00", "Bez dni z brakiem" = "#E69F00",
         "Model z cenzurowaniem" = "#0072B2", "Obecny plan" = "grey45")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie (prawda, którą znamy tylko dzięki symulacji)
n_sklep <- 25
dni_tyg <- c("pon", "wt", "śr", "czw", "pt", "sob", "nd")
mnoznik_dnia <- c(1.00, 0.97, 1.00, 1.05, 1.20, 1.35, 0.80)
b_temp <- log(1.12)       # +12% popytu na każde 5 °C ponad 15 °C
b_promo <- log(1.35)      # promocja „druga butelka −50%”: +35% popytu
b_wczoraj <- log(0.95)    # dzień po pustej półce: −5% popytu (zniechęceni klienci)
sigma <- 0.25             # rozrzut losowy popytu na skali logarytmu
tygodnie_promocji <- c(10, 18, 24, 29, 35, 46)       # promocje w całej sieci (tydzień roku)

set.seed(722)
sklep_poziom <- round(45 * exp(rnorm(n_sklep, 0, 0.25)), 1)  # mediana popytu w poniedziałek przy 15 °C
names(sklep_poziom) <- sprintf("S%02d", 1:n_sklep)

# Jeden rok sprzedaży. Dostawę rano wyznacza funkcja `dostawa(k, brak_wczoraj)` (k – kalendarz dnia);
# domyślnie obecny plan firmy: poziom sklepu × dzień tygodnia × 1.15, w promocji × 1.20, bez pogody.
plan_obecny <- function(k, brak_wczoraj) ceiling(1.15 * sklep_poziom * k$mnoznik * ifelse(k$promocja == 1, 1.20, 1))
symuluj_rok <- function(rok = 2025, dostawa = plan_obecny) {
  daty <- seq(as.Date(paste0(rok, "-01-01")), as.Date(paste0(rok, "-12-31")), by = "day")
  doy <- as.integer(format(daty, "%j")); dz <- as.integer(format(daty, "%u"))
  temp <- round(10 - 10 * cos(2 * pi * (doy - 20) / 365) + rnorm(length(daty), 0, 3), 1)
  promo <- as.integer(as.integer(format(daty, "%V")) %in% tygodnie_promocji & doy > 7)
  m <- matrix(NA_real_, length(daty), n_sklep)          # wiersze – dni, kolumny – sklepy
  popyt <- dost <- wyp <- wcz <- godz <- m
  brak <- rep(0, n_sklep)
  for (t in seq_along(daty)) {
    k <- list(t = t, dzien = dz[t], mnoznik = mnoznik_dnia[dz[t]], temperatura = temp[t], promocja = promo[t])
    logm <- log(sklep_poziom * k$mnoznik) + b_temp * (temp[t] - 15) / 5 + b_promo * promo[t] + b_wczoraj * brak
    popyt[t, ] <- round(exp(logm + rnorm(n_sklep, 0, sigma)))   # prawdziwy popyt (w firmie nieznany)
    dost[t, ] <- dostawa(k, brak)
    wcz[t, ] <- brak
    wyp[t, ] <- brak <- as.numeric(popyt[t, ] >= dost[t, ])
    # godzina wyczerpania (sklep czynny 8–20): dzienny profil klientów to rozkład beta z losowymi parametrami
    u <- qbeta(pmin(dost[t, ] / popyt[t, ], 1), 2.2 * exp(rnorm(n_sklep, 0, 0.12)), 1.8 * exp(rnorm(n_sklep, 0, 0.12)))
    godz[t, ] <- ifelse(wyp[t, ] == 1, round(4 * (8 + 12 * u)) / 4, NA)
  }
  data.frame(data = rep(daty, n_sklep), sklep = rep(names(sklep_poziom), each = length(daty)),
             dzien = factor(dni_tyg[rep(dz, n_sklep)], levels = dni_tyg), temperatura = rep(temp, n_sklep),
             promocja = rep(promo, n_sklep), brak_wczoraj = as.vector(wcz), dostawa = as.vector(dost),
             sprzedaz = pmin(as.vector(popyt), as.vector(dost)), wyprzedane = as.vector(wyp),
             godzina = as.vector(godz), popyt = as.vector(popyt))
}

soki <- symuluj_rok(2025)
cat("Dni sklepowe:", nrow(soki), " sklepy:", n_sklep, "\n")
cat("Dni z wyprzedanym sokiem:", sum(soki$wyprzedane), "=", round(100 * mean(soki$wyprzedane), 1), "%\n")
cat("Średnia sprzedaż:", round(mean(soki$sprzedaz), 1), " średni prawdziwy popyt:", round(mean(soki$popyt), 1),
    " (sprzedaż zaniża popyt o", round(100 * (1 - mean(soki$sprzedaz) / mean(soki$popyt)), 1), "%)\n")
cat("Niezaspokojony popyt w roku:", sum(soki$popyt - soki$sprzedaz), "butelek\n")
aggregate(cbind(wyprzedane = 100 * wyprzedane, sprzedaz, popyt) ~ promocja, data = soki, FUN = function(x) round(mean(x), 1))

# Plik CSV: kolumna popyt_prawdziwy istnieje tylko w symulacji
csv <- soki[, c("data", "sklep", "dzien", "temperatura", "promocja", "brak_wczoraj", "dostawa", "sprzedaz",
                "wyprzedane", "godzina", "popyt")]
names(csv)[names(csv) == "popyt"] <- "popyt_prawdziwy"
write.csv(csv, "braki-towaru-soki-sprzedaz-dzienna.csv", row.names = FALSE)
Wynik w R
Dni sklepowe: 9125  sklepy: 25
Dni z wyprzedanym sokiem: 1984 = 21.7 %
Średnia sprzedaż: 46.8  średni prawdziwy popyt: 49.3  (sprzedaż zaniża popyt o 5.1 %)
Niezaspokojony popyt w roku: 23087 butelek
  promocja wyprzedane sprzedaz popyt
1        0       19.7     45.0  47.1
2        1       37.7     60.6  66.5
2. Schemat „popyt – zapas – sprzedaż” (Rysunek 1)
R
# Przepis 2. Schemat „popyt – zapas – sprzedaż” z liczbami z przykładu: Rysunek 1
pelne <- round(100 * mean(soki$wyprzedane == 0), 1); puste <- round(100 * mean(soki$wyprzedane), 1)
pr <- soki[soki$sklep == "S09" & soki$data == as.Date("2025-07-11"), ]   # jeden dzień z pustą półką
pp <- soki[soki$sklep == "S09" & soki$data == as.Date("2025-07-07"), ]   # jeden dzień z towarem do końca
pr[, c("data", "sklep", "dzien", "temperatura", "dostawa", "sprzedaz", "popyt", "godzina")]
pp[, c("data", "sklep", "dzien", "temperatura", "dostawa", "sprzedaz", "popyt", "godzina")]

pola <- data.frame(
  x = c(0, 1, 2, 0.5, 1.5, 1), y = c(2, 2, 2, 1, 1, 0),
  naglowek = c("Popyt", "Dostawa rano", "Sprzedaż", "Sok został do zamknięcia",
               "Półka pusta przed 20:00", "Model z cenzurowaniem"),
  tresc = c("ilu klientów chciało kupić\n(w firmie nieznany)",
            "plan: poziom sklepu × dzień\ntygodnia × 1.15 (promocja × 1.20)",
            "= mniejsza z liczb:\npopyt albo dostawa",
            paste0(pelne, "% dni sklepowych\nsprzedaż = popyt\n(np. S09, ", format(pp$data, "%d.%m"), ": ",
                   pp$sprzedaz, " z ", pp$dostawa, ")"),
            paste0(puste, "% dni: popyt ≥ sprzedaż\n(cenzurowanie prawostronne;\nS09, ",
                   format(pr$data, "%d.%m"), ": ", pr$sprzedaz, " z ", pr$dostawa, ", pusto o ",
                   sub("\\.", ":", sprintf("%.2f", floor(pr$godzina) + (pr$godzina %% 1) * 0.6)), ")"),
            "dni pełne: „popyt = tyle”\ndni puste: „popyt co najmniej tyle”\n→ szacuje rozkład popytu"),
  typ = c("a", "b", "b", "b", "c", "a"))
strzalki <- data.frame(x = c(0.33, 1.33, 1.85, 2.15, 0.5, 1.5), y = c(2, 2, 1.62, 1.62, 0.62, 0.62),
                       xend = c(0.67, 1.67, 0.8, 1.6, 0.85, 1.15), yend = c(2, 2, 1.38, 1.38, 0.38, 0.38))
strzalki$x[3:4] <- c(1.95, 2.05)
p1 <- ggplot() +
  geom_segment(data = strzalki, aes(x = x, y = y, xend = xend, yend = yend), colour = "grey40", linewidth = 0.7,
               arrow = arrow(length = unit(0.18, "cm"), type = "closed")) +
  geom_rect(data = pola, aes(xmin = x - 0.42, xmax = x + 0.42, ymin = y - 0.36, ymax = y + 0.36,
                             fill = typ, colour = typ), linewidth = 0.8) +
  geom_text(data = pola, aes(x = x, y = y + 0.24, label = naglowek), fontface = "bold", size = 4.3,
            colour = "#0f1d3a") +
  geom_text(data = pola, aes(x = x, y = y + 0.07, label = tresc), vjust = 1, size = 3.6, lineheight = 1.0,
            colour = "grey15") +
  scale_fill_manual(values = c(a = "#F2F7FB", b = "#F7F7F7", c = "#FDF1E9"), guide = "none") +
  scale_colour_manual(values = c(a = "#0072B2", b = "grey45", c = "#D55E00"), guide = "none") +
  coord_cartesian(xlim = c(-0.45, 2.45), ylim = c(-0.4, 2.4), expand = FALSE) +
  labs(title = "Sprzedaż = mniejsza z dwóch liczb: popytu i dostawy", x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("braki-towaru-schemat-popyt-zapas-sprzedaz.svg", p1, width = 10, height = 6)
Wynik w R
           data sklep dzien temperatura dostawa sprzedaz popyt godzina
3112 2025-07-11   S09    pt        19.4     109      109   157   16.25
           data sklep dzien temperatura dostawa sprzedaz popyt godzina
3108 2025-07-07   S09   pon        15.8      91       89    89      NA
3. Sprzedaż ucięta dostawą (Rysunek 2)
R
# Przepis 3. Sprzedaż ucięta dostawą w jednym sklepie i odsetek pustych półek: Rysunek 2
library(patchwork)
lato <- subset(soki, sklep == "S09" & data >= as.Date("2025-06-02") & data <= as.Date("2025-07-27"))
cat("S09, 2.06–27.07: dni z pustą półką", sum(lato$wyprzedane), "z", nrow(lato),
    "; średnia sprzedaż", round(mean(lato$sprzedaz), 1), "; średni prawdziwy popyt", round(mean(lato$popyt), 1), "\n")

soki$temp_klasa <- cut(soki$temperatura, c(-Inf, 5, 10, 15, 20, Inf),
                       labels = c("< 5 °C", "5–10 °C", "10–15 °C", "15–20 °C", "≥ 20 °C"))
odsetek <- aggregate(wyprzedane ~ temp_klasa + promocja, data = soki, FUN = mean)
odsetek$n <- aggregate(wyprzedane ~ temp_klasa + promocja, data = soki, FUN = length)$wyprzedane
odsetek$proc <- 100 * odsetek$wyprzedane
odsetek$promocja <- factor(odsetek$promocja, 0:1, c("bez promocji", "promocja"))
print(transform(odsetek[, c("temp_klasa", "promocja", "n")], proc = round(odsetek$proc, 1)))

lato$stan <- factor(ifelse(lato$wyprzedane == 1, "półka pusta (sprzedaż = dostawa)", "sok został"),
                    c("sok został", "półka pusta (sprzedaż = dostawa)"))
pa <- ggplot(lato, aes(x = data)) +
  geom_step(aes(y = dostawa, linetype = "dostawa rano"), colour = "grey45", direction = "mid") +
  geom_segment(data = subset(lato, wyprzedane == 1), aes(xend = data, y = sprzedaz, yend = popyt),
               colour = "#D55E00", linewidth = 0.5, alpha = 0.7) +
  geom_point(aes(y = popyt, shape = "prawdziwy popyt (tylko w symulacji)"), colour = "#D55E00", size = 1.9) +
  geom_point(aes(y = sprzedaz, shape = "sprzedaż"), colour = "#0072B2", size = 1.9) +
  scale_shape_manual(NULL, values = c("prawdziwy popyt (tylko w symulacji)" = 1, "sprzedaż" = 16)) +
  scale_linetype_manual(NULL, values = c("dostawa rano" = "solid")) +
  scale_x_date(date_breaks = "1 week", date_labels = "%d.%m") +
  labs(title = "A. Sklep S09, czerwiec–lipiec 2025", x = NULL, y = "Butelki dziennie") + motyw
pb <- ggplot(odsetek, aes(x = temp_klasa, y = proc, fill = promocja)) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75) +
  geom_text(aes(label = sprintf("%.1f", proc)), position = position_dodge(width = 0.8), vjust = -0.3, size = 3.5) +
  scale_fill_manual(NULL, values = c("bez promocji" = "#56B4E9", "promocja" = "#D55E00")) +
  scale_y_continuous(limits = c(0, 100), expand = expansion(mult = c(0, 0.02))) +
  labs(title = "B. Odsetek dni z pustą półką (25 sklepów)", x = "Temperatura w ciągu dnia",
       y = "% dni sklepowych") + motyw
p2 <- pa / pb + plot_layout(heights = c(1.15, 1))
p2   # zapis: ggsave("braki-towaru-sprzedaz-ucieta-dostawa.svg", p2, width = 10, height = 8)
Wynik w R
S09, 2.06–27.07: dni z pustą półką 25 z 56 ; średnia sprzedaż 89.5 ; średni prawdziwy popyt 101.7
   temp_klasa     promocja    n proc
1      < 5 °C bez promocji 2675  4.4
2     5–10 °C bez promocji 1350 10.4
3    10–15 °C bez promocji 1375 19.1
4    15–20 °C bez promocji 1950 36.0
5     ≥ 20 °C bez promocji  725 50.3
6      < 5 °C     promocja  175  9.1
7     5–10 °C     promocja  150 21.3
8    10–15 °C     promocja  275 36.4
9    15–20 °C     promocja  275 50.2
10    ≥ 20 °C     promocja  175 62.9
4. Trzy metody: regresja na sprzedaży, bez dni z brakiem, model z cenzurowaniem (Rysunek 3)
R
# Przepis 4. Trzy sposoby szacowania popytu: regresja na sprzedaży, regresja bez dni z brakiem, model z cenzurowaniem
library(survival)

soki$temp5 <- (soki$temperatura - 15) / 5          # temperatura: jednostka = 5 °C, zero = 15 °C
wzor <- ~ sklep + dzien + temp5 + promocja + brak_wczoraj

# 1) zwykła regresja log(sprzedaży) – sprzedaż traktowana jak popyt
m_sprzedaz <- lm(update(wzor, log(sprzedaz) ~ .), data = soki)
# 2) ta sama regresja tylko na dniach, w których soku nie zabrakło (obciążenie selekcji)
m_bez <- lm(update(wzor, log(sprzedaz) ~ .), data = subset(soki, wyprzedane == 0))
# 3) model z cenzurowaniem prawostronnym (tobit dla log-popytu = model log-normalny w survreg):
#    w dniu wyprzedanym wiemy tylko, że popyt ≥ dostawa
m_cenz <- survreg(update(wzor, Surv(log(sprzedaz), wyprzedane == 0) ~ .), data = soki, dist = "gaussian")

efekt <- function(b, se) 100 * (exp(c(b, b - 1.96 * se, b + 1.96 * se)) - 1)   # zmiana popytu w % z 95% CI
wsp <- c("promocja", "temp5", "brak_wczoraj")
tab <- do.call(rbind, lapply(list("Regresja na sprzedaży" = m_sprzedaz, "Bez dni z brakiem" = m_bez,
                                  "Model z cenzurowaniem" = m_cenz), function(m) {
  se <- sqrt(diag(vcov(m)))[wsp]
  data.frame(wspolczynnik = wsp, t(sapply(wsp, function(w) efekt(coef(m)[w], se[w]))),
             sigma = if (inherits(m, "lm")) sigma(m) else m$scale)
}))
names(tab)[2:4] <- c("efekt_proc", "dolna", "gorna")
tab$metoda <- rep(c("Regresja na sprzedaży", "Bez dni z brakiem", "Model z cenzurowaniem"), each = 3)
prawda <- data.frame(wspolczynnik = wsp, efekt_proc = 100 * (exp(c(b_promo, b_temp, b_wczoraj)) - 1))
rownames(tab) <- NULL
print(cbind(tab[, c("metoda", "wspolczynnik")], round(tab[, c("efekt_proc", "dolna", "gorna", "sigma")], 2)))
cat("Prawda: promocja +", round(prawda$efekt_proc[1], 1), "%, temperatura +", round(prawda$efekt_proc[2], 1),
    "% na 5 °C, dzień po braku ", round(prawda$efekt_proc[3], 1), "%, sigma = ", sigma, "\n", sep = "")

# Średni popyt w roku: z modelu z cenzurowaniem E(popyt) = exp(xb + σ²/2) dla każdego dnia
xb <- predict(m_cenz, type = "lp")
cat("Średnia sprzedaż:", round(mean(soki$sprzedaz), 1), " średni popyt z modelu z cenzurowaniem:",
    round(mean(exp(xb + m_cenz$scale^2 / 2)), 1), " prawdziwy:", round(mean(soki$popyt), 1), "\n")

# Rysunek 3: oszacowania efektów w trzech metodach na tle prawdy
etyk <- c(promocja = "Promocja „druga butelka −50%”", temp5 = "Temperatura: +5 °C",
          brak_wczoraj = "Dzień po pustej półce")
tab$panel <- factor(etyk[tab$wspolczynnik], etyk); prawda$panel <- factor(etyk[prawda$wspolczynnik], etyk)
tab$metoda <- factor(tab$metoda, rev(c("Regresja na sprzedaży", "Bez dni z brakiem", "Model z cenzurowaniem")))
p3 <- ggplot(tab, aes(x = efekt_proc, y = metoda, colour = metoda, shape = metoda)) +
  geom_vline(data = prawda, aes(xintercept = efekt_proc), linetype = "dashed", colour = "black") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, linewidth = 0.8, orientation = "y") +
  geom_point(size = 3) +
  geom_text(aes(label = minus(sprintf("%+.1f%%", efekt_proc))), vjust = 2.0, size = 3.6, show.legend = FALSE) +
  facet_wrap(~ panel, scales = "free_x", ncol = 3) +
  scale_colour_manual(NULL, values = kol, guide = "none") +
  scale_shape_manual(NULL, values = c("Regresja na sprzedaży" = 15, "Bez dni z brakiem" = 17,
                                      "Model z cenzurowaniem" = 16), guide = "none") +
  scale_x_continuous(breaks = scales::breaks_pretty(n = 3), labels = function(x) minus(paste0(x, "%"))) +
  labs(title = "Zmiana popytu w % (95% CI); linia przerywana – prawdziwy efekt", x = NULL, y = NULL) + motyw +
  theme(panel.spacing.x = unit(1.4, "lines"))
p3   # zapis: ggsave("braki-towaru-trzy-metody-efekty.svg", p3, width = 10, height = 4.8)
Wynik w R
                 metoda wspolczynnik efekt_proc dolna gorna sigma
1 Regresja na sprzedaży     promocja      30.31 28.54 32.10  0.21
2 Regresja na sprzedaży        temp5       9.38  9.05  9.70  0.21
3 Regresja na sprzedaży brak_wczoraj      -4.46 -5.52 -3.39  0.21
4     Bez dni z brakiem     promocja      29.02 26.91 31.17  0.20
5     Bez dni z brakiem        temp5       7.33  6.96  7.69  0.20
6     Bez dni z brakiem brak_wczoraj      -3.52 -4.73 -2.29  0.20
7 Model z cenzurowaniem     promocja      34.80 32.45 37.18  0.25
8 Model z cenzurowaniem        temp5      11.79 11.37 12.21  0.25
9 Model z cenzurowaniem brak_wczoraj      -6.02 -7.32 -4.69  0.25
Prawda: promocja +35%, temperatura +12% na 5 °C, dzień po braku -5%, sigma = 0.25
Średnia sprzedaż: 46.8  średni popyt z modelu z cenzurowaniem: 49.5  prawdziwy: 49.3
5. Symulacja 200 lat (Rysunek 4)
R
# Przepis 5. Symulacja 200 lat sprzedaży: czy obciążenie to przypadek? Rysunek 4
library(survival)
set.seed(7222)
R <- 200
sym <- t(replicate(R, {
  d <- symuluj_rok(2025); d$temp5 <- (d$temperatura - 15) / 5
  c(sprzedaz = coef(lm(update(wzor, log(sprzedaz) ~ .), data = d))[c("promocja", "temp5")],
    bez = coef(lm(update(wzor, log(sprzedaz) ~ .), data = subset(d, wyprzedane == 0)))[c("promocja", "temp5")],
    cenz = coef(survreg(update(wzor, Surv(log(sprzedaz), wyprzedane == 0) ~ .), data = d,
                        dist = "gaussian"))[c("promocja", "temp5")],
    wyprzedane = mean(d$wyprzedane))
}))
proc <- 100 * (exp(sym[, 1:6]) - 1)
podsum <- data.frame(metoda = rep(c("Regresja na sprzedaży", "Bez dni z brakiem", "Model z cenzurowaniem"), each = 2),
                     wspolczynnik = rep(c("promocja", "temp5"), 3),
                     srednia = colMeans(proc), sd = apply(proc, 2, sd),
                     prawda = 100 * (exp(rep(c(b_promo, b_temp), 3)) - 1))
podsum$obciazenie <- podsum$srednia - podsum$prawda
rownames(podsum) <- NULL
print(cbind(podsum[, 1:2], round(podsum[, 3:6], 2)))
cat("Największy błąd Monte Carlo średniej (SD / √200):", round(max(podsum$sd) / sqrt(R), 2), "pp\n")
cat("Odsetek dni z pustą półką w 200 latach: od", round(100 * min(sym[, "wyprzedane"]), 1), "do",
    round(100 * max(sym[, "wyprzedane"]), 1), "%\n")

dlugie <- data.frame(metoda = rep(rep(c("Regresja na sprzedaży", "Bez dni z brakiem", "Model z cenzurowaniem"),
                                      each = 2), each = R),
                     panel = rep(rep(c("Promocja", "Temperatura: +5 °C"), 3), each = R), efekt = as.vector(proc))
dlugie$metoda <- factor(dlugie$metoda, rev(c("Regresja na sprzedaży", "Bez dni z brakiem", "Model z cenzurowaniem")))
linie <- data.frame(panel = c("Promocja", "Temperatura: +5 °C"), prawda = 100 * (exp(c(b_promo, b_temp)) - 1))
p4 <- ggplot(dlugie, aes(x = efekt, y = metoda, colour = metoda, shape = metoda)) +
  geom_vline(data = linie, aes(xintercept = prawda), linetype = "dashed") +
  geom_violin(aes(fill = metoda), alpha = 0.25, scale = "width", width = 0.7) +
  geom_boxplot(width = 0.15, outlier.size = 1.2, fill = "white") +
  stat_summary(fun = mean, geom = "point", size = 4.2, colour = "black", shape = 23, fill = "white") +
  facet_wrap(~ panel, scales = "free_x") +
  scale_colour_manual(NULL, values = kol, guide = "none") + scale_fill_manual(NULL, values = kol, guide = "none") +
  scale_shape_manual(NULL, values = c("Regresja na sprzedaży" = 15, "Bez dni z brakiem" = 17,
                                      "Model z cenzurowaniem" = 16), guide = "none") +
  scale_x_continuous(labels = function(x) paste0(x, "%")) +
  labs(title = "200 symulowanych lat: oszacowania efektów (romb – średnia)", x = "Zmiana popytu", y = NULL) + motyw
p4   # zapis: ggsave("braki-towaru-symulacja-200-lat.svg", p4, width = 10, height = 4.8)
Wynik w R
                 metoda wspolczynnik srednia   sd prawda obciazenie
1 Regresja na sprzedaży     promocja   30.42 0.84     35      -4.58
2 Regresja na sprzedaży        temp5    9.66 0.17     12      -2.34
3     Bez dni z brakiem     promocja   28.71 1.03     35      -6.29
4     Bez dni z brakiem        temp5    7.66 0.19     12      -4.34
5 Model z cenzurowaniem     promocja   35.11 1.20     35       0.11
6 Model z cenzurowaniem        temp5   12.09 0.22     12       0.09
Największy błąd Monte Carlo średniej (SD / √200): 0.08 pp
Odsetek dni z pustą półką w 200 latach: od 19.8 do 22.4 %
6. Godzina wyczerpania i utracona sprzedaż (Rysunek 5)
R
# Przepis 6. Godzina wyczerpania jako dodatkowa informacja i utracona sprzedaż: Rysunek 5
puste <- subset(soki, wyprzedane == 1)
# a) model z cenzurowaniem: oczekiwany popyt pod warunkiem, że popyt ≥ dostawa (rozkład log-normalny)
m <- predict(m_cenz, newdata = puste, type = "lp"); s <- m_cenz$scale; c0 <- log(puste$dostawa)
puste$z_modelu <- exp(m + s^2 / 2) * pnorm((m + s^2 - c0) / s) / pnorm((m - c0) / s)
# b) godzina wyczerpania: dostawa / odsetek dziennego ruchu, który zwykle przychodzi do tej godziny
#    (średni profil godzinowy z dni bez braków; w symulacji – rozkład beta(2.2, 1.8) na godzinach 8–20)
puste$udzial_do_godziny <- pbeta((puste$godzina - 8) / 12, 2.2, 1.8)
puste$z_godziny <- puste$dostawa / puste$udzial_do_godziny
puste$pora <- cut(puste$godzina, c(8, 16, 18, 20.01), right = FALSE,
                  labels = c("przed 16:00", "16:00–17:45", "od 18:00"))
blad <- function(x) c(sredni_blad_proc = mean(100 * (x / puste$popyt - 1)),
                      MAE = mean(abs(x - puste$popyt)))
print(round(rbind(sprzedaz = blad(puste$sprzedaz), model_z_cenzurowaniem = blad(puste$z_modelu),
                  z_godziny_wyczerpania = blad(puste$z_godziny)), 1))
print(table(puste$pora))
print(round(sapply(split(puste, puste$pora), function(d)
  c(MAE_model = mean(abs(d$z_modelu - d$popyt)), MAE_godzina = mean(abs(d$z_godziny - d$popyt)),
    mediana_bledu_proc_model = median(100 * (d$z_modelu / d$popyt - 1)),
    mediana_bledu_proc_godzina = median(100 * (d$z_godziny / d$popyt - 1)))), 1))
cat("Udział dziennego ruchu do 16:15:", round(100 * pbeta((16.25 - 8) / 12, 2.2, 1.8), 1), "%\n")

# Utracona sprzedaż w 2025 r. (butelki): prawda, model z cenzurowaniem, i gdy 30% klientów bierze inny smak
utracone_model <- sum(puste$z_modelu - puste$dostawa)
cat("Niezaspokojony popyt – prawda:", sum(puste$popyt - puste$dostawa), " model z cenzurowaniem:",
    round(utracone_model), "butelek\n")
cat("Jeśli 30% z nich kupiło inny smak, firma straciła", round(0.7 * utracone_model), "butelek, a",
    round(0.3 * utracone_model), "butelek zawyżyło sprzedaż innych smaków\n")

dl <- rbind(data.frame(metoda = "Model z cenzurowaniem", godzina = puste$godzina,
                       blad = 100 * (puste$z_modelu / puste$popyt - 1)),
            data.frame(metoda = "Godzina wyczerpania", godzina = puste$godzina,
                       blad = 100 * (puste$z_godziny / puste$popyt - 1)))
dl$metoda <- factor(dl$metoda, c("Model z cenzurowaniem", "Godzina wyczerpania"))
p5 <- ggplot(dl, aes(x = godzina, y = blad)) +
  geom_hline(yintercept = 0, colour = "black") +
  geom_boxplot(aes(group = cut_width(godzina, 1, boundary = 8)), width = 0.7, outlier.shape = NA,
               fill = "#F2F7FB", colour = "#0072B2", coef = 0, orientation = "x") +
  facet_wrap(~ metoda) +
  scale_x_continuous(breaks = seq(8, 20, 2), labels = function(x) paste0(x, ":00")) +
  scale_y_continuous(labels = function(x) minus(paste0(x, "%"))) +
  coord_cartesian(ylim = c(-40, 40)) +
  labs(title = "Błąd oszacowania popytu w dniach z pustą półką",
       subtitle = "Pudełka: mediana i kwartyle błędu w przedziałach godzinnych (8:00–9:00, 9:00–10:00, …)",
       x = "Godzina, o której skończył się sok", y = "Oszacowanie / prawdziwy popyt − 1") + motyw
p5   # zapis: ggsave("braki-towaru-godzina-wyczerpania.svg", p5, width = 10, height = 5.2)
Wynik w R
                      sredni_blad_proc  MAE
sprzedaz                         -14.2 11.6
model_z_cenzurowaniem              2.7  8.2
z_godziny_wyczerpania              0.9  3.2

przed 16:00 16:00–17:45    od 18:00
        148         831        1005
                           przed 16:00 16:00–17:45 od 18:00
MAE_model                         21.4         6.4      7.7
MAE_godzina                       11.7         4.0      1.3
mediana_bledu_proc_model         -21.3        -3.8     12.4
mediana_bledu_proc_godzina        11.1         1.2     -0.1
Udział dziennego ruchu do 16:15: 69.4 %
Niezaspokojony popyt – prawda: 23087  model z cenzurowaniem: 24405 butelek
Jeśli 30% z nich kupiło inny smak, firma straciła 17084 butelek, a 7322 butelek zawyżyło sprzedaż innych smaków
7. Dostawa z 80. centyla popytu – sprawdzenie na roku 2026 (Rysunek 6)
R
# Przepis 7. Dostawa z kwantyla popytu, nie sprzedaży: sprawdzenie na nowym roku (2026): Rysunek 6
# Reguła: dostawa = 80. centyl rozkładu popytu z modelu (pusta półka najwyżej w 1 dniu na 5).
# Uproszczenie: prognoza temperatury na jutro jest trafna.
regula_z_modelu <- function(b, s, centyl = 0.8) {
  b_sklep <- c(0, b[paste0("sklep", names(sklep_poziom)[-1])]); b_dzien <- c(0, b[paste0("dzien", dni_tyg[-1])])
  function(k, brak_wczoraj) {
    lp <- b[["(Intercept)"]] + b_sklep + b_dzien[k$dzien] + b[["temp5"]] * (k$temperatura - 15) / 5 +
      b[["promocja"]] * k$promocja + b[["brak_wczoraj"]] * brak_wczoraj
    ceiling(exp(lp + qnorm(centyl) * s))
  }
}
reguly <- list("Obecny plan" = plan_obecny,
               "Regresja na sprzedaży" = regula_z_modelu(coef(m_sprzedaz), sigma(m_sprzedaz)),
               "Model z cenzurowaniem" = regula_z_modelu(coef(m_cenz), m_cenz$scale))
wyniki <- do.call(rbind, lapply(names(reguly), function(r) {
  set.seed(7223)                       # ten sam rok 2026 (pogoda i klienci) dla każdej reguły
  d <- symuluj_rok(2026, reguly[[r]])
  data.frame(regula = r, puste_polki = 100 * mean(d$wyprzedane),
             utracony_popyt = 100 * sum(d$popyt - d$sprzedaz) / sum(d$popyt),
             niesprzedane = 100 * sum(d$dostawa - d$sprzedaz) / sum(d$dostawa),
             dostawa_dzien = mean(d$dostawa), sprzedaz_dzien = mean(d$sprzedaz))
}))
print(cbind(regula = wyniki$regula, round(wyniki[, -1], 1)))

dl <- data.frame(regula = rep(wyniki$regula, 3),
                 miara = rep(c("Dni z pustą półką", "Utracony popyt", "Niesprzedane butelki"), each = 3),
                 proc = c(wyniki$puste_polki, wyniki$utracony_popyt, wyniki$niesprzedane))
dl$miara <- factor(dl$miara, c("Dni z pustą półką", "Utracony popyt", "Niesprzedane butelki"))
dl$regula <- factor(dl$regula, rev(names(reguly)))
p6 <- ggplot(dl, aes(x = proc, y = regula, fill = regula)) +
  geom_col(width = 0.65) +
  geom_vline(data = data.frame(miara = factor("Dni z pustą półką", levels(dl$miara)), x = 20),
             aes(xintercept = x), linetype = "dashed") +
  geom_text(aes(label = sprintf("%.1f%%", proc)), hjust = -0.15, size = 3.8) +
  facet_wrap(~ miara, scales = "free_x") +
  scale_fill_manual(NULL, values = kol) +
  scale_x_continuous(expand = expansion(mult = c(0, 0.3)), breaks = scales::breaks_pretty(n = 3),
                     labels = function(x) paste0(x, "%")) +
  labs(title = "Rok 2026: dostawa z 80. centyla popytu (cel: pusta półka w 20% dni)", x = NULL, y = NULL) +
  motyw + theme(legend.position = "none", panel.spacing.x = unit(1.2, "lines"))
p6   # zapis: ggsave("braki-towaru-dostawa-z-kwantyla.svg", p6, width = 10, height = 4.6)
Wynik w R
                 regula puste_polki utracony_popyt niesprzedane dostawa_dzien sprzedaz_dzien
1           Obecny plan        20.5            4.9         23.0          60.2           46.4
2 Regresja na sprzedaży        28.0            5.5         16.0          54.7           46.0
3 Model z cenzurowaniem        19.2            3.3         20.5          59.4           47.2
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("regresja na sprzedaży – model z cenzurowaniem" = c("#D55E00", "#0072B2"),
             "bez dni z brakiem – model z cenzurowaniem" = c("#E69F00", "#0072B2"),
             "regresja na sprzedaży – bez dni z brakiem" = c("#D55E00", "#E69F00"),
             "bez promocji – promocja" = c("#56B4E9", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                              widzenie_typowe deuteranopia protanopia
regresja na sprzedaży – model z cenzurowaniem           114.6        108.3       91.9
bez dni z brakiem – model z cenzurowaniem               120.2        121.5      109.3
regresja na sprzedaży – bez dni z brakiem                33.4         18.4       24.9
bez promocji – promocja                                 113.6        101.1       89.0
czerwony – zielony (do unikania)                        121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i regresja liniowa (lm) – pakiet stats i funkcje podstawowej instalacji R; model z cenzurowaniem – funkcja survreg z pakietu survival (ten sam model daje AER::tobit). Rysunki wykonano w pakiecie ggplot2 (osie: pakiet scales), panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Popyt przechodzi na inne smaki. Część klientów, którzy nie dostali jabłka z imbirem, kupi inny sok. Wtedy sprzedaż produktu z brakiem jest cenzurowana, a sprzedaż zastępców – zawyżona (Anupindi i in., 1998). Jeśli założymy, że 30% niezaspokojonych klientów wybrało inny smak, firma straciła 17 084 butelki, a 7322 butelki „dopisały się” do popytu innych smaków. Vulcano i in. (2012) szacują w takiej sytuacji popyt pierwotny (pierwszego wyboru), łącząc model wyboru produktu z modelem napływu klientów. Zwykłe sumowanie popytów z osobnych modeli liczy tych klientów dwa razy.
- Pusta półka zniechęca następnego dnia. W naszych danych popyt dzień po braku był niższy o 5% (model: −6.0%, 95% CI [−7.3, −4.7]). Brak towaru kosztuje więc także w przyszłości (Anderson i in., 2006), a „popyt” zależy od dotychczasowej polityki dostaw. Dodaj do modelu zmienną „brak wczoraj”, zamiast udawać, że dni są niezależne.
- Założenie o rozkładzie. Część cenzurowana jest odtwarzana z kształtu rozkładu. Sprawdź reszty na dniach pełnych i porównaj wyniki z rozkładem normalnym albo ujemnym dwumianowym; przy małych liczbach sztuk (kilka butelek dziennie) logarytm zawodzi.
- Cenzurowanie ukryte w danych. „Sprzedaż = dostawa” bywa zbiegiem okoliczności (ostatni klient kupił ostatnią butelkę), a towar bywa na zapleczu, nie na półce. Ustal z działem logistyki, co znaczy flaga braku.
- Ten wpis nie zastąpi eksperymentu. Efekt promocji jest tu dobrze określony, bo promocje obejmują całą sieć w ustalonych tygodniach. Gdy promocje wybiera się w odpowiedzi na sprzedaż, problem przyczynowości zostaje (eksperyment z dawkami – patrz eksperyment z liczbą powiadomień push; skupienie przy progu – próg darmowej dostawy).
Najczęstsze pytania
Dlaczego sprzedaż nie jest popytem?
Sprzedaż to mniejsza z dwóch liczb: popytu i zapasu. W dniu, w którym towar się skończył, kasa pokazuje sprzedaż równą dostawie, a klienci, którzy odeszli z niczym, nigdzie nie są zapisani. Taka obserwacja jest cenzurowana prawostronnie: wiemy tylko, że popyt był co najmniej równy sprzedaży.
Czy można po prostu usunąć dni, w których zabrakło towaru?
Nie. Usuwając je, zostawiasz tylko dni z popytem niższym niż dostawa, czyli robisz z cenzurowania ucięcie. W przykładzie efekt promocji spadł wtedy do +29.0%, a temperatury do +7.3% na 5 °C (prawda: 35% i 12%) – gorzej niż w zwykłej regresji na sprzedaży.
Jak oszacować popyt przy brakach towaru w R?
Użyj regresji z cenzurowaniem prawostronnym: survreg(Surv(log(sprzedaz), wyprzedane == 0) ~ predyktory, dist = "gaussian") z pakietu survival (ten sam model daje AER::tobit z argumentem right). Dni bez braku wnoszą do wiarygodności gęstość, a dni z brakiem – prawdopodobieństwo, że popyt był co najmniej równy dostawie.
Co daje godzina, o której skończył się towar?
Pozwala odróżnić dzień, w którym towar zniknął w południe, od dnia, w którym zabrakło go tuż przed zamknięciem. W przykładzie oszacowanie popytu z godziny wyczerpania miało średni błąd bezwzględny 3.2 butelki wobec 8.2 z samego modelu z cenzurowaniem. Przy brakach po 18:00 błąd spadł z 7.7 do 1.3 butelki, przy brakach przed 16:00 – z 21.4 do 11.7.
Ile zamawiać, gdy w danych są braki towaru?
Zamawiaj z kwantyla rozkładu popytu, a nie sprzedaży. W symulacji kolejnego roku dostawa równa 80. centylowi z modelu z cenzurowaniem dała pustą półkę w 19.2% dni (cel 20%), a 80. centyl z regresji na sprzedaży – w 28.0% dni, bo zaniżona jest zarówno średnia, jak i rozrzut.
Powiązane hasła
Przeczytaj też
Model gazeciarza i zapas bezpieczeństwa
Sieć piekarni: kwantyl krytyczny, sprzedaż ≠ popyt w dniach wyprzedanych, zapas mąki z błędów prognozy, poziom obsługi α i β – rysunki i kod R.
Czytaj →PoradnikEfekt sufitu i model Tobita
Cenzurowanie czy prawdziwe maksimum, Tobit w R z progiem górnym, trzy efekty z jednego współczynnika, założenia w symulacji i alternatywy.
Czytaj →PoradnikPrognoza sprzedaży: sezonowość, święta i promocje
Sklep z zabawkami, trzy lata dziennych zamówień: STL, ETS i ARIMA z regresorami, MAE i MAPE na teście, przeciek danych i prognoza z przedziałami w R.
Czytaj →Masz dane sprzedaży z brakami towaru?
Pomożemy rozpoznać dni z cenzurowaniem, dobrać model popytu, policzyć utraconą sprzedaż i opisać wyniki tak, żebyś umiał(a) je obronić w pracy.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Anderson, E. T., Fitzsimons, G. J., & Simester, D. (2006). Measuring and mitigating the costs of stockouts. Management Science, 52(11), 1751–1763. https://doi.org/10.1287/mnsc.1060.0577
- Anupindi, R., Dada, M., & Gupta, S. (1998). Estimation of consumer demand with stock-out based substitution: An application to vending machine products. Marketing Science, 17(4), 406–423. https://doi.org/10.1287/mksc.17.4.406
- Conrad, S. A. (1976). Sales data and the estimation of demand. Journal of the Operational Research Society, 27(1), 123–127. https://doi.org/10.1057/jors.1976.13
- Nahmias, S. (1994). Demand estimation in lost sales inventory systems. Naval Research Logistics, 41(6), 739–757. https://doi.org/10.1002/1520-6750(199410)41:6<739::aid-nav3220410605>3.0.co;2-a
- Tobin, J. (1958). Estimation of relationships for limited dependent variables. Econometrica, 26(1), 24–36. https://doi.org/10.2307/1907382
- Vulcano, G., van Ryzin, G., & Ratliff, R. (2012). Estimating primary demand for substitutable products from sales transaction data. Operations Research, 60(2), 313–334. https://doi.org/10.1287/opre.1110.1012 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{anderson2006measuring, author={Anderson, Eric T. and Fitzsimons, Gavan J. and Simester, Duncan}, title={{Measuring and mitigating the costs of stockouts}}, journal={Management Science}, year={2006}, volume={52}, number={11}, pages={1751--1763}, doi={10.1287/mnsc.1060.0577}}@article{anupindi1998estimation, author={Anupindi, Ravi and Dada, Maqbool and Gupta, Sachin}, title={{Estimation of consumer demand with stock-out based substitution: An application to vending machine products}}, journal={Marketing Science}, year={1998}, volume={17}, number={4}, pages={406--423}, doi={10.1287/mksc.17.4.406}}@article{conrad1976sales, author={Conrad, S. A.}, title={{Sales data and the estimation of demand}}, journal={Journal of the Operational Research Society}, year={1976}, volume={27}, number={1}, pages={123--127}, doi={10.1057/jors.1976.13}}@article{nahmias1994demand, author={Nahmias, Steven}, title={{Demand estimation in lost sales inventory systems}}, journal={Naval Research Logistics}, year={1994}, volume={41}, number={6}, pages={739--757}, doi={10.1002/1520-6750(199410)41:6<739::aid-nav3220410605>3.0.co;2-a}}@article{tobin1958estimation, author={Tobin, James}, title={{Estimation of relationships for limited dependent variables}}, journal={Econometrica}, year={1958}, volume={26}, number={1}, pages={24--36}, doi={10.2307/1907382}}@article{vulcano2012estimating, author={Vulcano, Gustavo and van Ryzin, Garrett and Ratliff, Richard}, title={{Estimating primary demand for substitutable products from sales transaction data}}, journal={Operations Research}, year={2012}, volume={60}, number={2}, pages={313--334}, doi={10.1287/opre.1110.1012}}