Przykład: 40 000 zamówień herbat liściastych
Fikcyjny sklep internetowy z herbatami liściastymi sprzedaje herbaty w opakowaniach 50–250 g, akcesoria do parzenia i saszetki próbne po 9 zł. Dostawa kosztuje klienta 14.90 zł, chyba że koszyk osiągnie próg darmowej dostawy. Od stycznia do kwietnia próg wynosił 99 zł, od maja – 149 zł. Dział marketingu ma 40 372 zamówienia z roku: 12 987 z okresu progu 99 zł i 27 385 z okresu progu 149 zł. Pytanie biznesowe: ilu klientów dokłada produkty, żeby nie płacić za dostawę, i czy próg 149 zł się opłaca – a może lepszy byłby 129 albo 169 zł?
Odpowiedź da się wyczytać z samego histogramu wartości koszyków. Jeśli klienci reagują na próg, tuż nad nim pojawia się skupienie (ang. bunching), a tuż pod nim – dziura. Metodę bunching rozwinięto w ekonomii podatków, gdzie liczy się osoby „zatrzymujące” dochód tuż przy progu skali (Saez, 2010). Dziś stosuje się ją też do cen w handlu i innych sytuacji z wyraźnym progiem (Kleven, 2016). Mediana koszyka wynosi 89.34 zł, a średnia 100.52 zł, więc próg 149 zł leży daleko w prawym ogonie rozkładu.
Dane są fikcyjne i znamy prawdę. Ręcznie ustaliliśmy: rozkład koszyków, które klient zamierzał złożyć (lognormalny, mediana 88 zł); odsetek klientów w ogóle reagujących na próg (65%); ich gotowość do dopłaty (rozkład wykładniczy, średnio 12 zł); przekroczenie progu po dołożeniu produktu (średnio 6 zł); saszetkę próbną jako częsty „dobijacz” koszyka; zwroty (5% zamówień zwraca część koszyka, a dołożone produkty wracają w 20% zamówień). W danych wiemy więc, który koszyk naprawdę dociągnięto: przy progu 149 zł było ich 834 (3.0% zamówień). Parametrów danych ani ziarna 723 nie zmienialiśmy po pierwszym uruchomieniu. Zmieniliśmy natomiast dwa wybory analizy – opisujemy je przy rysunku 5 i przy kodzie. Dane pobierzesz jako prog-dostawy-herbaty-zamowienia.csv.
Rysunek 1: jak czytać histogram przy progu
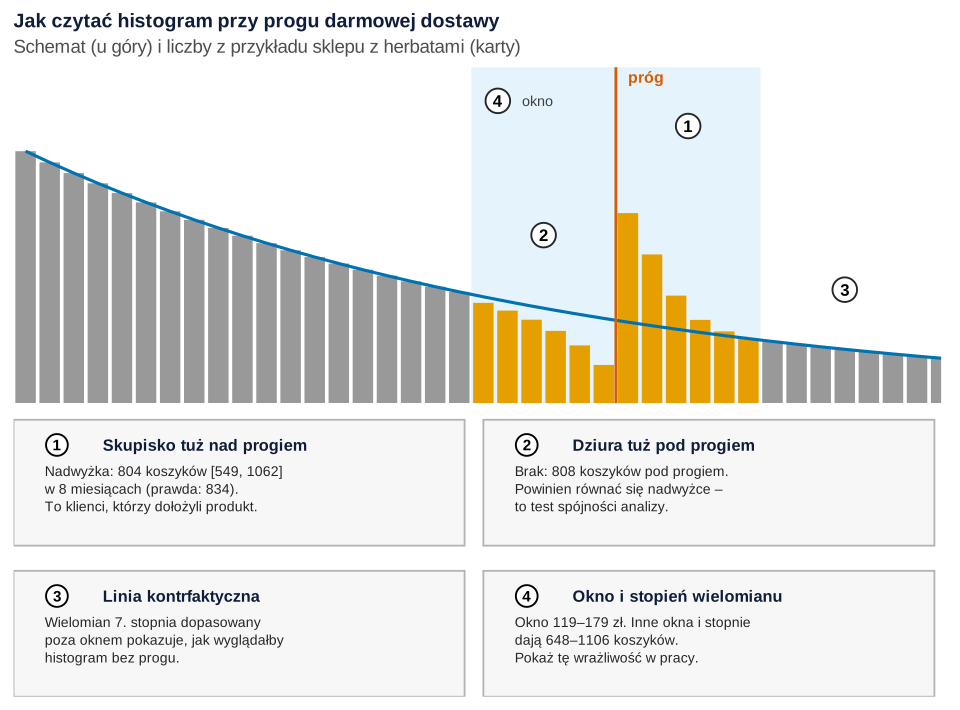
Co widać. Bez progu histogram koszyków byłby gładki (niebieska linia). Próg „zabiera” część koszyków spod siebie (dziura, karta 2) i „odkłada” je tuż nad sobą (skupisko, karta 1). Rozkładu bez progu nie widzimy. Szacujemy go z kształtu histogramu poza oknem wokół progu (karta 3). To ten sam pomysł co w modelu potencjalnych wyników: porównujemy to, co się stało, z tym, co stałoby się bez progu.
Jak może zmylić. Wynik zależy od tego, gdzie postawisz granice okna i jak giętka jest linia (karta 4). Dlatego zawsze pokazuj kilka wariantów, a nie jeden najładniejszy.
Rysunek 2: skupienie i rozkład kontrfaktyczny
Metoda bunching w czterech krokach, słowami (Kleven, 2016):
- Policz koszyki w wąskich przedziałach – tu po 5 zł, tak by próg 149 zł był granicą przedziału: [144, 149), [149, 154) itd.
- Wyznacz okno wokół progu, w którym próg zmienia zachowanie: tu od 119 do 179 zł (30 zł pod i nad progiem).
- Dopasuj wielomian (tu 7. stopnia) do liczby koszyków w przedziałach poza oknem i przedłuż go do okna. To rozkład kontrfaktyczny – „histogram bez progu”.
- Porównaj: nad progiem suma (liczba koszyków − linia) to nadwyżka, pod progiem suma (linia − liczba koszyków) to brak. Jeśli klienci tylko przesuwają koszyki przez próg, oba wyniki powinny być podobne.
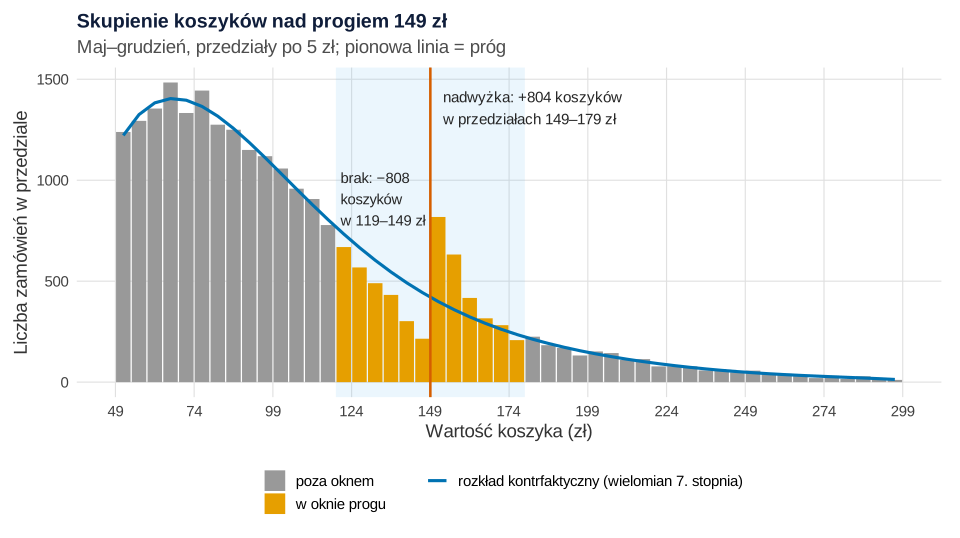
set.seed(723)).Co widać. W przedziale [149, 154) jest 818 zamówień, a linia kontrfaktyczna przewiduje 399. W przedziale tuż pod progiem [144, 149) jest 215 zamówień zamiast 443. Nadwyżka nad progiem wynosi 804 koszyki, brak pod progiem – 808. Wyniki są zgodne ze sobą i bliskie prawdzie (834). Nadwyżka leży średnio 6.2 zł nad progiem (prawda: 6.1 zł), więc klienci dokładają niewiele ponad to, czego brakuje.
Jak może zmylić. Ile wart jest jeden dociągnięty koszyk, szacujemy jako odległość między środkiem ciężkości nadwyżki i braku: 17.8 zł. Prawdziwy średni dodatek to 21.3 zł. Okno sięga tylko 30 zł pod próg, a część klientów dociągnęła koszyk z większej odległości. Skupienie to też nie to samo co skok w regresji nieciągłej (RDD). W RDD gromadzenie się obserwacji przy progu jest sygnałem manipulacji, który podważa analizę (McCrary, 2008). W metodzie bunching to właśnie skupienie jest mierzonym efektem.
Zdanie do Wyników:
Rysunek 3: próg 99 zł, potem 149 zł
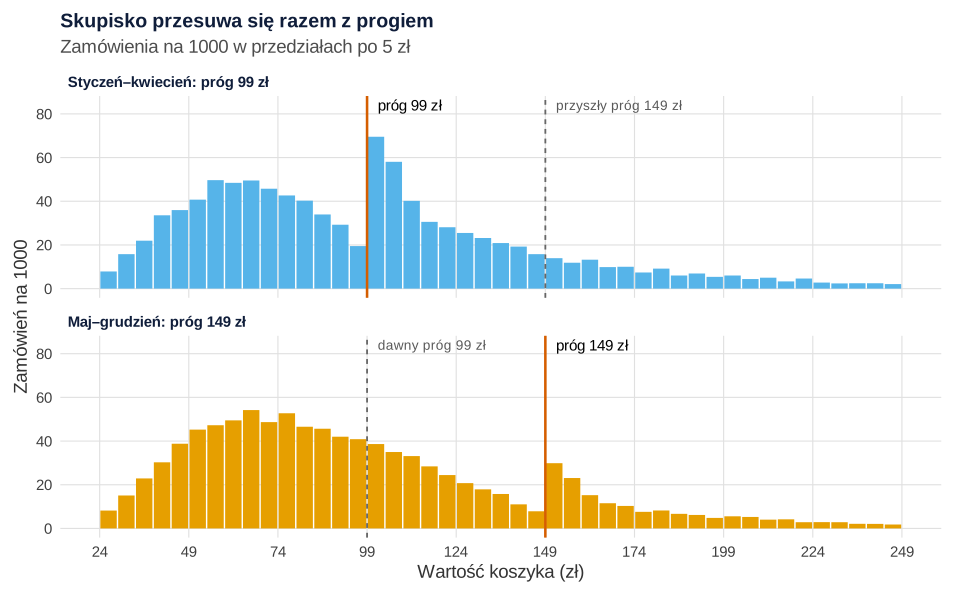
Co widać. Skupisko przesuwa się razem z progiem. Przy progu 99 zł przedział [99, 104) zawiera 7.0% zamówień, a po zmianie progu – 3.9%. Przy 149 zł jest odwrotnie: przedział [149, 154) urósł z 1.4% do 3.0%, a przedział tuż pod progiem zmalał z 1.6% do 0.8%. Ta sama metoda dla progu 99 zł daje nadwyżkę 717 koszyków i brak 945 (prawda: 875). To 58.0 dociągniętych koszyków na 1000 zamówień w zakresie analizy, a przy progu 149 zł – 33.6. Niższy próg leży bliżej typowego koszyka, więc łatwiej do niego dociągnąć.
Jak może zmylić. To porównanie „przed i po”, czyli schemat quasi-eksperymentalny. Między styczniem a majem mogły się zmienić też sezon, oferta i klienci. Mocnym argumentem jest jednak to, że skupisko „wędruje” dokładnie za progiem: w maju znika przy 99 zł i pojawia się przy 149 zł. Przy progu 99 zł nadwyżka i brak różnią się bardziej (717 i 945), bo próg leży blisko szczytu rozkładu, gdzie wielomian trudniej dopasować. Ten zakres dopasowania (od 34 zł) wybraliśmy po porównaniu kilku wariantów.
Rysunek 4: ile koszyków dociągnięto – przedział z bootstrapu
Liczba 804 pochodzi z jednej próby zamówień. Żeby ocenić niepewność, losujemy ze zwracaniem 27 385 zamówień, liczymy histogram i całą procedurę od nowa – 500 razy. To bootstrap (Efron, 1979). Granice 2.5% i 97.5% wyników to 95% przedział ufności. Przy okazji z braku pod progiem odczytujemy, jaki odsetek klientów dokłada przy danej luce do progu.
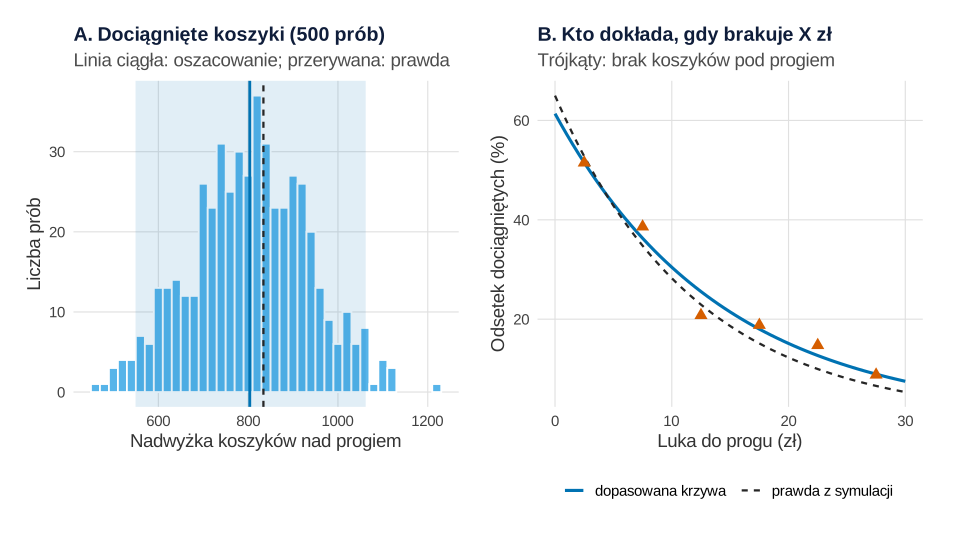
set.seed(7231)).Co widać. Dociągniętych koszyków było 804, 95% CI [549, 1062], czyli 2.9% zamówień. Przedział obejmuje prawdę (834), ale jest szeroki: od około 70 do 130 koszyków miesięcznie. Średni dodatek to 17.8 zł [15.7, 19.5], a dodatkowa wartość koszyków – 1791 zł miesięcznie [1148, 2509] (prawda: 2221 zł). Panel B pokazuje, kto dokłada. Gdy brakuje 2.5 zł, dokłada około połowy klientów; gdy brakuje 27.5 zł – około 9%. Dopasowana krzywa ma postać odsetek = π · exp(−luka / λ), z π = 0.61 [0.50, 0.71] (prawda 0.65) i λ = 14.3 zł [9.5, 19.5] (prawda 12 zł).
Jak może zmylić. Bootstrap mierzy tylko losowość próby. Nie obejmuje niepewności z wyboru okna i stopnia wielomianu (rysunek 5). Przedział dla wartości dodatku jest dodatkowo przesunięty w dół, bo okno nie łapie dalekich dopłat. Prawdziwe 2221 zł mieści się w nim tylko dlatego, że jest szeroki.
Zdanie do Wyników:
Rysunek 5: okno i stopień wielomianu
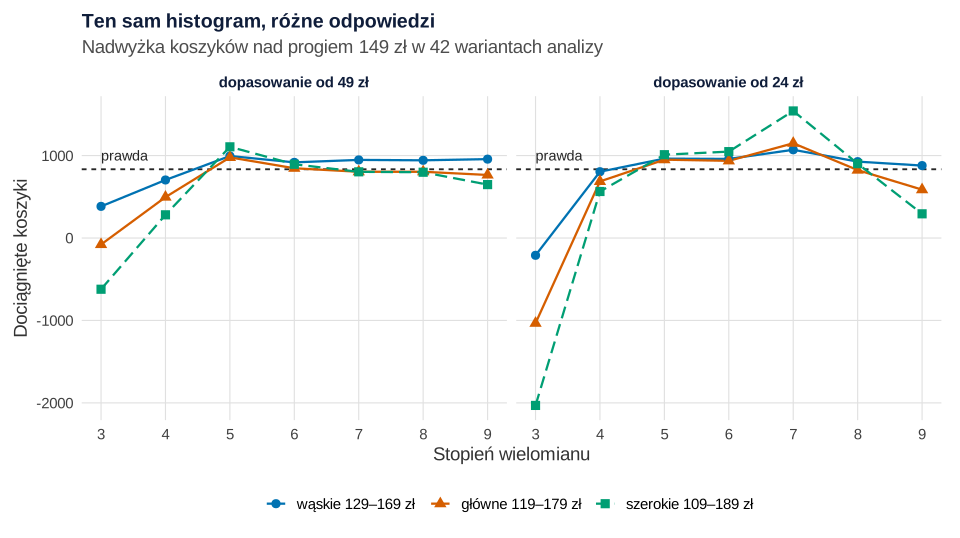
Co widać. Przy wielomianie 3. lub 4. stopnia linia nie nadąża za kształtem rozkładu i wynik bywa absurdalny: −79 koszyków w głównym oknie, −621 w szerokim. Od stopnia 5 i przy dopasowaniu od 49 zł wyniki mieszczą się między 648 a 1106. Gdy dopasowanie zaczyna się od 24 zł, czyli obejmuje szczyt rozkładu i jego lewy brzeg, rozrzut rośnie do 294–1542.
Jak może zmylić. Za wysoki stopień też szkodzi: wielomian zaczyna podążać za szumem i falować w oknie, gdzie nie ma danych (przeuczenie). Uczciwie: w pierwszym uruchomieniu dopasowanie zaczynało się od 24 zł i dawało nadwyżkę 1150 przy braku 447 koszyków. Taka niezgodność to sygnał źle dobranej linii, więc przesunęliśmy początek na 49 zł. Rysunek pokazuje oba zakresy, a pokazanie tej analizy wrażliwości w pracy jest obowiązkowe. Reguła praktyczna: wybierz wariant, w którym nadwyżka i brak są zgodne, a pozostałe pokaż w aneksie.
Rysunek 6: rachunek progu 129, 149 i 169 zł
Dociągnięty koszyk to nie zysk. Sklep zarabia marżę na dołożonych produktach, ale traci opłatę 14.90 zł na każdym zamówieniu powyżej progu, także na tych, które i tak by tam były. Symulujemy więc trzy progi. Rozkład zamierzonych koszyków bierzemy z rozkładu kontrfaktycznego, a reakcję klientów z krzywej z rysunku 4B. Przyjmujemy marżę brutto 50% i zwrot 20% dołożonych produktów. Liczby są na miesiąc, w porównaniu z brakiem darmowej dostawy.
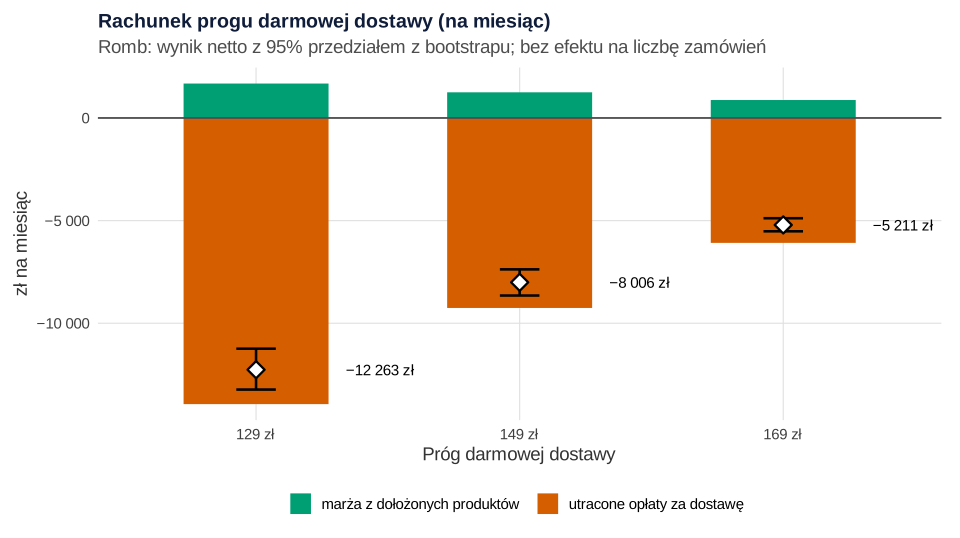
set.seed(7231)).Co widać. Przy progu 149 zł sklep dociąga około 126 koszyków miesięcznie, ale darmową dostawę ma 621 zamówień. Marża z dołożonych produktów (1249 zł) pokrywa niewielką część utraconych opłat (9255 zł). Wynik netto to −8006 zł miesięcznie [−8649, −7374]. Przy 129 zł strata rośnie o 4256 zł [3849, 4660], przy 169 zł maleje o 2795 zł [2420, 3151]. Podobny wniosek dały prawdziwe dane sklepu internetowego: darmowa dostawa od progu zwiększała sprzedaż, ale utracone opłaty mogły uczynić ją nieopłacalną (Lewis i in., 2006).
Jak może zmylić. Rachunek pomija najważniejszą niewiadomą: ilu klientów składa zamówienie tylko dzięki darmowej dostawie. Histogram pokazuje przesunięcia koszyków, ale nie pokaże zamówień, które bez progu w ogóle by nie powstały. Przy marży 49.88 zł z przeciętnego zamówienia próg 149 zł wychodzi na zero, jeśli przyciąga 161 dodatkowych zamówień miesięcznie, czyli 4.7% z 3423. Próg 169 zł potrzebuje 104, a 129 zł – 246. Czy tak jest, rozstrzygnie dopiero eksperyment.
Co z tym zrobić w marketingu
- Licz złotówki, nie koszyki. 804 dociągnięte koszyki brzmią dobrze, ale każdy przynosi około 18 zł dodatkowej wartości, a darmowa dostawa obejmuje też prawie 4 razy więcej zamówień, które i tak przekroczyłyby próg (495 wobec 126 miesięcznie).
- Sprawdź wpływ progu na liczbę zamówień w teście A/B. Losuj próg (np. 149 i 169 zł) na poziomie klienta. Metryka główna to marża na odwiedzającego, a metryki ochronne to konwersja i porzucone koszyki. Jak ustawić je przed testem, opisuje wpis o metrykach ochronnych w teście A/B. Ścieżkę do zakupu przeanalizujesz jak w lejku konwersji, a koszyki porzucone przy opłacie za dostawę – jak w eksperymencie z przypomnieniem o porzuconym koszyku.
- Pomóż dociągnąć tym, którym brakuje mało. Gdy brakuje 2.5 zł, dokłada połowa klientów, a gdy 27.5 zł – co jedenasty. Podpowiedź w koszyku („brakuje Ci 6 zł”) z produktem o wysokiej marży i niskim odsetku zwrotów może zwiększyć zysk z dociągniętych koszyków.
- Uważaj na średni koszyk jako miarę sukcesu. Próg podnosi średni koszyk z definicji, nawet gdy zysk spada. Porównuj marżę na zamówienie i na klienta, z przedziałami jak we wpisie o wskaźnikach ilorazowych w testach A/B.
- Monitoruj skupisko po każdej zmianie progu i cen. Ten sam histogram przyda się przy cenach z końcówką 99 – patrz ceny psychologiczne 19.99 czy 20.00 – i przy rabatach od wartości koszyka (głębokość rabatu a sprzedaż).
Podobny problem „obserwujemy co innego, niż chcemy zmierzyć” ma sprzedaż ucięta zapasem – zob. popyt ukryty przez braki towaru. Inne tematy na pracę z tej dziedziny zbiera wpis statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie opisz przedziały, okno, stopień wielomianu, sposób liczenia nadwyżki i braku oraz bootstrap. W Wynikach podaj nadwyżkę z przedziałem, zgodność z brakiem i analizę wrażliwości. W Dyskusji zaznacz, że skupienie mierzy tylko reakcję koszyków na próg, a nie wpływ progu na liczbę zamówień.
Kod R: histogram, bunching, bootstrap i rachunek progu
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 2 – funkcję bunching(), przepis 4 – funkcje reakcja() i ci(). Przepisy z rysunkami kończą się nazwą wykresu (p2–p7), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki) – dane, geometrie i skale są identyczne.
Losujące bloki mają własne ziarna: 723 (dane, przepis 1) i 7231 (500 prób bootstrapowych w przepisie 4; przepis 6 ustawia to samo ziarno, żeby odtworzyć te same próby). Ziaren nie dobieraliśmy pod wynik. Ręcznie ustalono (przepis 1): opłatę 14.90 zł, średnio 3200 zamówień miesięcznie w okresie progu 99 zł i 3400 w okresie progu 149 zł, rozkład zamierzonych koszyków (lognormalny, mediana 88 zł, odchylenie log 0.5, minimum 20 zł), odsetek klientów reagujących na próg (0.65), średnią tolerancję dopłaty (12 zł), przekroczenie progu (rozkład gamma, średnio 6 zł), szansę saszetki próbnej (0.70, 0.15 i 0.05) i zwroty (5% zamówień zwraca 30% koszyka, dołożone produkty wracają w 20% zamówień). W analizie ręcznie przyjęto przedziały 5 zł, okno 119–179 zł, wielomian 7. stopnia, zakres dopasowania 49–299 zł (dla progu 99 zł: 34–249 zł i okno 69–129 zł), marżę 50% i zwrot 20% dołożonych produktów w rachunku. Po pierwszym uruchomieniu zmieniliśmy dwa wybory analizy, nie dane: początek zakresu dopasowania z 24 na 49 zł (bo nadwyżka 1150 nie zgadzała się z brakiem 447) i sposób liczenia średniego dodatku (środki ciężkości nadwyżki i braku zamiast sumy różnic ważonych wartością koszyka, która przy niezgodnych nadwyżce i braku dawała wynik kilkakrotnie za duży). Zakres 34 zł dla progu 99 zł wybraliśmy po porównaniu zakresów od 29, 34, 39 i 49 zł. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Dane: 40 000 zamówień i dwa progi
R
# Przepis 1. Fikcyjny sklep internetowy z herbatami liściastymi: ok. 40 000 zamówień w roku,
# próg darmowej dostawy 99 zł (styczeń–kwiecień), potem 149 zł (maj–grudzień)
library(ggplot2); library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", blekit = "#56B4E9",
         zielony = "#009E73", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Ręcznie ustalone parametry (prawda znana tylko w symulacji)
oplata    <- 14.90                         # opłata za dostawę poniżej progu (zł)
pi_reag   <- 0.65                          # odsetek klientów, którzy w ogóle reagują na próg
lambda    <- 12                            # średnia „tolerancja” dopłaty u reagujących (zł, rozkład wykładniczy)
probka    <- 9                             # najtańszy produkt: herbata w saszetce próbnej (zł)
zam_mies  <- c(rep(3200, 4), rep(3400, 8)) # średnia liczba zamówień w miesiącu

set.seed(723)
n_mies <- rpois(12, zam_mies)
z <- data.frame(miesiac = rep(1:12, n_mies))
z$prog <- ifelse(z$miesiac <= 4, 99, 149)
n <- nrow(z)
z$zamierzona <- pmax(20, rlnorm(n, meanlog = log(88), sdlog = 0.5))   # koszyk, który klient chciał złożyć
luka <- z$prog - z$zamierzona                                         # ile brakuje do progu
tolerancja <- ifelse(runif(n) < pi_reag, rexp(n, 1 / lambda), 0)      # ile klient jest gotów dołożyć
z$dociagniety <- luka > 0 & luka <= tolerancja
nadwyzka <- rgamma(n, shape = 2, scale = 3)                           # o ile koszyk przekracza próg
z$wartosc <- round(ifelse(z$dociagniety, z$prog + nadwyzka, z$zamierzona), 2)
z$dodatek <- round(z$wartosc - z$zamierzona, 2)                       # dołożone produkty (prawda)
z$oplata_dostawy <- ifelse(z$wartosc >= z$prog, 0, oplata)
# saszetka próbna: częsty „dobijacz”, gdy brakuje najwyżej 9 zł
p_probka <- ifelse(z$dociagniety & luka <= probka, 0.70, ifelse(z$dociagniety, 0.15, 0.05))
z$probka <- as.integer(runif(n) < p_probka)
# zwroty: 5% zamówień zwraca 30% podstawowego koszyka; dołożone produkty wracają w 20% zamówień
zwrot_podst <- ifelse(runif(n) < 0.05, 0.30 * z$zamierzona, 0)
zwrot_dod   <- ifelse(z$dociagniety & runif(n) < 0.20, z$dodatek, 0)
z$zwrot <- round(zwrot_podst + zwrot_dod, 2)

cat("Zamówień:", n, "| styczeń–kwiecień (próg 99 zł):", sum(z$prog == 99),
    "| maj–grudzień (próg 149 zł):", sum(z$prog == 149), "\n")
cat("Mediana koszyka:", round(median(z$wartosc), 2), "zł | średnia:", round(mean(z$wartosc), 2), "zł\n")
for (t in c(99, 149)) {
  s <- z[z$prog == t, ]
  cat(sprintf("Próg %d zł: z darmową dostawą %.1f%% | dociągniętych (prawda) %d = %.1f%% | średni dodatek %.2f zł\n",
              t, 100 * mean(s$wartosc >= t), sum(s$dociagniety), 100 * mean(s$dociagniety),
              mean(s$dodatek[s$dociagniety])))
}
write.csv(data.frame(id_zamowienia = seq_len(n), miesiac = z$miesiac, prog_zl = z$prog, wartosc_zl = z$wartosc,
                     oplata_dostawy_zl = z$oplata_dostawy, probka_w_koszyku = z$probka, zwrot_zl = z$zwrot,
                     dociagniety_prawda = as.integer(z$dociagniety), dodatek_prawda_zl = z$dodatek),
          "prog-dostawy-herbaty-zamowienia.csv", row.names = FALSE)
Wynik w R
Zamówień: 40372 | styczeń–kwiecień (próg 99 zł): 12987 | maj–grudzień (próg 149 zł): 27385
Mediana koszyka: 89.34 zł | średnia: 100.52 zł
Próg 99 zł: z darmową dostawą 48.1% | dociągniętych (prawda) 875 = 6.7% | średni dodatek 18.36 zł
Próg 149 zł: z darmową dostawą 17.4% | dociągniętych (prawda) 834 = 3.0% | średni dodatek 21.30 zł
2. Histogram i rozkład kontrfaktyczny: Rysunek 2
R
# Przepis 2. Histogram w przedziałach 5 zł i rozkład kontrfaktyczny z wielomianu dopasowanego poza oknem progu
# Funkcja bunching(): zlicza koszyki w przedziałach [próg + 5k, próg + 5k + 5), dopasowuje wielomian
# stopnia `stopien` do przedziałów poza oknem [dol, gora) i przedłuża go do okna
bunching <- function(w, prog, dol, gora, stopien = 7, od = prog - 100, do = prog + 150, szer = 5) {
  brzegi <- seq(od, do, by = szer)
  h <- data.frame(lewy = head(brzegi, -1))
  h$srodek <- h$lewy + szer / 2
  h$n <- tabulate(findInterval(w[w >= od & w < do], brzegi), nbins = nrow(h))
  h$okno <- h$lewy >= dol & h$lewy < gora
  h$x <- (h$srodek - prog) / 100                                # skalowanie: stabilniejszy wielomian
  m <- lm(n ~ poly(x, stopien, raw = TRUE), data = h[!h$okno, ])
  h$kontr <- predict(m, newdata = h)
  nad <- h$okno & h$lewy >= prog; pod <- h$okno & h$lewy < prog
  list(h = h, prog = prog,
       nadwyzka = sum(h$n[nad] - h$kontr[nad]),                   # koszyki „za dużo” tuż nad progiem
       brak = sum(h$kontr[pod] - h$n[pod]),                       # koszyki „brakujące” tuż pod progiem
       # średni dodatek: środek ciężkości nadwyżki minus środek ciężkości braku (zł)
       dodatek = weighted.mean(h$srodek[nad], pmax(h$n[nad] - h$kontr[nad], 0)) -
                 weighted.mean(h$srodek[pod], pmax(h$kontr[pod] - h$n[pod], 0)),
       nad_prog = weighted.mean(h$srodek[nad] - prog, pmax(h$n[nad] - h$kontr[nad], 0)))
}

b149 <- bunching(z$wartosc[z$prog == 149], prog = 149, dol = 119, gora = 179)
s149 <- z[z$prog == 149, ]
cat(sprintf("Próg 149 zł (n = %d): nadwyżka nad progiem %.0f koszyków | brak pod progiem %.0f\n",
            nrow(s149), b149$nadwyzka, b149$brak))
cat(sprintf("Prawda: dociągniętych %d | średni dodatek: oszacowanie %.1f zł, prawda %.1f zł\n",
            sum(s149$dociagniety), b149$dodatek, mean(s149$dodatek[s149$dociagniety])))
cat(sprintf("Dodatkowa wartość koszyków w 8 miesiącach: oszacowanie %.0f zł, prawda %.0f zł\n",
            b149$nadwyzka * b149$dodatek, sum(s149$dodatek)))
cat(sprintf("Średnie przekroczenie progu przez nadwyżkę: %.1f zł (prawda %.1f zł)\n",
            b149$nad_prog, mean(s149$wartosc[s149$dociagniety] - 149)))
print(transform(b149$h[b149$h$lewy >= 109 & b149$h$lewy < 189, c("lewy", "n", "kontr")],
                kontr = round(kontr, 1), roznica = round(n - kontr, 1)), row.names = FALSE)

hh <- b149$h
p2 <- ggplot(hh, aes(srodek, n)) +
  annotate("rect", xmin = 119, xmax = 179, ymin = -Inf, ymax = Inf, fill = kol[["blekit"]], alpha = 0.12) +
  geom_col(aes(fill = ifelse(okno, "w oknie progu", "poza oknem")), width = 4.6) +
  geom_line(aes(y = kontr, linetype = "rozkład kontrfaktyczny (wielomian 7. stopnia)"),
            colour = kol[["niebieski"]], linewidth = 1.1) +
  geom_vline(xintercept = 149, colour = kol[["cynober"]], linewidth = 0.9) +
  annotate("text", x = 153, y = max(hh$n) * 0.97, hjust = 0, vjust = 1, size = 4, colour = "grey15",
           label = sprintf("nadwyżka: +%.0f koszyków\nw przedziałach 149–179 zł", b149$nadwyzka)) +
  annotate("text", x = 120.5, y = max(hh$n) * 0.70, hjust = 0, vjust = 1, size = 3.9, colour = "grey15",
           label = sprintf("brak: −%.0f\nkoszyków\nw 119–149 zł", b149$brak)) +
  scale_fill_manual(values = c("poza oknem" = kol[["szary"]], "w oknie progu" = kol[["pomaranczowy"]]), name = NULL) +
  scale_linetype_manual(values = c("rozkład kontrfaktyczny (wielomian 7. stopnia)" = "solid"), name = NULL) +
  scale_x_continuous(breaks = seq(49, 299, by = 25)) +
  labs(title = "Skupienie koszyków nad progiem 149 zł", subtitle = "Maj–grudzień, przedziały po 5 zł; pionowa linia = próg",
       x = "Wartość koszyka (zł)", y = "Liczba zamówień w przedziale") + motyw
p2   # zapis: ggsave("prog-darmowej-dostawy-histogram.svg", p2, width = 10, height = 5.6)
Wynik w R
Próg 149 zł (n = 27385): nadwyżka nad progiem 804 koszyków | brak pod progiem 808
Prawda: dociągniętych 834 | średni dodatek: oszacowanie 17.8 zł, prawda 21.3 zł
Dodatkowa wartość koszyków w 8 miesiącach: oszacowanie 14329 zł, prawda 17767 zł
Średnie przekroczenie progu przez nadwyżkę: 6.2 zł (prawda 6.1 zł)
 lewy   n kontr roznica
  109 907 879.4    27.6
  114 778 804.8   -26.8
  119 669 733.5   -64.5
  124 568 666.3   -98.3
  129 490 603.5  -113.5
  134 432 545.4  -113.4
  139 302 492.0  -190.0
  144 215 443.2  -228.2
  149 818 399.0   419.0
  154 632 359.1   272.9
  159 417 323.1    93.9
  164 316 290.7    25.3
  169 282 261.7    20.3
  174 208 235.7   -27.7
  179 225 212.4    12.6
  184 183 191.5    -8.5
3. Zmiana progu z 99 na 149 zł: Rysunek 3
R
# Przepis 3. Zmiana progu z 99 na 149 zł: czy skupisko przesuwa się razem z progiem?
A <- z$wartosc[z$prog == 99]; B <- z$wartosc[z$prog == 149]
b99 <- bunching(A, prog = 99, dol = 69, gora = 129, od = 34, do = 249)
sA <- z[z$prog == 99, ]
cat(sprintf("Próg 99 zł (styczeń–kwiecień, n = %d): nadwyżka %.0f | brak %.0f | prawda %d | średni dodatek %.1f zł (prawda %.1f zł)\n",
            nrow(sA), b99$nadwyzka, b99$brak, sum(sA$dociagniety), b99$dodatek, mean(sA$dodatek[sA$dociagniety])))
na_1000 <- function(b) 1000 * b$nadwyzka / sum(b$h$n)
cat(sprintf("Nadwyżka na 1000 zamówień w zakresie analizy: próg 99 zł %.1f | próg 149 zł %.1f\n", na_1000(b99), na_1000(b149)))
# „placebo”: przedziały tuż pod i tuż nad progiem, który w danym okresie nie obowiązywał
udz <- function(w, a) 100 * mean(w >= a & w < a + 5)
for (t in c(99, 149)) cat(sprintf("Przedziały wokół %d zł: [%d, %d) okres 99 zł %.1f%%, okres 149 zł %.1f%% | [%d, %d) okres 99 zł %.1f%%, okres 149 zł %.1f%%\n",
  t, t - 5, t, udz(A, t - 5), udz(B, t - 5), t, t + 5, udz(A, t), udz(B, t)))

brzegi <- seq(24, 249, by = 5)
gest <- function(w, okres) {
  d <- data.frame(srodek = head(brzegi, -1) + 2.5, okres = okres)
  d$na1000 <- 1000 * tabulate(findInterval(w[w >= 24 & w < 249], brzegi), nbins = nrow(d)) / length(w)
  d
}
g <- rbind(gest(A, "Styczeń–kwiecień: próg 99 zł"), gest(B, "Maj–grudzień: próg 149 zł"))
g$okres <- factor(g$okres, levels = unique(g$okres))
progi <- data.frame(okres = factor(levels(g$okres), levels = levels(g$okres)), prog = c(99, 149),
                    inny = c(149, 99), inny_et = c("przyszły próg 149 zł", "dawny próg 99 zł"))
p3 <- ggplot(g, aes(srodek, na1000)) +
  geom_col(aes(fill = okres), width = 4.6, show.legend = FALSE) +
  geom_vline(data = progi, aes(xintercept = prog), colour = kol[["cynober"]], linewidth = 0.9) +
  geom_vline(data = progi, aes(xintercept = inny), colour = "grey40", linetype = "22") +
  geom_text(data = progi, aes(x = prog + 3, y = 84, label = paste0("próg ", prog, " zł")), hjust = 0, size = 4) +
  geom_text(data = progi, aes(x = inny + 3, y = 84, label = inny_et),
            hjust = 0, size = 3.6, colour = "grey35") +
  facet_wrap(~ okres, ncol = 1) +
  scale_fill_manual(values = c(kol[["blekit"]], kol[["pomaranczowy"]])) +
  scale_x_continuous(breaks = seq(24, 249, by = 25)) +
  labs(title = "Skupisko przesuwa się razem z progiem", subtitle = "Zamówienia na 1000 w przedziałach po 5 zł",
       x = "Wartość koszyka (zł)", y = "Zamówień na 1000") + motyw +
  theme(strip.text = element_text(face = "bold", hjust = 0))
p3   # zapis: ggsave("prog-darmowej-dostawy-zmiana-progu.svg", p3, width = 10, height = 6.2)
Wynik w R
Próg 99 zł (styczeń–kwiecień, n = 12987): nadwyżka 717 | brak 945 | prawda 875 | średni dodatek 16.2 zł (prawda 18.4 zł)
Nadwyżka na 1000 zamówień w zakresie analizy: próg 99 zł 58.0 | próg 149 zł 33.6
Przedziały wokół 99 zł: [94, 99) okres 99 zł 1.9%, okres 149 zł 4.1% | [99, 104) okres 99 zł 7.0%, okres 149 zł 3.9%
Przedziały wokół 149 zł: [144, 149) okres 99 zł 1.6%, okres 149 zł 0.8% | [149, 154) okres 99 zł 1.4%, okres 149 zł 3.0%
4. Bootstrap i krzywa reakcji: Rysunek 4
R
# Przepis 4. Ile koszyków naprawdę „dociągnięto”? Przedział z bootstrapu i krzywa reakcji na lukę do progu
# Krzywa reakcji: w przedziale pod progiem brakuje odsetka 1 − n / kontr koszyków; dopasowujemy
# p(luka) = pi · exp(−luka / lambda) metodą najmniejszych kwadratów ważonych liczbą koszyków kontrfaktycznych
reakcja <- function(b) {
  h <- b$h[b$h$okno & b$h$lewy < b$prog, ]
  luka <- b$prog - h$srodek; brak <- 1 - h$n / h$kontr
  f <- function(th) sum(h$kontr * (brak - plogis(th[1]) * exp(-luka / exp(th[2])))^2)
  th <- optim(c(0, log(10)), f)$par
  c(pi = plogis(th[1]), lambda = exp(th[2]))
}
r149 <- reakcja(b149)
cat(sprintf("Krzywa reakcji: pi = %.2f (prawda %.2f), lambda = %.1f zł (prawda %.1f zł)\n", r149["pi"], pi_reag, r149["lambda"], lambda))

set.seed(7231)
B_rep <- 500
boot <- replicate(B_rep, {
  bb <- bunching(sample(B, replace = TRUE), prog = 149, dol = 119, gora = 179)
  c(nadwyzka = bb$nadwyzka, brak = bb$brak, dodatek = bb$dodatek, nad_prog = bb$nad_prog, reakcja(bb))
})
boot <- as.data.frame(t(boot))
ci <- function(x) quantile(x, c(.025, .975))
for (v in c("nadwyzka", "brak", "dodatek", "pi", "lambda"))
  cat(sprintf("%-9s 95%% CI [%.2f, %.2f]\n", v, ci(boot[[v]])[1], ci(boot[[v]])[2]))
cat(sprintf("Dociągnięte koszyki: %.0f [%.0f, %.0f] (prawda %d) = %.1f%% zamówień maj–grudzień\n",
            b149$nadwyzka, ci(boot$nadwyzka)[1], ci(boot$nadwyzka)[2], sum(s149$dociagniety), 100 * b149$nadwyzka / length(B)))
cat(sprintf("Dodatkowa wartość koszyków na miesiąc: %.0f zł [%.0f, %.0f] (prawda %.0f zł)\n",
            b149$nadwyzka * b149$dodatek / 8, ci(boot$nadwyzka * boot$dodatek / 8)[1], ci(boot$nadwyzka * boot$dodatek / 8)[2],
            sum(s149$dodatek) / 8))

p4a <- ggplot(boot, aes(nadwyzka)) +
  geom_histogram(binwidth = 20, fill = kol[["blekit"]], colour = "white") +
  annotate("rect", xmin = ci(boot$nadwyzka)[1], xmax = ci(boot$nadwyzka)[2], ymin = -Inf, ymax = Inf,
           fill = kol[["niebieski"]], alpha = 0.12) +
  geom_vline(xintercept = b149$nadwyzka, colour = kol[["niebieski"]], linewidth = 1) +
  geom_vline(xintercept = sum(s149$dociagniety), colour = "grey15", linetype = "22", linewidth = 0.8) +
  labs(title = "A. Dociągnięte koszyki (500 prób)", subtitle = "Linia ciągła: oszacowanie; przerywana: prawda",
       x = "Nadwyżka koszyków nad progiem", y = "Liczba prób") + motyw
kr <- data.frame(luka = seq(0, 30, by = 0.5))
kr$prawda <- pi_reag * exp(-kr$luka / lambda)
kr$model <- r149["pi"] * exp(-kr$luka / r149["lambda"])
hp <- b149$h[b149$h$okno & b149$h$lewy < 149, ]
hp$luka <- 149 - hp$srodek; hp$brak <- 1 - hp$n / hp$kontr
p4b <- ggplot(kr, aes(luka)) +
  geom_line(aes(y = 100 * model, linetype = "dopasowana krzywa"), colour = kol[["niebieski"]], linewidth = 1.1) +
  geom_line(aes(y = 100 * prawda, linetype = "prawda z symulacji"), colour = "grey15", linewidth = 0.8) +
  geom_point(data = hp, aes(y = 100 * brak), colour = kol[["cynober"]], size = 3, shape = 17) +
  scale_linetype_manual(values = c("dopasowana krzywa" = "solid", "prawda z symulacji" = "22"), name = NULL) +
  labs(title = "B. Kto dokłada, gdy brakuje X zł", subtitle = "Trójkąty: brak koszyków pod progiem",
       x = "Luka do progu (zł)", y = "Odsetek dociągniętych (%)") + motyw
p4 <- p4a + p4b
p4   # zapis: ggsave("prog-darmowej-dostawy-bootstrap.svg", p4, width = 10, height = 5.6)
Wynik w R
Krzywa reakcji: pi = 0.61 (prawda 0.65), lambda = 14.3 zł (prawda 12.0 zł)
nadwyzka  95% CI [549.24, 1061.79]
brak      95% CI [531.57, 1087.02]
dodatek   95% CI [15.69, 19.51]
pi        95% CI [0.50, 0.71]
lambda    95% CI [9.54, 19.49]
Dociągnięte koszyki: 804 [549, 1062] (prawda 834) = 2.9% zamówień maj–grudzień
Dodatkowa wartość koszyków na miesiąc: 1791 zł [1148, 2509] (prawda 2221 zł)
5. Wrażliwość na okno, stopień i zakres: Rysunek 5
R
# Przepis 5. Wrażliwość: stopień wielomianu, szerokość okna i początek zakresu dopasowania
warianty <- expand.grid(stopien = 3:9, okno = c("wąskie 129–169 zł", "główne 119–179 zł", "szerokie 109–189 zł"),
                        od = c(24, 49), stringsAsFactors = FALSE)
granice <- list("wąskie 129–169 zł" = c(129, 169), "główne 119–179 zł" = c(119, 179), "szerokie 109–189 zł" = c(109, 189))
wr <- do.call(rbind, lapply(seq_len(nrow(warianty)), function(i) {
  v <- warianty[i, ]; g <- granice[[v$okno]]
  bb <- bunching(B, prog = 149, dol = g[1], gora = g[2], stopien = v$stopien, od = v$od)
  data.frame(v, nadwyzka = bb$nadwyzka, brak = bb$brak)
}))
wr$okno <- factor(wr$okno, levels = names(granice))
wr$zakres <- factor(paste0("dopasowanie od ", wr$od, " zł"), levels = c("dopasowanie od 49 zł", "dopasowanie od 24 zł"))
print(transform(subset(wr, od == 49), nadwyzka = round(nadwyzka), brak = round(brak))[, c("stopien", "okno", "nadwyzka", "brak")],
      row.names = FALSE)
cat("Zakres nadwyżki (od 49 zł, stopnie 5–9):", round(range(subset(wr, od == 49 & stopien >= 5)$nadwyzka)), "\n")
cat("Zakres nadwyżki (od 24 zł, stopnie 5–9):", round(range(subset(wr, od == 24 & stopien >= 5)$nadwyzka)), "\n")
cat("Prawda:", sum(s149$dociagniety), "\n")

p5 <- ggplot(wr, aes(stopien, nadwyzka, colour = okno, shape = okno, linetype = okno)) +
  geom_hline(yintercept = sum(s149$dociagniety), colour = "grey15", linetype = "22") +
  geom_line(linewidth = 0.8) + geom_point(size = 2.8) +
  annotate("text", x = 3, y = sum(s149$dociagniety) + 170, label = "prawda", hjust = 0, size = 3.8, colour = "grey15") +
  facet_wrap(~ zakres) +
  scale_colour_manual(values = unname(kol[c("niebieski", "cynober", "zielony")]), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "42"), name = NULL) +
  scale_x_continuous(breaks = 3:9) +
  labs(title = "Ten sam histogram, różne odpowiedzi", subtitle = "Nadwyżka koszyków nad progiem 149 zł w 42 wariantach analizy",
       x = "Stopień wielomianu", y = "Dociągnięte koszyki") + motyw +
  theme(strip.text = element_text(face = "bold"))
p5   # zapis: ggsave("prog-darmowej-dostawy-wrazliwosc.svg", p5, width = 10, height = 5.6)
Wynik w R
 stopien                okno nadwyzka brak
       3   wąskie 129–169 zł      384 1054
       4   wąskie 129–169 zł      704  878
       5   wąskie 129–169 zł      995  507
       6   wąskie 129–169 zł      918  505
       7   wąskie 129–169 zł      948  475
       8   wąskie 129–169 zł      943  448
       9   wąskie 129–169 zł      957  436
       3   główne 119–179 zł      -79 1684
       4   główne 119–179 zł      496 1403
       5   główne 119–179 zł      978  778
       6   główne 119–179 zł      846  764
       7   główne 119–179 zł      804  808
       8   główne 119–179 zł      804  811
       9   główne 119–179 zł      765  843
       3 szerokie 109–189 zł     -621 2243
       4 szerokie 109–189 zł      281 1828
       5 szerokie 109–189 zł     1106  767
       6 szerokie 109–189 zł      894  722
       7 szerokie 109–189 zł      803  816
       8 szerokie 109–189 zł      798  856
       9 szerokie 109–189 zł      648  981
Zakres nadwyżki (od 49 zł, stopnie 5–9): 648 1106
Zakres nadwyżki (od 24 zł, stopnie 5–9): 294 1542
Prawda: 834
6. Rachunek progów 129, 149 i 169 zł: Rysunek 6
R
# Przepis 6. Rachunek progu: marża z dołożonych produktów kontra utracone opłaty za dostawę (129 / 149 / 169 zł)
# Założenia ręczne: marża brutto 50% wartości produktów, 20% dołożonych produktów wraca (dane działu zwrotów),
# opłata 14.90 zł; rozkład zamierzonych koszyków = kontrfaktyczny z przepisu 2, reakcja = krzywa z przepisu 4,
# przekroczenie progu = średnie przekroczenie z nadwyżki. Wynik na miesiąc (8 miesięcy z progiem 149 zł).
marza <- 0.50; zwrot_dod <- 0.20; mies <- 8
rachunek <- function(b, r, prog_nowy) {
  h <- b$h
  c_zam <- ifelse(h$okno, pmax(h$kontr, 0), h$n)                    # zamierzone koszyki w przedziałach
  powyzej <- sum(B >= max(h$lewy) + 5)                              # koszyki powyżej zakresu histogramu
  luka <- prog_nowy - h$srodek
  przes <- ifelse(luka > 0, c_zam * r[["pi"]] * exp(-luka / r[["lambda"]]), 0)   # dociągnięte przy nowym progu
  darmowe_same <- sum(c_zam[h$lewy >= prog_nowy]) + powyzej         # i tak powyżej progu
  dodatek <- sum(przes * (luka + b$nad_prog))                       # wartość dołożonych produktów (zł)
  c(dociagniete = sum(przes) / mies, darmowe = (darmowe_same + sum(przes)) / mies,
    marza_dod = marza * (1 - zwrot_dod) * dodatek / mies,
    utracone_oplaty = oplata * (darmowe_same + sum(przes)) / mies,
    wynik = (marza * (1 - zwrot_dod) * dodatek - oplata * (darmowe_same + sum(przes))) / mies)
}
progi_n <- c(129, 149, 169)
ocena <- sapply(progi_n, function(t) rachunek(b149, r149, t)); colnames(ocena) <- paste(progi_n, "zł")
print(round(ocena))
# niepewność: ten sam rachunek w każdej z 500 prób bootstrapowych – to samo ziarno co w przepisie 4,
# więc to te same próby zamówień
set.seed(7231)
wyn_boot <- t(replicate(B_rep, {
  bb <- bunching(sample(B, replace = TRUE), prog = 149, dol = 119, gora = 179)
  rr <- reakcja(bb)
  sapply(progi_n, function(t) rachunek(bb, rr, t)["wynik"])
}))
colnames(wyn_boot) <- paste(progi_n, "zł")
for (j in 1:3) cat(sprintf("Wynik miesięczny przy progu %s: %.0f zł [%.0f, %.0f]\n", colnames(wyn_boot)[j], ocena["wynik", j],
                           ci(wyn_boot[, j])[1], ci(wyn_boot[, j])[2]))
roz <- wyn_boot[, "169 zł"] - wyn_boot[, "149 zł"]; roz2 <- wyn_boot[, "129 zł"] - wyn_boot[, "149 zł"]
cat(sprintf("169 vs 149 zł: %+.0f zł [%.0f, %.0f]; 129 vs 149 zł: %+.0f zł [%.0f, %.0f]\n",
            ocena["wynik", 3] - ocena["wynik", 2], ci(roz)[1], ci(roz)[2], ocena["wynik", 1] - ocena["wynik", 2], ci(roz2)[1], ci(roz2)[2]))
marza_nowe <- marza * mean(B)                                       # marża z jednego nowego zamówienia
cat(sprintf("Marża z jednego dodatkowego zamówienia (średni koszyk %.2f zł): %.2f zł\n", mean(B), marza_nowe))
cat("Ile nowych zamówień miesięcznie musiałby przyciągnąć próg, żeby wyjść na zero:",
    paste(progi_n, "zł:", round(-ocena["wynik", ] / marza_nowe), collapse = " | "), "\n")
cat(sprintf("Dla porównania: zamówień miesięcznie (maj–grudzień) %.0f\n", length(B) / mies))

d6 <- data.frame(prog = rep(colnames(ocena), 2),
                 skladnik = rep(c("marża z dołożonych produktów", "utracone opłaty za dostawę"), each = 3),
                 zl = c(ocena["marza_dod", ], -ocena["utracone_oplaty", ]))
d6w <- data.frame(prog = colnames(ocena), wynik = ocena["wynik", ],
                  dol = apply(wyn_boot, 2, ci)[1, ], gora = apply(wyn_boot, 2, ci)[2, ])
p6 <- ggplot(d6, aes(prog, zl)) +
  geom_col(aes(fill = skladnik), width = 0.55) +
  geom_hline(yintercept = 0, colour = "grey30") +
  geom_errorbar(data = d6w, aes(y = wynik, ymin = dol, ymax = gora), width = 0.15, linewidth = 0.9) +
  geom_point(data = d6w, aes(y = wynik), shape = 23, size = 4, fill = "white", stroke = 1.2) +
  geom_text(data = d6w, aes(y = wynik, label = paste0(sub("-", "−", format(round(wynik), big.mark = " ")), " zł")),
            nudge_x = 0.34, size = 4, hjust = 0) +
  scale_fill_manual(values = c(kol[["zielony"]], kol[["cynober"]]), name = NULL) +
  scale_y_continuous(labels = function(x) sub("-", "−", format(x, big.mark = " ", scientific = FALSE, trim = TRUE))) +
  labs(title = "Rachunek progu darmowej dostawy (na miesiąc)",
       subtitle = "Romb: wynik netto z 95% przedziałem z bootstrapu; bez efektu na liczbę zamówień",
       x = "Próg darmowej dostawy", y = "zł na miesiąc") + motyw
p6   # zapis: ggsave("prog-darmowej-dostawy-rachunek.svg", p6, width = 10, height = 5.6)
Wynik w R
                129 zł 149 zł 169 zł
dociagniete        180    126     85
darmowe            935    621    408
marza_dod         1676   1249    873
utracone_oplaty  13938   9255   6084
wynik           -12263  -8006  -5211
Wynik miesięczny przy progu 129 zł: -12263 zł [-13230, -11237]
Wynik miesięczny przy progu 149 zł: -8006 zł [-8649, -7374]
Wynik miesięczny przy progu 169 zł: -5211 zł [-5521, -4884]
169 vs 149 zł: +2795 zł [2420, 3151]; 129 vs 149 zł: -4256 zł [-4660, -3849]
Marża z jednego dodatkowego zamówienia (średni koszyk 99.76 zł): 49.88 zł
Ile nowych zamówień miesięcznie musiałby przyciągnąć próg, żeby wyjść na zero: 129 zł: 246 | 149 zł: 161 | 169 zł: 104
Dla porównania: zamówień miesięcznie (maj–grudzień) 3423
7. Pułapki: zwroty i saszetka próbna
R
# Przepis 7. Pułapki: zwroty i „dobijanie” koszyka najtańszym produktem (saszetka próbna za 9 zł)
grupa <- cut(s149$wartosc, c(99, 129, 149, 159, 189, 249), right = FALSE,
             labels = c("99–129 zł", "129–149 zł (pod progiem)", "149–159 zł (tuż nad progiem)", "159–189 zł", "189–249 zł"))
tab <- aggregate(cbind(zamowien = 1, zwrot = s149$zwrot > 0, probka = s149$probka, dociagniety = s149$dociagniety) ~ grupa,
                 data = data.frame(grupa, s149), FUN = sum)
tab <- transform(tab, zwroty_proc = round(100 * zwrot / zamowien, 1), probka_proc = round(100 * probka / zamowien, 1),
                 dociagniete_proc_prawda = round(100 * dociagniety / zamowien, 1))
print(tab[, c("grupa", "zamowien", "zwroty_proc", "probka_proc", "dociagniete_proc_prawda")], row.names = FALSE)
w149 <- s149$wartosc >= 149 & s149$wartosc < 154
cat(sprintf("Koszyki 149–154 zł: z saszetką próbną %.1f%%; poza oknem 119–179 zł: %.1f%%\n",
            100 * mean(s149$probka[w149]), 100 * mean(s149$probka[s149$wartosc < 119 | s149$wartosc >= 179])))
Wynik w R
                        grupa zamowien zwroty_proc probka_proc dociagniete_proc_prawda
                    99–129 zł     4938         5.3         5.1                     0.0
     129–149 zł (pod progiem)     1439         4.0         4.4                     0.0
 149–159 zł (tuż nad progiem)     1450        14.4        21.9                    48.5
                   159–189 zł     1631         5.9         6.6                     8.0
                   189–249 zł     1220         5.0         4.8                     0.0
Koszyki 149–154 zł: z saszetką próbną 21.6%; poza oknem 119–179 zł: 4.8%
8. Grafika: karta „jak czytać histogram przy progu” (Rysunek 1)
R
# Przepis 8. Grafika: karta „jak czytać histogram przy progu” (schematyczny histogram + cztery karty)
# Słupki schematu liczymy wzorem (bez losowania); liczby na kartach pochodzą z przepisów 2, 4 i 5.
x <- seq(0, 38)                                            # 39 słupków schematu, próg między 24 a 25
gl <- 60 * exp(-x / 22)                                    # gładki rozkład bez progu
dz <- ifelse(x >= 19 & x <= 24, -gl * 0.55 * exp(-(24 - x) / 2.2), 0)   # „dziura” tuż pod progiem
sk <- ifelse(x >= 25 & x <= 29, c(26, 17, 8, 3, 1)[pmax(1, x - 24)], 0) # skupisko tuż nad progiem
sch <- data.frame(x = x, y = gl + dz + sk, okno = x >= 19 & x <= 30)
karty <- data.frame(
  xmin = c(0, 50, 0, 50), xmax = c(48, 98, 48, 98), ymin = c(-34, -34, -70, -70), ymax = c(-4, -4, -40, -40),
  nr = 1:4,
  tytul = c("Skupisko tuż nad progiem", "Dziura tuż pod progiem", "Linia kontrfaktyczna", "Okno i stopień wielomianu"),
  tekst = c(sprintf("Nadwyżka: %.0f koszyków [%.0f, %.0f]\nw 8 miesiącach (prawda: %d).\nTo klienci, którzy dołożyli produkt.",
                    b149$nadwyzka, ci(boot$nadwyzka)[1], ci(boot$nadwyzka)[2], sum(s149$dociagniety)),
            sprintf("Brak: %.0f koszyków pod progiem.\nPowinien równać się nadwyżce –\nto test spójności analizy.", b149$brak),
            sprintf("Wielomian %d. stopnia dopasowany\npoza oknem pokazuje, jak wyglądałby\nhistogram bez progu.", 7),
            sprintf("Okno %d–%d zł. Inne okna i stopnie\ndają %.0f–%.0f koszyków.\nPokaż tę wrażliwość w pracy.",
                    119, 179, min(subset(wr, od == 49 & stopien >= 5)$nadwyzka), max(subset(wr, od == 49 & stopien >= 5)$nadwyzka))))
znaczniki <- data.frame(nr = 1:4, x = c(27.5, 21.5, 34, 19.6), y = c(66, 40, 27, 72))
p7 <- ggplot() +
  annotate("rect", xmin = 18.5, xmax = 30.5, ymin = 0, ymax = 80, fill = kol[["blekit"]], alpha = 0.15) +
  geom_col(data = sch, aes(x, y, fill = okno), width = 0.85, show.legend = FALSE) +
  geom_line(data = sch, aes(x, gl), colour = kol[["niebieski"]], linewidth = 1.1) +
  annotate("segment", x = 24.5, xend = 24.5, y = 0, yend = 80, colour = kol[["cynober"]], linewidth = 1) +
  annotate("text", x = 25, y = 79, label = "próg", hjust = 0, vjust = 1, size = 4.2, colour = kol[["cynober"]], fontface = "bold") +
  annotate("text", x = 20.6, y = 72, label = "okno", hjust = 0, vjust = 0.5, size = 3.8, colour = "grey25") +
  geom_point(data = znaczniki, aes(x, y), shape = 21, size = 8, fill = "white", colour = "grey15", stroke = 1) +
  geom_text(data = znaczniki, aes(x, y, label = nr), size = 4.4, fontface = "bold") +
  scale_fill_manual(values = c(`FALSE` = kol[["szary"]], `TRUE` = kol[["pomaranczowy"]])) +
  # karty – osobny układ współrzędnych w dolnej części rysunku (przeskalowany do osi x schematu)
  geom_rect(data = karty, aes(xmin = xmin * 0.39 - 0.5, xmax = xmax * 0.39 - 0.5, ymin = ymin, ymax = ymax),
            fill = "grey97", colour = "grey70") +
  geom_point(data = karty, aes(x = xmin * 0.39 + 1.3, y = ymax - 6), shape = 21, size = 7, fill = "white", stroke = 1) +
  geom_text(data = karty, aes(x = xmin * 0.39 + 1.3, y = ymax - 6, label = nr), size = 4, fontface = "bold") +
  geom_text(data = karty, aes(x = xmin * 0.39 + 3.2, y = ymax - 6, label = tytul), hjust = 0, size = 4.3, fontface = "bold",
            colour = "#0f1d3a") +
  geom_text(data = karty, aes(x = xmin * 0.39 + 0.8, y = ymax - 11, label = tekst), hjust = 0, vjust = 1, size = 3.7,
            lineheight = 1.05, colour = "grey15") +
  coord_cartesian(xlim = c(-0.5, 38), ylim = c(-70, 80), expand = FALSE) +
  labs(title = "Jak czytać histogram przy progu darmowej dostawy",
       subtitle = "Schemat (u góry) i liczby z przykładu sklepu z herbatami (karty)", x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), panel.grid.minor = element_blank(), axis.text = element_blank())
p7   # zapis: ggsave("prog-darmowej-dostawy-karta.svg", p7, width = 10, height = 7.4)
9. Sprawdzenie palety (deuteranopia i protanopia)
R
# Przepis 9. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("szary – pomarańczowy (rys. 1, 2)" = c("grey60", "#E69F00"),
             "pomarańczowy – niebieski (rys. 2)" = c("#E69F00", "#0072B2"),
             "błękitny – pomarańczowy (rys. 3)" = c("#56B4E9", "#E69F00"),
             "niebieski – cynober (rys. 4, 5)" = c("#0072B2", "#D55E00"),
             "cynober – zielony (rys. 5, 6)" = c("#D55E00", "#009E73"),
             "niebieski – zielony (rys. 5)" = c("#0072B2", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(hex(k))),
                                   protanopia = roznica(protan(hex(k)))))), 1)
Wynik w R
                                  widzenie_typowe deuteranopia protanopia
szary – pomarańczowy (rys. 1, 2)             76.8         73.9       70.0
pomarańczowy – niebieski (rys. 2)           120.2        121.5      109.3
błękitny – pomarańczowy (rys. 3)            113.1        111.4      101.5
niebieski – cynober (rys. 4, 5)             114.6        108.3       91.9
cynober – zielony (rys. 5, 6)               102.4         53.5       37.3
niebieski – zielony (rys. 5)                 70.1         55.4       58.0
czerwony – zielony (do unikania)            121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Wielomiany dopasowano funkcją lm(), krzywą reakcji funkcją optim(), a dane i próby bootstrapowe wylosowano funkcjami rlnorm(), rexp(), rgamma() i sample() z pakietów stats i base. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Jeden wariant analizy. Wielomian 3. stopnia dał tu ujemną liczbę dociągniętych koszyków. Sprawdzaj, czy nadwyżka zgadza się z brakiem, i pokazuj wrażliwość (rysunek 5).
- Zbyt wąskie okno. Gubi klientów, którzy dopłacili dużo, i zaniża średni dodatek (17.8 zamiast 21.3 zł).
- Zwroty dociągniętych produktów. W koszykach 149–159 zł zwrot był w 14.4% zamówień, a w koszykach 129–149 zł w 4.0%. Część „dodatkowej sprzedaży” wraca do sklepu, więc wliczaj zwroty do rachunku (model odsetka zwrotów).
- Koszyki „dobijane” najtańszym produktem. Saszetka próbna za 9 zł była w 21.6% koszyków 149–154 zł i w 4.8% koszyków spoza okna. Taki dodatek ma małą wartość, a zamówienie i tak jedzie za darmo.
- Skupienie jako cały efekt progu. Histogram nie pokaże zamówień, które powstały dzięki darmowej dostawie, ani tych, które przepadły przez wyższy próg. Do tego potrzebny jest test A/B.
- Tarcia. Nie każdy klient zauważa próg: tu reagowało 65%. Mniejsze skupienie nie musi znaczyć, że klienci nie dbają o koszt dostawy. Część z nich po prostu nie reaguje na bodziec, co dobrze opisano przy progach podatkowych (Chetty i in., 2011; Kleven i Waseem, 2013).
Najczęstsze pytania
Co to jest metoda bunching?
To sposób szacowania reakcji na próg z samego rozkładu danych. Liczysz obserwacje w wąskich przedziałach, dopasowujesz wielomian do przedziałów poza oknem wokół progu i traktujesz go jako rozkład bez progu. Nadwyżka obserwacji tuż nad progiem (i brak tuż pod nim) mierzy, ile osób zmieniło zachowanie. Metoda pochodzi z ekonomii podatków (Saez, 2010; Kleven, 2016).
Jak sprawdzić, czy klienci dokładają produkty do progu darmowej dostawy?
Narysuj histogram wartości koszyków w przedziałach np. po 5 zł, tak by próg był granicą przedziału. Skupisko tuż nad progiem i dziura tuż pod nim to ślad dociągania koszyków. W przykładzie w przedziale 149–154 zł było 818 zamówień wobec 399 oczekiwanych z rozkładu kontrfaktycznego. Najmocniejszym dowodem jest przesunięcie skupiska po zmianie progu.
Jak dobrać okno i stopień wielomianu w metodzie bunching?
Okno powinno obejmować cały obszar, w którym próg zmienia zachowanie, a wielomian – dobrze opisywać rozkład poza nim. Sprawdź, czy nadwyżka nad progiem zgadza się z brakiem pod progiem, i pokaż analizę wrażliwości. W przykładzie wielomian 3. stopnia dawał wynik ujemny, a stopnie 5–9 – od 648 do 1106 koszyków przy prawdzie 834.
Czy próg darmowej dostawy się opłaca?
Nie da się tego stwierdzić z samego histogramu. Dociągnięte koszyki dają marżę z dołożonych produktów, ale sklep traci opłatę za dostawę na wszystkich zamówieniach powyżej progu. W przykładzie przy progu 149 zł marża wynosiła 1249 zł miesięcznie, a utracone opłaty 9255 zł; próg wyszedłby na zero, gdyby przyciągał 161 dodatkowych zamówień miesięcznie. To trzeba sprawdzić testem A/B.
Jak policzyć przedział ufności dla liczby dociągniętych koszyków?
Najprościej bootstrapem: losuj zamówienia ze zwracaniem, powtarzaj całą procedurę (histogram, wielomian, nadwyżka) np. 500 razy i weź percentyle 2.5 i 97.5. W przykładzie dało to 804 koszyki, 95% CI [549, 1062]. Przedział nie obejmuje niepewności z wyboru okna i stopnia wielomianu – tę pokazuje analiza wrażliwości.
Powiązane hasła
Przeczytaj też
Regresja nieciągła (RDD) i zmienne instrumentalne
Próg w regule przydziału i zmienna instrumentalna: założenia, lokalna regresja liniowa, testy, 2SLS w R z poprawnym SE i wzór opisu.
Czytaj →PoradnikLejek konwersji – etapy i test A/B
Sklep zoologiczny i nowy koszyk: odsetki od początku i warunkowe, przedziały Wilsona i Newcombe’a, liczebność i symulacja 1000 testów z kodem R.
Czytaj →PoradnikCeny psychologiczne: 19.99 czy 20.00
Końcówka ,99, efekt lewej cyfry, zakłócenie w danych historycznych i test losowy z efektami stałymi – na fikcyjnym sklepie z zabawkami, z kodem R.
Czytaj →Analizujesz próg darmowej dostawy albo piszesz o nim pracę?
Pomożemy policzyć skupienie przy progu z przedziałami, dobrać okno i wielomian, zaplanować test A/B progu i opisać wszystko tak, żebyś umiał(a) to obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Chetty, R., Friedman, J. N., Olsen, T., & Pistaferri, L. (2011). Adjustment costs, firm responses, and micro vs. macro labor supply elasticities: Evidence from Danish tax records. The Quarterly Journal of Economics, 126(2), 749–804. https://doi.org/10.1093/qje/qjr013 ● Otwarty dostęp
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Kleven, H. J. (2016). Bunching. Annual Review of Economics, 8(1), 435–464. https://doi.org/10.1146/annurev-economics-080315-015234
- Kleven, H. J., & Waseem, M. (2013). Using notches to uncover optimization frictions and structural elasticities: Theory and evidence from Pakistan. The Quarterly Journal of Economics, 128(2), 669–723. https://doi.org/10.1093/qje/qjt004
- Lewis, M., Singh, V., & Fay, S. (2006). An empirical study of the impact of nonlinear shipping and handling fees on purchase incidence and expenditure decisions. Marketing Science, 25(1), 51–64. https://doi.org/10.1287/mksc.1050.0150
- McCrary, J. (2008). Manipulation of the running variable in the regression discontinuity design: A density test. Journal of Econometrics, 142(2), 698–714. https://doi.org/10.1016/j.jeconom.2007.05.005 ● Otwarty dostęp: pełny tekst
- Saez, E. (2010). Do taxpayers bunch at kink points? American Economic Journal: Economic Policy, 2(3), 180–212. https://doi.org/10.1257/pol.2.3.180
Cytowania BibTeX
@article{chetty2011adjustment, author={Chetty, Raj and Friedman, John N. and Olsen, Tore and Pistaferri, Luigi}, title={{Adjustment costs, firm responses, and micro vs. macro labor supply elasticities: Evidence from Danish tax records}}, journal={The Quarterly Journal of Economics}, year={2011}, volume={126}, number={2}, pages={749--804}, doi={10.1093/qje/qjr013}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{kleven2016bunching, author={Kleven, Henrik Jacobsen}, title={{Bunching}}, journal={Annual Review of Economics}, year={2016}, volume={8}, number={1}, pages={435--464}, doi={10.1146/annurev-economics-080315-015234}}@article{kleven2013using, author={Kleven, Henrik J. and Waseem, Mazhar}, title={{Using notches to uncover optimization frictions and structural elasticities: Theory and evidence from Pakistan}}, journal={The Quarterly Journal of Economics}, year={2013}, volume={128}, number={2}, pages={669--723}, doi={10.1093/qje/qjt004}}@article{lewis2006empirical, author={Lewis, Michael and Singh, Vishal and Fay, Scott}, title={{An empirical study of the impact of nonlinear shipping and handling fees on purchase incidence and expenditure decisions}}, journal={Marketing Science}, year={2006}, volume={25}, number={1}, pages={51--64}, doi={10.1287/mksc.1050.0150}}@article{mccrary2008manipulation, author={McCrary, Justin}, title={{Manipulation of the running variable in the regression discontinuity design: A density test}}, journal={Journal of Econometrics}, year={2008}, volume={142}, number={2}, pages={698--714}, doi={10.1016/j.jeconom.2007.05.005}}@article{saez2010taxpayers, author={Saez, Emmanuel}, title={{Do taxpayers bunch at kink points?}}, journal={American Economic Journal: Economic Policy}, year={2010}, volume={2}, number={3}, pages={180--212}, doi={10.1257/pol.2.3.180}}