Przykład: sklep internetowy z zabawkami edukacyjnymi
Fikcyjny sklep internetowy sprzedaje około 400 zabawek edukacyjnych w pięciu kategoriach: klocki konstrukcyjne, zestawy eksperymentów, gry logiczne, puzzle i układanki oraz roboty do programowania. Połowa produktów ma cenę z końcówką ,99 (np. 49.99 zł), połowa – cenę pełną (np. 50.00 zł).
Dział marketingu pyta: czy 19.99 zł sprzedaje więcej niż 20.00 zł – ponad to, co wynika z jednego grosza różnicy? Jeśli tak, warto zmienić ceny pełne na końcówki ,99.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Prawdziwa elastyczność cenowa to −1.8. Końcówka ,99 podnosi sprzedaż o 7% (log 0.07), gdy zmienia cyfrę dziesiątek w cenach do 30 zł (19.99 vs 20.00), o 5% przy wyższych dziesiątkach (69.99 vs 70.00) i tylko o 1%, gdy dziesiątka się nie zmienia (24.99 vs 25.00). Dodatkowo co czwarty klient szuka zabawek filtrem „poniżej 50 zł”, więc produkt za 50.00 zł znika z jego listy. Końcówkę ,99 częściej dostawały promocje, tańsze kategorie i bestsellery. Parametry i ich zmiany po pierwszym uruchomieniu wymieniamy przy kodzie. Dane pobierzesz jako ceny-psychologiczne-produkty.csv (400 produktów, 12 tygodni) i ceny-psychologiczne-test.csv (test losowy, 1600 tygodni produktów).
Rysunek 1: dane historyczne – regresja z log(ceny) i końcówką ,99
Najprostsza analiza to regresja sprzedaży z 12 tygodni na logarytm ceny i zmienną 0/1 „końcówka ,99”. Logarytm ceny „zjada” różnicę jednego grosza: 49.99 to 0.02% mniej niż 50.00, więc przy elastyczności około −1.9 sprzedaż powinna wzrosnąć o 0.04%. Współczynnik przy końcówce mierzy skok sprzedaży ponad to – nieciągłość krzywej popytu na granicy pełnej złotówki. To ta sama logika co w regresji nieciągłej: Lacetera i in. (2012) znaleźli skokowe spadki cen używanych samochodów przy progach 10 000 mil przebiegu.
Sprzedaż to liczba sztuk, więc liczymy regresję Poissona z poprawką na nadmierną dyspersję (quasi-Poisson). b1 to elastyczność cenowa, a exp(b2) − 1 – procentowy efekt końcówki.
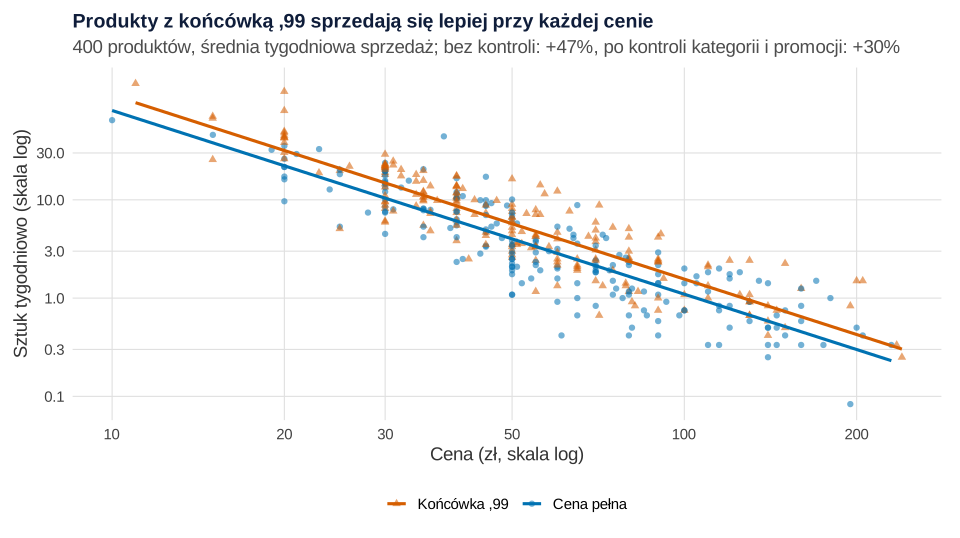
set.seed(724)).Co widać. Produkty z końcówką ,99 sprzedają się lepiej przy każdej cenie. Bez kontroli innych zmiennych efekt wynosi +46.9%, 95% CI [31.2, 64.3]. Po dodaniu kategorii – +42.6% [27.4, 59.6], a po dodaniu promocji – +29.9% [16.7, 44.6], p < .001. Elastyczność w ostatnim modelu: −1.86.
Jak może zmylić. Dodanie promocji zmniejszyło efekt mniej więcej o jedną trzecią, bo końcówkę ,99 ma 33% produktów w promocji wobec 14% wśród cen pełnych. To zmienna zakłócająca. Kategorię i promocję widzimy w danych, ale nie widzimy „siły” produktu: bestsellerom i nowościom ktoś kiedyś dał końcówkę ,99. Prawdziwy efekt w tych danych to kilka procent, a nie 30%.
Podpis do pracy:
Zdanie do Wyników:
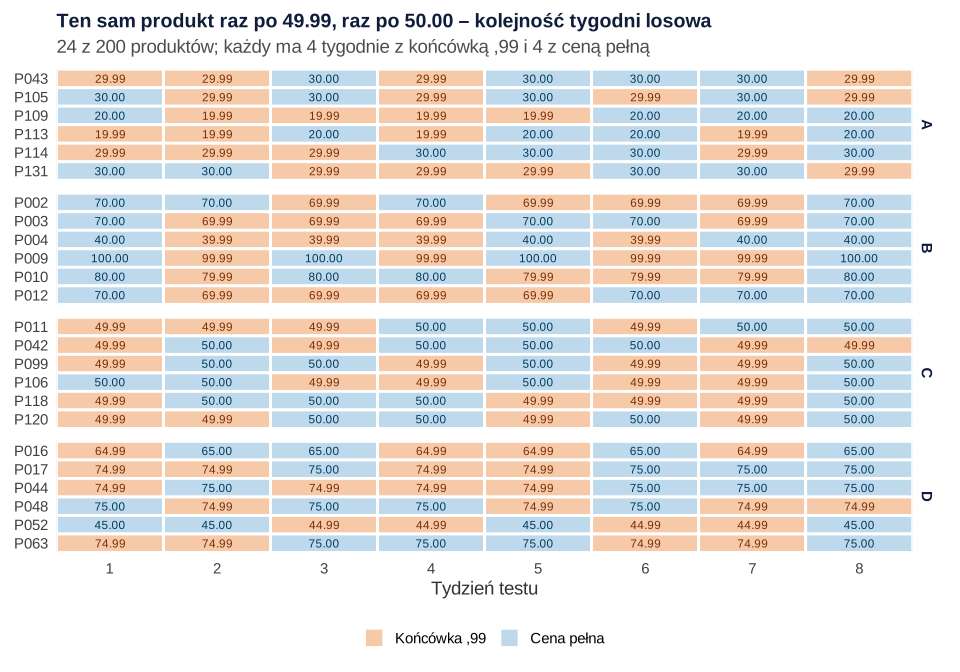
Rysunek 2: test losowy – ten sam produkt raz po 49.99, raz po 50.00
Zakłócenie usuwa losowanie. Sklep wybrał 200 produktów o cenach bliskich parom cen z czterech grup (najdalej o 2 zł) i przez 8 tygodni co tydzień losował dla każdego cenę z końcówką ,99 albo pełną: każdy produkt dostał 4 tygodnie jednej i 4 tygodnie drugiej ceny w losowej kolejności. To schemat naprzemienny: produkt jest porównywany sam ze sobą.
Grupy: A – zmiana dziesiątki w cenach do 30 zł (19.99 vs 20.00, 29.99 vs 30.00; 50 produktów), B – zmiana dziesiątki od 40 do 100 zł (np. 69.99 vs 70.00, 99.99 vs 100.00; 50), C – 49.99 vs 50.00, granica filtra „poniżej 50 zł” (40), D – bez zmiany dziesiątki (np. 24.99 vs 25.00, 74.99 vs 75.00; 60).
set.seed(7241)).Model ma efekty stałe produktu (αi – każdy produkt ma swój poziom sprzedaży) i tygodnia (γt – ferie, pogoda, kampanie). Jest to model z danych panelowych w wersji dla zliczeń:
Tygodnie tego samego produktu nie są niezależne, dlatego podajemy błędy standardowe odporne na klastrowanie po produkcie.
Co widać. Każdy wiersz to jeden produkt; o cenie w danym tygodniu nie decyduje ani menedżer, ani sezon.
Jak może zmylić. Klient, który widział 49.99 zł, a tydzień później 50.00 zł, może odłożyć zakup albo kupić wcześniej. Przy różnicy jednego grosza to mało prawdopodobne, przy większych – zawyża efekt.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: pięć oszacowań tego samego efektu
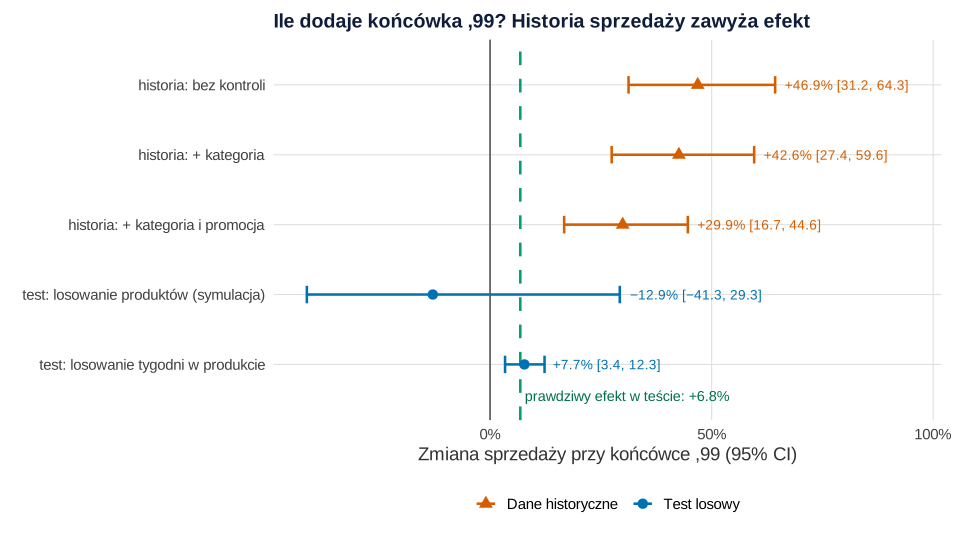
set.seed(7241), set.seed(7242)).Co widać. Test z losowaniem tygodni daje +7.7%, 95% przedział ufności [3.4, 12.3], p < .001. Prawdziwy efekt w tych produktach wynosi +6.8% – przedział go obejmuje. Najlepszy model historyczny (+29.9%) przeszacował efekt ponad czterokrotnie.
Dla porównania zasymulowaliśmy test na tych samych 200 produktach, ale z innym losowaniem: połowa produktów ma ,99 przez całe 8 tygodni, połowa – cenę pełną. Wynik: −12.9%, 95% CI [−41.3, 29.3], p = .493. Różnice między produktami przykrywają kilkuprocentowy efekt. Porównanie produktu z samym sobą zawęża przedział prawie ośmiokrotnie.
Jak może zmylić. +7.7% to średnia z czterech grup, w tym z grupy C, w której działa filtr ceny. Bez niej efekt wynosi +5.9%, 95% CI [1.3, 10.6], p = .011.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: efekt zależy od tego, którą cyfrę zmieniasz
Thomas i Morwitz (2005) pokazali w pięciu eksperymentach, że cena z dziewiątką na końcu wydaje się wyraźnie mniejsza od ceny o grosz wyższej tylko wtedy, gdy różnią się skrajne lewe cyfry (2.99 vs 3.00). To efekt lewej cyfry. Na danych skanerowych z 3500 produktów klienci reagowali na podwyżkę o jeden cent od ceny z końcówką 99 tak, jakby była to podwyżka o ponad 20 centów (Strulov-Shlain, 2023). Efekt powinien więc zależeć od tego, czy końcówka zmienia cyfrę dziesiątek – sprawdzamy to osobno w każdej grupie.
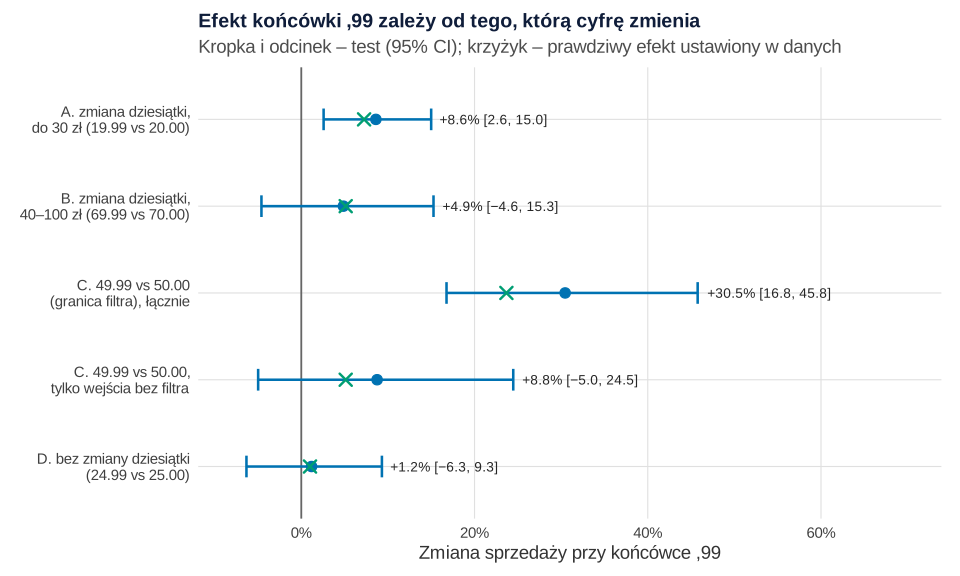
set.seed(7241)).Co widać. Przy 19.99 vs 20.00 (A) sprzedaż rośnie o 8.6%, 95% CI [2.6, 15.0], p = .005. Gdy dziesiątka się nie zmienia (D, np. 24.99 vs 25.00) – o 1.2% [−6.3, 9.3], p = .765. Największy skok jest przy 49.99 vs 50.00 (C): +30.5% [16.8, 45.8], p < .001. Ale to nie psychologia: sprzedaż z listy z filtrem „poniżej 50 zł” rośnie przy 49.99 o 181.1% [117.4, 263.4], bo przy 50.00 produktu na tej liście nie ma. Klienci spoza filtra reagują jak w innych grupach: +8.8% [−5.0, 24.5].
Jak może zmylić. Różnica między A i D wygląda na dużą, ale test interakcji jej nie potwierdza: różnica logarytmów 0.075, SE = 0.051, z = 1.47, p = .141. Każda grupa to tylko 40–60 produktów: różnica istnieje (ustawiliśmy ją), ale test ma na nią za mało danych. Manning i Sprott (2009) też opisują, że efekt końcówek zależy od poziomu ceny i celu zakupów.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: moc testu przy małym efekcie
Ile produktów potrzeba, żeby wykryć efekt kilku procent? Symulujemy test 1000 razy dla każdej kombinacji: 50–800 produktów, prawdziwy efekt +3%, +5% albo +8%, test 8 albo 16 tygodni, mediana sprzedaży 6 sztuk tygodniowo. Moc testu to odsetek symulacji z p < .05. Błąd Monte Carlo nie przekracza 1.6 punktu procentowego.
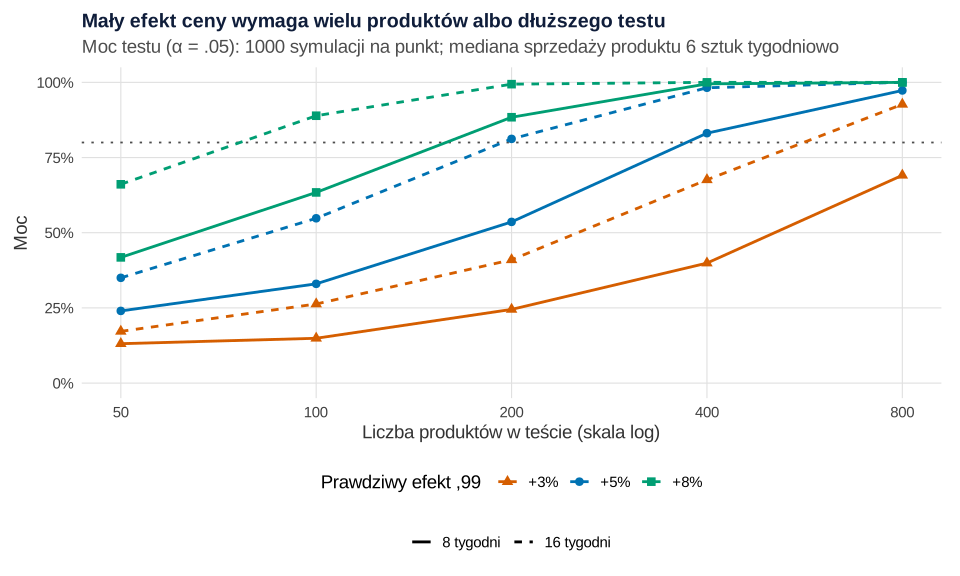
set.seed(7243)).Co widać. Przy efekcie +5% i 8 tygodniach 200 produktów daje moc 53.6% – rzut monetą. Moc 80% wymaga około 400 produktów (83.1%) albo 200 produktów przez 16 tygodni (81.2%). Efekt +3% przy 800 produktach i 8 tygodniach wykrywamy w 69.1% testów.
Jak może zmylić. Moc zależy od sprzedaży produktów: przy 1–2 sztukach tygodniowo potrzeba więcej produktów. O planowaniu liczebności symulacją pisaliśmy przy planie testu A/B.
Podpis do pracy:
Zdanie do Metody:
Rysunek 6: 19.99 czy 20.00 – karta
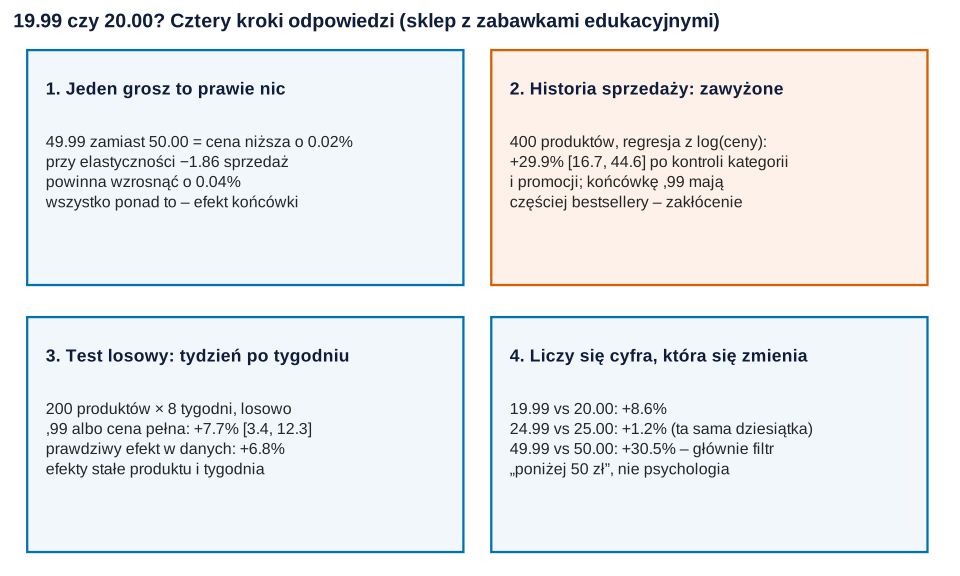
Co widać. Karta 1 ustawia poprzeczkę: wszystko powyżej 0.04% to efekt końcówki, nie grosza.
Jak może zmylić. Liczby dotyczą jednego fikcyjnego sklepu i ośmiu tygodni.
Podpis do pracy:
Co z tym zrobić w marketingu
- Nie decyduj z historii sprzedaży. Historia dała +29.9%, test – +7.7%.
- Testuj w schemacie „produkt sam ze sobą”. Losowanie tygodni w produkcie dało przedział [3.4, 12.3], losowanie produktów – [−41.3, 29.3].
- Zmieniaj końcówki tam, gdzie zmienia się lewa cyfra. 19.99 zamiast 20.00 ma sens; 24.99 zamiast 25.00 – prawie żadnego (+1.2%).
- Sprawdź progi filtrów. Przy 50.00 zł produkt znika z listy „poniżej 50 zł”. To decyzja o widoczności, nie o psychologii. Podobny mechanizm progu opisujemy przy progu darmowej dostawy.
- Policz rachunek, nie tylko sprzedaż. Grosz mniej na sztuce przy wzroście sprzedaży o kilka procent zwykle się opłaca; przy przecenach procentowych końcówki komplikują zaokrąglenia (zob. przecena końca sezonu). Strulov-Shlain (2023) szacuje, że sieci handlowe, wyceniając tak, jakby efekt lewej cyfry był mniejszy niż w rzeczywistości, tracą 1–4% potencjalnego zysku brutto.
Jak opisać w pracy
Opisz przydział cen, model, błędy standardowe i moc; wyniki podaj jako procentową zmianę sprzedaży z przedziałem ufności. Ogólne wskazówki znajdziesz we wpisie statystyka w pracy z marketingu, a o teście z kilkoma poziomami ceny – w losowym teście ceny.
| Grupa par cen | Produkty | Zmiana sprzedaży [95% CI] | p |
|---|---|---|---|
| A. Zmiana dziesiątki do 30 zł | 50 | +8.6% [2.6, 15.0] | .005 |
| B. Zmiana dziesiątki 40–100 zł | 50 | +4.9% [−4.6, 15.3] | .325 |
| C. 49.99 vs 50.00 | 40 | +30.5% [16.8, 45.8] | < .001 |
| D. Bez zmiany dziesiątki | 60 | +1.2% [−6.3, 9.3] | .765 |
| Łącznie | 200 | +7.7% [3.4, 12.3] | < .001 |
Kod R: dane historyczne, test losowy, grupy cen i moc
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcje minus() i proc(), z których korzystają następne. Przepisy 2–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(724)), 3 (set.seed(7241) – test i set.seed(7242) – porównawczy schemat z losowaniem produktów) i 5 (set.seed(7243)); ziaren nie zmieniano. Ręcznie ustalono: liczbę produktów w kategoriach (100, 80, 90, 80, 50), typowe ceny (70, 55, 45, 30 i 150 zł), elastyczność −1.8, efekt promocji (log 0.35), efekty końcówki ,99 (log 0.07, 0.05 i 0.01), udział filtra „poniżej 50 zł” (25%) i spadek wejść z filtra przy cenie 50–55 zł (do 40%), szansę końcówki ,99 zależną od kategorii, promocji i popularności, grupy testu (50, 50, 40 i 60 produktów), rozrzut sprzedaży (ujemny rozkład dwumianowy, parametr kształtu 8 w danych historycznych i 20 w teście) oraz parametry symulacji mocy. Po pierwszym uruchomieniu zmieniono: wpływ popularności na szansę końcówki ,99 z 2 na 0.8, efekt promocji z log 0.22 na log 0.35 i różnice popytu między kategoriami z (0, 0.1, −0.1, −0.2, 0.6) na (0, 0, 0.15, 0.25, 0.3) – przy pierwotnych wartościach model historyczny dawał +58%, a kontrola kategorii i promocji prawie nic nie zmieniała; oraz liczbę produktów w teście ze 160 na 200 i parametr kształtu w teście z 8 na 20 – przy pierwotnych wartościach test dawał +3.6%, 95% CI [−1.8, 9.2], przy prawdziwym efekcie 7.2%. Przepisy 1 i 3 zapisują dane do plików CSV w katalogu roboczym. Kod liczy się ok. 25 sekund.
1. Dane
R
# Przepis 1. Fikcyjny sklep internetowy z zabawkami edukacyjnymi: 400 produktów, 12 tygodni sprzedaży przed testem
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Końcówka ,99" = "#D55E00", "Cena pełna" = "#0072B2", "Szary" = "grey45")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków
proc <- function(b) 100 * (exp(b) - 1)               # współczynnik na skali log → zmiana sprzedaży w %

# Parametry ustalone ręcznie
kategorie <- c("Klocki konstrukcyjne", "Zestawy eksperymentów", "Gry logiczne", "Puzzle i układanki",
               "Roboty do programowania")
n_kat <- c(100, 80, 90, 80, 50)                      # liczba produktów w kategoriach
cena_mediana <- c(70, 55, 45, 30, 150)               # typowa cena w kategorii (zł)
popyt_kat <- c(0, 0, 0.15, 0.25, 0.3)               # różnice popytu między kategoriami (skala log)
szansa99_kat <- c(0, 0.2, 0.4, 0.8, -0.6)            # skłonność kategorii do końcówki ,99 (skala logitu)
elastycznosc <- -1.8                                 # prawdziwa elastyczność cenowa
efekt_promocji <- 0.35                               # produkt w „strefie okazji”: sprzedaż × 1.42
efekt_99 <- function(W) ifelse(W %% 10 == 0, ifelse(W <= 30, 0.07, 0.05), 0.01)   # prawdziwy efekt ,99 (log)
udzial_filtra <- 0.25                                # część popytu z filtra „poniżej 50 zł”
spadek_filtra <- 0.4                                 # przy cenie 50–55 zł z filtra trafia 40% tych klientów

set.seed(724)
kat <- rep(seq_along(kategorie), n_kat)
n <- length(kat)
popularnosc <- rnorm(n, 0, 0.5)                      # nieobserwowana „siła” produktu (bestseller, nowość)
promocja <- rbinom(n, 1, 0.25)
baza <- exp(rnorm(n, log(cena_mediana[kat]), 0.35))
los <- runif(n)
W <- ifelse(los < 0.4, pmax(10, round(baza / 10) * 10),          # cena „okrągła” w dziesiątkach
            ifelse(los < 0.7, pmax(10, round(baza / 5) * 5), pmax(9, round(baza))))
W <- ifelse(W >= 100 & W %% 5 != 0, round(W / 5) * 5, W)
# Kto dostaje końcówkę ,99: częściej produkty w promocji, tańsze kategorie i bestsellery (zakłócenie!)
k99 <- rbinom(n, 1, plogis(-0.4 + szansa99_kat[kat] + 1.2 * promocja + 0.8 * popularnosc))
cena <- ifelse(k99 == 1, W - 0.01, W)

# Średnia sprzedaż tygodniowa bez efektu filtra i mnożnik filtra „poniżej 50 zł” (ceny 50–55 zł są poza filtrem)
popyt_bazowy <- function(cena, W, k99, kat, popularnosc, promocja)
  exp(log(4) + popyt_kat[kat] + popularnosc + elastycznosc * log(cena / 50) + efekt_promocji * promocja +
        efekt_99(W) * k99)
mnoznik_filtra <- function(cena, W) ifelse(W >= 50 & W <= 55 & cena >= 50, spadek_filtra, 1)
lambda <- popyt_bazowy(cena, W, k99, kat, popularnosc, promocja) *
  (1 - udzial_filtra * (1 - mnoznik_filtra(cena, W)))
tydzien <- rnorm(12, 0, 0.08)                         # wahania tygodniowe
sprzedaz <- sapply(1:12, function(t) rnbinom(n, size = 8, mu = lambda * exp(tydzien[t])))

produkty <- data.frame(produkt = sprintf("P%03d", 1:n), kategoria = factor(kategorie[kat], levels = kategorie),
                       cena, cena_pelna_zl = W, koncowka99 = k99, promocja, sprzedaz_12tyg = rowSums(sprzedaz))
write.csv(produkty, "ceny-psychologiczne-produkty.csv", row.names = FALSE, fileEncoding = "UTF-8")

c(produkty = n, z_koncowka_99 = sum(k99), sztuk_12tyg = sum(produkty$sprzedaz_12tyg))
aggregate(cbind(koncowka99, promocja, cena) ~ kategoria, data = produkty, FUN = function(x) round(mean(x), 2))
Wynik w R
     produkty z_koncowka_99   sztuk_12tyg
          400           200         41501
                kategoria koncowka99 promocja   cena
1    Klocki konstrukcyjne       0.46     0.24  76.43
2   Zestawy eksperymentów       0.42     0.20  54.96
3            Gry logiczne       0.57     0.24  48.04
4      Puzzle i układanki       0.61     0.28  30.38
5 Roboty do programowania       0.40     0.22 148.28
2. Dane historyczne
R
# Przepis 2. Dane historyczne: regresja sprzedaży na log(ceny) i końcówkę ,99: Rysunek 1
# Korzysta z produkty, kol, motyw i proc() z przepisu 1.
produkty$koncowka <- factor(ifelse(produkty$koncowka99 == 1, "Końcówka ,99", "Cena pełna"),
                            levels = c("Końcówka ,99", "Cena pełna"))
# Kto ma końcówkę ,99? Odsetek w promocji i średnia sprzedaż w obu grupach
aggregate(cbind(promocja, sprzedaz_12tyg, cena) ~ koncowka, data = produkty, FUN = function(x) round(mean(x), 2))

# Regresja Poissona z nadmierną dyspersją (quasi-Poisson): współczynnik przy log(ceny) to elastyczność,
# a przy końcówce ,99 – skok sprzedaży ponad to, co wynika z 1 grosza różnicy w cenie
m0 <- glm(sprzedaz_12tyg ~ log(cena) + koncowka99, family = quasipoisson, data = produkty)
m1 <- update(m0, . ~ . + kategoria)
m2 <- update(m1, . ~ . + promocja)
obs <- do.call(rbind, lapply(list("bez kontroli" = m0, "+ kategoria" = m1, "+ kategoria i promocja" = m2),
  function(m) { b <- coef(summary(m))["koncowka99", ]; e <- coef(m)["log(cena)"]
    c(elastycznosc = unname(e), efekt99_proc = proc(b[["Estimate"]]),
      ci_dol = proc(b[["Estimate"]] - 1.96 * b[["Std. Error"]]), ci_gora = proc(b[["Estimate"]] + 1.96 * b[["Std. Error"]]),
      p = b[["Pr(>|t|)"]]) }))
round(obs, 3)
# Ile powinien dać sam 1 grosz? Elastyczność × zmiana log(ceny) przy 49.99 zamiast 50.00
round(100 * (exp(coef(m2)["log(cena)"] * log(49.99 / 50)) - 1), 3)

p1 <- ggplot(produkty, aes(cena, sprzedaz_12tyg / 12, colour = koncowka, shape = koncowka)) +
  geom_point(alpha = 0.55, size = 1.8) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, linewidth = 1.1) +
  scale_x_log10(breaks = c(10, 20, 30, 50, 100, 200, 300)) +
  scale_y_log10(breaks = c(0.1, 0.3, 1, 3, 10, 30)) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(17, 16), name = NULL) +
  labs(title = "Produkty z końcówką ,99 sprzedają się lepiej przy każdej cenie",
       subtitle = minus(sprintf("400 produktów, średnia tygodniowa sprzedaż; bez kontroli: +%.0f%%, po kontroli kategorii i promocji: +%.0f%%",
                                obs[1, "efekt99_proc"], obs[3, "efekt99_proc"])),
       x = "Cena (zł, skala log)", y = "Sztuk tygodniowo (skala log)") + motyw
p1   # zapis: ggsave("ceny-psychologiczne-dane-historyczne.svg", p1, width = 10, height = 5.6)
Wynik w R
      koncowka promocja sprzedaz_12tyg  cena
1 Końcówka ,99     0.33         132.79 60.88
2   Cena pełna     0.14          74.71 70.16
                       elastycznosc efekt99_proc ci_dol ci_gora p
bez kontroli                 -1.937       46.859 31.246  64.329 0
+ kategoria                  -1.837       42.616 27.441  59.598 0
+ kategoria i promocja       -1.857       29.927 16.720  44.628 0
log(cena)
    0.037
3. Test losowy, schemat i porównanie oszacowań – Rysunki 2 i 3
R
# Przepis 3. Test losowy: 200 produktów, 8 tygodni, co tydzień losowo cena ,99 albo pełna: Rysunki 2 i 3
# Korzysta z obiektów przepisów 1–2 (produkty, W, kat, popularnosc, promocja, popyt_bazowy(), mnoznik_filtra(), obs).
library(fixest)

# Pary cen w teście (ręcznie): A – zmiana dziesiątki do 30 zł, B – zmiana dziesiątki od 40 zł,
# C – 49.99 vs 50.00 (granica filtra „poniżej 50 zł”), D – bez zmiany cyfry dziesiątek (np. 24.99 vs 25.00)
pary <- list(A = c(20, 30), B = c(40, 60, 70, 80, 90, 100), C = 50, D = c(15, 25, 35, 45, 55, 65, 75))
liczba <- c(A = 50, B = 50, C = 40, D = 60)
wybrane <- integer(); grupa <- character(); para <- numeric()
for (g in c("C", "A", "B", "D")) {                   # do każdej grupy produkty o cenie najbliższej parom grupy
  odl <- sapply(W, function(w) min(abs(w - pary[[g]]))); odl[wybrane] <- Inf
  idx <- order(odl)[1:liczba[g]]
  wybrane <- c(wybrane, idx); grupa <- c(grupa, rep(g, liczba[g]))
  para <- c(para, sapply(W[idx], function(w) pary[[g]][which.min(abs(w - pary[[g]]))]))
}
tapply(abs(W[wybrane] - para), grupa, max)           # najdalsze przesunięcie ceny przy wejściu do testu (zł)

set.seed(7241)
n_t <- length(wybrane); tyg <- 8
przydzial <- t(replicate(n_t, sample(rep(0:1, each = tyg / 2))))   # każdy produkt: 4 tygodnie ,99 i 4 pełnej
efekt_tyg <- rnorm(tyg, 0, 0.08)
test <- data.frame(produkt = rep(produkty$produkt[wybrane], each = tyg), grupa = rep(grupa, each = tyg),
                   cena_pelna_zl = rep(para, each = tyg), tydzien = rep(1:tyg, n_t),
                   koncowka99 = as.vector(t(przydzial)))
i <- rep(wybrane, each = tyg)
test$cena <- test$cena_pelna_zl - 0.01 * test$koncowka99
mu <- popyt_bazowy(test$cena, test$cena_pelna_zl, test$koncowka99, kat[i], popularnosc[i], promocja[i]) *
  exp(efekt_tyg[test$tydzien])
test$sprzedaz_filtr <- rnbinom(nrow(test), size = 20, mu = mu * udzial_filtra * mnoznik_filtra(test$cena, test$cena_pelna_zl))
test$sprzedaz_inne <- rnbinom(nrow(test), size = 20, mu = mu * (1 - udzial_filtra))
test$sprzedaz <- test$sprzedaz_filtr + test$sprzedaz_inne
write.csv(test, "ceny-psychologiczne-test.csv", row.names = FALSE, fileEncoding = "UTF-8")
c(produkty = n_t, obserwacje = nrow(test), sztuk = sum(test$sprzedaz))

# Prawdziwy łączny efekt w teście (znamy go, bo dane są fikcyjne): log ilorazu oczekiwanej sprzedaży
mu99 <- popyt_bazowy(para - 0.01, para, 1, kat[wybrane], popularnosc[wybrane], promocja[wybrane]) *
  (1 - udzial_filtra * (1 - mnoznik_filtra(para - 0.01, para)))
mu00 <- popyt_bazowy(para, para, 0, kat[wybrane], popularnosc[wybrane], promocja[wybrane]) *
  (1 - udzial_filtra * (1 - mnoznik_filtra(para, para)))
prawda <- proc(log(sum(mu99) / sum(mu00))); round(prawda, 2)

# Analiza: regresja Poissona z efektami stałymi produktu i tygodnia, błędy odporne na klastrowanie po produkcie
t_fe <- fepois(sprzedaz ~ koncowka99 | produkt + tydzien, data = test, cluster = ~produkt)
wiersz <- function(m) { b <- coef(m)[["koncowka99"]]; s <- se(m)[["koncowka99"]]
  c(efekt99_proc = proc(b), ci_dol = proc(b - 1.96 * s), ci_gora = proc(b + 1.96 * s), p = pvalue(m)[["koncowka99"]]) }

# Dla porównania: ten sam sklep, ale losujemy produkty (połowa ma ,99 przez całe 8 tygodni) – symulacja
set.seed(7242)
rownolegly <- test[, c("produkt", "grupa", "cena_pelna_zl", "tydzien")]
rownolegly$koncowka99 <- rep(sample(rep(0:1, n_t / 2)), each = tyg)
rownolegly$cena <- rownolegly$cena_pelna_zl - 0.01 * rownolegly$koncowka99
mu_r <- popyt_bazowy(rownolegly$cena, rownolegly$cena_pelna_zl, rownolegly$koncowka99, kat[i], popularnosc[i],
                     promocja[i]) * exp(efekt_tyg[rownolegly$tydzien]) *
  (1 - udzial_filtra * (1 - mnoznik_filtra(rownolegly$cena, rownolegly$cena_pelna_zl)))
rownolegly$sprzedaz <- rnbinom(nrow(rownolegly), size = 20, mu = mu_r)
t_prod <- fepois(sprzedaz ~ koncowka99 | tydzien, data = rownolegly, cluster = ~produkt)

wyniki_testu <- rbind("test: losowanie produktów (symulacja)" = wiersz(t_prod),
                      "test: losowanie tygodni w produkcie" = wiersz(t_fe))
round(wyniki_testu, 4)

# Rysunek 2. Schemat losowania: pierwsze 24 produkty, 8 tygodni
sch <- subset(test, produkt %in% unique(test$produkt)[c(1:6, 41:46, 91:96, 141:146)])
sch$produkt <- factor(sch$produkt, levels = rev(unique(sch$produkt)))
sch$cena_txt <- sprintf("%.2f", sch$cena)
sch$koncowka <- factor(ifelse(sch$koncowka99 == 1, "Końcówka ,99", "Cena pełna"), levels = c("Końcówka ,99", "Cena pełna"))
p2 <- ggplot(sch, aes(tydzien, produkt, fill = koncowka)) +
  geom_tile(colour = "white", linewidth = 1) +
  geom_text(aes(label = cena_txt, colour = koncowka), size = 3.1, show.legend = FALSE) +
  facet_grid(grupa ~ ., scales = "free_y", space = "free_y",
             labeller = labeller(grupa = c(A = "A", B = "B", C = "C", D = "D"))) +
  scale_fill_manual(values = c("Końcówka ,99" = "#F6C9A9", "Cena pełna" = "#BFD9EC"), name = NULL) +
  scale_colour_manual(values = c("Końcówka ,99" = "#7A2E00", "Cena pełna" = "#003A5E")) +
  scale_x_continuous(breaks = 1:8, expand = c(0, 0)) +
  labs(title = "Ten sam produkt raz po 49.99, raz po 50.00 – kolejność tygodni losowa",
       subtitle = "24 z 200 produktów; każdy ma 4 tygodnie z końcówką ,99 i 4 z ceną pełną",
       x = "Tydzień testu", y = NULL) + motyw + theme(panel.grid.major = element_blank())
p2   # zapis: ggsave("ceny-psychologiczne-schemat-testu.svg", p2, width = 10, height = 7)

# Rysunek 3. Pięć oszacowań tego samego efektu
oszac <- data.frame(model = c(paste("historia:", rownames(obs)), rownames(wyniki_testu)),
                    rbind(obs[, c("efekt99_proc", "ci_dol", "ci_gora")], wyniki_testu[, 1:3]),
                    zrodlo = rep(c("Dane historyczne", "Test losowy"), c(3, 2)))
oszac$y <- 5:1
p3 <- ggplot(oszac, aes(efekt99_proc, y, colour = zrodlo, shape = zrodlo)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_vline(xintercept = prawda, linetype = "dashed", colour = "#009E73", linewidth = 0.9) +
  annotate("text", x = prawda + 1, y = 0.55, label = minus(sprintf("prawdziwy efekt w teście: +%.1f%%", prawda)),
           hjust = 0, size = 3.8, colour = "#00704F") +
  geom_errorbar(aes(xmin = ci_dol, xmax = ci_gora), width = 0.25, linewidth = 0.9, orientation = "y") +
  geom_point(size = 3.2) +
  geom_text(aes(x = ci_gora, label = minus(sprintf("%+.1f%% [%.1f, %.1f]", efekt99_proc, ci_dol, ci_gora))),
            hjust = -0.08, size = 3.6, show.legend = FALSE) +
  scale_colour_manual(values = c("Dane historyczne" = "#D55E00", "Test losowy" = "#0072B2"), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_x_continuous(labels = function(x) minus(paste0(x, "%"))) +
  scale_y_continuous(breaks = 5:1, labels = oszac$model) + coord_cartesian(xlim = c(-42, 95), ylim = c(0.45, 5.4)) +
  labs(title = "Ile dodaje końcówka ,99? Historia sprzedaży zawyża efekt",
       x = "Zmiana sprzedaży przy końcówce ,99 (95% CI)", y = NULL) + motyw
p3   # zapis: ggsave("ceny-psychologiczne-oszacowania.svg", p3, width = 10, height = 5.6)
Wynik w R
A B C D
0 0 2 0
  produkty obserwacje      sztuk
       200       1600      17221
[1] 6.82
                                      efekt99_proc   ci_dol ci_gora      p
test: losowanie produktów (symulacja)     -12.9203 -41.3399 29.2682 0.4925
test: losowanie tygodni w produkcie         7.7477   3.3826 12.2972 0.0004
4. Grupy cen i filtr „poniżej 50 zł” – Rysunek 4
R
# Przepis 4. Efekt zależy od progu: grupy cen i filtr „poniżej 50 zł”: Rysunek 4
# Korzysta z test, wiersz(), proc(), efekt_99(), udzial_filtra, spadek_filtra i motyw z przepisów 1–3.
opisy <- c(A = "A. zmiana dziesiątki,\ndo 30 zł (19.99 vs 20.00)", B = "B. zmiana dziesiątki,\n40–100 zł (69.99 vs 70.00)",
           C = "C. 49.99 vs 50.00\n(granica filtra), łącznie", C2 = "C. 49.99 vs 50.00,\ntylko wejścia bez filtra",
           D = "D. bez zmiany dziesiątki\n(24.99 vs 25.00)")
grupy <- lapply(c("A", "B", "C", "D"), function(g)
  wiersz(fepois(sprzedaz ~ koncowka99 | produkt + tydzien, data = subset(test, grupa == g), cluster = ~produkt)))
kanaly <- lapply(c("sprzedaz_inne", "sprzedaz_filtr"), function(y)
  wiersz(fepois(as.formula(paste(y, "~ koncowka99 | produkt + tydzien")), data = subset(test, grupa == "C"),
                cluster = ~produkt)))
zakresy <- data.frame(grupa = c("A", "B", "C", "C2", "D"), do.call(rbind, c(grupy[1:3], kanaly[1], grupy[4])))
# Prawdziwe efekty (znane z ustawień): w C łącznie dochodzi utrata klientów z filtra przy 50.00
zakresy$prawda <- proc(c(efekt_99(20), efekt_99(40),
                         efekt_99(50) + log(1 / (1 - udzial_filtra * (1 - spadek_filtra))), efekt_99(50), efekt_99(25)))
print(cbind(zakresy[1], round(zakresy[-1], 4)), row.names = FALSE)
round(kanaly[[2]], 4)                                 # w C: sprzedaż z listy z filtrem ceny (,99 vs 50.00)

# Łączny efekt bez grupy C (bez granicy filtra)
round(wiersz(fepois(sprzedaz ~ koncowka99 | produkt + tydzien, data = subset(test, grupa != "C"), cluster = ~produkt)), 4)

# Czy efekt przy zmianie dziesiątki do 30 zł (A) różni się od efektu bez zmiany dziesiątki (D)? Interakcja
t_int <- fepois(sprzedaz ~ koncowka99:grupa | produkt + tydzien, data = test, cluster = ~produkt)
b <- coef(t_int); V <- vcov(t_int)
roznica_AD <- b[["koncowka99:grupaA"]] - b[["koncowka99:grupaD"]]
se_AD <- sqrt(V["koncowka99:grupaA", "koncowka99:grupaA"] + V["koncowka99:grupaD", "koncowka99:grupaD"] -
               2 * V["koncowka99:grupaA", "koncowka99:grupaD"])
round(c(roznica_log = roznica_AD, se = se_AD, z = roznica_AD / se_AD, p = 2 * pnorm(-abs(roznica_AD / se_AD))), 4)

zakresy$etykieta <- factor(opisy[zakresy$grupa], levels = rev(opisy))
p4 <- ggplot(zakresy, aes(efekt99_proc, etykieta)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = ci_dol, xmax = ci_gora), width = 0.25, linewidth = 0.9, colour = "#0072B2",
                orientation = "y") +
  geom_point(size = 3.2, colour = "#0072B2") +
  geom_point(aes(x = prawda), shape = 4, size = 3.4, stroke = 1.3, colour = "#009E73") +
  geom_text(aes(x = ci_gora, label = minus(sprintf("%+.1f%% [%.1f, %.1f]", efekt99_proc, ci_dol, ci_gora))),
            hjust = -0.08, size = 3.6, colour = "grey15") +
  coord_cartesian(xlim = c(-8, 70)) +
  scale_x_continuous(labels = function(x) minus(paste0(x, "%"))) +
  labs(title = "Efekt końcówki ,99 zależy od tego, którą cyfrę zmienia",
       subtitle = "Kropka i odcinek – test (95% CI); krzyżyk – prawdziwy efekt ustawiony w danych",
       x = "Zmiana sprzedaży przy końcówce ,99", y = NULL) + motyw
p4   # zapis: ggsave("ceny-psychologiczne-zakresy-cen.svg", p4, width = 10, height = 6)
Wynik w R
 grupa efekt99_proc  ci_dol ci_gora      p  prawda
     A       8.6090  2.5773 14.9953 0.0046  7.2508
     B       4.8626 -4.6006 15.2645 0.3251  5.1271
     C      30.4610 16.7666 45.7616 0.0000 23.6790
    C2       8.7525 -4.9814 24.4714 0.2232  5.1271
     D       1.1860 -6.3313  9.3065 0.7647  1.0050
efekt99_proc       ci_dol      ci_gora            p
    181.0689     117.3967     263.3897       0.0000
efekt99_proc       ci_dol      ci_gora            p
      5.8519       1.2940      10.6149       0.0113
roznica_log          se           z           p
     0.0747      0.0508      1.4713      0.1412
5. Moc testu – Rysunek 5
R
# Przepis 5. Moc testu przy małym efekcie: ile produktów i tygodni potrzeba? Rysunek 5
# Korzysta z test i fixest (przepis 3) oraz motyw z przepisu 1.
# Przy losowaniu 4 + 4 tygodni w każdym produkcie regresja Poissona z efektem stałym produktu ma prosty wzór:
# efekt = log(suma sprzedaży w tygodniach ,99 / suma w tygodniach z ceną pełną), a błąd odporny na klastrowanie
# po produkcie liczy się z reszt produktów. Dzięki temu symulacja liczy się w kilka sekund.
efekt_ilorazowy <- function(y99, y00) {               # y99, y00: sprzedaż produktów w tygodniach ,99 i pełnej
  S99 <- sum(y99); S00 <- sum(y00); n <- length(y99)
  u <- y99 - (S99 / S00) * y00
  c(b = log(S99 / S00), se = sqrt(sum(u^2) * n / (n - 1)) / S99)
}
# Sprawdzenie na danych testu z przepisu 3: wzór = fepois z efektem stałym produktu
s99 <- tapply(test$sprzedaz * test$koncowka99, test$produkt, sum)
s00 <- tapply(test$sprzedaz * (1 - test$koncowka99), test$produkt, sum)
m_prod <- fepois(sprzedaz ~ koncowka99 | produkt, data = test, cluster = ~produkt, ssc = ssc(adj = FALSE))
round(rbind(wzor = efekt_ilorazowy(s99, s00), fepois = c(coef(m_prod), se(m_prod))), 5)

symuluj_test <- function(n_prod, efekt, tyg = 8) {
  lam <- rlnorm(n_prod, log(6), 0.9)                 # średnia sprzedaż produktu: mediana 6 sztuk tygodniowo
  kolej <- order(rep(1:n_prod, each = tyg), runif(n_prod * tyg))   # w każdym produkcie losowa kolejność tygodni
  k99 <- integer(n_prod * tyg); k99[kolej] <- rep(rep(0:1, each = tyg / 2), n_prod)
  k99 <- matrix(k99, n_prod, tyg, byrow = TRUE)      # 4 (lub 8) tygodni z ,99 w każdym produkcie
  mu <- lam * matrix(exp(rnorm(tyg, 0, 0.08)), n_prod, tyg, byrow = TRUE) * exp(log(1 + efekt) * k99)
  y <- matrix(rnbinom(n_prod * tyg, size = 20, mu = mu), n_prod, tyg)
  w <- efekt_ilorazowy(rowSums(y * k99), rowSums(y * (1 - k99)))
  abs(w[["b"]] / w[["se"]]) > qnorm(0.975)
}
set.seed(7243)
siatka <- expand.grid(n_prod = c(50, 100, 200, 400, 800), efekt = c(0.03, 0.05, 0.08), tyg = c(8, 16))
powt <- 1000
siatka$moc <- sapply(seq_len(nrow(siatka)), function(j)
  mean(replicate(powt, symuluj_test(siatka$n_prod[j], siatka$efekt[j], siatka$tyg[j]))))
siatka$blad_mc <- sqrt(siatka$moc * (1 - siatka$moc) / powt)        # błąd Monte Carlo odsetka
print(transform(siatka, moc = round(100 * moc, 1), blad_mc = round(100 * blad_mc, 1)), row.names = FALSE)

siatka$Efekt <- factor(sprintf("+%d%%", round(100 * siatka$efekt)), levels = c("+3%", "+5%", "+8%"))
siatka$Tygodnie <- factor(paste(siatka$tyg, "tygodni"), levels = c("8 tygodni", "16 tygodni"))
p5 <- ggplot(siatka, aes(n_prod, moc, colour = Efekt, shape = Efekt, linetype = Tygodnie)) +
  geom_hline(yintercept = 0.8, linetype = "dotted", colour = "grey30") +
  geom_line(linewidth = 1) + geom_point(size = 2.6) +
  scale_x_log10(breaks = c(50, 100, 200, 400, 800)) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  scale_colour_manual(values = c("+3%" = "#D55E00", "+5%" = "#0072B2", "+8%" = "#009E73")) +
  scale_shape_manual(values = c(17, 16, 15)) +
  labs(title = "Mały efekt ceny wymaga wielu produktów albo dłuższego testu",
       subtitle = sprintf("Moc testu (α = .05): %d symulacji na punkt; mediana sprzedaży produktu 6 sztuk tygodniowo", powt),
       x = "Liczba produktów w teście (skala log)", y = "Moc", colour = "Prawdziwy efekt ,99", shape = "Prawdziwy efekt ,99",
       linetype = NULL) + motyw + theme(legend.box = "vertical")
p5   # zapis: ggsave("ceny-psychologiczne-moc.svg", p5, width = 10, height = 6)
Wynik w R
             b     se
wzor   0.08216 0.0235
fepois 0.08216 0.0235
 n_prod efekt tyg   moc blad_mc
     50  0.03   8  13.1     1.1
    100  0.03   8  14.9     1.1
    200  0.03   8  24.5     1.4
    400  0.03   8  39.9     1.5
    800  0.03   8  69.1     1.5
     50  0.05   8  24.0     1.4
    100  0.05   8  33.0     1.5
    200  0.05   8  53.6     1.6
    400  0.05   8  83.1     1.2
    800  0.05   8  97.3     0.5
     50  0.08   8  41.8     1.6
    100  0.08   8  63.4     1.5
    200  0.08   8  88.4     1.0
    400  0.08   8  99.5     0.2
    800  0.08   8 100.0     0.0
     50  0.03  16  17.2     1.2
    100  0.03  16  26.3     1.4
    200  0.03  16  41.0     1.6
    400  0.03  16  67.6     1.5
    800  0.03  16  92.7     0.8
     50  0.05  16  35.0     1.5
    100  0.05  16  54.8     1.6
    200  0.05  16  81.2     1.2
    400  0.05  16  98.2     0.4
    800  0.05  16 100.0     0.0
     50  0.08  16  66.1     1.5
    100  0.08  16  88.9     1.0
    200  0.08  16  99.4     0.2
    400  0.08  16 100.0     0.0
    800  0.08  16 100.0     0.0
6. Grafika
R
# Przepis 6. Grafika: karta „19.99 vs 20.00” z liczbami z przykładu: Rysunek 6
# Korzysta z obs i m2 (przepis 2), wyniki_testu i prawda (przepis 3) oraz zakresy (przepis 4).
f1 <- function(x) sprintf("%.1f", x)
grosz <- proc(coef(m2)[["log(cena)"]] * log(49.99 / 50))
tst <- wyniki_testu["test: losowanie tygodni w produkcie", ]
zk <- setNames(split(zakresy, zakresy$grupa), zakresy$grupa)
karty <- data.frame(
  x = c(0, 1, 0, 1), y = c(1, 1, 0, 0),
  naglowek = c("1. Jeden grosz to prawie nic", "2. Historia sprzedaży: zawyżone",
               "3. Test losowy: tydzień po tygodniu", "4. Liczy się cyfra, która się zmienia"),
  tresc = minus(c(
    sprintf("49.99 zamiast 50.00 = cena niższa o 0.02%%\nprzy elastyczności %.2f sprzedaż\npowinna wzrosnąć o %.2f%%\nwszystko ponad to – efekt końcówki",
            coef(m2)[["log(cena)"]], grosz),
    sprintf("400 produktów, regresja z log(ceny):\n+%s%% [%s, %s] po kontroli kategorii\ni promocji; końcówkę ,99 mają\nczęściej bestsellery – zakłócenie",
            f1(obs[3, "efekt99_proc"]), f1(obs[3, "ci_dol"]), f1(obs[3, "ci_gora"])),
    sprintf("200 produktów × 8 tygodni, losowo\n,99 albo cena pełna: +%s%% [%s, %s]\nprawdziwy efekt w danych: +%s%%\nefekty stałe produktu i tygodnia",
            f1(tst[["efekt99_proc"]]), f1(tst[["ci_dol"]]), f1(tst[["ci_gora"]]), f1(prawda)),
    sprintf("19.99 vs 20.00: +%s%%\n24.99 vs 25.00: +%s%% (ta sama dziesiątka)\n49.99 vs 50.00: +%s%% – głównie filtr\n„poniżej 50 zł”, nie psychologia",
            f1(zk$A$efekt99_proc), f1(zk$D$efekt99_proc), f1(zk$C$efekt99_proc)))))
p6 <- ggplot(karty) +
  geom_rect(aes(xmin = x - 0.47, xmax = x + 0.47, ymin = y - 0.44, ymax = y + 0.44),
            fill = c("#F2F7FB", "#FDF1E9", "#F2F7FB", "#F2F7FB"), colour = c("#0072B2", "#D55E00", "#0072B2", "#0072B2"),
            linewidth = 0.8) +
  geom_text(aes(x = x - 0.43, y = y + 0.32, label = naglowek), hjust = 0, vjust = 1, fontface = "bold",
            size = 4.6, colour = "#0f1d3a") +
  geom_text(aes(x = x - 0.43, y = y + 0.12, label = tresc), hjust = 0, vjust = 1, size = 4.2,
            lineheight = 1.05, colour = "grey15") +
  coord_cartesian(xlim = c(-0.5, 1.5), ylim = c(-0.48, 1.48), expand = FALSE) +
  labs(title = "19.99 czy 20.00? Cztery kroki odpowiedzi (sklep z zabawkami edukacyjnymi)", x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p6   # zapis: ggsave("ceny-psychologiczne-karta.svg", p6, width = 10, height = 6)
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Przepis 7. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("końcówka ,99 – cena pełna" = c("#D55E00", "#0072B2"),
             "efekt +3% – +5%" = c("#D55E00", "#0072B2"), "efekt +5% – +8%" = c("#0072B2", "#009E73"),
             "efekt +3% – +8%" = c("#D55E00", "#009E73"),
             "tło ,99 – tło pełnej" = c("#F6C9A9", "#BFD9EC"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
końcówka ,99 – cena pełna                  114.6        108.3       91.9
efekt +3% – +5%                            114.6        108.3       91.9
efekt +5% – +8%                             70.1         55.4       58.0
efekt +3% – +8%                            102.4         53.5       37.3
tło ,99 – tło pełnej                        37.8         37.2       31.4
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i regresja quasi-Poissona (glm) – pakiet stats. Regresję Poissona z efektami stałymi i błędami odpornymi na klastrowanie policzono pakietem fixest. Rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- fixest (wersja 0.14.2): Bergé, L. (2018). Efficient estimation of maximum likelihood models with multiple fixed-effects: The R package FENmlm (CREA Discussion Paper No. 2018-13). University of Luxembourg. https://CRAN.R-project.org/package=fixest
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Zakłócenie w danych historycznych. Kontrola widocznych zmiennych zmniejszyła efekt z +46.9% do +29.9%, ale nie do prawdziwych kilku procent.
- Jedna liczba na wszystkie ceny. Efekt zależy od tego, czy zmienia się lewa cyfra (Thomas i Morwitz, 2005), i od poziomu ceny (Manning i Sprott, 2009). Średnia +7.7% miesza +1.2% (24.99 vs 25.00) z +30.5% (49.99 vs 50.00).
- Filtr i sortowanie zamiast psychologii. Przy granicy filtra „poniżej 50 zł” większość skoku to widoczność produktu. Sprzedaż z filtra wzrosła o 181.1%, poza filtrem – o 8.8%. Rozdziel sprzedaż według źródła wejścia.
- Wizerunek, nie tylko poziom ceny. Końcówki mogą działać także przez to, co klient z nich wnioskuje, np. „to promocja” (Stiving i Winer, 1997). Długofalowy efekt może być inny niż w 8-tygodniowym teście.
- Przesuwanie zakupów między produktami. Zmiana końcówek dwóch podobnych produktów przesuwa udziały wyborów między nimi (Manning i Sprott, 2009). Sklep jako całość zyskuje wtedy mniej, niż pokazuje test produktu.
- Za mały test. Przy efekcie +5% 200 produktów przez 8 tygodni daje moc 53.6%. Brak istotności w takim teście nie znaczy, że końcówki nie działają.
Kontrolowany eksperyment u wysyłkowego sprzedawcy odzieży też wykazał, że końcówka 99 zwiększa zakupy (Schindler i Kibarian, 1996).
Najczęstsze pytania
Czy cena 19.99 sprzedaje więcej niż 20.00?
Często tak, ale mniej, niż pokazują dane historyczne. W fikcyjnym teście sklepu z zabawkami cena 19.99 zamiast 20.00 zwiększała sprzedaż o 8.6%, 95% CI [2.6, 15.0], a cena 24.99 zamiast 25.00 – tylko o 1.2%. Efekt zależy od tego, czy końcówka zmienia lewą cyfrę ceny (Thomas i Morwitz, 2005).
Co to jest efekt lewej cyfry?
To skłonność do oceniania liczby głównie po pierwszej cyfrze: 4.99 wydaje się znacznie mniejsze niż 5.00. Na danych skanerowych klienci reagowali na podwyżkę o jeden cent od ceny z końcówką 99 tak, jakby była to podwyżka o ponad 20 centów (Strulov-Shlain, 2023).
Dlaczego nie wystarczy regresja na danych sprzedażowych?
Bo końcówkę ,99 rzadko przydziela się losowo: dostają ją produkty w promocji, tańsze kategorie i bestsellery. W przykładzie regresja z log(ceny), kategorią i promocją dała +29.9%, a prawdziwy efekt wynosił kilka procent. Zakłócenie usuwa dopiero test losowy.
Jak zaplanować test ceny 49.99 vs 50.00?
Losuj tygodnie z każdą ceną w obrębie produktu (np. 4 + 4 tygodnie w losowej kolejności) i licz regresję Poissona z efektami stałymi produktu i tygodnia oraz błędami odpornymi na klastrowanie po produkcie. W przykładzie dało to przedział [3.4, 12.3]; losowanie całych produktów na tej samej liczbie produktów dało [−41.3, 29.3].
Ilu produktów potrzeba, żeby wykryć efekt końcówki ,99?
Przy efekcie +5%, 8 tygodniach testu i medianie sprzedaży 6 sztuk tygodniowo moc 80% osiągano przy około 400 produktach (83.1%); przy 200 produktach moc wynosiła 53.6%, a przy 16 tygodniach – 81.2%. Liczebność policz symulacją dla swojej sprzedaży.
Powiązane hasła
Przeczytaj też
Elastyczność cenowa z danych sprzedażowych
Sieć 10 sklepów i granola: regresja log–log z przedziałem, elastyczność krzyżowa, marża i cena optymalna oraz pułapka ceny ustalanej pod popyt – z kodem R.
Czytaj →PoradnikLosowy test ceny i krzywa popytu
Aplikacja z subskrypcją i pięć losowych cen: konwersja, retencja, zysk i cena optymalna z bootstrapem oraz pułapka krzywej z historii – z kodem R.
Czytaj →PoradnikPróg darmowej dostawy – metoda bunching
Skupienie koszyków nad progiem, rozkład kontrfaktyczny, bootstrap i rachunek progu – na fikcyjnym sklepie z herbatami, z kodem R.
Czytaj →Analizujesz ceny albo test cenowy do pracy?
Pomożemy zaplanować test ceny, policzyć model z efektami stałymi i moc oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Lacetera, N., Pope, D. G., & Sydnor, J. R. (2012). Heuristic thinking and limited attention in the car market. American Economic Review, 102(5), 2206–2236. https://doi.org/10.1257/aer.102.5.2206 ● Otwarty dostęp: pełny tekst
- Manning, K. C., & Sprott, D. E. (2009). Price endings, left-digit effects, and choice. Journal of Consumer Research, 36(2), 328–335. https://doi.org/10.1086/597215
- Schindler, R. M., & Kibarian, T. M. (1996). Increased consumer sales response though use of 99-ending prices. Journal of Retailing, 72(2), 187–199. https://doi.org/10.1016/s0022-4359(96)90013-5 ● Otwarty dostęp
- Stiving, M., & Winer, R. S. (1997). An empirical analysis of price endings with scanner data. Journal of Consumer Research, 24(1), 57–67. https://doi.org/10.1086/209493
- Strulov-Shlain, A. (2023). More than a penny’s worth: Left-digit bias and firm pricing. Review of Economic Studies, 90(5), 2612–2645. https://doi.org/10.1093/restud/rdac082 ● Otwarty dostęp: pełny tekst
- Thomas, M., & Morwitz, V. (2005). Penny wise and pound foolish: The left-digit effect in price cognition. Journal of Consumer Research, 32(1), 54–64. https://doi.org/10.1086/429600
Cytowania BibTeX
@article{lacetera2012heuristic, author={Lacetera, Nicola and Pope, Devin G. and Sydnor, Justin R.}, title={{Heuristic thinking and limited attention in the car market}}, journal={American Economic Review}, year={2012}, volume={102}, number={5}, pages={2206--2236}, doi={10.1257/aer.102.5.2206}}@article{manning2009price, author={Manning, Kenneth C. and Sprott, David E.}, title={{Price endings, left-digit effects, and choice}}, journal={Journal of Consumer Research}, year={2009}, volume={36}, number={2}, pages={328--335}, doi={10.1086/597215}}@article{schindler1996increased, author={Schindler, Robert M. and Kibarian, Thomas M.}, title={{Increased consumer sales response though use of 99-ending prices}}, journal={Journal of Retailing}, year={1996}, volume={72}, number={2}, pages={187--199}, doi={10.1016/s0022-4359(96)90013-5}}@article{stiving1997empirical, author={Stiving, Mark and Winer, Russell S.}, title={{An empirical analysis of price endings with scanner data}}, journal={Journal of Consumer Research}, year={1997}, volume={24}, number={1}, pages={57--67}, doi={10.1086/209493}}@article{strulovshlain2023more, author={Strulov-Shlain, Avner}, title={{More than a penny’s worth: Left-digit bias and firm pricing}}, journal={Review of Economic Studies}, year={2023}, volume={90}, number={5}, pages={2612--2645}, doi={10.1093/restud/rdac082}}@article{thomas2005penny, author={Thomas, Manoj and Morwitz, Vicki}, title={{Penny wise and pound foolish: The left-digit effect in price cognition}}, journal={Journal of Consumer Research}, year={2005}, volume={32}, number={1}, pages={54--64}, doi={10.1086/429600}}